DLCV 06・影像中的文字:OCR 與文件理解
先備知識:DLCV 03・物件偵測:從 R-CNN 到 DETR
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
在玩具辨識器的輸出中,改變兩個相同字母之間畫格的空白機率,觀察貪婪(最佳路徑)解碼與前綴束搜尋怎麼讀它。
你將學到
- 區分文字偵測、辨識、版面分析與文件理解。
- 比較幾何式與分割式文字偵測器。
- 使用 CTC、注意力或 Transformer 模型解碼字元序列。
- 理解版面感知與不依賴獨立 OCR 的文件模型。
- 以適當協定評估辨識、偵測與下游擷取。
先看全貌
影像裡到處都是文字:路標、商品標籤、車牌、收據、表單、投影片與螢幕截圖。讀出它們,就是把像素變成程式可以搜尋、翻譯、檢查或儲存的字串,這件事稱為光學字元辨識(optical character recognition,OCR)。困難的版本是一般照片裡的文字,稱為場景文字(scene text)閱讀;有結構的版本是頁面的掃描檔與 PDF,稱為文件(document)分析。
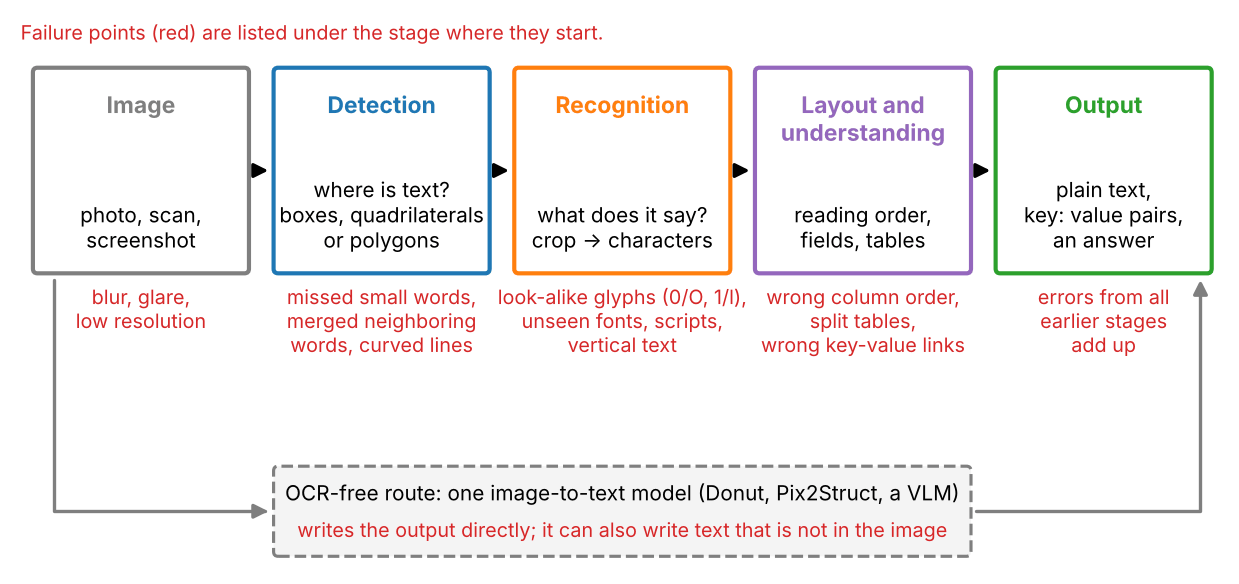
為什麼要獨立成一篇?一個單字又長又細,常常旋轉或彎曲,還緊貼著鄰居;它的「類別」不是固定清單裡的標籤,而是一個字母表上的任意字串,這個字母表可能有好幾萬個符號;而且一個字元寫錯就可能改變意思(發票上的「1046」與「1O46」)。所以這個領域有自己的偵測器、序列辨識器、指標與基準資料集。現在又有一類模型會讀完整頁並直接寫出結構化文字,讓整條管線變成可有可無,卻也帶來新的風險:影像並不支持、但讀起來很流暢的輸出。圖 1 畫出這條管線,以及每個階段常見的失敗。
本篇假設你已經讀過 DLCV 03,知道邊界框、IoU、NMS 與精確率–召回率。其他概念用連結帶過、不重複講:CTC 演算法(PR 06 的 CTC 補充資料)、編輯距離(PR 06)、注意力(NLP 07)與視覺語言模型(ML 10)。Long 等人 [1] 與 Chen 等人 [2] 的綜述整理了場景文字;Cui 等人 [3] 與 Zhang 等人 [4] 則涵蓋文件。
閱讀管線與出錯的地方
白話版。 傳統的 OCR 系統是一條鏈:找出文字區域、逐一讀出來,再把讀到的內容排好順序、賦予意義。每一環都會把自己的錯誤傳給下一環。
場景文字與文件文字
這兩種情境困難的地方不一樣。
| 場景文字 | 文件文字 | |
|---|---|---|
| 來源 | 照片、影片、街景 | 掃描檔、PDF、螢幕截圖、用手機拍的頁面 |
| 數量 | 每張影像幾個字 | 每頁數百到數千字 |
| 幾何 | 任意方向、透視、曲線 | 大多是水平行;有欄與表格 |
| 外觀 | 裝飾字體、雜亂背景、反光、模糊 | 小字、雜訊、印章、手寫 |
| 主要困難 | 找到並讀出每個單字 | 閱讀順序、結構與意義 |
基準資料集也依此分成兩類。與 ICDAR(International Conference on Document Analysis and Recognition,國際文件分析與辨識會議)同時舉辦的 Robust Reading 競賽,定義了許多標準的場景文字基準:ICDAR 2013 是對焦清楚、大多水平的英文文字 [5];ICDAR 2015 的 Incidental Scene Text 挑戰賽 [6] 用穿戴式相機(Google Glass)拍攝,單字常常很小、模糊又旋轉 [7]。文件基準則要求找出版面區域、表單欄位,或回答關於頁面的問題(見文件理解)。
錯誤從四個地方開始
知道錯誤出在哪個階段,比較容易修。
- 影像。 模糊、反光、低解析度與壓縮會把證據抹掉。像素裡沒有的字元,後面的階段都救不回來;若有生成模型「救回」了它,那只是猜的(見失效模式)。
- 偵測。 漏掉的單字就永遠消失了;兩個單字被合併成一個框,會被讀成一個字串;框切掉最後一個字母,就會產生刪除錯誤。
- 辨識。 長得像的字形(0/O、1/l/I、rn/m)、沒見過的字體與文字系統,以及直排文字,都會造成替換錯誤。
- 版面與理解。 字都對但順序錯、表格被橫著讀而不是直著讀、或是把數值接到錯的鍵上,都會讓完美的字元得到錯誤的答案。
一個好習慣:先單獨評估每個階段(例如用真值裁切圖評估辨識),再評估整條鏈,這樣才知道該改進哪一個階段。
深度學習之前:閾值與連通元件
白話版。 在乾淨頁面可對深色像素門檻化、分組連通區域並擬合方框;不均勻背景與相接字元會揭露此基準的限制。
傳統做法有三個步驟。二值化(binarization)拿像素和閾值比較,把每個像素標成墨水或紙。單一的全域閾值,例如用 Otsu 方法 [8] 選出的那個(推導見 IP 10),在光線不均時會失敗,所以文件系統改用局部閾值,在每個像素周圍的視窗內計算。Sauvola 方法 [9] 是為文件影像設計的,很常用:
其中 是像素 處的閾值, 與 是以該像素為中心、 視窗內灰階值的平均與標準差, 是標準差的動態範圍,(scikit-image 的預設值是 0.2)控制局部對比會把閾值壓低多少。比 暗的像素就是墨水。接著分組(grouping)把墨水像素併成連通元件(connected components,IP 09),通常會先做一次水平膨脹,把單字內字母之間的空隙接起來。取框(box extraction)則取每個連通元件的外接框。
下面的程式用 matplotlib 畫一張小發票,把左側調暗、加上雜訊,再用全域與局部閾值各跑一次這套做法。它用文字基準使用的精確率、召回率與 H-mean 為框打分(精確定義見評估 OCR):若預測框和某個尚未被配對的真值單字的 IoU 至少 0.5,就算正確。
程式碼 · Python · 64 行
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from scipy import ndimage as ndi
from skimage.filters import threshold_otsu, threshold_sauvola

H, W = 200, 560
WORDS = [("INVOICE", 20, 18, 22), ("No.", 200, 24, 14), ("1046", 245, 24, 14),
         ("Date:", 330, 24, 14), ("2026-11-01", 385, 24, 14),
         ("Item", 20, 80, 13), ("Qty", 260, 80, 13), ("Price", 400, 80, 13),
         ("Paper", 20, 110, 13), ("12", 265, 110, 13), ("3.50", 405, 110, 13),
         ("Total", 20, 160, 15), ("42.00", 395, 160, 15)]     # (word, x, y, font size)

def render(words):
    """Draw words with matplotlib; return a gray image in [0, 1] and word boxes."""
    fig = plt.figure(figsize=(W / 100, H / 100), dpi=100)
    texts = [fig.text(x / W, 1 - y / H, s, fontsize=fs, va="top") for s, x, y, fs in words]
    fig.canvas.draw()
    img = np.asarray(fig.canvas.buffer_rgba())[..., :3].mean(axis=2) / 255.0
    r = fig.canvas.get_renderer()
    boxes = [[b.x0, H - b.y1, b.x1, H - b.y0]
             for b in (t.get_window_extent(r) for t in texts)]
    plt.close(fig)
    return img, np.array(boxes)

def iou(a, b):
    w = min(a[2], b[2]) - max(a[0], b[0]); h = min(a[3], b[3]) - max(a[1], b[1])
    inter = max(w, 0) * max(h, 0)
    area = lambda r: (r[2] - r[0]) * (r[3] - r[1])
    return inter / (area(a) + area(b) - inter)

def detect(img, thresh, gap=9):
    ink = img < thresh                                   # dark pixels = ink
    ink = ndi.binary_opening(ink, np.ones((2, 2)))       # drop isolated noise pixels
    words = ndi.binary_dilation(ink, np.ones((3, gap)))  # bridge gaps between letters
    lab, _ = ndi.label(words)
    out = []
    for y, x in ndi.find_objects(lab):
        if (y.stop - y.start) * (x.stop - x.start) > 40:   # ignore tiny blobs
            out.append([x.start, y.start, x.stop, y.stop])
    return np.array(out, float)

def h_mean(pred, gt, thr=0.5):
    used, tp = set(), 0
    for p in pred:                                       # greedy one-to-one matching
        cand = [(iou(p, g), j) for j, g in enumerate(gt) if j not in used]
        best = max(cand, default=(0, -1))
        if best[0] >= thr:
            used.add(best[1]); tp += 1
    P, R = tp / max(len(pred), 1), tp / len(gt)
    return P, R, 2 * P * R / max(P + R, 1e-9)

rng = np.random.default_rng(0)
clean, gt = render(WORDS)
shade = 0.45 + 0.55 * np.linspace(0, 1, W)[None, :]      # light falls off to the left
img = np.clip(clean * shade + rng.normal(0, 0.04, clean.shape), 0, 1)

t_sau = threshold_sauvola(img, window_size=31)
for name, t, gap in [("Otsu, gap 9", threshold_otsu(img), 9), ("Sauvola, gap 3", t_sau, 3),
                     ("Sauvola, gap 9", t_sau, 9), ("Sauvola, gap 25", t_sau, 25)]:
    pred = detect(img, t, gap)
    P, R, F = h_mean(pred, gt)
    print(f"{name:16s} boxes={len(pred):2d}  P={P:.2f}  R={R:.2f}  H-mean={F:.2f}")
輸出
Otsu, gap 9      boxes= 8  P=0.62  R=0.38  H-mean=0.48
Sauvola, gap 3   boxes=33  P=0.15  R=0.38  H-mean=0.22
Sauvola, gap 9   boxes=13  P=1.00  R=1.00  H-mean=1.00
Sauvola, gap 25  boxes=11  P=0.64  R=0.54  H-mean=0.58
圖 2 顯示發生了什麼事。全域閾值把整個暗的左側都標成墨水,那裡的單字就消失在一個巨大的假框裡。局部閾值找回了每個單字,但只在人工挑選的某個間隙值下成立:膨脹太窄會把單字切成字母,太寬又會把「No.」與「1046」、「Date:」與日期合併。這裡所有數字都來自這個合成的玩具範例。
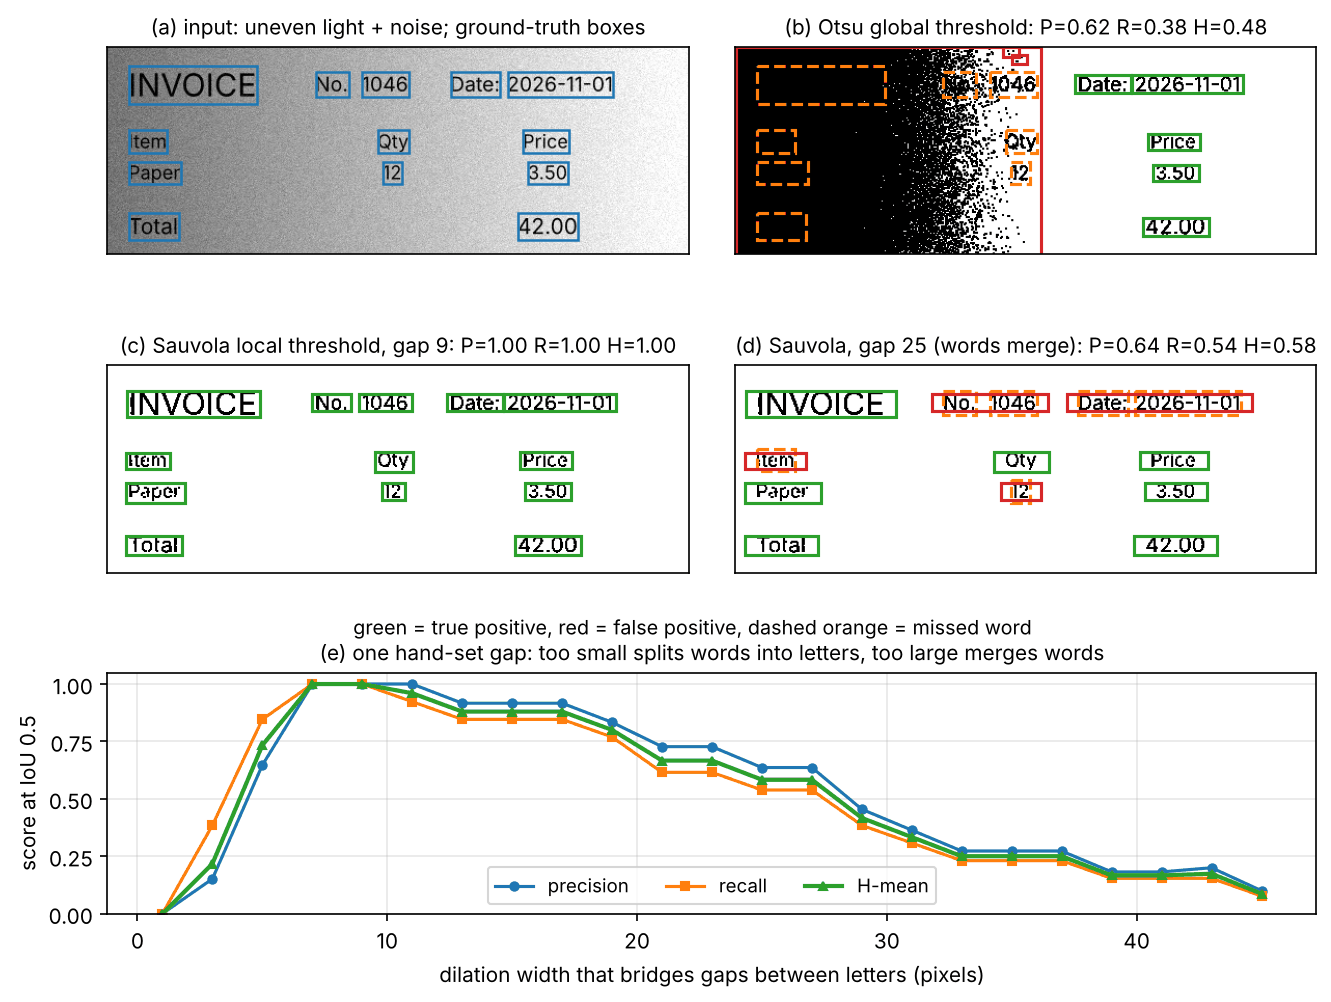
這個實驗正是學習式文字偵測器的動機。真實影像同時包含各種字體大小、紋理背景上的文字、旋轉,以及單字之間比其他單字內字母之間還近的情況。網路可以從上下文與外觀學會文字在哪裡,也能學會把鄰居分開。
文字偵測
白話版。 文字偵測器須以幾何預測或文字遮罩,處理細長、旋轉、彎曲及間距很近的區域。
為什麼文字不只是另一種物件
DLCV 03 的偵測器預測的是正立(與座標軸對齊)的框。對文字來說,這在三個地方會出問題。
- 極端的長寬比。 一行文字可能比它的高度寬很多倍,遠遠超出為一般物件調好的錨框形狀。
- 方向與彎曲。 招牌與包裝上的字會旋轉、有透視變形,或沿著曲線排列。所以基準資料集標註的是四邊形(ICDAR 2015 [6])或多邊形(Total-Text [10]、CTW1500 [11]),而且是在多邊形之間而不是矩形之間計算 IoU。
- 緊鄰的單字。 一行上的單字只隔幾個像素;把它們合併,或讓 NMS 刪掉其中一個,都會降低召回率。
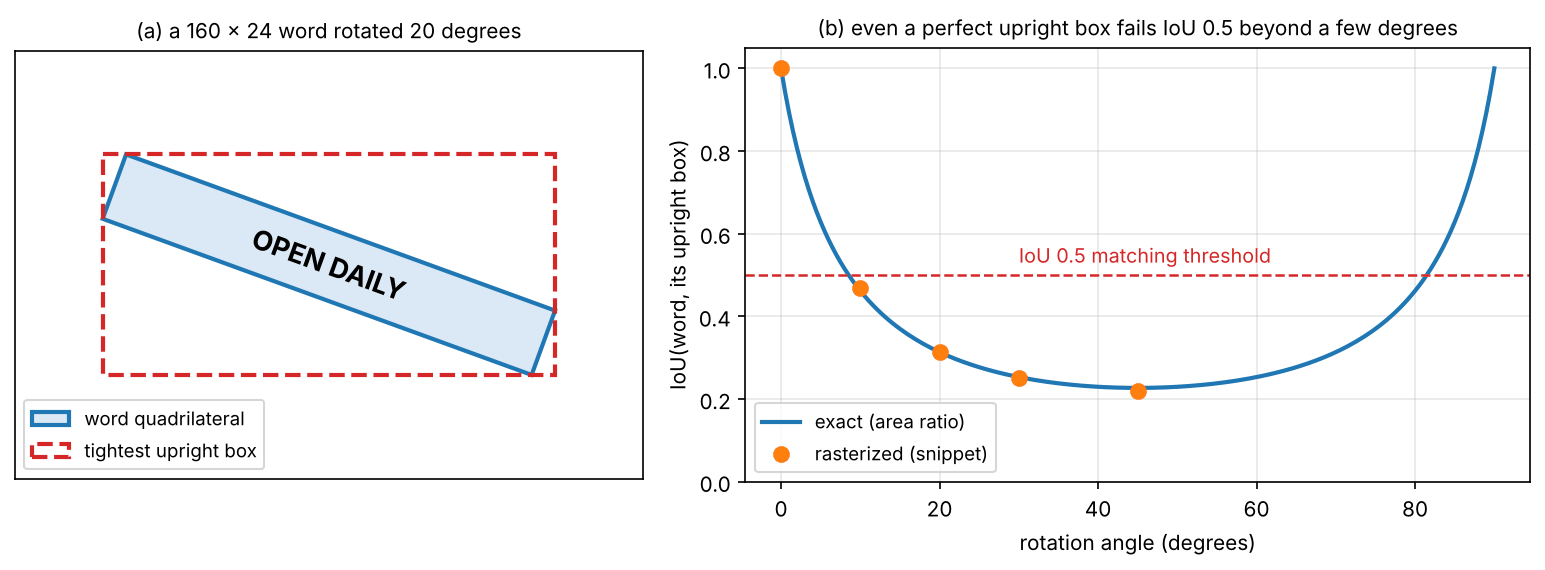
前兩個問題合在一起特別糟。下面的程式在一個細長單字旋轉時,計算它和最緊貼它的正立框之間的 IoU。
程式碼 · Python · 22 行
import numpy as np
from skimage.draw import polygon

def rotated_word(cx, cy, w, h, deg):
    """Corners of a w x h word box rotated by deg around its center (x, y)."""
    t = np.deg2rad(deg)
    R = np.array([[np.cos(t), -np.sin(t)], [np.sin(t), np.cos(t)]])
    corners = np.array([[-w, -h], [w, -h], [w, h], [-w, h]]) / 2
    return corners @ R.T + [cx, cy]

def mask(quad, shape=(300, 300)):
    m = np.zeros(shape, bool)
    rr, cc = polygon(quad[:, 1], quad[:, 0], shape)
    m[rr, cc] = True
    return m

for deg in [0, 10, 20, 30, 45]:
    quad = rotated_word(150, 150, 160, 24, deg)          # a long, thin word
    x0, y0 = quad.min(axis=0); x1, y1 = quad.max(axis=0)
    aabb = np.array([[x0, y0], [x1, y0], [x1, y1], [x0, y1]])  # tightest upright box
    a, b = mask(quad), mask(aabb)
    print(f"angle {deg:2d} deg: IoU(word, its upright box) = {(a & b).sum() / (a | b).sum():.2f}")
輸出
angle  0 deg: IoU(word, its upright box) = 1.00
angle 10 deg: IoU(word, its upright box) = 0.47
angle 20 deg: IoU(word, its upright box) = 0.31
angle 30 deg: IoU(word, its upright box) = 0.25
angle 45 deg: IoU(word, its upright box) = 0.22
對一個旋轉 的 矩形,精確值是 ,其中 與 是單字的寬與高,分母是它的正立外接框的面積。才轉 10 度,最好的正立框就通不過常用的 IoU 0.5 門檻了(圖 3)。因此文字偵測器輸出的是旋轉矩形、四邊形或多邊形;旋轉形狀的 IoU 怎麼算,和 DLCV 03B 為鳥瞰圖框解決的多邊形裁切是同一個問題。
以迴歸為基礎的偵測器:EAST
白話版。 各文字像素預測信心與單字幾何,再把一致的高信心預測合併成偵測結果。
EAST(Efficient and Accurate Scene Text detector)[12] 是一個全卷積網路,帶有 U 形的特徵合併分支,在降低取樣後的圖上每個位置輸出一個 之間的分數(這個像素是否在縮小後的單字內?)以及一個幾何。它提出兩種幾何。RBOX 有五個通道:像素到旋轉矩形四邊的距離,以及矩形的旋轉角。QUAD 有八個通道:像素到四邊形四個角的位移 ,。因為有幾萬個像素在投票,EAST 先逐列合併相鄰的幾何,以分數為權重做平均(局部感知 NMS,locality-aware NMS),然後才跑標準 NMS [12]。一次網路前向傳遞,就取代了早期系統中各個候選分組步驟。它的弱點是感受距離:像素必須預測可能遠在數百像素外的邊緣,而且四邊形無法順著彎曲的單字。
以分割為基礎的偵測器:PSENet 與 DBNet
白話版。 不要要求每個像素預測整個單字的形狀,只問「這個像素是文字嗎?」這樣得到的遮罩可以跟著任何曲線走。困難在於單字貼在一起時,要怎麼把遮罩切成單字,所以這些偵測器為每個單字預測一個更細的核心,讓核心彼此分開,事後再把它們長回去。
網路是類似 DLCV 04 的編碼器–解碼器,預測逐像素的文字機率圖 ;訣竅在標籤上。面積為 、周長為 的每個真值多邊形 ,都向內縮小一個位移
其中 是縮小比例;縮小後的多邊形(單字的核心,kernel)是正樣本區域。即使單字互相貼在一起,相鄰單字的核心之間仍有間隔,所以預測核心圖的連通元件就是單字實例;之後再把每個膨脹回原本大小。
PSENet(Progressive Scale Expansion Network)[13] 為每個單字預測多個不同縮小比例的核心,並用廣度優先搜尋,把最小、彼此分得開的核心長進較大的核心裡,這樣一個像素被某個單字佔走之後,鄰居就搶不走。代價是後處理緩慢又得依序進行。
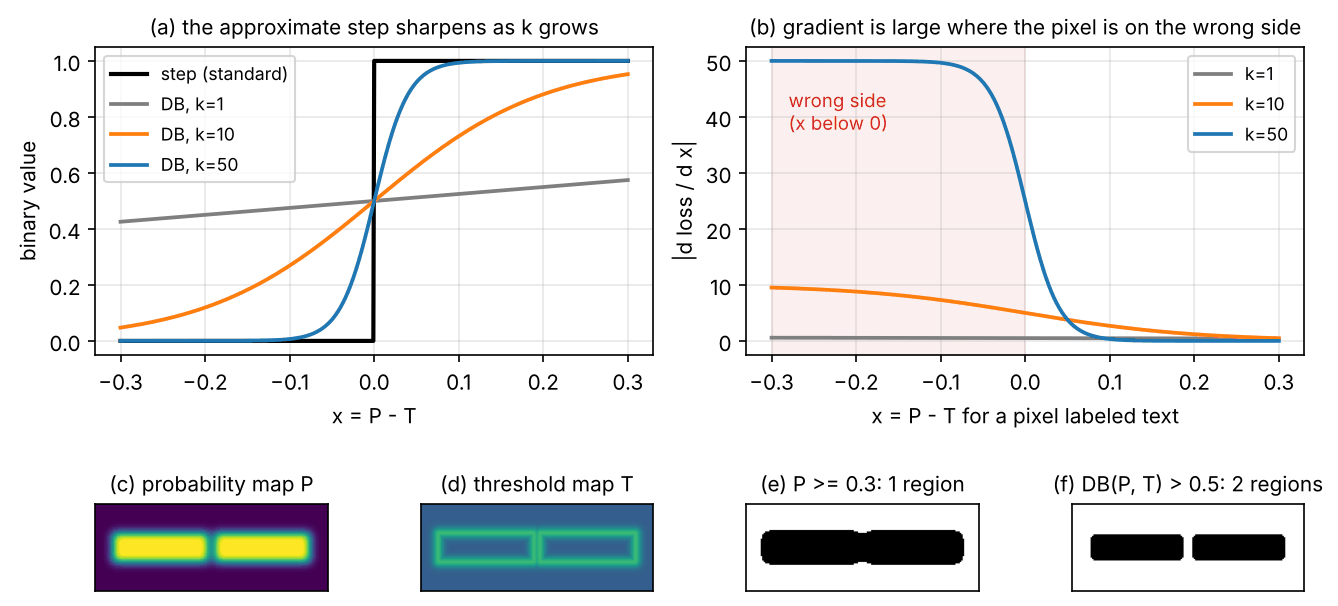
DBNet [14] 只保留一個核心,並讓二值化這一步本身可以訓練。標準的二值化 使用固定閾值 ,幾乎處處梯度為零,無法訓練。DBNet 另外預測第二張圖,即閾值圖 ,並使用近似的階梯函數
其中 是像素 處的近似二值, 是預測的文字機率, 是學到的閾值, 是放大係數,設為 50 [14]。令 、,文字像素的二元交叉熵 的導數是 ;背景像素的 ,導數是 。梯度被放大 倍,並且在像素落在閾值錯誤那一側時最大。閾值圖被監督成在每個單字邊界周圍的一圈帶狀區域內偏高,所以單字相接處的二值化很嚴格,單字內部則很寬鬆。
下面的程式用數值方法檢查導數,並在一維剖面上示範:兩個單字之間的閾值調高後可以把它們分開,而固定閾值會把它們合併。
程式碼 · Python · 22 行
import numpy as np

def db(P, T, k=50.0):
    """Differentiable binarization: an approximate step at the learned threshold T."""
    return 1.0 / (1.0 + np.exp(-k * (P - T)))

x = np.array([-0.10, -0.02, 0.0, 0.02, 0.10])            # x = P - T at five pixels
for k in [1.0, 50.0]:
    f = db(x, 0.0, k)
    g_pos = -k * (1 - f)       # d/dx of -log f       (pixel labeled text)
    g_neg = k * f              # d/dx of -log(1 - f)  (pixel labeled background)
    # check the text-pixel gradient by finite differences
    eps = 1e-6
    num = (-np.log(db(x + eps, 0, k)) + np.log(db(x - eps, 0, k))) / (2 * eps)
    assert np.allclose(num, g_pos, rtol=1e-4)
    print(f"k={k:4.0f}  B_hat={np.round(f, 3)}  dl+/dx={np.round(g_pos, 2)}  dl-/dx={np.round(g_neg, 2)}")

# Two words whose probability map P does not drop to 0 between them.
P = np.array([0.1, 0.9, 0.95, 0.9, 0.55, 0.5, 0.55, 0.9, 0.95, 0.9, 0.1])
T = np.array([0.3, 0.3, 0.3, 0.3, 0.7, 0.7, 0.7, 0.3, 0.3, 0.3, 0.3])   # high at the gap
print("fixed t=0.3:", (P >= 0.3).astype(int))
print("DB, k=50   :", (db(P, T) > 0.5).astype(int))
輸出
k=   1  B_hat=[0.475 0.495 0.5   0.505 0.525]  dl+/dx=[-0.52 -0.5  -0.5  -0.5  -0.48]  dl-/dx=[0.48 0.5  0.5  0.5  0.52]
k=  50  B_hat=[0.007 0.269 0.5   0.731 0.993]  dl+/dx=[-49.67 -36.55 -25.   -13.45  -0.33]  dl-/dx=[ 0.33 13.45 25.   36.55 49.67]
fixed t=0.3: [0 1 1 1 1 1 1 1 1 1 0]
DB, k=50 : [0 1 1 1 0 0 0 1 1 1 0]時,「二值」圖是在 0.5 附近的灰色模糊,每個像素得到的梯度都一樣小; 時它幾乎是二值的,比閾值低 0.1 的文字像素會得到約 的梯度,而判對的像素幾乎沒有梯度。圖 4 在二維中重現這個分離。
推論時 DBNet 丟掉閾值分支:它用固定的 0.2 對 二值化,取連通元件,並把每個區域膨脹 ,其中 與 是該區域的面積與周長, [14]。所以閾值圖主要是訓練時的工具,用來讓 本身變得銳利;簡單的後處理讓偵測器保持快速。
選讀:縮小與放大文字多邊形(見「補充資料」頁)。對矩形算出縮小位移、為什麼它不會把單字縮到消失,以及為什麼同一個放大比例無法精確還原每種長寬比。
選讀:DBNet 導讀(見「論文導讀」頁)。論文的消融實驗與基準表格怎麼組織,以及閱讀時要檢查什麼。
字元層級與彎曲文字偵測器
有些偵測器先找字母,再把鄰近的字母黏成單字。CRAFT [15] 預測區域分數(region score,字元的中心)與親和分數(affinity score,同一單字內兩個字元之間),並把字元連成任意形狀的單字;因為真實資料集只標註單字,它用一個中間模型來估計真實影像上的字元標籤。像 CTW1500 [11] 一併提出的多邊形偵測器,則是沿著彎曲的文字行迴歸許多邊界點。更豐富的形狀模型更能貼合不規則文字,但需要更複雜的輸出或後處理。
文字辨識
白話版。 辨識的輸入是一個裁下來的單字或文字行,輸出是它的字元。現代的做法把裁切圖當成序列來讀:從左到右滑過去,描述每一小條,再把這一串小條轉成一串字元,完全不必把單字切成一個個字母。
把辨識當成序列預測
早期系統把單字切成字元再逐一分類,字母黏在一起或斷開時就會失敗。CRNN(Convolutional Recurrent Neural Network)[16] 讓辨識不再需要切割,並且可以端到端訓練。裁切圖先縮放到固定高度;CNN 把它變成特徵圖,特徵圖的各個欄構成特徵序列,每一欄描述影像中的一條細長直條;深層雙向 LSTM(見 ML 04)加入左右兩側的上下文;轉錄層再把每一欄的預測變成標籤序列。使用矩形的池化視窗時,100 × 32 的輸入會產生 25 個畫格的序列,比大多數英文單字都長 [16]。沒有任何東西告訴網路哪個畫格屬於哪個字元;CTC 處理的就是這個缺少的對齊。
CTC:不需對齊的訓練
白話版。 每個畫格,網路可以說一個字元,或說「沒有新東西」(空白,blank)。讀輸出時,把重複的字元合併、再刪掉空白。訓練時,則把所有逐畫格、最後讀出來等於正確單字的「故事」的機率加起來。
連結時序分類(connectionist temporal classification,CTC)[17] 定義如下:對每個符號 (字母表中的字元或空白 )在畫格 的逐畫格機率 ,一個合併映射 (先合併重複,再移除空白),以及給定輸入 時標籤序列 的機率
其中 是一種對齊(每個畫格一個符號), 是畫格數,總和涵蓋所有合併後等於 的對齊。訓練時最小化 ,用前向遞迴計算,長度為 的標籤需要 。完整的推導與暴力檢查見 PR 06 的 CTC 補充資料;這裡只需要知道它對解碼意味著什麼。
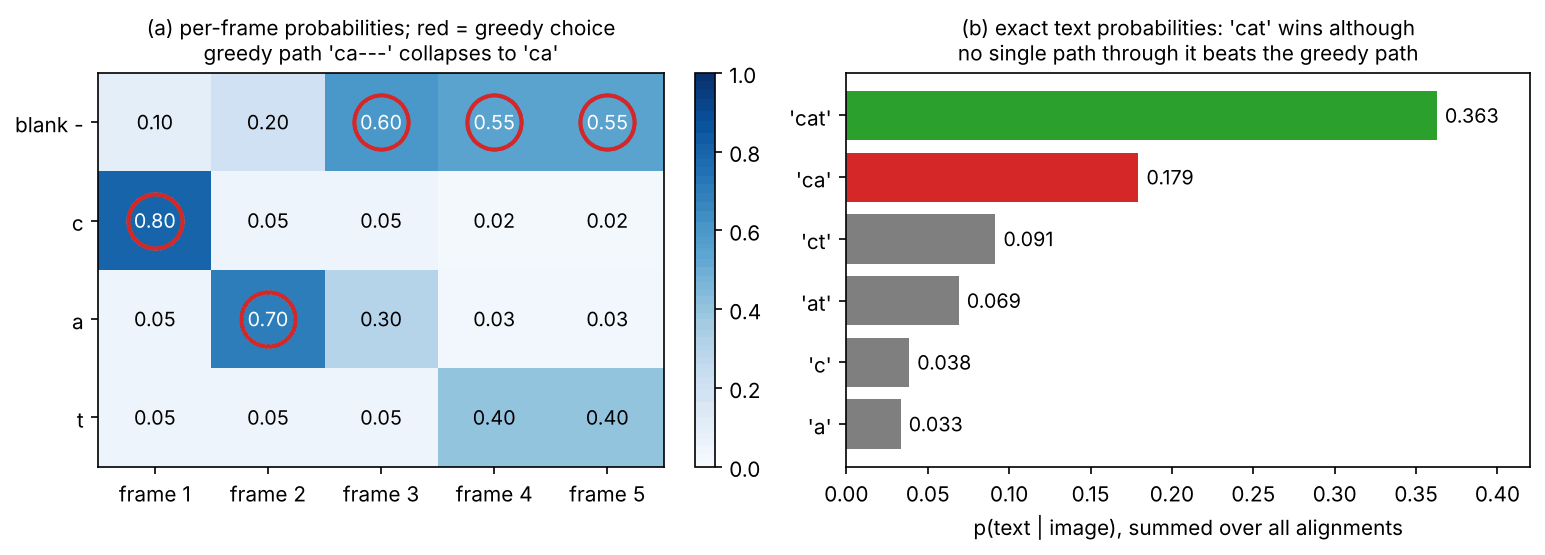
最便宜的解碼器是貪婪(greedy,最佳路徑)解碼:每個畫格取最可能的符號,再合併。CRNN 在不使用詞典的模式下正是用這個近似 [16]。但最可能的路徑不一定會合併成最可能的文字,因為一段文字的機率分散在許多條路徑上。下面的程式建了一個五畫格的玩具範例,讓這件事看得見。
程式碼 · Python · 28 行
import itertools
import numpy as np

alphabet = ["-", "c", "a", "t"]                 # index 0 is the CTC blank
# Per-frame probabilities from a recognizer (rows: 5 frames, columns: symbols).
probs = np.array([[0.10, 0.80, 0.05, 0.05],
                  [0.20, 0.05, 0.70, 0.05],
                  [0.60, 0.05, 0.30, 0.05],
                  [0.55, 0.02, 0.03, 0.40],
                  [0.55, 0.02, 0.03, 0.40]])

def collapse(path):
    """CTC map B: merge repeated symbols, then remove blanks."""
    merged = [s for i, s in enumerate(path) if i == 0 or s != path[i - 1]]
    return "".join(alphabet[s] for s in merged if s != 0)

greedy = probs.argmax(axis=1)                   # best symbol at every frame
print("greedy path:", "".join(alphabet[s] for s in greedy), "->", repr(collapse(greedy)))

# Exact: add up every alignment that collapses to the same text (4**5 = 1024 paths).
total = {}
for path in itertools.product(range(4), repeat=len(probs)):
    p = np.prod(probs[np.arange(len(probs)), path])
    total[collapse(path)] = total.get(collapse(path), 0.0) + p
for text, p in sorted(total.items(), key=lambda kv: -kv[1])[:3]:
    print(f"p({text!r}) = {p:.3f}")
print("collapse('caa-at') =", repr(collapse([1, 2, 2, 0, 2, 3])),
      " collapse('caaat') =", repr(collapse([1, 2, 2, 2, 3])))
輸出
greedy path: ca--- -> 'ca'
p('cat') = 0.363
p('ca') = 0.179
p('ct') = 0.091
collapse('caa-at') = 'caat'  collapse('caaat') = 'cat'
「t」在任何一個畫格都不是最可能的單一符號,所以貪婪解碼把它丟掉了;但在第 4 或第 5 畫格含有「t」的所有對齊加起來,機率是「ca」的兩倍(圖 5)。最後一行顯示空白的第二個用途:重複的字母只有在兩份之間隔著空白時才能保留。實際的解碼器使用前綴束搜尋(prefix beam search),它保留最好的幾個部分轉錄,並把合併後得到同一前綴的對齊併在一起。
選讀:CTC 前綴束搜尋,一步一步來(見「補充資料」頁)。每個前綴保留的兩個機率、三條更新規則,以及一個在這個玩具範例上找到 ‘cat’ 的、經過測試的實作。
CTC 有兩個內建的限制(見 PR 06 的補充資料):給定影像,各畫格的輸出彼此獨立,所以模型無法以已經輸出的字元為條件;而且對齊是單調的,所以閱讀順序必須與畫格順序一致。直排或彎曲的文字會打破第二點,除非先矯正。
注意力解碼器與矯正
白話版。 注意力解碼器一次寫一個字元。每寫一個字元之前,它會回頭看影像特徵並選擇要看哪裡;它也記得自己已經寫了什麼,所以行為像一個小小的拼字語言模型。
注意力解碼器(attention decoder)就是把 NLP 07 的編碼器–解碼器用在影像特徵上:第 步它對特徵序列做注意力,並根據結果與 預測字元 ,直到結束符號。它拋棄了 CTC 的獨立性假設,代價是必須依序解碼。ASTER [18] 把這樣的解碼器和矯正網路(rectification network)配成一對:薄板樣條(thin-plate spline,TPS)轉換由影像預測、只透過辨識損失來訓練,在讀之前先把彎曲或有透視變形的單字扭正成水平的直線。
Baek 等人 [7] 指出,當時大多數辨識器都符合同一個四階段樣板:轉換(無或 TPS)、特徵擷取、序列建模(無或 BiLSTM)與預測(CTC 或注意力);他們在相同資料上重新訓練所有組合,發現注意力主要增加的是速度成本,而且先前的比較因訓練集與測試子集不同而失真。
選讀:Baek 等人:What Is Wrong With Scene Text Recognition Model Comparisons?(ICCV 2019)(見「論文導讀」頁)。四階段框架、資料集稽核,以及怎麼讀取捨圖。
Transformer 辨識器
TrOCR [19] 用預訓練的 Transformer 取代 CNN 與 RNN。影像縮放到 384 × 384 並切成 16 × 16 的圖塊,和 Vision Transformer 一樣(ML 05);影像編碼器由 DeiT 或 BEiT 初始化來編碼這些圖塊,文字解碼器由 RoBERTa 或 MiniLM 初始化,以自迴歸方式產生詞片(wordpieces,子詞符號),並用束搜尋解碼 [19]。它先在合成文字影像上預訓練,再在印刷、手寫與場景文字上微調:辨識如今從通用的視覺與語言預訓練中借來骨幹與解碼器。
PARSeq [20] 用許多隨機的輸出位置順序訓練同一個 Transformer 解碼器(排列語言建模,permutation language modeling),所以同一組權重既能由左到右解碼、也能不用上下文平行解碼所有字元,還能利用兩側的上下文來修正第一次的猜測。
語言模型:幫助與傷害
一個「懂英文」的辨識器能修正模糊的字母:「PLEA_E」幾乎肯定是「PLEASE」。這種知識可以是隱含的(自迴歸解碼器以先前的字元為條件)、詞典(CRNN 可以把輸出限制在一份單字清單內 [16]),或明確的語言模型:在 ABINet [21] 中,一個獨立的雙向語言模型會迭代修正視覺模型的輸出。
同樣的先驗也會傷人。不是語言的文字,像序號、代碼、價格、人名與混合文字,正是 OCR 最重要的地方,也是語言模型把正確讀法「修正」成錯誤的地方。PARSeq 的作者指出,不看影像的外部語言模型有這種風險 [20];OCRBench 則報告,大型多模態模型在非語意文字(隨機字元字串)、手寫、多語言文字與數學式上很弱 [22]。當內容不是自然語言時,請在有語言先驗與沒有語言先驗兩種情況下各量一次。
選讀:語言模型在辨識器裡的位置(見「補充資料」頁)。詞典搜尋、隱含與明確的語言模型,以及怎麼測試先驗是否過度修正。
訓練資料:合成文字
有標註的真實裁切圖很稀少,而只用合成文字訓練的辨識器,在各個場景文字資料集上都能有不錯的泛化 [1]。MJSynth [23] 用各種字體、陰影、扭曲與雜訊算繪單字(890 萬張單字影像);SynthText [24] 依場景的幾何把文字貼進自然照片(550 萬個裁切單字)[7]。兩者一起訓練比單用任何一個都好,而且各取 20% 的組合樣本,就勝過任何一個完整資料集,所以多樣性可能比數量更重要 [7]。
端到端文字讀取(text spotting)
白話版。 不是先跑偵測器、再對每個裁切圖跑另一個辨識器,而是由一個網路兩件事都做,並共用特徵。讀得出來有助於找到(讀起來像單字的區域,多半是文字),找到也有助於讀出來。
文字讀取器(text spotter)直接輸出(形狀,轉錄)配對。FOTS [25] 在密集的逐像素偵測分支與用 CTC 解碼的辨識分支之間共用卷積特徵,靠的是 RoIRotate:這個運算子把每個偵測到的四邊形的特徵區域裁下來並旋轉成正立、固定高度的長條。Mask TextSpotter [26] 擴充 Mask R-CNN(見 DLCV 04 的實例分割),為整個單字與個別字元都加上遮罩,所以不需要序列模型就能讀彎曲文字。ABCNet [27] 用參數化的貝茲曲線(Bézier curve)擬合每個彎曲的文字實例,並用 BezierAlign(RoIAlign 的彎曲版)沿著曲線取樣特徵。端到端評估要問的是:每個真值單字是否既被定位、也被讀對,我們在評估 OCR中定義它。
文件理解
白話版。 在頁面上,讀出單字往往是最容易的部分。問題是哪些字屬於同一組、要依什麼順序讀、它們是什麼意思:哪個數字是總額、哪一行是標題、哪個儲存格在哪一欄。
版面分析與閱讀順序
版面分析(layout analysis)找出頁面的各個區域——段落、標題、清單、表格、圖片——通常是對頁面影像做物件偵測或實例分割。PubLayNet [28] 把超過一百萬篇 PubMed Central 文章的 XML 與 PDF 版本對起來,自動標註了超過 36 萬張頁面影像,共五個類別(文字、標題、清單、表格、圖片)。DocLayNet [29] 有 80,863 頁來源多樣的人工標註頁面,11 個類別,採 COCO 格式,因為只用科學文章訓練的模型,轉移到報告、手冊與表單時表現很差。
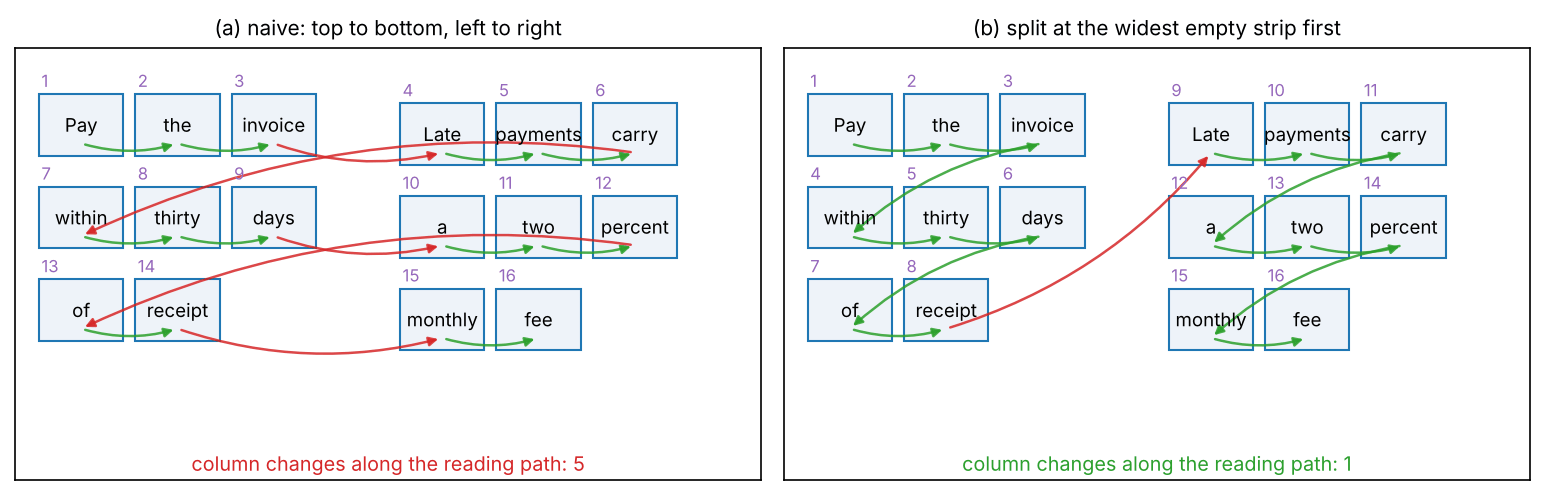
有了區域與單字之後,系統還必須產生閱讀順序(reading order)。最直覺的規則「先由上到下,再由左到右」,連最簡單的多欄頁面都會失敗,下面的程式在一份兩欄的公告上示範。
程式碼 · Python · 35 行
import numpy as np

# Word boxes (x0, y0, x1, y1) on a two-column page: each column is one sentence.
left = "Pay the invoice within thirty days of receipt".split()
right = "Late payments carry a two percent monthly fee".split()
words, boxes = [], []
for col, text in [(0, left), (1, right)]:
    for k, w in enumerate(text):
        row, pos = divmod(k, 3)                       # three words per line
        x0 = 40 + 300 * col + 80 * pos
        y0 = 100 + 30 * row + 3 * col                 # columns not perfectly aligned
        words.append(w); boxes.append([x0, y0, x0 + 70, y0 + 20])
boxes = np.array(boxes, float)

def naive_order(boxes, line_tol=10):
    """Top-to-bottom, then left-to-right, treating boxes within line_tol as one line."""
    line = np.round(boxes[:, 1] / line_tol)
    return np.lexsort((boxes[:, 0], line))

def column_order(boxes, line_tol=10):
    """Split the page at the widest empty vertical strip, then read column by column."""
    x_min, x_max = int(boxes[:, 0].min()), int(boxes[:, 2].max())
    covered = np.zeros(x_max - x_min, bool)
    for x0, _, x1, _ in boxes.astype(int):
        covered[x0 - x_min:x1 - x_min] = True
    edges = np.flatnonzero(np.diff(np.r_[1, covered.astype(int), 1]))  # empty-run bounds
    starts, ends = edges[::2], edges[1::2]
    widest = np.argmax(ends - starts)
    split = x_min + (starts[widest] + ends[widest]) / 2
    col = (boxes[:, 0] > split).astype(int)
    line = np.round(boxes[:, 1] / line_tol)
    return np.lexsort((boxes[:, 0], line, col))

print("naive :", " ".join(words[i] for i in naive_order(boxes)))
print("column:", " ".join(words[i] for i in column_order(boxes)))
輸出
naive : Pay the invoice Late payments carry within thirty days a two percent of receipt monthly fee
column: Pay the invoice within thirty days of receipt Late payments carry a two percent monthly fee
天真排序的輸出中,每個單字都是對的,文字卻毫無用處。欄規則修好了這個頁面,但它又是另一條人工規則,遇到表格或圖片就會失敗(圖 6);學習式的版面與文件模型,很大程度上就是為了取代這類規則而出現。
文字加版面:LayoutLM 家族
白話版。 不只把頁面上的單字交給語言模型,也告訴它每個單字在哪裡。這樣,收據右下角跟在「Total」後面的數字,就和段落中間的同一個單字意義不同。
LayoutLM [30] 從 BERT(NLP 10)出發,在每個單字的符號嵌入上加一個二維位置嵌入。每個單字都帶著它的 OCR 框 ——左上角與右下角——並重新縮放成 0 到 1,000 的整數「虛擬」座標,讓不同大小的頁面共用同一個尺度。四個嵌入查表結果相加,其中 與 共用一張表, 與 共用另一張:
其中 是第 個單字 的輸入向量, 與 是 BERT 的符號與一維位置嵌入,、 是水平與垂直座標學到的查表。預訓練時遮住一些單字但保留它們的二維位置,讓模型從文字與版面上下文預測它們(遮罩視覺語言模型,masked visual-language model),資料是約 1,100 萬頁用開源 Tesseract 引擎做 OCR 的掃描頁面 [30]、[31]。LayoutLM 在下游任務中還會加入每個單字影像區域的視覺特徵,由 Faster R-CNN 模型算出 [30]。LayoutLMv3 [32] 則把頁面影像切成圖塊直接輸入,同時遮住文字符號與影像圖塊,並加入單字–圖塊對齊的目標,使一個模型既能處理以文字為主的任務(表單、收據、問答),也能處理以影像為主的任務(文件分類、版面分析)。
關鍵資訊擷取(key information extraction)——從頁面中取出「發票號碼」、「日期」與「總額」——因此就是對 OCR 單字做符號分類,如 NLP 06 的序列標註,再加上把鍵連到值。FUNSD [33] 是這類的小型基準:199 張真實、有雜訊的掃描表單,語意實體標成問題、答案、標頭或其他,實體之間有連結。
這個家族的弱點在輸入:OCR 引擎漏掉或讀錯的字它無法修正,而且它繼承了引擎的閱讀順序。
免 OCR 模型:Donut 與 Pix2Struct
白話版。 跳過 OCR 引擎。訓練一個模型看頁面影像,然後一個符號一個符號地寫出想要的輸出——完整文字、JSON 紀錄或答案——就像影像標題生成模型寫標題那樣。
Donut(Document understanding transformer)[34] 由一個 Swin Transformer 編碼器(ML 05)與一個 BART 解碼器組成。它先預訓練去按閱讀順序讀出整頁的所有文字——這是一項「偽 OCR」任務,資料是 1,100 萬份英文掃描文件,加上它的 SynthDoG 產生器產生的中文、日文、韓文與英文合成頁面——再微調成輸出一串符號,這串符號可以一對一轉成 JSON,用於分類、資訊擷取或問答 [34]。這避開了執行 OCR 的成本、OCR 引擎在不同語言與文件類型上的僵化,以及 OCR 錯誤的傳遞。Pix2Struct [35] 的預訓練任務是把被遮住的網頁截圖解析成簡化的 HTML,在一個目標裡同時混合了 OCR、語言建模與影像標題生成;它接受可變解析度的輸入,並把問題直接算繪在影像上。
代價是解析度與可驗證性。Donut 使用 2560 × 1920 的輸入,並報告在小字很多的文件上,準確率隨輸入尺寸快速上升,運算成本也隨之增加 [34];而且因為模型是生成而不是抄寫,輸出的每個字元都無法對應到影像的某個區域。
選讀:Donut 導讀(見「論文導讀」頁)。兩個訓練階段、JSON 輸出格式、以 TED 為基礎的準確率,以及解析度分析。
文件用的視覺語言模型
通用的多模態大型語言模型(ML 10)現在能回答關於文件的問題,也能抄寫頁面;讀小字要靠切塊或動態解析度(示意圖沒畫出的事)。有三點要注意。第一,流暢的回答不等於抄寫:要拿它和偵測結果核對,或要求它給座標再驗證座標。第二,生成式讀取器有自己的失效模式:針對學術文件的 Nougat [36] 報告它有時會退化成一直重複同一句話(在 1.5% 的測試頁面上,領域外更常見),而且參考文獻清單與章節標題中的數字,有時會被跳過或被幻覺出來。第三,要量測具體的能力:OCRBench [22] 蒐集了 29 個資料集,分別測試文字辨識、場景文字與文件問答、關鍵資訊擷取,以及手寫數學式,而不是把 OCR 藏在一個總分裡。
手寫、多種文字與中日韓文字
白話版。 手寫因人而異,字母還會連在一起;許多文字系統的符號數量遠超過拉丁字母;有些,例如中文,還可以直排。這幾點都打破了英文場景文字模型默默做的某個假設。
手寫
離線手寫辨識是從掃描檔讀出手寫的文字行。手寫英文句子的 IAM 資料庫 [37],用 TrOCR 作者的話來說,是手寫文字辨識最常用的資料集;TrOCR 使用 6,161 行訓練、966 行驗證與 2,915 行測試的切分,並報告區分大小寫的 CER [19]。行層級、用 CTC 或注意力的辨識器可以原封不動地使用;困難在於不同書寫者之間的差異、連筆的字母,以及有標註的資料有限,這也是合成資料預訓練和大型預訓練解碼器有幫助的原因。對於中文手寫,CASIA 線上與離線資料庫 [38] 同時提供筆跡軌跡(線上)與掃描影像(離線)辨識所需的資料。
大字元集與直排文字
中文與日文使用的字母表有幾萬個符號,而拉丁文字只有幾十個 [1]。RCTW-17 列出了中文文字的不同之處:字元集大得多、詞與詞之間沒有空格,以及許多字元由好幾個不相連的部分組成 [39]。每一點都有後果。辨識器的輸出層隨字母表變大,而且大多數字元都很罕見:Chinese Text in the Wild 資料集在 32,285 張街景影像中標註了 1,018,402 個字元實例,涵蓋 3,850 種不同字元,其中大多數很少用 [40]。不相連的部分會破壞連通元件分組。沒有空格,系統就以行與字元而不是單字來運作(見 NLP 01)。
直排文字是另一個困難:中文除了橫排,也可以直排,像 CTW 這類街景資料集就含有直排文字 [40]。W3C 的 Requirements for Chinese Text Layout 描述了直排的編排方式:字元由上到下、行由右到左,而夾在其中的拉丁單字,不是直立擺放,就是順時針旋轉 90° [41]。假設畫格由左到右的辨識器,若拿到橫放的裁切圖,會把這一欄讀成亂碼;Baek 等人把直排文字列為他們測試的全部 24 個辨識器共同的失敗案例之一 [7]。解法是先決定每條偵測到的文字行的方向,再旋轉或重排之後才去讀。
選讀:閱讀直排與混合方向的文字(見「補充資料」頁)。對 OCR 重要的版面規則、如何逐行決定方向,以及裁切圖要長成什麼樣子,橫排辨識器才讀得了。
同時有多種文字
多語言系統還必須判斷自己看到的是哪一種文字系統。ICDAR 2019 多語言挑戰賽(MLT-2019)[42] 有 20,000 張真實影像,含 10 種語言的文字,並包含文字系統辨識任務;這些語言涵蓋七種文字系統 [2]。
評估 OCR
白話版。 像校對員那樣數錯誤:要插入、刪除或更改多少字元,才能把輸出變成正確答案。對偵測,則像物件偵測那樣數:找到的框有多少是對的,真實單字被找到多少。
由編輯距離算出 CER 與 WER
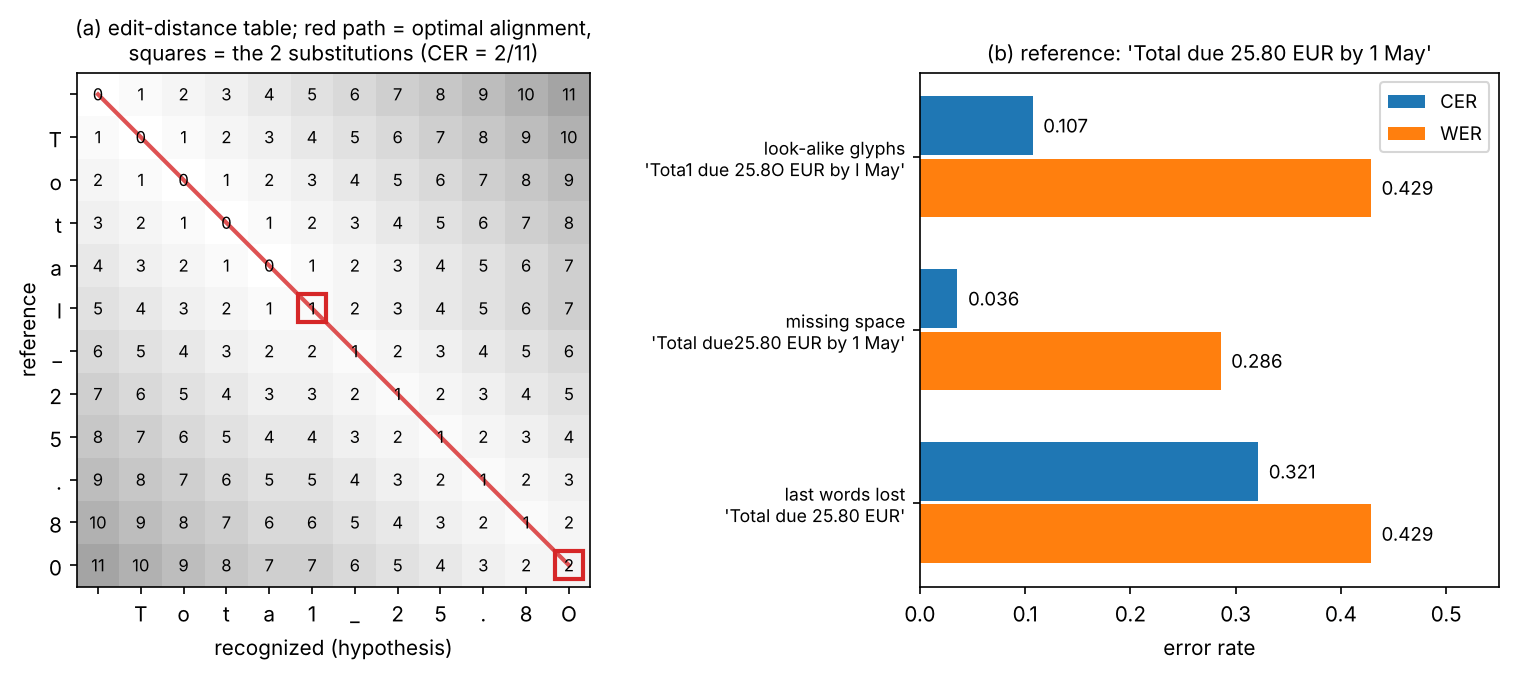
參考字串 與辨識字串 之間的編輯距離(edit distance,Levenshtein 距離)是把一個變成另一個所需的最少插入、刪除與替換次數;Wagner–Fischer 動態規劃可以算出它 [43](推導見 PR 06)。沿著最佳對齊回溯整張表,就能把總數拆成 次替換、 次刪除與 次插入。於是
其中 是參考字串的字元數,、、 與 是以單字(以空格切開的序列)計算的同樣數量。兩者都是錯誤率:0 表示完美,輸出含有大量插入時可以超過 1。還有其他慣例:對裁切單字的場景文字辨識,通常報告單字準確率(word accuracy,完全讀對的裁切圖比例),有些論文把 1 減去它稱為詞錯誤率,而多語言競賽報告的是 1 減去正規化編輯距離(normalized edit distance,NED)[2]。務必說明你報告的是哪一種。
程式碼 · Python · 34 行
import numpy as np

def edit_ops(ref, hyp):
    """Levenshtein alignment of two sequences; returns (S, D, I) counts."""
    n, m = len(ref), len(hyp)
    E = np.zeros((n + 1, m + 1), int)
    E[:, 0], E[0, :] = np.arange(n + 1), np.arange(m + 1)
    for i in range(1, n + 1):
        for j in range(1, m + 1):
            E[i, j] = min(E[i - 1, j] + 1, E[i, j - 1] + 1,
                          E[i - 1, j - 1] + (ref[i - 1] != hyp[j - 1]))
    S = D = I = 0
    i, j = n, m
    while i > 0 or j > 0:                       # walk back along one optimal path
        if i > 0 and j > 0 and E[i, j] == E[i - 1, j - 1] + (ref[i - 1] != hyp[j - 1]):
            S += ref[i - 1] != hyp[j - 1]; i, j = i - 1, j - 1
        elif i > 0 and E[i, j] == E[i - 1, j] + 1:
            D += 1; i -= 1
        else:
            I += 1; j -= 1
    return S, D, I

def rates(ref, hyp):
    c = edit_ops(ref, hyp)
    w = edit_ops(ref.split(), hyp.split())
    return c, sum(c) / len(ref), w, sum(w) / len(ref.split())

ref = "Total due 25.80 EUR by 1 May"
for hyp in ["Total due 25.80 EUR by 1 May",
            "Tota1 due 25.8O EUR by l May",      # three look-alike glyphs
            "Total due25.80 EUR by 1 May",       # one missing space
            "Total due 25.80 EUR"]:              # last words not read
    c, cer, w, wer = rates(ref, hyp)
    print(f"{hyp:30s} chars S,D,I={c} CER={cer:.3f} | words S,D,I={w} WER={wer:.3f}")
輸出
Total due 25.80 EUR by 1 May   chars S,D,I=(0, 0, 0) CER=0.000 | words S,D,I=(0, 0, 0) WER=0.000
Tota1 due 25.8O EUR by l May   chars S,D,I=(3, 0, 0) CER=0.107 | words S,D,I=(3, 0, 0) WER=0.429
Total due25.80 EUR by 1 May    chars S,D,I=(0, 1, 0) CER=0.036 | words S,D,I=(1, 1, 0) WER=0.286
Total due 25.80 EUR            chars S,D,I=(0, 9, 0) CER=0.321 | words S,D,I=(0, 3, 0) WER=0.429
三個長得像的替換,花掉 28 個字元中的 3 個(CER 0.107),卻毀了 7 個單字中的 3 個(WER 0.429),而且其中一個還把金額變成非數字。少一個空格只花一個字元,卻造成兩個單字錯誤;丟掉最後三個單字,則花了九個字元,含空格。CER 告訴你要修多少;WER,或者更好的是像「總額對不對?」這樣的任務檢查,才告訴你輸出能不能用(圖 7)。
偵測:IoU 0.5 下的精確率、召回率與 H-mean
文字偵測使用 DLCV 03 的精確率與召回率,只是有一條配對規則和一個彙總數字。在 Robust Reading 競賽使用的協定中(此處依 MLT-2019 的描述),偵測若與某個真值四邊形的 IoU 超過 0.5,就是真陽性;每個真值與每個偵測最多只能配對一次;而與標為「不在乎」(do not care,無法辨認或超出範圍的文字)的區域重疊超過該區域面積一半的偵測,在配對前會被移除 [42]。計數是在整個測試集上累加的,而且
其中 TP 是配對成功的組數, 是過濾後的偵測數, 是不屬於「不在乎」的真值單字數, 是 H-mean(精確率與召回率的調和平均,即 F-score)。和 COCO AP 不同,H-mean 是精確率–召回率曲線上的單一點,位於提交者自己選的信心閾值;Long 等人建議同時報告 AP [1]。ICDAR 2013 用的是不同的、以重疊為基礎的協定,所以它的數字不能和以 IoU 為基礎的數字比較 [1]。
端到端與文件指標
端到端文字讀取先如上所述把偵測配對到真值,再比較轉錄內容,可以對每個單字比(端到端辨識),也可以只對給定詞彙中的單字比(單字定位,word spotting);結果強烈依賴那份詞彙的大小 [2]。文件基準使用任務指標:ANLS(average normalized Levenshtein similarity,平均正規化 Levenshtein 相似度),這是用於 DocVQA 答案的、以編輯距離為基礎的分數,設計成不會把細小的 OCR 失誤當成完全失敗 [44];對擷取出的 JSON 紀錄,則用欄位層級的 F1 與以樹編輯距離為基礎的準確率 [34];版面區域則用 COCO 式的 mAP [29]。
選讀:評估協定的細節(見「補充資料」頁)。「不在乎」過濾、ICDAR 2013 協定中的一對多配對、詞彙、NED 與 AED、ANLS 與 TED 準確率,以及它們的邊界情況。
資料集與基準
下表列出本篇提到的基準資料集。大小依引用的論文所述。
| 基準 | 任務 | 內容 |
|---|---|---|
| ICDAR 2013 [5] | 偵測、辨識、端到端 | 對焦的場景文字,大多是水平的英文;462 張影像 [10] |
| ICDAR 2015 Incidental [6] | 偵測、辨識、端到端 | 穿戴式相機影像;偵測用 1,000 張訓練/500 張測試 [12];四邊形標註 |
| Total-Text [10] | 偵測、文字讀取 | 1,555 張影像(1,255/300)、9,330 個單字、多邊形;水平、多方向與彎曲 |
| CTW1500 [11] | 彎曲文字偵測 | 1,500 張影像(1,000/500)、超過 10,000 個多邊形文字標註 |
| IIIT5K [45] | 裁切單字辨識 | 取自網路影像搜尋的單字;2,000 訓練/3,000 測試 [7] |
| SVT [46] | 裁切單字辨識 | Google 街景;257 訓練/647 測試單字 [7] |
| MLT-2019 [42] | 多語言偵測、文字系統辨識、端到端 | 20,000 張影像、10 種語言 |
| RCTW-17 [39]、CTW [40] | 中文偵測與辨識 | 12,263 張影像;32,285 張有字元層級標註的影像 |
| IAM [37]、CASIA-HWDB [38] | 手寫 | 英文句子;中文線上與離線手寫 |
| FUNSD [33] | 表單理解 | 199 張掃描表單;問題/答案/標頭/其他實體與連結 |
| PubLayNet [28]、DocLayNet [29] | 版面分析 | 超過 36 萬頁自動標註的文章頁面(5 類);80,863 頁人工標註頁面(11 類) |
| DocVQA [44] | 文件問答 | 超過 12,000 張文件影像上的 50,000 個問題;ANLS |
| OCRBench [22]、OmniDocBench [47] | 多模態模型的 OCR 能力;頁面解析 | 29 個資料集;9 種文件來源、19 種版面類別 |
所有基準都有兩點要注意。不同論文曾在同一基準的不同子集上評估(Baek 等人發現 IC03 與 IC15 各有兩個版本在使用),所以比較數字之前要先檢查子集 [7]。而且標籤並不完美:Baek 等人估計,常用辨識基準的標註錯誤率,在忽略特殊字元時是 1.3%,把特殊字元算進去時升到 6.1%,連大小寫也算進去時是 24.1% [7]。
失效模式
白話版。 OCR 會在像素不再帶有答案時失敗,在形狀或文字系統和訓練時不同時失敗,也會在模型用看似合理的東西填補空缺時失敗。最後一種最危險,因為輸出看起來很完美。
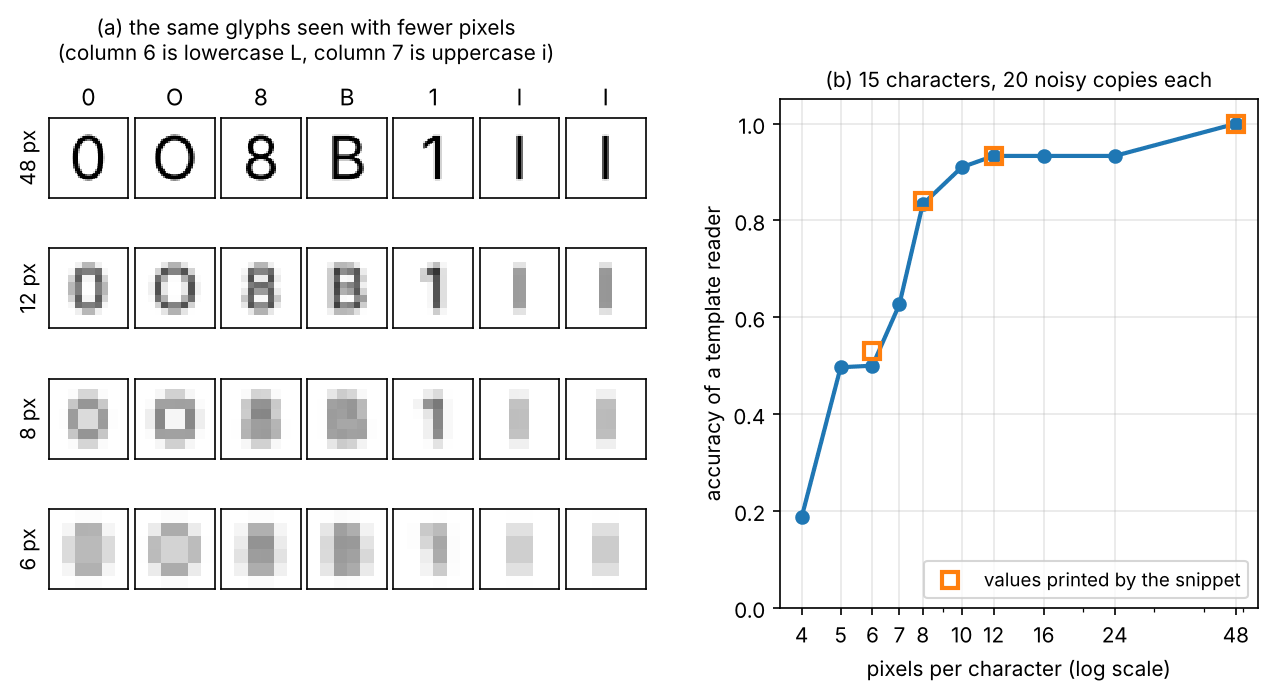
長得像的字形與低解析度。 許多字元只差幾個像素:0 與 O、1、l 與 I、5 與 S、8 與 B、「rn」與「m」。下面的程式為 15 個字元做了一個小小的範本讀取器,並顯示每個字元的像素數下降時,它如何退化。
程式碼 · Python · 37 行
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from skimage.transform import resize

CHARS = "0O8B5S1lIZ2aekx"

def glyph(c):
    """Render one character (ink = 1, paper = 0) on a 48 x 48 canvas."""
    fig = plt.figure(figsize=(0.48, 0.48), dpi=100)
    fig.text(0.5, 0.5, c, fontsize=26, ha="center", va="center")
    fig.canvas.draw()
    img = 1 - np.asarray(fig.canvas.buffer_rgba())[..., :3].mean(axis=2) / 255.0
    plt.close(fig)
    return img

def ncc(a, b):
    a, b = a - a.mean(), b - b.mean()
    return (a * b).sum() / np.sqrt((a * a).sum() * (b * b).sum())

templates = {c: glyph(c) for c in CHARS}
rng = np.random.default_rng(0)
for h in [48, 12, 8, 6]:                          # pixels per character cell
    errors, total = {}, 0
    for c, img in templates.items():
        for _ in range(20):
            low = resize(img, (h, h), anti_aliasing=True)       # camera sees few pixels
            low = low + rng.normal(0, 0.05, low.shape)          # sensor noise
            back = resize(low, (48, 48), order=1)               # what the reader gets
            guess = max(CHARS, key=lambda t: ncc(back, templates[t]))
            total += 1
            if guess != c:
                errors[(c, guess)] = errors.get((c, guess), 0) + 1
    top = sorted(errors.items(), key=lambda kv: -kv[1])[:3]
    print(f"{h:2d}px  accuracy={1 - sum(errors.values()) / total:.2f}  most confused: "
          + ", ".join(f"{a}->{b} ({n})" for (a, b), n in top))
輸出
48px  accuracy=1.00  most confused:
12px  accuracy=0.93  most confused: l->I (20)
 8px  accuracy=0.84  most confused: I->1 (13), l->1 (12), 0->O (6)
 6px  accuracy=0.53  most confused: B->8 (20), 0->8 (15), S->8 (12)
小寫「l」與大寫「I」在 12 像素時就已經混淆,因為這個無襯線字體把兩者都畫成一根單純的直條(圖 8);到 6 像素時,有一半的讀法是錯的。深度辨識器遠比範本比對好,但沒有任何辨識器能分開字體畫得一模一樣的字形;只有上下文能。超解析度可能有幫助(DLCV 09A),但請看下面的最後一項。
其他常見的失敗,各自標出它從哪個階段開始(圖 1):
- 彎曲、旋轉與有透視的文字(偵測與辨識):正立框會漏掉它們(圖 3);水平的辨識器除非先矯正,否則會讀錯。
- 特殊字體與風格(辨識):書法體的品牌名稱與店家招牌,是 Baek 等人研究中全部 24 個模型都失敗的案例之一,同樣的還有直排文字、特殊字元、嚴重遮擋與低解析度 [7]。
- 實例被合併或被拆開(偵測):圖 2 的間隙取捨的學習版;分割式偵測器用縮小的核心與學到的閾值來對付它。
- 版面錯誤(理解):字對但順序錯(圖 6)、表格被橫著讀、數值接到錯的鍵上。
- 分布偏移(所有階段):只用文章頁面訓練的版面模型,在較多樣的文件上會退化 [29];DLCV 14 討論一般性的偏移。
- 幻覺文字(任何生成階段):生成式讀取器可能輸出影像裡沒有的文字——重複的句子、捏造的章節編號 [36]、被「修正」過的序號。上游也會發生同樣的事:生成式復原或超解析度模型,可能把看不清的字母變成乾淨、清楚卻錯誤的字母,如 DLCV 09B 所討論的;生成影像中的文字也常常拼錯(DLCV 12)。凡是必須正確的資訊,例如金額、姓名或車牌,不要對經過生成式增強的影像跑 OCR,除非拿原圖核對。
現代觀點
綜述怎麼說
有四篇回顧涵蓋了本篇的範圍。Long 等人 [1] 依一個預測涵蓋單字的多少來整理場景文字偵測(整個單字,相對於字元、片段或核心),並把辨識分成以 CTC 為基礎與編碼器–解碼器兩類方法;他們認為跨資料集的泛化與大字母表是尚未解決的問題。Chen 等人 [2] 專注於辨識,依管線階段組織,並整理了資料集與評估協定。Cui 等人 [3] 回顧從規則式分析到預訓練 LayoutLM 式模型的文件任務;Zhang 等人 [4] 把文件解析分成模組化管線與統一的 VLM 式模型,並指出複雜版面、VLM 解析的可靠度與推論成本是主要挑戰。OCRBench [22] 補充了這些回顧,評估大型多模態模型在文字相關任務上的表現。
選讀:現代觀點綜述導讀(見「論文導讀」頁)。每篇回顧涵蓋什麼、怎麼整理這個領域、結論是什麼。
2023–2026 年的最新進展
- 管線仍是自然的選擇,當座標、速度或可稽核性重要時:DBNet 式的偵測器、注意力或 Transformer 辨識器,加上一個版面模型,各自獨立評估與修正。
- 端到端的頁面讀取器正在快速成熟。 一次就把頁面變成 Markdown 或結構化文字的模型,現在已涵蓋公式、表格與圖表:針對學術論文的 Nougat [36];GOT 把純文字、公式、表格、圖表與樂譜都當成「字元」,用一個編碼器–解碼器模型處理 [48];olmOCR 是一個微調過的視覺語言模型,用來大規模線性化 PDF,並附帶自己的困難頁面基準 [49];以及 DeepSeek-OCR,它研究一頁最少可以壓縮成多少個視覺符號、同時仍然可讀 [50]。這些報告全都來自作者自己。
- 評估正在迎頭趕上。 OmniDocBench [47](CVPR 2025)在來自九種文件來源的頁面上評估管線與端到端模型,有 19 個版面類別與 15 個屬性標籤,所以結果可以按文件類型與難度拆開看,而不是只有一個分數。
尚待解決的問題
- 忠實度。 生成式讀取器可能產生頁面上沒有的文字,而且它們的錯誤看起來像正確的文字。字元層級的接地(每個輸出符號由哪些像素支持)與校準過的信心,還不是標準配備。
- 非語意與罕見文字。 代碼、數字、人名、大字母表中的罕見字元與混合文字,正是語言先驗幫助最小、錯誤代價最大的地方 [22]。
- 複雜頁面上的版面與閱讀順序——有浮動圖片的多欄文章、巢狀表格、含手寫欄位的表單——對管線與端到端模型來說都依然困難;對複雜版面的穩健性是 Zhang 等人 [4] 點名的主要挑戰之一。
- 跨領域與跨文字系統的泛化,包含直排與彎曲文字,並且不必為每個領域蒐集新的標籤 [1]。
- 可比較的評估。 不同的子集、指標(CER、單字準確率、NED、ANLS)與輸出正規化,讓已發表的數字很難比較 [7]。
重點整理
- 分別評估閱讀流程各階段與完整管線,上游錯誤會向後傳遞。
- 旋轉、彎曲與密集文字,需要一般直立方框未必能表達的幾何。
- 縮小文字區域有助分開相接實例,門檻化與區域擴張則影響最終偵測。
- 辨識是序列預測;解碼與語言先驗有助自然詞彙,也可能扭曲代碼或數字。
- 版面與 OCR-free 模型改變錯誤傳遞路徑,解析度限制與虛構文字仍須檢查。
- 註明 CER/WER 版本、偵測匹配規則、忽略區域與下游任務指標。
練習
- 間隙與字體大小。 在偵測程式中,把
WORDS裡每個字體大小先乘以 0.6、再乘以 1.6,重新跑膨脹間隙的掃描。最佳間隙怎麼移動?這對於一張同時含有兩種大小的影像、只用一條固定的後處理規則意味著什麼?
提示
最佳間隙會隨字母間距、也就是隨字體大小縮放,所以同時含有兩種大小的影像,沒有單一的好間隙。學習式偵測器直接預測單字區域或縮小的核心,就避開了這個問題。
- 手算正立框。 證明旋轉 的 矩形與其最緊貼的正立框之間的 IoU 是 。對 、,求出它降到 0.5 的角度,並與正方形單字()比較。
提示
旋轉後的矩形完全在它的正立框內,所以交集是 ,聯集就是框的面積。對 數值求解,得到約 8.5°。對正方形,45° 時的最小值恰好是 ,所以正方形永遠不會低於 0.5:這個問題是細長形狀(如文字行)特有的。
- 貪婪與精確的 CTC。 把 CTC 矩陣最後兩列改成:兩個畫格中空白與「t」的機率都是 0.65 與 0.30。「cat」還是最可能的文字嗎?接著讓第 4、5 畫格中「t」的機率 從 0.05 變到 0.45,空白佔 。在哪些值上,貪婪與精確解碼的結果一致?
提示
重用暴力迴圈。在 時,「cat」(約 0.294)仍勝過「ca」(約 0.249)。貪婪解碼在 超過空白(大於 0.475)之前都回傳「ca」,但精確答案在 時就已經換成「cat」;兩個值之間兩者不一致。低於交叉點時,兩者都得到「ca」。
- 藏著災難的 CER。 構造一個 40 個字元的參考字串,以及兩個 CER 同為 0.05 的辨識結果,其中一個對發票處理系統無害,另一個卻是致命的。提出一個能區分兩者的欄位層級指標。
提示
一種是在很長的品項描述單字裡錯兩個字(「Paper A4 recyled」),另一種是在總額裡錯兩個字(「42.00」讀成「4Z.0O」)。對關鍵欄位(發票號碼、日期、總額)做欄位層級的完全比對,或是 Donut 報告的、對擷取欄位計算的 F1,都能區分這兩者;CER 與 WER 對每個字元或單字一視同仁。
- 閱讀順序又壞了。 在閱讀順序程式的兩欄公告上方,加一個橫跨兩欄的標題「PAYMENT TERMS」。
column_order會產生什麼?修改它,讓橫跨整個寬度的行先被讀,並描述一種仍然能打敗你的規則的版面。
提示
標題跨過了分割線,並依其左邊緣被分到左欄;放在最上面剛好沒問題,但放在中間的整行寬就不行了。把與分割線重疊的框當成獨立的一條帶,一條帶一條帶地讀。表格,或在某一欄內的圖片,仍然會打破以空白直條為基礎的規則。
參考文獻
- S. Long, X. He and C. Yao, “Scene text detection and recognition: The deep learning era,” International Journal of Computer Vision, vol. 129, pp. 161–184, 2021. doi
- X. Chen, L. Jin, Y. Zhu, C. Luo and T. Wang, “Text recognition in the wild: A survey,” ACM Computing Surveys, vol. 54, no. 2, 2021. doi
- L. Cui, Y. Xu, T. Lv and F. Wei, “Document AI: Benchmarks, models and applications,” arXiv:2111.08609, 2021. arXiv
- Q. Zhang, B. Wang, V. S.-J. Huang, J. Zhang, Z. Wang, H. Liang, C. He and W. Zhang, “Document parsing unveiled: Techniques, challenges, and prospects for structured information extraction,” arXiv:2410.21169, 2024. arXiv
- D. Karatzas, F. Shafait, S. Uchida, M. Iwamura, L. Gomez i Bigorda, S. Robles Mestre, J. Mas et al., “ICDAR 2013 Robust Reading Competition,” in Proc. International Conference on Document Analysis and Recognition (ICDAR), pp. 1484–1493, 2013. doi
- D. Karatzas, L. Gomez-Bigorda, A. Nicolaou, S. Ghosh, A. Bagdanov, M. Iwamura, J. Matas et al., “ICDAR 2015 competition on Robust Reading,” in Proc. International Conference on Document Analysis and Recognition (ICDAR), pp. 1156–1160, 2015. doi
- J. Baek, G. Kim, J. Lee, S. Park, D. Han, S. Yun, S. J. Oh and H. Lee, “What is wrong with scene text recognition model comparisons? Dataset and model analysis,” in Proc. IEEE/CVF ICCV, pp. 4714–4722, 2019. doi
- N. Otsu, “A threshold selection method from gray-level histograms,” IEEE Transactions on Systems, Man, and Cybernetics, vol. 9, no. 1, pp. 62–66, 1979. doi
- J. Sauvola and M. Pietikäinen, “Adaptive document image binarization,” Pattern Recognition, vol. 33, no. 2, pp. 225–236, 2000. doi
- C. K. Ch’ng and C. S. Chan, “Total-Text: A comprehensive dataset for scene text detection and recognition,” in Proc. ICDAR, pp. 935–942, 2017. doi
- Y. Liu, L. Jin, S. Zhang, C. Luo and S. Zhang, “Curved scene text detection via transverse and longitudinal sequence connection,” Pattern Recognition, vol. 90, pp. 337–345, 2019. doi
- X. Zhou, C. Yao, H. Wen, Y. Wang, S. Zhou, W. He and J. Liang, “EAST: An efficient and accurate scene text detector,” in Proc. IEEE CVPR, pp. 2642–2651, 2017. doi
- W. Wang, E. Xie, X. Li, W. Hou, T. Lu, G. Yu and S. Shao, “Shape robust text detection with progressive scale expansion network,” in Proc. IEEE/CVF CVPR, pp. 9328–9337, 2019. doi
- M. Liao, Z. Wan, C. Yao, K. Chen and X. Bai, “Real-time scene text detection with differentiable binarization,” in Proc. AAAI Conference on Artificial Intelligence, vol. 34, pp. 11474–11481, 2020. doi
- Y. Baek, B. Lee, D. Han, S. Yun and H. Lee, “Character region awareness for text detection,” in Proc. IEEE/CVF CVPR, pp. 9357–9366, 2019. doi
- B. Shi, X. Bai and C. Yao, “An end-to-end trainable neural network for image-based sequence recognition and its application to scene text recognition,” IEEE TPAMI, vol. 39, no. 11, pp. 2298–2304, 2017. doi
- A. Graves, S. Fernández, F. Gomez and J. Schmidhuber, “Connectionist temporal classification: Labelling unsegmented sequence data with recurrent neural networks,” in Proc. ICML, pp. 369–376, 2006. doi
- B. Shi, M. Yang, X. Wang, P. Lyu, C. Yao and X. Bai, “ASTER: An attentional scene text recognizer with flexible rectification,” IEEE TPAMI, vol. 41, no. 9, pp. 2035–2048, 2019. doi
- M. Li, T. Lv, J. Chen, L. Cui, Y. Lu, D. Florencio, C. Zhang, Z. Li and F. Wei, “TrOCR: Transformer-based optical character recognition with pre-trained models,” in Proc. AAAI Conference on Artificial Intelligence, vol. 37, pp. 13094–13102, 2023. doi
- D. Bautista and R. Atienza, “Scene text recognition with permuted autoregressive sequence models,” in Proc. ECCV, pp. 178–196, 2022. doi
- S. Fang, H. Xie, Y. Wang, Z. Mao and Y. Zhang, “Read like humans: Autonomous, bidirectional and iterative language modeling for scene text recognition,” in Proc. IEEE/CVF CVPR, pp. 7094–7103, 2021. doi
- Y. Liu, Z. Li, M. Huang, B. Yang, W. Yu, C. Li, X.-C. Yin, C.-L. Liu, L. Jin and X. Bai, “OCRBench: On the hidden mystery of OCR in large multimodal models,” Science China Information Sciences, vol. 67, 2024. doi
- M. Jaderberg, K. Simonyan, A. Vedaldi and A. Zisserman, “Synthetic data and artificial neural networks for natural scene text recognition,” arXiv:1406.2227, 2014. arXiv
- A. Gupta, A. Vedaldi and A. Zisserman, “Synthetic data for text localisation in natural images,” in Proc. IEEE CVPR, pp. 2315–2324, 2016. doi
- X. Liu, D. Liang, S. Yan, D. Chen, Y. Qiao and J. Yan, “FOTS: Fast oriented text spotting with a unified network,” in Proc. IEEE/CVF CVPR, pp. 5676–5685, 2018. doi
- P. Lyu, M. Liao, C. Yao, W. Wu and X. Bai, “Mask TextSpotter: An end-to-end trainable neural network for spotting text with arbitrary shapes,” in Proc. ECCV, pp. 71–88, 2018. doi
- Y. Liu, H. Chen, C. Shen, T. He, L. Jin and L. Wang, “ABCNet: Real-time scene text spotting with adaptive Bezier-curve network,” in Proc. IEEE/CVF CVPR, pp. 9806–9815, 2020. doi
- X. Zhong, J. Tang and A. Jimeno Yepes, “PubLayNet: Largest dataset ever for document layout analysis,” in Proc. ICDAR, pp. 1015–1022, 2019. doi
- B. Pfitzmann, C. Auer, M. Dolfi, A. S. Nassar and P. Staar, “DocLayNet: A large human-annotated dataset for document-layout segmentation,” in Proc. ACM SIGKDD, pp. 3743–3751, 2022. doi
- Y. Xu, M. Li, L. Cui, S. Huang, F. Wei and M. Zhou, “LayoutLM: Pre-training of text and layout for document image understanding,” in Proc. ACM SIGKDD, pp. 1192–1200, 2020. doi
- R. Smith, “An overview of the Tesseract OCR engine,” in Proc. ICDAR, vol. 2, pp. 629–633, 2007. doi
- Y. Huang, T. Lv, L. Cui, Y. Lu and F. Wei, “LayoutLMv3: Pre-training for document AI with unified text and image masking,” in Proc. ACM International Conference on Multimedia, pp. 4083–4091, 2022. doi
- G. Jaume, H. K. Ekenel and J.-P. Thiran, “FUNSD: A dataset for form understanding in noisy scanned documents,” in Proc. ICDAR Workshops (OST), 2019. doi
- G. Kim, T. Hong, M. Yim, J. Nam, J. Park, J. Yim, W. Hwang, S. Yun, D. Han and S. Park, “OCR-free document understanding transformer,” in Proc. ECCV, pp. 498–517, 2022. doi
- K. Lee, M. Joshi, I. R. Turc, H. Hu, F. Liu, J. M. Eisenschlos, U. Khandelwal, P. Shaw, M.-W. Chang and K. Toutanova, “Pix2Struct: Screenshot parsing as pretraining for visual language understanding,” in Proc. ICML, PMLR vol. 202, pp. 18893–18912, 2023. PMLR
- L. Blecher, G. Cucurull, T. Scialom and R. Stojnic, “Nougat: Neural optical understanding for academic documents,” in Proc. ICLR, 2024. OpenReview · arXiv
- U.-V. Marti and H. Bunke, “The IAM-database: An English sentence database for offline handwriting recognition,” International Journal on Document Analysis and Recognition, vol. 5, pp. 39–46, 2002. doi
- C.-L. Liu, F. Yin, D.-H. Wang and Q.-F. Wang, “CASIA online and offline Chinese handwriting databases,” in Proc. ICDAR, pp. 37–41, 2011. doi
- B. Shi, C. Yao, M. Liao, M. Yang, P. Xu, L. Cui, S. Belongie, S. Lu and X. Bai, “ICDAR2017 competition on reading Chinese text in the wild (RCTW-17),” in Proc. ICDAR, pp. 1429–1434, 2017. doi · arXiv
- T.-L. Yuan, Z. Zhu, K. Xu, C.-J. Li, T.-J. Mu and S.-M. Hu, “A large Chinese text dataset in the wild,” Journal of Computer Science and Technology, vol. 34, pp. 509–521, 2019. doi · arXiv
- F. Xue and R. Ishida (eds.), “Requirements for Chinese Text Layout,” W3C Group Note (draft of 7 October 2026). W3C
- N. Nayef, Y. Patel, M. Busta, P. N. Chowdhury, D. Karatzas, W. Khlif, J. Matas et al., “ICDAR2019 Robust Reading Challenge on multi-lingual scene text detection and recognition — RRC-MLT-2019,” in Proc. ICDAR, pp. 1582–1587, 2019. doi · arXiv
- R. A. Wagner and M. J. Fischer, “The string-to-string correction problem,” Journal of the ACM, vol. 21, no. 1, pp. 168–173, 1974. doi
- M. Mathew, D. Karatzas and C. V. Jawahar, “DocVQA: A dataset for VQA on document images,” in Proc. IEEE/CVF WACV, pp. 2199–2208, 2021. doi
- A. Mishra, K. Alahari and C. V. Jawahar, “Scene text recognition using higher order language priors,” in Proc. BMVC, 2012. doi
- K. Wang, B. Babenko and S. Belongie, “End-to-end scene text recognition,” in Proc. IEEE ICCV, pp. 1457–1464, 2011. doi
- L. Ouyang, Y. Qu, H. Zhou, J. Zhu, R. Zhang, Q. Lin, B. Wang, Z. Zhao et al., “OmniDocBench: Benchmarking diverse PDF document parsing with comprehensive annotations,” in Proc. IEEE/CVF CVPR, pp. 24838–24848, 2025. CVF
- H. Wei, C. Liu, J. Chen, J. Wang, L. Kong, Y. Xu, Z. Ge, L. Zhao et al., “General OCR theory: Towards OCR-2.0 via a unified end-to-end model,” arXiv:2409.01704, 2024. arXiv
- J. Poznanski, A. Rangapur, J. Borchardt, J. Dunkelberger, R. Huff, D. Lin, C. Wilhelm et al., “olmOCR: Unlocking trillions of tokens in PDFs with vision language models,” arXiv:2502.18443, 2025. arXiv
- H. Wei, Y. Sun and Y. Li, “DeepSeek-OCR: Contexts optical compression,” arXiv:2510.18234, 2025. arXiv
- C. Wolf and J.-M. Jolion, “Object count/area graphs for the evaluation of object detection and segmentation algorithms,” International Journal of Document Analysis and Recognition, vol. 8, pp. 280–296, 2006. doi
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 07・物件追蹤:從單一物件到多物件 · 29 分鐘