NLP 06・以 RNN 做序列標註(詞性標註、資訊擷取)
先備知識:NLP 05・用於語言的循環神經網路
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 把詞性標註與實體辨識表示成序列標註,並說明為何獨立的詞元判定可能與合法的整句分析不一致。
- 推導隱藏馬可夫序列分數與最大路徑(Viterbi)解碼,並把它們連到條件隨機場。
- 以可重現的位移定義實體結構描述,用 BIO 標籤編碼提及,並以精確區段而非詞元準確率評估。
- 建立 BiLSTM 標註器,加入字元層級特徵與 CRF 輸出層,並以遮罩前向演算法的對數概似訓練 CRF。
- 把實體標註放進資訊擷取(實體、關係、事件)的全貌,並認識標準資料集。
- 執行完整的 PyTorch 實驗,在訓練中從未出現的名稱上量測區段 F1、錯誤類型與非法標籤轉移。
先看全貌
許多語言任務要求每個詞元一個標籤。詞性(part-of-speech,POS)標註器把每個詞標成名詞、動詞、形容詞等;實體辨識器標出哪些詞元屬於人名、組織名或地名,以及每個名稱從哪裡開始、到哪裡結束。兩者看起來像沿著句子重複進行分類,但判定彼此並不獨立:某個詞的正確標籤,既取決於鄰近的詞,也取決於鄰近的標籤。把整個標籤序列視為一個結構化輸出,是本章的核心想法。
McRoy 第 3、4 章介紹語法類別與語法處理,第 8 章連結語言處理與資訊擷取 [1]。Hagiwara 第 5 章發展序列標記,包括詞性標記與命名實體辨識 [2]。本章結合這些觀點:標註器為各位置附上類別;擷取器則把選定區段轉成應用程式能檢查的紀錄。輸出契約十分重要:客服系統可能需要產品名稱與抱怨事件,歷史檔案則需要人物、組織、日期與帶有消息來源的陳述。
實際風險是轉換時遺失重要差別。「供應商說裝置通過了測試」不能證明裝置確實通過。系統即使抓對所有名字,仍可能因為刪除消息歸屬或可能性而建立錯誤紀錄。因此,要同時評估表面擷取與解讀;格式正確的輸出不是內容正確的證據。結構化預測的數學(HMM、前向—後向演算法、Viterbi 解碼與一般形式的 CRF)在 PR 06 發展;循環編碼器來自 NLP 05。剖析、語意角色,以及深入的關係與事件擷取,則在 NLP 12 介紹。
詞、詞法與語法類別
白話版。 詞的類別描述它在句子中的行為。拼字能提供線索,但脈絡通常決定實際用法。
詞法(morphology)研究詞內結構。複數詞尾、時態標記與派生前綴能提供有用證據,但不同語言不一定用相同片段或詞邊界表達性質。為了建模效率學出的子詞 token,也不一定對應語言學上的詞素。應區分模型斷詞與標註使用的語法單位。
詞性(part of speech)描述名詞、動詞等語法類別。名詞通常是名詞片語的中心,動詞通常是子句述語的中心。這是分布上的描述,不是每個名詞都必須指實體物品的規則。「Decision」與「arrival」雖指抽象內容與事件,仍是名詞。
相同表面詞可以有不同類別。在原創例句「the pilots can land」與「the metal can fell」中,「can」扮演不同角色。第二句也顯示,句子其餘部分改變時,熟悉的局部片語可能誤導。標記器必須考慮允許的脈絡與標註規則。
已標記句子可表示為:
其中 是輸入詞序列, 是位置 的詞, 是序列長度, 是標記序列, 是詞 的標記, 是有限標記集合。 與 指語言學上的詞位置,不會自動等同模型子詞位置。
標註也需要縮寫、標點、多詞表達與多種合理分析的規則。當模型使用子詞時,應定義如何把輸出對應回詞。只用第一個子詞表示是一種做法;池化所有子詞則是另一種。不論選哪個,標準標籤與解碼輸出都必須使用相同單位。
局部分類與序列預測
白話版。 分別替每個詞選最佳標記,可能錯過更好的共同解讀。序列模型把標記間的關係寫清楚。
局部分類器可以預測:
其中 是位置 選出的標記, 遍歷標記集合 , 是參數為 的模型, 是整個可見輸入序列。局部輸出頭仍可以讀取上下文;「獨立」描述輸出決策規則,不一定描述編碼器。
結構化解碼器則選擇:
其中 是選出的完整標記序列, 是輸入 允許的分析集合, 是由參數 對輸入與分析配對給出的分數。允許集合可以限制標註規則,分數則可以獎勵合理的相鄰標籤。
許多 NLP 任務都有這個差別。實體標籤必須組成有效跨度;依存樹中每個非根詞需要一個父節點;生成的結構化紀錄需要符合結構規格。較強的編碼器不會自動保證有效輸出,解碼器或獨立驗證器必須落實應用需要的限制。
結構化解碼也有取捨:錯誤的硬限制可能排除合法構造。如果文法要求每句都有明示主語,就會拒絕許多命令與片段。應記錄限制與預期輸入範圍,而不是把受限制的輸出當成該限制普遍適用所有語言的證據。
用隱藏馬可夫模型標記
白話版。 想像標記形成一串隱藏序列,每個標記再產生一個詞。相鄰標記與詞的相容性共同決定分數。
Rabiner 綜述的一階隱藏馬可夫模型(hidden Markov model,HMM)[3] 使用:
其中 是詞與標記的聯合機率, 是起始標記為 的機率, 是從標記 轉移到 的機率, 是標記 發射詞 的機率, 與 是位置 的詞與標記, 是序列長度。本例以固定長度為條件;若要建模終止,可加入明確的結束狀態因子。
起始機率總和為一;每列轉移機率總和為一;每個發射分布在觀察詞彙表上的總和也為一。這些正規化條件讓式子成為機率模型,而不是任意有用分數的乘積。
假設相當有限:下一個標記只依前一個標記,發射詞只依目前標記。真實句子有長距離依存、詞彙偏好與篇章脈絡。本章使用這個模型的價值,在於假設與精確解碼器都看得見;它是一個用來區分模型容量與搜尋的小型實驗室。
如果有完整標記的訓練樣本,可以計算起始狀態、轉移與發射次數,再依明確平滑規則正規化。如果只有詞,估計隱藏狀態就是另一個問題;沒有監督學出的狀態,不會自動成為有名稱的語法類別。下例手動指定機率,避免訓練不確定性遮蔽解碼機制。
最大路徑解碼
白話版。 保留以每種標記結束的最佳部分路徑。延伸這些路徑,就能找到最佳完整序列,不必列出所有可能。
使用對數機率,把乘積轉成總和:
其中 是涵蓋位置 到 、且以標記 結束的最佳路徑對數分數, 是起始機率, 是發射機率, 是轉移機率, 是標記集合。 與 分別指前一個與目前標記。零機率貢獻 。
這是最大路徑動態規劃,通常稱為 Viterbi 解碼 [3]。每格記錄達到最大值的前一個標記。選出最佳最後標記後,反向追蹤回溯指標。如果只保留分數,就會失去實際序列。
解碼器考慮 個位置與所有相鄰標記配對,因此 個標記時,時間複雜度為 。保留所有回溯指標的分數表占 空間;列舉所有標記序列則需考慮 種可能。這是在特定分解下的計算節省,不是近似搜尋結果。
下列獨立範例以完整列舉確認動態規劃答案。教學觀察「fish fish」刻意使用歧義詞。獨立的發射偏好會在兩個位置選名詞,聯合模型則可能偏好名詞後接動詞。
程式碼 · Python · 39 行
import itertools
import numpy as np

tags = ["N", "V"]
vocabulary = ["fish", "swim"]
initial = np.array([0.8, 0.2])
transition = np.array([[0.1, 0.9], [0.8, 0.2]])
emission = np.array([[0.7, 0.3], [0.3, 0.7]])
words = ["fish", "fish"]
observation = [vocabulary.index(word) for word in words]
assert np.allclose(transition.sum(axis=1), 1)
assert np.allclose(emission.sum(axis=1), 1)

scores = np.empty((len(words), len(tags)))
back = np.zeros_like(scores, dtype=int)
scores[0] = np.log(initial) + np.log(emission[:, observation[0]])
for t in range(1, len(words)):
    candidates = scores[t - 1, :, None] + np.log(transition)
    back[t] = candidates.argmax(axis=0)
    scores[t] = candidates.max(axis=0) + np.log(emission[:, observation[t]])
path = [int(scores[-1].argmax())]
for t in range(len(words) - 1, 0, -1):
    path.append(int(back[t, path[-1]]))
path.reverse()

def joint_score(sequence):
    value = np.log(initial[sequence[0]])
    value += np.log(emission[sequence[0], observation[0]])
    for t in range(1, len(words)):
        value += np.log(transition[sequence[t - 1], sequence[t]])
        value += np.log(emission[sequence[t], observation[t]])
    return value

all_paths = list(itertools.product(range(len(tags)), repeat=len(words)))
brute = max(all_paths, key=joint_score)
assert tuple(path) == brute
print("local emission choices:", [tags[emission[:, w].argmax()] for w in observation])
print("best joint path:", [tags[index] for index in path])
print("joint log score:", round(joint_score(path), 3))
改變轉移機率,即使每個詞的局部偏好不變,也能改變選出的序列。這並不證明新選擇符合真實語言;它證明模型與解碼器實作了預期的依存關係。
把路徑分數解讀為證據,而不只取最大值
前例選出名詞—動詞,是因為轉移偏好超過第二個詞的發射偏好。其聯合機率是四個因子的乘積:以名詞開始、名詞發射 fish、名詞轉移到動詞、動詞發射 fish。與名詞—名詞比較時,前兩個共同因子可以消去,剩下轉移乘上發射的比較。因此,不必把解碼器當成黑箱,就能理解決策。
以下獨立計算列舉相同的四條路徑,再正規化為觀察詞給定後的後驗分布:
程式碼 · Python · 15 行
import itertools
import numpy as np

initial = np.array([0.8, 0.2])
transition = np.array([[0.1, 0.9], [0.8, 0.2]])
fish = np.array([0.7, 0.3])
paths = list(itertools.product(range(2), repeat=2))
mass = np.array([initial[a] * fish[a] * transition[a, b] * fish[b]
                 for a, b in paths])
posterior = mass / mass.sum()
print('NN / NV / VN / VV joint:', mass.round(4))
print('Posterior:', posterior.round(3))
print('Probability of observed words:', round(mass.sum(), 4))
assert paths[posterior.argmax()] == (0, 1)
assert np.isclose(posterior.sum(), 1)
聯合機率為 0.0392、0.1512、0.0336、0.0036,後驗四捨五入為 0.172、0.664、0.148、0.016;觀察機率為 0.2276。它們回答不同問題:聯合機率包含這些詞本身多可能出現,後驗則在詞已固定後比較標記解讀。在這個人工模型中,最佳路徑之外仍有其他機率質量。
較長序列若把前驅貢獻改為相加,而不是取最大值,就能計算觀察機率;結合前向與後向貢獻,則得到標記邊際機率 [3]。逐位置選最高機率標記,會最小化該後驗下的逐位置期望錯誤;選最高機率完整路徑,則針對整段序列正確性。兩種決策可能不同。若允許的序列具有額外限制,獨立選出的邊際標記也可能違反輸出限制。
為什麼最大路徑解碼能丟掉其他以同一標記結束的前綴?在一階分解下,後續延伸只依賴最後標記與未來觀察,不依賴更早的前綴細節。加入相同後綴後,較低分前綴不會超越較高分前綴。若新增分數會獎勵與數個位置之前標記的關係,原狀態便不再滿足這個論證;必須擴大狀態或更換解碼器。精確性來自分數分解,不是演算法名稱。
條件式結構分數連結神經特徵與解碼
HMM 必須建模詞如何產生;條件模型則可直接依觀察句子評分標記序列。線性鏈條件隨機場(conditional random field,CRF)提供這種介面 [5]:
其中 是觀察句子, 是標記序列, 是序列長度, 索引位置, 是參數 計算的位置—標記分數, 包含相鄰標記分數。正規化常數 對每個允許序列 的 加總。位置分數與 HMM 發射不同,不必在所有詞上加總為一。上下文編碼器可以用整句計算各分數,同時讓輸出依存保持鏈狀。
訓練標註序列時,最小化其負對數機率:相對於所有允許競爭序列,提高正確序列分數。計算正規化常數使用加總遞迴,尋找最佳序列使用最大值遞迴。這說明神經編碼器與結構化解碼器如何配合。豐富的輸入證據不要求放棄可計算的輸出分解;反之,鏈狀轉移表無法表達全部語法依存。整句輸入特徵與輸出限制,處理的是不同部分。
PR 06 發展這兩種模型背後的一般理論:前向與前向—後向演算法、以 Baum–Welch 從未標註序列訓練 HMM,以及以「觀察特徵次數減去期望特徵次數」表示的 CRF 梯度。下文的神經標註器各節完全重用這個 CRF,只是位置分數 改由循環編碼器計算。
實體辨識從結構描述開始
直觀說法。 實體辨識器找出提及並指定類型,不會自動找出背後唯一的現實物件。
實體提及可表示為:
其中 是提及紀錄; 是文件識別碼; 是包含在內的起始字元位移; 是不包含在內的結束位移; 是類別。表面文字就是原文件從 到 的切片。本例使用 Python 字串位移,其他介面可能使用位元組或別的索引慣例。必須聲明慣例,因為 Unicode 字元與編碼後的位元組不具有相同邊界。
標註指南必須決定稱謂是否包含在人名區段中、組織名稱後綴是否保留,以及歧義用法如何處理。「臺北」可能指地點,也可能在上下文中代指政府。只標位置的結構與依上下文標組織的結構,可以合理地給出不同標註。只有凍結類型與指南,評估才有意義。
命名實體辨識(named entity recognition,NER)經常區分人物、組織與地點;CoNLL-2003 共享任務論文介紹了一種既有基準設定 [6]。提到它是為了說明評估傳統,並不表示其類別適用所有應用。別的領域可能更需要產品代碼、法律條文或設備零件。
實體連結(entity linking)是另外的決策:把提及對應到知識庫紀錄,或判定沒有適當紀錄。相同拼法可能指不同組織,不同拼法也可能指同一個組織。辨識器把 Orion 標成組織,還沒有解決身分問題。連結需要候選集合、上下文與明確的未知實體政策。
儲存正規化名稱時,也應保留原文與位移。小寫化、去除重音與合併空白可能改變字串及邊界。可靠設計可直接從原文擷取,把正規化結果存為額外欄位。若必須前處理,保留對齊映射,才能把預測區段轉回原文而不靠猜測。
序列標籤與區段預測
直觀說法。 實體提及可表示成詞元標籤,也可直接表示成文字區段。表示方式決定模型能描述哪些重疊。
BIO 方案使用 B 表示提及起點、I 表示延續、O 表示外部。例如 Mina works at Orion Labs 中,Mina 帶人物標籤,Orion 與 Labs 帶組織標籤。Hagiwara 的序列標註章節與 NER 綜述提供詞元層級擷取的背景 [2]、[7]。這個方案源自 Ramshaw 與 Marcus 的內外語塊標籤 [10]。
獨立詞元分類器可寫成:
其中 是輸入詞元序列; 是標籤序列; 是詞元數; 是位置索引; 是學得的參數。每次預測可以使用完整允許範圍的上下文表示,但在這個分解下,輸出標籤彼此獨立。輸入上下文與輸出相依性是不同概念。
獨立判定可能產生非法轉移,例如 O 後面接 I-PER。可以用確定性規則修正,但修正規則也會成為評估契約的一部分。另一種方式是以整個序列評分,讓結構化解碼器只搜尋合法路徑。若分數能局部分解,最大路徑解碼一節的動態規劃概念就能套用。更強的編碼器不會免除合法輸出定義。
單一平面詞元標籤序列無法表示任意巢狀提及。在某種結構描述下,Orion Labs Research Division 可能同時包含組織與巢狀部門提及。區段模型則直接評分候選邊界與類型:
其中 是學得的分數;、 是候選邊界; 是候選類別; 是輸入。這個分數未必是校準後的機率。選擇政策決定保留哪些候選、是否允許重疊,以及衝突如何解決。
候選數會隨句長增加,實務上可能限制最長區段或刪除部分候選。每種限制都會改變可找回的提及。若長名稱很重要,就要單獨量測其召回率。否則,一個快速系統可能平均表現不錯,卻完全無法表示少數使用者不可或缺的輸出。
邊界建模改變可能出現的錯誤
詞元標記模型與區段模型可以使用相同上下文編碼器,卻搜尋不同輸出空間。平面 BIO 標籤替每個詞元選一個歸屬;明確區段則選邊界配對與類型,選取規則允許時,巢狀區間可同時存在。差別在表示能力:解碼器無法表達巢狀輸出時,編碼器也無法把它恢復出來 [7]。
對 個詞元,非空連續區間數為 。其中 是句長;這是把每個起點可能的終點數加總。最大長度限制為 時,數量變成 ,其中 是允許區段長度。類型評分器可能需要為每個區間、每個類別計算分數。限制長度節省工作,卻在分類開始之前,就把較長提及移出候選空間。
邊界品質與語意分類需要分別診斷。涵蓋 Orion 的區段可能是強烈的組織候選,但標準提及是 Orion Labs。提高類別信心,不會補上缺少的邊界。模型也可能同時提出兩個區段,再由去重與重疊規則決定最後輸出。選取屬於模型行為,不能當成評估完成後的排版步驟。
關係又增加一個搜尋問題。保留越多提及,實體配對候選越多。依類型或距離限制配對,能降低計算,但文件層級關係可能跨越數句。聯合擷取器可用關係證據影響提及決策;流程式模型則先選定提及。分別以預測提及與標準提及評估流程,兩者差距能揭露在關係評分開始之前,就損失多少關係涵蓋能力。
精確區段評估
直觀說法。 常見背景詞標得正確,可能掩蓋漏掉的實體。應評估完整提及,包括邊界與類型。
對預測紀錄集合 與正確標註集合 :
其中 、 都包含文件識別碼、起始位移、結束位移與類別元組; 是集合大小; 是完全匹配的紀錄。精確率衡量預測中匹配的比例;召回率衡量標註中找回的比例; 結合兩者。本例程式在所示分母為零時回報零;若採其他慣例,應明確記錄。
完全匹配很嚴格。正確標註是 Orion Labs,卻只預測 Orion,就同時產生假陽性與假陰性。下游程式依賴完整名稱時,這種標準合理。其他應用可以把部分重疊當成次要診斷,但必須另外說明匹配規則,不能把寬鬆的重疊分數當成既有的完全匹配指標 [6]。
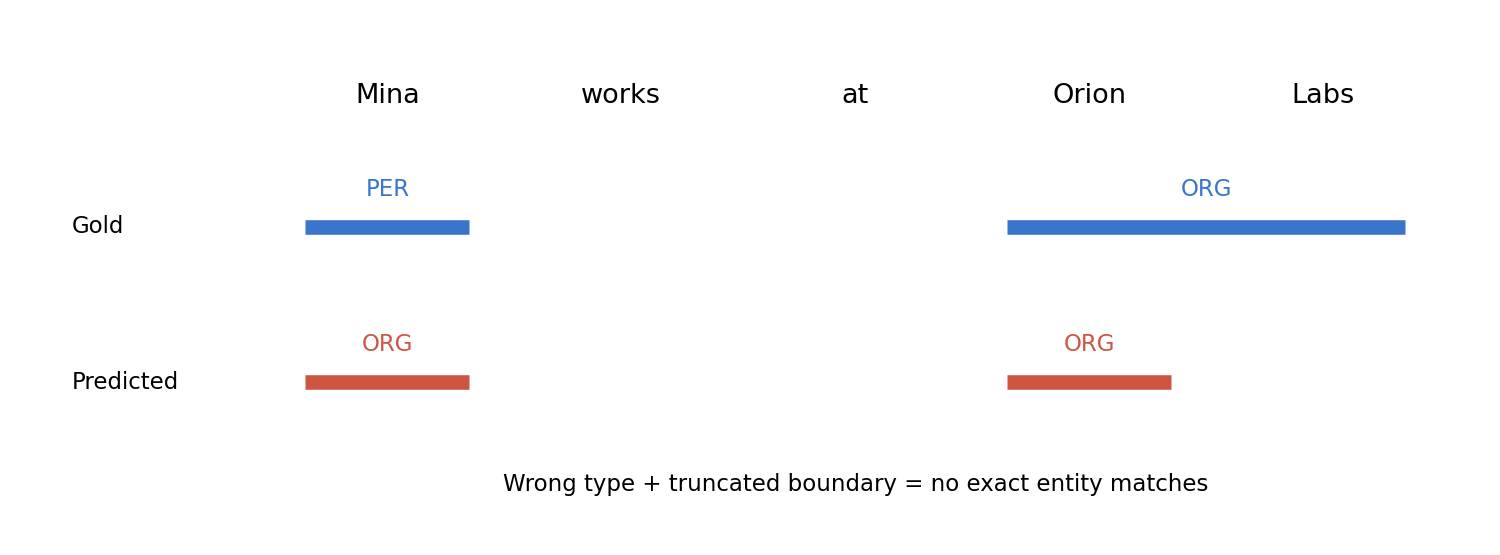
單一總分仍會隱藏原因。可區分漏掉提及、多餘提及、邊界不符、類別不符與連結不符,並按類別和文件來源報告表現。類別稀少時保留例數,讓讀者判斷不確定性。大型加權平均可能掩蓋幾乎沒有成功預測的類別。
完整的 CPU 擷取實驗
直觀說法。 小型確定性擷取器能讓契約容易檢查。它是盲點可見的教學基準,不是通用語言理解系統。
以下獨立範例辨識自訂名稱表、擷取嚴格受限的主動修理句型,並評估精確實體紀錄。它不下載任何資料。名稱表在評估前固定,正確標註也明確寫出。本例允許使用詞彙表;若真實評估禁止外部名稱集合,同樣程式就會違反契約。
程式碼 · Python · 46 行
import re

documents = {
    "a": "Mina repaired Sensor A in Taipei.",
    "b": "Orion Labs said Sensor B might fail.",
    "c": "Leo did not repair Sensor B.",
    "d": "The sensor was repaired by Mina.",
}
inventory = {
    "Mina": "PER", "Leo": "PER", "Orion Labs": "ORG",
    "Sensor A": "DEVICE", "Sensor B": "DEVICE", "Taipei": "LOC",
}
gold = {
    ("a", 0, 4, "PER"), ("a", 14, 22, "DEVICE"), ("a", 26, 32, "LOC"),
    ("b", 0, 10, "ORG"), ("b", 16, 24, "DEVICE"),
    ("c", 0, 3, "PER"), ("c", 19, 27, "DEVICE"), ("d", 27, 31, "PER"),
}
predicted = set()
for doc_id, text in documents.items():
    for name, category in inventory.items():
        pattern = r"(?<!\w)" + re.escape(name) + r"(?!\w)"
        for match in re.finditer(pattern, text):
            predicted.add((doc_id, match.start(), match.end(), category))
tp = len(predicted & gold)
precision = tp / len(predicted) if predicted else 0.0
recall = tp / len(gold) if gold else 0.0
f1 = 2 * tp / (len(predicted) + len(gold)) if predicted or gold else 0.0
assert predicted == gold
print("entity precision/recall/F1:", precision, recall, f1)

repair = re.compile(r"^(Mina|Leo) repaired (Sensor [AB])(?=[ .])")
events = []
for doc_id, text in documents.items():
    match = repair.search(text)
    if match:
        events.append({
            "document": doc_id, "predicate": "repair",
            "actor": match.group(1), "object": match.group(2),
            "polarity": "positive", "modality": "asserted",
            "evidence": [match.start(), match.end()],
        })
assert len(events) == 1 and events[0]["document"] == "a"
for event in events:
    start, end = event["evidence"]
    print(event, "source:", documents[event["document"]][start:end])
print("unsupported repair constructions:", ["c", "d"])
在這些人工設計文件中,精確實體分數是 1.0,因為所有名稱拼法都在表中。這不能證明泛化能力。事件規則只回傳文件 a;它排除了 c 的明確否定,卻也漏掉 d 的合法被動句。兩者都是沒有事件輸出,但原因不同。正式介面應區分被拒絕的否定主張與不支援的句型。
文件 b 有已辨識實體,卻沒有被直接斷言的修理事件;它還包含帶消息來源、可能發生的故障。這說明為何實體與事件需要分開評估。系統可能抓對所有名字,卻遺漏任務最重要的事件。擴充事件語法前,要先加入額外的正例與反例測試。
證據區間只包含匹配子句,不包含後面的地點。對沒有地點欄位的狹義修理紀錄,這樣足夠。若之後加入地點,就要一併擴充證據契約與測試。結構變更應視為任務變更,不能只是新增一個欄位,再隨意從附近不相關詞語填值。
實體區段之外的資訊擷取
白話版。 實體辨識找出名稱;資訊擷取(information extraction,IE)接著把它們連起來:哪個人為哪個組織工作、哪台裝置在何時何地故障。每一步都加入一種新紀錄,也多一種出錯的方式。
一張有用的地圖分成三層,每層建立在前一層之上。
| 層次 | 輸出紀錄 | 本章領域的例子 | 常見方法類型 |
|---|---|---|---|
| 實體 | 有類型的區段 | Orion Labs 是位於字元 0–10 的 ORG | 序列標註(本章)或區段評分 |
| 關係 | 有類型、有方向的提及配對,附證據 | employer(Mina, Orion Labs) | 分類候選提及配對 |
| 事件 | 觸發詞加上帶角色標籤的論元、肯否定與模態 | repair,修理者 Mina、物件 Sensor A、地點 Taipei | 先偵測觸發詞,再標註論元 |
序列標註直接貢獻於三個層次。實體提及是 BIO 區段;事件觸發詞可以用與實體相同的方式標註;甚至部分關係與論元判定,也能相對於給定觸發詞標註每個論元的詞元,寫成標註問題。上面的規則式擷取器已經顯示層次之間的依賴:它唯一的事件紀錄之所以正確,是因為兩個實體區段都被找到,而且句型受到支援。
標準資源反映了這些層次。ACE 2005 多語訓練語料替英文、中文與阿拉伯文標註實體、關係與事件,其中事件標註只限英文與中文 [19]。TACRED 是以群眾外包建立的句子層級關係擷取資料集,針對 TAC 知識庫填充(Knowledge Base Population)評測的關係類型 [20]。DocRED 把關係擷取擴展到由 Wikipedia 與 Wikidata 建立的完整文件,其中許多關係必須讀過多個句子才能推得 [21]。本章前面提出的紀錄設計問題(證據區段、消息歸屬、否定、未知值)適用於每一層。關係與事件擷取、語意角色及其評估,在 NLP 12 發展。
神經標註器:讀取整句的 BiLSTM
白話版。 以一個雙向讀取整句、在每個位置替每個標籤產生分數的神經網路,取代手寫的發射機率。最簡單的版本在每個位置獨立選出最高分標籤。
Collobert 等人證明,單一神經架構幾乎不需特徵工程,就能從資料學會標註詞性、語塊、命名實體與語意角色 [12]。使用循環編碼器時,標準設計是雙向 LSTM(BiLSTM)標註器 [13]、[14]、[15]:
其中 是詞元 的輸入向量(詞嵌入,可再串接下文的字元特徵); 讀過 , 讀過 ; 表示串接; 與 把兩個狀態對應到 個標籤分數; 收集這些分數,標籤 的分數為 。這些分數扮演前面 CRF 公式中 的角色:它們可以依賴整個句子。與 NLP 05 由左到右的語言模型不同,這裡適合使用雙向結構,因為選擇任何標籤之前整個句子都已給定 [23]。
softmax 標註器在給定這些分數後,把各標籤視為條件獨立:
其中 遍歷小批次中的句子, 是填補遮罩(真實詞元為一), 計算真實詞元數, 是正確標籤, 遍歷標籤。這正是序列標籤一節中的獨立詞元分類器,只是改由 BiLSTM 計算上下文。它速度快,也常常很強;它的弱點也與那裡指出的相同:沒有任何機制阻止它輸出 O I-ORG 或 B-PER I-ORG,因為每個位置的判定都忽略了鄰近位置的判定。
三項實務細節與架構同樣重要。
- 遮罩。 批次中的句子會填補到相同長度。遮罩把填補排除在損失之外;打包(
pack_padded_sequence)或遮罩則讓填補不進入反向 LSTM,否則它會從填補符號開始讀。 - 未知詞。 詞嵌入表只涵蓋訓練詞。其餘詞對應到未知編號,而且要訓練這個編號:隨機把一部分訓練詞換成它(詞 dropout),可以教標註器在詞本身陌生時依賴上下文。
- 子詞編碼器。 若編碼器使用子詞,要定義詞標籤如何對應到片段(只標第一個片段並忽略其餘,或另一條明確規則),並在評估前把預測對應回詞,如第一節所述。
BiLSTM-CRF:替整個標籤序列評分
白話版。 保留 BiLSTM 的逐詞元分數,再替每一對相鄰標籤加上學習得到的分數,選出總分最高的標籤序列。訓練時提高正確序列相對於所有其他序列的分數,而前向演算法能有效率地完成這個加總。
Huang、Xu 與 Yu 提出在 BiLSTM 上加一層線性鏈 CRF,用於詞性標註、語塊切分與 NER [13]。Lample 等人 [14] 以及 Ma 與 Hovy [15] 把同樣的輸出層與字元層級詞表示結合,在不使用手工特徵的情況下得到強大的 NER 結果。沿用最大路徑解碼一節的 CRF 記號,並加上起始與結束分數:
其中 是 BiLSTM 分數; 是標籤 後接標籤 的學習分數; 與 是以標籤 起始與結束的分數; 對所有長度為 的標籤序列 加總。訓練損失是對句子平均的負對數概似 。
對 個序列的加總,以對數空間的前向演算法計算:
其中 是涵蓋位置 到 、以標籤 結尾的所有部分序列,其指數分數總和的對數。把每個 log-sum-exp 換成最大值並記錄取得最大值的 ,就得到 HMM 一節的 Viterbi 遞迴,只是 換成 、 換成 。兩者的成本都是 。在填補過的批次中,遮罩為零的位置直接把 原樣往前複製,因此每個句子的正規化常數都停在它自己的長度。
梯度在做什麼。 損失對轉移分數微分得到
其中 計算 中標籤 後接標籤 的次數,期望值依模型分布計算。因此梯度下降會提高正確序列使用得比模型目前預期更多的轉移,並降低其他轉移;期望值來自前向—後向邊際機率,如 PR 06 所示。對前向演算法自動微分就能算出這個量,不必手寫反向傳播。
硬性限制。 BIO 方案直接禁止某些轉移:I-x 只能接在 B-x 或 I-x 之後,而且句子不能以 I-x 開頭。學習得到的 通常能從資料發現這一點,但資料很少時未必如此。把 與 中被禁止的項設為 (實務上用很大的負數),就讓非法序列在訓練與解碼時都不可能出現,而對合法序列毫無影響。這是局部與序列預測一節中輸出限制概念的具體實作。
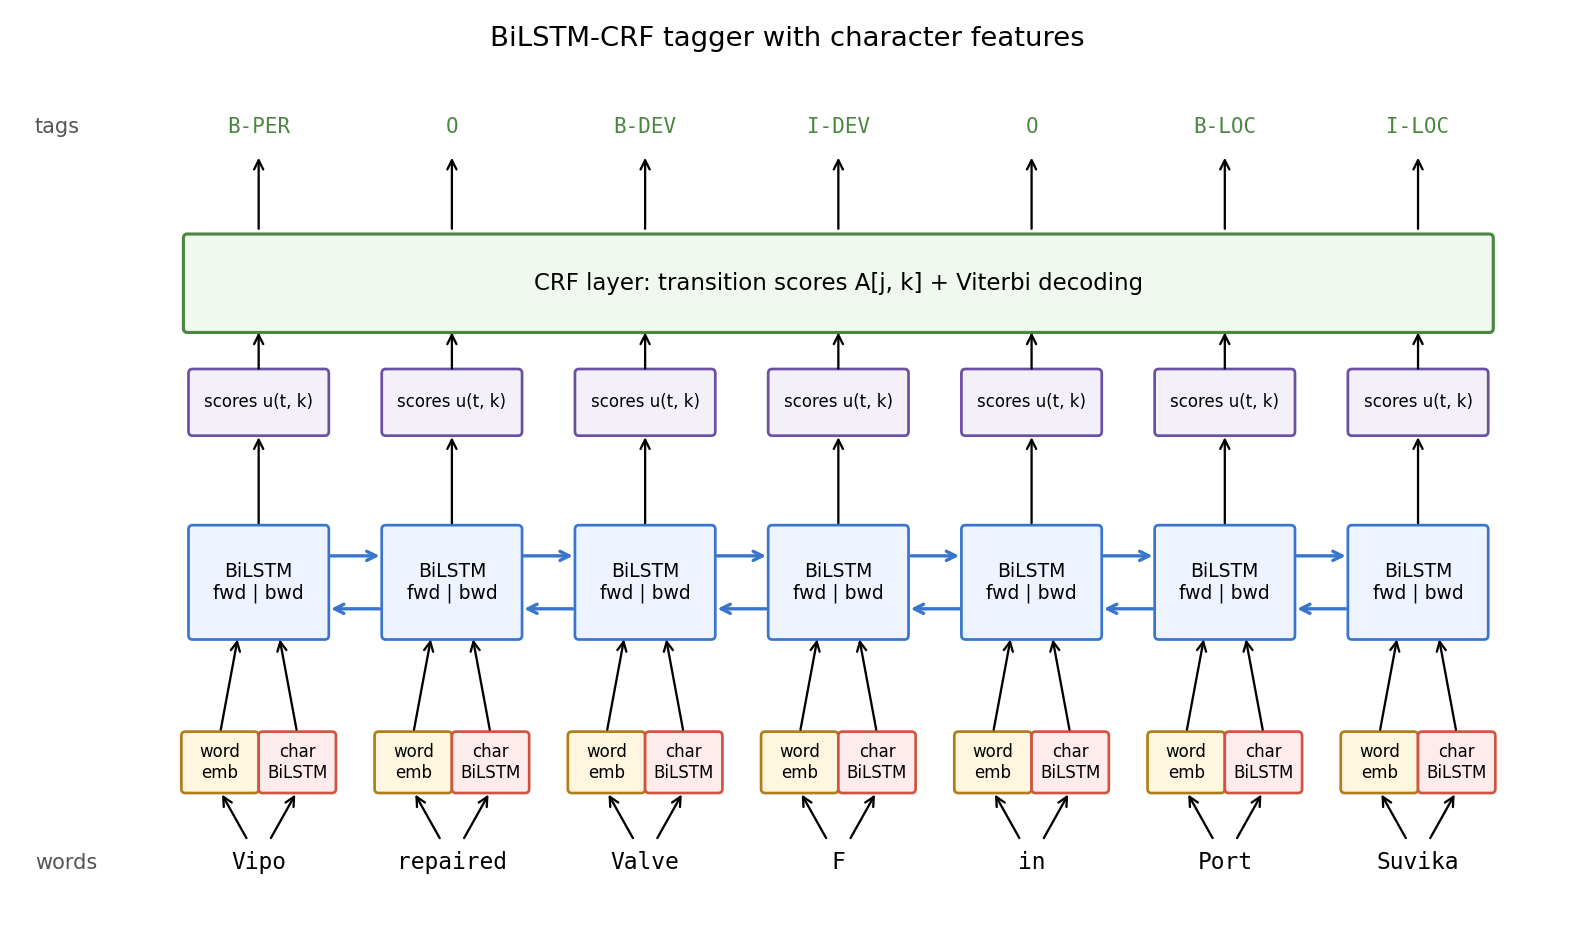
選讀:BiLSTM-CRF(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
字元層級特徵
白話版。 詞嵌入表對沒見過的詞一無所知。詞的字母卻常常知道:大寫、「-ville」或「-corp」這類字尾、數字與連字號,即使對全新的名稱也是很強的標籤線索。
在神經標註器之前,這些線索是手寫特徵(是否大寫、是否以「-ing」結尾、是否含數字)。神經標註器則從字元學習它們。Lample 等人在每個詞的字元上執行一個小型雙向 LSTM,並把最後的前向與反向狀態串接到詞嵌入 [14];Ma 與 Hovy 則對字元嵌入做卷積,再做最大池化 [15]。無論哪一種,輸入都變成
其中 是詞嵌入, 是字元摘要, 是 的字元數, 是讀完最後一個字元後的前向字元 LSTM 狀態, 是反向讀回第一個字元後的狀態。詞層級 BiLSTM 接著讀取 。Akbik、Blythe 與 Vollgraf 把這個想法再往前推:他們像 NLP 05 一樣訓練字元層級語言模型,再把每個詞周圍的內部狀態當作序列標註用的上下文嵌入 [16]。
字元特徵正好幫助詞嵌入最難處理的輸入:未見名稱、罕見詞形變化與拼寫錯誤。但它們無法解決拼字本身沒有編碼的歧義。沒有明顯字尾的名稱可能是人,也可能是公司,只有上下文或世界知識能決定。字元輸入也需要自己的未知符號規則,處理訓練中沒出現過的字元。
標註與擷取的資料集
白話版。 基準會固定標籤集合、標註指南、分詞方式與資料切分。只有四者都一致時,跨基準比較數字才有意義。
| 資源 | 任務 | 提供什麼 |
|---|---|---|
| Penn Treebank [11] | 英文詞性標註與剖析 | 大型英文標註語料,含詞性標籤與句法括號結構;其標籤集廣泛用於英文 |
| Universal Dependencies [4] | 跨語言詞性、詞法與依存關係 | 套用到多種語言樹庫的共同標註框架 |
| CoNLL-2003 [6] | 命名實體辨識 | 英文與德文資料,含四種類型(人物、組織、地點、其他)與完全匹配評估 |
| OntoNotes [17] | 18 種類型的命名實體,以及句法、語意角色與共指 | 多文體、多語言標註,具分層抽樣的訓練、開發與測試切分,其測試集與 CoNLL-2012 共享任務一致 |
| WNUT 2017 [18] | 雜訊使用者生成文字中的新興實體 | 測試罕見與先前未見表面形式的召回率 |
| ACE 2005 [19] | 實體、關係與事件 | 多語言標註(英文、中文、阿拉伯文),用於關係與事件擷取 |
| TACRED [20] | 句子層級關係擷取 | 針對 TAC KBP 關係類型、以群眾外包建立的關係標籤 |
| DocRED [21] | 文件層級關係擷取 | 在 Wikipedia 文件上標註的實體與關係,需要跨句推理 |
標籤編碼也各不相同。CoNLL-2003 檔案使用源自 Ramshaw 與 Marcus 語塊標籤的 IOB 變體,其中 B- 只出現在某個實體緊接在另一個同類型實體之後 [6]、[10];訓練前應把這類檔案轉成本章使用的 BIO 形式,否則 BIO 區段擷取器會誤讀。授權也不同:有些資源可以自由下載,有些則由語言資料聯盟(Linguistic Data Consortium)依授權發行。使用前先確認條款。對新領域而言,最有價值的資料集通常是依你自己凍結的指南、仔細裁定過的小型標註集,再搭配公開基準來比較方法。
完整的 PyTorch 標註實驗
白話版。 我們在同一個小型合成語料上訓練三個標註器,並在名稱從未出現在訓練中的句子上評估:只用詞的 BiLSTM、加上字元特徵的同一標註器,以及在字元標註器上加上受限 CRF 輸出層。評估計算精確區段、錯誤類型與非法標籤轉移。
語料是虛構的。人名、組織名與地名由隨機音節產生,因此測試名稱都是新拼法。組織名要嘛以 tek 或 corp 結尾,要嘛後面接 Labs 這個詞;地名要嘛以 ville 結尾,要嘛接在 Port 之後。有幾個模板允許同一位置放人或組織,所以單靠上下文不一定能決定類型。訓練句有 100 句,測試句有 200 句。其他所有東西都從零實作:從 BIO 標籤擷取區段、精確區段的精確率、召回率與 F1、錯誤分類、填補遮罩、詞 dropout、字元 BiLSTM,以及具遮罩前向演算法、Viterbi 解碼與 BIO 限制的 CRF,並以暴力列舉驗證。每個模型以三個種子訓練;整個程式在 CPU 上遠少於一分鐘即可完成。
程式碼 · Python · 253 行
import random
import torch
from torch import nn

# ---- 1. A synthetic tagged corpus: invented names, fixed templates ----
SYL = ["ka", "mi", "to", "re", "na", "lo", "su", "vi", "da", "po", "ri", "ze"]

def coin(rng, kind):
    stem = "".join(rng.choice(SYL) for _ in range(rng.choice((2, 3)))).capitalize()
    if kind == "PER":
        return stem
    if kind == "ORG":
        return rng.choice([stem + rng.choice(["tek", "corp"]), stem + " Labs"])
    return rng.choice(["Port " + stem, stem + "ville"])           # LOC

rng = random.Random(0)
TRAIN_NAMES = {k: sorted({coin(rng, k) for _ in range(40)}) for k in ("PER", "ORG", "LOC")}
seen = {n for v in TRAIN_NAMES.values() for n in v}
TEST_NAMES = {k: rng.sample(sorted({coin(rng, k) for _ in range(60)} - seen), 15)
              for k in ("PER", "ORG", "LOC")}                       # unseen spellings
TRAIN_NAMES["DEV"] = ["Pump A", "Pump B", "Sensor C", "Sensor D", "Valve E", "Valve F"]
TEST_NAMES["DEV"] = ["Pump G", "Sensor H", "Valve J", "Pump K"]
TEMPLATES = [
    "{PER} repaired {DEV} in {LOC} .",
    "{ORG} repaired {DEV} in {LOC} .",
    "{PER} reported a fault in {DEV} .",
    "{ORG} reported a fault in {DEV} .",
    "the sensor near {LOC} was checked by {PER} .",
    "the sensor near {LOC} was checked by {ORG} .",
    "{PER} and {PER} visited {LOC} .",
    "{ORG} shipped {DEV} to {LOC} yesterday .",
    "after the test , {PER} said {DEV} might fail .",
    "a pump in {LOC} failed and {ORG} replaced it .",
]

def make(names, n):
    data = []
    for _ in range(n):
        words, tags = [], []
        for piece in rng.choice(TEMPLATES).split():
            if piece.startswith("{"):
                kind = piece[1:-1]
                toks = rng.choice(names[kind]).split()
                words += toks
                tags += ["B-" + kind] + ["I-" + kind] * (len(toks) - 1)
            else:
                words.append(piece)
                tags.append("O")
        data.append((words, tags))
    return data

train_data, test_data = make(TRAIN_NAMES, 100), make(TEST_NAMES, 200)
TAGS = ["O"] + [f"{p}-{k}" for k in ("PER", "ORG", "LOC", "DEV") for p in "BI"]
t2i = {t: i for i, t in enumerate(TAGS)}
w2i = {w: i + 2 for i, w in enumerate(sorted({w for s, _ in train_data for w in s}))}
c2i = {c: i + 2 for i, c in enumerate(sorted({c for w in w2i for c in w}))}
PAD, UNK = 0, 1
print(train_data[0])

# ---- 2. Spans and exact span F1, from scratch ----
def spans(tags):
    out, start, kind = set(), None, None
    for i, t in enumerate(tags + ["O"]):
        if start is not None and not (t.startswith("I-") and t[2:] == kind):
            out.add((start, i, kind))
            start = None
        if t.startswith("B-") or (t.startswith("I-") and start is None):
            start, kind = i, t[2:]                  # an orphan I- still opens a span
    return out

def span_prf(gold_seqs, pred_seqs):
    tp = n_pred = n_gold = 0
    for g, p in zip(gold_seqs, pred_seqs):
        G, P = spans(g), spans(p)
        tp, n_pred, n_gold = tp + len(G & P), n_pred + len(P), n_gold + len(G)
    prec = tp / n_pred if n_pred else 0.0
    rec = tp / n_gold if n_gold else 0.0
    f1 = 2 * tp / (n_pred + n_gold) if n_pred + n_gold else 0.0
    return prec, rec, f1

def error_types(gold_seqs, pred_seqs):
    counts = {"type": 0, "boundary": 0, "missed": 0, "spurious": 0}
    for g, p in zip(gold_seqs, pred_seqs):
        G, P = spans(g), spans(p)
        overlap = lambda a, b: a[0] < b[1] and b[0] < a[1]
        for s in G - P:
            hits = [q for q in P if overlap(s, q)]
            if any(q[:2] == s[:2] for q in hits):
                counts["type"] += 1             # right boundaries, wrong category
            elif hits:
                counts["boundary"] += 1         # overlaps, wrong boundaries
            else:
                counts["missed"] += 1
        counts["spurious"] += sum(not any(overlap(q, s) for s in G) for q in P - G)
    return counts

def invalid(tags):                                  # I-x not preceded by B-x or I-x
    return sum(t.startswith("I-") and (i == 0 or tags[i - 1][2:] != t[2:])
               for i, t in enumerate(tags))

assert spans(["B-ORG", "I-ORG", "O", "B-PER"]) == {(0, 2, "ORG"), (3, 4, "PER")}
assert invalid(["O", "I-LOC", "B-DEV", "I-DEV"]) == 1
print("train/test sentences:", len(train_data), len(test_data),
      " gold test spans:", sum(len(spans(t)) for _, t in test_data))

# ---- 3. Padding, masks and word dropout ----
def batch(data, unk_rate=0.0, r=None):
    L = max(len(s) for s, _ in data)
    W = max(len(w) for s, _ in data for w in s)
    x = torch.full((len(data), L), PAD)
    c = torch.full((len(data), L, W), PAD)
    y = torch.zeros(len(data), L, dtype=torch.long)
    for b, (s, t) in enumerate(data):
        for i, w in enumerate(s):
            drop = r is not None and r.random() < unk_rate
            x[b, i] = UNK if drop else w2i.get(w, UNK)      # train the unknown id too
            y[b, i] = t2i[t[i]]
            for j, ch in enumerate(w):
                c[b, i, j] = c2i.get(ch, UNK)
    return x, c, y, x != PAD

# ---- 4. BiLSTM encoder with optional character BiLSTM features ----
class Encoder(nn.Module):
    def __init__(self, use_chars, wdim=32, cdim=16, hidden=48):
        super().__init__()
        self.use_chars = use_chars
        self.wemb = nn.Embedding(len(w2i) + 2, wdim, padding_idx=PAD)
        self.cemb = nn.Embedding(len(c2i) + 2, cdim, padding_idx=PAD)
        self.clstm = nn.LSTM(cdim, cdim, batch_first=True, bidirectional=True)
        self.lstm = nn.LSTM(wdim + (2 * cdim if use_chars else 0), hidden,
                            batch_first=True, bidirectional=True)
        self.emit = nn.Linear(2 * hidden, len(TAGS))

    def forward(self, x, c):
        feats = [self.wemb(x)]
        if self.use_chars:
            B, L, W = c.shape
            lengths = (c != PAD).sum(-1).clamp(min=1).view(-1)
            packed = nn.utils.rnn.pack_padded_sequence(
                self.cemb(c.view(B * L, W)), lengths, batch_first=True,
                enforce_sorted=False)
            _, (h, _) = self.clstm(packed)          # last forward + first backward state
            feats.append(torch.cat([h[0], h[1]], -1).view(B, L, -1))
        h, _ = self.lstm(torch.cat(feats, -1))
        return self.emit(h)                         # emission scores u[b, t, k]

# ---- 5. Linear-chain CRF with BIO constraints and a padding mask ----
class CRF(nn.Module):
    def __init__(self, K):
        super().__init__()
        self.A = nn.Parameter(torch.zeros(K, K))    # A[j, k]: score of tag j -> tag k
        self.start = nn.Parameter(torch.zeros(K))
        self.end = nn.Parameter(torch.zeros(K))
        ban = torch.zeros(K, K)                     # I-x only after B-x or I-x
        for k, tag in enumerate(TAGS):
            if tag.startswith("I-"):
                ban[:, k] = -1e4
                ban[t2i["B-" + tag[2:]], k] = ban[k, k] = 0.0
        self.register_buffer("ban", ban)
        self.register_buffer("ban_start", torch.tensor(
            [-1e4 if t.startswith("I-") else 0.0 for t in TAGS]))

    def trans(self):
        return self.A + self.ban

    def score(self, u, y, mask):                    # S(x, y) for the gold path
        s = (self.start + self.ban_start)[y[:, 0]] + u[:, 0].gather(1, y[:, :1]).squeeze(1)
        for t in range(1, u.size(1)):
            step = self.trans()[y[:, t - 1], y[:, t]] + u[:, t].gather(1, y[:, t:t + 1]).squeeze(1)
            s = s + step * mask[:, t]
        last = y.gather(1, (mask.sum(1) - 1).unsqueeze(1)).squeeze(1)
        return s + self.end[last]

    def log_partition(self, u, mask):               # forward algorithm in log space
        alpha = self.start + self.ban_start + u[:, 0]
        for t in range(1, u.size(1)):
            nxt = torch.logsumexp(alpha.unsqueeze(2) + self.trans() + u[:, t].unsqueeze(1), dim=1)
            alpha = torch.where(mask[:, t:t + 1], nxt, alpha)   # padding: carry forward
        return torch.logsumexp(alpha + self.end, dim=1)

    def nll(self, u, y, mask):
        return (self.log_partition(u, mask) - self.score(u, y, mask)).mean()

    def viterbi(self, u, mask):                     # same recursion with max + backpointers
        delta, back = self.start + self.ban_start + u[:, 0], []
        for t in range(1, u.size(1)):
            best, arg = (delta.unsqueeze(2) + self.trans()).max(1)
            back.append(arg)
            delta = torch.where(mask[:, t:t + 1], best + u[:, t], delta)
        delta = delta + self.end
        paths = []
        for b in range(u.size(0)):
            k = int(delta[b].argmax())
            path = [k]
            for t in range(int(mask[b].sum()) - 1, 0, -1):
                k = int(back[t - 1][b, k])
                path.append(k)
            paths.append(path[::-1])
        return paths

# Check the masked forward algorithm and Viterbi against brute-force enumeration
import itertools
torch.manual_seed(0)
check = CRF(len(TAGS))
with torch.no_grad():
    check.A.normal_()
u = torch.randn(1, 3, len(TAGS))
m = torch.ones(1, 3, dtype=torch.bool)
paths = [torch.tensor([p]) for p in itertools.product(range(len(TAGS)), repeat=3)]
scores = torch.stack([check.score(u, p, m)[0] for p in paths])
assert torch.allclose(check.log_partition(u, m)[0], torch.logsumexp(scores, 0), atol=1e-4)
assert paths[int(scores.argmax())][0].tolist() == check.viterbi(u, m)[0]

# ---- 6. Train three taggers and evaluate exact spans on unseen names ----
def run(use_chars, use_crf, seed, epochs=15):
    torch.manual_seed(seed)
    r = random.Random(seed)
    enc, crf = Encoder(use_chars), CRF(len(TAGS))
    params = list(enc.parameters()) + (list(crf.parameters()) if use_crf else [])
    opt = torch.optim.Adam(params, lr=5e-3)
    order = list(range(len(train_data)))
    for _ in range(epochs):
        r.shuffle(order)
        for i in range(0, len(order), 32):
            x, c, y, mask = batch([train_data[j] for j in order[i:i + 32]], 0.25, r)
            u = enc(x, c)
            loss = (crf.nll(u, y, mask) if use_crf      # sequence-level loss
                    else nn.functional.cross_entropy(u[mask], y[mask]))  # per token
            opt.zero_grad()
            loss.backward()
            nn.utils.clip_grad_norm_(params, 5.0)
            opt.step()
    enc.eval()
    with torch.no_grad():
        x, c, y, mask = batch(test_data)
        u = enc(x, c)
        pred = (crf.viterbi(u, mask) if use_crf else
                [u[b, :int(mask[b].sum())].argmax(-1).tolist() for b in range(len(u))])
    pred = [[TAGS[k] for k in p] for p in pred]
    gold = [t for _, t in test_data]
    return span_prf(gold, pred), sum(map(invalid, pred)), error_types(gold, pred), crf

results = {}
for name, use_chars, use_crf in [("BiLSTM, words", False, False),
                                 ("BiLSTM, words+chars", True, False),
                                 ("BiLSTM-CRF, words+chars", True, True)]:
    runs = [run(use_chars, use_crf, seed) for seed in (0, 1, 2)]
    results[name] = runs
    f1s = [prf[2] for prf, _, _, _ in runs]
    errors = {k: sum(r[2][k] for r in runs) for k in runs[0][2]}
    print(f"{name}: F1 per seed {[round(f, 3) for f in f1s]}, mean {sum(f1s) / 3:.3f}")
    print(f"    invalid I- tags {[r[1] for r in runs]}, errors over 3 seeds {errors}")
assert all(r[1] == 0 for r in results["BiLSTM-CRF, words+chars"])
輸出:
程式碼 · 8 行
(['Vipo', 'repaired', 'Valve', 'F', 'in', 'Port', 'Suvika', '.'], ['B-PER', 'O', 'B-DEV', 'I-DEV', 'O', 'B-LOC', 'I-LOC', 'O'])
train/test sentences: 100 200  gold test spans: 497
BiLSTM, words: F1 per seed [0.893, 0.771, 0.82], mean 0.828
    invalid I- tags [0, 30, 0], errors over 3 seeds {'type': 66, 'boundary': 43, 'missed': 247, 'spurious': 0}
BiLSTM, words+chars: F1 per seed [0.893, 0.903, 0.942], mean 0.913
    invalid I- tags [4, 1, 0], errors over 3 seeds {'type': 124, 'boundary': 2, 'missed': 7, 'spurious': 0}
BiLSTM-CRF, words+chars: F1 per seed [0.915, 0.909, 0.961], mean 0.929
    invalid I- tags [0, 0, 0], errors over 3 seeds {'type': 102, 'boundary': 0, 'missed': 8, 'spurious': 0}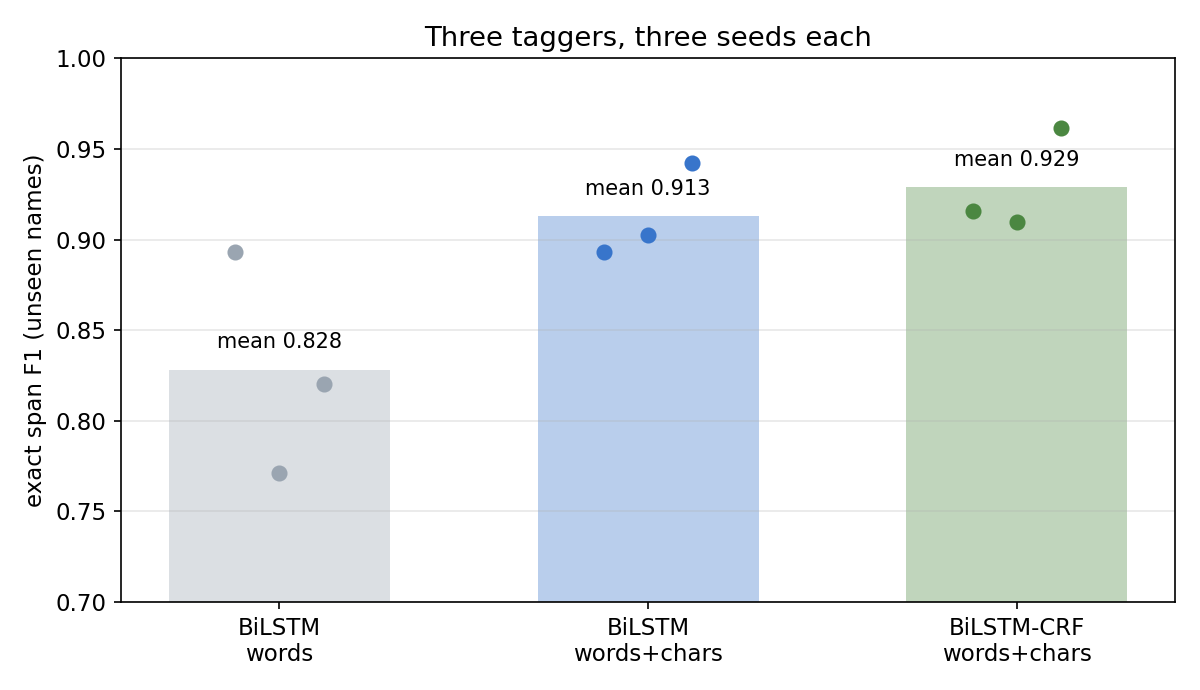
解讀結果
字元特徵修好偵測。 只用詞的標註器把大多數測試名稱看成未知編號。它的錯誤以漏掉實體為主(三個種子共 247 個),另外還有兩詞元名稱被切開或截短造成的邊界錯誤。加入字元特徵後,漏掉的實體降到 7 個,邊界錯誤降到 2 個:新名稱的字尾與大寫已足以找出它們。平均 F1 從 0.828 提高到 0.913。
剩下的是類型問題。 兩個字元模型剩下的錯誤幾乎都是類型錯誤(三個種子共 124 與 102 個):區段正確,但把人標成組織或反過來。這些都是單詞元名稱,常出現在同一位置可放任一類型的模板中,例如 Mimitek reported a fault 或 checked by Renaka。上下文無法決定這些情況;在這個語料中人名的拼字不帶類型標記;而只用 100 句訓練的模型,還沒有可靠地學會 tek 與 corp 字尾,不足以推翻也適合人名的上下文。
CRF 保證合法輸出,也稍有幫助。 只用詞的標註器在一個種子中產生 30 個非法 I- 標籤,字元 softmax 標註器在兩個種子中分別產生 4 個與 1 個;具 BIO 限制的 CRF 依構造一個也沒有。它的平均 F1 為 0.929,對比 0.913,而且每個種子都至少與 softmax 標註器一樣好。在 100 句訓練資料下差距不大;這裡支持多加一層的,是改善的一致性與保證區段格式正確,而不是差距大小。
種子同樣重要。 只用詞的標註器在不同種子間介於 0.771 到 0.893。產生 30 個非法轉移的種子,也是表現最差的那一個。與 NLP 05 一樣,單次執行是不可靠的摘要。
這個實驗沒有顯示什麼。 語料是合成、極小且模板化的;測試句重複使用訓練模板;標籤集也很小。真實基準包含歧義上下文、巢狀與不連續提及,以及標註分歧。這個實驗把三種機制(未知詞處理、字元證據與輸出限制)分離出來,讓每個效果都能被看見與量測;它並未估計這些效果在 CoNLL-2003 或任何其他資料集上的大小。
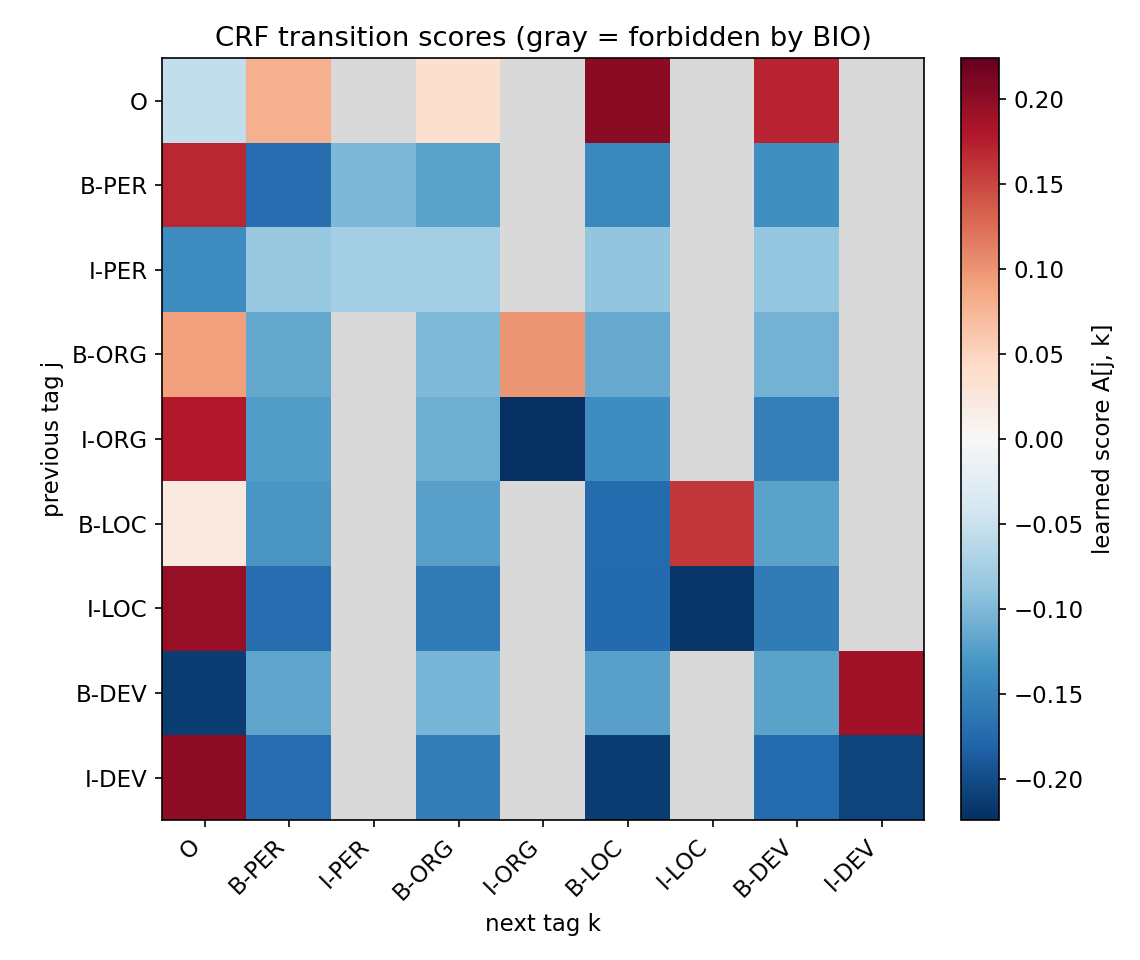
轉移學到了什麼。 圖 4 顯示一個種子學到的轉移分數。在允許的區域內,CRF 學到了語料的結構:B-LOC → I-LOC 與 B-DEV → I-DEV 明顯為正,而 I-ORG → I-ORG 與 I-LOC → I-LOC 明顯為負,因為這個語料中沒有任何名稱超過兩個詞元。學到的轉移表也是需要檢查的建模假設:在每個名稱最多兩個詞元的領域訓練後,它會在其他地方懲罰三詞元的名稱。
現代觀點
直觀說法。 當代擷取系統把預訓練表示與明確任務定義結合。通用生成提升彈性,但區段忠實度與支持性仍是另外的問題。
Li 等人的 NER 綜述依輸入表示、上下文編碼器與標籤解碼器整理早期深度系統 [7]。這個分類仍有用:換編碼器不會決定輸出是平面序列還是重疊區段。Xu 等人的 2024 生成式擷取綜述加入任務軸——實體、關係、事件與統一擷取——以及提示、例子、監督微調與受限生成等調適軸 [8]。應把這些圖譜當成設計維度,而不是普遍優越的架構排名。
從 BiLSTM-CRF 到預訓練編碼器。 依 Li 等人的分類,本章實驗在保持 BiLSTM 上下文編碼器不變的情況下,改變輸入表示(只用詞或詞加字元)與標籤解碼器(softmax 或 CRF)[7]。2016 到 2018 年間,帶字元特徵的 BiLSTM-CRF [14]、[15] 成為標準做法,字元語言模型的上下文字串嵌入又進一步延伸了它 [16]。之後,預訓練 Transformer 編碼器在多數系統中取代 BiLSTM 成為上下文編碼器;其上的線性或 CRF 標籤解碼器,就是 NLP 10 與 NLP 11 討論的詞元分類輸出頭。本章的解碼器問題(合法轉移、區段邊界、精確評估)原封不動地延續下去。
以大型語言模型做開放式實體辨識。 UniversalNER(ICLR 2024)透過針對性的指令微調,把大型語言模型蒸餾成小得多的開放領域 NER 模型,並在由 9 個領域、43 個 NER 資料集組成的基準上評估 [22]。它與 GLiNER [9] 一起代表一種轉變:從固定的標籤集合,走向在推論時才提供實體類型。
GLiNER 是 2024 年以雙向 Transformer 做標籤條件式區段擷取的原始研究 [9]。它展示了改變所需實體類別,不一定要自迴歸生成一長串紀錄。結構化區段輸出可以直接對齊原文。應用比較要納入支援的類型定義、巢狀區段行為、延遲與錯誤覆核,不能只看平均準確率。
生成式擷取器則輸出所需紀錄的文字序列化。強制結構合法可避免缺少鍵值或語法損壞,但無法保證名稱、關係或證據區間正確。實務驗證層會檢查引文是否存在、位移是否匹配、類別是否允許,以及實體身分是否一致。這些檢查可排除部分錯誤,解讀錯誤仍需要評估或覆核。
開放問題包含持續改變的類別集合、專業語言、巢狀實體、跨文件身分與領域轉移下的可靠不確定性。多語擷取還面對不同名稱邊界、文字系統與稱謂慣例。語言特定指南是任務定義的一部分,翻譯類別名稱並不足夠。按來源與語言評估文件,同時保留足夠例數,才能解釋各項比較。
新專案應先建立確定性或小型監督基準,凍結標註指南,檢查錯誤類型,再選更大的模型。保留測試文件時,防止重複模板與近乎相同的報告跨越切分。比較完整且受支持的紀錄,不要只檢查是否能剖析輸出格式。這樣建立的擷取服務,才有可量測且能回溯證據的失敗模式。
新標籤同時測試表示與解讀
標籤條件式區段擷取 [9] 與生成式擷取 [8],改變應用提供類別清單的方式。彈性帶來分析問題:模型辨認的是預定類別,還是只對熟悉標籤名稱反應?可以比較短標籤、精確描述,以及刻意相似的競爭描述。例如區分設備製造商與設備操作單位:兩者都可能是組織提及,但事件角色不同。
應分別判斷實體偵測、指定類型與關係配置。組織區段定位正確,不代表它製造了設備;生成紀錄若填滿每個要求欄位,也可能在來源省略參與者時編造一位。可以比較明確未知答案與強制填入。這個比較應揭露哪種輸出介面保留缺少資訊,以及哪些訓練範例能區分接近的結構規格。類別涵蓋擴大,只有在語意邊界仍清楚時才有用。
重點整理
- 序列標註替每個詞元指定一個標籤,但標籤彼此影響;結構化解碼器在既定分解下選出最佳完整序列。
- HMM 的 Viterbi 解碼在一階分解下是精確的;線性鏈 CRF 保留相同遞迴,但以條件方式替標籤評分,因此可由神經編碼器提供分數。
- 實體辨識從結構描述與位移開始;BIO 標籤編碼平面區段,巢狀提及需要區段表示。
- 評估精確區段(邊界與類型),並把錯誤拆成漏掉、多餘、邊界與類型錯誤,而不是回報詞元準確率。
- BiLSTM 標註器雙向讀取整個句子;遮罩與經過訓練的未知詞編號是不可少的細節。
- 以對數概似(前向演算法)訓練、以 Viterbi 解碼的 CRF 層讓標籤彼此一致;BIO 限制讓非法序列不可能出現。
- 字元特徵能從拼字找回未見名稱,卻無法解決拼字沒有編碼的歧義。
- 資訊擷取在實體區段之上建立關係與事件;每一層都有自己的紀錄契約與失敗模式。
練習
- 序列決策。 改變 HMM 的一列轉移機率,同時保持正規化。找出「fish fish」最佳路徑變成兩個名詞的條件。
提示
比較完整路徑乘積。以名詞起始的兩個候選,共用起始因子與第一次發射。
- 在 CPU 擷取範例加入名稱表沒有的新人物拼法,新增正確區段,回報精確召回率的變化。
提示
保持原名稱表固定。漏掉的提及是基準範圍的有用證據,不是把測試詞彙補進訓練的理由。
- 為重疊的組織與部門名稱設計結構描述,解釋為何單一平面 BIO 序列無法表達所有允許標註。
提示
先畫字元區間,再決定巢狀名稱是否算獨立實體,以及部門是否連結母組織。
- 在 PyTorch 實驗中移除 CRF 的 BIO 限制遮罩(把
ban與ban_start設為零)並重新訓練。計算三個種子的非法I-標籤數,再檢查O後接I-ORG的學習轉移分數。
提示
沒有遮罩時,非法轉移只會被 100 句訓練資料教到的程度所抑制。把學到的分數與轉入 I-ORG 的合法轉移分數比較。
- 加入只用字元的消融實驗:拿掉詞嵌入,只保留字元 BiLSTM。接著在產生器中替人名加上明顯字尾(例如
-ko),重新訓練所有模型。哪種錯誤類型改變了?為什麼?
提示
使用程式印出的錯誤分類。新的拼字線索應該只會把帶有該線索的名稱,從類型錯誤欄位中移出。
- 寫一個部分匹配評估器:預測區段與同類型正確區段重疊時就給分。把它與只用詞標註器的精確 F1 並列,並解釋兩者為何可能以不同順序排列模型。
提示
精確定義匹配規則(例如依最大重疊做一對一匹配),並以它自己的名稱回報。只用詞標註器的邊界錯誤,正是兩種分數分歧之處。
參考文獻
- Susan McRoy, Principles of Natural Language Processing, open textbook, 2021; Chapters 3–5 and 8. Open textbook
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Manning, 2021; Chapter 5, “Sequential labeling and language modeling.” Chapter
- L. R. Rabiner, “A tutorial on hidden Markov models and selected applications in speech recognition,” Proceedings of the IEEE, 77(2), 1989. Paper
- M.-C. de Marneffe, C. D. Manning, J. Nivre and D. Zeman, “Universal Dependencies,” Computational Linguistics, 47(2), 2021. Paper
- J. Lafferty, A. McCallum and F. Pereira, “Conditional random fields: Probabilistic models for segmenting and labeling sequence data,” ICML, 2001. Paper
- Erik F. Tjong Kim Sang and Fien De Meulder, “Introduction to the CoNLL-2003 Shared Task: Language-Independent Named Entity Recognition,” CoNLL, 2003. Paper
- Jing Li, Aixin Sun, Jianglei Han and Chenliang Li, “A Survey on Deep Learning for Named Entity Recognition,” IEEE Transactions on Knowledge and Data Engineering 34(1), 2022. Author-hosted paper
- Derong Xu, Wei Chen, Wenjun Peng, Chao Zhang, Tong Xu, Xiangyu Zhao, Xian Wu, Yefeng Zheng, Yang Wang and Enhong Chen, “Large language models for generative information extraction: a survey,” Frontiers of Computer Science 18(6), 2024. Survey
- Urchade Zaratiana, Nadi Tomeh, Pierre Holat and Thierry Charnois, “GLiNER: Generalist Model for Named Entity Recognition using Bidirectional Transformer,” NAACL, 2024. Paper
- Lance Ramshaw and Mitch Marcus, “Text Chunking using Transformation-Based Learning,” Third Workshop on Very Large Corpora, 1995. Paper
- Mitchell P. Marcus, Beatrice Santorini and Mary Ann Marcinkiewicz, “Building a Large Annotated Corpus of English: The Penn Treebank,” Computational Linguistics 19(2), 1993. Paper
- Ronan Collobert, Jason Weston, Léon Bottou, Michael Karlen, Koray Kavukcuoglu and Pavel Kuksa, “Natural Language Processing (Almost) from Scratch,” Journal of Machine Learning Research 12, 2011. Paper
- Zhiheng Huang, Wei Xu and Kai Yu, “Bidirectional LSTM-CRF Models for Sequence Tagging,” arXiv:1508.01991, 2015. arXiv
- Guillaume Lample, Miguel Ballesteros, Sandeep Subramanian, Kazuya Kawakami and Chris Dyer, “Neural Architectures for Named Entity Recognition,” NAACL-HLT, 2016. Paper
- Xuezhe Ma and Eduard Hovy, “End-to-end Sequence Labeling via Bi-directional LSTM-CNNs-CRF,” ACL, 2016. Paper
- Alan Akbik, Duncan Blythe and Roland Vollgraf, “Contextual String Embeddings for Sequence Labeling,” COLING, 2018. Paper
- Sameer Pradhan, Alessandro Moschitti, Nianwen Xue, Hwee Tou Ng, Anders Björkelund, Olga Uryupina, Yuchen Zhang and Zhi Zhong, “Towards Robust Linguistic Analysis using OntoNotes,” CoNLL, 2013. Paper
- Leon Derczynski, Eric Nichols, Marieke van Erp and Nut Limsopatham, “Results of the WNUT2017 Shared Task on Novel and Emerging Entity Recognition,” Workshop on Noisy User-generated Text, 2017. Paper
- Christopher Walker, Stephanie Strassel, Julie Medero and Kazuaki Maeda, ACE 2005 Multilingual Training Corpus, LDC2006T06, Linguistic Data Consortium, 2006. Catalog
- Yuhao Zhang, Victor Zhong, Danqi Chen, Gabor Angeli and Christopher D. Manning, “Position-aware Attention and Supervised Data Improve Slot Filling,” EMNLP, 2017. Paper
- Yuan Yao, Deming Ye, Peng Li, Xu Han, Yankai Lin, Zhenghao Liu, Zhiyuan Liu, Lixin Huang, Jie Zhou and Maosong Sun, “DocRED: A Large-Scale Document-Level Relation Extraction Dataset,” ACL, 2019. Paper
- Wenxuan Zhou, Sheng Zhang, Yu Gu, Muhao Chen and Hoifung Poon, “UniversalNER: Targeted Distillation from Large Language Models for Open Named Entity Recognition,” ICLR, 2024. arXiv
- Mike Schuster and Kuldip K. Paliwal, “Bidirectional Recurrent Neural Networks,” IEEE Transactions on Signal Processing 45(11), 1997. DOI
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 07・注意力機制與 Transformer · 22 分鐘