NLP 07・注意力機制與 Transformer
先備知識:NLP 06・以 RNN 做序列標註(詞性標註、資訊擷取)
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 為什麼把整個來源句壓進一個向量會限制編碼器—解碼器,以及注意力如何移除這個瓶頸。
- 加法式(Bahdanau)與乘法式(Luong)注意力的方程式,以及它們如何推廣成查詢、鍵與值。
- 縮放內積注意力、多頭注意力,以及自注意力(self-attention)與交叉注意力(cross-attention)的差別。
- 填補遮罩與因果遮罩如何規定每個位置可以讀什麼,以及如何測試它們確實有效。
- 為什麼注意力需要位置資訊,以及提供位置的主要方法。
- Transformer 編碼器與解碼器區塊如何組成、成本多少,以及哪些變體針對長上下文。
先看全貌
循環神經網路(NLP 05)一次讀一個詞元,並帶著一份持續更新的摘要。不論句子有五個詞還是五十個詞,這份摘要的大小都固定。注意力改變了讀取方式:不再只依賴一份摘要,每個位置都能回頭看所有已儲存的表示,並決定哪些對目前要做的預測有用。Transformer 把這個想法推到底,編碼器與解碼器都只用注意力和小型逐詞元網路組成,完全不需要循環。
本章由三個決定組織,值得分開看。評分規則決定一個位置與另一個位置有多匹配。可見性規則以遮罩表示,決定哪些位置根本可以被讀取。位置規則決定詞序如何進入一個原本會忽略詞序的計算。改進其中一項,修不好另一項的錯誤:更好的評分函數,無法修補洩漏未來詞元的遮罩。
Hagiwara 第 8 章從實務角度介紹注意力與 Transformer [1]。本章補上推導、對照原始論文,並用小型 CPU 範例實作每個機制。ML 05 從影像角度處理同一套機制,並提供完整的位置編碼數學;NLP 08 則用它建立翻譯模型。
1. 編碼器—解碼器的瓶頸
直觀說法。 序列到序列模型有一個讀取來源的編碼器,以及一個寫出目標的解碼器。如果兩者之間唯一的橋樑是一個向量,解碼器需要的每個細節都必須擠過這個向量。
Sutskever、Vinyals 與 Le [2] 以及 Cho 等人 [3] 的循環編碼器—解碼器,以編碼器 RNN 讀取來源序列 ,再把最後狀態交給解碼器:
其中 是讀完來源詞元 後的編碼器狀態; 是來源長度; 是唯一的上下文向量; 是目標步驟 的解碼器狀態; 是前一個目標詞元; 是目標前綴; 與 是 LSTM 或 GRU 單元之類的循環更新函數; 是輸出層,後接目標詞彙表上的 softmax。ML 04 推導這些單元並訓練這種模型。
不論輸入是什麼,向量 的維度都是 。十個詞的句子和六十個詞的段落,都必須在產生第一個目標詞之前壓進它。Bahdanau、Cho 與 Bengio 指出這個固定長度向量很可能是基本編碼器—解碼器的瓶頸,並提出讓解碼器改為在來源中搜尋相關部分 [4]。Sutskever 等人也回報,把來源句反轉有助於他們的 LSTM 模型,這與同一個診斷一致:縮短最早來源詞與最早目標詞之間的路徑,讓它們更容易被利用 [2]。
瓶頸關乎資訊流動,不只是容量。即使 很大,也必須在解碼器知道步驟 需要哪個來源細節之前就算好。注意力把這個選擇延後:編碼器為每個來源詞元保留一個向量,解碼器在每一步選擇不同的組合。
2. 加法式注意力(Bahdanau)
直觀說法。 在每個目標步驟,拿解碼器目前的需求去替每個來源位置評分,把分數轉成總和為一的權重,再對編碼器狀態做加權平均。
Bahdanau 等人 [4] 保留全部編碼器狀態 (來自雙向編碼器),並對目標步驟 計算:
其中 是前一個解碼器狀態; 是來源位置 的編碼器狀態;、 與 是學得的矩陣與向量; 是對齊分數; 是注意力權重,非負且對 總和為一; 是每一步各自的上下文向量,解碼器把它和自身狀態一起用來預測 。記號與 ML 04 一致。由於分數先讓兩個向量通過一個小型前饋層再比較,這種形式稱為加法式注意力。
對 NLP 而言有兩個重要後果。第一,解碼器現在有通往每個來源詞元的直接路徑,第一個來源詞的資訊不必撐過多次循環更新。第二,權重 形成目標與來源位置之間的軟對齊,可以畫出來檢查。這種檢查是診斷,不是保證:如後文所述,高權重只顯示計算從哪裡讀取,不說明最終預測為何正確。
3. 乘法式注意力(Luong)
直觀說法。 把小型評分網路換成內積,必要時中間夾一個學得矩陣。這更省計算,也讓注意力變成矩陣乘法。
Luong、Pham 與 Manning [5] 為一個讀取所有來源狀態的全域注意力模型比較了幾種評分函數。他們用目前(而非前一個)解碼器狀態 與每個來源狀態 評分:
其中 是目標步驟 的頂層解碼器狀態; 是來源位置 的編碼器狀態; 是學得矩陣; 是注意力權重。第三種選項 concat 像加法式注意力一樣,用前饋層對串接向量 評分。上下文向量 與解碼器狀態結合成注意力隱藏狀態,再送進輸出 softmax:
其中 是向量串接,、 是學得矩陣。Luong 等人也提出局部注意力,先預測一個對齊的來源位置,只讀取它附近的視窗;以及輸入饋送(input feeding),把 送進下一個解碼步驟,讓模型知道自己先前的對齊決定 [5]。
「general」評分是通往 Transformer 的橋樑。令 、,分數就只是 。一旦每個分數都是查詢與鍵的內積,整張分數表就是一次矩陣乘法,正是現代硬體最擅長的運算。
4. 查詢、鍵與值:從對齊到自注意力
直觀說法。 把解碼器狀態推廣成查詢(這個位置在找什麼),把來源狀態推廣成鍵(每個位置提供什麼來比對)與值(被讀到時傳出什麼)。如此注意力可在任意兩組向量之間運作,也包括序列和它自己。
在加法式與乘法式注意力中,同一個編碼器狀態同時用來比對和加權平均。Transformer 以三個學得投影分開這些角色 [6]。若查詢來自解碼器、鍵和值來自編碼器,這個運算就是交叉注意力,是 Bahdanau 與 Luong 注意力的直接後代。若查詢、鍵和值都來自同一個序列,就是自注意力:每個詞元讀取同一句中的其他詞元,建立自己的新表示。
自注意力產生上下文表示。在「the crane lifts steel」和「the crane eats fish」中,crane 的嵌入查表結果相同;但經過自注意力後,兩次出現讀到不同鄰居,輸出向量就能不同。這正是 NLP 10 發展成 BERT 的表示概念。重用這類表示必須配對分詞器與詞彙表:嵌入列只在該模型詞元 ID 的定義下有意義。未調適權重就換分詞器,可能讓形式合法的數字代表不相關符號。
5. 縮放內積注意力
直觀說法。 每個位置詢問其他哪些位置含有有用資訊。注意力把比較轉成權重,再組合相應的值向量。
對單一注意力頭:
其中 包含輸入表示; 是學得的查詢與鍵投影; 是值投影; 是投影矩陣; 是鍵和值的寬度; 是加法可見性遮罩,元素為 (允許)或 (阻擋); 包含按列正規化的注意力權重; 是輸出。每個查詢列分別套用 softmax。這是 Transformer 論文介紹的機制 [6]。
在常見初始化假設下,縮放因子避免內積只因鍵向量維度增加而變大:若查詢與鍵的分量彼此獨立、平均為零、變異數為一, 的變異數就是 ;除以 讓變異數回到一,softmax 才不會飽和(ML 05 有完整推導)。它不會把注意力權重變成校準後的語意重要性。高權重表示經過學得投影後,在這次計算有較大貢獻;不會證明該詞元造成最終答案,也不會證明它支持生成的陳述。
程式碼:在玩具句子上從零實作注意力
為了不經訓練就看清方程式在做什麼,我們手動建立向量。「the pump stopped because it overheated」的每個詞元得到一個四特徵向量(裝置名詞、代名詞、事件動詞、功能詞),句子再補上一個 <pad>,就像在批次中一樣。投影的設計讓代名詞與動詞尋找裝置、名詞尋找事件,代名詞也微弱地提供裝置資訊。這裡沒有任何學習;重點是觀察評分、遮罩與平均如何運作。
程式碼 · Python · 34 行
import numpy as np

tokens = ["the", "pump", "stopped", "because", "it", "overheated", "<pad>"]
# Hand-built features: [device noun, pronoun, event verb, function word]
X = np.array([[0, 0, 0, 1], [1, 0, 0, 0], [0, 0, 1, 0], [0, 0, 0, 1],
              [0, 1, 0, 0], [0, 0, 1, 0], [0, 0, 0, 0]], dtype=float)
# Query space: [looking for a device, looking for an event]
W_Q = 3.0 * np.array([[0, 1], [1, 0], [1, 0], [0, 0]])   # nouns seek events; pronouns, verbs seek devices
W_K = np.array([[1, 0], [0.5, 0], [0, 1], [0, 0]])       # devices offer "device"; a pronoun weakly so
W_V = np.eye(4)                                          # pass the features through unchanged

def attention(X, mask):
    Q, K, V = X @ W_Q, X @ W_K, X @ W_V
    scores = Q @ K.T / np.sqrt(K.shape[1])
    scores = np.where(mask, scores, -np.inf)              # blocked pairs get zero weight
    A = np.exp(scores - scores.max(axis=1, keepdims=True))
    A /= A.sum(axis=1, keepdims=True)
    return A @ V, A

T = len(tokens)
real = np.array([t != "<pad>" for t in tokens])
padding_mask = np.broadcast_to(real, (T, T))              # every query may read real keys
causal_mask = padding_mask & np.tri(T, dtype=bool)        # ...and only earlier ones
out, A = attention(X, padding_mask)
_, A_causal = attention(X, causal_mask)
it, pump = tokens.index("it"), tokens.index("pump")
print("weights of 'it':", " ".join(f"{t}={w:.2f}" for t, w in zip(tokens, A[it])))
print("output of 'it' (device, pronoun, event, function):", out[it].round(2))
print("'pump' reads 'stopped': bidirectional", A[pump, 2].round(2),
      "| causal", A_causal[pump, 2].round(2))
X2 = X.copy(); X2[-1] = [5, 5, 5, 5]                      # garbage in the padding slot
out2, _ = attention(X2, padding_mask)
print("padding changes real outputs:", not np.allclose(out[real], out2[real]))
assert np.allclose(A.sum(axis=1), 1) and A[:, -1].max() == 0
輸出:
程式碼 · 4 行
weights of 'it': the=0.07 pump=0.55 stopped=0.07 because=0.07 it=0.19 overheated=0.07 <pad>=0.00
output of 'it' (device, pronoun, event, function): [0.55 0.19 0.13 0.13]
'pump' reads 'stopped': bidirectional 0.4 | causal 0.0
padding changes real outputs: False
代名詞的新向量大多是它從 pump 借來的裝置特徵:經過一步注意力,it 已帶有可能先行詞的資訊。填補欄的權重恰為零,因此即使填補位置存了垃圾,也改變不了真實詞元的輸出。在因果遮罩下,pump 不能再讀較晚的動詞 stopped。真實模型會學習投影;這裡是手動寫出,而且範例刻意只有一個裝置,所以不能說明訓練好的模型如何解決較難的指涉(那是共指問題,見 NLP 12)。
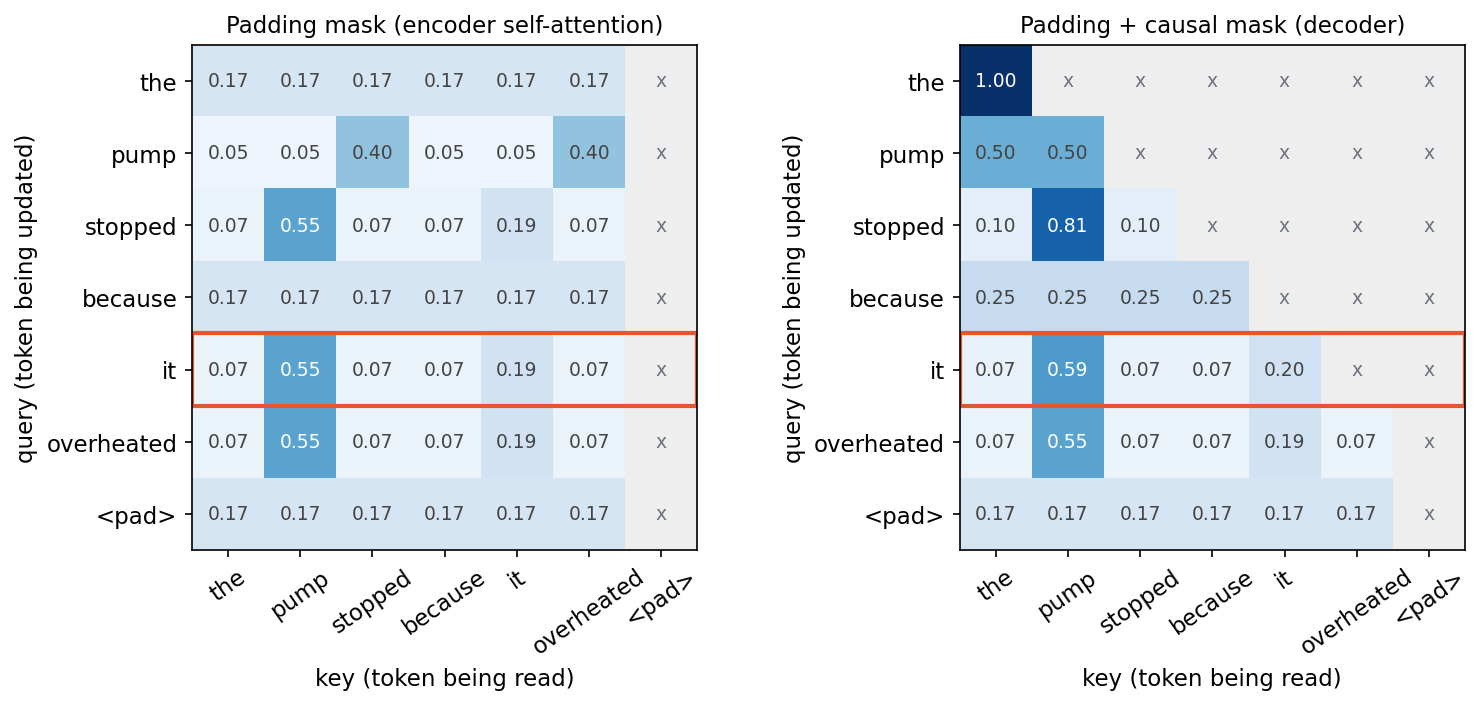
請注意圖中的 <pad> 列:填補查詢仍會產生一個(無意義的)輸出,因為它的鍵並未全部被阻擋。這讓本例採用右側填補時的手寫 softmax 保持有定義。若一整列都被阻擋,一般 softmax 沒有定義並可能產生 NaN;不要假設不同核心會以相同方式處理。應拒絕沒有真實詞元的空序列,或明確處理只有填補的查詢列,尤其是左側填補與因果遮罩一起使用時。應遮住填補鍵,並在損失中忽略填補輸出。
6. 多頭注意力
直觀說法。 平行執行幾個較小的注意力運算,每個有自己的投影,讓不同的頭比對不同關係。再把輸出串接起來,用另一個投影混合。
有 個頭時,第 個頭有自己的投影 :
其中 是第 5 節的縮放內積運算,且 ;方括號把 個輸出(各為 )串接回寬度 ; 是輸出投影。原始 Transformer 使用 個頭、模型寬度 [6]。由於每個頭窄了 倍,多頭注意力的成本約等於一個全寬度的頭,四個投影矩陣共有 個權重(另加偏差),與 ML 05 的計數相同。
一個頭對每個查詢只形成一個加權平均。若動詞同時需要主詞與受詞,單一 softmax 必須把權重分給兩者,兩邊都會變模糊;多個頭則能各自集中在一種關係上。不過不要過度解讀:頭不保證學到人類可讀的角色,有些頭是多餘的。
後來的兩種變體只改變鍵與值的共享方式。多查詢注意力(multi-query attention)讓所有查詢頭共用一個鍵頭和一個值頭,縮小每個解碼步驟要讀取的記憶體 [15]。分組查詢注意力(grouped-query attention)讓每個鍵/值頭由一組查詢頭共用,是兩者之間的折衷 [16]。兩者主要影響快速自迴歸解碼,見 NLP 09。
7. 自注意力與交叉注意力
直觀說法。 同一個運算可以連接同一序列內的詞元(自注意力),也可以連接兩個序列(交叉注意力)。唯一的差別是查詢、鍵和值從哪裡來。
| 機制 | 查詢來自 | 鍵與值來自 | NLP 中的典型用途 |
|---|---|---|---|
| 雙向自注意力 | 該序列 | 同一序列的所有真實詞元 | BERT 等編碼器;翻譯器的來源端 |
| 因果自注意力 | 該序列 | 同一序列的目前與較早位置 | 僅解碼器語言模型;翻譯器的目標端 |
| 交叉注意力 | 解碼器 | 編碼器輸出 | 編碼器—解碼器翻譯與摘要 |
對交叉注意力,令 為解碼器狀態, 為編碼器輸出(常稱為記憶,memory):
其中 與 是目標與來源長度;分數矩陣形狀為 ,每個目標位置一列; 阻擋來源填補; 是每個目標位置的輸出。這就是加上學得查詢、鍵、值投影的 Bahdanau 與 Luong 注意力。這裡不需要因果遮罩,因為解碼開始前整個來源都已知。
應由任務可取得的資訊決定遮罩,而不是模型名稱。完整句子已知時,分類器可使用雙向編碼器;串流延續則必須排除未來輸出。翻譯可以在來源全部抵達後讀取完整來源,但同步翻譯(來源句還沒說完就開始翻)需要更嚴格的來源可見性規則。
8. 遮罩:填補與因果
直觀說法。 遮罩是一張表,說明哪個查詢可以讀哪個鍵。填補遮罩隱藏人為的填充詞元;因果遮罩隱藏未來。
因果自注意力在 時令 ,否則令 。其中 是查詢位置, 是候選鍵位置。目標已位移,所以目前輸入位置仍是允許的前綴詞元,對角線可見。完整雙向自注意力允許所有真實輸入位置,但仍可阻擋填補位置。填補遮罩則在鍵 是填補位置時,對每個查詢 令 。結合多個遮罩時,只要任一遮罩阻擋某一對,該對就被阻擋。
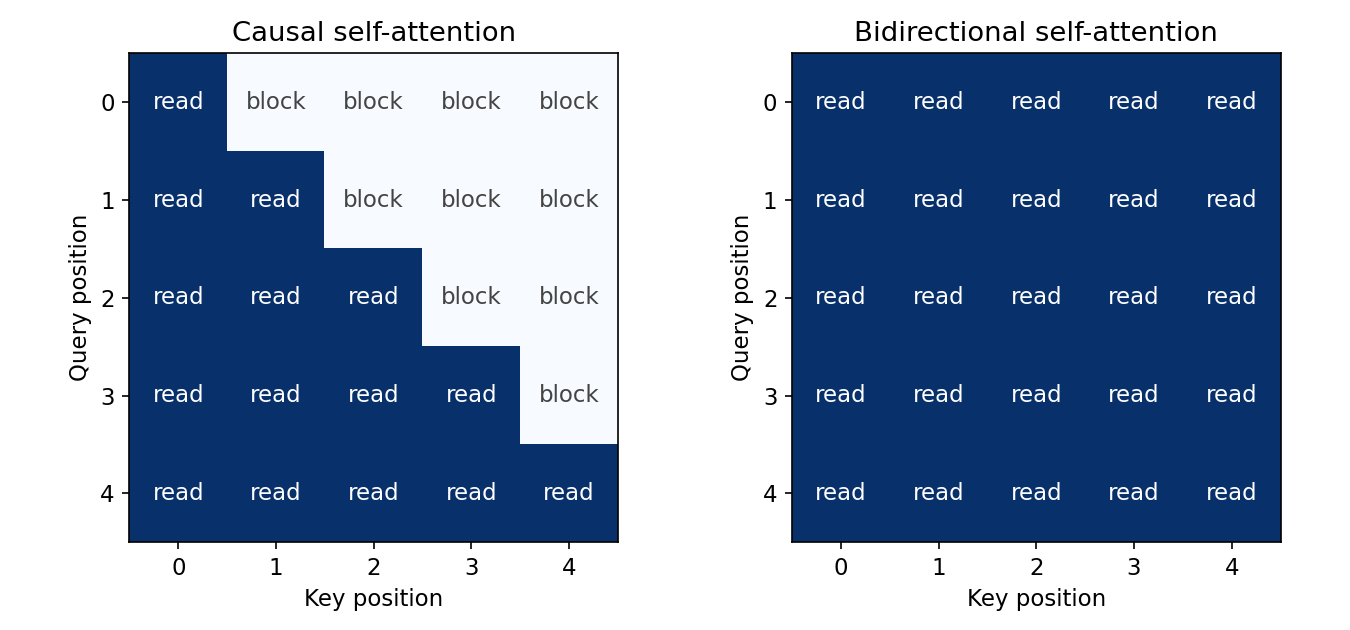
有兩種遮罩容易混淆。注意力遮罩控制表示可以讀什麼;損失遮罩控制哪些目標位置貢獻訓練目標。填補兩者都需要:填補鍵不得貢獻上下文,填補目標不得貢獻損失。它們解決不同問題,應分別測試。
布林遮罩的意思也取決於 API。在 PyTorch 的 scaled_dot_product_attention 中,True 代表此配對允許參與注意力 [22]。在 MultiheadAttention 中,attn_mask 的 True 代表阻擋,key_padding_mask 的 True 則標記要忽略的鍵 [23]。先用 allowed 或 blocked 命名邏輯關係,再明確轉換;直接重用同一個布林陣列,可能悄悄反轉資訊流規則。浮點遮罩則是加到分數上的偏移,例如零或負無限大;由零與一組成的浮點陣列不等同於布林遮罩。
以下獨立範例使用單位投影與均勻分數,讓預期輸出可以直接檢查。第一個查詢只讀第一個值,第二個查詢平均兩個值。反轉布林遮罩後,兩個 API 的結果相同。SDPA 也直接接收 dropout 機率,因此評估時必須明確傳入 dropout_p=0.0 [22]。
程式碼 · Python · 22 行
import torch
from torch import nn
from torch.nn import functional as F

# Two queries and keys, with zero scores: allowed keys receive equal weights.
q = torch.zeros(1, 2, 2)
k = torch.zeros_like(q)
v = torch.tensor([[[10.0, 0.0], [0.0, 20.0]]])
allowed = torch.tril(torch.ones(2, 2, dtype=torch.bool))
blocked = ~allowed
sdpa = F.scaled_dot_product_attention(q[:, None], k[:, None], v[:, None],
                                     attn_mask=allowed, dropout_p=0.0)[:, 0]
mha = nn.MultiheadAttention(2, 1, bias=False, dropout=0.0, batch_first=True).eval()
with torch.no_grad():
    mha.in_proj_weight.copy_(torch.eye(2).repeat(3, 1))
    mha.out_proj.weight.copy_(torch.eye(2))
    module_out, _ = mha(q, k, v, attn_mask=blocked, need_weights=False)
expected = torch.tensor([[[10.0, 0.0], [5.0, 10.0]]])
assert torch.allclose(sdpa, expected)
assert torch.allclose(module_out, expected)
print('mask conventions agree:', torch.allclose(sdpa, module_out))
print('outputs:', sdpa[0].tolist())
輸出
mask conventions agree: True
outputs: [[10.0, 0.0], [5.0, 10.0]]
檢查注意力並測試資訊流
這個獨立矩陣範例把學得的分數與可見性規則分開。向量與投影皆為合成,因此權重沒有語言學解釋。
程式碼 · Python · 26 行
import numpy as np

rng = np.random.default_rng(0)
T, d = 5, 8                                   # 5 tokens, 8-dimensional embeddings
X = rng.normal(size=(T, d))                   # token embeddings (+ positions)
Wq, Wk, Wv = (rng.normal(size=(d, d)) / np.sqrt(d) for _ in range(3))

def attention(X, causal):
    Q, K, V = X @ Wq, X @ Wk, X @ Wv
    scores = Q @ K.T / np.sqrt(d)             # (T, T) query-key similarities
    if causal:                                # position t may only look at <= t
        scores = np.where(np.tri(T, dtype=bool), scores, -np.inf)
    w = np.exp(scores - scores.max(axis=1, keepdims=True))
    w /= w.sum(axis=1, keepdims=True)         # softmax over keys
    return w @ V, w

out, w = attention(X, causal=True)
print(np.round(w, 2))

# Changing the LAST token must not change any earlier causal output...
X2 = X.copy(); X2[-1] += 5.0
out2, _ = attention(X2, causal=True)
print("causal: earlier outputs unchanged:", np.allclose(out[:-1], out2[:-1]))
# ...but in a bidirectional encoder every position can see it.
b1, _ = attention(X, causal=False); b2, _ = attention(X2, causal=False)
print("bidirectional: earlier outputs unchanged:", np.allclose(b1[:-1], b2[:-1]))
輸出:
程式碼 · 7 行
[[1.   0.   0.   0.   0.  ]
 [0.88 0.12 0.   0.   0.  ]
 [0.42 0.29 0.29 0.   0.  ]
 [0.28 0.24 0.29 0.19 0.  ]
 [0.34 0.06 0.24 0.11 0.26]]
causal: earlier outputs unchanged: True
bidirectional: earlier outputs unchanged: False
因果權重是下三角矩陣:第一個詞元只能讀自己,最後一個可以讀全部。數值檢查示範了遮罩的可見性規則。更一般地說,第 列只聚合位置不超過 的值向量。若查詢、鍵和值也由不含未來資訊的狀態計算而來,未來輸入就無法影響該輸出。這個條件必須在整個網路都成立,也包括任何混合不同位置的前處理。相同遮罩讓所有下一詞元訓練損失可以平行計算,同時讓每個預測只使用自己的前綴。
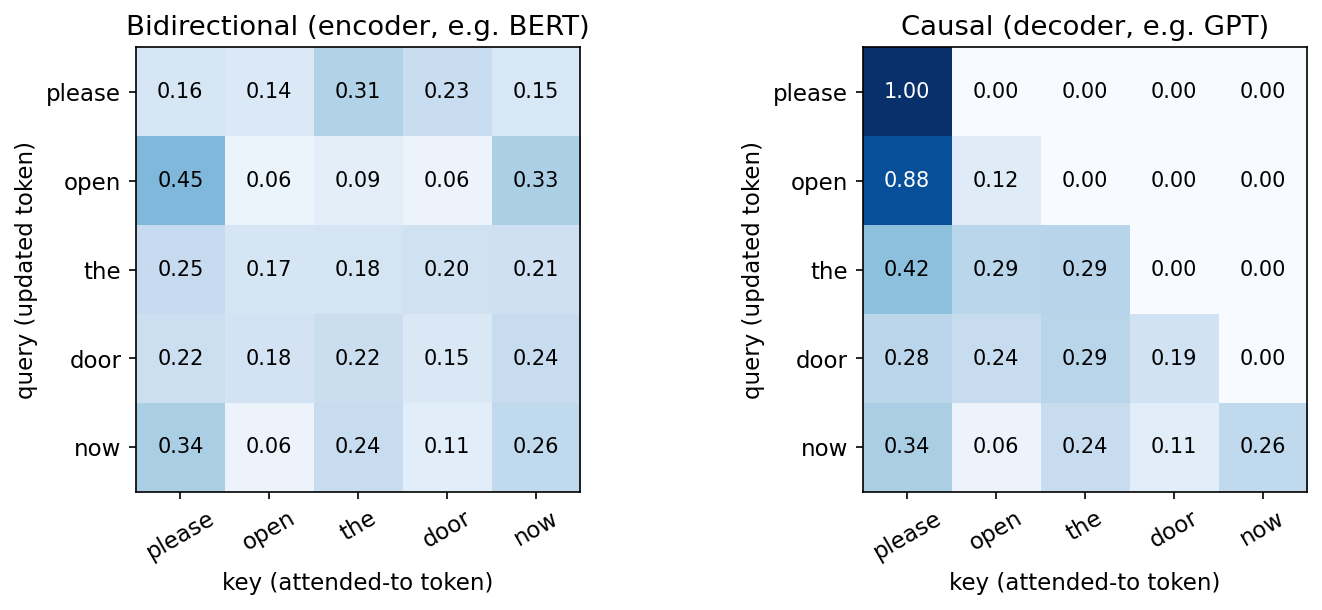
在任何真實程式庫中,都值得保留這類擾動測試。低訓練損失揭露不了洩漏的遮罩,因為能看到答案的模型同樣能得到低損失;只有改變未來輸入、再檢查較早輸出的測試,才直接針對可見性契約。
9. 位置:告訴注意力詞元在哪裡
直觀說法。 注意力比較詞元表示,位置資訊則告訴模型詞元在哪裡。詞元身分本身不會說明它是主詞還是最後一個詞。
沒有位置資訊時,自注意力具有排列等變性(permutation equivariance):打亂輸入詞元,輸出會以相同方式被打亂,因為公式中沒有任何東西提到順序。「Dog bites man」與「man bites dog」會得到同一組向量。第 10 節的編碼器區塊程式碼會檢查這個性質,並顯示加入位置後性質消失。
最簡單的做法是在第一層之前,把位置向量加到每個詞元嵌入。使用學得的嵌入與位置表:
其中 是位置 的初始表示; 是詞元嵌入表; 選取詞元 的列; 是位置表; 選取位置列; 是表示寬度。學得的位置表也限制支援的最遠位置。超過範圍的序列不是普通長輸入,而是非法索引。服務契約應記錄上下文限制。擴充位置表或改變位置行為屬於模型變更,需要評估,不能直接假定長文件表現維持不變。
原始 Transformer 則使用固定的正弦(sinusoidal)編碼 [6]:
其中 是位置, 是一對維度的索引,每一對以自己的頻率旋轉。這與 ML 05 的公式相同(該頁寫成 );那裡證明了使它有用的兩個性質(固定位移相當於旋轉、內積只依賴位移),並畫出圖樣。原論文也在加上編碼之前,把詞元嵌入乘以 [6];NLP 08 的翻譯模型沿用這個慣例。
後來的方法把位置直接放進注意力分數,讓模型看到相對位移:
- 相對位置表示(relative position representations)把依賴截斷位移 的學得向量加到鍵與值上 [9]。
- 旋轉位置嵌入(RoPE)把每個查詢與鍵旋轉一個與位置成正比的角度,使分數 只透過 依賴位置 [10]。
- ALiBi 對每個因果注意力分數加上固定、依頭而異、與距離 成正比的懲罰,設計目標是讓在短輸入上訓練的模型能在較長輸入上評估 [11]。
這個選擇和上下文長度契約互相影響。學得的絕對位置表有硬性上限;相對方法移除了硬性上限,但不保證在超過訓練長度時仍準確。請在打算服務的長度上評估。
10. Transformer 編碼器與解碼器區塊
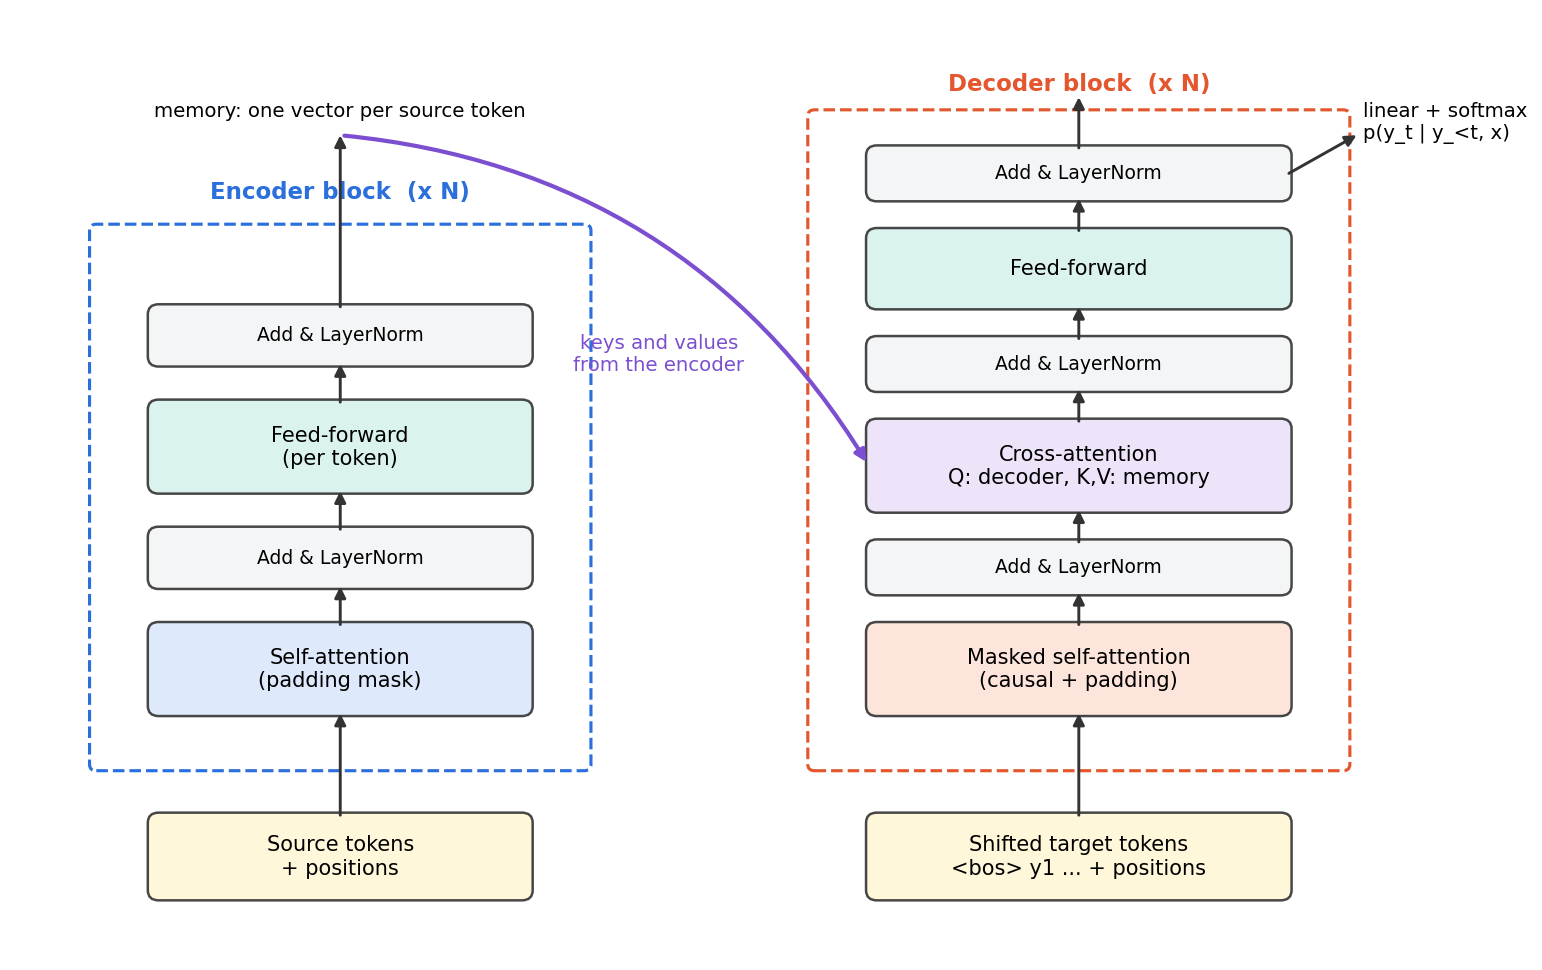
直觀說法。 一個區塊輪流做兩件事。注意力讓詞元交換資訊;小型前饋網路再各自處理每個詞元。殘差連接與正規化讓深層堆疊可以訓練。解碼器在兩者之間多做一件事:透過交叉注意力讀取編碼器。
原始編碼器區塊 [6] 把每個子層包在殘差連接中,後接層正規化(後正規化,post-norm):
其中 是區塊輸入; 是帶填補遮罩的多頭自注意力; 是層正規化,把每個詞元的 個特徵標準化,再套用學得的縮放與平移 [7]; 對每個位置分別套用,、,隱藏寬度為 (原始模型在 時為 2048); 是區塊輸出。許多後來的模型把正規化移到每個子層之前(前正規化,pre-norm,即 )。Xiong 等人分析了為何後正規化需要學習率暖身,而前正規化可以不用 [8]。因此,在說明正規化放在哪裡之前,「一個 Transformer」並未完整指定。
解碼器區塊有三個子層,各有自己的殘差連接與正規化:
- 對目標前綴的遮罩自注意力,使用因果遮罩(批次時再加填補遮罩)。
- 交叉注意力,查詢來自第 1 步,鍵和值來自編碼器的最終輸出,只遮蔽來源填補。
- 逐位置的前饋網路。
堆疊 個編碼器區塊與 個解碼器區塊,就得到完整模型(原始模型 [6])。每個解碼器區塊都讀同一個編碼器最終輸出。線性層與目標詞彙表上的 softmax 把最後的解碼器狀態轉成 。去掉編碼器與交叉注意力,就成為僅解碼器模型,也就是目前多數大型語言模型的形狀(NLP 09);去掉解碼器,就成為 BERT 之類的僅編碼器模型(NLP 10)。
程式碼:從零實作微型 Transformer 編碼器區塊
以下程式碼直接依方程式實作多頭自注意力與後正規化編碼器區塊,借用 PyTorch nn.TransformerEncoderLayer 隨機初始化的權重 [21],並檢查兩者輸出相同。接著測試三個性質:填補被忽略、沒有位置時區塊具排列等變性、正弦位置打破這個對稱。為了讓比較精確,dropout 關閉,參考層處於評估模式。
程式碼 · Python · 43 行
import math
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
B, T, d, h, d_ff = 2, 6, 16, 4, 64
ref = nn.TransformerEncoderLayer(d, h, d_ff, dropout=0.0, activation="relu",
                                 batch_first=True, norm_first=False).eval()

def multi_head_attention(x, key_padding, p):
    q, k, v = (x @ p.in_proj_weight.T + p.in_proj_bias).chunk(3, dim=-1)
    split = lambda t: t.view(B, T, h, d // h).transpose(1, 2)        # (B, h, T, d/h)
    q, k, v = split(q), split(k), split(v)
    scores = q @ k.transpose(-2, -1) / math.sqrt(d // h)               # (B, h, T, T)
    scores = scores.masked_fill(key_padding[:, None, None, :], float("-inf"))
    heads = scores.softmax(dim=-1) @ v                                  # (B, h, T, d/h)
    concat = heads.transpose(1, 2).reshape(B, T, d)                     # heads side by side
    return concat @ p.out_proj.weight.T + p.out_proj.bias

def encoder_block(x, key_padding, layer=ref):
    # Post-norm, as in the original Transformer: x <- LN(x + Sublayer(x))
    a = multi_head_attention(x, key_padding, layer.self_attn)
    x = F.layer_norm(x + a, (d,), layer.norm1.weight, layer.norm1.bias, layer.norm1.eps)
    f = layer.linear2(F.relu(layer.linear1(x)))
    return F.layer_norm(x + f, (d,), layer.norm2.weight, layer.norm2.bias, layer.norm2.eps)

x = torch.randn(B, T, d)
pad = torch.tensor([[False] * 6, [False] * 4 + [True] * 2])     # second sentence: 4 real tokens
with torch.no_grad():
    ours, theirs = encoder_block(x, pad), ref(x, src_key_padding_mask=pad)
    print("matches nn.TransformerEncoderLayer:", torch.allclose(ours[~pad], theirs[~pad], atol=1e-5))
    x2 = x.clone(); x2[1, 4:] = 100.0                             # garbage in padded slots
    print("padding is ignored:", torch.allclose(encoder_block(x2, pad)[~pad], ours[~pad], atol=1e-5))
    perm = torch.tensor([3, 0, 5, 1, 4, 2])
    none = torch.zeros(B, T, dtype=torch.bool)
    y, yp = encoder_block(x, none), encoder_block(x[:, perm], none)
    print("no positions -> permutation-equivariant:", torch.allclose(yp, y[:, perm], atol=1e-5))
    pos = torch.arange(T)[:, None] / 10000 ** (torch.arange(0, d, 2) / d)
    pe = torch.stack([pos.sin(), pos.cos()], dim=-1).flatten(1)     # sin/cos interleaved
    y, yp = encoder_block(x + pe, none), encoder_block(x[:, perm] + pe, none)
    print("with positions -> still equivariant:", torch.allclose(yp, y[:, perm], atol=1e-5))
print("parameters:", sum(p.numel() for p in ref.parameters()))
輸出:
程式碼 · 5 行
matches nn.TransformerEncoderLayer: True
padding is ignored: True
no positions -> permutation-equivariant: True
with positions -> still equivariant: False
parameters: 3280
比較只使用真實詞元:在評估模式下,PyTorch 可能走融合路徑,不在填補位置計算有意義的值,而這些輸出本來就會被忽略。參數數量驗證了公式:注意力有 個權重與偏差,前饋網路有 個,兩個層正規化有 個。注意參數分布:在這個區塊中,如同原始 Transformer,前饋網路占了大多數。
在加上位置之前,模型沒有任何位置資訊,第三和第四項檢查正顯示了這一點。真實模型只在第一個區塊的輸入加一次位置向量;後面的區塊都透過殘差流繼承順序資訊。
選讀:Transformer(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
11. 成本與長上下文變體
直觀說法。 每個查詢都和每個鍵比較,所以運算量與分數表會隨序列長度平方成長。對一個句子很便宜,對一本書就很昂貴。
對長度 、寬度 的序列,一個自注意力層計算 與 各約需 次乘加,投影另需約 。循環層約需 ,但需要 個依序步驟;自注意力層的所有位置則可平行計算,任兩個位置之間的路徑長度為一。Vaswani 等人在比較各類層時整理了這個取捨 [6]。對短句( 小於 ),自注意力比較便宜;對長文件, 項會占主導。
直接儲存注意力分數會隨序列長度平方成長。專用實作可避免實體化每個中間矩陣,但哪些位置需要互動的建模問題仍在。部署時,應按實際上下文長度量測記憶體與延遲,不能由短句直接外推。
長上下文方法可分成幾個家族。Tay 等人的綜述把它們整理為固定模式、可學模式、低秩與核方法、記憶、循環與降取樣 [17]。代表性例子:
| 想法 | 例子 | 改變了什麼 |
|---|---|---|
| 限制哪些位置對互動 | Longformer:滑動局部視窗加少數全域詞元 [12] | 固定視窗下成本隨 線性成長;遠距詞元透過全域詞元或多層溝通 |
| 替換 softmax 核 | 使用特徵映射的線性注意力 [13] | 分數可分解,得到線性成本與因果注意力的循環觀點;注意力函數本身不同 |
| 保留精確注意力,減少記憶體搬移 | FlashAttention:分塊、IO 感知計算 [14] | 結果與標準注意力相同,記憶體流量較少;仍是平方級運算 |
| 讓多個頭共用鍵與值 | 多查詢與分組查詢注意力 [15, 16] | 解碼時的鍵/值快取較小 |
| 可延伸的位置方法 | 相對位置、RoPE、ALiBi [9–11] | 移除硬性位置上限;在未見長度的準確度仍需量測 |
這些方法不能互換。FlashAttention 計算的函數與標準注意力相同;Longformer 與線性注意力計算的是不同函數,必須當成不同模型評估。完全不計算成對分數的狀態空間與循環替代方案,見 ML 04 與 ML 05。
現代觀點
直觀說法。 2017 年的注意力區塊在當前模型中仍清晰可辨;多數改變在於正規化位置、位置處理、鍵/值共享與高效核心運算,而不是核心方程式。
綜述。 Lin、Wang、Liu 與 Qiu 的 Transformer 變體綜述(AI Open,2022)先介紹原始模型,再提出分類法,從架構修改、預訓練與應用三個角度回顧變體 [18]。它很適合用來定位某個變體(「這是改注意力、改位置,還是改區塊?」)。Tay、Dehghani、Bahri 與 Metzler 的 Efficient Transformers: A Survey(ACM Computing Surveys,2022)聚焦注意力的記憶體與運算,並依機制分類高效模型(即第 11 節的家族)[17]。它的實務訊息是:效率主張取決於序列長度、硬體與實作,因此要在你需要的長度上比較模型。
注意力作為解釋。 Jain 與 Wallace 回報,在他們的模型中,注意力權重常與基於梯度的重要性量測不一致,而且非常不同的注意力分布可以得到相同預測 [19]。Wiegreffe 與 Pinter 則主張,注意力能否作為解釋取決於如何定義「解釋」,並提出檢驗方法 [20]。綜合來看:注意力圖顯示計算從哪裡讀取,對除錯遮罩與對齊很有用,但它本身不是模型為何做出某個決定的證據。
2023–2026 實務現況。 分組查詢注意力 [16] 與 IO 感知的精確注意力核心 [14],分別處理主導服務成本的兩件事:解碼時的鍵/值記憶體,以及注意力計算中的記憶體流量。RoPE [10] 與 ALiBi [11] 等相對位置方法的設計目標,是移除學得位置表的硬性最大長度。編碼器—解碼器 Transformer 仍很適合有明確來源與目標的任務,例如翻譯(NLP 08);開放式生成則以僅解碼器模型為主(NLP 09)。
開放問題。 可靠地使用極長上下文(較長視窗允許更多輸入,但不保證全部被利用)、超過訓練長度的長度泛化、長文件注意力的成本,以及忠實解讀注意力頭到底計算了什麼。
重點整理
- 單一上下文向量迫使整個來源通過固定大小的瓶頸;注意力讓每個輸出步驟都能讀取每個來源位置。
- Bahdanau 注意力用小型前饋網路評分;Luong 的 dot 與 general 評分把注意力化為矩陣乘法,直接引出查詢、鍵與值。
- 縮放內積注意力是 ;多頭注意力以約一個頭的成本執行 個較窄的副本。
- 自注意力讓序列與自己混合;交叉注意力讓解碼器讀編碼器。決定每個位置能讀什麼的是遮罩,而不是權重。
- 遮蔽填補鍵、在因果模型中遮蔽未來、讓損失遮罩分開處理,並用擾動檢查測試可見性。
- 注意力忽略順序;學得、正弦、相對、旋轉或 ALiBi 位置提供順序,各自有不同的長度契約。
- 注意力成本隨 成長;長上下文變體不是改變函數(稀疏、線性),就是更有效率地計算同一個函數(FlashAttention)。
練習
- 移除第 8 節資訊流範例的因果遮罩。哪一行輸出會改變?為什麼不使用遮罩訓練的語言模型仍可能有很低的訓練損失?
提示
改變的最後詞元能被較早位置讀取。低損失可能獎勵生成時根本不可取得的資訊。
- 在玩具句子程式碼中,於代名詞前加入第二個裝置名詞(「valve」)。
it的權重會怎樣?除了這些手動特徵之外,模型還需要什麼才能選對先行詞?
提示
特徵相同時,兩個裝置得到相同分數。位置資訊、動詞意義與篇章脈絡必須進入查詢或鍵,才能打破平手。
- 在因果解碼器中,為長度 3 與 5、填補到 5 的兩個目標序列批次設計注意力與損失遮罩。為每個序列寫出 的阻擋/允許表,並列出貢獻損失的目標位置。
提示
填補鍵不得貢獻上下文,填補目標不得貢獻損失。也要決定填補查詢列如何處理,避免全部被阻擋的 softmax 列。
- 對 、、 的模型,計算一個編碼器區塊與一個解碼器區塊的權重數(忽略偏差與層正規化)。編碼器區塊有多少比例在前饋網路?
提示
自注意力與交叉注意力各有 個權重;前饋網路有 個。解碼器比編碼器多一個注意力子層。
- 對序列長度 、 與 ,在 下比較 (注意力分數)與 (投影)。從哪個長度開始分數項占主導?
提示
兩項在 時相等。低於這個長度時,投影的成本高於分數計算。
- 說明 Luong 的「general」評分 為何是縮放內積注意力的特例。查詢、鍵與值投影分別是什麼?
提示
把 吸收進鍵投影。值投影是單位矩陣,縮放因子為 1。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapter 8, Manning, 2021. Publisher · Chapter 8
- I. Sutskever, O. Vinyals and Q. V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper
- K. Cho, B. van Merriënboer, C. Gulcehre, D. Bahdanau, F. Bougares, H. Schwenk and Y. Bengio, “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation,” EMNLP, 2014. Paper
- D. Bahdanau, K. Cho and Y. Bengio, “Neural Machine Translation by Jointly Learning to Align and Translate,” ICLR, 2015. Paper
- M.-T. Luong, H. Pham and C. D. Manning, “Effective Approaches to Attention-based Neural Machine Translation,” EMNLP, 2015. Paper
- A. Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. Paper
- J. L. Ba, J. R. Kiros and G. E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. Paper
- R. Xiong et al., “On Layer Normalization in the Transformer Architecture,” ICML, 2020. Paper
- P. Shaw, J. Uszkoreit and A. Vaswani, “Self-Attention with Relative Position Representations,” NAACL, 2018. Paper
- J. Su, M. Ahmed, Y. Lu, S. Pan, W. Bo and Y. Liu, “RoFormer: Enhanced Transformer with Rotary Position Embedding,” Neurocomputing 568, 2024. DOI
- O. Press, N. A. Smith and M. Lewis, “Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation,” ICLR, 2022. Paper
- I. Beltagy, M. E. Peters and A. Cohan, “Longformer: The Long-Document Transformer,” arXiv:2004.05150, 2020. Paper
- A. Katharopoulos, A. Vyas, N. Pappas and F. Fleuret, “Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention,” ICML, PMLR 119, 2020. Paper
- T. Dao, D. Y. Fu, S. Ermon, A. Rudra and C. Ré, “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” NeurIPS, 2022. Paper
- N. Shazeer, “Fast Transformer Decoding: One Write-Head is All You Need,” arXiv:1911.02150, 2019. Paper
- J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón and S. Sanghai, “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,” EMNLP, 2023. Paper
- Y. Tay, M. Dehghani, D. Bahri and D. Metzler, “Efficient Transformers: A Survey,” ACM Computing Surveys 55(6), 2022. DOI
- T. Lin, Y. Wang, X. Liu and X. Qiu, “A Survey of Transformers,” AI Open 3, 2022. DOI
- S. Jain and B. C. Wallace, “Attention is not Explanation,” NAACL, 2019. Paper
- S. Wiegreffe and Y. Pinter, “Attention is not not Explanation,” EMNLP-IJCNLP, 2019. Paper
- PyTorch,
TransformerEncoderLayerdocumentation. Documentation - PyTorch,
scaled_dot_product_attention文件,2.15 版,查閱日期 2026-11-05。文件 - PyTorch,
MultiheadAttention文件,2.15 版,查閱日期 2026-11-05。文件
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 08・以 Transformer 建構序列到序列模型(機器翻譯、聊天機器人) · 27 分鐘