Transformer — Attention Is All You Need
選讀・NLP 07・注意力機制與 Transformer 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
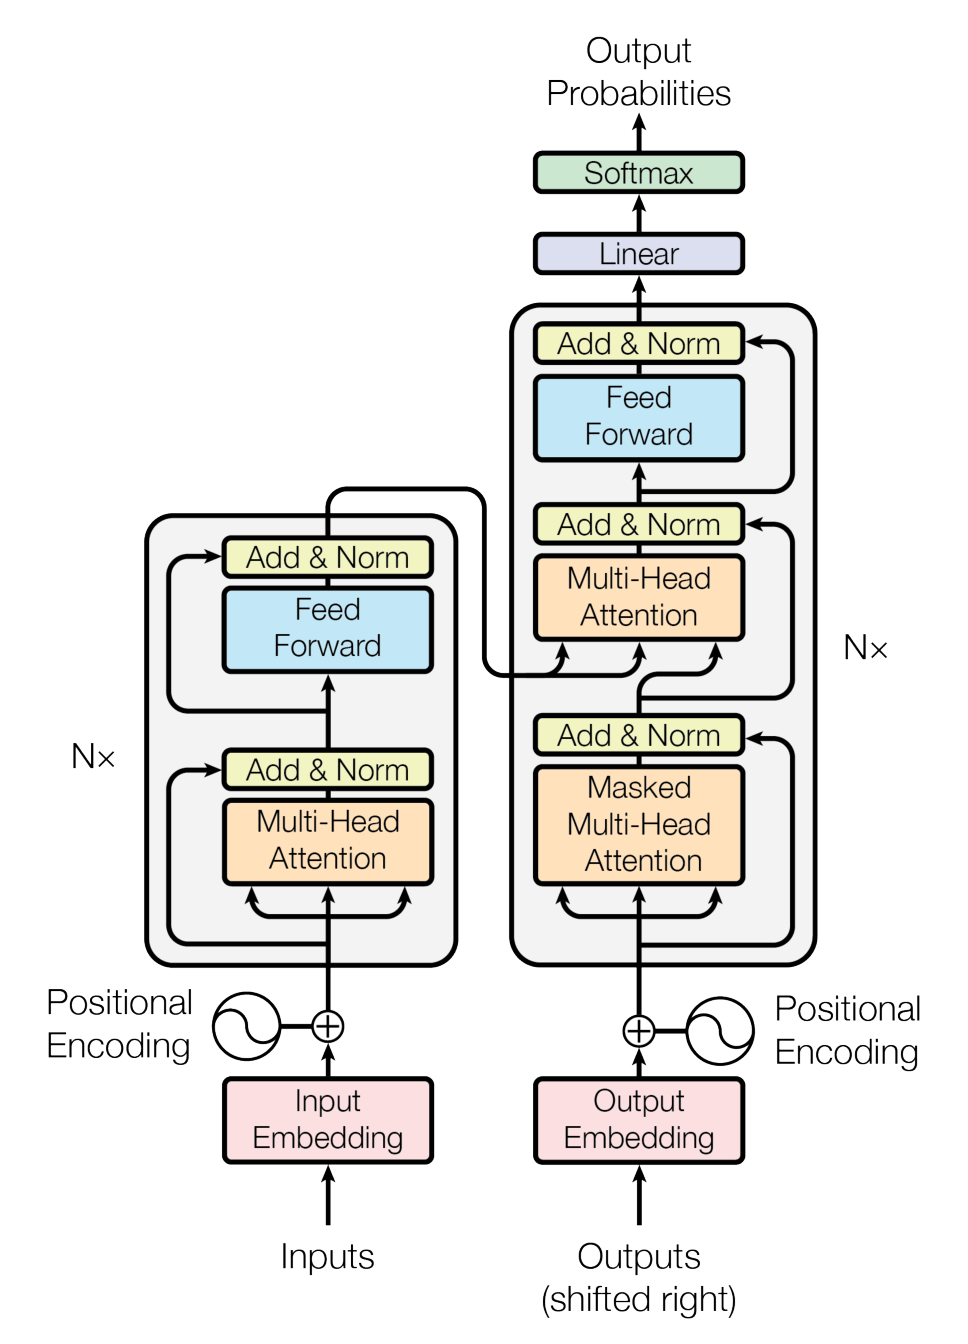
循環翻譯模型透過依序更新狀態傳遞資訊,限制訓練平行化,也拉長部分相依路徑。Vaswani 等人以注意力與逐位置前饋網路取代循環 [6]。論點在架構層次:注意力足以擔任編碼器—解碼器翻譯系統的資訊傳遞機制。先理解本章的 query、key、value 與遮罩,再把原圖讀成三種不同注意力路徑。
方法
單一注意力頭可寫成包含明確遮罩的形式:
包含查詢向量, 包含鍵向量, 包含值向量, 是查詢與鍵的維度。矩陣 在允許的查詢—鍵配對為零,禁止的配對為負無限大;softmax 對每個查詢所在列正規化。縮放避免維度增大時內積過大,使 softmax 過度飽和。多個學得的注意力頭在不同投影空間執行此操作,再合併輸出。
編碼器自注意力的三種輸入都來自編碼器狀態。解碼器自注意力都來自解碼器狀態,並遮住未來目標位置。交叉注意力的查詢來自解碼器,鍵和值則來自編碼器。位置資訊補上單靠注意力缺少的順序。殘差路徑、前饋子層與正規化構成完整區塊;原始版本在殘差相加之後正規化。
teacher forcing 訓練可以同時處理目標位置,因為右移的正確前綴加上因果遮罩,防止讀到未來標籤。生成時仍逐 token 自迴歸進行。因此,訓練可平行不表示能無限制地一次生成整段輸出。
結果
表 2 報告 newstest2014 翻譯分數:Transformer base 的英譯德為 27.3 BLEU,big 為 28.4;big 的英譯法為 41.0。評估使用檢查點平均,base 平均五個、big 平均二十個,並搭配束搜尋。與單一檢查點或貪婪解碼相比時,應註明這些條件。論文的效率主張針對其翻譯設定,不適用於所有序列長度或硬體。
消融與設計證據
表 3 在英譯德 newstest2013 開發集改變頭數、維度、前饋容量與正則化,且沒有檢查點平均。單頭注意力比最佳設定差,頭數過多也會退步。這些開發集分數不是表 2 的測試分數。標籤平滑可能改善 BLEU 卻使困惑度變差,說明較好的概似類指標不一定代表較好的解碼翻譯。
結論
閱讀時應能指出每個注意力區塊的查詢、鍵、值來自哪裡,再標示哪些位置被禁止。接著讀 NLP 08 的完整解碼行為,以及 NLP 10 如何把相同元件用於僅編碼器的預訓練。
問題與限制
密集注意力產生的 token 配對分數數量呈平方成長。遮罩與位置處理可能在不易察覺下改變任務,缺少因果遮罩更會在訓練時洩漏未來目標。注意力權重描述學得的計算,不保證是因果解釋。移除循環改變架構,沒有移除上下文限制、資料偏差,或長序列另行評估的必要。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapter 8, Manning, 2021. Publisher · Chapter 8
- I. Sutskever, O. Vinyals and Q. V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper
- K. Cho, B. van Merriënboer, C. Gulcehre, D. Bahdanau, F. Bougares, H. Schwenk and Y. Bengio, “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation,” EMNLP, 2014. Paper
- D. Bahdanau, K. Cho and Y. Bengio, “Neural Machine Translation by Jointly Learning to Align and Translate,” ICLR, 2015. Paper
- M.-T. Luong, H. Pham and C. D. Manning, “Effective Approaches to Attention-based Neural Machine Translation,” EMNLP, 2015. Paper
- A. Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. Paper
- J. L. Ba, J. R. Kiros and G. E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. Paper
- R. Xiong et al., “On Layer Normalization in the Transformer Architecture,” ICML, 2020. Paper
- P. Shaw, J. Uszkoreit and A. Vaswani, “Self-Attention with Relative Position Representations,” NAACL, 2018. Paper
- J. Su, M. Ahmed, Y. Lu, S. Pan, W. Bo and Y. Liu, “RoFormer: Enhanced Transformer with Rotary Position Embedding,” Neurocomputing 568, 2024. DOI
- O. Press, N. A. Smith and M. Lewis, “Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation,” ICLR, 2022. Paper
- I. Beltagy, M. E. Peters and A. Cohan, “Longformer: The Long-Document Transformer,” arXiv:2004.05150, 2020. Paper
- A. Katharopoulos, A. Vyas, N. Pappas and F. Fleuret, “Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention,” ICML, PMLR 119, 2020. Paper
- T. Dao, D. Y. Fu, S. Ermon, A. Rudra and C. Ré, “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” NeurIPS, 2022. Paper
- N. Shazeer, “Fast Transformer Decoding: One Write-Head is All You Need,” arXiv:1911.02150, 2019. Paper
- J. Ainslie, J. Lee-Thorp, M. de Jong, Y. Zemlyanskiy, F. Lebrón and S. Sanghai, “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,” EMNLP, 2023. Paper
- Y. Tay, M. Dehghani, D. Bahri and D. Metzler, “Efficient Transformers: A Survey,” ACM Computing Surveys 55(6), 2022. DOI
- T. Lin, Y. Wang, X. Liu and X. Qiu, “A Survey of Transformers,” AI Open 3, 2022. DOI
- S. Jain and B. C. Wallace, “Attention is not Explanation,” NAACL, 2019. Paper
- S. Wiegreffe and Y. Pinter, “Attention is not not Explanation,” EMNLP-IJCNLP, 2019. Paper
- PyTorch,
TransformerEncoderLayerdocumentation. Documentation - PyTorch,
scaled_dot_product_attention文件,2.15 版,查閱日期 2026-11-05。文件 - PyTorch,
MultiheadAttention文件,2.15 版,查閱日期 2026-11-05。文件