NLP 11・以 BERT 做分類(情感分析、自然語言推論)
先備知識:NLP 10・預訓練模型:BERT
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 依決策型態選擇輸出頭:一個標籤、每個詞元一個標籤,或文章中的一段區段。
- 為情感分析與前提—假說推論微調預訓練編碼器,並了解標準資料集(SST、IMDB、SNLI、MultiNLI、SQuAD)實際包含什麼。
- 辨識標註痕跡(annotation artifacts)、只看假說的基準與挑戰集,理解為何分布內高分可能掩蓋捷徑。
- 有意識地設定學習率、訓練輪數、暖身、類別權重與決策門檻,並知道微調為何可能不穩定。
- 以準確率、macro-F1、校準與覆蓋率評估,並區分相關證據與充分證據。
- 在 CPU 上從頭以遮罩語言模型預訓練一個微小編碼器,再微調於合成情感與推論任務。
先看全貌
NLP 10 建立了 BERT:以預測被遮住詞元來預訓練的雙向編碼器。預訓練給的是一個表示函數,不是一個應用。客服團隊仍要說明「緊急」是什麼意思,推論資料集仍要規定一句話何時可由另一句推出。本章處理第二步:在編碼器上接一個小輸出層,用標註樣本同時訓練兩者,再檢查結果解決的是預期任務,而不是一個方便的仿冒品。
本章有兩類主要決策。單一文字分類替一個輸入指定一個標籤:正面或負面情感、主題、工單路徑。文字對分類標註兩個輸入之間的關係:假說是否可由前提推出、與前提矛盾,或兩者皆非?擷取式問答與它們相鄰:模型不是輸出一個標籤,而是選擇答案在文章中從哪裡開始、到哪裡結束。三者都重用同一個預訓練編碼器,只有輸出頭與訓練標籤不同 [3]。
Hagiwara 第 9 章正是針對這些應用討論以預訓練編碼器進行遷移學習 [1];McRoy 關於基準任務以及資訊擷取與論證的章節則提供語言學觀點 [2]。全程請記住一個問題:什麼證據能說服懷疑者,模型學到的是任務,而不是資料集?
BERT 的應用:選擇輸出頭
直觀說法。 任務頭把編碼器的詞元向量轉成需要的答案。先決定答案是一個類別、每個詞元各一個標籤,還是文章中的一段文字。
| 應用 | 輸入 | 監督輸出 |
|---|---|---|
| 情感、主題或客服工單分類 | 一段文字 | 由池化 [CLS] 狀態預測一個類別 |
| 蘊涵、改寫或查詢—文件相關性 | 一起打包的兩段文字 | 關係標籤或相關性分數 |
| 實體識別或其他詞元標記 | 已分詞的文字 | 每個受監督詞元位置的標籤 |
| 擷取式問答 | 問題與文章 | 文章中的起點與終點 |
| 使用 Sentence-BERT 的語意檢索 | 分開編碼的文字 | 以句子層級目標學得的可比較向量 |
序列與詞元任務使用 BERT 論文描述的表示 [3];原始分類與區段實作明確呈現輸出形狀 [4]。Sentence-BERT 則加入句子比較的訓練 [20]。以下公式說明這些選擇各自計算什麼。
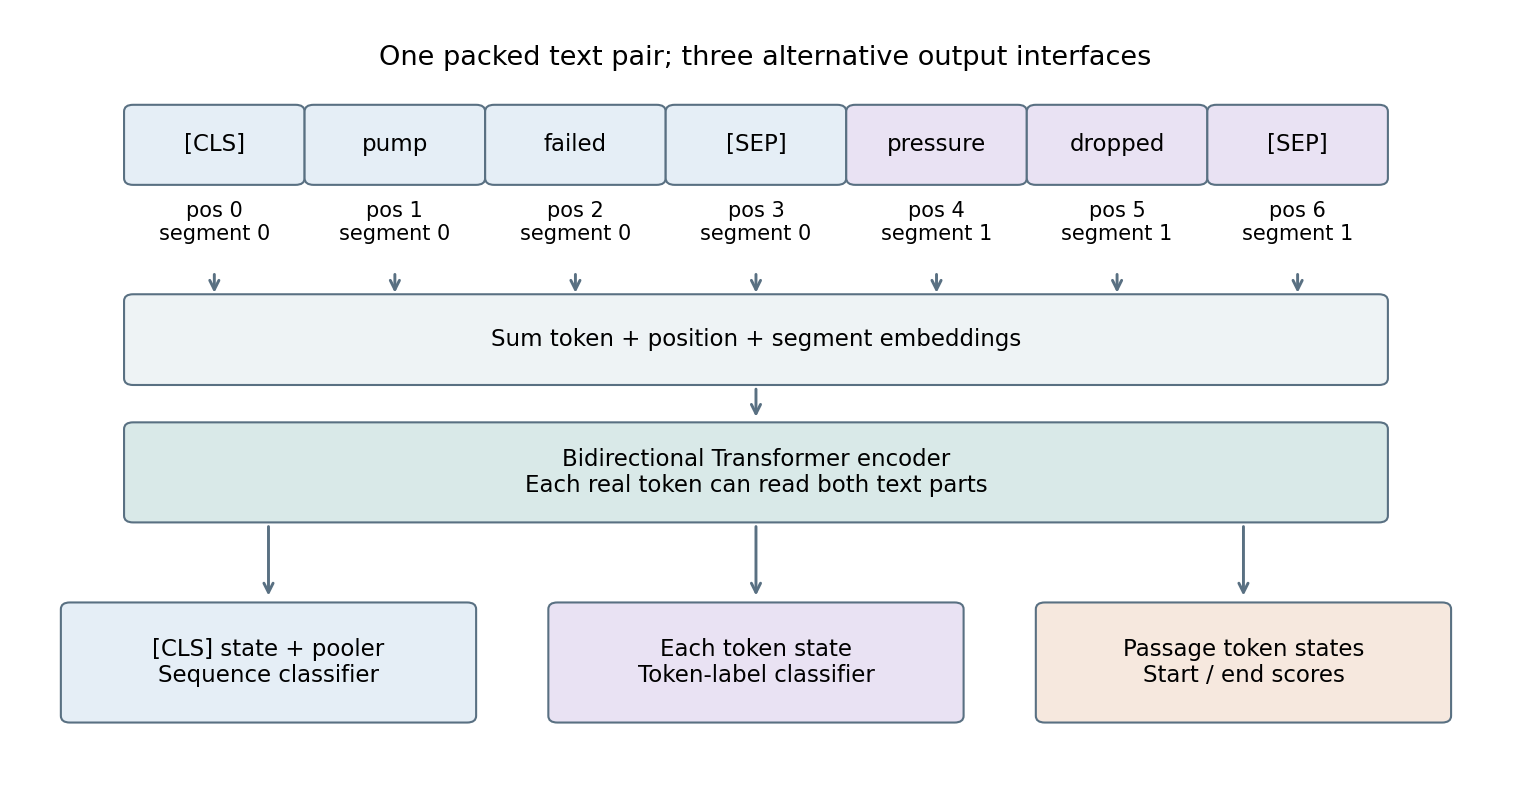
序列分類與文字對決策
對有 個類別的分類器,一種常見 BERT 介面是:
其中 是打包後的詞元序列; 是第一個上下文輸出列; 與 組成池化器; 是池化輸出; 與 組成分類器; 表示類別 。端到端微調時,標註類別的交叉熵同時更新任務頭與編碼器 [4]。
對「the pump failed」,工單分類器可預測事故類別。對前提—假說文字對,相同輸出形狀可表示蘊涵、矛盾或兩者皆非。這些標籤來自任務資料集,不是預訓練時下一句預測(NSP)的標籤詞彙。文字對自注意力讓一段文字的詞元在最終決策前,先讀取另一段文字。
詞元標記
替每個上下文輸出列接上分類器:
其中 是詞元位置, 是標籤數量; 與 由所有位置共用; 是詞元標籤; 是標註值; 是納入監督的非空位置集合。設備名稱若被拆成多個 WordPiece,就需要一致規則:只監督第一個片段、忽略其他片段,或把標籤一致地映射到各片段。 不應包含填補與特殊標記。推論時,再把預測片段映射回詞或字元區段,細節見 NLP 06。NLP 12 的語意角色標註會以加上述詞標記的方式重用同一個任務頭。
擷取式問答
假設文章寫「Pump B stopped at noon」,問題是「Which pump stopped?」。把問題與文章一起打包、編碼,再替可能的答案邊界評分:
其中 是候選起點與終點位置; 是學得的起點與終點向量; 是邊界分數; 是在允許位置上計算的 softmax 分布; 是標註的答案邊界。解碼時,在 與指定最大長度下,選取使 最大的合法區段 [4]。問題位置與填補不能當成文章答案回傳。若加入「沒有答案」標記,也必須訓練此選項,並以開發資料選擇決策門檻。
BERT 論文為這個任務只新增兩個向量:起點向量與終點向量;每個邊界機率都是它與最終詞元狀態的內積,再對文章位置取 softmax [3]。圖 2 說明為何解碼必須聯合進行,而不是各自取兩次 argmax:最佳起點與最佳終點必須構成合法區段。在這組合成分數中,分數最高的合法區段是「Pump B」。
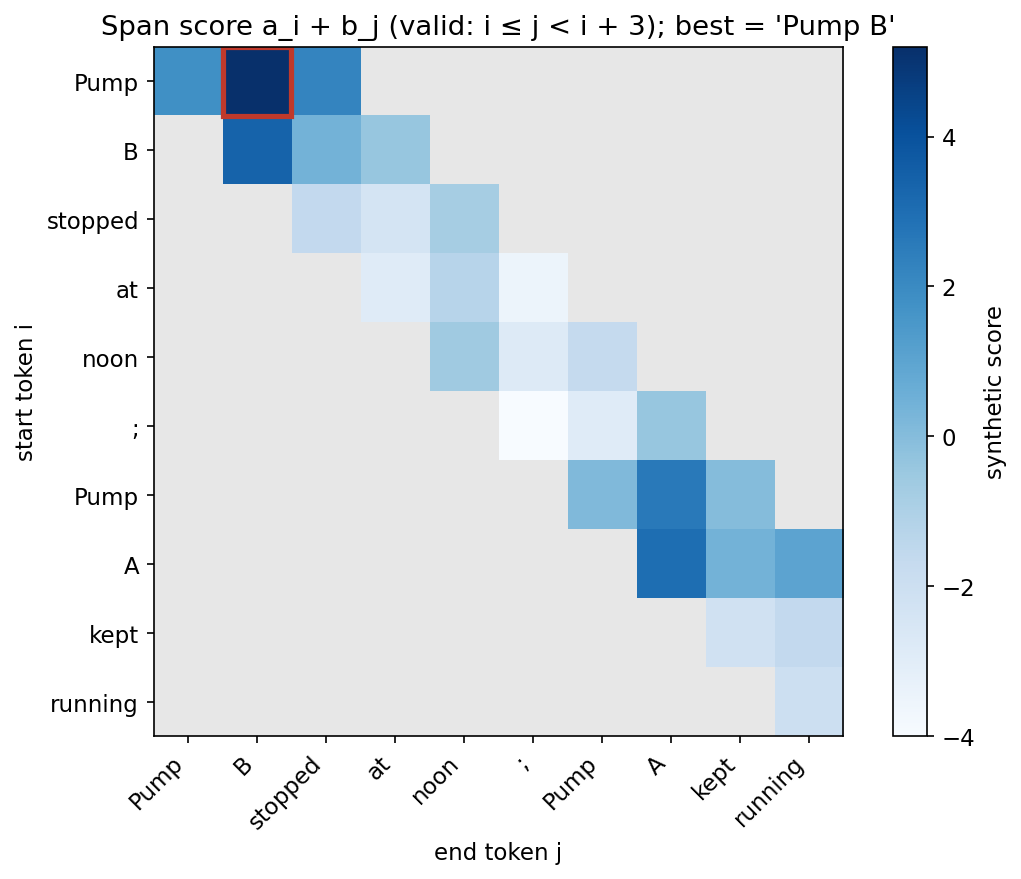
輸出會是「Pump B」這類文章文字。這個設定不會生成解釋,也不會找出尚未取得的文章。NLP 09 的檢索增強生成處理找文章的問題;下方關於可回答性的小節則處理:找到的文章是否足夠。
檢索:聯合評分,還是可重用向量?
聯合 BERT 相關性模型把查詢與候選一起打包,因此候選表示依賴這次查詢;換一對文字就要重新執行。句子嵌入模型則分開編碼文件,允許快取。Sentence-BERT 以配對或三元組句子目標訓練第二種介面 [20]。原始預訓練 [CLS] 向量或任意平均池化,不會自動形成經過良好訓練的餘弦檢索空間。
實際系統的一種設計是先用分開儲存的向量召回候選,再聯合評分較少的查詢—候選文字對。應分別評估檢索階段的候選召回與最終排序器。NLP 04 說明池化與相似度,NLP 09 展開完整檢索流程。
單一文字分類:情感分析
直觀說法。 情感分析判斷一段文字表達正面或負面意見。看似簡單,但否定、轉折與混合意見都表示:只數好話與壞話並不夠。
在 個標註樣本上寫出微調目標:
其中 是由預訓練初始化的編碼器參數; 是隨機初始化的任務頭參數; 是第 段打包文字; 是其標籤; 是上面定義的分類分布。完整微調同時更新 與 。凍結 、只訓練 比較便宜,但只能重用凍結特徵本來就具備的區分。
兩個基準資料集,以及它們量測什麼
Stanford Sentiment Treebank(SST) 包含 11,855 個取自影評的單句;作者剖析這些句子,並請標註者標記剖析樹中全部 215,154 個不重複片語 [5]。片語層級標籤讓研究者能觀察情感如何組合:「not」與「good」組成的片語有自己的標籤。論文同時報告細粒度(五類)與二元的句子層級結果 [5]。GLUE 後來把二元版本收錄為 SST-2,列出約 67k 個訓練樣本與 1.8k 個測試樣本,以準確率評估 [14]。最初的 SST 模型是建立在剖析樹上的遞迴網路;ML 04 說明這類架構。
Maas 等人的 IMDB 影評資料集含 50,000 則評論,平均分為 25,000 則訓練與 25,000 則測試,另有 50,000 則未標註評論;標註任務是類別平衡的二元問題 [6]。它的單位是整篇評論,不是一句話。評論常比短編碼器視窗長,因此文件分類器需要明確的截斷或分塊政策:保留開頭、保留結尾,或在多個視窗上彙總預測。每種政策回答的問題略有不同,因為評論常在結尾改變語氣。
這兩個資料集說明一個反覆出現的問題:監督單位定義了任務。只用獨立意見句訓練的句子情感模型,可能無法處理包含引述、修正與多位說話者的完整對話。如果部署可以查看先前回合,標註與訓練也應包含相同的允許脈絡。反過來,標註者如果看得到最後處理結果,但模型只看得到第一則訊息,就可能產生模型根本無法判定的目標。NLP 03 以計數式分類器詳細說明這份預測約定,換成 BERT 後同樣適用。
上下文編碼器增加了什麼,又沒有增加什麼
詞袋分類器在「the battery is good」與「the battery is not good」中給「good」相同權重。上下文編碼器則在兩句中替「good」算出不同向量,所以任務頭原則上能學會反轉。NLP 03 以計數特徵做了受控否定測試,顯示稀疏證據會讓這種反轉無法確定。上下文讓區別可以被表示;標註資料仍必須讓它可以被學到。片語身分也不同於作用範圍:區分「not every repair succeeded」與「every repair failed」需要組合性的區別,相鄰詞特徵無法提供;微調後的編碼器也只有在訓練資料包含這種區別時才會學到。
情感標籤本身也是標註決策。一則評論可能稱讚螢幕、批評電池。單一標籤情感分析強迫這則評論歸入一類;面向式情感分析則把意見指派給目標。兩者都不是「唯一正確」的任務,應選擇應用實際使用其輸出的那一種。
文字對:自然語言推論
直觀說法。 文字可以支持某個結論,卻未必證明它在現實中為真。文字蘊涵與證據品質要分開。
自然語言推論(natural language inference,NLI)依標註慣例,把前提與假說分為蘊涵、矛盾或中立。若前提是「Mina 修了一個感測器」,通常可推出「有人修了某樣東西」,卻推不出「Mina 修了所有感測器」;「Mina 沒有修任何感測器」則與前提衝突。
對 BERT,把文字對打包成 [CLS] premise [SEP] hypothesis [SEP],片段 ID 分別為 與 ,再套用 的序列任務頭:
其中 是前提詞元序列, 是假說詞元序列, 分別表示蘊涵、中立與矛盾,其他符號與序列分類頭相同。因為自注意力跨越 [SEP] 邊界,每個假說詞元在每一層都能注意每個前提詞元。這種聯合編碼讓決策能依賴兩段文字逐詞元的比較;這也是文字對模型無法快取其中一側的原因。
SNLI 與 MultiNLI
Stanford Natural Language Inference(SNLI) 語料含 570,152 組人工撰寫的句對,標記為蘊涵、矛盾與語意獨立(中立)[7]。標註者看到一則圖片說明作為前提,再撰寫假說。論文討論一個細微的標註選擇:是否假設兩句描述同一事件。若不做此假設,許多看似矛盾的句對就會是中立。語料固定一種慣例,讓每組句對只有一個標籤 [7]。你替自己的推論資料做的,正是這類必須明文記錄的決策。
MultiNLI 把設計擴展到十種書面與口語英語文類、共 433k 個樣本。訓練集只出現五種文類,因此開發集與測試集分成來自訓練文類的 matched 部分,以及來自其他文類的 mismatched 部分 [8]。這種切分把領域偏移變成可量測的量,而不是事後想到的問題。
標註痕跡與只看假說的基準
被要求寫出矛盾句的群眾標註者,常使用相同手法:否定詞,或換一個活動。Gururangan 等人顯示,一個只看假說的簡單文字分類器,能在 SNLI 約 67%、MultiNLI 約 53% 的資料上預測正確標籤,且否定與模糊等現象與特定類別高度相關 [9]。Poliak 等人在十個 NLI 資料集上執行只看假說的基準,發現它在其中多個資料集上顯著勝過多數類別基準 [10]。忽略前提的模型不可能在做推論,所以它的分數量測的是資料集規律。
McCoy、Pavlick 與 Linzen 從相反方向著手:他們建立 HANS,一組受控資料,讓三種句法啟發法——詞彙重疊、子序列與成分——給出錯誤答案,並發現在 MNLI 上訓練的模型(包括 BERT)在其上表現很差 [11]。這些研究合起來支持兩個習慣:
- 一定要跑部分輸入基準。 若只看假說(或只看前提、只看問題)的模型表現良好,基準分數就有一部分與你在意的關係無關。
- 建立翻轉線索的挑戰句對。 固定詞彙,只改變一個應該重要的區別:角色反轉、否定出現在前提而非假說、可能性與斷言、指控與事實、一個與全部。
推論模型預測的是標註關係,不會獨立驗證前提。若前提是編造的,獲得蘊涵的假說也可能是編造的。因此,結合檢索的應用需要來源選擇,也需要回答支持檢查;下方問答小節會繼續討論。
論證擷取可辨識主張、提出的支持陳述與明說的攻擊關係 [2]。「裝置可靠,因為它通過了一次測試」具有可辨識的論證結構,但辨識結構不代表測試具有代表性,也不表示結論有效。應用可以儲存陳述的理由,並把其證據強度標為尚未評估。
有用的挑戰句對一次改變一個關鍵差別。流暢改寫也是有用變化,但應保留原本標籤。合成改寫若改變作用範圍或刪除歸屬,就必須重新標註,不能自動繼承原紀錄。
選讀:Sentence-BERT(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
把擷取式問答視為文字對任務:答案需要支持
直觀說法。 SQuAD 式問答要求模型在給定文章中指出答案。實務上更難的問題是:文章裡到底有沒有受支持的答案。
Stanford Question Answering Dataset(SQuAD) 含 107,785 組由群眾標註者針對 536 篇維基百科文章撰寫的問答;每個答案都是對應段落中的一段區段 [12]。它的兩個指標都忽略標點與冠詞 a、an、the:完全符合(exact match) 是預測與任一參考答案完全相同的比例;F1 量測預測與參考答案的詞元重疊,再對問題平均 [12]。部分給分很重要,因為標註者的分歧大多出現在區段邊緣不重要的詞上。
SQuAD 2.0 加入超過 50,000 個刻意寫得與可回答問題相似的不可回答問題;系統還必須判斷段落何時不支持任何答案並拒答 [13]。BERT 論文的作法是把不可回答問題視為起點與終點都在 [CLS] 的區段。預測時比較空答案分數 與最佳非空區段分數 ,只有在 時才回答 [3]。其中 是在開發集上選來最大化 F1 的門檻。這一個門檻就把區段模型變成選擇性回答器。
本機證據式回答器
不用訓練好的區段模型,也能示範回答契約。下面的回答器只處理一個明確問題家族,回傳來源區間。它以 TF–IDF 為四個合成段落排序,再只回答 Pump A 的狹義溫度上限問題。程式保留單字元詞,讓裝置代碼 A 仍是特徵。函數不是通用意圖分類器,呼叫者必須把已聲明的問題家族路由給它。
程式碼 · Python · 33 行
import re
from sklearn.feature_extraction.text import TfidfVectorizer

corpus = {
    'temperature-v2': 'Pump A temperature limit is 80 C. This policy is current.',
    'shutdown-v1': 'Pump A shutdown follows a vibration alarm.',
    'label-v1': 'A technician replaced the cabinet label.',
    'sensor-v1': 'Sensor B reports humidity once per hour.',
}
ids = list(corpus)
vectorizer = TfidfVectorizer(ngram_range=(1, 2), token_pattern=r"(?u)\b\w+\b")
D = vectorizer.fit_transform([corpus[key] for key in ids])
def rank(query):
    score = (D @ vectorizer.transform([query]).T).toarray().ravel()
    order = sorted(range(len(ids)), key=lambda i: (-score[i], ids[i]))
    return [(ids[i], float(score[i])) for i in order]

def answer_temperature(query):
    if not re.search(r'\bpump\s+a\b', query, flags=re.I):
        return {'answer': None, 'reason': 'unsupported entity'}
    key, score = rank(query)[0]
    text = corpus[key]
    pattern = r'Pump A temperature limit is (\d+) C\.'
    match = re.search(pattern, text)
    if not match:
        return {'answer': None, 'reason': 'no matching evidence'}
    evidence = text[match.start():match.end()]
    result = {'answer': f'{match.group(1)} C', 'document': key,
              'start': match.start(), 'end': match.end(), 'evidence': evidence}
    assert text[result['start']:result['end']] == result['evidence']
    return result
print(answer_temperature('What is the Pump A temperature limit?'))
print(answer_temperature('What is the Pump Z temperature limit?'))
Pump A 回傳受支持的 80 C、文件版本與字元區間 0–33。即使存在溫度相關段落,Pump Z 問題仍回傳 unsupported entity。在 SQuAD 式資料上訓練的區段任務頭會以學得的邊界分數取代正規表示式,但周邊契約——實體檢查、證據區間、驗證過的位移、明確拒答——應該保留。
明確實體檢查避免高詞彙分數把 Pump A 的上限移植到沒有支持的裝置。證據表達式也要求來源說出預期關係,而非只含一個數字。更彈性的系統需要更完整的實體與關係檢查,包括範圍、單位及適用日期。應透過標註測試擴充能力,不要放寬到所有問題都收到答案。
回答器只看最高段落,因此正確證據排在後面時會拒答。這個限制刻意保留並說明。後續版本可以在固定預算內檢查多個候選,記錄最終用了哪個。要同時量測受支持回答與錯誤接受。
函數保留證據切片並驗證位移,可抓出序列化錯誤,卻不能抓全部語意錯誤。引用句仍可能談錯裝置、過期政策或假設情況。精確引文是重要機械檢查,支持關係仍是契約另外一部分。
相關不代表可回答
段落可以討論主題,卻缺少所問事實。系統應能有意義地回傳證據不足。
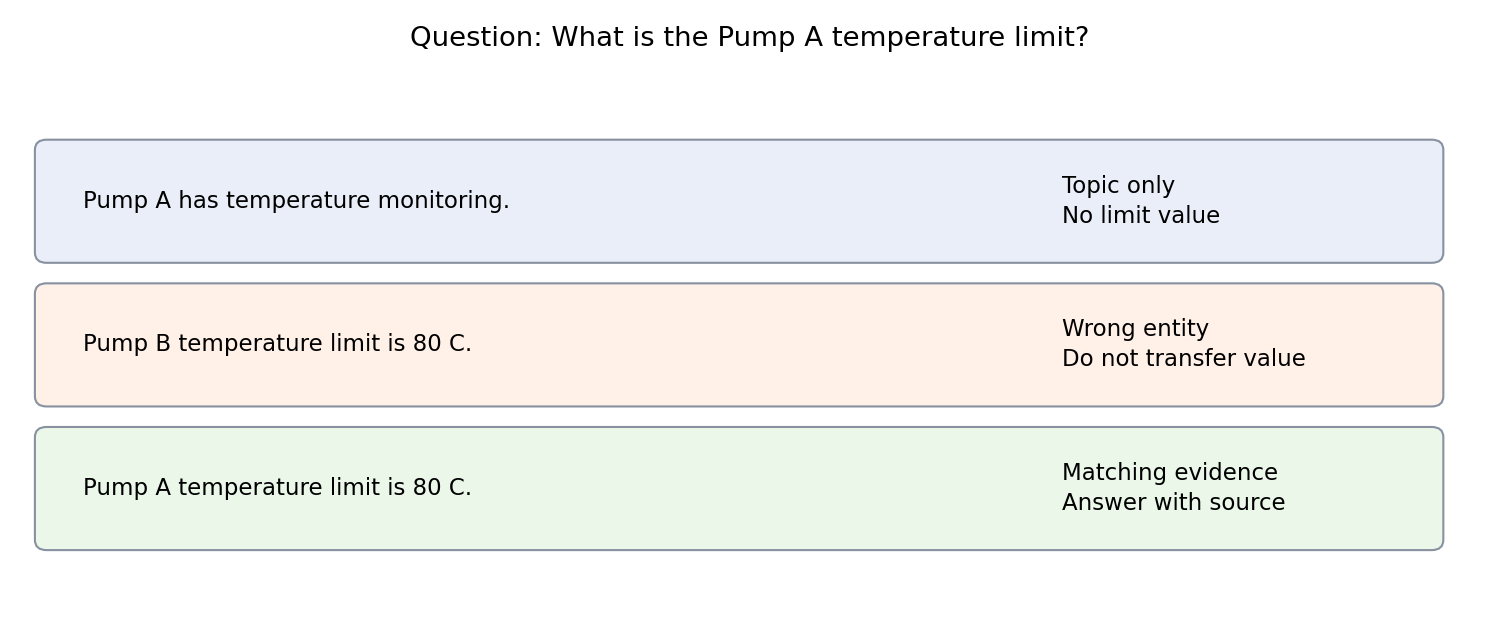
狹義問題應先定義必要欄位,再評估系統。溫度範例需要裝置身分、上限關係、數值與單位,也可能需要生效日期或操作條件。即使段落第一名,只要少一個必需欄位,證據仍可能不足。
拒答政策決定何時不回答或請求澄清。若使用信心分數,門檻應在開發資料依錯答與不必要覆核的成本選擇——正是 SQuAD 2.0 任務頭中 的角色。原始相似度不是校準後的正確機率;語料、分詞器或嵌入模型改變時,尺度也可能改變。
同時報告覆蓋率與接受回答的品質:
其中 是評估問題數; 是收到回答的數量; 是依契約判正確的接受回答數。沒有接受回答時,接受準確率未定義;應回報此情況,不能把零接受當成成功準確率。
覆蓋率必須包含沒有可用答案的問題。否則只在處處有答案的集合上,永遠回答的系統也會好看——這正是 SQuAD 2.0 要揭露的弱點 [13]。應納入錯誤實體、缺少值、來源衝突與不支援的時間範圍,測試模型是否認知證據限制,而非只產生可能的區段。
用受控替換診斷失敗
把一個不完美元件換成已知正確輸入,就能找到答案在哪裡失敗。診斷結果應與端到端部署分數分開。
先直接提供標註支持段落給回答器。如果仍答錯值,檢索就不是直接原因;應查實體、單位、範圍與文字實現。如果正確證據能答對,檢索證據卻失敗,就查候選召回與段落次序。這能定位瓶頸,但不假裝部署時也會有完美證據。
接著保留正確段落,加入無關或衝突段落。只有額外上下文才造成失敗,表示是內容選擇或證據整合問題。一次改一個性質:另一裝置、過期版本、引述指控或未授權指令。執行前先標預期行為,避免看到結果後改解釋替輸出辯護。
受支持答案需要一串成功決策。對適用證據已存在語料中的問題,可寫成:
其中 表示機率, 是充分證據保留於檢索結果的事件, 是正確解讀證據的事件, 是輸出忠實實現解讀的事件。這是機率鏈式法則,不是假設獨立。把互不相干的無條件階段分數相乘並不等價:閱讀器在人工挑選簡單文章上的準確率,可能不同於在檢索器實際候選上的準確率。
以下人工評估讓條件關係看得見:
程式碼 · Python · 12 行
import numpy as np

retrieved = np.arange(100) < 80
interpreted = np.arange(100) < 72
realized = np.arange(100) < 68
r = retrieved.mean()
e = interpreted[retrieved].mean()
g = realized[retrieved & interpreted].mean()
complete = (retrieved & interpreted & realized).mean()
print('Conditional stage rates:', round(r, 3), round(e, 3), round(g, 3))
print('Complete supported answers:', round(complete, 3))
assert np.isclose(r * e * g, complete)
階段比例為 0.8、0.9、0.944,完整成功率卻為 0.68。這是合成結果,不是系統效能報告。各元件表現看似不錯,完整答案仍未必同樣可靠。最後保留真實查詢分布:診斷套件刻意提高困難案例比例,代表性保留集合則估計一般行為。兩者應分開報告目的,不要混成一個總分。
基準:GLUE 與 SuperGLUE
直觀說法。 基準套件讓一個預訓練模型跑過許多小任務並彙總結果。它適合比較通用編碼器,卻不擅長告訴你自己的應用是否可行。
GLUE 收錄九個英語理解任務——單句任務(語法可接受度與 SST-2 情感)、相似度與改寫任務,以及包含 MNLI 在內的推論任務——並附上一個針對特定語言現象的診斷資料集與線上排行榜 [14]。它的資料集都不是為此基準從頭建立,部分任務保留私有測試標籤,以確保排行榜被公平使用 [14]。各任務指標不同:SST-2 用準確率,改寫任務用準確率與 F1,句子相似度用 Pearson 與 Spearman 相關係數,類別不平衡的可接受度任務用 Matthews 相關係數 [14]。BERT 論文的主要遷移結果報告在 GLUE、SQuAD 與一個常識推論資料集上 [3]。
SuperGLUE 保留 GLUE 的設計——圍繞八個任務的排行榜、單一彙總分數與分析工具——但挑選更困難的任務,包括針對段落的是非問答,以及嵌入子句上的三類蘊涵 [15]。
讀套件平均分數要小心。它混合了規模、指標與雜訊程度不同的任務,提升可能只來自某個小任務。除非同時報告部分輸入基準與挑戰集,否則它對標註痕跡一無所知;除非你的領域就在其中,否則它也不能說明你的領域。用套件挑選起始檢查點,用自己的保留資料挑選系統。
微調實務
直觀說法。 微調是從好權重出發的短期監督訓練。主要風險是學習率太大而破壞預訓練所學、更新次數太少或太多、隨機種子運氣不好,以及類別比例或標籤意義與部署不同的資料。
學習率、訓練輪數與排程
BERT 作者把 dropout 固定在 0.1,並報告以下範圍在其任務上普遍有效:批次大小 16 或 32;Adam 學習率 、 或 ;訓練 2、3 或 4 輪 [3]。他們也觀察到,大型資料集(十萬筆以上標註樣本)對這些選擇遠不如小型資料集敏感 [3]。釋出的分類程式預設學習率 、三輪、最大序列長度 128、暖身比例 0.1 [4]。其最佳化器排程為:
其中 是第 次更新的學習率; 是設定的峰值; 是總訓練步數; 是暖身步數,為 的固定比例。同一實作對層正規化與偏差以外的參數施加 0.01 的權重衰減,並把全域梯度範數裁剪在 1.0 [4]。這類解耦權重衰減的最佳化器一般稱為 AdamW [26]。
為什麼學習率這麼小?每次更新都在移動編碼了有用區別的預訓練權重。適合從隨機初始化訓練網路的學習率,可能在幾百步內就把它們抹除,之後模型實際上只是從少量標註資料學習。
不穩定與隨機重啟
對 BERT-LARGE,原作者發現在小型資料集上微調有時不穩定;他們進行數次隨機重啟——保留同一預訓練檢查點,只改變資料洗牌與分類層初始化——再依開發集選出最佳模型 [3]。Mosbach、Andriushchenko 與 Klakow 分析 BERT、RoBERTa 與 ALBERT 在 GLUE 任務上的這種不穩定。他們把失敗的執行歸因於訓練早期的最佳化困難,特徵是梯度消失;其餘變異則來自訓練損失幾乎相同的執行之間的泛化差異 [16]。他們沒有在 BERT-BASE 上觀察到這種不穩定。他們對小型資料集的建議是:使用含 Adam 偏差修正的小學習率,並大幅增加迭代次數,訓練到接近零的訓練損失 [16]。
實務教訓:報告多個種子的分布,而不只報告最好的種子,且只依開發資料選擇。一次幸運的執行不是方法。
類別不平衡
真實標籤分布很少平衡。類別加權改變每個訓練樣本的貢獻:
其中 是加權交叉熵, 是訓練樣本數, 索引樣本, 是文件, 是標註類別, 是該類別的權重, 是分類器分布。加權政策改變訓練目標,但不能創造缺少的語言多樣性。
加權、過度取樣與門檻調整回答不同問題。加權改變參數學習;過度取樣改變呈現頻率,有時只是不斷重複少數類別中的同幾個樣本;門檻調整則在分數算出後改變行動政策。Hagiwara 的開發章節討論不平衡與訓練選擇 [1]。任何介入都應以真實類別盛行率評估,而不是以人為平衡的最終測試集評估。
校準
分類器可能選對標籤,卻提供不可靠的機率。校準(calibration)檢查預測信心是否與相似樣本的觀察正確率一致。模型可以保留 argmax 決策,同時改變信心。Guo 等人研究這個差別與訓練後的溫度縮放 [17]:
其中 是 logit 向量, 是在保留開發資料上最小化負對數概似所擬合的單一溫度, 是縮放後的分布;對期望校準誤差 ,樣本依信心分成 個區間 , 是樣本數, 是區間 內的準確率, 是其平均預測信心。所有 logit 除以同一個正數不會改變大小次序,因此溫度縮放不可能改變準確率。
Desai 與 Durrett 在 NLI、改寫偵測與常識推理上量測 BERT 與 RoBERTa。直接使用時,預訓練模型在領域內是校準的,且領域外校準誤差低於他們比較的基準;溫度縮放進一步降低領域內誤差,標籤平滑則有助於領域外 [18]。這是那些任務與模型的性質,不保證你的微調檢查點也如此。只要機率會驅動拒答之類的行動,就應在自己的開發資料上量測校準。
評估:準確率、macro-F1 與選擇性決策
直觀說法。 準確率計算答對多少。Macro-F1 讓每個類別同等重要,罕見類別因此無法被忽略。選擇性指標則問:系統可以拒答時,被接受的答案有多好。
把一個類別視為正類時:
其中 是精確率(precision), 是召回率(recall), 是真陽性數, 是偽陽性數, 是偽陰性數, 是精確率與召回率的調和平均。分母為零時,必須明確選擇慣例。Macro F1 平等平均各類別 F1;依樣本數加權的平均則讓常見類別影響較大。指標文件說明這些選擇 [19]。
對 SST-2 或 IMDB 這類平衡任務,準確率已足夠 [6]、[14]。三類 NLI 也應報告各類別 F1:模型可能準確率不錯,卻混淆中立與矛盾。對偏斜任務,macro-F1 或 Matthews 相關係數讓罕見類別的失敗比較容易看見,但兩者都不代表失敗的實際成本。漏掉緊急客服案件與誤送一般收據,可能有不同後果。應另外寫出成本政策,而不是把方便計算的分數當成完整效用。
選擇性預測可寫成:
其中 是評估樣本數, 表示是否接受第 個樣本, 是預測, 是參考標籤, 在條件成立時為一,否則為零。如果沒有接受任何樣本,接受風險便未定義。風險與涵蓋率曲線呈現不同門檻下的取捨;部署門檻應依驗證資料選擇,而不是依最終測試標籤選擇。
接著閱讀錯誤。建立錯誤表,包含文字、標準標籤、預測標籤、機率、語言、長度、來源群組與分析者的解釋。實用錯誤類型包括標註歧義、缺少脈絡、否定、未見詞彙、多主題輸入、引述,以及確實超出範圍的文字。不同類型需要不同修正。更多訓練樣本可能改善未見詞彙,卻無法補上預測時永遠拿不到的對話回合。ML 11 涵蓋一般的評估與監測工具。
把模型與前處理產物一起保存。分詞器與詞彙表、最大長度與截斷政策、標籤順序、校準溫度與決策門檻,共同構成推論套件。以另一個分詞器載入權重,會默默改變意義。套件應保存有版本的標籤結構與幾個確定性介面範例,讓服務可以檢查假設。
可執行實驗:先預訓練,再微調
直觀說法。 我們在一個微小的未標註語料上,以遮罩語言模型從頭預訓練一個兩層編碼器,再為情感任務與 NLI 任務微調。資料是合成的,因此實驗示範的是機制,不是基準效能。
實驗設計分離出三個問題:
- 預訓練能遷移嗎? 未標註語料包含所有形容詞,每個都出現在
love或hate旁邊。情感訓練集從未包含superb或terrible;測試集只包含這兩個形容詞,有否定也有不否定。隨機初始化的編碼器從未在任何脈絡中見過它們。 - 只看假說的基準能揭露捷徑嗎? NLI 訓練資料中,
not只出現在矛盾假說裡——一個刻意製造的標註痕跡。 - 挑戰集能揭露它嗎? 挑戰集讓
not出現在蘊涵中(兩句都否定),並建立假說沒有not的矛盾(改為前提被否定)。
編碼器以縮小版重現 NLP 10 的 BERT 配方:詞元+位置+片段嵌入、層正規化、兩個 Transformer 編碼器區塊、遮住 15% 的位置,以及微調時接在 [CLS] 上、含 tanh 層的池化任務頭。最佳化器為 AdamW [26]。
程式碼 · Python · 109 行
import itertools, random
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.feature_extraction.text import CountVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, f1_score

torch.manual_seed(0); random.seed(0); torch.set_num_threads(1)
POS, NEG = ['good', 'great', 'fine', 'superb'], ['bad', 'awful', 'poor', 'terrible']
ITEMS, NAMES = ['battery', 'screen', 'camera', 'speaker'], ['mina', 'ravi', 'lena']
VERBS = {'repaired': 'repair', 'cleaned': 'clean', 'tested': 'test'}
OBJS = ['the pump', 'the valve', 'the sensor']
words = set(' '.join(POS + NEG + ITEMS + NAMES + OBJS).split()) | set(VERBS) \
    | set(VERBS.values()) | set('the is not i love hate it someone did'.split())
vocab = ['[PAD]', '[CLS]', '[SEP]', '[MASK]'] + sorted(words)
idx, L, D = {w: i for i, w in enumerate(vocab)}, 16, 32

def batch(examples):                      # each example: (text,) or (text_a, text_b)
    ids, segs = [], []
    for ex in examples:
        toks, seg = ['[CLS]'], [0]
        for s, text in enumerate(ex):
            part = text.split() + ['[SEP]']
            toks += part; seg += [s] * len(part)
        ids.append([idx[t] for t in toks] + [0] * (L - len(toks)))
        segs.append(seg + [0] * (L - len(seg)))
    return torch.tensor(ids), torch.tensor(segs)

class TinyBERT(nn.Module):
    def __init__(self):
        super().__init__()
        self.tok, self.pos, self.seg = nn.Embedding(len(vocab), D), nn.Embedding(L, D), nn.Embedding(2, D)
        self.norm = nn.LayerNorm(D)
        block = nn.TransformerEncoderLayer(D, 2, 64, dropout=0.0, activation='gelu', batch_first=True)
        self.encoder = nn.TransformerEncoder(block, 2)
        self.mlm = nn.Linear(D, len(vocab))
    def forward(self, ids, seg):
        h = self.tok(ids) + self.pos(torch.arange(ids.shape[1])) + self.seg(seg)
        return self.encoder(self.norm(h), src_key_padding_mask=ids.eq(0))

# 1) Masked-LM pretraining on unlabeled text (no sentiment or NLI labels).
corpus = [(f'i love it the {i} is {a}',) for i in ITEMS for a in POS] \
    + [(f'i hate it the {i} is {a}',) for i in ITEMS for a in NEG] \
    + [(f'{n} {v} {o}',) for n in NAMES for v in VERBS for o in OBJS]
model = TinyBERT()
ids, seg = batch(corpus)
opt = torch.optim.AdamW(model.parameters(), lr=3e-3)
for step in range(400):
    pick = (torch.rand(ids.shape) < 0.15) & ids.gt(3)    # 15% of real tokens
    logits = model.mlm(model(ids.masked_fill(pick, idx['[MASK]']), seg))
    loss = F.cross_entropy(logits.flatten(0, 1), ids.masked_fill(~pick, -100).flatten())
    opt.zero_grad(); loss.backward(); opt.step()
print('final MLM loss:', round(loss.item(), 3))
pretrained_state = {k: v.clone() for k, v in model.state_dict().items()}

# 2) Fine-tune encoder + [CLS] head end to end.
def finetune(encoder, train, n_classes, epochs=60, lr=1e-3):
    torch.manual_seed(1)
    head = nn.Sequential(nn.Linear(D, D), nn.Tanh(), nn.Linear(D, n_classes))
    opt = torch.optim.AdamW([*encoder.parameters(), *head.parameters()], lr=lr)
    x, y = batch([ex for ex, _ in train]), torch.tensor([lab for _, lab in train])
    for _ in range(epochs):
        loss = F.cross_entropy(head(encoder(*x)[:, 0]), y)
        opt.zero_grad(); loss.backward(); opt.step()
    return lambda exs: head(encoder(*batch(exs))[:, 0]).argmax(-1).tolist()

def report(name, data, predict):
    gold = [lab for _, lab in data]
    with torch.no_grad():
        pred = predict([ex for ex, _ in data])
    print(f'{name:46s} acc={accuracy_score(gold, pred):.2f} '
          f'macro-F1={f1_score(gold, pred, average="macro"):.2f}')

# Task A: sentiment with negation. "superb" and "terrible" never get a label.
def review(item, adj, negated):
    return ((f'the {item} is {"not " * negated}{adj}',), int(adj in POS) ^ negated)
labeled = [a for a in POS + NEG if a not in ('superb', 'terrible')]
train_a = [review(i, a, n) for i in ITEMS for a in labeled for n in (0, 1)]
test_a = [review(i, a, n) for i in ITEMS for a in ('superb', 'terrible') for n in (0, 1)]
report('sentiment, pretrained encoder', test_a, finetune(model, train_a, 2))
report('sentiment, random-init encoder', test_a, finetune(TinyBERT(), train_a, 2))

# Task B: NLI (0 entailment, 1 neutral, 2 contradiction) with a negation shortcut.
def pair(n, v, o, kind):
    p, neg = f'{n} {v} {o}', f'{n} did not {VERBS[v]} {o}'
    other = list(VERBS)[(list(VERBS).index(v) + 1) % 3]
    return {'ent': ((p, f'someone {v} {o}'), 0), 'neu': ((p, f'{n} {other} {o}'), 1),
            'con': ((p, neg), 2),                   # training: "not" only in contradictions
            'neg-ent': ((neg, neg), 0),             # challenge: "not" in an entailment
            'neg-con': ((neg, p), 2)}[kind]         # challenge: contradiction without "not"
triples = list(itertools.product(NAMES, VERBS, OBJS)); random.shuffle(triples)
train_b = [pair(*t, k) for t in triples[:18] for k in ('ent', 'neu', 'con')]
test_b = [pair(*t, k) for t in triples[18:] for k in ('ent', 'neu', 'con')]
challenge = [pair(*t, k) for t in triples[18:] for k in ('neg-ent', 'neu', 'neg-con')]

vec = CountVectorizer(token_pattern=r'\S+').fit([ex[1] for ex, _ in train_b])
hyp_only = LogisticRegression(C=10, max_iter=1000).fit(
    vec.transform([ex[1] for ex, _ in train_b]), [lab for _, lab in train_b])
hyp_predict = lambda exs: hyp_only.predict(vec.transform([ex[1] for ex in exs])).tolist()
model.load_state_dict(pretrained_state)
pair_predict = finetune(model, train_b, 3)
for split, data in [('in-distribution', test_b), ('challenge', challenge)]:
    report(f'NLI {split}, hypothesis-only', data, hyp_predict)
    report(f'NLI {split}, pair encoder', data, pair_predict)
counter = [pair(*t, k) for t in triples[:18] for k in ('neg-ent', 'neg-con')]
model.load_state_dict(pretrained_state)
report('NLI challenge, pair encoder + counterexamples', challenge,
       finetune(model, train_b + counter, 3))
在單一 CPU 執行緒上只需數秒,輸出為:
程式碼 · 8 行
final MLM loss: 0.621
sentiment, pretrained encoder                  acc=1.00 macro-F1=1.00
sentiment, random-init encoder                 acc=0.25 macro-F1=0.20
NLI in-distribution, hypothesis-only           acc=1.00 macro-F1=1.00
NLI in-distribution, pair encoder              acc=1.00 macro-F1=1.00
NLI challenge, hypothesis-only                 acc=0.33 macro-F1=0.22
NLI challenge, pair encoder                    acc=0.67 macro-F1=0.56
NLI challenge, pair encoder + counterexamples  acc=1.00 macro-F1=1.00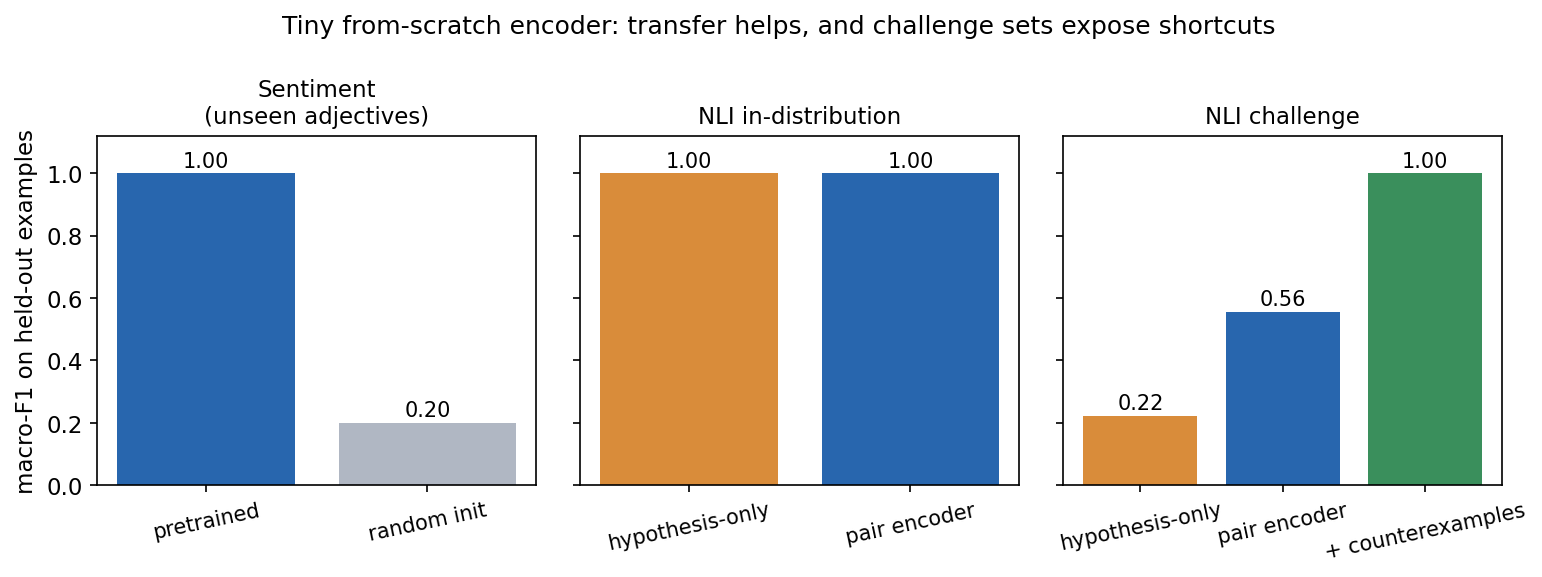
遷移。 預訓練編碼器正確標記全部十六個測試句,包括否定句,儘管 superb 與 terrible 從未帶著標籤出現。預訓練期間,它們分別與 love 及 hate 共享脈絡,因此它們的表示早已靠近同極性的已標註形容詞。隨機初始化的編碼器對這兩個詞只有隨機嵌入,微調集也沒有任何東西能把它們連到標籤。這是縮小版的 BERT 論點:未標註文字可以提供少量標註資料無法提供的區別。它也顯示了依賴性:遷移之所以成功,是因為未標註語料包含相關的共現。用不相干的文字預訓練並不會有幫助。
捷徑。 在分布內資料上,只看假說的邏輯斯迴歸是完美的。這正是警訊:從不讀前提的模型不可能在做推論,所以這份測試集並不要求推論。微調後的文字對編碼器在分布內也是完美的,單看這點無法知道它用了什麼。
挑戰。 在挑戰集上,只看假說的基準掉到機率水準。檢查預測可發現,文字對編碼器正確分類了每個前提被否定的矛盾句對與每個中立句對,卻把九個雙重否定的蘊涵全部標成矛盾——它部分學到了「假說有 not 就是矛盾」。加入十八個兩種挑戰類型的反例(以訓練用的人名、動詞與物件建立)後,挑戰集就被修正。最後一行要小心解讀:反例與挑戰集共用樣板,所以滿分說明的是:只要資料要求,模型就能學會這個區別;並不表示它能泛化到新的捷徑。
這裡一切都刻意縮小:40 個詞的詞彙、最多十幾個詞元的句子、一個種子。在我們試過的四個種子中,定性模式相同,但隨機初始化與挑戰集的確切數字會變動。練習 5 請你量測這個分布。
現代觀點
綜述與其分類地圖。 Minaee 等人在 ACM Computing Surveys 的回顧涵蓋超過 150 個深度學習文字分類模型與超過 40 個資料集,橫跨情感分析、新聞分類、問答與自然語言推論 [21]。它依架構分組——前饋、循環、卷積、膠囊、注意力、記憶增強、圖、孿生、混合,以及基於 Transformer 的預訓練語言模型——核心結論是:以任務標籤微調的預訓練語言模型,已在許多文字分類任務上創下新的最佳成績。Chang 等人的評估綜述區分評估什麼、在哪裡(哪些基準)以及如何(自動、人工、程序)[24];Zhao 等人的綜述則把分類放在預訓練、調適、使用與能力評估的整體流程中 [25]。合起來看,它們主張依任務擬定評估計畫,而不是只看一個排行榜數字。
LLM 時代的編碼器(2023–2026)。 大型僅解碼器模型可以透過提示進行分類,不需任務專屬權重。Zhang 等人在 26 個資料集、13 個情感任務上,把 LLM 與在領域資料上訓練的小型模型比較。LLM 在較簡單的任務上表現令人滿意,但在需要結構化情感資訊或對特定現象更深入理解的任務上落後;在少樣本設定中則明顯勝過小型模型 [22]。實務解讀:標籤稀少時,提示是強力選項;有標註資料且重視延遲時,微調後的編碼器仍具競爭力。編碼器本身也仍在演進。發表於 ACL 2025 的 ModernBERT 把近年的架構與訓練最佳化帶入僅編碼器模型,以 2 兆個詞元、原生 8,192 詞元序列長度訓練,並在分類與檢索評估上報告強勁結果,同時兼顧速度與記憶體效率 [23]。本章的微調介面——接在 [CLS] 或詞元狀態上的任務頭——可以原封不動沿用。
沒有改變的事。 標註痕跡 [9]、[10] 與啟發式捷徑 [11] 是資料集與訓練訊號的性質,不是某一種架構的性質。更大或更新的模型仍可能學到它們,提示式模型也可能帶來自己的捷徑。部分輸入基準、挑戰集、校準檢查 [18] 與拒答政策 [13] 仍是找出問題的工具。
開放問題。 領域偏移下的穩健性(MultiNLI 的 matched/mismatched 切分 [8] 是早期且狹窄的版本)、長文與多段落輸入的校準拒答、多語與語碼轉換的情感、隨政策改變的標籤,以及評估集洩漏進預訓練語料。每一項都更適合在大型模型旁邊放一個小而透明的基準來研究。
重點整理
- 編碼器是共用的;任務頭與標籤定義任務。先選序列、詞元或區段輸出。
- 文字對任務把兩段文字打包成一個序列,讓注意力逐詞元比較;代價是任一側都無法快取。
- 監督單位——句子、評論、對話——是任務定義的一部分。
- 只看假說(部分輸入)的基準若表現良好,表示該基準並不完全要求你在意的關係。
- 一次翻轉一個線索的挑戰集,能揭露分布內準確率所掩蓋的捷徑。
- 以小學習率、暖身與衰減微調;報告多個種子的變異,並只依開發資料選擇。
- 把決策(準確率、macro-F1)、機率(校準)與拒答(覆蓋率、接受風險)當作不同性質分別評估。
- 相關不代表可回答:區段答案需要支持它的段落,以及明確說「未提及」的方式。
練習
- 截斷政策。 你要分類的評論常比編碼器視窗長。比較保留開頭詞元、保留結尾詞元,以及在重疊視窗上平均預測三種作法。每種政策會誤判哪些評論?
提示
寫三則簡短的合成評論:結論出現在開頭、出現在結尾,以及在中途反轉(「一開始我很喜歡……但是」)。在選擇政策前,先決定標註準則想要的標籤。
- 部分輸入稽核。 對實驗中的 NLI 資料,再訓練一個只看前提的基準。執行前先預測它的準確率,再解釋結果。
提示
在訓練樣板中,每個前提都會與三種標籤同時出現。只看前提的模型不可能優於多數類別;把它與只看假說的結果比較。
- SQuAD 2.0 門檻。 給定可回答與不可回答問題在開發集上的分數 與 ,說明如何選擇 ,以及 增大時覆蓋率與接受準確率如何變化。
提示
在觀察到的分數差 上掃描 。 越大,回答的問題越少。畫出覆蓋率對接受準確率的曲線,再依錯答的既定成本選點。
- 校準。 為實驗中的情感分類器加入溫度縮放:在保留切分上以最小化負對數概似擬合一個溫度。說明準確率為何不會改變,並量測平均信心如何移動。
提示
把 logit 除以正的純量會保留其次序。改為最佳化 ,可讓溫度保持為正。
- 種子變異。 以五個種子執行預訓練與微調,報告每一行的平均與範圍,並判斷哪些結論仍然成立。
提示
兩個 torch.manual_seed 呼叫都要改。把方向性的主張(預訓練優於隨機初始化;挑戰集低於分布內)與確切數值的主張分開。
- 推論挑戰句對。 建立六組 NLI 句對,分別測試角色反轉、前提中的否定、情態、歸屬、量詞範圍與時間。在評估任何模型前,先寫下預期標籤與假設。
提示
前提提供的資訊太少時,要保留中立選項。測試歸屬時,比較「Mina said the pump failed」與「The pump failed」。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapters 9–11, Manning, 2021. Publisher
- Susan McRoy, Principles of Natural Language Processing, Chapters 6 and 8, open textbook, 2021. Open textbook
- Jacob Devlin, Ming-Wei Chang, Kenton Lee and Kristina Toutanova, “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,” NAACL-HLT, 2019. Paper
- Google Research, BERT: original implementation, software, 2018. Classification, Question answering, Optimizer
- Richard Socher, Alex Perelygin, Jean Wu, Jason Chuang, Christopher D. Manning, Andrew Ng and Christopher Potts, “Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank,” EMNLP, 2013. Paper
- Andrew L. Maas, Raymond E. Daly, Peter T. Pham, Dan Huang, Andrew Y. Ng and Christopher Potts, “Learning Word Vectors for Sentiment Analysis,” ACL-HLT, 2011. Paper
- Samuel R. Bowman, Gabor Angeli, Christopher Potts and Christopher D. Manning, “A large annotated corpus for learning natural language inference,” EMNLP, 2015. Paper
- Adina Williams, Nikita Nangia and Samuel R. Bowman, “A Broad-Coverage Challenge Corpus for Sentence Understanding through Inference,” NAACL-HLT, 2018. Paper
- Suchin Gururangan, Swabha Swayamdipta, Omer Levy, Roy Schwartz, Samuel R. Bowman and Noah A. Smith, “Annotation Artifacts in Natural Language Inference Data,” NAACL-HLT, 2018. Paper
- Adam Poliak, Jason Naradowsky, Aparajita Haldar, Rachel Rudinger and Benjamin Van Durme, “Hypothesis Only Baselines in Natural Language Inference,” *SEM, 2018. Paper
- R. Thomas McCoy, Ellie Pavlick and Tal Linzen, “Right for the Wrong Reasons: Diagnosing Syntactic Heuristics in Natural Language Inference,” ACL, 2019. Paper
- Pranav Rajpurkar, Jian Zhang, Konstantin Lopyrev and Percy Liang, “SQuAD: 100,000+ Questions for Machine Comprehension of Text,” EMNLP, 2016. Paper
- Pranav Rajpurkar, Robin Jia and Percy Liang, “Know What You Don’t Know: Unanswerable Questions for SQuAD,” ACL, 2018. Paper
- Alex Wang, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy and Samuel R. Bowman, “GLUE: A Multi-Task Benchmark and Analysis Platform for Natural Language Understanding,” ICLR, 2019. Paper
- Alex Wang, Yada Pruksachatkun, Nikita Nangia, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy and Samuel R. Bowman, “SuperGLUE: A Stickier Benchmark for General-Purpose Language Understanding Systems,” NeurIPS, 2019. Paper
- Marius Mosbach, Maksym Andriushchenko and Dietrich Klakow, “On the Stability of Fine-tuning BERT: Misconceptions, Explanations, and Strong Baselines,” ICLR, 2021. Paper
- Chuan Guo, Geoff Pleiss, Yu Sun and Kilian Q. Weinberger, “On Calibration of Modern Neural Networks,” ICML, 2017. Paper
- Shrey Desai and Greg Durrett, “Calibration of Pre-trained Transformers,” EMNLP, 2020. Paper
- scikit-learn developers, “Classification metrics,” scikit-learn documentation, current online edition. Documentation
- Nils Reimers and Iryna Gurevych, “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks,” EMNLP-IJCNLP, 2019. Paper
- Shervin Minaee, Nal Kalchbrenner, Erik Cambria, Narjes Nikzad, Meysam Chenaghlu and Jianfeng Gao, “Deep Learning–based Text Classification: A Comprehensive Review,” ACM Computing Surveys 54(3), 2021. Survey
- Wenxuan Zhang, Yue Deng, Bing Liu, Sinno Jialin Pan and Lidong Bing, “Sentiment Analysis in the Era of Large Language Models: A Reality Check,” Findings of NAACL, 2024. Paper
- Benjamin Warner, Antoine Chaffin, Benjamin Clavié, Orion Weller, Oskar Hallström, Said Taghadouini et al., “Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference,” ACL, 2025. Paper
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Survey
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” Frontiers of Computer Science, 2026. Updated survey
- Ilya Loshchilov and Frank Hutter, “Decoupled Weight Decay Regularization,” ICLR, 2019. Paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 12・句法與語意任務 · 33 分鐘