NLP 12・句法與語意任務
先備知識:NLP 11・以 BERT 做分類(情感分析、自然語言推論)、NLP 06・以 RNN 做序列標註(詞性標註、資訊擷取)
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 定義上下文無關文法,用 CKY 圖表辨識並列舉剖析,再以機率文法或神經跨度分數在其中選擇。
- 以轉移系統(arc-standard)與圖式解碼建立依存樹,並解釋為何逐詞獨立選中心詞需要樹限制。
- 標註述詞—論元結構(語意角色),在擷取的關係中保留作用範圍與來源,並讀懂一個小型 AMR 圖。
- 以先行詞模型把提及連成實體,並在脈絡不足時保留歧義。
- 用各自的指標評估每種結構:PARSEVAL 括號、UAS/LAS、角色 F1、MUC/B³/CEAF 與 CoNLL F1,以及 Smatch。
- 說明預訓練編碼器與大型語言模型如何改變這些任務,以及哪些事沒有改變。
先看全貌
語言表面是線性的,解讀卻有結構。句子以有順序的詞序列輸入,但讀者會把詞分組、辨識彼此的關係、判斷誰對誰做了什麼,並把一句中的「it」連到另一句的「the pump」。「We saw robots with cameras」可能描述帶著相機的機器人,也可能描述觀察時使用的器材。單靠詞清單無法選定解讀。
本章收集自然語言處理中經典的結構化預測任務。在 NLP 06 中,輸出是每個位置一個標籤;這裡的輸出則是一棵樹、一張圖或提及的分割,而且某處的選擇會限制其他地方:一個詞只能有一個中心詞、一個跨度只能屬於述詞的一個論元、共指連結必須形成一致的群組。McRoy 關於語法、語意與篇章的章節,以及另附的圖表剖析附錄,提供語言學觀點 [1];Jurafsky 與 Martin 關於成分剖析、依存剖析、語意角色與共指的章節,提供演算法觀點 [2]。成分、依存、量詞範圍等語言學類別本身,在 NLP 02 介紹。
這些結構有助擷取誰做了什麼、定位修飾語,並建立區分流暢度與結構理解的測試。它們無法處理所有問題:合文法的句子可能是假的,不完整的訊息也可能清楚傳達意思。我們把每種結構視為範圍明確的表示,而不是理解的定義。
成分與上下文無關文法
直觀說法。 片語結構把詞組成能遞迴結合的單位。文法規定允許的組合;剖析則是某個句子的推導。
上下文無關文法(context-free grammar)可定義為:
其中 是文法, 是非終結類別集合, 是終結詞彙表, 是改寫規則集合, 是起始類別。非終結符代表名詞片語等結構,終結符則是觀察到的詞。上下文無關規則替換一個非終結符,而不檢查周圍符號。
原創教學文法可使用 、、 與 。其中 表示句子, 表示名詞片語, 表示動詞片語, 表示介系詞片語, 表示動詞類別, 表示介系詞類別。這是教學文法的符號選擇,不是完整英文文法。Penn Treebank 等樹庫提供大量以這類樹標註的句子,文法與剖析器即由此學習 [4]。
遞迴規則能以有限規格產生無界的句子家族,但同樣的遞迴也可能讓天真的搜尋反覆做相同工作或無限循環,因此剖析器需要搜尋策略與緊湊的部分分析表示。
應區分涵蓋範圍與偏好。規則系統可能接受句子卻給出多個分析,也可能因缺少詞彙條目而無法剖析完全合理的句子。剖析失敗只表示所實作的文法與搜尋沒有找到分析,不表示使用者寫了無意義的內容。明確文法的好處是可檢查性:能顯示哪個規則連結了跨度,以及歧義出現在哪裡 [1]。
依跨度進行圖表剖析:CKY 演算法
由上而下的假設與由下而上的證據
直觀說法。 剖析器可以從句子預期包含什麼開始,也可以從觀察詞已支持什麼開始。兩個方向都需要避免重複工作。
由上而下搜尋從起始類別展開產生式,形成預期子節點。它能排除不符合預期的詞彙分析,但不好的展開選擇可能導致很長的失敗路徑;若遞迴產生式把第一個子節點展成同一類別,就可能在還沒消耗輸入前反覆遇到同一個未解預期。由下而上搜尋從觀察詞建立跨度支持的類別,可能產生許多不屬於任何完整句子的片語,但中間結果也可能被多個成功分析共用。
因此,設計問題不只是選哪個方向「比較好」,而是部分工作如何表示,以及兩個部分分析何時算同一搜尋狀態。圖表儲存完成跨度,另一條路徑抵達既有狀態時不必重新計算。不過記憶化本身不會解決歧義:辨識只需要每個跨度與類別一個布林值,偏好的剖析需要分數與回溯指標,所有選項則需要以森林保留不同推導連結。
跨度遞迴式
直觀說法。 儲存每個連續跨度可能的類別。把短跨度結合成長跨度,並讓所有完整剖析共用結果。
Cocke–Kasami–Younger(CKY)演算法是這個想法的標準動態規劃 [2]。它需要二元規則:喬姆斯基正規形(Chomsky normal form)的文法只有 與 兩種規則,而任何不含空產生式的上下文無關文法都能轉成此形式 [2]。採用半開邊界:跨度 包含位置 到 的詞元。辨識可寫成:
其中 是類別 能涵蓋跨度 的布林敘述, 是二元規則集合, 結合左類別 與右類別 , 是內部切分邊界, 表示兩個子節點都必須存在, 表示至少一組規則與切分成功。字母 同時出現在圖表符號與右子節點類別中,可由中括號與類別引數分辨角色。
先以詞彙規則初始化長度為一的格子,再依跨度長度、起點、切分點與相容規則迭代。子節點比父節點短,因此已經完成。一元規則與空產生式需要額外處理;本章可執行文法刻意不包含兩者。
這個演算法能辨識輸入,但辨識本身無法解釋樹。應以回溯指標或緊湊森林儲存成功組合。多個父節點可以共享子跨度,而不必複製完整子樹。高度歧義句子若展開所有完整樹,即使辨識是多項式時間,展開仍可能需要指數時間。固定二元文法下,跨度與切分巢狀迴圈對詞元長度呈立方關係;圖表有平方數量的跨度,每個跨度包含可能類別。
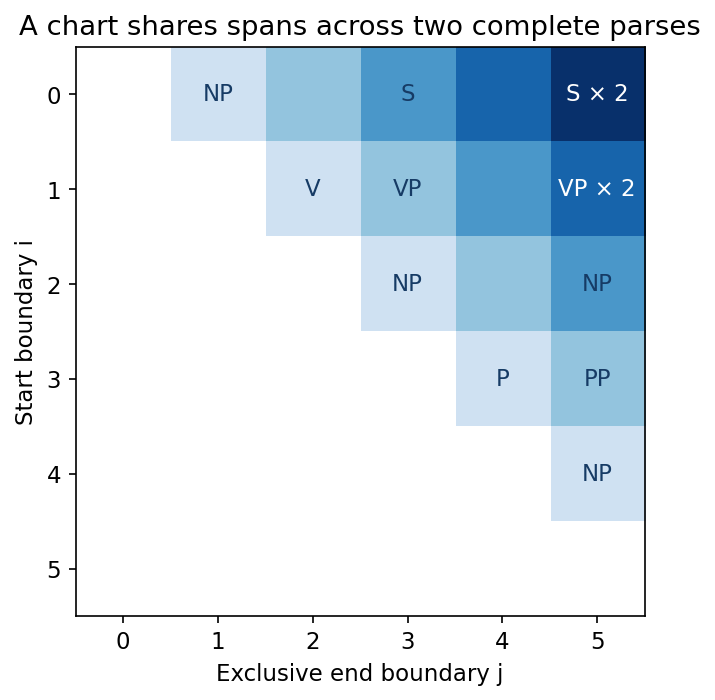
保留兩種分析的剖析器
文法允許兩種附接時,就回報兩種選項。剖析器不應只因某個選項先被加入,就丟掉歧義。以下獨立剖析器在圖表格子中儲存完整小樹。它刻意比緊湊森林實作簡單;適合五個詞的示範,而前面幾段已說明為何明確列舉不適合大型歧義輸入。
程式碼 · Python · 39 行
from collections import defaultdict

words = "we saw robots with cameras".split()
lexical = {
    "we": ["NP"], "saw": ["V"], "robots": ["NP"],
    "with": ["P"], "cameras": ["NP"],
}
rules = [
    ("S", "NP", "VP"),
    ("VP", "V", "NP"),
    ("VP", "VP", "PP"),
    ("NP", "NP", "PP"),
    ("PP", "P", "NP"),
]
chart = defaultdict(lambda: defaultdict(list))
for i, word in enumerate(words):
    for category in lexical.get(word, []):
        chart[i, i + 1][category].append((category, word))
for length in range(2, len(words) + 1):
    for start in range(len(words) - length + 1):
        end = start + length
        for split in range(start + 1, end):
            for parent, left, right in rules:
                for left_tree in chart[start, split].get(left, []):
                    for right_tree in chart[split, end].get(right, []):
                        tree = (parent, left_tree, right_tree)
                        if tree not in chart[start, end][parent]:
                            chart[start, end][parent].append(tree)

def bracket(tree):
    if len(tree) == 2:
        return f"({tree[0]} {tree[1]})"
    return f"({tree[0]} {bracket(tree[1])} {bracket(tree[2])})"

parses = chart[0, len(words)].get("S", [])
assert len(parses) == 2
for tree in parses:
    print(bracket(tree))
print("complete parses:", len(parses))
輸出
(S (NP we) (VP (V saw) (NP (NP robots) (PP (P with) (NP cameras)))))
(S (NP we) (VP (VP (V saw) (NP robots)) (PP (P with) (NP cameras))))
complete parses: 2
一棵樹把介系詞片語放進受詞名詞片語,另一棵則讓它修飾動詞片語。兩者都按順序使用每個詞,並符合文法。要選擇其中之一,可能需要周圍場景、先前篇章,或超出目前規則的詞彙偏好。
加入未知詞,某個詞彙格子可能變空。正確做法是診斷涵蓋範圍。正式服務可以使用備援標記器、允許明確未知類別,或要求澄清,但每個備援都會改變接受的語言,應記錄並測試。
結構上的機率
直觀說法。 文法說明哪些分析存在;機率模型可以偏好部分分析,並彙整各選項的不確定性。
機率式上下文無關文法(PCFG)為每個產生式配置機率,並在相同父類別的規則間正規化 [40]。一個推導具有:
其中 是完整推導樹, 索引樹中每次產生式使用, 是規則機率, 是終結輸出為輸入 的允許剖析集合, 是機率最高的剖析。同一規則重複使用時,乘積會分別計入。
把圖表中的選項改成加總,就能計算各推導的總機率質量(inside 演算法);改成最大值,就能計算最佳推導(機率式 CKY)。兩者回答不同問題:具有許多中等機率剖析的句子,總機率可能高於只有一個強剖析的句子,最佳樹也不一定占後驗質量的大部分。以下程式對同樣五個詞同時計算兩者。
程式碼 · Python · 46 行
import math
from collections import defaultdict

words = "we saw robots with cameras".split()
lexical = {"we": "NP", "saw": "V", "robots": "NP", "with": "P", "cameras": "NP"}

def parse(p_np_pp):
    # All productions sharing a parent must sum to one, including lexical rules.
    assert 0 < p_np_pp < 1
    rules = {("S", "NP", "VP"): 1.0, ("PP", "P", "NP"): 1.0,
             ("VP", "V", "NP"): 0.6, ("VP", "VP", "PP"): 0.4,
             ("NP", "NP", "PP"): p_np_pp}
    lexical_prob = {"we": (1 - p_np_pp) / 3, "robots": (1 - p_np_pp) / 3,
                    "cameras": (1 - p_np_pp) / 3, "saw": 1.0, "with": 1.0}
    parent_mass = defaultdict(float)
    for (parent, _, _), probability in rules.items():
        parent_mass[parent] += probability
    for word, parent in lexical.items():
        parent_mass[parent] += lexical_prob[word]
    assert all(math.isclose(total, 1.0) for total in parent_mass.values())
    best = defaultdict(dict)    # (i, j) -> {category: (log prob, tree)}
    inside = defaultdict(lambda: defaultdict(float))
    for i, w in enumerate(words):
        best[i, i + 1][lexical[w]] = (math.log(lexical_prob[w]), f"({lexical[w]} {w})")
        inside[i, i + 1][lexical[w]] = lexical_prob[w]
    n = len(words)
    for length in range(2, n + 1):
        for i in range(n - length + 1):
            j = i + length
            for k in range(i + 1, j):
                for (a, b, c), p in rules.items():
                    if b in best[i, k] and c in best[k, j]:
                        score = math.log(p) + best[i, k][b][0] + best[k, j][c][0]
                        if score > best[i, j].get(a, (-math.inf,))[0]:
                            best[i, j][a] = (score, f"({a} {best[i, k][b][1]} {best[k, j][c][1]})")
                        inside[i, j][a] += p * inside[i, k][b] * inside[k, j][c]
    score, tree = best[0, n]["S"]
    return tree, math.exp(score), inside[0, n]["S"]

for p in (0.2, 0.5):
    tree, p_best, p_total = parse(p)
    print(f"P(NP -> NP PP) = {p}: best = {p_best:.6f}, total = {p_total:.6f}")
    print("  ", tree)
    common = ((1 - p) / 3) ** 3
    assert math.isclose(p_total, common * (0.24 + 0.6 * p))
    assert math.isclose(p_best / p_total, max(0.24, 0.6 * p) / (0.24 + 0.6 * p))
輸出
P(NP -> NP PP) = 0.2: best = 0.004551, total = 0.006827
   (S (NP we) (VP (VP (V saw) (NP robots)) (PP (P with) (NP cameras))))
P(NP -> NP PP) = 0.5: best = 0.001389, total = 0.002500
   (S (NP we) (VP (V saw) (NP (NP robots) (PP (P with) (NP cameras)))))
三條詞彙 NP 規則平分遞迴規則用掉後剩餘的質量:每條機率為 ,其中 。兩棵樹都包含這三個詞彙選擇,因此共同因子是 。動詞附接的機率為 ,名詞附接則為 。省略 不會改變同一文法內哪棵樹勝出,但相加後就不再是句子的機率。程式保留此因子,並檢查每個父類別的正規化。
當 越過 時,偏好的樹仍會翻轉。把某棵樹的聯合機率除以 inside 總和,才得到給定這些詞之後的後驗機率。因此,最佳樹機率、句子機率與後驗信心是三個不同量。這裡的附接偏好來自類別規則機率,而非詞彙上下文;下一節的神經評分器補入這項缺少的證據。
從樹庫估計的規則機率取決於標註慣例與領域。新聞樹庫與客服語料可能有不同片段模式與附接偏好。機率建模提供偏好機制,但不會消除領域依賴。
神經成分剖析:為跨度評分,再用圖表解碼
直觀說法。 不再相乘規則機率,而是讓神經編碼器替每個跨度與標籤評分,再用同一張圖表找出分數最高的樹。
跨度式剖析器替每個候選成分評分,並搜尋總分最大的樹:
其中 是視為帶標籤跨度 集合的樹, 是半開跨度 的標籤, 是由跨度邊界上下文向量算出的分數, 是解碼得到的樹。Stern、Andreas 與 Klein 顯示,獨立替標籤與跨度評分可與傳統圖表動態規劃相容,也容許以遞迴切分輸入的貪婪由上而下解碼器 [5]。Kitaev 與 Klein 把該設計中的 LSTM 編碼器換成自注意力,發現分開位置與內容資訊能提升準確度,並報告在 Penn Treebank 上不使用外部資料時 93.55 F1、使用預訓練詞表示時 95.13 F1 [6]。後續研究再加入多語預訓練 [7]。
即使分數來自大型神經網路,輸出仍是一棵樹:圖表保證結構合法,編碼器則提供 PCFG 規則機率無法提供的詞彙證據。
依存結構與語法角色
直觀說法。 依存分析直接連結詞,顯示哪個詞依附哪個詞,並標記語法關係。
基本依存樹可用中心詞索引表示:
其中 是詞 的中心詞索引, 表示人工根節點, 是句子長度, 是該詞的關係標籤, 是關係集合。有效基本樹還需要明確的根節點規則、連通性與無有向循環。
逐詞獨立選中心詞可能違反全域要求。兩個詞可能互相選為中心而形成循環;數個不連通部分可能沒有唯一句根。樹解碼器應落實預期結構,或由服務驗證並拒絕無效分析。
Universal Dependencies 提供跨語言的詞法、詞性與語法依存標註框架 [8]。類別設計希望兼顧跨語言比較與語言專屬差異。這是標註框架,不表示每種語言具有相同詞序或明示語法標記。
片語結構與依存關係強調不同資訊。成分樹清楚表示跨度分組;依存樹清楚表示詞彙中心與關係。相互轉換需要中心詞、標點與功能詞的約定,不能只當成換一種畫法。
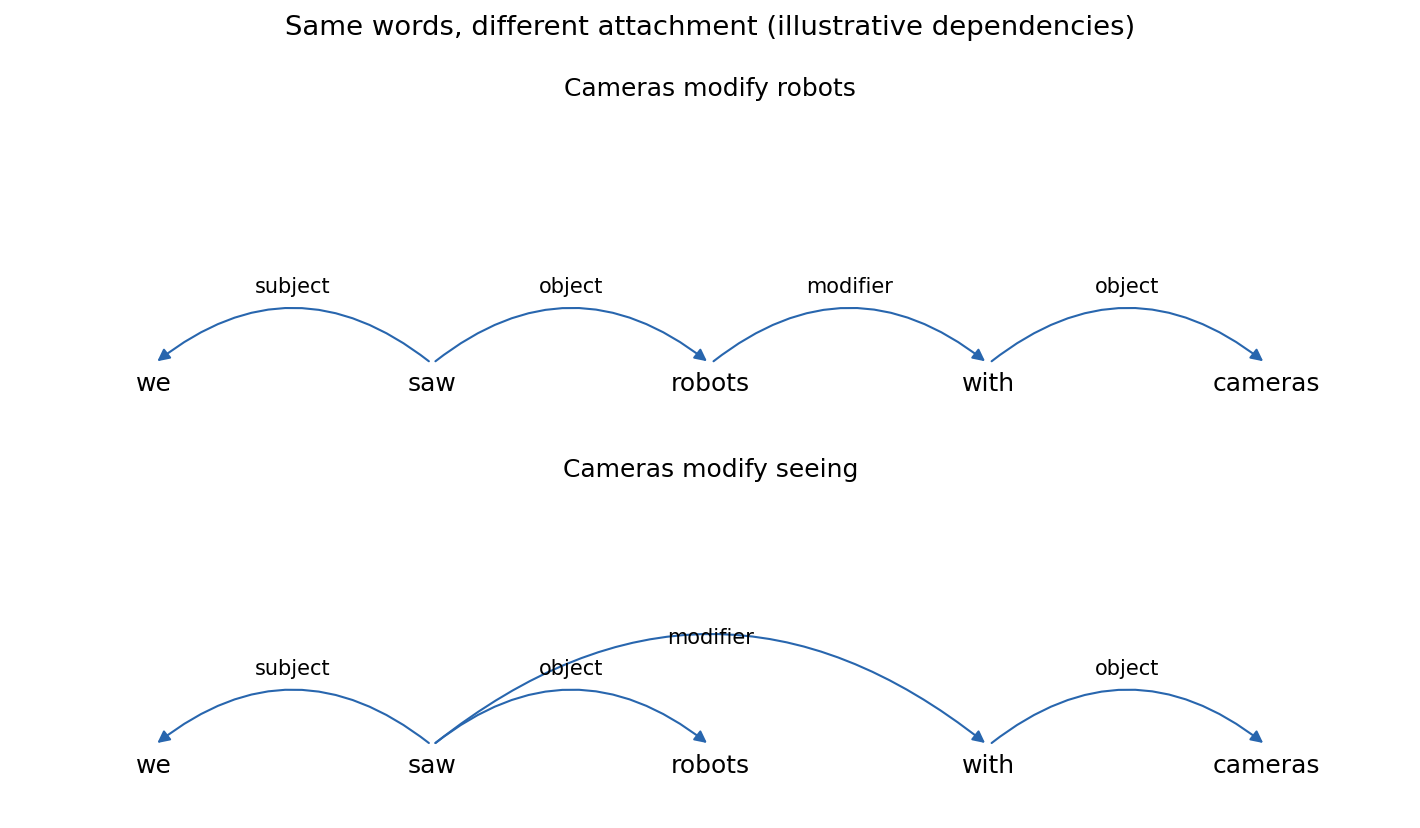
對擷取而言,語法角色是有用證據,但不能與語意角色互換。被動句改變語法主語位置,卻保留誰對誰做了什麼。下方的語意角色小節會發展這個差別,說明依存箭頭為何不能單獨證明真實世界關係。
附接歧義揭露模型的歸納偏好
兩種相機附接共享詞彙,卻替看見事件配置不同參與者。名詞片語附接描述機器人的性質;動詞片語附接描述看見時的工具或情境。下游擷取器若選定名詞解讀,可能建立機器人—相機持有關係;工具解讀卻不支持該紀錄。附接差異之所以重要,是因為它改變關係,不只是括號長得不同。
如 PCFG 程式所示,文法可以允許兩者,機率模型仍會偏好其一。若只有父類別的規則機率,除非擴充狀態或評分表示,否則模型無法依 saw、robots、cameras 的詞彙身分改變偏好。這是容量限制;對相同分數擴大搜尋,不會創造缺少的詞彙證據。
相反的失敗是搜尋限制:模型可能已有實用分數,卻在形成完整樹之前,透過剪枝移除正確跨度。應分別診斷:參考結構能否表示、是否保留於候選建立階段,以及在留下的候選中是否得最高分。答案分別指向不同改善:擴充表示、調整剪枝或改進評分。
也可能真的缺少資訊:孤立句子中兩種閱讀可能都成立,標準樹只記錄語料選定的解讀。對擷取器而言,先保留兩種可能,等到檢查所需關係再決定,可能比早期定案更合適。
轉移式依存剖析
直觀說法。 用一個堆疊由左到右讀句子,每一步從少數動作中選一個:把下一個詞移入堆疊,或把堆疊頂端兩項互相連結。分類器選動作,動作序列就建出樹。
Nivre 把確定性依存剖析器形式化為轉移系統,並分析以堆疊為基礎的變體(arc-standard 與 arc-eager,限於投射樹)以及以串列為基礎的變體,其中之一能處理非投射樹 [9]。投射(projective)樹是指弧線能畫在句子上方而不交叉的樹。在 Chen 與 Manning 使用的 arc-standard 系統中,組態 包含堆疊 、緩衝區 與弧集合 ,並有三種轉移 [10]:
其中 是堆疊頂端, 是其下一項, 是緩衝區第一個詞, 表示把 放在堆疊 頂端, 是從中心詞 指向依附詞 、標籤為 的弧, 讀作「變成」。剖析開始時堆疊只有根、所有詞都在緩衝區;緩衝區清空且只剩根時結束。每個詞被移入一次、被連結一次,因此 個詞的句子恰好需要 次轉移。
訓練分類器時,把每棵標準樹轉成能產生它的轉移序列,稱為靜態神諭(static oracle)。以下規則是一種標準選擇:堆疊第二項的標準中心詞是頂端時向左連結;頂端的標準中心詞是第二項且頂端已收齊自己所有依附詞時向右連結;否則移入。
程式碼 · Python · 23 行
words = ["ROOT", "we", "saw", "robots", "with", "cameras"]
# Gold heads for the instrument reading: "with cameras" attaches to "saw".
gold = {1: 2, 2: 0, 3: 2, 4: 5, 5: 2}

def oracle(gold):
    stack, buffer, arcs, steps = [0], list(range(1, len(words))), {}, []
    def done(h):  # has h already collected all of its dependents?
        return all(d in arcs for d, head in gold.items() if head == h)
    while buffer or len(stack) > 1:
        if len(stack) >= 2 and gold.get(stack[-2]) == stack[-1]:
            dependent = stack.pop(-2)
            arcs[dependent] = stack[-1]; steps.append("LEFT-ARC")
        elif len(stack) >= 2 and gold[stack[-1]] == stack[-2] and done(stack[-1]):
            dependent = stack.pop()
            arcs[dependent] = stack[-1]; steps.append("RIGHT-ARC")
        else:
            stack.append(buffer.pop(0)); steps.append("SHIFT")
    return steps, arcs

steps, arcs = oracle(gold)
print(" ".join(steps))
print({words[d]: words[h] for d, h in sorted(arcs.items())})
assert arcs == gold and len(steps) == 2 * (len(words) - 1)
輸出
SHIFT SHIFT LEFT-ARC SHIFT RIGHT-ARC SHIFT SHIFT LEFT-ARC RIGHT-ARC RIGHT-ARC
{'we': 'saw', 'saw': 'ROOT', 'robots': 'saw', 'with': 'cameras', 'cameras': 'saw'}五個詞用了十次轉移,與預測一致。done 檢查很重要:如果 robots 在 cameras 到達前就被連到 saw 並彈出,之後就不可能建出名詞附接的樹。歸約的順序編碼了樹。
剖析時由分類器取代神諭。Chen 與 Manning 把堆疊與緩衝區固定位置上的詞、詞性與弧標籤嵌入,輸入一個使用立方活化函數(cube activation)的單隱藏層網路,再以 softmax 選擇轉移;他們的貪婪剖析器很快,但如他們所說,會受到錯誤傳遞影響,因為早期錯誤動作無法撤銷 [10]。Kiperwasser 與 Goldberg 則為每個詞元計算一個與剖析器共同訓練的雙向 LSTM 向量,再串接少數幾個向量作為特徵;同一種表示同時適用於貪婪轉移剖析器與全域最佳化的圖式剖析器 [12]。轉移剖析器的時間與句長成線性;代價是局部、由左到右的決策程序。
圖式依存剖析
直觀說法。 一次替所有可能的中心詞—依附詞弧評分,再選出能構成樹、總分最高的一組弧。
McDonald 等人把加權依存剖析形式化為:在以詞加上根為節點的有向圖中,尋找最大生成樹 [11]:
其中 為每個詞指定一個中心詞, 是對句子 構成有效樹的中心詞指派集合, 是從中心詞 指向依附詞 的弧分數。在投射樹上,Eisner 演算法以 時間求解;在包含非投射樹的所有樹上,Chu–Liu–Edmonds 最大生成樹演算法以 時間求解 [11]。
Dozat 與 Manning 在深層雙向編碼器之上,把弧評分器做成雙仿射(biaffine)形式 [13]:
其中 與 是依附詞與候選中心詞上下文向量的低維投影, 是替兩者互動評分的學習矩陣, 是讓每個詞具有成為中心詞先驗傾向的學習向量。第二個雙仿射分類器則預測所選弧的關係標籤。評分器一次就產生完整的 弧分數矩陣。
樹限制帶來什麼?以下程式為我們的句子使用虛構分數,先讓每個詞獨立挑選最佳中心詞,再列舉所有單一根的樹——只對極小輸入可行,卻讓解碼器的工作看得見。最後計算下一節定義的 UAS 與 LAS。
程式碼 · Python · 39 行
import itertools
import numpy as np

words = ["ROOT", "we", "saw", "robots", "with", "cameras"]
n = len(words) - 1
# score[h, d]: invented arc scores (head h -> dependent d), not a trained model.
score = np.full((n + 1, n + 1), -2.0)
score[0, 2], score[2, 1], score[2, 3], score[5, 4] = 3.0, 2.0, 2.0, 2.0
score[3, 5], score[2, 5] = 1.5, 1.2                # robots vs saw for "cameras"
score[4, 5] = 1.8                                  # tempting but creates a cycle
np.fill_diagonal(score, -np.inf)

def is_tree(heads):                                # heads[d-1] is the head of d
    if sum(h == 0 for h in heads) != 1:
        return False
    for d in range(1, n + 1):
        seen, node = set(), d
        while node != 0:
            if node in seen:
                return False
            seen.add(node); node = heads[node - 1]
    return True

greedy = [int(np.argmax(score[:, d])) for d in range(1, n + 1)]
total = lambda hs: sum(score[h, d] for d, h in enumerate(hs, start=1))
trees = [hs for hs in itertools.product(range(n + 1), repeat=n)
         if all(h != d for d, h in enumerate(hs, 1)) and is_tree(hs)]
best = max(trees, key=total)
print("greedy heads:", greedy, "valid tree:", is_tree(greedy))
print("best tree:   ", list(best), "score:", round(total(best), 2))
print("trees enumerated:", len(trees))

gold = [2, 0, 2, 5, 2]
labels_gold = ["nsubj", "root", "obj", "case", "obl"]
labels_pred = ["nsubj", "root", "obj", "mark", "nmod"]
uas = np.mean([p == g for p, g in zip(best, gold)])
las = np.mean([p == g and lp == lg for p, g, lp, lg
               in zip(best, gold, labels_pred, labels_gold)])
print(f"UAS = {uas:.2f}, LAS = {las:.2f}")
輸出
greedy heads: [2, 0, 2, 5, 4] valid tree: False
best tree:    [2, 0, 2, 5, 3] score: 10.5
trees enumerated: 625
UAS = 0.80, LAS = 0.60
貪婪選擇讓 with 與 cameras 互為中心詞,形成與根不連通的兩詞循環(圖 3)。在五個詞的 625 棵單一根樹中,最佳者打破循環,把 cameras 連到 robots——這是有效的樹,卻是名詞解讀,而標準標註選的是工具解讀。最大生成樹演算法不需列舉就能找到相同答案。
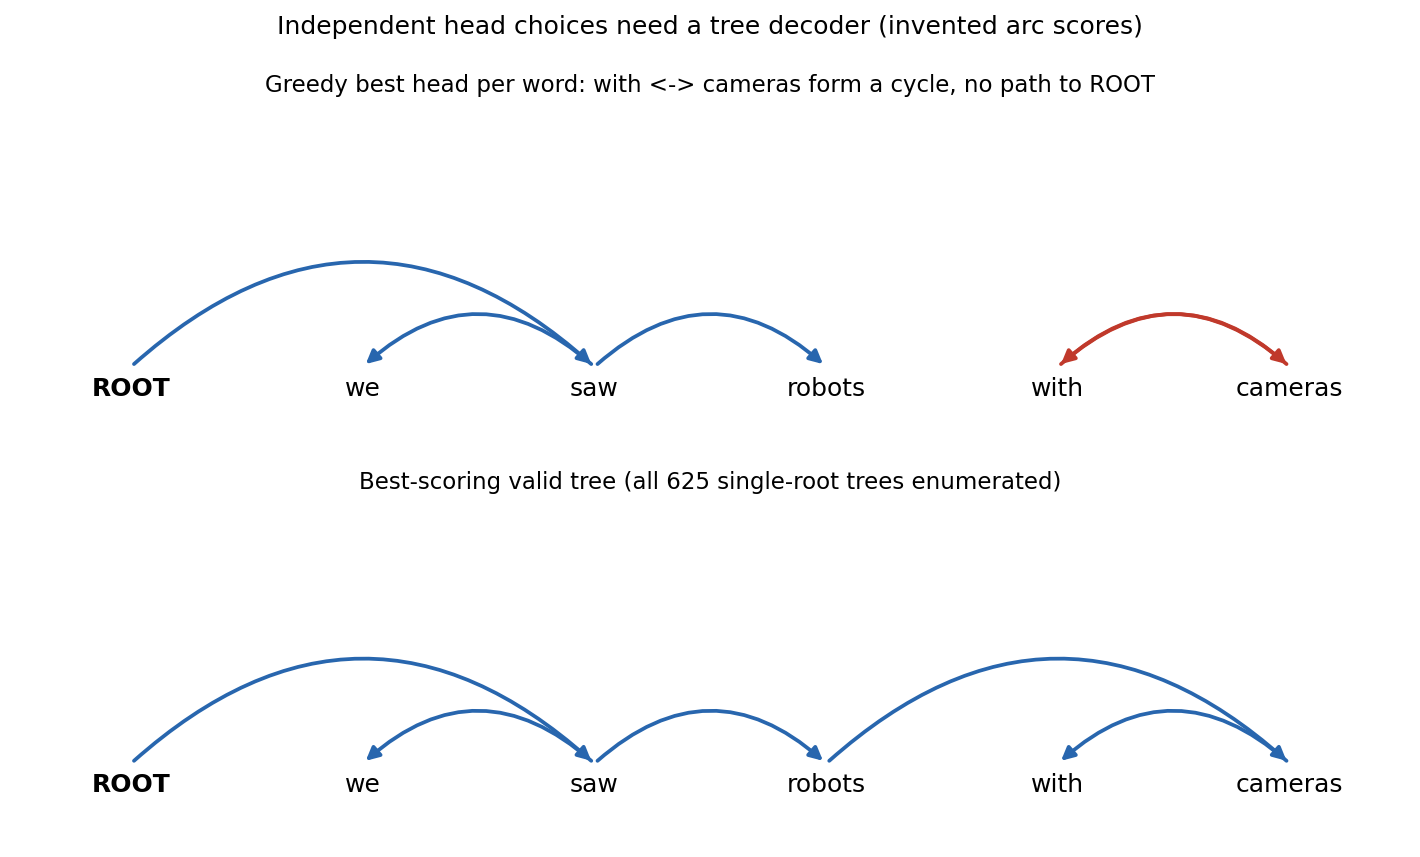
圖式與轉移式剖析器的取捨不同:前者在弧分數上做全域搜尋,解碼為平方或立方時間;後者做線性時間的局部決策。Kiperwasser 與 Goldberg 的共用 BiLSTM 特徵同時服務兩個家族 [12]。不論用哪一族,結構保證都來自解碼器或轉移系統,而不是編碼器。
評估剖析器:PARSEVAL、UAS 與 LAS
直觀說法。 比較剖析器承諾產生的表示,並檢查斷詞、標註或脈絡改變答案的情況。
最初的 PARSEVAL 程序先移除標點等材料,再比較候選剖析與樹庫剖析,計算交叉括號分數——候選括號與參考括號交叉的次數——以及召回率,即共同括號數除以參考括號數 [3]。今日標準是帶標籤括號的精確率、召回率與 F1 [2]:
其中 是樹 的帶標籤成分 集合, 是預測樹, 是參考樹,F1 是兩者的調和平均。對我們的兩個剖析,兩棵樹只有一個帶標籤括號不同:名詞附接樹有 ,動詞附接樹有 。計入預終結符時,每棵樹有九個帶標籤成分,因此任一棵對另一棵評分,精確率與召回率都是 。應說明是否包含詞彙預終結符、標點與根;不同納入規則會改變分母。
對依存結構,無標籤附接分數(UAS)是中心詞正確的詞所占比例,帶標籤附接分數(LAS)還要求關係正確:
其中 是帶標籤附接分數, 是評估詞位置集合, 是集合大小, 與 是預測中心詞與關係, 與 是參考中心詞與關係, 是指示函數;UAS 則去掉關係條件。在程式中,cameras 的中心詞錯誤(兩個分數都扣分),with 的中心詞正確但標籤錯誤(只有 LAS 扣分),因此得到 與 。
套用這些公式前,必須固定詞元對齊。CoNLL 2018 共享任務要求系統把原始文字剖析成多種語言的 Universal Dependencies,測試輸入不附任何標準標註 [14]。系統因此必須自行切分與斷詞,而預測詞必須先與標準詞對齊,附接分數才有意義。如果標準標註有兩個詞,斷詞器卻輸出一個,就無法正常解讀附接比較。應報告切分不符,並說明如何處理對齊,不要默默刪除困難樣本。
建立小型診斷配對:保持詞彙相近但移動修飾語,加入巢狀子句,把主動句改為被動句,或加入片段與混合語言片語。即使總體分數穩定,這些測試仍能揭露模型結構在什麼條件下改變。句子確實有歧義時,不要把一棵標準樹視為絕對確定。語料需要選定慣例或經裁決的分析,但其他分析可能也合理。對應用而言,應問分歧是否改變擷取事實或行動,讓剖析錯誤與實際後果連結。
語意角色標註:誰對誰做了什麼
直觀說法。 同一個事件可以用不同語法表達。應擷取事件角色,不能假定第一個名字永遠是行動者。
簡單的雙參與者述詞可寫成:
其中 是關係名稱;第一個論元是修理者;第二個是被修理物件。「Mina 修好了感測器」與「感測器被 Mina 修好了」可以共用這種表示,雖然表面的主詞不同。語法提供線索,角色解讀還必須考慮述詞與句型 [1]。
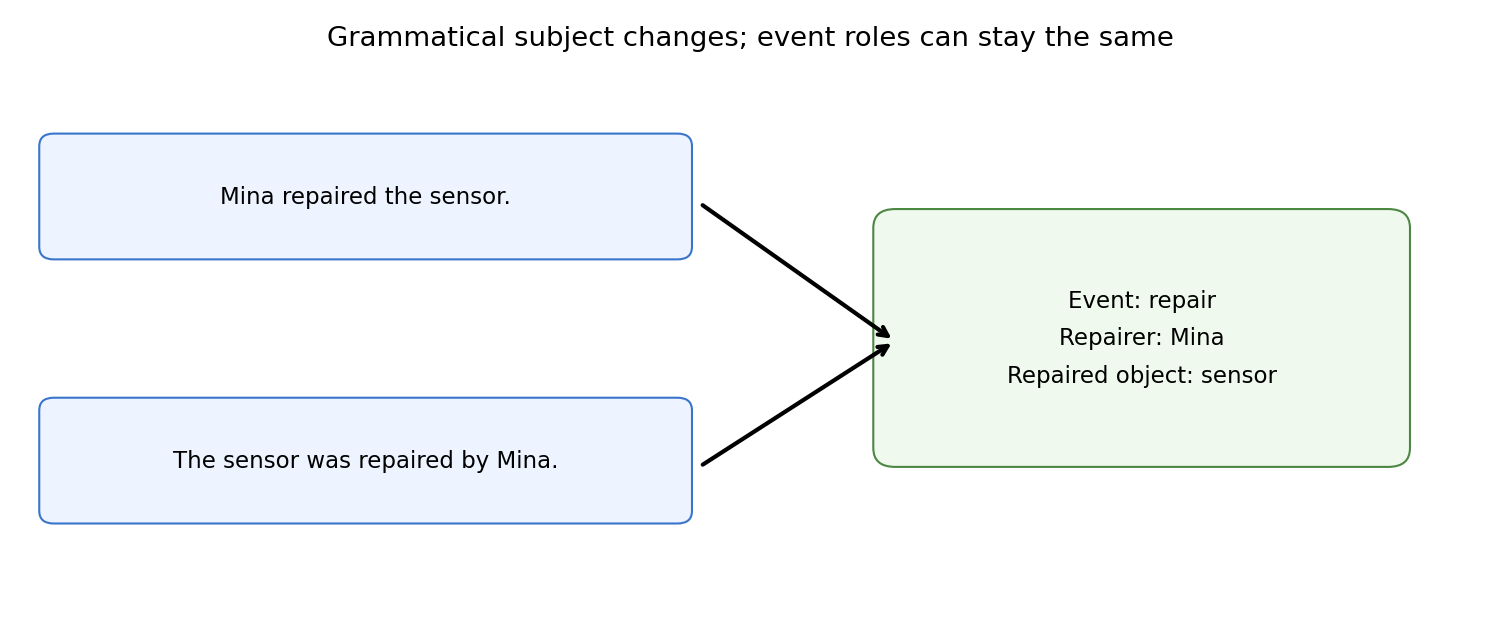
並非每個動詞都允許所有變換,也不是每個論元都明說。「感測器修好了」沒有指明修理者。若系統填入前文最近提到的人,就是做了上下文推論,而非直接擷取。這個推論可能合理,但需要另外的信心政策與證據契約。當應用未授權推論時,應保留明確的未知角色。
論元與修飾語也有差別。在「Mina 週二在臺北修好了感測器」中,修理者與被修理物件參與核心事件,地點與時間則補充事件。事件結構可包含四個欄位,但應說明哪些是必填。選填欄位能避免擷取器為滿足過度嚴格的格式而編造細節。
PropBank 角色與 SRL 任務
Gildea 與 Jurafsky 把自動語意角色標註建構為剖析句子上的統計任務:把帶角色的片語對應到剖析成分,從詞與樹抽取特徵,再估計每種可能角色的機率 [15]。PropBank 接著為 Penn Treebank 的動詞標註述詞專屬的編號論元:每個動詞義項有一個框架集,其中 Arg0 通常是施事般的參與者、Arg1 是受事或主題,更高編號則依動詞定義;附加語則用 ArgM 標籤,例如表示否定的 ArgM-NEG 與表示情態的 ArgM-MOD [16]。編號正是重點:在「an amendment offered by Rep. X」中,amendment 雖是語法主詞,仍是 offer 的 Arg1 [16]。CoNLL-2005 共享任務以 PropBank 標準化 SRL 評估:預測論元只有在跨度與角色都正確時才算對,系統以論元層級的精確率、召回率與 F1 比較 [17]。
語意角色能連接不同句型,卻不保證各種資源的標註一致。有些資源使用述詞專屬角色,有些使用通用角色。合併訓練語料前,先比較定義與例子。機械式重新命名標籤,可能掩蓋工具、原因、受益者與隱含參與者的標註差異。
把 SRL 視為以述詞為條件的標記
He 等人把 SRL 寫成每個述詞各做一次的 BIO 序列標記:輸入標出哪個詞是述詞,深層 highway BiLSTM 搭配受限解碼——例如禁止沒有前置 B- 的 I- 標籤——標記論元跨度 [18]。他們的八層集成模型在 CoNLL-2005 測試集上報告 83.2 F1,並發現深層模型能找回長距離依存,卻仍會犯出乎意料的明顯錯誤,句法資訊仍有幫助空間 [18]。換成預訓練編碼器後,同一設計就是 NLP 11 的詞元標記任務頭再加上述詞指示。以下程式把角色跨度轉成標籤序列再轉回來,並拒絕無效序列。
程式碼 · Python · 34 行
tokens = "Mina said the sensor was repaired by Lena".split()
# One frame per predicate: (start, end) token spans, end exclusive.
frames = {
    "said":     {"ARG0": (0, 1), "ARG1": (2, 8)},
    "repaired": {"ARG1": (2, 4), "ARG0": (6, 8)},
}

def to_bio(frame, n):
    tags = ["O"] * n
    for role, (i, j) in frame.items():
        tags[i] = "B-" + role
        tags[i + 1:j] = ["I-" + role] * (j - i - 1)
    return tags

def from_bio(tags):
    spans, start, role = {}, None, None
    for k, tag in enumerate(tags + ["O"]):
        if start is not None and not tag.startswith("I-" + role):
            spans[role] = (start, k); start = None
        if tag.startswith("B-"):
            start, role = k, tag[2:]
        elif tag.startswith("I-") and start is None:
            raise ValueError(f"I- tag without B- at position {k}")
    return spans

for predicate, frame in frames.items():
    tags = to_bio(frame, len(tokens))
    tags[tokens.index(predicate)] = "B-V"
    print(f"{predicate:9s}", " ".join(tags))
    assert {r: s for r, s in from_bio(tags).items() if r != "V"} == frame
try:
    from_bio(["O", "I-ARG1", "I-ARG1"])
except ValueError as error:
    print("invalid:", error)
輸出
said      B-ARG0 B-V B-ARG1 I-ARG1 I-ARG1 I-ARG1 I-ARG1 I-ARG1
repaired  O O B-ARG1 I-ARG1 O B-V B-ARG0 I-ARG0
invalid: I- tag without B- at position 1
同一句話產生兩個框架。對 said,Mina 是說話者,整個轉述子句是 ARG1。對 repaired,Lena 是修理者,感測器雖是語法主詞,仍是 ARG1。只讀 repaired 框架的擷取器,會把完成的修理記成事實;said 框架則顯示修理是 Mina 的轉述。這正是下方關係紀錄必須保留的歸屬差別。
語意表示中的作用範圍
直觀說法。 「every」、「some」與「not」這類小詞,對陳述的改變可能比名字還大。語意剖析器必須記錄它們修飾什麼,否則輸出回答的是錯誤問題。
NLP 02 以一個實作反模型介紹量詞範圍與否定。這裡看作用範圍對任務輸出代表什麼。「Every technician checked a sensor」有一種閱讀是每位技師可檢查不同感測器,另一種閱讀是有一個感測器被所有人檢查。「Mina did not check every sensor」的形式是
其中 遍歷實體, 表示感測器, 表示 Mina 檢查該實體, 指 Mina, 表示否定, 表示邏輯等價。一個反例感測器,就足以讓全稱陳述不成立。「Mina checked no sensor」則排除每一次成功檢查。否定的位置決定哪種證據能反駁陳述。
文件資料庫通常沒有完整知識:沒有擷取到檢查紀錄,可能是未報告,不代表沒發生。回答全稱問題時,這個差別很重要。觀察清單可支持「這些感測器已檢查」,但要成立「所有感測器都已檢查」,還需要完整的相關感測器清單與全面涵蓋。反之,找到一個明確未檢查的感測器,就足以反駁完整性。作用範圍推理與證據完整性必須一起考慮。同樣地,「沒有找到故障證據」描述觀察或搜尋結果,不應自動轉成「故障不可能發生」。
範圍有限的擷取器遇到不支援的作用範圍句型,應拒絕判定或送交覆核。能處理「沒有修理」的規則,仍可能誤解「沒有說 Mina 修理了」:系統必須知道被否定的是什麼,而這正是 PropBank 的 ArgM-NEG 附在特定述詞上的資訊 [16]。
組合意義是對角色與作用範圍進行計算
理解組合的一個實用方式,是問每個片語還缺什麼。Mina 指定一個參與者;repaired 要求特定角色的參與者;repaired a sensor 用存在條件處理受詞要求,仍留下行動者等待填入;結合主詞後才補完該要求。這種組合順序說明,只辨認相同三個內容詞還不夠,角色必須正確綁定 [1]。
「Mina repaired a sensor」的一種受限邏輯閱讀為:
其中 遍歷可能實體, 表示 是感測器, 表示參與者 修復 , 指 Mina。存在量詞表示至少有一個合適實體,不會識別是哪個感測器,也不表示所有感測器都修好了。這個簡單閱讀刻意省略時態與事件時間;它們是額外語意欄位,不是符號暗中提供的事實。
「Only Mina repaired the sensor」限制其他可能參與者;「Mina tried to repair the sensor」描述嘗試,不保證修復完成;「Mina stopped repairing the sensor」改變事件的時間解讀。只有行動者與對象的紀錄,無法表達這些差異。這提供選擇表示的具體標準:列出必須回答的問題,檢查是否有兩個需要不同答案的來源陳述,卻被壓成同一紀錄。如果嘗試修復與完成修復都變成 repair(Mina, sensor),這個結構就太粗,無法回答完成狀態。序列化已經造成資訊損失時,更強編碼器也無法避免。
關係、事件與來源追溯
直觀說法。 關係連結實體,事件則以一次發生為中心組織參與者。兩者都需要證據,也都可能在實體區段全對的情況下出錯。
二元關係紀錄可寫成:
其中 是紀錄; 是關係類型; 是頭實體或提及; 是尾實體或提及; 指向支持證據。頭與尾只是次序慣例,不是語言學主張。雇用關係中,交換員工與雇主就改變了紀錄。結構描述必須定義方向,評估也必須檢查。
事件擷取在觸發詞或事件類型之外,還包含買方、賣方、物品、金額與時間等角色——也就是限縮在應用結構描述內的語意角色標註。交易句可能提到多個價格,只有其中一個是實際付款金額。共同選擇角色配置能避免部分矛盾,但若來源本身含糊,仍需要更多上下文。應用允許時,可保留多個解讀或送交覆核。
來源追溯應包含文件身分、來源版本與支持區段。沒有版本,位移可能指向後來編輯過的文件;沒有歸屬——就像上面的 said 框架——引述的指控會變成直接事實。這些是紀錄管線的性質,不是換大編碼器就會自動解決的問題。
應分階段評估——提及偵測、類別預測、關係選擇與最終受支持紀錄——並且除了正確提及,也要用預測提及評估關係:測試時提供完美輸入,可能掩蓋實際部署管線的失敗率。
篇章、提及與共指
直觀說法。 意義會跨越句子延續。共指消解判斷哪些提及指向同一實體,讓關於「the pump」與「it」的事實落在同一筆紀錄上。
篇章(discourse)是跨子句或句子組織的語言。例如「幫浦變熱了。操作員停止了它。」介紹事件、行動者與物件指涉,可能暗示對升溫的回應,卻不一定證明升溫造成停止。比較「The pump stopped because the valve closed」、「The pump stopped after the valve closed」與「The pump stopped although the valve remained open」:第一句提出因果解釋,第二句排列事件先後而不建立因果,第三句標示與預期的對比 [1]。摘要器或擷取器加入「because」,就是在增加主張。關係還有作用範圍:在「Mina said the pump stopped because the valve closed」中,解釋可能屬於 Mina 的報告,而不是獨立建立的發現。
提及(mention)是指向實體、事件或概念的文字區段;先行詞(antecedent)是協助解讀後續提及的較早表達;共指(coreference)把指向相同實體的提及分組。措辭相似不保證身分相同,兩個不同幫浦都可能叫「備用幫浦」。
先行詞排序模型
Lee 等人的區段式共指模型,可替一個提及的可能先行詞評分 [19]。抽象形式為:
其中 是文件或對話; 索引當前提及; 是包含空選項的候選先行詞集合; 是選到的先行詞變數; 是學得相容性分數。空選項讓提及可以引入新實體或暫不連結。刪除候選會改變模型能考慮的範圍。Lee 等人的模型把各項貢獻分開 [19]:
其中 是目前候選區段, 是較早候選區段, 是空先行詞, 評分區段是否為提及, 評分配對相容性。固定空選項分數為零,替真實連結提供共同基準。提及剪枝節省配對計算,卻可能在連結開始前,就移除唯一有效的先行詞。
模型既要偵測提及,也要連結。較早實體區段若已被丟掉,後續只改善剩餘候選分數也找不回它。診斷時應分開偵測召回與連結準確率。
群組讓監督更複雜。如果 Pump A、the pump、it 指同一實體,最後提及連到任一較早提及都正確。任意只獎勵最近一個的損失,會懲罰另一條有效連結。以群組為目標的訓練改為獎勵它們的合計機率:
其中 是候選區段 的損失, 是依標註與剪枝規則保留下來、且非空的有效先行詞集合, 是先行詞變數, 是文件, 是條件先行詞機率。沒有有效較早先行詞時,空選項屬於 。這是對有效連結取邊際,原始模型也使用這種方法 [19]。推論時,沿先行詞連結合併提及,形成實體群組。一條錯誤橋接就可能合併兩個原本各自合理的群組,錯誤合併的群組之後可能讓多個事件歸到錯誤幫浦。
新近性基準與它的失敗
以下手寫基準使用明確相容性與新近性,刻意保持小型以揭露失敗。裝置類別由資料提供,程式不會依姓名或社會刻板印象推測屬性。
程式碼 · Python · 19 行
entities = [
    {"id": "pump_a", "category": "device", "turn": 1},
    {"id": "valve_b", "category": "device", "turn": 2},
    {"id": "operator", "category": "person", "turn": 2},
]
def candidates(category):
    return [e for e in entities if e["category"] == category]
def recent(category):
    choices = candidates(category)
    return max(choices, key=lambda e: e["turn"])["id"] if choices else None
print("Recency baseline for it:", recent("device"))
assert recent("device") == "valve_b"
# In a synthetic annotation, the speaker meant the earlier pump.
intended = "pump_a"
assert recent("device") != intended
# A cautious application preserves ambiguity instead of hiding the choice.
possible = {e["id"] for e in candidates("device")}
resolution = next(iter(possible)) if len(possible) == 1 else None
assert resolution is None and possible == {"pump_a", "valve_b"}
基準輸出 valve_b,人工設定的說話意圖卻指較早幫浦。線索無法每次都確定身分。「你指 Pump A 還是 Valve B?」這種澄清能明確保留不確定性;NLP 08 會在對話中發展澄清。
上下文還包含指示語(deixis):這個、這裡、現在等表達依賴說話者、地點、時間或介面選取,因此應把相關情境與話語一起存;系統拒絕輸入無法支持的推論,不應被判錯。引文也帶來限制:操作員引文中的 I 指操作員,「另一台幫浦」則預設一個新近性規則無法定義的對比集合。
選讀:End-to-end coreference(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
評估共指:MUC、B³、CEAF 與 CoNLL F1
直觀說法。 共指輸出是把提及分割成實體。不同指標以不同單位——連結、提及或實體——計算兩個分割的一致程度,因此單一指標無法說明全貌。
令 為鍵(標準)分割, 為回應分割。
- MUC 以連結為基礎 [20]。對每個鍵實體 ,令 為回應在 上誘導的分割,未匹配的提及視為單例。召回率為 :回應保留的鍵連結數,除以所需的最少連結數。精確率則交換鍵與回應的角色。
- B³ 以提及為基礎。對每個提及 ,比較包含它的鍵實體 與回應實體 :召回率對提及平均 ,精確率平均 [23]。
- CEAF 以實體為基礎 [21]。它在鍵實體與回應實體間找最佳一對一對齊,也就是最大二分匹配。以實體相似度 (實體式變體 CEAF)計算時,召回率是對齊相似度總和除以鍵實體數,精確率則除以回應實體數。
CoNLL-2012 共享任務以 MUC、B³ 與 CEAF 三者 F1 的未加權平均評分,理由是每個指標代表不同面向 [23]。Pradhan 等人後來發布參考評分程式,因為不一致的實作——特別是預測提及與標準提及不符時——產生了無法比較的數字 [22]。以下程式針對圖 5 的回應計算三者,其中「it」被錯誤併入閥門群組。
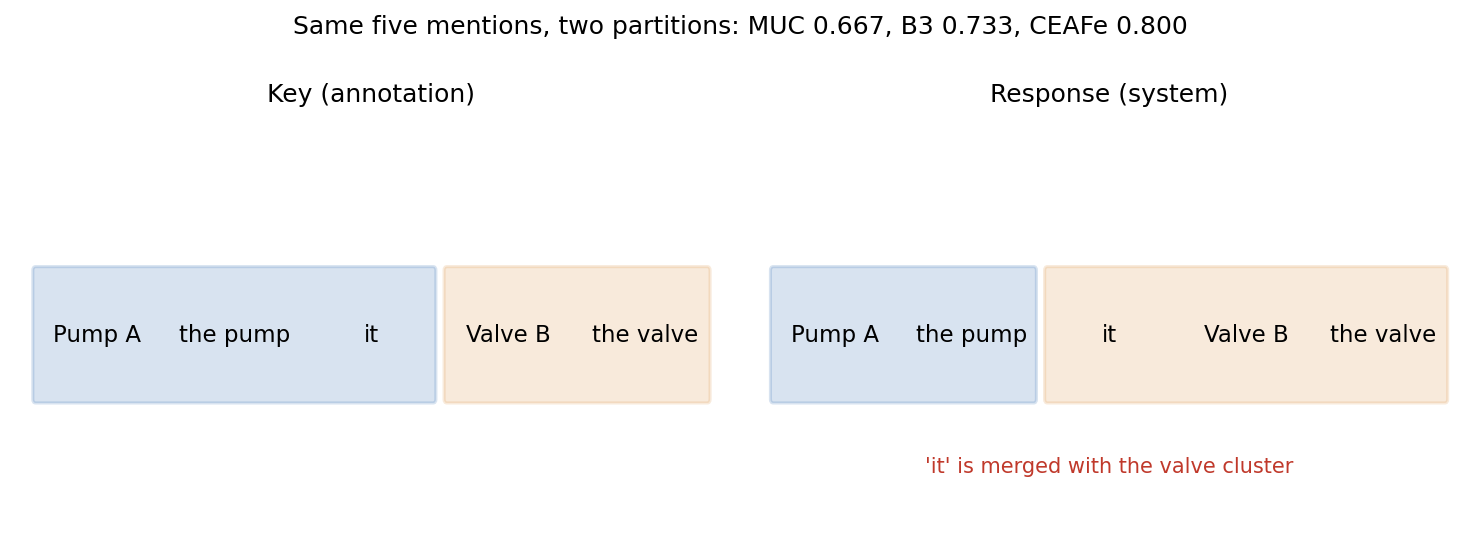
程式碼 · Python · 36 行
import numpy as np
from scipy.optimize import linear_sum_assignment

# Mentions: a="Pump A", b="the pump", c="it", d="Valve B", e="the valve"
key = [{"a", "b", "c"}, {"d", "e"}]
response = [{"a", "b"}, {"c", "d", "e"}]          # "it" wrongly joined to the valve

def f1(p, r):
    return 2 * p * r / (p + r) if p + r else 0.0

def muc(gold, pred):                                # link-based
    def recall(g, p):
        def parts(s):  # pieces of s cut by p; uncovered mentions are singletons
            covered = set().union(*p)
            return sum(1 for t in p if s & t) + len(s - covered)
        return sum(len(s) - parts(s) for s in g) / sum(len(s) - 1 for s in g)
    return recall(pred, gold), recall(gold, pred)    # precision, recall

def b_cubed(gold, pred):                            # mention-based
    def score(a, b):
        cluster_of = {m: s for s in b for m in s}
        return np.mean([len(s & cluster_of.get(m, set())) / len(s)
                        for s in a for m in s])
    return score(pred, gold), score(gold, pred)

def ceaf_e(gold, pred):                             # entity-based
    phi = np.array([[2 * len(g & p) / (len(g) + len(p)) for p in pred] for g in gold])
    rows, cols = linear_sum_assignment(-phi)
    total = phi[rows, cols].sum()
    return total / len(pred), total / len(gold)

scores = {name: f1(*fn(key, response)) for name, fn in
          [("MUC", muc), ("B3", b_cubed), ("CEAFe", ceaf_e)]}
for name, value in scores.items():
    print(f"{name:6s} F1 = {value:.3f}")
print(f"CoNLL F1 = {np.mean(list(scores.values())):.3f}")
輸出
MUC    F1 = 0.667
B3     F1 = 0.733
CEAFe  F1 = 0.800
CoNLL F1 = 0.733
手算 MUC:鍵需要 條連結;回應把幫浦實體切成兩塊、閥門實體保持完整,保留 條連結,因此召回率為 ,依對稱性精確率也是 。B³ 對每個受影響的提及扣分,CEAF 則仍讓每個鍵實體對齊到大致正確的回應實體。一個錯誤、三個數字:這正是共享任務取平均的原因,也是應用應該同時檢查使用這些群組之紀錄的原因。
分數只在標註政策下可解讀:是否連結事件與聯想關係、單例是否計分,以及如何標註歧義。
語意剖析與 AMR
直觀說法。 語意剖析把句子映射到程式能使用的意義表示:邏輯形式、資料庫查詢或一張圖。抽象意義表示(Abstract Meaning Representation,AMR)是廣泛使用的整句圖格式。
Banarescu 等人為「語意庫」設計 AMR:AMR 是有根、帶標籤的有向圖,便於人閱讀、也便於程式走訪;它試圖抽離句法上的特異性,讓基本意義相同的句子得到相同 AMR,並大量使用 PropBank 框架集 [24]。當一個實體扮演多個角色時,AMR 使用再進入(re-entrancy)——一個有多個父節點的節點——因此圖不是樹。在「the operator wants to stop the pump」中,operator 同時是 want-01 與 stop-01 的 ARG0。AMR 刻意不規定圖如何從詞推導出來,因此詞與節點的對齊是另一個問題 [24]。
Smatch 把每張圖視為三元組的合取——instance(variable, concept) 或 relation(variable1, variable2)——並在使匹配最多的變數對應下,報告匹配三元組的精確率、召回率與 F1,以此評估 AMR 剖析 [25]。找出該對應是 NP 完全問題,因此論文提供整數線性規劃方法,以及帶隨機重啟的爬山啟發法 [25]。對四個變數的圖,我們可以直接嘗試每種對應:
程式碼 · Python · 20 行
import itertools

# "the operator wants to stop the pump" vs a parse that loses who stops.
gold = {("instance", "w", "want-01"), ("instance", "o", "operator"),
        ("instance", "s", "stop-01"), ("instance", "p", "pump"),
        ("ARG0", "w", "o"), ("ARG1", "w", "s"),
        ("ARG0", "s", "o"), ("ARG1", "s", "p")}
pred = {("instance", "a", "want-01"), ("instance", "b", "operator"),
        ("instance", "c", "stop-01"), ("instance", "d", "pump"),
        ("ARG0", "a", "b"), ("ARG1", "a", "c"), ("ARG1", "c", "d")}

def rename(triples, mapping):
    return {(r, mapping.get(x, x), mapping.get(y, y)) for r, x, y in triples}

pred_vars, gold_vars = sorted({t[1] for t in pred}), sorted({t[1] for t in gold})
best = max(len(rename(pred, dict(zip(pred_vars, perm))) & gold)
           for perm in itertools.permutations(gold_vars))
precision, recall = best / len(pred), best / len(gold)
print("matched triples:", best)
print(f"Smatch P={precision:.3f} R={recall:.3f} F1={2*precision*recall/(precision+recall):.3f}")
輸出
matched triples: 7
Smatch P=1.000 R=0.875 F1=0.933
預測圖少了一個三元組——說明 operator 也是執行停止者的再進入 ARG0 邊。Smatch 仍給 0.933。對安全應用而言,「誰停止幫浦」可能就是全部問題。與本章其他彙總指標一樣,Smatch 應搭配針對關鍵關係的檢查。
預訓練模型如何改變這些任務
直觀說法。 預訓練編碼器把剖析器、角色標註器與共指系統變成「編碼器加上小型結構解碼器」。它們沒有取消對解碼器、標註規範或謹慎評估的需求。
有三個明顯轉變。第一,特徵被上下文向量取代。Kitaev 與 Klein 的剖析器在使用預訓練詞表示後,從 93.55 提升到 95.13 F1 [6];Joshi 等人把 BERT 用於共指,在 OntoNotes 上報告比先前最佳成績高 3.9 F1,並指出在文件層級脈絡、對話與提及改寫上仍有弱點 [26]。SpanBERT 則改變預訓練目標本身——遮住連續跨度,並訓練跨度邊界表示去預測跨度內容——報告 OntoNotes 共指 79.6% F1,以及 SQuAD 1.1 與 2.0 上的 94.6 與 88.7 F1 [27]。跨度形狀的任務受益於跨度形狀的預訓練。
第二,結構有一部分其實存在於編碼器內部。Hewitt 與 Manning 的結構探測找到一個線性轉換,使詞向量間的平方距離編碼剖析樹中的距離;這對 ELMo 與 BERT 成立,對基準則不成立 [28]。Tenney、Das 與 Pavlick 發現 BERT 以可解釋的順序在各層表示傳統管線的步驟——詞性標記、剖析、命名實體、語意角色,最後是共指——同時有時會依較高層資訊修正較低層的決策 [29]。這些是探測結果:它們顯示資訊可被線性取出,不表示模型像剖析器那樣使用它。
第三,管線收斂成微調與提示。編碼器為標記與樹提供證據,大型語言模型也可以依提示回傳結構 [30]。輸出驗證器仍有必要:看起來合理的括號字串,可能漏掉詞元、重排詞,或不形成連通樹。
現代觀點
綜述與其分類。 Zhang 的句法—語意剖析綜述聚焦於兩種最常見的形式化——成分剖析與依存剖析——回顧兩者以及語意依存圖的代表模型,並涵蓋跨領域、跨語言與聯合剖析,以及語料建置 [31]。Poesio 等人對回指計算模型的回顧,從神經網路之前的研究一路追溯到現今的神經模型,整理標註資料集,並討論橋接指涉與篇章指示等較少研究的現象 [32]。Chen 等人的 SRL 綜述已獲 Artificial Intelligence Review 接受,提出四維分類——模型架構、句法特徵建模、應用情境與多模態延伸——分析句法特徵何時有幫助,並探討 LLM 與專門 SRL 系統的互補角色 [34]。Zhao 等人的 LLM 綜述區分模型訓練、調適、使用與能力評估 [30];結構可在其中扮演不同角色:監督輸出、內部表示探測、生成限制或診斷挑戰。Chang 等人的評估綜述再區分量測任務與使用的基準及程序 [33]。
近期原始研究(2023–2026)。 Tian、Xia 與 Song 發現 LLM 擅長淺層剖析(分塊),卻難以產生正確的完整成分樹,並以先提示分塊、再過濾分塊的方式改善 [35]。Hale 與 Stanojević 跨類型多樣的語言測試一項候選句法普遍性,發現所研究的模型只在部分較高資源語言中遵守它 [36],說明以英文為主的結構測試不能證明一致的多語言能力。在共指方面,Le 與 Ritter 發現提示指令微調模型可以勝過無監督共指系統,但依賴高品質的提及偵測 [37];Porada、Zou 與 Cheung 在五個共指系統間控制預訓練語言模型,發現在相同模型規模下,基於編碼器的模型勝過較新的基於解碼器的模型,而控制編碼器後,過去五年報告的 F1 提升大部分(但不是全部)消失 [38]。在語意表示方面,Jin 等人發現把 AMR 放進 LLM 思維鏈提示,在五個任務上大致弊多於利,錯誤集中在多詞表達、命名實體與最後推論步驟 [39]。
區分結構有效與結構泛化
這些研究引出兩種不同測試:第一,系統能否替這個標註規則產生合法結構?第二,選擇是否回應語法差異,而不是熟悉詞序?結構驗證器處理第一個問題,無法證明第二個。總是回傳某種慣常附接的模型,可以通過格式檢查,卻在受控比較中失敗。
建立詞彙幾乎不變、角色相關構造卻改變的配對(主動與被動、修飾語移位、關係子句),再固定構造並更換詞彙。如果不熟悉的名詞改變整個結構,詞彙涵蓋正在干擾;如果語法改變後解讀不變,熟悉詞彙模式主導了結果。最後檢查錯誤是否改變下游所需的語意角色。
較長上下文改變指涉決策,不只增加記憶大小
較長歷史可恢復缺少的先行詞,但也會加入相容候選;在先行詞 softmax 中,即使既有連結分數不變,新增候選仍會改變分母,因此以短歷史校準的門檻未必能沿用。比較短歷史、長但不相關的歷史,以及含另一台同類裝置的長歷史,才能區分有用脈絡與單純更多文字。
未解問題。 標註框架各有差異;低資源語言缺少獨立檢查的樹;切分與語法交互影響;自發對話含有片段與修正;長文件與對話中的共指仍然困難;模型也可能學會基準慣例,卻缺乏穩健的組合能力。保留替代分析、測試結構最小配對、比較架構時控制編碼器 [38],以及量測下游後果,是研究這些限制的具體做法。
重點整理
- 文法無法剖析是涵蓋範圍的結果,不是對說話者的評判;圖表共享跨度,但列舉所有樹仍可能指數成長。
- 最佳樹(最大值)與總機率(加總)回答不同問題;只有規則機率看不到詞彙證據,這正是神經跨度與弧評分器補上的部分。
- 轉移式剖析器做線性時間的局部決策;圖式剖析器替所有弧評分並需要樹解碼器,因為獨立選擇中心詞可能形成循環。
- 每種結構都有自己的指標——帶標籤括號、UAS/LAS、論元 F1、MUC/B³/CEAF、Smatch——且都需要說明分母與對齊政策。
- 語意角色在語法變換下保持不變;PropBank 依述詞編號論元,並把否定與情態標為附加語。
- 在擷取紀錄中保留作用範圍、歸屬與來源;過粗的結構描述會丟失任何編碼器事後都找不回的區別。
- 共指是偵測加上連結;一條錯誤橋接就可能合併實體,明確的歧義結果勝過自信的錯誤。
- 預訓練編碼器改進並簡化了這些系統,但有效性仍來自解碼器,評估仍來自標註規範。
練習
- 延伸文法。 讓圖表剖析器接受「we saw cameras」與一個新介系詞,再加入未見名詞,說明需要哪個詞彙改變。
提示
既有二元規則已支援較短句子。終結符的涵蓋與片語組合是不同問題。
- 辨識與列舉。 把圖表的樹清單改成布林類別,比較剖析器仍能回答什麼,以及丟掉什麼。接著修改 PCFG 程式,加入針對
robots with的詞彙化規則分數,讓名詞附接在原始規則機率下勝出。
提示
不保留樹仍能判斷是否接受;要恢復不同附接,需要回溯指標。詞彙化版本可把 的分數乘上一個依中心名詞而定的因子。
- 結構驗證器與非投射樹。 為基本依存樹檢查詞元輸出、每詞一個中心詞、沒有自我連結、唯一根與無循環。再為一個短句建構弧線會交叉的有效樹,並說明 arc-standard 神諭為何無法產生它。
提示
從每詞追蹤中心詞指標,應抵達根,且不重訪同一詞。arc-standard 只連結堆疊頂端兩項,因此它建立的每條弧都跨越一段連續、已完成的區域。
- 兩種閱讀,兩筆紀錄。 寫出「A technician inspected every sensor」的兩種解讀。設計能儲存任一種閱讀的關係結構描述,以及從文件集合回答「每個感測器都檢查過了嗎?」的證據規則。
提示
比較存在量詞在全稱量詞外側與相反順序。答案需要感測器清單與涵蓋資訊,而不只是擷取到的檢查事件。
- 共指指標。 建立一個把圖 5 五個提及全部併成一個實體的回應,以及一個讓五個提及都是單例的回應。執行程式前先算出兩者的 MUC、B³ 與 CEAF,再說明哪個指標對哪種錯誤最寬容。
提示
MUC 計算連結,所以單一巨大群組會保留每條鍵連結。B³ 對每個群組含錯誤成員的提及扣分。單例完全沒有連結。
- 雙語指示語。 寫一則含有指示詞、相對日期與間接請求的雙語訊息,例如混用英文與中文。描述兩種會改變解讀的語境,並列出共指或擷取系統需要哪些證據才能區分。
提示
轉寄引述會改變 “I”、“here” 與 “tomorrow” 所依據的視角。能力測驗與維修對話,可以讓相同問句有不同目的。
參考文獻
- Susan McRoy, Principles of Natural Language Processing, Chapters 3–5 and 7 and the chart-parsing appendix, open textbook, 2021. Open textbook
- Daniel Jurafsky and James H. Martin, Speech and Language Processing, 3rd ed. draft (August 19, 2026), Chapters 19, 20, 22 and 24. Book site
- E. Black, S. Abney, D. Flickenger, C. Gdaniec, R. Grishman, P. Harrison, D. Hindle, R. Ingria, F. Jelinek, J. Klavans, M. Liberman, M. Marcus, S. Roukos, B. Santorini and T. Strzalkowski, “A Procedure for Quantitatively Comparing the Syntactic Coverage of English Grammars,” Speech and Natural Language Workshop, 1991. Paper
- Mitchell P. Marcus, Beatrice Santorini and Mary Ann Marcinkiewicz, “Building a Large Annotated Corpus of English: The Penn Treebank,” Computational Linguistics 19(2), 1993. Paper
- Mitchell Stern, Jacob Andreas and Dan Klein, “A Minimal Span-Based Neural Constituency Parser,” ACL, 2017. Paper
- Nikita Kitaev and Dan Klein, “Constituency Parsing with a Self-Attentive Encoder,” ACL, 2018. Paper
- Nikita Kitaev, Steven Cao and Dan Klein, “Multilingual Constituency Parsing with Self-Attention and Pre-Training,” ACL, 2019. Paper
- Marie-Catherine de Marneffe, Christopher D. Manning, Joakim Nivre and Daniel Zeman, “Universal Dependencies,” Computational Linguistics 47(2), 2021. Paper
- Joakim Nivre, “Algorithms for Deterministic Incremental Dependency Parsing,” Computational Linguistics 34(4), 2008. Paper
- Danqi Chen and Christopher Manning, “A Fast and Accurate Dependency Parser using Neural Networks,” EMNLP, 2014. Paper
- Ryan McDonald, Fernando Pereira, Kiril Ribarov and Jan Hajič, “Non-Projective Dependency Parsing using Spanning Tree Algorithms,” HLT-EMNLP, 2005. Paper
- Eliyahu Kiperwasser and Yoav Goldberg, “Simple and Accurate Dependency Parsing Using Bidirectional LSTM Feature Representations,” Transactions of the ACL 4, 2016. Paper
- Timothy Dozat and Christopher D. Manning, “Deep Biaffine Attention for Neural Dependency Parsing,” ICLR, 2017. Paper
- Daniel Zeman, Jan Hajič, Martin Popel, Martin Potthast, Milan Straka, Filip Ginter, Joakim Nivre and Slav Petrov, “CoNLL 2018 Shared Task: Multilingual Parsing from Raw Text to Universal Dependencies,” CoNLL Shared Task, 2018. Paper
- Daniel Gildea and Daniel Jurafsky, “Automatic Labeling of Semantic Roles,” Computational Linguistics 28(3), 2002. Paper
- Martha Palmer, Daniel Gildea and Paul Kingsbury, “The Proposition Bank: An Annotated Corpus of Semantic Roles,” Computational Linguistics 31(1), 2005. Paper
- Xavier Carreras and Lluís Màrquez, “Introduction to the CoNLL-2005 Shared Task: Semantic Role Labeling,” CoNLL, 2005. Paper
- Luheng He, Kenton Lee, Mike Lewis and Luke Zettlemoyer, “Deep Semantic Role Labeling: What Works and What’s Next,” ACL, 2017. Paper
- Kenton Lee, Luheng He, Mike Lewis and Luke Zettlemoyer, “End-to-end Neural Coreference Resolution,” EMNLP, 2017. Paper
- Marc Vilain, John Burger, John Aberdeen, Dennis Connolly and Lynette Hirschman, “A Model-Theoretic Coreference Scoring Scheme,” MUC-6, 1995. Paper
- Xiaoqiang Luo, “On Coreference Resolution Performance Metrics,” HLT-EMNLP, 2005. Paper
- Sameer Pradhan, Xiaoqiang Luo, Marta Recasens, Eduard Hovy, Vincent Ng and Michael Strube, “Scoring Coreference Partitions of Predicted Mentions: A Reference Implementation,” ACL, 2014. Paper
- Sameer Pradhan, Alessandro Moschitti, Nianwen Xue, Olga Uryupina and Yuchen Zhang, “CoNLL-2012 Shared Task: Modeling Multilingual Unrestricted Coreference in OntoNotes,” EMNLP-CoNLL Shared Task, 2012. Paper
- Laura Banarescu, Claire Bonial, Shu Cai, Madalina Georgescu, Kira Griffitt, Ulf Hermjakob, Kevin Knight, Philipp Koehn, Martha Palmer and Nathan Schneider, “Abstract Meaning Representation for Sembanking,” Linguistic Annotation Workshop, 2013. Paper
- Shu Cai and Kevin Knight, “Smatch: an Evaluation Metric for Semantic Feature Structures,” ACL, 2013. Paper
- Mandar Joshi, Omer Levy, Luke Zettlemoyer and Daniel Weld, “BERT for Coreference Resolution: Baselines and Analysis,” EMNLP-IJCNLP, 2019. Paper
- Mandar Joshi, Danqi Chen, Yinhan Liu, Daniel S. Weld, Luke Zettlemoyer and Omer Levy, “SpanBERT: Improving Pre-training by Representing and Predicting Spans,” Transactions of the ACL 8, 2020. Paper
- John Hewitt and Christopher D. Manning, “A Structural Probe for Finding Syntax in Word Representations,” NAACL-HLT, 2019. Paper
- Ian Tenney, Dipanjan Das and Ellie Pavlick, “BERT Rediscovers the Classical NLP Pipeline,” ACL, 2019. Paper
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” Frontiers of Computer Science, 2026; online manuscript updated March 2026. Survey
- Meishan Zhang, “A survey of syntactic-semantic parsing based on constituent and dependency structures,” Science China Technological Sciences 63, 2020. Survey
- Massimo Poesio, Juntao Yu, Silviu Paun, Abdulrahman Aloraini, Pengcheng Lu, Janosch Haber and Derya Cokal, “Computational Models of Anaphora,” Annual Review of Linguistics 9, 2023. Survey
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Survey
- Huiyao Chen, Meishan Zhang, Jing Li, Lilja Øvrelid, Jan Hajič, Hao Fei and Min Zhang, “A Systematic Survey of Semantic Role Labeling in the Era of Pretrained Language Models,” arXiv:2502.08660, 2025; accepted at Artificial Intelligence Review. Survey
- Yuanhe Tian, Fei Xia and Yan Song, “Large Language Models are No Longer Shallow Parsers,” ACL, 2024. Paper
- John T. Hale and Miloš Stanojević, “Do LLMs learn a true syntactic universal?” EMNLP, 2024. Paper
- Nghia T. Le and Alan Ritter, “Are Large Language Models Robust Coreference Resolvers?” arXiv:2305.14489, 2023. Paper
- Ian Porada, Xiyuan Zou and Jackie Chi Kit Cheung, “A Controlled Reevaluation of Coreference Resolution Models,” LREC-COLING, 2024. Paper
- Zhijing Jin, Yuen Chen, Fernando Gonzalez Adauto, Jiarui Liu, Jiayi Zhang, Julian Michael, Bernhard Schölkopf and Mona Diab, “Analyzing the Role of Semantic Representations in the Era of Large Language Models,” NAACL, 2024. Paper
- NLTK contributors,
nltk.grammar.PCFG,API 文件,查閱日期 2026-11-05。正規化契約
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑這是「自然語言處理」單元的最後一篇。 回到學習地圖 →