Coreference — End-to-end Neural Coreference Resolution
選讀・NLP 12・句法與語意任務 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
共指消解必須判斷哪些文字跨度指向同一實體,也要處理未由獨立提及偵測器提供的跨度。Lee、He、Lewis 與 Zettlemoyer 提出共同學習跨度表示、提及分數及先行詞決策 [19]。論點是直接考慮候選跨度,就能從群集標註訓練文件級共指。先理解本章的跨度、提及、先行詞與分群;單一 token 的實體標籤還不是共指連結。
方法
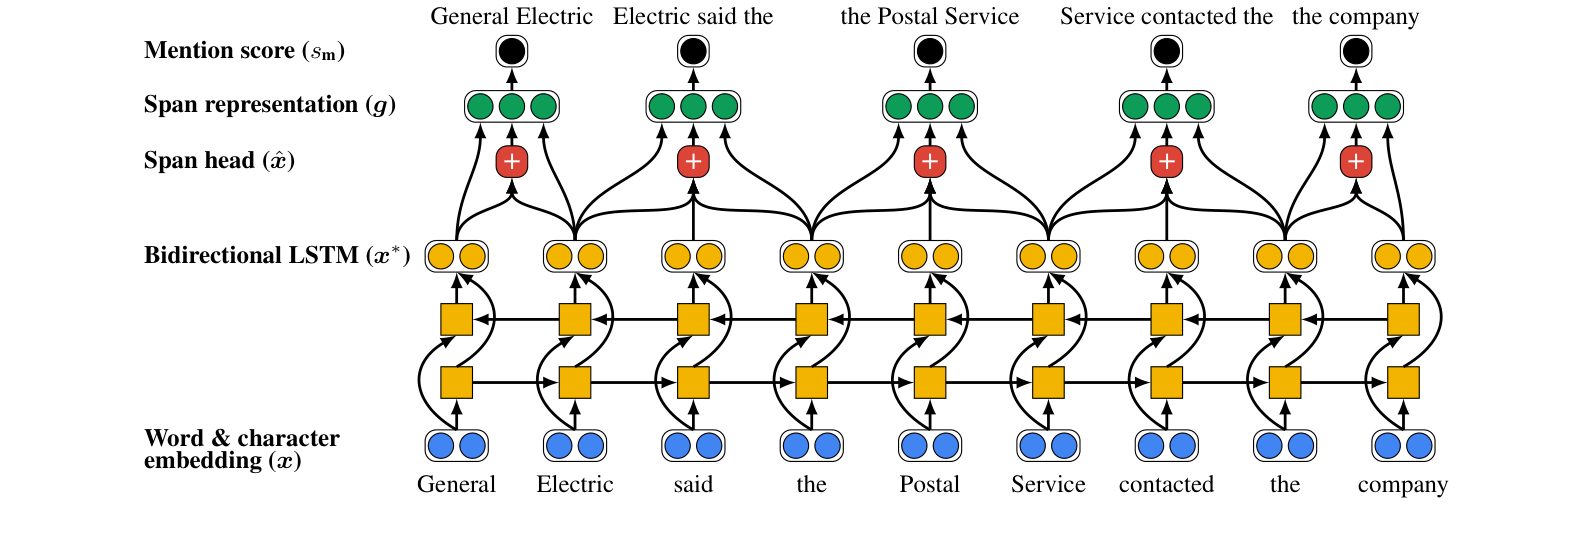
跨度表示結合雙向循環網路的端點狀態、跨度內詞彙的注意力加權表示,以及跨度寬度特徵。學得的注意力扮演軟中心詞,不需要正確句法中心詞標註。提及評分器先剪枝候選,再評估先行詞配對。
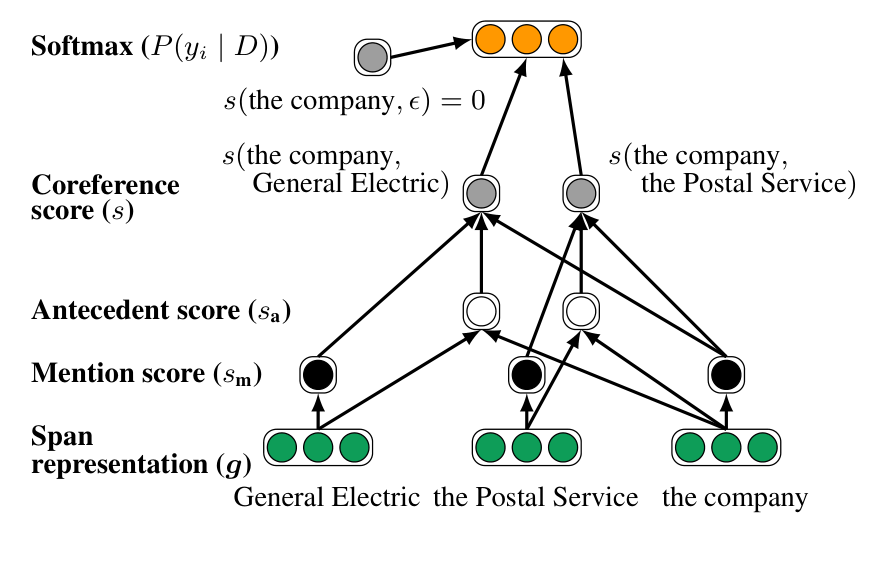
對保留的跨度,同時用提及品質及配對相容性評分較早候選:
是文件, 是目前跨度, 是非虛擬的較早跨度, 是提及分數, 是成對先行詞分數。 是選到的先行詞; 包含可用的較早候選與虛擬選項 , 走訪此集合。虛擬選項使用 ,不套用前面的加法公式,其用途包含開始新的實體群集。
訓練最大化分配給全部正確先行詞的機率總和,因為同一正確群集可能包含多個有效的先前提及,不必強迫指定其中一條連結。若沒有保留下來的正確先行詞,就使用虛擬選項。推論時以選到的先行詞連結形成群集;早期剪枝造成的遺漏,後續評分器無法補救。
結果
表 1 的英文 CoNLL-2012 測試結果,以 MUC、B³、CEAFφ4 三種 F1 平均報告:單模型 67.2,五模型集成 68.8。這些是群集指標,不是 token 準確率或提及偵測 F1。集成與單模型的計算成本不同;判斷小幅分數差異前,應確認使用相同評估程式與提及設定。
消融與設計證據
表 2 使用開發集:完整單模型為 67.7,移除中心詞注意力為 66.4,移除距離/寬度特徵為 63.9。這些降幅必須以 67.7 為基準,不是測試分數 67.2。系統也將跨度寬度限制為 10 個詞,最多保留文件 token 數 0.4 倍的跨度,先行詞上限為 250。剪枝控制成本,也可能移除正確提及或連結。
結論
重要連結是表示學習與候選集合上的結構化決策。沿兩張圖追蹤「the company」如何建立跨度、被剪枝及評估先行詞。再讀本章的共指評估:偵測提及、選擇先行詞、形成正確群集,是三個不同的錯誤來源。
問題與限制
剪枝形成召回率上限,虛擬選項也混合多種情況,並非完整的不確定性模型。文件類型、說話者中繼資料與標註規約都影響遷移。高分連結仍可能語意錯誤,尤其判斷需要文字之外的知識時。端到端訓練移除的是分開監督的提及流程,不是所有特徵選擇、搜尋近似或資料集假設。
參考文獻
- Susan McRoy, Principles of Natural Language Processing, Chapters 3–5 and 7 and the chart-parsing appendix, open textbook, 2021. Open textbook
- Daniel Jurafsky and James H. Martin, Speech and Language Processing, 3rd ed. draft (August 19, 2026), Chapters 19, 20, 22 and 24. Book site
- E. Black, S. Abney, D. Flickenger, C. Gdaniec, R. Grishman, P. Harrison, D. Hindle, R. Ingria, F. Jelinek, J. Klavans, M. Liberman, M. Marcus, S. Roukos, B. Santorini and T. Strzalkowski, “A Procedure for Quantitatively Comparing the Syntactic Coverage of English Grammars,” Speech and Natural Language Workshop, 1991. Paper
- Mitchell P. Marcus, Beatrice Santorini and Mary Ann Marcinkiewicz, “Building a Large Annotated Corpus of English: The Penn Treebank,” Computational Linguistics 19(2), 1993. Paper
- Mitchell Stern, Jacob Andreas and Dan Klein, “A Minimal Span-Based Neural Constituency Parser,” ACL, 2017. Paper
- Nikita Kitaev and Dan Klein, “Constituency Parsing with a Self-Attentive Encoder,” ACL, 2018. Paper
- Nikita Kitaev, Steven Cao and Dan Klein, “Multilingual Constituency Parsing with Self-Attention and Pre-Training,” ACL, 2019. Paper
- Marie-Catherine de Marneffe, Christopher D. Manning, Joakim Nivre and Daniel Zeman, “Universal Dependencies,” Computational Linguistics 47(2), 2021. Paper
- Joakim Nivre, “Algorithms for Deterministic Incremental Dependency Parsing,” Computational Linguistics 34(4), 2008. Paper
- Danqi Chen and Christopher Manning, “A Fast and Accurate Dependency Parser using Neural Networks,” EMNLP, 2014. Paper
- Ryan McDonald, Fernando Pereira, Kiril Ribarov and Jan Hajič, “Non-Projective Dependency Parsing using Spanning Tree Algorithms,” HLT-EMNLP, 2005. Paper
- Eliyahu Kiperwasser and Yoav Goldberg, “Simple and Accurate Dependency Parsing Using Bidirectional LSTM Feature Representations,” Transactions of the ACL 4, 2016. Paper
- Timothy Dozat and Christopher D. Manning, “Deep Biaffine Attention for Neural Dependency Parsing,” ICLR, 2017. Paper
- Daniel Zeman, Jan Hajič, Martin Popel, Martin Potthast, Milan Straka, Filip Ginter, Joakim Nivre and Slav Petrov, “CoNLL 2018 Shared Task: Multilingual Parsing from Raw Text to Universal Dependencies,” CoNLL Shared Task, 2018. Paper
- Daniel Gildea and Daniel Jurafsky, “Automatic Labeling of Semantic Roles,” Computational Linguistics 28(3), 2002. Paper
- Martha Palmer, Daniel Gildea and Paul Kingsbury, “The Proposition Bank: An Annotated Corpus of Semantic Roles,” Computational Linguistics 31(1), 2005. Paper
- Xavier Carreras and Lluís Màrquez, “Introduction to the CoNLL-2005 Shared Task: Semantic Role Labeling,” CoNLL, 2005. Paper
- Luheng He, Kenton Lee, Mike Lewis and Luke Zettlemoyer, “Deep Semantic Role Labeling: What Works and What’s Next,” ACL, 2017. Paper
- Kenton Lee, Luheng He, Mike Lewis and Luke Zettlemoyer, “End-to-end Neural Coreference Resolution,” EMNLP, 2017. Paper
- Marc Vilain, John Burger, John Aberdeen, Dennis Connolly and Lynette Hirschman, “A Model-Theoretic Coreference Scoring Scheme,” MUC-6, 1995. Paper
- Xiaoqiang Luo, “On Coreference Resolution Performance Metrics,” HLT-EMNLP, 2005. Paper
- Sameer Pradhan, Xiaoqiang Luo, Marta Recasens, Eduard Hovy, Vincent Ng and Michael Strube, “Scoring Coreference Partitions of Predicted Mentions: A Reference Implementation,” ACL, 2014. Paper
- Sameer Pradhan, Alessandro Moschitti, Nianwen Xue, Olga Uryupina and Yuchen Zhang, “CoNLL-2012 Shared Task: Modeling Multilingual Unrestricted Coreference in OntoNotes,” EMNLP-CoNLL Shared Task, 2012. Paper
- Laura Banarescu, Claire Bonial, Shu Cai, Madalina Georgescu, Kira Griffitt, Ulf Hermjakob, Kevin Knight, Philipp Koehn, Martha Palmer and Nathan Schneider, “Abstract Meaning Representation for Sembanking,” Linguistic Annotation Workshop, 2013. Paper
- Shu Cai and Kevin Knight, “Smatch: an Evaluation Metric for Semantic Feature Structures,” ACL, 2013. Paper
- Mandar Joshi, Omer Levy, Luke Zettlemoyer and Daniel Weld, “BERT for Coreference Resolution: Baselines and Analysis,” EMNLP-IJCNLP, 2019. Paper
- Mandar Joshi, Danqi Chen, Yinhan Liu, Daniel S. Weld, Luke Zettlemoyer and Omer Levy, “SpanBERT: Improving Pre-training by Representing and Predicting Spans,” Transactions of the ACL 8, 2020. Paper
- John Hewitt and Christopher D. Manning, “A Structural Probe for Finding Syntax in Word Representations,” NAACL-HLT, 2019. Paper
- Ian Tenney, Dipanjan Das and Ellie Pavlick, “BERT Rediscovers the Classical NLP Pipeline,” ACL, 2019. Paper
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” Frontiers of Computer Science, 2026; online manuscript updated March 2026. Survey
- Meishan Zhang, “A survey of syntactic-semantic parsing based on constituent and dependency structures,” Science China Technological Sciences 63, 2020. Survey
- Massimo Poesio, Juntao Yu, Silviu Paun, Abdulrahman Aloraini, Pengcheng Lu, Janosch Haber and Derya Cokal, “Computational Models of Anaphora,” Annual Review of Linguistics 9, 2023. Survey
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Survey
- Huiyao Chen, Meishan Zhang, Jing Li, Lilja Øvrelid, Jan Hajič, Hao Fei and Min Zhang, “A Systematic Survey of Semantic Role Labeling in the Era of Pretrained Language Models,” arXiv:2502.08660, 2025; accepted at Artificial Intelligence Review. Survey
- Yuanhe Tian, Fei Xia and Yan Song, “Large Language Models are No Longer Shallow Parsers,” ACL, 2024. Paper
- John T. Hale and Miloš Stanojević, “Do LLMs learn a true syntactic universal?” EMNLP, 2024. Paper
- Nghia T. Le and Alan Ritter, “Are Large Language Models Robust Coreference Resolvers?” arXiv:2305.14489, 2023. Paper
- Ian Porada, Xiyuan Zou and Jackie Chi Kit Cheung, “A Controlled Reevaluation of Coreference Resolution Models,” LREC-COLING, 2024. Paper
- Zhijing Jin, Yuen Chen, Fernando Gonzalez Adauto, Jiarui Liu, Jiayi Zhang, Julian Michael, Bernhard Schölkopf and Mona Diab, “Analyzing the Role of Semantic Representations in the Era of Large Language Models,” NAACL, 2024. Paper
- NLTK contributors,
nltk.grammar.PCFG,API 文件,查閱日期 2026-11-05。正規化契約