NLP 01・自然語言處理導論
先備知識:從這裡開始・學習路徑與推薦教科書
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
自然語言處理
你將學到
- 說明語言為何對電腦困難,並為每個語言學層次舉出一個歧義例子。
- 透過標誌性的論文,追溯 NLP 的主要時代:規則、統計學習、神經網路與預訓練模型。
- 依輸出形式分類常見 NLP 任務,並找到涵蓋各任務的教學。
- 認識中文特有的問題:斷詞,以及繁體字與簡體字兩套字集。
- 透過輸入、輸出與所需語言證據定義 NLP 任務,並在正規化與斷詞過程中保留這些證據。
- 建立資料切分,找出錯誤真正起源的處理階段。
先看全貌
自然語言處理(natural language processing, NLP)研究能分析、解讀或產生人類語言的電腦系統。NLP 流程把特定語言問題轉成計算。考慮「Pump B: not ready.」:維護應用可能需要設備名稱與陳述的就緒狀態;訊息分流應用可能只需要類別;對話助理則可能需要追問還有什麼沒完成。即使輸入字串相同,它們也是不同任務。
第一步是決定應用需要什麼答案,以及哪些證據支持答案。接著把文字轉成模型輸入,同時保留這些證據。前處理已抹去的差異,再強的模型也無法恢復;看似合理的標籤,若描述錯誤的目標,也沒有用。
本教學以 Hagiwara 從應用出發的觀點,以及 McRoy 對語言和相關資料結構的說明為基礎 [1, 2]。我們先看語言為何困難、領域如何走到今天的方法、它解決哪些任務,以及中文文字有什麼不同。接著沿著一條實用路線前進:定義任務、保留文字、選擇計算單位、建立資料,再評估結果。NLP 02 說明這些決策背後的語言結構,本教學最後的路線圖則串起整個系列。
1. 語言為何對電腦困難
白話版。 同一串字元可以有不同意思,而意思取決於結構、語境與說話者的目的。除非我們提供其餘資訊,否則電腦只看得到字元。
歧義出現在語言分析的每個層次。下表每一列都會在 NLP 02 以例子與程式深入說明:
| 層次 | 例子 | 兩種解讀 |
|---|---|---|
| 詞邊界 | 學生會說話 | 「學生有說話能力」/「學生會在發言」 |
| 詞類 | “the pilots can land” / “the metal can fell” | “can” 作助動詞/作名詞 |
| 詞義 | “window” | 牆上的開口/螢幕上的區域 |
| 附著 | “The technician inspected the panel with the camera.” | 相機是工具/相機裝在面板上 |
| 作用域 | “Every technician uses a camera.” | 可能是不同相機/一台共用相機 |
| 指稱 | “Mei put a camera beside a lamp. It was overheating.” | “it” 是相機/是燈 |
| 意圖 | “Can you lower the gain?” | 詢問能力/請求動作 |
人們解決大多數這類歧義時幾乎不自覺,靠的是前後文、情境與世界知識。程式則必須被提供這些語境,或從資料中學會近似它們。另外三種性質讓困難加劇。
- 生產性。 說話者隨時用熟悉的零件組出新詞與新句子,因此沒有一份有限的輸入清單能涵蓋整個語言。
- 偏斜的頻率。 少數詞極為常見,大多數詞很罕見。NLP 02 用 Zipf 定律量測這件事:在一個語料庫中,三分之一的詞型別只出現一次。罕見詞正是模型證據最少的地方。
- 變異。 方言、語域、拼寫慣例、混合語言訊息與書寫系統都不相同。以某一變體訓練的系統,可能在另一變體上悄悄失敗。
這些都不表示 NLP 做不到,而是表示每個系統都在選擇保留哪些區別;好的工程會把這些選擇明確寫出來。
2. 簡史:規則、統計、神經網路與預訓練
白話版。 早期系統依照人工撰寫的規則運作。後來的系統從大量文字集合學習機率。接著神經網路學會自己的特徵;今天,多數系統從一個以未標註文字預訓練的大型模型出發,再調整到任務上。
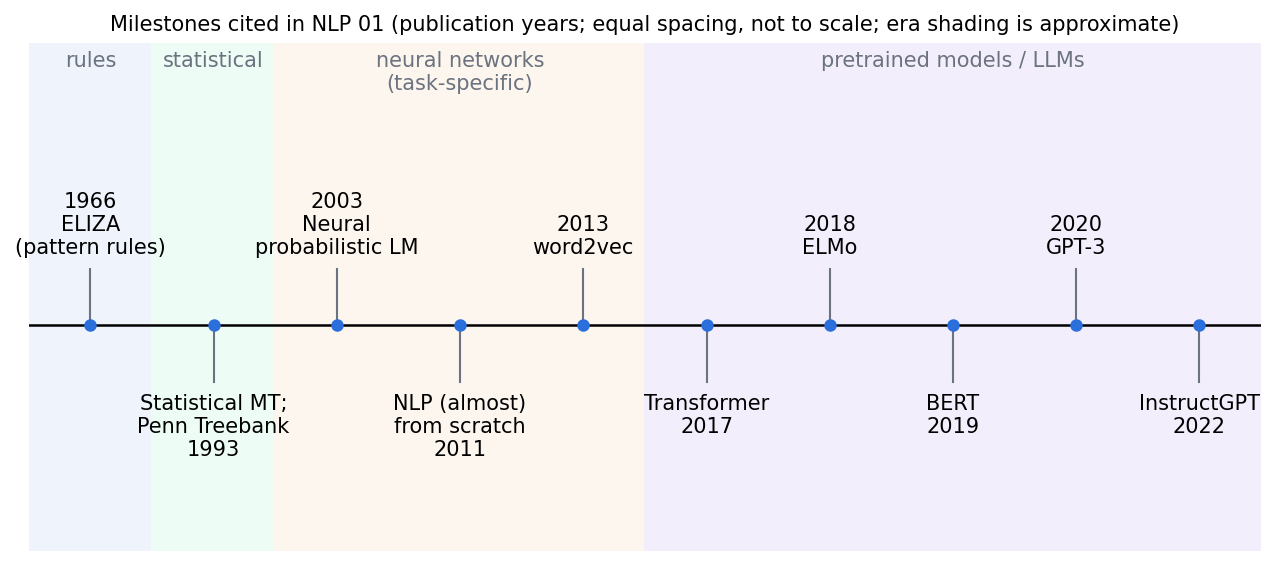
規則與人工建立的知識。 Weizenbaum 的 ELIZA(1966)回應輸入的英文時,會比對關鍵詞,並套用腳本中的分解與重組規則;它最知名的腳本模仿心理治療師的對話風格 [6]。這個時代的系統以人工編寫文法、詞庫與模式。在設計範圍內它們可以很精確,但每遇到新的說法或領域,都需要新規則。
從語料庫進行統計學習。 在接下來的數十年間,研究者越來越常從資料估計模型,而不是寫下每一條規則。Brown 等人(1993)描述一系列統計翻譯模型,其參數由互為翻譯的句子對估計而得 [7]。同一年,Penn Treebank 釋出一個標註詞性與句法結構的大型英文語料庫 [8],讓標記器與剖析器有共同的訓練資料與共同的測試。關鍵改變是證據來自語料庫中的計數,而在保留資料上評估也成為標準做法。
神經網路。 Bengio 等人(2003)訓練一個神經語言模型,同時學習每個詞的分散式表示與詞序列的機率 [9]。Collobert 等人(2011)用同一個神經架構處理詞性標註、詞組切分(chunking)、命名實體辨識與語意角色標註,主要從未標註文字學習內部表示,而不是依賴人工設計的特徵 [10]。Mikolov 等人(2013)讓詞向量能在大型語料庫上低成本地訓練 [11]。這時的模型仍傾向一次只為一個任務建立。
預訓練模型與大型語言模型。 Transformer(2017)以注意力取代循環結構 [12]。ELMo(2018)從預訓練的雙向語言模型提供依語境而變的詞表示 [13];BERT(2019)在未標註文字上預訓練深層雙向 Transformer,再為每個任務加上小型輸出層做微調 [14]。GPT-3(2020)顯示大型自迴歸模型只要在提示中看到幾個例子,不需梯度更新,就能執行許多任務 [15];InstructGPT(2022)則以人類回饋微調這類模型,使它遵循指令 [16]。Zhao 等人的綜述以預訓練、適應調整、使用方式與能力評估四個面向,組織大型語言模型的文獻 [17]。
各時代彼此重疊:規則式元件、計數方法與神經模型都仍在使用。能延續下去的是第 4–9 節的流程。不論用哪種模型,總要有人定義任務、保留證據、選擇單位、建立資料並進行評估。
3. 主要任務與應用
白話版。 大多數 NLP 任務可以依輸出分組:整段文字一個標籤、每個詞一個標籤、一個結構、從集合中找出的段落,或新的文字。
| 輸出形式 | 任務例子 | 應用 | 對應教學 |
|---|---|---|---|
| 每段文字或文字對一個標籤 | 主題分類、情感分析、垃圾訊息偵測、自然語言推論 | 分流、內容審核、評論分析 | NLP 03、NLP 11 |
| 每個 token 或範圍一個標籤 | 詞性標註、命名實體辨識、資訊擷取 | 把報告轉成紀錄 | NLP 06 |
| 語言結構 | 剖析、語意角色、共指 | 分析誰對誰做了什麼 | NLP 12 |
| 從集合中找證據 | 搜尋、擷取式問答 | 文件搜尋、客服 | NLP 11、NLP 09 |
| 依輸入產生新文字 | 翻譯、摘要、對話 | 翻譯工具、助理、聊天機器人 | NLP 08、NLP 09 |
| 可重用的表示 | 詞與句子嵌入、預訓練編碼器 | 相似度、分群、遷移到新任務 | NLP 04、NLP 10 |
同一個應用常結合好幾列。回答維修問題的助理,可能要分類問題、檢索段落、擷取設備名稱,再產生回覆。每一步都有自己的輸出與錯誤,所以本教學其餘部分把任務定義當成第一個設計決策。
4. 選模型前先規定任務
白話版。 「理解這則訊息」太籠統,無法直接訓練或評估。先指定哪些意思必須變成輸出。
對原創訊息「Pump B: not ready.」,三種可能輸出是:
| 任務 | 輸出 | 重要證據 |
|---|---|---|
| 主題分類 | maintenance | 訊息談的是設備狀態 |
| 實體擷取 | Pump B,附上原文範圍 | 設備名稱的確切字元 |
| 狀態擷取 | 設備 Pump B;就緒狀態 false | 名稱與否定就緒的陳述 |
第一個答案不能證明第三個答案。分類器可能只靠「pump」辨認主題,完全忽略「not」。狀態擷取器則必須保留否定。回傳設備名稱的系統還需要邊界規則:是否包含 B?是否排除冒號?把這些決定寫進標註說明。
接著比較「Pump B was not ready yesterday」與「Pump B is ready now」。設備相同,時間與肯定/否定卻不同。即時狀態應用需要處理多個帶日期陳述的規則;歷史擷取器可能保留兩者。正確答案取決於任務定義與可用脈絡,而不是字串唯一通用的解讀。
對「It still isn’t ready」,訊息沒有寫設備名稱。若應用提供前文對話,指涉解析就能使用它;若只有這句孤立文字,辨認出 Pump B 就是在加入從未提供的資訊。這是輸入設計問題,NLP 12(共指)與 NLP 08(對話狀態)會進一步討論。
預測與執行要分開。預測出重新安排的請求,並不能決定該修改哪一筆預約。先從能和文字核對的輸出開始,例如意圖標籤、設備名稱範圍,或明確陳述的事件。後續教學再加入解析缺漏細節所需的情境推理。
5. 保留原始文字與證據
白話版。 模型輸入與畫面上的證據文字,可以是同一則訊息的不同表示。保留能連起兩者的方式。
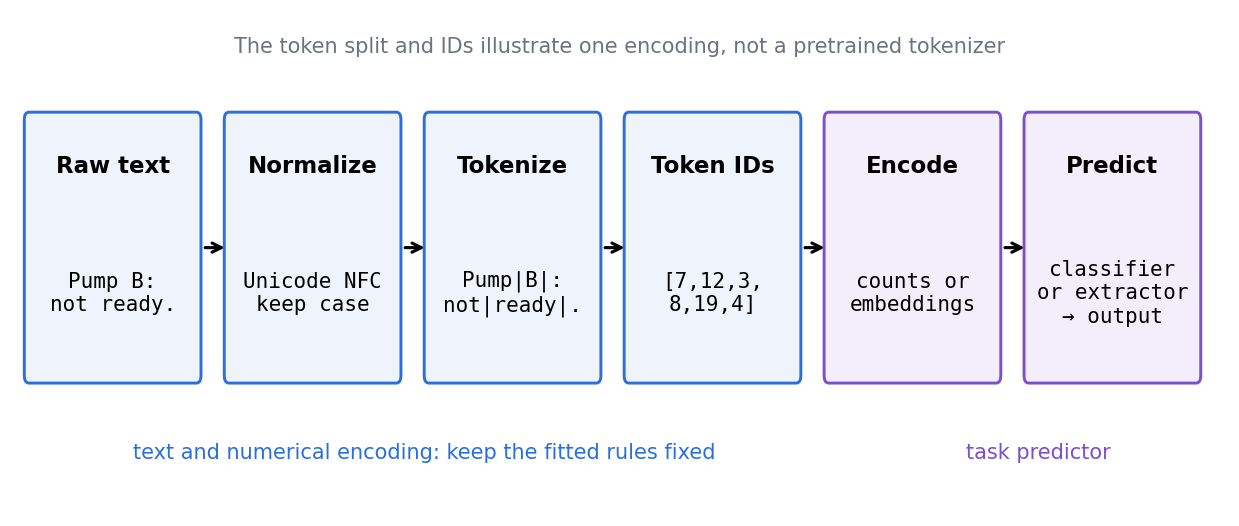
處理流程可寫成:
其中 是原始輸入紀錄; 是前處理與數值編碼函數; 是模型輸入; 是參數為 的預測器; 是輸出。紀錄可包含文字與允許使用的脈絡。前處理涵蓋正規化、token 邊界與詞彙 ID 等決策。
若兩筆不同紀錄變成同一個 ,確定性預測器就必須對兩者給出相同結果:
其中 是兩筆原始紀錄。這個簡單等式解釋了為什麼前處理也是模型的一部分。若移除「not」使肯定與否定陳述完全相同,之後再改神經架構也無法區分。把字母轉成小寫而合併 US 與 us,或移除標點而讓小數變成另一個字串,也有同樣問題。
有些等價關係很有用。Unicode NFC 正規化把標準等價的字元序列映成共同形式 [3]。這和自行決定移除重音、標點或大小寫不同:前者處理指定的字元等價關係,後者可能抹掉任務需要的差異。應先決定本應用中哪些輸入應視為等價,而不是把所有轉換都當成無害清理。
正規化與文字範圍的算例
Café 可以使用預組合的重音字母,也可以用基本字母 e 接上一個組合重音。兩者看起來相似,卻占用不同數量的 Unicode 碼位(code point)[3]。擷取器若回傳字元位置,正規化就可能讓後面的文字範圍位移。
文字範圍(span) 表示在指定字串中,從位移 開始、到 之前結束的字元。兩個位移都是非負整數,且 。不知道它們對應哪種文字表示與索引單位,位置本身就沒有意義。
程式碼 · Python · 20 行
import re
import unicodedata

raw = 'Café Pump B: not ready.'
normalized = unicodedata.normalize('NFC', raw)
needle = 'Pump B'
raw_start = raw.index(needle)
normal_start = normalized.index(needle)
raw_span = (raw_start, raw_start + len(needle))
normal_span = (normal_start, normal_start + len(needle))
tokens = [(m.group(), m.start(), m.end())
          for m in re.finditer(r'\w+|[^\w\s]', normalized)]
assert normalized != raw
assert unicodedata.normalize('NFC', normalized) == normalized
assert raw[raw_span[0]:raw_span[1]] == needle
assert raw[normal_span[0]:normal_span[1]] != needle
assert all(normalized[start:end] == token for token, start, end in tokens)
print('code points:', len(raw), '->', len(normalized))
print('raw / normalized evidence spans:', raw_span, normal_span)
print('normalized tokens:', [token for token, _, _ in tokens])
程式輸出碼位數 24 -> 23。原始設備名稱範圍為 (6, 12),正規化後為 (5, 11)。兩者在各自字串中都選出 Pump B;把第二個範圍套到第一個字串,卻會選錯字元。最後一個斷言檢查正規化 token 與其來源位移是否對應。
做擷取時,可以維護轉換位置到原文的對齊,也可以直接在原始字串保留標註。本例展示錯誤如何發生,沒有實作通用對齊演算法。NLP 06 會說明詞、token 與字元範圍如何成為結構化輸出。
6. 決定計算使用哪些單位
白話版。 詞、字元與模型 token 回答不同問題。選計算單位時,不要把它誤當成語言的所有單位。
在「a cat and a dog」中,空白切分得到五個 token 實例(occurrences)與四種不同的型別(types):a、cat、and、dog。詞彙表替每個保留型別指定 ID。ID 是表格項目的名字,ID 7 並不比 ID 3 表達更大的意思。
「Pump B: not ready.」則帶來不同選擇。空白切分會把標點黏在詞上;辨識標點的切分器可能產生 Pump、B、:、not、ready、.;子詞斷詞器還可能把詞切得更細。它們都可能是有效的計算編碼,但 token 位置不同。詞標籤必須對齊模型實際使用的編碼。
子詞斷詞器從資料學習要保留哪些片段。NLP 02 會逐步訓練一個小型位元組對編碼(byte-pair encoding, BPE)斷詞器,並與 WordPiece、unigram 模型及 SentencePiece 比較。它的核心結論是:學到的片段反映頻率而不是構詞,而斷詞器是一整套已擬合的程序,不只是一份詞彙清單。
詞彙覆蓋率與未知輸入
詞彙表只包含保留的項目。若把沒見過的詞映到未知標記,所有這類詞都共享同一個 ID。任務若主要依賴熟悉的周圍詞,這可能可接受;但未見設備名稱與未見帳戶名稱之間的差異也會消失。
定義一個示意的未知 token 比例:
其中 是未知 token 比例; 是指定斷詞器下第 個 token 實例; 是擬合後詞彙表; 是評估的出現總數; 在條件成立時為一。重複出現的未知詞會重複計數。這量測缺少詞彙項目的比例,不是失去多少意思,也不是任務準確度。
7. 中文文字:斷詞與兩套字集
白話版。 中文書寫的詞與詞之間沒有空格,所以決定詞的起訖本身就是一種分析。中文也以繁體字與簡體字兩套標準字集書寫,在其中一套上擬合的模型,看到另一套時會遇到許多陌生字元。
斷詞
中文通常沒有詞間空白。「學生會說話」可以切成 學生 / 會 / 說話(學生有說話能力),也可以切成 學生會 / 說話(學生會在發言);脈絡有助選出原本的意思。模型斷詞器也可能只使用字元或子詞片段,其切分未必是完整詞法或語法分析。NLP 02 用一個小程式列舉兩種解讀,並區分這些語言結構。
斷詞也是一種慣例。第二屆國際中文斷詞評測使用四個語料庫:兩個為繁體字(臺灣的中央研究院與香港城市大學),兩個為簡體字(北京大學與微軟研究院),每個都依提供者自己的標準切分 [18]。當資料集有詞層級標籤時,它依循的標準就是任務定義的一部分;以字元為單位的模型在評估前,必須把輸出對齊到這些詞。
繁體字與簡體字
臺灣與香港的文字主要以繁體字書寫,中國大陸的文字則以簡體字書寫;上述評測語料庫也依循這個分界 [18]。許多字在兩套字集中相同,但也有許多字是不同的 Unicode 碼位:繁體的「機」是 U+6A5F,其簡體對應字則是 U+673A。Unicode 正規化不會合併它們,因為它們是不同的字元,而不是同一字元的不同編碼方式。
轉換不是一對一的字元替換。Unihan 資料庫為每個字記錄繁簡異體,並指出語境可能決定對應:從簡體轉成繁體時,U+810F 表示「內臟」時對應「臟」,表示「不乾淨」時對應「髒」[19]。不同地區的用詞也可能不同,所以即使字元轉換完美,也無法把一種變體的文字變成另一種變體的文字。
字集不一致會直接反映在詞彙覆蓋率上。下列程式在一句繁體句子上擬合字元詞彙表,再對同一句新句子的兩種寫法量測未知 token 比例 。簡體版本以跳脫碼書寫,以便看出哪些字元不同。
程式碼 · Python · 7 行
vocab = set("這台相機已經校正好了")              # character vocabulary fitted on Traditional text
tests = {"Traditional": "那台相機已經過熱了",
         # The same sentence in Simplified characters, written as escapes:
         "Simplified": "那台相\u673a已\u7ecf\u8fc7\u70ed了"}
for name, text in tests.items():
    unknown = [f"U+{ord(ch):04X}" for ch in text if ch not in vocab]
    print(f"{name:11s} u = {len(unknown)}/{len(text)}  unknown: {unknown}")
繁體句子的 :「那」、「過」、「熱」不在這段極小的訓練文字中。簡體句子的 :「那」(兩套字集相同)以及「過」、「熱」的簡體形式仍然未知,另外再加上「機」與「經」的簡體對應字,因為詞彙表只有它們的繁體形式。真實詞彙表大得多,但效果在性質上相同:主要以一套字集訓練的模型,對另一套字集的證據較少。請決定要同時用兩套字集訓練、用考慮語境的工具轉換,還是分別評估各字集,並說明你的選擇。
8. 建立真正回答任務的樣本與標籤
白話版。 語料庫是觀測集合;訓練樣本則依任務從觀測建立。建立方式決定模型學什麼。
分類樣本可以是完整訊息配上一個類別;擷取樣本可以是訊息配上字元範圍與標籤;語言建模則由文字本身提供預測目標,不需要類別標註。這些差異解釋了為什麼同一份語料能支援不同目標 [1, 2]。
假設維護訊息含有「the camera is fine, but the delivery was late」。產品情緒標籤、配送情緒標籤與整則訊息標籤未必一致。標註說明應包含目標。標註者若選不同目標,分歧首先反映任務定義問題,還不能直接解讀成模型品質問題。
定義資料切分的獨立單位。同一件客訴的兩種改寫,雖然是不同字串,卻可能描述同一事件。一則放訓練、一則放測試,可能讓測試獎勵辨認該事件,而不是轉移到新事件。相關訊息、對話或文件修訂若共享資訊而可能洩漏,就應整組切分。
須追蹤兩種擬合狀態:預測器從訓練標籤學權重,斷詞器或詞彙表可能從未標註訓練文字學習。若特徵流程仍用測試文字決定詞彙表,只隔離測試標籤還不夠。兩者都須依實驗規則固定。
用小型基準診斷表示方式
先從容易檢查行為的表示開始。訊息的計數表示保留哪些詞出現,卻忽略順序。因此「The dog bit the man」與「The man bit the dog」即使反轉誰對誰做了什麼,仍有相同計數。只用這些計數的確定性分類器,必須對兩者給出相同預測。
這是精確的表示限制。只要特徵映射仍相同,更多樣本也無法分開這組句子。局部片語特徵能分開部分語序差異;脈絡模型可使用更豐富的輸入互動。NLP 03 會推導並測試這些選擇。針對實際失敗增加結構,實驗才能辨認改變了什麼。
9. 評估輸出,診斷錯誤原因
白話版。 評估應告訴你哪裡出錯、該改善哪裡。單一彙總分數通常找不出原因。
分類時檢查每個類別的錯誤,尤其罕見類別;準確率(accuracy)可能掩蓋某類從未被預測的問題。精確率(precision)問回傳項目有多少正確,召回率(recall)問必要項目找回多少。兩者都取決於如何定義項目 [5]。擷取找到正確詞卻回傳錯誤範圍,是邊界錯誤;狀態紀錄配對正確設備卻判錯肯定/否定,是意思錯誤。
保留幾組只改變一個重要語言差異的挑戰案例,例如「ready」與「not ready」、Pump A 與 Pump B、「yesterday」與「now」。固定任務,只改變該差異。普通訊息答對,還不能說明系統是否使用了這些案例所需的區別。
| 觀察 | 優先檢查 | 改善必須證明什麼 |
|---|---|---|
| 未見設備名稱被合併成同一表示 | 詞彙表與備援方式 | 名稱在輸入中仍可區分 |
| 詞正確,證據反白範圍錯誤 | 正規化與位移對齊 | 回傳位移對應畫面原文 |
| 否定使真實標籤反轉,預測卻不變 | 特徵映射與監督訊號 | 相關差異保留於編碼,並影響決策 |
| 驗證結果好,新客戶結果差 | 切分獨立性與領域差異 | 表現能轉移到目標群體 |
| 在一套中文字集上表現好,另一套很差 | 字元覆蓋率與轉換 | 兩套字集都被涵蓋,或明確回報差距 |
盡可能一次只改一個階段。前處理和模型一起改,即使分數提高,也無法知道誰造成改善。解讀權重或輸出前,先檢查轉換後輸入。這讓錯誤分析成為可測試的解釋,而不是一串模型名字。
10. NLP 系列路線圖
本系列依循第 2 節的時代順序:先談語言結構,再談神經網路基礎、序列模型、注意力與 Transformer,最後是預訓練模型與結構化任務。
| 教學 | 內容 |
|---|---|
| NLP 01・自然語言處理導論 | 語言為何困難、歷史、任務、中文問題,以及從任務到評估的流程 |
| NLP 02・語言學基礎 | 構詞、token 與子詞、詞性、句法、意義、語境、語料庫與 Zipf 定律 |
| NLP 03・自然語言處理的類神經網路 | 計數特徵、TF–IDF、邏輯迴歸與神經網路文字分類器 |
| NLP 04・詞彙語意與詞嵌入 | 分布式意義、計數式向量、word2vec |
| NLP 05・用於語言的循環神經網路 | n-gram 語言模型、困惑度、循環語言模型 |
| NLP 06・以 RNN 做序列標註 | 詞性標註、實體辨識與範圍評估 |
| NLP 07・注意力機制與 Transformer | 注意力、語境表示與位置 |
| NLP 08・以 Transformer 建構序列到序列模型 | 編碼器–解碼器模型、解碼、機器翻譯與聊天機器人 |
| NLP 09・以 Transformer 做語言模型 | 因果語言模型、文字生成與檢索增強生成 |
| NLP 10・預訓練模型:BERT | 遮罩語言預訓練與 BERT 編碼器 |
| NLP 11・以 BERT 做分類 | 情感分析、自然語言推論與擷取式問答輸出層 |
| NLP 12・句法與語意任務 | 剖析、語意角色、共指與篇章 |
本站其他教學涵蓋一般機制:ML 02 介紹神經網路,ML 04 介紹循環網路,ML 05 介紹注意力與 Transformer 區塊,IT 01 介紹熵與交叉熵。
第一次讀論文的路線。 先讀章節正文;這十二篇導讀是選讀檢查點,不是額外先修要求。每篇開頭說明先備知識,結尾提供下一步。路線依問題分組,不照發表年份排列;理解注意力動機時,可依 Seq2Seq → Bahdanau → Transformer 閱讀。
論文路線 1・文字單位與詞向量
先理解: 斷詞、向量內積、交叉熵
理解檢查: token 是什麼?哪些證據賦予向量意義?
論文路線 2・局部與序列決策
先理解: 卷積、循環狀態、條件機率
閱讀順序: TextCNN → Seq2Seq → BiLSTM-CRF
理解檢查: 局部特徵如何變成類別、序列或受約束的標籤路徑?
論文路線 3・注意力與預訓練
先理解: 編碼器—解碼器流程、softmax、遮罩
閱讀順序: Bahdanau attention → Transformer → BERT
理解檢查: 模型能讀哪些上下文?訓練它預測什麼?
論文路線 4・任務目標與結構
先理解: 微調、句對、跨度評估
閱讀順序: Sentence-BERT → InstructGPT → Coreference
理解檢查: 相似度、人類偏好與實體連結需要哪些不同證據?
每讀一篇,試著解釋原圖的一條箭頭、定義目標式中的符號,並指出一個結果所用的資料切分與模型設定。若有不清楚的步驟,先回到導讀連結的所屬章節再繼續。
現代觀點
Chang 等人的評估綜述整理語言模型應評估什麼、在哪裡評估與如何評估 [4]。對處理流程而言,這促使我們分別檢查編碼、任務輸出與應用行為。生成解釋再流暢,也不是設備名稱召回率的另一種量測;兩種輸出回答不同問題。
Zhao 等人的大型語言模型綜述描述了目前的預設做法:在廣泛文字上預訓練一個大型模型,再加以適應(例如指令調整或對齊人類偏好),透過提示使用它,並在許多任務上評估其能力 [17]。它的組織方式呼應第 2 節的歷史:每個時代都沿用前一時代的任務定義,改變的是從文字得到輸出的方式。
對現今系統,可沿用的原則是比較模型家族前先檢查介面。相關文字沒有被截斷,較大的輸入預算才有用;表示能支持任務所需差異(包括使用者同時以兩套中文字集書寫時),多語斷詞器才有用。預訓練表示可能減少所需標註資料,但應用目標仍需要明確監督與評估。後續教學會分析各自機制,而不是把這些當成自動得到的好處。
開放問題包含如何量測超越字元覆蓋的語言覆蓋、切分如何影響不同語言與語域,以及如何區分表示失敗、標籤不足與脈絡缺漏。一個有用的小研究,是在固定任務、獨立切分資料與幾個語言診斷案例下比較兩種編碼。回報各編碼保留或失去什麼,再據此解釋觀察到的錯誤。
重點整理
- 語言在每個層次都有歧義,從詞邊界到意圖;語境與世界知識能解決字串本身無法決定的部分。
- NLP 從人工規則走向語料統計,再走向神經網路與預訓練模型;任務定義與評估問題則原封不動地延續下來。
- 依輸出形式分組任務:文字標籤、token 標籤、結構、檢索證據、生成文字或表示。
- 中文多了兩個問題:依不同標準進行的斷詞,以及轉換並非一對一的兩套字集。
- 選模型前,先定義輸出與支持它的語言證據,並區分原始文字與轉換後模型輸入。
- 預測器無法恢復前處理函數已抹掉的差異;token 與詞彙 ID 是計算單位,不是完整語言分析。
- 只在允許的訓練文字上擬合學習式表示,切分時把相關觀測放在同組;改架構前,先診斷詞彙、邊界、意思與轉移錯誤。
練習
- 對「Pump B was not ready yesterday, but it is ready now」,定義主題分類、歷史狀態擷取與目前狀態擷取的標籤。哪些標籤需要時間處理規則?
提示
設備名稱可以不變,狀態值與有效時間卻不同。先決定回傳一個狀態,還是兩個帶日期事件。
- 把正規化範例中的分解重音換成預組合重音。說明哪些位移改變,哪些斷言仍有效。
提示
分別比較原文與正規化字串。位移是某個表示中的位置,不是所有外觀等價字串中的共同位置。
- 讓一個前處理規則移除「not」。建構兩則所需狀態標籤不同、轉換輸入卻相同的訊息,證明確定性預測器為什麼不能分開它們。
提示
套用包含 與 的等式。矛盾在訓練前就已出現。
- 在字集覆蓋程式中,改用繁體訓練句與其簡體版本的聯集擬合詞彙表,重新計算兩個測試句的 。接著解釋為什麼只靠一張字元對照表,不一定能在查詢前把每個簡體測試字轉成繁體。
提示
聯集能消除字集造成的未知字,卻無法消除「那」、「過」、「熱」。關於轉換,請參考 Unihan 的例子:同一個簡體碼位依意思對應到兩個不同的繁體字。
- 把同一事件的三則改寫訊息分組,建立訓練/測試資料集。設計切分與兩種診斷,區分事件記憶與對新事件的轉移。
提示
按事件整組切分,再分別檢查未見名稱與未見措辭。標籤規則保持固定。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapters 1–3 and 10–11, Manning, 2021. 出版社
- Susan McRoy, Principles of Natural Language Processing, open textbook, 2021. 書籍
- Unicode Consortium, “Unicode Normalization Forms,” Unicode Standard Annex #15, revision 58, 2026. 規格
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. 綜述
- Scikit-learn developers, “Metrics and Scoring: Quantifying the Quality of Predictions,” documentation, current online edition. 文件
- Joseph Weizenbaum, “ELIZA—A Computer Program for the Study of Natural Language Communication Between Man and Machine,” Communications of the ACM, 9(1), pp. 36–45, 1966. DOI
- Peter F. Brown, Stephen A. Della Pietra, Vincent J. Della Pietra and Robert L. Mercer, “The Mathematics of Statistical Machine Translation: Parameter Estimation,” Computational Linguistics, 19(2), 1993. 論文
- Mitchell P. Marcus, Beatrice Santorini and Mary Ann Marcinkiewicz, “Building a Large Annotated Corpus of English: The Penn Treebank,” Computational Linguistics, 19(2), 1993. 論文
- Yoshua Bengio, Réjean Ducharme, Pascal Vincent and Christian Jauvin, “A Neural Probabilistic Language Model,” Journal of Machine Learning Research, 3, pp. 1137–1155, 2003. 論文
- Ronan Collobert, Jason Weston, Léon Bottou, Michael Karlen, Koray Kavukcuoglu and Pavel Kuksa, “Natural Language Processing (Almost) from Scratch,” Journal of Machine Learning Research, 12, pp. 2493–2537, 2011. 論文
- Tomas Mikolov, Kai Chen, Greg Corrado and Jeffrey Dean, “Efficient Estimation of Word Representations in Vector Space,” arXiv:1301.3781, 2013. 論文
- Ashish Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. 論文
- Matthew E. Peters et al., “Deep Contextualized Word Representations,” NAACL-HLT, 2018. 論文
- Jacob Devlin, Ming-Wei Chang, Kenton Lee and Kristina Toutanova, “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,” NAACL-HLT, 2019. 論文
- Tom B. Brown et al., “Language Models are Few-Shot Learners,” NeurIPS, 2020. 論文
- Long Ouyang et al., “Training Language Models to Follow Instructions with Human Feedback,” NeurIPS, 2022. 論文
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” arXiv:2303.18223, 2023 (continuously updated). 綜述
- Thomas Emerson, “The Second International Chinese Word Segmentation Bakeoff,” Proceedings of the Fourth SIGHAN Workshop on Chinese Language Processing, 2005. 論文
- Unicode Consortium, “Unicode Han Database (Unihan),” Unicode Standard Annex #38, revision 41, 2026. 規格
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 02・語言學基礎 · 34 分鐘