Bahdanau attention — Jointly Learning to Align and Translate
選讀・NLP 08・以 Transformer 建構序列到序列模型(機器翻譯、聊天機器人) 的論文導讀(第 1/1 篇)。引用編號對應本頁底部的參考文獻。
導覽:本頁與本系列: 導覽:本頁與本系列
挑戰
固定向量的編碼器—解碼器必須先壓縮來源,再開始生成翻譯。Bahdanau、Cho 與 Bengio 探討解碼器能否在每個輸出步驟,重新查看不同來源位置 [7]。論點是只用平行句對監督,同時學習翻譯與軟對齊。先理解本章的編碼器—解碼器;即使已在 NLP 07 學過後來的 Transformer,這個循環注意力模型仍能說清楚注意力的動機。
方法
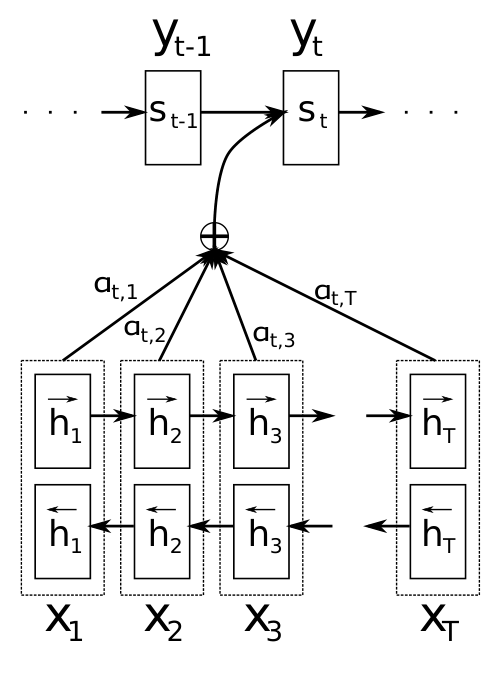
雙向循環編碼器在每個來源位置建立一個表示,結合左右上下文。解碼器預測目標詞前,小型可學習對齊網路根據前一狀態,評估各來源表示的用途:
是目標步驟, 是來源位置, 是來源長度, 是前一解碼器狀態, 是雙向來源表示。可學習前饋函數 給出分數 ; 是正規化注意力權重, 是加權所得的上下文向量。分母的 走訪全部來源位置。解碼器把這個上下文與前一狀態、前一目標 token 一起使用。
圖 1 的箭頭清楚呈現與固定向量模型的差異:整個生成過程都能存取來源表示。加權總和可微分,因此翻譯損失能訓練對齊機制,不需要額外提供詞對齊標註。這是位置上的軟分佈,不是硬性指定每個目標詞恰好翻譯一個來源詞。
結果
表 1 的完整英譯法測試集上,RNNencdec-50 得到 17.82 BLEU,RNNsearch-50 為 26.75。訓練更久的 RNNsearch-50 達到 28.45,論文列出的 Moses 基準為 33.30。篩選掉來源或參考譯文含未知詞的句子後,訓練較久的注意力模型為 36.15,Moses 為 35.63;該篩選評估也禁止生成未知 token。這個結果不能證明在完整測試分佈上勝出。
消融與設計證據
比較涵蓋兩種模型,以及最大訓練句長 30 或 50 的設定。圖 2 將效能對照句長,支持注意力在此設定較能處理長輸入的主張。但表 1 帶星號的模型訓練更久,因此其提升不是只改注意力的消融。讀證據時應分開處理架構、訓練句長篩選、訓練時間與未知詞篩選。
結論
關鍵是把單一固定來源摘要,改成每個輸出位置都依解碼器狀態重新產生摘要。試著解釋為何兩個目標步驟能對同一來源詞給出不同權重。再回到 NLP 07 的 Transformer 導讀,比較循環模型的可學習對齊,以及投影查詢—鍵與編碼器—解碼器交叉注意力。
問題與限制
注意力本身不會解決未知詞,循環解碼器也仍需依序執行。來源表示已包含周圍上下文,因此權重不能解讀為某個孤立詞的獨占貢獻。好看的對齊圖可協助診斷,卻不證明因果解釋或翻譯正確。長度穩健性也必須在論文篩選過的訓練、評估條件之外另行檢查。
參考文獻
- M. Hagiwara, Real-World Natural Language Processing, Manning, 2021, Chapters 6 and 8. Book · Sequence-to-sequence chapter
- S. McRoy, Principles of Natural Language Processing, open textbook, 2021, Chapter 9. Book · Generation chapter
- P. F. Brown, S. A. Della Pietra, V. J. Della Pietra and R. L. Mercer, “The Mathematics of Statistical Machine Translation: Parameter Estimation,” Computational Linguistics 19(2), 1993. Paper
- P. Koehn, F. J. Och and D. Marcu, “Statistical Phrase-Based Translation,” HLT-NAACL, 2003. Paper
- K. Cho, B. van Merriënboer, C. Gulcehre, D. Bahdanau, F. Bougares, H. Schwenk and Y. Bengio, “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation,” EMNLP, 2014. Paper
- I. Sutskever, O. Vinyals and Q. V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper
- D. Bahdanau, K. Cho and Y. Bengio, “Neural Machine Translation by Jointly Learning to Align and Translate,” ICLR, 2015. Paper
- A. Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. Paper
- R. Sennrich, B. Haddow and A. Birch, “Neural Machine Translation of Rare Words with Subword Units,” ACL, 2016. Paper
- M. Ranzato, S. Chopra, M. Auli and W. Zaremba, “Sequence Level Training with Recurrent Neural Networks,” ICLR, 2016. Paper
- S. Bengio, O. Vinyals, N. Jaitly and N. Shazeer, “Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks,” NeurIPS, 2015. Paper
- Y. Wu et al., “Google’s Neural Machine Translation System: Bridging the Gap between Human and Machine Translation,” arXiv:1609.08144, 2016. Paper
- K. Papineni, S. Roukos, T. Ward and W.-J. Zhu, “Bleu: a Method for Automatic Evaluation of Machine Translation,” ACL, 2002. Paper
- M. Post, “A Call for Clarity in Reporting BLEU Scores,” WMT, 2018. Paper
- M. Popović, “chrF: character n-gram F-score for automatic MT evaluation,” WMT, 2015. Paper
- R. Rei, C. Stewart, A. C. Farinha and A. Lavie, “COMET: A Neural Framework for MT Evaluation,” EMNLP, 2020. Paper
- C.-Y. Lin, “ROUGE: A Package for Automatic Evaluation of Summaries,” Text Summarization Branches Out, 2004. Paper
- M. Freitag et al., “Results of WMT22 Metrics Shared Task: Stop Using BLEU – Neural Metrics Are Better and More Robust,” WMT, 2022. Report
- A. Lavie et al., “Findings of the WMT25 Shared Task on Automated Translation Evaluation Systems: Linguistic Diversity is Challenging and References Still Help,” WMT, 2025. Report
- T. Kocmi et al., “Findings of the WMT24 General Machine Translation Shared Task: The LLM Era Is Here but MT Is Not Solved Yet,” WMT, 2024. Report
- NLLB Team et al., “Scaling neural machine translation to 200 languages,” Nature 630, 2024. DOI
- F. Stahlberg, “Neural Machine Translation: A Review,” Journal of Artificial Intelligence Research 69, 2020. DOI
- O. Vinyals and Q. V. Le, “A Neural Conversational Model,” ICML Deep Learning Workshop, 2015. Paper
- J. Li, M. Galley, C. Brockett, J. Gao and B. Dolan, “A Diversity-Promoting Objective Function for Neural Conversation Models,” NAACL-HLT, 2016. Paper
- J. Deriu, Á. Rodrigo, A. Otegi, G. Echegoyen, S. Rosset, E. Agirre and M. Cieliebak, “Survey on Evaluation Methods for Dialogue Systems,” Artificial Intelligence Review 54, 2021. Survey
- J. Ni, T. Young, V. Pandelea, F. Xue and E. Cambria, “Recent Advances in Deep Learning Based Dialogue Systems: A Systematic Survey,” Artificial Intelligence Review 56, 2023. Survey
- Y. Qin et al., “Tool Learning with Foundation Models,” ACM Computing Surveys 57, 2024. Author manuscript · Publication
- P. Schmidtova et al., “Do My Eyes Deceive Me? A Survey of Human Evaluations of Hallucinations in NLG,” INLG, 2025. Survey
- C. Szegedy, V. Vanhoucke, S. Ioffe, J. Shlens and Z. Wojna, “Rethinking the Inception Architecture for Computer Vision,” CVPR, 2016. Paper
- M. Freitag, G. Foster, D. Grangier, V. Ratnakar, Q. Tan and W. Macherey, “Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation,” Transactions of the Association for Computational Linguistics 9, 2021. DOI