NLP 04・詞彙語意與詞嵌入
先備知識:NLP 03・自然語言處理的類神經網路
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分詞形、詞元(lemma)與詞義,並說出主要的詞彙關係:同義、反義、上下位與部分整體關係,以及 WordNet 如何組織它們。
- 解釋分布假設:共享上下文能提供哪些詞彙證據,以及無法確立哪些意義關係。
- 建立詞與上下文矩陣,把正向 PMI 轉成精簡向量,並推導 CBOW、Skip-gram、負取樣、GloVe 與 fastText 的目標函數。
- 以相似度與類比測試評估嵌入,同時認清它們的限制,並量測一種關聯偏誤。
- 將詞向量池化成句子表示、以對比學習訓練句子嵌入,並說明上下文嵌入改變了什麼。
先看全貌
詞 ID 只識別詞彙表項目。它的數值不會說明該詞在語言中做什麼。嵌入(embedding)替項目配置學習出的向量,讓不同詞共享有用的統計模式。核心問題不只是如何把向量縮小,而是哪些證據與目標應該決定它的座標。
語言學家以詞彙語意學(lexical semantics)描述詞義:詞的各種意義,以及同義、上下位等關係,並由人工記錄在 WordNet 這類資源中。分布式方法則改從文字學習向量。本課連結這兩種觀點。Hagiwara 將詞與文件嵌入發展為實務應用可重用的特徵 [1]。McRoy 則區分詞彙相似度與情緒、蘊涵等語言任務 [2]。這裡專注於表示本身,並持續追問:向量幾何實際捕捉的是哪一種詞彙關係。
NLP 03 把詞向量當成任務的副產品來學習:分類器裡的嵌入層,以及 Bengio 等人神經機率語言模型中的表 [3]。Word2Vec 則把向量本身當成目標,並以鄰近詞、而不是下一個詞,作為預測對象。兩者的預測約定不同:
| 問題 | 神經機率語言模型 | 靜態 Word2Vec 嵌入 |
|---|---|---|
| 觀察什麼? | 有順序的 個 token 歷史,以及緊接其後的 token | 中心詞與兩側選定的鄰近詞 |
| 預測什麼? | 下一個 token 的正規化分布 | 從鄰近詞猜中心詞,或從中心詞分別猜鄰近詞 |
| 目的是由左至右生成嗎? | 是;它本身就是語言模型 | 基本視窗訓練不是有順序的生成器 |
| 訓練後重用什麼? | 整個網路;詞向量只是副產品 | 學習出的向量表 |
CBOW 中的 continuous 代表內部表示具有實數座標,不代表文字本身連續、詞之間沒有邊界,或每種詞義都各有向量。本課最後會連結計數式與預測式構造,並指出各自保留的資訊。計數式語言模型及其評估則留到 NLP 05。
詞彙語意:詞義與關係
白話版。 一個寫出來的詞可能有好幾個意義,而意義之間有結構化的關係:有些幾乎等價,有些彼此相反,有些是另一個的一種。嵌入稍後會把其中好幾種關係混在一起,所以先替它們命名。
詞形、詞元與詞義
詞形(word form)是文字中實際出現的樣子(banks、banked);詞元(lemma)是把各種屈折形式歸在一起的辭典條目(bank)。詞義(sense)是詞元的一個意義。bank 至少有兩個彼此無關的詞義:河邊的斜坡與金融機構,這是同形異義(homonymy)。window 的詞義彼此相關:牆上的開口與螢幕上的區域,這是一詞多義(polysemy)。NLP 02 討論上下文與組合如何選出詞義。對表示而言,關鍵在於詞彙表項目是詞形或詞元,不是詞義:每個項目只有一列的表,必然把該項目的所有詞義合併在一起。
詞義之間的關係
詞彙關係存在於詞義之間,而不是拼寫字串之間:
- 同義(synonymy):兩個詞義在許多上下文中可以互換,意義改變很小,例如
slope與incline。完全同義很少見;語域、搭配與隱含意義通常不同。 - 反義(antonymy):沿著某個尺度或維度相反的詞義,例如
hot與cold。反義詞在其他方面非常相似:描述同一種屬性,出現在同類句子中。 - 下位與上位關係(hyponymy、hypernymy):一種「是一種」關係。
poodle是dog的下位詞,dog是poodle的上位詞。這種關係不對稱,通常具遞移性,形成階層。 - 部分整體關係(meronymy):部分與整體,例如
wheel與car。
另有兩個概念對評估很重要。相似度(similarity)問兩個概念是否共享屬性(cup 與 mug);相關性(relatedness)或聯想(association)問它們是否常一起出現(cup 與 coffee)。相關的一對詞不一定相似。
WordNet:人工建立的詞彙資料庫
WordNet 把英文名詞、動詞、形容詞與副詞組織成同義詞集(synset):表達同一概念的一組同義詞元,各附一段簡短釋義(gloss),並以上位、部分整體與反義等關係相連 [4]。查詢一個詞元會傳回它的各個同義詞集,每個詞義一個。沿著上位連結往上走,會到達越來越一般的概念,讓程式能量測兩個詞義在階層中相距多遠。
下列範例以相同風格、用手工建立一個迷你資料庫,不必下載 WordNet 本身也能展示運作方式。其中條目都是本課自行編寫的。
程式碼 · Python · 31 行
# A hand-built miniature lexical database in the style of WordNet (not WordNet data).
synsets = {
    "bank.n.slope":   {"lemmas": ["bank"], "gloss": "sloping land beside a river", "hypernym": "slope.n"},
    "bank.n.finance": {"lemmas": ["bank"], "gloss": "an institution that holds deposits", "hypernym": "institution.n"},
    "slope.n":        {"lemmas": ["slope", "incline"], "gloss": "a surface at an angle", "hypernym": "landform.n"},
    "landform.n":     {"lemmas": ["landform"], "gloss": "a natural feature of land", "hypernym": "entity.n"},
    "institution.n":  {"lemmas": ["institution"], "gloss": "an organization with a public role", "hypernym": "organization.n"},
    "school.n":       {"lemmas": ["school"], "gloss": "an institution for teaching", "hypernym": "institution.n"},
    "organization.n": {"lemmas": ["organization"], "gloss": "a group with a purpose", "hypernym": "entity.n"},
    "entity.n":       {"lemmas": ["entity"], "gloss": "anything that exists", "hypernym": None},
}

def senses(word):
    return [s for s, v in synsets.items() if word in v["lemmas"]]

def path_to_root(s):
    path = [s]
    while synsets[path[-1]]["hypernym"]:
        path.append(synsets[path[-1]]["hypernym"])
    return path

def path_similarity(a, b):            # 1 / (1 + edges on the shortest is-a path)
    pa, pb = path_to_root(a), path_to_root(b)
    common = next(s for s in pa if s in pb)
    return 1 / (1 + pa.index(common) + pb.index(common))

print("senses of bank:", senses("bank"))
print("synonyms in slope.n:", synsets["slope.n"]["lemmas"])
print("hypernym chain:", " -> ".join(path_to_root("bank.n.finance")))
for other in ["school.n", "slope.n"]:
    print(f"path_similarity(bank.n.finance, {other}) = {path_similarity('bank.n.finance', other):.3f}")
執行會印出:
程式碼 · 5 行
senses of bank: ['bank.n.slope', 'bank.n.finance']
synonyms in slope.n: ['slope', 'incline']
hypernym chain: bank.n.finance -> institution.n -> organization.n -> entity.n
path_similarity(bank.n.finance, school.n) = 0.333
path_similarity(bank.n.finance, slope.n) = 0.167
bank 的金融詞義比較接近 school(兩者都是機構),而不是 slope,即使 bank 的另一個詞義正是一種斜坡。詞義清單讓這個區別明確;字串 bank 的單一向量做不到。
人工資源精確且可解讀,但建置成本高,對某些語言與領域的涵蓋遠優於其他,跟不上新詞與新詞義,而且只編碼一套詞義劃分,未必符合應用需求。分布式向量做的是相反的取捨:便宜、涵蓋廣,但關係是隱含且混雜的。許多實務工作會結合兩者,例如用詞彙資源檢查嵌入的近鄰。
分布式證據:上下文是觀察
白話版。 出現在相似上下文的詞,可能得到相似向量。上下文提供用法的證據,不會直接提供定義或真值條件。
Harris 主張意義的差異與分布的差異相關,也就是與語言單位出現的環境相關 [5]。這個分布假說(distributional hypothesis)是本課其餘所有方法的基礎。
詞類型(word type)是詞彙表項目;詞出現(word token)是一次實際出現。靜態嵌入把許多次出現的證據彙整成該類型的一個向量。bank 在 river 旁與在 account 旁出現,都會影響同一列。模型可以學到這個詞的混合用法,但查表操作無法為每種詞義選不同列。
收集統計之前先定義上下文。半徑二的詞視窗包含中心詞左右各最多兩個 token,排除中心詞。較短視窗著重緊鄰位置;較大視窗納入較遠的主題證據。若方向重要,可以把左側與右側位置當成不同特徵。本課刻意合併兩側,讓模型的不變性明確呈現。
分布假設(distributional assumption)實用之處,在於文字提供重複觀察,不必替每個詞標註語意類別。它並不完整,因為共享用法包含同義、反義、主題關聯與語法相容性。hot 與 cold 都可能出現在 water 前;基於這種證據的相似度,無法確立兩者表達相同屬性。用上一節的術語來說,分布式相似度混合了同義、反義、同位下位詞與相關性。Turney 與 Pantel 按照矩陣所表示的證據,整理這些向量空間方法 [6]。
一起記錄語料、tokenizer 與視窗規格。改變斷詞方式,就改變哪些類型被計算上下文。從技術事故報告學出的嵌入,可能以不同於電子設備手冊的方式組織 charge。座標是這些選擇的結果,不是與語言無關的詞義測量。
計數式嵌入:檢查共享上下文的假設
白話版。 計算每個詞與各種上下文一起出現的頻率,再與假設兩者獨立的基準比較。特別強的關聯會形成正向座標。
Turney 與 Pantel 的分布式表示綜述 [6] 說明這種計數式途徑。令 計算中心詞 與鄰近上下文詞 所形成之有序配對的觀察次數。即使兩種角色的詞彙表包含相同詞,角色仍不同。從表格定義經驗機率:
其中 是中心與上下文的總配對數, 是一個儲存格的計數, 是經驗聯合機率, 是中心詞邊際機率, 是上下文邊際機率。加總遍歷對應詞彙表。一個 token 可能貢獻多個配對,因此 不是 token 數。
逐點互資訊(pointwise mutual information,PMI)比較經驗聯合機率與獨立基準。正向 PMI(positive PMI,PPMI)只保留強於基準的關聯:
其中 是一個配對的對數關聯分數, 是其非負版本, 是自然對數。機率定義如上。聯合計數為零且邊際機率為正時,PMI 趨近負無限大,PPMI 為零;整列完全未觀察到則需要另外處理。
高頻上下文不會自動得到很大的關聯分數。它必須比整體頻率所預期的更常出現在這個中心詞附近。相反地,罕見配對可能只靠很少證據就得到高 PMI。應同時檢查計數與分數;移除負關聯、只保留正關聯,也是在捨棄資訊,不會使剩下的每個關聯都可靠。
PPMI 矩陣仍為每個上下文保留一個座標。截斷奇異值分解(singular value decomposition,SVD)可將它壓縮:
其中 是 PPMI 矩陣, 與 包含左右奇異向量, 是奇異值對角矩陣, 是保留維度,下標 取前 個奇異成分。 是低秩重建, 提供下方使用的中心詞向量。這是程式採用的慣例;以其他方式分配奇異值縮放,會產生不同的向量幾何。
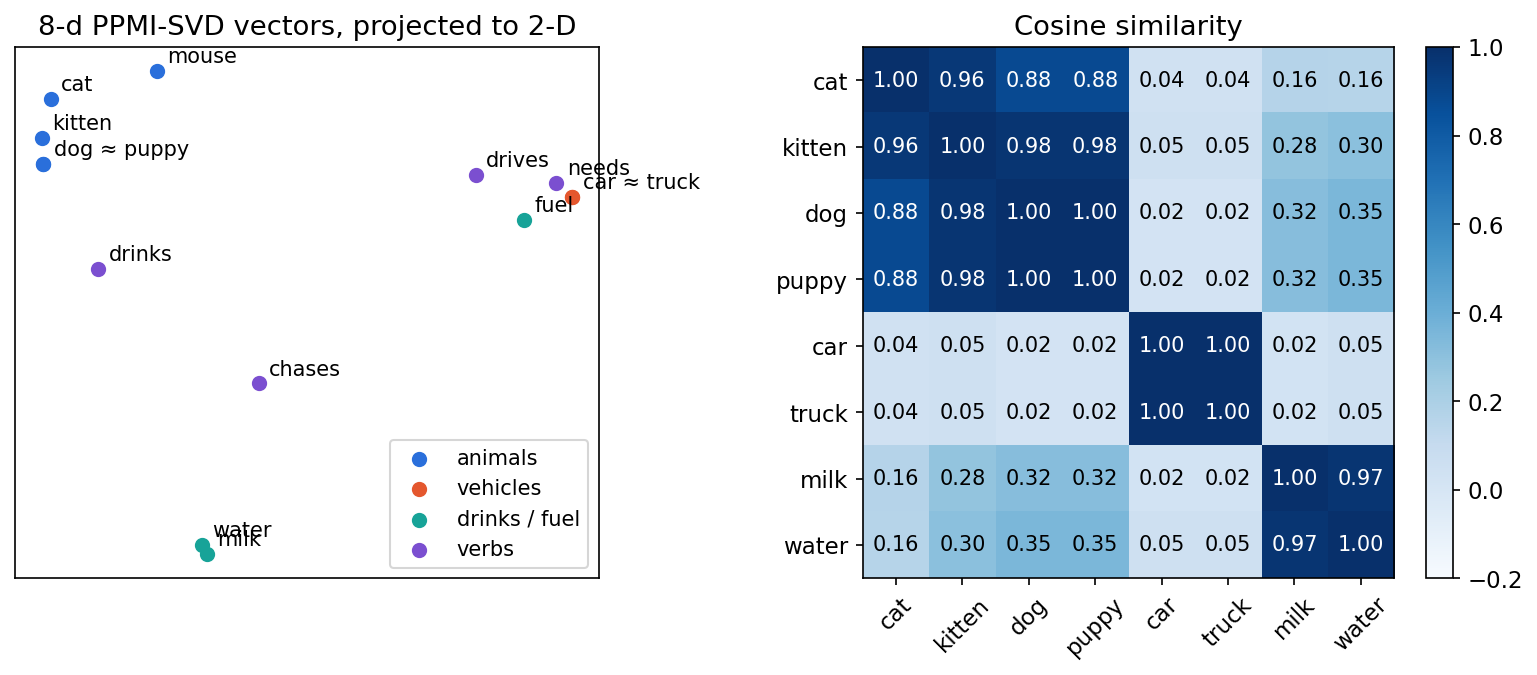
SVD 找出列之間共享的模式,不會替每個座標指定語意名稱。若原矩陣的秩高於 ,壓縮無法保留每個儲存格。下列合成語料讓我們同時檢查構造方式,以及將餘弦相似度解讀為同義關係的失敗案例。
程式碼 · Python · 37 行
import numpy as np

sentences = """the cat drinks milk . the dog drinks water . a cat chases a mouse .
a dog chases a cat . the kitten drinks milk . the puppy drinks water .
a kitten chases a ball . a puppy chases a ball . the car needs fuel .
the truck needs fuel . a car drives on the road . a truck drives on the road .""".split(".")
tokens = [s.split() for s in sentences if s.strip()]
vocab = sorted({w for s in tokens for w in s})
idx = {w: i for i, w in enumerate(vocab)}

# 1) Co-occurrence counts within a +-2 word window.
C = np.zeros((len(vocab), len(vocab)))
for s in tokens:
    for i, w in enumerate(s):
        for j in range(max(0, i - 2), min(len(s), i + 3)):
            if j != i:
                C[idx[w], idx[s[j]]] += 1

# 2) Positive pointwise mutual information.
total = C.sum()
pw, pc = C.sum(1, keepdims=True) / total, C.sum(0, keepdims=True) / total
with np.errstate(divide="ignore"):
    pmi = np.log((C / total) / (pw * pc))
ppmi = np.maximum(pmi, 0)

# 3) Truncated SVD gives dense 8-dimensional embeddings.
U, S, _ = np.linalg.svd(ppmi)
E = U[:, :8] * S[:8]
E /= np.linalg.norm(E, axis=1, keepdims=True)

def nearest(word, k=3):
    sims = E @ E[idx[word]]
    order = [vocab[i] for i in np.argsort(-sims) if vocab[i] != word]
    return [(w, round(float(sims[idx[w]]), 2)) for w in order[:k]]

for w in ["cat", "puppy", "truck", "milk"]:
    print(w, "->", nearest(w))
輸出:
程式碼 · 4 行
cat -> [('kitten', 0.96), ('puppy', 0.88), ('dog', 0.88)]
puppy -> [('dog', 1.0), ('kitten', 0.98), ('cat', 0.88)]
truck -> [('car', 1.0), ('needs', 0.6), ('the', 0.47)]
milk -> [('water', 0.97), ('a', 0.62), ('chases', 0.51)]只用十二個句子、沒有任何標籤,動物就和動物聚在一起,車輛和車輛聚在一起。注意「milk」與「water」幾乎相同:在這個語料中兩者都是被喝的東西。嵌入相似度量的是共享的上下文,這通常、但不總是對應到相似的意思;例如「熱」與「冷」這類反義詞也會共享上下文。
Word2Vec:藉由預測鄰近詞學習詞向量
白話版。 出現在相似上下文的詞,常具有相似用途。Word2Vec 把這個觀察變成小型預測任務:從鄰近詞猜中心詞,或從中心詞猜鄰近詞,並學習有助於預測的向量。向量是學習出的參數,不是人工列出的詞義清單。兩種基本架構是連續詞袋模型(continuous bag of words,CBOW)與 Skip-gram [7]。
把句子轉成訓練樣本
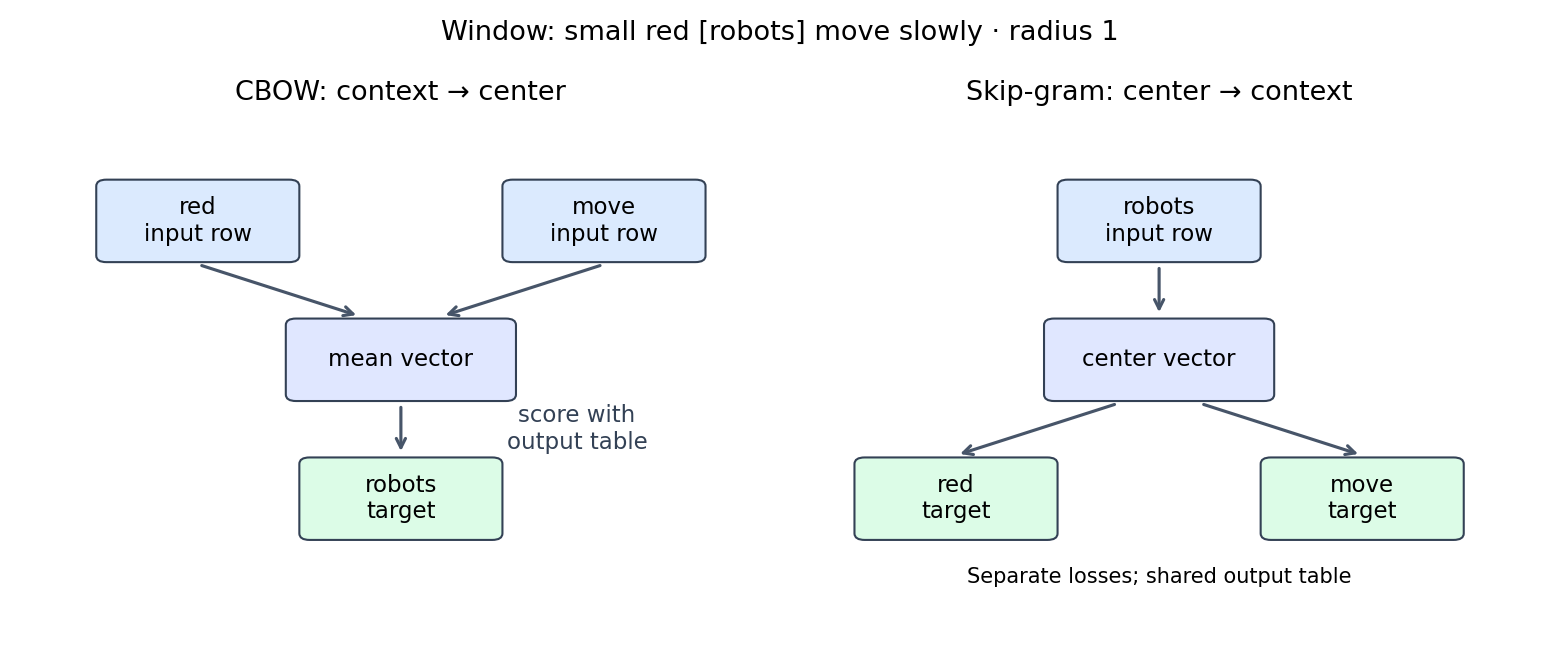
從原創句子 small red robots move slowly 開始。上下文視窗(context window)選出鄰近位置;半徑一代表中心詞前後各一個詞。此例只使用句子內部的中心位置,因此每個視窗都有兩個鄰近詞:
| 中心詞 | 上下文 | CBOW 訓練樣本 | Skip-gram 訓練樣本 |
|---|---|---|---|
red | small、robots | [small, robots] → red | red → small;red → robots |
robots | red、move | [red, move] → robots | robots → red;robots → move |
move | robots、slowly | [robots, slowly] → move | move → robots;move → slowly |
CBOW 結合多個上下文詞來預測一個中心詞;Skip-gram 用一個中心詞,分別預測各個上下文詞。 Skip-gram 並不產生有順序的句子;「skip」也不代表隨機刪詞。目標可以位於中心詞任一側。實作可在句子邊界使用較短視窗;這裡的程式略過那些中心位置,讓張量形狀保持簡單。
訓練標籤直接來自文字本身。在建立樣本之前,不必有人替 robots 標註語意類別。重複出現就提供重複證據。視窗決定模型被鼓勵捕捉的關係:即使詞彙表不變,改變視窗仍會改變訓練任務。
兩個嵌入表與 softmax
一個詞作為輸入時需要向量,作為預測候選時也需要向量。使用兩個學習表,而不是先假定這兩種角色共享權重:
其中 是輸入嵌入表, 是輸出嵌入表, 是詞彙表大小, 是向量維度, 是詞的 ID,冒號選取該列的所有座標。轉置把 與 變成直向行向量。 表示輸入, 是目標詞 ID, 索引候選詞, 是目標的 softmax 機率。每個內積都是預測分數;分母使整個詞彙表的機率總和為一。
CBOW 平均上下文向量來形成輸入。損失要求模型替觀察到的中心詞配置較高機率:
其中 是位置 的中心詞, 是選出的鄰近位置集合且不包含 , 是集合大小, 是這些詞向量的平均, 包含有效中心位置, 是中心詞負對數機率的平均。平均不保留上下文順序:交換左右鄰近詞會產生相同輸入。有些寫法加總上下文向量;本課與程式使用平均。
Skip-gram 則查出中心詞向量,再用相同預測規則處理每個鄰近詞:
其中 是 Skip-gram 損失, 是觀察到的中心與上下文位置配對, 是配對數, 索引中心位置, 索引一個鄰近位置, 是輸入詞, 是目標詞。即使詞 ID 重複,每次出現仍保留為獨立樣本。
一次訓練步驟會相對於其他候選,提高觀察到的目標分數,同時改變選出的輸入向量與輸出向量。許多樣本重複使用同一個輸入列,迫使模型整合該詞在不同上下文出現的證據。這種共享預測任務,就是從離散詞 ID 學到連續特徵的途徑。這兩種基本架構都不需要堆疊很深的隱藏層,這是它們與 NLP 03 神經語言模型在計算上的主要差別。
負取樣:比較觀察配對與隨機抽樣
完整 softmax 對每次預測都計算詞彙表中每個詞的分數。負取樣(negative sampling)將這個跨詞彙表的分類,改成較小的二元任務:區分實際觀察到的中心與上下文配對,以及隨機抽取目標詞形成的配對。Word2Vec 的後續論文提出了這個方法 [8]。
對觀察到的輸入詞 與上下文詞 ,一次取樣的損失為:
其中 是一組觀察配對的負取樣損失, 是中心詞 ID, 是觀察到的上下文詞 ID, 是中心的輸入向量, 與 是輸出向量, 是指定的隨機目標數, 是分布 的第 次抽樣, 是作用於實數分數 的 sigmoid。第一項鼓勵觀察配對具有高分;其餘項鼓勵隨機配對具有低分。完整訓練目標對觀察配對與取樣隨機性取平均。若使用 CBOW 版本,可用上下文平均向量取代 。
原論文使用的一種常見取樣分布為:
其中 是抽出詞彙項目 的機率, 是它在語料中的出現次數, 索引詞彙表項目, 是詞彙表大小。相較於直接依次數取樣,這個指數讓頻率分布較平坦。它是設計選擇,不是普遍的機率定律。
對觀察配對 robots → move,隨機抽樣可能產生 robots → red。「負」標籤的意思是由雜訊程序抽出,並不宣稱兩個詞永遠不會共同出現。抽樣結果可能是其他位置的真實上下文,甚至與這次的目標相同。實作必須說明是否保留、略過或重新抽取這類碰撞;改變規則也會改變取樣目標。模型區分的是配對的統計來源,不是在建立絕對不相容的詞典。
二元 sigmoid 分數在詞彙表上的總和不等於一。負取樣是另一種訓練目標,不是上面 softmax 的精確計算;其損失也不是正規化的下一詞概似。它用來學習實用表示,而表示仍應依預定的下游任務評估。
預測為何會改變向量幾何
「從鄰近詞學習」可以直接從梯度看懂。對一個使用完整 softmax 的目標詞,其分數是輸出向量與輸入表示的內積:
其中 是候選詞 的分數, 是觀察到目標詞 時的損失, 在候選詞等於目標詞時為一,否則為零; 是對輸入表示的梯度。嵌入表、詞彙表大小 與條件機率皆沿用前面的定義。
梯度下降會讓輸入表示靠近觀察到的輸出向量,同時遠離模型依機率加權的其他候選向量平均。某個詞每次出現,都會透過同一列累積更新。因此,上下文分布相似的詞可能學到相近的預測角色,過程中完全不需要標註它們是不是同義詞。
對使用平均的 CBOW,每個選中的上下文向量列都收到 。如果兩組上下文只是相同詞的不同排列,輸入表示就無法區分它們。Skip-gram 則讓一個中心詞向量接受多個鄰詞目標的更新;它的基本分數沒有欄位記錄鄰詞位於左邊還是右邊。因此,選擇視窗同時決定目標函數可以直接表達哪些關係;擴大視窗並不只是讓小視窗變得更準確。
負取樣分數究竟估計什麼
先暫時不限制嵌入維度,就能看清楚取樣目標。固定一個中心詞,假設每個候選詞都有可以獨立調整的分數。以 表示它的經驗上下文機率、 表示雜訊機率,該候選詞對期望損失的貢獻為:
其中 是一個候選上下文詞, 是不受限制的實數分數, 與 是固定中心詞下的兩種機率, 是每個觀察詞對所搭配的獨立雜訊取樣次數, 是前面定義的 sigmoid。本推導保留雜訊取樣恰好抽到觀察目標的碰撞情況。
當兩種機率都大於零時,駐點分數為:
其中 使該候選詞的期望損失最小。若 、、,最佳分數就是零:在相關的機率質量中,兩種統計來源各占一半。如果只將 改成 ,最佳分數就變成 。觀察到的上下文頻率沒有改變,雜訊分布卻改變了分數。因此,正分數表示「比這個取樣基準更常共同出現」,並不表示「這個詞對一定有意義」。若觀察機率為零、雜訊機率為正,則不受限制的最佳分數趨向負無窮。
如果雜訊分布恰好等於語料的上下文邊際分布,這個比值就得到 PMI 減去 。Levy 與 Goldberg 分析了由此產生的矩陣分解觀點 [9];常用的四分之三次方取樣分布則會改變這個比值。實際嵌入模型讓分數共用低維向量,通常無法同時達到每個獨立最佳值。因此,向量表是在秩限制下折衷不同詞對的統計關係。這既說明它與計數式方法的連結,也解釋了截斷 PPMI 矩陣與訓練 Word2Vec 為何不一定得到相同向量。
完整 softmax 每個目標的運算量約為 ;計算一個觀察目標與 個取樣詞的分數則約為 ,尚未計入取樣與批次處理成本。其中 是嵌入維度。計算量降低的同時,目標函數也改變了。sigmoid 值與負取樣損失都不能代替計算困惑度時所需的正規化詞元機率。
在 CPU 訓練 CBOW 與 Skip-gram
這個獨立範例使用完整 softmax 學習輸入與輸出表。詞彙表很小,因此可以直接檢查目標,不需要取樣近似。兩個模型共用相同的原創語料、半徑一的內部視窗、嵌入寬度與訓練迴圈。Skip-gram 路徑只有一個輸入詞,取平均就是中心向量本身。
程式碼 · Python · 57 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(7)
torch.set_num_threads(1)
corpus = [
    'small red robots move slowly',
    'small blue robots move quickly',
    'large red sensors work slowly',
    'large blue sensors work quickly',
    'small red sensors work quietly',
    'large blue robots move quietly',
]
vocab = sorted(set(' '.join(corpus).split()))
ids = {word: i for i, word in enumerate(vocab)}
cbow_x, cbow_y, sg_x, sg_y = [], [], [], []
for sentence in corpus:
    tokens = [ids[word] for word in sentence.split()]
    # Use radius 1 and interior centers, so every context has two words.
    for t in range(1, len(tokens) - 1):
        neighbors = [tokens[t - 1], tokens[t + 1]]
        cbow_x.append(neighbors)
        cbow_y.append(tokens[t])
        for neighbor in neighbors:
            sg_x.append([tokens[t]])
            sg_y.append(neighbor)

class Word2Vec(nn.Module):
    def __init__(self, size, width=8):
        super().__init__()
        self.input = nn.Embedding(size, width)
        self.output = nn.Embedding(size, width)
        nn.init.normal_(self.input.weight, std=0.1)
        nn.init.normal_(self.output.weight, std=0.1)

    def forward(self, context):
        h = self.input(context).mean(dim=1)
        return h @ self.output.weight.T

embeddings = {}
for name, inputs, targets in [('CBOW', cbow_x, cbow_y),
                             ('Skip-gram', sg_x, sg_y)]:
    x, y = torch.tensor(inputs), torch.tensor(targets)
    model = Word2Vec(len(vocab))
    optimizer = torch.optim.SGD(model.parameters(), lr=1.0)
    initial = F.cross_entropy(model(x), y).item()
    for step in range(250):
        optimizer.zero_grad()
        loss = F.cross_entropy(model(x), y)
        loss.backward()
        optimizer.step()
    final = F.cross_entropy(model(x), y).item()
    assert final < initial
    embeddings[name] = model.input.weight.detach().clone()
    print(name, len(y), f'{initial:.3f} -> {final:.3f}')
print('vocabulary', len(vocab), 'embedding shape', tuple(embeddings['CBOW'].shape))
執行會印出 CBOW 18 2.384 -> 0.159、Skip-gram 36 2.402 -> 1.198 與 vocabulary 11 embedding shape (11, 8)。損失是平均負對數機率,以 nat 為單位。斷言確認實作能擬合這些訓練樣本。CBOW 損失較低,不表示它學出的詞向量較好:它的目標與條件輸入和 Skip-gram 不同。這個語料太小,無法判斷語意鄰近關係或對自然語言的泛化能力。
訓練後,embeddings['CBOW'][ids['robots']] 可取出一個學到的輸入向量。訓練需要輸出表,但若下游模型只查詢輸入向量,提供服務時可省略輸出表。應記錄保留哪個表;使用輸入向量、輸出向量或兩者組合,都是表示設計的選擇。
選讀:word2vec(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
GloVe:直接擬合共現次數的對數
白話版。 GloVe 不是一次處理一個視窗、逐一預測,而是先計算每一對詞共同出現多少次,再擬合詞向量,讓它們的內積重現這些次數的對數。高頻配對得到較大權重,但權重有上限。
Pennington 等人以共現機率的比值說明 GloVe 的動機 [10]。令 為詞 出現在詞 上下文中的(依距離加權的)次數,。對兩個詞 與 ,比值 在上下文詞 與 相關而與 無關時很大,反之很小;若 與兩者同樣相關或同樣無關,比值接近一。比值比任一個機率單獨更有區辨力。模型要求向量差編碼這類比值,最後得到對共現矩陣的加權最小平方目標:
其中 是詞彙表大小, 是詞 與 的共現次數, 是 的詞向量, 是 的另一個上下文向量, 與 是純量偏差, 是加權函數, 與 是它的截斷值與指數(式中 otherwise 意為「其他情況」)。因為 ,次數為零的儲存格完全不貢獻,所以永遠不需要 ,加總實際上只涵蓋觀察到的配對。論文固定 、,使用相距 個詞的配對貢獻 的共現加權,並以兩個表的和 作為最終詞向量 [10]。
GloVe 與 Word2Vec 有三個設計差異。它以全域計數而不是個別視窗訓練,因此掃過語料一次建立 ,之後訓練時間與非零儲存格數成正比。偏差吸收詞頻,內積只需建模剩下的部分。加權函數則避免 the 這類極高頻配對主導,同時讓罕見而雜訊大的配對影響很小。與負取樣一樣,這個目標在秩限制下分解一個平移過的對數次數矩陣,這也是 GloVe 與 Skip-gram 向量實務上常表現相近的原因。
下列程式在先前的玩具語料上計算這些材料:共現比值與加權函數。
程式碼 · Python · 27 行
import numpy as np

text = """the cat drinks milk . the dog drinks water . a cat chases a mouse .
a dog chases a cat . the kitten drinks milk . the puppy drinks water .
a kitten chases a ball . a puppy chases a ball . the car needs fuel .
the truck needs fuel . a car drives on the road . a truck drives on the road ."""
sents = [s.split() for s in text.split(".") if s.strip()]
vocab = sorted({w for s in sents for w in s})
idx = {w: i for i, w in enumerate(vocab)}

X = np.zeros((len(vocab), len(vocab)))            # +-2 window, 1/distance weighting
for s in sents:
    for i, w in enumerate(s):
        for j in range(max(0, i - 2), min(len(s), i + 3)):
            if j != i:
                X[idx[w], idx[s[j]]] += 1.0 / abs(i - j)
P = X / X.sum(1, keepdims=True)                   # P(k | i): row-normalized counts

for k in ["drinks", "chases", "needs", "the"]:
    a, b = P[idx["kitten"], idx[k]], P[idx["truck"], idx[k]]
    ratio = "inf" if b == 0 else f"{a / b:.2f}"
    print(f"P({k}|kitten)={a:.3f}  P({k}|truck)={b:.3f}  ratio={ratio}")

def f(x, x_max=100.0, alpha=0.75):                 # GloVe weighting function
    return np.minimum((x / x_max) ** alpha, 1.0)
print("f at 1, 10, 100, 1000:", np.round(f(np.array([1.0, 10.0, 100.0, 1000.0])), 3))
print("nonzero cells:", int((X > 0).sum()), "of", X.size)
執行會印出:
程式碼 · 6 行
P(drinks|kitten)=0.200  P(drinks|truck)=0.000  ratio=inf
P(chases|kitten)=0.200  P(chases|truck)=0.000  ratio=inf
P(needs|kitten)=0.000  P(needs|truck)=0.200  ratio=0.00
P(the|kitten)=0.200  P(the|truck)=0.200  ratio=1.00
f at 1, 10, 100, 1000: [0.032 0.178 1.    1.   ]
nonzero cells: 96 of 361
比值把動物上下文與車輛上下文分開,而 the 的比值為一,因此不提供資訊。輸出也暴露這個小語料的限制:矩陣將近四分之三是零,而 GloVe 忽略零值儲存格。觀察到的配對這麼少時,只有幾百個參數的模型就能精確擬合每個觀察到的儲存格,得到的幾何主要取決於初始化。GloVe 的計數式設計需要矩陣足夠充實的大型語料;因此這裡不訓練它。練習 3 會請你親自觀察這種欠定(underdetermination)現象。
選讀:GloVe(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
fastText:由字元 n-gram 組成向量
白話版。 詞級的表沒有看過的詞就沒有向量,而且把 charger 與 chargers 當成無關的兩列。fastText 用字元片段的向量組成每個詞的向量,因此拼寫相關的詞共享參數,沒見過的詞也能得到向量。
Bojanowski 等人擴充使用負取樣的 Skip-gram,把每個詞表示為一袋字元 n-gram [11]。詞的前後加上邊界符號 < 與 >,讓前綴與後綴能和詞中間相同的字母區分開來,並把整個加上邊界的詞另外加入為一個單位。論文使用所有 的 n-gram。中心詞 與上下文詞 的分數變成
其中 是 的 n-gram 集合(包含加上邊界的整個詞), 是 n-gram 的學習向量, 是 的上下文向量。詞本身的向量是 。這個分數取代上面負取樣損失中的 。為了限制記憶體,論文以雜湊函數把 n-gram 映射到固定數量的桶,因此無關的 n-gram 可能共用同一個向量 [11]。
程式碼 · Python · 25 行
import numpy as np

def char_ngrams(word, n_min=3, n_max=6):
    w = f"<{word}>"                       # boundary symbols mark prefixes and suffixes
    grams = {w[i:i + n] for n in range(n_min, n_max + 1) for i in range(len(w) - n + 1)}
    return grams | {w}                    # the whole word is kept as one extra unit

print(sorted(char_ngrams("robot", 3, 3)))
vocab = ["charge", "charger", "recharge", "discharge", "robot", "robots"]
query = "chargers"                        # not in the vocabulary
q = char_ngrams(query)
for word in vocab:
    print(f"{word:10s} shares {len(q & char_ngrams(word)):2d} of {len(q)} units with '{query}'")

# A fastText-style vector is the sum of its unit vectors, so an unseen word still gets one.
rng = np.random.default_rng(0)
table = {}                                # stands in for a trained (hashed) n-gram table
def vector(word, dim=8):
    return sum(table.setdefault(g, rng.normal(size=dim)) for g in sorted(char_ngrams(word)))
def cos(a, b):
    return a @ b / (np.linalg.norm(a) * np.linalg.norm(b))
for word in vocab:
    vector(word)
print("cos(chargers, charger) =", round(cos(vector("chargers"), vector("charger")), 3))
print("cos(chargers, robots)  =", round(cos(vector("chargers"), vector("robots")), 3))
執行會印出:
程式碼 · 9 行
['<ro', '<robot>', 'bot', 'obo', 'ot>', 'rob']
charge     shares 14 of 27 units with 'chargers'
charger    shares 18 of 27 units with 'chargers'
recharge   shares 10 of 27 units with 'chargers'
discharge  shares 10 of 27 units with 'chargers'
robot      shares  0 of 27 units with 'chargers'
robots     shares  0 of 27 units with 'chargers'
cos(chargers, charger) = 0.804
cos(chargers, robots)  = -0.222
這裡的 n-gram 向量是隨機的,沒有經過訓練,所以 chargers 與 charger 的高餘弦值完全來自它們共享的單位。這正是機制所在:沒看過的屈折形式,向量大多繼承自已知的片段。共享是否有幫助,由訓練決定。對屈折與衍生變化通常有幫助;對只是碰巧共享字母的詞則會誤導;discharge 與 recharge 都含 charge,但意義差異無法從片段看出。子詞向量對構詞豐富的語言與罕見詞最有幫助。也請注意它與 NLP 02 子詞 tokenizer 的關係:BPE 在查表前把詞切成一串片段,fastText 則把所有重疊 n-gram 的向量加總。
稠密詞與文件表示
白話版。 稠密向量讓不同詞共享統計資訊。它能連結相關片語,但向量幾何反映訓練資料與目標,不是通用的意義定義。
靜態向量可作為分類器的精簡可重用特徵、探索詞的近鄰,或建立平均池化的文件基準。當有標籤的應用資料不多,但有適合的文字語料可用時,它們很實用。嵌入訓練與下游分類器訓練是不同階段:預測鄰近詞不會直接學到 billing 標籤或拒答政策。
靜態嵌入表為每個詞彙項目配置向量:
其中 是嵌入表, 是詞彙表大小, 是嵌入維度, 是位置 的 token ID, 是選出的橫向列向量, 是文件的 token 長度, 是平均池化後的文件向量。冒號表示取出選定列的所有座標。
上面的各種表都提供取得 的方式。有了 token 向量,平均池化就能把不同長度的文件轉成固定寬度的特徵。這個彙整步驟與嵌入表的訓練目標是分開的。
平均池化很適合教學,因為限制很清楚:任意排列文件中的 token,都會得到同一個平均。若使用相同靜態詞向量,「the technician helped the customer」與「the customer helped the technician」的表示完全相同。否定詞也只是平均中的一份貢獻,並未自動成為改變片語意義的運算子。bank 在 river bank 與 bank account 會取出相同靜態向量;增加訓練資料不會改變這個查詢規則。
這裡有兩個獨立選擇:如何取得 token 向量,以及如何組合向量。可以凍結預訓練 token 向量,只訓練分類器;也可以與分類器一起微調向量,或從頭訓練全部參數。凍結能減少任務專屬參數;微調能配合領域中的詞義,但小型資料集也可能扭曲表示或記住標籤。
不要只靠漂亮的群聚圖比較嵌入。二維投影可能隱藏原空間中的重疊。應在相同任務、切分、分類器容量與調參額度下比較表示。如果換成稠密表示時也更換下游模型頭,實驗便無法單獨識別表示的影響。
餘弦量測方向,不量測真值
計數式範例比較的是已正規化為單位長度的向量。此時內積就是兩者夾角的餘弦:
其中 與 是非零的嵌入直向行向量, 是內積, 是歐幾里得長度。餘弦介於 與 。零向量需要明確處理規則,因為分母為零。
餘弦消除任一向量乘上正比例常數的影響,但不會消除所有與訓練目標相容的變換。在兩個嵌入表的模型中,預測分數取決於輸入與輸出向量的乘積。許多不同的表可以產生相同乘積:
其中 與 是形狀為 的輸入及輸出表, 是任意可逆的 矩陣, 是其反矩陣的轉置, 與 是變換後的表。 的每個儲存格是一個中心詞與輸出詞的預測分數。因此,這種配對變換不會改變完整 softmax 的預測與負取樣目標。同樣的論證也適用於 GloVe 的 。
正交座標變換會保留輸入向量的夾角,一般可逆變換則未必。因此,相同預測損失無法唯一決定保留之輸入表的餘弦鄰近關係。最佳化、初始化與額外限制會選出某個解。這也是低訓練損失本身無法保證下游相似度實用的原因之一。
下列獨立數值檢查結合三件事:分數保留、平均運算的詞序不變性,以及上方推導出的雜訊相依最佳分數。矩陣是為了這個計算手動選定的,不是訓練出的語言向量。
程式碼 · Python · 28 行
import numpy as np

# Two input rows and three output rows: scores are center-output dot products.
E = np.array([[1., 1.], [1., -1.]])
U = np.array([[1., 0.], [0., 1.], [-1., 1.]])
A = np.diag([2., 0.5])
changed_E = E @ A
changed_U = U @ np.linalg.inv(A).T

def cosine(a, b):
    return (a @ b) / (np.linalg.norm(a) * np.linalg.norm(b))

assert np.allclose(E @ U.T, changed_E @ changed_U.T)
assert np.allclose(E[[0, 1]].mean(0), E[[1, 0]].mean(0))
print('scores unchanged:', np.allclose(E @ U.T, changed_E @ changed_U.T))
print('cosine:', f'{cosine(E[0], E[1]):.3f}', '->',
      f'{cosine(changed_E[0], changed_E[1]):.3f}')
print('mean unchanged by order:',
      np.allclose(E[[0, 1]].mean(0), E[[1, 0]].mean(0)))

# The unrestricted negative-sampling optimum depends on the noise baseline.
p, K = 0.5, 2
for q in [0.25, 0.05]:
    score = np.log(p / (K * q))
    sigmoid = 1 / (1 + np.exp(-score))
    gradient = (p + K * q) * sigmoid - p
    assert np.isclose(gradient, 0)
    print('noise', q, 'optimal score', f'{score:.3f}')
輸出如下:
程式碼 · 5 行
scores unchanged: True
cosine: 0.000 -> 0.882
mean unchanged by order: True
noise 0.25 optimal score 0.000
noise 0.05 optimal score 1.609
餘弦改變了,所有中心詞與輸出詞的分數卻維持不變。平均相等則有不同含意:一旦表示合併兩種 token 順序,只收到平均值的分類器就無法還原原本是哪個順序。這些是表示的性質,不是某個最佳化器訓練不佳的證據。
評估詞嵌入
白話版。 判斷嵌入有兩種方式:問它的幾何是否符合人對詞的判斷(內在評估),或把它接到任務上量測任務表現(外在評估)。單靠任何一種,都無法說明向量是否「好」。
相似度:讓餘弦與人類評分相關
詞相似度(word similarity)資料集列出詞對與分級的人類評分。模型以餘弦替每一對打分,評估則以 Spearman 等級相關(Spearman’s rank correlation)量測兩種排序的一致程度:
其中 是詞對數, 是第 對在模型餘弦排序與人類評分排序中的名次差,。這個公式假設沒有同名次;有同名次時, 是名次的 Pearson 相關。Spearman 的 只用名次,因此忽略餘弦的尺度。
評分代表什麼,和統計量一樣重要。WordSim-353 是廣泛使用的詞對評分集 [12]。Hill 等人指出它的評分沒有區分相似度與聯想,因此建立 SimLex-999 明確量化相似度,讓有關聯但不相似的詞對得到低分 [13]。以寬視窗訓練的模型,可能在聯想式資料上得分高、在相似度式資料上得分低,原因如詞彙語意一節所述:分布式證據混合了各種關係。
類比:向量位移測試及其限制
Mikolov、Yih 與 Zweig 觀察到,某些關係會呈現為大致固定的向量位移 [14]。要回答「 之於 ,如同 之於?」,位移法(offset method)傳回
其中 是詞彙表, 是候選 的向量,題目中的三個詞被排除在候選之外。Linzen 指出這個排除其實很關鍵:目標點 常常最接近 本身,因此這個方法的成功混合了位移一致性與 周圍的鄰近結構 [15]。他建議在類比準確率旁一併報告簡單基準,例如直接傳回 的最近鄰。
下一個範例用自編的相似度評分與三道類比題,評估先前的 PPMI 向量。評分是本課自行編造的,不是基準資料集。
程式碼 · Python · 41 行
import numpy as np
from scipy.stats import spearmanr

text = """the cat drinks milk . the dog drinks water . a cat chases a mouse .
a dog chases a cat . the kitten drinks milk . the puppy drinks water .
a kitten chases a ball . a puppy chases a ball . the car needs fuel .
the truck needs fuel . a car drives on the road . a truck drives on the road ."""
sents = [s.split() for s in text.split(".") if s.strip()]
vocab = sorted({w for s in sents for w in s})
idx = {w: i for i, w in enumerate(vocab)}
C = np.zeros((len(vocab), len(vocab)))
for s in sents:
    for i, w in enumerate(s):
        for j in range(max(0, i - 2), min(len(s), i + 3)):
            if j != i:
                C[idx[w], idx[s[j]]] += 1
P = C / C.sum()
with np.errstate(divide="ignore"):
    ppmi = np.maximum(np.log(P / (P.sum(1, keepdims=True) * P.sum(0, keepdims=True))), 0)
U, S, _ = np.linalg.svd(ppmi)
E = U[:, :8] * S[:8]
E /= np.linalg.norm(E, axis=1, keepdims=True)
cos = lambda a, b: float(E[idx[a]] @ E[idx[b]])

# 1) Similarity: correlate model cosines with (invented) graded judgments, 0-10.
judged = [("cat", "kitten", 9), ("dog", "puppy", 9), ("car", "truck", 8), ("milk", "water", 5),
          ("cat", "dog", 6), ("cat", "mouse", 3), ("car", "road", 2), ("kitten", "fuel", 0)]
model = [cos(a, b) for a, b, _ in judged]
rho = spearmanr(model, [h for _, _, h in judged]).statistic
print(f"Spearman rho = {rho:.3f} over {len(judged)} pairs")

# 2) Analogy a:b :: c:? with the offset b - a + c (3CosAdd).
def analogy(a, b, c, exclude_inputs=True):
    target = E[idx[b]] - E[idx[a]] + E[idx[c]]
    scores = E @ (target / np.linalg.norm(target))
    for i in np.argsort(-scores):
        if not exclude_inputs or vocab[i] not in (a, b, c):
            return vocab[i]
for a, b, c in [("cat", "kitten", "dog"), ("car", "fuel", "cat"), ("cat", "milk", "puppy")]:
    print(f"{a}:{b} :: {c}:?  ->", analogy(a, b, c), "| without excluding inputs ->",
          analogy(a, b, c, exclude_inputs=False))
執行會印出:
程式碼 · 4 行
Spearman rho = 0.837 over 8 pairs
cat:kitten :: dog:?  -> puppy | without excluding inputs -> puppy
car:fuel :: cat:?  -> kitten | without excluding inputs -> cat
cat:milk :: puppy:?  -> water | without excluding inputs -> water
有兩題得到預期答案。中間那題同時展示兩個限制。不排除題目詞時,答案是 cat,也就是題目中的詞。排除後,答案是 kitten,即 cat 的最近鄰,而不是預期的「牠吃喝什麼」答案 milk。位移並沒有承載這個關係;決定答案的是 的鄰近結構。當然,八組自編詞對與三道類比題,遠不足以支持關於這些向量的任何一般結論。
內在評估與外在評估
Schnabel 等人比較多種評估方法,發現不同評估對嵌入方法的排序不同、詞頻會影響結果與餘弦相似度,而且外在任務不應被當成通用嵌入品質的代理指標 [16]。實務原則是:針對應用需要的關係進行評估。
最近鄰清單能揭露明顯的語料模式,但它是診斷,不是應用分數。分開詞彙問題:候選是同義詞、反義詞、主題相關詞,還是能占據相同語法位置的詞?單一、未加限定的「相關」會掩蓋這些差別。
在一般留出樣本之外加入控制條件的配對。情緒表示應比較正面陳述與其否定;角色敏感任務應交換誰對誰做事,同時固定詞的集合;技術語料則測試術語的領域用法與日常用法。這些測試問的是表示是否保留必要差異,不要求每對詞都位於預設座標。
若平均池化把重要配對變成相同向量,在表示固定時,收集更多分類標籤也無法修復碰撞。若向量已區分配對,分類器卻預測錯誤,問題可能出在監督或決策邊界。從最早遺失必要證據的階段定位失敗。
嵌入中的偏誤
白話版。 嵌入會學到語料中的任何規律,包括社會刻板印象。如果某一群名字與某些職業共同出現得比較多,向量就會編碼這種關聯,下游系統也可能把它複製出來。
Bolukbasi 等人顯示以新聞文字訓練的詞嵌入編碼了性別刻板印象,在空間中找出一個性別方向,並提出把它從應該性別中立的詞中移除 [17]。Caliskan 等人提出仿照心理學內隱聯結測驗(Implicit Association Test)的詞嵌入聯結測驗(Word Embedding Association Test,WEAT),發現嵌入重現了一系列已有文獻記錄的人類偏誤 [18]。對目標詞 與兩個屬性集合 、,WEAT 使用的關聯為
其中 與 是集合大小, 表示詞向量。正值代表 平均而言較接近集合 。完整測試會在兩組目標詞上彙總這個分數,並與排列分布比較。
下列自編語料中,沒有任何句子把名字和職業連在一起。職業詞總是與自己的活動一起出現,而自編的名字以偏斜的比例與各種活動一起出現。
程式碼 · Python · 47 行
import random
import numpy as np

rng = random.Random(0)
# An invented corpus. Job words always appear with their own activity; invented
# names appear with activities at skewed rates. No sentence says "ana is a pilot".
group_a, group_b = ["ana", "ari"], ["bo", "bea"]
activity = {"pilot": "flies the plane", "baker": "bakes the bread", "clerk": "files the forms"}
share_a = {"pilot": 0.8, "baker": 0.2, "clerk": 0.5}    # P(group A | activity)
sents = []
for _ in range(3000):
    job = rng.choice(list(activity))
    if rng.random() < 0.5:
        sents.append(f"the {job} {activity[job]}".split())
    else:
        name = rng.choice(group_a if rng.random() < share_a[job] else group_b)
        sents.append(f"{name} {activity[job]}".split())
vocab = sorted({w for s in sents for w in s})
idx = {w: i for i, w in enumerate(vocab)}
C = np.zeros((len(vocab), len(vocab)))
for s in sents:
    for i, w in enumerate(s):
        for j in range(max(0, i - 2), min(len(s), i + 3)):
            if j != i:
                C[idx[w], idx[s[j]]] += 1
P = C / C.sum()
with np.errstate(divide="ignore"):
    ppmi = np.maximum(np.log(P / (P.sum(1, keepdims=True) * P.sum(0, keepdims=True))), 0)
U, S, _ = np.linalg.svd(ppmi)
E = U[:, :4] * S[:4]
E /= np.linalg.norm(E, axis=1, keepdims=True)

def association(word, E):            # mean cosine to group A minus mean cosine to group B
    unit = E / np.linalg.norm(E, axis=1, keepdims=True)
    w = unit[idx[word]]
    return np.mean([w @ unit[idx[a]] for a in group_a]) - np.mean([w @ unit[idx[b]] for b in group_b])

for job in activity:
    print(f"{job:6s} association {association(job, E):+.3f}")

# Project out one "group direction" and measure again.
d = E[[idx[a] for a in group_a]].mean(0) - E[[idx[b] for b in group_b]].mean(0)
d /= np.linalg.norm(d)
E_proj = E.copy()
for job in activity:
    E_proj[idx[job]] -= (E_proj[idx[job]] @ d) * d
print("after projection:", [f"{job} {round(association(job, E_proj), 3) + 0.0:+.3f}" for job in activity])
執行會印出:
程式碼 · 4 行
pilot  association +0.795
baker  association -0.811
clerk  association +0.072
after projection: ['pilot +0.000', 'baker +0.000', 'clerk +0.000']
「誰從事哪種活動」的偏斜,變成名字與職業詞之間的強烈關聯,即使兩者從未在同一句中出現:它們共享活動上下文。投影掉群組方向後,量測到的關聯變成零,但這個結果是循環論證,因為投影移除的正是這個分數所量測的方向。Gonen 與 Goldberg 顯示,對已發表的去偏方法而言,偏誤大多只是被隱藏而非移除:它仍留在那些號稱已中立化的詞彼此間的距離中,而且可以被還原 [19]。應把去偏步驟視為需要在下游任務上稽核的一項介入,而不是保證,並記得關聯的來源在資料本身。
從詞向量到句子嵌入
白話版。 嵌入提供特徵;應用仍需要目標、監督與行動規則。當應用要比較整個句子時,就針對它要支援的比較方式訓練句子表示。
文件分類可以先做平均池化實驗。替每份訓練文件建立一個向量,再以標籤配適分類器;評估時使用相同 tokenizer、嵌入查表與池化方法。將它與 NLP 03 的稀疏特徵與卷積編碼器比較。固定資料切分與分類器的調整機會,才能公平檢查表示改變的效果。
凍結的表使用標註任務之前學到的上下文統計;微調則讓標籤調整每列。兩種政策回答不同問題:語料中可重用的特徵是否已能區分類別,以及任務特定的調整是否改善表示。標籤有限時,微調也可能配適偶然出現的識別碼。將對話或重複文件模板等群組完整留出,有助於揭露這種行為。
決定如何處理未涵蓋文字。把每個未知詞映射到同一列,會合併所有這類詞。略過它們會改變池化分母,也可能使文件變空。回傳零向量不會形成有意義的餘弦方向。子詞向量能減輕、但無法消除這個問題。涵蓋率、保留 token 數,以及空表示的處理動作,都是模型規格的一部分。
詞層級標記應保留 token 向量序列,而不是池化成單一文件向量。下游編碼器就能先結合局部上下文,再為各位置預測標籤。這不會讓原本的表成為上下文表示:兩種詞義的 bank 初始查表值仍相同。上下文相依的計算發生在後續。
相似度與對比式句子學習
適合預測鄰近詞的表示,可能需要調適,才能讓整個句子的距離可靠。Sentence-BERT 使用共享編碼器與任務目標訓練成對的句子表示,讓比較句子時不必對每一對候選共同編碼 [20]。計算上的差別很重要:分別快取文件向量可以支援檢索;同時讀取查詢與候選文件的模型,則必須為每一對執行。
一般的對比目標能把想要的幾何關係寫清楚:
其中 是一個查詢的損失, 是查詢向量, 是候選中與查詢相關的配對文字向量, 是候選 的向量, 是候選數, 是控制分布尖銳程度的溫度。這是一般性的學習構造,不表示每個句子編碼器都使用完全相同的目標。它和 Word2Vec 的 softmax 形式相同:一個觀察到的配對與其他候選競爭。
SimCSE 是廣泛使用的一個實例 [21]。它的非監督版本把同一個句子編碼兩次;由於兩次前向傳遞的 dropout 不同,兩個向量略有差異而形成正配對,批次中的其他句子則是負樣本。作者報告移除 dropout 會導致表示崩塌。它的監督版本使用自然語言推論資料,以蘊涵配對作為正樣本、矛盾配對作為困難負樣本 [21]。
負樣本定義了什麼叫「不同」。兩則討論不同發票的客服訊息,對尋找同一案件可能是實用的負樣本;對辨識 billing 類別則可能是不好的負樣本。錯誤負樣本會把語意相關的例子推遠。在改變編碼器之前,先檢查正負配對如何取樣。
相似度也不等於蘊涵。「The parcel arrived」與「The parcel did not arrive」共享主題與許多 token,在語意搜尋空間可能靠近,卻做出相反陳述。因此,即使使用相同編碼器,分類、語意搜尋與推論仍需要不同的驗證樣本。NLP 11 把推論當成獨立任務處理。
預告:上下文嵌入
白話版。 靜態表在任何地方都給 bank 同一個向量。上下文模型則利用周圍的詞,替每次出現計算不同的向量,讓河岸詞義與金錢詞義得以分開。
Peters 等人將 ELMo 表示計算為整個輸入句子的函數,使用雙向語言模型的內部狀態,並把它們作為特徵加入任務模型 [22]。BERT 在預訓練編碼器內更進一步:token 最後的隱藏狀態取決於其他允許看到的輸入 token [23]。差別是查表與計算。兩者都可能從嵌入表開始;靜態 Word2Vec 直接提供一列,BERT 則透過上下文相依網路處理各列與位置。
上下文能改善詞義區分,但不會讓每個隱藏狀態的餘弦自動成為已校準的相似度量。靜態向量是跨越許多次出現的類型層級摘要;上下文向量是一次出現的 token 層級表示。應用需要哪一種,取決於它問的是一般意義下的詞,還是此處用法中的詞。NLP 07 建立這些模型使用的注意力機制,NLP 10 則發展遮罩預訓練與 BERT 的上下文表示,這裡不重複。
現代觀點
Turney 與 Pantel 的綜述 [6] 區分詞項與文件、詞與上下文,以及配對與模式矩陣。這種分類使證據來源明確:文件關聯、鄰近詞關係與關係模式是不同觀察。本課的啟示是,先定義矩陣,再解讀向量空間。
Apidianaki 的 2023 年綜述 [24] 從靜態類型層級向量,走向上下文相依的出現層級表示,再討論如何回到靜態表示。內容涵蓋語意特化、詞義區分、表示解讀,以及從上下文編碼器取得靜態向量。核心區別是在哪個層級彙整證據,不是把架構排成「越新就自動解決所有詞彙任務」的名次。把詞彙資源中的關係注入向量的方法,與本課的 WordNet 一節直接相關。
在句子與文字層級的嵌入方面,Muennighoff 等人的 MTEB 基準涵蓋 8 種嵌入任務、58 個資料集與 112 種語言,作者發現沒有任何單一文字嵌入方法在所有任務上都占優勢 [25]。在 2023–2026 年間,多數實用的文字嵌入來自以上述對比目標微調的預訓練 Transformer 編碼器或語言模型,而 MTEB 風格的基準套件是比較它們的常見方式。靜態向量仍是快速、透明的基準,是低資源情境中的特徵,也是研究對象。
因此,適合檢視研究的問題是:這種表示保留了哪個詞義區別,又如何驗證? 上下文隱藏狀態、由它們聚合而來的靜態向量,以及以任務訓練的句子表示,回答不同問題。能保留大致主題的嵌入,仍可能合併否定陳述或罕見詞義。如果小型靜態表的可測不變性符合應用,它仍是適當基準。
開放問題包括跨領域可靠幾何、證據稀少時的詞義區分、去偏後仍存留的偏誤,以及固定語料與評估條件的比較。多語工作還加入斷詞與不均衡涵蓋率:tokenizer 與訓練語料曾為該類型提供證據,這列才有用。應與最終分數一起報告這些條件與挑戰樣本,讓解釋連結到實際觀察的語言行為。
重點整理
- 詞彙表項目是詞形或詞元,不是詞義;同義、反義、上位等詞彙關係存在於詞義之間,WordNet 以人工記錄它們。
- 靜態嵌入彙整許多次出現,為每個詞彙表項目形成一個向量;分布式相似度捕捉共享用法,混合了同義、反義與相關性。
- PPMI 將共現與獨立基準比較;SVD、使用負取樣的 Skip-gram 與 GloVe,都在秩限制下壓縮關聯統計。
- CBOW 從合併的鄰近詞預測中心詞;Skip-gram 分別預測鄰近詞;負取樣區分配對的統計來源,不是正規化分布。
- fastText 以字元 n-gram 組成詞向量,因此拼寫相關的詞共享參數,沒見過的詞也有向量。
- 相似度與類比測試取決於評分的意義,以及是否排除題目詞等細節;應評估應用需要的關係。
- 嵌入會吸收語料中的關聯,包括社會偏誤;以投影去偏可能只是隱藏而非移除偏誤。
- 平均池化消除詞序;句子嵌入應針對它服務的比較訓練,而上下文模型是替每次出現計算向量,而不是查表。
練習
- 建立樣本。 列出
robots help people today的半徑一 CBOW 與 Skip-gram 樣本,先只使用內部中心位置,再納入邊界中心。哪些輸入形狀會改變?
提示
中心位置數與中心、上下文配對數分開計算。長度不同的 CBOW 上下文需要遮罩或分開處理;Skip-gram 每個配對仍只收到一個中心 ID。
- 檢查矩陣儲存格。 建立一份語料,讓某個上下文整體很常見,卻對選定中心詞具有接近零的 PMI。再增加觀察到的中心與上下文配對,解釋分子與邊際機率如何改變。
提示
先從接近獨立的聯合表開始。修改計數後重算所有邊際;把邊際固定會變成分析另一張表。
- 訓練 GloVe,看它搖擺。 在 PyTorch 中實作 GloVe 目標,於玩具語料上只用非零儲存格訓練。以三個隨機種子訓練,比較
cat的最近鄰。接著計算參數數與非零儲存格數。是什麼造成不穩定?怎樣能讓問題的解更確定?
提示
兩個 的表加上兩個偏差向量,參數數很容易超過觀察到的儲存格數。上下文更多樣的大語料會增加方程式;較小的 則減少未知數。
- 相似度與相關性。 寫出十組相關但不相似的詞對(例如
cup與coffee),以及十組相似的詞對。在你自己編寫的語料上,以視窗半徑 1 與 4 分別執行 PPMI 程式,比較餘弦如何區分兩組。
提示
較寬的視窗收集主題共現,有利於相關性;較窄的視窗強調能填入同一位置的詞。兩組的變化都要報告,而不是只給單一分數。
- 揭露不變性。 建立兩句詞計數相同、參與者角色不同的有意義句子。即使每個詞向量都完美符合其訓練目標,說明靜態平均池化為何仍無法區分兩句。
提示
改變順序不會改變加總。這個限制對任何靜態嵌入表成立,不只對本課的合成數值成立。
- 在投影之外稽核。 在偏誤範例中完成投影後,用剩下的所有維度計算每個職業詞最接近的名字,並訓練一個小型邏輯斯分類器,從投影後職業詞的鄰居預測 A 組或 B 組。關聯是否仍留下痕跡?
提示
投影只以一種方式移除了一個方向。尋找這個分數沒有量測到的結構,就像 Gonen 與 Goldberg 以分群與分類所做的那樣。
參考文獻
- M. Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Manning, 2021; Chapters 3–4. publisher
- S. McRoy, Principles of Natural Language Processing, open textbook, 2021; Chapter 6, “Benchmark Tasks for Language Modelling.” chapter
- Y. Bengio, R. Ducharme, P. Vincent and C. Jauvin, “A neural probabilistic language model,” Journal of Machine Learning Research 3, 2003. paper
- G. A. Miller, “WordNet: a lexical database for English,” Communications of the ACM 38(11), 1995. paper
- Z. S. Harris, “Distributional structure,” Word 10(2–3), 1954. paper
- P. D. Turney and P. Pantel, “From frequency to meaning: vector space models of semantics,” Journal of Artificial Intelligence Research 37, 2010. survey
- T. Mikolov, K. Chen, G. Corrado and J. Dean, “Efficient estimation of word representations in vector space,” ICLR Workshop, 2013. paper
- T. Mikolov, I. Sutskever, K. Chen, G. Corrado and J. Dean, “Distributed representations of words and phrases and their compositionality,” Advances in Neural Information Processing Systems 26, 2013. paper
- O. Levy and Y. Goldberg, “Neural word embedding as implicit matrix factorization,” Advances in Neural Information Processing Systems 27, 2014. paper
- J. Pennington, R. Socher and C. D. Manning, “GloVe: global vectors for word representation,” EMNLP, 2014. paper
- P. Bojanowski, E. Grave, A. Joulin and T. Mikolov, “Enriching word vectors with subword information,” Transactions of the Association for Computational Linguistics 5, 2017. paper
- L. Finkelstein, E. Gabrilovich, Y. Matias, E. Rivlin, Z. Solan, G. Wolfman and E. Ruppin, “Placing search in context: the concept revisited,” ACM Transactions on Information Systems 20(1), 2002. paper
- F. Hill, R. Reichart and A. Korhonen, “SimLex-999: evaluating semantic models with (genuine) similarity estimation,” Computational Linguistics 41(4), 2015. paper
- T. Mikolov, W.-t. Yih and G. Zweig, “Linguistic regularities in continuous space word representations,” NAACL-HLT, 2013. paper
- T. Linzen, “Issues in evaluating semantic spaces using word analogies,” Workshop on Evaluating Vector-Space Representations for NLP (RepEval), 2016. paper
- T. Schnabel, I. Labutov, D. Mimno and T. Joachims, “Evaluation methods for unsupervised word embeddings,” EMNLP, 2015. paper
- T. Bolukbasi, K.-W. Chang, J. Zou, V. Saligrama and A. Kalai, “Man is to computer programmer as woman is to homemaker? Debiasing word embeddings,” Advances in Neural Information Processing Systems 29, 2016. paper
- A. Caliskan, J. J. Bryson and A. Narayanan, “Semantics derived automatically from language corpora contain human-like biases,” Science 356(6334), 2017. paper
- H. Gonen and Y. Goldberg, “Lipstick on a pig: debiasing methods cover up systematic gender biases in word embeddings but do not remove them,” NAACL-HLT, 2019. paper
- N. Reimers and I. Gurevych, “Sentence-BERT: sentence embeddings using Siamese BERT-networks,” EMNLP-IJCNLP, 2019. paper
- T. Gao, X. Yao and D. Chen, “SimCSE: simple contrastive learning of sentence embeddings,” EMNLP, 2021. paper
- M. E. Peters, M. Neumann, M. Iyyer, M. Gardner, C. Clark, K. Lee and L. Zettlemoyer, “Deep contextualized word representations,” NAACL-HLT, 2018. paper
- J. Devlin, M.-W. Chang, K. Lee and K. Toutanova, “BERT: pre-training of deep bidirectional transformers for language understanding,” NAACL-HLT, 2019. paper
- M. Apidianaki, “From word types to tokens and back: a survey of approaches to word meaning representation and interpretation,” Computational Linguistics 49(2), 2023. survey
- N. Muennighoff, N. Tazi, L. Magne and N. Reimers, “MTEB: massive text embedding benchmark,” EACL, 2023. paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 05・用於語言的循環神經網路 · 28 分鐘