NLP 02・語言學基礎
先備知識:NLP 01・自然語言處理導論
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分語言及其口語、手語、書寫形式,並區分語言學單位與計算用的 token。
- 分析詞的內部結構,比較詞幹擷取(stemming)與詞形還原(lemmatization),並列舉中文斷詞的歧義。
- 訓練一個小型 BPE 斷詞器,並說明它與 WordPiece、unigram 模型及 SentencePiece 的關係。
- 使用 Universal Dependencies 詞性標記,並解釋詞組結構、文法關係與一致關係為何包含詞頻無法保留的資訊。
- 推導詞彙意義、組合意義、否定與量詞作用域,並區分斷言、預設、會話含意與篇章關係。
- 批判地閱讀語料庫與標註:標註者之間的一致度、Zipf 定律與罕見詞的長尾。
先看全貌
語言讓人描述情境、提出問題、協調行動,也改變他人的認知。看得到的句子只是這些活動的一部分。句子的內部結構限制可行的解讀;說話者也依賴共同看見的物件、先前對話,以及對發話理由的預期。
考慮 “The technician inspected the panel with the camera.” 技師是使用相機檢查面板,還是檢查一個裝有相機的面板?知道每個詞的字典義,仍然無法決定答案。再考慮 “Can you inspect it tomorrow?” 現在,受檢查的物件、參照日期,以及這句話是否在提出請求,都依賴語境。有用的分析會先辨認這些選項,再選擇表示方式或標籤。
本教學替 Hagiwara 的 Real-World Natural Language Processing 所採取的實作路線 [1],以及 McRoy 的 Principles of Natural Language Processing 所採取的符號與計算路線 [2],建立語言基礎。開放教科書 Essentials of Linguistics 提供補充的語言學背景 [3]。本教學範例均為原創。NLP 01 介紹了從任務到評估的處理流程;本教學說明這個流程必須保留的單位與結構。後續教學再把它們變成模型:NLP 06 標註詞性與實體,NLP 12 剖析句子、標註語意角色並解析共指。這些層次彼此影響,不表示軟體必須依序使用互相獨立的模組。
1. 語言、模態與單位
白話版。 口語、手語與書寫是表達語言的不同方式,各自記錄不同資訊。電腦的「token」則是另一種為了處理而選定的單位。
語言是一套有結構的表達與解讀系統。口語與書寫是表達語言的方式,兩者不是可以任意互換的容器。手語使用有系統的視覺與手部表達,觸覺手語則提供另一種模態(modality)[4]。文字逐字稿保留互動中的部分資訊,卻省略時間節奏、視線、手勢,以及大部分實際環境。
語音與書寫符號回答不同問題
語音學(phonetics)研究語音的物理產生與感知;音韻學(phonology)研究語音在某個語言中的規律。音素(phoneme)是特定語言系統中具有區辨作用的語音單位;不同的物理實現可能屬於同一音素 [5]。字素(grapheme)則是書寫系統的單位。兩者未必一對一對應。
英文 “ship” 有四個字母,但開頭的 “sh” 表示一個子音。反過來,同一字母在不同詞裡也可能有不同作用。因此,計算字母數量無法直接回答語音結構的問題。即使使用者想表達相同的詞,語音應用與文字應用仍可能需要不同的標註。
聲調(tone)與語調(intonation)也不同 [6]。華語 mā、má、mǎ、mà 分別區分常見的書寫詞「媽、麻、馬、罵」。聲調形態參與詞彙上的區辨;整段發話的音高輪廓也可能傳達疑問或強調。在英文裡,“Really.” 與 “Really?” 在書寫上暗示不同解讀,但標點只能粗略模擬說話者如何表達不相信、好奇或確認。書寫的問號無法還原原本的聲音。
字元、詞與 token
詞形(word form)是實際出現的形式;詞位(lexeme)把相關詞形歸為同一詞彙項目。在簡化分析中,“repair”、“repairs” 與 “repaired” 都是動詞詞位 REPAIR 的詞形。詞元(lemma)是用來索引該項目的代表形式。因此,詞形還原(lemmatization)是一種標註決定,不表示不同詞形能在句子裡互換 [2, 3]。
在 “The technician repairs cameras” 與 “The technician repaired cameras” 中,這些區別很重要。把兩個動詞都歸入 REPAIR,有助於搜尋相關活動;但若丟掉實際詞形,就會失去現在與過去的對比。應用可以同時保留原始文字區段與詞元,不必認定某一表示一定要取代另一表示。
計算用的 token 是處理程序選定的輸入單位。它可能是一個詞、詞的一部分、標點,或一段字元序列。它的邊界不一定與音素、詞素或詞位一致。同樣地,中文字元也可能構成多字詞:「相機」這段書寫序列指稱一種物件。字元式系統可能接收兩個單位,詞導向分析則可能使用一個單位。兩種計數都不能單獨定義該片語包含多少個意義。
2. 構詞:詞的內部結構
白話版。 詞有組成部分。有些部分帶有詞彙意義,有些帶有時態或單複數等文法資訊,而部分之間的分組方式也可能改變意義。
詞的結構可以同時傳達詞彙意義與文法資訊。構詞學(morphology)研究這種結構;詞素(morpheme)是形式與意義或文法功能之間最小的、反覆出現的配對 [7]。「最小」不表示「只有一個字母」,有意義的成分也不一定能獨立出現。複數詞尾、時態標記與派生前綴能提供有用證據,但不同語言不一定用相同片段或詞邊界表達這些性質。
屈折、派生與生產性的組合
屈折(inflection)對比改變詞的文法實現,例如 repair/repaired。派生(derivation)過程可以形成新的詞彙項目,例如 repair/repairable。複合詞(compound)結合詞基,例如 camera mount [3, 7]。這些是分析上的區別;只辨認詞尾的拼寫,不足以決定它的功能。
比較 “She repairs the camera” 與 “The repairs took a day” 裡的 “repairs”。前者是限定動詞的詞形,後者是複數名詞。若規則刪掉每個詞尾的 “s”,就會失去詞類,以及該詞尾出現的原因。這條規則也無法正確處理 mouse/mice 之類的不規則配對。分析的任務是解釋反覆出現的形式與功能規律,並明確表示例外。
生產性(productivity)表示一種模式能支持新組合,而不只是描述記住的清單。若工作室引入新的 “sensor cradle”,聽者可以根據熟悉的成分與情境解讀這個複合詞。然而,組合不會決定所有細節:它可能在組裝、運送或操作期間固定感測器。構詞可以提供概括的關係,語境則補上這次使用的確切實例。
中文也有詞的內部結構與生產性的組合。在「三台相機」中,「三」表達數量,「台」是與被計數物件搭配的量詞,「相機」命名物件。英文 “three cameras” 在這個例子裡把複數標記放在名詞上。這個對比指出不同的文法選擇,不表示中文詞缺少結構,也不表示英文名詞總是有明確的數量。
詞幹擷取與詞形還原
白話版。 詞幹擷取器依規則切掉詞尾;詞形還原器則根據詞的文法類別查出字典形式。前者便宜而粗糙;後者需要更多知識,犯的明顯錯誤也較少。
詞幹擷取器(stemmer)透過改寫詞尾,把不同詞形映到共同字串,也就是詞幹(stem)。Porter 演算法是經典的英文例子:它依序套用數組詞尾規則,每條規則都附有對剩餘詞幹的條件,設計目的是在資訊檢索中把相關詞歸在一起 [16]。詞幹不必是真正的詞,只需要一致。詞形還原器(lemmatizer)回傳詞元,這需要詞庫,通常也需要詞性:作名詞時 “saw” 本身就是詞元,作動詞時卻是 SEE 的詞形。
下面的玩具版切除器只用四條有順序的規則,加上一個最短詞幹長度的條件;精神上接近 Porter 演算法,但簡單得多。查詢表則代替字典。
程式碼 · Python · 21 行
# A toy suffix stripper (a few Porter-style rules) versus a lookup lemmatizer.
RULES = [("ies", "y"), ("ing", ""), ("ed", ""), ("s", "")]   # tried in order; first match wins

def stem(word):
    for suffix, replacement in RULES:
        if word.endswith(suffix) and len(word) - len(suffix) >= 3:
            return word[: -len(suffix)] + replacement
    return word

# A lemmatizer needs the part of speech; this tiny table stands in for a dictionary.
LEMMAS = {("repairs", "VERB"): "repair", ("repairs", "NOUN"): "repair",
          ("repaired", "VERB"): "repair", ("mice", "NOUN"): "mouse",
          ("was", "AUX"): "be", ("batteries", "NOUN"): "battery",
          ("news", "NOUN"): "news", ("this", "DET"): "this"}

def lemmatize(word, pos):
    return LEMMAS.get((word, pos), word)

for word, pos in [("repairs", "VERB"), ("repaired", "VERB"), ("batteries", "NOUN"),
                  ("mice", "NOUN"), ("was", "AUX"), ("news", "NOUN"), ("this", "DET")]:
print(f"{word:10s} stem={stem(word):9s} lemma={lemmatize(word, pos)}")切除器能處理規則形式(repairs、repaired、batteries 都得到合理詞幹),卻讓 mice 與 was 原封不動,還把 news 變成 new、this 變成 thi。前兩個失敗來自不規則構詞;後兩個是過度擷取(over-stemming):只是看起來像詞尾的字母被刪掉了。詞形還原器七個都對,但只因為表中已經有它們;沒見過的詞會原樣通過。兩種工具都不決定文法類別:VERB 或 NOUN 是呼叫者提供的,而那正是 NLP 06 中詞性標註器的工作。
該用哪一種取決於任務。對搜尋而言,合併 repairs 與 repaired 可以提高召回率,即使有少數無關詞撞在一起。對狀態擷取器而言,詞幹擷取器丟掉的時態可能正是答案。現代神經網路流程很少對輸入做詞幹擷取;它們保留原始形式,讓子詞 token 與脈絡承載構詞資訊,這也是下一節重要的原因之一。
相同零件可以用不同順序組合
假設有人使用 “an unsealable case” 這個描述,我們可以考慮兩種有用的結構分析:
un + (seal + able):無法密封的盒子。(un + seal) + able:可以解除密封的盒子。
第一種把 “un” 當作對形容詞的否定;第二種先把它當作逆轉密封動作的成分,再由 “able” 形成形容詞。兩種解讀對實際操作有相反含意。它們是否成立、是否自然,會受語境影響;因此本例示範可能的分析,不主張每位說話者都同樣常用兩種解讀。
兩種分析包含的零件完全相同。改變的是中間的分組,以及每個操作與哪種對象結合。同樣的問題也會出現在句子的附著與邏輯作用域:如果任務需要這個區別,表示方式就必須保留結構。
中文斷詞也是解讀問題
中文書寫不以空格標示詞邊界。原創字串「學生會說話」可以分析成「學生 / 會 / 說話」(學生有說話能力),或「學生會 / 說話」(學生會發言)。前者把「會」當作表達能力的成分,後者則把「學生會」當作複合名詞。因此,處理後插入的空格記錄了一種分析;沒有空格的原始字串並未直接提供這些邊界。
下列程式列舉一個明確的小型詞庫所允許的路徑。它不是通用的中文斷詞器,而是說明:選擇最長的匹配詞條,無法直接確定說話者的意圖。
程式碼 · Python · 19 行
from functools import lru_cache

text = "學生會說話"
lexicon = ("學生", "學生會", "會", "說話")

@lru_cache(None)
def segment(start):
    if start == len(text):
        return ((),)
    paths = []
    for word in lexicon:
        if text.startswith(word, start):
            for rest in segment(start + len(word)):
                paths.append((word,) + rest)
    return tuple(paths)

for path in segment(0):
    print(" / ".join(path))
assert len(segment(0)) == 2
印出的兩條路徑就是上述解讀。每一步遞迴都消耗一個已知詞,終止條件只接受完整覆蓋字串的路徑。擴充詞庫可能增加選項,卻不會增加特定對話的證據。句法分析、前後文,或這段訊息與學生會會議相關的知識,可能讓其中一條路徑更合理。
連標準答案本身也是一種選擇。第二屆國際中文斷詞評測(Second International Chinese Word Segmentation Bakeoff)使用四個語料庫評估系統:兩個為繁體字(來自臺灣的中央研究院與香港城市大學),兩個為簡體字(來自北京大學與微軟研究院),而且每個提供者都依自己的標準切分資料 [27]。因此,同一種切法可能在某個語料庫「錯」、在另一個語料庫「對」。請說明你的標籤依循哪一種斷詞標準。
3. Token 與子詞
白話版。 模型需要一份固定的單位清單。整詞會留下太多未知詞;單一字元會讓序列太長。子詞方法從資料學出折衷:常見字串成為單一 token,罕見字串則由較小片段拼出。
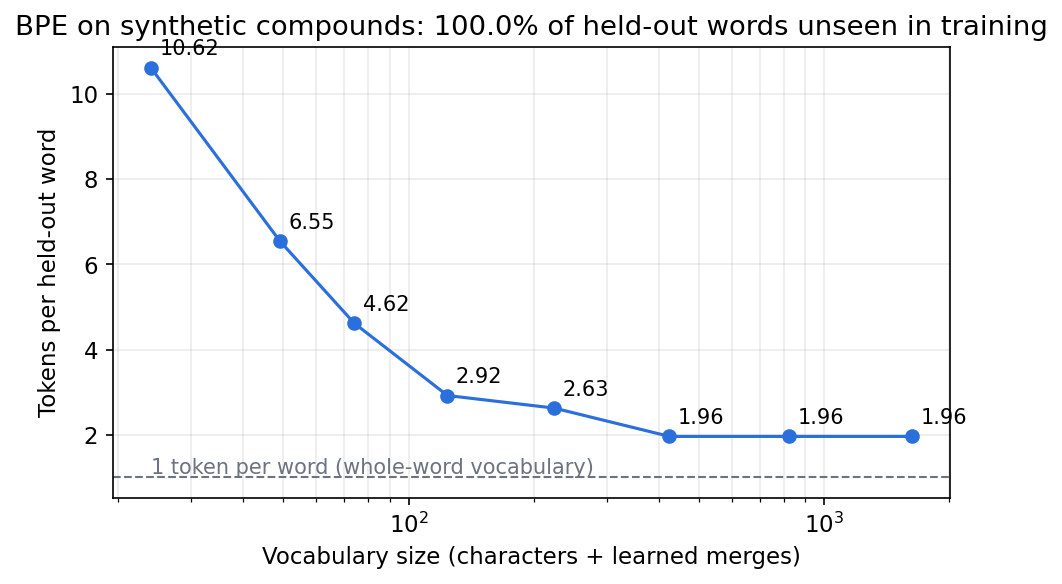
NLP 01 定義了未知 token 比例,並說明為何把每個沒見過的詞都映到同一標記會失去區別。必要字元都被涵蓋時,字元詞彙表能減少完整詞的未知問題,代價是序列更長。位元組編碼若有完整基礎位元組字母表,就能涵蓋任意輸入位元組,但單位未必對應可閱讀字元。子詞方法在詞彙表大小與序列長度間取捨;Mielke 等人的綜述整理了這些選擇 [22]。沒有一種切分對所有語言、任務與資源預算都最好。
學習式斷詞器通常擬合語料庫中的統計模式。這些模式有助重用常見片段,但常見片段未必是有意義的詞素(morpheme);反過來,有意義的屈折變化也可能被切成數個片段。判斷模型能辨認什麼時,必須分清楚:斷詞提供編碼,後續計算仍須學習編碼片段如何組合。
逐步理解一種子詞方法:BPE
BPE 學習哪些相鄰片段值得合併,替常見組合建立符號,讓其他字串仍以較小片段的序列表示。Sennrich、Haddow 與 Birch 把位元組對編碼(byte-pair encoding, BPE)改用於罕見詞翻譯 [17]。下面的字元版教學實作在詞內運作:
- 把每個訓練詞表示成字元,加上一個詞尾標記。
- 計數相鄰符號對,依該詞的語料出現頻率加權。
- 在這些詞表示中,把最常見符號對的每次出現都合併。
- 儲存這次合併,重複固定次數。
合併會改變後續符號對計數。兩符號合成新符號後,新符號又能參與另一個符號對。因此演算法學得的是有順序的操作序列,而不是能任意套用順序的片段集合。
程式碼 · Python · 42 行
from collections import Counter

corpus = ("low low low low low lower lower newest newest newest newest newest "
          "newest widest widest widest").split()
# Start from characters; "_" marks the end of a word so merges respect boundaries.
words = Counter(tuple(w) + ("_",) for w in corpus)

def pair_counts(words):
    pairs = Counter()
    for symbols, freq in words.items():
        for a, b in zip(symbols, symbols[1:]):
            pairs[a, b] += freq
    return pairs

def merge(words, pair):
    out = Counter()
    for symbols, freq in words.items():
        s, i = [], 0
        while i < len(symbols):
            if i + 1 < len(symbols) and (symbols[i], symbols[i + 1]) == pair:
                s.append(symbols[i] + symbols[i + 1]); i += 2
            else:
                s.append(symbols[i]); i += 1
        out[tuple(s)] += freq
    return out

merges = []
for step in range(10):
    pairs = pair_counts(words)
    best = max(pairs, key=lambda p: (pairs[p], p))   # most frequent; ties broken by symbol order
    merges.append(best)
    words = merge(words, best)
print("merges:", [a + b for a, b in merges])

def tokenize(word):                   # apply the learned merges in order
    symbols = list(word) + ["_"]
    for pair in merges:
        symbols = list(merge(Counter({tuple(symbols): 1}), pair))[0]
    return symbols

for w in ["lowest", "newer", "wider"]:
    print(w, "->", tokenize(w))
輸出包含 lowest -> ('low', 'est_')、newer -> ('ne', 'w', 'e', 'r', '_') 與 wider -> ('wi', 'd', 'e', 'r', '_')。第一個詞不在訓練語料中,卻能用學得的片段重新組合字母。其他詞的編碼較長,反映哪些組合獲得合併。
合併順序為什麼重要
第一個合併為 t_,接著是 st_ 與 est_。訓練詞中重複出現的結尾讓這些組合很常見。這在例子中像英文詞尾,但演算法沒有「找出詞尾」的指令,只依頻率做決策。同一拼法換一份語料,可能得到不同切分。
low 合併要等較小組合先形成後才會出現。編碼依儲存順序執行,才能重現擬合程序。只從最終符號中優先找最長片段,是另一種演算法,未必產生相同切分。平手規則也有影響:本程式以符號順序打破相同計數,讓執行可重現。
函數回傳片段,還不是數值 ID,也沒有證明能涵蓋任意未見字元。本例成功處理的新詞,都重用訓練出現過的字元;若一個詞含新字元,就需要指定備援方式與相容的詞彙查表。這分開了兩個問題:字串能否切分,以及每個回傳片段是否都有模型懂的 ID。
WordPiece、unigram 模型與 SentencePiece
BPE 只是其中一員。其他方法的差別在於如何選擇片段,以及如何切分新詞。
- WordPiece 源自日語與韓語語音搜尋 [18]。Google 神經機器翻譯系統描述它的版本時,說明是選出固定數量的片段,使切分後的訓練語料所用片段數最少,並在每個詞開頭加上邊界標記,讓原始詞序列能無歧義地還原 [19]。BERT 使用 WordPiece 詞彙表 [30];NLP 10 會在此基礎上繼續。
- Unigram 語言模型切分由上而下:先從大型候選片段集合開始,把一個詞建模成獨立抽出的片段序列,再刪去對語料概似度貢獻最小的片段 [20]。因為它是機率模型,同一個詞可以有數種帶分數的切分;Kudo 利用這點在訓練時抽樣不同切分,作為正則化方法 [20]。
- SentencePiece 是工具組,而不是新的準則:它直接從原始句子訓練 BPE 或 unigram 模型,並把空白當成一般符號,因此不需要特定語言的預切分器,解碼也能還原編碼 [21]。這對中文、日文等不以空白分詞的語言很重要。
在這三種方法中,學到的片段都是統計上的,而不是構詞上的。子詞邊界剛好落在 est,是語料頻率的證據,並不是「-est 為最高級詞尾」的分析。
使用完整斷詞器,而不只是一份合併清單
斷詞軟體還會指定正規化、預切分、特殊標記與解碼 [23]。模型檢查點的 token ID 對應特定詞彙表與約定。只匹配斷詞器家族名稱並不足夠:兩個詞彙表可能把同一 ID 指派給不同符號。
預訓練模型應使用隨附的斷詞器與設定。若在實驗中訓練斷詞器,就只用允許的訓練文字擬合,評估前固定詞彙表與合併規則。分別查看片段、ID 與重建文字,各種檢視能找出不同錯誤。
選讀:BPE(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
4. 詞性
白話版。 詞的類別描述它在句子中的行為。拼字能提供線索,但脈絡通常決定實際用法。
詞性(part of speech)描述名詞、動詞等語法類別。名詞通常是名詞片語的中心,動詞通常是子句述語的中心。這是分布上的描述,不是每個名詞都必須指實體物品的規則。「Decision」與「arrival」雖指抽象內容與事件,仍是名詞 [2]。
相同表面詞可以有不同類別。在原創例句「the pilots can land」與「the metal can fell」中,「can」扮演不同角色。第二句也顯示,句子其餘部分改變時,熟悉的局部片語可能誤導。標記器必須考慮允許的脈絡與標註規則。
Universal Dependencies 標記集
不同專案的標記集合各不相同,讓跨語言比較變得困難。Universal Dependencies(UD)是一套對詞性、構詞特徵與依存關係做一致跨語言標註的框架 [24]。它的通用詞性(UPOS)集合有 17 個標記 [25]:
| 類別 | 標記 |
|---|---|
| 開放類 | ADJ 形容詞、ADV 副詞、INTJ 感嘆詞、NOUN 名詞、PROPN 專有名詞、VERB 動詞 |
| 封閉類 | ADP 介詞(adposition)、AUX 助動詞、CCONJ 對等連接詞、DET 限定詞、NUM 數詞、PART 小品詞、PRON 代名詞、SCONJ 從屬連接詞 |
| 其他 | PUNCT 標點、SYM 符號、X 其他 |
UD 把粗略標記與 Number=Plur、Tense=Past 等特徵分開,因此作名詞的 “repairs” 可以標成 NOUN 加上 Number=Plur,而 “repaired” 是 VERB 加上 Tense=Past。各語言的樹庫還會為通用準則未規定的構式補充文件化的慣例。這個標記集是共用的標註方案,不代表每種語言都在相同位置劃分類別界線。
已標記句子可表示為:
其中 是輸入詞序列, 是位置 的詞, 是序列長度, 是標記序列, 是詞 的標記, 是有限標記集合,例如 17 個 UPOS 標記。 與 指語言學上的詞位置,不會自動等同模型子詞位置。
標註也需要縮寫、標點、多詞表達與多種合理分析的規則。當模型使用子詞時,應定義如何把輸出對應回詞。只用第一個子詞表示是一種做法;池化所有子詞則是另一種。不論選哪個,標準標籤與解碼輸出都必須使用相同單位。用隱藏式馬可夫模型、Viterbi 解碼與循環神經網路標記器,從 預測 ,是 NLP 06 的主題。
5. 句法:順序、分組與文法關係
白話版。 文法把詞組成詞組,並以主詞、受詞等關係連接它們。相同的詞放進不同結構,可能描述不同事件。
文法組織詞的組合。詞序、詞組結構,以及主詞、受詞等關係,限制誰對誰做了什麼 [2, 3]。這些限制比相鄰詞的清單豐富。
詞頻為何會失去角色資訊
“Ada praised Bo” 與 “Bo praised Ada” 包含相同的詞,但普通主動句解讀會交換稱讚者與被稱讚者。中文「阿達稱讚小博 / 小博稱讚阿達」在這兩句裡形成相同對比。只計算詞頻的表示,會把每一組句子映射成相同的對象。
程式碼 · Python · 14 行
from collections import Counter

first = "Ada praised Bo".split()
second = "Bo praised Ada".split()

def roles(tokens):
    # Only our deliberately fixed three-word active-clause template.
    assert len(tokens) == 3 and tokens[1] == "praised"
    return {"praiser": tokens[0], "praised_person": tokens[2]}

print(Counter(first) == Counter(second))
print(roles(first))
print(roles(second))
assert roles(first) != roles(second)
詞頻比較印出 True,角色字典則不同。這是資訊流失的結果,不是訓練模型的效能測試。當兩個輸入已經變成相同詞頻後,任何只依賴那些詞頻的後續確定性函數,都無法還原原先是哪種順序。
句法角色也不等於語意角色。在 “Bo was praised by Ada” 裡,Bo 是文法主詞,但 Ada 仍然是執行稱讚的人。即使被動句描述同一事件,把主詞直接當成行動者仍會失敗。抽取任務應說明它需要文法依存關係、事件參與者,還是兩者都需要。
成分結構與依存關係描述不同面向
句法成分(constituent)是參與更大結構的單位。在 “The label beside the boxes is missing” 裡,名詞片語 “the label beside the boxes” 作為主詞。它的中心語(head)是 “label”;“beside the boxes” 修飾這個中心語。把整個片語換成 “it”,仍保留簡單的文法框架:“It is missing”。這類測試提供分組的證據,不表示每段相鄰子字串都是詞組 [8]。
一致關係(agreement)的對比 “The labels beside the box are missing” 說明為何只看距離不夠。在這些例子中,動詞與主詞的中心語一致,而不是與最近的名詞 “box” 一致。局部啟發式規則即使正確找到最近名詞,仍可能選錯單複數。
依存(dependency)表示則記錄詞之間的關係,例如動詞的主詞與受詞,或名詞的修飾語 [2]。UD 使用依存樹:每個詞恰好有一個中心語,並以帶標籤的關係連到它,例如名詞性主詞 nsubj [24]。成分結構凸顯分組,依存關係凸顯相連的中心語。兩者可以描述相關證據,不必有完全相同的結構或標註慣例。早期大型英文資源 Penn Treebank 標註的是成分樹 [26];UD 則以依存關係標註許多語言 [24]。
在面板範例中,“with the camera” 可以修飾檢查事件,也可以修飾面板。下圖只保留這一個附著差異,省略限定詞與其他關係。它們是教學示意圖,不是依某一具名標註標準完成的剖析結果。
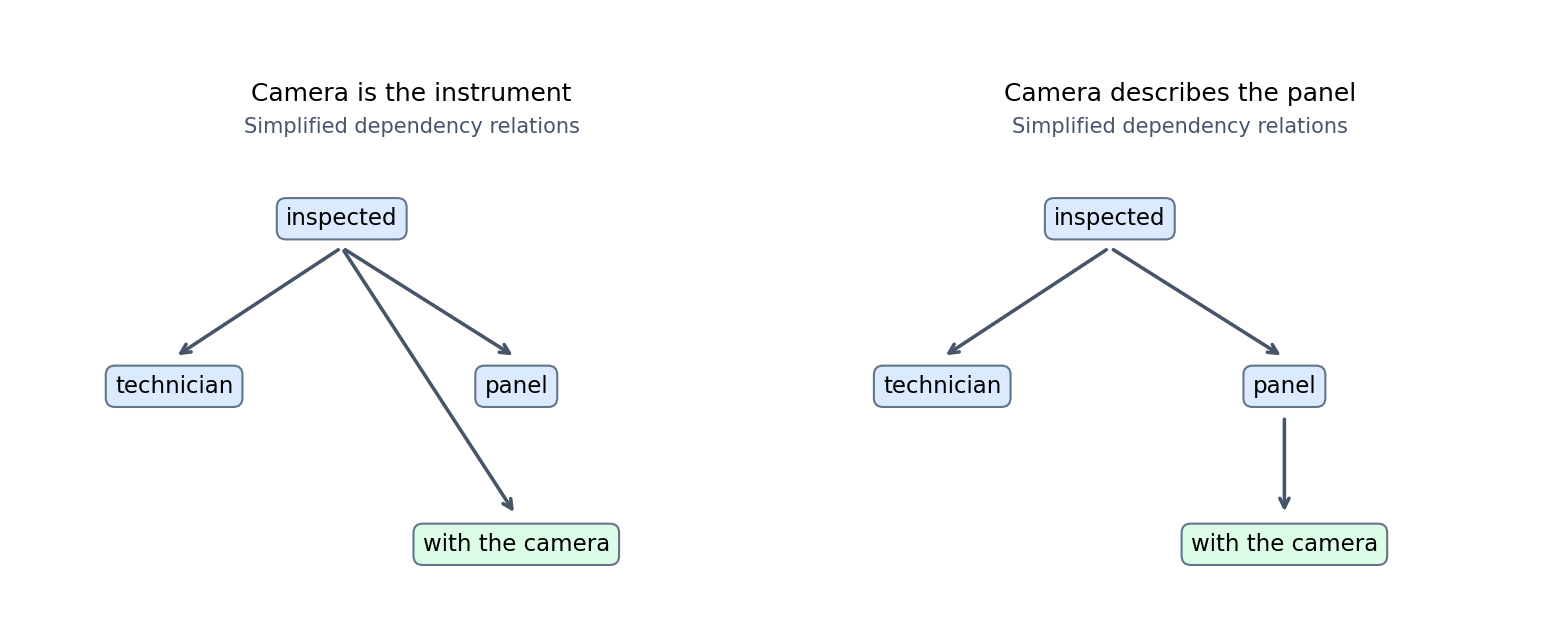
若附著於事件,相機是檢查的工具;若附著於名詞,相機協助辨認面板。前後文可以支持其中一種:例如技師解釋錄影方法,或有人區分有裝相機與沒有裝相機的面板。文法上的可能性不決定實際發生了哪一種情境。
這裡只是預覽。NLP 12 會深入文法、圖表剖析、機率式剖析與依存剖析。此處的核心問題是:表示需要保留什麼?答案包括分組、相連的中心語、角色方向,以及合理的替代分析。
6. 語意:意義與真值條件
白話版。 語意學問一個表達式是什麼意思,以及世界要是什麼樣子,句子才為真。詞義重要,句子如何組合詞義也同樣重要。
句子可以很流暢,卻錯誤描述情境。語意學(semantics)研究表達式如何貢獻意義,以及有結構的句子如何決定斷言為真的條件 [2, 3]。把這些條件與會話推論分開,能讓歧義更容易分析。
詞彙意義依賴語境與關係
多義(polysemy)涉及同一表達式的相關義項;同形異義(homonymy)涉及共享形式的不同意義 [3]。window 可以指牆上的開口,也可以指螢幕上有邊界的區域。兩者的關係有助於解釋這種延伸,但若把 “window” 固定換成某一具體物件,就會漏掉螢幕上的解讀。字典可以列出義項,實際出現的詞仍需要解讀。NLP 04 會研究從語境學到的向量如何捕捉其中一些關係。
中文「開」出現在「開門」與「開會」中,英文分別常用 “open a door” 與 “hold a meeting”。把每個「開」都翻成同一英文動詞,會抹掉與構式相關的差異。意義屬於表達式在組合與語境中的使用,不是無視語境的中文字元到英文詞對照。
即使看似簡單的形容詞,也可能依賴比較類別。「小象」可能比「大螞蟻」大。這些表達式把動物與適當類別相比,而不是使用一個普遍的尺寸門檻。在一組只有玩具象的物件中,相關比較又可能改變。因此,名為「小」的標註,應說明比較的對象是什麼。
組合依賴結構
組合性(compositionality)指複合表達式的意義,取決於各部分的意義與組合方式 [3]。它不表示只要把詞義相加即可。“Bo praised Ada” 把參與者放入有方向的關係;重排句子會用不同方式組合同一組名字。附著差異也會改變修飾語限制哪個表達式。
慣用表達式也可能有約定俗成的意義,無法從獨立詞條預測。詞庫與文法互相補充:分析必須同時記錄慣例組合與生產性的組合。對應用而言,要問任務需要哪種區別。搜尋維修說明也許能接受概括的詞彙歸類;判斷維修是否完成,則需要事件、時態與否定資訊。
量詞作用域改變要求
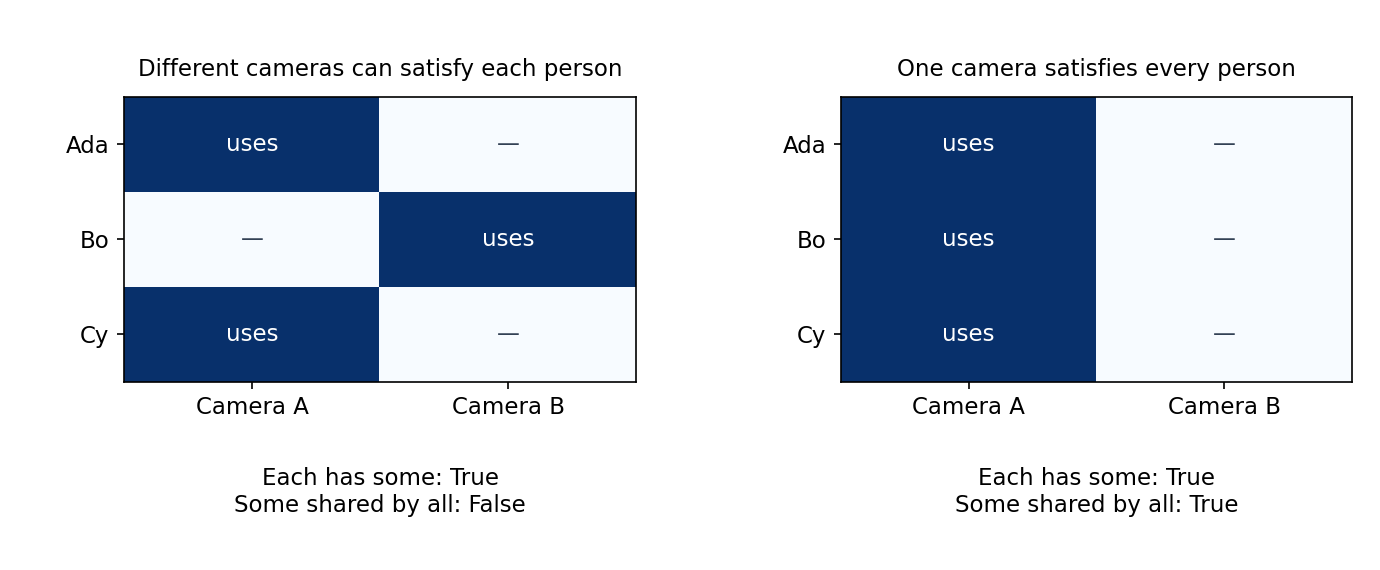
“Every technician uses a camera” 有一種解讀,容許不同技師使用不同相機;在適當語境裡,也能理解成有一台所有技師共用的相機。這兩種條件不同:
其中 是技師集合, 是相機集合, 表示技師 使用相機 , 與 是兩種解讀的名稱; 表示「對每一個」, 表示「存在」。本例的兩個集合都非空。在 裡,變數 可以隨 改變;在 裡,同一個 必須適用於所有 。
檢查 時,逐一查看每位技師,找到至少一台他使用的相機。檢查 時,先選一台相機,再確認所有技師都使用那一台。如果 成立, 就成立:對每位技師都選那台共用相機即可。反向推論不成立,因為每個人都可能有相機,卻沒有一台相機是所有人共用的。
程式碼 · Python · 14 行
technicians = ("Ada", "Bo", "Cy")
cameras = ("A", "B")
worlds = {
    "distributed": {("Ada", "A"), ("Bo", "B"), ("Cy", "A")},
    "shared": {("Ada", "A"), ("Bo", "A"), ("Cy", "A")},
}
for name, uses in worlds.items():
    each_has_some = all(any((t, c) in uses for c in cameras)
                        for t in technicians)
    some_for_everyone = any(all((t, c) in uses for t in technicians)
                           for c in cameras)
    print(name, each_has_some, some_for_everyone)
assert not any(all((t, c) in worlds["distributed"] for t in technicians)
               for c in cameras)
輸出為 distributed True False 與 shared True True。圖 3 每列表示一個人的選項。第一種解讀要求每列至少有一格被標記;第二種要求至少有一整欄都被標記。因此,作用域改變的是限制條件,不只是把相同要求改寫成另一句話。
否定與作用域也必須分清楚
“Not every technician approved” 容許有人批准,但至少有一人沒有批准。“Every technician did not approve” 若採取否定在全稱量詞內部的解讀,則表示沒有人批准。書寫英文自身也可能留下作用域歧義;明確改寫能消除這種不確定性。
中文「不是每位技師都批准 / 每位技師都不批准」較容易展示這個區別。前者否定「所有人都批准」,後者對每位技師指定不批准。對非空的技師集合而言:
其中 是技師集合, 表示 批准, 是否定, 與 分別是全稱與存在量詞, 表示邏輯等價。第一個條件只需一個反例,就能推翻全體批准;第二個條件則排除所有批准。若一位技師批准、另一位沒有批准,就只有第一個條件為真。
NLP 12 會深入述詞與論元結構及語意角色標註,NLP 11 則測試句子之間的推論。在設計 approved 這類欄位之前,先確定它代表誰的批准、哪個事件,以及哪個帶有量詞的主張。
7. 語用:在情境中解讀
白話版。 說話者的意思可能超出句子的字面內容。語用學研究情境如何補上這段落差。
說話者經常傳達超過句子字面斷言的內容。語用學(pragmatics)研究語境中的語言使用,包括指稱、背景假設與溝通行動 [9, 10]。語境提供證據,卻不代表可以任意解讀。
指稱與說話者的視角
“I will check that here tomorrow” 的結構很簡單,離開情境後卻缺少許多資訊。“I” 指說話者,“that” 選擇指稱對象,“here” 使用空間視角,“tomorrow” 使用時間視角。這些依賴語境的表達式涉及指示(deixis)[10]。轉寄的訊息不應把原說話者的時間與地點,默默換成接收者的時間與地點。
指稱也依賴篇章。“Mei put a camera beside a lamp. It was overheating.” 若沒有更多證據,“it” 可能指任一物件。知道相機與燈都可能變熱,仍然無法消除歧義。在 “Mei turned off the lamp. It stopped flickering” 裡,所描述的事件提供了支持「燈」的證據。證據可以支持某個候選,但不會把文法上的可能性變成普遍規則。
實際分析可以記錄表達式、候選指稱對象,以及支持它們的語境。若輸入不能確定指稱,保留未解決狀態也是有意義的結果。跨句子的共指解析在 NLP 12 中發展,跨對話輪次追蹤實體則在 NLP 08。
斷言、預設與會話含意
斷言(assertion)提出當下討論的主張。預設(presupposition)把命題當成背景,而不是主要更新。會話含意(conversational implicature)則是根據發話內容及其使用方式推得的額外意義,往往可以取消而不否定字面斷言 [9, 10]。三者不應被壓成同一個「意義」標籤。
“Mei stopped checking the sensor” 斷言某個活動停止,並通常把 Mei 先前檢查感測器當成背景。“Mei did not stop checking the sensor” 也通常把先前檢查視為已知。這種在否定下仍持續的貢獻,有助於辨認背景意義。它們是一般解讀,不是先前事件真的發生的證明。聽者可以質疑:「她根本從來沒有檢查過。」
“Some panels passed” 斷言相關集合裡至少有一個面板通過。在詢問整批是否都通過的對話裡,聽者可能推論「並非全部」。但是 “Some panels passed; in fact, all of them did” 可以取消這個推論,而不否定第一個斷言 [9]。相對地,若面板集合、測試與時間相同,“All panels passed; in fact, one failed” 就互相衝突。
這個差異不需要語言模型也能檢查。想像三個面板:一個、兩個或三個通過,都滿足字面的 “some”。“Some but not all” 的解讀則只保留前兩種可能。會話上的預期讓推論縮小了可能情境;這種縮小不是存在意義本身提供的。它是否合理,取決於問題、說話者的知識與報告方式。
文法上的問句可以執行請求
“Can you lower the gain?” 在形式上詢問能力。在錄音過程中,它可能是在請求調整設定;在測驗中,則可能詢問受訓者是否知道如何操作 [10]。言語行為(speech act)是透過發話執行的溝通行動,例如請求、承諾、斷言或提問。
“The gain is too high” 同樣可能是報告,也可能是間接請求。實際詞句本身不會指定所有人際條件。誰控制設備?前一個問題是什麼?說話者是在診斷錄音,還是在協調調整?這些細節為行動解讀提供依據。
有用的標註會分開記錄句子形式、斷言內容與意圖行動。否則,所有問句形式的請求都可能被標成尋求資訊,或所有負面描述都可能被標成指令。目標是對這次互動提出有依據的解讀;缺少情境時,也要保留其他選項。
8. 篇章:跨句子與輪次的意義
白話版。 文本或對話中的句子彼此依靠。後面的句子會回指、對比、解釋或修正前文,讀者則持續追蹤這個共同狀態。
發話可以引入實體、修正先前主張、提供理由,或對比預期。篇章(discourse)分析研究句子與對話輪次之間的連結 [2, 10]。逐句獨立閱讀,會丟掉讓後續表達式可被理解的共同狀態。
“Mei told Lin that she would calibrate the camera” 可以把任一人當成未來校正者。中文「美玲告訴怡君,她會校正相機」在這個虛構情境中也有相似歧義。前文若說「怡君已經自願幫忙」,就支持怡君;若說「美玲是唯一有空的技師」,就支持美玲。文法性別或提及順序,單獨都無法決定兩種語境。
比較 “The sensor became hot. Its readings stayed stable” 與 “The sensor became hot, but its readings stayed stable”。後者明確標記:結果違反熱可能干擾讀值的預期。關於穩定的斷言可以相同,篇章貢獻卻不同。相對地,“The readings drifted because the sensor became hot” 提出因果解釋,不只是依序出現兩件事。
對話也包含修復。“Move it to Friday.” “The inspection?” “Yes, the inspection.” 中間一輪不是在推進排程日期,而是在確定物件。釐清後,後續指稱可以使用共同確認的對象。若對話系統只摘要第一句與最後一句的詞,就會漏掉澄清如何改變對話狀態。
這提示一種實用表示:分開記錄已引入的實體、斷言事件、未解決指稱與對話問題。表示可以保留不完整。一句輸入可能沒有說明說話者;完整交換可能確定說話者,卻仍未指出確切相機。增加語境長度,只有在相關證據確實存在時才有幫助。
9. 語料庫、標註與 Zipf 定律
白話版。 NLP 從真實文字集合中學習,這些文字常附有人工標籤。文字如何蒐集、標籤是否一致,限制了任何模型能學到的內容;而且每個語料庫都有一條由罕見詞組成的長尾。
語料庫(corpus)是依明確決定蒐集的文字或語音轉寫:哪些來源、哪段時期、哪些說話者、哪些語言變體。標註語料庫(annotated corpus)再依書面準則加上分析,例如斷詞、標記、樹、實體範圍或情感標籤。兩個廣泛使用的例子顯示其範圍:Penn Treebank 為英文文字標註詞性與成分樹 [26];Universal Dependencies 專案以同一套跨語言依存方案,釋出許多語言的樹庫 [24]。前面的斷詞評測語料庫也說明,連詞邊界都附帶一套標準 [27]。
標註準則與一致度
標籤的清楚程度取決於背後的準則。兩位細心的標註者可能因為句子本身有歧義、準則沒有規定,或其中一人出錯而意見不同。在共同樣本上量測一致度,能在把標籤拿去訓練之前區分這些情況。
當某個標籤非常常見時,原始的百分比一致度會高估可靠性,因為標註者即使用猜的也常會一致。Cohen’s kappa 修正了這一點 [28]:
其中 是標註者 與 意見一致的項目比例; 是假設兩人各自依觀察到的比例獨立選標籤時,預期的一致比例; 是標籤集合; 與 分別是兩位標註者使用標籤 的次數; 是項目數。 代表完全一致, 代表只達到機率水準的一致;公式要求 。
程式碼 · Python · 14 行
from collections import Counter
from sklearn.metrics import cohen_kappa_score

words = "Mei has to repair the camera mount before the inspection".split()
a = "PROPN VERB PART VERB DET NOUN NOUN ADP DET NOUN".split()   # annotator A
b = "PROPN AUX ADP VERB DET NOUN NOUN ADP DET NOUN".split()     # annotator B
n = len(words)
p_o = sum(x == y for x, y in zip(a, b)) / n                     # observed agreement
ca, cb = Counter(a), Counter(b)
p_e = sum(ca[k] * cb[k] for k in ca) / n**2                     # agreement expected by chance
kappa = (p_o - p_e) / (1 - p_e)
print(f"p_o={p_o:.3f}  p_e={p_e:.3f}  kappa={kappa:.3f}")
assert abs(kappa - cohen_kappa_score(a, b)) < 1e-12
print("disagreements:", [(w, x, y) for w, x, y in zip(words, a, b) if x != y])
程式印出 p_o=0.800 p_e=0.180 kappa=0.756,兩處分歧是 has(VERB 對 AUX)與 to(PART 對 ADP)。兩者都不是粗心失誤:“has to” 位於主要動詞與助動詞的邊界,不定詞的 “to” 也很像介詞。有用的結果是針對這個構式做出準則決定,而不是更高的數字。Kappa 總結可靠性;分歧清單則指出該修正什麼。
Zipf 定律:少數詞非常常見,多數詞很罕見
把語料庫裡每個詞都計數,再依頻率排序型別。少數功能詞如 “the” 與 “of” 占了所有 token 的一大部分,而大量型別只出現一兩次。Zipf 定律把詞的頻率排名與次數之間的關係描述為近似的冪律 [29]:
其中 是型別依次數遞減排序後的名次, 是名次 的型別出現次數, 是尺度常數, 是指數。當 時,乘積 大致固定。在雙對數座標上,這個關係是一條斜率為 的直線。Piantadosi 的回顧指出,這個定律在許多語言與語料庫中近似成立,在兩端有系統性的偏離,而其成因仍有爭論 [29]。
我們可以用已經在磁碟上的真實英文文字檢查它:專案環境(Python 3.9)所安裝的 Python 標準函式庫說明字串(docstring)。
程式碼 · Python · 22 行
import ast, re, sysconfig
from collections import Counter
from pathlib import Path

lib = Path(sysconfig.get_paths()["stdlib"])        # text already on disk: stdlib docstrings
docs = []
for path in sorted(lib.glob("*.py")):
    try:
        tree = ast.parse(path.read_text(encoding="utf-8"))
    except (SyntaxError, UnicodeDecodeError):
        continue
    docs += [ast.get_docstring(n) or "" for n in ast.walk(tree)
             if isinstance(n, (ast.Module, ast.FunctionDef, ast.AsyncFunctionDef, ast.ClassDef))]
tokens = [w for d in docs for w in re.findall(r"[a-z]+", d.lower())]
counts = Counter(tokens)
print(len(tokens), "tokens,", len(counts), "types")
ranked = counts.most_common()
for r in (1, 2, 10, 100, 1000):
    word, f = ranked[r - 1]
    print(f"rank {r:4d}  {word:10s} f={f:5d}  r*f={r * f}")
hapax = sum(f == 1 for f in counts.values())
print(f"types seen once: {hapax} ({hapax / len(counts):.0%})")
在 Python 3.9.7 下,程式找到 134,620 個 token 與 6,281 個型別。乘積 在名次 1(“the”)是 8,313,名次 10(“be”)是 13,640,名次 100(“called”)是 20,100,名次 1,000 是 18,000:並不固定,但名次變動 1,000 倍時,乘積只在約 2.5 倍範圍內變動。圖表腳本在名次 10 到 1,000 之間做最小平方擬合,得到 。所有型別中有三分之一,也就是 2,003 個(32%),恰好只出現一次。不同 Python 版本附帶的說明字串不同,確切計數可能改變。
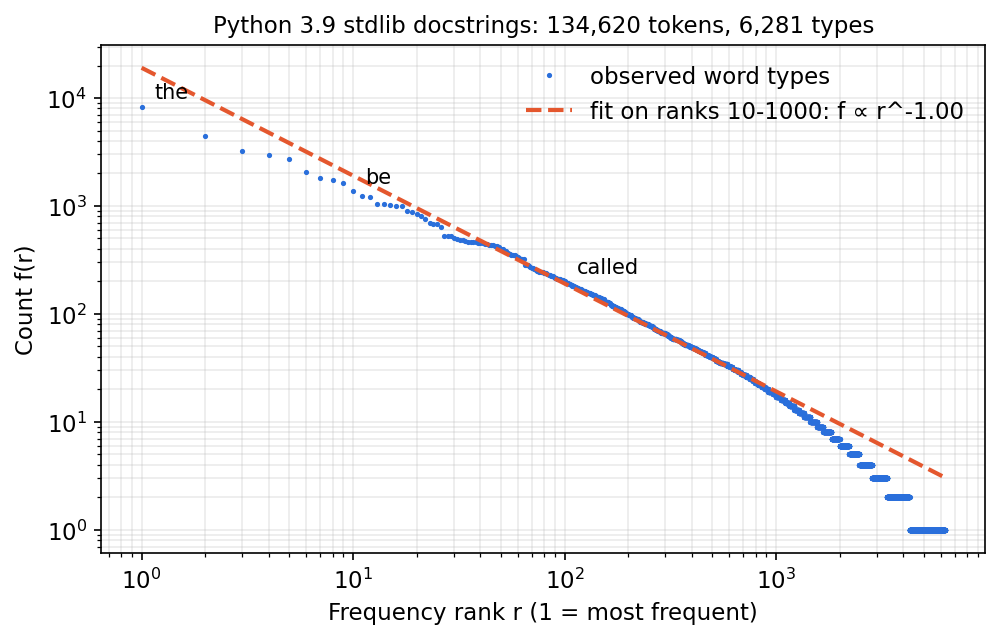
這對 NLP 有三個後果。第一,任何固定的詞彙表都會漏掉一部分長尾,因此新文字總會帶來沒見過的詞;這是子詞詞彙表存在的原因。第二,以計數估計的機率對常見詞可靠,對占多數的罕見詞則不可靠,這就是 n-gram 模型需要平滑化的原因(NLP 05)。第三,以所有 token 計算的準確率主要由常見詞決定;若罕見名稱或技術詞彙很重要,評估就必須另外量測它們。
10. 語言多樣性與模型假設
白話版。 不同語言用不同方式包裝資訊,不同社群也使用不同的語言變體。圍繞某一語言習慣建立的模型,可能錯過另一種語言所表達的內容。
不同語言與社群會把資訊分配到構詞、詞序、韻律與語境的不同位置。語言類型學(typology)比較這些結構模式。方言(dialect)涉及社群的語言變體;語域(register)涉及特定情境或活動的使用方式 [3, 11]。這些區別描述變異,不是替說話方式排序。
翻譯不會保留每種結構
比較 “I calibrated this camera yesterday” 與「這台相機,我昨天校正過」。中文例子先把相機設為主題,再對它作出評論。把第一個名詞片語直接當成行動者,就會誤認校正者。英文翻譯可以保留事件,卻改變訊息如何組織已知與新資訊。
當相機與負責者已經確定時,短句「已經校正好了」可以提供充分資訊。逐字翻譯若要求每個英文論元都有明說的對應項目,可能把它看成不完整。在語境中,它卻能直接回答待解問題。這不表示省略的參與者一定能被找回;分析仍須查看實際篇章。
同樣地,「三台相機」與 “three cameras” 用不同方式包裝數量。不能只因為「複數詞尾」適合某一語言,就把這個特徵設為普遍要求。結構類別可以用於比較,同時需要各語言的實現與標註決定。強制詞尾較少的語言,仍然可以透過構式、詞與語境表達細緻區別。
變體、情境與混合語言表達
正式維修報告與技師聊天,可能用不同詞彙、縮寫與明確程度描述相同設備。報告的 “The shutter failed to actuate” 與口語的 “The shutter didn’t fire”,在語境中可能描述相關事件,但措辭提供不同的情境與讀者證據。不熟悉的說法不會自動成為錯誤。
說話者可能在雙語討論裡寫「把 exposure 調低一點」。英文項目出現在中文構式的一個位置。語碼轉換(code-switching)涉及互動中不同語言變體的交替 [14];分析本例需要同時看詞彙選擇與周圍文法。只憑一次出現,未必能確定社群把該項目當成語碼轉換,還是已經成立的借詞。
分析應先保留觀察到的表達,再進行標準化。把地區或技術表達換成預設標準,可能有助於某個搜尋任務,卻抹掉另一任務需要的區別。語料庫記錄特定說話者、情境與蒐集決定下的語言;常見語料模式是使用證據,不是所有說話者可說內容的普遍清單。
11. 一次完整的閱讀分析
用一則虛構訊息,把不同層次放在一起:
小林說:「那台相機又過熱了,你明天能幫我看看嗎?」
Lin said: “That camera overheated again. Can you take a look for me tomorrow?”
翻譯有助於英文讀者,但已經替「看看」與引述互動的標點選擇措辭。在把翻譯當成等價證據之前,先分析原文。
| 層次 | 訊息提供的內容 | 仍需確定的事項 |
|---|---|---|
| 書寫形式與斷詞 | 引號把小林的發話分成一組;相機是物件表達式 | 語音的語調與手勢不存在於文字中 |
| 構詞與構式 | 看看在此請求裡是重疊形式,不是計數兩次檢查 | 確切活動與預期投入取決於情境 |
| 句法 | 小林引入被報導的說話者;你是引號內的受話者 | 報導者不一定是受話者 |
| 語意 | 相機被描述為過熱;句子表達未來協助的問題 | 哪台相機,以及描述是否符合事實 |
| 背景與指稱 | 又通常援引先前發生;那台選擇語境中可辨認的相機 | 先前過熱與指示詞的對象需要證據 |
| 語用與篇章 | 在維修對話裡,問句自然支持請求解讀 | 該解讀是否符合這次互動,以及請求是否被接受 |
引述改變參照框架。「我」指引號內的說話者小林。「你」指小林的受話者,可能與目前讀者不同。「明天」相對於引號內發話的日期。如果報導較晚才送達,送達日期不會重新定義請求的日期。
在這個構式裡,「看看」的一般解讀呈現「看一下」的活動,往往帶有較輕或試探性的語氣 [13]。它不會確定精確檢查時間或數值上的重複次數。若翻成 “inspect twice”,就是把可見的形式重複誤當成事件計數。
最後,把語言證據與事實證據分開。訊息提供小林曾報告過熱與請求協助的證據;它本身不會驗證過熱、指出序號,或證明有人同意幫忙。結構化輸出可以記錄說話者與被報導事件,同時保留未解決指稱與日期。這比只給出「相機維修」之類的主題標籤,更能提供有用分析。
現代觀點
近期綜述說明,對大型語言模型而言,語言分析仍然必要。Ma 等人的 2025 年綜述,依指稱與指示、會話含意與預設、言語行為、篇章、社會語用等現象,組織語用評估 [10]。它比較任務設計、資料蒐集與評估,指出現有測試與語境中語言使用的落差。對本教學最有用的啟示是:評估任務真正要求的推論,不要把概括的語言分數當成所有語用能力的證明。
Mielke 等人的斷詞綜述,從詞、字元與中間單位整理開放詞彙問題 [22]。有用的問題是切分如何平衡覆蓋率、序列長度與重用。這些量彼此不同:斷詞器可以表示每個輸入字串,模型卻仍可能缺乏學習相關組合的訓練證據。Zipf 定律說明了這個問題為何永遠不會消失:無論詞彙表多大,長尾都會持續帶來罕見形式 [29]。
Qin 等人的 2025 年綜述,區分透過參數調整的多語言對齊,以及固定參數下的對齊,包括提示與翻譯式方法 [12]。它整理跨語言訓練、評估與挑戰。這個區分指出系統在哪裡調整行為,但能產生多語言輸出,不代表它保留構式的作用域、語域或會話功能。
Winata 等人的 2023 年系統性綜述,依語言、任務與研究趨勢,組織語碼轉換研究 [15]。可以搭配 Doğruöz 等人對結構與社會模式的分析 [14]:測試由兩個單語來源拼接的文字,與解讀雙語說話者如何在互動中實際切換,是不同任務。第 10 節 exposure 的例子把這點具體呈現出來:除了辨認英文項目,周圍構式與對話情境也提供資訊。
語言學分析也持續細化看似簡單的構式。Lu 與 Müller 的 2026 年研究,分析華語動詞重疊及其與動詞類別、時貌的互動 [13]。本教學相關的觀察是:有限活動的意義,以及依賴語境的語用效果,值得分開分析。看得到的形式重複,不是要求把事件計數兩次的普遍規則。
具體評估可以固定其他條件,只改變一項特性。交換 Ada 與 Bo,測試角色方向;保留詞彙、改變相機的附著;比較「不是全部」與「沒有任何一個」;把引述訊息移到較晚的報導語境。先寫出預期解讀與可接受選項,再觀察失敗在哪個區別上。這些是小型診斷測試,不表示通過後就具備一般語言能力。
開放問題包括如何取得相關語境、區分真正歧義與可避免的標註歧見、評估自然的混合語言對話,以及跨社群測量解讀,而不只使用翻譯提示。有些輸入本來就容許多種讀法。說明選項與缺少證據的系統,可能比自信選定單一答案的系統更忠於語言。
重點整理
- 口語、手語與書寫揭露不同資訊;逐字稿只是部分紀錄。
- 計算用 token 不必與詞、詞素、詞位或語音單位一致;BPE、WordPiece 或 unigram 模型學到的子詞片段反映頻率,而不是構詞。
- 詞幹擷取依規則切掉詞尾;詞形還原對應到字典形式,並需要詞性。兩者都會丟掉某些任務需要的資訊。
- 構詞結構與中文斷詞編碼了分析選擇,也可能有替代方案,而不同語料庫依循不同標準。
- 詞頻會丟掉順序;詞性類別、分組與文法關係提供額外意義。成分結構顯示分組,依存關係顯示中心語。
- 作用域決定真值條件:「每個人都有某個」不等於「某一個被所有人共用」。
- 斷言、背景假設、可取消的推論、指稱、言語行為與篇章關係,需要說話者的情境及對話歷史。
- 語料庫帶有蒐集選擇與標註準則;要檢查一致度,並預期罕見詞形成 Zipf 式長尾。
練習
- 在 “The technician repaired two cameras” 裡,辨認詞形、詞位、屈折對比、一組 UPOS 標記序列,以及一種計算用 token 切分。解釋每種表示保留什麼。
提示
比較 “repaired” 與 REPAIR。Tokenizer 可以保留整個詞形或拆開;兩種選擇都不能單獨確定時態解讀,UD 則把時態記錄為特徵。
- 替「學生會說話」的兩種解讀各加一句語境。解釋為何只列舉詞庫路徑,無法偏好任一語境。
提示
一種情境可以討論學生的能力;另一種可以討論學生會宣布立場。
- 改變 BPE 語料中一個訓練詞的頻率。檢查第一個合併,再編碼
lowest。為什麼兩種結果都不必維持不變?
提示
符號對計數以詞的出現次數加權。前面的合併會改變後面可使用的符號對。
- 替 “The technician inspected the panel with the camera” 寫出兩種語境,各支持一種附著。辨認修飾語連到哪個中心語,以及事件描述如何改變。
提示
對比檢查方法,以及在多個面板中辨認裝有相機的面板。
- 修改量詞程式,加入一位沒有使用任何相機的技師。執行前先預測兩種解讀,再解釋 為何蘊涵 。
提示
若任一技師沒有可用配對,兩個條件都失敗。一台共用相機能替每位技師提供見證。
- 分別分析 “Mei stopped checking the sensor” 與 “Some panels passed” 在否定與明確取消下的表現。區分主要斷言、一般背景假設,以及會話推論。
提示
試著用 “Mei never checked it” 挑戰背景,用 “in fact, all passed” 取消推論。維持相同面板集合與測試。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Manning, 2021. 出版社
- Susan McRoy, Principles of Natural Language Processing, University of Wisconsin–Milwaukee open textbook, 2021. Grammars and Syntactic Processing
- Catherine Anderson, Bronwyn Bjorkman, Derek Denis, Julianne Doner, Margaret Grant, Nathan Sanders and Ai Taniguchi, Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 開放教科書
- Catherine Anderson et al., “3.1 Modality,” Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 章節
- Catherine Anderson et al., “4.1 Phonemes and allophones,” Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 章節
- Catherine Anderson et al., “3.12 Tone and intonation,” Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 章節
- Catherine Anderson et al., “5.1 What is morphology?,” Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 章節
- Catherine Anderson et al., “6.4 Identifying phrases: Constituency tests,” Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 章節
- Catherine Anderson et al., “8.4 Conversational implicatures,” Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 章節
- Bolei Ma, Yuting Li, Wei Zhou, Ziwei Gong, Yang Janet Liu, Katja Jasinskaja, Annemarie Friedrich, Julia Hirschberg, Frauke Kreuter and Barbara Plank, “Pragmatics in the Era of Large Language Models: A Survey on Datasets, Evaluation, Opportunities and Challenges,” ACL, pp. 8679–8696, 2025. 論文
- Catherine Anderson et al., “10.2 Language varies,” Essentials of Linguistics, 2nd ed., eCampusOntario, 2022. 章節
- Libo Qin, Qiguang Chen, Yuhang Zhou, Zhi Chen, Yinghui Li, Lizi Liao, Min Li, Wanxiang Che and Philip S. Yu, “A survey of multilingual large language models,” Patterns, 6(1), 101118, 2025. 論文
- Yanru Lu and Stefan Müller, “Deliminative verbal reduplication in Mandarin Chinese,” Journal of Linguistics, 62(3), pp. 595–632, 2026. 論文
- A. Seza Doğruöz, Sunayana Sitaram, Barbara E. Bullock and Almeida Jacqueline Toribio, “A Survey of Code-switching: Linguistic and Social Perspectives for Language Technologies,” ACL-IJCNLP, pp. 1654–1666, 2021. 論文
- Genta Winata, Alham Fikri Aji, Zheng Xin Yong and Thamar Solorio, “The Decades Progress on Code-Switching Research in NLP: A Systematic Survey on Trends and Challenges,” Findings of ACL, pp. 2936–2978, 2023. 論文
- M. F. Porter, “An algorithm for suffix stripping,” Program, 14(3), pp. 130–137, 1980. DOI
- Rico Sennrich, Barry Haddow and Alexandra Birch, “Neural Machine Translation of Rare Words with Subword Units,” ACL, 2016. 論文
- Mike Schuster and Kaisuke Nakajima, “Japanese and Korean Voice Search,” ICASSP, pp. 5149–5152, 2012. DOI
- Yonghui Wu et al., “Google’s Neural Machine Translation System: Bridging the Gap between Human and Machine Translation,” arXiv:1609.08144, 2016. 論文
- Taku Kudo, “Subword Regularization: Improving Neural Network Translation Models with Multiple Subword Candidates,” ACL, 2018. 論文
- Taku Kudo and John Richardson, “SentencePiece: A Simple and Language Independent Subword Tokenizer and Detokenizer for Neural Text Processing,” EMNLP System Demonstrations, 2018. 論文
- Sabrina J. Mielke et al., “Between Words and Characters: A Brief History of Open-Vocabulary Modeling and Tokenization in NLP,” arXiv:2112.10508, 2021. 綜述
- Hugging Face, “The Tokenization Pipeline,” Tokenizers documentation, current online edition. 文件
- Marie-Catherine de Marneffe, Christopher D. Manning, Joakim Nivre and Daniel Zeman, “Universal Dependencies,” Computational Linguistics, 47(2), 2021. 論文
- Universal Dependencies contributors, “Universal POS tags,” Universal Dependencies documentation, current online edition. 文件
- Mitchell P. Marcus, Beatrice Santorini and Mary Ann Marcinkiewicz, “Building a Large Annotated Corpus of English: The Penn Treebank,” Computational Linguistics, 19(2), 1993. 論文
- Thomas Emerson, “The Second International Chinese Word Segmentation Bakeoff,” Proceedings of the Fourth SIGHAN Workshop on Chinese Language Processing, 2005. 論文
- Jacob Cohen, “A Coefficient of Agreement for Nominal Scales,” Educational and Psychological Measurement, 20(1), pp. 37–46, 1960. DOI
- Steven T. Piantadosi, “Zipf’s word frequency law in natural language: A critical review and future directions,” Psychonomic Bulletin & Review, 21(5), pp. 1112–1130, 2014. DOI
- Jacob Devlin, Ming-Wei Chang, Kenton Lee and Kristina Toutanova, “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,” NAACL-HLT, 2019. 論文
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 03・自然語言處理的類神經網路 · 31 分鐘