NLP 10・預訓練模型:BERT
先備知識:NLP 09・以 Transformer 做語言模型(自然語言生成)
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 說明「先預訓練、再微調」的配方,以及 BERT 與 ELMo、GPT 的相對位置。
- 把文字轉成 BERT 輸入:WordPiece 片段、
[CLS]/[SEP]打包,以及相加的詞元、段落與位置嵌入。 - 精確說明遮罩語言建模目標(選取 15%,再依 80/10/10 替換),以及下一句預測目標與後來的批評。
- 在玩具語料上從零預訓練一個小型 BERT 式編碼器,並量測它學到什麼。
- 區分上下文嵌入與靜態嵌入,並用控制任務探測(probe)表示。
- 把 RoBERTa、ALBERT、DistilBERT、ELECTRA、多語 BERT 與中文 BERT 放進同一張地圖。
先看全貌
一般 Word2Vec 特徵替每個詞取出一個固定向量 [6]。BERT,全名 Bidirectional Encoder Representations from Transformers,則讀取周圍文字,替每次出現的詞元重新計算表示 [1]。在「the crane lifts steel」與「the crane eats fish」中,crane 查表得到的初始嵌入相同,編碼器卻能利用其他詞算出不同的最終向量。關鍵是區分詞彙表項目與這次出現的表示。
BERT 分兩階段學習。預訓練使用一般無標籤文字,由文字自己提供目標。微調再把同一個網路加上小型任務頭,調適到情感或蘊涵等有標籤任務。第一階段昂貴、只做一次;第二階段便宜、每個任務各做一次。
Hagiwara 第 9 章在實務情境中說明預訓練模型調適 [18]。本章則走進模型內部,並以 NLP 09 的因果語言模型作對照,沿用 NLP 07 的注意力區塊與 NLP 04 的靜態嵌入。接在 BERT 上的分類、蘊涵、標記與擷取式問答任務頭,是 NLP 11 的主題。這裡每個模型都很小,且從零訓練,不下載任何檢查點。
1. 先預訓練,再微調
直觀說法。 先從大量無標籤文字學到語言的一般知識,再用少量標籤把它用在特定任務。問題在於:哪種預訓練目標能產生最可重用的表示?
三個 2018 年的設計構成 BERT 的背景。ELMo 訓練由左到右與由右到左的 LSTM 語言模型,並把其內部狀態的學得組合,當作上下文詞特徵提供給既有任務模型 [5]。GPT 把 12 層僅解碼器 Transformer 預訓練成由左到右語言模型,再針對每個任務微調整個網路 [4]。BERT 保留 GPT「微調全部參數」的配方,但把因果目標換成遮罩目標,讓每一層都能使用左右兩側上下文 [1]。
BERT 論文主張,由左到右的限制對句子層級任務並非最佳,對問答這類需要兩個方向上下文的詞元層級任務更可能有很大傷害 [1]。其消融實驗包含一個沒有下一句預測的由左到右模型,預訓練與微調都受同樣的只看左側限制,並與雙向模型比較 [1]。工程上的教訓是:可見性模式是與任務相連的建模選擇,不是個人喜好。
預訓練提供參數初始化與表示函數,卻沒有提供應用標籤。幫浦維護分類器仍需要範例定義「緊急」,實體標記器也需要辨認現場設備名稱的標註。微調會一起調整編碼器與任務頭;凍結編碼器、只訓練任務頭,成本較低,但調適能力也不同。
2. 遮罩與條件目標
直觀說法。 不是每個預訓練語言模型都預測下一詞元。遮罩目標使用周圍內容,條件生成則根據另一個輸入預測輸出序列。
BERT 的遮罩語言目標藏起選定位置,再使用雙向上下文預測原詞元 [1]。簡化描述如下:
其中 是受監督遮罩位置集合; 是集合大小; 是原詞元; 是模型參數; 是受損輸入序列。波浪號表示損壞,不是獨立抽出的文件。這個式子描述遮罩預測部分;完整的損壞程序見第 5 節。
遮罩預測器適合上下文表示、分類與區段任務,其損失卻不會自動成為一般由左到右序列的對數機率。把各自讀取句子兩側的預測相乘,通常不會得到與因果分解相同的正規化聯合分布。因此,遮罩目標分數與因果困惑度不能直接互換。
條件序列生成則寫成:
其中 是來源序列; 是目標序列; 是包含結束詞元的目標長度; 是目標前綴。來源可以完整可見,目標仍保持因果。T5 把多種 NLP 任務整理成文字到文字架構,並研究 Transformer 編碼器—解碼器的遷移學習 [27];NLP 08 深入介紹這一類模型。
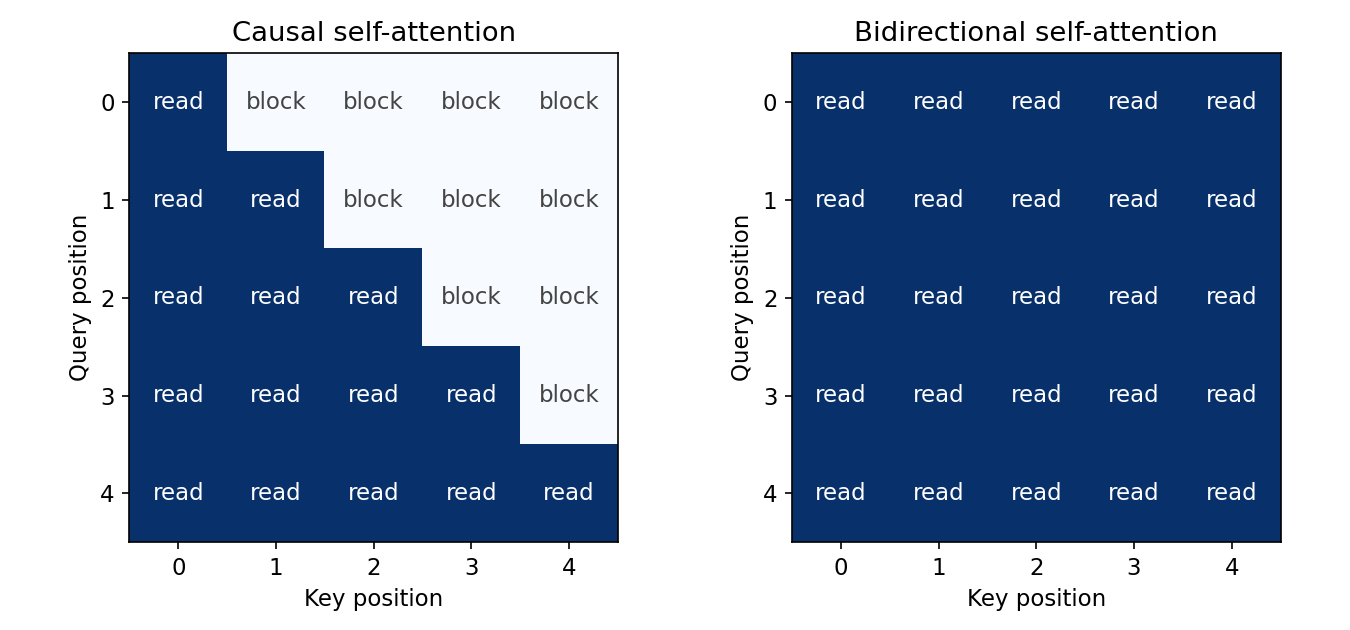
這些區別有助選模型。完整句子已知時,分類器可使用雙向編碼器;串流延續則必須排除未來輸出。翻譯可以在來源全部抵達後讀取完整來源,但同步翻譯需要更嚴格的來源可見性契約。應由任務可取得的資訊決定遮罩,而非因為某個模型名稱熟悉就選它的遮罩。
3. 從文字到 BERT 輸入
直觀說法。 BERT 從不直接看到詞。文字先被拆成詞彙表片段,再加上特殊標記,每個位置則得到三個學得向量的和。
WordPiece
原始分詞器先做文字前處理,再執行 WordPiece 分詞 [2]。BERT 使用含 30,000 個詞元的 WordPiece 嵌入 [1],這是為 Google 神經機器翻譯系統提出的子詞方法 [7]。需要時,WordPiece 把詞拆成詞彙表中的片段;原始詞彙表以 ## 標示接續片段。原始實作以貪婪的最長匹配優先切分每個詞:先取詞首最長的詞彙項目,再取最長的接續片段,依此類推;若某段剩餘部分沒有任何匹配,整個詞就變成 [UNK] [2]。詞彙表事先從語料學得,就像 NLP 02 中學得 BPE 合併規則一樣。
程式碼 · Python · 34 行
vocab = {'[UNK]', 'the', 'pump', 'over', 'heat', '##heat', '##ed', '##s',
         'un', '##load', 'load', '##ing', '幫', '浦', '過', '熱'}

def wordpiece(word, max_chars=200):
    """Greedy longest-match-first split into vocabulary pieces."""
    if len(word) > max_chars:
        return ['[UNK]']
    pieces, start = [], 0
    while start < len(word):
        end = len(word)
        while end > start:
            piece = word[start:end] if start == 0 else '##' + word[start:end]
            if piece in vocab:
                break
            end -= 1
        if end == start:                     # no piece fits: the whole word is unknown
            return ['[UNK]']
        pieces.append(piece)
        start = end
    return pieces

def basic_split(text):
    """Lowercase, put spaces around CJK ideographs, split on whitespace."""
    out = []
    for ch in text.lower():
        cjk = 0x4E00 <= ord(ch) <= 0x9FFF
        out.append(f' {ch} ' if cjk else ch)
    return ''.join(out).split()

for text in ['The pump overheated', 'unloading pumps', 'the pumpkin', '幫浦過熱']:
    tokens = [p for w in basic_split(text) for p in wordpiece(w)]
    print(f'{text!r:24} -> {tokens}')
assert wordpiece('overheated') == ['over', '##heat', '##ed']
assert wordpiece('pumpkin') == ['[UNK]']
輸出:
程式碼 · 4 行
'The pump overheated'    -> ['the', 'pump', 'over', '##heat', '##ed']
'unloading pumps'        -> ['un', '##load', '##ing', 'pump', '##s']
'the pumpkin'            -> ['the', '[UNK]']
'幫浦過熱'                   -> ['幫', '浦', '過', '熱']
這帶來三個結果。一個詞可能占多個模型位置,因此詞標籤與字元區段必須對應到詞元位置。剩餘部分無法涵蓋的詞會變成單一 [UNK],即使它的前綴 pump 是已知詞;這是貪婪規則的性質,不是語言的性質。中文字則在 WordPiece 之前一字一個位置地切開,原始多語與中文模型也是如此(第 11 節)。這裡的 basic_split 只檢查主要的 CJK 統一表意文字區塊;原始程式還檢查其他幾個範圍,並處理重音與標點 [2]。
打包一段文字或一對文字
單一文字打包成 [CLS] text [SEP];文字對則打包成 [CLS] text A [SEP] text B [SEP]。序列分類器可讀取 [CLS] 位置的最終狀態,[SEP] 則標記邊界。段落 ID 區分兩部分,卻不會阻擋跨段落注意力:文字 A 的查詢仍能讀取文字 B。決策依賴兩段文字互動時,這種聯合編碼很有用 [2]。
進入編碼器前,先相加三種學得的向量:
其中 是打包後的序列長度; 表示編碼器參數; 是位置 的詞元 ID; 是段落 ID; 是詞彙表 的詞元表; 是位置表,支援長度為 ; 是段落表; 是相加後的輸入; 包含上下文輸出列 。原始實作還會對相加後的嵌入執行正規化與 dropout [2]。填補鍵被阻擋,兩側的一般文字則保持可見。
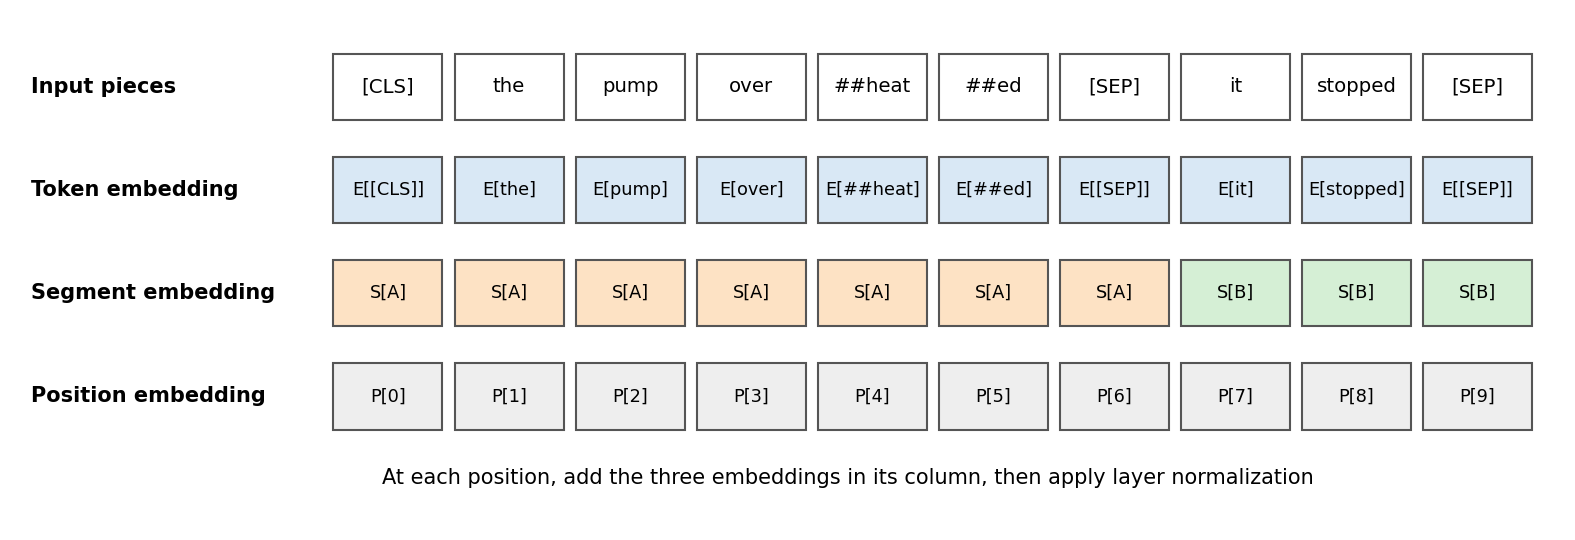
與原始 Transformer 的固定正弦位置不同,BERT 的位置向量是學得的列 [2]。學得的位置表限制支援的最遠位置;更長的輸入是非法索引,不是普通的長序列,必須截斷或切成視窗。嵌入列也只在該模型詞元 ID 的定義下有意義。未調適權重就換分詞器,可能讓形式合法的數字代表不相關符號。
4. 編碼器
直觀說法。 BERT 是 Transformer 的編碼器那一半:一疊相同的區塊,每個區塊讓每個位置讀取所有其他位置,再分別轉換每個位置。
BERT 疊合多個 Transformer 編碼器區塊 [1, 3]。每個區塊先用雙向自注意力混合資訊,再用前饋網路轉換各位置;殘差連接與層正規化支援整個堆疊 [9]。「雙向」表示編碼器各層都能讀取輸入左右兩側,不是像 ELMo 那樣各訓練一個因果模型、再把輸出接起來 [5]。NLP 07 推導多頭注意力;BERT 唯一特有的選擇是圖 1 的注意力遮罩。
論文報告兩種大小。以 表示區塊數、 表示隱藏寬度、 表示注意力頭數,BERT-Base 為 、、,共 1.1 億個參數;BERT-Large 為 、、,共 3.4 億個參數 [1]。BERT-Base 刻意選成與原始 GPT 同樣大小以便比較 [1]。前饋層使用 GELU 活化函數 [8, 1]。預訓練使用 BooksCorpus 與英文維基百科,論文強調使用文件層級語料,才能取得長的連續序列 [1]。
可把輸出想成每個輸入詞元各占一列的表格,而不是單一的句子向量。詞元標籤頭逐列讀取;序列頭則透過池化轉換讀取第一列。同一編碼器能支援兩者,因為輸出保留了詞元位置;NLP 11 會建立這些任務頭。
5. BERT 在取得任務標籤前學什麼?
直觀說法。 遮罩語言建模把原始文字變成填空練習;下一句預測則多問一個是非題:兩段文字是否相連。
遮罩語言建模
遮罩語言建模(masked language modeling,MLM)從一般文字學習:原詞元就是自己的目標。例如 the crane [MASK] steel 要求模型利用兩側文字猜回被移除的詞元。預測損失同時更新編碼器與詞彙頭,因此最終詞元向量可作為後續監督任務的輸入。
原始 BERT 選取 15% 的 WordPiece 位置作為預測目標。在被選位置中,80% 換成 [MASK]、10% 換成隨機詞元、10% 保留原詞元 [1]。選取與替換是不同步驟:每個被選位置都提供目標,即使可見詞元未改變。其他位置提供上下文,不貢獻 MLM 損失。這種混合替換方式縮小預訓練輸入與一般未遮罩任務輸入的差異,因為後者從不出現 [MASK]。
這個設計的代價是樣本效率:只有被選位置產生損失。ELECTRA 的作者正是指出這一點:MLM 每個例子只從被遮罩的那一小部分詞元學習 [14]。原始實作也在準備資料時就一次決定遮罩;RoBERTa 比較這種靜態遮罩與動態遮罩(每次使用序列時重新抽取遮罩模式),發現動態遮罩相當或略好 [11]。第 7 節的小模型使用動態遮罩。
下一句預測及其批評
原始 BERT 也訓練下一句預測(next sentence prediction,NSP)[1]:文字對有一半來自連續語料,另一半則從語料隨機抽取第二段。池化後的 [CLS] 狀態預測這個二元標籤。NSP 預測關係標籤,不會生成下一句。原始預訓練結合 MLM 與 NSP,論文的消融實驗報告移除 NSP 會降低 QNLI、MNLI 與 SQuAD 1.1 的表現 [1]。
後續研究有不同結論。RoBERTa 的複製研究發現,以連續文字填滿輸入時,移除 NSP 損失的下游表現相當或略好,並推測原始消融可能只移除了損失項,卻保留了段落對的輸入格式 [11]。ALBERT 的作者推測 NSP 太簡單,因為它把主題預測與連貫性預測混在一起:隨機抽取的第二段通常主題不同。他們改用句序預測(sentence-order prediction),取同一文件中兩個連續段落,維持原順序或對調,讓主題不再洩漏答案 [12]。一般教訓是:應檢查實際檢查點的訓練目標,不要假定後來的每個編碼器都保留所有原始設計。
選讀:BERT(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
6. 可執行的雙向編碼器
直觀說法。 在預訓練完整模型之前,先隔離讓它像 BERT 的兩個性質:改變較後面的詞會改變較前面詞的表示,而填補完全不造成影響。
以下 CPU 範例以四個自創句子訓練 MLM,固定選取位置 2 並換成 [MASK]。因此,右側可見動詞有助區分 robot 與 sensor。這個刻意簡化的替換規則用來觀察機制;模型隨機初始化,只有一個小型編碼器區塊,並以線性詞彙頭取代原始 BERT 的完整預測頭。它使用層正規化、GELU 與 AdamW [8–10]。
程式碼 · Python · 68 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(23)
torch.set_num_threads(1)
vocab = ['[PAD]', '[CLS]', '[SEP]', '[MASK]', 'the', 'a',
         'robot', 'sensor', 'moves', 'measures']
index = {word: i for i, word in enumerate(vocab)}
rows = ['the robot moves', 'the sensor measures',
        'a robot moves', 'a sensor measures']
ids = torch.tensor([[index[w] for w in ['[CLS]'] + s.split()
                     + ['[SEP]', '[PAD]']] for s in rows])
blocked = ids.eq(index['[PAD]'])
corrupted = ids.clone()
corrupted[:, 2] = index['[MASK]']
labels = torch.full_like(ids, -100)
labels[:, 2] = ids[:, 2]

class TinyEncoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.word = nn.Embedding(len(vocab), 16)
        self.position = nn.Embedding(6, 16)
        self.segment = nn.Embedding(2, 16)
        self.embed_norm = nn.LayerNorm(16)
        self.layer = nn.TransformerEncoderLayer(
            16, 2, 32, dropout=0.0, activation='gelu', batch_first=True)
        self.mlm = nn.Linear(16, len(vocab))
        self.pool = nn.Sequential(nn.Linear(16, 16), nn.Tanh())
        self.classifier = nn.Linear(16, 3)
        self.tagger = nn.Linear(16, 3)
        self.span = nn.Linear(16, 2)
    def forward(self, tokens, padding):
        positions = torch.arange(tokens.shape[1])
        segments = torch.zeros_like(tokens)  # single segment here
        h = self.embed_norm(self.word(tokens) + self.position(positions)
                            + self.segment(segments))
        return self.layer(h, src_key_padding_mask=padding)

model = TinyEncoder()
optimizer = torch.optim.AdamW(model.parameters(), lr=0.01)
def objective():
    logits = model.mlm(model(corrupted, blocked))
    return F.cross_entropy(logits.reshape(-1, len(vocab)), labels.reshape(-1))
initial = objective().item()
for _ in range(100):
    optimizer.zero_grad()
    loss = objective()
    loss.backward()
    optimizer.step()
model.eval()
with torch.no_grad():
    final = objective().item()
    h = model(ids, blocked)
    changed = ids.clone()
    changed[0, 3] = index['measures']
    context_gap = (model(changed, blocked)[0, 2] - h[0, 2]).abs().max().item()
    changed_padding = ids.clone()
    changed_padding[blocked] = index['robot']
    pad_gap = (model(changed_padding, blocked)[~blocked] - h[~blocked]).abs().max().item()
    shapes = [model.classifier(model.pool(h[:, 0])).shape,
              model.tagger(h).shape, model.span(h).shape]
assert final < initial and context_gap > 1e-4 and pad_gap < 1e-6
print('masked loss:', round(initial, 3), '->', round(final, 3))
print('context changes representation:', context_gap > 1e-4)
print('padding leaves real tokens unchanged:', pad_gap < 1e-6)
print('class / tag / span shapes:', [tuple(s) for s in shapes])
輸出:
程式碼 · 4 行
masked loss: 2.223 -> 0.001
context changes representation: True
padding leaves real tokens unchanged: True
class / tag / span shapes: [(4, 3), (4, 6, 3), (4, 6, 2)]
遮罩損失由 2.223 降到 0.001,量測的是對這四個範例的擬合。改變 robot 之後的詞會改變它的最終表示;改變被阻擋填補位置所儲存的值,則不影響真實詞元的輸出。因果模型必須排除前一種未來影響(NLP 09 的擾動測試),雙向編碼器則刻意允許它。
任務頭印出的形狀為 (4, 3)、(4, 6, 3) 與 (4, 6, 2):四個序列各對三個類別做決策、每個範例有六個詞元決策,以及每個詞元的兩個邊界分數。這些任務頭尚未訓練。 本例只有編碼器與 MLM 頭收到梯度。要建立應用,必須提供任務標籤、最佳化相應任務頭與編碼器,再評估保留資料上的任務輸出,NLP 11 會這樣做。
兩種遮罩需要分清楚。編碼器的填補遮罩決定哪些鍵可讀取;-100 標籤告訴交叉熵忽略哪些位置,不會把那些位置移出注意力。在這個示範中,所有真實詞都能提供上下文,但只有被選名詞貢獻 MLM 損失。
7. 從零預訓練一個小型 BERT
直觀說法。 現在把真正的損壞配方套到一個小型人造語言上,訓練幾秒鐘,然後檢查三件事:模型填補保留句空格的能力、同一個詞在不同上下文是否得到不同向量,以及簡單分類器能從每一層讀出什麼。
玩具語料由一個小文法產生。主詞限制動詞、動詞限制受詞,所以被遮罩的詞常常可以由兩側推出。crane 刻意設計成有歧義:它可以 lift(機器,起重機),也可以 eat(鳥,鶴)。128 個可能句子中保留 40 個。損壞函數精確實作第 5 節:選取 15%,再依 80/10/10 替換,每一步重新抽取。
程式碼 · Python · 137 行
import itertools, random
from collections import Counter
import numpy as np
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score

random.seed(0); torch.manual_seed(0); torch.set_num_threads(1)

# 1. A toy corpus: the subject constrains the verb, the verb constrains the object.
frames = {'robot': ['lifts', 'moves'], 'crane': ['lifts', 'eats'],
          'technician': ['repairs', 'moves'], 'heron': ['eats', 'sees']}
objects = {'lifts': ['steel', 'box'], 'moves': ['box', 'cart'],
           'eats': ['fish', 'bread'], 'repairs': ['pump', 'cart'], 'sees': ['fish', 'boat']}
sentences = [f'{d1} {a}{s} {v} {d2} {o}'.split()
             for s in frames for v in frames[s] for o in objects[v]
             for d1, d2, a in itertools.product(['the', 'a'], ['the', 'a'], ['', 'old '])]
random.shuffle(sentences)
test, train = sentences[:40], sentences[40:]
special = ['[PAD]', '[CLS]', '[SEP]', '[MASK]']
words = sorted({w for s in sentences for w in s})
vocab = special + words
index = {w: i for i, w in enumerate(vocab)}
first_word = len(special)
L = 2 + max(len(s) for s in sentences)

def encode(rows):
    ids = torch.zeros(len(rows), L, dtype=torch.long)
    for r, s in enumerate(rows):
        seq = [index['[CLS]']] + [index[w] for w in s] + [index['[SEP]']]
        ids[r, :len(seq)] = torch.tensor(seq)
    return ids
train_ids, test_ids = encode(train), encode(test)

# 2. BERT-style corruption: select 15% of real word positions; of those,
#    80% -> [MASK], 10% -> random word, 10% -> unchanged. All selected are targets.
def corrupt(ids, generator):
    real = ids >= first_word
    selected = (torch.rand(ids.shape, generator=generator) < 0.15) & real
    labels = torch.where(selected, ids, torch.full_like(ids, -100))
    u = torch.rand(ids.shape, generator=generator)
    out = ids.clone()
    out[selected & (u < 0.8)] = index['[MASK]']
    swap = selected & (u >= 0.8) & (u < 0.9)
    out[swap] = torch.randint(first_word, len(vocab), (int(swap.sum()),), generator=generator)
    return out, labels

class TinyBERT(nn.Module):
    def __init__(self, d=32, layers=2):
        super().__init__()
        self.word, self.position = nn.Embedding(len(vocab), d), nn.Embedding(L, d)
        self.segment, self.norm = nn.Embedding(2, d), nn.LayerNorm(d)
        self.blocks = nn.ModuleList(nn.TransformerEncoderLayer(
            d, 4, 4 * d, dropout=0.0, activation='gelu', batch_first=True)
            for _ in range(layers))
        self.mlm = nn.Linear(d, len(vocab))
    def forward(self, ids):
        pad = ids.eq(index['[PAD]'])
        h = self.norm(self.word(ids) + self.position(torch.arange(ids.shape[1]))
                      + self.segment(torch.zeros_like(ids)))
        states = [h]
        for block in self.blocks:
            h = block(h, src_key_padding_mask=pad)
            states.append(h)
        return states                               # embeddings, layer 1, layer 2

model = TinyBERT()
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-3)
g = torch.Generator().manual_seed(1)
for step in range(600):                             # a fresh mask every step
    inputs, labels = corrupt(train_ids, g)
    logits = model.mlm(model(inputs)[-1])
    loss = F.cross_entropy(logits.reshape(-1, len(vocab)), labels.reshape(-1))
    optimizer.zero_grad(); loss.backward(); optimizer.step()
model.eval()

# 3. Held-out masked-word accuracy: mask each word position in turn.
def masked_hits(ids, rows_text):
    by_kind = {}
    with torch.no_grad():
        for r, s in enumerate(rows_text):
            for i, w in enumerate(s):
                x = ids[r:r + 1].clone(); x[0, i + 1] = index['[MASK]']
                guess = vocab[model.mlm(model(x)[-1][0, i + 1]).argmax()]
                kind = 'determiner/adjective' if w in ('the', 'a', 'old') else 'noun/verb'
                by_kind.setdefault(kind, []).append(guess == w)
    return {k: round(float(np.mean(v)), 3) for k, v in sorted(by_kind.items())}
counts = torch.bincount(train_ids[train_ids >= first_word], minlength=len(vocab))
real_test = test_ids[test_ids >= first_word]
print('final training MLM loss:', round(loss.item(), 3))
print('held-out masked accuracy:', masked_hits(test_ids, test))
print('most-frequent-word baseline:', vocab[int(counts.argmax())],
      round((real_test == counts.argmax()).float().mean().item(), 3))
# Upper reference: the best guess given every other word, read off the grammar.
def oracle(text):
    by_kind = {}
    for s in text:
        for i, w in enumerate(s):
            fits = Counter(t[i] for t in sentences if len(t) == len(s)
                           and all(a == b for j, (a, b) in enumerate(zip(t, s)) if j != i))
            kind = 'determiner/adjective' if w in ('the', 'a', 'old') else 'noun/verb'
            by_kind.setdefault(kind, []).append(fits[w] / sum(fits.values()))
    return {k: round(float(np.mean(v)), 3) for k, v in sorted(by_kind.items())}
print('expected accuracy of an ideal guesser:', oracle(test))

# 4. One word, two contexts: identical input row, different output rows.
with torch.no_grad():
    pair = encode([['the', 'crane', 'lifts', 'the', 'steel'],
                   ['the', 'crane', 'eats', 'the', 'fish']])
    cos = [F.cosine_similarity(s[0, 2], s[1, 2], dim=0).item() for s in model(pair)]
print('cosine of the two "crane" vectors by layer:', [round(c, 3) for c in cos])

# 5. Probes. (a) Part of speech vs a control task that gives each word type a
#    random label; (b) the sense of "crane" (machine vs bird) from its own vector.
pos = {w: 'DET' if w in ('the', 'a') else 'ADJ' if w == 'old' else
       'VERB' if w in objects else 'NOUN' for w in words}
control = {w: random.randint(0, 3) for w in words}
crane = [s for s in sentences if 'crane' in s]
crane_ids = encode(crane)
sense = np.array([int('eats' in s) for s in crane])
def rows(ids, text, layer):
    with torch.no_grad():
        h = model(ids)[layer]
    return np.array([h[r, i + 1].numpy() for r, s in enumerate(text) for i in range(len(s))])
for layer in range(3):
    Xtr, Xte = rows(train_ids, train, layer), rows(test_ids, test, layer)
    acc = []
    for table in (pos, control):
        ytr = [table[w] for s in train for w in s]; yte = [table[w] for s in test for w in s]
        acc.append(LogisticRegression(max_iter=3000).fit(Xtr, ytr).score(Xte, yte))
    h = model(crane_ids)[layer].detach()[:, :, :]
    Xc = np.array([h[r, s.index('crane') + 1].numpy() for r, s in enumerate(crane)])
    acc.append(cross_val_score(LogisticRegression(max_iter=3000), Xc, sense, cv=4).mean())
    print(f'layer {layer}: POS {acc[0]:.2f}  control {acc[1]:.2f}  crane sense {acc[2]:.2f}')
assert cos[0] > 0.999 and cos[-1] < cos[0]
輸出(單一 CPU 執行緒約六秒):
程式碼 · 8 行
final training MLM loss: 0.453
held-out masked accuracy: {'determiner/adjective': 0.418, 'noun/verb': 0.492}
most-frequent-word baseline: the 0.17
expected accuracy of an ideal guesser: {'determiner/adjective': 0.592, 'noun/verb': 0.633}
cosine of the two "crane" vectors by layer: [1.0, 0.819, 0.639]
layer 0: POS 1.00  control 1.00  crane sense 0.38
layer 1: POS 1.00  control 1.00  crane sense 1.00
layer 2: POS 1.00  control 1.00  crane sense 1.00
把遮罩詞的數字和兩個參考比較。永遠猜最常見的詞 the,有 17% 的機會正確。一個完全知道文法的理想猜測者,也就是知道每個空格在給定其他所有詞時的真實分布,在內容詞上也只會答對 63%,而不是 100%:在 the robot ___ the box 之後,lifts 和 moves 都合文法。模型只看 88 個訓練句,就在內容詞上達到 49%。這個差距才是它學到與沒學到多少的誠實量測。許多空格沒有唯一答案,這也是 MLM 準確率從來不是理解能力直接量測的原因。
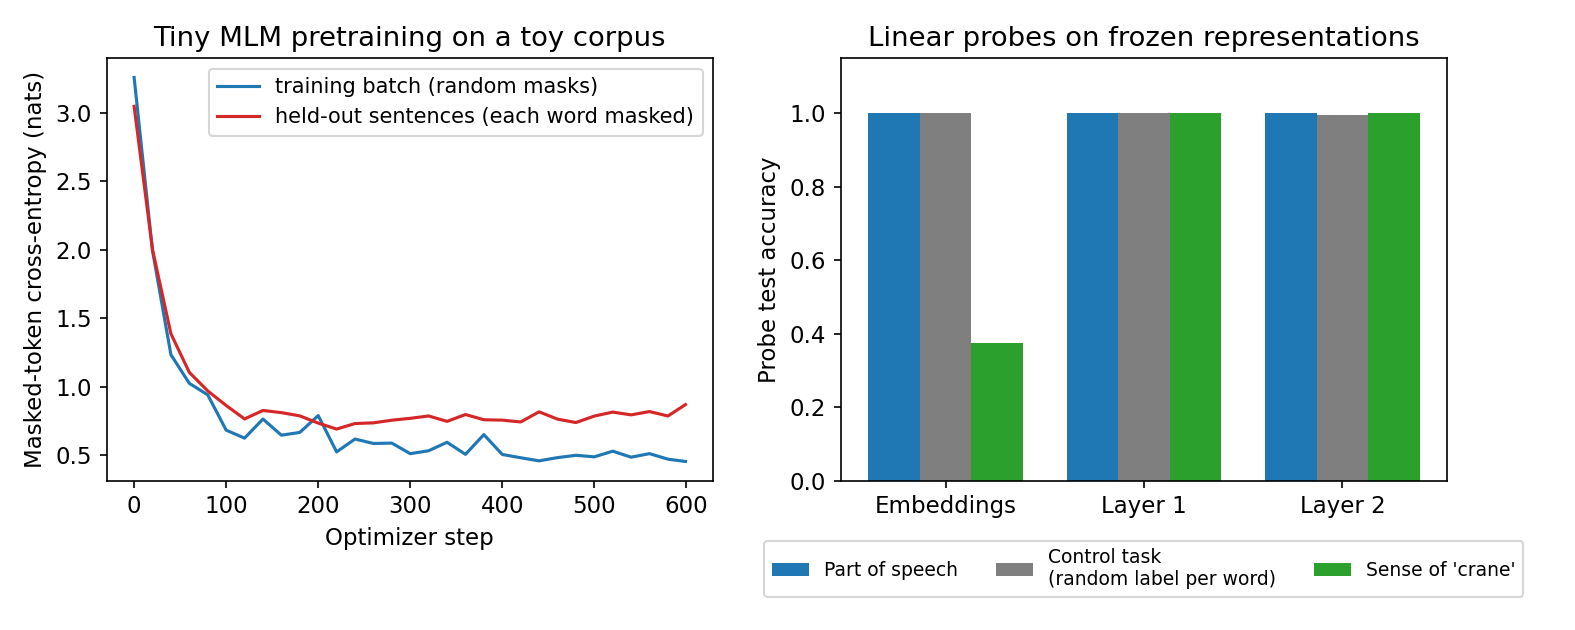
圖 3 左側顯示,訓練損失持續下降時,保留損失先趨平、再慢慢上升。同一個程式訓練更多步會讓訓練損失更低,保留資料的遮罩準確率卻變差,所以 600 步的預算是看保留損失決定的,而不是看訓練損失。這是一般的模型選擇,對預訓練與微調同樣適用。
8. 上下文嵌入與靜態嵌入
直觀說法。 靜態嵌入讓一個詞在任何地方都只有一個向量。上下文編碼器替每次出現各給一個向量,而且差異隨深度增加。
NLP 04 建立的 Word2Vec 或 PPMI 向量是表格中的一列:鳥和機器共用同一個 crane 向量,它必須平均兩種上下文。上面印出的餘弦值以極小規模呈現上下文式的替代方案。在嵌入層,兩個 crane 向量完全相同(餘弦 1.0),因為詞元和位置都相同。經過一個編碼器區塊後餘弦為 0.819,兩個區塊後為 0.639:右側上下文 lifts the steel 或 eats the fish 已被混入。
Ethayarajh 在真實模型中量測了這個效應。在 ELMo、BERT 與 GPT-2 中,同一個詞在不同上下文的表示,仍比兩個不同詞的表示更相似,但這種自我相似度在上層低很多;平均而言,一個詞的上下文表示中,只有不到 5% 的變異能由該詞的靜態嵌入解釋 [19]。同一研究也發現,上下文表示在任何一層都不是各向同性的:向量集中在空間中的狹窄區域 [19]。實務上的後果是,BERT 向量之間的原始餘弦相似度,不會自動成為有意義的語意相似度。句子層級的相似度需要自己的訓練目標,NLP 04 與 NLP 11 會討論。
靜態向量仍有用途:便宜、推論時不需要編碼器,也容易檢查。當同一個表面形式帶有不同意義或角色時,上下文向量較合適,而真實文字大多是這種情況。
9. 探測表示中包含什麼
直觀說法。 探測器(probe)是在凍結表示上訓練、用來預測某種語言性質的小型分類器。若它成功,表示該性質可以從向量中取回。究竟是表示還是探測器完成了工作,則是另一個問題。
Tenney、Das 與 Pavlick 逐層探測 BERT,發現負責詞性標記、剖析、命名實體、語意角色與共指的區域,大致依傳統 NLP 管線的順序出現,後面的層有時會修正前面的決定 [20]。Hewitt 與 Manning 的結構探測器尋找一個線性轉換,使詞向量之間的平方距離編碼剖析樹中的距離;他們在 ELMo 與 BERT 中找到這樣的轉換,在基準中則沒有 [21]。Clark 等人分析的是注意力而非向量,找到專門注意分隔標記、固定位置偏移,以及直接受詞、限定詞與共指提及的注意力頭 [23]。
Hewitt 與 Liang 補上了關鍵的對照。控制任務替每個詞型指派隨機標籤,因此只能靠記住詞的身分解決。好的探測器應該具有選擇性:語言任務準確率高,對應控制任務準確率低 [22]。沒有這個比較,高探測準確率可能只顯示探測器很強,而不是表示編碼了該性質。
我們的小型實驗呈現了兩面。詞性在每一層都可完美取回,但每個詞的隨機標籤也一樣,因為在這個文法中,詞性完全由詞本身決定。探測器的成功因此只說明「這個詞可以被辨認」,選擇性為零。crane 詞義探測則不同。在嵌入層,兩種詞義共用一個向量,準確率在機率水準或更低(0.38,32 個句子、四折);經過一個編碼器區塊後就完美。這個性質需要上下文,所以逐層上升是編碼器把資訊移進 crane 向量的證據。即使如此,探測只顯示資訊對線性讀取器可得,不表示模型在預測時使用了它。
10. BERT 家族
直觀說法。 BERT 之後,好幾篇論文一次改變配方中的一部分:訓練多久、如何共享參數、如何壓縮,以及預測什麼。
| 模型 | 改變了什麼 | 報告的動機 |
|---|---|---|
| RoBERTa [11] | 以更大批次、更多資料訓練更久,移除 NSP,使用更長序列與動態遮罩 | 複製研究發現 BERT 明顯訓練不足 |
| ALBERT [12] | 分解式嵌入參數化、跨層參數共享、句序預測 | 降低記憶體並加速訓練;以連貫性目標取代 NSP |
| DistilBERT [13] | 在預訓練階段把知識蒸餾到較小的學生模型,使用三重損失 | 作者報告小 40%、保留 BERT 97% 的語言理解能力、快 60% |
| ELECTRA [14] | 取代詞元偵測:小型生成器填入被遮罩位置,編碼器判斷每個詞元是原本的還是被替換的 | 從全部輸入詞元學習,而非只從被遮罩的子集 |
ALBERT 的分解式嵌入把詞彙表大小與隱藏大小分開:不用一張 的表,而是一張 的表加上 投影,其中 遠小於 [12]。作者認為 WordPiece 嵌入應學習與上下文無關的表示,隱藏狀態則與上下文有關,所以兩者大小不必相同 [12]。ELECTRA 微調時保留的是判別器;生成器在預訓練後就丟棄 [14]。
這些變體同時改變參數量、計算預算與目標,因此其發表的比較屬於各自的實驗設定。選用時,要檢查它的分詞器、最大長度、訓練目標與訓練資料,並在你在乎的任務上量測。
11. 多語與中文 BERT
直觀說法。 一個編碼器可以用共享詞彙表同時在多種語言上預訓練。中文則需要決定單位,因為中文書寫時詞與詞之間沒有空格。
原始釋出包含一個多語 BERT-Base,在 104 種語言的維基百科上訓練,共用 110k 的 WordPiece 詞彙表,且沒有任何告訴模型目前是哪種語言的標記 [2]。Pires、Schlinger 與 Garrette 發現此模型的零樣本遷移出乎意料地好,也就是用一種語言微調、在另一種語言評估,甚至跨越書寫系統也行;在類型學上相近的語言之間遷移最好;但某些語言對有系統性的缺陷 [15]。XLM-R 之後以遠更多經過過濾的 CommonCrawl 資料,在一百種語言上訓練 Transformer 遮罩語言模型,報告在跨語言基準上大幅優於多語 BERT,對低資源語言尤其明顯 [16]。它對正向遷移與容量稀釋之間取捨的分析提醒我們:在固定大小的模型中加入更多語言並非沒有代價 [16]。
對中文,原始多語模型在 WordPiece 之前,於 CJK 表意文字範圍內的每個字前後加上空格,因此中文實際上以字為單位分詞 [2];第 3 節的 basic_split 函數模仿這個規則。釋出內容也提供只用中文的 BERT-Base,涵蓋簡體與繁體中文 [2]。以字為位置可避免斷詞錯誤,但只遮罩「幫浦」這類多字詞中的一個字,模型可以由同詞的另一個字猜回,而不必依賴句子上下文。Cui 等人替中文 BERT 引入全詞遮罩(whole word masking):以斷詞器找出詞的邊界,被選中詞的所有字一起遮罩,而輸入仍以字為單位分詞 [17]。他們的 MacBERT 模型以詞向量相似度選出的相近詞取代 [MASK],縮小預訓練與微調輸入之間的差距 [17]。
處理台灣的繁體中文文字時,要檢查預訓練語料實際包含什麼,而不只看語言標籤。以簡體中文為主的資料所訓練的模型,可能能正確切分繁體字,卻在地區詞彙(例如「資料」與其他地區的用法)或特定領域的台灣術語上較弱。這是要用領域內例子量測的資料問題,不是架構能決定的。
現代觀點
Rogers、Kovaleva 與 Rumshisky 的入門綜述 [24] 回顧了超過 150 篇關於 BERT 的研究:它捕捉了哪些語言與世界知識、存在何處,注意力頭與各層如何運作,對訓練目標與架構的修改,過度參數化與壓縮。其整體訊息與第 9 節一致:許多性質可以被取回,但可取回不等於被使用,探測結果也取決於探測器。
在大型僅解碼器模型的時代,編碼器並沒有消失。ModernBERT [25] 發表於 ACL 2025,是 2024 年的僅編碼器模型,把近年的架構與效率最佳化帶進 BERT 設計;作者把編碼器描述為許多正式檢索與分類管線的主力,並報告以 2 兆個詞元訓練、原生序列長度為 8,192。Zhao 等人的綜述 [26] 把遮罩編碼器放在預訓練語言模型的更廣歷史中,並指出因果解碼器已被既有大型語言模型廣泛採用為架構;NLP 09 說明了為何單一因果目標就能同時用於評分與生成。
2026 年的實務總結:當整個輸入都可取得、輸出是標籤、區段或檢索用向量,而且延遲與成本重要時,使用雙向編碼器;輸出是開放式文字時,使用僅解碼器模型。開放問題包括超越探測的忠實解釋、低資源語言與書寫系統的穩健多語涵蓋、超出學得位置上限的長文件編碼,以及評估任務結果中有多少來自預訓練表示、而非微調資料。
重點整理
- BERT 是不用標籤預訓練、再以小型任務頭微調的 Transformer 編碼器;預訓練提供表示,不提供任務標籤。
- 輸入是打包成
[CLS] A [SEP] B [SEP]的 WordPiece 片段,加上相加的詞元、段落與學得位置嵌入;段落不阻擋注意力。 - MLM 選取 15% 位置並依 80/10/10 替換;每個被選位置都是目標,遮罩分數也不是因果困惑度。
- NSP 後來被發現並非必要(RoBERTa),或被句序預測取代(ALBERT)。
- 從零預訓練的小型 BERT 呈現了這些機制:保留句空格的填補優於頻率基準、但低於文法本身的上限,而歧義詞的向量隨深度分開。
- 上下文向量隨每次出現而不同,靜態向量則不會。上下文向量之間的原始餘弦,不會自動是語意相似度。
- 探測需要控制任務;探測顯示資訊可得,不表示模型使用它。
- 多語與中文 BERT 做了特定的單位選擇(共享 WordPiece、CJK 逐字切分、全詞遮罩),這些選擇影響模型學到什麼。
練習
- 在小型 BERT 中,把動態遮罩換成訓練前只抽一次的靜態遮罩。比較保留資料的遮罩準確率與損失曲線。
提示
把 corrupt(train_ids, g) 移到迴圈外只呼叫一次。靜態遮罩下,每個句子永遠藏同樣的位置,所以許多(句子、位置)目標從未出現。
- 在玩具語料中加入下一句預測:用
[SEP]與段落 ID 組成兩句的文字對,其中一半的第二句是隨機的。再建立句序版本。在你的語料中,哪一個只靠主題線索就能解決?
提示
建立兩份使用不同詞彙的「文件」。隨機第二句通常來自另一份文件,所以 NSP 很容易;同一文件內對調順序則不然。
- 擴充 WordPiece 詞彙表,使
pumpkin不再是[UNK],但不要直接加入pumpkin。再找一個詞,讓貪婪最長匹配的切法與片段數最少的切法不同。
提示
第一部分加入 ##kin 就夠了。第二部分可以放入一個會留下難處理剩餘部分的長前綴,以及一個能乾淨切分的短前綴。
- 在玩具語料上設計一個探測任務,使類似詞性的控制結果會顯示正的選擇性。這個性質必須依賴上下文,而不是詞的身分。
提示
名詞是主詞還是受詞是一個選項,但先檢查在這個文法中,位置本身是否已經洩漏答案。若是,就加入打破這種關聯的句子變體。
- 把 MLM 頭換成 ELECTRA 式的取代詞元偵測器:以隨機詞而非
[MASK]損壞位置,並在每個位置訓練二元分類器。比較每個批次中有多少位置產生損失。
提示
ELECTRA 使用小型的已訓練生成器;隨機替換讓偵測容易得多,所以要說明你的簡化改變了什麼。比較有遮罩與沒有遮罩時的已標註位置數。
- 把雙向範例改成詞元分類器。若一個已標註詞拆成三個片段,定義哪些位置貢獻損失,以及如何重建詞標籤。
提示
選擇只監督第一片段,或明確定義所有片段的標籤映射。忽略填補與特殊標記、訓練標記頭,再把輸出映射回原文。
參考文獻
- Jacob Devlin, Ming-Wei Chang, Kenton Lee and Kristina Toutanova, “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,” NAACL, 2019. Paper
- Google Research, BERT: original implementation and released models, software, 2018. Encoder and pooler · Tokenizer · Multilingual and Chinese models
- Ashish Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. Paper
- Alec Radford, Karthik Narasimhan, Tim Salimans and Ilya Sutskever, “Improving Language Understanding by Generative Pre-Training,” OpenAI technical report, 2018. Paper
- Matthew E. Peters, Mark Neumann, Mohit Iyyer, Matt Gardner, Christopher Clark, Kenton Lee and Luke Zettlemoyer, “Deep Contextualized Word Representations,” NAACL, 2018. Paper
- Tomas Mikolov, Kai Chen, Greg Corrado and Jeffrey Dean, “Efficient Estimation of Word Representations in Vector Space,” ICLR Workshop, 2013. Paper
- Yonghui Wu et al., “Google’s Neural Machine Translation System: Bridging the Gap between Human and Machine Translation,” arXiv:1609.08144, 2016. Paper
- Dan Hendrycks and Kevin Gimpel, “Gaussian Error Linear Units (GELUs),” arXiv:1606.08415, 2016, revised 2023. Paper
- Jimmy Lei Ba, Jamie Ryan Kiros and Geoffrey E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. Paper
- Ilya Loshchilov and Frank Hutter, “Decoupled Weight Decay Regularization,” ICLR, 2019. Paper
- Yinhan Liu et al., “RoBERTa: A Robustly Optimized BERT Pretraining Approach,” arXiv:1907.11692, 2019. Paper
- Zhenzhong Lan, Mingda Chen, Sebastian Goodman, Kevin Gimpel, Piyush Sharma and Radu Soricut, “ALBERT: A Lite BERT for Self-supervised Learning of Language Representations,” ICLR, 2020. Paper
- Victor Sanh, Lysandre Debut, Julien Chaumond and Thomas Wolf, “DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter,” 5th Workshop on Energy Efficient Machine Learning and Cognitive Computing at NeurIPS, 2019. Paper
- Kevin Clark, Minh-Thang Luong, Quoc V. Le and Christopher D. Manning, “ELECTRA: Pre-training Text Encoders as Discriminators Rather Than Generators,” ICLR, 2020. Paper
- Telmo Pires, Eva Schlinger and Dan Garrette, “How Multilingual is Multilingual BERT?,” ACL, 2019. Paper
- Alexis Conneau et al., “Unsupervised Cross-lingual Representation Learning at Scale,” ACL, 2020. Paper
- Yiming Cui, Wanxiang Che, Ting Liu, Bing Qin and Ziqing Yang, “Pre-Training With Whole Word Masking for Chinese BERT,” IEEE/ACM Transactions on Audio, Speech, and Language Processing 29, 2021. Publisher · Author manuscript
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapter 9, Manning, 2021. Publisher
- Kawin Ethayarajh, “How Contextual are Contextualized Word Representations? Comparing the Geometry of BERT, ELMo, and GPT-2 Embeddings,” EMNLP-IJCNLP, 2019. Paper
- Ian Tenney, Dipanjan Das and Ellie Pavlick, “BERT Rediscovers the Classical NLP Pipeline,” ACL, 2019. Paper
- John Hewitt and Christopher D. Manning, “A Structural Probe for Finding Syntax in Word Representations,” NAACL, 2019. Paper
- John Hewitt and Percy Liang, “Designing and Interpreting Probes with Control Tasks,” EMNLP-IJCNLP, 2019. Paper
- Kevin Clark, Urvashi Khandelwal, Omer Levy and Christopher D. Manning, “What Does BERT Look at? An Analysis of BERT’s Attention,” BlackboxNLP Workshop, 2019. Paper
- Anna Rogers, Olga Kovaleva and Anna Rumshisky, “A Primer in BERTology: What We Know About How BERT Works,” Transactions of the Association for Computational Linguistics 8, 2020. Paper
- Benjamin Warner et al., “Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference,” ACL, 2025. Paper
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” Frontiers of Computer Science, 2026. Updated survey
- Colin Raffel, Noam Shazeer, Adam Roberts, Katherine Lee, Sharan Narang, Michael Matena, Yanqi Zhou, Wei Li and Peter J. Liu, “Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer,” JMLR 21(140), 2020. Paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 11・以 BERT 做分類(情感分析、自然語言推論) · 27 分鐘