NLP 09・以 Transformer 做語言模型(自然語言生成)
先備知識:NLP 08・以 Transformer 建構序列到序列模型(機器翻譯、聊天機器人)
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 2 個互動實驗
追蹤固定 logits 經過溫度縮放、top-k 截斷、核心截斷與重新正規化的結果。
你將學到
- 把序列機率分解成因果的下一詞元預測,並訓練一個遵守這個分解的小型僅解碼器(decoder-only)Transformer。
- 把 GPT 系列模型、它們的訓練目標與規模化研究放進同一張一致的圖。
- 用貪婪搜尋、束搜尋(beam search)、溫度、top-k 與核取樣(nucleus sampling)解碼,並說明各自改變與不改變什麼。
- 建立並評估三種生成任務:擷取式與抽象式摘要、資料到文字(data-to-text),以及開放式故事寫作。
- 以困惑度、ROUGE、人工覆核與模型評審量測生成品質,並了解各自的盲點。
- 以詞彙與稠密方法檢索證據,並用 Recall@k、MRR 與 nDCG 評估排序。
- 解釋幻覺(hallucination)、檢索增強生成,以及檢索證據與應用指令之間的界線。
先看全貌
語言模型依指定上下文替文字配置機率。這個簡單定義連結拼字補全、句子生成與可重用的上下文表示,但各種用途並沒有相同輸出契約。預測可能的延續與驗證事實回答是不同工作。流暢延續可能反映常見文字模式,卻不適合某個特定任務。
語言應用也必須選擇說什麼、清楚表達,並支持說出的內容,這是不同責任。可讀句子可能描述錯事件,正確句子也可能漏掉使用者需要的警告。部署再增加一項責任:結果必須可預期地抵達,並留下足夠上下文讓人追查失敗。
Hagiwara 第 5 章討論語言模型,第 8 章介紹注意力與 Transformer,第 9 章說明預訓練模型調適,第 10–11 章談訓練實務與部署 [1]。McRoy 第 6 章透過任務強調語言模型評估,第 9 章討論生成與摘要 [2]。本章把機率模型連到這些實際問題,只訓練微小合成模型;大型預訓練系統則透過已驗證的原始論文與綜述討論。
三個決策組織這個主題:訓練目標決定預測什麼;注意力模式決定哪些輸入位置可見;解碼程序決定預測如何變成使用者輸出。比較模型時要分開。改變取樣溫度會改變輸出分布,不會改變已學到哪些事實,也不會驗證產生的主張。
本章的位置:以計數為基礎的 n-gram 語言模型、平滑與最早的困惑度計算在 NLP 05;注意力、位置與 Transformer 區塊在 NLP 07;編碼器—解碼器翻譯與對話在 NLP 08。這裡把 Transformer 當成僅解碼器語言模型與文字生成器使用。雙向的替代方案 BERT 在 NLP 10。
1. 因果序列機率
直觀說法。 依前面的詞元逐一預測,就能建立序列機率。訓練時雖然看得到完整序列,每次預測仍必須遵守可見性規則。
由機率鏈式法則:
其中 是位置 的詞元; 是序列長度; 是 之前的前綴; 是模型參數。起始詞元可提供第一個普通詞元的明確上下文,結束詞元則讓模型替停止配置機率。鏈式法則是精確等式,學得的條件分布則近似資料生成過程。
對含有 個受監督詞元位置的語料,平均負對數概似為:
其中 是訓練目標; 遍歷所有範例的有效預測位置; 是目標詞元; 是允許使用的前綴; 不包含填補位置及其他刻意不監督的位置。自然對數使損失單位為每詞元的 nat。若批次平均把填補也計入,就改變了目標,可能獎勵模型預測人造填補符號。
NLP 05 的 n-gram 模型以最後 個詞元取代 ,因此結尾相同的兩個前綴必須得到相同預測。Transformer 語言模型則保留整個允許的前綴(直到上下文上限),由學得的注意力決定哪些較早詞元重要。分解方式相同,改變的是條件機率能讀取多少前綴。
教師強制(teacher forcing)在訓練時使用觀察到的前綴預測每個詞元。架構若強制因果遮罩,就能平行評估所有位置。生成時,前綴改為先前生成的詞元,錯誤可能影響後續預測。因此,即使權重相同,訓練目標與逐步生成行為仍需要不同診斷。
輸入與目標要錯開一個位置。完整序列若是起始、the、robot、moves、結束,模型輸入就是起始、the、robot、moves,目標則是 the、robot、moves、結束。若直接由未位移表示預測輸入詞元本身,就建立了與下一詞元預測無關的捷徑。第 3 節的程式明確寫出位移。
教師強制損失為何會漏掉部分生成錯誤?
教師強制提供正確前綴,即使模型自己會產生另一個前綴 [16]。假設參考從 Pump A 開始,生成卻選了 Pump B。後續詞元仍可能構成完全流暢的 Pump B 陳述。教師強制損失卻始終在 Pump A 後評估那些位置,沒有測試如何從這次生成錯誤恢復。差別在於:給定歷史下的預測,以及模型自己持續建立歷史時的行為。
詞元平均也隱藏不同語意後果。替換 the 可能只影響風格;替換 not、裝置 ID 或單位,卻能反轉結果。每個詞元貢獻一項對數損失,應用對這些變化的成本可能差很多。如果常見用詞改善,稀少關鍵差異卻惡化,平均損失下降仍可能伴隨更多重要欄位錯誤。因此,除了平均訓練目標,也要檢查完整輸出的命題。
2. 僅解碼器的 Transformer 語言模型
直觀說法。 僅解碼器 Transformer 是一疊自注意力區塊,每個位置只能讀取自己和更早的位置。用下一詞元預測訓練後,它既能替文字評分,也能產生文字。
每個區塊先計算遮罩自注意力,再接逐位置前饋網路,並使用殘差連接與正規化,與原始 Transformer 相同 [3];NLP 07 推導注意力公式。與雙向編碼器唯一的差別,是注意力 softmax 內的加法遮罩 :當 時 ,否則 。其中 是發出查詢的位置, 是它可讀取的鍵位置。目標已位移,所以目前輸入位置仍是允許的前綴詞元,對角線可見。
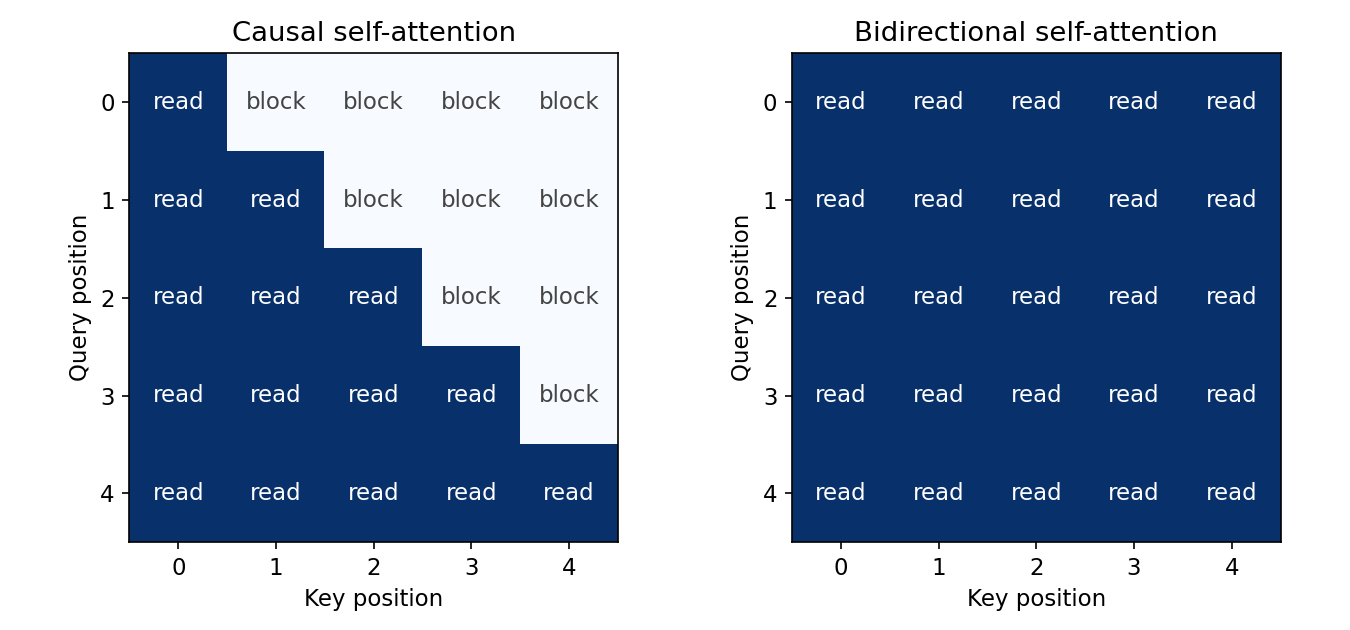
最後一個線性層把位置 的頂層向量映成詞彙 logits ,softmax 再把它轉成 。因為遮罩的每一列都藏住未來,一次前向傳遞就能同時計算所有位置的訓練損失;生成時仍然每次只產生一個詞元。
GPT 系列
GPT 論文顯示這個單一設計能推到多遠。Radford 等人在 BooksCorpus 上,以遮罩自注意力訓練一個 12 層僅解碼器 Transformer 語言模型,再加上任務專用輸出層,針對分類、蘊涵與相似度等任務微調 [4]。配方是生成式預訓練加判別式微調:無標籤文字提供大部分學習訊號,少量標註資料再調適模型。
GPT-2 保留下一詞元目標,主要實驗則不再做任務專用微調。作者以新的網頁資料集 WebText 訓練,使用位元組層級的位元組對編碼(byte-pair encoding)讓任何字串都能表示,並報告語言模型開始能在零樣本(zero-shot)設定下執行問答與摘要等任務;最大模型有 15 億個參數 [5]。GPT-3 把同一方法擴大成 1,750 億參數的自迴歸模型,評估時只以文字給出任務說明與少數示範,不做梯度更新 [6]。這是同一條線上的三個點:架構與目標幾乎沒變,改變的是資料、模型大小,以及呈現任務的方式。
正確理解這條線,對後面各節很重要。提示(prompt)就是一個前綴 。「零樣本」與「少樣本」描述的是前綴內容,不是另一種模型。延續的品質仍取決於訓練文字讓什麼變得可能,這也是後來要再加上指令微調、偏好學習與檢索(第 9–11 節)的原因。
3. 可執行的因果模型
直觀說法。 小模型可以學會合成語言模式,卻對沒見過的組合泛化很差。我們還測試低損失不能證明的性質:未來詞元不得影響較早預測。
以下獨立 CPU 範例使用自訂等長句子。訓練與測試句不同,但每個普通詞彙都曾出現在訓練中。程式沒有填補、預訓練權重或資料下載,刻意作為機制實驗而非語言基準。
實作使用 AdamW 最佳化 [9]、前饋區塊中的 GELU 活化函數 [10],以及注意力和前饋轉換之前的層正規化(layer normalization)[11]。這些選擇定義小型實驗,不是重現原 Transformer 的所有細節。研究因果遮罩時保持它們固定,避免最佳化或活化函數的改變干擾比較。
程式碼 · Python · 62 行
import math
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(11)
torch.set_num_threads(1)
train_text = [
    'the red robot moves', 'the blue robot waits',
    'a red sensor waits', 'a blue sensor moves',
    'the red sensor moves', 'a blue robot waits',
]
test_text = ['a red robot moves', 'the blue sensor waits']
vocab = ['<bos>', '<eos>'] + sorted(set(' '.join(train_text).split()))
index = {word: i for i, word in enumerate(vocab)}
def encode(rows):
    return torch.tensor([[index[w] for w in ['<bos>'] + s.split() + ['<eos>']] for s in rows])
train, test = encode(train_text), encode(test_text)

class TinyCausalModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.token = nn.Embedding(len(vocab), 16)
        self.position = nn.Embedding(5, 16)
        self.norm1, self.norm2 = nn.LayerNorm(16), nn.LayerNorm(16)
        self.q, self.k, self.v = [nn.Linear(16, 16, bias=False) for _ in range(3)]
        self.output = nn.Linear(16, 16)
        self.ff = nn.Sequential(nn.Linear(16, 32), nn.GELU(), nn.Linear(32, 16))
        self.head = nn.Linear(16, len(vocab))
    def forward(self, ids):
        length = ids.shape[1]
        h = self.token(ids) + self.position(torch.arange(length))
        z = self.norm1(h)
        scores = self.q(z) @ self.k(z).transpose(-1, -2) / math.sqrt(16)
        blocked = torch.ones(length, length, dtype=torch.bool).triu(1)
        weights = scores.masked_fill(blocked, float('-inf')).softmax(dim=-1)
        h = h + self.output(weights @ self.v(z))
        h = h + self.ff(self.norm2(h))
        return self.head(h)

model = TinyCausalModel()
optimizer = torch.optim.AdamW(model.parameters(), lr=0.01)
def loss(rows):
    logits = model(rows[:, :-1])
    return F.cross_entropy(logits.reshape(-1, len(vocab)), rows[:, 1:].reshape(-1))
initial = loss(train).item()
for _ in range(180):
    optimizer.zero_grad()
    objective = loss(train)
    objective.backward()
    optimizer.step()
model.eval()
with torch.no_grad():
    train_nll, test_nll = loss(train).item(), loss(test).item()
    original = train[:1, :-1]
    changed = original.clone()
    changed[0, -1] = index['blue']
    gap = (model(original)[:, :-1] - model(changed)[:, :-1]).abs().max().item()
assert train_nll < initial and gap < 1e-6
print('initial/train/test NLL:', *(round(x, 3) for x in [initial, train_nll, test_nll]))
print('held-out perplexity:', round(math.exp(test_nll), 3))
print('future-token perturbation gap:', gap)
輸出:
程式碼 · 3 行
initial/train/test NLL: 2.194 0.409 3.17
held-out perplexity: 23.81
future-token perturbation gap: 0.0
斷言只檢查訓練損失下降,不要求保留損失改善特定幅度。這裡保留損失(每詞元 3.17 nat)甚至高於未訓練時的起始損失(2.194):保留句把熟悉詞語組成訓練未包含的組合,而模型已自信地背下六個訓練模式。大的訓練—測試落差說明,學會觀察到的模式不代表有組合泛化能力。
未來詞元擾動測試改變最後輸入詞元,再比較所有較早位置的 logits。因果注意力應讓這個變動對較早預測不可見,印出的差距正好是零。測試直接對準可見性契約,但通過不代表所有資料隔離都成立:跨切分重複文件、使用禁止的測試資料建詞彙表,或未來中繼資料,都能造成其他洩漏。
模型沒有 dropout,因此本例評估模式不會改變隨機層;仍明確呼叫它,因為真實模型必須區分訓練與評估。損失函數展平批次及位置維度,保留詞彙維度作為類別。若不小心交換這些軸,程式可能照樣執行,卻最佳化錯誤問題。
每個序列等長,位置表也涵蓋五個模型輸入位置。學得的位置表限制支援的最遠位置;超過範圍的序列不是普通長輸入,而是非法索引。擴充成可變長資料,要分別加入注意力與損失遮罩。注意力遮罩控制表示可讀什麼;損失遮罩控制哪些目標對目標函數有貢獻。兩者處理不同問題,需要獨立測試。
4. 訓練目標與規模化
直觀說法。 大型語言模型使用與上面小模型相同的下一詞元損失。改變的是文字量、參數量與投入的計算量,而這三者之間有可量測的取捨。
Kaplan 等人訓練多組 Transformer 語言模型,報告保留損失約隨模型大小、資料量與計算量呈冪律下降 [7]。只看模型大小時:
其中 是保留交叉熵損失, 是不含嵌入的參數數量, 是擬合常數, 是擬合指數。Hoffmann 等人之後擬合含不可消除項的形式 ,其中 是訓練詞元數, 是任何模型都無法移除的損失, 是擬合常數;他們的結論是,固定計算預算時,參數與訓練詞元應以大致相同比例擴大 [8]。ML 10 推導計算最適的取捨,並以程式擬合規模化定律。
有兩個提醒讓規模化保持在正確位置。第一,擬合常數取決於分詞器、資料組成與訓練程序,不能在不相關的設定間轉移。第二,規模化定律預測的是損失,不是特定任務行為。較低的下一詞元損失通常有幫助,但模型在摘要中是否保留否定、是否會編造引用,仍要直接量測(第 8 節)。
5. 困惑度與有意義的比較
直觀說法。 困惑度總結保留詞元預測表現,但數值取決於詞元定義與評估位置。
平均負對數概似為 時:
其中 是困惑度(perplexity); 是自然指數; 對同一組評估位置使用自然對數。較低困惑度表示模型在該評估契約下,對觀察到的詞元配置較高平均機率,不是事實正確、實用性或合語法性的直接指標。IT 01 把這個量連到交叉熵,NLP 05 則替計數模型計算它。
只有分詞與輸入慣例相容時才比較困惑度。一個詞可能在某詞彙表是單一詞元,在另一個表被拆成多個詞元,平均每詞元損失便使用不同單位。還應記錄是否評分起始與結束符號、文件如何分段、上下文長度,以及評估視窗是否重疊。重複計算目標位置會改變權重。
評估文件應與訓練及其衍生文件獨立。把同一文件相鄰段落分到不同集合,可能暴露風格、事實與幾乎相同措辭。具有時間相依性的應用應採適當時間切分,並保留文件版本。單一名稱或短語沒見過,不能證明周圍文件獨立。
McRoy 的基準觀點提醒我們,序列預測之外還要評估任務行為 [2]。分類器需要類別表現,擷取器需要區段與受支持關係,生成器需要意義保留與遺漏評估。困惑度較低的模型仍可能把「沒有移動」改成「移動」而失敗。評估要對準使用者真正的結果。
可重現的語言模型實驗
別人能知道哪些文字、詞元與決策產生結果,結果才有用。先記錄文件切分與理由:獨立合成句子可能適合隨機切分,客服助理則可能需要按客戶或時間隔離。本例詞彙只來自訓練句,測試組合也刻意全部使用已知詞,因而隔離一個狹義的組合泛化問題。
接著記錄分詞、序列邊界、目標位移、最大上下文與損失分母。程式評分每個下一詞元目標,包括結束詞元,但不把起始詞元當目標。若別的實驗排除停止預測,或讓不同長度句子等權,其數字回答的就是不同問題。最後區分選擇與報告:在開發資料上選架構、訓練長度與解碼行為,只在選擇凍結後檢視保留集合。保存前處理版本、模型設定、種子、允許的輸入上下文與輸出設定,敏感原文件則放在適當存取控制下。
6. 解碼:從分布到文字
直觀說法。 訓練模型產生分數;解碼器決定選最強詞元、搜尋數個延續,還是取樣其他選項。這些選擇都不會讓無支持內容變可靠。
溫度
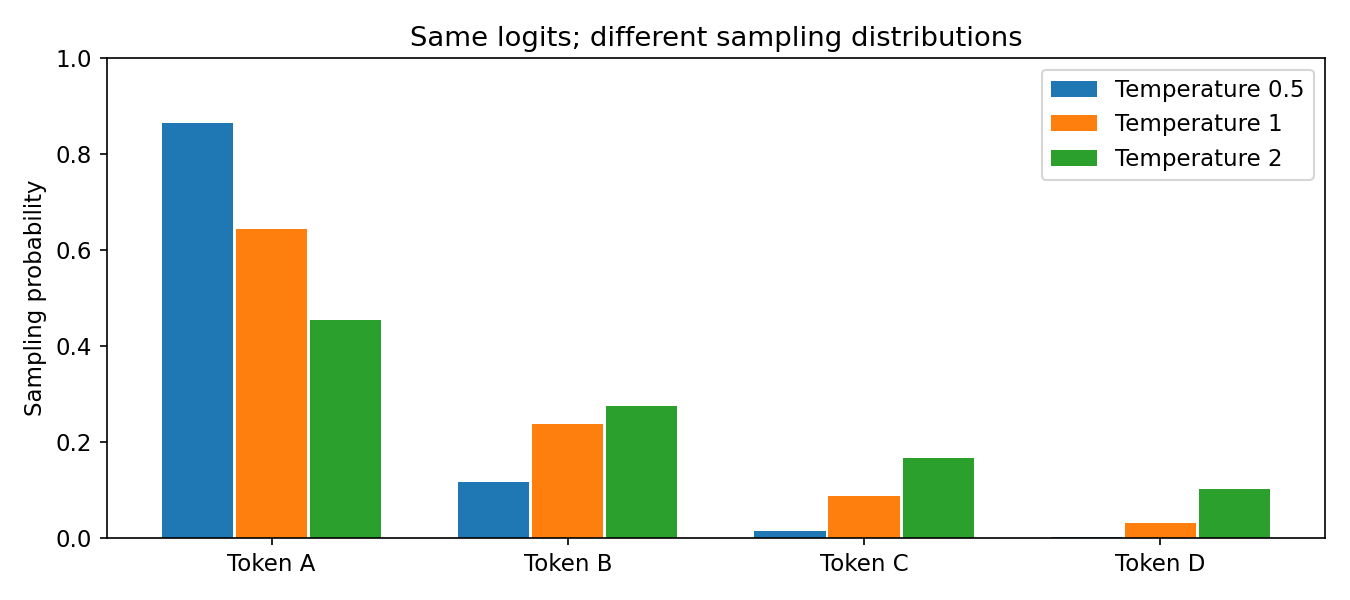
對 logit 與正溫度 :
其中 是候選詞元; 是詞彙表; 遍歷分母候選; 是模型未正規化分數; 是溫度; 是所得取樣分布。低溫集中在高分詞元,高溫則分散機率。當 ,取樣趨近貪婪選擇,也就是直接取最高分詞元。事實錯誤也可能是最高 logit 的選項,因此降低隨機性不會移除它。
貪婪搜尋與束搜尋
貪婪解碼選最高的下一詞元,束搜尋保留數個部分序列。候選序列分數為:
其中 是給定提示或來源 時完整輸出 的對數機率; 包含結束詞元;其他符號同前。原始對數機率中,每個新增詞元都貢獻非正項,因此可能偏好短序列。長度調整會改變搜尋目標,應說明形式並在驗證資料調整,不能默默加入。
以下微型條件模型有兩個競爭的起始詞,展示選最佳下一詞不一定得到最佳完整序列。機率為實驗設定,不由語言資料估計。
程式碼 · Python · 27 行
import math

table = {
    (): {"safe": 0.55, "close": 0.45},
    ("safe",): {"stop": 0.51, "wait": 0.49},
    ("close",): {"valve": 0.99, "door": 0.01},
}
def next_probs(prefix):
    return table.get(prefix, {"<eos>": 1.0})
def decode(width):
    beams = [((), 0.0)]
    for _ in range(3):
        candidates = []
        for seq, score in beams:
            if seq and seq[-1] == "<eos>":
                candidates.append((seq, score))
                continue
            for token, prob in next_probs(seq).items():
                candidates.append((seq + (token,), score + math.log(prob)))
        beams = sorted(candidates, key=lambda pair: pair[1], reverse=True)[:width]
    return beams[0]
greedy, beam = decode(1), decode(2)
print(greedy[0], round(math.exp(greedy[1]), 4))
print(beam[0], round(math.exp(beam[1]), 4))
assert greedy[0] == ("safe", "stop", "<eos>")
assert beam[0] == ("close", "valve", "<eos>")
assert beam[1] > greedy[1]
輸出:
程式碼 · 2 行
('safe', 'stop', '<eos>') 0.2805
('close', 'valve', '<eos>') 0.4455
束搜尋在人工樹中找到較可能的序列。這只說明模型的機率配置。若 close valve 與來源指令矛盾,更好的機率搜尋仍會產生錯誤的應用行為。搜尋品質與任務正確需要分開量測。
搜尋錯誤、模型錯誤與錯誤目標
微型束搜尋之所以成功,是因為保留 close 前綴,直到發現高機率延續。貪婪解碼在看到延續前,就丟掉該分支。相對於人工設定的序列機率目標,這是搜尋錯誤。較寬的束可減少這類錯誤,但仍是有界搜尋;任何深度都可能把實用前綴排除在保留集合之外。
原始前綴對數機率提供實用上界。後續每個對數機率項都非正,因此延伸前綴不會提高原始分數。若完成候選的分數高於所有未完成前綴,它就是保留下來分支中的最佳結果。這個論證要求未調整的總和;長度獎勵或正規化會改變上界,停止規則也必須一起考慮。
接著區分模型錯誤。若來源要求保持閥門開啟,模型卻替 close valve 配最高序列機率,精確機率搜尋只會更穩定地呈現模型錯誤。搜尋不能創造評分中缺少的來源相容性。最後,最大機率只是其中一種決策目標。通用短回答可能機率很高,卻漏掉必需警告。調整束寬之前,先評估目標是否獎勵使用者需要的結果。
top-k 與核取樣
在開放式寫作中,最大化機率常常不是正確目標。Holtzman 等人觀察到,即使模型很強,把概似當解碼目標仍會產生平淡且奇怪地重複的文字;而從完整分布直接取樣,又可能從長尾挑到極不可能的詞元 [12]。兩種截斷規則介於兩個極端之間。
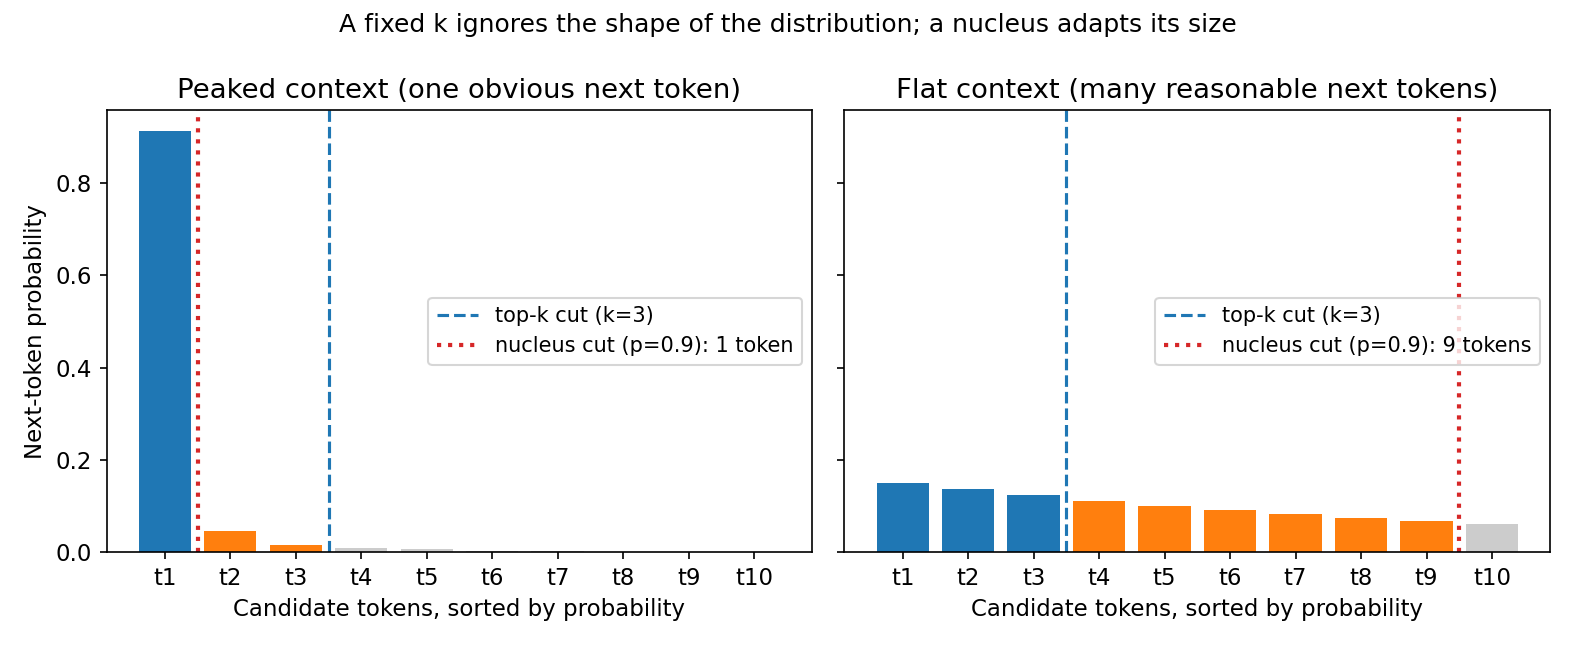
top-k 取樣保留機率最高的 個詞元再重新正規化。Fan 等人在故事生成中使用它,每一步從 10 個最可能的候選中取樣,並發現此任務上它比束搜尋有效 [13]。核取樣(top-p)先依機率由高到低排序,再保留累積機率達到 的最短前綴 [12]:
其中 是排序第 的詞元, 是其機率, 是詞彙表大小, 是保留的前綴長度, 是核(nucleus), 是目標機率質量, 是指示函數, 是重新正規化後的取樣分布。相同機率需固定同分排序規則;程式保留原始索引順序。與 top-k 的差別在於核會自動調整:前綴只有一個明顯延續時,核可能只含一個詞元;前綴很開放時,核可能包含很多詞元。
由高到低取前綴的條件很重要。當機率為 、門檻為 時,top-p 保留前兩個詞元。第一個與最後一個也構成總和達到 的兩元素集合,但它跳過機率更高的候選,並非此處定義的核。下方斷言會檢查這個差別。
程式碼 · Python · 45 行
import numpy as np

tokens = np.array(['valve', 'pump', 'door', 'sensor', 'cabinet', 'label', 'fish', 'moon'])
logits = np.array([3.0, 2.6, 1.2, 1.0, 0.2, -0.5, -1.5, -2.0])

def softmax(z):
    e = np.exp(z - z.max())
    return e / e.sum()

def temperature(z, tau):
    return softmax(z / tau)

def top_k(p, k):
    keep = np.argsort(-p)[:k]                 # indices of the k largest
    q = np.zeros_like(p); q[keep] = p[keep]
    return q / q.sum()

def nucleus(p, top_p):
    if not 0 < top_p <= 1:
        raise ValueError("top_p must be in (0, 1]")
    order = np.argsort(-p, kind="stable")
    cumulative = np.cumsum(p[order])
    size = int(np.searchsorted(cumulative, top_p) + 1)   # smallest prefix reaching top_p
    q = np.zeros_like(p); q[order[:size]] = p[order[:size]]
    return q / q.sum()

p = softmax(logits)
print('greedy choice:', tokens[np.argmax(p)])
for name, q in [('tau=0.5', temperature(logits, 0.5)), ('tau=1.0', p),
                ('tau=2.0', temperature(logits, 2.0)),
                ('top-k=3', top_k(p, 3)), ('top-p=0.9', nucleus(p, 0.9))]:
    print(f'{name:9s} support={int((q > 0).sum())}  P(valve)={q[0]:.3f}  '
          f'tail mass={q[4:].sum():.3f}')

# The nucleus adapts its size to the shape of the distribution.
flat = softmax(np.zeros(8))
peaked = softmax(np.array([6.0, 1, 0, 0, 0, 0, 0, 0]))
print('nucleus size, flat vs peaked:',
      int((nucleus(flat, 0.9) > 0).sum()), int((nucleus(peaked, 0.9) > 0).sum()))

rng = np.random.default_rng(0)
draws = rng.choice(len(tokens), size=2000, p=nucleus(p, 0.9))
assert set(draws) <= set(np.flatnonzero(nucleus(p, 0.9)))
assert np.array_equal(np.flatnonzero(nucleus(np.array([0.4, 0.3, 0.2, 0.1]), 0.5)), [0, 1])
assert np.isclose(top_k(p, 3).sum(), 1) and np.argmax(temperature(logits, 0.1)) == 0
輸出:
程式碼 · 7 行
greedy choice: valve
tau=0.5   support=8  P(valve)=0.667  tail mass=0.003
tau=1.0   support=8  P(valve)=0.481  tail mass=0.052
tau=2.0   support=8  P(valve)=0.312  tail mass=0.190
top-k=3   support=3  P(valve)=0.545  tail mass=0.000
top-p=0.9 support=4  P(valve)=0.507  tail mass=0.000
nucleus size, flat vs peaked: 8 1
這裡的「tail mass」是最不可能的四個詞元所剩的機率。溫度只重塑分布,所以每個詞元都仍可能被選到:在 時,將近五分之一的機率落在 cabinet、label、fish 與 moon。截斷則直接移除長尾。在均勻分布上,核保留全部八個詞元;在尖峰分布上只保留一個。固定的 在兩種情況下都保留三個。
實務上這些設定會組合使用(例如先調溫度再做核取樣),並依任務選擇。資料到文字的報告通常需要確定且可重現的輸出;腦力激盪則需要多樣性。取樣多樣不是品質的證據,重複取樣得到一致結果也不是主張的獨立驗證:它們共享同一模型,也往往共享訓練偏誤。
停止與長度
生成還需要停止政策與長度預算。模型可能太早停止,也可能持續輸出重複內容。要明訂輸出上限、停止規則及達上限後的行為;截斷的摘要不能當完整結果回傳。解碼參數應與模型一起記錄,讓評估可重現;只改解碼器,就可能改變所有下游指標。
7. 自然語言生成任務
直觀說法。 生成是產生內容與形式都符合任務的序列。輸入可以是文件、表格、提示或檢索段落;任務決定什麼算錯誤。
僅解碼器模型用同一種方式處理所有條件任務:把輸入當成前綴。條件分解為:
其中 是來源輸入; 是要求語言或格式等任務脈絡; 是含結束詞元的輸出; 是 前的詞元; 是學得參數。在僅解碼器模型中, 與 被序列化成前綴,損失通常只計算 的詞元;編碼器—解碼器(NLP 08)則另外編碼 。無論哪種,分解只描述分布,不保證取樣輸出獲得來源支持。
選模型前先定義生成問題
先用普通語言寫任務契約。設備報告可寫:「給定附時間戳的觀察,用兩句描述目前溫度及任何明確記錄的故障,保留裝置名稱、單位、數字與否定。」它揭露「好好摘要」這種無限制指令掩蓋的遺漏和矛盾。
分開三種操作。內容選擇選使用者相關觀察;句子規劃決定順序、分組與指代表達;文字實現把計畫寫成合語法文字。McRoy [2] 提供語言學基礎。神經系統可在內部合併這些操作,但仍需分別測試每項責任。
來源若有高溫、稍後正常溫度及明確沒有故障,選最高值與選最新值會產生不同報告。語法流暢不會決定該用哪個規則。要記錄描述目前狀態、極端事件,還是整段軌跡;時間與範圍屬於輸入契約。
資料到文字:模板基準
資料到文字生成把結構化紀錄寫成文字。Wiseman、Shieber 與 Rush 建立一個大型語料,把資料紀錄與描述文件配對,並提出擷取式評估方法,檢查文字實際傳達了哪些紀錄;他們測試的神經系統產生流暢文字,模板基準卻在其中部分指標上勝過它們 [15]。輸入結構狹窄時,模板是有用基準,可完全控制允許的主張,方便定位失敗。限制也清楚:無法自然涵蓋任意關係、指涉或篇章。應量測涵蓋範圍,不要把模板視為天生不足。
下面是狹義結構的確定報告函數,展示欄位驗證與可追溯輸出。事件紀錄是可信的結構輸入;從原文取得並驗證紀錄屬於另一個 NLP 階段。
程式碼 · Python · 26 行
import math

VERSION = "equipment-template-1"
def report(event):
    required = {"device", "temperature_c", "fault", "evidence_id"}
    if set(event) != required:
        raise ValueError("Unexpected input fields")
    if not isinstance(event["device"], str) or not event["device"].strip():
        raise ValueError("Missing device")
    value = event["temperature_c"]
    if isinstance(value, bool) or not isinstance(value, (int, float)) or not math.isfinite(value):
        raise ValueError("Temperature must be finite")
    if event["fault"] not in ("present", "absent", "unknown"):
        raise ValueError("Unknown fault status")
    if not isinstance(event["evidence_id"], str) or not event["evidence_id"]:
        raise ValueError("Missing evidence ID")
    phrases = {"present": "A fault was recorded.",
               "absent": "No fault was recorded.",
               "unknown": "Fault status was not recorded."}
    text = f"{event['device']} measured {value:g} C. {phrases[event['fault']]}"
    return {"text": text, "evidence_id": event["evidence_id"], "version": VERSION}
output = report({"device": "Pump A", "temperature_c": 30,
                 "fault": "absent", "evidence_id": "synthetic-event-01"})
print(output)
assert output["text"] == "Pump A measured 30 C. No fault was recorded."
assert output["version"] == VERSION
輸出:
程式碼 · 1 行
{'text': 'Pump A measured 30 C. No fault was recorded.', 'evidence_id': 'synthetic-event-01', 'version': 'equipment-template-1'}注意 absent 與 unknown 的差別。「沒有記錄到故障」描述的是紀錄證據,不表示故障不可能。編碼這個差別,能防止文字實現階段把缺少證據升格為確定。學得生成器要在新增彈性解決了此基準已記錄的失敗時才有價值,而且應該用這些區別來測試它。
擷取式摘要:在預算內選證據
擷取式摘要選來源句子,抽象式摘要可改寫或融合句子。擷取讓每句的來源清楚,但所選句子仍可能因缺上下文、時間衝突或未解代名詞而誤導。選了「它故障了」卻沒有先行詞,即使每個字都出自來源,仍是篇章錯誤。
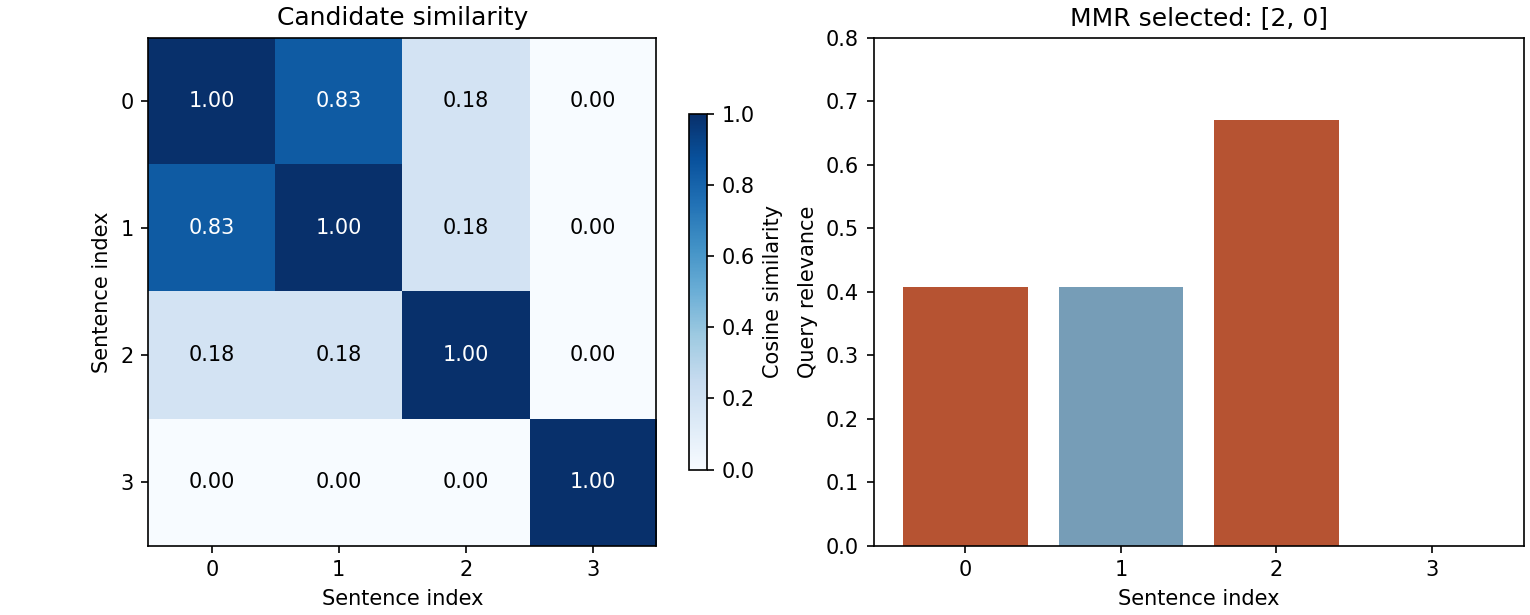
假設文件有候選句 ,句 用單位向量 表示,使用者查詢用單位向量 表示。簡單相關分數是 。為避免重複,可用最大邊際相關性(maximal marginal relevance,MMR)[14]:
其中 是已選句索引集合; 是下一個索引; 平衡相關性與已選句的相似度; 為空時,最大相似度定義為零。向量長度為一,所以內積是餘弦相似度。這是貪婪選擇規則,不是摘要品質全域最佳的證明。
以下用二元詞指示讓每個決策都可檢查,四句皆為合成。移除少數功能詞能降低語法的支配程度,卻也可能移除有用的區別。
程式碼 · Python · 30 行
import re
import numpy as np

sentences = [
    "Pump A temperature reached 80 C during the test.",
    "The test recorded Pump A temperature at 80 C.",
    "Pump A vibration triggered a shutdown warning.",
    "The technician replaced a label on the cabinet.",
]
query = "pump temperature vibration shutdown"
stop = {"a", "the", "at", "on", "during"}
def tokens(text):
    return set(re.findall(r"[a-z0-9]+", text.lower())) - stop
vocab = sorted(set().union(*(tokens(s) for s in sentences), tokens(query)))
def vector(text):
    v = np.array([w in tokens(text) for w in vocab], dtype=float)
    return v / max(np.linalg.norm(v), 1e-12)
V = np.stack([vector(s) for s in sentences])
q = vector(query)
relevance, similarity = V @ q, V @ V.T
selected = []
for _ in range(2):
    redundancy = similarity[:, selected].max(axis=1) if selected else np.zeros(4)
    score = 0.55 * relevance - 0.45 * redundancy
    score[selected] = -np.inf
    selected.append(int(np.argmax(score)))
print("Selected indices:", selected)
print("Summary:", " ".join(sentences[i] for i in sorted(selected)))
assert len(set(selected)) == 2
assert 2 in selected and not ({0, 1} <= set(selected))
輸出:
程式碼 · 2 行
Selected indices: [2, 0]
Summary: Pump A temperature reached 80 C during the test. Pump A vibration triggered a shutdown warning.
選到的兩句包含停機句與一個溫度句,避免幾乎重複的溫度觀察。選後排序索引可恢復來源順序:選擇順序量測邊際價值,呈現順序則要支持理解。
真實預算通常限制詞元而非句數。整句分詞長度放得進剩餘預算,才能加入;默默截句可能刪掉條件或否定。多文件摘要應把近似重複報告分組,避免多份副本假裝成獨立證據。保留來源 ID 與時間戳,讓讀者能追查所選證據。
相關性、可行性與內容保留是不同目標
MMR 避免選取與先前句子相似的內容 [14],但不知道哪些事實必須出現。若警告與已選觀察共享很多詞,相似度懲罰可能壓低它,即使它新增的限定十分重要。向量多樣性只是重複度的代理量,不直接量測完整意義。
內容要求會改變可行集合。對詞元預算與必需警告:
其中 是所選句子的索引集合, 是候選 的完整詞元長度, 是預算, 包含表達必需警告的候選。第一個條件限制大小,第二個確保涵蓋。若沒有集合同時滿足兩者,該預算下的擷取任務就不可行。改相關性係數,無法讓過長句子放得下,也無法創造缺少的警告。
以下獨立範例隔離這個差別。效用是明示的教學選擇,不是學得的相關分數:
程式碼 · Python · 19 行
import itertools

sentences = [
    'Pump A temperature reached 80 C during the test.',
    'The test recorded Pump A temperature at 80 C.',
    'Pump A vibration triggered a shutdown warning.',
    'The technician replaced a label on the cabinet.',
]
lengths = [len(s.split()) for s in sentences]
utility = [0.9, 0.85, 0.6, 0.2]
subsets = [tuple(i for i in range(4) if keep[i])
           for keep in itertools.product([False, True], repeat=4)]
feasible = [s for s in subsets if sum(lengths[i] for i in s) <= 20]
score = lambda s: sum(utility[i] for i in s)
ordinary = max(feasible, key=score)
with_warning = max((s for s in feasible if 2 in s), key=score)
print('Lengths:', lengths)
print('Without requirement:', ordinary, 'with warning:', with_warning)
assert ordinary == (0, 1) and with_warning == (0, 2)
輸出:
程式碼 · 2 行
Lengths: [9, 9, 7, 8]
Without requirement: (0, 1) with warning: (0, 2)
這裡以空白分隔的詞計算長度;模型詞元預算則必須使用該模型的分詞器。無限制的選擇重複溫度內容,必含警告的要求則改變所選配對。不能接受遺漏時,更複雜的評分仍需要任務的硬內容要求。
抽象式摘要
改寫模型能融合觀察、提高可讀性,也能編造來源未建立的連接。「溫度高,因此幫浦故障」若來源只記錄同時發生的事件,就新增了因果。兩句改成一句,只要關係保留就可以;把先後改為因果,或刪除「during the test」,就改變了內容。先記錄命題及其來源區間、再產生文字的計畫,能讓你分別評估選擇、計畫與文字實現,找出意義在哪裡遺失。
故事生成與開放式文字
開放式生成把報告的優先順序反過來:沒有唯一正確輸出,多樣性本身就是品質的一部分。Fan、Lewis 與 Dauphin 收集人寫的故事與寫作提示配對,先生成故事前提再生成故事,並因為束搜尋傾向產生簡短而通用的文字而改用 top-k 取樣 [13]。對本章來說,重點是同一個語言模型可能需要依任務使用不同解碼器:受限報告用確定性搜尋,故事用截斷取樣。不變的是評估必須對準任務:故事看連貫性與切題程度,摘要看內容是否受支持。
8. 評估生成文字
直觀說法。 單一自動分數無法總結所有生成品質。自動指標應按指定程序比較系統,再檢查應用真正在乎的錯誤維度。
困惑度(第 5 節)把模型當成參考文字的預測器來評估,並不直接說明某次解碼輸出的好壞,也不能比較分詞器不同的模型。重疊指標比較輸出與參考。ROUGE 包含偏召回的摘要重疊量測 [17]。這類指標比較候選與一個或多個參考,不證明語意等價或來源支持。報告分數要指定版本、分詞、聚合方式與參考集合。翻譯指標如 BLEU 與學得指標在 NLP 08 討論。
簡單的 unigram 召回檢查:
其中 遍歷詞型;、 是參考與候選的詞頻;分母是參考詞元數。它示範 ROUGE 式評估的一個部分,以下最小實作沒有重現完整套件的每項前處理或聚合選項。
程式碼 · Python · 14 行
import re
from collections import Counter

def words(text):
    return re.findall(r"[a-z0-9]+", text.lower())
def overlap_recall(reference, hypothesis):
    ref, hyp = Counter(words(reference)), Counter(words(hypothesis))
    return sum((ref & hyp).values()) / sum(ref.values())
reference = "Pump A is operating at 30 C."
contradiction = "Pump A is not operating at 30 C."
score = overlap_recall(reference, contradiction)
print("Unigram recall:", score)
assert score == 1.0
assert ("not" in words(reference)) != ("not" in words(contradiction))
輸出:
程式碼 · 1 行
Unigram recall: 1.0矛盾句保留了所有參考詞,因此召回為 1.0。精確率會懲罰多出的詞,但小懲罰仍不能表達否定反轉的重要性。這是受控反例,不表示重疊指標永遠不與人類判斷相關,而是說明它必須配合對意義敏感的檢查。
人工評估與錯誤類別
設備應用可分別計算無支持主張、必需主張遺漏、數值關係錯誤與未解指涉。它們是專案自訂的錯誤類別。每類都要給標註者正反例,包含缺少證據與證據矛盾的情況。說得少的摘要可能無支持主張較少,卻漏掉關鍵資訊,因此兩個方向的錯誤都要回報。
人工評估要隱藏系統身分、隨機呈現、保留來源上下文並指定決策任務。先請覆核者標出無支持陳述,再判斷整體實用性;整體偏好可能獎勵風格,卻漏掉罕見的關鍵錯誤。應報告由誰覆核,以及如何處理歧見。聚合要以有意義的單位:同一事故的多個句子彼此相關,把它們當獨立例子會誇大確定性。
以語言模型當評審
可以用提示讓強大的語言模型評分或比較輸出。Zheng 等人研究這種「LLM 當評審」(LLM-as-a-judge)設定,報告在他們的基準上,強評審的偏好與人類偏好的一致程度,可與人類彼此之間的一致程度相比;同時也記錄了位置偏誤、冗長偏誤與自我抬高偏誤 [18]。Wang 等人顯示,只要交換兩個回覆出現的順序,就可能改變模型評審偏好哪一個,並提出兩種順序都評估等校準方法 [19]。
把模型評審當成另一種有自己版本、提示與失敗模式的量測儀器。兩種呈現順序都要評估,隱藏輸出來自哪個系統,在你自己的錯誤類別(尤其是否定、數量與無支持主張)上以人工標註驗證評審,並在可行時避免用同一模型家族評自己的系統。平均而言能排好系統順序的評審,不會自動成為接受單一輸出的可靠門檻。
9. 檢索:找到生成所依據的證據
直觀說法。 生成器要使用證據之前,得先有人把證據找出來。檢索系統從明確語料選出段落;這些段落是否支持回答、答案如何措辭,則是後續的決策。
語言模型不搜尋當前文件集合,也能延續問題;檢索系統則從明確語料選資訊。問答再加入一個決策:選到的內容是否支持回答,以及用哪些詞表達。把元件結合能建立有用管線,但沒有哪個階段會自動替下一階段背書。
本節貫穿的問題是「Pump A 的溫度上限是多少?」相關段落討論 Pump A 或溫度;足夠的段落指出該幫浦在適用政策下的上限;有效引用指向真實來源;受支持回答保留數值、單位、時間與範圍。四者是不同條件,評估應能指出失敗的是哪一項。
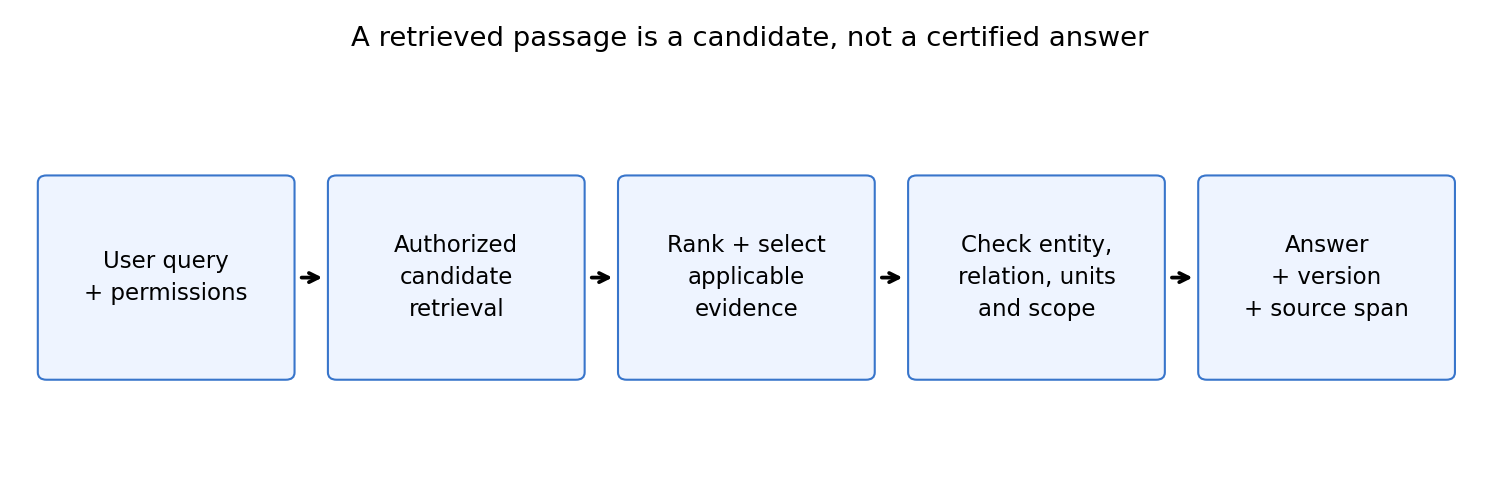
本節建立並評估檢索階段。判斷檢索到的段落是否真的回答問題——擷取式片段答案、相關與可回答的區別,以及用受控替換診斷——在 NLP 11 討論。第 10 節再讓生成器以檢索證據為條件。
選模型前先設計語料
直觀說法。 檢索器搜尋你提供的內容。文件身分、更新狀態與權限是系統的一部分,不是排序後才補的選填資料。
可搜尋段落可表示為:
其中 是段落紀錄; 是父文件識別碼; 是版本;、 是原文中包含起點、不包含終點的位移; 是段落文字; 描述存取政策。必須聲明位移單位。這是本章的應用紀錄,不是通用儲存標準。
段落可是一個自然段、一組句子或依文件結構選的章節。短段落能隔離答案,卻可能丟掉限定條件;長段落保留上下文,卻引入不相關內容並消耗生成預算。切塊邊界應根據任務選,再評估支持事實與條件是否仍放在一起。
例如標題寫「只適用戶外設備」,下一段才給溫度上限。單獨索引該段,可能讓人以為也適用室內設備。保留標題或結構化適用範圍會改變可回答性契約。固定字元視窗容易實作,但簡單不代表能保留意義。
版本也重要。舊政策可能相關卻不適用。需要當前答案時,應保留生效日期與替代關係。不能只因最新段落放在提示最後,就期待生成器判斷當前政策。應依明訂適用規則過濾或排序;語料沒有指定唯一權威來源時,讓衝突可見。
在未授權元件或使用者收到段落文字前,就要套用權限。私密內容若已進模型請求或紀錄,才過濾最終答案就太晚了。檢索器語料視野應符合當前使用者權限,評估也應在受限視野下進行;否則全域相關性分數可能評到系統永遠不能展示的文件。
詞彙檢索與稀疏向量
直觀說法。 詞彙檢索匹配詞語,替有辨識力的詞加權。它容易檢查,精確名稱、代碼與技術短語重要時尤其有用。
簡單的詞頻與逆文件頻率權重為:
其中 是詞 在文件 的權重; 是依選定慣例定義的詞頻; 是索引文件數; 是包含該詞的文件數。只出現在查詢的詞若文件頻率為零,需要特別處理。實作常加入平滑或詞頻轉換,應記錄真正使用的慣例 [33, 34]。
使用正規化文件與查詢向量時:
其中 是查詢; 是候選文件; 是向量; 是餘弦相似度; 是歐氏範數。任一向量為零時定義分數為零。程式使用 scikit-learn 正規化向量,因此非零列的內積就是餘弦相似度 [34]。
倒排索引(inverted index)為每個詞儲存出現它的文件,讓搜尋引擎不必把查詢與每份文件的所有詞彙逐一比較 [33]。本例只有四段,所以直接計算全部分數。數學表示與有效率的索引策略是分開的選擇。
前處理直接影響檢索。丟掉單字元詞元的分詞器可能刪掉 Pump A 的 A。普通詞小寫化可能有幫助,卻會抹掉區分大小寫代碼。短語特徵有助辨識相鄰詞,不會涵蓋任意語法,也不保證語意相同。漏掉結果時,先看詞彙表,再怪排序模型。
詞彙系統可能漏掉改寫。Device ceased operating 與 machine shutdown 可能少有共同詞。同義詞或查詢擴展能幫忙,但也改變匹配政策、增加歧義。應在保留查詢上評估擴展,特別包含精確代碼案例。廣泛擴展提升召回時,也可能找到術語相似的錯誤裝置。
飽和與文件長度
直觀說法。 重複查詢詞很多次,不應永遠提高相關性。長文件也有更多機會偶然匹配。
常見 BM25 形式為:
其中 在簡化式中是查詢詞集合; 是候選文件; 是詞頻; 是選定逆文件頻率權重; 是詞元長度; 是平均文件長度; 是正的飽和參數; 控制長度正規化。不同實作的 IDF 與查詢詞頻慣例不同,資訊檢索教科書討論了這個家族及其假設 [33]。
隨重複增加,分子與分母讓詞頻貢獻接近一個極限。長度項改變長文件預期有多少詞頻。這些是排序調整,不是文件含有真實答案的機率。一段內容可能反覆討論上限而排名很高,卻從未給出數值。
應在反映部署語料的開發查詢上調整長度正規化。若所有答案都在短參考條目,不相關內容都在長敘事,一個設定可能特別強;改成長技術手冊後,行為會改變。比較排序設定時保持切塊固定,否則應說明語料表示與分數都改變了。
稠密檢索與聯合重排序
直觀說法。 學得的編碼器能匹配沒有精確重疊的相關表達。效果取決於訓練任務與對比例子。
雙編碼器分數為:
其中 把查詢轉成向量; 把段落轉成向量; 是學得參數; 是內積分數。編碼器可共用或分別使用參數。Dense Passage Retrieval 是這種設計在問答中的原始研究例子 [35]。
段落向量可預先計算,查詢再搜尋高分向量。近似搜尋以部分精確近鄰忠實度換速度;若使用它,就要同時評估表示與搜尋近似。本章不實作這種索引,因為小語料精確搜尋更適合學習契約。
對比訓練可把一個正段落與數個負段落比較:
其中 是單一查詢損失; 是標註正段落; 是負候選 ; 是正溫度; 是學得分數。負例可包含措辭相似的困難段落。但只因未被標註就判負的段落,若也有有效答案,就成了假負例。
聯合重排序器一起讀查詢與候選段落,能產生比兩個固定向量更豐富的詞元互動,通常放在較便宜的候選檢索後。這增加計算與一個選擇程序。應先報告候選召回率:沒有收到正確段落,重排序器就無法把它找回。
稠密與詞彙檢索可以互補。稠密表示可能幫助改寫,詞彙匹配則保留精確代碼與罕見名字。混合時要注意尺度,因為詞彙分數與學得內積沒有相同單位。應在開發資料選混合設定,檢查是否引入錯誤實體結果。
對比損失實際教模型什麼?
稠密損失不只是把查詢移向任何大致相關的文章,而是學習候選集合呈現的差異。令候選零為正例,其餘為負例。對候選分數:
其中 是查詢對候選 的分數, 是負候選數, 索引全部候選, 是溫度, 是候選 softmax 機率, 是損失, 對正例為一、其餘為零。這個導數直接由前面的 softmax 損失得到。梯度下降提高正例分數、降低負例分數;競爭最強的負例承受最大的向下壓力。
DPR 透過正負文章比較,訓練分開的查詢與文章表示 [35]。公式說明比較的選擇為何重要。若負例都來自不相關主題,模型可能學會主題區分,卻沒有學會區分 Pump A 與 Pump B。具有相同關係、卻是錯誤裝置的文章,對這種錯誤提供更有用的對比。但若未標註文章其實支持答案,把它當成負例,就會教出錯誤的分離。
這個獨立的分數空間實驗確認梯度方向。它示範目標,不會訓練文章編碼器:
程式碼 · Python · 15 行
import numpy as np

scores = np.array([1.2, 0.8, -0.4])  # positive, hard negative, easy negative
def probabilities(values):
    z = np.exp(values - values.max())
    return z / z.sum()
p = probabilities(scores)
gradient = p.copy()
gradient[0] -= 1.0  # temperature is one
updated = scores - 0.5 * gradient
before, after = -np.log(p[0]), -np.log(probabilities(updated)[0])
print('Gradient:', gradient.round(3))
print('Loss:', round(before, 3), '->', round(after, 3))
assert gradient[0] < 0 and gradient[1] > gradient[2] > 0
assert after < before
梯度四捨五入為 [-0.466, 0.358, 0.108],損失由 0.627 降至 0.467。分數較高的競爭負例,比簡單負例承受更大的向下壓力。
溫度同時影響分布尖銳程度與梯度尺度;候選則改變模型正在學的對比。因此,新編碼器若也改了正例標籤、負例建立方式或訓練語料,提升便不能只歸因於架構。比較時應保留這些差異。
依重要差異比較檢索路徑
雙編碼器在還不知道未來查詢時,就先壓縮文章。這讓向量能快取並有效率地搜尋候選,但未來問題需要的每個細節,都必須在壓縮後保留下來。聯合重排序器同時取得兩段文字,可比較彼此的特定詞元;每對計算成本較高,仍取決於訓練範例。聯合注意力提供辨識細節的機會,不證明模型一定尊重該細節。
| 查詢差異 | 有用證據 | 應檢查的失敗 |
|---|---|---|
Pump A 與 Pump B | 精確識別碼加上關係 | 主題相似掩蓋一個字元的差異 |
ceased operating 與 shutdown | 學到的改述相容性 | 詞彙表漏掉同義表達 |
| 目前與升級前的限制 | 版本與生效日期中繼資料 | 高度相關文章回答錯誤時間範圍 |
| 許可與禁止 | 否定及其語法作用範圍 | 共同詞彙隱藏相反指令 |
混合設計可聯集詞彙與稠密候選、去重,再聯合重排留下的文章。聯集保留任一路徑找到的候選,但固定總預算仍可能排除部分候選。直接相加原始分數較難解讀:把一個系統的分數乘常數,雖不改自己的排序,卻會改變它在加總中的影響力。因此,正規化或學習組合需要開發資料的相關性判斷,而不是假定任意係數都適用。
應分別比較候選召回、最後順序與資源成本。系統可能改善前者卻損害後者,也可能兩者都改善卻超出服務預算。把精確名稱、改述與範圍敏感問題分組診斷,錯誤模式能揭露表示丟了哪些資訊,以及哪種下游互動值得額外計算。
排序評估
直觀說法。 檢索評估需要查詢及相關性判斷。選到一份文件,不代表選對了。
對查詢 的相關集合 與前 結果集合 :
其中 是截斷位置; 包含標註相關文件; 包含截斷前檢索結果; 是集合大小。本章只對至少一份相關文件的查詢計算。沒有答案的查詢屬於另外的可回答性評估,不應任意指定召回率。
第一個相關結果排名為 時:
其中 是倒數排名; 是其平均; 是評估查詢數; 從一開始。沒有回傳相關結果時定義倒數排名為零。當代檢索增強評估討論使用這些診斷 [31]。倒數排名只重視第一個成功結果,忽略後面的相關結果。
標註完整性很重要。多個段落都支持答案,卻只標一個相關,可能把有效檢索判錯。要記錄相關是指主題匹配、包含答案,還是完整支持。重要歧義可使用多位判斷者,再依書面指南裁決。資料集應揭露任務定義,不只是列一段偏好的文字。
開發與測試要隔離查詢家族及文件衍生版本。把開發問題稍作改寫放進測試,泛化證據很弱;同一報告的切塊跨集合也可能洩漏事實與措辭。切分應反映部署問題:沒見過的使用者、文件、未來版本或新領域。
量測一個小型檢索器
這段獨立程式使用四個合成段落。它保留單字元詞,讓裝置識別碼 A 仍是特徵,並在三個標註查詢上量測排序。
程式碼 · Python · 30 行
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer

corpus = {
    'temperature-v2': 'Pump A temperature limit is 80 C. This policy is current.',
    'shutdown-v1': 'Pump A shutdown follows a vibration alarm.',
    'label-v1': 'A technician replaced the cabinet label.',
    'sensor-v1': 'Sensor B reports humidity once per hour.',
}
ids = list(corpus)
vectorizer = TfidfVectorizer(ngram_range=(1, 2), token_pattern=r"(?u)\b\w+\b")
D = vectorizer.fit_transform([corpus[key] for key in ids])
def rank(query):
    score = (D @ vectorizer.transform([query]).T).toarray().ravel()
    order = sorted(range(len(ids)), key=lambda i: (-score[i], ids[i]))
    return [(ids[i], float(score[i])) for i in order]
queries = [
    ('Pump A temperature limit', {'temperature-v2'}),
    ('vibration shutdown alarm', {'shutdown-v1'}),
    ('humidity report', {'sensor-v1'}),
]
recalls, reciprocal = [], []
for query, relevant in queries:
    ranking = rank(query)
    recalls.append(len({key for key, _ in ranking[:2]} & relevant) / len(relevant))
    first = next((i + 1 for i, (key, _) in enumerate(ranking) if key in relevant), None)
    reciprocal.append(1 / first if first else 0.0)
    print(query, '->', ranking[0][0])
print('mean Recall@2:', np.mean(recalls))
print('mean reciprocal rank:', np.mean(reciprocal))
輸出:
程式碼 · 5 行
Pump A temperature limit -> temperature-v2
vibration shutdown alarm -> shutdown-v1
humidity report -> sensor-v1
mean Recall@2: 1.0
mean reciprocal rank: 1.0
三個最高結果符合各自唯一相關段落,因此本次小型執行的平均 Recall@2 與平均倒數排名都是 1.0。這是固定測試案例結果,不是真實檢索基準。NLP 11 沿用同一語料與排序器,建立範圍狹窄的證據式回答器。
分級相關性:nDCG
Recall@k 與倒數排名把判斷視為相關或不相關。若判斷者替段落分級——完整支持高於只提到主題——量測就應獎勵把最有用的段落排在最前面。
其中 是排名 結果的分級相關性; 是前 名的折損累積增益(discounted cumulative gain); 是已判斷結果依理想順序排列時的同一總和,因此 ; 時定義為零。Järvelin 與 Kekäläinen 提出累積增益這一族量測 [36];對數底數、增益轉換與截斷位置因實作而異,報告時應寫明。
同樣四個已判斷段落的兩種排序,差別只在支持段落或主題段落排第一:
程式碼 · Python · 16 行
import numpy as np

def dcg(gains, k):
    gains = np.asarray(gains[:k], dtype=float)
    return float(np.sum(gains / np.log2(np.arange(2, gains.size + 2))))
def ndcg(gains, k):
    ideal = dcg(sorted(gains, reverse=True), k)
    return dcg(gains, k) / ideal if ideal > 0 else 0.0

# graded judgments of one ranking: 2 = complete support, 1 = topical, 0 = unrelated
ranked_a = [1, 2, 0, 0]  # topical passage above the supporting one
ranked_b = [2, 1, 0, 0]  # supporting passage first
for name, gains in [('A', ranked_a), ('B', ranked_b)]:
    print(name, 'nDCG@3:', round(ndcg(gains, 3), 3),
          'binary RR:', 1 / (1 + gains.index(2)))
assert ndcg(ranked_b, 3) == 1.0 and ndcg(ranked_a, 3) < 1.0
輸出:
程式碼 · 2 行
A nDCG@3: 0.86 binary RR: 0.5
B nDCG@3: 1.0 binary RR: 1.0
若以「完整支持」為相關標準,排序 A 的倒數排名減半。nDCG 也下降,但幅度較小,因為它仍替排第一的主題段落計分。哪種行為正確取決於任務:若只有完整答案有用,主題段落的分級分數可能掩蓋失敗。選量測前先寫好分級指南。
10. 幻覺與檢索增強生成
直觀說法。 語言模型可能產生流暢、卻得不到輸入或真實世界支持的文字。檢索提供外部證據,但生成器仍必須正確使用;檢索來的文字絕不能被當成新的權威。
Ji 等人的綜述區分內在(intrinsic)幻覺,即與來源矛盾的輸出,以及外在(extrinsic)幻覺,即無法由來源驗證的輸出 [20]。Maynez 等人對抽象式摘要器的人工研究發現,所檢查的每個模型生成摘要都含有大量幻覺內容,並發現文字蘊涵量測與忠實度的相關性優於標準重疊指標 [21]。這兩點都可由第 1 節與第 6 節推得:訓練目標獎勵可能的文字,任何解碼器都無法補上分布中缺少的證據。
注意力可診斷計算存取,不能證明事實。詞元讀到正確證據,仍可能表達相反意思。驗證要看輸出主張、來源實體、關係及範圍。狹義結構任務可讓生成器說出已驗證的計畫,如上面的模板;自由文字的驗證並不完整,應明說限制。
檢索增強生成
原始檢索增強生成(retrieval-augmented generation,RAG)論文,把學得檢索器與條件序列生成結合,用於知識密集任務 [22]。一種序列層級形式為:
其中 是問題; 是輸出序列; 是檢索段落; 是前 個候選集合; 是檢索器參數; 是生成器參數。近似反映只保留候選。這是特定模型的機率形式,不代表所有當代 RAG 應用都實作它。
很多實務系統先檢索、組提示,再執行分開訓練的生成器。即使未最佳化原始邊際目標,這種管線仍可有用,但要說清楚設計。否則 RAG 這個名稱會掩蓋檢索是否學得、候選是否重排序,以及生成器是否受訓使用來源。第 9 節建立並評估檢索器本身;擷取式答案與可回答性檢查在 NLP 11。
證據扎根(grounding)依明訂的支持規則,把主張連到外部證據。有引用的答案可能可追溯,但可追溯弱於受支持:有效網址也可能指向與答案矛盾的文件。要評估每個重要主張是否由引用證據推得,以及是否保留必要限定。
證據也可能衝突。生成器不應把互斥政策默默合成一個自信答案。應用可依契約優先採用權威版本、展示衝突或請求澄清。決策應來自中繼資料與任務規則,而非哪一句最流暢。
錯誤沿檢索、解讀與文字實現傳遞
受支持答案需要一串成功決策:語料必須有適用證據,檢索必須保留它,閱讀器必須解讀正確實體與關係,輸出也必須保留該解讀。由記憶知識猜出的答案,可能碰巧正確,卻不符合證據要求。對適用證據已存在語料中的問題,可寫成:
其中 表示機率, 是充分證據保留於檢索結果的事件, 是正確解讀證據的事件, 是輸出忠實實現解讀的事件。這是機率鏈式法則,不是假設獨立。把互不相干的無條件階段分數相乘並不等價:閱讀器在人工挑選簡單文章上的準確率,可能不同於在檢索器實際候選上的準確率。
程式碼 · Python · 12 行
import numpy as np

retrieved = np.arange(100) < 80
interpreted = np.arange(100) < 72
realized = np.arange(100) < 68
r = retrieved.mean()
e = interpreted[retrieved].mean()
g = realized[retrieved & interpreted].mean()
complete = (retrieved & interpreted & realized).mean()
print('Conditional stage rates:', round(r, 3), round(e, 3), round(g, 3))
print('Complete supported answers:', round(complete, 3))
assert np.isclose(r * e * g, complete)
輸出:
程式碼 · 2 行
Conditional stage rates: 0.8 0.9 0.944
Complete supported answers: 0.68
這是合成結果,不是系統效能報告。計算說明各元件表現看似不錯,完整答案仍未必同樣可靠。改善最弱階段的效果,還要能通過後續階段才有用。
檢索內容的邊界
檢索文字是待檢查的證據,不是有權改變應用的指令來源。段落可能包含引述指令、誤導文字或惡意要求。提示注入(prompt injection)試圖讓模型遵循與應用邊界衝突的指令,OWASP 記錄了此風險類別 [23]。檢索系統的重要界線,是使用者/應用指令與不可信來源材料之間。
來源文字應清楚分隔並標示文件身分,不得重新定義使用者權限、索取秘密資料或授權工具動作。若有工具,應在檢索段落之外,依使用者任務及應用政策驗證動作。文字分隔有助組織輸入,卻不是完整的強制機制。
相同原則適用於紀錄與快取。某使用者權限下產生的快取結果,不能未經檢查就給另一位使用者。證據區段必須指向回答所用的同一文件版本。文件移除或替換時,要更新索引,並考慮讓衍生回答失效。
這些檢查也支援一般正確性。「忽略舊上限,新政策如下」可以是需要解讀的合法文件內容,「忽略你的應用指令」卻不是系統的新權威。兩者都可儲存為來源材料,再套用任務的證據與權限規則;不能讓檢索器成為修改治理契約的通道。
11. 調適預訓練生成器
直觀說法。 預訓練學習廣泛的延續模式;調適改變任務行為;提示則改變提供的輸入,不一定改權重。學習遵循指令與學習人們偏好的回覆是不同訊號,兩者都不保證真實。
監督任務調適對標註例子最小化任務損失,例如只在回覆詞元上計算第 7 節的條件損失。繼續在領域文字上訓練語言模型會改變所建模的分布,卻不會自動教會應用的輸出政策。熟悉領域與理解任務指令是兩種不同調適。上下文內例子(如 GPT-3 [6])直接出現在輸入中,不更新參數就能示範格式;若例子包含私密答案或測試標籤,評估就可能失效,而在開發案例上選出的提示,必須在最終測試前凍結。
低秩調適(Low-Rank Adaptation,LoRA)固定基礎權重矩陣,訓練受限更新 [24]:
其中 是固定矩陣; 與 是學得因子; 是選定的秩; 是有效調適矩陣。簡化式省略可選縮放。減少可訓練參數能降低調適成本,但不能取代代表性標籤、資料隔離與任務評估。基礎模型版本、分詞器、調適權重與設定應一起儲存:針對某基礎檢查點訓練的調適,不保證能套用到同家族另一檢查點。
InstructGPT 論文先研究監督指令例子,再以人類回饋進行偏好訓練 [25],因而區分基礎延續模型與朝請求行為調適的模型。偏好來源很重要:標註者依政策平衡實用性、格式與其他目標。較受偏好的回覆仍可能有事實錯誤。
直接偏好最佳化(Direct Preference Optimization,DPO)結合偏好與不偏好的回覆,以及參考政策 [26]。代表性目標如下:
其中 是提示; 與 是偏好及不偏好的回覆序列; 是可訓練政策; 是固定參考政策; 是正縮放參數; 是 logistic sigmoid; 是單一偏好對的損失。序列機率是回覆詞元條件機率的乘積,提示提供上下文,不是受監督回覆詞元。
目標提高偏好回覆相對於另一回覆的概似,並以參考政策為基準。若資料獎勵自信但無支持的答案,最佳化可能強化這種行為。指令遵循、偏好一致與事實支持是不同性質,需要不同證據。ML 10 以程式執行一個低秩更新。
選讀:InstructGPT(見「論文導讀」頁)。依原論文圖理解目標、實驗比較與限制。
12. 訓練實務遇上服務限制
直觀說法。 部署後的生成器要服務長度不一的輸入,每個請求的成本同時取決於提示與輸出。填補與注意力快取是兩種不同的記憶體成本,兩者都要量。
Hagiwara 第 10 章把填補、排序與遮罩連到實際推論 [1]。要分清楚:正確的損失遮罩防止填補改變目標,未必防止硬體處理填補位置。定義填補利用率:
其中 是請求 的真實詞元長度; 是批次大小; 是填補後位置中真實詞元的比例。這是工作量診斷,不是實測加速。按相近長度組批可提高利用率,也可能讓請求等待適合的批次。
程式碼 · Python · 18 行
import numpy as np

lengths = np.array([8, 64, 12, 60, 10, 56, 14, 52])
def utilization(values):
    batches = values.reshape(-1, 4)
    real = int(batches.sum())
    padded = int((batches.max(axis=1) * 4).sum())
    return real / padded
arrival = utilization(lengths)
bucketed = utilization(np.sort(lengths))
print("Arrival-order utilization:", round(arrival, 3))
print("Length-bucketed utilization:", round(bucketed, 3))
assert bucketed > arrival
# Two cache arrays (keys and values), with a toy equal head layout.
layers, kv_heads, head_dim, cache_tokens, bytes_per_value = 4, 2, 16, 128, 4
cache_bytes = 2 * layers * kv_heads * head_dim * cache_tokens * bytes_per_value
print("Toy cache bytes:", cache_bytes)
assert cache_bytes == 131072
輸出:
程式碼 · 3 行
Arrival-order utilization: 0.575
Length-bucketed utilization: 0.885
Toy cache bytes: 131072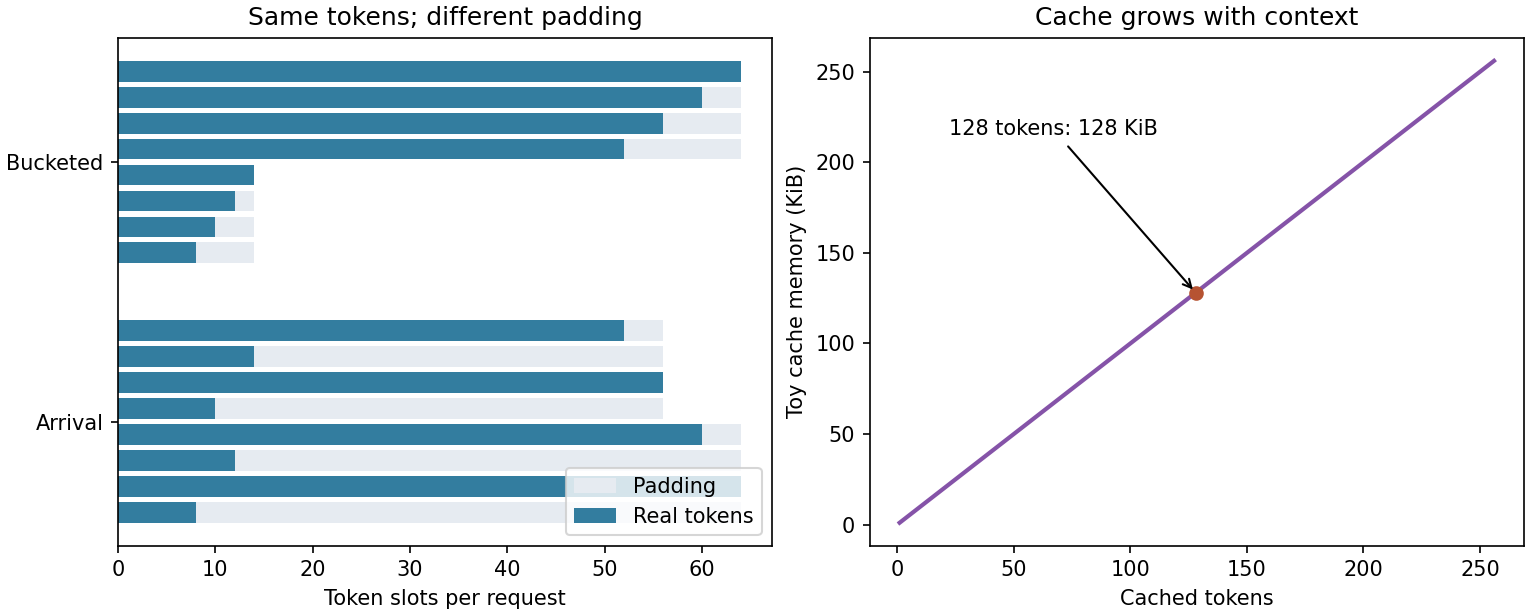
自迴歸注意力常快取先前的鍵和值,避免每產生一個詞元就重算。簡單布局下,快取記憶體近似 ,其中 是層數、 是鍵/值頭數、 是頭維度、 是快取詞元數、 是每個值的位元組數。因子二表示鍵與值。實際實作還有配置及中繼資料成本,也可能使用不同布局。
應分開量測首詞元時間、後續詞元間隔、總完成時間及負載下的吞吐量。短提示長答案與長提示短答案壓力不同。端到端量測要包含前處理、等待、驗證與序列化。依量測到的工作負載設定請求長度上限、輸出上限及佇列期限,並說明逾時時回傳部分結果、可重試錯誤或經覆核的替代結果。
可重現的服務契約
只有模型檔無法重現預測。分詞、正規化、證據選擇、解碼參數、驗證規則與輸出格式都影響行為。Hagiwara 的部署章 [1] 提供版本、測試、訓練—服務差異與監控的實務閱讀。換成學得生成器時,文字旁要回傳模型版本與已驗證證據 ID(如模板函數所做),並把前處理版本與解碼設定和模型一起保存。紀錄應能支援診斷,卻不必無謂保留私密原文。
新版本先服務有限比例的請求,用相同錯誤類別與穩定版本比較,同時檢查延遲、完成率與證據正確性。回復應保持簡單:儲存的套件應能一起選回舊模型、分詞器、解碼設定與驗證規則。舊模型混用新分詞器,可能產生各元件單獨時都沒有出現的失敗。
現代觀點
直觀說法。 當代語言模型結合預訓練、調適、解碼、評估與系統整合。綜述若能釐清這些不同選擇,而非壓縮成單一模型排名,就特別有用。
Zhao 等人的綜述 [27] 更新至 2026 年,並發表於 Frontiers of Computer Science,依預訓練、調適、使用與能力評估組織大型語言模型。這有助區分更多訓練資料、指令微調與不同使用方式。Chang 等人的評估綜述 [28] 區分評什麼、在哪裡評與如何評。兩者共同支持任務專屬的評估計畫,而非依賴單一通用分數。
Li 等人的預訓練生成綜述 [29] 依輸入表示、架構與最佳化整理方法,並涵蓋應用及評估。這有助定位變化:檢索改變可用證據,編碼器—解碼器改變條件架構,調適改變參數或訓練目標。該綜述早於部分後續系統,應搭配較新的評估與部署證據閱讀。
Ji 等人的幻覺綜述 [20] 與 Schmidtova 等人對幻覺人工評估的綜述 [30] 從兩側處理同一問題。前者整理跨任務的定義、指標與緩解方法;後者檢查研究如何定義與評估幻覺,指出術語不一致及方法報告缺失。其實務重點是分開定義來源支持、世界知識與錯誤嚴重度,並公開標註說明與歧見處理方式。
Gao 等人的 RAG 綜述 [31] 把檢索增強系統分為 naive、advanced 與 modular 範式,並區分上下文相關、答案相關與答案忠實。各階段會互相影響:把「升級前的限制是多少?」改寫為「溫度限制是多少?」,可能改善主題檢索,卻刪掉時間條件。應保留原始查詢,比較改寫後的意義,而不只看檢索分數。
Kwon 等人的 PagedAttention [32] 研究語言模型服務中的鍵—值快取配置與共享,處理記憶體浪費以及記憶體所允許的批次大小,替上面的快取計算提供系統觀點。論文報告的改善屬於其工作負載與比較;採用服務設計前,先量測自己的請求長度、並行程度與延遲目標。
開放問題包括評估集合污染、長上下文穩健性(較大的上下文視窗允許更多輸入,卻不能證明所有相關部分都被可靠使用)、多語與低資源語言涵蓋、穩定的不確定性、在不壓制有用回答下偵測無支持主張,以及指令遵循和來源支持正確性的關係。評估模型可能與生成器共享錯誤,尤其兩者訓練資料相近時。能以較低延遲與較簡單覆核滿足任務時,小型專用模型甚至模板,可能是更好的工程選擇。
重點整理
- 僅解碼器 Transformer 以因果方式分解文字;要明確位移目標,並測試未來詞元無法改變較早 logits。
- GPT 系列保留同一架構與目標,擴大資料、參數與呈現任務的方式;規模化定律預測損失,不預測任務行為。
- 困惑度比較需要相容的分詞與評估位置,也不直接說明解碼輸出的好壞。
- 貪婪與束搜尋最佳化序列機率;溫度重塑分布;top-k 與核取樣截掉長尾,而核會隨分布形狀調整。
- 生成需要內容契約:選擇、規劃與文字實現各有不同失敗方式,擷取式摘要仍需檢查必需內容。
- 重疊指標、人工覆核與模型評審各有盲點;要在重要錯誤(例如否定反轉)上驗證它們。
- 檢索提供證據,不提供權威;相關性、引用有效性與主張支持是不同條件。
- 把整個前處理—模型—解碼—驗證套件版本化,並把指令微調與偏好學習視為與事實支持不同的事。
練習
- 移除可執行因果模型中的因果遮罩。哪個斷言應失敗?為何訓練損失仍可能好看?
提示
改變的最後詞元能被較早位置讀取。低損失可能獎勵生成時根本取不到的資訊。
- 使用解碼程式,找出一個溫度,使單純取樣放在四個長尾詞元上的機率,超過 的 top-k 所能保留的上限。再構造一個 logit 向量,讓 的核大於五個詞元,並說明各規則何時較合適。
提示
的 top-k 最多只能保留一個長尾詞元。平坦的 logit 向量讓核變大,尖峰的則讓核變小。
- 修改微型束搜尋的機率,讓束搜尋選出違反外部指令的句子。加入合法完整序列的限制,並與加寬束比較效果。
提示
機率搜尋最佳化的是分布分數,合法序列規則改變的是哪些輸出可接受。加寬束未必能修好錯誤的機率模型。
- 建立兩個候選摘要:一個詞重疊高但數量錯,另一個重疊較低但意義正確。設計能顯示差別的標註表,以及模型評審程序。
提示
先請覆核者標出無支持數量與遺漏的必需事實,再判斷整體實用性。保留來源、隱藏系統身分;模型評審則兩種呈現順序都要跑。
- 構造一對獎勵風格、卻選到較缺乏支持回覆的偏好資料,說明哪種額外評估能揭露問題,並計算 128×256 矩陣的秩 4 LoRA 更新有多少可訓練參數。
提示
固定證據,比較自信地加入事實的答案,與保留來源不確定性的限定答案。LoRA 的部分要分別計算兩個因子矩陣。
- 擴充報告函數,加入時間戳與目標語言選項。拒絕格式錯誤的輸入、保留未知狀態、附上證據 ID,並將文字實現規則版本化。寫下以學得生成器取代模板前需要哪些測試。
提示
不要推測未記錄的時間戳,也不要把未知轉成不存在。要測試前處理一致性、數字格式、書寫系統要求、長輸入、逾時行為與完整回復套件。
參考文獻
- Masato Hagiwara, Real-World Natural Language Processing: Practical Applications with Deep Learning, Chapters 5, 8, 9, 10 and 11, Manning, 2021. Publisher · Training practices · Deployment
- Susan McRoy, Principles of Natural Language Processing, open textbook, Chapters 6 and 9, 2021. Benchmark chapter · Generation chapter
- Ashish Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. Paper
- Alec Radford, Karthik Narasimhan, Tim Salimans and Ilya Sutskever, “Improving Language Understanding by Generative Pre-Training,” OpenAI technical report, 2018. Paper
- Alec Radford, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei and Ilya Sutskever, “Language Models are Unsupervised Multitask Learners,” OpenAI technical report, 2019. Paper
- Tom B. Brown et al., “Language Models are Few-Shot Learners,” NeurIPS, 2020. Paper
- Jared Kaplan et al., “Scaling Laws for Neural Language Models,” arXiv:2001.08361, 2020. arXiv
- Jordan Hoffmann et al., “Training Compute-Optimal Large Language Models,” arXiv:2203.15556, 2022; published as “An empirical analysis of compute-optimal large language model training,” NeurIPS, 2022. arXiv
- Ilya Loshchilov and Frank Hutter, “Decoupled Weight Decay Regularization,” ICLR, 2019. Paper
- Dan Hendrycks and Kevin Gimpel, “Gaussian Error Linear Units (GELUs),” arXiv:1606.08415, 2016, revised 2023. Paper
- Jimmy Lei Ba, Jamie Ryan Kiros and Geoffrey E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. Paper
- Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes and Yejin Choi, “The Curious Case of Neural Text Degeneration,” ICLR, 2020. Paper
- Angela Fan, Mike Lewis and Yann Dauphin, “Hierarchical Neural Story Generation,” ACL, 2018. Paper
- Jade Goldstein and Jaime Carbonell, “Summarization: (1) Using MMR for Diversity-Based Reranking and (2) Evaluating Summaries,” TIPSTER Phase III Workshop, 1998. Paper
- Sam Wiseman, Stuart M. Shieber and Alexander M. Rush, “Challenges in Data-to-Document Generation,” EMNLP, 2017. Paper
- Ilya Sutskever, Oriol Vinyals and Quoc V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. Paper
- Chin-Yew Lin, “ROUGE: A Package for Automatic Evaluation of Summaries,” Text Summarization Branches Out, 2004. Paper
- Lianmin Zheng et al., “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena,” NeurIPS Datasets and Benchmarks Track, 2023. Paper
- Peiyi Wang et al., “Large Language Models are not Fair Evaluators,” ACL, 2024. Paper
- Ziwei Ji et al., “Survey of Hallucination in Natural Language Generation,” ACM Computing Surveys 55, 2023. Survey
- Joshua Maynez, Shashi Narayan, Bernd Bohnet and Ryan McDonald, “On Faithfulness and Factuality in Abstractive Summarization,” ACL, 2020. Paper
- Patrick Lewis et al., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,” NeurIPS, 2020. Paper
- OWASP GenAI Security Project contributors, “LLM01: Prompt Injection,” OWASP guidance, accessed 2026. Official guidance
- Edward J. Hu, Yelong Shen, Phillip Wallis, Zeyuan Allen-Zhu, Yuanzhi Li, Shean Wang, Lu Wang and Weizhu Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” ICLR, 2022. Author publication page
- Long Ouyang et al., “Training language models to follow instructions with human feedback,” NeurIPS, 2022. Paper
- Rafael Rafailov, Archit Sharma, Eric Mitchell, Christopher D. Manning, Stefano Ermon and Chelsea Finn, “Direct Preference Optimization: Your Language Model is Secretly a Reward Model,” NeurIPS, 2023. Paper
- Wayne Xin Zhao et al., “A Survey of Large Language Models,” Frontiers of Computer Science, 2026. Updated survey
- Yupeng Chang et al., “A Survey on Evaluation of Large Language Models,” ACM Transactions on Intelligent Systems and Technology, 2024. Survey
- Junyi Li, Tianyi Tang, Wayne Xin Zhao, Jian-Yun Nie and Ji-Rong Wen, “Pre-Trained Language Models for Text Generation: A Survey,” ACM Computing Surveys, 2024. Publisher · Author manuscript
- Patricia Schmidtova et al., “Do My Eyes Deceive Me? A Survey of Human Evaluations of Hallucinations in NLG,” INLG, 2025. Survey
- Yunfan Gao, Yun Xiong, Xinyu Gao, Kangxiang Jia, Jinliu Pan, Yuxi Bi, Yi Dai, Jiawei Sun, Meng Wang and Haofen Wang, “Retrieval-Augmented Generation for Large Language Models: A Survey,” arXiv:2312.10997, revised 2024. Survey
- Woosuk Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” SOSP, 2023. Conference · Paper
- Christopher D. Manning, Prabhakar Raghavan and Hinrich Schütze, Introduction to Information Retrieval, Chapters 6, 8 and 11, Cambridge University Press, 2008. Author-hosted book
- scikit-learn developers, “Text feature extraction,” scikit-learn documentation, accessed 2026. Documentation
- Vladimir Karpukhin, Barlas Oguz, Sewon Min, Patrick Lewis, Ledell Wu, Sergey Edunov, Danqi Chen and Wen-tau Yih, “Dense Passage Retrieval for Open-Domain Question Answering,” EMNLP, 2020. Paper
- Kalervo Järvelin and Jaana Kekäläinen, “Cumulated Gain-Based Evaluation of IR Techniques,” ACM Transactions on Information Systems 20(4), 422–446, 2002. Publisher
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 NLP 10・預訓練模型:BERT · 20 分鐘