ML 10・基礎模型與視覺語言學習
先備知識:ML 06・表示學習與自監督、ML 09・視覺自迴歸:像素、Tokens 與尺度、ML 08・擴散模型與流匹配
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 從預訓練與重用定義基礎模型。
- 在實際量測範圍內解讀縮放法則。
- 比較監督來源與可重用的視覺能力。
- 追蹤影像—文字對齊、視覺提示與多模態連接器。
- 選擇調適方法,測試任務表現、穩健性與限制。
先看全貌
在電腦視覺的大部分歷史裡,每個任務各有一個模型:一個網路分類花朵、另一個偵測汽車、再一個分割腫瘤,每個都從頭訓練,或從 ImageNet [43] 分類器開始。基礎模型則在廣泛的資料上、以大規模訓練一次,接著適配到許多下游任務 [1]。這個詞描述的是模型如何被訓練與重用,而不是一種新的網路層。DINOv2 [15] 或 DINOv3 [16] 影像編碼器、CLIP 式影像文字模型 [3]、SAM [5] 這類提示式分割器、多模態語言模型,以及廣泛預訓練的影像生成器,都可以扮演這個角色。
為什麼重要?有三個理由。第一,標註很昂貴,而預訓練把大部分學習移到不需要人工標籤的資料上(圖說、影像本身)。第二,一個骨幹網路服務許多任務,讓工程投入更集中。第三,它改變了介面:很多時候不必重新訓練,只要用一段文字提示、一次點擊或幾個範例就能指定任務。Bommasani 等人把這種方法的集中稱為同質化(homogenization),並提醒它同時也集中了失敗:共用骨幹的一個缺陷,會被建立在它之上的每個系統繼承 [1]。
本章延續 ML 06・表示學習(什麼樣的特徵可以重用)、ML 05・Vision Transformer(常用骨幹),以及生成模型章節 ML 08 與 ML 09。Bishop 與 Bishop 的教科書 [14] 對遷移學習與表示有系統性的說明,可作為參考。本章沿用 Awais 等人的視覺基礎模型綜述 [39] 與 Caffagni 等人的多模態綜述 [2] 所畫出的架構地圖,並引用為 2026 年 10 月版本查證過的代表性報告。這些例子用來說明模型家族,不是在替商業產品排名,也不宣稱某個 checkpoint 在所有情況都最好。
什麼樣的模型稱為「基礎」模型
白話版。 基礎模型是在廣泛資料上、以通用目標預訓練的大型模型,它的內部表示或使用介面可以重用在從未專門訓練過的任務上。
Bommasani 等人 [1] 在 2021 年提出這個名稱,並強調兩個性質:
- 湧現(emergence)。 能力來自規模與訓練目標,而不是被明確設計出來。例如 CLIP 只被訓練去配對影像與圖說,卻能把影像分類到用文字命名的類別 [3];DINO 完全沒有使用標籤,它的注意力圖卻能勾勒出物體輪廓 [24]。
- 同質化(homogenization)。 許多應用收斂到少數幾個預訓練骨幹與訓練配方。
使用「湧現」時要小心。本章中它只表示一種不是訓練目標的能力,並不代表無法預測或神秘的跳躍;某個能力看起來是否「突然」出現,常常取決於用來衡量它的指標。
形式上,令 為在上游資料集 上以目標 預訓練的模型:
下游任務 提供一個(通常很小的)資料集 與任務損失 。適配就是選一小組新的或被修改的參數 ,並求解
其中 是我們放在預訓練模型上方或內部的任何東西:線性分類頭、adapter、LoRA 更新、提示,或什麼都不放(純提示,)。整章都圍繞上面兩行: 與 應該是什麼,以及 可以多小。
基礎模型不一定要產生文字。一個凍結的影像編碼器,若它的特徵供一百個不同分類器使用,就是基礎模型。反過來,為單一狹窄任務訓練的大模型,不論多大都不算。
縮放定律
白話版。 縮放法則擬合損失如何隨模型大小、資料與計算量改變,有助規劃可比條件下的訓練,但不保證外推增益。
Kaplan 等人 [17] 訓練了多組 Transformer 語言模型,報告損失與模型大小、資料量及計算量之間呈冪律關係,部分趨勢跨越超過七個數量級;在測試範圍內,寬度與深度的影響很小。對模型大小 的冪律寫成
其中 是保留資料上的交叉熵損失, 是不含嵌入層的參數數量, 是與 同單位的擬合常數, 是擬合指數。取對數得 :斜率為 的直線。
真實曲線會彎曲,因為有一部分損失永遠消不掉(資料本身就有雜訊或歧義)。因此 Hoffmann 等人 [18] 擬合了帶有不可約項的形式:
其中 是訓練 token 數, 是不可約損失, 是擬合常數。對稠密 Transformer,訓練計算量常用的近似是 次浮點運算 [17](每個參數、每個 token,前向約 2 次、反向約 4 次)。固定 ,在 上最小化 (令 ),就得到計算最佳(compute-optimal)的模型大小。Hoffmann 等人訓練了超過 400 個語言模型,結論是:在計算最佳的訓練下,模型大小與訓練 token 數應等比例擴大——模型大小每加倍,token 數也應加倍 [18]。這和 Kaplan 等人較早「用相對適量的資料訓練非常大的模型」的建議不同 [17];這個分歧提醒我們,擬合出的指數取決於實驗流程(學習率排程、納入哪些實驗、計算量怎麼算)。
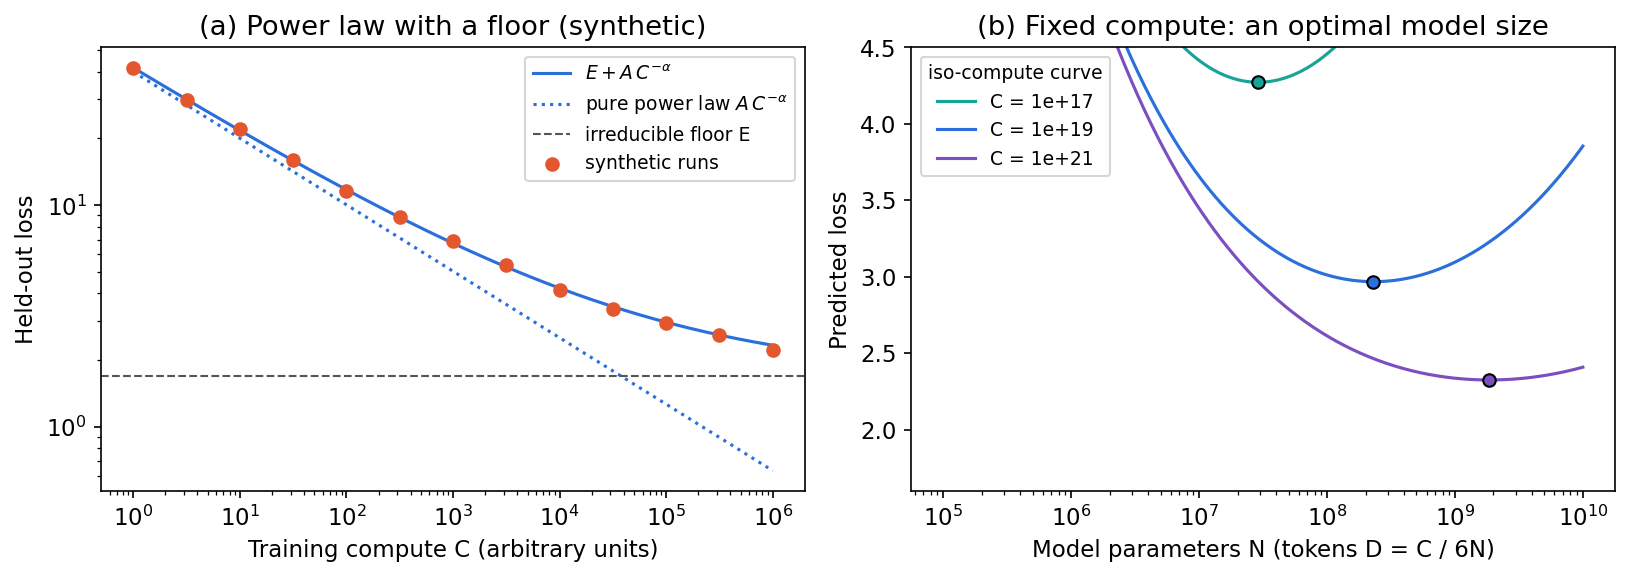
視覺領域也有自己的縮放研究。Zhai 等人 [19] 針對在大型標註資料上訓練的 Vision Transformer [21],刻畫錯誤率、資料量與計算量的關係,並擴大到二十億參數的模型。Cherti 等人 [20] 在公開的 LAION 資料集 [34] 上訓練 CLIP 式模型,發現零樣本分類、檢索、linear probing 與微調都呈冪律縮放——但也發現 OpenAI 的 CLIP 與 OpenCLIP 在架構相同、配方相近的情況下,縮放行為仍不同,因為兩者的訓練資料分布不同。資料不是一個純量。
程式:擬合縮放定律並外插
下面的程式在 13 個合成訓練實驗中,只用較便宜的那幾個擬合 ,再預測昂貴的那幾個。所有資料都是合成的;重點在流程。
程式碼 · Python · 22 行
import numpy as np
from scipy.optimize import curve_fit

rng = np.random.default_rng(0)
# Synthetic "runs": loss = E + A * C^(-alpha), with 2% multiplicative noise.
E_true, A_true, alpha_true = 1.7, 40.0, 0.3
compute = np.logspace(0, 6, 13)            # arbitrary compute units
loss = (E_true + A_true * compute**-alpha_true) * np.exp(.02 * rng.normal(size=13))

def law(c, E, A, alpha):
    return E + A * c**-alpha

# Fit only the cheaper runs, then extrapolate to the larger ones.
small = compute <= 1e4
(E, A, alpha), _ = curve_fit(law, compute[small], loss[small], p0=(1, 10, .5))
print(f"fit: E={E:.2f}  A={A:.1f}  alpha={alpha:.3f}")
for c, l in zip(compute[~small], loss[~small]):
    print(f"C={c:9.0f}  observed {l:.3f}  predicted {law(c, E, A, alpha):.3f}")

# Naive straight line in log-log space ignores the floor E.
slope = np.polyfit(np.log(compute[small]), np.log(loss[small]), 1)[0]
print(f"pure power-law slope without floor: {slope:.3f}")
輸出:擬合得到 、、;外插的損失與含雜訊的觀測值相差約 7% 以內;若在對數–對數空間畫一條不含下限的直線,斜率約為 ,指數是錯的。有兩個教訓可以帶到實務:一定要納入下限;跨越多個數量級的外插應視為帶誤差範圍的預測。
縮放定律沒告訴你的事
- 它預測的是預訓練分布上的平均損失,不是你的任務準確率。下游指標可能平滑改善、飽和,或呈階梯式變化。
- 它只在固定配方與資料分布下成立 [20]。更好的資料過濾或不同的目標都會改變常數。
- 它完全不談推論成本。用更多資料訓練的較小模型,在相同損失下部署可能更便宜,這也是許多上線模型會訓練超過計算最佳點的原因。
- 資料是有限的。高品質資料用完後,不論再加多少計算量, 這一項都不會再縮小。
預訓練目標:目標值從哪裡來?
白話版。 每種預訓練方法都會發明一個預測任務。差別在於「答案」從哪裡來:人工標籤、圖說、同一張影像被遮住的部分、另一個網路,或下一個 token。
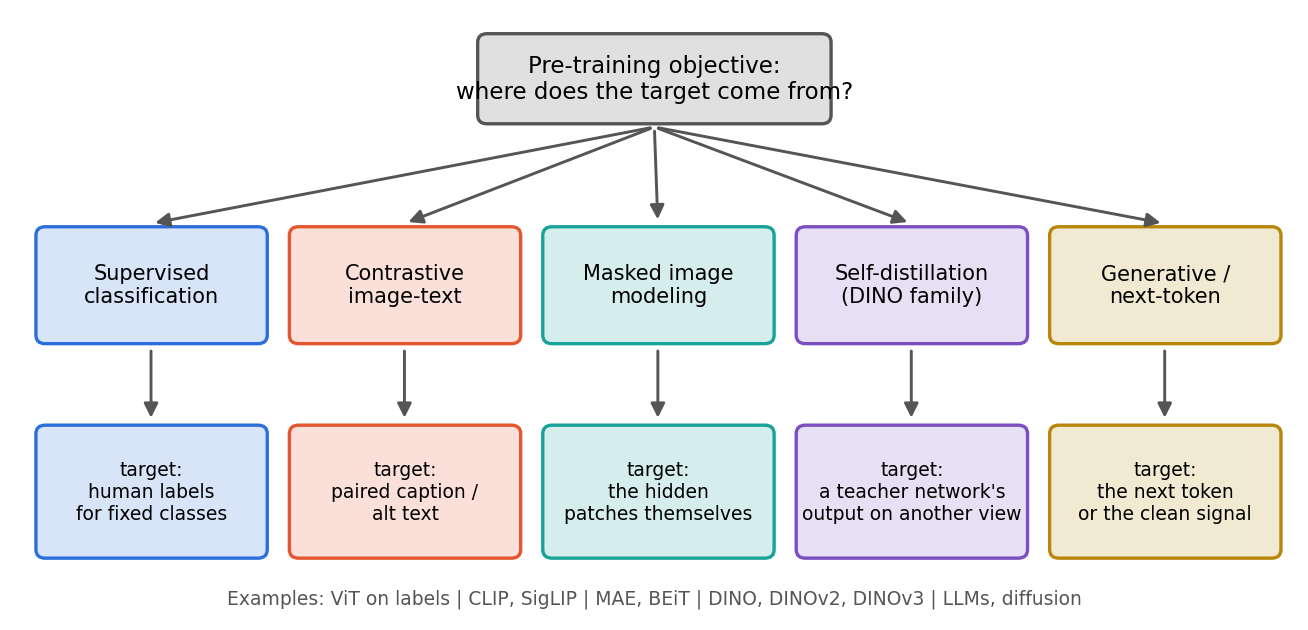
| 目標 | 目標值來源 | 代表模型 | 典型強項 |
|---|---|---|---|
| 監督式分類 | 人工標籤 | 在大型標註資料上訓練的 ViT [19], [21] | 在標籤空間內有強的全域語意 |
| 影像文字對比 | 成對的圖說/alt text | CLIP [3]、ALIGN [25]、SigLIP [4] | 以文字定義的辨識、檢索 |
| 遮罩影像建模 | 同一張影像被遮住的 patch | BEiT [23]、MAE [22] | 微調後很強;保留局部細節 |
| 自蒸餾 | 教師網路在另一個視角上的輸出 | DINO [24]、DINOv2 [15]、DINOv3 [16] | 凍結特徵、密集對應 |
| 生成式/下一個 token | 下一個 token 或乾淨訊號 | LLM、擴散(ML 07)、自迴歸(ML 08) | 生成;語言介面 |
監督式預訓練
在大型標註資料集上用交叉熵訓練分類器,然後拿掉最後一層。這是十年來的 ImageNet 配方,在大規模下仍然有效 [19], [21]。它的弱點是特徵被固定的標籤集合塑形:標籤不需要的區分可能會被丟掉。
影像文字對比學習
網路影像本來就附有圖說,因此 CLIP [3] 與 ALIGN [25] 同時訓練影像編碼器與文字編碼器,讓批次中配對正確的組合分數高於配錯的組合。ALIGN 顯示,只做最少過濾、雜訊很多的大型 alt-text 語料,仍能得到強的表示 [25]。損失函數的細節在下一節。
遮罩影像建模
把影像大部分遮住,再預測缺少的部分。BEiT [23] 遮住 patch 後預測它們的離散視覺 token,借用 BERT [44] 的遮罩語言建模概念。MAE [22] 直接預測原始像素,並觀察到遮住高比例(例如 75%)的 patch 會形成一個不平凡的任務;它的編碼器只看可見的 patch,再由輕量解碼器重建其餘部分,使訓練很有效率。令 為被遮住的 patch 索引集合, 為 patch 的(正規化)像素, 為重建結果,
損失只在被遮住的 patch 上計算:預測可見的 patch 只是複製,沒有意義。遮罩建模的特徵在微調後常常非常好,但作為 linear probe 的凍結特徵時,通常比對比式或自蒸餾的特徵弱。
自蒸餾:DINO 家族
DINO [24]——作者形容為「沒有標籤的自蒸餾」——訓練一個學生網路 ,讓它在同一張影像的不同增強視角(裁切)上去配合教師網路 。兩者都輸出 維分數,再用溫度 與 的 softmax 轉成機率:
其中 與 是兩個視角, 是教師輸出的移動平均(置中,centering),較小的 讓教師分布變得尖銳(銳化,sharpening)。置中避免某一維獨大;銳化避免輸出變成均勻分布;兩者合起來防止崩塌(collapse)——也就是每張影像都對應到相同輸出的平凡解。教師不接收梯度,它的權重是學生權重的指數移動平均(動量編碼器):
DINO 也使用多重裁切(multi-crop)訓練:學生看幾個小的局部裁切,教師看全域裁切,迫使模型學會局部與全域的對應。作者報告,所得到的 ViT 特徵含有明確的物體分割資訊,這在監督式 ViT 或卷積網路中沒有那麼明顯;而且這些特徵很適合作為 k 最近鄰分類器 [24]。
DINOv2 [15] 把這個配方擴大,關鍵是整理資料:用自動化流程建立專門、多樣且經過整理的影像資料集,而不是使用未整理的網路影像;訓練一個 10 億參數的 ViT,再蒸餾成較小的模型。作者報告這些凍結特徵在他們大多數影像層級與像素層級的基準上超越 OpenCLIP [15]。DINOv3 [16] 進一步擴大資料與模型,並提出 Gram anchoring,針對一個已知問題:長時間訓練時,密集(逐 patch)特徵圖的品質會退化。它也加入事後(post-hoc)策略,提升對解析度、模型大小與文字對齊的彈性。
為什麼密集特徵重要。 分類器每張影像只需要一個向量;分割、深度估計、對應與追蹤則需要每個 patch 都有好的向量。自蒸餾編碼器之所以成為這些密集任務常用的凍結骨幹,正是因為它們的 patch 特徵不需要微調就保有語意。
生成式預訓練
預測下一個 token(語言模型、ML 09 中的自迴歸影像模型)或去雜訊(ML 08 的擴散模型)也是預訓練目標。對語言來說,它產生最有彈性的介面——用自然語言下指令——這也是多模態模型把視覺接到預訓練語言模型上,而不是反過來的原因。
影像與文字的共享空間:CLIP 與 SigLIP
白話版。 對齊配對影像與文字嵌入,再依候選描述為影像評分;文字定義分類仍依賴提示及學得的涵蓋範圍。
CLIP [3] 把影像嵌入 與文字嵌入 正規化成單位長度,並以可學習的溫度 形成分數 。對一個含 組配對樣本的批次,
每張影像應在 個圖說中選出配對的那一個(第一項,逐列 softmax),每個圖說也應選出配對的影像(第二項,逐欄)。批次中其他組合都當作負樣本。訓練使用成對的文字監督,通常來自既有的圖說或 alt text;下游的「零樣本」使用並不代表模型訓練時沒有監督。
推論時,把「a photo of a dog」這類候選描述編碼,再與影像比較。文字嵌入取代了學習式分類器的類別權重:
候選集合與措辭都會影響結果;把多個模板(「a photo of a 」「a close-up of a 」)的嵌入平均,是降低敏感度的常見作法。零樣本的意思是在所述流程下沒有針對任務訓練參數;它不保證這些類別、甚至測試影像本身,不曾出現在預訓練資料中(見〈風險與評估〉)。
程式:配對損失與檢索機制
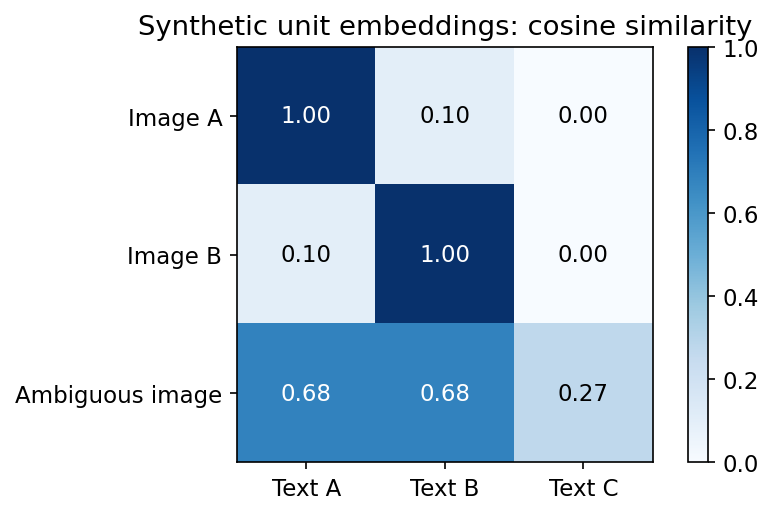
以下是合成嵌入,用來讓計算一目了然。它們不是預訓練模型的輸出,配對結果也不能證明真實世界的零樣本準確率。
程式碼 · Python · 14 行
import torch
from torch.nn import functional as F

images = F.normalize(torch.tensor([[1., .1, 0.], [.1, 1., 0.],
                                   [0., .1, 1.]]), dim=-1)
texts = F.normalize(torch.eye(3), dim=-1)
scores = images @ texts.T / .1
labels = torch.arange(3)
loss = (F.cross_entropy(scores, labels) +
        F.cross_entropy(scores.T, labels))/2
print("matching text:", scores.argmax(1).tolist())
print("paired loss:", round(loss.item(), 4))
ambiguous = F.normalize(torch.tensor([[.5, .5, .2]]), dim=-1)
print("cosines:", (ambiguous @ texts.T).tolist())
它會印出 matching text: [0, 1, 2]、約 0.0002 的配對損失,以及模糊影像約 0.68, 0.68, 0.27 的餘弦值:它與兩個描述一樣接近,任何 softmax 都無法告訴你哪一個才對。
SigLIP:用 sigmoid 取代 softmax
SigLIP [4] 把批次正規化的 softmax 換成對每一組影像文字配對各自做二元判斷。令配對正確時 、否則 ,並有可學習的尺度 與偏差 ,
其中 ,因此每一項等於 。因為沒有任何一項需要對整個批次求和,這個損失不需要跨裝置的全域正規化,讓大批次訓練更簡單。由於正樣本只有 個、負樣本有 個,偏差 的初始值會讓初始預測強烈偏向負類。
共享嵌入支援檢索與開放詞彙辨識,但細粒度計數、否定(「一隻沒有項圈的狗」)、空間關係與罕見的領域詞彙都是已知弱點。這些需求要直接評估,不要從亮眼的整體分類分數推論。
選讀:CLIP(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
提示式分割:Segment Anything 系列
白話版。 提示告訴模型你想要哪個區域或概念,輸出則是遮罩。
SAM [5] 結合一個較重的影像編碼器(每張影像跑一次)、輕量的提示編碼器與輕量的遮罩解碼器,因此同一張影像上的許多提示都能很快回應。空間提示——點、框或粗略遮罩——不需要固定的類別詞彙就能選取物體。因為單次點擊有歧義(點在襯衫上可能指襯衫,也可能指整個人),SAM 會預測幾個候選遮罩並附上信心分數。它在 SA-1B 上訓練:超過 10 億個遮罩、1100 萬張具授權且尊重隱私的影像,透過「模型在迴圈中」的資料引擎蒐集 [5]。
SAM 2 [6] 把提示式分割延伸到影片,加入串流記憶:模型儲存過去影格與被提示物體的特徵,並沿時間傳遞遮罩;在之後影格上的修正點擊會更新記憶。
SAM 3 [7] 於 2025 年發布,報告在 2026 年 3 月修訂,提出提示式概念分割(promptable concept segmentation):給定一個短名詞片語(例如「yellow school bus」)、影像範例或兩者,它會回傳所有符合實例的遮罩與身分。它的影像層級偵測器與基於記憶的影片追蹤器共用一個骨幹,並以 presence head 把「這個概念是否出現」的辨識與「實例在哪裡」的定位分開 [7]。
這些介面提供的資訊不同:空間點說明在哪裡,名詞片語說明是什麼,範例說明長什麼樣子。請報告建立提示的成本,以及提示來自人、真值標註或自動偵測器。用真值框當提示得到的「零樣本分割」分數,其實隱藏了大量的標註資訊。
多模態大型語言模型
白話版。 把視覺特徵轉成語言模型讀得懂的「字」,再教它遵循視覺指令。
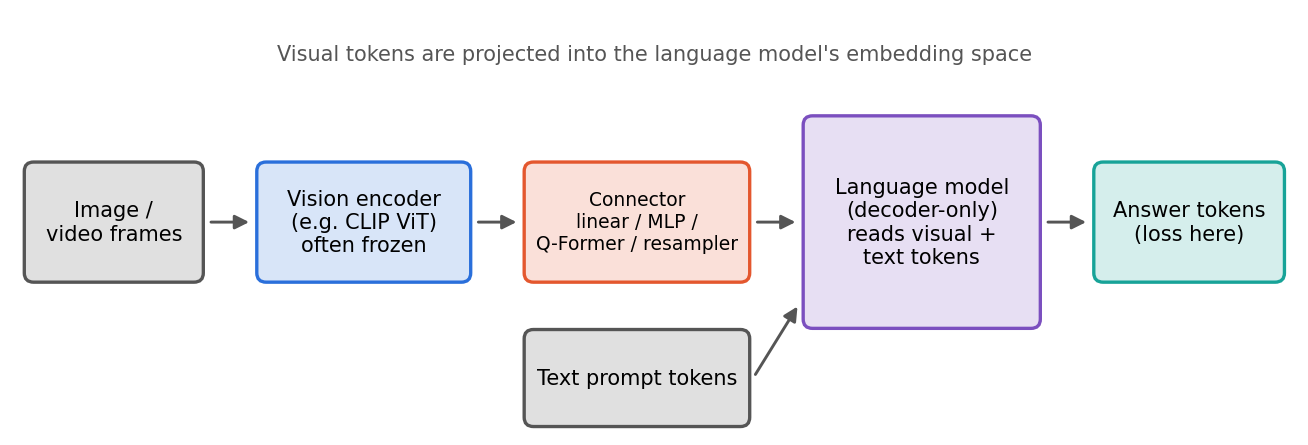
常見的設計是
這裡 是視覺特徵網格(對 ViT 而言,每個 patch 一個向量), 是位於語言模型 token 嵌入空間中的向量序列,解碼器把 當成一般文字的嵌入來處理。
連接器
- 線性或 MLP 投影。 LLaVA [8] 用單一投影把 CLIP 特徵映射到語言模型的嵌入空間;LLaVA-1.5 [28] 報告簡單的 MLP 連接器(搭配 336 像素解析度的 CLIP ViT-L 與學術 VQA 資料)出奇地強大且節省資料。每個 patch 變成一個視覺 token。
- 可學習查詢。 BLIP-2 [26] 在凍結的影像編碼器與凍結的語言模型之間插入輕量的 Querying Transformer(Q-Former)。一組固定的可學習查詢向量對影像特徵做交叉注意力,因此語言模型永遠只看到少量、固定數目的視覺 token。BLIP-2 分兩階段訓練 Q-Former:先對凍結的影像編碼器做表示學習,再對凍結的語言模型做生成學習。
- 重取樣與交叉注意力。 Flamingo [27] 橋接凍結的視覺與語言模型,並能處理任意交錯的影像文字序列,使模型能從直接寫在提示中的範例做少樣本學習。
取捨在於 token 數與細節:每個 patch 一個 token 保留細節,但序列很長(多張影像或影片時很昂貴);少數可學習查詢很便宜,但可能遺失小字。
視覺指令微調
LLaVA [8] 用只處理語言的 GPT-4 [45],根據影像的圖說與框生成多模態指令遵循資料,再分兩階段訓練:先對齊連接器(特徵對齊),再在指令資料上微調連接器與語言模型。損失是一般的下一個 token 交叉熵,只算在答案 token 上:
其中 是文字 token, 是屬於助理回答的位置集合, 是視覺 token。指令與提示 token 作為上下文可見,但不計入損失。
Qwen3-VL 的 2025 年報告 [9] 呈現目前的方向:一系列稠密與混合專家(mixture-of-experts)模型,原生支援最長 256K token 的影像、影片與文字交錯上下文。它是代表性報告,不代表每個任務都會因更長的上下文或更多生成的推理而受益。
示意圖沒畫出的事
閱讀文件可能需要以切塊(tiling)或動態解析度保留小字;影片問題需要時間戳與時間順序。這些細節會改變 token 數與前處理;通用的「視覺編碼器 + LLM」示意圖只是起點。流暢的回答也可能提到影像中根本不存在的物體(物體幻覺),或數錯數量。請區分物體定位、OCR、空間推理、事實問答與風格上的指令遵循——它們需要不同的證據與指標(見〈風險與評估〉)。整個設計空間的綜述可參考 Yin 等人 [40] 與 Caffagni 等人 [2]。
適配基礎模型
白話版。 用能解決目標任務的最便宜適配方式,並在看起來像實際部署的資料上檢查。
| 策略 | 可訓練元件 | 適合的起點 |
|---|---|---|
| 提示/上下文範例 | 無 | 模型介面本來就符合任務 |
| 凍結特徵 + 線性分類頭(linear probe) | 小型監督式讀出層 | 標籤少、特徵遷移良好 |
| Prompt tuning/visual prompt tuning | 少數可學習的輸入 token | 許多任務共用同一個凍結骨幹 |
| Adapter/LoRA | 小型插入模組或低秩模組 | 記憶體有限下的領域適配 |
| 部分微調 | 選定的區塊加分類頭 | 想做一些適配,又不想負擔完整最佳化器成本 |
| 完整微調(可搭配 LP-FT) | 所有模型參數 | 資料與計算足夠;單靠遷移不夠 |
Linear probe
凍結編碼器 ,先算好特徵,再擬合線性分類器 。它便宜、不容易過擬合,也是衡量表示品質的標準量尺:如果線性讀出就能成功,代表資訊在特徵中是線性可取得的。
程式:為什麼預訓練特徵在標籤少時最有幫助
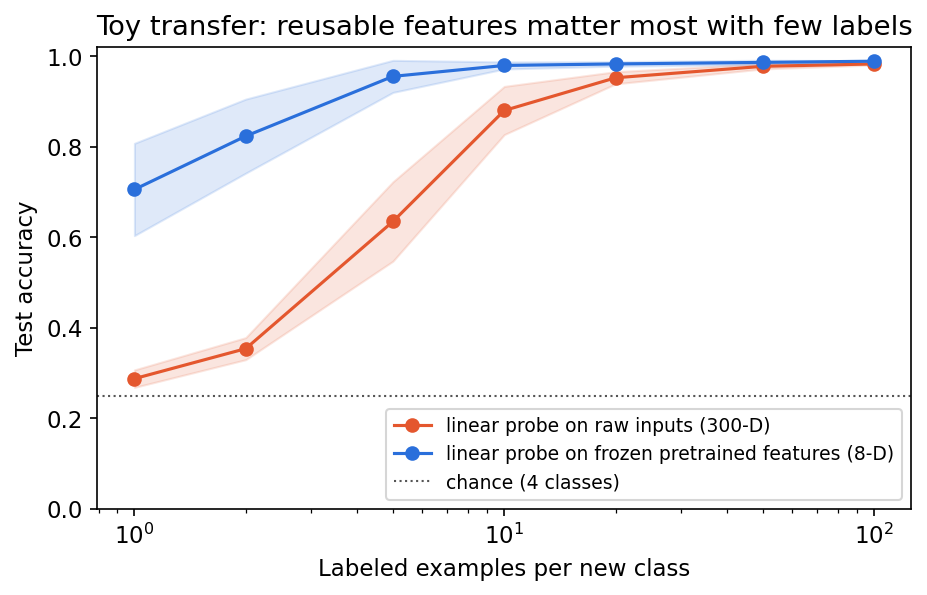
這個玩具實驗模擬整個故事。觀測值是 300 維,混合了 8 個語意因子(決定類別)、8 個很大的干擾因子(想像成光線與姿態)以及雜訊。「預訓練」看到 50 個上游類別,標籤充足,並學到一個 8 維投影(線性判別分析,代替深度編碼器)。下游有四個新類別,每類只有少數標籤。
程式碼 · Python · 35 行
import numpy as np
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.linear_model import LogisticRegression

rng = np.random.default_rng(0)
D, k_sem, k_nui = 300, 8, 8
sem_map = rng.normal(size=(k_sem, D))   # semantic factors -> pixels
nui_map = rng.normal(size=(k_nui, D))   # nuisance factors (light, pose...)

def sample(centers, n):
    y = rng.integers(len(centers), size=n)
    z = centers[y] + 0.7 * rng.normal(size=(n, k_sem))
    u = 4.0 * rng.normal(size=(n, k_nui))          # large nuisance variation
    x = z @ sem_map + u @ nui_map + rng.normal(size=(n, D))
    return x, y

# 1) "Pre-training": many upstream classes with plenty of labels.
up_centers = rng.normal(size=(50, k_sem))
x_up, y_up = sample(up_centers, 10_000)
encoder = LinearDiscriminantAnalysis(n_components=k_sem).fit(x_up, y_up)

# 2) Downstream: four NEW classes, few labels, linear probe only.
new_centers = rng.normal(size=(4, k_sem))
x_te, y_te = sample(new_centers, 2_000)
f_te = encoder.transform(x_te)          # frozen features, computed once
for shots in [1, 5, 20, 100]:
    raw, feat = [], []
    for repeat in range(10):
        x_tr, y_tr = sample(new_centers, 4 * shots)
        raw.append(LogisticRegression(max_iter=3000)
                   .fit(x_tr, y_tr).score(x_te, y_te))
        feat.append(LogisticRegression(max_iter=3000)
                    .fit(encoder.transform(x_tr), y_tr).score(f_te, y_te))
    print(f"{shots:>3} labels/class | raw pixels {np.mean(raw):.3f}"
          f" | frozen features {np.mean(feat):.3f}")
在我們的機器上,它印出的準確率大約是:每類 1 個標籤時 0.29 對 0.71、5 個時 0.62 對 0.95、20 個時 0.96 對 0.99、100 個時 0.98 對 0.99(原始輸入對凍結特徵;隨機猜測為 0.25)。預訓練投影已經丟掉干擾方向,所以少數標籤就夠了;標籤夠多時,原始輸入上的 probe 也會自己學會忽略干擾,差距隨之消失。上游類別與下游類別不同——特徵之所以能遷移,是因為兩者共享相同的語意因子。如果下游任務依賴的正是預訓練丟掉的因子(這裡是干擾因子),那麼不論加多少標籤,凍結特徵都會失敗。這就是實務上要測試的失敗模式。
微調、LP-FT 與穩健微調
完整微調會更新所有權重,資料足夠時通常有最好的分布內準確率。但 Kumar 等人 [32] 指出它可能扭曲好的預訓練特徵:在他們的基準上,微調平均而言分布內準確率較高,分布外準確率卻比 linear probing 低。他們的解釋是,隨機初始化的分類頭在訓練初期把又大又雜的梯度送進骨幹。LP-FT——先擬合 linear probe,再從這個分類頭開始微調全部參數——減少了這種扭曲,並在他們的實驗中勝過兩種單獨作法 [32]。WiSE-FT [33] 走另一條路:在權重空間線性內插零樣本模型與微調模型,,對 CLIP 類模型在分布偏移下提升了穩健性,同時保持強的目標任務準確率。兩者都很便宜,在斷言「微調傷害了穩健性」之前值得先試。
參數高效微調(PEFT)
Adapter [29] 在每個 Transformer 區塊內插入小型瓶頸 MLP,只訓練它們,每個任務只增加少量參數,原網路保持不變。Prompt tuning 學習幾個額外的輸入 token;Visual Prompt Tuning(VPT) [30] 把這個作法用在 ViT 上,在凍結骨幹的 patch 序列前面加上可學習的 token。Xu 等人 [42] 綜覽 PEFT,提出加法式(additive)、部分(partial)、重參數化(reparameterized)、混合(hybrid)與統一(unified)微調的分類,並實驗比較參數與記憶體效率。
LoRA [10] 把凍結權重 的更新重參數化為
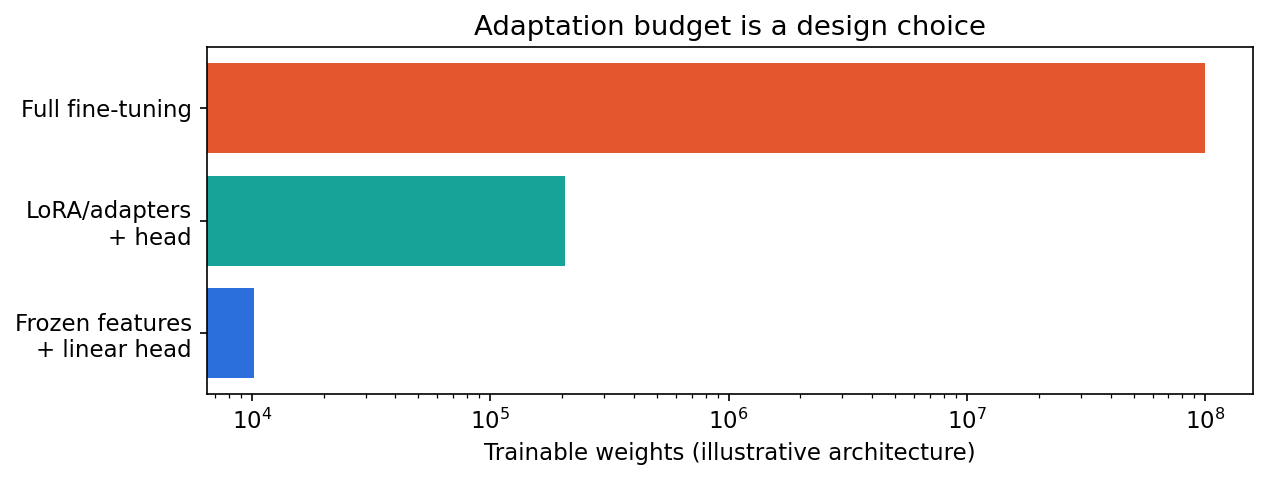
其中秩 , 是縮放常數。凍結 ,只學 。可訓練權重從 降到 。把 初始化為 0,使初始更新為零; 隨機初始化,學習才能開始。訓練後 可以合併回 ,因此推論不增加成本。QLoRA [31] 以 4 位元精度儲存凍結的基礎權重,並穿過它們反向傳播到 LoRA adapter,大幅減少記憶體,讓非常大的模型也能在單張 GPU 上微調。
程式:凍結基礎權重上的低秩更新
這個獨立範例在合成輸入上訓練一步 adapter。它展示參數化方式與初始行為,並沒有重現完整的預訓練模型微調流程。
程式碼 · Python · 24 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
class LoRALinear(nn.Module):
    def __init__(self, din, dout, rank=4, alpha=4):
        super().__init__()
        self.base = nn.Linear(din, dout, bias=False)
        self.base.weight.requires_grad_(False)
        self.A = nn.Parameter(torch.randn(rank, din) * .02)
        self.B = nn.Parameter(torch.zeros(dout, rank))
        self.scale = alpha/rank
    def forward(self, x):
        return self.base(x) + self.scale * F.linear(F.linear(x, self.A), self.B)

layer = LoRALinear(32, 16)
x = torch.randn(8, 32)
assert torch.allclose(layer(x), layer.base(x))
opt = torch.optim.Adam([layer.A, layer.B], lr=.01)
loss = F.mse_loss(layer(x), torch.randn(8, 16))
opt.zero_grad(); loss.backward(); opt.step()
assert layer.base.weight.grad is None
print("trainable:", sum(p.numel() for p in layer.parameters() if p.requires_grad))
它印出 trainable: 192,也就是 ,完整矩陣則是 512。第一個 assertion 檢查初始化為零的 在一開始不改變模型;第二個檢查凍結的基礎權重沒有收到梯度。
LoRA 是一種參數化方式,不保證不會過擬合或遺忘。Adapter 仍需要領域驗證。凍結的 BatchNorm 統計量、影像正規化、輸出標籤對應,以及各 checkpoint 特有的前處理,也都需要刻意處理。
提示與上下文學習
最便宜的適配不改任何權重:為 CLIP 寫更好的文字提示、給 SAM 一個框,或像 Flamingo 那樣把幾個已解好的範例放進多模態模型的上下文 [27]。Zhang 等人的視覺語言綜述 [41] 比較了提示、特徵適配與微調在各種視覺任務上的表現。提示迭代很快,但很脆弱:措辭稍微改變就可能影響結果,因此要固定並報告提示流程。
影片、幾何與世界模型
白話版。 除了辨認單一影格,模型還可以預測隨時間的變化、推論三維結構,或支援動作規劃。
V-JEPA 2 [11] 研究在特徵空間(而非像素空間)做預測的自監督影片模型,並以條件於動作的延伸版本進行規劃。VGGT [12] 以一次前饋,從一個或多個視角預測相機參數、深度、點雲圖(point maps)與軌跡。它們代表超越分類的兩條路:時間狀態建模與幾何推論。
看起來逼真的生成影片不一定遵守物理限制;場景重建即使不產生寫實像素也可能很有用。請依所宣稱的能力,量測多視角一致性、幾何、條件於動作的結果與時間行為。DLCV 13・世界模型 會更詳細地討論部分可觀測性、學習動態與規劃。
風險與評估
白話版。 廣泛預訓練可能把資料偏差、無根據預測及測試集重疊帶入評估;這些問題須與整體基準表現分開檢查。
資料來源、偏誤與隱私
網路規模的影像文字資料集大到無法人工檢查。LAION-5B [34] 公開了這樣的資料集(58.5 億組經 CLIP 過濾的配對),因而促成 OpenCLIP 這類開放重現 [20];Birhane 等人 [35] 對其前身 LAION-400M 的稽核,則記錄了影像文字配對中露骨與刻板印象的內容。下游系統會繼承這些關聯。授權與同意也很重要:訓練資料、模型權重與生成輸出可能各有不同條款;個人資料(人臉、姓名、醫療影像)帶來的隱私義務,不會因為資料是公開的就消失。SAM 的 SA-1B 是一個在說明中強調具授權且尊重隱私影像的資料集例子 [5];部署每個模型時都應記錄這類性質。
幻覺
多模態 LLM 可能提到影像中不存在的物體。POPE [37] 以輪詢方式衡量物體幻覺:針對特定物體是否存在提出是非題(包括常見物體與經常共同出現的干擾物體),使量測比評分自由生成的描述更不受模型生成風格影響。POPE 錯誤率低並不涵蓋計數、屬性或關係;這些要另外測試。
污染與「零樣本」
如果基準影像(或近似重複的影像)在預訓練資料中,「零樣本」分數有一部分其實是在測記憶。Mayilvahanan 等人 [36] 探討 CLIP 的泛化是否主要來自訓練與測試的高相似度:他們把 LAION 中與常見分布外基準太相似的影像剪除後重新訓練,部分基準的表現下降,但整體仍然很強。教訓是雙向的:相似度解釋了一部分報告的表現,但不是全部——所以要實際量測,不要預設任何一方。實務檢查包括:把測試集與可取得的訓練資料做去重複、在模型資料截止日期之後蒐集的資料上報告結果,並完整說明零樣本流程(類別名稱、模板、候選集合)。
基準
MMMU [38] 這類綜合性多模態基準——從考試、測驗與教科書蒐集 11.5K 個大學程度問題,橫跨六大學科,包含圖表、示意圖、地圖、表格等多種影像——測試知識與推理,但單一數字混合了感知、OCR、領域知識與答案格式。部署時,請建立一個小型、針對任務的評估集並納入已知的失敗案例,報告不同隨機種子或提示措辭下的變異,並與簡單基準比較(凍結特徵上的 linear probe 常常強得令人意外)。ML 11・評估與部署 會深入討論校準、資料切分與部署。
現代觀點
值得閱讀的綜述。
- Bommasani 等人 [1]——為基礎模型命名的報告。內容涵蓋能力(語言、視覺、機器人、推理)、應用(法律、醫療、教育)、技術(建模、訓練、適配、評估、資料)與社會影響。它的核心觀點——湧現、同質化與被繼承的失敗——至今仍是這個領域的框架。
- Awais 等人 [39]——電腦視覺綜述,依架構設計、訓練目標(對比式與生成式)、資料集、微調機制與提示方式整理基礎模型,並列出評估、實際應用、對抗穩健性與可解釋性等開放挑戰。
- Zhang 等人 [41]——TPAMI 上關於視覺任務的視覺語言模型綜述:網路架構、預訓練目標、下游任務、資料集、遷移學習與知識蒸餾,並對所回顧的方法做基準比較。
- Yin 等人 [40] 與 Caffagni 等人 [2]——多模態大型語言模型綜述:架構(編碼器、連接器、LLM)、訓練策略與資料(預訓練、指令微調、對齊)、評估與幻覺。
- Han 等人 [13]——把地圖擴展到多模態生成模型的綜述,依生成類別與技術組織。
- Xu 等人 [42]——參數高效微調的批判性回顧,把方法分成加法式、部分、重參數化、混合與統一五個家族,並實驗比較代表性方法。
2023–2026 年的現況。 有四個趨勢特別明顯。(1) 更好的凍結特徵:DINOv2 [15] 與 DINOv3 [16] 讓自監督編碼器強到許多密集任務直接從凍結的 patch 特徵開始。(2) 概念層級的提示:分割從「點一個物體」(SAM [5])走到影片記憶(SAM 2 [6]),再到「分割這個片語的每一個實例」(SAM 3 [7])。(3) 長且交錯的多模態上下文:Qwen3-VL [9] 等模型可同時讀取多張影像、影片與文字。(4) 超越辨識:用於規劃的影片預測(V-JEPA 2 [11])與前饋式幾何(VGGT [12])把基礎模型當成世界與場景的估計器。
開放問題。
- 有依據的可靠性:減少幻覺,並讓模型在適當時候說出「看不到」[37]。
- 在污染與基準飽和下做誠實的評估 [36]。
- 資料:把整理資料當成一個縮放軸 [15], [20],以及來源、授權與同意 [34], [35]。
- 有效率的適配與推論:高解析度影像與影片的 token 預算;能保留穩健性的 PEFT [32], [33]。
- 讓密集、三維與時間理解達到影像層級模型的語意水準。
面對任何新的「基礎」模型,請記錄它的輸入/輸出介面、訓練目標、資料來源、支援的適配方式、checkpoint 授權、前處理與任務層級的評估。這能避免把模型大小或開放式聊天介面當成具備通用能力的證據。
重點整理
- 基礎模型結合廣泛預訓練與重用,不限定單一架構,也不必生成文字。
- 縮放法則是依資料、目標與訓練配方擬合的經驗關係,外推需要驗證。
- 預訓練目標塑造能力,但不單獨決定下游表現。
- 影像—文字相似度支援檢索與文字定義類別,但相似度不是校準後的信心。
- 視覺提示與連接器控制資訊存取,應交代提示建構方式與影像解析度限制。
- 先建立低成本調適基準,再檢查較強方法的增益、成本、轉移敏感度、幻覺與資料污染。
練習
- 候選集合的影響。 在合成 CLIP 範例中加入第四個描述。影像不變時,softmax 的「信心」會不會改變?
提示
會:softmax 的分母改變了。影像與某個固定描述的相似度不變,但正規化後的機率取決於候選集合。試著加入一個與模糊影像嵌入很接近的文字向量。
- 計算最佳配置。 利用參數化定律 與 ,證明最佳模型大小的成長為 。 代表什麼?
提示
代入 ,對 微分並令其為零:。解得 。當 時,,因此 :參數與 token 等比例擴大,與 Hoffmann 等人的結論一致。
- 讓遷移失效。 在 linear probe 實驗中,讓下游類別取決於干擾因子而非語意因子。隨著標籤增加,凍結特徵上的 probe 會怎樣?這對選擇基礎模型有什麼啟示?
提示
改為對 u 抽類別中心,而不是 z。凍結的 8 維特徵被訓練成丟掉干擾方向,所以不論加多少標籤都接近隨機猜測,而原始輸入上的 probe 會進步。骨幹只有在預訓練保留了你的任務所需資訊時才有用——投入適配之前,先用 linear probe 檢查。
- LoRA 預算。 一個 ViT-B 區塊有四個 的注意力投影,以及兩個大小分別為 與 的 MLP 矩陣。計算這六個矩陣完整微調與全部使用 rank-8 LoRA 時的可訓練權重數。
提示
完整:。LoRA:,約為完整數量的 1.6%。
- 提示的公平性。 設計一個能把遮罩品質與提示品質分開的 SAM 評估。
提示
固定提示流程並計算人工互動次數。把自動提議與使用理想真值提示得到的遮罩分開評估,兩者都要報告。對 SAM 3,在同一批影像上比較名詞片語提示與範例提示。
- 污染稽核。 有一個新的影像文字模型宣稱在某個公開基準上有很高的零樣本準確率。在相信這個數字之前,列出你會做的三項檢查。
提示
(a) 以嵌入相似度等方式,在可取得的訓練資料中搜尋測試影像的近似重複;(b) 在資料截止日期之後新蒐集的資料上評估;(c) 檢查對提示模板與候選類別清單的敏感度;也可以與 linear probe 及簡單基準比較。
參考文獻
- R. Bommasani et al., “On the Opportunities and Risks of Foundation Models,” Stanford CRFM report, arXiv:2108.07258, 2021; revised 2022. arXiv
- D. Caffagni et al., “The Revolution of Multimodal Large Language Models: A Survey,” Findings of ACL, 2024. arXiv
- A. Radford et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML, 2021. arXiv
- X. Zhai, B. Mustafa, A. Kolesnikov and L. Beyer, “Sigmoid Loss for Language Image Pre-Training,” ICCV, 2023. arXiv
- A. Kirillov et al., “Segment Anything,” ICCV, 2023. arXiv
- N. Ravi et al., “SAM 2: Segment Anything in Images and Videos,” ICLR, 2025. arXiv
- N. Carion et al., “SAM 3: Segment Anything with Concepts,” arXiv:2511.16719, 2025; revised March 2026. arXiv
- H. Liu, C. Li, Q. Wu and Y. J. Lee, “Visual Instruction Tuning,” NeurIPS, 2023. arXiv
- S. Bai et al., “Qwen3-VL Technical Report,” arXiv:2511.21631, 2025. arXiv
- E. J. Hu et al., “LoRA: Low-Rank Adaptation of Large Language Models,” ICLR, 2022. arXiv
- M. Assran et al., “V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning,” arXiv:2506.09985, 2025. arXiv
- J. Wang et al., “VGGT: Visual Geometry Grounded Transformer,” CVPR, 2025. arXiv
- L. Han et al., “A Survey of Generative Categories and Techniques in Multimodal Generative Models,” arXiv:2506.10016, 2025. arXiv
- C. M. Bishop and H. Bishop, Deep Learning: Foundations and Concepts, Springer, 2024. Book
- M. Oquab et al., “DINOv2: Learning Robust Visual Features without Supervision,” Transactions on Machine Learning Research, 2024. arXiv
- O. Siméoni et al., “DINOv3,” arXiv:2508.10104, 2025. arXiv
- J. Kaplan et al., “Scaling Laws for Neural Language Models,” arXiv:2001.08361, 2020. arXiv
- J. Hoffmann et al., “Training Compute-Optimal Large Language Models,” arXiv:2203.15556, 2022; published as “An empirical analysis of compute-optimal large language model training,” NeurIPS, 2022. arXiv
- X. Zhai, A. Kolesnikov, N. Houlsby and L. Beyer, “Scaling Vision Transformers,” CVPR, 2022. arXiv
- M. Cherti et al., “Reproducible Scaling Laws for Contrastive Language-Image Learning,” CVPR, 2023. arXiv
- A. Dosovitskiy et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” ICLR, 2021. arXiv
- K. He, X. Chen, S. Xie, Y. Li, P. Dollár and R. Girshick, “Masked Autoencoders Are Scalable Vision Learners,” CVPR, 2022. arXiv
- H. Bao, L. Dong, S. Piao and F. Wei, “BEiT: BERT Pre-Training of Image Transformers,” ICLR, 2022. arXiv
- M. Caron et al., “Emerging Properties in Self-Supervised Vision Transformers,” ICCV, 2021. arXiv
- C. Jia et al., “Scaling Up Visual and Vision-Language Representation Learning With Noisy Text Supervision,” ICML, 2021. arXiv
- J. Li, D. Li, S. Savarese and S. Hoi, “BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models,” ICML, 2023. PMLR
- J.-B. Alayrac et al., “Flamingo: a Visual Language Model for Few-Shot Learning,” NeurIPS, 2022. arXiv
- H. Liu, C. Li, Y. Li and Y. J. Lee, “Improved Baselines with Visual Instruction Tuning,” CVPR, 2024. arXiv
- N. Houlsby et al., “Parameter-Efficient Transfer Learning for NLP,” ICML, 2019. PMLR
- M. Jia et al., “Visual Prompt Tuning,” ECCV, 2022. arXiv
- T. Dettmers, A. Pagnoni, A. Holtzman and L. Zettlemoyer, “QLoRA: Efficient Finetuning of Quantized LLMs,” NeurIPS, 2023. arXiv
- A. Kumar, A. Raghunathan, R. Jones, T. Ma and P. Liang, “Fine-Tuning can Distort Pretrained Features and Underperform Out-of-Distribution,” ICLR, 2022. arXiv
- M. Wortsman et al., “Robust Fine-Tuning of Zero-Shot Models,” CVPR, 2022. arXiv
- C. Schuhmann et al., “LAION-5B: An Open Large-Scale Dataset for Training Next Generation Image-Text Models,” NeurIPS Datasets and Benchmarks Track, 2022. arXiv
- A. Birhane, V. U. Prabhu and E. Kahembwe, “Multimodal Datasets: Misogyny, Pornography, and Malignant Stereotypes,” arXiv:2110.01963, 2021. arXiv
- P. Mayilvahanan, T. Wiedemer, E. Rusak, M. Bethge and W. Brendel, “Does CLIP’s Generalization Performance Mainly Stem from High Train-Test Similarity?,” ICLR, 2024. arXiv
- Y. Li et al., “Evaluating Object Hallucination in Large Vision-Language Models,” EMNLP, 2023. arXiv
- X. Yue et al., “MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark for Expert AGI,” CVPR, 2024. arXiv
- M. Awais et al., “Foundational Models Defining a New Era in Vision: A Survey and Outlook,” arXiv:2307.13721, 2023. arXiv
- S. Yin et al., “A Survey on Multimodal Large Language Models,” National Science Review, 2024. arXiv
- J. Zhang, J. Huang, S. Jin and S. Lu, “Vision-Language Models for Vision Tasks: A Survey,” IEEE TPAMI, vol. 46, no. 8, 2024. arXiv
- L. Xu et al., “Parameter-Efficient Fine-Tuning Methods for Pretrained Language Models: A Critical Review and Assessment,” arXiv:2312.12148, 2023. arXiv
- J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li and L. Fei-Fei, “ImageNet: A Large-Scale Hierarchical Image Database,” CVPR, 2009, pp. 248–255. doi
- J. Devlin, M.-W. Chang, K. Lee and K. Toutanova, “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,” NAACL-HLT, 2019, pp. 4171–4186. doi
- OpenAI, “GPT-4 Technical Report,” arXiv:2303.08774, 2023. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 11・評估、效率與部署 · 28 分鐘