ML 06・表示學習與自監督
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 定義有用的表示與依任務而定的不變性。
- 透過最近鄰、線性探測或微調重用特徵。
- 比較對比、教師—學生、遮罩與特徵預測目標。
- 說明表示崩塌,以及抑制崩塌的機制。
- 在明確協定下評估遷移與影像—文字對齊。
先看全貌
假設你有一百萬張沒有標記的影像,但真正關心的任務只有 500 個標記樣本。只用這 500 個樣本從頭訓練一個大型網路,等於把幾乎所有可用的資料都丟掉了。表示學習把工作拆成兩步。第一步,從一個不需要你的標記的廣泛訊號學出編碼器 。第二步,用手上少量的標記,在 之上訓練一個小型的任務頭(head)。
為什麼重要:幾乎所有現代視覺系統都從一個預訓練的編碼器出發。影像分類器、物件偵測器、分割模型、影像–文字模型,以及生成模型裡的影像編碼器,都建立在用這種方式學到的表示之上。起點的好壞,往往比任務頭的細節更重要。
本章先談什麼是表示、為什麼遷移有效,接著逐一介紹實務上主流的自監督目標,最後討論如何衡量一個表示到底好不好。本章假設你已經熟悉神經網路(ML 02)、CNN(ML 03)與 Vision Transformer(ML 05)。線性因子模型與自編碼器是學習表示的古典路線,另有專章:ML 06A。
什麼是表示?
白話版。 表示就是模型用來描述一個輸入的那串數字。好的表示讓你關心的東西容易讀出來,並把你不關心的東西藏起來。
精確版。 編碼器是一個函數 ,把輸入 (這裡是影像)對應到特徵向量 ,其中 是可學習的參數, 是特徵維度。任務頭 把 對應到預測,所以完整模型是 。如果一個簡單的任務頭(例如線性分類器)只用少量標記樣本就能從 解決任務,我們就說 是這個任務的好表示。Bengio、Courville 與 Vincent 的綜述 [1] 是這個觀點的經典陳述;它列出讓表示有用的「先驗」(priors),例如平滑性、多個解釋因子、由淺到深逐漸抽象的特徵階層,以及跨任務共享的因子。
局部表示與分散式表示
類別最簡單的表示是 one-hot:每個概念一個單元,且恰好只有一個單元是開啟的。它容易讀,卻無法泛化。知道「紅色汽車」完全不會告訴你任何關於「紅色卡車」的事,因為它們沒有共同的開啟單元。分散式表示則用許多特徵來描述每個輸入,而每個特徵又被許多輸入共享:「紅」、「藍」、「汽車」、「卡車」。於是「紅色卡車」就能重複使用從紅色汽車學來的「紅」這個單元。
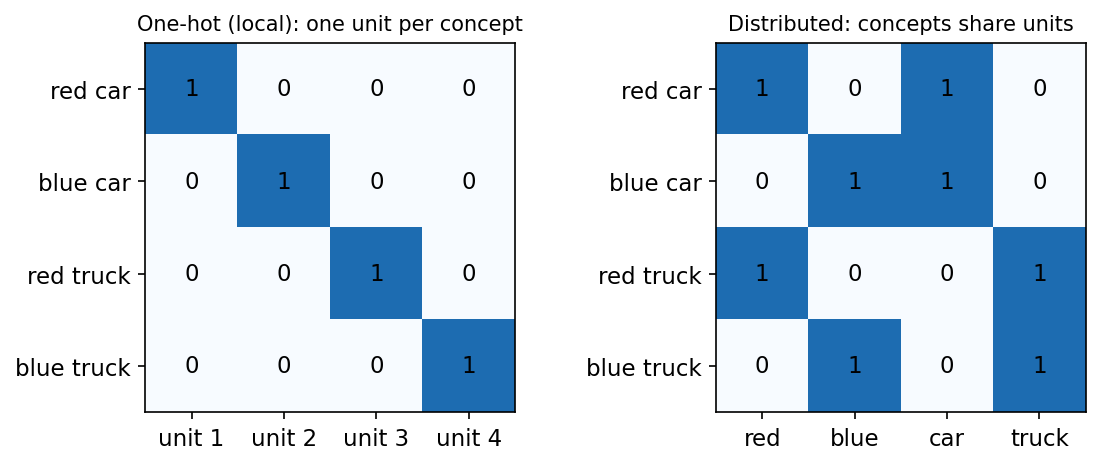
計數論證很驚人。用 個二元特徵,one-hot 編碼只能分辨 個概念,而分散式編碼原則上能分辨 種組態 [1]。深度網路會自動學出分散式編碼:每個隱藏單元對許多輸入有反應,每個輸入也會啟動許多單元。表示學習大部分的實際價值都來自這種共享。
不變性與等變性
有用的表示會保留與任務相關的差異,並壓抑會造成干擾的差異。
- 若 ,特徵就對轉換 具有不變性(invariance):把一隻貓平移兩個像素,不應該改變「這是一隻貓」。
- 若 ,特徵就具有等變性(equivariance),也就是以可預測的方式跟著改變:平移那隻貓,牠的分割遮罩也應該平移同樣的距離。
「有用」永遠取決於下游任務。顏色不變性有助於物體辨識,卻會傷害水果成熟度的估計。旋轉不變性對紋理有幫助,卻會搞混 6 和 9。密集預測(分割、深度)需要空間上等變的區塊(patch)特徵,而不是每張影像一個不變的向量。後面會看到,自監督目標主要是透過所使用的資料增強(data augmentation)來選擇不變性,所以這個選擇是建模決策,而不是細節。
學習距離:度量學習
PCA 在 ML 01 介紹過,並在 ML 06A 深入討論,它保留變異最大的方向。但變異大的方向可能來自光照,而不是物體身分。監督學習依照標記來塑造特徵;度量學習(metric learning)則依照應該配對的樣本來塑造距離。給定錨點(anchor)、正例 (同一身分)與負例 (不同身分),三元組損失(triplet loss)是
其中 是三個特徵向量, 是邊界(margin)。當正例比負例近至少 時,損失為零。太容易的負例損失為零,什麼也學不到,所以挑選有資訊量的(「困難的」)負例很重要。下面的對比式自監督學習,就是一種用資料增強而不是標記來產生正例的度量學習。
遷移學習:預訓練一次,重複使用很多次
白話版。 在一個大任務上訓練網路,保留它的特徵擷取器,再拿去用在小任務上。你可以凍結特徵、只訓練新的任務頭,也可以讓整個網路繼續學習。
精確版。 預訓練在來源資料集或目標上找出編碼器參數 。遷移到一個有標記集合 的目標任務時,有三種常見做法:
- 最近鄰(-NN): 不訓練。用測試特徵 最相似的 個訓練特徵的標記來分類。
- 線性探測: 凍結 ,在 上擬合線性分類器 ,其中 與 是唯一被訓練的參數。
- 微調: 從 出發,連同任務頭一起更新編碼器,通常使用較小的學習率。
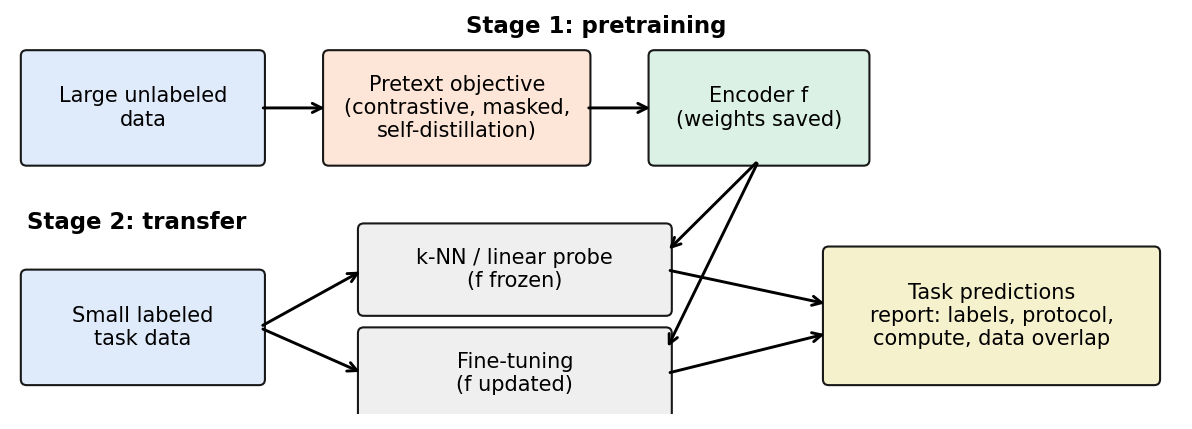
遷移為什麼會有效?Yosinski 等人 [2] 在 ImageNet 訓練的 CNN 上逐層量測。第一層特徵(很像 Gabor 濾波器的邊緣與顏色偵測器)是通用的:在任務之間遷移得很好。越高層的特徵越專屬於來源任務,而且來源任務與目標任務差異越大,可遷移性就越低。他們也發現,從遷移來的特徵初始化再微調,即使在目標任務上,也比從隨機初始化訓練有更好的泛化。
多年來,預訓練的預設來源是有監督的 ImageNet 分類。可是標記很昂貴,而且像「狗」這樣的標記,完全沒有告訴網路那隻狗的姿勢、草地或光線。自監督學習讓資料自己監督自己,移除了標記的瓶頸。
自監督學習:讓資料自己產生標記
白話版。 從資料建立預測目標,例如匹配兩個視圖或恢復遮罩內容;學得的特徵能否遷移,仍須測試。
精確版。 自監督目標是只從無標記輸入(或像影像–圖說這種天然配對的資料)計算出來的損失 。Liu 等人 [3] 與 Gui 等人 [4] 的綜述,以及 Balestriero 等人實用的「食譜」[5],把這個領域整理成下表的幾個家族:
| 家族 | 訓練訊號 | 代表方法 | 主要風險 |
|---|---|---|---|
| 對比式 | 拉近正配對,推開其他樣本 | SimCLR、MoCo | 需要大量負例;假負例 |
| 自蒸餾(無負例) | 學生在另一個視圖上模仿教師 | BYOL、SimSiam、DINO | 缺少不對稱或中心化時會塌縮 |
| 冗餘抑制 | 一致性加上去相關、非常數的特徵維度 | Barlow Twins、VICReg | 正則項帶來額外超參數 |
| 遮罩建模 | 預測被遮住的像素或符元 | BEiT、MAE | 特徵可能偏重低階細節 |
| 特徵預測 | 預測被遮住區域的特徵 | I-JEPA、V-JEPA 2 | 需要像蒸餾一樣的防塌縮設計 |
| 語言監督 | 讓影像與其圖說配對 | CLIP、SigLIP | 繼承網路資料的偏誤與雜訊 |
這些家族是學習目標,而不是架構:每一種都可以用來訓練 CNN 或 Transformer。現代系統常常結合好幾種。以下逐一介紹。
對比式學習與 InfoNCE 損失
白話版。 讓同一張影像的兩個增強版本彼此一致,並且和批次中其他所有影像不一致。這是一道選擇題:「在這 個候選中,哪一個是我的搭檔?」
InfoNCE
van den Oord、Li 與 Vinyals 在對比預測編碼(Contrastive Predictive Coding, CPC)[6] 中提出 InfoNCE 損失。取一個查詢 、一個「屬於」它的正例鍵 ,以及 個負例鍵 。給定相似度分數 與溫度 ,
這正是一個 類分類問題的 softmax 交叉熵,正確類別就是正例。由此得到兩個結果。
- 互資訊的下界。 CPC 證明 ,其中 是互資訊(mutual information)。最小化損失會提高這個下界,而負例越多( 越大)下界可以越高。實務上這個界很鬆,特徵品質也高度依賴編碼器與資料增強,所以請把它當成動機,而不是特徵為什麼好的解釋。
- 溫度控制難度。 除以較小的 會讓 softmax 更尖銳,使損失集中在與查詢最相似的負例(困難負例)上。
SimCLR
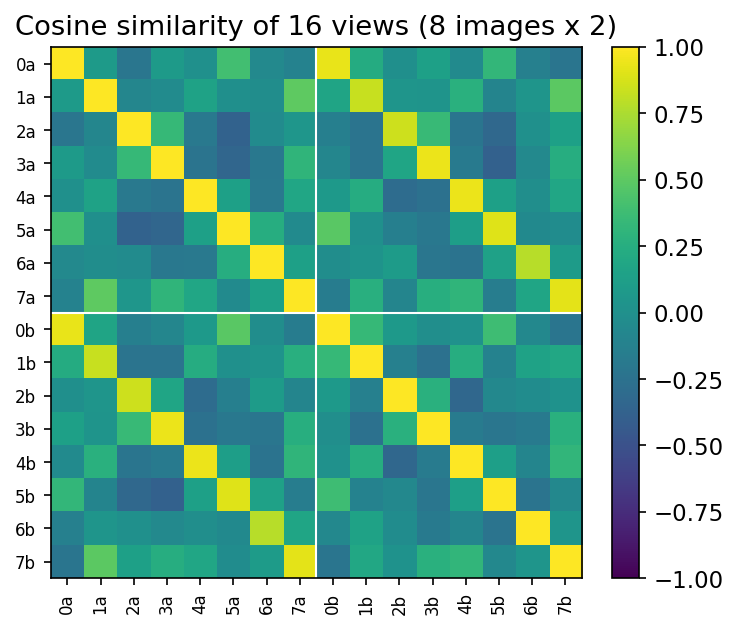
SimCLR [7] 是最簡單形式的 InfoNCE。取一批 張影像,各產生兩個增強視圖(隨機裁切並縮放、顏色扭曲、模糊),共 個視圖。骨幹網路 把每個視圖對應到 ,一個小型 MLP 投影頭(projection head) 再把 對應到 ,相似度用餘弦相似度 。對於搭檔為 的視圖 ,
其中 已經做過 正規化,總和遍及其他所有 個視圖。批次裡其他每張影像都是負例,因此不需要記憶庫,但這個方法受益於大批次。總損失對每個正配對的兩種順序取 的平均;論文稱之為 NT-Xent 損失(normalized temperature-scaled cross-entropy)。
SimCLR 論文有三個值得記住的發現 [7]。資料增強的組合非常重要,其中隨機裁切加上顏色扭曲特別關鍵。投影頭有幫助:投影頭之前的特徵()比之後的()更能遷移,所以預訓練後會丟掉投影頭。而且對比式學習比監督學習更受益於大批次與更長的訓練。
程式:檢查損失與塌縮時的值
這段獨立的 PyTorch 範例用合成的配對向量驗證損失、自身遮罩與梯度。它不訓練編碼器。
程式碼 · Python · 23 行
import torch
from torch.nn import functional as F

torch.manual_seed(0)
B, D = 8, 16
base = torch.randn(B, D)
views = torch.cat([base + .1*torch.randn_like(base),
                   base + .1*torch.randn_like(base)]).requires_grad_()
z = F.normalize(views, dim=-1)
logits = z @ z.T / .2
self_mask = torch.eye(2*B, dtype=torch.bool)
logits = logits.masked_fill(self_mask, float("-inf"))
positive = (torch.arange(2*B) + B) % (2*B)
loss = F.cross_entropy(logits, positive)
loss.backward()
assert torch.isfinite(views.grad).all()
print("paired loss:", round(loss.item(), 4))

collapsed = F.normalize(torch.ones(2*B, D), dim=-1)
scores = (collapsed @ collapsed.T / .2).masked_fill(self_mask, float("-inf"))
collapsed_loss = F.cross_entropy(scores, positive)
print("collapsed loss:", round(collapsed_loss.item(), 4))
print("expected:", round(torch.log(torch.tensor(2*B-1.)).item(), 4))
它印出配對損失 0.1423 與塌縮損失 2.7081,正好等於 。如果所有表示都相同,正例得到的機率是 ,損失就是 ,也就是均勻亂猜的最差值。因此對比式的鑑別讓完全塌縮成為一個很差的解,雖然最佳化與負例選擇仍然可能很困難。
MoCo:負例佇列與動量編碼器
InfoNCE 偏好大量負例,但 SimCLR 只能從當前批次取得負例。動量對比(Momentum Contrast, MoCo)[8] 用兩個想法把負例數量和批次大小脫鉤。
- 佇列。 最近幾個批次編碼出來的鍵被存進長度為 的先進先出佇列,重複當作負例使用。無論批次多小,查詢都能看到 個負例。
- 動量編碼器。 佇列裡的鍵是由稍早版本的網路產生的。如果鍵編碼器變化太快,新舊鍵就會不一致。因此 MoCo 用另一個編碼器計算鍵,它的參數 緩慢地跟隨查詢編碼器的參數 :
其中 是動量,接近 1(論文預設 0.999)。只有 接收梯度。這種指數移動平均(exponential moving average, EMA)教師的想法,在 BYOL、DINO 與 JEPA 中都會再次出現。
程式碼 · Python · 21 行
import torch
from torch.nn import functional as F

torch.manual_seed(0)
B, D, K = 8, 16, 32          # batch, embedding size, queue length

# --- MoCo-style InfoNCE: one positive key per query, negatives from a queue
q = F.normalize(torch.randn(B, D), dim=1)                 # queries (online encoder)
k = F.normalize(q + 0.1 * torch.randn(B, D), dim=1)       # keys (momentum encoder)
queue = F.normalize(torch.randn(K, D), dim=1)             # keys from past batches
l_pos = (q * k).sum(1, keepdim=True)                      # B x 1
l_neg = q @ queue.T                                       # B x K
logits = torch.cat([l_pos, l_neg], dim=1) / 0.07
loss_moco = F.cross_entropy(logits, torch.zeros(B, dtype=torch.long))
queue = torch.cat([k, queue])[:K]                         # enqueue new, drop oldest
print("MoCo logits:", tuple(logits.shape), "loss:", round(loss_moco.item(), 3))

# momentum (EMA) update of the key encoder's parameters
theta_q, theta_k, m = torch.randn(5), torch.zeros(5), 0.999
theta_k = m * theta_k + (1 - m) * theta_q
print("key params moved by:", round((theta_k.norm() / theta_q.norm()).item(), 4))
每個查詢面對一個 類的分類問題,正確答案永遠在第 0 欄,所以目標全為零。輸出顯示 logits 的形狀是 (8, 33),而 EMA 一步只讓鍵編碼器往查詢編碼器移動了 0.1%(從零開始、走一步)。實際實作中, 與 來自兩個編碼器分別作用在同一批影像的兩個增強版本上。
對齊性與均勻性
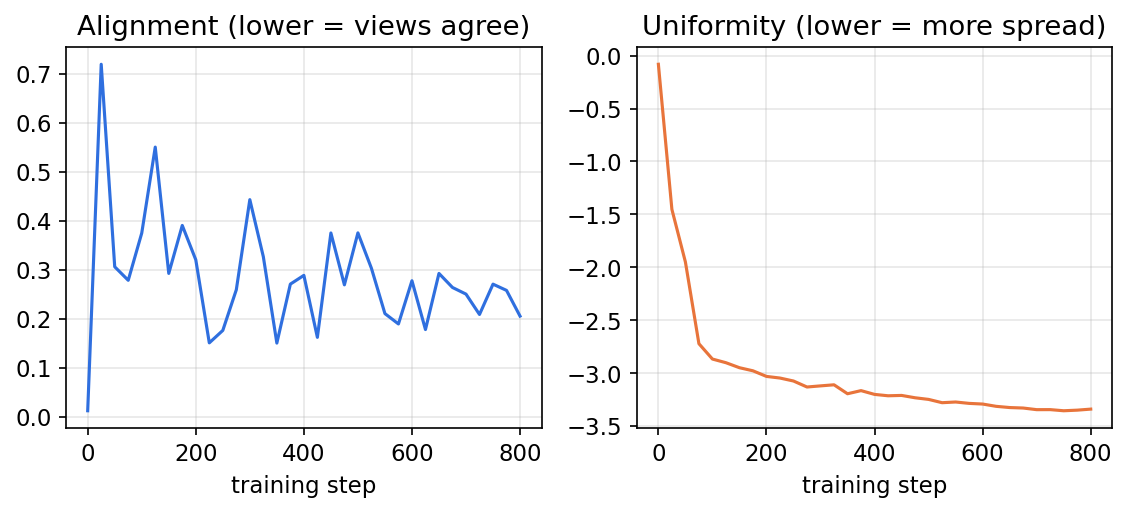
Wang 與 Isola [9] 從幾何角度清楚說明對比式損失在單位球面上做了什麼。在正規化特徵下,損失在漸近意義上最佳化兩個性質:
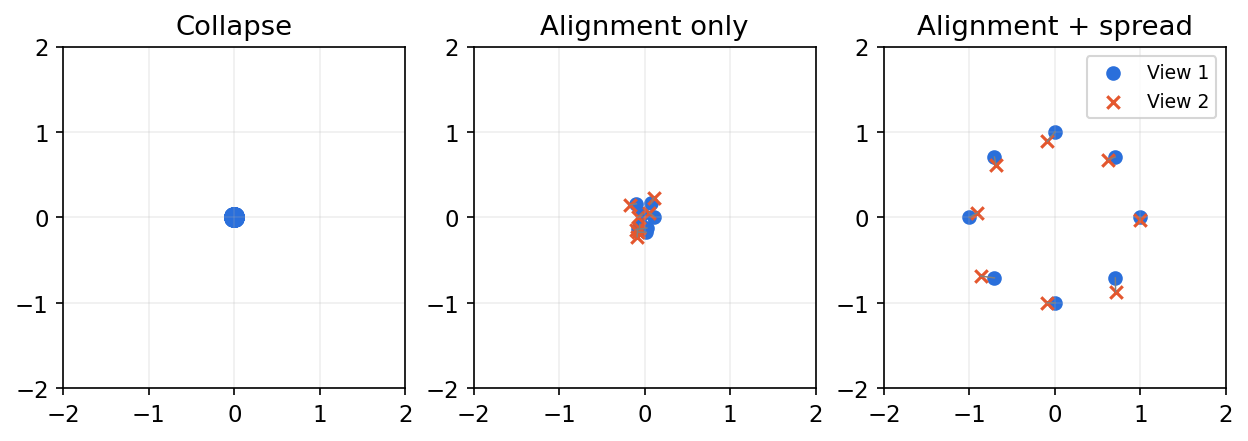
其中 是正配對, 是獨立樣本,(常用 )。正配對被映射到相近的點時,對齊性(alignment)就低。特徵在球面上分散開來時,均勻性(uniformity)就低,也就是盡可能保留輸入的資訊。塌縮的編碼器有完美的對齊性(0)和最差的均勻性(0);有用的編碼器兩者都要小。
程式碼 · Python · 18 行
import torch
from torch.nn import functional as F

def alignment(z1, z2):            # mean squared distance between positive pairs
    return (z1 - z2).square().sum(1).mean()

def uniformity(z, t=2.0):         # log of mean Gaussian potential over all pairs
    return torch.pdist(z).square().mul(-t).exp().mean().log()

torch.manual_seed(0)
n, D = 512, 16
collapsed = F.normalize(torch.ones(n, D), dim=1)
spread = F.normalize(torch.randn(n, D), dim=1)
noisy_view = F.normalize(spread + 0.1 * torch.randn(n, D), dim=1)
print("collapsed: align", alignment(collapsed, collapsed).item(),
      "uniform", round(uniformity(collapsed).item(), 3))
print("spread:    align", round(alignment(spread, noisy_view).item(), 3),
      "uniform", round(uniformity(spread).item(), 3))
塌縮的集合得到對齊性 0.0、均勻性 0.0;分散的集合大約是 0.138 與 −3.51。圖 4 追蹤下面訓練數字編碼器時的這兩個量。在第 0 步,隨機網路把每個視圖都映射到幾乎同一點,所以對齊性接近零只是因為一切都塌縮了。訓練先把特徵分散開來(均勻性急遽下降),再逐步把正例拉回彼此身邊。
實作範例:在 8×8 數字上跑 SimCLR
白話版。 完全不使用標記,在 scikit-learn 的數字資料集上訓練一個迷你 SimCLR 編碼器,再檢查它的特徵能不能讓最近鄰分類器更穩健。
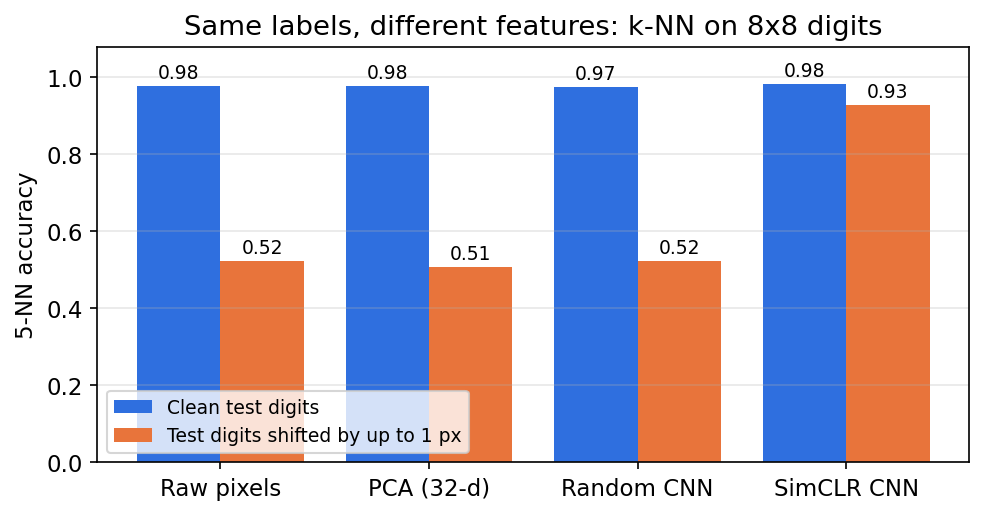
這裡的資料增強是最多一個像素的隨機平移、隨機亮度變化與像素雜訊。因此我們預期學到的特徵對小平移大致不變,這是原始像素做不到的。評估時,每一種特徵都使用同一組有標記的訓練集,並分別在乾淨的數字與最多平移一個像素的數字上測試。
程式碼 · Python · 55 行
import copy
import numpy as np
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier

torch.manual_seed(0); np.random.seed(0); torch.set_num_threads(1)
d = load_digits()
Xtr, Xte, ytr, yte = train_test_split(d.data / 16., d.target, test_size=.3,
                                      random_state=0, stratify=d.target)
Xtr_t = torch.tensor(Xtr, dtype=torch.float32)

def augment(x):                      # the augmentations define the invariances
    img = F.pad(x.view(-1, 1, 8, 8), (1, 1, 1, 1))
    i, j = np.random.randint(0, 3, size=2)               # shift by up to 1 px
    img = img[:, :, i:i + 8, j:j + 8]
    img = img * (0.7 + 0.6 * torch.rand(len(img), 1, 1, 1))  # brightness
    return (img + 0.1 * torch.randn_like(img)).reshape(len(x), 64)  # noise

backbone = nn.Sequential(nn.Unflatten(1, (1, 8, 8)),
                         nn.Conv2d(1, 32, 3, padding=1), nn.ReLU(),
                         nn.Conv2d(32, 64, 3, padding=1), nn.ReLU(),
                         nn.AdaptiveAvgPool2d(2), nn.Flatten())  # h: 256-d
random_backbone = copy.deepcopy(backbone)                    # baseline
head = nn.Sequential(nn.ReLU(), nn.Linear(256, 64))          # projection g
opt = torch.optim.Adam([*backbone.parameters(), *head.parameters()], lr=1e-3)

def nt_xent(z1, z2, tau=0.2):
    z = F.normalize(torch.cat([z1, z2]), dim=-1)
    n = len(z1)
    logits = (z @ z.T / tau).fill_diagonal_(float("-inf"))
    return F.cross_entropy(logits, (torch.arange(2 * n) + n) % (2 * n))

for step in range(800):                                 # about a minute on CPU
    x = Xtr_t[torch.randint(len(Xtr_t), (256,))]
    loss = nt_xent(head(backbone(augment(x))), head(backbone(augment(x))))
    opt.zero_grad(); loss.backward(); opt.step()

def shift(x, dy, dx):                   # move one 8x8 image, fill with zeros
    img = np.zeros((10, 10)); img[1:9, 1:9] = x.reshape(8, 8)
    return img[1 - dy:9 - dy, 1 - dx:9 - dx].ravel()

moves = np.random.default_rng(0).integers(-1, 2, size=(len(Xte), 2))
Xte_shift = np.stack([shift(x, *m) for x, m in zip(Xte, moves)])
enc = lambda net: (lambda A: net(torch.tensor(A, dtype=torch.float32)).detach().numpy())
pca = PCA(32, random_state=0).fit(Xtr)
for name, f in [("raw pixels", lambda A: A), ("PCA-32", pca.transform),
                ("random CNN", enc(random_backbone)), ("SimCLR CNN", enc(backbone))]:
    knn = KNeighborsClassifier(5, metric="cosine").fit(f(Xtr), ytr)
    print(f"{name:11s} clean {knn.score(f(Xte), yte):.3f}  "
          f"shifted {knn.score(f(Xte_shift), yte):.3f}")
在我們的機器上,輸出為:
程式碼 · 4 行
raw pixels  clean 0.978  shifted 0.524
PCA-32      clean 0.978  shifted 0.507
random CNN  clean 0.974  shifted 0.524
SimCLR CNN  clean 0.987  shifted 0.919
確切數字會因 PyTorch 版本與硬體略有不同,重點是模式。在乾淨的數字上,原始像素已經非常好:這個資料集很簡單,花俏的編碼器幫助不大。在平移過的數字上,原始像素、PCA 以及同架構但未訓練的 CNN 都掉到 50% 左右,而自監督特徵保住了大部分的準確率。網路學到了我們透過資料增強要求的不變性,而且僅止於此:如果改用旋轉過的數字測試(資料增強從未出現過旋轉),就不應期待同樣的穩健性。
選讀:SimCLR(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
沒有負例:為什麼只求一致會塌縮
白話版。 如果唯一的指令是「讓兩個輸出一致」,那麼對每張影像都輸出同一個常數就完美達成了。沒有負例的方法必須靠別的機制阻止這件事。
對兩個視圖 最小化 ,有一個平凡解 ,其中 是常數。光是一致,並不要求特徵攜帶任何資訊。完全塌縮把所有東西映射到同一點;維度塌縮(dimensional collapse)比較隱微:特徵會變化,但只沿著少數幾個方向,浪費了 維中的大部分。
BYOL:線上網路追逐緩慢的目標
BYOL [10] 使用兩個網路。線上(online)網路(編碼器、投影器,再加一個預測器 )被訓練去預測目標(target)網路對同一張影像另一個視圖的投影。目標網路不靠梯度訓練,而是線上權重的 EMA,和 MoCo 一樣:
損失是正規化後的預測與正規化後的目標投影之間的平方距離,並對兩個視圖做對稱化。目標輸出被當作常數(停止梯度,stop-gradient)。沒有負例,BYOL 實務上卻不會塌縮。不對稱性(一邊有預測器,另一邊有停止梯度與 EMA)以及完整的訓練配方都很重要;光有 EMA 並不能證明不可能塌縮。
SimSiam:停止梯度是關鍵成分
Chen 與 He 的 SimSiam [11] 把 BYOL 再進一步精簡:兩個視圖共用一個編碼器,一個分支上有預測器 ,沒有動量編碼器、沒有負例,也不需要大批次。令 、,
其中 是停止梯度, 是負的餘弦相似度。論文實驗顯示,拿掉停止梯度會讓模型很快塌縮,而預測器也是必要的。作者把這個方法詮釋為一種交替式、類似期望最大化(EM)的最佳化。實務上的教訓是:非常小的架構不對稱,就決定了這些方法是在學習還是在塌縮。
DINO:帶中心化與銳化的自蒸餾
DINO [12] 把一致性問題變成帶軟標記的分類。教師與學生都透過帶溫度的 softmax,在 個「原型」維度上輸出一個機率向量。看到視圖 的學生,被訓練去符合教師在另一個視圖 上的分布:
其中 是教師網路(學生的 EMA), 是教師輸出的移動平均(中心化,centering), 是較低的教師溫度(銳化,sharpening)。中心化防止某一維獨大;銳化防止輸出變成均勻分布。兩者各自單獨使用都會以不同方式塌縮;合在一起才會平衡。DINO 也使用多重裁切(multi-crop):教師只看大的全域裁切,學生還會看到小的局部裁切,因此學生必須從局部證據推斷全域內容。搭配 Vision Transformer 時,DINO 的注意力圖在完全沒有分割標記的情況下就能凸顯物體邊界,這點很受矚目。
Barlow Twins 與 VICReg:直接規範統計量
另一條路是直接在損失中禁止塌縮。Barlow Twins [13] 計算兩個視圖(在批次上標準化後)嵌入之間的 互相關矩陣 ,並把它推向單位矩陣:
第一項讓每一維在兩個視圖間一致,第二項(權重 )讓不同維度去相關,避免攜帶重複的資訊。VICReg [14] 把同樣的想法拆成三個有名字的項:不變性(兩個嵌入間的均方距離)、變異數(用 hinge 損失讓每一維的標準差保持在門檻之上,直接禁止常數輸出)與共變異數(懲罰非對角的共變異數元素)。「沒有負例」不代表「沒有防塌縮設計」;這些方法只是把設計放進損失,而不是放進架構。
遮罩建模:從填空中學習
白話版。 把輸入的一部分藏起來,預測缺了什麼。BERT 就是這樣學會語言的;只要選對遮住的比例,這招對影像也有效。
BEiT [15] 把 BERT 式的預訓練帶進 Vision Transformer。影像被切成區塊,部分區塊被遮住,網路為被遮住的位置預測離散的視覺符元(visual token),這些符元來自另外訓練好的影像符元化器(tokenizer)。
MAE [16] 則直接預測原始像素。它遮住很大比例的區塊,只把可見的區塊送進編碼器,再用一個輕量的解碼器重建缺失的像素。令被遮住的區塊索引集合為 ,
其中 是區塊 的真實像素向量, 是預測值。MAE 的設計是刻意的。高遮罩比例(預設 75%)讓任務夠難,網路無法只靠鄰居內插。編碼器只處理可見區塊,降低預訓練成本。用每個目標區塊自身的平均與變異數做正規化,可以改善特徵。預訓練完成後,解碼器就被丟掉。
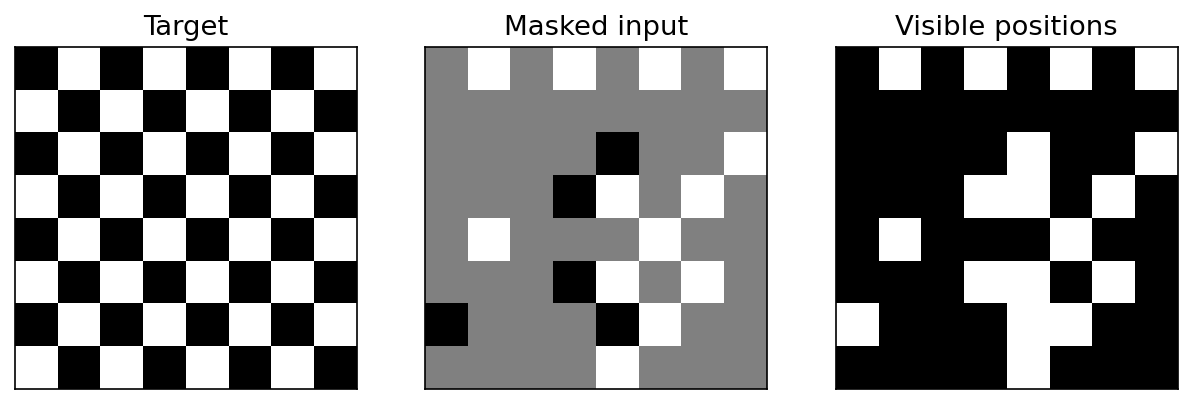
重建不等於生成。從可見像素預測被遮住像素的模型,並沒有被訓練成從零開始取樣出完整影像。低重建損失也不保證得到最好的語意特徵:背景紋理可能主導像素誤差。遮罩建模的特徵在線性探測下通常不如對比式或蒸餾式特徵,但微調之後很強,這也是為什麼評估方式必須講清楚。
預測特徵而不是像素:JEPA
白話版。 與其把每個不確定的像素都畫出來,不如預測被遮住區域的描述。
I-JEPA [17](影像聯合嵌入預測架構,Image Joint-Embedding Predictive Architecture)編碼一個可見的脈絡(context)區塊,並從中預測數個目標(target)區塊的編碼器特徵。目標編碼器是脈絡編碼器的 EMA,預測器則接收脈絡特徵以及目標的位置。簡化後的目標函數是
其中 是脈絡編碼器, 是 EMA 目標編碼器, 是預測器, 是停止梯度。這個式子只是概括想法;遮罩策略(大的、語意尺度的目標區塊)與架構都是方法的一部分,不是可有可無的細節。
V-JEPA 2 [18] 把特徵預測大規模延伸到影片。它的報告把無動作的影片預訓練,與之後用少量機器人資料訓練、用於規劃的動作條件模型區分開來。預測未來的潛在狀態、辨識動作、生成逼真的未來畫面,是不同的能力;一個「世界模型」的主張應該說清楚它指的是哪一種。
以語言作為監督:CLIP
白話版。 對齊影像與圖說嵌入,再把影像與候選類別的文字描述比較;提示措辭會影響結果。
CLIP [19] 用從網路收集的影像–文字配對來訓練。在一批 個配對中,影像編碼器產生正規化嵌入 ,文字編碼器產生 。 的相似度矩陣 ( 是可學習的溫度)的對角線就是正確配對。損失是兩個 InfoNCE 損失的平均,一個沿著列(哪句圖說配這張影像?),一個沿著行(哪張影像配這句圖說?):
零樣本分類隨之而來。為每個類別嵌入一句提示,例如「a photo of a dog」,再把影像分到提示嵌入最相似的類別。不需要任何任務專屬的標記,不過提示的措辭會影響準確率。
SigLIP [20] 把 softmax 換成對每一個影像–文字配對各自獨立的 sigmoid 損失:矩陣中的每個元素都變成一個是非題:「這兩個配對嗎?」這樣就不需要對整個批次做正規化,簡化了大規模分散式訓練。
程式碼 · Python · 26 行
import torch
from torch.nn import functional as F

torch.manual_seed(0)
D = 16

# --- CLIP-style symmetric loss on N matched image-text pairs
N = 6
img = F.normalize(torch.randn(N, D), dim=1)
txt = F.normalize(img + 0.3 * torch.randn(N, D), dim=1)   # caption i matches image i
logit_scale = torch.tensor(1 / 0.07)
sim = logit_scale * img @ txt.T                           # N x N, diagonal = matches
labels = torch.arange(N)
loss_clip = (F.cross_entropy(sim, labels) + F.cross_entropy(sim.T, labels)) / 2
print("CLIP loss:", round(loss_clip.item(), 3))

# zero-shot classification: embed one prompt per class, pick the most similar
class_prompts = txt[:3]                                   # stand-ins for "a photo of a {class}"
pred = (img @ class_prompts.T).argmax(1)
print("zero-shot predictions for images 0-2:", pred[:3].tolist())

# SigLIP-style alternative: an independent yes/no decision for every pair
t, b = 10.0, -10.0                                        # learnable in practice
signs = 2 * torch.eye(N) - 1                              # +1 on matches, -1 elsewhere
loss_sig = -F.logsigmoid(signs * (t * img @ txt.T + b)).sum() / N
print("sigmoid loss:", round(loss_sig.item(), 3))
合成的圖說是影像嵌入加上雜訊的副本,所以 CLIP 損失很小(0.054),零樣本步驟也找回了正確的「類別」[0, 1, 2]。在真正的 CLIP 中,兩個編碼器分別是 Vision Transformer 或 CNN 與文字 Transformer,而困難的部分在資料:圖說描述了什麼、遺漏了什麼,決定了表示知道什麼。sigmoid 損失的值(3.473)不能和 softmax 損失直接比較;它的單位不同,還多了偏置項 。
DINOv2 與 DINOv3:把特徵當成產品
白話版。 只要有足夠的精選資料與算力,預訓練就能產出一個可以凍結、並重複用在許多不同任務上的編碼器,從分類到深度估計都行。
DINOv2 [21] 結合影像層級的自蒸餾(如 DINO)與區塊層級的遮罩目標,並且非常重視資料策展(data curation):從未經整理的影像中,透過與精選影像比對檢索,建出一個大型、多樣且去除重複的預訓練集。成果是一系列凍結後就能搭配簡單任務頭、全域與區塊特徵都好用的編碼器。2025 年發表的 DINOv3 [22] 進一步擴大規模,並加入 Gram anchoring,以對抗長時間訓練中密集(區塊)特徵品質下降的問題。它不只是讓每個特徵各自匹配,而是約束區塊特徵之間的相似度矩陣,使其接近較早期模型的矩陣。報告也把一個非常大的教師模型蒸餾成較小的模型以便部署。
實務上的問題是:凍結的全域或密集特徵能不能解決你的任務。一個擅長語意檢索的模型,可能會漏掉製造零件上的一道小刮痕。提高輸入解析度並使用區塊特徵可能有幫助,但這會改變運算預算與比較的方式。
誠實地評估遷移
白話版。 以明確調適協定,在保留的任務或資料上測試特徵;評估須與特徵及超參數選擇分開。
| 評估方式 | 訓練什麼 | 衡量什麼 |
|---|---|---|
| -NN | 不訓練;與有標記參考特徵的相似度 | 表示的局部結構 |
| 線性探測 | 線性任務頭;編碼器凍結 | 簡單讀出就能取得的資訊 |
| 微調 | 任務頭加上部分或全部編碼器層 | 在給定標記與運算預算下的可調適性 |
| 密集遷移 | 在區塊特徵圖上的空間任務頭 | 是否適合像素或區域層級的輸出 |
線性探測與微調
微調的自由度較高,所以當目標資料充足、且與預訓練資料相似時,它通常會贏。但它不一定比較好。Kumar 等人 [23] 從理論與實驗上證明,完整微調可能會扭曲好的預訓練特徵:當隨機初始化的任務頭還是錯的時候,它的大梯度流進編碼器,把特徵改往適合訓練分布、卻傷害分布外(out-of-distribution, OOD)輸入的方向。線性探測不會扭曲特徵。他們的對策 LP-FT 分兩步:先凍結編碼器訓練線性任務頭,再從這個任務頭出發微調全部參數。
我們在數字範例上重現了這個定性效應。編碼器是上面的 SimCLR CNN;有標記的訓練數字是乾淨的;測試數字則是平移過的,屬於輕微的分布偏移。每種標記預算都對三次隨機抽取的標記樣本取平均。
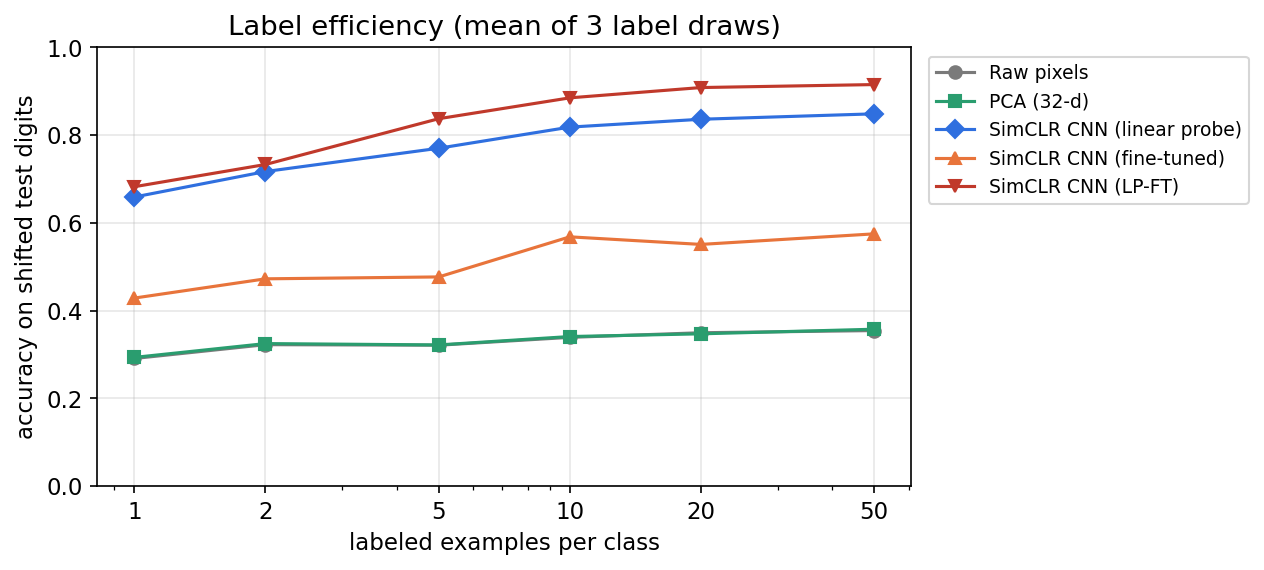
請看圖 8 的形狀,而不是確切數值。凍結的自監督特徵搭配線性任務頭,每類只要少數幾個標記,就能勝過每類 50 個標記的原始像素。在這裡,從隨機初始化任務頭開始的一般微調輸給了凍結的探測,而 LP-FT 兩者都贏,這和 Kumar 等人在分布偏移下回報的順序相同。微調需要自己的超參數搜尋,任務頭的初始化也很重要。
防止資料洩漏的規則
- 做相似度比較時,特徵要一致地正規化(餘弦 -NN 需要正規化向量)。
- 標準化、PCA 與分類器的超參數,只能在訓練與驗證資料上擬合。
- 凍結的編碼器仍然有訓練歷史:預訓練資料與評估資料的重疊可能灌水結果,網路規模的模型尤其如此。
- 回報標記數量、骨幹網路、檢查點、輸入解析度、資料增強、任務頭、調參預算與評估方式。在測試集上從許多編碼器中挑最好的,就是測試資料洩漏,即使沒有任何一個被微調。
現代觀點
綜述與回顧論文。 四篇綜述從互補的角度描繪這個領域。
- Bengio、Courville 與 Vincent(TPAMI 2013)[1] 為整件事定下框架。他們問一個表示憑什麼比另一個好,並以一組通用先驗回答:分散式編碼、深度與抽象、解釋因子的解糾纏(disentangling)、流形與自然分群。他們回顧了機率模型、自編碼器與流形學習。這篇早於現代自監督學習,但仍是「我們為什麼要學表示」最好的陳述。
- Liu 等人(TKDE 2023)[3] 把橫跨視覺、語言與圖的自監督方法分成生成式(自編碼與自迴歸重建)、對比式(脈絡–實例與實例–實例)與生成–對比式(對抗式)三組,並討論當時對比式目標為何在視覺基準上勝出。
- Gui 等人(TPAMI 2024)[4] 對演算法做了較新的整理,涵蓋對比式、自蒸餾、冗餘抑制與遮罩影像建模方法,並討論應用與開放問題,例如理論、代理任務的選擇與多模態自監督學習。
- Balestriero 等人(2023)[5] 是由領域內許多作者合寫的實務指南。它把方法分成深度度量學習家族(SimCLR 及其相關方法)、自蒸餾家族(BYOL、SimSiam、DINO)、典型相關分析家族(VICReg、Barlow Twins)以及遮罩影像建模,並收集了論文常常埋在細節裡的「訣竅」(資料增強、投影器、EMA 排程、批次大小的影響)。Prince 的教科書 [24] 則以平易、圖文並茂的方式並附上 notebook 介紹同樣的概念。
實務現況(2023–2026)。 從上面引用的論文中可以看到以下趨勢:
- 結合多種目標。 領先的影像編碼器把影像層級的蒸餾與區塊層級的遮罩預測結合起來(DINOv2 [21]、DINOv3 [22]),而不是只依賴一種代理任務。
- 資料是一級設計選擇。 DINOv2 的策展流程,以及 CLIP [19] 與 SigLIP [20] 背後網路規模的配對收集,都顯示預訓練吃進什麼資料和損失函數一樣重要。
- 密集特徵。 分割、深度與對應關係需要好的區塊特徵,這促成了像 Gram anchoring [22] 這樣的目標。
- 在潛在空間中預測,並延伸到影片。 I-JEPA [17] 與 V-JEPA 2 [18] 預測特徵而不是像素,並延伸到影片與動作條件預測。
- 與語言對齊的編碼器成為多模態模型的預設骨幹(見 ML 10)。
開放問題。 我們仍然缺少一套能預測「哪種代理任務適合哪種下游任務」的理論;防止塌縮靠的多半是配方而不是保證;評估結果高度依賴評估方式,以及預訓練與測試資料之間的重疊;網路規模的預訓練也繼承了資料中的偏誤與缺口。我們對 [3]、[4]、[5]、[21]、[22] 的解讀是:資料與目標的設計值得和架構一樣多的關注。這是對文獻的詮釋,不是「某個目標到處都贏」的定理。
接下來的章節換一個問題:與其描述一張影像,模型要如何描述並取樣整個分布?自編碼器見 ML 06A,生成模型見 ML 07。
重點整理
- 有用特徵讓目標任務更容易解決,分散式編碼本身不保證泛化。
- 資料擴增決定忽略哪些差異,應保留下游任務需要的差異。
- 對比目標區分正配對與其他候選;只要求一致,會允許常數輸出的崩塌解。
- 教師不對稱、變異數限制與冗餘懲罰,以不同方式處理崩塌。
- 重建像素、預測特徵與對齊圖說,訓練的是不同能力。
- 最近鄰測試、線性探測與微調回答不同問題;應在預期分布轉移下評估調適。
練習
- 溫度與塌縮。 在第一段程式中,把溫度從 0.2 改成 0.05 和 1.0。塌縮損失會變嗎?配對損失呢?
提示
塌縮損失仍是 :所有非自身的 logits 都相等,所以除以任何 之後 softmax 仍是均勻的。配對損失會改變,因為溫度縮放的是分數之間的差距;有真正的差距時, 越小 softmax 越尖銳。
- 資料增強就是假設。 你想要的特徵用於 (a) 顯微影像中的細胞計數、(b) 鳥種辨識、(c) 讀取路標文字。各舉一個你會拿掉的標準 SimCLR 資料增強,並說明原因。
提示
(a) 隨機裁切可能改變視野中的細胞數量,所以「相同」的標記其實不再相同。(b) 強烈的顏色抖動可能抹去羽色,而羽色是重要的鳥種線索。(c) 水平翻轉會把文字變成鏡像文字。先決定什麼必須保留,再選擇不變性。
- MAE 的運算量。 一張影像有 196 個區塊,MAE 遮住 75%。有多少個區塊進入編碼器?編碼器中兩兩注意力分數的數量縮小為幾分之幾?
提示
49 個可見區塊進入編碼器。注意力分數隨符元數量的平方成長:。解碼器仍然要處理全部 196 個位置,但它很小。
- 破壞數字實驗。 修改 SimCLR 數字程式,讓
augment不做平移。重新訓練,並比較平移測試的 -NN 準確率與原本的結果。這告訴你什麼?
提示
把隨機的 i, j 換成 i, j = 1, 1。在我們的機器上,平移測試的準確率從 0.919 掉到 0.743,而乾淨測試的準確率維持在 0.981。少了平移增強,目標中就沒有任何東西要求平移不變性;剩下的穩健性來自訓練過的卷積加池化編碼器本來就會學到的東西(主範例中未訓練的那個完全沒有)。決定學到什麼的主要是資料增強,而不是「自監督」這個名詞。
- 紙上的 SimSiam 消融實驗。 在 SimSiam 中,假設你拿掉停止梯度,讓兩個分支都接收梯度。用兩句話說明為什麼常數輸出會變成很容易達到的最小值,以及為什麼光有預測器不足以阻止它。
提示
兩邊都有梯度時,只要 和 指向同一方向,損失 就達到最小,而一個常數編碼器加上一個輸出同樣常數方向的預測器,對每個輸入都做得到。停止梯度改變了最佳化動態,讓目標在每一步中保持固定;SimSiam 論文回報,沒有它就會迅速塌縮。
- 公平的探測。 設計一個實驗,在每類 10、50、100 個標記下,比較凍結的預訓練編碼器與 PCA 加邏輯斯迴歸。列出三件必須固定的事,以及兩件必須回報的事。
提示
必須固定:有標記的子集(兩者使用相同樣本)、保留的測試切分,以及選擇正則化強度的程序(只用驗證資料)。必須回報:預訓練編碼器的訓練資料(以及與你測試集的任何重疊),以及隨機抽取標記的次數與其變異範圍。
參考文獻
- Y. Bengio, A. Courville and P. Vincent, “Representation Learning: A Review and New Perspectives,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, no. 8, 2013. Paper · arXiv
- J. Yosinski, J. Clune, Y. Bengio and H. Lipson, “How transferable are features in deep neural networks?” NeurIPS, 2014. Paper
- X. Liu et al., “Self-supervised Learning: Generative or Contrastive,” IEEE Transactions on Knowledge and Data Engineering, vol. 35, 2023 (online 2021). Paper · arXiv
- J. Gui et al., “A Survey on Self-Supervised Learning: Algorithms, Applications, and Future Trends,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2024. Paper · arXiv
- R. Balestriero et al., “A Cookbook of Self-Supervised Learning,” arXiv:2304.12210, 2023. Paper
- A. van den Oord, Y. Li and O. Vinyals, “Representation Learning with Contrastive Predictive Coding,” arXiv:1807.03748, 2018. Paper
- T. Chen, S. Kornblith, M. Norouzi and G. Hinton, “A Simple Framework for Contrastive Learning of Visual Representations,” ICML, 2020. Paper
- K. He, H. Fan, Y. Wu, S. Xie and R. Girshick, “Momentum Contrast for Unsupervised Visual Representation Learning,” CVPR, 2020. Paper
- T. Wang and P. Isola, “Understanding Contrastive Representation Learning through Alignment and Uniformity on the Hypersphere,” ICML, 2020. Paper
- J.-B. Grill et al., “Bootstrap Your Own Latent: A New Approach to Self-Supervised Learning,” NeurIPS, 2020. Paper
- X. Chen and K. He, “Exploring Simple Siamese Representation Learning,” CVPR, 2021. Paper
- M. Caron et al., “Emerging Properties in Self-Supervised Vision Transformers,” ICCV, 2021. Paper
- J. Zbontar, L. Jing, I. Misra, Y. LeCun and S. Deny, “Barlow Twins: Self-Supervised Learning via Redundancy Reduction,” ICML, 2021. Paper
- A. Bardes, J. Ponce and Y. LeCun, “VICReg: Variance-Invariance-Covariance Regularization for Self-Supervised Learning,” ICLR, 2022. Paper
- H. Bao, L. Dong, S. Piao and F. Wei, “BEiT: BERT Pre-Training of Image Transformers,” ICLR, 2022. Paper
- K. He et al., “Masked Autoencoders Are Scalable Vision Learners,” CVPR, 2022. Paper
- M. Assran et al., “Self-Supervised Learning from Images with a Joint-Embedding Predictive Architecture,” CVPR, 2023. Paper
- M. Assran et al., “V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning,” technical report, 2025. Report
- A. Radford et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML, 2021. Paper
- X. Zhai, B. Mustafa, A. Kolesnikov and L. Beyer, “Sigmoid Loss for Language Image Pre-Training,” ICCV, 2023. Paper
- M. Oquab et al., “DINOv2: Learning Robust Visual Features without Supervision,” Transactions on Machine Learning Research, 2024. Paper
- O. Siméoni et al., “DINOv3,” technical report, 2025. Report
- A. Kumar, A. Raghunathan, R. Jones, T. Ma and P. Liang, “Fine-Tuning can Distort Pretrained Features and Underperform Out-of-Distribution,” ICLR, 2022. Paper
- S. J. D. Prince, Understanding Deep Learning, MIT Press, 2023. Book and notebooks
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 06A・線性因子模型與自編碼器 · 27 分鐘