ML 07・生成模型:自編碼器、VAE、GAN 與正規化流
先備知識:ML 06・表示學習與自監督
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分分布建模與標籤預測。
- 比較基於概似的模型與隱式取樣器。
- 推導 VAE 下界,理解重參數化。
- 說明對抗訓練與可逆密度變換。
- 分別評估概似、真實感、多樣性與條件遵循。
先看全貌
分類器問:「這張影像裡有什麼?」生成模型(generative model)問:「可能出現哪些影像?」如果它學到有用的分布,我們就能取樣出新的例子、補上缺失區域、壓縮資料、偵測異常輸入,或依文字、類別標籤、另一張影像來條件式地生成。
學分布比學標籤難得多。標籤只是一個數字;一張影像有成千上萬個像素,彼此以複雜的方式相互依賴。本章的每個家族,都是對同一個工程問題的不同回答:要怎麼表示一個極高維資料上的分布,才能既從例子訓練它,之後又能從它取樣?
本章採用 Bishop 與 Bishop [1] 以及 Prince [2] 發展的機率觀點。Bond-Taylor 等人的比較綜述 [3] 依照我們將遇到的取捨來整理這些家族——訓練速度、樣本品質、多樣性,以及是否能得到概似;Papamakarios 等人的正規化流綜述 [4] 則特別有助於區分「學到的分布」與「方便的取樣程序」。擴散模型與自迴歸模型各有專章(ML 08 與 ML 09),因為它們的訓練與取樣值得仔細討論;這裡先把它們放上地圖。
用分布描述資料
白話版。 找一個機率模型,讓觀察到的例子在它之下看起來「很可能」,再用這個模型產生看起來像出自同一來源的新例子。
最大概似
假設資料 是從未知分布 獨立抽出的樣本, 是參數為 的模型。最大概似估計最小化平均負對數概似(negative log-likelihood,NLL):
其中 是訓練樣本數, 是模型給第 個樣本的對數密度。
為什麼這是合理的目標?當 變大,平均值會趨近於對資料分布的期望值,而且
是 Kullback–Leibler 散度,只有兩個分布相同時才為零; 是資料的熵,與 無關。因此最大概似就等於最小化從資料到模型的前向 KL 散度。
KL 的方向很重要。前向 KL 會重罰「在真實資料所在之處給出接近零的密度」的模型,所以概似訓練是「涵蓋質量(mass-covering)」的:它寧可把機率攤到每一個模態(mode)上,即使因此在模態之間也放了一些機率。請記住這點;稍後會看到 GAN 的行為不同。
密度、離散像素與每維位元數
對連續值而言, 是密度,不是「恰好觀察到 」的機率;密度可以大於 1。然而真實影像存的是 0–255 這類整數。直接用連續密度去擬合整數是病態問題:模型可以在整數格點上放無限高的尖峰,讓概似趨於無窮大。標準解法是去量化(dequantization)——在擬合連續密度之前,對每個整數值加上 的均勻雜訊。Theis 等人 [5] 證明,連續模型在去量化資料上的對數概似,會是對應離散模型對數概似的下界,這讓不同論文的數字可以相互比較。另一種作法是直接使用離散概似(對 256 個值做 softmax,或像下方程式碼一樣對二值像素用 Bernoulli 分布)。
影像的概似通常以每維位元數(bits per dimension)回報:
其中 是儲存數值的個數(高 × 寬 × 通道數)。對離散模型, 是每張影像以 nat 表示的負對數機率,bpd 對應每個儲存值的理想編碼成本。連續密度還需要交代去量化慣例:若 8 位元整數 加上獨立均勻雜訊 後縮放為 ,其每維位元數的去量化界限為 。額外的 8 來自縮放後量化格的體積。這是離散負對數概似的每維上界,不是精確的離散概似 [5]。比較分數前,要交代單位、雜訊分布,以及其他變數變換所需的修正。
條件式與無條件生成
判別式分類器建模 。條件式生成器建模 ,其中 可以是文字、類別、低解析度影像或已觀察到的像素。貝氏定理把相關的量連在一起,但分類器本身並不提供影像取樣器。
條件化也解釋了一個常見的失敗。最小化像素 MSE 會預測條件平均 。如果一個模糊的輸入有好幾個合理輸出——例如一張灰階照片裡的襯衫可能是紅色也可能是藍色——平均值會把它們混成褐色。生成模型則嘗試表示整個分布 ,一次取樣出一個合理的答案。
兩大家族:概似式與隱式
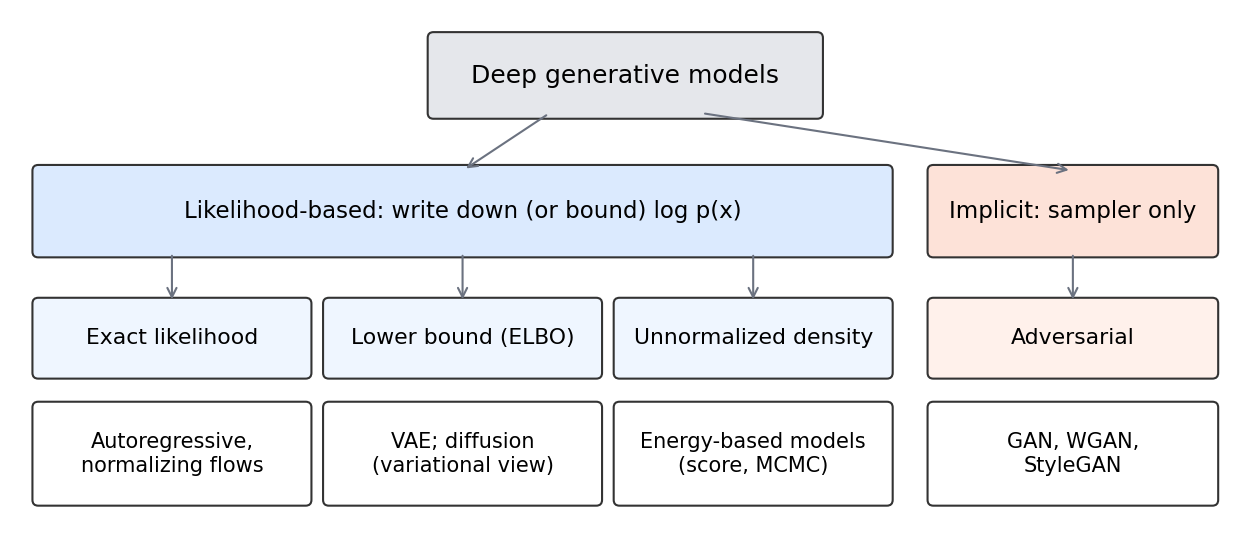
以下每個模型都需要兩種能力:從資料訓練的方法,以及取樣的方法。它們的差別在於能不能計算 。
- 概似式(顯式)模型寫下密度或其界限,再加以最大化。自迴歸模型與正規化流給出精確概似;VAE(以及從變分角度看的擴散模型)最佳化一個下界;能量模型只定義到一個未知正規化常數為止的密度。
- 隱式模型只定義一個取樣器——「把雜訊推過一個網路」——而沒有 的公式。GAN 是主要例子。因為沒有概似可以最大化,它們必須用別的方式比較樣本與資料來訓練。
一般自編碼器:有壓縮、沒有先驗
白話版。 把一個例子編碼成精簡的潛在碼,再解碼回來。這對壓縮與表示學習非常好,但它本身並不告訴你怎麼「發明」新的潛在碼。
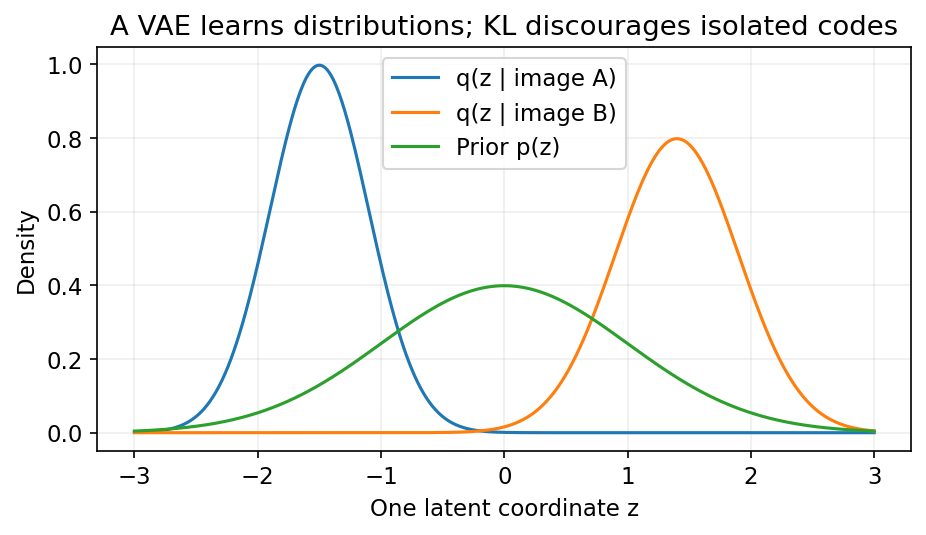
編碼器 與解碼器 最小化 之類的重建損失。自編碼器、它們的線性親戚(PCA、因子分析)及各種正則化變體,在 ML 06A 中有完整介紹。本章要強調的只有一點:一般自編碼器並不要求潛在碼落在哪裡。訓練資料的潛在碼可能只佔據潛在空間中一塊又薄又怪的區域。若你接著取樣 再解碼,可能落在解碼器從沒見過的空白區域,得到一團垃圾。因此重建再好,也不保證無條件生成的品質。
VAE 透過「給潛在碼一個先驗分布」,把自編碼器變成機率模型來解決這個問題。
VAE:潛在變數機率模型
白話版。 VAE 透過隨機潛在編碼與解碼器建模觀測;編碼器近似各觀測對應的編碼後驗。
模型
選一個潛在向量 的先驗 ,通常是標準高斯 ,以及解碼器 ——一個輸出影像分布參數的神經網路(二值像素用 Bernoulli 機率,或高斯平均值)。模型對影像的密度是邊際分布
取樣很容易:先抽 ,再抽 。計算 則很難:積分要跑過所有可能的潛在碼,而解碼器是非線性網路,沒有封閉解。真正的後驗 也因此無法計算。
推導證據下界
Kingma 與 Welling [6] 引入一個近似後驗的編碼器(或稱推論網路)。以下逐步推導。因為 與 無關,我們可以對任何 的分布取期望而不改變它的值:
第二行用了 ;第三行在對數裡同乘、同除 。因為 KL 散度永遠不為負,第一項是 的下界:證據下界(evidence lower bound,ELBO)。下界與真實對數概似之間的差距,恰好是近似後驗與真實後驗之間的 KL 散度。編碼器越好,下界越緊;完美的編碼器會讓差距歸零。
把 展開,得到程式中使用的形式:
第一項(重建)獎勵能讓解碼器重現 的潛在碼;第二項(貼近先驗)懲罰分布偏離先驗太遠的潛在碼。用 Jensen 不等式()一行就能得到同樣的下界,但上面的分解更有用,因為它明確指出了差距是什麼。訓練時對 與 同時最大化資料上的平均 ELBO,也就是最小化負 ELBO。
當編碼器是對角高斯 、先驗是標準高斯時,KL 項有封閉解:
其中 與 是編碼器在第 個潛在座標上的平均值與變異數。每一項只有在 且 時才為零。
重參數化
重建項是對 的期望值,而我們需要它對 的梯度。照字面寫的取樣無法微分:隨機抽樣是個黑盒子。重參數化技巧(reparameterization trick) [6] 把隨機性移到一個固定的雜訊變數上:
是逐元素相乘。現在 是 與獨立雜訊 的確定性、可微函數,一般的反向傳播就能透過 與 給出低變異的梯度估計。程式中編碼器預測 logvar ,再用 exp(.5 * logvar) 當標準差,不需任何限制就能保證為正。
程式:二值手寫數字的小型 VAE
這個完整的 CPU 範例使用 scikit-learn 內建的 8 × 8 手寫數字,並先二值化,讓 Bernoulli 解碼器成為明確的概似模型。重建項對像素加總、KL 對潛在維度加總,然後兩者都對樣本取平均;若只偷偷對其中一項取平均,就會改變兩者的比重。
程式碼 · Python · 39 行
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
torch.set_num_threads(1)
d = load_digits()
train, test = train_test_split(d.data, test_size=.2, random_state=0,
                              stratify=d.target)
X = torch.tensor((train > 8).astype("float32"))
Xt = torch.tensor((test > 8).astype("float32"))
enc = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 16))
dec = nn.Sequential(nn.Linear(8, 64), nn.ReLU(), nn.Linear(64, 64))
opt = torch.optim.Adam(list(enc.parameters()) + list(dec.parameters()), lr=.002)

def terms(x):
    mu, logvar = enc(x).chunk(2, dim=-1)
    z = mu + (.5*logvar).exp() * torch.randn_like(mu)
    recon = F.binary_cross_entropy_with_logits(dec(z), x, reduction="none").sum(1)
    kl = .5*(mu.square() + logvar.exp() - logvar - 1).sum(1)
    return recon, kl

for step in range(400):
    x = X[torch.randint(len(X), (64,))]
    recon, kl = terms(x)
    loss = (recon + kl).mean()
    opt.zero_grad()
    loss.backward()
    opt.step()
enc.eval(); dec.eval()
with torch.no_grad():
    recon, kl = terms(Xt)
    samples = dec(torch.randn(4, 8)).sigmoid().reshape(4, 8, 8)
    print("test negative ELBO estimate:", round((recon + kl).mean().item(), 3))
    print("reconstruction / KL:", round(recon.mean().item(), 3),
          round(kl.mean().item(), 3))
    print("sample probability maps:", tuple(samples.shape))
在我們的機器上,它印出測試集負 ELBO 約為每張影像 20.5 nats,其中重建約 17.0 nats、KL 約 3.5 nats。因為 ELBO 是對數概似的下界,20.5 nats 就是測試 NLL 的上界。輸出是 Bernoulli 機率圖;若要得到二值樣本,就依這些機率對每個像素取樣。測試估計帶有隨機性,多取幾次潛在樣本再平均會更穩定。這裡沒有用測試集挑選檢查點。
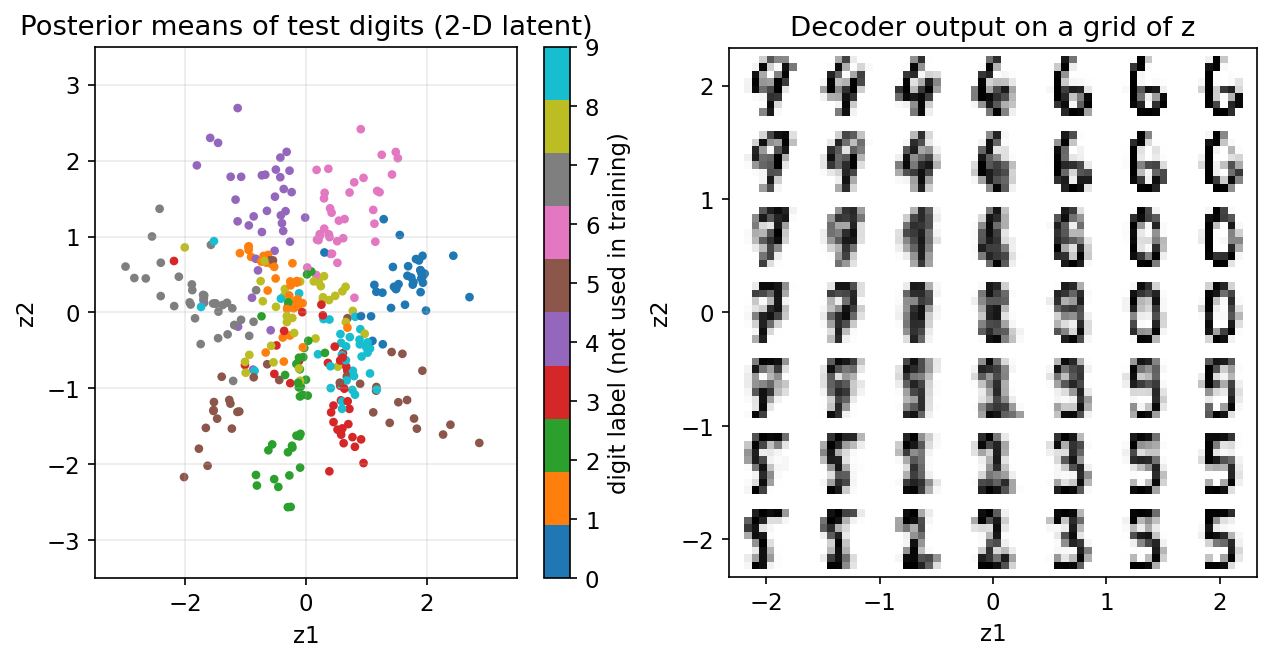
圖 3 顯示同樣資料上、潛在空間只有兩維的 VAE(由圖檔腳本訓練更久)學到了什麼。即使從沒用到標籤,相同類別的數字仍落在彼此附近;對一個規則網格上的 解碼,數字形狀會平滑地漸變。這正是一般自編碼器缺少的性質:先驗主體附近的每一點,解碼出來都像個數字。
後驗崩塌、β-VAE 與更深的 VAE
如果解碼器非常強大(例如本身就能建模像素的自迴歸解碼器),提高 ELBO 最便宜的方式可能是完全忽略 :令 使 KL 項為零,讓解碼器包辦一切。這就是後驗崩塌(posterior collapse)。Bowman 等人 [7] 在文字 VAE 上觀察到這個現象,並提出 KL 退火(KL annealing):一開始給 KL 項很小的權重,訓練中逐步升到 1,讓模型在懲罰生效前先學會使用潛在碼。監看每個潛在維度的 KL 是最簡單的診斷——KL 接近零的維度不攜帶任何資訊。
Higgins 等人 [8] 則反其道而行:β-VAE 把 KL 項乘上 ,以犧牲重建為代價,迫使模型學出更分解、更「解纏(disentangled)」的潛在碼。要精確理解這件事:當 ,目標函數就不再是 ELBO,它的值也不再是 的下界;Kingma 與 Welling 的教學綜述 [9] 討論了這點以及許多其他變體。最後,單層、因子化高斯的 VAE 容易產生模糊影像,部分原因是高斯解碼器會對不確定性取平均。階層式 VAE 疊了好幾層潛在變數;NVAE [10] 顯示,經過精心設計、搭配穩定化正則化的深層階層,可以在高達 256 × 256 像素的自然影像上產生清晰樣本。
選讀:VAE(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
GAN:與對手一起學習
白話版。 生成器學習欺騙區分生成樣本與資料的判別器;這種競爭目標能改善樣本,但訓練可能不穩定。
極小極大遊戲
令 把雜訊 映到樣本 ,其分布記為 。令 是判別器估計 為真的機率。Goodfellow 等人 [11] 的原始 GAN 目標是
判別器最大化 :這就是一般的二元交叉熵,真資料標 1、假資料標 0。生成器最小化 :它希望 越大越好。
這個遊戲在最小化什麼
固定生成器,把 寫成對 的積分:。對每個 分別來看,當 ,函數 在 有最大值(令導數 為零即可)。所以最佳判別器是
它就是「若兩者事前機率相同,一個點來自資料而非生成器」的機率。把 代回並加減 ,得到
其中 、,稱為 Jensen–Shannon 散度。因此在完美判別器之下,生成器是在最小化資料與模型間的一個對稱散度,全域最佳解是 ,此時處處 [11]。注意整個過程從沒計算過概似:判別器扮演一個學出來、會自我調整的「這看起來像資料嗎?」檢定。
非飽和損失與實作方式
訓練初期生成器很差,, 幾乎是平的,生成器的梯度消失。實務上生成器改為最小化 ,也就是同一篇論文 [11] 提出的非飽和(non-saturating)損失:正好在生成器落後時給出強梯度。它的固定點相同,但動態不同。
兩者交替更新。更新 時要把生成樣本 detach,讓梯度不會流到 ;更新 時讓梯度穿過 流進 ,但只執行 的最佳化器。用 logits 搭配 binary_cross_entropy_with_logits,在數值上比先套 sigmoid 再取 log 更安全。
程式:在八個高斯上訓練 GAN
測試模態涵蓋的經典場景,是二維平面上排成一圈的八個緊密高斯群。它小到能在 CPU 上一分鐘內訓練完,而且你可以親眼看到每個模態有沒有被涵蓋。
程式碼 · Python · 42 行
import math
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
torch.set_num_threads(1)
angles = torch.arange(8) * (2 * math.pi / 8)
centers = 2.0 * torch.stack([angles.cos(), angles.sin()], dim=1)

def sample_data(n):
    idx = torch.randint(8, (n,))
    return centers[idx] + 0.05 * torch.randn(n, 2)

def mlp(i, o):
    return nn.Sequential(nn.Linear(i, 128), nn.ReLU(),
                         nn.Linear(128, 128), nn.ReLU(), nn.Linear(128, o))

G, D = mlp(8, 2), mlp(2, 1)
opt_g = torch.optim.Adam(G.parameters(), lr=1e-3, betas=(.5, .999))
opt_d = torch.optim.Adam(D.parameters(), lr=1e-3, betas=(.5, .999))
for step in range(3000):
    real = sample_data(256)
    fake = G(torch.randn(256, 8))
    # Discriminator: logits, real -> 1, fake -> 0; detach so G is untouched.
    d_loss = (F.binary_cross_entropy_with_logits(D(real), torch.ones(256, 1))
              + F.binary_cross_entropy_with_logits(D(fake.detach()),
                                                   torch.zeros(256, 1)))
    opt_d.zero_grad(); d_loss.backward(); opt_d.step()
    # Generator: non-saturating loss -log D(G(z)).
    g_loss = F.binary_cross_entropy_with_logits(D(fake), torch.ones(256, 1))
    opt_g.zero_grad(); g_loss.backward(); opt_g.step()

with torch.no_grad():
    x = G(torch.randn(5000, 8))
    dist = torch.cdist(x, centers)
    nearest = dist.min(1)
    good = nearest.values < 0.15          # within 3 std of some mode
    counts = torch.bincount(nearest.indices[good], minlength=8)
print("fraction near a mode:", round(good.float().mean().item(), 3))
print("modes with >= 1% of samples:", int((counts >= 50).sum()))
print("samples per mode:", counts.tolist())
輸出為:
程式碼 · 3 行
fraction near a mode: 0.896
modes with >= 1% of samples: 7
samples per mode: [590, 14, 710, 276, 651, 731, 863, 646]
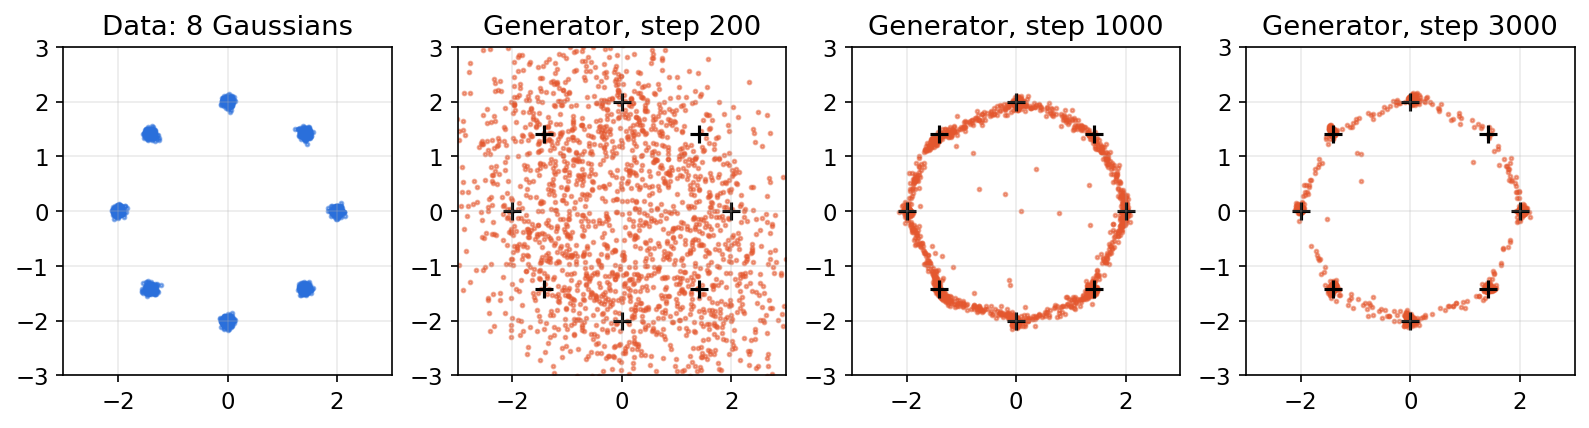
約 90% 的樣本落在某個模態上,但 45° 方向的模態在 5,000 個樣本中只分到 14 個,另一個模態也明顯偏少。這就是當場抓到的部分模式崩塌。圖 4 呈現生成器的演變:早期是一團沒有結構的點雲,接著是一個涵蓋所有模態、但也涵蓋模態之間空隙的圓環,最後是更銳利的群聚,卻幾乎放棄了一個模態。精確數字會隨亂數種子與套件版本改變,但這個定性現象很典型。
模式崩塌及其成因
當生成器產生的輸出種類太少,就發生了模式崩塌。生成器得到的獎勵來自「目前的判別器接受的樣本」,而不是多樣性。如果它找到一塊判別器喜歡的區域,就可以把樣本都堆在那裡;判別器接著學會拒絕那塊區域,生成器再跳到另一塊,雙方可能互相追逐而不收斂。與最大概似不同,生成器的逐樣本損失中,沒有任何一項會直接懲罰漏掉某個模態。Salimans 等人 [12] 提出了特徵匹配(feature matching)與小批次判別(minibatch discrimination)等早期對策,讓判別器看整批樣本的統計量,於是多樣性不足就能被察覺。
所以一組清晰、逼真的影像,仍可能只涵蓋資料分布的一小部分。品質與涵蓋度一定要分開量測——我們會在評估一節回到這點。
Wasserstein GAN
當 與 分布在又薄、又互不重疊的集合上(影像在像素空間中正是如此),JSD 會卡在最大值 ,無法提供「兩者相距多遠」的有用梯度。Arjovsky 等人 [13] 改用 Wasserstein-1(推土機)距離:把一個分布的機率質量搬到另一個分布的最小成本。根據 Kantorovich–Rubinstein 定理,它的對偶形式是
上確界取遍所有 1-Lipschitz 函數 (輸入從 變到 時,輸出變化不超過 )。網路 這時改稱為評論器(critic):它輸出無上下界的分數,而不是機率。即使兩個支撐集不重疊,生成器樣本越靠近資料,Wasserstein 距離也會平滑地縮小。
難處在於如何落實 Lipschitz 限制。原始 WGAN 把評論器的每個權重裁剪到一個小區間,作法粗糙,可能讓評論器過於簡單。WGAN-GP [14] 改為加上梯度懲罰
其中 是在真實樣本與生成樣本配對之間的直線上均勻抽取, 是權重(論文使用 10)。另外兩個廣泛使用的穩定技巧直接作用在判別器上:頻譜正規化(spectral normalization) [15] 把每個權重矩陣除以它最大的奇異值,逐層限制 Lipschitz 常數;Mescheder 等人 [16] 分析的 R1 懲罰則在真實資料上懲罰 ,他們證明這能帶來局部收斂,而未正則化的 GAN 訓練可能會震盪。
架構,以及 GAN 現在用在哪裡
StyleGAN [17] 說明架構與損失同樣重要:它把雜訊映到一個中介潛在空間,再把這個「風格」注入每一個解析度,得到可控制、高品質的人臉合成。GAN 只需一次生成器前向傳遞就能取樣,推論很快。對抗損失也常作為其他系統的元件出現——例如在影像 tokenizer 中用來重建清晰細節。但這不代表每個使用這種 tokenizer 的模型都是 GAN 生成器;分布可能完全由別的東西建模。
選讀:GAN(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
正規化流:可逆轉換
白話版。 正規化流透過可逆映射變換簡單密度;追蹤各映射的體積變化,即可計算模型密度。
變數變換
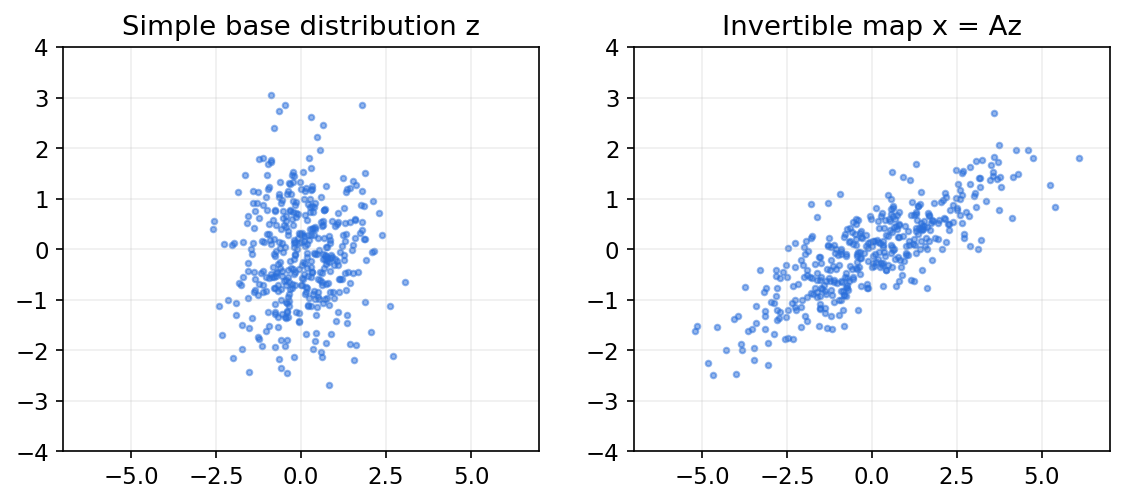
令 是簡單的基底分布, 是同維度、可逆且可微的映射。則
是映射的 Jacobian 矩陣,它的行列式衡量映射把 附近的小體積放大了多少。機率質量守恆,所以若一塊區域被拉伸成兩倍體積,它的密度就必須減半。在一維中, 讓每個區間加倍,對數密度加上 。組合映射 只要把各步的對數行列式加起來。
耦合層
公式是精確的,但一般 行列式的成本是 ——對影像來說毫無希望。流的層因此被設計成 Jacobian 為三角矩陣,行列式就只是對角線的乘積。RealNVP [18] 的仿射耦合層把 分成兩半 ,計算
其中 與 是任意神經網路。Jacobian 是區塊三角矩陣:第一塊是單位矩陣,第二塊是 ,所以 。反函數一樣便宜:。關鍵在於 與 永遠不需要求逆,所以可以任意複雜。交替切分方式堆疊多層,就能讓每個座標都被轉換。Glow [19] 則在耦合層之間加入學習得到的可逆 1 × 1 卷積,作為廣義的通道排列。
程式:驗證耦合層的對數行列式
下面的程式建立一個仿射耦合層,並把它便宜算出的對數行列式,與 autograd 算出的完整 Jacobian 做比對。
程式碼 · Python · 40 行
import torch
from torch import nn

torch.manual_seed(0)

class AffineCoupling(nn.Module):
    """RealNVP-style layer: keep x1, scale-and-shift x2 using x1."""
    def __init__(self, dim, hidden=32):
        super().__init__()
        self.d = dim // 2
        self.net = nn.Sequential(nn.Linear(self.d, hidden), nn.Tanh(),
                                 nn.Linear(hidden, 2 * (dim - self.d)))

    def forward(self, x):
        x1, x2 = x[..., :self.d], x[..., self.d:]
        s, t = self.net(x1).chunk(2, dim=-1)
        s = torch.tanh(s)                       # keep scales moderate
        y2 = x2 * s.exp() + t
        return torch.cat([x1, y2], -1), s.sum(-1)   # output, log|det J|

    def inverse(self, y):
        y1, y2 = y[..., :self.d], y[..., self.d:]
        s, t = self.net(y1).chunk(2, dim=-1)
        s = torch.tanh(s)
        return torch.cat([y1, (y2 - t) * (-s).exp()], -1)

layer = AffineCoupling(4)
x = torch.randn(4)
y, logdet = layer(x)
J = torch.autograd.functional.jacobian(lambda v: layer(v)[0], x)
print("log|det J| from layer:   ", round(logdet.item(), 5))
print("log|det J| from autograd:", round(torch.linalg.slogdet(J)[1].item(), 5))
print("upper-right block is zero:", bool(torch.allclose(J[:2, 2:], torch.zeros(2, 2))))
print("inverse error:", (layer.inverse(y) - x).abs().max().item() < 1e-6)

# Log density of y under a standard-normal base after one layer:
base = torch.distributions.Normal(0., 1.)
z = layer.inverse(y)
log_px = base.log_prob(z).sum() - layer(z)[1]
print("log p(y):", round(log_px.item(), 4))
兩個對數行列式都印出 0.14867,Jacobian 右上區塊恰好為零(三角結構),反函數也還原了輸入。最後一行就是變數變換公式的實際運作。訓練一個流模型,就是用一疊這樣的層,在資料上最大化這個 log p。
優點、限制與連續流
流模型提供精確概似、精確反演(適合影像編輯,也能把資料映到性質良好的潛在空間),以及一次前向傳遞的取樣。代價在於架構:每一層都必須可逆且行列式便宜,而且潛在空間必須與資料同維度,這會把容量浪費在表示所有像素方向上的雜訊。Rezende 與 Mohamed [20] 最初提出流,是為了讓 VAE 的近似後驗更有彈性,這說明同一個工具既能用於推論,也能用於生成。
連續正規化流把離散的層疊換成常微分方程 。Neural ODE [21] 指出,這時對數密度是透過 的散度(Jacobian 的跡)而非行列式來演化,於是解除了架構限制,但計算概似需要解一次 ODE。ML 08 介紹的流匹配(flow matching) [22],則用簡單的迴歸而非最大概似來訓練這種向量場。所以「流」這個詞指的是相關的轉換,但訓練目標不一定是概似。
能量模型
白話版。 與其描述怎麼產生影像,不如給每一張可能的影像打一個分數——「能量」——能量越低代表越「像真的」。能量低的地方,機率就高。
能量模型(energy-based model,EBM)定義
其中 是任何輸出純量的網路, 是讓密度積分為一的配分函數(partition function)。EBM 極有彈性——任何架構都行——但在高維中 無法計算,所以概似與精確樣本都無法直接取得。Goodfellow、Bengio 與 Courville [23] 涵蓋了經典工具(配分函數與近似推論等章節),Song 與 Kingma [24] 則整理了現代的訓練途徑:搭配 MCMC 樣本(例如 Langevin 動力學)的最大概似;分數匹配(score matching),它擬合 ,因而完全不需要 ;以及雜訊對比類方法。分數匹配正是通往擴散模型的橋樑。
自迴歸模型(簡介)
白話版。 一次產生影像的一小塊,每一塊都以目前已產生的全部內容為條件,就像一個字一個字地寫句子。
對 的 個元素採用任何順序,機率的連鎖律都是精確的:
每個因子都是一般的分類或迴歸問題,所以訓練就是簡單、穩定、具精確概似的最大概似。PixelRNN 與 PixelCNN [25] 就是這樣對原始像素建模,每個子像素用一個 256 類的 softmax。缺點是取樣必須循序進行: 個元素要 次網路計算。現代系統改為預測壓縮後的 token、一組組的 token 或整個尺度。ML 09 會詳細介紹這個家族。
擴散模型(簡介)
白話版。 教一個網路從帶雜訊的影像中去掉一點點雜訊。然後從純雜訊出發,反覆套用這個去雜訊器,慢慢雕出一張影像。
擴散模型定義一個固定的前向過程,逐步對資料加入高斯雜訊,直到只剩雜訊;再學習一個逐步還原的反向過程。Ho 等人 [26] 證明,訓練(在權重之外)可以化約成預測被加入的雜訊——一個簡單的迴歸——而且這個目標是重新加權的變分下界,這也是圖 1 把擴散模型放在 VAE 旁邊的原因。與分數匹配的連結(見能量模型一節)提供了第二個等價觀點。Yang 等人的綜述 [27] 整理了眾多變體。擴散模型與流匹配如今主導高品質影像生成,是 ML 08 的主題。
家族地圖
| 家族 | 基本訓練訊號 | 取樣機制 | 概似 | 主要限制 |
|---|---|---|---|---|
| VAE | 變分下界(ELBO) | 取樣潛在變數再解碼(一次傳遞) | 下界 | 下界取決於近似推論;樣本可能模糊 |
| GAN | 對抗判別 | 生成器前向傳遞(一次) | 無 | 遊戲不穩定;模式崩塌 |
| 正規化流 | 變數變換概似 | 可逆轉換(一次) | 精確 | 可逆性與同維度限制 |
| 自迴歸 | 條件概似 | 循序條件取樣 | 精確 | 生成時的相依性可能代價高 |
| 擴散 | 去雜訊/分數目標 | 反向雜訊過程(多步) | 下界或基於 ODE | 品質取決於模型與取樣器 |
| 流匹配 | 速度場迴歸 | 對學到的向量場積分 | 需額外計算 | 積分成本 |
| 能量模型 | 能量學習(MCMC、分數匹配) | 常需迭代取樣 | 未正規化 | 正規化與混合可能困難 |
Bond-Taylor 等人 [3] 把這些取捨總結成一個很難同時滿足的三角:快速取樣、高樣本品質、良好的模態涵蓋。GAN 快又清晰,但可能漏掉模態;概似式模型涵蓋模態,但過去較慢或較模糊;擴散模型以多步取樣為代價,達到高品質與高涵蓋。這張表是教學用的整理,不是互斥的分類。實際模型常結合多個家族:VAE 壓縮影像、Transformer 建模它的潛在分布,再用擴散目標訓練那個 Transformer。
評估生成模型
白話版。 生成器可以在不同面向上「好」:給真實資料高機率、產生個別看來逼真的樣本、涵蓋資料中的所有多樣性,或遵循它的條件。沒有任何單一數字能涵蓋全部,所以要用多個指標,並清楚每個指標漏掉了什麼。
Theis 等人 [5] 把這點講得很透徹:在高維中,平均對數概似、樣本品質,以及 Parzen 窗估計之類的舊代理指標,彼此可以大致獨立。模型可能概似很好但樣本很差,反之亦然。請依你實際的用途來評估。
概似
對概似式模型而言,保留資料上的 NLL(或每維位元數)有理論根據,在去量化與前處理一致時也可以相互比較。GAN 則無法計算它。而且高概似不代表能可靠地偵測分布外資料:Nalisnick 等人 [28] 發現,在 CIFAR-10 上訓練的流模型、VAE 與 PixelCNN,可能給不相關的 SVHN 門牌數字影像更高的概似,因為概似主要受平滑度這類低階統計量主導,而非語意內容。
Inception Score
Salimans 等人 [12] 提出 Inception Score(IS)。把每張生成影像 送進預訓練的 ImageNet 分類器(Inception-v3),得到標籤分布 ,並令 為對樣本的平均。則
當每張影像都被有信心地分類( 尖銳)、整組樣本又涵蓋許多類別( 分散)時,IS 就高。它從不看真實資料,所以無法判斷樣本是否像你的資料集,而且只對類似 ImageNet 的內容有意義。
Fréchet Inception Distance
Heusel 等人 [29] 提出的 Fréchet Inception Distance(FID) 在特徵空間中比較真實與生成影像。對兩組影像擷取 Inception-v3 特徵,各自擬合一個高斯——平均值 與共變異數 ——再計算兩個高斯之間的 Fréchet 距離:
越低越好。FID 使用真實資料,對品質與多樣性都敏感,因此成為標準指標。但它不是逐張影像的真實度量:它取決於特徵擷取器、影像縮放方式,特別是樣本數(有限樣本下它有偏差,所以只能比較樣本數相同的 FID),而且它把品質與涵蓋度混成一個數字。
精確率與召回率
為了把兩者分開,Sajjadi 等人 [30] 定義了分布的精確率與召回率:精確率問的是生成樣本中有多少比例落在真實資料所在之處(品質),召回率問的是真實分布有多少比例被生成器涵蓋(多樣性)。Kynkäänniemi 等人 [31] 提出一個簡單又穩健的估計方法,以下就來實作。用一組球的聯集近似每組樣本的流形,每顆球的半徑等於該點到同組中第 個最近鄰的距離。於是
- 精確率 = 落在某個真實樣本的球內的生成樣本比例;
- 召回率 = 落在某個生成樣本的球內的真實樣本比例。
在影像上,這些點是深度特徵而非像素。在我們的二維圓環上,可以直接用座標:
程式碼 · Python · 30 行
import numpy as np

rng = np.random.default_rng(0)
angles = np.arange(8) * 2 * np.pi / 8
centers = 2 * np.stack([np.cos(angles), np.sin(angles)], 1)

def ring(n, modes):
    idx = rng.choice(modes, n)
    return centers[idx] + .05 * rng.standard_normal((n, 2))

def knn_radius(a, k):
    d = np.linalg.norm(a[:, None] - a[None], axis=-1)
    return np.sort(d, axis=1)[:, k]          # column 0 is the point itself

def coverage(query, ref, k=3):
    """Fraction of query points inside some reference point's k-NN ball."""
    r = knn_radius(ref, k)
    d = np.linalg.norm(query[:, None] - ref[None], axis=-1)
    return np.mean((d <= r[None]).any(axis=1))

real = ring(1000, range(8))
fakes = {
    "all 8 modes": ring(1000, range(8)),
    "only 2 modes": ring(1000, [0, 4]),
    "8 modes, blurry": ring(1000, range(8)) + .4 * rng.standard_normal((1000, 2)),
}
for name, fake in fakes.items():
    precision = coverage(fake, real)   # are fake samples on the real manifold?
    recall = coverage(real, fake)      # is the real manifold covered by fakes?
    print(f"{name:16s} precision={precision:.2f} recall={recall:.2f}")
輸出
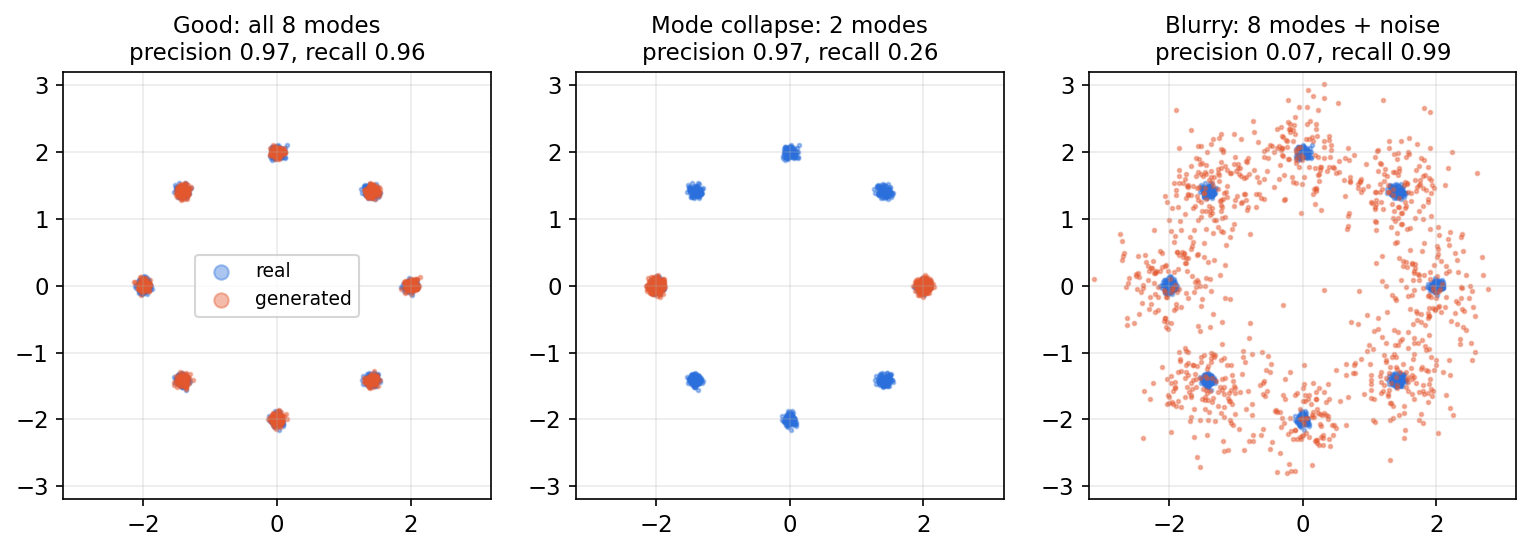
all 8 modes      precision=0.97 recall=0.96
only 2 modes     precision=0.97 recall=0.26
8 modes, blurry  precision=0.07 recall=0.99
模式崩塌的生成器維持很高的精確率——它的每個樣本都很完美——但召回率掉到約 2/8。模糊的生成器恰好相反:它涵蓋每個模態,但大多數樣本偏離資料。像 FID 這樣的單一純量會把兩者都判為「比較差」,卻說不出為什麼。圖 6 呈現這三種情況。
現行指標的已知限制
評估本身就是活躍的研究領域。Stein 等人 [32] 進行了大規模人類實驗,發現沒有任何現有自動指標與人類的真實感判斷有強相關;特別是以 Inception 特徵計算的 FID,低估了擴散模型的感知真實度。他們建議 FID 與精確率/召回率之類的指標改用更豐富的自監督特徵空間(DINOv2 ViT-L/14)。Jayasumana 等人 [33] 主張 FID 的常態假設與 Inception 特徵不適合現代文字生成影像模型,並提出 CMMD:在 CLIP 嵌入上計算的最大平均差異(maximum mean discrepancy),不需要高斯假設。實務建議:回報多個互補指標並附上確切協定(特徵擷取器、樣本數、解析度、參考集)、展示未經挑選的樣本,而當主張涉及「看起來的品質」時,進行人類評估。
條件式任務還要加上對齊度的量測(影像是否符合文字或低解析度輸入?)。在影像復原中,一個漂亮的生成紋理可能沒有觀測資料支持;「看起來合理的樣本」與「量測到的證據」之間的區別,是 DLCV 09 的核心議題。
現代觀點
值得一讀的綜述。 四篇綜述從不同角度涵蓋本章內容。
- Bond-Taylor 等人 [3](IEEE TPAMI 2022)是 VAE、GAN、正規化流、能量模型與自迴歸模型最好的單篇比較綜述。它依核心技術與已知病徵整理每個家族,並從訓練速度、取樣速度、樣本品質、多樣性與概似加以比較,結論是每個家族都在某處用弱點換來優點,而混合方法是自然的前進方向。
- Papamakarios 等人 [4](JMLR 2021)是正規化流的統一論述:表達能力、耦合式/自迴歸式/殘差式/連續式流的設計空間,以及在密度估計、推論與模擬上的用途。
- Kingma 與 Welling [9](Foundations and Trends in ML 2019)是 VAE 發明者撰寫的權威教學綜述:推導、重參數化估計量、更緊的下界、更有彈性的後驗(包括流)、階層式模型,以及加權 β 的變體。
- Yang 等人 [27](ACM Computing Surveys 2023)綜述擴散模型——取樣加速、概似改進、結構化資料,以及與 VAE、GAN、流和 EBM 的關聯——是通往下一章的橋樑。
Bishop 與 Bishop [1]、Prince [2] 的教科書對所有家族都有一致的推導,Prince 的 notebook 更提供可執行的配套程式。
領域現況(2023–2026)。 擴散與流匹配模型——通常在學到的潛在空間中運作——如今產出了大部分最先進的影像與影片生成結果。這讓自編碼器再次成為承重元件:VQ-VAE [34] 展示了如何學習離散潛在碼,讓另一個先驗模型去建模;潛在擴散 [35] 則證明,把生成模型放在壓縮後的自編碼器潛在空間中執行,能在保留細節的同時大幅降低成本。tokenizer 必須在壓縮率、重建品質,以及潛在空間是否容易建模之間取得平衡;請先評估它的重建,因為下游先驗無法還原編碼器已經丟掉的細節。
GAN 並沒有消失。GigaGAN [36] 把 GAN 擴展到文字生成影像,並凸顯 GAN 仍然最擅長的事:快到足以互動使用的單次傳遞取樣、高解析度上取樣,以及平滑、可編輯的潛在空間。Huang 等人 [37] 重新檢視訓練目標本身,推導出具局部收斂保證的正則化相對式(relativistic)GAN 損失,並顯示一個不依賴傳統技巧大全的極簡現代基準(R3GAN)在標準基準上能超越 StyleGAN2。對抗損失也繼續存在於其他系統中,例如用來讓 tokenizer 的重建更銳利。
在評估方面,2023–2024 年對 FID 的批評 [32]、[33] 推動領域轉向更豐富的特徵擷取器、分開的精確率/召回率式指標與人類評估,但至今仍沒有公認的單一指標。
開放問題。(1)與人類一致、且能區分品質、多樣性與記憶的可靠評估。(2)偵測模型何時在複製訓練影像而非泛化。(3)真正能用於分布外偵測的校準概似 [28]。(4)速度、品質與涵蓋度的三角取捨:在不失去模態的前提下,以 GAN 的速度達到擴散模型的品質。(5)學出同時具備壓縮性、忠實性又容易建模的潛在空間。
重點整理
- 生成器需要明確分布或取樣程序,只有重建並不足夠。
- 最大概似擬合觀測資料的機率;高概似與逼真樣本是不同目標。
- ELBO 是對數概似的下界,差距取決於近似後驗的失配。
- 對抗目標依賴判別器行為,訓練改進不保證收斂或避免模式崩塌。
- 可逆流透過 Jacobian 行列式追蹤密度;可計算的變換限制其設計。
- 回報互補指標,並交代特徵擷取器、樣本數與條件設定協定。
練習
- KL 健全性檢查。 把 、 代入高斯 KL。接著計算一維中 的 KL。
提示
時每一項都是零,因為後驗與先驗是同一個分布。 時得到 nats:把平均值移動一個標準差,代價是半個 nat。
- 損失縮放。 把 VAE 的重建項改成對像素取平均而不是加總。若 KL 保持不變,會發生什麼事?
提示
相對於 KL,重建項變小了 64 倍。這等同於對加總損失使用 的 β-VAE:它實際上改變了正則化強度(往往導向後驗崩塌),而不只是改變回報的單位。
- 最佳判別器。 在 、 的點 上, 是多少?當 時, 處處是多少?此時遊戲的值是多少?
提示
。兩個分布相同時,處處 ,,與 一致。
- 仿射流。 對 、,推導密度修正項,並說明為何奇異的 會使它失效。再用已知的高斯 檢查你的答案。
提示
減去 。因為 ,這與 的正規化常數一致。奇異映射不可逆,會把體積壓扁,所以同維度的變數變換公式不適用。
- 辨認崩塌。 分別為 VAE 後驗崩塌與 GAN 模式崩塌提出不同的檢查方法。接著把 GAN 程式改成 WGAN-GP(評論器不加 sigmoid、梯度懲罰 、每次生成器更新前做多次評論器更新),並比較各模態的樣本數。
提示
VAE:檢查每個潛在維度的 KL,以及改變 時解碼輸出是否跟著變。GAN:統計每個模態的樣本數(如我們的程式)、計算召回率,並在固定條件下找重複的樣本。這是兩種不同的失敗。WGAN-GP:取樣 、,呼叫 torch.autograd.grad 並設 create_graph=True;若訓練震盪就降低學習率。下結論前請比較多個亂數種子。
- 指標的盲點。 利用精確率/召回率程式,建構一組生成樣本,使它的精確率與召回率和好的生成器差不多,但一半的樣本只集中在四個模態。這告訴你這個指標有什麼限制?
提示
模態權重不均仍可能得到高召回率,因為召回率只問每個真實點附近是否有某個生成點,而不問模態的頻率是否相符。精確率/召回率量測的是支撐集的重疊,而不是密度;請搭配 FID 這類分布層級的指標或逐模態直方圖。
參考文獻
- C. M. Bishop and H. Bishop, Deep Learning: Foundations and Concepts, Springer, 2024. Book
- S. J. D. Prince, Understanding Deep Learning, MIT Press, 2023. Book and notebooks
- S. Bond-Taylor, A. Leach, Y. Long and C. G. Willcocks, “Deep Generative Modelling: A Comparative Review of VAEs, GANs, Normalizing Flows, Energy-Based and Autoregressive Models,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2022. Paper
- G. Papamakarios et al., “Normalizing Flows for Probabilistic Modeling and Inference,” JMLR, 2021. Review
- L. Theis, A. van den Oord and M. Bethge, “A note on the evaluation of generative models,” ICLR, 2016. Paper
- D. P. Kingma and M. Welling, “Auto-Encoding Variational Bayes,” ICLR, 2014. Paper
- S. R. Bowman et al., “Generating Sentences from a Continuous Space,” CoNLL, 2016. Paper
- I. Higgins et al., “β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework,” ICLR, 2017. Paper
- D. P. Kingma and M. Welling, “An Introduction to Variational Autoencoders,” Foundations and Trends in Machine Learning, 2019. Review
- A. Vahdat and J. Kautz, “NVAE: A Deep Hierarchical Variational Autoencoder,” NeurIPS, 2020. Paper
- I. Goodfellow et al., “Generative Adversarial Nets,” NeurIPS, 2014. Paper
- T. Salimans et al., “Improved Techniques for Training GANs,” NeurIPS, 2016. Paper
- M. Arjovsky, S. Chintala and L. Bottou, “Wasserstein GAN,” ICML, 2017. Paper
- I. Gulrajani et al., “Improved Training of Wasserstein GANs,” NeurIPS, 2017. Paper
- T. Miyato et al., “Spectral Normalization for Generative Adversarial Networks,” ICLR, 2018. Paper
- L. Mescheder, A. Geiger and S. Nowozin, “Which Training Methods for GANs do actually Converge?” ICML, 2018. Paper
- T. Karras, S. Laine and T. Aila, “A Style-Based Generator Architecture for Generative Adversarial Networks,” CVPR, 2019. Paper
- L. Dinh, J. Sohl-Dickstein and S. Bengio, “Density estimation using Real NVP,” ICLR, 2017. Paper
- D. P. Kingma and P. Dhariwal, “Glow: Generative Flow with Invertible 1x1 Convolutions,” NeurIPS, 2018. Paper
- D. J. Rezende and S. Mohamed, “Variational Inference with Normalizing Flows,” ICML, 2015. Paper
- R. T. Q. Chen, Y. Rubanova, J. Bettencourt and D. Duvenaud, “Neural Ordinary Differential Equations,” NeurIPS, 2018. Paper
- Y. Lipman et al., “Flow Matching for Generative Modeling,” ICLR, 2023. Paper
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 18–20. Book
- Y. Song and D. P. Kingma, “How to Train Your Energy-Based Models,” arXiv, 2021. Paper
- A. van den Oord, N. Kalchbrenner and K. Kavukcuoglu, “Pixel Recurrent Neural Networks,” ICML, 2016. Paper
- J. Ho, A. Jain and P. Abbeel, “Denoising Diffusion Probabilistic Models,” NeurIPS, 2020. Paper
- L. Yang et al., “Diffusion Models: A Comprehensive Survey of Methods and Applications,” ACM Computing Surveys, 2023. Survey
- E. Nalisnick et al., “Do Deep Generative Models Know What They Don’t Know?” ICLR, 2019. Paper
- M. Heusel et al., “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” NeurIPS, 2017. Paper
- M. S. M. Sajjadi, O. Bachem, M. Lucic, O. Bousquet and S. Gelly, “Assessing Generative Models via Precision and Recall,” NeurIPS, 2018. Paper
- T. Kynkäänniemi, T. Karras, S. Laine, J. Lehtinen and T. Aila, “Improved Precision and Recall Metric for Assessing Generative Models,” NeurIPS, 2019. Paper
- G. Stein et al., “Exposing flaws of generative model evaluation metrics and their unfair treatment of diffusion models,” NeurIPS, 2023. Paper
- S. Jayasumana et al., “Rethinking FID: Towards a Better Evaluation Metric for Image Generation,” CVPR, 2024. Paper
- A. van den Oord, O. Vinyals and K. Kavukcuoglu, “Neural Discrete Representation Learning,” NeurIPS, 2017. Paper
- R. Rombach et al., “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. Paper
- M. Kang et al., “Scaling up GANs for Text-to-Image Synthesis,” CVPR, 2023. Paper
- Y. Huang, A. Gokaslan, V. Kuleshov and J. Tompkin, “The GAN is dead; long live the GAN! A Modern GAN Baseline,” NeurIPS, 2024. Paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 08・擴散模型與流匹配 · 40 分鐘