ML 03・卷積、影像濾波與 CNN
先備知識:ML 02・類神經網路:從感知器到深度網路、影像就是陣列
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 說明濾波核,區分互相關與卷積。
- 實作濾波,明確選擇資料型別與邊界規則。
- 追蹤通道、填補、步幅、膨脹與輸出形狀。
- 連結感受野、平移行為與反向傳播。
- 從結構與計算選擇比較 CNN 設計。
先看全貌
影像是一個數字網格(見 影像就是陣列)。我們想對影像做的許多事都是局部的:一個像素是在邊緣上、在平滑區域內,還是在雜訊斑塊裡,大多取決於它的鄰居。卷積正是把「看一小塊鄰域、用固定權重組合、然後在每個位置重複」這件事形式化的運算。它是古典影像處理的主力工具,也是卷積神經網路(convolutional neural network, CNN)的基本積木;差別在於 CNN 從資料中學習權重,而不是由人手動設計。
本篇分成兩半。前半(濾波)是古典工具箱,只需要 NumPy。後半(CNN)建立在 ML 02 之上,你在那裡已經認識了網路層、損失函數與反向傳播。若之後想更深入固定濾波器,IP 03 介紹空間濾波,IP 04 則透過卷積定理說明頻率域觀點。深度學習方面,DLCV 02 詳細探討現代分類骨幹網路,ML 04 轉向序列資料,ML 05 則介紹卷積的主要替代方案:注意力機制。標準教科書可參考 Goodfellow 等人 [1] 的第 9 章與 Prince [10] 的第 10 章。
第一部分・用固定卷積核濾波
滑動的加權和
白話版。 每個輸出像素都是輸入影像在相同位置附近像素的加權和。那一小格權重稱為卷積核(kernel,也稱為濾波器 filter 或遮罩 mask)。
精確版。 令 為灰階影像, 是第 欄、第 列的強度。令 為大小 的卷積核,垂直索引從 到 、水平索引從 到 ,因此 是它的中心。濾波後的影像 為
其中 索引卷積核的列、 索引卷積核的行, 是相同位置的輸出,雙重總和恰好走訪卷積核的每個係數一次。以 卷積核為例,,每個輸出像素需要九次乘法與八次加法。
圖 1 手算了一個輸出值。橘色視窗蓋住填補後輸入左上角的 鄰域。與卷積核逐元素相乘再相加:。這個數字就成為 在視窗中心的值。把視窗往右滑一格再重複,就填出下一個輸出。
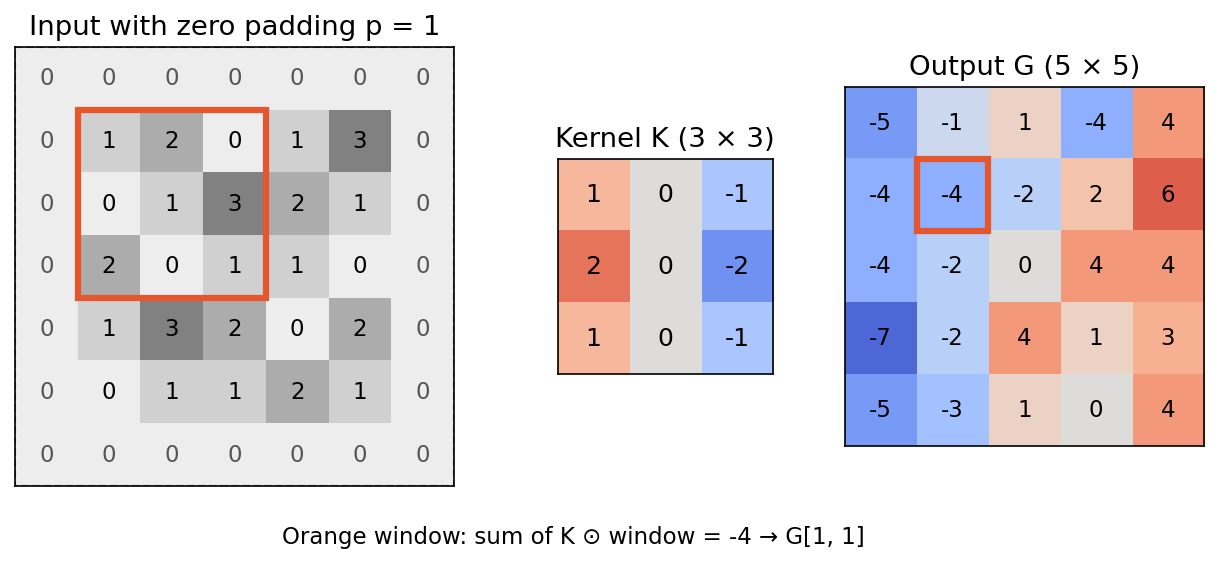
有兩個觀察對後面所有內容都很重要。第一,同樣的九個權重用在每一個位置:這個運算具有平移不變性(shift-invariant,也稱為空間不變)。第二,這個運算是線性的:對 濾波會得到 。線性平移不變(linear shift-invariant, LSI)運算恰好就是卷積能表達的那一類,這也是卷積在訊號處理中如此核心的原因。
互相關與卷積
白話版。 上面的公式在技術上是互相關(cross-correlation)。真正的卷積做同樣的事,只是卷積核先旋轉 180 度。對稱的卷積核兩者結果相同;不對稱的則不同。
精確版。 數學上的卷積寫成 :
第二種寫法顯示,卷積等於用翻轉後的卷積核 做互相關。看出差別最乾淨的方法,是對單一亮點(脈衝,impulse)濾波。互相關會留下一個旋轉 180 度的卷積核副本;卷積則留下卷積核的原樣副本。這個副本就是脈衝響應(impulse response),也是訊號處理偏好卷積的原因:任何影像的輸出,都是一堆經過平移、縮放的脈衝響應之和。
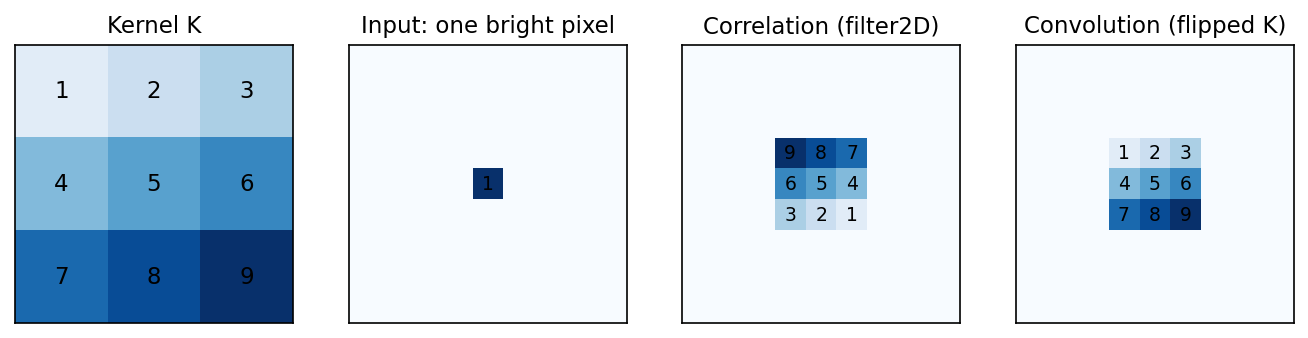
卷積具有互相關所沒有的代數性質。它滿足交換律()與結合律(),因此連續套用兩個濾波器,等於套用一個較大的濾波器。例如連續做兩次 方框模糊,就等於一個 卷積核。結合律也解釋了可分離(separable)卷積核: 的高斯核等於一個 的行濾波器再接一個 的列濾波器,每個像素的運算量從 降到 。卷積定理指出,空間中的卷積等於傅立葉域中的乘法;IP 04 會發展這個觀點。
各函式庫計算的是哪一種?
| 函式庫呼叫 | 計算內容 | 預設邊界 |
|---|---|---|
cv2.filter2D | 互相關 [11] | reflect-101(BORDER_DEFAULT) |
scipy.ndimage.correlate / convolve | 互相關 / 卷積 | reflect(重複邊緣樣本) |
scipy.signal.convolve2d | 卷積 | 補零 |
torch.nn.functional.conv2d、nn.Conv2d | 互相關 [31] | 零填補 |
對於手工設計的不對稱卷積核(Sobel、浮雕、運動模糊),翻轉與否會改變結果的正負號或方向,所以需要真正的卷積時,要刻意翻轉,例如用 cv2.flip(K, -1)。對於學習出來的卷積核,這個差別就消失了:一個「本來應該」使用翻轉卷積核的網路,會直接把翻轉後的版本學起來。這就是為什麼深度學習框架把互相關稱為「卷積」也無傷大雅。
模糊、邊緣與銳化
白話版。 總和為一的正權重會平均鄰居而產生模糊。總和為零的權重會抵消平坦區域、只留下變化,因此能找出邊緣。把一點點「影像減去其模糊版本」加回影像,就能銳化。
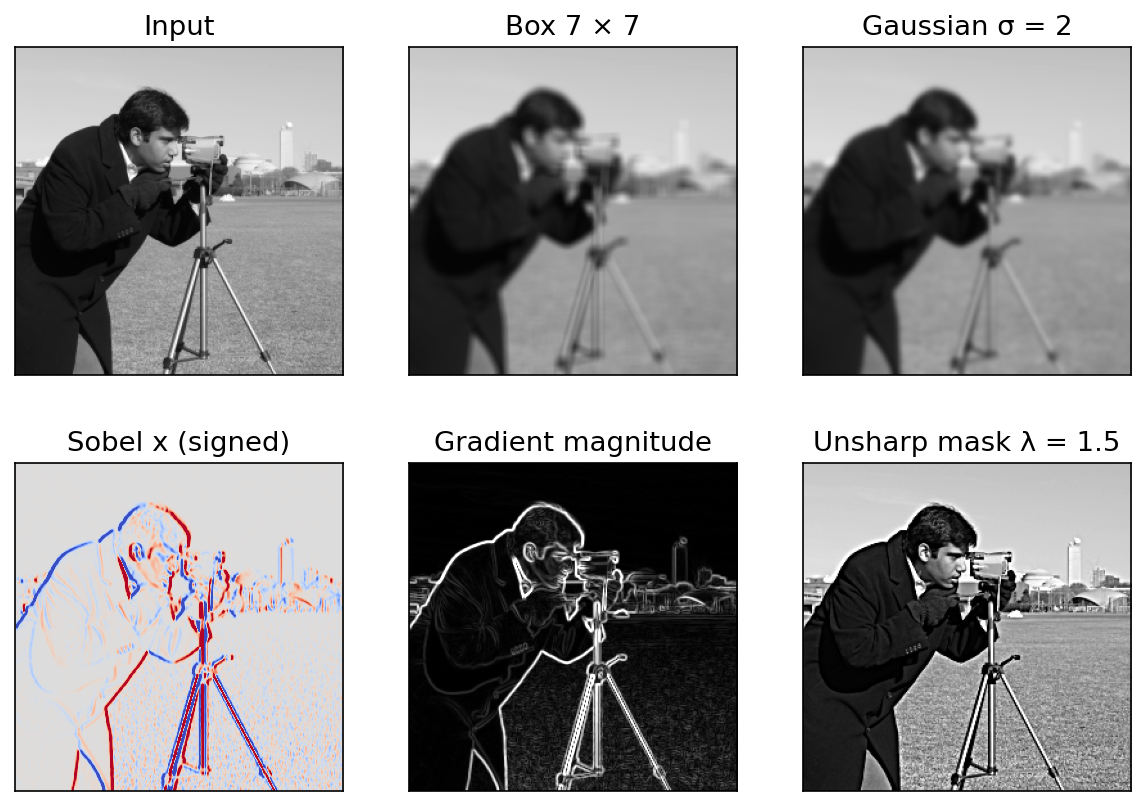
方框模糊(box blur)讓每個鄰居權重相等; 版本有九個 。高斯模糊取樣
其中 (以像素為單位)決定模糊寬度, 將權重正規化使總和為一。近的像素比遠的像素重要,因此能避免方框模糊的塊狀瑕疵。實務上常用約 的卷積核半徑。
權重總和告訴你在每個像素都等於 的平坦區域會發生什麼:輸出為 。總和為一的模糊保持亮度;總和為二的卷積核會讓亮度加倍(並使 8 位元影像飽和);總和為零的卷積核則輸出零。
Sobel 卷積核估計水平與垂直方向的導數,同時在垂直方向上做平滑:
對沿 方向的強度變化有反應,所以它凸顯垂直邊界; 凸顯水平邊界。輸出 、 帶有正負號:由暗到亮與由亮到暗的邊緣正負相反。梯度強度(gradient magnitude) 是非負的邊緣強度, 則是邊緣方向。上面的分解顯示 Sobel 是可分離的:一個 平滑行向量乘上一個 中央差分。
拉普拉斯(Laplacian)卷積核 近似 ;它對細線以及邊緣的兩側都有反應。反銳化遮罩(unsharp masking)以下式銳化:
其中 是高斯模糊後的副本, 是高頻細節, 控制強度。 太大會放大雜訊,並在邊緣兩側產生亮暗光暈。
動手試試:卷積核實驗室
編輯下方的卷積核格子,觀察輸出即時更新。先從 Sobel x 開始,然後把它轉置,改為偵測水平邊緣而非垂直邊緣。把模糊預設的每個權重都調大,你會看到平坦區域變亮,正如權重總和規則的預測。試試拉普拉斯與浮雕預設,並在看結果之前先預測它們的卷積核總和。
下方的滑桿比較一張合成測試影像(圓盤、正方形、棋盤格與條紋)與它經過 高斯模糊()的結果。細條紋與棋盤格最先消失,因為模糊是一種低通濾波器:它移除快速的強度變化,保留緩慢的變化。
程式碼:從零開始,再到 OpenCV、SciPy 與 PyTorch
下面的迴圈就是整個演算法。它不逐一走訪每個像素(在 Python 裡很慢),而是走訪卷積核的每個係數,每個係數加上一份平移過的填補影像,讓 NumPy 做向量化計算。接著程式檢查:只要對齊定義(互相關或卷積)與邊界規則,四個函式庫的結果就會一致。需要 numpy、scipy、opencv-python 與 torch。
程式碼 · Python · 45 行
import numpy as np
import cv2
import torch
import torch.nn.functional as F
from scipy import ndimage, signal

def correlate2d(img, K, mode="edge"):
    """Cross-correlation of a 2-D float image with an odd-sized kernel.
    mode is any np.pad mode: "constant" (zeros), "edge", "reflect", "wrap"."""
    kh, kw = K.shape
    ph, pw = kh // 2, kw // 2
    padded = np.pad(img, ((ph, ph), (pw, pw)), mode=mode)
    H, W = img.shape
    out = np.zeros((H, W), dtype=np.float64)
    for i in range(kh):              # loop over kernel taps, not pixels:
        for j in range(kw):          # each step adds one shifted copy of the image
            out += K[i, j] * padded[i:i + H, j:j + W]
    return out

def convolve2d(img, K, mode="edge"):
    return correlate2d(img, K[::-1, ::-1], mode)     # convolution = correlation with flipped K

rng = np.random.default_rng(0)
img = rng.random((32, 40))
K = rng.standard_normal((3, 5))                      # deliberately asymmetric

ours_corr = correlate2d(img, K, "reflect")
ours_conv = convolve2d(img, K, "reflect")
# OpenCV: filter2D computes correlation; BORDER_REFLECT_101 is np.pad's "reflect"
cv_corr = cv2.filter2D(img, cv2.CV_64F, K, borderType=cv2.BORDER_REFLECT_101)
# SciPy: ndimage.correlate / ndimage.convolve with mode="mirror" (= reflect-101)
sp_corr = ndimage.correlate(img, K, mode="mirror")
sp_conv = ndimage.convolve(img, K, mode="mirror")
# PyTorch: conv2d is correlation; pad first with the same rule
t = torch.tensor(img)[None, None]
t = F.pad(t, (2, 2, 1, 1), mode="reflect")
pt_corr = F.conv2d(t, torch.tensor(K)[None, None])[0, 0].numpy()

for name, a in [("OpenCV", cv_corr), ("SciPy", sp_corr), ("PyTorch", pt_corr)]:
    print(f"{name:8s} correlation matches:", np.allclose(ours_corr, a))
print("SciPy    convolution matches:", np.allclose(ours_conv, sp_conv))
print("conv == corr for this kernel?", np.allclose(ours_conv, ours_corr))
# zero padding: our convolution equals signal.convolve2d with mode="same"
same = signal.convolve2d(img, K, mode="same", boundary="fill")
print("zero-padded 'same' convolution matches:", np.allclose(convolve2d(img, K, "constant"), same))
除了 conv == corr 因為隨機卷積核不對稱而印出 False 之外,所有檢查都印出 True。注意命名陷阱:NumPy 的 "reflect" 填補(dcb|abcd|cba,不重複邊緣樣本)對應 OpenCV 的 BORDER_REFLECT_101 與 SciPy 的 "mirror";而 SciPy 的 "reflect" 會重複邊緣樣本(dcba|abcd|dcba)。
第二段程式碼展示了初學者處理真實影像時最常遇到的兩個錯誤:整數飽和與卷積核總和規則。
程式碼 · Python · 21 行
import numpy as np
import cv2
from skimage import data

img_u8 = data.camera()                               # 512 x 512 uint8 test image
img = img_u8.astype(np.float32) / 255.0
sobel_x = np.array([[-1, 0, 1], [-2, 0, 2], [-1, 0, 1]], np.float32)

gx = cv2.filter2D(img, -1, sobel_x)                  # float in, float out: negatives kept
gy = cv2.filter2D(img, -1, sobel_x.T)
mag = np.hypot(gx, gy)
print("float Sobel x range:", gx.min().round(3), gx.max().round(3))

gx_u8 = cv2.filter2D(img_u8, -1, sobel_x)            # uint8 in, uint8 out: saturated
print("uint8 Sobel x range:", gx_u8.min(), gx_u8.max(),
      "| pixels clipped to 0:", f"{(gx_u8 == 0).mean():.0%}")

blur = cv2.GaussianBlur(img, (5, 5), 1.4)            # 5 x 5 Gaussian, sigma 1.4
print("mean brightness kept by blur:", np.isclose(img.mean(), blur.mean(), atol=1e-3))
K2 = 2 * np.ones((3, 3), np.float32) / 9             # weights sum to 2
print("mean after sum-2 kernel:", round(float(cv2.filter2D(img, -1, K2).mean() / img.mean()), 3))
在浮點數下,Sobel 響應大約介於 到 。若輸入與輸出都是 uint8,所有負的響應都會被截成零(這裡超過一半的像素),因此所有由亮到暗的邊緣都消失了。請一律用 float32 濾波,只在顯示時才轉回整數。
邊界處理
白話版。 在影像邊緣附近,卷積核有一部分會懸在影像外面。你必須決定要假裝那裡有什麼值。
常見選擇有:零填補(常數填補),假裝外面的世界是黑色;複製(replicate),重複邊緣像素;反射(reflect),在邊界處鏡射影像;環繞(wrap),把影像視為週期性的,離散傅立葉轉換隱含的就是這種假設。OpenCV 的預設 BORDER_REFLECT_101 會鏡射但不重複邊緣像素 [11]。PyTorch 的 nn.Conv2d 預設使用零填補,除非你把 padding_mode 設為 'reflect'、'replicate' 或 'circular' [31]。
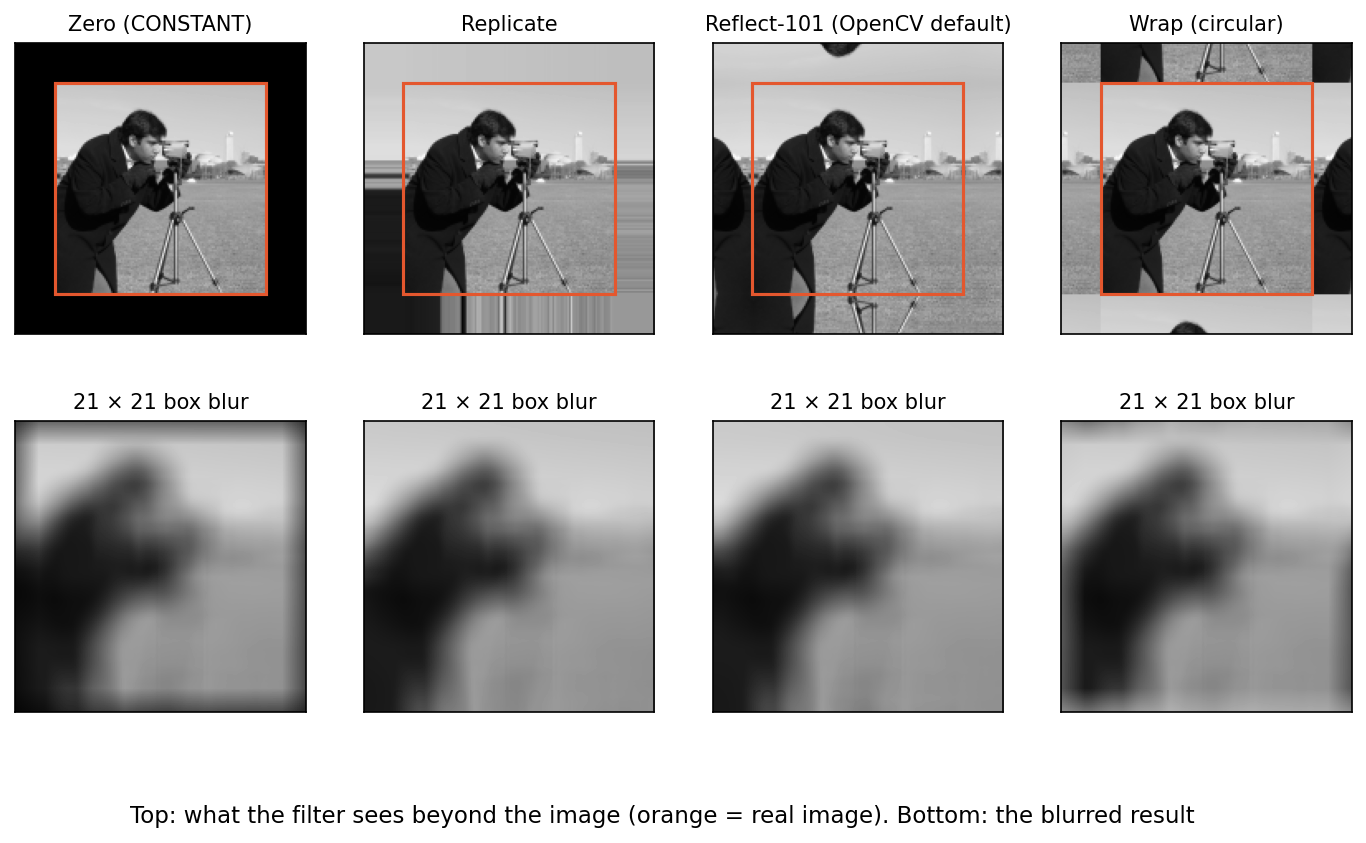
零填補會讓模糊影像的邊框變暗,因為黑色像素被平均進去了。環繞則把影像頂部混進底部。對照片而言,複製與反射通常最不顯眼。卷積核小的時候,差別只影響一圈細框;但在深層 CNN 中,每一層都會加上自己的一圈:經過許多零填補層之後,特徵圖中很大一部分都「看過」人工邊界,這讓網路能從填補中推斷出絕對位置。
第二部分・卷積神經網路
從固定濾波器到學習式網路層
白話版。 標準密集卷積學習涵蓋全部輸入通道的濾波器,各自產生一張輸出特徵圖;分組卷積則限制通道連接。
精確版。 令輸入為 (通道、高、寬),權重為 ,偏差為 。步幅為一、零填補為 的網路層計算
索引輸出通道(濾波器), 索引輸入通道, 索引輸出位置, 索引卷積核係數;影像外的位置讀取填補值。接著逐元素套用 ReLU 等非線性函數。一個 RGB 濾波器有三片 ,每個顏色通道一片,它們的響應會加總成每個位置的一個數字:一個濾波器不會產生三張分開的影像。
這個公式內建了兩個結構假設:
- 局部連接(local connectivity):每個輸出只取決於一個 鄰域,而不是整張影像。
- 權重共享(weight sharing,又稱參數共享):同一個 用在每個位置 。
兩者合起來就是 CNN 的歸納偏差(inductive bias),也就是對哪些函數比較可能的假設。它的回報是效率。一個 、、 的網路層有 個參數,與影像大小無關。若改用全連接層,把攤平的 影像映射到區區 32 個數字,就需要 百萬個權重,而且還得在每個位置分別學會同一個邊緣偵測器。
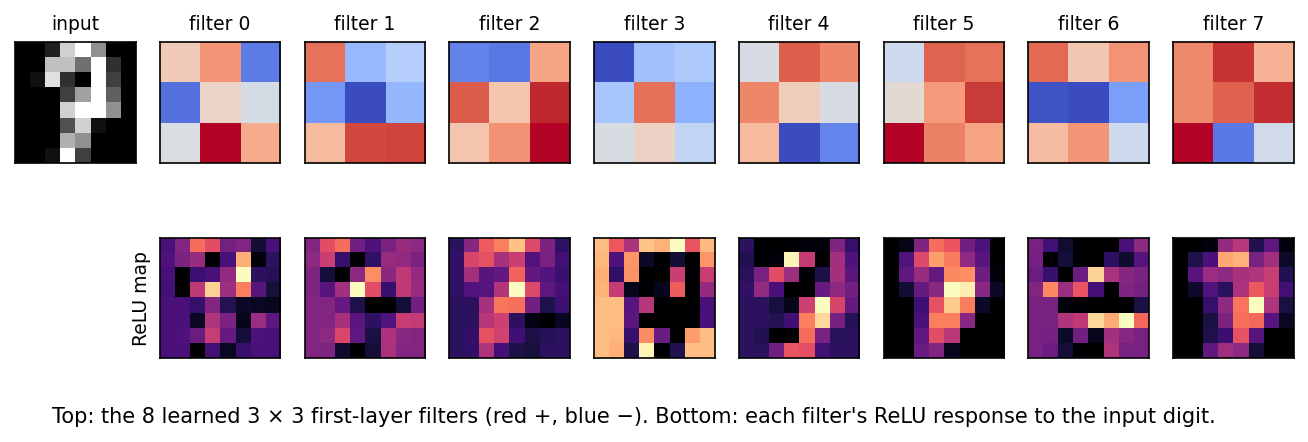
Goodfellow 等人 [1] 把動機總結為稀疏交互作用、參數共享與等變性。圖 5 展示一個小型 CNN 在後面分類器程式碼所用的 數字資料集上訓練後,第一層學到了什麼。學到的 濾波器看起來像有方向的導數與斑點偵測器:網路自己重新發現了類似 Sobel 的卷積核,因為它們有用,而不是因為有人告訴它。Zeiler 與 Fergus [30] 透過視覺化大型 ImageNet 網路的濾波器與特徵圖,在大尺度上展示了同樣的現象。
填補、步幅與膨脹
白話版。 填補(padding)控制邊界處的行為以及輸出是否維持大小。步幅(stride)跳過一些位置以縮小輸出。膨脹(dilation)把卷積核係數分散開來,不增加權重就能看得更遠。
對輸入大小 (高或寬)、卷積核大小 、每邊填補 、步幅 與膨脹 ,輸出大小為 [12]
是有效卷積核大小:膨脹 會在係數之間插入 個空隙。三種填補慣例有名稱:valid(,輸出縮小 )、same(奇數 且 時 ,輸出維持大小)、full(,計入所有部分重疊,輸出增加 )。步幅二大致把每個空間維度減半,是池化之外常見的下採樣方式。
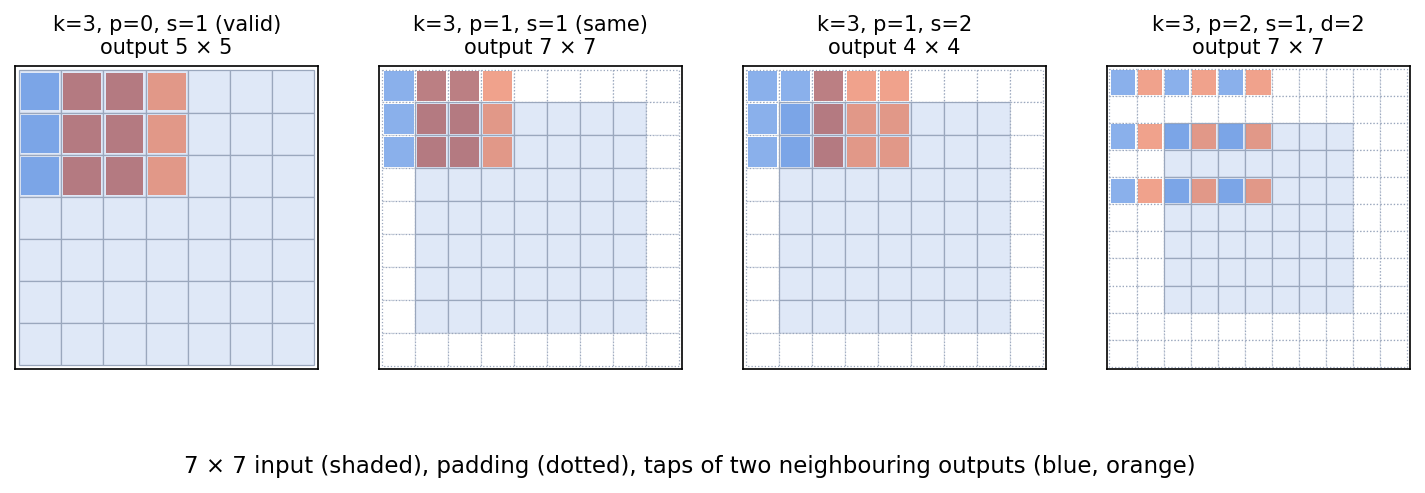
膨脹(atrous)卷積由 Yu 與 Koltun [18] 推廣到密集預測:堆疊膨脹率為 1、2、4、… 的網路層,可以在維持完整解析度的同時,讓視野呈指數成長。單一膨脹層只看到稀疏的輸入格點,因此混合膨脹率時要小心,以免產生「網格」(gridding)瑕疵。轉置卷積(transposed convolution)把帶步幅卷積的前向映射反過來執行以上採樣;它會在下面的反向傳播小節再次出現。Dumoulin 與 Visin 的卷積算術指南 [12] 為這些設定的每種組合都畫了圖解。
下面的程式碼用 PyTorch 檢查公式、計算參數量、說明 卷積就是逐像素的線性層,並量測平移等變性:
程式碼 · Python · 35 行
import torch
from torch import nn

def out_size(n, k, p=0, s=1, d=1):
    return (n + 2 * p - d * (k - 1) - 1) // s + 1

x = torch.randn(1, 3, 64, 64)                        # one RGB 64 x 64 image
for k, p, s, d in [(3, 1, 1, 1), (5, 2, 2, 1), (3, 2, 1, 2), (1, 0, 1, 1)]:
    conv = nn.Conv2d(3, 16, k, stride=s, padding=p, dilation=d)
    y = conv(x)
    n_params = sum(q.numel() for q in conv.parameters())
    assert y.shape[-1] == out_size(64, k, p, s, d)
    assert n_params == 16 * (3 * k * k + 1)
    print(f"k={k} p={p} s={s} d={d}: output {tuple(y.shape[1:])}, parameters {n_params}")

# A 1x1 convolution is the same linear layer applied at every pixel
conv1 = nn.Conv2d(16, 4, kernel_size=1)
lin = nn.Linear(16, 4)
lin.weight.data = conv1.weight.data[:, :, 0, 0].clone()
lin.bias.data = conv1.bias.data.clone()
z = torch.randn(2, 16, 8, 8)
same = torch.allclose(conv1(z), lin(z.permute(0, 2, 3, 1)).permute(0, 3, 1, 2), atol=1e-6)
print("1x1 conv == per-pixel Linear:", same)

# Translation equivariance away from borders (stride 1, no padding effects in the centre)
conv = nn.Conv2d(1, 4, 3, padding=1, bias=False)
img = torch.zeros(1, 1, 32, 32); img[..., 10:14, 8:12] = 1
shift = lambda t: torch.roll(t, shifts=(3, 5), dims=(-2, -1))
with torch.no_grad():
    a, b = conv(shift(img)), shift(conv(img))
print("shift then conv == conv then shift:", torch.allclose(a, b, atol=1e-6))
conv2 = nn.Conv2d(1, 4, 3, padding=1, stride=2, bias=False)
with torch.no_grad():
    y0, y1 = conv2(img), conv2(torch.roll(img, 1, dims=-1))   # shift by one pixel
print("stride 2, 1-pixel shift: max output change =", round((y0 - y1).abs().max().item(), 3))
它印出的輸出形狀為 、、 與 ,參數量分別為 448、1216、448 與 64; 與等變性檢查都通過;而平移一個像素會讓步幅二的輸出產生明顯非零的變化(確切數值取決於隨機初始化的權重)。
通道與 1×1 卷積
白話版。 通道是特徵圖的「是什麼」維度;高與寬是「在哪裡」維度。 卷積在每個像素混合通道,不看鄰居。
具有 個輸入與 個輸出的 卷積,會把每個像素的通道向量乘上同一個 矩陣,正如上面程式碼所驗證。Lin 等人的 Network in Network [17] 把這個想法當作迷你的逐像素 MLP,並提出全域平均池化(global average pooling)作為分類器頭部。GoogLeNet [16] 在昂貴的 與 分支之前用 網路層減少通道數,ResNet 的瓶頸區塊 [5] 則把 層夾在 縮減層與 擴張層之間。動機都相同:空間濾波的成本是通道混合的 倍,所以便宜的部分交給 網路層,昂貴的部分保持窄小。
池化與下採樣
白話版。 池化(pooling)用一個數字(通常是最大值或平均值)概括特徵圖的每個小區塊。它縮小特徵圖,並讓表示對小幅平移較不敏感。
視窗 、步幅二的最大池化保留每個區塊中的最大值:「這附近有沒有出現這個特徵?」平均池化保留平均值。全域平均池化把每個通道在所有位置上平均,不論輸入大小,每個通道都產生一個數字,這就是現代分類器能接受不同影像大小的原因。池化沒有可學習的參數。它的梯度很簡單:最大池化把整個上游梯度交給每個視窗中勝出的輸入;平均池化則把梯度平均分給視窗內所有輸入。
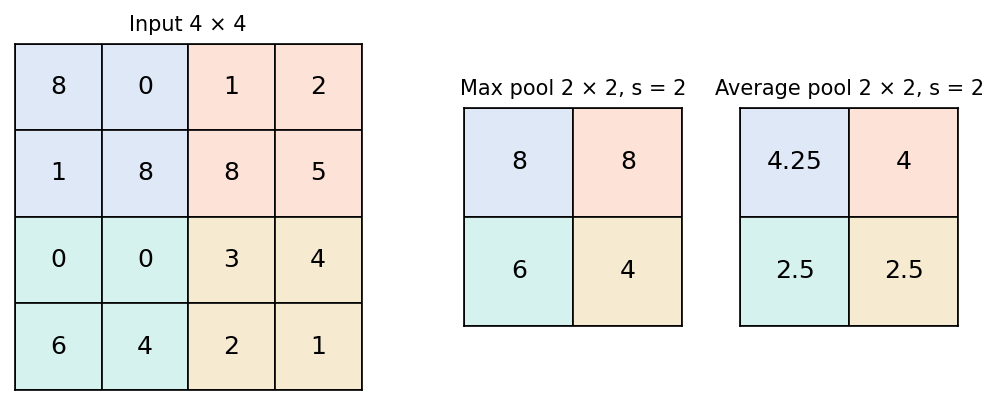
無論用池化或帶步幅的卷積,下採樣都能節省運算並擴大後續的感受野,但它也是一種沒有適當低通濾波的次取樣(subsampling)。高頻會產生混疊(aliasing),輸入只移動一個像素,輸出就可能明顯改變,正如上面程式碼所量測。Zhang [20] 證明在次取樣前插入一個小模糊(「抗混疊」或「blur pooling」),能讓標準 CNN 的平移不變性顯著提升:這是古典訊號處理規則修好深度網路的漂亮例子。
等變性不等於不變性
白話版。 排除邊界影響時,步幅為一的卷積會隨輸入平移;這種等變性不代表預測具有平移不變性。
令 把影像平移 個像素。在遠離邊界處,步幅為一的卷積具有平移等變性(translation-equivariant):。分類器要的是不變性(invariance):。CNN 藉由堆疊等變的網路層再加上池化(特別是會捨棄位置資訊的全域平均池化),得到近似的不變性。填補、步幅、裁切與有限的影像大小都會破壞精確的等變性。旋轉與尺度等變性並不是內建的;必須靠資料擴增或特別設計的群等變(group-equivariant)網路層來提供。
這個區別在實務上很重要。偵測器必須是等變的:人移動了,預測框也要跟著移動。分類器應該是不變的:人移動了,標籤不該改變。同一個骨幹網路可以服務兩者,只是頭部不同。
感受野
白話版。 前面的網路層看到影像的小碎片;較深的網路層把這些碎片組合起來,看到較大的區域。
一個單元的感受野(receptive field)是能影響它的輸入像素集合。令 為第 層之後的感受野寬度, 為跳距(jump),即第 層相鄰單元之間相隔的輸入像素數。從 開始,卷積核大小 、膨脹 、步幅 的網路層給出
三個堆疊的步幅一 網路層看到 個像素,面積與單一 網路層相同,但權重是 而不是 ,並且有三個非線性而非一個;這正是 VGG [15] 的核心設計論點。步幅二的網路層會讓跳距加倍,因此之後每一層的感受野都以兩倍速度成長。
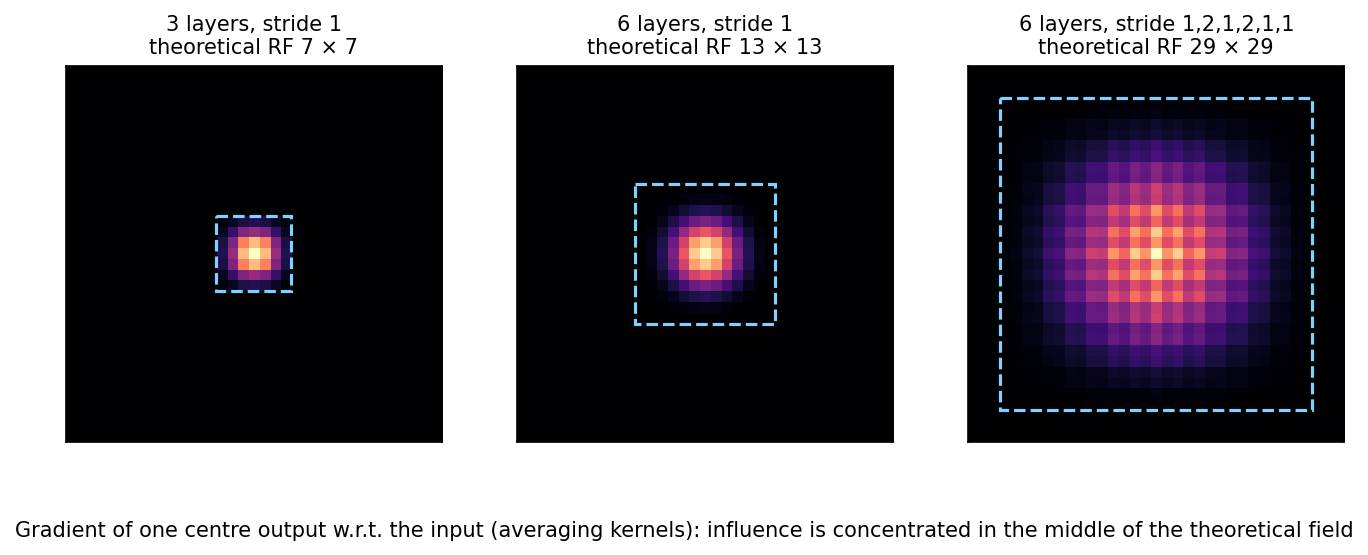
理論感受野說明哪些像素可能有影響。Luo 等人 [3] 透過輸入梯度量測有效感受野(effective receptive field),如圖 8 所示,發現它大致呈高斯形狀,只占理論感受野的一小部分,而且對均勻的網路層堆疊而言,大約隨深度的平方根成長。由此得到兩個實務教訓:網路可能需要比理論感受野所暗示的更多上下文;而下採樣、膨脹與大型卷積核,都是不必無限加深就能擴大有效感受野的方法。
卷積的反向傳播
白話版。 卷積核梯度結合輸入與上游梯度;輸入梯度使用前向線性運算子的轉置,並須配合步幅及填補規約。
精確版。 取單一通道、無填補、步幅一:。令 為損失, 為反向傳播傳來的上游梯度,如 ML 02 所述。每個權重 用在每個輸出位置,所以依連鎖律,它的梯度是對這些位置的加總:
這是輸入 與 的 valid 互相關,也說明了為什麼權重共享不會讓訓練變複雜:共享的權重只是把每個位置的梯度累加起來。每個輸入像素 會貢獻給所有視窗涵蓋它的輸出,對應係數為 :
其中 在其範圍外視為零。這是 與 的 full 卷積,等價於把零填補後的 與翻轉的卷積核做互相關。這正是轉置卷積所計算的東西,轉置卷積也因此得名。偏差的梯度就是每個輸出通道的 。若有多個通道,輸入梯度還要對輸出通道加總,卷積核梯度還要對批次加總。
程式碼 · Python · 20 行
import torch
import torch.nn.functional as F

torch.manual_seed(0)
X = torch.randn(1, 1, 6, 7, requires_grad=True)     # input
K = torch.randn(1, 1, 3, 3, requires_grad=True)     # kernel
Y = F.conv2d(X, K)                                   # 'valid' correlation: 4 x 5
G = torch.randn_like(Y)                              # pretend upstream gradient dL/dY
(Y * G).sum().backward()                             # so that dL/dY = G exactly

# 1) dL/dK: correlate the input with the upstream gradient
dK = F.conv2d(X.detach(), G)
# 2) dL/dX: 'full' convolution of G with K = correlation of zero-padded G with flipped K
dX = F.conv2d(F.pad(G, (2, 2, 2, 2)), K.detach().flip(-1, -2))
# 3) the same thing is what a transposed convolution computes
dX_t = F.conv_transpose2d(G, K.detach())

print("dL/dK matches autograd:", torch.allclose(dK, K.grad, atol=1e-5))
print("dL/dX matches autograd:", torch.allclose(dX, X.grad, atol=1e-5))
print("conv_transpose2d gives the same:", torch.allclose(dX_t, X.grad, atol=1e-5))
三行都印出 True。(Y * G).sum().backward() 這個技巧讓 autograd 使用我們指定的上游梯度 ,是測試任何手推反向傳播的好方法。
經典架構速覽
白話版。 每個知名的 CNN 都是卷積、非線性與下採樣的堆疊。這些年改變的是深度、如何讓深層堆疊可以訓練,以及如何聰明地分配運算量。
| 模型(年份) | 關鍵想法 | 帶來的啟示 |
|---|---|---|
| LeNet-5(1998)[13] | 卷積 → 次取樣 → 卷積 → 次取樣 → 全連接,端到端訓練 | 學習出來的卷積特徵在數字辨識上勝過手工特徵 |
| AlexNet(2012)[14] | 更深更寬、ReLU、dropout、資料擴增、GPU 訓練 | 大量標註資料加上 GPU 讓 CNN 贏下 ImageNet |
| VGG(2014)[15] | 只用 卷積,16–19 層 | 以小卷積核加深既簡單又有效 |
| GoogLeNet / Inception(2014)[16] | 平行的 、、 分支,搭配 縮減 | 以受控成本取得多尺度特徵 |
| ResNet(2015)[5] | 殘差連接 、BatchNorm | 非常深的網路(100 層以上)變得可以訓練 |
| U-Net(2015)[4] | 編碼器–解碼器,在每個解析度加上跳接 | 用少量影像得到密集、像素對齊的輸出 |
| MobileNetV2(2018)[7] | 深度可分離卷積、反轉殘差、線性瓶頸 | 適合手機的高準確率模型 |
| EfficientNet(2019)[8] | 深度、寬度、解析度的複合縮放 | 各維度要一起縮放,而不是一次一個 |
| ConvNeXt(2022)[9] | 深度卷積核、LayerNorm、反轉瓶頸、Transformer 時代的訓練方法 | 現代化的純 CNN 可與視覺 Transformer 競爭 |
從 LeNet 到 ResNet 的模式是深度穩定增加。AlexNet [14] 證明,用 GPU、ReLU 與 dropout 在 ImageNet 上訓練的深層 CNN 能大幅勝過傳統流程。VGG [15] 主張使用一致的 網路層堆疊,如感受野小節所計算。GoogLeNet [16] 用 縮減讓寬度變便宜。接著深度撞上了最佳化之牆:層數更多的普通網路反而有更高的訓練誤差,這不是過擬合(overfitting),而是最佳化失敗。ResNet [5] 用恆等捷徑解決了這個問題。DLCV 02 會沿著這條路線繼續探討訓練方法、遷移學習與評估。
殘差區塊與正規化
白話版。 不要求一個區塊計算整個輸出,而是要它計算對輸入的修正量。
殘差區塊計算 ,其中 通常是兩到三個卷積,搭配正規化與 ReLU。它的雅可比矩陣為 :即使 貢獻很小,恆等路徑仍能把訊號往前送、把梯度往回傳。若 就是一個區塊所能做到最好的,它也能輕易學會,所以增加區塊不再傷害最佳化。當形狀改變(更多通道、步幅二)時,捷徑變成投影 ,通常是帶步幅的 卷積。
批次正規化(batch normalization)[19] 在訓練時用批次平均與變異數標準化每個通道,再套用學習出來的縮放與平移;評估時則使用移動平均。它讓訓練更快、對初始化較不敏感,但在批次非常小或相關性高時表現不佳,此時群組正規化(GroupNorm)[6](在每個樣本內對通道群組計算統計量)較可靠。驗證之前一定要呼叫 model.eval(),讓 BatchNorm 使用移動統計量。
程式碼 · Python · 30 行
import torch
from torch import nn

count = lambda m: sum(p.numel() for p in m.parameters())

C = 64
dense = nn.Conv2d(C, C, 3, padding=1, bias=False)
separable = nn.Sequential(
    nn.Conv2d(C, C, 3, padding=1, groups=C, bias=False),   # depthwise: one 3x3 per channel
    nn.Conv2d(C, C, 1, bias=False))                        # pointwise: mix channels
print("dense:", count(dense), "| depthwise+pointwise:", count(separable),
      "| ratio:", round(count(separable) / count(dense), 4), "vs 1/C + 1/9 =",
      round(1 / C + 1 / 9, 4))

class BasicBlock(nn.Module):
    """ResNet-style block: y = relu(x + F(x)), with a 1x1 projection when shapes change."""
    def __init__(self, c_in, c_out, stride=1):
        super().__init__()
        self.f = nn.Sequential(
            nn.Conv2d(c_in, c_out, 3, stride, 1, bias=False), nn.BatchNorm2d(c_out), nn.ReLU(),
            nn.Conv2d(c_out, c_out, 3, 1, 1, bias=False), nn.BatchNorm2d(c_out))
        self.proj = (nn.Identity() if stride == 1 and c_in == c_out else
                     nn.Sequential(nn.Conv2d(c_in, c_out, 1, stride, bias=False),
                                   nn.BatchNorm2d(c_out)))
    def forward(self, x):
        return torch.relu(self.proj(x) + self.f(x))

x = torch.randn(2, 64, 32, 32)
print("same shape :", tuple(BasicBlock(64, 64)(x).shape))
print("downsample :", tuple(BasicBlock(64, 128, stride=2)(x).shape))
輸出顯示密集網路層有 36,864 個權重,可分離組合則有 4,672 個,比例 0.1267 與下面的公式一致;區塊輸出形狀分別為 與 。
高效率 CNN:把空間濾波與通道混合分開
白話版。 「看周圍」(空間濾波)與「組合特徵」(通道混合)不必在同一個昂貴的運算中完成。
密集的 卷積有 個權重。深度(depthwise)卷積分別濾波每個通道( 個權重,PyTorch 中為 groups=C);接著的逐點(pointwise) 卷積混合通道( 個權重)。當 時,
當 且 很大時,這個比例趨近 。
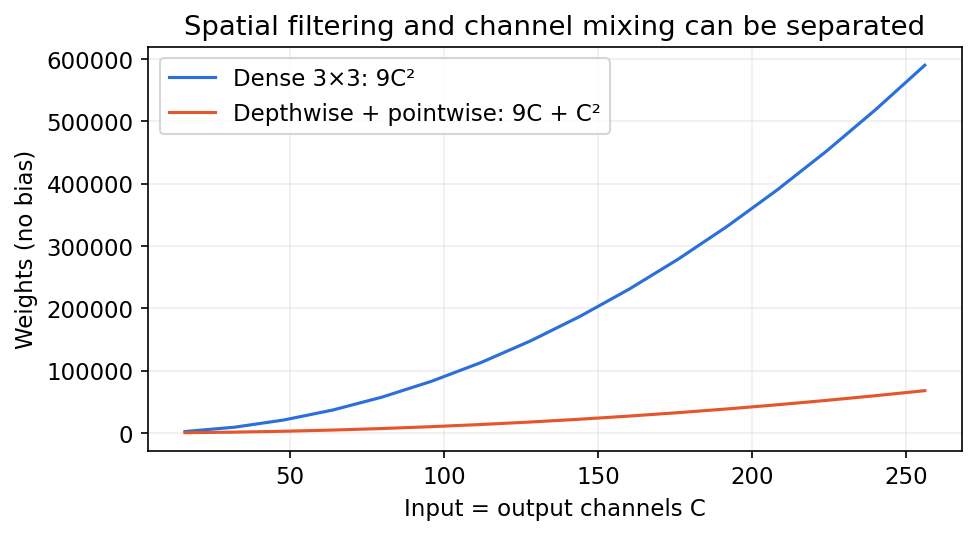
MobileNetV2 [7] 的區塊先用 網路層擴張通道,以深度 濾波,再以線性(無 ReLU) 瓶頸投影回去,並在兩個窄端之間加上殘差連接。EfficientNet [8] 用單一複合係數同時縮放深度、寬度與輸入解析度。ConvNeXt [9] 從 ResNet 出發,一次一項地套用與視覺 Transformer 相關的設計選擇:patchify 起始層、 深度卷積核、反轉瓶頸、較少的激勵函數、LayerNorm,以及搭配大量資料擴增的較長訓練。結果與相近大小的 Swin Transformer 相當,顯示 Transformer 的優勢有很大一部分來自訓練方法與巨觀設計,而不只是注意力本身。
選讀:ResNet(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
程式碼:完整的小影像分類器
這個範例需要 torch、numpy 與 scikit-learn。它使用內建的 數字資料集,因此不需要下載或 GPU。分層切分得到彼此獨立的訓練、驗證與測試集:驗證集用來挑選最佳的訓練週期,測試集只在最後評估一次。這是教學用的基準,而不是 ImageNet 的訓練方法。
程式碼 · Python · 45 行
import copy
import numpy as np
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
torch.set_num_threads(1)
d = load_digits()
X = torch.tensor(d.images[:, None] / 16.0, dtype=torch.float32)
y = torch.tensor(d.target, dtype=torch.long)
train, test = train_test_split(np.arange(len(y)), test_size=.2,
                              stratify=d.target, random_state=0)
train, val = train_test_split(train, test_size=.2,
                             stratify=d.target[train], random_state=1)
model = nn.Sequential(
    nn.Conv2d(1, 16, 3, padding=1), nn.ReLU(),
    nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(),
    nn.MaxPool2d(2),                     # B × 32 × 4 × 4
    nn.Flatten(), nn.Linear(32 * 4 * 4, 10),
)
opt = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-4)
best_loss, best_state = float("inf"), None
for epoch in range(12):
    model.train()
    order = torch.tensor(train)[torch.randperm(len(train))]
    for idx in order.split(64):
        loss = nn.functional.cross_entropy(model(X[idx]), y[idx])
        opt.zero_grad()
        loss.backward()
        opt.step()
    model.eval()
    with torch.no_grad():
        val_loss = nn.functional.cross_entropy(model(X[val]), y[val]).item()
    if val_loss < best_loss:
        best_loss = val_loss
        best_state = copy.deepcopy(model.state_dict())
model.load_state_dict(best_state)
model.eval()
with torch.no_grad():
    accuracy = (model(X[test]).argmax(1) == y[test]).float().mean().item()
print("parameters:", sum(p.numel() for p in model.parameters()))
print("best validation loss:", round(best_loss, 4))
print("held-out accuracy:", round(accuracy, 4))
在我們的 CPU 上執行,它回報 9,930 個參數,保留測試集準確率約 96%(確切數字會因 PyTorch 版本略有差異)。交叉熵接收的是 logits,前面不接 softmax。頭部把 特徵圖攤平,而不是做全域平均池化,因為在很小的數字影像上,筆畫的位置本身就帶有資訊;對於大小不一的影像,自適應或全域池化能提供固定大小的頭部。
要檢查錯誤,而不只看分數。哪些數字配對容易混淆?把每個測試數字平移一個像素會不會變差?在把所有進步都歸功於卷積之前,先與參數量相當的 MLP 以及古典 SVM 比較,如 IP 13 所示。
現代觀點
綜述文獻。 有幾篇綜述描繪了 CNN 的全貌,各有不同重點。Gu 等人 [23](Pattern Recognition,2018)依元件整理 CNN 的進展:卷積變體、池化、激勵函數、損失函數、正規化與最佳化,接著是應用。Khan 等人 [22](Artificial Intelligence Review,2020)依主要創新提出架構分類法:空間利用(卷積核大小)、深度、多路徑設計(捷徑、Inception 分支)、寬度、特徵圖利用(通道注意力)以及基於注意力的設計。Li 等人 [21](IEEE TNNLS,2022)涵蓋從 LeNet 開始的歷史,比較一維、二維與多維卷積,並綜覽輕量化網路與應用,給出選擇超參數的經驗法則。Alzubaidi 等人 [2](Journal of Big Data,2021)以 CNN 架構為中心,對深度學習做了廣泛、應用導向的回顧,並討論資料稀少、遷移學習與硬體。這些綜述都早於 ConvNeXt,因此請把它們當作 2012–2020 年代的地圖來讀。
Transformer 之後的 CNN(2022–2026)。 視覺 Transformer(ML 05)促使學界重新檢視卷積,主要發現是兩者的差距比早期比較所顯示的要小:
- 現代化的 CNN。 ConvNeXt [9] 證明經過細心現代化的 ResNet 能與 Swin 相當。ConvNeXt V2 [24](CVPR 2023)加入以稀疏卷積實作的遮罩自編碼器預訓練,以及全域響應正規化層,把自監督預訓練(見 ML 06)帶進純 CNN。
- 大型卷積核。 RepLKNet [26](CVPR 2022)使用大到 的深度卷積核,並以重新參數化的小卷積核降低最佳化難度,藉此擴大有效感受野。UniRepLKNet [27](CVPR 2024)把大卷積核設計延伸到音訊、影片、點雲與時間序列。
- 動態與可變形卷積。 InternImage [25](CVPR 2023)把取樣位置由輸入預測的可變形卷積,擴展成用於偵測與分割的大型基礎骨幹網路。
- 規模。 Smith 等人 [29](2023)在大型 JFT-4B 影像資料集上預訓練 NFNet CNN,發現在可比較的預算下,其效能遵循與視覺 Transformer 相似的運算量縮放趨勢,主張在大規模下主導結果的是運算量與資料,而不是架構。
- 邊緣裝置。 MobileNetV4 [28](ECCV 2024)設計了在 CPU、GPU、DSP 與加速器上都有良好延遲的區塊與神經架構搜尋,承認光看參數量無法預測速度。
CNN 在 2026 年的定位。 卷積仍是下列情境的預設選擇:受延遲限制與裝置端的推論、高解析度的密集預測(復原、分割、醫學影像,見 DLCV 09)、局部性偏差有幫助的小資料集,以及 CNN–Transformer 混合模型的起始層或前段。大型視覺基礎模型多半以 Transformer 為主,但它們的 patch 嵌入、上採樣解碼器與擴散 U-Net 中經常包含卷積。
開放問題。 下採樣下的精確平移等變性(混疊 [20]);以低成本內建旋轉與尺度對稱性;理解一個任務真正需要多大的有效感受野 [3];以及架構之間的公平比較,這需要先對齊資料、資料擴增、解析度、訓練排程與運算量,才能把差異歸因於卷積或注意力。
重點整理
- 卷積會翻轉卷積核,互相關不會;重現濾波器時須檢查函式庫規約。
- 卷積核總和決定對常數輸入的響應,但總和為一不代表一定平滑。
- 學得的濾波器在空間上共用權重,通道分組決定各濾波器讀取哪些輸入。
- 填補、步幅與膨脹決定形狀及取樣,下採樣可能引入混疊。
- 平移等變性不同於不變性;邊界、步幅與池化會影響實際行為。
- 比較架構時,分開看空間濾波、通道混合與跳接,並在相同預算下量測效率。
練習
- 設計並驗證。 寫出一個只偵測水平邊緣的 卷積核,以及另一個只偵測從左上到右下對角邊緣的卷積核。在卷積核實驗室中,或用
cv2.filter2D在一張含有水平線、垂直線與對角線的合成影像上驗證兩者。
提示
水平邊緣是沿 方向的變化,所以使用 (各列為 / / )。對角邊緣則把導數放在跨越對角線的方向,例如 。它的權重總和為零,所以平坦區域輸出為零。
- 卷積核總和。 為什麼模糊卷積核的權重總和應該為一?先預測再檢查:一張中灰色的
uint8影像經過權重都等於 的 卷積核濾波後會怎樣?若改用float32濾波又有什麼不同?
提示
數值為 的平坦區域會映射到 。總和為二時,灰階 128 會變成 256,在 uint8 中飽和為 255;所有比中灰亮的區域都變成白色。在 float32 中數值加倍但不會被截斷,之後可以再重新縮放。
- 組合。 證明連續做兩次 方框模糊等於一個 卷積核,並寫出這個卷積核。在遠離邊界處以數值驗證,並解釋為什麼在邊界處等式可能不成立。
提示
依結合律,組合後的卷積核是方框核與自己的卷積: 與自己的外積再除以 81。在邊界處,第一次濾波已經編造了填補值,第二次再對那個結果填補;而單次 濾波填補的是原始影像,所以兩者在寬度為二的外框中不同。
- 網路層算術。 對 的 RGB 輸入,以及一個有 16 個濾波器、、、 的網路層:寫出輸出形狀與參數數量。接著計算三個步幅分別為 1、2、1 的 網路層之後的 ,並與所有步幅都為一的情況比較。
提示
,所以輸出為 ,參數為 。感受野:。步幅全為一則得到 。
- 手算梯度。 對 的輸入 與卷積核 做 valid 互相關,寫出 ,再以 推導 與 。用反向傳播程式碼中的 autograd 技巧檢查你的公式。
提示
。於是 、( 與 的互相關)。,即 與 的 full 卷積。
- 數字分類的消融實驗。 在分類器中,把
Flatten+Linear(512, 10)換成全域平均池化 +Linear(32, 10)。比較參數量、驗證損失與測試準確率,再用平移一個像素的測試數字評估兩個模型。解釋你觀察到的取捨。
提示
使用 nn.AdaptiveAvgPool2d(1) 再接 nn.Flatten()。池化移除了大部分頭部參數與位置資訊,可能有助於對平移的穩健性,但在筆畫位置很重要的 數字上可能變差。其他設定保持不變,只用驗證集做選擇,並同時回報準確率與參數量。
參考文獻
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 9. Book
- L. Alzubaidi et al., “Review of deep learning: concepts, CNN architectures, challenges, applications, future directions,” Journal of Big Data, 2021. Review
- W. Luo, Y. Li, R. Urtasun and R. Zemel, “Understanding the Effective Receptive Field in Deep Convolutional Neural Networks,” NeurIPS, 2016. Paper
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” MICCAI, 2015. Paper
- K. He, X. Zhang, S. Ren and J. Sun, “Deep Residual Learning for Image Recognition,” CVPR, 2016. Paper
- Y. Wu and K. He, “Group Normalization,” ECCV, 2018. Paper
- M. Sandler et al., “MobileNetV2: Inverted Residuals and Linear Bottlenecks,” CVPR, 2018. Paper
- M. Tan and Q. Le, “EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks,” ICML, 2019. Paper
- Z. Liu et al., “A ConvNet for the 2020s,” CVPR, 2022. Paper
- S. J. D. Prince, Understanding Deep Learning, MIT Press, 2023, ch. 10. Book and notebooks
- OpenCV, “Image Filtering” (
filter2D, border types), documentation, version 4.x. Documentation - V. Dumoulin and F. Visin, “A guide to convolution arithmetic for deep learning,” arXiv:1603.07285, 2016. arXiv
- Y. LeCun, L. Bottou, Y. Bengio and P. Haffner, “Gradient-based learning applied to document recognition,” Proceedings of the IEEE, 1998. DOI
- A. Krizhevsky, I. Sutskever and G. E. Hinton, “ImageNet Classification with Deep Convolutional Neural Networks,” NeurIPS, 2012. Paper
- K. Simonyan and A. Zisserman, “Very Deep Convolutional Networks for Large-Scale Image Recognition,” ICLR, 2015. arXiv
- C. Szegedy et al., “Going Deeper with Convolutions,” CVPR, 2015. arXiv
- M. Lin, Q. Chen and S. Yan, “Network In Network,” ICLR, 2014. arXiv
- F. Yu and V. Koltun, “Multi-Scale Context Aggregation by Dilated Convolutions,” ICLR, 2016. arXiv
- S. Ioffe and C. Szegedy, “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,” ICML, 2015. arXiv
- R. Zhang, “Making Convolutional Networks Shift-Invariant Again,” ICML, 2019. arXiv
- Z. Li, F. Liu, W. Yang, S. Peng and J. Zhou, “A Survey of Convolutional Neural Networks: Analysis, Applications, and Prospects,” IEEE Transactions on Neural Networks and Learning Systems, 2022. DOI
- A. Khan, A. Sohail, U. Zahoora and A. S. Qureshi, “A Survey of the Recent Architectures of Deep Convolutional Neural Networks,” Artificial Intelligence Review, 2020. arXiv
- J. Gu et al., “Recent Advances in Convolutional Neural Networks,” Pattern Recognition, 2018. arXiv
- S. Woo et al., “ConvNeXt V2: Co-designing and Scaling ConvNets with Masked Autoencoders,” CVPR, 2023. arXiv
- W. Wang et al., “InternImage: Exploring Large-Scale Vision Foundation Models with Deformable Convolutions,” CVPR, 2023. arXiv
- X. Ding et al., “Scaling Up Your Kernels to 31x31: Revisiting Large Kernel Design in CNNs” (RepLKNet), CVPR, 2022. arXiv
- X. Ding et al., “UniRepLKNet: A Universal Perception Large-Kernel ConvNet for Audio, Video, Point Cloud, Time-Series and Image Recognition,” CVPR, 2024. arXiv
- D. Qin et al., “MobileNetV4: Universal Models for the Mobile Ecosystem,” ECCV, 2024. arXiv
- S. L. Smith, A. Brock, L. Berrada and S. De, “ConvNets Match Vision Transformers at Scale,” arXiv:2310.16764, 2023. arXiv
- M. D. Zeiler and R. Fergus, “Visualizing and Understanding Convolutional Networks,” ECCV, 2014. arXiv
- PyTorch,
torch.nn.Conv2ddocumentation. Documentation
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 04・循環與遞迴神經網路 · 26 分鐘