DLCV 09・深度影像復原:低階視覺
先備知識:DLCV 01・深度學習的影像處理與電腦視覺、IP 05・影像復原與重建
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
- 你將學到1 分鐘
- 先看全貌2 分鐘
- 什麼是低階視覺?2 分鐘
- 一個問題、許多面貌:退化模型3 分鐘
- 深度學習之前:手工先驗的時代1 分鐘
- 深度學習的問題設定3 分鐘
- 超解析度(Super-Resolution, SR)3 分鐘
- 去雜訊(Denoising)2 分鐘
- 除霧(Dehazing)2 分鐘
- 除雪(Desnowing)1 分鐘
- 除雨(Deraining)1 分鐘
- 低光增強(簡介)1 分鐘
- 影像融合(簡介)1 分鐘
- 去模糊(Deblurring)5 分鐘
- 影像修補(Inpainting,簡介)1 分鐘
- 去背(Matting,簡介)1 分鐘
- 通用骨幹網路1 分鐘
- All-in-one 與通用復原3 分鐘
- 損失函數1 分鐘
- 評估指標14 分鐘
- NTIRE 挑戰賽1 分鐘
- 現代觀點3 分鐘
- 重點整理1 分鐘
- 練習4 分鐘
- 補充資料
- 論文導讀
- 參考文獻
電腦視覺深度學習
你將學到
- 以觀測模型及未知量描述影像復原。
- 建立配對資料與合成退化,再評估真實世界落差。
- 比較任務專用骨幹,以及受退化資訊或指令條件化的模型。
- 選擇損失,並區分忠實度、感知品質與量測一致性。
- 使用適當資料集與協定評估,並辨認缺失細節的不確定性。
先看全貌
低階視覺處理的是像素本身。在系統能辨認人臉、讀出路牌或偵測車輛之前,影像得先清楚到「看得見」。影像復原模型就是流程中負責這一步的部分:拿到一張受損的照片(太小、雜訊多、模糊、起霧、下雨、太暗),輸出對乾淨場景更好的估計。
為什麼重要:每支手機相機在你看到照片之前,都已經做過去雜訊、去馬賽克(demosaicking)與超解析度。衛星、顯微鏡、醫學與監視影像在量測之前都要先復原。影音串流服務會把低位元率的畫面放大。自駕車需要偵測器在雨霧中照常運作。從研究的角度看,許多架構想法也是先在復原任務上被驗證的:殘差學習、通道注意力、高效率 Transformer 與擴散先驗,都有知名的復原版本。
本篇假設你已熟悉 CNN 與反向傳播(DLCV 01),以及傳統影像復原(IP 05),後者詳細介紹了雜訊模型、Wiener 濾波與退化模型。這裡會直接連結過去,不再重複。
相關篇章。 有三篇深入本篇的部分主題:DLCV 09A(單張影像超解析度)、DLCV 09A.3(影片超解析度)與 DLCV 09B(以 GAN 與擴散先驗做生成式復原)。影像融合見 DLCV 10。DLCV 01B 說明影像復原網路為什麼和分類網路的積木組法不同。
什麼是低階視覺?
白話版。 高階視覺問的是「圖裡有什麼?」(分類、偵測);低階視覺問的是「這張圖逐個像素來看,實際上長什麼樣?」前者關於理解,後者關於感知。
原文 [1] 中的比喻,來自人與外界互動的方式:我們先感知(光打在視網膜上,看見邊緣、顏色與對比),再理解(那是一個杯子)。兩者缺一不可。如果感知很差(杯子很模糊),理解也會跟著受影響。低階視覺任務就是為了讓感知重新變好而存在:當我們說一個東西「很模糊」,代表感官對它的判定並不靈敏,於是就有了把它變「清晰」的去模糊任務。
精確版。 低階視覺任務把一張影像映射成內容(通常)相同的另一張影像:
輸出是逐像素的估計,而不是一個標籤。 是輸入的高、寬與通道數, 是輸出的(超解析度倍率為 時 ,其他情況通常相等)。這帶來三個影響整個領域的特性:
- 輸出密集且高解析度。 每個像素都重要,所以架構不能大幅降採樣,必須保留細節,這讓高解析度下的運算成本很高。
- 監督訊號很容易合成。 拿一張乾淨影像,用已知的方式把它弄壞,就得到一組輸入–目標配對。這是相對於辨識任務(需要人工標註)的巨大優勢,也是這個領域最大弱點的來源:合成的損傷終究不是真實的損傷。
- 「正確答案」並不唯一。 很多張乾淨影像都和同一張受損影像相容。哪一張「最好」,取決於你重視的是忠於真實還是看起來自然,後面的評估章節會詳細討論。
這類任務範圍很廣:去模糊、超解析度、去雜訊、修補(inpainting)、色彩校正、紅外線與可見光融合等等。過去大家常在 Papers with Code 上依任務瀏覽分類與排行榜,但它已停止營運,原網址現在會直接轉址到 Hugging Face 的 Trending Papers 頁面,依任務分類的 SOTA 頁面已無法瀏覽。現在追蹤進展的可靠方式,是每年的 NTIRE 挑戰賽報告(New Trends in Image Restoration and Enhancement,CVPR 的一個 workshop),本篇接近結尾時會介紹 [2], [3]。
一個問題、許多面貌:退化模型
白話版。 本篇的每一個任務都可以寫成:「相機看到乾淨的場景 ,某種東西破壞了它,我們拿到的是 。」改變的只有那個「破壞」。只要能把破壞寫下來,就能說出這是哪個任務。
統一的觀點
其中 是未知的乾淨影像, 是退化運算子(可能是非線性的,也可能未知), 是雜訊, 是觀測到的影像。復原就是從 估計 。以下是原文 [1] 與本篇後面用到的具體形式,圖 1 把每一種套用在同一張照片上。
模糊(課本上的模型)。 和 IP 05 一樣,
其中 是清晰影像, 是點擴散函數(模糊核), 是二維卷積, 是加性雜訊, 是觀測影像, 是像素座標。去雜訊是 (單位脈衝,也就是沒有模糊)的特例。
超解析度。 低解析度影像是高解析度影像經過模糊、次取樣再加上雜訊的結果:
其中 是模糊(抗鋸齒)核, 表示每個方向每 個像素取一個, 是放大倍率(2、3、4……)。經典的「bicubic」基準設定則把這一切換成 MATLAB 風格的雙三次降採樣,並且不加雜訊。
壓縮。 , 是品質因子。JPEG 會量化 區塊的 DCT 係數(見 IP 08),產生區塊效應與振鈴。它既非加性也非線性,所以通常直接當成黑盒子放進退化流程。
霧(大氣散射模型)。
其中 是像素位置, 是有霧影像, 是無霧的場景輻射, 是全域大氣光(霧的顏色), 是透射率, 是散射係數, 是場景深度。第一項是被衰減的場景;第二項是被散射進相機的「空氣光」(airlight)。越遠的物體( 大) 越小,逐漸融入 。
雨。 雨線(rain streak)常用加性模型:
其中 是無雨背景, 是雨層。附著在鏡頭或擋風玻璃上的雨滴(raindrop)行為不同:它會遮住並折射背景,所以常用的模型是 ,其中 是雨滴的二值遮罩, 是逐元素乘積, 是穿過雨滴的光 [39]。
低光(Retinex)。 Retinex 理論 [5] 把影像分解成反射率與光照:
其中 是觀測影像, 是反射率(物體表面本身的顏色與紋理,這是我們要的), 是光照, 是逐元素乘積。暗照片的 很小;增強就是估計 並把它提亮,同時原本藏在暗處的雜訊也會被放大。
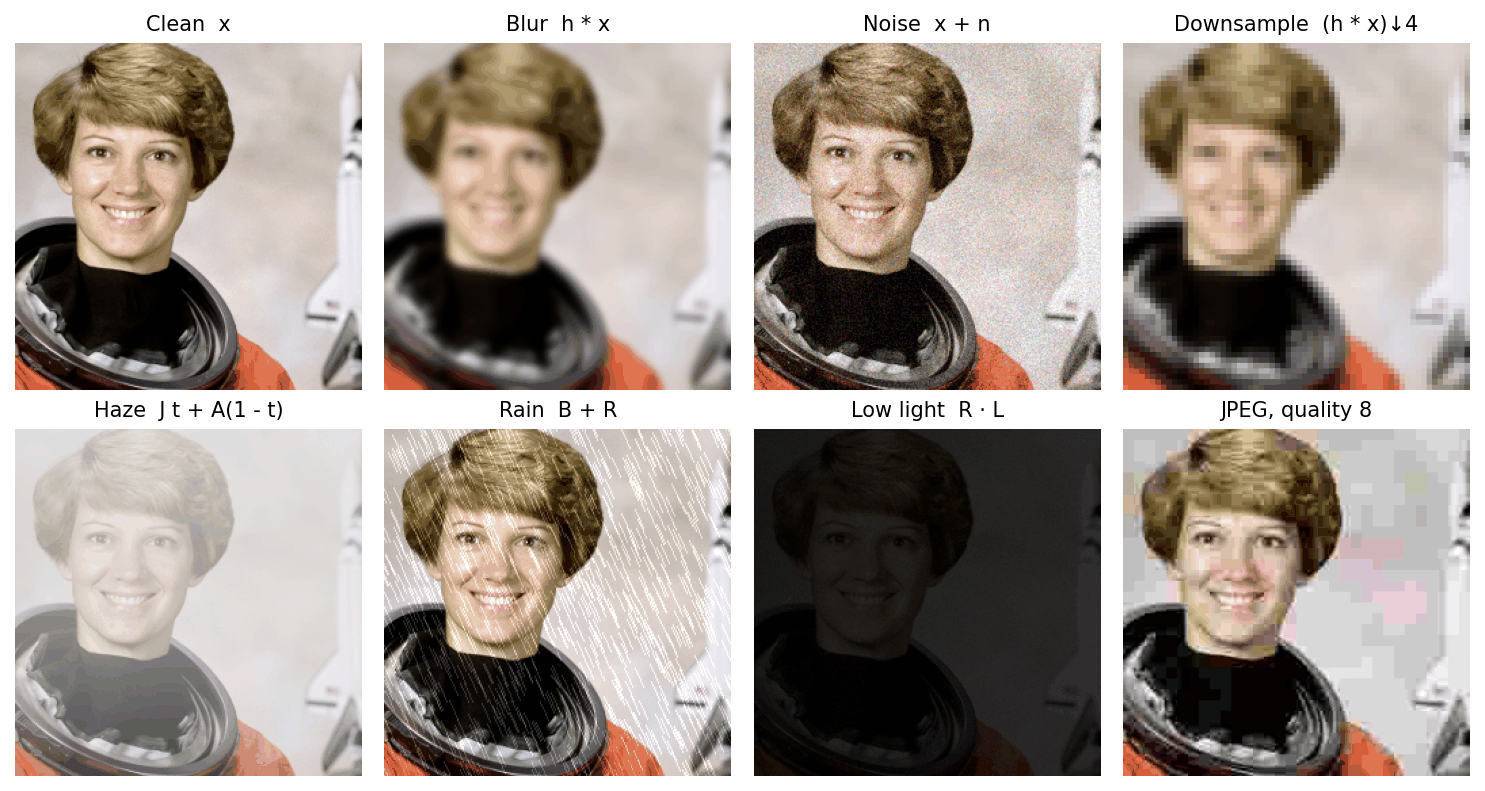
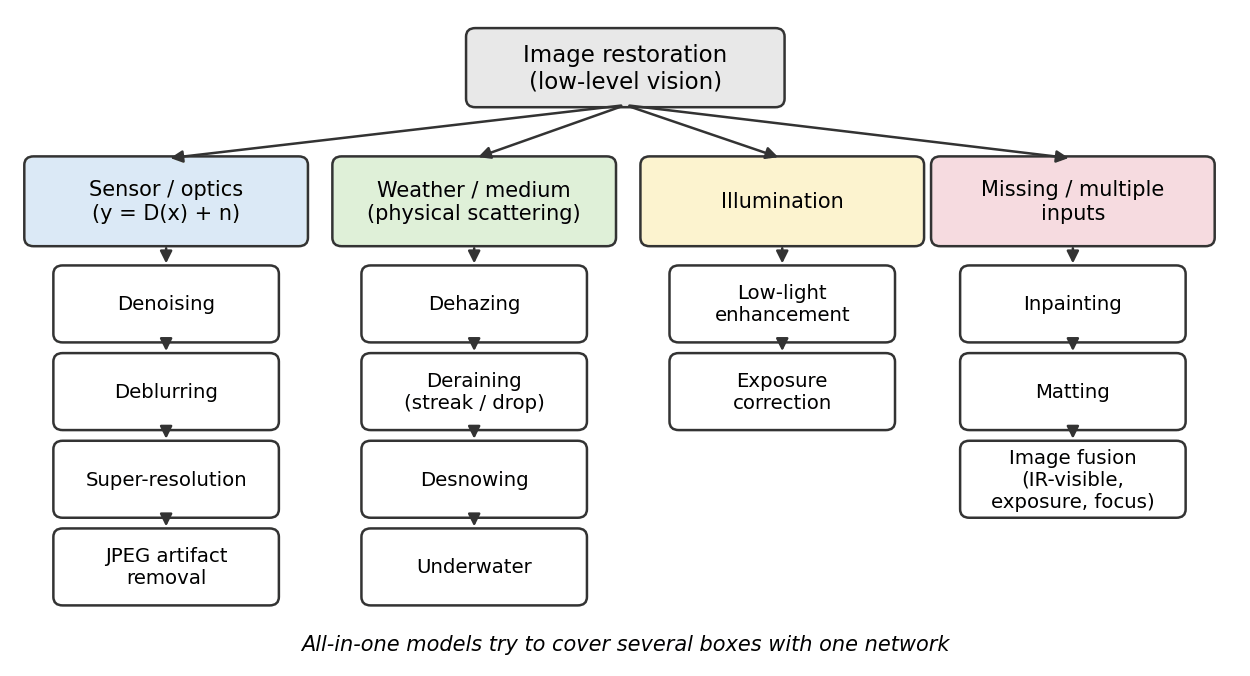
這些模型都不完全精確,卻有相同的形狀:乾淨影像進去,運算子加上雜訊出來。這正是原文 [1] 的核心觀點:雖然不是很嚴謹,但透過退化模型來看,它們本質上都可以用同一種方式「理解」,屬於同一種問題,同一套工具(而且常常是同一個網路)都適用。圖 2 依照損傷的來源把它們分類。
為什麼困難:病態問題
上面幾乎每一種 ,都有許多不同的 會產生相同的 。降採樣 4 倍丟掉每 16 個像素中的 15 個;模糊把高頻壓到幾乎為零; 的濃霧會抹去遠處的物體。這個反問題是病態的(ill-posed),我們需要一個關於乾淨影像長相的先驗(prior)。用貝氏(MAP)形式寫:
第一項(資料保真項)要求 必須能解釋觀測, 是編碼先驗的正則項(自然的影像 小), 平衡兩者。整個領域的歷史,就是一部尋找更好先驗 的歷史。
深度學習之前:手工先驗的時代
在深度學習興起之前,每個任務都有自己精心推導的先驗,成敗取決於對問題是否有足夠充分的物理或統計知識(prior knowledge)。去雜訊用局部平滑、非局部自相似與稀疏性;去模糊用 Wiener 與限制最小平方濾波,加上重尾的梯度先驗;除霧用暗通道先驗 [25];超解析度用插值與以範例為基礎的字典;低光增強用直方圖等化與 Retinex 分解。IP 05 涵蓋了這套工具的核心(雜訊模型、平均/中位數/自適應濾波、反濾波、Wiener 與 CLS 濾波),結尾也簡短回顧了走向學習式去雜訊的歷史。[1] 的看法是:深度學習逐漸解決並超越這些模型能做到的程度之後,關鍵不再是為每個任務建立強大的理論先驗,而是強大的學習機制與特徵擷取方法。退化模型並沒有消失,它從求解器搬進了資料產生器。
深度學習的問題設定
白話版。 做出大量(受損, 乾淨)的影像對,訓練網路把受損的變成乾淨的。大部分的苦工都在讓損傷看起來夠真實。
以成對資料做監督式訓練
給定乾淨影像集合 與一個退化取樣器,建立配對 ,其中 ,然後求
其中 是參數為 的復原網路, 是訓練對數量, 是損失函數(L1、L2、感知、對抗……見損失函數一節)。訓練時使用隨機裁切的小塊(patch,例如 到 )並搭配翻轉與旋轉,因為卷積與視窗注意力網路具有平移等變性,而全解析度影像也放不進 GPU 記憶體。
有一個事實可以解釋後面很多現象:用 L2 損失時,最佳網路輸出的是後驗平均 。當許多清晰影像都與 相容時,它們的平均是模糊的。這就是為什麼以 MSE 訓練的超解析度看起來很平滑,也是後來引入 GAN 與擴散模型的原因。
合成退化流程
配對資料有三種來源。(1) 合成:用已知模型(雙三次降採樣、高斯雜訊、高斯模糊、JPEG)弄壞乾淨影像。便宜且無限量,但受限於模型有多真實。(2) 實拍:同一個場景拍兩次,例如短曝光與長曝光,或把連拍平均成乾淨參考(如真實雜訊資料集 SIDD [22]),或把高速攝影的連續影格平均,得到真實的動態模糊(GoPro [44])。真實但昂貴,且侷限於特定相機。(3) 非成對/自監督:只用受損影像學習,靠 GAN、循環一致性或雜訊統計。今天大多數強模型都用豐富退化流程產生的合成配對訓練,再同時在合成與實拍資料上評估。
典型的「經典」流程是 模糊 → 降採樣 → 雜訊 → JPEG,模仿相機與圖片分享網站依序破壞照片的順序:
程式碼 · Python · 26 行
import numpy as np, cv2, torch, torch.nn.functional as F
from skimage import data, img_as_float32

def gaussian_kernel(sigma, size=21):
    ax = torch.arange(size) - size // 2
    g = torch.exp(-ax**2 / (2 * sigma**2))
    k = torch.outer(g, g)
    return k / k.sum()

def degrade(x, scale=4, sigma_blur=1.6, sigma_noise=0.03, jpeg_q=40, rng=None):
    """x: float tensor (C,H,W) in [0,1]. Returns the low-quality image y = D(x) + n."""
    rng = rng or np.random.default_rng(0)
    C = x.shape[0]
    k = gaussian_kernel(sigma_blur).to(x)[None, None].repeat(C, 1, 1, 1)
    y = F.conv2d(F.pad(x[None], (10,) * 4, mode="reflect"), k, groups=C)   # 1) blur  h * x
    y = y[..., ::scale, ::scale]                                           # 2) downsample  (.)↓s
    y = y + sigma_noise * torch.from_numpy(rng.standard_normal(y.shape).astype(np.float32))  # 3) noise n
    y = y.clamp(0, 1)[0]
    img = (y.permute(1, 2, 0).numpy() * 255).round().astype(np.uint8)      # 4) JPEG round trip
    ok, buf = cv2.imencode(".jpg", img[..., ::-1], [cv2.IMWRITE_JPEG_QUALITY, jpeg_q])
    img = cv2.imdecode(buf, cv2.IMREAD_COLOR)[..., ::-1]
    return torch.from_numpy(img.copy()).permute(2, 0, 1).float() / 255

x = torch.from_numpy(img_as_float32(data.astronaut())).permute(2, 0, 1)    # (3, 512, 512)
y = degrade(x)
print(x.shape, "->", y.shape)        # torch.Size([3, 512, 512]) -> torch.Size([3, 128, 128])
實際訓練時,每個參數(模糊核的寬度與形狀、雜訊強度與種類、JPEG 品質,甚至順序)都會對每張影像隨機取樣,讓網路看到的是一整個退化分布,而不是單一一種。
真實世界與盲退化
只用一種固定 (例如雙三次 )訓練的模型,遇到真實照片就會失效,因為真實退化是未知的、隨位置變化的,而且是多種效應的混合。這就是盲(blind,或稱真實世界)復原問題。大致有兩種策略:
- 把合成分布做得夠寬,寬到能涵蓋真實情況。 Real-ESRGAN [4] 把經典流程連續套用兩次(「高階」退化,每一輪都隨機取樣模糊核、縮放、雜訊與 JPEG),並加入 sinc 濾波器來模擬振鈴與過衝。即使只用合成資料訓練,它在真實低品質影像上的泛化也比雙三次訓練的模型好得多。
- 引入強大的生成先驗。 預訓練的文字生成影像擴散模型已經知道自然影像長什麼樣。DiffBIR [16]、SUPIR [17] 與 OSEDiff [18] 都以受損輸入作為條件來驅動這類模型,讓先驗「補上」合理的細節。這是真實世界超解析度近年的主要趨勢,後面會再討論。
第三種互補的策略是估計退化本身(雜訊強度、模糊核、退化種類),再餵給網路,例如 FFDNet 的雜訊強度圖 [21] 與各種 all-in-one 模型。在盲超解析度中,未知的主要是 裡的模糊核 ;有一整個系列的方法把模糊核交給網路當條件、在迴圈中估計並修正它,或只從測試影像本身估計它 [87]–[91]。要記住的結論是:明確估計模糊核的方法在退化真的是「模糊、降採樣、雜訊」時準確又可解釋,但錯誤的模糊核會傳到輸出裡。所以大多數真實世界模型,例如 BSRGAN [92]、Real-ESRGAN [4] 與擴散先驗方法,改從隨機化的退化流程中隱式地學習退化。
選讀:盲超解析度:以模糊核為條件與估計模糊核(見「補充資料」頁)。SRMD、USRNet、IKC、DAN 與 KernelGAN 如何處理模糊核,以及明確路線何時勝過隱式路線。
選讀:即插即用先驗與半二次分裂(見「補充資料」頁)。求解器如何把資料項與先驗拆開,讓任何去雜訊器都能當作先驗;這也是 USRNet 這類深度展開網路背後的想法。
超解析度(Super-Resolution, SR)
白話版。 把小圖變大而且變清楚,也就是預測缺少的高解析度像素,而不只是把現有的像素拉伸開來。
本節只做概覽;DLCV 09A・影像超解析度會深入介紹超解析度:退化模型、傳統與學習式方法、感知式與擴散式超解析度、真實世界超解析度,以及如何評估。
問題設定
單張影像超解析度(SISR)在 之下,從 估計 。傳統做法是插值法(interpolation):最近鄰(nearest neighbor)、雙線性(bilinear)與雙三次(bicubic)。其中雙三次插值以 鄰域擬合三次多項式,最為知名,至今仍被廣泛使用,既是基準方法,也是產生低解析度測試輸入的標準方式。插值只會重新分配既有資訊,無法重建被 丟掉的高頻。
網路怎麼「變大」:三種上採樣策略
輸出比輸入大,所以每個 SR 網路都得決定解析度在哪裡提升。
a. 先上採樣(先插值)。 SRCNN [6] 先用雙三次插值把輸入放大到目標尺寸,再接三層卷積(區塊擷取、非線性映射、重建)。簡單直觀,但每一層都在高解析度上運算,速度慢,網路還得清理插值造成的瑕疵。
b. 轉置卷積(反卷積,deconvolution)。 FSRCNN [7] 在低解析度上運算,只在最後用學習得到的轉置卷積放大,速度比 SRCNN 快很多。步長無法整除核大小的轉置卷積會產生不均勻的重疊,容易出現棋盤狀瑕疵(checkerboard artifact)[9],所以現在很少被當作 SR 的最終上採樣器;不過在其他類型的神經網路中(例如分割與生成模型的解碼器)仍然相當常見。
c. 子像素卷積(pixel shuffle)。 ESPCN [8] 在低解析度上計算 個通道,再重新排列成 倍大的影像:
其中 是有 個通道的低解析度特徵張量, 是低解析度位置, 是子像素偏移, 是輸出通道。所有學習都在低解析度進行,重新排列本身沒有參數。這是現代 SR 網路的主流選擇(torch.nn.PixelShuffle)。
里程碑與目前的主流家族
白話版。 SR 網路先是變深,接著學會畫出逼真的紋理,最近則借用了 Transformer 與大型預訓練生成模型。
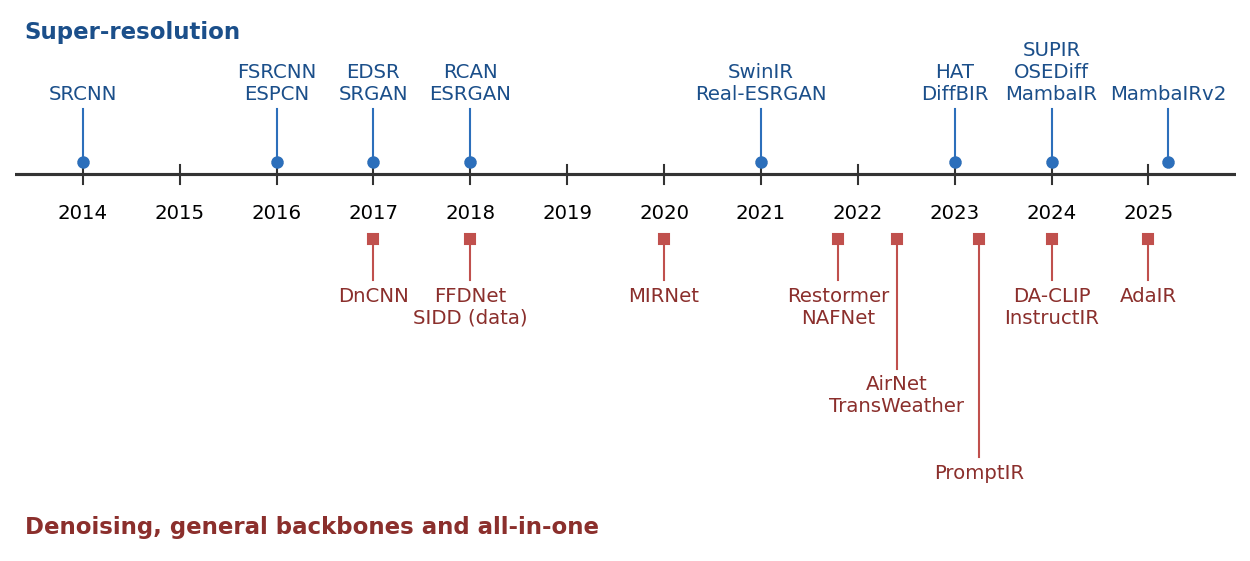
主要的幾步:SRCNN [6] 是第一個端到端的 SR CNN;EDSR [10] 與 RCAN [11] 把 SR 網路做得非常深(EDSR 拿掉批次正規化,RCAN 加入通道注意力);SRGAN [12] 與 ESRGAN [13] 加入對抗損失與感知損失,產生銳利、逼真的紋理,而不是 MSE 的模糊平均。目前的主流家族是 SwinIR [14]、HAT [15] 這類 Transformer,MambaIR [49] 這類狀態空間模型,以及擴散先驗(DiffBIR [16]、SUPIR [17] 與一步式的 OSEDiff [18]);擴散先驗在真實照片上能產生更有說服力的紋理,但也可能捏造出場景中不存在的細節。模型通常以 DIV2K [19] 訓練,並以亮度通道上的 PSNR 與 SSIM 比較;沒有真值的真實世界 SR 則依賴感知與無參考指標(見評估指標一節)。大約在 2018 年,輸出已經遠勝插值,如何評判 SR 便成為核心問題(見感知–失真一節)。
選讀:超解析度的里程碑、主流家族與基準(見「補充資料」頁)。每個里程碑改變了什麼、各種擴散先驗方法有何不同,以及基準測試的慣例。
去雜訊(Denoising)
白話版。 把照片上隨機的顆粒去掉,同時不要把真正的紋理也抹平。雜訊是最單純的退化,所以去雜訊成了大多數深度復原想法最先出現的試驗場。
問題設定
。合成設定中 (加性白高斯雜訊,AWGN,標準差 通常以 0–255 的尺度表示,例如 )。真實相機的雜訊不一樣:它和訊號相關(光子散粒雜訊隨亮度增加),去馬賽克後在空間上具相關性,還會被相機的影像處理流程改變形狀。針對暗影像寫出的卜瓦松–高斯(Poisson–Gaussian)雜訊模型,請見 DLCV 09C。
里程碑
DnCNN [20] 做了兩個後來成為標準的選擇。第一是殘差學習(residual learning):網路 不直接預測 ,而是預測雜訊,輸出為
其中 。殘差(雜訊)比乾淨影像「更容易學」,使得搭配批次正規化的深層純 CNN 能訓練得很好。單一 DnCNN 也能針對一段範圍的雜訊強度訓練(盲高斯去雜訊),而且同一個網路也能處理 SR 與 JPEG 去區塊。
FFDNet [21] 把雜訊強度圖 (與影像同尺寸,每個像素的值為 )和降採樣後的輸入一起餵給網路。測試時調整 ,可以在去雜訊與保留細節之間取捨;非均勻的 則能處理隨位置變化的雜訊。它的速度快到可以在 CPU 上執行。
真實雜訊。 SIDD 資料集 [22] 提供真實的智慧型手機雜訊影像,乾淨參考影像則透過仔細拍攝連拍並加以處理而得。只用 AWGN 訓練的模型在它上面表現很差,這推動了整個領域走向真實的雜訊合成與實拍訓練資料。
通用骨幹。 MIRNet [30]、Restormer [23] 與 NAFNet [24] 是通用的復原架構,在 SIDD 以及去模糊等任務上都報告了最先進的結果,會在骨幹網路一節介紹。
程式碼:一個小小的殘差去雜訊網路
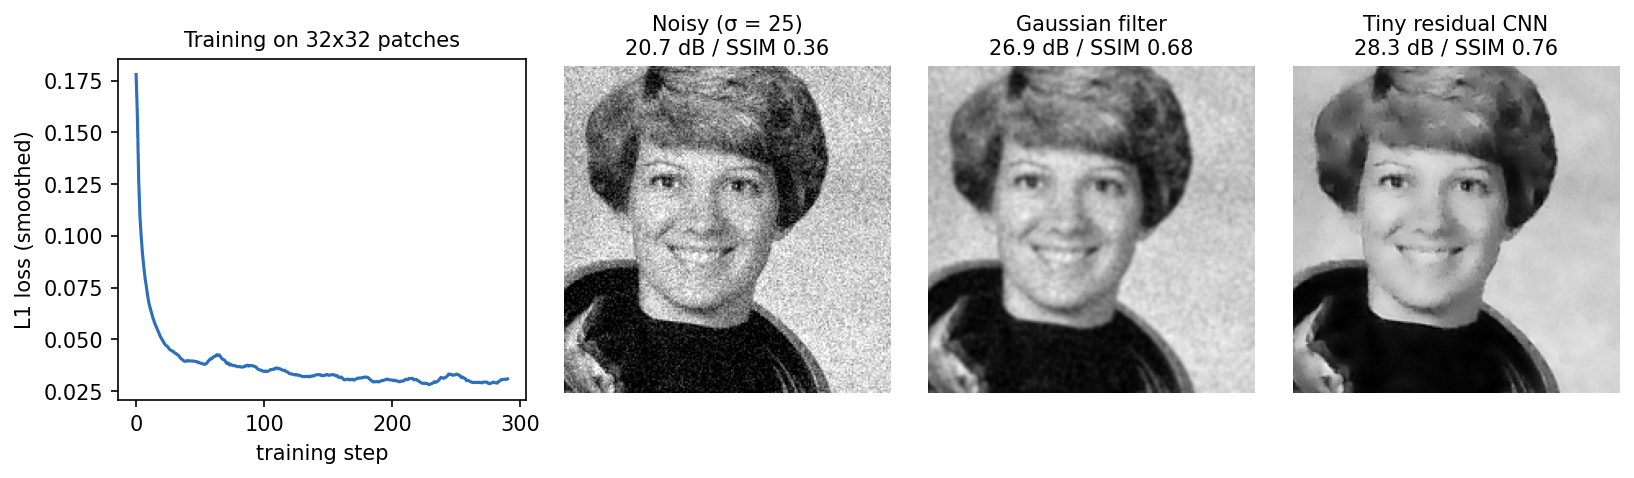
下面的程式在四張 skimage 影像隨機切出的 小塊上訓練一個五層、DnCNN 風格的網路,每一步都加上新的高斯雜訊,然後在一張從沒看過的影像上測試。在筆電 CPU 上大約一分鐘內就能跑完(我們在負載很重的機器上量到約一分鐘)。
程式碼 · Python · 48 行
import time, numpy as np, torch, torch.nn as nn
from skimage import data, img_as_float32
from skimage.color import rgb2gray

torch.manual_seed(0); torch.set_num_threads(2)
rng = np.random.default_rng(0)
sigma = 25 / 255                                    # noise level (on a [0,1] scale)
train_imgs = [img_as_float32(im) for im in (data.camera(), data.coins(), data.moon(), data.page())]
test_img = img_as_float32(rgb2gray(data.astronaut()))   # held out

def random_patches(n=32, p=32):
    batch = []
    for _ in range(n):
        im = train_imgs[rng.integers(len(train_imgs))]
        i, j = rng.integers(0, im.shape[0] - p), rng.integers(0, im.shape[1] - p)
        batch.append(im[i:i + p, j:j + p])
    return torch.from_numpy(np.stack(batch))[:, None]   # (n, 1, p, p)

class TinyDnCNN(nn.Module):
    """conv-ReLU, (depth-2) x conv-BN-ReLU, conv. Predicts the NOISE, not the image."""
    def __init__(self, depth=5, ch=32):
        super().__init__()
        layers = [nn.Conv2d(1, ch, 3, padding=1), nn.ReLU(inplace=True)]
        for _ in range(depth - 2):
            layers += [nn.Conv2d(ch, ch, 3, padding=1), nn.BatchNorm2d(ch), nn.ReLU(inplace=True)]
        layers += [nn.Conv2d(ch, 1, 3, padding=1)]
        self.body = nn.Sequential(*layers)
    def forward(self, y):
        return y - self.body(y)                         # x_hat = y - R(y): residual learning

net = TinyDnCNN()
opt = torch.optim.Adam(net.parameters(), lr=2e-3)
t0 = time.time()
for step in range(300):
    x = random_patches()
    y = x + sigma * torch.randn_like(x)                 # synthetic pairs, made on the fly
    loss = nn.functional.l1_loss(net(y), x)
    opt.zero_grad(); loss.backward(); opt.step()
print(f"trained in {time.time() - t0:.0f} s, last L1 = {loss.item():.4f}")

net.eval()
with torch.no_grad():
    x = torch.from_numpy(test_img)[None, None]
    y = x + sigma * torch.randn_like(x)
    x_hat = net(y).clamp(0, 1)
mse = lambda a, b: torch.mean((a - b) ** 2).item()
print(f"PSNR noisy {10*np.log10(1/mse(y.clamp(0,1), x)):.2f} dB -> denoised {10*np.log10(1/mse(x_hat, x)):.2f} dB")
# e.g. PSNR noisy 20.74 dB -> denoised 28.64 dB
即使是這個只用四張圖、訓練 300 個小步驟的玩具模型,在沒看過的照片上也能提升約 8 dB,而且勝過手動調整的高斯濾波(圖 4)。拖動滑桿,比較雜訊輸入與小網路的輸出。
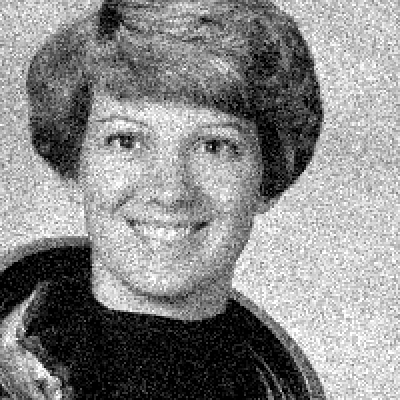
 雜訊(σ = 25)小型殘差 CNN
除霧(Dehazing)
白話版。 去霧旨在恢復受大氣散射遮蔽的對比與顏色,遠處區域尤其明顯。
傳統做法與暗通道先驗
傳統方法先估計 中的未知量(透射率圖 與大氣光 ),再代回公式求解。最困難的部分,就是想出能把這些未知量確定下來的可靠關係。最知名的是何凱明等人的暗通道先驗(dark channel prior)[25]:在無霧的戶外影像中,大多數局部區塊裡至少有一個像素在某個顏色通道上非常暗(陰影、深色或鮮豔的物體):
其中 是以 為中心的小區塊, 是顏色通道 。對霧的模型做同樣的雙重取最小值,再利用 ,就得到透射率估計
其中 (論文中取 0.95)刻意保留一點霧,以維持深度感。接著 ,小小的 用來避免除以零。這個先驗在大片與大氣光相近的明亮區域(白牆、天空)會失效,而以區塊為單位得到的粗糙 也必須再精修,才能貼合邊緣。
深度除霧:兩個流派
原文 [1] 把深度除霧分成兩派,這個分法至今仍很貼切。
1. 物理引導(「套公式」)。 學出未知參數,再反轉模型。DehazeNet [26] 用 CNN(搭配 Maxout 單元與有界 ReLU)從有霧區塊迴歸出透射率 。AOD-Net [27] 進一步簡化大氣散射模型,把 與 合併成單一函數 :
其中 是常數偏移。一個輕量 CNN 預測 ,於是整個網路是端到端的,還可以接在偵測器前面一起訓練。
2. 強大的通用架構(「超級模型」)。 跳過物理,直接用強大的網路學 。GridDehazeNet [28] 使用以注意力為基礎的多尺度網格;FFA-Net [29] 堆疊通道注意力與像素注意力區塊,並做自適應特徵融合。這類設計的學習能力很強,換句話說,很有機會也適用於其他退化任務,這正是 MIRNet [30] 等通用復原網路走的路。之後出現了 Transformer 除霧模型:DehazeFormer [31] 修改正規化層、激活函數與空間聚合方式,把 Swin Transformer 調整成適合除霧。
資料集
- RESIDE [32]:大型基準,包含以深度與散射模型合成的室內外有霧影像,以及用於任務導向評估的真實有霧影像。它的 SOTS 測試集是最常被引用的除霧基準。
- O-HAZE [33] 與 Dense-Haze [34]:以專業造霧機拍攝的真實有霧/無霧配對,分別是戶外場景與濃霧場景。規模小,但能突顯合成與真實之間的落差。
- KITTI [35] 不是除霧資料集。它是在 Karlsruhe 一帶錄製的自駕車情境視覺基準(立體視覺、光流、里程計、3D 物件偵測、追蹤)。部分除霧研究會在它的影像上合成霧氣(它有光達與立體視覺提供的深度),或用它評估除霧對下游偵測的影響。
除雪(Desnowing)
白話版。 去掉飄落的雪。看起來像除雨的親戚,但行為上也很像除霧。
除雪比看起來困難。雪花的大小與透明度差異極大,從不透明的白色團塊到半透明的條紋都有,而大雪還會造成類似霧的朦朧效應(veiling effect)。所以除雪模型不只要處理呈現為白點的「雪」,也得處理朦朧的霧氣。DesnowNet [36] 推出 Snow100K 資料集(在真實影像上合成雪,另附真實雪景影像),以及一個同時估計雪的半透明程度與其殘留的網路。JSTASR [37] 明確建模雪的大小與透明度,並加入去除朦朧效應的步驟。現在除雪通常被放進 TransWeather [52] 這類「惡劣天氣」all-in-one 模型中一起研究。
除雨(Deraining)
白話版。 把照片裡的雨去掉。「雨」其實指兩種很不一樣的東西:在空中落下的細雨線,以及停在鏡頭或擋風玻璃上的雨滴。
雨線與雨滴
- 雨線(rain streak)是疊加在場景上、細而亮、有方向性的線條,模型為 。遠處的雨線累積起來會形成類似霧的面紗。方法的目標是把兩層分開。一個早期具影響力的深度方法同時偵測並去除雨 [38],並提供了被廣泛使用的輕雨與大雨合成資料集。
- 雨滴(raindrop)附著在玻璃表面,像一個個小透鏡:遮住並折射背景、常常失焦,而且沒有一致的方向。Qian 等人的注意力 GAN [39] 用注意力圖(雨滴在哪裡?)同時引導生成器與判別器,並推出一個透過玻璃拍攝、有無水滴成對的雨滴資料集。
走向真實場景
大多數除雨資料集是合成的,用合成雨線訓練的模型面對真實的雨常常失效。NTIRE 2025 Day and Night Raindrop Removal for Dual-Focused Images 挑戰賽 [40] 反映了研究重心轉向真實資料:它使用真實拍攝的 Raindrop Clarity 資料集,涵蓋白天與夜晚,以及對焦在雨滴與對焦在背景兩種情況(訓練 14,139 張、驗證 240 張、測試 731 張)。對焦設定很關鍵:相機對焦在雨滴上時,背景也是模糊的,於是去除雨滴有一部分變成了去模糊。
低光增強(簡介)
白話版。 讓暗照片看起來曝光正常、細節可見、色調自然,同時不要把雜訊放大。
訓練時對比暗影像與同一場景正常曝光的參考影像,例如隨 RetinexNet [41] 推出、包含低光/正常光配對的 LOL 資料集。傳統方法以對比度調整(直方圖等化)與 Retinex 模型為主(較少見的還有反轉大氣散射模型)。深度方法有兩條路線:受 Retinex 啟發、分解 再調整 的網路(RetinexNet [41]),以及特別設計的通用網路。Retinexformer [42](ICCV 2023)結合兩者:單階段的 Retinex 公式加上光照引導的注意力,作者稱它是第一個以 Transformer 為基礎的低光增強方法。低光增強本身的內容(零參考方法、曲線估計、雜訊、色彩、影片)多到值得獨立一章:見 DLCV 09C。
影像融合(簡介)
白話版。 把同一場景、各有所長的幾張影像組合成一張,讓結果同時擁有每一張的優點,資訊更豐富多樣。
原文 [1] 提到三種常見設定:紅外線與可見光融合(紅外線提供熱目標,可見光相機提供紋理與色彩)、多重曝光融合(結合曝光不足與過度照片的細節,得到類似 HDR 的結果),以及多焦點融合(由對焦在不同深度的照片合成全景深影像)。與其他任務不同,融合通常沒有真實的「正確融合影像」,所以深度融合依賴保留來源影像梯度與強度的非監督式損失,或使用 GAN。Zhang 等人的綜述 [43] 依這些情境與學習策略整理了深度融合方法。
去模糊(Deblurring)
白話版。 從被手震、物體移動或失焦弄糊的影像中,還原出清晰的影像。
問題設定
去模糊就是 的直接應用。模糊核 已知時稱為非盲(non-blind)去模糊(DIP 第 5 章中 Wiener 與 CLS 濾波的設定,以及學習式非盲求解器); 未知時稱為盲(blind)去模糊。動態場景中的真實動態模糊更麻煩:不同物體的運動不同、深度也不同,所以根本沒有單一的全域 。
盲去模糊:估計模糊核
白話版。 盲去模糊須推估清晰影像與模糊;交替方法固定其中一項,再改善另一項估計。
聯合問題。 對空間上均勻的模糊,盲反卷積(blind deconvolution)要解
其中 是模糊影像, 是未知的清晰影像, 是未知的模糊核(只在一個小視窗內非零,手震通常是 到 像素), 是影像先驗(通常是稀疏梯度懲罰,因為自然影像大多是平坦區域加上少數強邊緣), 是模糊核先驗, 是它們的權重。限制條件表示模糊核只是把光重新分配:它非負,而且保持總亮度不變。即使如此,模糊核也只能還原到差一個小平移的程度,因為把 往一個方向平移、 往反方向平移, 不變。
為什麼這麼病態。 未知數( 和 )遠多於方程式,很多組解都能完全解釋 。更糟的是,最明顯的那一組是錯的:(沒有模糊)且 完美符合資料。Levin 等人 [74] 指出,在常用的稀疏梯度先驗下,模糊影像的先驗代價往往比清晰影像更低,因為模糊會讓梯度變小,而 偏好小梯度。所以對 做天真的聯合 MAP 估計,常會得到「沒有模糊」的解。他們的分析指向一個較適定的目標:只估計模糊核,對所有可能產生 的清晰影像取平均。模糊核的未知數比像素觀測少得多,所以它比整張影像確定得多;一旦知道 ,再用非盲反卷積就能還原 。
傳統的解法。 實務上有效的方法,不是近似上述對影像的平均(Fergus 等人 [75] 的變分貝氏),就是預測並挑選清晰邊緣,只用可靠的梯度估計模糊核(Cho 與 Lee [77] 用衝擊濾波器把目前的估計銳化,下面的程式也這麼做;Xu 與 Jia [78] 只保留有資訊量的邊緣),或是改變先驗,讓清晰的影像勝出(Krishnan 等人 [79]、Pan 等人 [80])。它們都共用下面這個迴圈。
標準流程。 幾乎所有傳統盲去模糊方法都遵循同一個迴圈。在影像金字塔最粗的一層,從 delta 模糊核開始,交替進行
其中 是迭代次數, 是影像梯度, 是經過邊緣預測或挑選後的潛在影像(銳化過,弱梯度設為零)。模糊核這一步在梯度域進行,因為卷積與微分可以交換,,而模糊的資訊主要藏在梯度裡;搭配二次懲罰時,它在頻域有封閉解,之後再投影回限制條件。迭代幾次後,把模糊核放大到金字塔的下一層(由粗到細,coarse-to-fine),因為大模糊在粗尺度上只有幾個像素寬,這樣可以避開不好的局部極小值。最後固定 ,用非盲反卷積產生輸出影像:可以是 IP 05 的 Wiener 或限制最小平方濾波,也可以是超拉普拉斯(hyper-Laplacian)先驗或學習式的非盲求解器。
深度學習與模糊核。 神經網路以三種方式進入盲去模糊:先預測模糊核(或反卷積濾波器),再以傳統方法反卷積 [81]–[83];用未經訓練的生成網路、不靠訓練資料,對單張照片同時擬合模糊核與影像,例如 SelfDeblur [85];或是略過模糊核,端到端地把模糊影像映射成清晰影像,例如 Nah 等人 [44] 的多尺度網路、DeblurGAN [86]、Restormer 與 NAFNet。
選讀:傳統與學習式的盲去模糊方法(見「補充資料」頁)。只估計模糊核的 MAP 公式,以及上面提到的每個方法各自怎麼做。
選讀:Deep Image Prior:網路結構即先驗(見「論文導讀」頁)。SelfDeblur 所用影像生成器背後那篇論文的閱讀指南。
哪一種比較好?以模糊核為基礎的方法適合空間均勻的模糊,提供可解釋、可以檢查也可以重複使用的模糊核,但它們較慢,遇到隨位置變化的模糊就會失效。不估計模糊核的網路能處理物體運動與深度造成的非均勻模糊,也是 GoPro 等動態場景基準上目前最好的方法,但它們只能泛化到訓練時看過的模糊,也不給出明確的模糊核。Zhang 等人的綜述 [69] 整理了這個轉變(完整的比較在同一則補充資料中)。
程式碼:一個交替式盲反卷積的玩具範例。 下面的程式用一個彎曲的 手震模糊核把 的 camera 影像弄糊,然後交替進行封閉形式的影像步驟(帶二次梯度懲罰、類似 CLS 的濾波器)與模糊核步驟(只用經衝擊濾波後最強的 2% 梯度做最小平方,再投影到 、)。在 CPU 上約一秒跑完。
程式碼 · Python · 59 行
import numpy as np
from numpy.fft import fft2, ifft2
from scipy.ndimage import convolve, gaussian_filter, laplace
from skimage import data, img_as_float, transform

rng = np.random.default_rng(0)
f_true = transform.resize(img_as_float(data.camera()), (256, 256), anti_aliasing=True)
K = 15                                               # kernel support K x K
h_true = np.zeros((K, K))
for t in np.linspace(0, 1, 40):                      # a curved "camera-shake" path
    h_true[round(3 + 8 * t), round(2 + 10 * t + 2 * np.sin(3 * t))] += 1
h_true = gaussian_filter(h_true, 0.5); h_true /= h_true.sum()
g = convolve(f_true, h_true, mode="wrap") + 0.005 * rng.standard_normal(f_true.shape)

def otf(h, shape):                                   # centered kernel -> transfer function
    p = np.zeros(shape); p[:h.shape[0], :h.shape[1]] = h
    return fft2(np.roll(p, (-(h.shape[0] // 2), -(h.shape[1] // 2)), (0, 1)))

G = fft2(g)
Dx, Dy = otf(np.array([[0, -1, 1]]), g.shape), otf(np.array([[0], [-1], [1]]), g.shape)

def image_step(h, lam):        # f = argmin ||h*f - g||^2 + lam ||grad f||^2  (closed form, CLS-like)
    H = otf(h, g.shape)
    return np.real(ifft2(np.conj(H) * G / (np.abs(H)**2 + lam * (np.abs(Dx)**2 + np.abs(Dy)**2))))

def shock(f, n=5, dt=0.5):     # edge prediction: a shock filter turns soft edges into steps
    f = gaussian_filter(f, 0.7)
    for _ in range(n):
        gy, gx = np.gradient(f)
        f = f - dt * np.sign(laplace(f)) * np.hypot(gx, gy)
    return f

def kernel_step(f, keep=0.02, beta=1e-3):   # least squares in the gradient domain, strong edges only
    num = den = 0
    for D in (Dx, Dy):
        fx = np.real(ifft2(D * fft2(f)))
        fx[np.abs(fx) < np.quantile(np.abs(fx), 1 - keep)] = 0
        Fx = fft2(fx)
        num, den = num + np.conj(Fx) * D * G, den + np.abs(Fx)**2
    h = np.roll(np.real(ifft2(num / (den + beta))), (K // 2, K // 2), (0, 1))[:K, :K]
    h = np.maximum(h, 0)                             # project onto h >= 0 ...
    return h / h.sum()                               # ... and sum(h) = 1

def best_shift(fn):            # blind deconvolution recovers h (and f) only up to a small translation
    return min(fn(dy, dx) for dy in range(-3, 4) for dx in range(-3, 4))
kernel_error = lambda h: best_shift(lambda dy, dx: np.linalg.norm(np.roll(h, (dy, dx), (0, 1)) - h_true)) / np.linalg.norm(h_true)
psnr = lambda f: -best_shift(lambda dy, dx: 10 * np.log10(np.mean((np.clip(np.roll(f, (dy, dx), (0, 1)), 0, 1) - f_true)[8:-8, 8:-8] ** 2)))

h = np.zeros((K, K)); h[K // 2, K // 2] = 1
h = gaussian_filter(h, 1.0); h /= h.sum()            # start from an almost-delta kernel ("no blur")
print(f"kernel error at start: {kernel_error(h):.2f}")
for _ in range(30):                                  # alternate: image update, then kernel update
    h = kernel_step(shock(image_step(h, lam=0.02)))
print(f"kernel error after 30 alternations: {kernel_error(h):.2f}")
print(f"PSNR  blurry {psnr(g):.2f} dB | estimated kernel {psnr(image_step(h, 1e-2)):.2f} dB"
      f" | true kernel {psnr(image_step(h_true, 1e-2)):.2f} dB")
# kernel error at start: 1.19
# kernel error after 30 alternations: 0.57
# PSNR  blurry 22.59 dB | estimated kernel 27.11 dB | true kernel 29.67 dB
模糊核的相對誤差大約減半,用估計的模糊核做最後的非盲步驟,也補回了模糊輸入與「真實模糊核」結果之間大部分的差距。但要誠實看待這個玩具範例:模糊是合成的、均勻的、循環的(所以 FFT 模型完全成立),雜訊很低,參數(lam、keep、衝擊濾波的次數)也是針對這張影像調的。程式沒有影像金字塔,所以更大的模糊核會失敗;面對真實照片時,還需要處理邊界、飽和像素,並使用穩健的損失。兩種誤差都是在最佳的小平移之後才量測,原因就是上面說的平移不確定性。
資料與里程碑
Nah 等人 [44](CVPR 2017)用 GoPro 資料集處理這個問題:他們以高速攝影機拍攝清晰的影片,把連續影格平均起來,得到真實的模糊影像,並以中間那一格作為清晰目標。他們的網路是多尺度的:先還原粗略版本,再逐步在更細的尺度上精修,類似傳統盲去模糊由粗到細的策略,但完全不需要估計模糊核。GoPro 至今仍是最常用的去模糊基準。
今天最常被比較的基準是通用骨幹 Restormer [23] 與 NAFNet [24]。NAFNet 有一個驚人的發現:常用的非線性啟用函數(ReLU、GELU、Sigmoid)其實不是必要的,可以用兩半特徵的逐元素相乘(「SimpleGate」)取代,或直接移除,得到一個「無傳統非線性啟用函數」(nonlinear activation free)的網路,不但更簡單,在 GoPro 與 SIDD 上也更強。特徵相乘仍是非線性,名稱指的是傳統啟用函數。Zhang 等人的去模糊綜述 [69] 涵蓋了更廣的範圍(盲與非盲、影片、失焦、損失函數)。
影像修補(Inpainting,簡介)
白話版。 把缺失或破損的區域(刮痕、被移除的物體、破洞)補上合理的內容。
修補是最接近影像生成的復原任務:在大破洞裡沒有東西可以「還原」,只能創造出和周圍相符的內容。它的退化是一個遮罩,,其中 在破洞處為 0、其他地方為 1。前陣子相當知名的遮罩自編碼器(masked autoencoder, MAE)[45] 也可以歸類於此,可視為把修補當作預訓練任務:遮住 75% 的影像區塊,訓練 ViT 把它們重建回來,結果學到了很強的視覺表徵。實務上的修補方面,LaMa [46] 使用具備全影像感受野的快速傅立葉卷積,並以大型遮罩訓練,能在高解析度下填補大破洞;如今,以擴散模型為基礎的修補是大範圍、語意層級編輯的預設做法。
去背(Matting,簡介)
白話版。 把前景(一個人、他的頭髮)連同柔和、半透明的邊緣一起摳出來,好貼到新背景上。
去背假設每個像素是前景與背景的混合:
其中 是不透明度(alpha matte), 是前景顏色, 是背景顏色。每個像素有七個未知數( 與兩組 RGB 顏色),卻只有三個觀測值,嚴重不足,所以傳統方法要求使用者提供三色圖(trimap:確定前景、確定背景、不確定區域)。它也可以視為分割的一種軟性變形。Background Matting [47] 用一張不含主體的背景照片取代三色圖,先在合成影像上訓練網路,再以對抗損失(判斷新合成圖看起來是否自然)在真實影像上訓練。
通用骨幹網路
白話版。 在上述所有任務中,總是那幾種網路設計反覆勝出。它們是通用的「影像到影像引擎」,可以拿來訓練上面任何一種退化。
| 骨幹 | 核心想法 | 為什麼適合復原 |
|---|---|---|
| U-Net [48] | 編碼器–解碼器,每個尺度都有跳躍連接 | 降採樣路徑提供大感受野,跳躍連接保留細節 |
| SwinIR [14] | 在全解析度上堆疊位移視窗自注意力的殘差群組 | 權重隨內容自適應;SR、去雜訊、JPEG 表現強 |
| Restormer [23] | 由 Transformer 區塊組成的 U-Net;注意力在通道維度計算(轉置注意力),搭配門控前饋網路 | 成本與像素數呈線性,可擴展到大影像 |
| NAFNet [24] | 由簡單卷積區塊組成的 U-Net,使用 LayerNorm、SimpleGate 與簡化通道注意力;移除傳統啟用函數,閘門仍有非線性 | 每單位 FLOP 的準確度極高;預設的「簡單基準」 |
| MambaIR / MambaIRv2 [49], [50] | 選擇性狀態空間(Mamba)掃描,加上局部增強與通道注意力;v2 加入「注意力式」非因果掃描 | 以線性成本取得全域感受野 |
反覆出現的設計理由。(1)全域殘差:預測 (或 減去上採樣的 ),讓網路只學缺少的部分。(2)自 EDSR [10] 以來,大多數 SR/復原網路不用批次正規化:訓練小塊與完整測試影像的 BN 統計量不同,會損害色彩與數值範圍的保真度。(3)以可控成本取得大感受野:多尺度 U-Net、視窗或通道注意力、狀態空間掃描。復原既需要上下文(分辨紋理與雜訊),也需要全解析度的細節。(4)用注意力或門控做內容自適應處理:通道注意力(RCAN)、門控(NAFNet、Restormer)。原文的「Extension」清單預言了 ViT、Flow、GAN、Diffusion 等新架構;到了 2026 年,狀態空間模型也加入 CNN 與 Transformer,成為第三種骨幹選項 [49], [50]。
All-in-one 與通用復原
白話版。 不要為雨、霧、雜訊各訓練一個模型,而是訓練一個模型,讓它自己判斷影像哪裡出了問題,再把它修好。
動機
原文的「Extension」一節把 all-in-one 復原列為 2023 年最熱門的題目之一,大約從 2021 年開始。動機很實際:在實際部署的系統中,我們事先不知道某張影像有哪一種退化(或哪幾種混合),各種天氣也可能隨時出現或同時發生。一整組任務專屬模型需要前面再接一個可靠的分類器,還浪費記憶體;一個能自我調整的模型方便得多。困難在於任務干擾:不同退化需要不同、甚至相反的操作(去雜訊是平滑,去模糊是銳化),所以直接做多任務訓練的效果會輸給專用模型。
代表方法
- AirNet [51](CVPR 2022):以對比學習訓練的退化編碼器,以成對修復資料與對比裁切樣本學到影像「如何」受損,並用它引導復原網路;它的雜訊+雨+霧設定成為標準的三任務基準。
- TransWeather [52](CVPR 2022):一個 Transformer 處理雨、霧、雪,使用可學習的天氣類型查詢。
- PromptIR [53](NeurIPS 2023):輕量的提示區塊把退化相關的資訊注入 Restormer 風格的解碼器。
- AdaIR [54](ICLR 2025):不同退化影響不同的頻帶,所以分別自適應地調整低頻與高頻特徵。
- DA-CLIP [55](ICLR 2024):調整過的 CLIP 模型提供退化嵌入,用來引導復原網路。
- InstructIR [56](ECCV 2024):以一句自然語言指令(「把雨去掉」)作為網路的條件。
選讀:All-in-one 方法的細節(見「補充資料」頁)。六個模型各自如何表示退化,又如何把它注入網路。
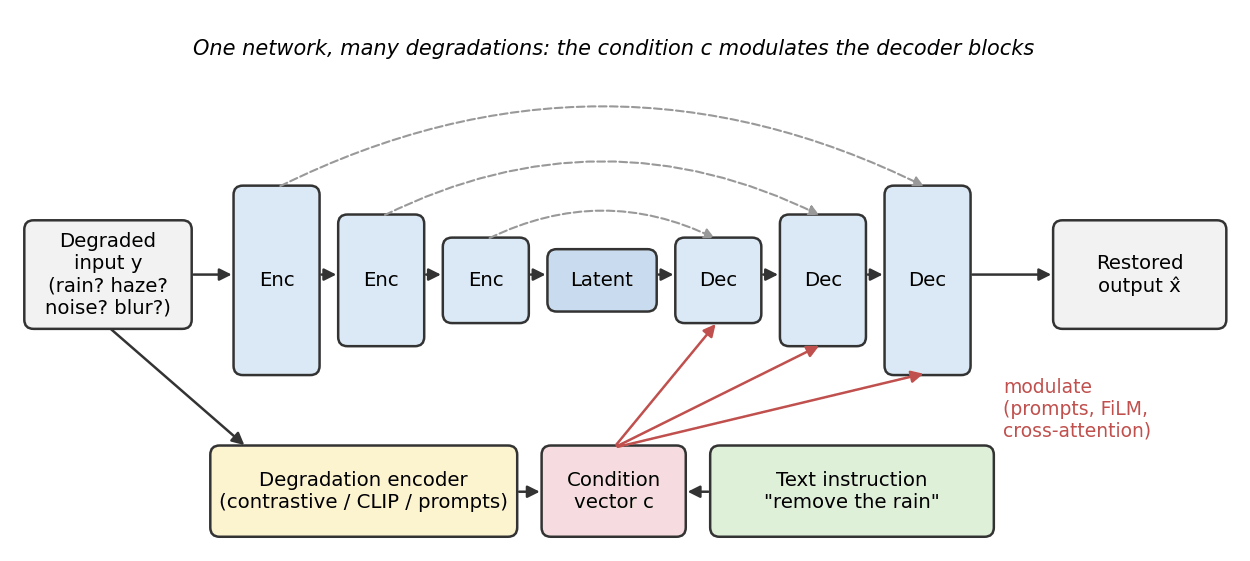
原文的動機仍是核心;改變的是「由誰決定退化類型」。它從固定的任務標籤,轉移到學習出的提示、視覺語言嵌入,最後到人類的指令,背後往往有大型預訓練模型支撐。All-in-one 綜述 [72] 對此有詳細討論。
生成式與工具式擴充。 AutoDIR [119] 結合自動品質評估、潛在擴散與結構修正;PromptFix [122] 結合使用者指令、視覺輔助描述與高頻保留。AgenticIR [120]、4KAgent [121] 則安排並評估預訓練工具;規劃迴圈與多個候選的成本,與整合骨幹單次前向運算不同。
選讀:Restormer、NAFNet(見「論文導讀」頁)。先理解修復骨幹如何保留細節並收集脈絡。
選讀:AirNet、TransWeather、PromptIR、AdaIR(見「論文導讀」頁)。接著比較退化特徵、學得查詢、特徵 prompt 與頻率調適。
選讀:DA-CLIP、InstructIR、AutoDIR、PromptFix(見「論文導讀」頁)。區分視覺推估引導、人類指令與生成式編輯。
選讀:AgenticIR、4KAgent(見「論文導讀」頁)。最後理解跨工具的規劃、候選選擇、反思與回復。
損失函數
白話版。 損失函數決定了什麼叫「好」。像素損失獎勵平均而言接近真實;感知與對抗損失獎勵看起來真實;頻率損失獎勵把細節做對。
像素損失。 令 ,
其中 是像素值的總數, 是一個小常數,讓最後一個成為平滑、可微分的 L1 版本。L2 直接最佳化 PSNR,但對大誤差懲罰很重,而且會收斂到後驗平均。Zhao 等人 [57] 證明在架構固定的情況下,光是換損失函數就能明顯改變結果,而且 L1 與受感知啟發的損失(包括和 SSIM 的組合)常常勝過 L2,甚至在與 L2 相關的指標上也是。L1 是現代大多數 SR 與復原論文的預設選擇。
感知(特徵)損失。 在預訓練分類網路 (通常是 VGG)的特徵空間中比較影像 [58]:
其中 是第 層的特徵圖,有 個通道、尺寸為 。它能容忍小的位移,獎勵的是邊緣與紋理吻合,而不是數值完全相同。
對抗損失。 判別器 學習分辨復原影像與真實影像,復原網路則學著騙過它,例如 。這會把輸出推向自然影像的流形上(SRGAN [12]、ESRGAN [13]、Real-ESRGAN [4]),代價是可能出現憑空捏造的紋理。實務上以 GAN 為基礎的復原網路會使用加權和,例如 ,權重為 。
頻率損失。 網路傾向先擬合低頻,對細節擬合不足。在傅立葉轉換 上加一項損失,例如對複數值或振幅計算 ,就能直接懲罰缺少的高頻。焦點頻率損失(focal frequency loss)[59] 更進一步,自適應地加重目前最難重建的頻率成分。頻率項現在在去模糊與 all-in-one 模型中很常見。
評估指標
白話版。 「復原結果是否接近真實?」與「它看起來像不像真的照片?」是兩個不同的問題,由不同的指標回答,而且你無法同時把兩者做到最好。
全參考指標
PSNR(峰值訊雜比):
其中 是像素可能的最大值(1 或 255), 是均方誤差。單位是 dB;提升 1 dB 約等於 MSE 降低 21%。
SSIM(結構相似度)[60] 比較局部平均、變異數與共變異數:
在兩張影像的局部視窗 、 上計算再取平均,其中 是局部平均, 是局部變異數, 是局部共變異數, 是維持數值穩定的小常數。它和人眼感受到的結構相關性比 PSNR 好,但仍然偏好平滑的結果。
LPIPS [61] 衡量深度網路特徵之間的距離(依人類相似度判斷校準)。越低越好,它會獎勵 PSNR 所懲罰的逼真紋理。
程式碼 · Python · 17 行
import numpy as np
from scipy import ndimage as ndi
from skimage import data, img_as_float32
from skimage.metrics import peak_signal_noise_ratio, structural_similarity

x = img_as_float32(data.camera())
y = np.clip(x + np.random.default_rng(0).normal(0, 0.1, x.shape), 0, 1).astype(np.float32)
x_hat = ndi.gaussian_filter(y, 1.0)

def psnr(ref, est, peak=1.0):
    mse = np.mean((ref.astype(np.float64) - est) ** 2)
    return 10 * np.log10(peak ** 2 / mse)

print(f"PSNR  ours {psnr(x, x_hat):.2f} dB | skimage {peak_signal_noise_ratio(x, x_hat, data_range=1):.2f} dB")
print(f"SSIM  {structural_similarity(x, x_hat, data_range=1):.3f}")
# PSNR  ours 27.20 dB | skimage 27.20 dB
# SSIM  0.639
一定要寫清楚計算慣例(RGB 或 Y 通道、邊界裁切、數值範圍、是否先四捨五入成 8 位元):光是這些差異,就足以讓論文中的 PSNR 相差零點幾 dB。
無參考指標
白話版。 無參考指標只從復原影像估計品質,適合沒有乾淨參考的情況,但無法證明還原細節正確。
全參考、部分參考與無參考
影像品質評估(image quality assessment, IQA)方法依照它們對原始影像 知道多少來分類:
- 全參考(full-reference, FR):完整的 可用,指標逐像素或逐特徵比較 與 (PSNR、SSIM [60]、LPIPS [61])。合成基準用的就是這一類。
- 部分參考(reduced-reference, RR):只有 的少數摘要特徵可用(例如隨壓縮視訊一起傳送的統計量),指標在 上計算同樣的特徵再比較。
- 無參考(no-reference, NR,盲):只有 可用。指標必須自帶一套「什麼叫好」的模型。
復原需要 NR 指標有三個理由。(1) 真實測試影像沒有真值:真實世界 SR、去雨、除霧都在沒有人擁有乾淨版本的照片上評估。(2) 參考影像本身可能不完美,或只是眾多合理答案之一:GAN 或擴散模型的輸出可能看起來非常好,PSNR 卻很低,因為它的紋理與參考影像不同(見下方的感知–失真權衡)。(3) NR 分數可以在執行時引導系統,例如在沒有參考影像時,從多個輸出或參數中挑一個。代價是:NR 指標是人類意見的模型,而每個模型都有盲點。
如何驗證 NR 指標:與人類意見的相關性
白話版。 只有當一個 NR 指標對影像的排序和人一致時,我們才信任它。所以研究者收集大量影像的大量人類評分,再檢查指標分數與評分有多一致。
平均意見分數。 在主觀實驗中,每張影像 由多位觀察者評分,平均分就是它的平均意見分數(mean opinion score),,其中 是評分者 給的分數, 是評分者人數。有些資料集公布的是差異分數(DMOS),以失真影像與其參考影像評分之差為基礎;DMOS 通常越低越好。
SRCC(Spearman 等級相關係數)衡量指標是否把影像排成和人相同的順序:
其中 是測試影像數, 是影像 依預測分數的名次與依 MOS 的名次之差(這個簡式假設沒有同名次;有同名次時改算名次的 Pearson 相關)。SRCC 對分數做任何單調轉換都不變,因此它衡量的是預測的單調性。
PLCC(Pearson 線性相關係數)衡量分數之間有多線性地一致:
其中 是指標給影像 的分數, 是它的 MOS,、 是兩者的平均。由於各指標的尺度是任意的,常見做法是先用一個擬合出的單調函數(通常是 logistic 函數)轉換 ,再在轉換後的分數上算 PLCC,因此 PLCC 衡量的是校準後的預測準確度。兩者都落在 。對 NIQE 這種「越低越好」的指標,與 MOS 的原始相關係數是負的,論文會報告其絕對值。指標通常在資料集的一部分上訓練、在其餘部分測試,而跨資料集的相關性才是對泛化能力更誠實的檢驗。
人類評分資料集。 NR 指標在附有人類評分的影像品質資料集上訓練與測試。對復原而言,重點是失真從哪裡來:合成損壞(LIVE [104]、TID2013 [105]、KADID-10k [106])、真實相機照片(KonIQ-10k [107]、SPAQ [108]),或是復原演算法本身的輸出(PIPAL [109])。只有最後這一類資料集,才包含復原論文真正需要評分的那種影像。
選讀:人類評分的 IQA 資料集(見「補充資料」頁)。用一張表整理每個資料集的內容。
第一類:自然場景統計(NSS)模型
白話版。 乾淨的照片有一些隱藏的統計習慣。把照片的局部亮度與局部對比去掉之後,剩下的部分會呈現某種典型形狀的鐘形直方圖,而且相鄰的剩餘值彼此只有微弱的關聯。模糊、雜訊與壓縮會以各自特有的方式改變這個形狀。NSS 指標就是量測這個形狀,再問它有多不尋常。
MSCN 係數。 對灰階影像 ,去均值對比正規化(mean-subtracted contrast-normalized, MSCN)係數為 [94]
其中 是像素位置, 是權重總和為 1 的小型圓對稱高斯視窗, 與 是局部加權平均與標準差, 是一個小常數(8 位元影像取 1),避免在平坦區域除以零。這是一種除法正規化,大致模仿人類早期視覺中的對比增益控制。
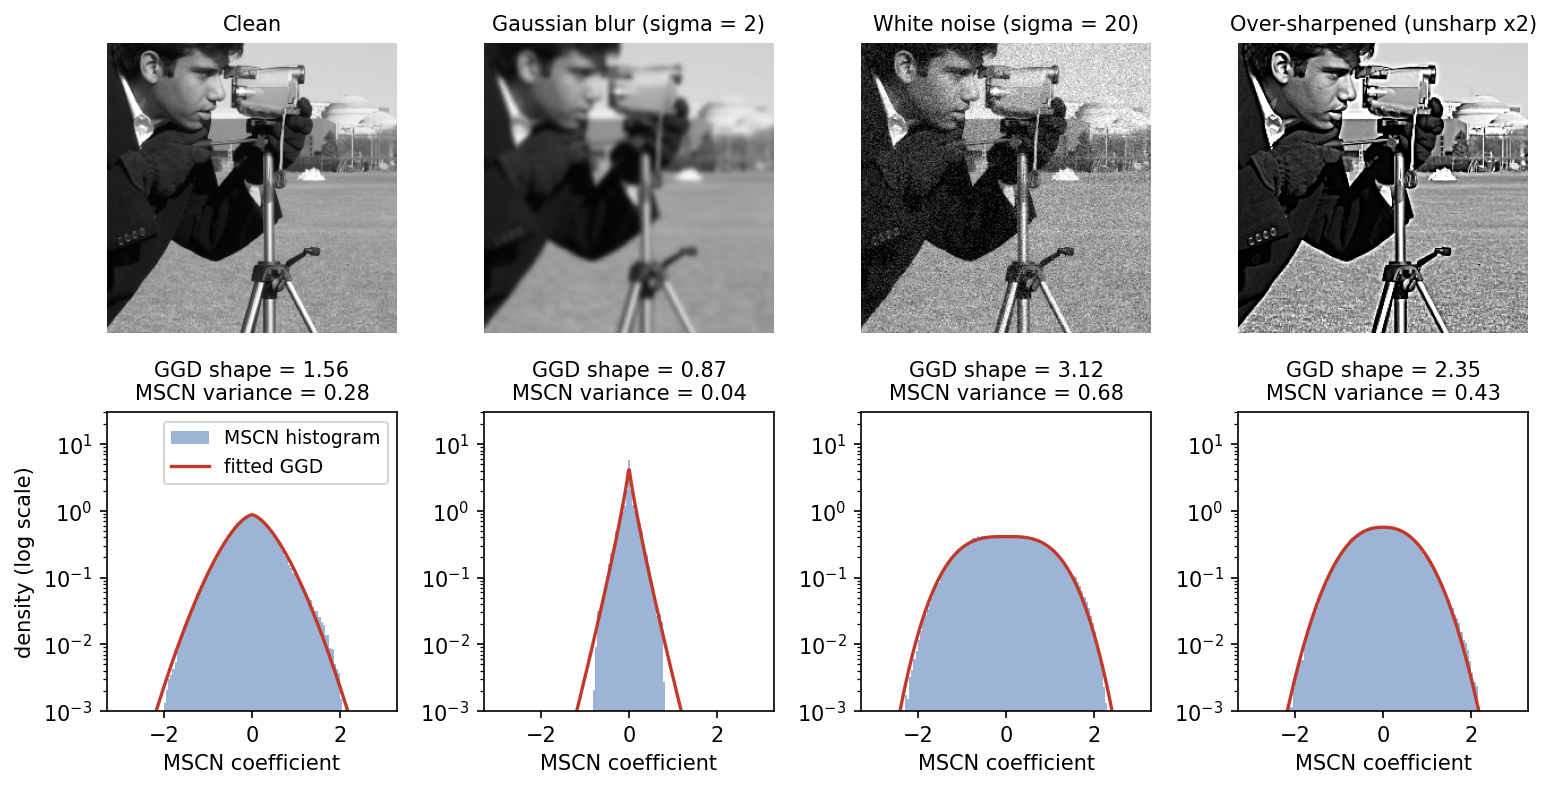
廣義高斯擬合。 的直方圖以零均值的廣義高斯分布(generalized Gaussian distribution, GGD)建模:
其中 是一個 MSCN 值, 是形狀參數( 為高斯, 為拉普拉斯; 越小直方圖越尖、尾巴越重,越大則頂部越平), 是變異數, 是對應的尺度, 是 gamma 函數。估計 的簡單方法是動差匹配(moment matching):比值 只與 有關,所以先從資料算出左邊,再搜尋能對上的 。
BRISQUE [94](Blind/Referenceless Image Spatial Quality Evaluator)計算 MSCN 係數的 GGD 形狀與變異數,再加上對相鄰 MSCN 係數乘積(水平、垂直與兩個對角方向)擬合非對稱 GGD 得到的參數,並在兩個影像尺度上重複。一個以合成失真影像的人類評分訓練的支持向量迴歸器(SVR),把這些特徵對應成品質分數。越低越好。它是需要意見分數的(opinion-aware):訓練時需要人類評分。
NIQE [62](Natural Image Quality Evaluator)則不需要意見分數(opinion-unaware):它從未看過人類評分或失真影像。它在清晰的區塊上計算類似的 NSS 特徵,對一組原始影像的特徵擬合一個均值 、共變異數 的多變量高斯(multivariate Gaussian, MVG),對測試影像的區塊擬合另一個 MVG ,然後報告
也就是兩個高斯之間類似 Mahalanobis 距離的量( 為轉置)。越低越好;零代表「統計上和原始影像集一樣」。
還有兩個在復原論文中常見的親戚。PIQE [96] 逐區塊套用 MSCN 統計量,不需要意見分數,還能給出影像哪裡看起來失真的分布圖。2018 年 PIRM 超解析挑戰賽 [63] 的感知指數(Perceptual Index, PI)把 NIQE 與 Ma 等人 [95] 從超解析影像的人類評分學出的分數結合起來;PI 越低代表感知品質越好,許多感知 SR 論文至今仍報告它。
選讀:PIQE 與感知指數(見「補充資料」頁)。PIQE 如何彙整區塊失真、PI 的公式,以及 PIRM 挑戰賽如何使用它。
程式:實際看看 MSCN 統計量。 下面的程式在 camera 及其模糊、加雜訊、過度銳化的版本上,計算 MSCN 係數、以動差匹配估計的 GGD 形狀、MSCN 變異數,以及水平相鄰係數的相關(BRISQUE 成對特徵的簡化版):
程式碼 · Python · 35 行
import numpy as np
from scipy.ndimage import gaussian_filter
from scipy.special import gamma
from skimage import data, img_as_float

def mscn(img, sigma=7/6, C=1.0):
    """Mean-subtracted contrast-normalized coefficients of a grayscale image in [0, 255]."""
    mu = gaussian_filter(img, sigma)
    sd = np.sqrt(np.abs(gaussian_filter(img * img, sigma) - mu * mu))
    return (img - mu) / (sd + C)

def ggd_shape(x):
    """Moment-matching estimate of the generalized Gaussian shape alpha (2 = Gaussian)."""
    alphas = np.arange(0.2, 10.0, 0.001)
    r_theory = gamma(1 / alphas) * gamma(3 / alphas) / gamma(2 / alphas) ** 2
    r_data = np.mean(x ** 2) / np.mean(np.abs(x)) ** 2
    return alphas[np.argmin((r_theory - r_data) ** 2)], np.mean(x ** 2)

rng = np.random.default_rng(0)
clean = img_as_float(data.camera()) * 255
versions = {
    "clean": clean,
    "blur (sigma=2)": gaussian_filter(clean, 2),
    "noise (sigma=20)": np.clip(clean + rng.normal(0, 20, clean.shape), 0, 255),
    "over-sharpened": np.clip(clean + 2.0 * (clean - gaussian_filter(clean, 2)), 0, 255),
}
for name, img in versions.items():
    m = mscn(img)
    alpha, var = ggd_shape(m)
    rho = np.mean(m[:, :-1] * m[:, 1:]) / var           # correlation of horizontal neighbors
    print(f"{name:17s} GGD shape {alpha:4.2f} | MSCN variance {var:4.2f} | neighbor corr. {rho:+.2f}")
# clean             GGD shape 1.56 | MSCN variance 0.28 | neighbor corr. +0.12
# blur (sigma=2)    GGD shape 0.87 | MSCN variance 0.04 | neighbor corr. +0.89
# noise (sigma=20)  GGD shape 3.12 | MSCN variance 0.68 | neighbor corr. -0.10
# over-sharpened    GGD shape 2.35 | MSCN variance 0.43 | neighbor corr. +0.09
每種失真都把特徵推往自己的方向(圖 6)。模糊去掉局部對比,大部分 MSCN 值縮向零:變異數很小、直方圖非常尖( 小)、相鄰值高度相關。雜訊加入彼此獨立的能量:變異數變大、直方圖頂部變平( 大於 2)、相鄰相關接近零(略為負值,因為減去局部平均會讓相鄰值彼此牽連)。過度銳化則把特徵推往和雜訊相同的方向。這正是 NSS 指標用於復原時的核心弱點:它分不出復原出來的紋理和憑空加上的高頻能量。另外要注意,絕對數值取決於影像內容與 (乾淨的 camera 影像並不是單位高斯),這就是為什麼 BRISQUE 需要訓練迴歸器、NIQE 需要原始參考影像集,而不是使用固定門檻。
第二類:學習式深度模型
白話版。 不用手工設計的統計量,而是訓練神經網路直接預測人類評分。深度特徵更能掌握內容、語意與複雜的瑕疵,但模型只懂它訓練時看過的影像與意見。
五個常用的例子:NIMA [97] 預測人類評分的整個分布,而不是單一數字;HyperIQA [98] 依畫面內容調整品質判斷規則,因為同樣的模糊出現在天空上和臉上,給人的感受不同;MUSIQ [99] 以原始解析度與長寬比讀取影像,不會因縮放而改變正要被評估的瑕疵;MANIQA [100] 是一個 transformer,贏得 NTIRE 2022 感知 IQA 挑戰賽的無參考賽道,該賽事資料包含復原與 GAN 的輸出;TOPIQ [101] 則讓高階語意決定哪些低階失真比較重要。
這些模型都是需要意見分數的,輸出「越高越好」的分數,而且都依賴訓練資料集:同一架構在 KonIQ-10k 上訓練與在 PIPAL 上訓練,可能會給復原方法不同的排名。
選讀:學習式 NR 評估器如何運作(見「補充資料」頁)。五個模型各自的架構與訓練目標。
第三類:視覺–語言與大型多模態模型
白話版。 用大量圖文資料訓練出的模型,已經「知道」好照片和壞照片長什麼樣子。你可以直接問它們:把影像和文字提示比較,或乾脆請一個聊天機器人式的模型打分數。
CLIP-IQA [102] 比較影像的 CLIP 嵌入與一對反義提示(例如「Good photo.」與「Bad photo.」)的嵌入,再把兩個相似度轉成 0 到 1 之間的分數(越高越好)。基本版本完全不需要意見分數;換用其他提示對(「Sharp photo.」/「Blurry photo.」)可以探測單一屬性,而提示的措辭會改變分數。Q-Align [103] 微調一個大型多模態模型,讓它像人類評分者一樣以 bad 到 excellent 的評分等級回答,再把它對這五個字的機率轉成分數。這類模型跨資料集表現強,但運算量大,也會繼承基礎模型的偏誤。
選讀:CLIP-IQA 與 Q-Align 的分數(見「補充資料」頁)。把相似度與等級字詞的機率轉成品質分數的兩條公式。
分布層級的指標
有些指標評的是一組輸出而非單張影像。FID [64] 比較復原結果集合與一組真實影像在 Inception 特徵上的分布;它原本是為生成模型設計的,現在用於擴散 SR 這類生成式復原,但它需要大量影像,而且無法告訴你任何單張影像的好壞。原文也提到的 IS(Inception Score)衡量類別預測的信心與多樣性,比較適合類別條件式生成而非復原,如今在復原任務中很少使用。
使用者研究與成對比較
白話版。 好不好看,最終由人決定。兩種標準的問法是:請人在量表上打分數,或請人從兩張中選出比較好的一張。這樣的研究也是上述每個 NR 指標用來驗證的標尺,更是新方法能提出的最有力證據。
平均意見分數(MOS)。 位評分者各自給一張影像一個固定量表上的分數 (常見為 1 到 5),MOS 就是這些分數的平均,定義同上面驗證指標時的說明。ITU-R BT.500 [111] 為這類測試訂定標準:觀看條件、評分量表、單刺激與雙刺激以及比較式方法,還有篩除不可靠評分者的程序。
成對比較。 絕對量表在不同評分者之間會漂移;從兩張中選出比較好的一張比較容易,也比較一致。Bradley–Terry 模型 [112] 把大量這樣的選擇轉換成每個方法 的一個強度 ,擬合的目標是讓方法 勝過方法 的機率等於 。依擬合出的強度排序,就得到一個一致的排名,即使每位評分者一次只比較過兩張影像。
選讀:擬合 Bradley–Terry 模型(見「補充資料」頁)。最大概似的更新公式,以及一個可執行的三方法範例。
良好的做法:隱藏方法名稱、隨機化順序與左右位置、同時顯示輸入以提供脈絡、使用足夠多的影像與評分者、回報信賴區間或顯著性,並說明顯示器與觀看條件。只有少數評分者與精挑細選影像的研究,只能算展示,不能算證據。
常見陷阱
- 指標可以被刻意迎合。 一個會加顆粒或銳化邊緣的復原模型可以改善 NSS 分數(上面的程式就顯示了這點),卻沒有變得更忠實。任何可微分的指標(以及任何學習式 IQA 網路)一旦被拿來當訓練損失函數或用於模型選擇,都可能被直接最佳化,網路學會的是討好指標而不是討好人。如果一個方法在損失函數中用了 CLIP 或某個 IQA 網路,再用同一個模型評估它就不是獨立的評估。
- 領域不匹配。 大多數需要意見分數的指標是在合成失真(LIVE、TID2013、KADID-10k)或相機照片(KonIQ-10k、SPAQ)上訓練的。復原輸出的瑕疵不一樣:憑空生成的紋理、過度平滑、GAN 特有的圖樣。這種不匹配正是 PIPAL [109] 明確的動機:其作者發現既有的 IQA 方法無法公平評估以 GAN 為基礎的復原。低光源的問題則在於曝光與色彩,而大多數 NSS 特徵會把它們正規化掉;低光源專屬的討論請見 DLCV 09C。
- 指標彼此不一致。 NSS、學習式與視覺–語言指標常把同一批方法排出不同的順序,而且都可能與人的判斷不同。分數也取決於實作、權重檔、色彩空間、輸入尺寸以及影像是否被縮放,所以從不同論文抄來的數字往往無法直接比較。
- 「NR 品質較高」不等於「較正確」。 NR 指標無法知道一張清晰的臉或一行文字是否和真實場景相符。憑空生成的車牌也可能拿到滿分。
建議做法
- 有參考影像時,以 FR 指標(PSNR、SSIM、LPIPS)為主,NR 指標作為補充;並在感知–失真平面上標出你的方法(見下一小節)。
- 在沒有參考影像的真實影像上,報告多個來自不同類別的 NR 指標(例如 NIQE 或 PI、一兩個學習式模型如 MUSIQ、MANIQA 或 TOPIQ,以及一個視覺–語言指標如 CLIP-IQA 或 Q-Align),並註明每個指標是越高還是越低越好。
- 使用同一套實作並寫明版本與權重檔。開源的 IQA-PyTorch 工具箱(
pyiqa)[110] 以統一介面重新實作了本節大多數的指標(NIQE、BRISQUE、PIQE、Ma 分數與 PI、NIMA、HyperIQA、MUSIQ、MANIQA、TOPIQ、CLIP-IQA、Q-Align,以及 FR 指標)。 - 不要對著裁判調參:至少保留一個完全沒參與訓練或模型選擇的指標。
- 重要的主張要有使用者研究佐證(平均意見分數或成對比較,盲測且隨機化);上面的使用者研究小節介紹了 MOS 與 Bradley–Terry 成對比較的流程。指標之間或指標與人不一致時,要明白說出來。
總覽表
四個類別一覽:
| 類別 | 例子 | 需要人類評分嗎? | 方向 | 常見盲點 |
|---|---|---|---|---|
| NSS | NIQE、BRISQUE、PIQE、PI | NIQE 與 PIQE 不需要;BRISQUE 與 PI(透過 Ma)需要 | 越低越好 | 獎勵添加的顆粒與銳化;把曝光與色彩正規化掉 |
| 學習式深度模型 | NIMA、HyperIQA、MUSIQ、MANIQA、TOPIQ | 需要 | 越高越好 | 取決於訓練資料;復原瑕疵不同於訓練時的失真 |
| 視覺–語言 | CLIP-IQA、Q-Align | CLIP-IQA(零樣本)不需要;Q-Align 需要 | 越高越好 | 提示措辭;基礎模型的偏誤;運算量大 |
| 分布層級 | FID | 不需要(使用預訓練 Inception 特徵) | 越低越好 | 需要大量影像;無法評判單張影像 |
選讀:逐一指標的總覽表(見「補充資料」頁)。全部十三個指標的類別、訓練需求、方向與主要敏感之處。
感知–失真權衡
Blau 與 Michaeli [65] 把這個矛盾形式化。令 為任意失真度量(MSE、 SSIM……), 為真實影像分布與復原影像分布之間的散度(感知品質: 越小,輸出在統計上越無法與真實影像區分)。感知–失真函數定義為
其中最小值取遍所有(可能帶隨機性的)復原方法。他們證明 是非遞增的,而且(當散度對第二個引數為凸時)是凸函數:原點附近有一塊無法達到的區域。一個方法不可能同時擁有最小失真與完美的真實感。特別是 MMSE 估計 的失真最低,但輸出分布模糊、不真實;想看起來真實,就必須接受較高的 MSE。GAN(以及現在的擴散模型)是沿著這條邊界移動的原則性方法。
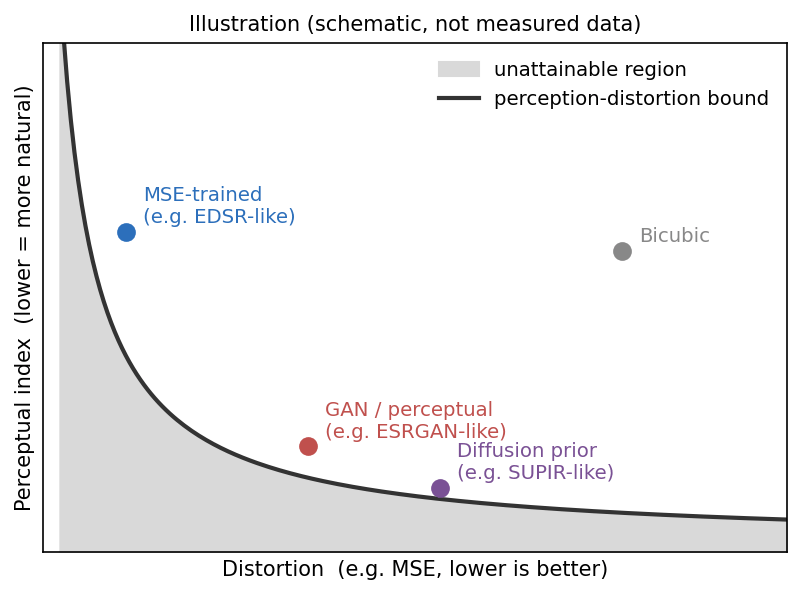
這正是原文評估指標一節的更新:擴散模型能「生成」看似合理但不一定忠於原圖的細節,保真度(PSNR/SSIM)與感知品質之間的落差因此更受重視。NTIRE 2025 SR 挑戰賽就分成兩個賽道:以 PSNR 排名的 restoration track,以及以感知分數排名的 perceptual track [3];2024 年的版本則以 PSNR 排名 [2]。實務建議:同時報告一個失真指標與一個感知指標,並說明你的方法瞄準權衡曲線上的哪個位置。
NTIRE 挑戰賽
白話版。 每年 CVPR 的一個 workshop 會在固定資料集上舉辦公開競賽,並發表報告說明勝出的想法:這是了解「現在什麼有用」最簡單的方式。
既然依任務分類的排行榜已經消失,NTIRE 挑戰賽報告就是追蹤復原領域的好管道。每份報告都會說明任務、資料、評估方式,以及名列前茅隊伍的方法。本篇引用的例子:
- NTIRE 2017 SR [19]:推出 DIV2K;EDSR [10] 奪冠。
- NTIRE 2024 SR [2]:在 DIV2K 上做雙三次 ,以 PSNR 排名。
- NTIRE 2025 SR [3]:restoration(PSNR)與 perceptual 兩個賽道分開評比。
- NTIRE 2025 雨滴去除 [40]:真實的白天與夜晚雨滴影像,並有雙重對焦設定。
- NTIRE 2024 與 2025 低光增強:這兩屆低光挑戰賽的摘要請見 DLCV 09C。
近年的報告有兩個共同模式:勝出的作品通常是上述骨幹(HAT、Restormer、NAFNet 或 Mamba 風格,有時再加上擴散先驗)的集成或大型混合模型,並使用大量資料與算力訓練;而挑戰賽也越來越常使用真實拍攝的資料與感知賽道。
現代觀點
原文最後列出了延伸方向(醫學影像、多模態、非監督、新架構、all-in-one、低階結合高階、即時與低運算、水下)。其中大多數現在都是活躍的研究領域。以下依任務整理綜述文獻,再談 2023–2026 年的最新進展與尚未解決的問題。
綜述論文
- 超解析度(Wang、Chen 與 Hoi [66]):把 SR 模型描述成在上採樣位置與運算、網路設計、損失函數與訓練策略上的選擇,並點名非監督/真實世界 SR 為主要的開放方向。
- 去雜訊(Tian 等人 [67];Elad、Kawar 與 Vaksman [68]):瓶頸往往是雜訊模型的真實程度;去雜訊器如今是其他反問題與擴散模型的基本元件,前沿也移向從後驗分布取樣。
- 去模糊(Zhang 等人 [69]):動態場景去模糊已從估計模糊核,轉向以 GoPro 這類實拍配對訓練的端到端多尺度網路。
- 除霧(Gui 等人 [70])與除雨(Yang 等人 [71]):物理引導與無物理的設計並存;真實的退化模型與真實世界的評估,比在合成資料上繼續微調架構更重要。
- All-in-one(Jiang 等人 [72]):依架構、學習範式與核心創新分類;各論文的任務組合不一致,讓比較變得困難,對未見過與混合退化的泛化仍是開放問題。
- 擴散式復原(Li 等人 [73]):感知品質最好,但成本高,也有保真度與捏造細節的疑慮;蒸餾成少步驟與更好的評估是關鍵方向。
選讀:綜述論文的詳細介紹(見「論文導讀」頁)。每篇綜述的完整標題、出處、分類方式與重點。
2023–2026 年的最新進展
- All-in-one 與盲復原成為主流設定,不再是小眾題目。方法從學習式退化表徵(AirNet)發展到提示(PromptIR)、頻率感知的自適應(AdaIR)與語言引導(DA-CLIP、InstructIR)。
- 以預訓練擴散模型作為生成先驗,大幅改變了真實世界 SR 與盲復原(DiffBIR、SUPIR),一步式變體(OSEDiff)則把推論成本從數十、數百步降到一步。
- 狀態空間模型(MambaIR、MambaIRv2)加入 CNN 與 Transformer,成為以線性成本取得全域感受野的骨幹選項。
- 評估方式跟上了生成能力:挑戰賽把保真度賽道與感知賽道分開 [3],真實拍攝的資料集(SIDD、O-HAZE、Dense-Haze、Raindrop Clarity)也和合成基準一起成為標準。
尚未解決的問題
- 真實世界的泛化。 合成流程仍然漏掉真實相機的影像處理、隨位置變化的模糊與混合天氣;模型遇到沒見過的組合時表現會下滑。
- 保真度 vs. 捏造。 生成先驗可能憑空創造文字、人臉或紋理。在醫學、鑑識與科學用途中這是不能接受的,而我們還缺少衡量「忠實又清晰」的好指標。
- 評估。 PSNR/SSIM 獎勵模糊;無參考指標可以被刻意迎合;人類評測成本高。對生成式復原而言,指標與人類偏好的一致性仍然很弱。
- 效率。 在手機與相機上做高解析度、即時(以及影片)復原仍是很強的限制,對 Transformer 與擴散模型尤其如此。
- All-in-one 模型的任務干擾與擴展,以及如何在不重新訓練的情況下加入新的退化。
- 低階結合高階。 讓復原幫助下游偵測或分割,而不是給人看,是另一種目標(任務導向評估,例如 RESIDE [32])。
原文的觀點
原文以兩個至今仍成立的觀察作結。第一,由於每個任務都簡單明瞭,現階段 SOTA 的比拼大多靠特殊的架構取勝,也就代表大量的算力與複雜的實驗設計;但這些任務在應用上都相當實用且容易上手,所以在應用面與任務的組合上還有很多著墨空間(all-in-one 復原正是往這裡發展)。第二,相較於高階任務,這個領域的學習成本不高:入門時很容易想像模型的架構與樣貌(受損的影像進去、更乾淨的影像出來),進而接觸更進一步的內容,是進入深度學習研究的好入口。
重點整理
- 選擇復原器及解讀輸出前,先說明退化假設。
- 訓練配對與退化合成決定網路學習還原什麼。
- 讓解析度路徑、感受野與正規化配合復原任務。
- 條件化可協助單一模型處理多種退化;未知與混合退化須分開測試。
- 像素準確度、感知真實感與輸入一致性回答不同問題,應搭配報告。
- 盲復原可以估計、依退化條件化,或隱式處理退化;聯合估計可能偏向退化解 [74]。
- 使用符合任務的資料集,並把無參考分數視為可能失準的品質估計,而非細節已還原的證明。
練習
- 退化的順序。 用
degrade函式,在相同參數下比較 (a) 模糊 → 降採樣 → 雜訊 → JPEG 與 (b) 雜訊 → 模糊 → 降採樣 → JPEG。從視覺上,以及在平坦區塊量測雜訊標準差,說明為什麼順序會影響網路要學的東西。
提示
在 (b) 中,模糊與降採樣會過濾雜訊:標準差變小,而且在空間上變得相關(變成平滑的斑塊,而不是逐像素的顆粒)。在 (a) 中,雜訊在低解析度下仍然是白雜訊。只用 (a) 訓練的網路,測試時遇到相關雜訊會去除不足。這也是 Real-ESRGAN 隨機化並重複各個階段的原因之一。
- 手算 pixel shuffle。 一個特徵張量的形狀為 ,、,第 個通道全部填入常數 。用 SR 一節的公式寫出 pixel shuffle 的 輸出,再用
torch.nn.PixelShuffle(2)驗證。
提示
輸出像素 取自通道 。所以每個 區塊都是 , 的輸出就是把這個區塊重複四次。每個輸出區塊都從同一個低解析度位置上的四個通道各取一個值。
- 殘差還是直接預測? 把
TinyDnCNN.forward改成回傳self.body(y)(直接預測乾淨影像),以相同的隨機種子與步數訓練兩個版本,比較 PSNR 與損失曲線。再用 重做一次。殘差學習在什麼情況下幫助最大?
提示
在訓練步數很少時,殘差版本通常收斂更快、PSNR 更高,因為它在初始化時就已經大約輸出 (PSNR 不差),只需要學一個小修正。低雜訊時直接預測的版本最吃力,因為它必須透過好幾層 ReLU 學出一個近乎恆等的映射。
- 用數字算暗通道。 某個有霧像素 ,其區塊內所有通道 的最小值為 ,。取 、,計算這個像素的 與還原後的 。
提示
。接著 ,約為 。輸出比輸入更暗、飽和度更高,這正是去掉霧的面紗後該有的樣子。
- 感知 vs. 失真。 把小型去雜訊網路的輸出再加上少量新的高斯雜訊(),計算加入前後的 PSNR 與 SSIM。雖然兩個指標都下降了,影像看起來卻可能更自然(比較不像塑膠)。把這個現象和感知–失真函數 連結起來。
提示
近似 MMSE 的輸出位於低失真的位置,但離自然影像分布很遠(太平滑)。加入顆粒會讓輸出分布更接近真實照片( 變小),代價是 MSE 變高:這是沿著(或朝向)凸邊界的移動,而不是越過它。
- 設計一個 all-in-one 實驗。 你要為雜訊()、雨線與霧建立單一模型。說明訓練資料的混合方式、如何為網路提供條件(測試時沒有標籤)、要和哪些基準比較,以及如何偵測任務干擾。
提示
每個任務各自取資料集並平衡取樣;加入一個與網路一起訓練的退化編碼器(如 AirNet 的對比學習,或 PromptIR 的提示)。與三個使用相同骨幹、相同大小的單任務模型比較,也和不加條件的版本比較。任務干擾的跡象是:all-in-one 模型在某個任務上落後單任務模型,在其他任務上卻打平;另外也要在訓練時沒見過的混合退化(雨+霧)上測試。
- 動手估計模糊核。 在盲反卷積的程式中,(a) 拿掉
shock(...)並設定keep=1.0(使用全部梯度),比較模糊核誤差與最後的 PSNR;(b) 改從 的方框模糊核開始,而不是接近 delta 的模糊核;(c) 把h_true換成 視窗中一條長 像素的直線運動軌跡。用 Levin 等人 [74] 的討論與由粗到細的策略解釋每個結果。
提示
(a) 使用全部梯度時,平滑的潛在影像中大量的弱梯度會主導最小平方擬合,估計不再改善(我們的執行結果中,模糊核誤差不降反升,最後的 PSNR 也停留在模糊輸入的水準)。只挑選少數強而且預測良好的邊緣,模糊核步驟才有資訊量,這正是實務上對付天真聯合 MAP「沒有模糊」偏差的方法。(b) 這個迴圈是非凸的交替最佳化,起點很重要;不同的起點可能收斂到不同的局部極小值。(c) 在全解析度下,從 delta 起點很難找到大的模糊核:我們的執行結果中誤差下降得少很多,也只補回一小部分「真實模糊核」的 PSNR。先在縮小的影像上估計模糊核(那時它只有幾個像素長),再把結果放大,正是影像金字塔的用途。
- 驗證一個 NR 指標。 五張復原影像的平均意見分數為 ,NIQE 分數為 。(a) 手算 SRCC,並解釋它的正負號。(b) 如果改報告 ,SRCC 會改變嗎?PLCC 呢?(c) 把 MSCN 程式用在一張去雜訊後再過度銳化的影像上,解釋為什麼 NSS 指標可能給它比單純去雜訊的輸出更好的分數。
提示
(a) 由小到大排名時,影像 1–5 的 MOS 名次為 ,NIQE 名次為 。名次差為 ,所以 ,。符號為負,是因為 NIQE 越低代表品質越好;報告時取 。只有影像 1 與影像 5 的順序對調。(b) SRCC 只依賴名次,任何像 這樣的單調轉換都不會改變它;PLCC 則會改變,這也是為什麼 PLCC 通常在擬合單調對應之後才計算。(c) 去雜訊會留下平滑的影像,其 MSCN 統計量類似輕微模糊(變異數低、直方圖尖)。銳化把高頻能量加回來,把統計量推回接近自然影像的樣子,不論加上的細節是不是真的。
參考文獻
- Shyandram, “Low-Level Vision Task-Image Restoration簡介,” Medium post, 2023; updated 2026. link
- Z. Chen, Z. Wu, E. Zamfir, K. Zhang, Y. Zhang, R. Timofte et al., “NTIRE 2024 Challenge on Image Super-Resolution (×4): Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2024. arXiv
- Z. Chen, K. Liu, J. Gong, J. Wang, L. Sun et al., “NTIRE 2025 Challenge on Image Super-Resolution (×4): Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2025. arXiv
- X. Wang, L. Xie, C. Dong and Y. Shan, “Real-ESRGAN: Training Real-World Blind Super-Resolution with Pure Synthetic Data,” in Proc. IEEE/CVF ICCV Workshops, 2021. arXiv
- E. H. Land and J. J. McCann, “Lightness and Retinex Theory,” Journal of the Optical Society of America, vol. 61, no. 1, pp. 1–11, 1971. doi
- C. Dong, C. C. Loy, K. He and X. Tang, “Image Super-Resolution Using Deep Convolutional Networks,” IEEE TPAMI, 2016 (conference version ECCV 2014). arXiv
- C. Dong, C. C. Loy and X. Tang, “Accelerating the Super-Resolution Convolutional Neural Network,” in Proc. ECCV, 2016. arXiv
- W. Shi, J. Caballero, F. Huszár, J. Totz, A. P. Aitken, R. Bishop, D. Rueckert and Z. Wang, “Real-Time Single Image and Video Super-Resolution Using an Efficient Sub-Pixel Convolutional Neural Network,” in Proc. IEEE CVPR, 2016. arXiv
- A. Odena, V. Dumoulin and C. Olah, “Deconvolution and Checkerboard Artifacts,” Distill, 2016. link
- B. Lim, S. Son, H. Kim, S. Nah and K. M. Lee, “Enhanced Deep Residual Networks for Single Image Super-Resolution,” in Proc. IEEE CVPR Workshops, 2017. arXiv
- Y. Zhang, K. Li, K. Li, L. Wang, B. Zhong and Y. Fu, “Image Super-Resolution Using Very Deep Residual Channel Attention Networks,” in Proc. ECCV, 2018. arXiv
- C. Ledig, L. Theis, F. Huszár, J. Caballero, A. Cunningham, A. Acosta, A. Aitken, A. Tejani, J. Totz, Z. Wang and W. Shi, “Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network,” in Proc. IEEE CVPR, 2017. arXiv
- X. Wang, K. Yu, S. Wu, J. Gu, Y. Liu, C. Dong, C. C. Loy, Y. Qiao and X. Tang, “ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks,” in Proc. ECCV Workshops, 2018. arXiv
- J. Liang, J. Cao, G. Sun, K. Zhang, L. Van Gool and R. Timofte, “SwinIR: Image Restoration Using Swin Transformer,” in Proc. IEEE/CVF ICCV Workshops, 2021. arXiv
- X. Chen, X. Wang, J. Zhou, Y. Qiao and C. Dong, “Activating More Pixels in Image Super-Resolution Transformer,” in Proc. IEEE/CVF CVPR, 2023. arXiv
- X. Lin, J. He, Z. Chen, Z. Lyu, B. Dai, F. Yu, W. Ouyang, Y. Qiao and C. Dong, “DiffBIR: Towards Blind Image Restoration with Generative Diffusion Prior,” arXiv:2308.15070, 2023. arXiv
- F. Yu, J. Gu, Z. Li, J. Hu, X. Kong, X. Wang, J. He, Y. Qiao and C. Dong, “Scaling Up to Excellence: Practicing Model Scaling for Photo-Realistic Image Restoration In the Wild,” in Proc. IEEE/CVF CVPR, 2024. arXiv
- R. Wu, L. Sun, Z. Ma and L. Zhang, “One-Step Effective Diffusion Network for Real-World Image Super-Resolution,” in Proc. NeurIPS, 2024. arXiv
- E. Agustsson and R. Timofte, “NTIRE 2017 Challenge on Single Image Super-Resolution: Dataset and Study,” in Proc. IEEE CVPR Workshops, 2017. doi
- K. Zhang, W. Zuo, Y. Chen, D. Meng and L. Zhang, “Beyond a Gaussian Denoiser: Residual Learning of Deep CNN for Image Denoising,” IEEE Transactions on Image Processing, vol. 26, no. 7, pp. 3142–3155, 2017. arXiv
- K. Zhang, W. Zuo and L. Zhang, “FFDNet: Toward a Fast and Flexible Solution for CNN-Based Image Denoising,” IEEE Transactions on Image Processing, 2018. arXiv
- A. Abdelhamed, S. Lin and M. S. Brown, “A High-Quality Denoising Dataset for Smartphone Cameras,” in Proc. IEEE/CVF CVPR, 2018. doi
- S. W. Zamir, A. Arora, S. Khan, M. Hayat, F. S. Khan and M.-H. Yang, “Restormer: Efficient Transformer for High-Resolution Image Restoration,” in Proc. IEEE/CVF CVPR, 2022. arXiv
- L. Chen, X. Chu, X. Zhang and J. Sun, “Simple Baselines for Image Restoration,” in Proc. ECCV, 2022. arXiv
- K. He, J. Sun and X. Tang, “Single Image Haze Removal Using Dark Channel Prior,” in Proc. IEEE CVPR, 2009. doi
- B. Cai, X. Xu, K. Jia, C. Qing and D. Tao, “DehazeNet: An End-to-End System for Single Image Haze Removal,” IEEE Transactions on Image Processing, 2016. arXiv
- B. Li, X. Peng, Z. Wang, J. Xu and D. Feng, “AOD-Net: All-in-One Dehazing Network,” in Proc. IEEE ICCV, 2017. doi · arXiv
- X. Liu, Y. Ma, Z. Shi and J. Chen, “GridDehazeNet: Attention-Based Multi-Scale Network for Image Dehazing,” in Proc. IEEE/CVF ICCV, 2019. arXiv
- X. Qin, Z. Wang, Y. Bai, X. Xie and H. Jia, “FFA-Net: Feature Fusion Attention Network for Single Image Dehazing,” in Proc. AAAI, 2020. arXiv
- S. W. Zamir, A. Arora, S. Khan, M. Hayat, F. S. Khan, M.-H. Yang and L. Shao, “Learning Enriched Features for Real Image Restoration and Enhancement,” in Proc. ECCV, 2020. arXiv
- Y. Song, Z. He, H. Qian and X. Du, “Vision Transformers for Single Image Dehazing,” IEEE Transactions on Image Processing, vol. 32, 2023. arXiv
- B. Li, W. Ren, D. Fu, D. Tao, D. Feng, W. Zeng and Z. Wang, “Benchmarking Single-Image Dehazing and Beyond,” IEEE Transactions on Image Processing, 2019. arXiv
- C. O. Ancuti, C. Ancuti, R. Timofte and C. De Vleeschouwer, “O-HAZE: A Dehazing Benchmark with Real Hazy and Haze-Free Outdoor Images,” in Proc. IEEE/CVF CVPR Workshops, 2018. doi
- C. O. Ancuti, C. Ancuti, M. Sbert and R. Timofte, “Dense-Haze: A Benchmark for Image Dehazing with Dense-Haze and Haze-Free Images,” in Proc. IEEE ICIP, 2019. doi
- A. Geiger, P. Lenz and R. Urtasun, “Are We Ready for Autonomous Driving? The KITTI Vision Benchmark Suite,” in Proc. IEEE CVPR, 2012. project page
- Y.-F. Liu, D.-W. Jaw, S.-C. Huang and J.-N. Hwang, “DesnowNet: Context-Aware Deep Network for Snow Removal,” IEEE Transactions on Image Processing, 2018. arXiv
- W.-T. Chen, H.-Y. Fang, J.-J. Ding, C.-C. Tsai and S.-Y. Kuo, “JSTASR: Joint Size and Transparency-Aware Snow Removal Algorithm Based on Modified Partial Convolution and Veiling Effect Removal,” in Proc. ECCV, 2020. doi
- W. Yang, R. T. Tan, J. Feng, J. Liu, Z. Guo and S. Yan, “Deep Joint Rain Detection and Removal from a Single Image,” in Proc. IEEE CVPR, 2017. arXiv
- R. Qian, R. T. Tan, W. Yang, J. Su and J. Liu, “Attentive Generative Adversarial Network for Raindrop Removal from a Single Image,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- X. Li, Y. Jin, X. Jin, Z. Wu, B. Li, Y. Wang et al., “NTIRE 2025 Challenge on Day and Night Raindrop Removal for Dual-Focused Images: Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2025. arXiv
- C. Wei, W. Wang, W. Yang and J. Liu, “Deep Retinex Decomposition for Low-Light Enhancement,” in Proc. BMVC, 2018. arXiv
- Y. Cai, H. Bian, J. Lin, H. Wang, R. Timofte and Y. Zhang, “Retinexformer: One-stage Retinex-based Transformer for Low-light Image Enhancement,” in Proc. IEEE/CVF ICCV, 2023. arXiv
- H. Zhang, H. Xu, X. Tian, J. Jiang and J. Ma, “Image Fusion Meets Deep Learning: A Survey and Perspective,” Information Fusion, vol. 76, pp. 323–336, 2021. doi
- S. Nah, T. H. Kim and K. M. Lee, “Deep Multi-scale Convolutional Neural Network for Dynamic Scene Deblurring,” in Proc. IEEE CVPR, 2017. doi · arXiv
- K. He, X. Chen, S. Xie, Y. Li, P. Dollár and R. Girshick, “Masked Autoencoders Are Scalable Vision Learners,” in Proc. IEEE/CVF CVPR, 2022. arXiv
- R. Suvorov, E. Logacheva, A. Mashikhin, A. Remizova, A. Ashukha, A. Silvestrov, N. Kong, H. Goka, K. Park and V. Lempitsky, “Resolution-robust Large Mask Inpainting with Fourier Convolutions,” in Proc. IEEE/CVF WACV, 2022. arXiv
- S. Sengupta, V. Jayaram, B. Curless, S. Seitz and I. Kemelmacher-Shlizerman, “Background Matting: The World is Your Green Screen,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” in Proc. MICCAI, 2015. arXiv
- H. Guo, J. Li, T. Dai, Z. Ouyang, X. Ren and S.-T. Xia, “MambaIR: A Simple Baseline for Image Restoration with State-Space Model,” in Proc. ECCV, 2024. arXiv
- H. Guo, Y. Guo, Y. Zha, Y. Zhang, W. Li, T. Dai, S.-T. Xia and Y. Li, “MambaIRv2: Attentive State Space Restoration,” in Proc. IEEE/CVF CVPR, 2025. arXiv
- B. Li, X. Liu, P. Hu, Z. Wu, J. Lv and X. Peng, “All-In-One Image Restoration for Unknown Corruption,” in Proc. IEEE/CVF CVPR, 2022. code & paper
- J. M. J. Valanarasu, R. Yasarla and V. M. Patel, “TransWeather: Transformer-based Restoration of Images Degraded by Adverse Weather Conditions,” in Proc. IEEE/CVF CVPR, 2022. arXiv
- V. Potlapalli, S. W. Zamir, S. Khan and F. S. Khan, “PromptIR: Prompting for All-in-One Image Restoration,” in Proc. NeurIPS, 2023. arXiv
- Y. Cui, S. W. Zamir, S. Khan, A. Knoll, M. Shah and F. S. Khan, “AdaIR: Adaptive All-in-One Image Restoration via Frequency Mining and Modulation,” in Proc. ICLR, 2025. arXiv
- Z. Luo, F. K. Gustafsson, Z. Zhao, J. Sjölund and T. B. Schön, “Controlling Vision-Language Models for Multi-Task Image Restoration,” in Proc. ICLR, 2024. arXiv
- M. V. Conde, G. Geigle and R. Timofte, “InstructIR: High-Quality Image Restoration Following Human Instructions,” in Proc. ECCV, 2024. arXiv
- H. Zhao, O. Gallo, I. Frosio and J. Kautz, “Loss Functions for Image Restoration with Neural Networks,” IEEE Transactions on Computational Imaging, 2017 (arXiv title: “Loss Functions for Neural Networks for Image Processing”). arXiv
- J. Johnson, A. Alahi and L. Fei-Fei, “Perceptual Losses for Real-Time Style Transfer and Super-Resolution,” in Proc. ECCV, 2016. doi · arXiv
- L. Jiang, B. Dai, W. Wu and C. C. Loy, “Focal Frequency Loss for Image Reconstruction and Synthesis,” in Proc. IEEE/CVF ICCV, 2021. arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image Quality Assessment: From Error Visibility to Structural Similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- A. Mittal, R. Soundararajan and A. C. Bovik, “Making a ‘Completely Blind’ Image Quality Analyzer,” IEEE Signal Processing Letters, 2013. doi
- Y. Blau, R. Mechrez, R. Timofte, T. Michaeli and L. Zelnik-Manor, “The 2018 PIRM Challenge on Perceptual Image Super-resolution,” in Proc. ECCV Workshops, 2018. arXiv
- M. Heusel, H. Ramsauer, T. Unterthiner, B. Nessler and S. Hochreiter, “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” in Proc. NeurIPS, 2017. arXiv
- Y. Blau and T. Michaeli, “The Perception-Distortion Tradeoff,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- Z. Wang, J. Chen and S. C. H. Hoi, “Deep Learning for Image Super-Resolution: A Survey,” IEEE TPAMI, 2021. arXiv
- C. Tian, L. Fei, W. Zheng, Y. Xu, W. Zuo and C.-W. Lin, “Deep Learning on Image Denoising: An Overview,” Neural Networks, vol. 131, pp. 251–275, 2020. arXiv
- M. Elad, B. Kawar and G. Vaksman, “Image Denoising: The Deep Learning Revolution and Beyond — A Survey Paper,” SIAM Journal on Imaging Sciences, vol. 16, no. 3, pp. 1594–1654, 2023. doi · arXiv
- K. Zhang, W. Ren, W. Luo, W.-S. Lai, B. Stenger, M.-H. Yang and H. Li, “Deep Image Deblurring: A Survey,” International Journal of Computer Vision, 2022. arXiv
- J. Gui, X. Cong, Y. Cao, W. Ren, J. Zhang, J. Zhang, J. Cao and D. Tao, “A Comprehensive Survey and Taxonomy on Single Image Dehazing Based on Deep Learning,” ACM Computing Surveys, 2023. doi · arXiv
- W. Yang, R. T. Tan, S. Wang, Y. Fang and J. Liu, “Single Image Deraining: From Model-Based to Data-Driven and Beyond,” IEEE TPAMI, 2021. doi · arXiv
- J. Jiang, Z. Zuo, G. Wu, K. Jiang and X. Liu, “A Survey on All-in-One Image Restoration: Taxonomy, Evaluation and Future Trends,” IEEE TPAMI, 2025. arXiv
- X. Li, Y. Ren, X. Jin, C. Lan, X. Wang, W. Zeng, X. Wang and Z. Chen, “Diffusion Models for Image Restoration and Enhancement: A Comprehensive Survey,” International Journal of Computer Vision, 2025. arXiv
- A. Levin, Y. Weiss, F. Durand and W. T. Freeman, “Understanding and Evaluating Blind Deconvolution Algorithms,” in Proc. IEEE CVPR, 2009, pp. 1964–1971. doi
- R. Fergus, B. Singh, A. Hertzmann, S. T. Roweis and W. T. Freeman, “Removing Camera Shake from a Single Photograph,” ACM Transactions on Graphics (Proc. SIGGRAPH), vol. 25, no. 3, pp. 787–794, 2006. doi
- Q. Shan, J. Jia and A. Agarwala, “High-quality Motion Deblurring from a Single Image,” ACM Transactions on Graphics (Proc. SIGGRAPH), vol. 27, no. 3, 2008. doi
- S. Cho and S. Lee, “Fast Motion Deblurring,” ACM Transactions on Graphics (Proc. SIGGRAPH Asia), vol. 28, no. 5, 2009. doi
- L. Xu and J. Jia, “Two-Phase Kernel Estimation for Robust Motion Deblurring,” in Proc. ECCV, 2010, pp. 157–170. doi
- D. Krishnan, T. Tay and R. Fergus, “Blind Deconvolution Using a Normalized Sparsity Measure,” in Proc. IEEE CVPR, 2011, pp. 233–240. doi
- J. Pan, D. Sun, H. Pfister and M.-H. Yang, “Blind Image Deblurring Using Dark Channel Prior,” in Proc. IEEE CVPR, 2016, pp. 1628–1636. doi
- J. Sun, W. Cao, Z. Xu and J. Ponce, “Learning a Convolutional Neural Network for Non-uniform Motion Blur Removal,” in Proc. IEEE CVPR, 2015. arXiv
- C. J. Schuler, M. Hirsch, S. Harmeling and B. Schölkopf, “Learning to Deblur,” IEEE TPAMI, vol. 38, no. 7, pp. 1439–1451, 2016. doi · arXiv
- A. Chakrabarti, “A Neural Approach to Blind Motion Deblurring,” in Proc. ECCV, 2016. arXiv
- D. Ulyanov, A. Vedaldi and V. Lempitsky, “Deep Image Prior,” in Proc. IEEE/CVF CVPR, 2018, pp. 9446–9454. doi · arXiv
- D. Ren, K. Zhang, Q. Wang, Q. Hu and W. Zuo, “Neural Blind Deconvolution Using Deep Priors,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- O. Kupyn, V. Budzan, M. Mykhailych, D. Mishkin and J. Matas, “DeblurGAN: Blind Motion Deblurring Using Conditional Adversarial Networks,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- K. Zhang, W. Zuo and L. Zhang, “Learning a Single Convolutional Super-Resolution Network for Multiple Degradations,” in Proc. IEEE/CVF CVPR, 2018. arXiv
- J. Gu, H. Lu, W. Zuo and C. Dong, “Blind Super-Resolution With Iterative Kernel Correction,” in Proc. IEEE/CVF CVPR, 2019. arXiv
- S. Bell-Kligler, A. Shocher and M. Irani, “Blind Super-Resolution Kernel Estimation using an Internal-GAN,” in Proc. NeurIPS, 2019. link · arXiv
- Z. Luo, Y. Huang, S. Li, L. Wang and T. Tan, “Unfolding the Alternating Optimization for Blind Super Resolution,” in Proc. NeurIPS, 2020. arXiv
- K. Zhang, L. Van Gool and R. Timofte, “Deep Unfolding Network for Image Super-Resolution,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- K. Zhang, J. Liang, L. Van Gool and R. Timofte, “Designing a Practical Degradation Model for Deep Blind Image Super-Resolution,” in Proc. IEEE/CVF ICCV, 2021. arXiv
- A. Liu, Y. Liu, J. Gu, Y. Qiao and C. Dong, “Blind Image Super-Resolution: A Survey and Beyond,” IEEE TPAMI, 2022 (early access). doi · arXiv
- A. Mittal, A. K. Moorthy and A. C. Bovik, “No-Reference Image Quality Assessment in the Spatial Domain,” IEEE Transactions on Image Processing, vol. 21, no. 12, pp. 4695–4708, 2012. doi
- C. Ma, C.-Y. Yang, X. Yang and M.-H. Yang, “Learning a No-Reference Quality Metric for Single-Image Super-Resolution,” Computer Vision and Image Understanding, vol. 158, pp. 1–16, 2017. doi · arXiv
- N. Venkatanath, D. Praneeth, M. C. Bh, S. S. Channappayya and S. S. Medasani, “Blind Image Quality Evaluation Using Perception Based Features,” in Proc. Twenty First National Conference on Communications (NCC), 2015, pp. 1–6. doi · MATLAB documentation
- H. Talebi and P. Milanfar, “NIMA: Neural Image Assessment,” IEEE Transactions on Image Processing, vol. 27, no. 8, pp. 3998–4011, 2018. doi · arXiv
- S. Su, Q. Yan, Y. Zhu, C. Zhang, X. Ge, J. Sun and Y. Zhang, “Blindly Assess Image Quality in the Wild Guided by a Self-Adaptive Hyper Network,” in Proc. IEEE/CVF CVPR, 2020, pp. 3664–3673. doi
- J. Ke, Q. Wang, Y. Wang, P. Milanfar and F. Yang, “MUSIQ: Multi-scale Image Quality Transformer,” in Proc. IEEE/CVF ICCV, 2021, pp. 5128–5137. doi · arXiv
- S. Yang, T. Wu, S. Shi, S. Lao, Y. Gong, M. Cao, J. Wang and Y. Yang, “MANIQA: Multi-dimension Attention Network for No-Reference Image Quality Assessment,” in Proc. IEEE/CVF CVPR Workshops, 2022, pp. 1190–1199. doi · arXiv
- C. Chen, J. Mo, J. Hou, H. Wu, L. Liao, W. Sun, Q. Yan and W. Lin, “TOPIQ: A Top-Down Approach From Semantics to Distortions for Image Quality Assessment,” IEEE Transactions on Image Processing, vol. 33, pp. 2404–2418, 2024. doi · arXiv
- J. Wang, K. C. K. Chan and C. C. Loy, “Exploring CLIP for Assessing the Look and Feel of Images,” in Proc. AAAI Conference on Artificial Intelligence, 2023. arXiv
- H. Wu, Z. Zhang, W. Zhang, C. Chen, L. Liao, C. Li, Y. Gao, A. Wang, E. Zhang, W. Sun, Q. Yan, X. Min, G. Zhai and W. Lin, “Q-Align: Teaching LMMs for Visual Scoring via Discrete Text-Defined Levels,” in Proc. ICML, PMLR 235, pp. 54015–54029, 2024. link · arXiv
- H. R. Sheikh, M. F. Sabir and A. C. Bovik, “A Statistical Evaluation of Recent Full Reference Image Quality Assessment Algorithms,” IEEE Transactions on Image Processing, vol. 15, no. 11, pp. 3440–3451, 2006 (LIVE Image Quality Assessment Database). doi · database
- N. Ponomarenko, L. Jin, O. Ieremeiev, V. Lukin, K. Egiazarian, J. Astola, B. Vozel, K. Chehdi, M. Carli, F. Battisti and C.-C. J. Kuo, “Image Database TID2013: Peculiarities, Results and Perspectives,” Signal Processing: Image Communication, vol. 30, pp. 57–77, 2015. doi · database
- H. Lin, V. Hosu and D. Saupe, “KADID-10k: A Large-scale Artificially Distorted IQA Database,” in Proc. Eleventh International Conference on Quality of Multimedia Experience (QoMEX), 2019. doi · database
- V. Hosu, H. Lin, T. Sziranyi and D. Saupe, “KonIQ-10k: An Ecologically Valid Database for Deep Learning of Blind Image Quality Assessment,” IEEE Transactions on Image Processing, vol. 29, pp. 4041–4056, 2020. arXiv
- Y. Fang, H. Zhu, Y. Zeng, K. Ma and Z. Wang, “Perceptual Quality Assessment of Smartphone Photography,” in Proc. IEEE/CVF CVPR, 2020, pp. 3674–3683. doi
- J. Gu, H. Cai, H. Chen, X. Ye, J. Ren and C. Dong, “PIPAL: A Large-Scale Image Quality Assessment Dataset for Perceptual Image Restoration,” in Proc. ECCV, 2020. arXiv
- C. Chen and J. Mo, “IQA-PyTorch: PyTorch Toolbox for Image Quality Assessment,” software (pip package
pyiqa), 2022. GitHub - ITU-R, “Recommendation BT.500-15: Methodologies for the Subjective Assessment of the Quality of Television Images,” 2023. ITU
- R. A. Bradley and M. E. Terry, “Rank Analysis of Incomplete Block Designs: The Method of Paired Comparisons,” Biometrika, vol. 39, no. 3–4, pp. 324–345, 1952. doi
- D. Geman and C. Yang, “Nonlinear Image Recovery with Half-Quadratic Regularization,” IEEE Transactions on Image Processing, vol. 4, no. 7, pp. 932–946, 1995. doi
- S. V. Venkatakrishnan, C. A. Bouman and B. Wohlberg, “Plug-and-Play Priors for Model Based Reconstruction,” in Proc. IEEE Global Conference on Signal and Information Processing (GlobalSIP), 2013, pp. 945–948. doi
- K. Zhang, W. Zuo, S. Gu and L. Zhang, “Learning Deep CNN Denoiser Prior for Image Restoration,” in Proc. IEEE/CVF CVPR, 2017, pp. 2808–2817. doi · arXiv
- A. Chambolle, “An Algorithm for Total Variation Minimization and Applications,” Journal of Mathematical Imaging and Vision, vol. 20, no. 1–2, pp. 89–97, 2004. doi
- A. Buades, B. Coll and J.-M. Morel, “A Non-Local Algorithm for Image Denoising,” in Proc. IEEE CVPR, vol. 2, 2005, pp. 60–65. doi
- D. Ulyanov, A. Vedaldi and V. Lempitsky, “Deep Image Prior,” International Journal of Computer Vision, vol. 128, no. 7, pp. 1867–1888, 2020. doi · arXiv
- Y. Jiang, Z. Zhang, T. Xue and J. Gu, “AutoDIR: Automatic All-in-One Image Restoration with Latent Diffusion,” in Proc. ECCV, 2024. paper
- K. Zhu, J. Gu, Z. You, Y. Qiao and C. Dong, “An Intelligent Agentic System for Complex Image Restoration Problems,” in Proc. ICLR, 2025. paper
- Y. Zuo, Q. Zheng, M. Wu, X. Jiang, R. Li, J. Wang, Y. Zhang, G. Mai, L. V. Wang, J. Zou, X. Wang, M.-H. Yang and Z. Tu, “4KAgent: Agentic Any Image to 4K Super-Resolution,” in Proc. NeurIPS, 2025. paper
- Y. Yu, Z. Zeng, H. Hua, J. Fu and J. Luo, “PromptFix: You Prompt and We Fix the Photo,” in Proc. NeurIPS, 2024. paper
檢查理解
本篇有 8 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 09A・非盲影像超解析度 · 24 分鐘