DLCV 01A・深度視覺模型的訓練實務
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 建立先排除低成本錯誤、再進行大型訓練的流程。
- 防止資料洩漏,讓影像增強與標籤保持一致。
- 選擇學習率、排程、批次大小與梯度累積設定。
- 使用正則化、混合精度與預訓練模型微調。
- 除錯損失與梯度,再以固定預算及多個隨機種子比較模型。
先看全貌
你已經知道影像用的卷積網路與 Transformer 網路怎麼建構(DLCV 01)。本篇談的是工作的另一半:讓網路訓練得好、訓練得快,並且知道結果是不是真的。
為什麼要用一整篇談這個?因為訓練配方的影響常常和架構一樣大。He 等人把學習率熱身、餘弦衰減等訓練改良,加上網路的一些小改動,把 ResNet-50 的 ImageNet top-1 準確率從 75.3% 提高到 79.29% [1];DLCV 02 介紹了類似的結果。而且訓練的失敗常常是無聲的:資料管線有錯的網路通常還是能訓練,只是比較差,所以不會有任何崩潰來提醒你 [2]。本篇的習慣,就是實務工作者及早抓出這些錯誤的方法。
多數工具背後的理論,本站別處已經講過,本篇直接連過去而不重複:
| 主題 | 詳細內容在 |
|---|---|
| 浮點數、梯度檢查、NaN 值的除錯順序 | ML 01C |
| SGD、動量、Adam、AdamW、初始化、正規化層、梯度裁剪、基本排程 | ML 02 |
| 基準、資料切分與洩漏、顯著性檢定、可重現性、延遲與部署 | ML 11 |
| 批次正規化如何運作;知識蒸餾 | DLCV 01 補充資料 |
| 分類配方:資料擴增、損失與最佳化器的選擇、遷移學習、校準 | DLCV 02 |
本篇補上的是工作流程:做事的順序、能抓出錯誤的快速測試,以及對多數視覺模型都管用的預設值。
訓練檢查清單
白話版。 大型訓練前,先確認小模型能擬合一個批次,一次只改一項因素。
下面這份清單就是整篇的濃縮。每一項都連到解釋它的小節。
- 先定好評估方式。 在訓練任何東西之前,先定義切分單位、指標與一個簡單的基準(資料管線;ML 11)。
- 看資料。 在完整的輸入管線(解碼、縮放、資料擴增、正規化)之後畫出一個批次,並把標註疊在上面。一分鐘內就能抓出大部分管線錯誤。
- 從已知可靠的預設值開始。 標準架構、He 初始化、有的話就用預訓練骨幹、AdamW 或帶動量的 SGD(初始化)。
- 過擬合一個批次。 在單一固定批次上,訓練損失必須降到幾乎為零(除錯)。
- 找出學習率:先做一次簡短的範圍測試,再選一個有熱身與衰減的排程(學習率)。
- 設定批次大小:依記憶體決定,學習率隨之調整(批次大小)。
- 訓練完整模型,什麼都記錄(損失、指標、學習率、梯度範數),並依驗證分數保留最佳檢查點。
- 看到過擬合才加正則化,一次一種工具(正則化)。
- 等實驗正確後再加速:用混合精度(混合精度)。
- 公平比較:同樣的預算、同樣的資料、多個隨機種子,每個消融實驗只改一件事;測試集最後只開一次(公平的實驗)。
執行範例
為了用真實數字示範每一步,這些程式碼訓練一個用 NumPy 寫的小型多層感知器(MLP):64 個輸入、一個含 32 個 ReLU 單元的隱藏層、10 個輸出,以 SGD 加動量訓練,資料是 scikit-learn 的 手寫數字 [3]。它不是深度視覺模型,但本篇的每個訓練決策都適用於它,而且每次執行在 CPU 上都不到一秒。下文所有稱為「我們的小玩具實驗」的數字都來自這份程式碼;圖表腳本 scripts/figures/dl_01a_training_practice.py 可以重現它們。
下面的程式碼把它定義一次:分層切分的資料載入、用訓練切分的統計量做正規化、帶 He 初始化的兩層網路、反向傳播,以及能接受任何學習率排程的訓練迴圈。迴圈同時保存權重的指數移動平均,EMA 一節會用到。後面的程式碼會重複使用這些函式,所以請先執行這一段。
程式碼 · Python · 65 行
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

X, y = load_digits(return_X_y=True)                     # 1,797 images of 8x8 pixels, 10 classes
X_tmp, X_te, y_tmp, y_te = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0)
X_tr, X_va, y_tr, y_va = train_test_split(X_tmp, y_tmp, test_size=0.25, stratify=y_tmp, random_state=0)
mu, sd = X_tr.mean(0), X_tr.std(0) + 1e-8               # statistics of the TRAINING split only
X_tr, X_va, X_te = [(a - mu) / sd for a in (X_tr, X_va, X_te)]

def init(seed, sizes=(64, 32, 10)):                     # He initialization for ReLU layers
    rng = np.random.default_rng(seed)
    return [[rng.normal(0, np.sqrt(2 / m), (m, n)), np.zeros(n)]
            for m, n in zip(sizes[:-1], sizes[1:])]

def forward(P, X):
    h = [X]
    for i, (W, b) in enumerate(P):
        z = h[-1] @ W + b
        h.append(np.maximum(z, 0) if i < len(P) - 1 else z)   # ReLU; the last layer gives logits
    return h

def loss_and_grads(P, X, y):
    h = forward(P, X)
    z = h[-1] - h[-1].max(1, keepdims=True)             # stable log-softmax
    logp = z - np.log(np.exp(z).sum(1, keepdims=True))
    loss = -logp[np.arange(len(y)), y].mean()           # cross-entropy
    d = np.exp(logp)                                    # softmax probabilities
    d[np.arange(len(y)), y] -= 1
    d /= len(y)                                         # dLoss/dlogits
    grads = []
    for i in reversed(range(len(P))):
        grads.insert(0, [h[i].T @ d, d.sum(0)])
        if i:
            d = (d @ P[i][0].T) * (h[i] > 0)            # back through the ReLU
    return loss, grads

def evaluate(P, X, y):
    z = forward(P, X)[-1]
    z = z - z.max(1, keepdims=True)
    logp = z - np.log(np.exp(z).sum(1, keepdims=True))
    return -logp[np.arange(len(y)), y].mean(), (z.argmax(1) == y).mean()

def train(schedule, peak, epochs=15, bs=16, momentum=0.9, seed=0, ema_decay=0.99):
    P = init(seed)
    V = [[np.zeros_like(W), np.zeros_like(b)] for W, b in P]   # momentum buffers
    E = [[W.copy(), b.copy()] for W, b in P]                    # EMA copy of the weights
    rng = np.random.default_rng(seed + 1000)            # data order depends on the seed too
    T, t, log = epochs * int(np.ceil(len(y_tr) / bs)), 0, []
    for _ in range(epochs):
        order = rng.permutation(len(y_tr))
        for i in range(0, len(y_tr), bs):
            idx = order[i:i + bs]
            _, G = loss_and_grads(P, X_tr[idx], y_tr[idx])
            lr = schedule(t, T, peak)
            t += 1
            for (W, b), (gW, gb), v, e in zip(P, G, V, E):   # SGD with momentum, in place
                v[0] = momentum * v[0] + gW
                v[1] = momentum * v[1] + gb
                W -= lr * v[0]
                b -= lr * v[1]
                e[0] += (1 - ema_decay) * (W - e[0])    # e <- decay * e + (1 - decay) * w
                e[1] += (1 - ema_decay) * (b - e[1])
        log.append(evaluate(P, X_tr, y_tr) + evaluate(P, X_va, y_va))
    return P, np.array(log), E   # log columns: train loss, train acc, val loss, val acc
切分結果是 942 張訓練影像、315 張驗證影像與 540 張測試影像;本篇不會動到測試影像。
資料管線
白話版。 檢查完整資料管線產生的張量;其數值與標籤決定學習內容及評估是否有效。
資料切分、資料洩漏與測試集
測試集必須「新」得和部署時的資料一樣。要依「將會是新的」那個單位來切分(病人、影片、相機、地點或時間區段),切分前先去除重複,所有前處理步驟都只用訓練切分來擬合,所有決策都用驗證集做,這樣測試集只會被打開一次。ML 11 講了洩漏的各種形式與如何衡量不確定性;本篇假設你已遵守這些規則。
正規化統計量
當每個輸入通道的平均值接近零、分散程度接近一時,網路訓練得最好。標準步驟是
其中 是通道 (例如紅、綠或藍)的像素值, 與 是通道 的平均值與標準差, 是網路看到的值。由此得到兩條實務規則。
- 從頭訓練:只用訓練切分計算 與 ,把它們和模型一起存起來,在驗證、測試與部署時套用同樣的存下來的值。執行範例正是這樣做的,只是以每個像素而不是每個通道來算。
- 微調預訓練模型:使用模型預訓練時的統計量,而不是你新資料集的。第一層的濾波器是為那個尺度的輸入學出來的。
這裡最常見的錯誤是不一致:訓練時影像縮放到 ,部署時卻是原始的 – 值,或是一處用 RGB、另一處用 BGR。兩者都還是會產生預測,只是很差。
類別不平衡
白話版。 類別不平衡可能讓整體高準確率掩蓋稀有類別失敗;可調整取樣、損失權重或分類器初始化。
Buda 等人在難度逐步提高的基準上比較了卷積網路的各種補救方法 [4]。在他們的實驗中,過取樣(oversampling)稀有類別在幾乎所有情境下都是最主要的方法,完全消除不平衡時效果最好,而且與某些傳統模型不同,它並未使網路過擬合;他們也建議,當整體準確率是關注重點時,用門檻調整來補償類別先驗 [4]。這三種手段如下:
程式碼 · Python · 17 行
import numpy as np

counts = np.array([900, 80, 20])                        # training images per class
labels = np.repeat([0, 1, 2], counts)

w = counts.sum() / (len(counts) * counts)               # option 1: weight the loss
print("loss weight per class:", np.round(w, 2))

p = 1.0 / counts[labels]                                # option 2: oversample rare classes
p /= p.sum()
rng = np.random.default_rng(0)
drawn = labels[rng.choice(len(labels), size=3000, p=p)]
print("class share in 3,000 sampled examples:", np.round(np.bincount(drawn) / 3000, 3))

prior = counts / counts.sum()                           # option 3: start the output bias at the prior
b0 = np.log(prior)
print("initial softmax output:", np.round(np.exp(b0) / np.exp(b0).sum(), 3))
輸出
loss weight per class: [ 0.37  4.17 16.67]
class share in 3,000 sampled examples: [0.33  0.338 0.332]
initial softmax output: [0.9  0.08 0.02]
選項 1 把每個範例的損失乘上 ,其中 是訓練範例數, 是類別數, 是類別 的數量。選項 2 以正比於 的機率抽取每個範例,讓每個類別出現的次數相同。選項 3 把輸出偏置設為 ,讓尚未訓練的網路就已經預測出類別頻率;Lin 等人在密集偵測中用了同樣的想法,讓每個位置一開始的前景機率約為 0.01 [5](見 DLCV 03 的焦點損失)。不論選哪一種,都要回報每個類別的指標(DLCV 02)。
資料擴增作為正則化
白話版。 資料擴增讓網路每次看到每張影像稍微不同的版本,所以它無法死記像素,必須學會哪些東西不會變。黃金法則:只有在新影像的正確標籤已知時,才允許做這個轉換。
這條規則決定了每個任務該用什麼擴增:
| 任務 | 通常安全 | 需要小心或不對 |
|---|---|---|
| 照片分類 | 隨機裁切與縮放、水平翻轉、色彩抖動、輕微模糊 | 直立場景的垂直翻轉;文字、數字與對左右敏感的類別做翻轉 |
| 偵測 | 翻轉、裁切、縮放、色彩抖動,對影像與邊界框一起做 | 切到物體的裁切:把框裁剪,剩下太少就丟掉 |
| 分割 | 對影像與遮罩做相同的幾何轉換 | 對遮罩做內插:標籤要用最近鄰縮放,絕不用雙線性 |
| 關鍵點與姿態 | 對影像與點做幾何轉換 | 水平翻轉也必須對調左右關鍵點的標籤(DLCV 05) |
| 影像復原與低階視覺 | 翻轉、90° 旋轉、對輸入與目標做相同的裁切 | 會改變目標本身的色彩或模糊擴增 |
| 醫學與遙測 | 方向沒有意義時的旋轉 | 會改變診斷數值的強度變化 |
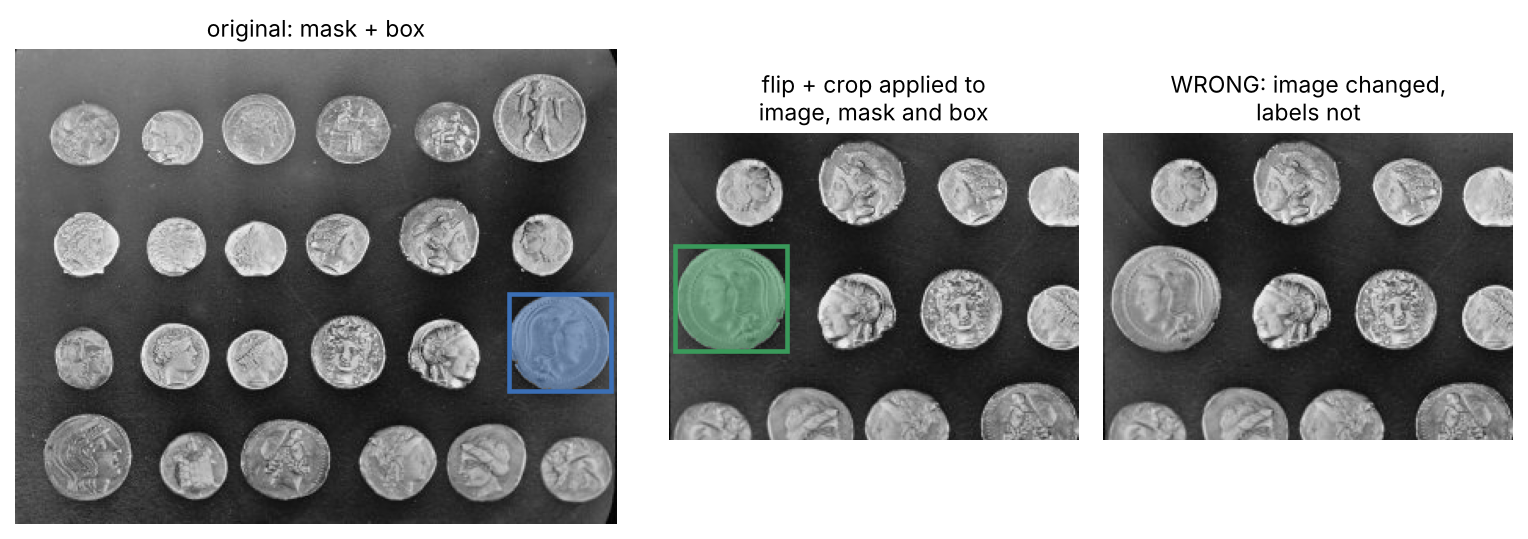
對於密集任務,關鍵字是一致性:套用在像素上的每個幾何變動,都必須以相同的座標套用在標籤上。下面的程式碼把一張硬幣照片連同分割遮罩與其中一枚硬幣的邊界框一起翻轉和裁切,然後檢查轉換後的框是否等於轉換後遮罩的框:
程式碼 · Python · 26 行
import numpy as np
from scipy import ndimage
from skimage import data, filters, measure, segmentation

img = data.coins()                                      # 303 x 384 grayscale photo
fg = segmentation.clear_border(img > filters.threshold_otsu(img))
lab = measure.label(ndimage.binary_fill_holes(fg))
coin = max(measure.regionprops(lab), key=lambda r: r.area)
mask = lab == coin.label                                # segmentation target for one coin
box = tuple(int(v) for v in coin.bbox)                  # detection target (y0, x0, y1, x1)
H, W = img.shape

def hflip(img, mask, box):
    y0, x0, y1, x1 = box
    return img[:, ::-1], mask[:, ::-1], (y0, W - x1, y1, W - x0)

def crop(img, mask, box, top, left, h, w):
    y0, x0, y1, x1 = box                                # shift, then clip to the crop
    new = (max(y0 - top, 0), max(x0 - left, 0), min(y1 - top, h), min(x1 - left, w))
    return img[top:top + h, left:left + w], mask[top:top + h, left:left + w], new

i2, m2, b2 = crop(*hflip(img, mask, box), top=90, left=0, h=180, w=240)
r, c = np.nonzero(m2)
print("original box:               ", box)
print("box after flip + crop:      ", b2)
print("box of the transformed mask:", (int(r.min()), int(c.min()), int(r.max()) + 1, int(c.max()) + 1))
輸出
original box:                (156, 315, 218, 380)
box after flip + crop:       (66, 4, 128, 69)
box of the transformed mask: (66, 4, 128, 69)
對寬度為 的影像做水平翻轉時,欄位從 到 的框會移到欄位 到 :左右邊界互換角色。只翻轉影像而不翻轉標籤,會給網路互相矛盾的目標(圖 1,右)。Karpathy 把這類錯誤,也就是翻轉影像卻沒翻轉標籤,列為會讓網路無聲地訓練得更差、而不是直接失敗的錯誤之一 [2]。實務上,請使用能讓影像連同遮罩與框一起轉換的函式庫,例如 Albumentations [6],並且仍然用上面這樣的檢查驗證一次。
要多強?擴增強度是一個超參數:用驗證集調整它,並預期強擴增的模型其訓練損失會高於驗證損失。Shorten 與 Khoshgoftaar 整理了影像擴增的各個家族 [7];DLCV 02 展示了現代分類配方中的混合式擴增。
實務上的初始化與正規化
白話版。 好的開始會讓訊號在每一層都保持合理的大小,使訓練的最初幾步用來學習,而不是從錯誤的尺度中恢復。對標準架構來說,下面的預設值都經過充分驗證;除非有理由,否則就用它們。
- 權重。ReLU 類的激活函數之前的層用 He 初始化:以變異數 抽取權重,其中 是一個單元的輸入數,這能讓各層的激活變異數大致維持不變 [8]。偏置從零開始。ML 02 推導了這一點。
- 殘差區塊。把每個殘差分支中最後一個批次正規化層的尺度 初始化為零。這樣每個區塊一開始就是恆等映射,訊號沿著捷徑傳遞,早期訓練更容易;Goyal 等人發現這對他們所有的模型都有幫助,對大批次訓練尤其如此 [9],He 等人也把它列入他們的技巧集 [1]。
- 輸出層。類別不平衡時,把分類器偏置初始化為類別先驗的對數(上面的選項 3)。
- 預訓練權重。如果有適合你輸入類型的預訓練骨幹,就從它開始。只有新的分類頭是從頭初始化的。
實務上的正規化層。批次正規化(batch normalization, BN)[10] 用當前小批次的平均值與變異數把每個通道標準化,再保存移動平均供推論使用(DLCV 01 補充資料)。兩個習慣可避免多數 BN 問題:
- 切換模式。訓練模式使用批次統計量並更新移動平均;評估模式使用存下來的平均。測試時忘記切換到評估模式,是個經典錯誤。
- 注意每個裝置上的批次大小。BN 的統計量是在單一裝置上的範例中計算的。如果每個裝置只有一兩張影像(偵測與分割中很常見),統計量就會變得雜訊很大。群組正規化(Group Normalization)在每個範例內對成組的通道做正規化,不依賴批次大小,在 BN 退化的地方仍能維持準確;Wu 與 He 也描述了偵測中常見的做法:凍結預訓練骨幹的 BN,把它存下的統計量當作固定的線性層 [11]。
Transformer 使用在每個範例內部計算的正規化,不依賴批次;ML 02 比較了各種正規化層。
選擇學習率
白話版。學習率是每一步往下坡走的大小。太小,訓練就像在爬;太大,損失就會亂跳或爆掉。最好的學習率在訓練過程中也會變:早期大步有幫助,最後小步有幫助。
Bengio 寫道,學習率通常是單一最重要的超參數 [12]。這裡的做法是:先量一次可用的範圍,再讓排程在這個範圍中移動。
學習率範圍測試
白話版。執行一次訓練,每一步都把學習率稍微調高一點,同時觀察損失。損失不再下降、開始上升的地方,就是學習率變得太大了。
Smith 提出這個學習率範圍測試,同時提出週期性學習率:短時間訓練,同時讓學習率在低值與高值之間增加,並讀出網路仍然能學習的範圍 [13]。在他後來的指引中,損失最低(或準確率最高)處的學習率是可用的最大值,適合作為先升後降的排程的最大值,而固定的學習率則必須更小,否則網路根本不會開始收斂;對於單一週期的排程,他建議最小值比最大值低 10 到 20 倍 [14]。
Smith 從驗證損失或準確率讀曲線;我們的版本改用每個批次的訓練損失,不需任何額外成本。它在最多 200 步內讓學習率從 指數增加到 ,使每個數量級獲得相同的時間,並用指數移動平均平滑有雜訊的批次損失:
其中 是第 步那個批次的損失, 是移動平均(從 開始), 是平滑係數, 是畫在圖上的偏差校正平均;這個校正去除了朝零起始值被拉低的影響。當平滑後的損失超過其最小值的四倍時,測試就停止。下面的程式碼重複使用執行範例中的 init 與 loss_and_grads。
程式碼 · Python · 26 行
def lr_range_test(lo=1e-4, hi=10.0, steps=200, bs=16, momentum=0.9, seed=0):
    P = init(seed)
    V = [[np.zeros_like(W), np.zeros_like(b)] for W, b in P]
    rng = np.random.default_rng(seed)
    lrs, smooth, avg = [], [], 0.0
    for t in range(steps):
        lr = lo * (hi / lo) ** (t / (steps - 1))        # exponential sweep
        idx = rng.choice(len(y_tr), bs, replace=False)
        loss, G = loss_and_grads(P, X_tr[idx], y_tr[idx])
        avg = 0.9 * avg + 0.1 * loss                    # smooth the noisy batch loss
        lrs.append(lr)
        smooth.append(avg / (1 - 0.9 ** (t + 1)))       # bias-corrected average
        if not np.isfinite(loss) or smooth[-1] > 4 * min(smooth):
            break                                       # the loss has blown up: stop
        for (W, b), (gW, gb), v in zip(P, G, V):
            v[0] = momentum * v[0] + gW
            v[1] = momentum * v[1] + gb
            W -= lr * v[0]
            b -= lr * v[1]
    return np.array(lrs), np.array(smooth)

lrs, smooth = lr_range_test()
best = lrs[smooth.argmin()]
print(f"lowest smoothed loss {smooth.min():.3f} at lr {best:.3f}; stopped at lr {lrs[-1]:.3f}")
print(f"suggested peak for a one-cycle or warmup schedule: about {best:.2f}")
print(f"suggested constant learning rate: about {best / 10:.3f}")
輸出
lowest smoothed loss 0.270 at lr 0.138; stopped at lr 0.392
suggested peak for a one-cycle or warmup schedule: about 0.14
suggested constant learning rate: about 0.014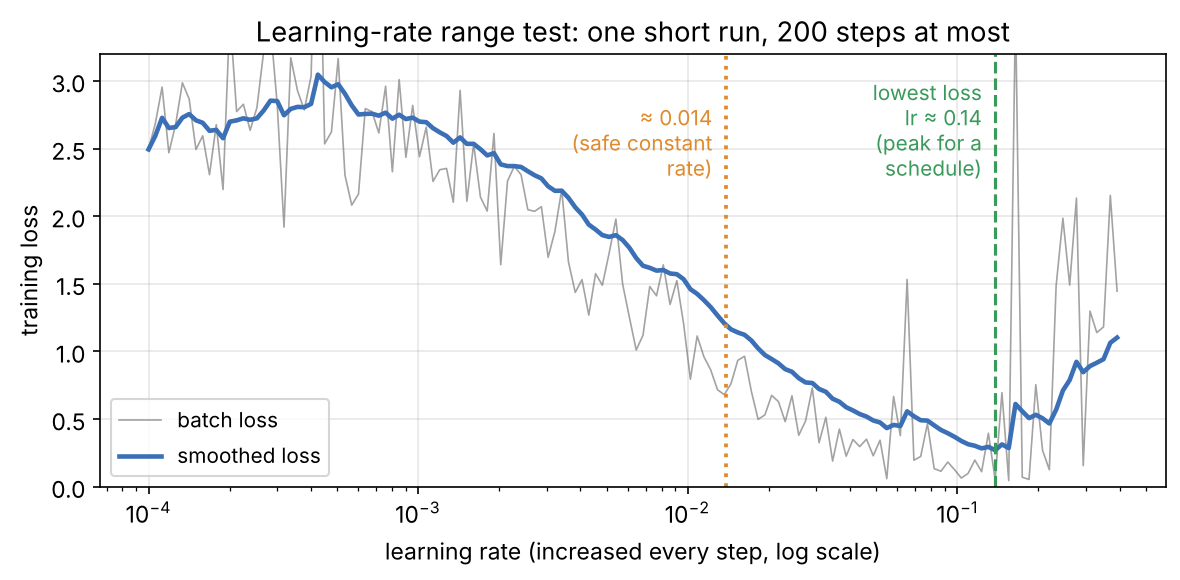
由左到右讀圖 2:先是小到什麼都改變不了,然後是損失陡降的有用範圍,最後是太大的步伐。程式碼取最小值的十分之一作為固定學習率;這個係數是我們的經驗法則,不是 [14] 中的數值。一次範圍測試只需要幾百步,所以每當你更改模型、批次大小、最佳化器或權重衰減時,都應該重跑。把結果當成一個範圍,而不是精確的值:曲線有雜訊,也會隨隨機種子而變。
熱身(warmup)
白話版。一開始用很小的學習率,在最初的幾百或幾千步內把它升到目標值。一開始權重是隨機的,最佳化器的移動統計量也是空的,所以全尺寸的一步可能把模型丟進一個再也出不來的糟糕區域。
使用 步的線性熱身時,第 步的學習率是
其中 是熱身結束時達到的目標學習率。Goyal 等人說明了為什麼形狀很重要:在大批次的 ImageNet 訓練中,前幾個 epoch 用固定的低學習率、然後跳到目標值,會讓訓練誤差出現尖峰,而逐漸升高則避免了這個尖峰 [9]。熱身對大批次、大學習率、自適應最佳化器與 Transformer 最重要,在微調中也是便宜的保險。Goyal 等人報告,即使是固定低學習率的熱身,在原型設計偵測與分割模型(把預訓練層與新層一起微調)時也特別有幫助 [9]。我們的小玩具在前 5% 的步數內熱身。
排程:階梯式、餘弦與 one-cycle
白話版。熱身之後,學習率應該下降。怎麼降其實不如「有降」重要:大步用來探索,最後的小步讓模型穩定在一個好的區域。
ML 02 介紹了階梯式衰減、餘弦退火與熱身;本節補上 one-cycle,並在同一個問題上比較全部。以 表示當前步數, 表示總步數, 表示最大學習率。圖 3 中的四種排程是:
- 固定:。簡單,但最後幾步和最初幾步一樣大。
- 階梯式衰減:在固定的里程碑處(例如訓練進度的 50% 與 75%)把學習率乘上係數 (通常是 0.1)。這是用 SGD 訓練 CNN 的經典選擇。
- 熱身 + 餘弦:經過 步熱身後,,其中進度 從 0 走到 1,所以學習率從 平滑滑到零。餘弦形狀來自 SGDR,它還會週期性地重啟 [15];He 等人在 ImageNet 分類中採用單純的餘弦衰減,準確率比他們的階梯式衰減基準更好 [1]。
- One-cycle:一次長的上升,從低學習率升到 ,然後降到遠低於起始學習率的值。Smith 與 Topin 用這種「1cycle」策略搭配很大的最大學習率,把某些網路訓練得比標準排程快得多,他們稱之為超收斂(super-convergence)[16]。我們的版本遵循 PyTorch
OneCycleLR的預設值:前 30% 的步數從 開始做餘弦形狀的上升,然後做餘弦形狀的下降,降到比起點低 倍 [17]。該實作還會在學習率上升時降低動量,這是 Smith 的建議 [14];我們的小玩具則讓動量保持不變。
程式碼 · Python · 26 行
import numpy as np

def constant(t, T, peak):
    return peak

def step_decay(t, T, peak, milestones=(0.5, 0.75), factor=0.1):
    return peak * factor ** sum(t >= m * T for m in milestones)

def warmup_cosine(t, T, peak, warmup=0.05):
    W = max(1, int(warmup * T))
    if t < W:
        return peak * (t + 1) / W                       # linear warmup
    q = (t - W) / max(1, T - W)                         # progress after warmup, 0 -> 1
    return 0.5 * peak * (1 + np.cos(np.pi * q))         # cosine decay to 0

def one_cycle(t, T, peak, pct=0.3, div=25, final_div=1e4):
    up, lo = max(1, int(pct * T)), peak / div
    if t < up:                                          # rise from peak/div to peak
        return lo + (peak - lo) * 0.5 * (1 - np.cos(np.pi * t / up))
    q = (t - up) / max(1, T - up)                       # fall far below the start
    end = lo / final_div
    return end + (peak - end) * 0.5 * (1 + np.cos(np.pi * q))

T = 900
for f in (constant, step_decay, warmup_cosine, one_cycle):
    print(f"{f.__name__:13s}", [f"{f(t, T, 0.1):.2g}" for t in (0, 20, 270, 450, 700, 899)])
輸出
constant      ['0.1', '0.1', '0.1', '0.1', '0.1', '0.1']
step_decay    ['0.1', '0.1', '0.1', '0.01', '0.001', '0.001']
warmup_cosine ['0.0022', '0.047', '0.084', '0.054', '0.013', '3.4e-07']
one_cycle     ['0.004', '0.0053', '0.1', '0.081', '0.023', '1e-06']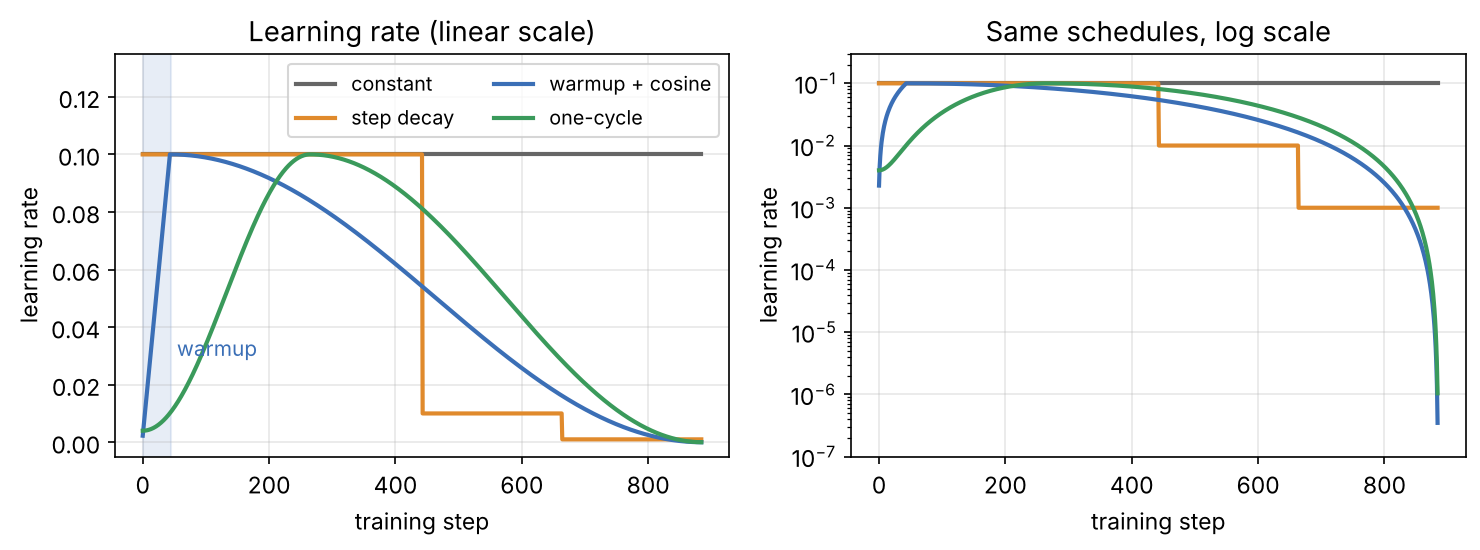
選讀:帶重啟的餘弦退火(見「補充資料」頁)。含重啟週期的 SGDR 公式,以及重啟何時有用。
排程在小玩具上的表現
下面的迴圈用每一種排程(峰值 0.1)各訓練執行範例一次,再用固定學習率 0.01 訓練一次。它使用執行範例中的 train 與上面剛定義的排程函式。
程式碼 · Python · 5 行
for f in (constant, step_decay, warmup_cosine, one_cycle):
    _, log, _ = train(f, peak=0.1)
    print(f"{f.__name__:13s} peak 0.1   final train loss {log[-1, 0]:8.3f}   val acc {log[-1, 3]:.3f}")
_, log, _ = train(constant, peak=0.01)
print(f"{'constant':13s} peak 0.01  final train loss {log[-1, 0]:8.3f}   val acc {log[-1, 3]:.3f}")
輸出
constant      peak 0.1   final train loss  995.468   val acc 0.917
step_decay    peak 0.1   final train loss    0.000   val acc 0.940
warmup_cosine peak 0.1   final train loss    0.000   val acc 0.971
one_cycle     peak 0.1   final train loss    0.000   val acc 0.956
constant      peak 0.01  final train loss    0.021   val acc 0.959
圖 4 逐 epoch 顯示各次實驗。這個小玩具得出三點結論,與上面的建議相符:
- 接近邊緣的峰值需要排程。在固定的 0.1(接近範圍測試的最小值)下,損失爆炸,驗證準確率在 81% 到 92% 之間擺盪。同一個峰值放進先升後降的排程中就沒問題(這次實驗中,熱身 + 餘弦達到 97.1%,one-cycle 達到 95.6%)。
- 衰減能救回來,但太晚。階梯式衰減把一半的訓練花在不穩定的學習率上;學習率在第 8 個 epoch 降下來之後,損失才恢復,驗證準確率達到 94.0%。
- 固定學習率夠小就能用。在 0.01(範圍測試建議的峰值的十分之一)下,固定排程訓練得很平穩(95.9%),只是在同樣的預算內走得不夠遠:它的訓練損失還有 0.021。
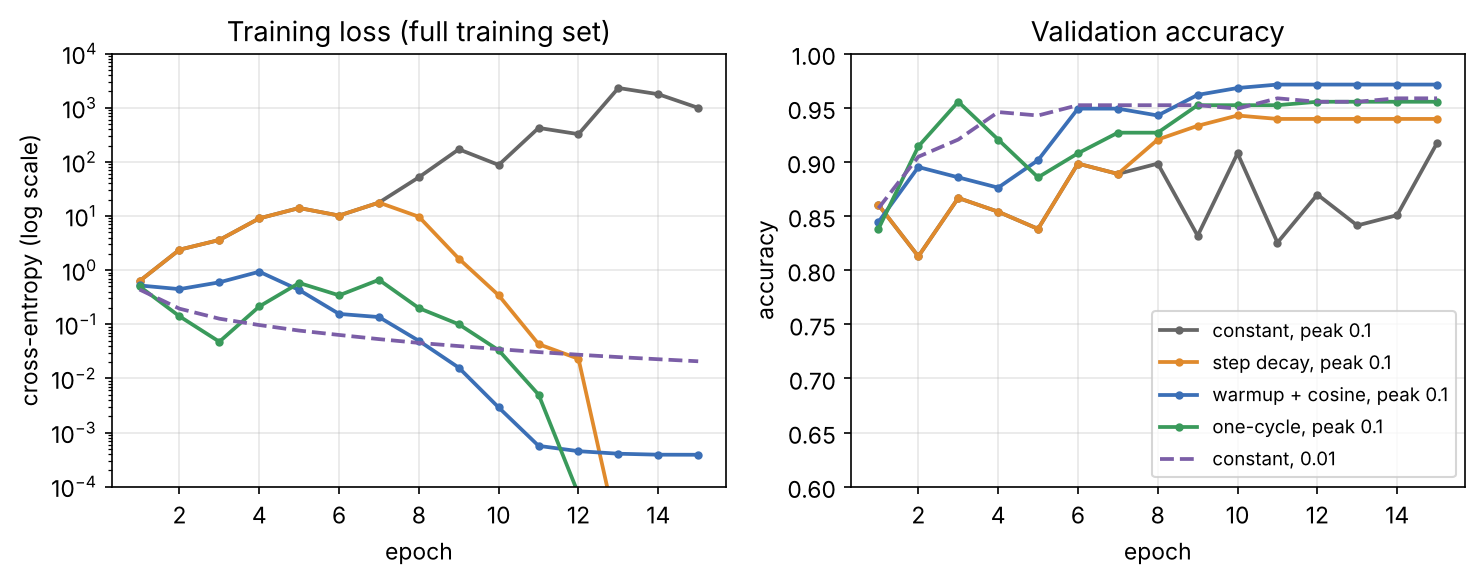
不要從這張圖解讀餘弦與 one-cycle 之間的名次:這只是一個隨機種子,而下面的種子研究顯示它們的順序會隨種子而翻轉。可靠的結論是第一點。
該選哪個排程。熱身後接餘弦衰減是安全的預設;重現舊論文時,階梯式衰減沒問題;one-cycle 適合短預算;事先不知道訓練長度時,固定學習率加一小段最後的衰減會有幫助(現代觀點)。排程是以步定義的,所以當 epoch 數、批次大小或資料集大小改變時,要重新計算 。
批次大小與梯度累積
白話版。較大的批次給出雜訊較少的梯度,所以每一步可以走得更大。如果批次加倍,通常可以把學習率也加倍,但有個限度。(ML 02 定義了批次、iteration 與 epoch。)
Goyal 等人在 ImageNet [19] 上訓練 ResNet-50 [18],使用最多 8,192 張影像的小批次而不損失準確率,靠的是兩條規則 [9]:
- 線性縮放規則:當小批次大小乘以 時,把學習率也乘以 ,其他超參數(例如權重衰減)保持不變。He 等人以 的形式陳述同一條規則,適用於批次大小為 、用 SGD 訓練的 ResNet-50 [1]。
- 漸進式熱身:在最初 5 個 epoch 內,把學習率從小批次的值升到縮放後的值。
這條規則是一個近似。它假設一次大步所取代的 個小步之間,梯度變化不大;這在訓練早期(所以需要熱身)以及超過某個批次大小之後都不成立;在他們的 ImageNet 實驗中,這個極限約在 8,000 張影像 [9]。對於自適應最佳化器,這個關係沒有那麼簡單,所以批次大小大幅變動後,請重新執行範圍測試。
選讀:Accurate, Large Minibatch SGD(Goyal 等人)(見「論文導讀」頁)。縮放規則從哪裡來、如何讀他們的熱身比較,以及他們列出的實作陷阱。
梯度累積。當你想要的批次放不進記憶體時,就跑幾個較小的微批次(micro-batch),把它們的梯度加起來,只做一次最佳化器更新。當損失是對範例取平均,且 個微批次大小相等時,
其中 是全部 個範例的平均損失, 是含 個範例的微批次 的平均損失, 是參數。下面的程式碼在小玩具上檢查這一點(它重複使用執行範例中的 init 與 loss_and_grads):
程式碼 · Python · 13 行
P = init(0)
xb, yb = X_tr[:32], y_tr[:32]
_, full = loss_and_grads(P, xb, yb)                     # one batch of 32

acc = [[np.zeros_like(W), np.zeros_like(b)] for W, b in P]
k = 4                                                   # 4 micro-batches of 8
for j in range(k):
    _, G = loss_and_grads(P, xb[8 * j:8 * j + 8], yb[8 * j:8 * j + 8])
    for a, (gW, gb) in zip(acc, G):
        a[0] += gW / k                                  # divide by k: mean of means
        a[1] += gb / k
diff = max(np.abs(a[0] - g[0]).max() for a, g in zip(acc, full))
print(f"largest difference, accumulated vs full batch: {diff:.1e}")
輸出
largest difference, accumulated vs full batch: 1.1e-16差異是浮點捨入造成的:更新其實是相同的。在真實模型中,有兩件事會破壞這個等價性。批次正規化是對每個微批次計算統計量,所以累積並不會讓 BN 得到更大的批次。另外,如果損失是對每張影像數量不定的項目取平均(分割中的有效像素、偵測中的框、圖說中的 token),累積後的總和要除以總數,而不是除以 。
選讀:損失不是單純平均時的梯度累積(見「補充資料」頁)。逐像素與逐框損失的正確加權,以及哪些計數器(排程、權重衰減、EMA)必須隨每次最佳化器更新而前進。
實務上的正則化
白話版。正則化工具讓死記更困難,使網路學到能泛化的規律。它們都朝同一個方向拉,所以要一次加一種,而且只有在驗證曲線顯示過擬合時才加。
Smith 與 Topin 強調了一個容易忽略的重點:大的學習率本身也有正則化的效果,所以較高的峰值需要較少其他種類的正則化,而且所有形式(大學習率、小批次、權重衰減、dropout)必須一起平衡 [16]。當你更改排程時,要重新調整權重衰減與資料擴增,反之亦然。
權重衰減。權重衰減在每一步把每個權重稍微縮小一點。對單純的 SGD 來說,這等於在損失中加入 L2 懲罰;對 Adam [20] 這類自適應最佳化器就不是了,因為懲罰項的梯度會被逐參數重新縮放。Loshchilov 與 Hutter 的 AdamW 把衰減從梯度步驟中解耦 [21];ML 02 推導了其中的差異。兩條實務規則:
- 在 PyTorch 中,
torch.optim.AdamW套用的是解耦衰減,而torch.optim.Adam的weight_decay參數則是把 L2 項加進梯度,除非設定decoupled_weight_decay=True[22]。對 Transformer 與現代 CNN 配方,請使用解耦衰減。 - 不要對偏置,以及正規化層的尺度與位移做衰減。He 等人把這種「不對偏置衰減」列為他們的改良之一 [1];DLCV 02 以程式碼展示了這兩個參數群組。
Dropout 與隨機深度。Dropout 在訓練時把隨機的激活值歸零 [23];隨機深度(stochastic depth)則隨機跳過整個殘差區塊,跳過機率隨深度增加 [24]。Dropout 常見於分類頭與 Transformer 區塊,隨機深度則常見於深層殘差網路與視覺 Transformer。兩者在訓練模式與評估模式下的行為不同。
提前停止與檢查點選擇。定期在驗證集上評估,保留最佳檢查點,並在分數一段時間沒有改進時停止(這段時間稱為「耐心」)。在 Prechelt 對多層感知器的研究中,較慢的停止準則使泛化略有改善,但訓練成本高出許多 [25]。Tuning Playbook 建議定期儲存檢查點,並事後回溯挑選最佳的一個 [26]。
權重的 EMA
白話版。在權重本身旁邊,再保留一份緩慢移動的權重平均,並評估這個平均。最後幾步的雜訊會互相抵消,就像把同一個場景的好幾張照片平均起來能去除雜訊一樣。
DLCV 02 把 EMA 列為現代分類配方的一部分;本節談的是如何選擇它的視窗。每次最佳化器更新後,更新
其中 是目前的權重, 是其指數移動平均(EMA), 是衰減率。這個平均實際上涵蓋大約最近 步: 時約 100 步, 時約 1,000 步。對隨機梯度下降的迭代值取平均,是最佳化領域的老想法 [27],而隨機權重平均(stochastic weight averaging, SWA)把等權重的版本帶進了深度學習 [28]。Morales-Brotons 等人系統性地研究了權重的 EMA:EMA 模型的泛化比最後一次迭代好,所需的學習率衰減也較少,而除非重新計算批次正規化的統計量,否則 BN 會限制平均視窗能有多長 [29]。
視窗必須比整個訓練短。我們的小玩具把這一點具體化(它重複使用上面的 train、constant 與 evaluate):
程式碼 · Python · 9 行
for decay in (0.99, 0.999):
    raw, avg = [], []
    for s in range(5):
        P, log, E = train(constant, peak=0.05, seed=s, ema_decay=decay)
        raw.append(evaluate(P, X_va, y_va)[1])
        avg.append(evaluate(E, X_va, y_va)[1])
    print(f"decay {decay}: window ~{1 / (1 - decay):.0f} steps   "
          f"val acc raw {np.mean(raw):.3f}   EMA {np.mean(avg):.3f}")
print("steps in the whole run:", 15 * int(np.ceil(len(y_tr) / 16)))
輸出
decay 0.99: window ~100 steps   val acc raw 0.963   EMA 0.963
decay 0.999: window ~1000 steps   val acc raw 0.963   EMA 0.945
steps in the whole run: 885
在這個小而簡單的問題上, 時 EMA 沒有帶來好處,而 時它反而更差:約 1,000 步的視窗比整個 885 步的訓練還長,所以平均仍帶有糟糕的早期迭代的權重。EMA 在更新帶有雜訊的長時間訓練中才有回報,實務上也是這樣用的。
選讀:權重的 EMA:如何選擇衰減率(見「補充資料」頁)。有效視窗、起始階段的偏差校正、批次正規化統計量,以及如何評估平均後的權重。
混合精度與損失縮放
白話版。用 16 位元數字做大部分運算,可以把記憶體流量減半並使用快速的硬體單元,但 16 位元放不下所有東西。要把少數敏感的量保留在 32 位元,並縮放損失,讓很小的梯度不會被捨入成零。
Micikevicius 等人用兩項技術讓 float16 訓練可行:以 float32 保存權重的主副本來累積更新,以及損失縮放,也就是在反向傳播前把損失乘上係數 ,更新前再把梯度除以 [30]。這兩個問題都很容易重現:
程式碼 · Python · 9 行
import numpy as np

g = np.float32(2e-8)                                    # a small, real gradient value
print("float16 gradient:          ", np.float16(g))     # underflows to zero
S = np.float32(1024)                                    # loss scale
g16 = np.float16(g * S)                                 # scaled: representable in float16
print("scaled, then unscaled:     ", np.float32(g16) / S)
print("float16 weight 1 + 1e-4:   ", np.float16(1) + np.float16(1e-4))   # update lost
print("float32 weight 1 + 1e-4:   ", np.float32(1) + np.float32(1e-4))
輸出
float16 gradient:           0.0
scaled, then unscaled:      2.0023435e-08
float16 weight 1 + 1e-4:    1.0
float32 weight 1 + 1e-4: 1.0001第一行是下溢(underflow): 小於 float16 能表示的最小正值,所以變成零,而乘上 1,024 就把它移回可表示的範圍。第三行是更新遺失:在 1.0 附近,float16 的數字間隔太大,無法反映 的變化,這就是權重本身要留在 float32 的原因。
在 PyTorch 中,自動混合精度結合了 torch.autocast(讓每個運算以合適的精度執行)與 torch.amp.GradScaler(執行動態損失縮放);其在 CPU 上的 bfloat16 範例只用 autocast [31]。bfloat16 保留了 float32 的 8 個指數位元,也就保留了它的範圍,所以很少需要損失縮放(ML 01C)。先在 float32 下把實驗做對,再開啟混合精度並檢查損失曲線幾乎不變;如果 NaN 只出現在混合精度下,就去找在 16 位元下溢位的運算。ML 01C 詳細解釋了這些格式。
遷移學習與微調策略
白話版。預訓練網路已經認得邊緣、紋理與物體的部位。微調要教它你的任務,卻不破壞那些知識:新的部分快速改變,舊的部分輕輕調整。
DLCV 02 定義了線性探測與完整微調;本節談的是如何在兩者之間選擇,以及如何讓微調更溫和。Yosinski 等人測量了每一層特徵的通用程度:早期層學到的特徵可以跨資料集遷移,後期層則更偏向特定任務,來源與目標任務差距越大,可遷移性越低,不過即使任務相距很遠,遷移來的特徵仍然優於隨機特徵 [32]。這就是下列策略背後的原因,由最便宜到最有彈性排列:
| 策略 | 訓練什麼 | 適用時機 |
|---|---|---|
| 線性探測 | 只訓練凍結特徵上的新線性分類頭 | 資料很少;特徵對這個任務已經夠好;也用來衡量特徵品質 |
| 部分微調 | 分類頭與最後幾個階段 | 資料量中等;目標接近預訓練的領域 |
| 完整微調 | 全部,骨幹用較小的學習率 | 資料夠多,或領域差距大 |
| 先線性探測再微調(LP-FT) | 先只訓練分類頭,再訓練全部 | 在意對分布偏移的穩健性時 |
| 參數高效微調 | 小型附加模組,例如低秩更新(LoRA [33]) | 非常大的模型;許多任務共用一個骨幹 |
有三個工具能讓完整微調更溫和:
- 逐層學習率。給每個層群組自己的學習率,越早的層越小。Howard 與 Ruder 把這稱為判別式微調(discriminative fine-tuning),並與逐步解凍(gradual unfreezing:先訓練最後一層,之後每個 epoch 再多解凍一個層群組)一起提出 [34]。在視覺配方中,骨幹的學習率常比分類頭小 10 到 100 倍(DLCV 02)。
- LP-FT。Kumar 等人指出,用隨機初始化的分類頭做完整微調,可能會扭曲良好的預訓練特徵:在擬合隨機分類頭的過程中,骨幹對類似訓練資料的輸入改變很大,對看起來不同的輸入則改變小得多。先訓練線性分類頭,再微調全部(LP-FT),在他們的實驗中同時保留了微調在分布內的增益,以及線性探測對分布外的穩健性 [35]。
- 熱身與 BN。短暫的熱身能保護預訓練權重,不被新分類頭一開始的大梯度破壞;而在每個裝置的批次很小時,骨幹的 BN 層常被凍結(上文)。
選讀:逐層學習率與逐步解凍(見「補充資料」頁)。如何設定每一層的學習率、逐層衰減規則,以及如何分階段解凍。
選讀:Fine-Tuning can Distort Pretrained Features(Kumar 等人)(見「論文導讀」頁)。支持 LP-FT 的論證,以及如何閱讀其分布內與分布外的結果。
除錯一次訓練
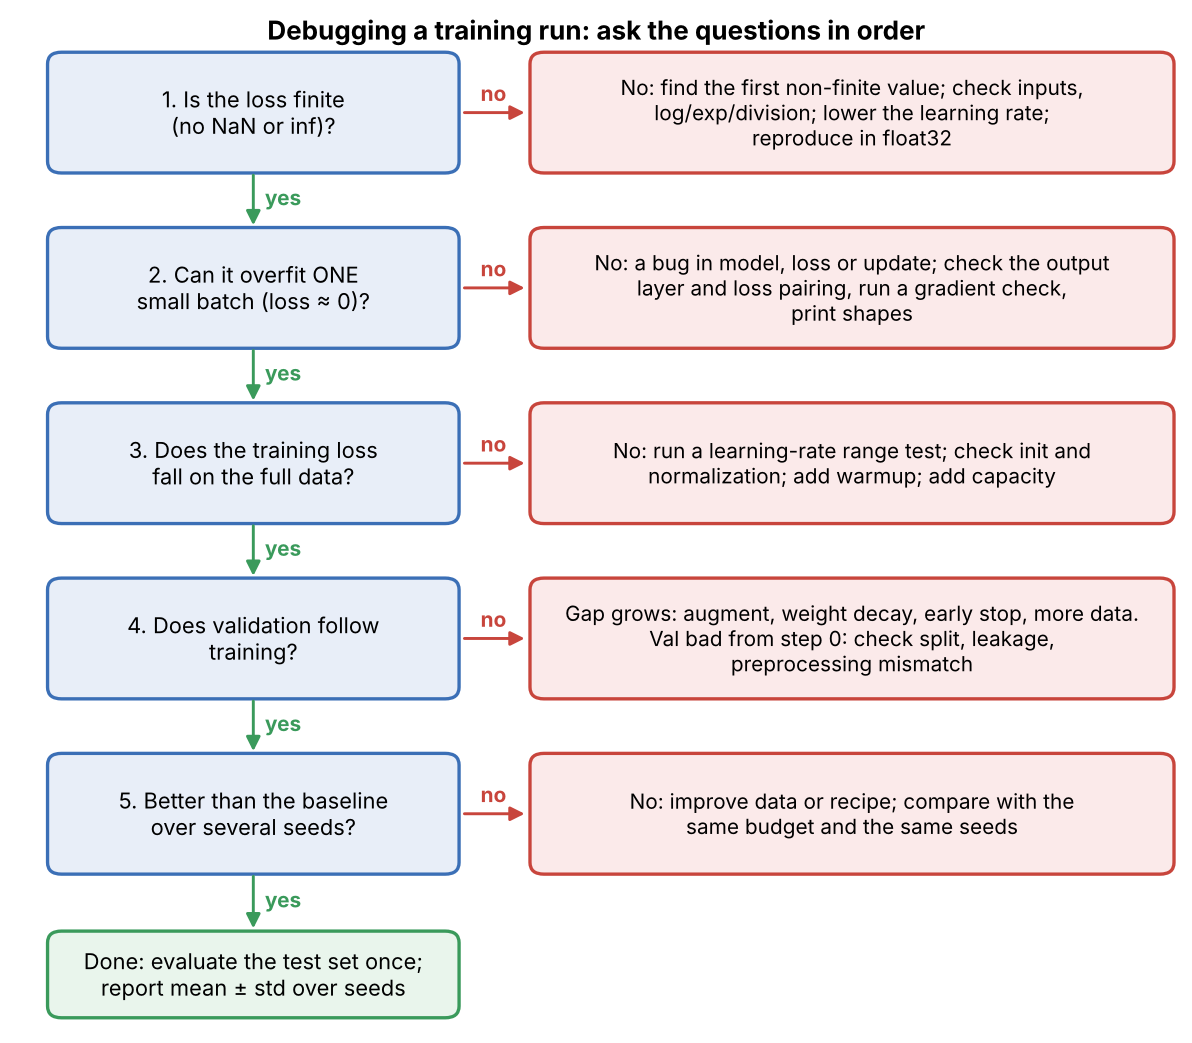
白話版。多數訓練錯誤不會崩潰;它們只是讓模型稍微變差。除錯就是執行正確的管線一定能通過的便宜測試,並依能隔離原因的順序進行(圖 5)。
先過擬合一個批次
白話版。取一個小批次,反覆在它上面訓練。正確的模型與訓練迴圈能記住幾張影像,所以損失一定會降到接近零。如果做不到,就是哪裡壞了,而你在幾秒鐘內就發現,而不是幾天之後。
Karpathy 的網路訓練配方把這個測試放在很前面:過擬合單一小批次,而在那之前,先檢查初始化時的損失是不是它該有的值 [2]。對於 個平衡的類別和初始化良好的最後一層,最初的預測接近均勻,所以交叉熵一開始約為 (我們的數字資料是 )。下面的程式碼先檢查這一點,再對 16 張數字影像執行兩次單批次測試:一次是正確的,一次帶有一個很容易犯的錯,也就是在模型中以及損失內部都套用 softmax。它重複使用執行範例中的 init 與 forward。
程式碼 · Python · 29 行
def overfit_one_batch(double_softmax=False, steps=300, lr=0.1, seed=0):
    P = init(seed)
    xb, yb = X_tr[:16], y_tr[:16]                       # ONE fixed batch of 16 images
    for step in range(steps):
        h = forward(P, xb)
        z = h[-1]
        if double_softmax:                              # BUG: the "logits" are already probabilities
            z = np.exp(z - z.max(1, keepdims=True))
            z = z / z.sum(1, keepdims=True)
        s = z - z.max(1, keepdims=True)
        p = np.exp(s) / np.exp(s).sum(1, keepdims=True)
        loss = -np.log(p[np.arange(16), yb]).mean()
        d = p.copy()
        d[np.arange(16), yb] -= 1
        d /= 16
        if double_softmax:                              # chain rule through the extra softmax
            d = z * (d - (d * z).sum(1, keepdims=True))
        for i in reversed(range(len(P))):
            gW, gb = h[i].T @ d, d.sum(0)
            if i:
                d = (d @ P[i][0].T) * (h[i] > 0)
            P[i][0] -= lr * gW
            P[i][1] -= lr * gb
    return loss

print(f"loss at init:          {evaluate(init(0), X_tr, y_tr)[0]:.4f}   (ln 10 = {np.log(10):.4f})")
print(f"correct loss:          {overfit_one_batch():.4f}")
print(f"double-softmax bug:    {overfit_one_batch(double_softmax=True):.4f}")
print(f"floor of the bug:      {-np.log(np.e / (np.e + 9)):.4f}")
輸出
loss at init:          2.8204   (ln 10 = 2.3026)
correct loss:          0.0036
double-softmax bug:    1.4661
floor of the bug:      1.4612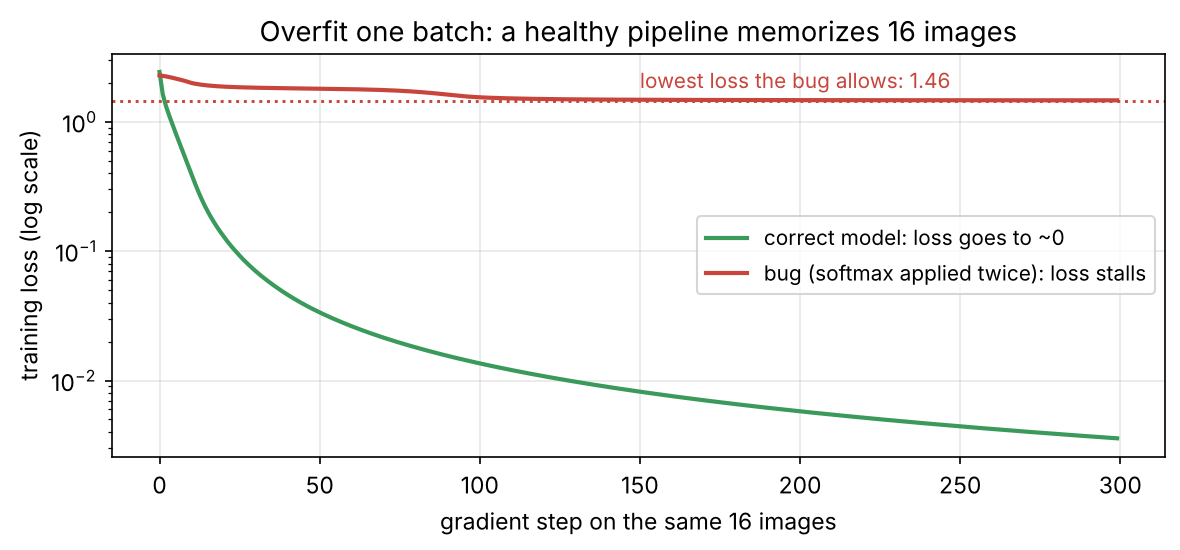
初始損失略高於 ,是因為經過 He 初始化的輸出層會產生中等大小的 logit,所以最初的預測並非完全均勻;這裡無傷大雅。如果數值遠高於 ,就表示網路一開始就自信地答錯,把最後一層的初始權重縮小就能解決。這個錯誤有一個硬性的下限。經過第一次 softmax 之後,傳給損失的「logit」介於 0 到 1 之間,所以第二次 softmax 最好也只能讓真實類別得到 ,其餘九個類別各得 :機率為 ,損失為 。在完整資料集上,這個錯誤不會崩潰,仍然能產生可用的分類器,所以可能不被發現;單批次測試在幾秒內就能揭露它。
通過測試所能證明的,比看起來少。Zhang 等人證明了標準的影像分類器可以完美擬合隨機標籤,甚至隨機雜訊影像 [36],所以記住一個批次只能說明模型、損失與更新能夠學習,不能說明標籤是正確的。標錯或對不齊的資料,必須靠實際去看它才能發現(檢查清單第 2 項)。
讀懂損失曲線
白話版。損失曲線是一次訓練的主要紀錄:它的形狀告訴你該懷疑管線的哪個部分。把訓練與驗證曲線畫在一起,損失用對數尺度。
ML 02 解釋了四種基本形狀(平坦、過擬合、收斂、健康)。以下幾種模式在視覺訓練中很典型:
- 正好卡在 。網路輸出均勻的機率:梯度沒有傳到它那裡(張量被分離、參數被凍結、學習率為零),或是標籤是常數。
- 會恢復的損失尖峰。學習率接近穩定性的邊緣(如圖 4),或是有幾個批次含有損毀的影像或標籤。記錄損失最大的批次的索引,然後去看它們。
- 驗證比訓練更好。在強擴增或 dropout 下是正常的,因為訓練損失是在更困難的、經過擴增的輸入上量測的。
- 驗證準確率持平但驗證損失上升。網路對它答錯的範例變得過度自信;排序沒問題,但機率不對(DLCV 02 的校準)。
- 每個里程碑都會下降一截。階梯式衰減下這是預期的。如果餘弦排程結束時曲線仍在陡降,就表示預算太短。
- 驗證很好,部署很差。懷疑是前處理不一致,或是捷徑學習(shortcut learning):網路依賴一個驗證集與訓練集共有、但部署資料沒有的線索 [37](DLCV 02)。
梯度範數、死單元與 NaN
白話版。每隔幾百步記錄幾個健康指標:每一層梯度的大小、從不激活的單元所占的比例,以及有沒有東西變成 NaN。訓練出問題時,這些數字通常最先出問題。
下面的程式碼在三種固定學習率下訓練三個 epoch 之後,計算其中兩項。它重複使用上面的 train、forward、loss_and_grads 與 constant。
程式碼 · Python · 12 行
def health(P, X, y):
    _, G = loss_and_grads(P, X, y)
    h = forward(P, X)[1]                                # hidden ReLU activations
    dead = (h.max(0) == 0).mean()                       # units that are zero for every input
    norms = [np.linalg.norm(gW) for gW, _ in G]
    return norms, dead

for peak in (0.01, 0.1, 0.3):
    P, log, _ = train(constant, peak=peak, epochs=3)
    norms, dead = health(P, X_tr, y_tr)
    print(f"lr {peak:<5} train loss {log[-1, 0]:9.3g}  grad norms "
          f"{norms[0]:9.3g} {norms[1]:9.3g}  dead units {dead:.0%}")
輸出
lr 0.01  train loss     0.127  grad norms    0.0664    0.0496  dead units 0%
lr 0.1   train loss      3.61  grad norms      1.44      2.11  dead units 0%
lr 0.3   train loss   2.1e+08  grad norms  1.02e+04  1.31e+04  dead units 0%
在健康的實驗與發散的實驗之間,梯度範數增加了五個以上的數量級,而且遠早於損失變成 NaN,所以記錄它們是便宜的保險。梯度裁剪(ML 02)是合理的防護,但它只是掩蓋太大的學習率,而不是解決它。這裡沒有單元死掉,因為這個小玩具是以爆炸的方式失敗。死亡 ReLU(dead ReLU)對每個輸入都輸出零,所以得不到梯度,也就再也無法恢復;許多死單元(通常發生在一次巨大的更新之後,或偏置強烈為負時)意味著容量的損失。
當損失變成 NaN 或無限大時,要找出第一個產生非有限值的運算,而不是把所有東西都裁剪:依序檢查輸入、前向傳遞、損失、梯度與更新的大小,並且在怪罪混合精度之前,先在 float32 中重現。ML 01C 詳細給出了這個順序,而它關於檢查導數的一節則展示如何測試手寫的反向傳播。
可重現性與公平的實驗
白話版。一個結果必須能重複,而且背後的比較必須公平,才有用。固定隨機種子、記錄你做了什麼,並且把每個設定跑好幾次,因為單憑隨機機會,就可能讓分數的變動大過你想展示的改進。
隨機種子、確定性與記錄
要為每個亂數產生器設定種子:Python 的、NumPy 的、框架的,以及資料載入器工作行程的。即使如此,各次執行仍可能不同:PyTorch 文件指出,不保證跨版本、跨提交或跨平台,或在 CPU 與 GPU 之間得到完全可重現的結果。在同一個環境內,它建議使用 torch.use_deterministic_algorithms(True)、關閉 cuDNN 的 benchmark,並透過 worker_init_fn 與 generator 為資料載入器工作行程設定種子,同時警告確定性的運算常常比較慢 [38]。要記錄足夠的資訊,讓實驗能重跑:程式碼版本、設定、資料版本與切分識別碼、隨機種子、環境與硬體,以及損失、指標、學習率與梯度範數的曲線(ML 11)。
隨機種子有多重要?
隨機種子改變初始化與資料順序,因此也改變結果。下面的程式碼在小玩具上訓練兩種設定,A(熱身 + 餘弦)與 B(one-cycle),每種各用五個隨機種子,並逐對比較(它重複使用 train 與排程函式):
程式碼 · Python · 8 行
seeds = range(5)
A = [train(warmup_cosine, peak=0.1, seed=s)[1][-1, 3] for s in seeds]
B = [train(one_cycle, peak=0.1, seed=s)[1][-1, 3] for s in seeds]
print("A (warmup + cosine):", np.round(A, 3))
print("B (one-cycle):      ", np.round(B, 3))
d = np.array(B) - np.array(A)                           # paired: same seed, same data order
print(f"A mean {np.mean(A):.3f} +- {np.std(A, ddof=1):.3f}   B mean {np.mean(B):.3f} +- {np.std(B, ddof=1):.3f}")
print(f"paired difference B - A: mean {d.mean():+.3f}, range {d.min():+.3f} to {d.max():+.3f}")
輸出
A (warmup + cosine): [0.971 0.962 0.956 0.956 0.959]
B (one-cycle):       [0.956 0.952 0.952 0.978 0.956]
A mean 0.961 +- 0.007   B mean 0.959 +- 0.011
paired difference B - A: mean -0.002, range -0.016 to +0.022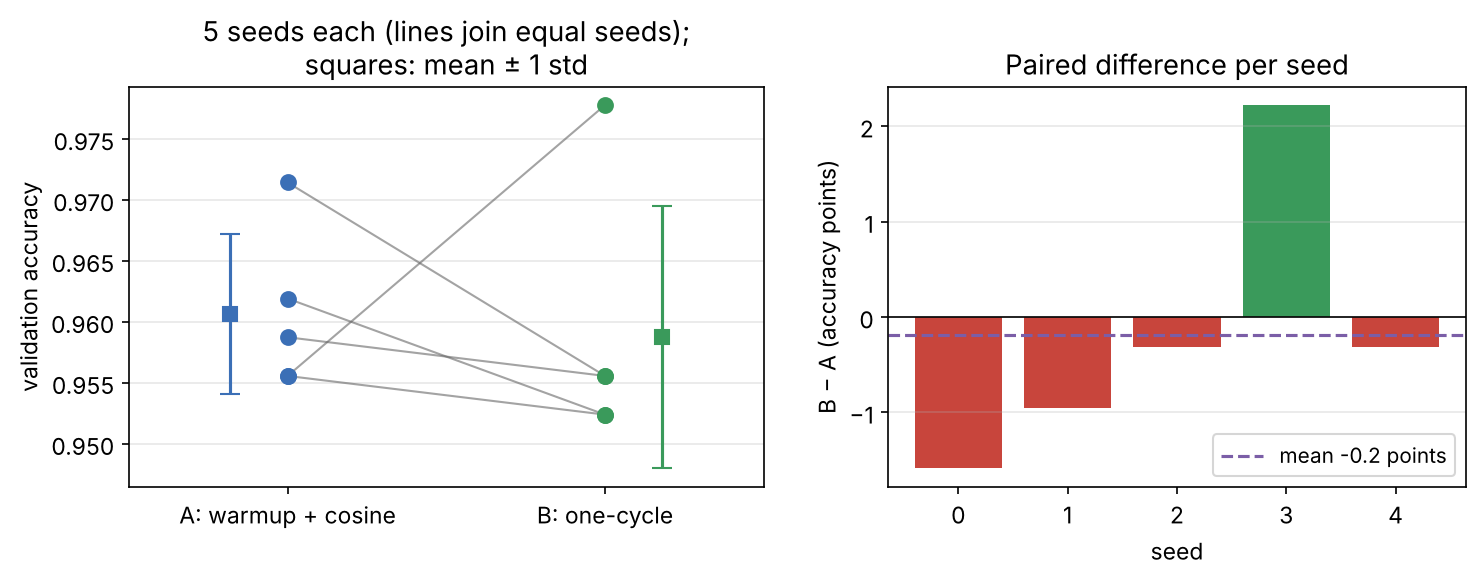
只看種子 3,你會報告 one-cycle 贏 2.2 個百分點;只看種子 0,則會說它輸 1.6 個百分點。五個種子下,平均差異是 0.2 個百分點,而分散程度遠大於此:這個小玩具上沒有可偵測的差異(而且這裡一張驗證影像就值約 0.3 個百分點)。要回報跨種子的平均值與標準差,在相同的種子與切分上做配對比較,並且在宣稱有改進之前,使用 ML 11 的信賴區間與配對檢定。發表的大規模結果也這樣做:Goyal 等人把每個 ImageNet 誤差都報告為五次試驗的平均值與標準差 [9]。
基準、消融實驗與預算
公平的實驗只改變一件事,其他一切保持固定:
- 基準。一定要包含一個簡單的基準與先前最好的配方,並在同一條管線中由你自己訓練。把新方法與舊論文裡的基準相比,會把方法的效果和配方的效果混在一起(DLCV 02)。
- 相同的調參預算。讓每個方法的超參數都有相同的試驗次數。一個調了一週的方法,贏過只跑一次的基準,是贏在調參,而不是贏在設計。
- 相同的訓練預算。在相同的步數或相同的運算量下比較;單是較長的排程就可能解釋一個增益。
- 消融實驗。從完整方法中一次移除一個元件,每個都用多個隨機種子,並報告下降多少。一次改變兩件事的消融實驗,無法告訴你哪一個才重要。
- 只評估一次測試集。所有決策都用驗證資料做;最後選定的結果只在測試集上評估一次。
Deep Learning Tuning Playbook 把這些整理成漸進的策略:決定每一輪實驗的目標,把正在研究的超參數、必須針對每個設定重新調整的超參數(「干擾」超參數),以及保持固定的超參數區分開來,並且只在證據充分時才採納一個改變 [26]。
現代觀點
白話版。本篇的核心習慣是穩定的。近期的工作改變的是:如何比較訓練方法、排程有多少必須事先固定,以及大型預訓練模型如何適應新任務。
綜述與指南怎麼說
實用的訓練知識,更多存在於綜述與指南,而不是單篇論文。Bengio 在 Neural Networks: Tricks of the Trade 中的章節,收集了基於梯度的訓練建議,從學習率與小批次大小到提前停止與超參數搜尋 [12]。Deep Learning Tuning Playbook 涵蓋了架構、最佳化器、批次大小與初始設定的選擇、漸進而科學的調參過程、要訓練多久,以及檢查點選擇與實驗追蹤等管線細節 [26]。Shorten 與 Khoshgoftaar 把影像擴增整理成幾何與色彩轉換、核濾波器、混合影像、隨機擦除、特徵空間與對抗式擴增、生成式與風格轉換擴增,以及元學習的策略,也討論了測試時擴增 [7]。Xin 等人把視覺模型的參數高效微調分成基於附加的、基於部分的、統一式的與多任務的調整,並提出統一的基準 [39]。
公平地比較訓練方法本身就很困難。Dahl 等人主張,社群無法可靠地辨識訓練演算法的改進,因為不清楚何時才算訓練完成、結果對工作負載的細節很敏感,而且需要調參的方法很難公平比較;他們提出了 AlgoPerf 基準,衡量在固定硬體上跨多個工作負載達到目標結果所需的時間 [40]。
2023–2026 年的最先進技術
- 有基準的訓練演算法。第一屆 AlgoPerf 競賽收到來自 10 個團隊的 18 份提交。在由提交者提供搜尋空間的規則下,優勝者使用非對角預條件(non-diagonal preconditioning),甚至在掛鐘時間上也勝過 Adam 等常用方法;在不允許調參的規則下,優勝者基於 Schedule-Free AdamW [41]。
- 需要調的排程更少。Defazio 等人的 Schedule-Free 方法統一了排程與迭代值平均,不需要事先知道停止步數,除了動量最佳化器本身的超參數之外也沒有新的超參數 [42]。一個更簡單的替代方法是固定學習率,後面接一小段「冷卻」衰減,MiniCPM 稱之為熱身-穩定-衰減(warmup-stable-decay, WSD)[43]。Hägele 等人發現,它的擴展性與餘弦排程一樣可預測,只要在訓練的一小部分做冷卻就夠,而且權重平均能沿著訓練軌跡改善結果,不需額外的訓練成本;他們的實驗是在語言模型上,所以要自己驗證能否遷移到視覺的工作負載 [44]。
- 處處都用權重平均。除了上面的 EMA 研究 [29],平均也用在微調中:WiSE-FT 在預訓練模型的零樣本權重與微調後權重之間做內插,改善分布偏移下的穩健性 [45],而 model soups 則把數個微調後的模型取平均,在不增加推論成本的情況下提高準確率 [46]。
- 微調基礎模型。面對非常大的預訓練骨幹,完整微調可以被線性探測、LP-FT [35],或 LoRA [33]、[39] 這類參數高效方法取代。實務上的問題從「哪種架構」轉為「哪個預訓練模型,以及要調整它的多少部分」。
尚待解決的問題
- 能遷移的超參數。最佳學習率、熱身長度與權重衰減仍會隨模型大小、批次大小與資料集而變;範圍測試與線性縮放規則是近似,不是定律。
- 公平而負擔得起的比較。各論文的調參預算不同,隨機種子往往少到無法區分方法。AlgoPerf 這類基準針對訓練演算法處理了這個問題 [40],但對多數視覺任務還沒有可比較的標準。
- 大規模下的確定性。位元層級完全一致的可重現性,跨硬體與軟體版本都不受保證 [38],這讓大型訓練中的小幅退步很難診斷。
- 密集與特殊任務的資料擴增。在幾何與強度都帶有標籤資訊的偵測、分割、醫學與遙測影像上,如何自動選擇資料擴增,仍是未解的問題。
- 微調而不遺忘。把基礎模型調整到狹窄的任務,同時保留它在分布外的穩健性,仍是活躍的研究問題 [35]、[45]。
重點整理
- 擴大訓練前,先檢查處理後的批次、初始損失,並確認能過擬合一個批次。
- 依部署時的新資料單位切分,只用訓練資料擬合前處理,空間標籤須隨影像一起變換。
- 用學習率範圍測試、暖身與衰減;改變批次大小時重新檢查排程。
- 梯度累積是否等同大批次,取決於損失加權與批次相依運算;應依實際樣本、像素或方框數正規化。
- 一起調整互相影響的正則化方式,並用驗證資料選擇檢查點。
- 微調預訓練特徵時採取較小幅度更新,並檢查小批次下的正規化行為。
- 報告多個隨機種子、相同預算與單項消融,測試集保留到最後評估。
練習
- 先範圍測試,再排程。用批次大小 8、16 與 64(修改
bs)重跑範圍測試。最小值處的學習率如何移動?接著在每個批次大小下,用它自己的範圍測試得到的峰值訓練warmup_cosine,並與線性縮放規則比較。
提示
在我們的實驗(隨機種子 0 與 1)中,最小值在批次 8 時約為 0.15–0.16,批次 16 時為 0.13–0.14,批次 64 時為 0.35:它隨批次大小上升,但不成精確的比例,而且簡短的測試有雜訊。記得在固定 epoch 數時,以步數計的 會隨批次變大而變小,所以較大的批次也得到較少的更新次數。
- 因錯誤原因通過的單批次測試。把
y_tr[:16]洗牌(讓標籤不再對應影像),然後執行overfit_one_batch。損失會怎樣?這說明了該測試能偵測什麼、不能偵測什麼?檢查清單中的哪一項檢查本來可以抓出被洗牌的標籤?
提示
損失仍然降到接近零(在我們用 np.random.default_rng(0) 排列標籤的實驗中是 0.0056),因為網路能記住任意 16 個標籤,就像 Zhang 等人在大規模隨機標籤上所示 [36]。這個測試檢查的是模型、損失與更新,不是資料。看一個畫上標籤的批次(第 2 項)可以抓出對不齊的標籤;驗證準確率接近隨機水準也可以。
- 翻轉關鍵點。擴充
hflip函式,讓它也能轉換以(x, y, name)表示的關鍵點清單,名稱如left_eye與right_eye。寫一個檢查,在翻轉後的left_eye仍叫left_eye時失敗。
提示
座標對像素中心遵循 (對連續座標則是 ,與這裡使用的框慣例相符), 不變。然後用查找表交換每一對左右名稱。連續套用兩次翻轉必須精確回到原本的關鍵點,這是個好測試。
- 有被忽略像素的累積。分割損失在標籤不是「忽略」的像素上,對逐像素交叉熵取平均。微批次 1 有 1,000 個有效像素,平均損失 0.5;微批次 2 有 3,000 個有效像素,平均損失 0.9。合併後批次的平均損失是多少?而把兩個微批次的平均值再取平均,會得到什麼?
提示
合併後的平均是 。把兩個平均值再取平均得 ,這低估了有效像素較多的微批次。梯度也適用同樣的加權:累積總和,再除以總數。
- 要幾個隨機種子?用
train,對設定 A 與 B 各跑 10 個隨機種子,而不是 5 個。平均差異的正負號會改變嗎?估計配對平均差異的標準誤 ,其中 是各種子差異的標準差, 是種子數,並判斷用 10 個種子能不能偵測到 0.5 個百分點的改進。
提示
在我們用種子 0–9 的實驗中,正負號確實改變:B − A 的平均差異變成約 +0.6 個百分點,而五個種子時是 −0.2 個百分點。在 個百分點下,標準誤是 個百分點,所以 0.5 個百分點的改進離零只有約一個標準誤:不具說服力。更大的驗證集與更多隨機種子都有幫助;ML 10 展示了配對 bootstrap 區間。
- 微調計畫。你有 2,000 張有標註的 X 光影像、一個在自然照片上預訓練的骨幹,以及一張一次只能放 8 張影像的 GPU。寫一份訓練計畫:正規化統計量、資料擴增(哪些不安全?)、如何處理批次正規化、微調策略、學習率的做法,以及你要如何判斷某個改變有沒有幫助。
提示
使用預訓練的正規化統計量;避免會改變診斷數值的強度擴增,並且在左右側別有意義時小心翻轉;因為每批 8 張影像的統計量有雜訊,所以凍結骨幹的 BN 統計量(或在新層使用群組正規化);先做線性探測,再做 LP-FT,早期層用較小的學習率並加一小段熱身;對分類頭做一次範圍測試;依病人切分;用多個隨機種子和配對區間比較各變體。
參考文獻
- T. He, Z. Zhang, H. Zhang, Z. Zhang, J. Xie and M. Li, “Bag of tricks for image classification with convolutional neural networks,” in Proc. IEEE/CVF CVPR, 2019. doi
- A. Karpathy, “A recipe for training neural networks,” blog post, 2019. link
- scikit-learn developers, “load_digits,” scikit-learn documentation, version 1.9.1. link
- M. Buda, A. Maki and M. A. Mazurowski, “A systematic study of the class imbalance problem in convolutional neural networks,” Neural Networks, vol. 106, 2018. doi
- T.-Y. Lin, P. Goyal, R. Girshick, K. He and P. Dollár, “Focal loss for dense object detection,” in Proc. IEEE ICCV, 2017. doi
- A. Buslaev, V. I. Iglovikov, E. Khvedchenya, A. Parinov, M. Druzhinin and A. A. Kalinin, “Albumentations: Fast and flexible image augmentations,” Information, vol. 11, no. 2, 2020. doi
- C. Shorten and T. M. Khoshgoftaar, “A survey on image data augmentation for deep learning,” Journal of Big Data, vol. 6, 2019. doi
- K. He, X. Zhang, S. Ren and J. Sun, “Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification,” in Proc. IEEE ICCV, 2015. doi
- P. Goyal, P. Dollár, R. Girshick, P. Noordhuis, L. Wesolowski, A. Kyrola, A. Tulloch, Y. Jia and K. He, “Accurate, large minibatch SGD: Training ImageNet in 1 hour,” arXiv:1706.02677 (technical report), 2017. arXiv
- S. Ioffe and C. Szegedy, “Batch normalization: Accelerating deep network training by reducing internal covariate shift,” in Proc. ICML, PMLR 37, 2015. link
- Y. Wu and K. He, “Group normalization,” in Proc. ECCV, 2018. doi
- Y. Bengio, “Practical recommendations for gradient-based training of deep architectures,” in Neural Networks: Tricks of the Trade, 2nd ed., LNCS 7700, Springer, 2012. doi
- L. N. Smith, “Cyclical learning rates for training neural networks,” in Proc. IEEE WACV, 2017. doi
- L. N. Smith, “A disciplined approach to neural network hyper-parameters: Part 1 — learning rate, batch size, momentum, and weight decay,” US Naval Research Laboratory Technical Report 5510-026, arXiv:1803.09820, 2018. arXiv
- I. Loshchilov and F. Hutter, “SGDR: Stochastic gradient descent with warm restarts,” in Proc. ICLR, 2017. arXiv
- L. N. Smith and N. Topin, “Super-convergence: Very fast training of neural networks using large learning rates,” in Artificial Intelligence and Machine Learning for Multi-Domain Operations Applications, Proc. SPIE 11006, 2019. doi
- PyTorch contributors, “torch.optim.lr_scheduler.OneCycleLR,” PyTorch 2.15 documentation, 2026. link
- K. He, X. Zhang, S. Ren and J. Sun, “Deep residual learning for image recognition,” in Proc. IEEE CVPR, 2016. doi
- J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li and L. Fei-Fei, “ImageNet: A large-scale hierarchical image database,” in Proc. IEEE CVPR, 2009. doi
- D. P. Kingma and J. Ba, “Adam: A method for stochastic optimization,” in Proc. ICLR, 2015. arXiv
- I. Loshchilov and F. Hutter, “Decoupled weight decay regularization,” in Proc. ICLR, 2019. arXiv
- PyTorch contributors, “torch.optim.Adam,” PyTorch 2.15 documentation, 2026. link
- N. Srivastava, G. Hinton, A. Krizhevsky, I. Sutskever and R. Salakhutdinov, “Dropout: A simple way to prevent neural networks from overfitting,” Journal of Machine Learning Research, vol. 15, 2014. link
- G. Huang, Y. Sun, Z. Liu, D. Sedra and K. Q. Weinberger, “Deep networks with stochastic depth,” in Proc. ECCV, 2016. doi
- L. Prechelt, “Early stopping — but when?,” in Neural Networks: Tricks of the Trade, 2nd ed., LNCS 7700, Springer, 2012. doi
- V. Godbole, G. E. Dahl, J. Gilmer, C. J. Shallue and Z. Nado, “Deep learning tuning playbook,” Google Research, GitHub repository, 2023. link
- B. T. Polyak and A. B. Juditsky, “Acceleration of stochastic approximation by averaging,” SIAM Journal on Control and Optimization, vol. 30, no. 4, 1992. doi
- P. Izmailov, D. Podoprikhin, T. Garipov, D. Vetrov and A. G. Wilson, “Averaging weights leads to wider optima and better generalization,” in Proc. UAI, 2018. arXiv
- D. Morales-Brotons, T. Vogels and H. Hendrikx, “Exponential moving average of weights in deep learning: Dynamics and benefits,” Transactions on Machine Learning Research, 2024. arXiv
- P. Micikevicius, S. Narang, J. Alben, G. Diamos, E. Elsen, D. Garcia, B. Ginsburg, M. Houston, O. Kuchaiev, G. Venkatesh and H. Wu, “Mixed precision training,” in Proc. ICLR, 2018. arXiv
- PyTorch contributors, “Automatic mixed precision package — torch.amp,” PyTorch 2.15 documentation, 2026. link
- J. Yosinski, J. Clune, Y. Bengio and H. Lipson, “How transferable are features in deep neural networks?,” in Advances in Neural Information Processing Systems 27, 2014. link
- E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang and W. Chen, “LoRA: Low-rank adaptation of large language models,” in Proc. ICLR, 2022. arXiv
- J. Howard and S. Ruder, “Universal language model fine-tuning for text classification,” in Proc. ACL, 2018. doi
- A. Kumar, A. Raghunathan, R. Jones, T. Ma and P. Liang, “Fine-tuning can distort pretrained features and underperform out-of-distribution,” in Proc. ICLR, 2022. arXiv
- C. Zhang, S. Bengio, M. Hardt, B. Recht and O. Vinyals, “Understanding deep learning requires rethinking generalization,” in Proc. ICLR, 2017. arXiv
- R. Geirhos, J.-H. Jacobsen, C. Michaelis, R. Zemel, W. Brendel, M. Bethge and F. A. Wichmann, “Shortcut learning in deep neural networks,” Nature Machine Intelligence, vol. 2, 2020. doi
- PyTorch contributors, “Reproducibility,” PyTorch 2.15 documentation, 2026. link
- Y. Xin, J. Yang, S. Luo, Y. Du, Q. Qin, K. Cen, Y. He, Z. Zhang, B. Fu, X. Yang, G. Zhai, M.-H. Yang and X. Liu, “Parameter-efficient fine-tuning for pre-trained vision models: A survey and benchmark,” arXiv:2402.02242, 2024. arXiv
- G. E. Dahl, F. Schneider, Z. Nado, N. Agarwal, C. S. Sastry, P. Hennig, S. Medapati, R. Eschenhagen, P. Kasimbeg, D. Suo et al., “Benchmarking neural network training algorithms,” arXiv:2306.07179, 2023. arXiv
- P. Kasimbeg, F. Schneider, R. Eschenhagen, J. Bae, C. S. Sastry, M. Saroufim, B. Feng, L. Wright, E. Z. Yang, Z. Nado, S. Medapati, P. Hennig, M. Rabbat and G. E. Dahl, “Accelerating neural network training: An analysis of the AlgoPerf competition,” in Proc. ICLR, 2025. arXiv
- A. Defazio, X. A. Yang, H. Mehta, K. Mishchenko, A. Khaled and A. Cutkosky, “The road less scheduled,” in Advances in Neural Information Processing Systems 37, 2024. link
- S. Hu, Y. Tu, X. Han, C. He, G. Cui, X. Long, Z. Zheng, Y. Fang, Y. Huang, W. Zhao et al., “MiniCPM: Unveiling the potential of small language models with scalable training strategies,” in Proc. Conference on Language Modeling (COLM), 2024. arXiv
- A. Hägele, E. Bakouch, A. Kosson, L. Ben Allal, L. Von Werra and M. Jaggi, “Scaling laws and compute-optimal training beyond fixed training durations,” in Advances in Neural Information Processing Systems 37, 2024. link
- M. Wortsman, G. Ilharco, J. W. Kim, M. Li, S. Kornblith, R. Roelofs, R. Gontijo Lopes, H. Hajishirzi, A. Farhadi, H. Namkoong and L. Schmidt, “Robust fine-tuning of zero-shot models,” in Proc. IEEE/CVF CVPR, 2022. doi
- M. Wortsman, G. Ilharco, S. Y. Gadre, R. Roelofs, R. Gontijo-Lopes, A. S. Morcos, H. Namkoong, A. Farhadi, Y. Carmon, S. Kornblith and L. Schmidt, “Model soups: Averaging weights of multiple fine-tuned models improves accuracy without increasing inference time,” in Proc. ICML, PMLR 162, 2022. link
- PyTorch contributors, “Automatic mixed precision examples,” PyTorch 2.15 documentation, 2026. link
- PyTorch contributors, “DistributedDataParallel,” PyTorch 2.15.0 source documentation, 2026. Official source.
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 01B・網路的積木與組合:分類與影像復原網路 · 38 分鐘