DLCV 01C・模型壓縮與高效推論
先備知識:DLCV 01A・深度視覺模型的訓練實務、DLCV 01B・網路的積木與組合:分類與影像復原網路
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分模型大小、運算量、記憶體流量、延遲與吞吐量。
- 比較非結構化、結構化與硬體支援的稀疏剪枝。
- 選擇量化尺度、校準方式,以及 PTQ 或 QAT。
- 說明蒸餾、低秩分解與高效率架構設計。
- 檢查任務敏感度,並在目標裝置量測匯出模型。
先看全貌
訓練好的網路,對於某個特定裝置上的某個特定工作,通常比需要的更大、更慢。模型壓縮(model compression)是一組在訓練之後(或訓練期間)移除這些多餘部分的技術,而高效推論(efficient inference)則是讓較小的模型在真實硬體上真的跑得更快的工程。兩者並不相同,這個領域裡大多數的失望都來自把它們混為一談。
為什麼重要。 大部分部署的視覺模型都在預算之下運作(手機相機、每秒 60 張影格的工廠產線、靠電池的機器人),壓縮決定了模型放不放得進這個預算。壓縮也會改變模型:量化或剪枝後的網路是另一個函數,可能在原本不會出錯的地方出錯。因此整章只有一條規則:在目標裝置上量測成本,並在部署資料上量測壓縮後的準確率。
基礎知識在哪裡。 本章建立在站內其他地方教過的內容上,並以連結取代重複:計算 FLOPs、記憶體帳、延遲協定、仿射量化公式與匯出執行環境,見 ML 11;帶溫度的 logit 蒸餾損失與經過測試的梯度檢查,見 DLCV 01 補充資料;深度可分離卷積與區塊成本,見 DLCV 02 與 DLCV 01B;偵測器的速度量測,見 DLCV 03A。這裡所有程式碼都只用 NumPy 與 scikit-learn,在 CPU 上幾秒就跑完,並使用 scikit-learn 內建的 digits 資料集或合成資料。我們程式碼產生的每一個準確率數字都是玩具結果,來自 8 × 8 像素的數字辨識任務;它說明的是一個機制,而不是真實視覺模型上效果的大小。
下表是本章的地圖。
| 技術 | 縮小什麼 | 需要什麼 | 速度可能從哪裡來 |
|---|---|---|---|
| 非結構化剪枝 | 非零權重的數量 | 微調;要稀疏核才跑得快 | 稀疏核,或受限於記憶體時的壓縮儲存 |
| 結構化剪枝 | 通道、注意力頭、區塊 | 微調 | 較小的稠密張量:任何執行環境都適用 |
| 量化 | 每個權重與激活值的位元數 | 校準資料,或量化感知訓練 | 整數或低精度核;搬動的位元組更少 |
| 蒸餾 | 架構(較小的學生) | 一個教師與一次訓練 | 學生在設計上就比較小 |
| 低秩分解 | 把一個大層拆成兩個細層 | 通常需要微調 | 乘加運算更少,前提是細層能有效率地執行 |
| 高效設計與搜尋 | 架構本身 | 搜尋或設計預算 | 依硬體挑選的區塊 |
「成本」是什麼意思
白話版。 壓縮前先確定受限資源:儲存空間、執行記憶體、延遲或吞吐量。參數或運算較少,不保證推論較快。
六個彼此不同的數字
描述執行一個網路要花多少成本的有六個數字:
- 參數量 :學習到的值的數量。每個值用 位元時,權重在磁碟與記憶體中占 位元組。剪枝與量化都會降低這個數字。
- 乘加運算(multiply–accumulate, MAC)或 FLOPs:每張影像的運算量。一次 MAC 是一次乘法加一次加法,通常算作 2 FLOPs;各函式庫的計算方式不一致,所以要寫明你回報的是哪一種。一個從 個通道到 個通道、輸出為 的 卷積,成本是 次 MAC(ML 11)。
- 記憶體流量(memory traffic):在主記憶體與運算單元之間搬動的位元組數。權重、輸入激活值與輸出激活值,至少都要被讀取或寫入一次。
- 尖峰記憶體(peak memory):一次前向傳遞中,同一時間存在的最大記憶體量(權重加上仍需要的激活值)。對高解析度的影像復原網路而言,它可能由激活值而不是權重主導。
- 延遲(latency):在目標裝置上,一個輸入從頭到尾的實際經過時間。相機管線或使用者感受到的就是這個。
- 吞吐量(throughput):許多影像一起處理時,每秒處理的影像數。大批次會提高吞吐量,但不會降低單張影像的延遲。
Dehghani 等人指出,這些成本指標可能互相矛盾,只回報其中一個,可能會對哪個模型比較有效率得出錯誤的結論 [1]。壓縮會讓這種不一致更嚴重,因為每種技術攻擊的是不同的數字:剪枝針對參數量與 MAC,量化針對位元組,而兩者都不會自動針對延遲。
運算強度與屋頂線
白話版。 層的速度可能受運算或記憶體存取限制;若瓶頸是資料搬移,減少計算的幫助有限。
精確版。 Williams、Waterman 與 Patterson 的屋頂線模型(roofline model)[2] 用下式限制一個計算可達到的速度:
其中 是裝置的尖峰運算速率(這裡以每秒 MAC 數計)、 是它的記憶體頻寬(每秒位元組數), 是該計算的運算強度(arithmetic intensity,每位元組的 MAC 數)。兩個上限交會處的強度 稱為脊點(ridge point):低於它時,該層受限於記憶體(memory-bound),高於它時則受限於運算(compute-bound)。單一層的簡單時間估計是
下面的程式碼把這個式子套用到一個虛構的加速器(4 TMAC/s、100 GB/s;真實裝置各不相同)上的幾個層,並假設每個權重、輸入與輸出值恰好各穿過記憶體一次。真實的核會重複利用快取並讓資料傳輸與運算重疊,所以這些數字只是理想化的示意。
程式碼 · Python · 25 行
# A made-up accelerator: 4 TMAC/s peak compute, 100 GB/s memory bandwidth.
PEAK_MACS, BANDWIDTH = 4e12, 100e9

def layer(kind, C=64, H=56, W=56, batch=1):
    """MACs and bytes moved, if weights, inputs and outputs each cross memory once."""
    if kind == "conv 3x3":
        weights, macs = 9 * C * C, 9 * C * C * H * W
    elif kind == "depthwise 3x3":
        weights, macs = 9 * C, 9 * C * H * W
    elif kind == "pointwise 1x1":
        weights, macs = C * C, C * C * H * W
    elif kind == "linear 2048x2048":
        weights, macs, C, H, W = 2048 * 2048, 2048 * 2048, 2048, 1, 1
    acts = 2 * C * H * W                                  # one input and one output tensor
    return batch * macs, weights + batch * acts

for kind, batch, nbytes in [("conv 3x3", 1, 4), ("depthwise 3x3", 1, 4), ("pointwise 1x1", 1, 4),
                            ("depthwise 3x3", 1, 1), ("linear 2048x2048", 1, 4), ("linear 2048x2048", 64, 4)]:
    macs, values = layer(kind, batch=batch)
    traffic = values * nbytes
    t_compute, t_memory = macs / PEAK_MACS, traffic / BANDWIDTH
    bound = "compute" if t_compute > t_memory else "memory"
    print(f"{kind:17s} batch {batch:2d} {8 * nbytes:2d}-bit: {macs / 1e6:7.1f} M MACs, "
          f"{macs / traffic:5.1f} MACs/byte, ~{max(t_compute, t_memory) * 1e6:6.1f} us ({bound}-bound)")
print(f"ridge point: {PEAK_MACS / BANDWIDTH:.0f} MACs/byte")
輸出:
程式碼 · 7 行
conv 3x3          batch  1 32-bit:   115.6 M MACs,  65.9 MACs/byte, ~  28.9 us (compute-bound)
depthwise 3x3     batch  1 32-bit:     1.8 M MACs,   1.1 MACs/byte, ~  16.1 us (memory-bound)
pointwise 1x1     batch  1 32-bit:    12.8 M MACs,   7.9 MACs/byte, ~  16.2 us (memory-bound)
depthwise 3x3     batch  1  8-bit:     1.8 M MACs,   4.5 MACs/byte, ~   4.0 us (memory-bound)
linear 2048x2048  batch  1 32-bit:     4.2 M MACs,   0.2 MACs/byte, ~ 167.9 us (memory-bound)
linear 2048x2048  batch 64 32-bit:   268.4 M MACs,  15.1 MACs/byte, ~ 178.3 us (memory-bound)
ridge point: 40 MACs/byte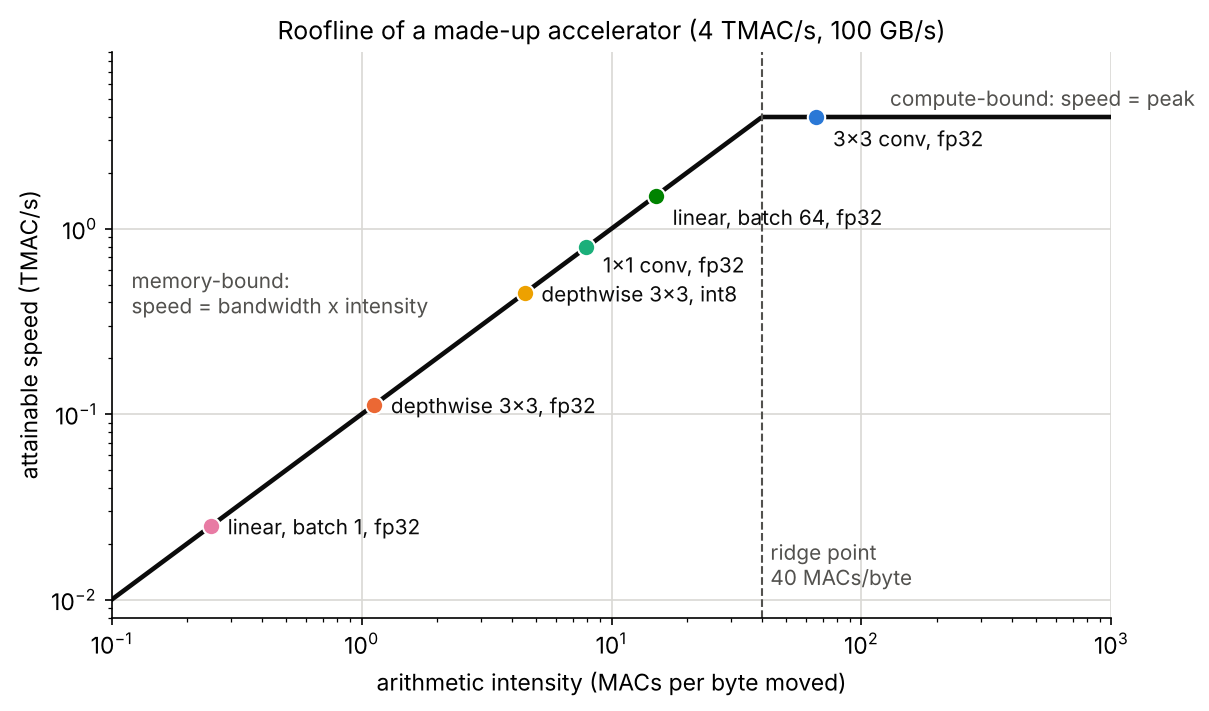
後面會反覆出現三個教訓。第一,深度卷積層的 MAC 比稠密的 卷積少 64 倍,估計卻只快了約 1.8 倍,因為它受限於記憶體(這就是 DLCV 01B 中「MAC 不等於延遲」這項警告背後的算術)。第二,把那一層改用 8 位元而不是 32 位元儲存,估計時間縮短為 1/4,而一個 MAC 都沒有變:對受限於記憶體的層,量化的好處來自搬動更少的位元組。第三,批次 64 的線性層做的工作是批次 1 的 64 倍,花的時間卻差不多,因為它的權重只讀一次就重複使用,所以大批次的吞吐量幾乎說明不了批次 1 的延遲。
誠實地量測
請遵循 ML 11 的延遲協定(固定並回報裝置、執行環境、精度、批次大小、解析度與執行緒數;暖機;百分位數;在 GPU 上同步),以及 DLCV 03A 的端到端檢查清單。壓縮另外多了三條自己的規則:
- 與公平的稠密基準比較:一個大小相同、用相同預算訓練的稠密模型。Liu 等人發現,在他們檢驗的結構化剪枝方法中,從頭訓練剪枝後的架構,表現持平或優於微調剪枝後的權重 [3];Blalock 等人回顧了 81 篇剪枝論文,發現基準與指標不一致,使大多數比較無從進行 [4]。
- 在匯出之後、在你實際出貨的執行環境上量測準確率。 匯出、量化、融合後的計算圖,在數值上是和你訓練的不同的程式。
- 回報取捨曲線,而不是單一個點。 在幾種壓縮程度下,準確率對延遲(與記憶體)的曲線,才能顯示一個方法是移動了整條曲線,還是只是在曲線上挑了另一個點。
剪枝
白話版。 剪枝移除選定權重或通道。零散零值需稀疏核心才能加速;移除通道會縮小稠密運算,但延遲仍須實測。
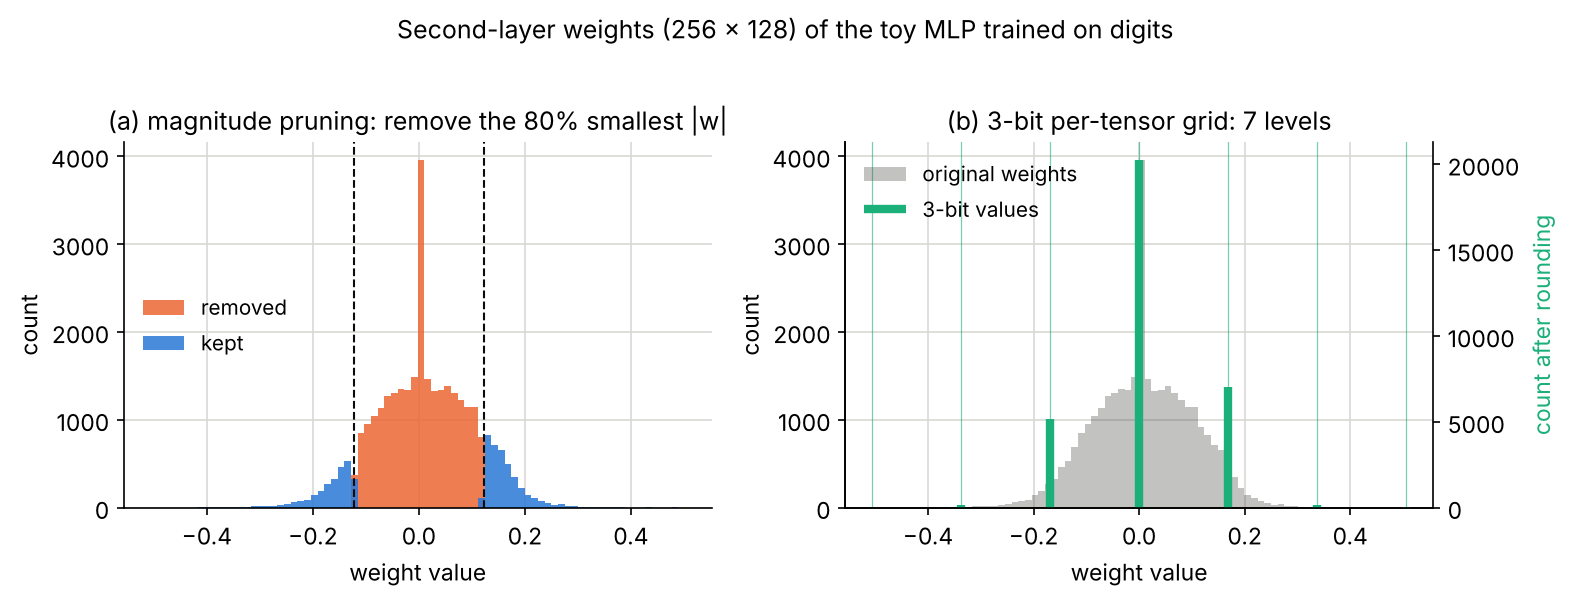
移除什麼
把網路的參數寫成向量 。剪枝選擇一個二元遮罩(mask),並用 取代 ,其中 是逐元素相乘。稀疏度(sparsity)是零所占的比例,
其中 計算遮罩中非零項的個數。各種方法的差別在於遮罩的粒度:
- 非結構化(細粒度):任何單一權重都可以被移除。這在選擇移除什麼上有最大的自由度,但結果是一個形狀仍為稠密、卻充滿零星零的張量。Li 等人指出,除非有稀疏卷積函式庫,這種不規則的稀疏並不會大幅降低卷積層的成本 [5]。
- 結構化(粗粒度):整個濾波器、通道、注意力頭或區塊被移除。移除一個卷積的輸出通道 ,也會移除下一層的輸入通道 ,所以兩個張量都縮小,而且仍是稠密的。Li 等人正是因為這個原因,把整個濾波器連同與它相連的特徵圖一起剪掉:結果可以用一般的稠密矩陣函式庫執行 [5]。
- 半結構化:硬體可以利用的固定小樣式。NVIDIA 的稀疏 Tensor Core 支援 2:4 稀疏,也就是每連續四個權重中至少有兩個零;該論文報告這種樣式的數學吞吐量是稠密單元的兩倍 [6]。
選讀:N:M 半結構化稀疏(見「補充資料」頁)。2:4 的權重如何儲存、訓練—剪枝—重新訓練的流程,以及用 NumPy 檢查這種樣式比非結構化剪枝多損失多少權重量值。
該移除哪些權重:量值與其他準則
最簡單、至今仍最常用的準則是量值(magnitude):移除 最小的權重。它可以逐層套用(每層移除相同比例)或全域套用(整個網路用同一個閾值;小權重多的層因此損失較多)。對結構化剪枝,則改用一組權重的量值:Li 等人用每個濾波器的絕對權重和( 範數)為濾波器排名 [5]。Network slimming 在訓練時對批次正規化層的尺度因子 加上 懲罰,把不重要通道的尺度推向零,然後移除 最小的通道 [7]。還有許多其他準則(以梯度為基礎、二階的、以資料為基礎的);Hoefler 等人對它們做了綜述 [8]。
結構化剪枝有一個非結構化剪枝沒有的陷阱:耦合的通道,例如殘差相加兩側的通道,它們必須一起被移除。Fang 等人的 DepGraph 可以從計算圖自動找出這類群組 [9]。
選讀:剪枝耦合的通道(見「補充資料」頁)。殘差相加、深度層、串接與注意力頭的相依規則,並以小例子逐一走過。
剪枝、微調、再重複
移除權重會改變函數,所以剪枝之後要接著訓練。Han 等人描述了標準的三步驟配方:訓練網路以學出哪些連接重要、剪掉不重要的連接,並重新訓練剩下的權重;他們在 ImageNet 上報告,把 AlexNet 的參數從 6,100 萬降到 670 萬、把 VGG-16 的從 1.38 億降到 1,030 萬,而準確率沒有下降 [10]。他們的 Deep Compression 流程又在剪枝之上加入量化與 Huffman 編碼 [11]。
剪枝常被分成幾個較小的步驟,每一步之後都做一些訓練,而不是一次大幅砍掉。Zhu 與 Gupta 的漸進式排程,在訓練期間把稀疏度從零升到目標值,一開始升得快,接近尾聲時升得慢 [12]。他們也比較了記憶體占用相同的大而稀疏模型與小而稠密模型,發現在他們測試的各種架構上,大而稀疏的模型一致地更準確 [12]。
選讀:漸進式剪枝排程(見「補充資料」頁)。三次方的稀疏度公式與每個符號的定義、一個走過的排程範例,以及它留給你決定的選擇。
程式碼:小型 MLP 的非結構化與結構化剪枝
這段程式碼先在 scikit-learn 的 digits 上訓練一個 64–256–128–10 的 MLP,再用兩種方式剪枝:移除每一層最小的權重,以及移除整個隱藏單元(傳入權重的 範數最小者,兩個隱藏層都做)。每個剪枝後的模型都微調 10 個 epoch,並在每一步最佳化器更新之後重新套用遮罩。最後,把剪得最多的結構化模型切成一個真正更小的稠密網路。
程式碼 · Python · 56 行
import copy, warnings
import numpy as np
from sklearn.datasets import load_digits
from sklearn.exceptions import ConvergenceWarning
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier
warnings.filterwarnings("ignore", category=ConvergenceWarning)

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(X / 16.0, y, test_size=0.3, random_state=0, stratify=y)
base = MLPClassifier(hidden_layer_sizes=(256, 128), max_iter=300, random_state=0).fit(Xtr, ytr)
print(f"dense: {sum(w.size for w in base.coefs_)} weights, test accuracy {base.score(Xte, yte):.3f}")

def fine_tune(net, masks, epochs=10):
    order_rng = np.random.default_rng(0)
    for _ in range(epochs):
        order = order_rng.permutation(len(Xtr))
        for i in range(0, len(Xtr), 128):
            net.partial_fit(Xtr[order[i:i + 128]], ytr[order[i:i + 128]])   # one Adam step
            for w, m in zip(net.coefs_, masks):
                w *= m                                                     # keep pruned weights at zero

def unstructured_masks(net, sparsity):          # smallest |w| in each layer -> 0
    return [np.abs(w) > np.quantile(np.abs(w), sparsity) for w in net.coefs_]

def structured_masks(net, keep):                # drop hidden units with the smallest L1 norm of incoming weights
    masks = [np.ones_like(w) for w in net.coefs_]
    for l in range(len(net.coefs_) - 1):
        norms = np.abs(net.coefs_[l]).sum(axis=0)
        dead = np.argsort(norms)[: int(round((1 - keep) * norms.size))]
        masks[l][:, dead] = 0                   # incoming weights of the unit ...
        masks[l + 1][dead, :] = 0               # ... and its outgoing weights
    return masks

for name, make, levels in [("remove weights", unstructured_masks, [0.8, 0.9, 0.95]),
                           ("keep units", structured_masks, [0.5, 0.25, 0.125])]:
    for level in levels:
        net = copy.deepcopy(base)
        masks = make(net, level)
        for w, m in zip(net.coefs_, masks):
            w *= m
        before = net.score(Xte, yte)
        fine_tune(net, masks)
        kept = int(sum(m.sum() for m in masks))
        print(f"{name} {level:6.1%}: {kept:5d} weights left, "
              f"accuracy {before:.3f} -> {net.score(Xte, yte):.3f} after fine-tuning")

# The last structured model is a genuinely smaller dense network: slice out the live units.
alive = [masks[l].any(axis=0) for l in range(2)]
small_W = [net.coefs_[0][:, alive[0]], net.coefs_[1][alive[0]][:, alive[1]], net.coefs_[2][alive[1]]]
small_b = [net.intercepts_[0][alive[0]], net.intercepts_[1][alive[1]], net.intercepts_[2]]
h = Xte
for l, (w, b) in enumerate(zip(small_W, small_b)):
    h = h @ w + b if l == 2 else np.maximum(h @ w + b, 0)
print("sliced shapes:", [w.shape for w in small_W],
      "| same predictions:", bool((h.argmax(1) == net.predict(Xte)).all()))
輸出(玩具結果):
程式碼 · 8 行
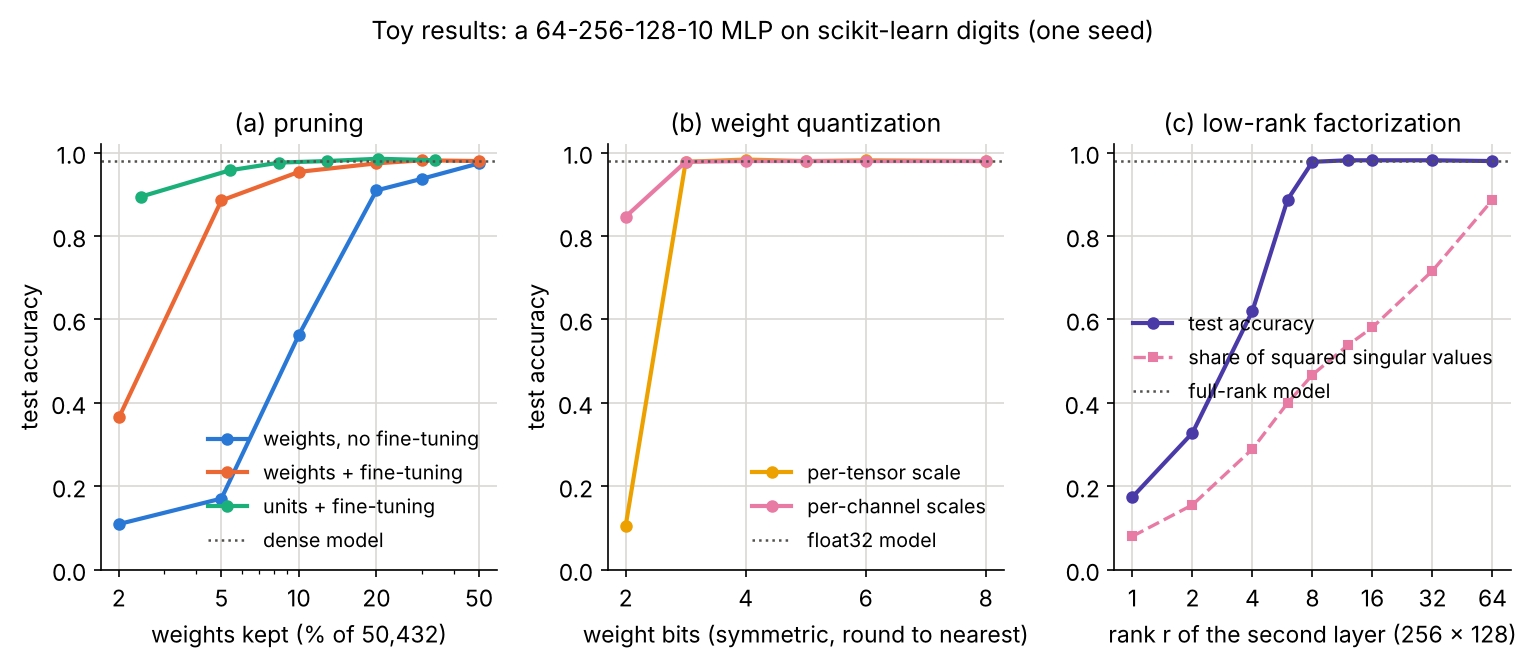
dense: 50432 weights, test accuracy 0.980
remove weights  80.0%: 10087 weights left, accuracy 0.909 -> 0.974 after fine-tuning
remove weights  90.0%:  5044 weights left, accuracy 0.563 -> 0.954 after fine-tuning
remove weights  95.0%:  2523 weights left, accuracy 0.170 -> 0.885 after fine-tuning
keep units  50.0%: 17024 weights left, accuracy 0.887 -> 0.981 after fine-tuning
keep units  25.0%:  6464 weights left, accuracy 0.550 -> 0.980 after fine-tuning
keep units  12.5%:  2720 weights left, accuracy 0.402 -> 0.957 after fine-tuning
sliced shapes: [(64, 32), (32, 16), (16, 10)] | same predictions: True從中能讀到什麼。微調做了大部分的工作:移除 90% 的權重會讓準確率掉到 0.563,十個 epoch 就把它帶回 0.954。結構化剪枝產生了一個真正的網路,形狀為 64–32–16–10,任何函式庫都能把它當成一般稠密矩陣來執行。而在剩下約 2,500 個權重時,小的稠密網路(0.957)勝過大的稀疏網路(0.885),這與 Zhu 與 Gupta 在大型模型上的發現相反 [12]:我們的網路對 8 × 8 的數字任務來說參數過多,讓它變窄幾乎沒有代價。不要從這個玩具往任一方向推論。
樂透彩券假說
白話版。 如果剪枝後的網路可以這麼小,為什麼不直接訓練小網路?Frankle 與 Carbin 發現,在他們的實驗中,隨機重新初始化的剪枝網路訓練效果較差,但同一個稀疏網路若重設回它原本的初始權重,訓練效果就和完整網路一樣好。他們提出,大型網路從一開始就含有這種幸運的稀疏子網路(「中獎彩券」,winning tickets)。
這些彩券是用反覆量值剪枝找到的:訓練、剪掉量值最小的權重、把留下的權重重設為初始值,然後重複;在小型 MNIST 與 CIFAR-10 網路上,這個做法一致地找到了只有原本大小 10–20% 或更小的彩券 [13]。在 ImageNet 的規模上,權重必須重設為訓練早期的值,而不是初始化時的值 [14];Liu 等人則報告,在學習率調得好的情況下,他們的實驗中使用彩券初始化並沒有比隨機初始化更好 [3]。實務上的教訓並不誇張:這個假說談的是哪些稀疏網路是可訓練的,而不是更便宜的壓縮方法(找一張彩券要花好幾次完整訓練)。
選讀:樂透彩券假說(Frankle 與 Carbin,ICLR 2019)(見「論文導讀」頁)。實驗控制了什麼、如何讀提早停止的圖,以及這項主張的限制。
量化
白話版。 用 32 位元浮點數訓練的網路,並不需要那麼高的精度才能做出好的預測。量化(quantization)把權重(通常還有激活值)存成小整數(8 位元,有時是 4 位元),並搭配少數幾個尺度因子。這能讓記憶體減少 4 到 8 倍,在有整數運算的硬體上還能加速計算。困難在於,一個小格點必須同時涵蓋大量的小數字與少數非常大的數字。
均勻仿射量化
這是最常見的方案,因為它允許有效率的定點運算 [15],它把實數值 映射成整數 ,再映射回來 [16]:
其中 是尺度(scale,相鄰可表示值之間的間距), 是整數零點(zero point,精確表示實數 0 的那個整數), 是 位元格式的整數範圍(例如無號 8 位元是 ,對稱有號格式是 ), 是四捨五入到最近的整數, 是夾進範圍內, 是 經過反量化後的近似值。對於包含 0 的實數範圍 ,常見的選擇是
對稱量化固定 並使用有號範圍。精確表示 0 很重要,因為零填補與 ReLU 的輸出會產生許多精確的零 [15]。會出現兩種誤差:範圍內的值有捨入誤差,最多 ;範圍外的值有截斷誤差。範圍越大,截斷越少,但 變大,捨入誤差也隨之變大 [15]。ML 11 有經過測試的實作與誤差對位元數的曲線。
為什麼整數核可以把尺度提到外面
白話版。 只有在一層最昂貴的部分,也就是那一長串乘積之和,能完全用整數執行時,整數才有用。如果每個權重列有一個尺度、每個激活張量有一個尺度,這些尺度就可以從和裡面提出來,只在最後套用一次。
對線性層的一個輸出 (卷積是對一個區塊做同樣的和),把權重以每個輸出通道一個尺度 做對稱量化,,並把輸入以尺度 與零點 做仿射量化,。於是
其中的和只涉及整數,並在 32 位元整數暫存器中累加;單一個乘積 對每個輸出只套用一次。這就是為什麼權重的逐通道尺度很便宜(每個輸出通道一個因子),而激活值的逐通道尺度卻不便宜:它們會落在和的裡面,每個輸入通道都需要重新縮放累加器 [15]。這也是為什麼常見的選擇是對稱的權重加上非對稱的激活值:非對稱的權重零點會為每個輸出加上一個與資料相關的項 [15]。偏置通常保留為 32 位元整數 [16]。
程式碼 · Python · 24 行
import numpy as np

rng = np.random.default_rng(0)
W = rng.normal(0, 0.2, size=(16, 256))              # a layer: 16 outputs, 256 inputs
x = rng.normal(0.3, 1.0, size=256)                  # input activations (not centred at 0)

# Weights: symmetric int8, one scale per output channel (zero point 0).
s_w = np.abs(W).max(axis=1) / 127
W_q = np.round(W / s_w[:, None]).astype(np.int8)

# Activations: affine uint8 with a scale and an integer zero point.
lo, hi = min(x.min(), 0.0), x.max()
s_x = (hi - lo) / 255
z_x = int(np.round(-lo / s_x))
x_q = np.clip(np.round(x / s_x) + z_x, 0, 255).astype(np.uint8)
print("activation scale:", round(s_x, 5), "| zero point:", z_x)

# Integer-only inner products, accumulated in int32, then one rescale per output.
acc = W_q.astype(np.int32) @ (x_q.astype(np.int32) - z_x)
y_int = s_w * s_x * acc
y_ref = W @ x
print("max |integer result - float result|:", np.abs(y_int - y_ref).max().round(4))
print("relative error:", (np.linalg.norm(y_int - y_ref) / np.linalg.norm(y_ref)).round(4))
print("largest |accumulator|:", np.abs(acc).max(), "| int16 limit:", 2**15 - 1)
輸出:
程式碼 · 4 行
activation scale: 0.01967 | zero point: 117
max |integer result - float result|: 0.0495
relative error: 0.0083
largest |accumulator|: 83167 | int16 limit: 32767
整數路徑重現浮點結果,誤差在約 1% 以內。累加器達到 83,167,遠超過 16 位元能容納的範圍,這就是為什麼即使輸入是 8 位元,加速器仍使用 32 位元累加器 [15]。在進入下一層之前,32 位元的結果會用下一層的尺度轉回 8 位元(「重新量化」,requantization)。
選讀:用定點乘數重新量化(見「補充資料」頁)。Jacob 等人如何把合併後的實數尺度變成一次整數乘法加一次位元位移,讓推論時不留下任何浮點運算。
粒度與範圍設定
粒度(granularity)是有多少個值共用一個尺度:每個張量一個、每個輸出通道一個,或每一小組連續權重一個。粒度越細,格點越能貼合每一組自己的範圍。範圍設定(range setting,也稱校準)是 的選擇方式 [15]:
- Min-max:觀察到的最小值與最大值。沒有截斷,但一個離群值就會把所有人的格點拉寬。
- 百分位數:忽略一小部分最極端的值。
- MSE:在具代表性的資料上,搜尋使 最小的範圍,在截斷與捨入之間取捨。
權重事先已知,不需要資料。激活值取決於輸入,所以它們的範圍是靠讓一小份未標註的校準集(calibration set)影像跑過網路來估計;Nagel 等人指出,500 到 1,000 張未標註影像通常就夠了 [15]。
選讀:選擇截斷範圍:min-max、百分位數與 MSE(見「補充資料」頁)。一個經過測試的比較,顯示最佳規則會隨位元寬度改變:8 位元時保留離群值,4 位元時截斷它們。
什麼會壞掉:離群值、折疊後的批次正規化與激活值
白話版。 當一個共用的尺度必須涵蓋大小差異極大的值時,量化就會失敗。大的值迫使格點變粗,而大量的小值全都被捨入到少數幾個整數。
典型的視覺例子是 MobileNetV2。Nagel 等人指出,它的一個深度可分離層中,不同輸出通道的權重範圍差異極大,以致一組量化參數無法服務整個張量;在折疊批次正規化並使用 8 位元逐張量量化時,他們的模型在 ImageNet 上的 top-1 準確率從 71.72% 掉到 0.12% [17]。他們的解法不需要資料或訓練:因為 時 ,所以可以把一層的某個輸出通道縮小,同時把下一層對應的輸入通道放大,函數不會改變(跨層均衡化,cross-layer equalization)。在把 ReLU6 換成具有這個性質的 ReLU 之後,均衡化加上偏置吸收,讓模型在 8 位元下達到 70.92% [17]。
我們的玩具重現了這個機制。我們取訓練好的 MLP,把一個隱藏單元放大 100 倍(並把下一層的權重縮小為 1/100)。浮點網路計算的仍是完全相同的函數,但它的激活值與權重範圍現在含有一個巨大的通道。
程式碼 · Python · 48 行
import warnings
import numpy as np
from sklearn.datasets import load_digits
from sklearn.exceptions import ConvergenceWarning
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier
warnings.filterwarnings("ignore", category=ConvergenceWarning)

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(X / 16.0, y, test_size=0.3, random_state=0, stratify=y)
net = MLPClassifier(hidden_layer_sizes=(256, 128), max_iter=300, random_state=0).fit(Xtr, ytr)

def q_weight(w, bits, per_channel):     # symmetric: one scale per output unit, or one per tensor
    qmax = 2 ** (bits - 1) - 1
    m = np.abs(w).max(axis=0, keepdims=True) if per_channel else np.abs(w).max()
    return np.clip(np.round(w * qmax / m), -qmax, qmax) * m / qmax

def q_act(a, hi, bits):                 # post-ReLU activations: grid on [0, hi], zero point 0
    s = hi / (2 ** bits - 1)
    return np.clip(np.round(a / s), 0, 2 ** bits - 1) * s

def run(Ws, bs, X, wbits=None, abits=None, his=None, per_channel=True, record=None):
    h = X
    for l, (w, b) in enumerate(zip(Ws, bs)):
        h = h @ (q_weight(w, wbits, per_channel) if wbits else w) + b
        if l < len(Ws) - 1:
            h = np.maximum(h, 0)
            if record is not None:
                record.append(h)
            if abits:
                h = q_act(h, his[l], abits)
    return h

acc = lambda logits: (logits.argmax(1) == yte).mean()
for c in [1, 100]:
    Ws = [w.copy() for w in net.coefs_]
    bs = [b.copy() for b in net.intercepts_]
    Ws[0][:, 0] *= c; bs[0][0] *= c; Ws[1][0, :] /= c   # same function: ReLU(c*t) = c*ReLU(t)
    calib = []
    run(Ws, bs, Xtr[:100], record=calib)                 # 100 training images calibrate the ranges
    minmax = [a.max() for a in calib]
    pct99 = [np.percentile(a, 99) for a in calib]
    print(f"unit 0 scaled by {c}: float {acc(run(Ws, bs, Xte)):.3f} | "
          f"W8A8 {acc(run(Ws, bs, Xte, 8, 8, minmax)):.3f} | "
          f"W8A4 {acc(run(Ws, bs, Xte, 8, 4, minmax)):.3f} | "
          f"W8A4 clipped {acc(run(Ws, bs, Xte, 8, 4, pct99)):.3f} | "
          f"W4 per-tensor {acc(run(Ws, bs, Xte, 4, per_channel=False)):.3f} | "
          f"W4 per-channel {acc(run(Ws, bs, Xte, 4)):.3f}")
輸出(玩具結果;「W8A4」表示 8 位元權重與 4 位元激活值):
程式碼 · 2 行
unit 0 scaled by 1: float 0.980 | W8A8 0.980 | W8A4 0.978 | W8A4 clipped 0.978 | W4 per-tensor 0.983 | W4 per-channel 0.980
unit 0 scaled by 100: float 0.980 | W8A8 0.980 | W8A4 0.163 | W8A4 clipped 0.980 | W4 per-tensor 0.102 | W4 per-channel 0.978
兩個網路是同一個函數,但有了一個離群通道,4 位元 min-max 的激活值就崩潰到 0.163,4 位元逐張量的權重崩潰到 0.102。把激活值範圍在第 99 百分位數截斷(0.980),以及使用逐單元的權重尺度(0.978),都能解決。這裡截斷剛好不花任何代價;當離群通道攜帶真正的資訊時就會有代價,這就是為什麼會有移動或隔離離群值的方法。
同樣的模式在更大的規模上,推動了 Transformer 的量化研究:Dettmers 等人在大型語言模型中發現系統性的離群特徵維度,並把它們保留在 16 位元 [18],而 SmoothQuant 用等價的逐通道重新縮放,把難度從激活值轉移到權重,與跨層均衡化屬於同一類想法 [19]。
訓練後量化與量化感知訓練
白話版。 你可以只用一點校準資料就量化一個已完成的模型(快、不需要標籤),或者在訓練模型的同時讓它「感受」到捨入,讓它學到能經得起捨入的權重(慢一些,但在低位元寬度下更準確)。
訓練後量化(post-training quantization, PTQ)取一個訓練好的浮點模型,只用一小份校準集來轉換。Nagel 等人建議的流程是:跨層均衡化;對稱的權重量化器與非對稱的激活量化器(若硬體支援,權重逐通道);以 MSE 為基礎的權重範圍;然後在有校準資料時使用 AdaRound(學習每個權重該向上還是向下捨入 [20]),否則使用解析式的偏置校正;最後設定激活值範圍 [15]。
量化感知訓練(quantization-aware training, QAT)在前向傳遞中插入「偽量化」(先量化、再立刻反量化),並照常訓練。困難在於 幾乎處處梯度為零。直通估計器(straight-through estimator, STE)[21] 在反向傳遞中把捨入視為恆等映射。對於對稱量化器 ,這給出
所以梯度會原封不動地通過範圍內的值,並在被截斷的值處停止 [15]。被更新的是浮點的「影子」權重,而前向傳遞永遠使用它們量化後的版本。
何時用哪一種:在白皮書的實驗中,PTQ 足以處理 8 位元的權重與激活值(所有測試的模型都在浮點結果的 0.7% 以內),而更低的位元寬度,特別是 4 位元激活值,就需要 QAT;使用深度可分離層的網路,即使做了 QAT 仍然是最難的 [15]。
選讀:超越四捨五入:AdaRound、BRECQ 與 LSQ(見「補充資料」頁)。三項改進:學習每個權重該向上或向下捨入、重建整個區塊,以及在 QAT 中學習尺度本身。
混合精度與其他數字格式
並非所有層都同樣敏感,所以混合精度量化(mixed-precision quantization)讓不同的層使用不同的位元寬度:HAWQ 根據二階(Hessian)資訊選擇 [22],HAQ 則根據硬體模擬器回饋的延遲與能耗,並發現邊緣與雲端加速器的最佳策略並不相同 [23]。整數不是唯一的選擇:8 位元浮點編碼(E4M3 與 E5M2)[24] 把位元花在指數上,能容忍更寬的數量級範圍,代價是步階更少。
不要把這和混合精度訓練(DLCV 01A)混淆,後者保留一份 32 位元的權重主副本,並用 16 位元計算以加快訓練。混合精度量化談的是部署後的模型。
知識蒸餾
白話版。 訓練一個小的學生(student)去模仿大的教師(teacher),而不只是模仿正確的標籤。教師的完整輸出(它認為哪些錯誤類別也有可能)以及它的中間特徵,每個範例帶有的資訊比一個標籤更多,所以學生從同樣的影像可以學到更多。
Hinton 等人帶溫度 與 因子的回應式損失,已在 DLCV 01 補充資料中推導並測試,並在 ML 11 中摘要 [25];這裡不重複。用一行來說:學生最小化 ,其中 與 分別是學生與教師的 logits, 是標籤, 是 softmax, 是交叉熵, 是軟項的權重。Hinton 等人指出,像 Ba 與 Caruana 那樣用 L2 損失迴歸 logits 來匹配它們 [26],是這個損失在高溫下的極限 [25]。
程式碼:把玩具 MLP 蒸餾成 8 單元的學生
教師是剪枝程式碼中那個有 50,432 個權重的 MLP。學生只有一個含 8 個單元的隱藏層(592 個權重),用全批次梯度下降訓練:一次只用標籤,兩次使用蒸餾損失。
程式碼 · Python · 43 行
import warnings
import numpy as np
from sklearn.datasets import load_digits
from sklearn.exceptions import ConvergenceWarning
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier
warnings.filterwarnings("ignore", category=ConvergenceWarning)

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(X / 16.0, y, test_size=0.3, random_state=0, stratify=y)
teacher = MLPClassifier(hidden_layer_sizes=(256, 128), max_iter=300, random_state=0).fit(Xtr, ytr)
h = Xtr
for l, (w, b) in enumerate(zip(teacher.coefs_, teacher.intercepts_)):   # teacher logits
    h = h @ w + b if l == 2 else np.maximum(h @ w + b, 0)
z_teacher = h

def softmax(z, T=1.0):
    e = np.exp((z - z.max(axis=1, keepdims=True)) / T)
    return e / e.sum(axis=1, keepdims=True)

def train_student(T, alpha, hidden=8, steps=500, lr=0.2, seed=0):
    """64 -> 8 -> 10 ReLU network, full-batch gradient descent on the distillation loss."""
    rng = np.random.default_rng(seed)
    W1, b1 = rng.normal(0, np.sqrt(2 / 64), (64, hidden)), np.zeros(hidden)
    W2, b2 = rng.normal(0, np.sqrt(1 / hidden), (hidden, 10)), np.zeros(10)
    Y, p_T = np.eye(10)[ytr], softmax(z_teacher, T)
    for _ in range(steps):
        a = np.maximum(Xtr @ W1 + b1, 0)
        z = a @ W2 + b2
        # gradient of (1-alpha)*CE(y, softmax(z)) + alpha*T^2*CE(p_T, softmax(z/T)) w.r.t. z
        g = ((1 - alpha) * (softmax(z) - Y) + alpha * T * (softmax(z, T) - p_T)) / len(Xtr)
        ga = (g @ W2.T) * (a > 0)
        W2 -= lr * a.T @ g;  b2 -= lr * g.sum(0)
        W1 -= lr * Xtr.T @ ga; b1 -= lr * ga.sum(0)
    return (np.maximum(Xte @ W1 + b1, 0) @ W2 + b2).argmax(1)

print(f"teacher: {sum(w.size for w in teacher.coefs_)} weights, accuracy {teacher.score(Xte, yte):.3f}")
for T in (1, 4):
    print(f"mean top probability of the teacher on training images at T = {T}: "
          f"{softmax(z_teacher, T).max(axis=1).mean():.3f}")
for name, T, alpha in [("labels only", 1, 0.0), ("distill, T = 1", 1, 0.5), ("distill, T = 4", 4, 0.5)]:
    accs = [(train_student(T, alpha, seed=s) == yte).mean() for s in range(5)]
    print(f"student (592 weights), {name:14s}: accuracy {np.mean(accs):.3f} +/- {np.std(accs):.3f} over 5 seeds")
輸出(玩具結果):
程式碼 · 6 行
teacher: 50432 weights, accuracy 0.980
mean top probability of the teacher on training images at T = 1: 0.998
mean top probability of the teacher on training images at T = 4: 0.787
student (592 weights), labels only   : accuracy 0.936 +/- 0.025 over 5 seeds
student (592 weights), distill, T = 1: accuracy 0.936 +/- 0.025 over 5 seeds
student (592 weights), distill, T = 4: accuracy 0.954 +/- 0.006 over 5 seeds的蒸餾把學生的平均準確率從 0.936 提高到 0.954,並讓它對隨機種子的依賴小得多。 時則毫無改變,第二行說明了原因:在自己的訓練影像上,教師幾乎是確定的(平均最高機率 0.998),所以它的軟目標實際上就是標籤。溫度才是讓教師對錯誤類別的看法顯現出來的東西。這個效果很小,而且只適用於這個玩具;能遷移的是機制,不是數字。
特徵與注意力蒸餾
教師的中間表示也可以被模仿。FitNets 訓練一個細而深的學生,讓它的某個中間層(「被引導」層)經過一個小的學習式迴歸器(regressor)後,去預測教師的某個中間層(「提示」層);需要迴歸器,是因為兩個層的寬度不同,作者使用卷積迴歸器來讓它的大小保持在可控範圍 [27]。注意力轉移(attention transfer)模仿的是教師的特徵在哪裡活躍,而不是特徵本身:對特徵圖 ,它形成一張空間圖
其中 是通道 , 是指數(該論文也研究了 以及對通道取最大值),並訓練學生在多個深度上匹配教師經 正規化的圖 [28]。因為 沒有通道維度,教師與學生的寬度不需要一致。Gou 等人依傳遞的內容(回應、特徵、範例之間或層之間的關係)以及傳遞的方式(從固定教師離線、線上,或自蒸餾)來整理這個領域 [29]。
蒸餾有沒有用,取決於什麼
- 教師與學生必須看到相同的輸入。 Beyer 等人發現,當教師與學生拿到每張影像完全相同的擴增視角(「一致」的教學)、擴增很強,並且訓練時間很長(「有耐心」)時,蒸餾效果最好;不一致的設定在他們的實驗中停在較低的水準 [30]。
- 更好的教師不一定是更好的老師。 Cho 與 Hariharan 發現,更大、更準確的教師往往沒有產生更好的學生,他們把原因歸於容量不匹配,發現經由中等大小模型的多步蒸餾無效,並報告提早停止教師的訓練可以緩解這個問題 [31]。
- 蒸餾是一種訓練方法,不是對既有模型的壓縮:它需要一次訓練、資料,以及事先選定的學生架構。例如 DeiT 訓練視覺 Transformer 時,加了一個向卷積教師學習的蒸餾 token(DLCV 02)[32]。
低秩分解
白話版。 一個大的權重矩陣所含的資訊,往往比它的大小所暗示的少得多。把它寫成兩個細矩陣的乘積,就能把一個大層換成兩個小層,權重與運算都少很多。
任何 矩陣 都有奇異值分解 ,其中 ()與 ()的各行互相正交且長度為 1, 是對角矩陣,對角線上是奇異值 。保留最大的 個,就得到 Frobenius 範數下最佳的秩- 近似(ML 01A):
其中 是 的前 行, 是選定的秩(rank)。層 變成兩層 ,權重數為 而不是 ,只有當 時才會節省權重與 MAC。對於核為 的卷積,把它重塑成 的矩陣再分解: 變成有 個輸出通道的 卷積, 是回到 個通道的 卷積。Denton 等人利用卷積濾波器中這類線性結構,在 CPU 與 GPU 上把卷積層加速約兩倍,準確率差距在 1% 以內 [33];Jaderberg 等人建立了在空間域中秩為 1 的濾波器基底(一個 後接一個 的濾波器)[34];Zhang 等人把低秩加速擴展到用於分類與偵測的非常深的網路,其最小化的是每層非線性響應的重建誤差,而不是權重的重建誤差 [35]。
程式碼 · Python · 21 行
import warnings
import numpy as np
from sklearn.datasets import load_digits
from sklearn.exceptions import ConvergenceWarning
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier
warnings.filterwarnings("ignore", category=ConvergenceWarning)

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(X / 16.0, y, test_size=0.3, random_state=0, stratify=y)
net = MLPClassifier(hidden_layer_sizes=(256, 128), max_iter=300, random_state=0).fit(Xtr, ytr)
(W1, W2, W3), (b1, b2, b3) = net.coefs_, net.intercepts_

U, S, Vt = np.linalg.svd(W2, full_matrices=False)       # W2 is 256 x 128
energy = np.cumsum(S**2) / np.sum(S**2)
for r in [4, 8, 16, 32, 128]:
    A, B = U[:, :r] * S[:r], Vt[:r]                     # W2 ~ A @ B: a 256->r and an r->128 layer
    h = np.maximum(np.maximum(Xte @ W1 + b1, 0) @ A @ B + b2, 0)
    acc = ((h @ W3 + b3).argmax(1) == yte).mean()
    print(f"rank {r:3d}: {A.size + B.size:5d} weights instead of {W2.size} "
          f"({energy[r - 1]:.0%} of the squared singular values), accuracy {acc:.3f}")
輸出(玩具結果):
程式碼 · 5 行
rank   4:  1536 weights instead of 32768 (29% of the squared singular values), accuracy 0.620
rank   8:  3072 weights instead of 32768 (47% of the squared singular values), accuracy 0.978
rank  16:  6144 weights instead of 32768 (58% of the squared singular values), accuracy 0.981
rank  32: 12288 weights instead of 32768 (72% of the squared singular values), accuracy 0.981
rank 128: 49152 weights instead of 32768 (100% of the squared singular values), accuracy 0.980
秩 8 保留了準確率,所用的權重不到該層的十分之一,儘管它只保留了 47% 的奇異值平方。權重的 Frobenius 誤差並不是任務誤差的好指標:重要的是這一層對它實際看到的輸入做了什麼,這就是 Zhang 等人改為最小化響應誤差的原因 [35]。最後一行顯示了損益兩平規則:滿秩時分解後的形式權重比原本更多,因為 。把一層拆成兩層,還會為中間結果多出一次記憶體往返,所以在受限於記憶體的裝置上,延遲的節省會比 MAC 的節省小。
三個玩具並排看
一開始就設計得小
白話版。 與其在訓練後縮小一個大網路,你可以從一開始就選擇小而且對硬體友善的架構,不論是手工設計(高效率區塊)還是靠搜尋。實務上兩種做法會結合:設計良好的小網路再做量化,有時也做剪枝或蒸餾。
主要的手工設計家族在別處已經涵蓋,這裡只列出:深度可分離卷積與反向殘差(MobileNet [36]、MobileNetV2 [37];推導與成本見 DLCV 02 與 ML 03)、深度/寬度/解析度的複合縮放(EfficientNet [38];DLCV 02),以及逐區塊的成本算術(DLCV 01B)。本章開頭的屋頂線觀點,是看待這所有家族的正確鏡頭:一個區塊要在某個裝置上有效率,就要對那個裝置而言每位元組做足夠的運算,並且在那裡有快速的核。
重參數化:訓練時豐富,部署時簡單
結構重參數化(structural re-parameterization)訓練一個有數條平行線性分支的區塊,並在部署時把它們合併成一個卷積。RepVGG 訓練的區塊含有一個 卷積、一個 卷積與一條恆等分支,每個後面都接批次正規化,部署時則是由 卷積與 ReLU 組成的簡單堆疊 [39]。折疊的推導與數值檢查,見 DLCV 03A 補充資料;針對增強網路的版本,見 DLCV 09C 補充資料。
重參數化會與量化互相影響。YOLOv6 報告指出,由於大量使用重參數化區塊,先前的 PTQ 技術無法產生好的結果;在它的 1.0 版中,YOLOv6-S 在 8 位元 PTQ 下的 COCO val AP 從 42.4 掉到 35.0,使用 RepOptimizer 訓練後則回到 40.9,因為它縮窄了激活值的分布 [40]。合併後的核加進了範圍差異很大的分支,這正是逐張量量化處理得最差的情況。
神經架構搜尋
白話版。 神經架構搜尋(neural architecture search, NAS)讓演算法選擇層的類型、寬度與核大小,並以準確率來評分候選者,在考慮硬體的形式中,還以目標裝置上量測到的延遲來評分。
Elsken 等人用三項選擇描述每一種 NAS 方法:搜尋空間(允許哪些架構)、搜尋策略(如何提出候選者)與效能估計策略(如何在不完整訓練的情況下為候選者評分)[41]。三個想法對壓縮很重要:
- 權重共享讓搜尋負擔得起。 最早的強化學習方法是把每個被提出的架構分別訓練 [42];ENAS 讓所有候選者共享同一張大圖的權重 [43],DARTS 把離散的選擇鬆弛成連續的選擇並用梯度下降最佳化 [44],而 Once-for-All 訓練一個網路,從中取出不同深度、寬度、核大小與解析度的子網路給不同的裝置使用,不需要重新訓練 [45]。
- 針對量測到的延遲搜尋,而不是 FLOPs。 MnasNet 把在真實手機上量測到的延遲放進目標函數 [46];ProxylessNAS 直接在目標任務與硬體上搜尋 [47];FBNet 的可微分搜尋出於同樣的觀察:FLOPs 不一定反映延遲 [48]。
- 保留一個隨機基準。 Li 與 Talwalkar 發現,在他們使用的兩個基準上,帶提早停止的隨機搜尋至少和 ENAS 一樣好 [49]。
部署:從小模型到快模型
白話版。 壓縮後的模型,要等到編譯器或執行環境把它變成少數幾個大的融合運算,並有支援它的數字格式與稀疏樣式的核,才會變快。論文裡的速度宣稱,常假設了你的裝置沒有的支援。
運算子融合與批次正規化折疊
每個獨立的運算都會從記憶體讀入它的輸入,再把輸出寫回去。運算子融合(operator fusion)把連續的運算(卷積、偏置、批次正規化、激活函數)合併成一個核,讓中間結果留在快速的晶片內記憶體;從屋頂線的觀點來看,它藉由去掉記憶體往返來提高運算強度。最常見的融合是批次正規化折疊(batch-norm folding):推論時,帶有學習到的尺度 、平移 、累積平均 與變異數 的批次正規化 [50],對每個輸出通道 是一個仿射映射,所以可以被吸收進前一個卷積,
其中 與 是輸出通道 的核與偏置, 是一個很小的常數。經過測試的 NumPy 版本在 DLCV 03A 補充資料。對壓縮而言,請注意因子 :它在不同通道之間不一樣,所以折疊可能會把各通道的權重範圍拉開,這是 MobileNetV2 難以逐張量量化的原因之一 [17]。在裝置上,批次正規化是在量化之前折疊的,所以整數核看到的是折疊後的權重,而 QAT 必須正確地模擬折疊 [15]。
整數核與執行環境支援
只有當執行環境對計算圖中的每個運算都有整數(或低精度)核時,量化才會加速推論。ML 11 展示了一個純權重 int8 的模型,它小了四倍卻更慢,因為每次呼叫都要把權重轉回浮點。在真實部署中,要檢查:目標是否支援逐通道的權重尺度(不是所有硬體都支援 [15]);哪些運算子退回浮點(每次退回都會多一次反量化與量化);以及執行環境是否讓計算圖在各層之間維持整數。匯出與執行環境工具本身(ONNX、ONNX Runtime、TensorRT、torch.export)在 ML 11 有說明。
為什麼論文的加速在裝置上會縮水
- FLOPs 不是瓶頸。 一個移除了受限於記憶體的層 90% MAC 的方法,幾乎不會改變它們的時間(圖 1)。
- 稀疏需要核。 非結構化稀疏,只有在那個裝置上有針對該樣式的稀疏核時才會加速 [5]、[8];2:4 稀疏在部分 GPU 上有專用硬體 [6];結構化剪枝不需要任何特別的東西。
- 批次大小。 大批次的吞吐量不是批次 1 的延遲(上面的線性層例子)。
- 管線的其餘部分。 前處理、NMS 這類後處理(DLCV 03A)、縮放與資料傳輸,不會因為網路變小而變小。
- 不支援的運算子。 單一個沒有低精度核的運算子,就可能迫使加入的轉換比省下的還貴。
壓縮視覺模型:哪些地方敏感
白話版。 視覺模型的不同部分,對壓縮的反應差異很大。每個通道權重很少的層、必須在數值上精確的輸出(框座標、像素值),以及範圍隨影像而變的激活值,是常見的弱點。
分類骨幹
由深度可分離層建成的網路,是最難量化的常見骨幹。在 Nagel 等人的實驗中,使用 4 位元權重與 8 位元激活值時,逐張量 PTQ 讓 MobileNetV2 與 EfficientNet-lite 的 ImageNet top-1 分別損失約 2.5 與 4.2 個點,他們推測原因是深度可分離卷積;逐通道尺度為 EfficientNet-lite 找回了 2.8 個點 [15]。各通道權重範圍差異很大的層,是最先該考慮逐通道尺度或較高精度的候選,而逐層敏感度測試(一次只量化一層並測量下降,如練習 5)可以很快找出其他的層。
偵測器
偵測器預測連續的框座標與分數,兩者都會受粗糙格點之害。在白皮書中,EfficientDet-D1 在浮點下達到 40.08 COCO mAP,8 位元 PTQ 下是 38.29,但 4 位元逐張量權重只有 0.31(逐通道是 35.08);QAT 讓 4 位元權重的結果提高到 35.34 與 36.75 [15]。YOLOv6 這類重參數化的偵測器需要對量化友善的訓練(見上文)[40]。因為嚴格 IoU 下的準確率是粗糙的框座標最先傷到的,所以量化之後要檢查高 IoU 閾值的 AP,而不只是 IoU 0.5 的 AP(DLCV 03A)。
蒸餾對偵測器也需要小心。Wang 等人發現,把一般的蒸餾套用到偵測器只有很小的增益,因此改讓學生在物件附近的位置模仿教師的特徵(位置由錨框估計);這在他們的實驗中改善了 KITTI、Pascal VOC 與 COCO 上的學生 [51]。
密集預測與影像復原
對超解析度、去雜訊與增強而言,輸出是一張影像,每個量化誤差都可能變得看得見。有兩個性質讓這些網路比分類器更難。第一,許多影像復原網路拿掉了批次正規化;Li 等人發現這會讓激活值的動態範圍大得多,破壞了假設激活值已正規化的量化方案,並提出了為每層學習最大值尺度的做法(PAMS)[52]。第二,Hong 等人觀察到,超解析度網路中每個通道的激活值分布都不同,而且還會隨輸入影像改變,並提出逐通道、感知分布的量化(DAQ)[53]。所以要用與部署內容相似的影像做校準(低光源模型就用暗景),用 DLCV 09 的指標在完整解析度下評估,並檢查平滑的漸層,色帶最先出現在那裡。NTIRE 高效率超解析度挑戰賽在固定的 PSNR 閾值下,把執行時間、FLOPs 與參數量分成不同賽道排名 [54](DLCV 09A);DLCV 09C 涵蓋高效率的增強網路。
視覺 Transformer 與擴散模型
在視覺 Transformer 中,softmax 與 GELU 之後的激活值遠非高斯分布,PTQ4ViT 對每個這樣的張量使用兩個範圍來處理 [55];Liu 等人加入一個排序損失,讓量化後的注意力保留注意力分數的順序 [56]。擴散模型多了時間維度:同一個去雜訊網路要在許多雜訊等級下執行,它的激活值分布會隨時間步改變。Q-Diffusion 把這點,連同捷徑層中的雙峰激活值,視為關鍵困難,並使用感知時間步的校準 [57];PTQ4DM 研究的是同一個多時間步校準的問題 [58]。大型分割基礎模型則靠蒸餾來壓縮:MobileSAM 蒸餾 Segment Anything Model [59] 的大型影像編碼器成一個小的(「解耦蒸餾」)[60],EfficientSAM 則預訓練小型編碼器去重建 SAM 的特徵 [61]。
現代觀點
綜述怎麼說
- 一般壓縮。 Cheng 等人把這個領域分成四類:參數剪枝與量化、低秩分解、轉移式/緊湊卷積濾波器,以及知識蒸餾,並討論每一類的優缺點 [62]。Menghani 把高效深度學習整理成五個領域:壓縮技術、學習技術(如蒸餾)、自動化(超參數最佳化與架構搜尋)、高效架構,以及基礎設施(軟體與硬體),並附上實務者指南 [63]。
- 量化。 Gholami 等人從基礎(均勻與非均勻量化器、範圍校準、粒度、微調)到進階主題(純整數推論、混合精度、考慮硬體與蒸餾輔助的量化、極低位元量化)綜述量化 [64];Nagel 等人的白皮書是實用的配套,有經過測試的 PTQ 與 QAT 流程以及除錯工作流程 [15]。
- 剪枝與稀疏。 Hoefler 等人整理了 300 多篇關於推論與訓練稀疏的論文,包括如何在硬體上得到真正的加速 [8]。Cheng、Zhang 與 Shi 依通用或特定加速、何時剪枝、如何剪枝,以及與其他壓縮技術的融合來整理剪枝,並涵蓋大型語言與多模態模型的剪枝 [65]。Blalock 等人仍是剪枝結果該如何回報這件事的警示性參考 [4]。
- 蒸餾。 Gou 等人依知識類型、訓練方案、教師—學生架構與演算法對蒸餾分類 [29];Wang 與 Yoon 則聚焦於視覺,以及蒸餾為什麼有效 [66]。
- 架構搜尋。 Elsken 等人提供了上面使用的三維度分類法 [41];White 等人在超過 1,000 篇 NAS 論文之後寫作,給出搜尋空間、演算法與加速技巧的分類法,並附上基準與最佳實務 [67]。
選讀:A White Paper on Neural Network Quantization(Nagel 等人,2021)(見「論文導讀」頁)。它的流程如何建構,以及如何閱讀它的 PTQ 與 QAT 表格。
2023–2026 年的最新進展
- 超大型模型的低位元權重。 以補償誤差的捨入(GPTQ [68])或感知激活值並保護重要通道(AWQ [69])的方式,把權重量化到 3–4 位元,已成為大型 Transformer 的標準做法;ML 11 介紹了這兩者。SmoothQuant 把離群值從激活值遷移到權重,使語言模型的 8 位元權重與激活值變得可行 [19]。
- 4 位元的生成式視覺模型。 繼 Q-Diffusion [57] 之後,SVDQuant 把大型擴散模型的權重與激活值都量化到 4 位元:它把激活值的離群值移進權重,再用一個小的高精度低秩分支吸收權重的離群值,並把該分支融合進低位元核,以避免額外的記憶體流量;它結合了本章的兩項技術:低秩分解與量化 [70]。
- 8 位元浮點格式(E4M3、E5M2),在訓練與推論上作為 int8 的替代方案 [24]。
- 蒸餾後的基礎模型。 大型視覺基礎模型的小型學生,例如分割用的 MobileSAM 與 EfficientSAM [60]、[61],以及 DLCV 02 討論的蒸餾版 DINOv2 骨幹。
- 適用於任何計算圖的結構化剪枝。 DepGraph 式的相依分析,讓通道剪枝能用同一個方法套用到 CNN、Transformer 與其他架構 [9]。
- 由挑戰賽推動的高效影像復原,其中執行時間、FLOPs 與參數量是分開計分的 [54]。
尚未解決的問題
- 預測裝置速度。 FLOPs 與參數量仍然主導論文,但只有目標裝置上量測到的延遲才重要,而它取決於核、記憶體與批次大小 [1]。
- 公平的比較。 大小與訓練預算相同的基準、多個種子,以及完整的取捨曲線,仍然常常缺少 [4]、[3]。
- 低位元激活值。 4 位元權重已越來越常規;4 位元激活值,尤其是在含有深度層、注意力與隨時間變化的分布的網路中,仍然要付出準確率的代價 [15]、[57]。
- 壓縮在準確率之外改變了什麼。 平均準確率可能掩蓋稀有類別、偏移輸入或校準上的變化;壓縮之後去量測這些,仍不是標準做法。
- 影像復原與生成模型的壓縮,其誤差在輸出中看得見,而沒有單一指標能完整反映。
重點整理
- 定義實際部署預算,並在目標裝置量測端到端成本。
- 減少 MACs 不一定改善記憶體受限層;應檢查搬移位元組數與可用核心。
- 非結構化剪枝需稀疏運算支援才能加速;結構化剪枝產生較小稠密層,仍須實測。
- 先試 PTQ,檢查校準與離群值;所需精度造成過大準確率損失時再用 QAT。
- 蒸餾取決於教師資訊、對應輸入視圖與訓練方式;教師較大不保證較好。
- 匯出後驗證壓縮模型及敏感輸出,並與同樣充分訓練的小型稠密模型比較。
練習
- 屋頂線算術。 在第一段程式碼的虛構加速器(4 TMAC/s、100 GB/s)上,估計一個在 特徵圖上、128 個輸入與 128 個輸出通道的 卷積,在 16 位元精度下的時間。它是受限於運算還是記憶體?接著找出一個 的 fp32 線性層要變成受限於運算的最小批次大小。
提示
這個卷積做 M 次 MAC,搬動 個值,也就是每個值 2 位元組時約 0.70 MB,所以它的強度約為每位元組 166 次 MAC:受限於運算,約 28.9 µs。對批次 的線性層,強度是 ;令它等於 40 得到 。可以改寫程式碼中的 layer 函式來檢查。
- 大而稀疏,還是小而稠密? 在剪枝程式碼中,窄的稠密網路在約 2,500 個權重時勝過稀疏網路,與 Zhu 與 Gupta 在大型模型上的結果不同。設計一個能讓這個比較更公平的玩具實驗(想想每個模型被允許訓練多久、如何初始化),並預測如果原始網路本來就很窄,例如 64–32–16–10,結果會如何改變。
提示
讓兩個模型有相同的最佳化器總步數,分別調整它們的學習率,並加入第三個模型:從頭訓練的窄架構(Liu 等人主張的那種基準)。一個本來就很窄的網路沒有多少冗餘可以移除,所以結構化剪枝應該會更快失去準確率,而能把重要權重保留在任何位置的非結構化模型,可能反而勝出。
- 手動量化。 用仿射方案與 min-max 範圍,把數值 量化成 4 位元無號整數。計算 、、每個 與每個 。為什麼 的誤差不是零,儘管它就是範圍的一端?誤差有沒有可能大於 ?
提示
,,所以 ,。把 捨入成整數,會讓整個格點平移,使 0 恰好落在格點上;格點因此涵蓋 而不是 ,所以兩個端點值都不在格點上(兩個誤差都約為 0.053,小於 )。高於 或低於 的值會被截斷,它的誤差就可能超過 。
- 蒸餾中的溫度與權重。 用 與 重新執行蒸餾程式碼。哪些設定對 8 單元的學生有幫助?為什麼很高的溫度可能比適中的溫度幫助更小?請在回答中使用軟項的梯度 。
提示
有一次執行中,( 與 )得到 0.948 與 0.953,但 得到 0.937 與 0.916,而只用標籤是 0.936。在很高的溫度下,軟目標趨近均勻分布,對正確類別說得更少,而 時標籤項剩下的權重很小;因子 也會改變有效的步長,所以學習率會與 互相影響。下結論之前,先拿差異和各種子之間的變異比較。
- 逐層敏感度。 用離群值程式碼中的函式
q_weight與run,一次只把一層的權重量化到 2 位元(逐通道),其他層保持浮點,並依準確率下降幅度為三層排名。然後只把最穩健的兩層量化到 2 位元,把最敏感的那層保持在 8 位元。這個混合精度模型需要的權重記憶體,與全部 8 位元相比如何?
提示
傳給 run 一串量化與未量化的權重矩陣,而不是使用它的 wbits 參數。三層的權重數分別是 、 與 ;記憶體是 位元組,再加上每個輸出單元一個尺度。這就是 HAWQ 這類以敏感度為基礎的混合精度的想法,只是用量測到的準確率取代了 Hessian 資訊。
參考文獻
- M. Dehghani, A. Arnab, L. Beyer, A. Vaswani and Y. Tay, “The efficiency misnomer,” ICLR, 2022. arXiv
- S. Williams, A. Waterman and D. Patterson, “Roofline: an insightful visual performance model for multicore architectures,” Communications of the ACM, vol. 52, no. 4, pp. 65–76, 2009. doi
- Z. Liu, M. Sun, T. Zhou, G. Huang and T. Darrell, “Rethinking the value of network pruning,” ICLR, 2019. arXiv
- D. Blalock, J. J. Gonzalez Ortiz, J. Frankle and J. Guttag, “What is the state of neural network pruning?,” MLSys, 2020. arXiv
- H. Li, A. Kadav, I. Durdanovic, H. Samet and H. P. Graf, “Pruning filters for efficient ConvNets,” ICLR, 2017. arXiv
- A. Mishra, J. Albericio Latorre, J. Pool, D. Stosic, D. Stosic, G. Venkatesh, C. Yu and P. Micikevicius, “Accelerating sparse deep neural networks,” arXiv:2104.08378, 2021. arXiv
- Z. Liu, J. Li, Z. Shen, G. Huang, S. Yan and C. Zhang, “Learning efficient convolutional networks through network slimming,” ICCV, 2017. arXiv
- T. Hoefler, D. Alistarh, T. Ben-Nun, N. Dryden and A. Peste, “Sparsity in deep learning: pruning and growth for efficient inference and training in neural networks,” Journal of Machine Learning Research, vol. 22, no. 241, pp. 1–124, 2021. paper
- G. Fang, X. Ma, M. Song, M. B. Mi and X. Wang, “DepGraph: towards any structural pruning,” CVPR, 2023. doi arXiv
- S. Han, J. Pool, J. Tran and W. J. Dally, “Learning both weights and connections for efficient neural networks,” NeurIPS (NIPS), 2015. arXiv
- S. Han, H. Mao and W. J. Dally, “Deep compression: compressing deep neural networks with pruning, trained quantization and Huffman coding,” ICLR, 2016. arXiv
- M. Zhu and S. Gupta, “To prune, or not to prune: exploring the efficacy of pruning for model compression,” arXiv:1710.01878, 2017. arXiv
- J. Frankle and M. Carbin, “The lottery ticket hypothesis: finding sparse, trainable neural networks,” ICLR, 2019. arXiv
- J. Frankle, G. K. Dziugaite, D. M. Roy and M. Carbin, “Linear mode connectivity and the lottery ticket hypothesis,” ICML, 2020. arXiv
- M. Nagel, M. Fournarakis, R. A. Amjad, Y. Bondarenko, M. van Baalen and T. Blankevoort, “A white paper on neural network quantization,” arXiv:2106.08295, 2021. arXiv
- B. Jacob, S. Kligys, B. Chen, M. Zhu, M. Tang, A. Howard, H. Adam and D. Kalenichenko, “Quantization and training of neural networks for efficient integer-arithmetic-only inference,” CVPR, 2018. doi arXiv
- M. Nagel, M. van Baalen, T. Blankevoort and M. Welling, “Data-free quantization through weight equalization and bias correction,” ICCV, 2019. arXiv
- T. Dettmers, M. Lewis, Y. Belkada and L. Zettlemoyer, “LLM.int8(): 8-bit matrix multiplication for transformers at scale,” NeurIPS, 2022. arXiv
- G. Xiao, J. Lin, M. Seznec, H. Wu, J. Demouth and S. Han, “SmoothQuant: accurate and efficient post-training quantization for large language models,” ICML, 2023. arXiv
- M. Nagel, R. A. Amjad, M. van Baalen, C. Louizos and T. Blankevoort, “Up or down? Adaptive rounding for post-training quantization,” ICML, 2020. arXiv
- Y. Bengio, N. Léonard and A. Courville, “Estimating or propagating gradients through stochastic neurons for conditional computation,” arXiv:1308.3432, 2013. arXiv
- Z. Dong, Z. Yao, A. Gholami, M. W. Mahoney and K. Keutzer, “HAWQ: Hessian aware quantization of neural networks with mixed-precision,” ICCV, 2019. arXiv
- K. Wang, Z. Liu, Y. Lin, J. Lin and S. Han, “HAQ: hardware-aware automated quantization with mixed precision,” CVPR, 2019. arXiv
- P. Micikevicius et al., “FP8 formats for deep learning,” arXiv:2209.05433, 2022. arXiv
- G. Hinton, O. Vinyals and J. Dean, “Distilling the knowledge in a neural network,” NIPS Deep Learning Workshop, 2014; arXiv:1503.02531. arXiv
- L. J. Ba and R. Caruana, “Do deep nets really need to be deep?,” NeurIPS (NIPS), 2014. arXiv
- A. Romero, N. Ballas, S. E. Kahou, A. Chassang, C. Gatta and Y. Bengio, “FitNets: hints for thin deep nets,” ICLR, 2015. arXiv
- S. Zagoruyko and N. Komodakis, “Paying more attention to attention: improving the performance of convolutional neural networks via attention transfer,” ICLR, 2017. arXiv
- J. Gou, B. Yu, S. J. Maybank and D. Tao, “Knowledge distillation: a survey,” International Journal of Computer Vision, vol. 129, no. 6, pp. 1789–1819, 2021. doi
- L. Beyer, X. Zhai, A. Royer, L. Markeeva, R. Anil and A. Kolesnikov, “Knowledge distillation: a good teacher is patient and consistent,” CVPR, 2022. arXiv
- J. H. Cho and B. Hariharan, “On the efficacy of knowledge distillation,” ICCV, 2019. arXiv
- H. Touvron, M. Cord, M. Douze, F. Massa, A. Sablayrolles and H. Jégou, “Training data-efficient image transformers & distillation through attention,” ICML, 2021. arXiv
- R. Denton, W. Zaremba, J. Bruna, Y. LeCun and R. Fergus, “Exploiting linear structure within convolutional networks for efficient evaluation,” NeurIPS (NIPS), 2014. arXiv
- M. Jaderberg, A. Vedaldi and A. Zisserman, “Speeding up convolutional neural networks with low rank expansions,” BMVC, 2014. arXiv
- X. Zhang, J. Zou, K. He and J. Sun, “Accelerating very deep convolutional networks for classification and detection,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 38, no. 10, pp. 1943–1955, 2016. doi arXiv
- A. G. Howard, M. Zhu, B. Chen, D. Kalenichenko, W. Wang, T. Weyand, M. Andreetto and H. Adam, “MobileNets: efficient convolutional neural networks for mobile vision applications,” arXiv:1704.04861, 2017. arXiv
- M. Sandler, A. Howard, M. Zhu, A. Zhmoginov and L.-C. Chen, “MobileNetV2: inverted residuals and linear bottlenecks,” CVPR, 2018. arXiv
- M. Tan and Q. V. Le, “EfficientNet: rethinking model scaling for convolutional neural networks,” ICML, 2019. arXiv
- X. Ding, X. Zhang, N. Ma, J. Han, G. Ding and J. Sun, “RepVGG: making VGG-style ConvNets great again,” CVPR, 2021. arXiv
- C. Li et al., “YOLOv6: a single-stage object detection framework for industrial applications,” arXiv:2209.02976, 2022. arXiv
- T. Elsken, J. H. Metzen and F. Hutter, “Neural architecture search: a survey,” Journal of Machine Learning Research, vol. 20, pp. 1–21, 2019. arXiv
- B. Zoph and Q. V. Le, “Neural architecture search with reinforcement learning,” ICLR, 2017. arXiv
- H. Pham, M. Y. Guan, B. Zoph, Q. V. Le and J. Dean, “Efficient neural architecture search via parameter sharing,” ICML, 2018. arXiv
- H. Liu, K. Simonyan and Y. Yang, “DARTS: differentiable architecture search,” ICLR, 2019. arXiv
- H. Cai, C. Gan, T. Wang, Z. Zhang and S. Han, “Once-for-all: train one network and specialize it for efficient deployment,” ICLR, 2020. arXiv
- M. Tan, B. Chen, R. Pang, V. Vasudevan, M. Sandler, A. Howard and Q. V. Le, “MnasNet: platform-aware neural architecture search for mobile,” CVPR, 2019. arXiv
- H. Cai, L. Zhu and S. Han, “ProxylessNAS: direct neural architecture search on target task and hardware,” ICLR, 2019. arXiv
- B. Wu, X. Dai, P. Zhang, Y. Wang, F. Sun, Y. Wu, Y. Tian, P. Vajda, Y. Jia and K. Keutzer, “FBNet: hardware-aware efficient ConvNet design via differentiable neural architecture search,” CVPR, 2019. doi arXiv
- L. Li and A. Talwalkar, “Random search and reproducibility for neural architecture search,” UAI, 2019. arXiv
- S. Ioffe and C. Szegedy, “Batch normalization: accelerating deep network training by reducing internal covariate shift,” ICML, 2015. arXiv
- T. Wang, L. Yuan, X. Zhang and J. Feng, “Distilling object detectors with fine-grained feature imitation,” CVPR, 2019. arXiv
- H. Li, C. Yan, S. Lin, X. Zheng, Y. Li, B. Zhang, F. Yang and R. Ji, “PAMS: quantized super-resolution via parameterized max scale,” ECCV, 2020. arXiv
- C. Hong, H. Kim, S. Baik, J. Oh and K. M. Lee, “DAQ: channel-wise distribution-aware quantization for deep image super-resolution networks,” WACV, 2022. arXiv
- B. Ren, Y. Li, N. Mehta, R. Timofte et al., “The ninth NTIRE 2024 efficient super-resolution challenge report,” CVPR Workshops, 2024. doi arXiv
- Z. Yuan, C. Xue, Y. Chen, Q. Wu and G. Sun, “PTQ4ViT: post-training quantization for vision transformers with twin uniform quantization,” ECCV, 2022. doi arXiv
- Z. Liu, Y. Wang, K. Han, S. Ma and W. Gao, “Post-training quantization for vision transformer,” NeurIPS, 2021. arXiv
- X. Li, Y. Liu, L. Lian, H. Yang, Z. Dong, D. Kang, S. Zhang and K. Keutzer, “Q-Diffusion: quantizing diffusion models,” ICCV, 2023. doi arXiv
- Y. Shang, Z. Yuan, B. Xie, B. Wu and Y. Yan, “Post-training quantization on diffusion models,” CVPR, 2023. arXiv
- A. Kirillov et al., “Segment anything,” ICCV, 2023. doi arXiv
- C. Zhang, D. Han, Y. Qiao, J. U. Kim, S.-H. Bae, S. Lee and C. S. Hong, “Faster segment anything: towards lightweight SAM for mobile applications,” arXiv:2306.14289, 2023. arXiv
- Y. Xiong et al., “EfficientSAM: leveraged masked image pretraining for efficient segment anything,” CVPR, 2024. doi arXiv
- Y. Cheng, D. Wang, P. Zhou and T. Zhang, “Model compression and acceleration for deep neural networks: the principles, progress, and challenges,” IEEE Signal Processing Magazine, vol. 35, no. 1, pp. 126–136, 2018. doi arXiv
- G. Menghani, “Efficient deep learning: a survey on making deep learning models smaller, faster, and better,” ACM Computing Surveys, vol. 55, no. 12, pp. 1–37, 2023. doi arXiv
- A. Gholami, S. Kim, Z. Dong, Z. Yao, M. W. Mahoney and K. Keutzer, “A survey of quantization methods for efficient neural network inference,” book chapter in Low-Power Computer Vision; arXiv:2103.13630, 2021. arXiv
- H. Cheng, M. Zhang and J. Q. Shi, “A survey on deep neural network pruning: taxonomy, comparison, analysis, and recommendations,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 46, no. 12, pp. 10558–10578, 2024. doi arXiv
- L. Wang and K.-J. Yoon, “Knowledge distillation and student-teacher learning for visual intelligence: a review and new outlooks,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 6, pp. 3048–3068, 2022. doi arXiv
- C. White, M. Safari, R. Sukthanker, B. Ru, T. Elsken, A. Zela, D. Dey and F. Hutter, “Neural architecture search: insights from 1000 papers,” arXiv:2301.08727, 2023. arXiv
- E. Frantar, S. Ashkboos, T. Hoefler and D. Alistarh, “GPTQ: accurate post-training quantization for generative pre-trained transformers,” ICLR, 2023. arXiv
- J. Lin, J. Tang, H. Tang, S. Yang, W.-M. Chen, W.-C. Wang, G. Xiao, X. Dang, C. Gan and S. Han, “AWQ: activation-aware weight quantization for LLM compression and acceleration,” MLSys, 2024. arXiv
- M. Li, Y. Lin, Z. Zhang, T. Cai, X. Li, J. Guo, E. Xie, C. Meng, J.-Y. Zhu and S. Han, “SVDQuant: absorbing outliers by low-rank components for 4-bit diffusion models,” ICLR, 2025. arXiv
- Y. Li, R. Gong, X. Tan, Y. Yang, P. Hu, Q. Zhang, F. Yu, W. Wang and S. Gu, “BRECQ: pushing the limit of post-training quantization by block reconstruction,” ICLR, 2021. arXiv
- S. K. Esser, J. L. McKinstry, D. Bablani, R. Appuswamy and D. S. Modha, “Learned step size quantization,” ICLR, 2020. arXiv
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 02・深度影像分類 · 41 分鐘