DLCV 01B・網路的積木與組合:分類與影像復原網路
先備知識:DLCV 01・深度學習的影像處理與電腦視覺、ML 05・注意力與視覺 Transformer
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 辨認網路的 stem、階段、區塊、neck 與 head。
- 追蹤區塊如何混合空間與通道資訊,並估計成本。
- 解釋分類與復原為何以不同方式使用解析度、正規化與跳接。
- 比較對應的網路設計,並以小型實驗診斷組合錯誤。
- 在控制訓練與計算預算的條件下解讀消融。
先看全貌
在論文的圖裡,視覺網路看起來很複雜,但它其實只由少數幾種積木重複、連接而成。兩個用了相同積木的網路,行為可能差很多,因為它們的組合方式不同:解析度在哪裡改變、跳接接到哪裡、正規化放在哪裡、輸出怎麼形成。本章談的就是這些組合上的決定。
為什麼重要。 實務上很少需要發明新的積木,更常見的是挑選骨幹網路、把它改到新任務上,或判斷一篇論文的十項改動裡哪幾項真的有用。把分類骨幹原封不動拿去做去雜訊,會丟掉細節;而某個在別篇論文有效的積木,放進你的設計空間未必有效。
基礎在哪裡。 這些積木本身在站內別處已經教過,本章只連結過去、不重複:卷積、感受野與殘差區塊見 ML 03 與 DLCV 01;Transformer 區塊、Swin 與高效率注意力見 ML 05;分類骨幹網路見 DLCV 02;編碼器–解碼器與 ASPP 見 DLCV 04;復原的骨幹網路與上取樣見 DLCV 09 與 DLCV 09A。本章所有程式碼只用 NumPy 與 SciPy,在 CPU 上幾秒就能跑完,資料是合成資料或 skimage.data。
網路的解剖
白話版。 視覺網路通常包含擷取特徵的 stem、重複區塊組成的主體,以及任務 head。閱讀時追蹤三者中的解析度變化。
精確版。 把特徵圖寫成形狀為 的張量,其中 是通道數(寬度), 是空間大小。常見的組成如下:
- Stem:最前面的一兩層。ResNet 用步幅 2 的 卷積,加上步幅 2 的 最大池化,所以主體是從輸入解析度的 開始 [1]。ConvNeXt 改成「patchify」:步幅 4 的 卷積 [2];ViT 則把影像切成 的 patch [3]。復原網路只用一個全解析度的 卷積,SwinIR 稱它為淺層特徵擷取(shallow feature extraction) [4]。
- Stage:一串共用同一解析度與同一寬度的區塊。區塊(block)是重複的單位(殘差區塊、Transformer 區塊)。
- 下取樣層(downsampling layer,也叫轉換層):把 與 減半,通常同時把 加倍。它可以是 stage 第一個區塊裡的步幅卷積(ResNet)、獨立的步幅 2 的 卷積(ConvNeXt、NAFNet)、patch merging(Swin),或 pixel unshuffle(Restormer)。
- Neck:選用的模組,用來混合多個 stage 的特徵,例如偵測器使用的特徵金字塔網路(Feature Pyramid Network,FPN)[5]。
- Head:分類用的是全域平均池化加一個線性層;復原用的是最後一個卷積,超解析度還要再加上取樣器。
一個 stage 的輸出步幅(output stride),是輸入大小與該 stage 特徵圖大小的比值。ResNet 的四個 stage,輸出步幅依序是 4、8、16、32 [1];Swin 也一樣 [6]。整個網路都維持同一解析度與同一寬度的(如 ViT)稱為等向(isotropic);stage 解析度逐步下降的稱為階層式(hierarchical)。
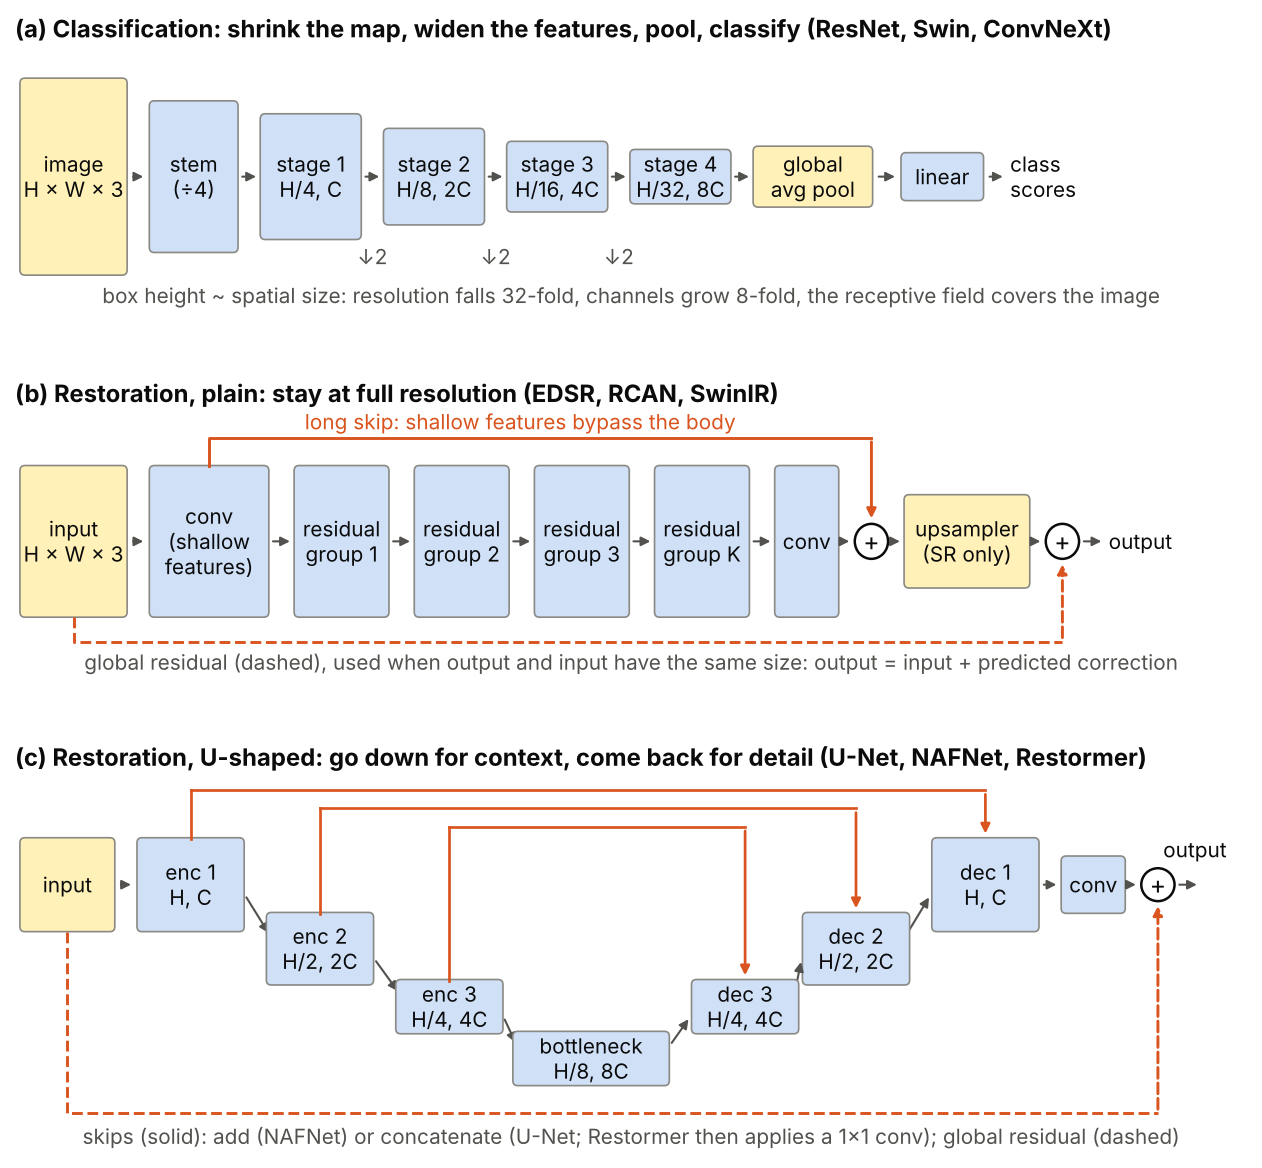
ResNet 也提出了被抄得最多的整體設計規則:特徵圖縮小一半時,濾波器數量加倍,「好讓每一層的時間複雜度維持不變」[1]。一個輸入與輸出都是 個通道的 卷積,作用在 的特徵圖上,要花 次乘加(multiply-accumulate,MAC);特徵圖縮小一半、寬度加倍後,成本是 ,完全相同。圖 1 畫出本章要比較的三種整體架構。
積木目錄
白話版。 區塊混合空間與通道資訊;跳接、正規化與非線性函數控制混合對訊號與成本的影響。
MetaFormer 論文把這個分工講得很明確:Transformer 區塊是一個 token 混合器(token mixer)(注意力)加一個通道混合器(channel mixer)(MLP),各自放在帶有正規化的殘差分支裡;把注意力換成簡單的空間池化運算,在 ImageNet 上仍有具競爭力的準確率 [7],這暗示整體結構本身就貢獻了大部分的效能 [8]。圖 2 用這個共同格式畫出本章的各個區塊。
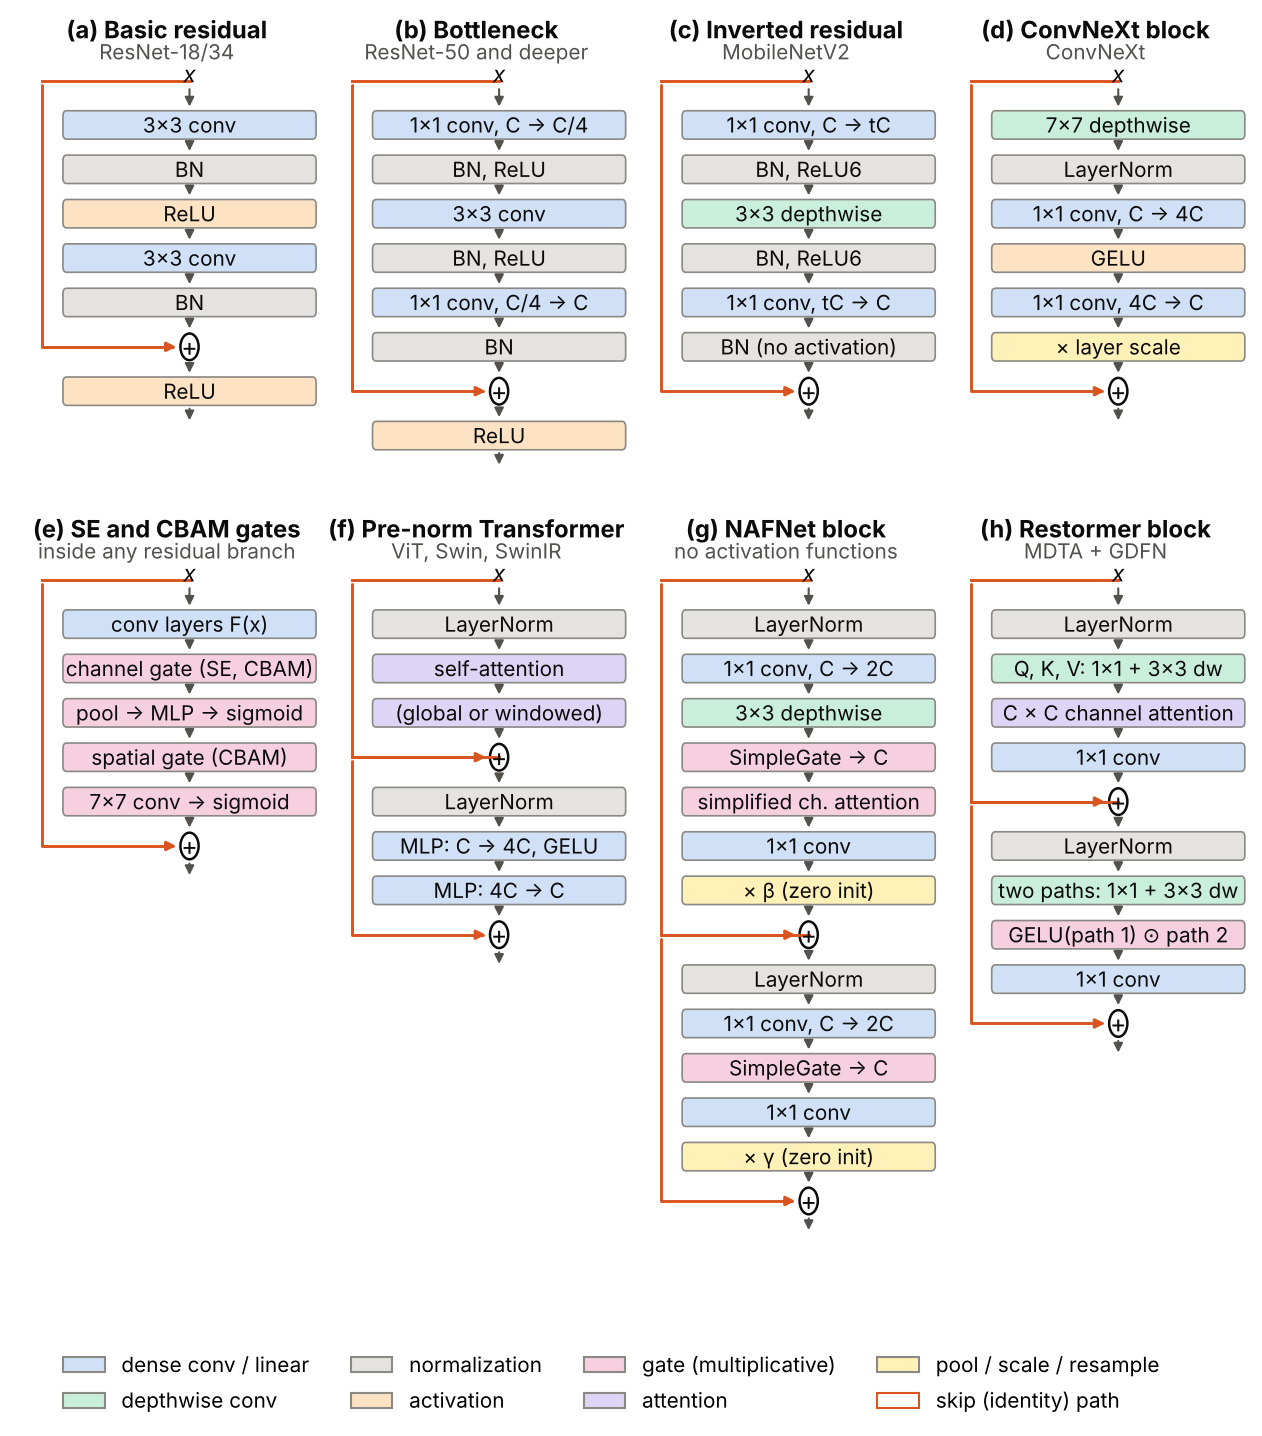
下表為每個區塊配一句白話說明,並標出它的基礎在哪裡教。
| 區塊 | 一句白話 | 用在 | 基礎 |
|---|---|---|---|
| 殘差(基本) | 學一個修正量 ,加回輸入 | ResNet-18/34、EDSR | DLCV 01 |
| 瓶頸 | 用 壓縮通道,濾波,再擴張回來 | ResNet-50 與更深的網路 | DLCV 02 |
| 深度可分離 | 每個通道各自濾波,再用 混合通道 | MobileNet [9] | DLCV 02 |
| 反向殘差 | 先擴張、做深度濾波、再線性投影回來;跳接接在細的兩端 | MobileNetV2 [10] | ML 03 |
| ConvNeXt 區塊 | 大的深度卷積核,加上 Transformer 風格的 MLP | ConvNeXt | DLCV 02 |
| SE / CBAM | 依據池化統計算出的閘,重新調整通道(以及位置)的權重 | SENet、RCAN、NAFNet | DLCV 02 補充資料 |
| 自注意力 | 每個 token 都看所有其他 token | ViT | ML 05 |
| 視窗注意力 | 在局部視窗內做注意力,視窗在層與層之間位移 | Swin、SwinIR | ML 05 |
| 通道(轉置)注意力 | 在通道之間做注意力,成本隨像素數線性增加 | Restormer | 本章 |
| 閘控區塊 | 把兩半特徵相乘,取代活化函數 | NAFNet、Restormer 的 GDFN | 本章 |
殘差連接與殘差縮放
白話版。 殘差區塊把學得的修正量加回輸入;需檢查正規化、活化函數的位置及修正量的初始尺度。
精確版。 一般形式是
其中 是區塊輸入, 是殘差分支(卷積、注意力、正規化), 是輸出, 是分支的縮放係數。非線性函數常見的放法有三種:
- 後活化(post-activation)(原始 ResNet):,BN 在 裡面 [1]。
- 前活化(pre-activation):BN 與 ReLU 移進分支裡、放在每個卷積之前,使捷徑成為純粹的恆等映射;He 等人發現這樣在非常深時比較容易訓練 [11]。Pre-norm 的 Transformer 區塊 是同一個想法(ML 05)。
- 加法之後沒有活化函數:EDSR、MobileNetV2、ConvNeXt、NAFNet 與 Restormer 的區塊都以加法收尾。
有幾種設計會明確控制 。EDSR 發現特徵圖數量變大後訓練在數值上不穩定,於是在其 32 個區塊、256 個通道的最終模型中,固定使用 0.1 的殘差縮放 [12]。ConvNeXt 使用 Layer Scale [13],也就是每個通道各自可學習的 ,初始值為 [2]。NAFNet 的程式碼把每個分支乘上初始值為零的可學習逐通道參數,使每個區塊一開始都是恆等映射 [14];把 ResNet 分支最後一個 BN 的縮放係數初始化為零,效果相同(DLCV 01A)。共同的理由是:一疊恆等區塊很容易最佳化,之後每個區塊再慢慢長出自己的修正量。
跳接也有兩種尺度。短跳接包住一個區塊;長跳接包住一組區塊或整個主體。RCAN 的「residual in residual」結構兩種都用:殘差群組帶有長跳接,每個群組裡的區塊再帶有短跳接 [15]。
訓練與推論也可以使用不同的模組計算圖:RepVGG [54] 在訓練時加入額外的仿射分支,部署前再合併成一個卷積。
選讀:RepVGG:訓練用分支,部署用直線網路(見「論文導讀」頁)。說明精確轉換、架構選擇與實測取捨。
瓶頸、反向殘差與深度可分離卷積
白話版。 空間濾波與通道混合不必擠在同一個昂貴的層裡完成。瓶頸讓昂貴的 在較少的通道上執行;深度卷積讓每個通道各自濾波,把混合通道的工作留給便宜的 層。這些區塊的成本會差上很多倍,所以值得算清楚。
精確版。 一個從 個通道到 個通道的稠密 卷積,有 個權重;在步幅為 1 時,每個輸出像素要花 次 MAC。作用在 個通道上的深度 卷積,兩者都是 。ResNet 的瓶頸把 降到 、濾波,再擴張回來 [1]。MobileNetV2 的反向殘差(inverted residual)則相反:先用 卷積把 擴張到 (論文主要實驗的擴張倍率是 ),用 深度卷積濾波,再用線性的 卷積投影回來,而且不接活化函數,因為作者主張在窄的層裡接 ReLU 會破壞資訊 [10]。論文給出的成本是:對 的輸入、 個輸入通道與 個輸出通道,共 次乘加 [10]。下面的程式碼在 、特徵圖 的條件下,數出圖 2 各區塊每個輸出像素的權重與 MAC,並用這個公式檢驗反向殘差。
程式碼 · Python · 26 行
# Weights (no biases or norm parameters) and MACs per output pixel of common blocks,
# all with C input and C output channels at stride 1. A dense k x k conv from a to b
# channels has k*k*a*b weights and costs k*k*a*b MACs per pixel; a depthwise one k*k*a.
def blocks(C, n_tokens):
    g = int(2.66 * C)                                  # Restormer GDFN hidden width
    return {                                           # name: (weights, MACs per pixel)
        'basic residual (2 x 3x3)':     (18 * C * C, 18 * C * C),
        'bottleneck (1x1, 3x3, 1x1)':   (2 * C * C // 4 + 9 * (C // 4) ** 2,) * 2,
        'depthwise separable 3x3':      (9 * C + C * C,) * 2,
        'inverted residual, t = 6':     (12 * C * C + 54 * C,) * 2,
        'ConvNeXt (7x7 dw, 4x MLP)':    (49 * C + 8 * C * C,) * 2,
        'NAFNet block':                 (7 * C * C + 18 * C, 6 * C * C + 18 * C),  # SCA acts on a pooled vector
        'SE add-on, r = 16':            (2 * C * C // 16, C),                       # one multiply per pixel
        'ViT block, global attention':  (12 * C * C, 12 * C * C + 2 * n_tokens * C),
        'Swin block, 8 x 8 windows':    (12 * C * C, 12 * C * C + 2 * 64 * C),
        'Restormer block (MDTA+GDFN)':  (4 * C * C + 27 * C + 3 * g * C + 18 * g,
                                         4 * C * C + 27 * C + 2 * C * C // 4 + 3 * g * C + 18 * g),  # 4 heads
    }

C, side = 64, 128
for name, (p, m) in blocks(C, side * side).items():
    print(f"{name:30s} {p:7d} weights  {m:8d} MACs/pixel")

# Check the inverted residual against MobileNetV2's formula h*w*d'*t*(d' + k^2 + d'') per pixel.
t, k = 6, 3
assert blocks(C, 1)['inverted residual, t = 6'][1] == C * t * (C + k * k + C)
輸出
basic residual (2 x 3x3)         73728 weights     73728 MACs/pixel
bottleneck (1x1, 3x3, 1x1)        4352 weights      4352 MACs/pixel
depthwise separable 3x3           4672 weights      4672 MACs/pixel
inverted residual, t = 6         52608 weights     52608 MACs/pixel
ConvNeXt (7x7 dw, 4x MLP)        35904 weights     35904 MACs/pixel
NAFNet block                     29824 weights     25728 MACs/pixel
SE add-on, r = 16                  512 weights        64 MACs/pixel
ViT block, global attention      49152 weights   2146304 MACs/pixel
Swin block, 8 x 8 windows        49152 weights     57344 MACs/pixel
Restormer block (MDTA+GDFN)      53812 weights     55860 MACs/pixel
這些數字帶出四個教訓。
- 寬度相同時,區塊的成本差了 10 倍以上。 瓶頸與可分離區塊比基本區塊便宜約 16 到 17 倍。所以真實的網路從來不在相同寬度下比較區塊:MobileNetV2 把反向殘差用在細的張量上,ResNet-50 把瓶頸用在寬的張量上。比較區塊要在相同成本下比,而不是在相同的 下比。
- 在像素上做全域注意力,對復原來說負擔不起。 把 特徵圖的每個像素都當成一個 token,ViT 區塊每個像素的成本約是 視窗 Swin 區塊的 37 倍,而且影像越大差距越大。這就是復原用的 Transformer 要用視窗(SwinIR)或跨通道的注意力(Restormer)的原因;一般的成本論證見 ML 05。
- 注意力附加模組在 MAC 上很便宜。 SE 閘只增加 個權重,以及每個通道每個像素一次乘法;它的代價在記憶體搬運,不在算術。
- MAC 不等於延遲。 深度層每搬動一個位元組只做很少的運算,所以實際可能比 MAC 數字顯示的慢;ML 03 與 DLCV 02 的效率一節都談過。請在目標硬體上實測。
便宜的區塊是不是也比較好,要看設計空間。RegNet 的族群研究發現,它最好的模型既不用瓶頸,也不用反向瓶頸,而且在它的設定下深度卷積比反向瓶頸更差 [16];ConvNeXt 卻發現在它自己那串改動裡,反向瓶頸略好一些 [2]。兩者可以同時成立:比較的結果取決於固定不動的其他選擇。
CNN 內的注意力:SE 與 CBAM
白話版。 閘會看整張特徵圖的摘要,決定這張特定影像要把哪些通道(或位置)調大或調小。這是讓卷積網路擁有一點「依內容而定、看全影像」行為的便宜方法。
精確版。 Squeeze-and-excitation(SE)根據各通道平均值組成的向量 ,算出通道閘 ,其中 與 是兩層 MLP 的權重(先以比例 縮減維度、再還原), 是 ReLU, 是 sigmoid;然後把特徵圖的每個通道 乘上 。公式與程式碼見 DLCV 02 補充資料 [17]。CBAM 從兩方面擴充它 [18]:它的通道閘同時用平均與最大值池化每個通道,並讓兩個向量通過同一個共用的 MLP;另外還有第二個空間閘,沿通道方向池化後套用 卷積,讓區塊也能把整個區域調大或調小。CBAM 的消融實驗發現,先通道後空間的順序,比兩個閘平行執行更好 [18]。
選讀:CBAM 的通道閘與空間閘(見「補充資料」頁)。寫出兩個公式並定義每個符號,說明它們與 SE 以及 NAFNet 的簡化通道注意力有何關係。
放在哪裡。 SE 和 CBAM 都放在殘差分支上、加法之前:SE 把閘作用在非恆等分支,「在與恆等分支相加之前」[17];CBAM 則把模組套在每個 ResNet 區塊的卷積輸出上 [18]。RCAN 把通道注意力帶進超解析度 [15];NAFNet 後來把它簡化成 ,也就是對池化向量做一次線性映射,沒有 ReLU 也沒有 sigmoid,而它的消融實驗中沒有損失任何效果 [19]。「現代觀點」中的注意力綜述,把 SE 歸入「通道注意力」一族,把 CBAM 歸入「通道加空間」[20]。
Token 混合器:自注意力、視窗注意力與通道注意力
白話版。 注意力是依內容算出權重,在 token 之間混合資訊;卷積用的則是固定權重。設計上的問題是哪些 token 彼此交談:全部的 token(全域)、同一個局部視窗內的 token,或是 Restormer 的新招:讓通道之間交談,而不是像素之間。
精確版。 對 個寬度為 的 token 做全域多頭自注意力,分數與加權和約需 次 MAC,另外投影還要 ;視窗注意力把範圍限制在 視窗內,成本是 (ML 05)[6]。Restormer 的多頭深度卷積轉置注意力(multi-Dconv head transposed attention,MDTA)則是在通道之間計算注意力 [21]:
其中 是輸入特徵圖, 是輸出,(、 同理)由經過 layer normalization 的輸入 算出:先做 卷積 ,再做 深度卷積 ;帽子符號表示重新整形的矩陣 、、; 是可學習的溫度參數;沒有上標的 是輸出的 卷積。注意力圖 的大小是 ,而不是 ,所以成本隨像素數線性增加,而每個輸出像素仍透過通道統計量依賴整張影像。深度卷積把局部脈絡補了回來。和一般多頭注意力一樣,通道會分成幾個頭,各有各的注意力圖。
Restormer 的前饋部分(GDFN)和下面的閘一起介紹。這些混合器之間的取捨,會在復原的各節再次出現:視窗注意力在空間上混合得強、但只在局部;通道注意力以低成本達到全域;而一項比較研究主張,在超解析度上 Restormer 的空間映射能力比 SwinIR 弱 [22]。
正規化:BN、LN、GN,以及何時不用
白話版。 正規化層把特徵調整到標準大小,再讓網路學出它偏好的尺度。各層的差別在於哪些數字共用統計量。在分類中,這個選擇多半只影響訓練穩定度;在復原中,選錯可能改變輸出的亮度與對比。
精確版。 所有常見的層都在某個數值集合上計算 (範本見 ML 02)。對形狀為 的 mini-batch:
| 層 | 統計量計算的範圍 | 是否依賴批次? |
|---|---|---|
| BatchNorm(BN)[23] | 每個通道在 上 | 是;測試時用移動平均 |
| LayerNorm(LN)[24] | 單一樣本的特徵(用在影像時,實作不同:整個 ,或每個位置的 ) | 否 |
| InstanceNorm(IN)[25] | 每個樣本、每個通道在 上 | 否 |
| GroupNorm(GN)[26] | 每個樣本在 與一組通道上 | 否; 等於 LN, 等於 IN |
BN 是分類 CNN 的預設選擇,在大批次下表現很好。它已知的失敗情況是小批次:GN 的作者報告,在批次大小為 2 時,ImageNet 上的 ResNet-50 搭配 GN,錯誤率比搭配 BN 的版本低 10.6% [26]。BN 計算了什麼、為什麼訓練與推論的行為不同,見 DLCV 01 補充資料。
為什麼復原網路拿掉 BN。 EDSR 把 BN 從殘差區塊中移除,理由是 BN 把特徵正規化之後,會讓網路失去「範圍彈性(range flexibility)」;這項改動提升了準確率,並且比 SRResNet(SRGAN 論文的殘差 SR 網路 [27])少用了約 40% 的訓練記憶體 [12]。ESRGAN 補充說,當訓練與測試的統計量不同時,BN 容易產生偽影,在以 GAN 損失訓練的較深網路中尤其明顯,所以也把它拿掉 [28]。這並不是定律:DnCNN 把殘差學習和 BN 結合起來做高斯去雜訊,並報告兩者互相幫助 [29]。下面的程式碼用一個固定、未訓練的殘差分支 (卷積、正規化、ReLU、 卷積)與全域殘差 來示範這個機制。同一張中灰度影像 ,被放在兩個不同的批次裡復原。
程式碼 · Python · 47 行
import numpy as np
from scipy.ndimage import gaussian_filter, correlate

rng = np.random.default_rng(0)

def image(level, size=32):
    """A smooth synthetic image with mean brightness `level` (values roughly in [0, 1])."""
    t = gaussian_filter(rng.standard_normal((size, size)), 2)
    return level + 0.15 * t / t.std()

C = 4
W1 = rng.normal(0.1, 0.2, (C, 3, 3))           # 3x3 conv, 1 -> C channels (fixed random weights)
w2 = rng.normal(0.0, 0.05, C)                  # 1x1 conv, C -> 1 channel

def features(batch):                           # (N, H, W) -> (N, C, H, W)
    return np.stack([[correlate(x, W1[c], mode='nearest') for c in range(C)] for x in batch])

def branch(batch, norm, running=None):
    """Residual branch: conv -> normalize -> ReLU -> 1x1 conv."""
    f = features(batch)
    if norm == 'bn-train':                     # per channel, over the whole batch
        mu, var = f.mean((0, 2, 3), keepdims=True), f.var((0, 2, 3), keepdims=True)
    elif norm == 'bn-eval':                    # per channel, stored training statistics
        mu, var = running
    else:                                      # 'instance': per sample and channel
        mu, var = f.mean((2, 3), keepdims=True), f.var((2, 3), keepdims=True)
    h = np.maximum((f - mu) / np.sqrt(var + 1e-5), 0)
    return np.tensordot(w2, h, axes=(0, 1))    # (N, H, W)

train = np.stack([image(rng.uniform(0.3, 0.7)) for _ in range(64)])
f = features(train)
running = (f.mean((0, 2, 3), keepdims=True), f.var((0, 2, 3), keepdims=True))

A = image(0.5)
dark = np.stack([image(0.15) for _ in range(7)])
bright = np.stack([image(0.85) for _ in range(7)])
for norm in ['bn-train', 'bn-eval', 'instance']:
    for name, others in [('dark', dark), ('bright', bright)]:
        batch = np.concatenate([A[None], others])
        out = A + branch(batch, norm, running)[0]          # global residual: y = x + r(x)
        print(f"{norm:8s}  A with 7 {name:6s} images: output mean {out.mean():.3f}")

# Per-sample normalization forgets each image's level and contrast:
B = 0.5 * A + 0.3
r_A, r_B = branch(A[None], 'instance')[0], branch(B[None], 'instance')[0]
print("instance-norm branch, A vs 0.5*A + 0.3: max |r_A - r_B| =", np.abs(r_A - r_B).max().round(4))
print("outputs with the global residual: means", (A + r_A).mean().round(3), (B + r_B).mean().round(3))
輸出
bn-train  A with 7 dark   images: output mean 0.629
bn-train  A with 7 bright images: output mean 0.482
bn-eval   A with 7 dark   images: output mean 0.509
bn-eval   A with 7 bright images: output mean 0.509
instance  A with 7 dark   images: output mean 0.521
instance  A with 7 bright images: output mean 0.521
instance-norm branch, A vs 0.5*A + 0.3: max |r_A - r_B| = 0.0005
outputs with the global residual: means 0.521 0.575
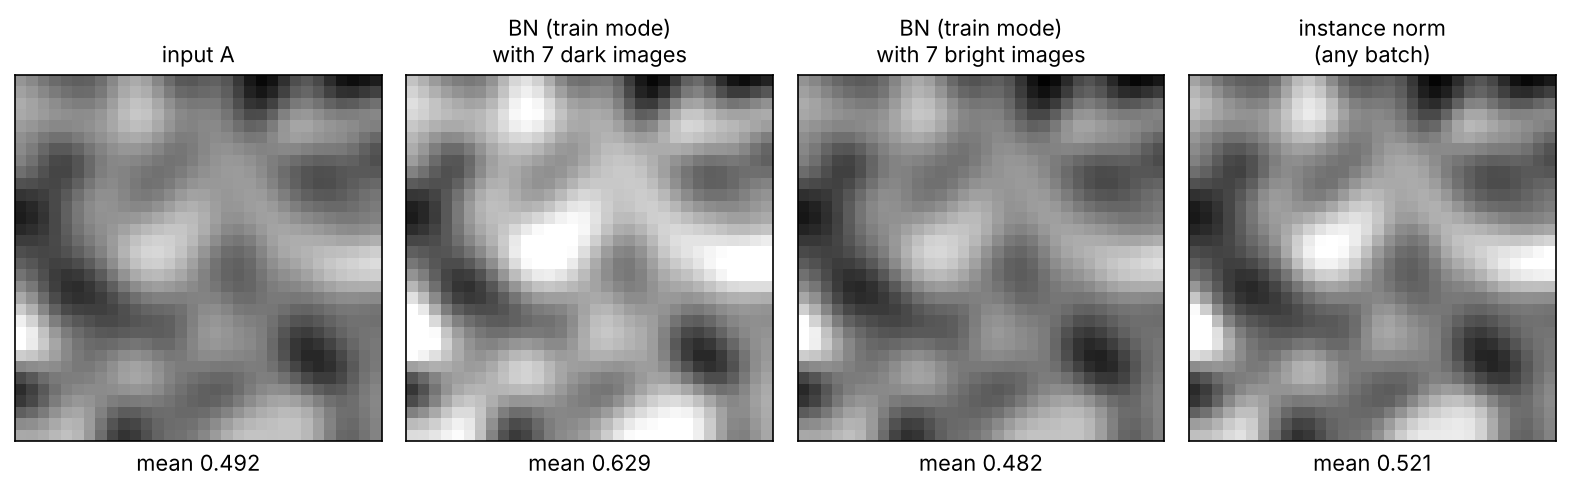
在訓練模式下,BN 讓同一張影像(輸入平均值 0.492)的輸出亮度變成 0.629 或 0.482,只取決於同批次的其他影像(圖 3)。在評估模式下,批次不再有影響,但儲存的統計量來自其他影像,所以網路在測試時的行為和訓練時不同:這就是 EDSR 與 ESRGAN 描述的不一致。逐樣本的正規化不依賴批次,卻在另一個方向上「看不見」:分支對 和對 給出相同的輸出(差距只在 的量級),所以只有恆等路徑承載了影像本身的亮度與對比。這就是為什麼有做正規化的復原網路(NAFNet、Restormer 與 SwinIR 都用 LayerNorm)要把它放在殘差分支裡面,並搭配全域殘差 [19]、[21]、[4]。這裡的權重是隨機且未訓練的;訓練可以部分補償,但對批次的依賴是結構性的。
NAFNet 的消融實驗顯示了另一面:在它的基本區塊加上 LayerNorm,使它能以大 10 倍的學習率訓練,並在 SIDD 去雜訊基準 [31] 上讓 PSNR [30] 提高 0.44 dB,在 GoPro 去模糊基準 [32] 上提高 3.39 dB [19]。正規化對復原網路也有幫助,只要它沒有拿走輸出所需要的資訊。
活化函數與閘
白話版。 非線性函數讓堆疊的層能做的事不只是一個線性映射。傳統的選擇是對每個數字套用固定的函數(ReLU、GELU)。閘則是把兩個學出來的特徵相乘,讓其中一個決定另一個能通過多少。現代的復原區塊使用閘,而 NAFNet 更是什麼都不用,只用閘。
精確版。 ReLU、GELU 與 SwiGLU 前饋區塊 [33] 的定義見 ML 02。Dauphin 等人的閘控線性單元(gated linear unit,GLU)計算 ,其中 、 是兩個線性映射, 是 sigmoid [34]。NAFNet 的 SimpleGate 拿掉了 sigmoid 與第二個映射 [19]:
其中 是有 個通道的特徵圖, 與 分別是它的前 個與後 個通道, 是逐元素相乘。輸入的兩個線性函數相乘後是二次的,所以區塊不需要任何活化函數也是非線性的;作者指出,GELU 本身 ( 是標準常態分布的累積分布函數 [35])就是閘的一個特例。Restormer 的 GDFN 使用 ,其中 是 GELU,兩條路徑各由 與 深度卷積組成,通道擴張係數為 [21]。在 NAFNet 的消融實驗中,把 GELU 換成 SimpleGate,在 SIDD 上多了 +0.08 dB,在 GoPro 上多了 +0.41 dB [19]。
上取樣:轉置卷積、pixel shuffle 與 resize-convolution
白話版。 上取樣讓特徵圖變大。常見的做法有三種:讓每個輸入像素把一塊學出來的圖樣「畫」到輸出上(轉置卷積);每個輸入像素算出幾個值再重新排列(pixel shuffle);或是先放大、再做卷積(resize-convolution)。前兩種很容易畫出規則的棋盤格圖樣,第三種不會。
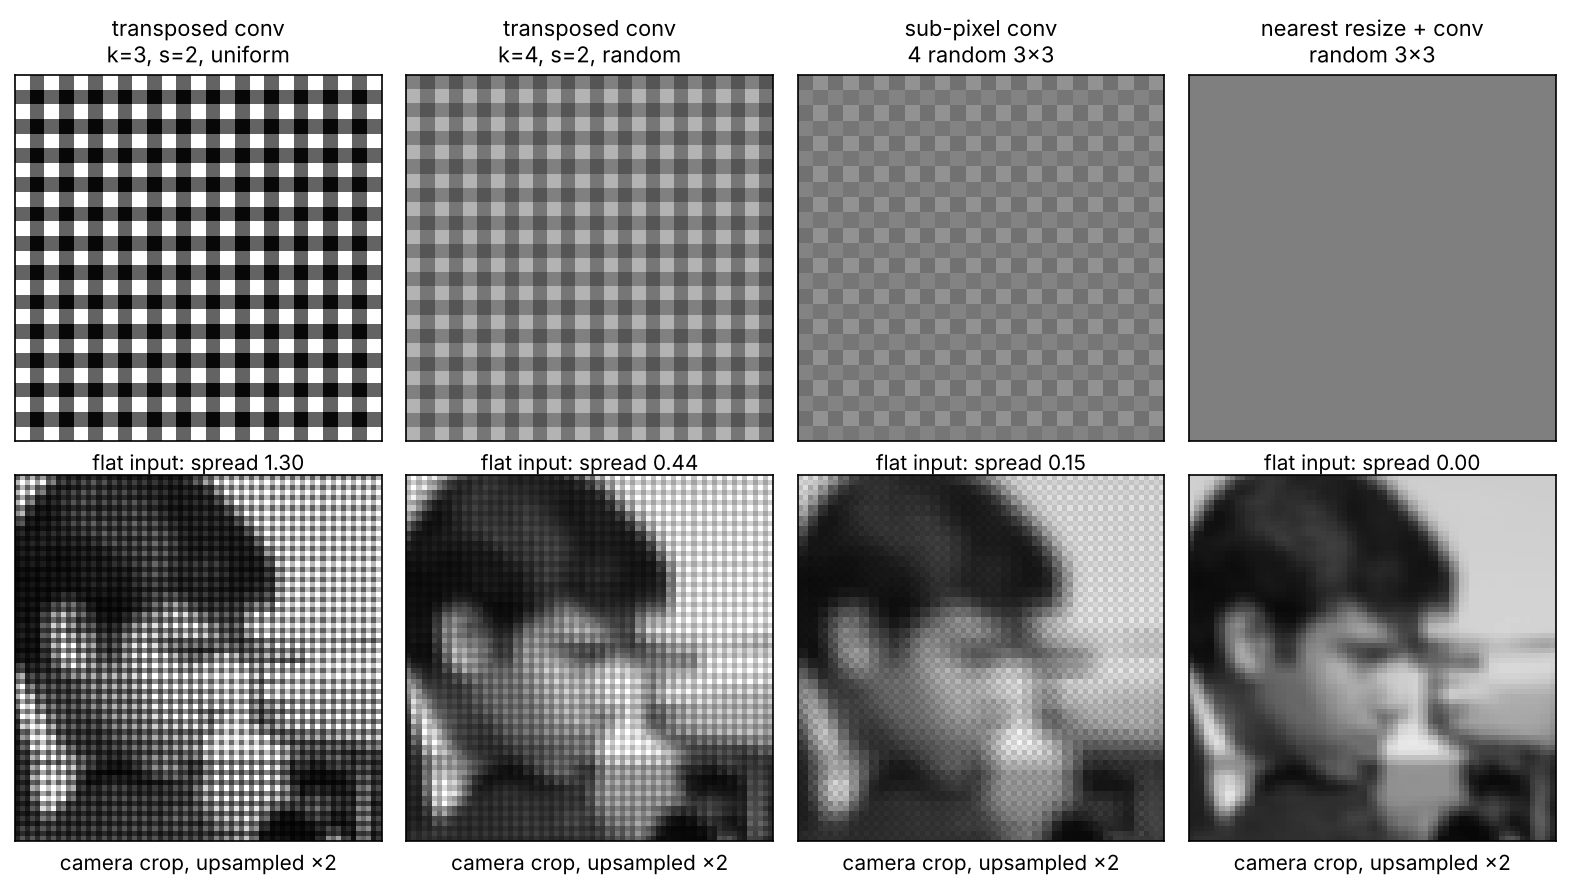
精確版。 這三種方法與 pixel shuffle 的確切索引規則,見 DLCV 09 與 DLCV 09A [36]。對組合來說,重要的是一個計數論證。步幅為 時,輸出像素分成 種相位(phase)(它們的列與行位置除以 的餘數)。在轉置卷積中,某個相位的輸出只會接收到卷積核的一部分權重。平坦輸入在這個相位上的值,等於這些權重的總和,也就是相位和(phase sum)。若各相位和不相等,平坦的輸入就會變成週期性的圖樣。其中一個成因,Odena 等人稱為不均勻重疊(uneven overlap):卷積核大小不能被步幅整除時,各相位接收到的權重數量不同 [37]。即使大小可以整除,隨機權重也會讓各相位和不相等,所以剛初始化的層仍然會產生圖樣;Aitken 等人把這兩項,加上損失函數中的步幅運算,列為棋盤格偽影的三個來源 [38]。子像素卷積有同樣的自由度,因為每個相位都有自己的濾波器。Resize-convolution(先用最近鄰上取樣,再做普通卷積)在每個輸出像素都套用同一個完整的卷積核,所以所有相位看到的總和相同。下面的程式碼把一個平坦的 輸入上取樣 2 倍。
程式碼 · Python · 36 行
import numpy as np
from scipy.ndimage import correlate

rng = np.random.default_rng(0)

def transposed_conv(x, w, s):
    """Each input pixel 'paints' a scaled copy of the k x k kernel w; copies are s pixels apart."""
    k, (H, W) = w.shape[0], x.shape
    out = np.zeros((s * (H - 1) + k, s * (W - 1) + k))
    for i in range(H):
        for j in range(W):
            out[s * i:s * i + k, s * j:s * j + k] += x[i, j] * w
    return out

def resize_conv(x, w, s):
    """Nearest-neighbour upsampling by s, then an ordinary 'same' convolution with w."""
    return correlate(np.kron(x, np.ones((s, s))), w, mode='nearest')

def subpixel_conv(x, ws, s):
    """s*s ordinary convolutions whose outputs are interleaved (pixel shuffle)."""
    out = np.zeros((s * x.shape[0], s * x.shape[1]))
    for n, w in enumerate(ws):
        out[n // s::s, n % s::s] = correlate(x, w, mode='nearest')
    return out

x = np.ones((16, 16))                          # flat input: a good upsampler returns a flat image
cases = {
    'transposed k=3, s=2, uniform w': transposed_conv(x, np.ones((3, 3)), 2)[4:-4, 4:-4],
    'transposed k=4, s=2, uniform w': transposed_conv(x, np.ones((4, 4)), 2)[4:-4, 4:-4],
    'transposed k=4, s=2, random w ': transposed_conv(x, rng.uniform(0.5, 1.5, (4, 4)), 2)[4:-4, 4:-4],
    'sub-pixel, 4 random 3x3 kernels': subpixel_conv(x, rng.uniform(0.5, 1.5, (4, 3, 3)), 2)[4:-4, 4:-4],
    'resize + conv, random 3x3 w   ': resize_conv(x, rng.uniform(0.5, 1.5, (3, 3)), 2)[4:-4, 4:-4],
}
for name, y in cases.items():
    phases = [y[a::2, b::2].mean() for a in (0, 1) for b in (0, 1)]     # the four 2x2 sub-pixel phases
    print(f"{name}: phase means {np.round(phases, 2)}  relative spread {np.ptp(y) / y.mean():.2f}")
輸出
transposed k=3, s=2, uniform w: phase means [4. 2. 2. 1.]  relative spread 1.30
transposed k=4, s=2, uniform w: phase means [4. 4. 4. 4.]  relative spread 0.00
transposed k=4, s=2, random w : phase means [4.04 3.22 5.01 3.85]  relative spread 0.44
sub-pixel, 4 random 3x3 kernels: phase means [ 8.71 10.13  9.49  8.91]  relative spread 0.15
resize + conv, random 3x3 w : phase means [7.86 7.86 7.86 7.86] relative spread 0.00、 時,就算權重一致,也是一個相位接收 4 個權重、兩個接收 2 個、一個接收 1 個:4 : 2 : 2 : 1 的圖樣是由形狀本身決定的。 時每個相位都接收 4 個權重,所以一致的權重會得到平坦的輸出,隨機權重則否。只有 resize-convolution 在任何權重下都是平坦的。圖 4 把同樣四種上取樣器用在平坦輸入與一張照片上。訓練可以把各相位和拉近,Odena 等人報告他們最好的結果來自最近鄰 resize-convolution [37];對 pixel shuffle 來說,讓所有相位都從同一個卷積核初始化,可以在一開始就消除圖樣 [38],如 DLCV 09A 所述。
選讀:一維轉置卷積的相位和(見「補充資料」頁)。任意卷積核大小與步幅下,每個輸出相位接收到幾個權重,以及為什麼可整除是必要但不充分的條件。
下取樣也有對應的選擇:步幅卷積(ResNet)、池化、獨立的步幅 2 的 卷積(ConvNeXt、NAFNet [14])、patch merging(Swin)與 pixel unshuffle(Restormer [21])。ConvNeXt 報告說,它獨立的 下取樣層一開始會讓訓練發散,直到它在每個空間解析度改變的地方加上正規化層為止 [2]。
跳接:相加或串接
白話版。 跳接把較早的特徵圖帶到較後面的層。它可以相加(兩張圖形狀必須相同,結果維持原來的寬度),也可以串接(把兩張圖沿通道疊起來,由下一層決定怎麼組合)。串接比較有彈性,也比較貴。
精確版。 串接後再接一個 卷積,已經把相加包含為特例:設編碼器特徵圖為 、解碼器特徵圖為 ,各有 個通道,那麼權重矩陣為 (兩個 的單位矩陣並排)的 卷積,會把 映射成 。所以串接能學到相加能學到的一切,還能學更多,代價是更寬的層,以及必須儲存兩張圖。下面的程式碼檢驗這個等式,並在 輸入、寬度由 32 到 256 的 4 層 U-Net 解碼器中,數出每種合併方式之後第一個卷積的成本。
程式碼 · Python · 24 行
import numpy as np

rng = np.random.default_rng(0)

# 1) Concatenation followed by a 1x1 convolution contains addition as a special case.
C, H, W = 8, 5, 5
enc, dec = rng.standard_normal((C, H, W)), rng.standard_normal((C, H, W))
cat = np.concatenate([enc, dec])                       # (2C, H, W)
W_fuse = np.hstack([np.eye(C), np.eye(C)])             # a 1x1 conv is a (C_out x C_in) matrix
print("concat + 1x1 conv [I I] == add:", np.allclose(np.tensordot(W_fuse, cat, 1), enc + dec))

# 2) What each choice costs in the decoder of a 4-level U-Net on a 256 x 256 input.
widths, size = [32, 64, 128, 256], 256
totals = {'add': [0, 0], 'concat': [0, 0], 'concat + 1x1': [0, 0]}
for level, c in enumerate(widths):
    hw = (size // 2 ** level) ** 2                     # pixels at this level
    first = {'add': 9 * c * c,                         # first 3x3 conv after the merge
             'concat': 9 * 2 * c * c,
             'concat + 1x1': 2 * c * c + 9 * c * c}    # 1x1 halves channels, then 3x3
    for k, p in first.items():
        totals[k][0] += p
        totals[k][1] += p * hw
for k, (p, m) in totals.items():
    print(f"{k:13s} merge-layer weights {p:7d}   MACs {m / 1e9:.2f} G")
輸出
concat + 1x1 conv [I I] == add: True
add           merge-layer weights  783360   MACs 2.42 G
concat        merge-layer weights 1566720   MACs 4.83 G
concat + 1x1  merge-layer weights  957440   MACs 2.95 G
串接會讓合併層的權重與 MAC 加倍;像 Restormer 那樣先做一次 融合,可以拿回大部分省下的成本。著名設計之間的選擇並不一致:
- U-Net 在把通道減半的 上卷積之後,將(裁切過的)編碼器特徵圖與解碼器特徵圖串接 [39]。
- FPN 用相加:較粗的特徵圖以最近鄰內插上取樣 2 倍,加上經 投影的骨幹特徵圖,再對每個合併後的特徵圖做 卷積,以減少上取樣造成的混疊 [5](DLCV 03)。
- Restormer 串接之後,在除了最上層以外的所有層級,用 卷積把通道減半 [21]。
- NAFNet 的程式碼把編碼器特徵圖加到上取樣後的解碼器特徵圖上 [14]。
- DenseNet 把一個區塊內所有先前各層的輸出串接起來 [40](DLCV 02 補充資料)。
多尺度模組:FPN、ASPP 與 U-Net
白話版。 物體和退化都有大有小。多尺度模組讓一個網路同時看好幾種尺度:建立特徵圖金字塔(FPN)、用好幾種大小的濾波器探測同一張特徵圖(ASPP),或先往下再往上走(U-Net)。
這些與其說是積木,不如說是組合模式,每一個都在用到它的地方教過:FPN 在 DLCV 03 [5];空洞空間金字塔池化(atrous spatial pyramid pooling,ASPP),也就是以多種擴張率平行進行的空洞卷積,在 DLCV 04 [41];U-Net 在 DLCV 01 與 IP 10 論文導讀 [39]。有一條規則把它們串在一起:脈絡來自往粗的方向走,細節來自一直保持細緻的路徑。FPN 的橫向連接、U-Net 的跳接,以及 DLCV 03B 中分割解碼器的低階跳接,都是那第二條路徑。
為分類而組合
白話版。 分類器要回答的是關於整張影像的一個問題。所以它很快地縮小影像,把運算花在小而寬的特徵圖上(那裡每個位置已經看得到很大的區域),最後把空間格點整個丟掉。
原則,以及各自的理由:
- 用 stem 提早下取樣。 最前面的層要處理最多的像素,所以 stem 在主體開始之前就把解析度降到 1/4(ResNet 的步幅 2 的 卷積加最大池化 [1];ConvNeXt 的步幅 4 的 patchify 層,在它的路線圖中沒有損失準確率 [2])。
- 每個 stage 解析度減半、寬度加倍。 這讓每層的成本大致維持不變(見解剖一節),並讓感受野以等比方式成長。
- 把大多數區塊放在第三個 stage。 ResNet-50 每個 stage 的區塊數是 (3, 4, 6, 3);ConvNeXt 依循 Swin 的 1:1:3:1 比例,改成 (3, 3, 9, 3),準確率因此提高 [2]。第三個 stage 的輸出步幅是 16,感受野夠大,位置的數量也還夠。
- 全域池化,再做線性分類。 全域平均池化讓輸出不受物體位置影響,也讓網路能接受任意大小的輸入。ViT 論文發現 class token 與全域平均池化的效果相近,但需要不同的學習率 [3]。
- 把昂貴的全域混合放在 token 少的地方。 全域注意力在後面的 stage 才負擔得起;混合型設計把卷積放前面、注意力放後面(ML 05)。像 SE 這種便宜的閘可以放進每個區塊。
- 批次大的時候,用批次正規化沒問題;批次小時改用 GN 或 LN。
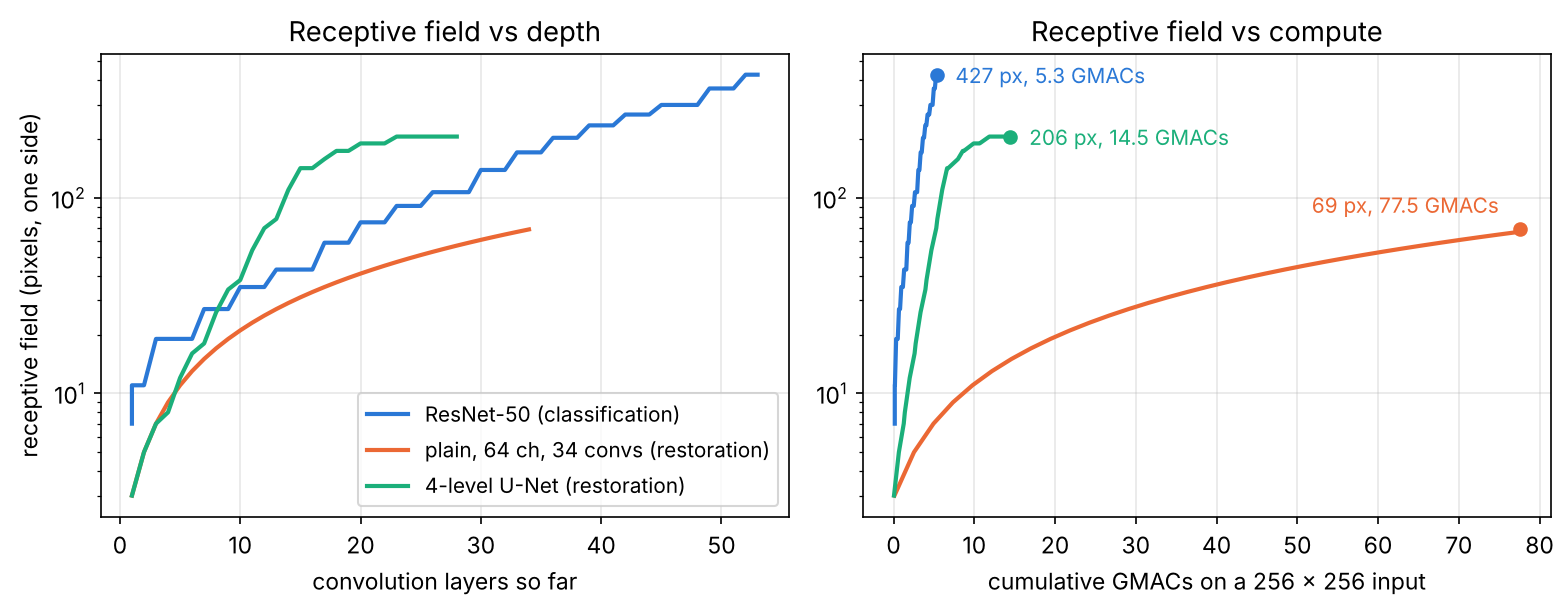
感受野長得多快? ML 03 的遞迴式涵蓋了步幅堆疊的情況;下面的程式碼也處理上取樣:從一個輸出單元往回走,追蹤能影響它的輸入區間。它在 的輸入上比較 ResNet-50 與兩種復原網路:EDSR-baseline 形狀的一般全解析度主體(16 個殘差區塊,每個有兩個 卷積、64 個通道,再加頭尾),以及寬度從 32 到 512 的 4 層 U-Net。
程式碼 · Python · 54 行
def analyze(layers, H=256):
    """Exact 1-D receptive field of one output unit, plus the multiply-accumulates (MACs)
    of a square H x H input. A layer is ('conv', k, stride, c_in, c_out) or ('up', f),
    where 'up' is nearest-neighbour upsampling by f (the convolution after it pays the cost)."""
    macs, size = 0, H
    for layer in layers:                              # forward: track the map size and cost
        if layer[0] == 'conv':
            _, k, s, cin, cout = layer
            size //= s
            macs += size * size * k * k * cin * cout
        else:
            size *= layer[1]
    rf = 0
    for p0 in range(16):                              # a few output positions (alignment matters)
        lo = hi = p0
        for layer in reversed(layers):                # backward: which inputs reach unit p0?
            if layer[0] == 'conv':
                _, k, s, _, _ = layer
                pad = (k - 1) // 2
                lo, hi = s * lo - pad, s * hi - pad + k - 1
            else:
                lo, hi = lo // layer[1], hi // layer[1]
        rf = max(rf, hi - lo + 1)
    return rf, macs, size

# Classification: ResNet-50 (stride on the 3x3 conv of each first block, max-pool as a k=3, s=2 layer).
resnet = [('conv', 7, 2, 3, 64), ('conv', 3, 2, 64, 0)]        # stem conv, then max-pool (no MACs)
cin = 64
for width, blocks, stride in [(64, 3, 1), (128, 4, 2), (256, 6, 2), (512, 3, 2)]:
    for b in range(blocks):
        s = stride if b == 0 else 1
        resnet += [('conv', 1, 1, cin, width), ('conv', 3, s, width, width),
                   ('conv', 1, 1, width, 4 * width)]
        if b == 0:
            resnet += [('conv', 1, 1, cin, 4 * width)]          # projection shortcut (cost only)
        cin = 4 * width

# Restoration A: plain full-resolution body, 64 channels, 32 convs of 3x3 (EDSR-baseline-like).
plain = [('conv', 3, 1, 3, 64)] + [('conv', 3, 1, 64, 64)] * 32 + [('conv', 3, 1, 64, 3)]

# Restoration B: 4-level U-Net, 2 convs per level, widths double as resolution halves.
w = [32, 64, 128, 256, 512]
unet = [('conv', 3, 1, 3, w[0])]
for i in range(4):
    unet += [('conv', 3, 1, w[i], w[i])] * 2 + [('conv', 2, 2, w[i], w[i + 1])]
unet += [('conv', 3, 1, w[4], w[4])] * 2
for i in reversed(range(4)):
    unet += [('up', 2), ('conv', 1, 1, w[i + 1], w[i]),
             ('conv', 3, 1, 2 * w[i], w[i]), ('conv', 3, 1, w[i], w[i])]   # concat skip doubles c_in
unet += [('conv', 3, 1, w[0], 3)]

for name, net in [('ResNet-50', resnet), ('plain 64ch x 34', plain), ('U-Net 4 levels', unet)]:
    rf, macs, size = analyze(net)
    print(f"{name:16s} RF {rf:4d} px   output {size:3d}x{size:<3d}   {macs / 1e9:6.2f} GMACs")
輸出
ResNet-50        RF  427 px   output   8x8       5.34 GMACs
plain 64ch x 34  RF   69 px   output 256x256    77.54 GMACs
U-Net 4 levels   RF  206 px   output 256x256    14.47 GMACs
U-Net 的跳接在計算中省略了,因為最深的那條路徑決定了感受野(對所有路徑暴力檢查,得到的同樣是 206)。圖 5 畫出成長的過程。ResNet-50 用 5.3 GMAC 達到 427 像素,但回傳的是 的特徵圖;一般的復原網路每層只多 2 個像素,用 77.5 GMAC 才有 69 像素;U-Net 在全輸出解析度下達到 206 像素,運算量不到前者的五分之一。這些是理論上的感受野;用梯度量得的有效感受野較小,而且集中在中央 [42](DLCV 01)。
選讀:經過上取樣與跳接的感受野(見「補充資料」頁)。逐步說明往回推的區間方法、上取樣之後為什麼對齊很重要,以及為什麼最深的路徑決定結果。
為復原而組合
白話版。 復原網路要回傳一張大小相同(超解析度則是更大)、而且幾乎就是輸入的影像。所以它保持解析度,或藉由跳接回到原解析度;它只預測修正量;它避免會改變強度範圍的層;它取得脈絡,卻不必在每一層都為全解析度付費。
原則:
- 保持解析度,或回到原解析度。 X-Restormer 背後的比較研究把復原網路分成三種架構:U 形編碼器–解碼器(如 Restormer 與 NAFNet)、保持原始大小的一般 residual-in-residual 網路(RCAN、SwinIR),以及多階段漸進式網路(用好幾個子網路依序處理影像)[22]。它形容一般設計有利於重建高頻細節但很昂貴,U 形設計則因為下取樣而讓感受野快速成長,能處理大的輸入 [22]。圖 1(b) 與 (c) 畫出兩種主要的形狀。
- 學殘差。 輸出是輸入加上預測的修正量,,其中 是退化的輸入, 是網路。VDSR 預測的是高解析度影像與其內插後輸入之間的殘差 [43];DnCNN 預測雜訊 [29];SwinIR 對不需要上取樣的任務使用 [4];Restormer 輸出殘差影像 並回傳 [21];NAFNet 的程式碼把輸入加到最後一個卷積的輸出上 [14]。修正量很小、以零為中心,所以不必把容量浪費在複製影像上。
- 為低頻加一條長跳接。 SwinIR 把淺層特徵直接送到重建模組,,因為淺層特徵主要含有低頻,深層特徵就能專心處理遺失的高頻 [4]。EDSR 與 RCAN 在主體或群組外圍使用長跳接 [12]、[15]。
- 保住強度範圍。 主體不用 BN(EDSR、ESRGAN),正規化只放在殘差分支內(NAFNet、Restormer、SwinIR),如正規化一節所示 [12]、[28]。
- 讓感受野配合退化,並且花得聰明。 X-Restormer 的研究主張,超解析度主要依賴局部資訊與強的空間映射,U 形的下取樣與上取樣對去雜訊有幫助,而動態去模糊與去霧需要大範圍或全域的資訊 [22]。感受野的程式碼顯示了代價:全解析度的主體每層只多幾個像素的感受野,卻要付全額成本;下取樣讓感受野快速且便宜地成長;通道注意力或狀態空間掃描則以線性成本涵蓋整張影像 [21]、[44]。
- 依目標設計輸出層。 最後一層是普通卷積(SwinIR 在去雜訊時的重建、Restormer 的最後一個卷積、NAFNet 的結尾層 [4]、[21]、[14]);在那裡接 ReLU 或 sigmoid 會截掉修正量。超解析度則把上取樣器放在最後,讓主體在低解析度下執行(DLCV 09A)。
- 為完整大小的測試影像做準備。 復原網路用裁切區塊訓練,卻在整張影像上測試。U-Net 需要大小能被 整除,NAFNet 的程式碼用補邊處理這件事 [14]。全域統計量(例如通道注意力的池化)在訓練時涵蓋的是一個裁切區塊,測試時涵蓋的卻是整張影像;NAFNet 指出這會降低效能,並採用先前研究的補救辦法 [19],Restormer 則以逐步加大的 patch 訓練 [21]。
選讀:A Comparative Study of Image Restoration Networks for General Backbone Network Design(X-Restormer)(見「論文導讀」頁)。哪種骨幹網路在哪種退化上勝出,以及為什麼。
並排比較:改了什麼、為什麼
白話版。 看出組合如何運作最快的方法,是把一個分類模型和由它衍生的復原模型並排放,列出差異。每項差異都有上面兩份清單中的理由。
ResNet 對 EDSR 與 NAFNet
| 元件 | ResNet [1] | EDSR [12] | NAFNet [19]、[14] | 為什麼改 |
|---|---|---|---|---|
| Stem | 步幅 2 的 + 最大池化 | 一個 卷積 | 一個 卷積 | 保留每個像素 |
| 解析度 | 4 個 stage,輸出步幅 32 | 固定(低解析度輸入的大小) | U 形,下取樣用步幅 2 的 2×2 卷積,上取樣用 卷積 + pixel shuffle | 細節與脈絡的取捨 |
| 區塊 | conv-BN-ReLU-conv-BN,相加,ReLU | conv-ReLU-conv,×0.1(大模型),相加 | LN、、 dw、SimpleGate、SCA、、×β、相加;然後是閘控 MLP、×γ、相加 | 保住範圍;便宜的閘控 |
| 正規化 | BN | 無 | 分支內使用 LayerNorm | 見正規化一節 |
| 跳接 | 只有短跳接 | 短跳接 + 繞過主體的長跳接 | 短跳接 + 層級之間的相加跳接 + 全域殘差 | 低頻繞過主體 |
| Head | 全域平均池化 + FC | 取樣器(卷積 + pixel shuffle)+ 卷積 | 卷積 + 輸入 | 輸出是影像 |
| 損失 | 交叉熵 | L1 | 消融實驗中用 PSNR 損失 | 迴歸目標 |
EDSR 自己的表列出了從 SRResNet 出發的步驟:兩個基準模型都是 16 個區塊、每個 64 個濾波器,移除 BN,用 L1 取代 L2,完整模型則是 32 個區塊、每個 256 個濾波器,加上 0.1 的殘差縮放,參數量從 1.5M 增加到 43M [12]。
Swin 對 SwinIR
| 元件 | Swin [6] | SwinIR [4] | 為什麼改 |
|---|---|---|---|
| 輸入 | patch 切分與線性嵌入 | 全解析度的 卷積(淺層特徵) | 每個像素一個 token |
| 階層 | 4 個 stage 之間做 patch merging | 沒有:6 個殘差 Swin Transformer 區塊(RSTB),解析度固定 | 復原需要每個像素 |
| 視窗 | (JPEG 偽影移除用 7) | JPEG [45] 以 8 × 8 為單位編碼;作者觀察到用 8 時表現下降 | |
| 區塊群組 | Swin 層 | 每個 RSTB 含 6 個 Swin 層 + 一個 卷積 + 一條殘差連接 | 卷積帶來平移等變性;殘差有助於聚合 |
| Head | 全域平均池化 + 線性層 | 作用在 上的卷積(SR 另加 pixel shuffle) | 低頻繞過主體 |
| 寬度 | 96 個通道以上 | 180 個通道,6 個頭 | 在準確率與大小之間取得平衡 |
SwinIR 的消融實驗報告,每個 RSTB 內的殘差連接使 PSNR [30] 提高 0.16 dB,而在那裡改用 卷積幾乎沒有進步,可能是因為它不像 卷積那樣能擷取局部相鄰的資訊 [4]。JPEG 視窗大小是一個很好的例子,說明組合上的選擇會與資料互相影響:作者推測 時的下降,可能來自 JPEG 的 區塊切分。
ViT 對 Restormer
| 元件 | ViT [3] | Restormer [21] | 為什麼改 |
|---|---|---|---|
| Token | 的 patch | 每個像素(經卷積嵌入) | 不丟掉任何資訊 |
| Token 混合器 | 對 patch 的全域自注意力, 的圖 | MDTA:通道注意力, 的圖,搭配深度卷積 | 成本隨像素線性增加,仍有全域涵蓋 |
| 通道混合器 | MLP,4 倍擴張,GELU | GDFN:閘控、深度卷積、擴張 2.66 | 閘控與局部脈絡 |
| 形狀 | 等向,單一解析度 | 4 層 U 形,pixel-unshuffle 下取樣,pixel-shuffle 上取樣,串接 + 的跳接,加上精修 stage | 以可負擔的成本做多尺度 |
| Head | class token + MLP | 卷積成殘差影像,加到輸入上 | 輸出是影像 |
| 訓練 | 固定解析度 | 逐步加大的 patch,從 開始 | 從更大的區域學習 |
Restormer 的設定從第 1 層到第 4 層使用 [4, 6, 6, 8] 個區塊、[1, 2, 4, 8] 個頭與 [48, 96, 192, 384] 個通道,另外精修 stage 有 4 個區塊 [21]。兩欄都在 pre-norm 的殘差分支裡使用 LayerNorm:Transformer 區塊本身保留了下來;改變的是 token 混合器,以及它周圍的整體架構。
探索設計空間
白話版。 設計上的問題(「區塊 X 有幫助嗎?」)沒有一般性的答案;它只在一組特定的其他選擇、資料與預算下才有答案。所以一次只改一件事,固定預算,看不只一個任務或隨機種子,而且可以的話,比較整個模型族群,而不是只看單一優勝者。
讀一份消融實驗
NAFNet 的論文是可讀性很高的消融實驗範本。它從 U-Net 中由卷積、ReLU 與捷徑組成的基本區塊出發,在 16 GMAC 的固定預算下,一次加入一項改動,並報告在 SIDD [31](真實相機去雜訊)與 GoPro [32](動態去模糊)上的 PSNR [19]:
| 步驟 | SIDD (dB) | GoPro (dB) |
|---|---|---|
| PlainNet | 39.29 | 28.51 |
| + LayerNorm(以及大 10 倍的學習率) | 39.73 | 31.90 |
| ReLU → GELU | 39.71 | 32.11 |
| + 通道注意力 | 39.85 | 32.35 |
| GELU → SimpleGate | 39.93 | 32.76 |
| CA → 簡化 CA | 39.96 | 32.85 |
讀這類表格時要檢查:
- 預算固定嗎? 這裡是固定的(16 GMAC),所以進步不只是「多用了運算」。
- 步驟是累積的嗎? 是的:每一列都包含前面所有的改動,所以這張表衡量的是每項改動在前面改動已經存在的前提下的效果,而不是單獨的效果。換個順序,增量可能不同。
- 各任務一致嗎? 不一定:GELU 在 SIDD 上沒有差別,在 GoPro 上卻有幫助。對某種退化重要的改動,對另一種不一定重要。
- 訓練配方與區塊混在一起了嗎? LayerNorm 那一列同時改了學習率,因為 LayerNorm 讓較大的學習率變得穩定。作者明確說出了這一點;許多論文沒有。
- 雜訊有多大? 每列只跑一次,就沒有誤差線。差幾百分之一 dB 的差異,應該讀成「沒有損失」,論文對最後一列就是這樣解讀的。
選讀:Simple Baselines for Image Restoration(NAFNet)(見「論文導讀」頁)。論文提出的問題、它如何建立再簡化它的區塊,以及它的主張代表什麼、不代表什麼。
ConvNeXt 的路線圖對分類也是同樣的讀法:ResNet-50 光靠現代訓練配方,ImageNet top-1 就從 76.1% 提高到 78.8%,再經過一連串架構改動提高到 82.0%,其中最大的單項改動所增加的,還不到配方的貢獻 [2]。這就是為什麼用不同配方訓練的架構不能直接比較(DLCV 01A)。
選讀:ConvNeXt 路線圖,一步一步(見「補充資料」頁)。每一步與它的準確率,以及運算量在過程中怎麼變。
比較族群:設計空間
RegNet 把「哪個單一模型最好?」換成「哪個設計空間更常產生好模型?」[16]。設計空間是由幾個參數(每個 stage 的區塊數、寬度、瓶頸比例、群組寬度)定義的一組模型。使用的工具是誤差經驗分布函數(error empirical distribution function):
其中 是從該空間取樣並訓練的 個模型中第 個的誤差, 在其引數為真時等於 1、否則為 0, 是誤差低於 的模型所占的比例。曲線位置較高的空間,整體而言比較好,這比比較兩個手工調整的模型穩健得多。RegNet 取樣了 個模型,運算量為 3.6 億到 4 億 FLOPs,每個訓練 10 個 epoch,並保留不會損害曲線(共用的瓶頸比例與群組寬度)或能改善曲線(寬度與深度隨 stage 遞增)的限制 [16]。最好的模型在各種運算量級下都有約 20 個區塊,不用瓶頸,而且受益於 SE [16]。
選讀:Designing Network Design Spaces(RegNet)(見「論文導讀」頁)。這項研究如何一步步精修設計空間,以及如何讀它的分布圖。
選讀:RegNet 的量化線性寬度(見「補充資料」頁)。把一條直線變成各 stage 寬度與深度的三個式子,附有已測試的程式碼。
實用流程
- 在比較區塊之前,先固定預算(MAC、參數量、記憶體或實測延遲)與訓練配方。
- 一次只改一件事,並記錄每一次執行,包括沒有幫助的。
- 在不只一個任務、資料集或隨機種子上評估;報告變異範圍。
- 在目標模型大小上確認;對很小的模型有幫助的區塊,對大模型未必有幫助。
- 做架構搜尋時,用 NAS 綜述的三個維度來思考:搜尋空間、搜尋策略,以及如何估計效能 [46]。便宜的估計(如短時間訓練,RegNet 的 10 個 epoch)適合用來為族群排序,但應該用完整訓練加以確認。
常見的組合錯誤
白話版。 多數架構上的錯誤不是積木選錯,而是對的積木放在錯的地方。下面的清單列出症狀、原因與解法。
- 在復原的主體使用 BN。 症狀:亮度或顏色隨批次飄移,或測試時出現偽影。解法:拿掉 BN,或在殘差分支內做逐樣本的正規化,並搭配全域殘差。
- 每個裝置的批次很小,卻用 BN(偵測、分割、高解析度)。解法:GroupNorm,或凍結預訓練的 BN 統計量(DLCV 01A)。
- 轉置卷積的卷積核大小不能被步幅整除。 症狀:棋盤格紋理。解法:resize-convolution,或初始化一致的 pixel shuffle。
- 復原網路沒有全域殘差。 網路必須先學會複製影像,才能修正它。解法:預測修正量。
- 輸出端接 ReLU 或 sigmoid。 修正量不能是負的,或亮部飽和。解法:最後一層用線性層;只在顯示與評估時才截斷。
- 感受野比退化還小。 症狀:大範圍的模糊或霧仍然殘留。解法:加下取樣層級、空洞卷積或全域混合;先計算感受野。
- 復原網路過早下取樣,或直接沿用分類骨幹:細微的細節遺失。解法:保留一條全解析度路徑(跳接、精修 stage)。
- 在全解析度上做全域注意力,記憶體會爆掉。改用視窗、通道注意力或下取樣。
- U-Net 的輸入大小不能被 整除,或搭配串接跳接時使用奇數大小。症狀:形狀錯誤或跳接錯位。解法:補邊再裁切,如 NAFNet 的程式碼所做 [14]。
- 把參數量當成速度。 深度卷積與大量串接的設計,即使參數或 MAC 很少,也可能很慢。請實測延遲與記憶體。
- 比較用不同配方或預算訓練的設計:配方本身的貢獻,可能超過任何單一區塊 [2]。
- 忽略與資料的交互作用,例如 SwinIR 的視窗大小與 JPEG 的區塊 [4]。
現代觀點
綜述怎麼說
Khan 等人 [47] 回顧 CNN 架構,把其中的創新分成七類:空間利用、深度、多路徑、寬度、特徵圖利用、通道增強與注意力。這套分類對本章很有用,因為大多數類別是組合上的選擇(深度、寬度、多路徑連接),而不是新的層類型。
Guo 等人 [20] 綜述電腦視覺中的注意力,依「選擇什麼」來分類:通道注意力(注意什麼,例如 SE)、空間注意力(注意哪裡,包含自注意力)、時間注意力(注意何時)、分支注意力(注意哪個分支),以及兩種混合:通道加空間(例如 CBAM)與空間加時間。他們把注意力視為依輸入而定的「動態權重調整」,與本章的閘觀點相符。
Khan 等人 [48] 回顧視覺中的 Transformer,從自注意力的基礎與大規模預訓練,談到辨識、偵測、分割、生成、影片與低階視覺的應用,比較常見設計的優缺點,最後提出尚待研究的方向。
Elsken、Metzen 與 Hutter [46] 沿著三個維度整理神經架構搜尋:搜尋空間、搜尋策略與效能估計策略。這份綜述是本章手動探索設計空間之後,很自然的下一步。
Chen 等人 [22] 是比較研究而不是綜述:它在五項任務上對五種復原骨幹網路(包括 SwinIR、Restormer 與 NAFNet)做基準測試,依架構(U 形、一般 residual-in-residual、多階段)與核心運算(卷積、空間自注意力、轉置自注意力)分類,並發現在某項任務上很強的網路,常常在另一項任務上表現不足。
2023–2026 年的最新進展
- 卷積與注意力收斂到同一種區塊形狀。 ConvNeXt V2 在 ConvNeXt 上加了 Global Response Normalization 層與遮罩自編碼器預訓練 [49];MetaFormer 的觀點把 token 混合器視為一個可互換的零件 [8]。
- 預訓練和區塊一樣重要。 Battle of the Backbones 在超過 1,500 次訓練中比較了許多預訓練骨幹網路在各項任務上的表現,發現在它考慮的多數任務上,以大型資料集監督式預訓練的卷積網路仍然表現最好,而自監督骨幹網路在對照的比較中具有競爭力 [50]。
- 復原網路混用運算。 HAT 把通道注意力與視窗自注意力結合,並加入視窗之間重疊的交叉注意力 [51];X-Restormer 把 Restormer 一半的通道注意力區塊換成空間注意力區塊,以強化它的空間映射 [22];MambaIR 與 MambaIRv2 用能以線性成本涵蓋整張影像的狀態空間掃描取代注意力,加入局部增強與通道注意力,v2 更加入非因果的「注意力式」建模 [44]、[52]。
尚未解決的問題
- 通用的復原骨幹網路。 沒有任何單一組合在所有退化上都最好;比較研究把「任務通用性」視為尚待達成的目標 [22]。
- 公平的比較。 架構、訓練配方與預訓練糾纏在一起,而像 RegNet 這種族群層級的研究需要數百次訓練 [16],對高解析度的復原模型來說太昂貴。
- 實際的感受野。 理論感受野很容易算;訓練好的復原網路實際用了多少脈絡則難以測量,而歸因分析顯示它可能比設計所允許的少 [51]、[42]。
- 成本模型。 MAC、記憶體搬運與延遲彼此不一致,尤其是深度卷積、閘控與注意力;設計規則仍然取決於硬體。
- 架構內部的訓練–測試偏移。 全域統計量(池化、正規化、注意力)在裁切區塊與完整影像上的行為不同,而目前採用的補救辦法改的是訓練或測試流程,而不是架構 [19]、[21]。
選讀:NAFNet(見「論文導讀」頁)。檢查受控基準、乘法閘門,以及移除啟用函數的真正意思。
重點整理
- 比較個別區塊前,先追蹤解析度變化與跳接路徑。
- 在相同成本下比較空間/通道混合;延遲須與參數量及 MACs 分開量測。
- 分類器常下採樣再池化;復原器則須保留或重建空間細節與強度。
- 殘差學習與長跳接保留輸入的直接路徑,並須檢查輸出層允許的數值範圍。
- 使用批次統計的正規化會引入批次相依性;逐樣本正規化仍可能移除有用的強度資訊。
- 把偽影歸咎於訓練資料前,先檢查上採樣相位平衡、跳接對齊與填補。
- 區分區塊與訓練配方的影響,並比較設計家族,而不只比較單一最高分模型。
練習
- 減半與加倍。 一個 stage 在 的特徵圖上,執行 128 個通道的 卷積。(a) 這樣的一層要花多少 MAC?(b) 下一個 stage 把特徵圖減半、寬度加倍;現在一層要花多少?(c) 如果改成把寬度變成三倍,成本會怎麼變?
提示
(a) 次 MAC。(b) 是同一個數字。(c) 通道數變成 時,成本是 ,也就是 (a) 的 :寬度以平方進入,面積則是線性。
- 區塊預算。 使用
blocks函數,在 時,找出擴張倍率 為多少時,輸入與輸出都是 個通道的反向殘差,成本會和基本殘差區塊相同。接著找出寬度 為多少時, 的反向殘差成本會和 的基本區塊相同。這對「在相同寬度下比較區塊」說明了什麼?
提示
令 ; 時得到 。第二個問題要解 ,得到 。反向殘差在相同寬度下並不「便宜」;它之所以便宜,是因為 MobileNet 把它用在細的張量上。
- 批次大小為一的 BN。 在正規化的程式碼中,用
'bn-train'單獨復原 (批次大小為 1)。把輸出平均值與'instance'的結果比較,並解釋批次大小為 1 的 BN 與實例正規化之間的關係。接著在批次中加入 32 張隨機的中灰度影像,看看訓練模式與評估模式能靠得多近。
提示
時,BN 在 上的統計量,正好就是逐樣本、逐通道的統計量,所以結果等於實例正規化(0.521)。當有許多來自訓練分布的影像時,批次統計量會趨近移動平均,輸出也趨近評估模式的值。
- 讓轉置卷積變平坦。 對 、,寫出 16 個卷積核權重要滿足什麼條件,平坦輸入才會得到平坦輸出(邊界以外)。用一個隨機的 卷積核構造出這樣的卷積核,用上取樣程式碼檢查,並把它和 resize-convolution 連起來看。
提示
對 ,四個相位和 必須相等。一種構造方式是對任意 卷積核 v,令 w = np.kron(v, np.ones((2, 2))):這樣每個相位剛好接收 v 的每個元素一次,所以所有相位和都等於 v 的總和。Resize-convolution 對任何卷積核都有同樣的性質,這就是它平坦的原因。
- 設計的感受野。 把感受野程式碼中的 U-Net 改成三層而不是四層,以及四層但每層三個卷積。哪一種改動每 GMAC 換到更多的感受野?接著把一般網路中間的 32 層換成 16 層擴張率為 2 的層(在
analyze中加入擴張率欄位)。新的感受野是多少?這種設計有 DLCV 04 中的哪個問題的風險?
提示
卷積核為 、擴張率為 的層,涵蓋 個輸入,所以在往回推的步驟中,把 k - 1 換成 d * (k - 1)。拿掉一個層級,等於拿掉 U-Net 中最粗、最便宜、感受野最大的部分;每層多加卷積,則會在每個解析度都增加成本。堆疊擴張率相同的層,會讓感受野出現空洞(網格效應,gridding)。
參考文獻
-
K. He, X. Zhang, S. Ren and J. Sun, “Deep Residual Learning for Image Recognition,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016. CVF · arXiv
-
Z. Liu, H. Mao, C.-Y. Wu, C. Feichtenhofer, T. Darrell and S. Xie, “A ConvNet for the 2020s,” in Proc. IEEE/CVF CVPR, 2022. CVF · arXiv
-
A. Dosovitskiy, L. Beyer, A. Kolesnikov, D. Weissenborn, X. Zhai, T. Unterthiner, M. Dehghani, M. Minderer et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” in International Conference on Learning Representations (ICLR), 2021. arXiv
-
J. Liang, J. Cao, G. Sun, K. Zhang, L. Van Gool and R. Timofte, “SwinIR: Image Restoration Using Swin Transformer,” in Proc. IEEE/CVF International Conference on Computer Vision Workshops (ICCVW), 2021. CVF · arXiv
-
T.-Y. Lin, P. Dollár, R. Girshick, K. He, B. Hariharan and S. Belongie, “Feature Pyramid Networks for Object Detection,” in Proc. IEEE CVPR, 2017. CVF · arXiv
-
Z. Liu, Y. Lin, Y. Cao, H. Hu, Y. Wei, Z. Zhang, S. Lin and B. Guo, “Swin Transformer: Hierarchical Vision Transformer Using Shifted Windows,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV), 2021. CVF · arXiv
-
O. Russakovsky, J. Deng, H. Su, J. Krause, S. Satheesh, S. Ma, Z. Huang, A. Karpathy et al., “ImageNet Large Scale Visual Recognition Challenge,” International Journal of Computer Vision, vol. 115, no. 3, pp. 211–252, 2015. doi
-
W. Yu, M. Luo, P. Zhou, C. Si, Y. Zhou, X. Wang, J. Feng and S. Yan, “MetaFormer Is Actually What You Need for Vision,” in Proc. IEEE/CVF CVPR, 2022. CVF · arXiv
-
A. G. Howard, M. Zhu, B. Chen, D. Kalenichenko, W. Wang, T. Weyand, M. Andreetto and H. Adam, “MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications,” arXiv:1704.04861, 2017. arXiv
-
M. Sandler, A. Howard, M. Zhu, A. Zhmoginov and L.-C. Chen, “MobileNetV2: Inverted Residuals and Linear Bottlenecks,” in Proc. IEEE/CVF CVPR, 2018. CVF · arXiv
-
K. He, X. Zhang, S. Ren and J. Sun, “Identity Mappings in Deep Residual Networks,” in Proc. European Conference on Computer Vision (ECCV), LNCS, Springer, 2016. doi · arXiv
-
B. Lim, S. Son, H. Kim, S. Nah and K. M. Lee, “Enhanced Deep Residual Networks for Single Image Super-Resolution,” in Proc. IEEE CVPR Workshops (CVPRW), 2017. CVF · arXiv
-
H. Touvron, M. Cord, A. Sablayrolles, G. Synnaeve and H. Jégou, “Going Deeper With Image Transformers,” in Proc. IEEE/CVF ICCV, 2021. CVF
-
L. Chen, X. Chu, X. Zhang and J. Sun, NAFNet official implementation,
basicsr/models/archs/NAFNet_arch.py, GitHub (megvii-research/NAFNet), accessed 2026. code -
Y. Zhang, K. Li, K. Li, L. Wang, B. Zhong and Y. Fu, “Image Super-Resolution Using Very Deep Residual Channel Attention Networks,” in Proc. ECCV, 2018. CVF · arXiv
-
I. Radosavovic, R. P. Kosaraju, R. Girshick, K. He and P. Dollár, “Designing Network Design Spaces,” in Proc. IEEE/CVF CVPR, 2020. CVF · arXiv
-
J. Hu, L. Shen and G. Sun, “Squeeze-and-Excitation Networks,” in Proc. IEEE/CVF CVPR, 2018. CVF · arXiv
-
S. Woo, J. Park, J.-Y. Lee and I. S. Kweon, “CBAM: Convolutional Block Attention Module,” in Proc. ECCV, 2018. CVF · arXiv
-
L. Chen, X. Chu, X. Zhang and J. Sun, “Simple Baselines for Image Restoration,” in Proc. ECCV, LNCS, Springer, 2022. doi · arXiv
-
M.-H. Guo, T.-X. Xu, J.-J. Liu, Z.-N. Liu, P.-T. Jiang, T.-J. Mu, S.-H. Zhang, R. R. Martin, M.-M. Cheng and S.-M. Hu, “Attention Mechanisms in Computer Vision: A Survey,” Computational Visual Media, vol. 8, no. 3, pp. 331–368, 2022. doi · arXiv
-
S. W. Zamir, A. Arora, S. Khan, M. Hayat, F. S. Khan and M.-H. Yang, “Restormer: Efficient Transformer for High-Resolution Image Restoration,” in Proc. IEEE/CVF CVPR, 2022. CVF · arXiv
-
X. Chen, Z. Li, Y. Pu, Y. Liu, J. Zhou, Y. Qiao and C. Dong, “A Comparative Study of Image Restoration Networks for General Backbone Network Design,” in Proc. ECCV 2024, LNCS, Springer, 2025. doi · arXiv
-
S. Ioffe and C. Szegedy, “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift,” in Proc. International Conference on Machine Learning (ICML), PMLR 37, 2015. PMLR
-
J. L. Ba, J. R. Kiros and G. E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. arXiv
-
D. Ulyanov, A. Vedaldi and V. Lempitsky, “Instance Normalization: The Missing Ingredient for Fast Stylization,” arXiv:1607.08022, 2016. arXiv
-
Y. Wu and K. He, “Group Normalization,” in Proc. ECCV, 2018. CVF · arXiv
-
C. Ledig, L. Theis, F. Huszár, J. Caballero, A. Cunningham, A. Acosta, A. Aitken, A. Tejani, J. Totz, Z. Wang and W. Shi, “Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network,” in Proc. IEEE CVPR, 2017. CVF
-
X. Wang, K. Yu, S. Wu, J. Gu, Y. Liu, C. Dong, Y. Qiao and C. C. Loy, “ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks,” in Proc. ECCV Workshops, 2018. CVF · arXiv
-
K. Zhang, W. Zuo, Y. Chen, D. Meng and L. Zhang, “Beyond a Gaussian Denoiser: Residual Learning of Deep CNN for Image Denoising,” IEEE Transactions on Image Processing, vol. 26, no. 7, pp. 3142–3155, 2017. doi · arXiv
-
Q. Huynh-Thu and M. Ghanbari, “Scope of Validity of PSNR in Image/Video Quality Assessment,” Electronics Letters, vol. 44, no. 13, pp. 800–801, 2008. doi
-
A. Abdelhamed, S. Lin and M. S. Brown, “A High-Quality Denoising Dataset for Smartphone Cameras,” in Proc. IEEE/CVF CVPR, 2018. CVF
-
S. Nah, T. H. Kim and K. M. Lee, “Deep Multi-Scale Convolutional Neural Network for Dynamic Scene Deblurring,” in Proc. IEEE CVPR, 2017. CVF
-
N. Shazeer, “GLU Variants Improve Transformer,” arXiv:2002.05202, 2020. arXiv
-
Y. N. Dauphin, A. Fan, M. Auli and D. Grangier, “Language Modeling with Gated Convolutional Networks,” in Proc. ICML, PMLR 70, 2017. PMLR
-
D. Hendrycks and K. Gimpel, “Gaussian Error Linear Units (GELUs),” arXiv:1606.08415, 2016. arXiv
-
W. Shi, J. Caballero, F. Huszár, J. Totz, A. P. Aitken, R. Bishop, D. Rueckert and Z. Wang, “Real-Time Single Image and Video Super-Resolution Using an Efficient Sub-Pixel Convolutional Neural Network,” in Proc. IEEE CVPR, 2016. CVF · arXiv
-
A. Odena, V. Dumoulin and C. Olah, “Deconvolution and Checkerboard Artifacts,” Distill, vol. 1, no. 10, 2016. Distill · doi
-
A. Aitken, C. Ledig, L. Theis, J. Caballero, Z. Wang and W. Shi, “Checkerboard Artifact Free Sub-Pixel Convolution: A Note on Sub-Pixel Convolution, Resize Convolution and Convolution Resize,” arXiv:1707.02937, 2017. arXiv
-
O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” in Proc. Medical Image Computing and Computer-Assisted Intervention (MICCAI), LNCS, Springer, pp. 234–241, 2015. doi · arXiv
-
G. Huang, Z. Liu, L. van der Maaten and K. Q. Weinberger, “Densely Connected Convolutional Networks,” in Proc. IEEE CVPR, 2017. CVF
-
L.-C. Chen, G. Papandreou, I. Kokkinos, K. Murphy and A. L. Yuille, “DeepLab: Semantic Image Segmentation with Deep Convolutional Nets, Atrous Convolution, and Fully Connected CRFs,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 40, no. 4, pp. 834–848, 2018. doi · arXiv
-
W. Luo, Y. Li, R. Urtasun and R. Zemel, “Understanding the Effective Receptive Field in Deep Convolutional Neural Networks,” in Advances in Neural Information Processing Systems (NeurIPS), 2016. NeurIPS · arXiv
-
J. Kim, J. K. Lee and K. M. Lee, “Accurate Image Super-Resolution Using Very Deep Convolutional Networks,” in Proc. IEEE CVPR, 2016. CVF · arXiv
-
H. Guo, J. Li, T. Dai, Z. Ouyang, X. Ren and S.-T. Xia, “MambaIR: A Simple Baseline for Image Restoration with State-Space Model,” in Proc. ECCV 2024, LNCS, Springer, 2025. doi · arXiv
-
ITU-T, “Recommendation T.81: Information technology – Digital compression and coding of continuous-tone still images – Requirements and guidelines” (the JPEG standard), 1992. ITU
-
T. Elsken, J. H. Metzen and F. Hutter, “Neural Architecture Search: A Survey,” Journal of Machine Learning Research, vol. 20, 2019. JMLR · arXiv
-
A. Khan, A. Sohail, U. Zahoora and A. S. Qureshi, “A Survey of the Recent Architectures of Deep Convolutional Neural Networks,” Artificial Intelligence Review, vol. 53, no. 8, pp. 5455–5516, 2020. doi · arXiv
-
S. Khan, M. Naseer, M. Hayat, S. W. Zamir, F. S. Khan and M. Shah, “Transformers in Vision: A Survey,” ACM Computing Surveys, vol. 54, no. 10s, 2022. doi · arXiv
-
S. Woo, S. Debnath, R. Hu, X. Chen, Z. Liu, I. S. Kweon and S. Xie, “ConvNeXt V2: Co-Designing and Scaling ConvNets With Masked Autoencoders,” in Proc. IEEE/CVF CVPR, 2023. CVF · arXiv
-
M. Goldblum, H. Souri, R. Ni, M. Shu, V. Prabhu, G. Somepalli, P. Chattopadhyay, M. Ibrahim et al., “Battle of the Backbones: A Large-Scale Comparison of Pretrained Models across Computer Vision Tasks,” in Advances in Neural Information Processing Systems (NeurIPS), 2023. arXiv
-
X. Chen, X. Wang, J. Zhou, Y. Qiao and C. Dong, “Activating More Pixels in Image Super-Resolution Transformer,” in Proc. IEEE/CVF CVPR, 2023. CVF · arXiv
-
H. Guo, Y. Guo, Y. Zha, Y. Zhang, W. Li, T. Dai, S.-T. Xia and Y. Li, “MambaIRv2: Attentive State Space Restoration,” in Proc. IEEE/CVF CVPR, 2025. CVF · arXiv
-
A. Araujo, W. Norris and J. Sim, “Computing Receptive Fields of Convolutional Neural Networks,” Distill, vol. 4, no. 11, 2019. Distill · doi
-
X. Ding, X. Zhang, N. Ma, J. Han, G. Ding and J. Sun, “RepVGG: Making VGG-style ConvNets Great Again,” in Proc. IEEE/CVF CVPR, pp. 13733–13742, 2021. CVF paper
-
S. Zagoruyko and N. Komodakis, “DiracNets: Training Very Deep Neural Networks Without Skip-Connections,” arXiv:1706.00388, 2017. arXiv
-
X. Ding, Y. Guo, G. Ding and J. Han, “ACNet: Strengthening the Kernel Skeletons for Powerful CNN via Asymmetric Convolution Blocks,” in Proc. IEEE/CVF ICCV, 2019. CVF
-
H. Zhao, J. Shi, X. Qi, X. Wang and J. Jia, “Pyramid Scene Parsing Network,” in Proc. IEEE CVPR, 2017. CVF
-
M. Cordts, M. Omran, S. Ramos, T. Rehfeld, M. Enzweiler, R. Benenson, U. Franke, S. Roth and B. Schiele, “The Cityscapes Dataset for Semantic Urban Scene Understanding,” in Proc. IEEE CVPR, 2016. CVF
-
E. D. Cubuk, B. Zoph, D. Mane, V. Vasudevan and Q. V. Le, “AutoAugment: Learning Augmentation Strategies From Data,” in Proc. IEEE/CVF CVPR, 2019. CVF
-
H. Zhang, M. Cisse, Y. N. Dauphin and D. Lopez-Paz, “mixup: Beyond Empirical Risk Minimization,” in Proc. ICLR, 2018. arXiv
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 01C・模型壓縮與高效推論 · 36 分鐘