DLCV 13・世界模型:影片、潛在動態與規劃
先備知識:ML 04・循環與遞迴神經網路、ML 10・基礎模型與視覺語言學習、DLCV 07・物件追蹤:從單一物件到多物件
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分觀測、隱藏狀態、信念與動作。
- 比較線上規劃、想像中的策略學習與價值等價搜尋。
- 區分合理影片預測與有用的動作條件化模擬。
- 理解循環與特徵預測式潛在動態。
- 量測多步誤差,並偵測規劃器利用模型錯誤的情況。
先看全貌
追蹤問的是物體去了哪裡。世界模型問的是接下來可能發生什麼,尤其是如果代理人採取某個動作會發生什麼。機器人靠近杯子時,光有物體標籤不夠:它需要預測夾爪和杯子會怎麼移動、哪些結果不確定,以及哪個動作較可能達成目標。
「世界模型」一詞涵蓋好幾個研究傳統。Ding 等人依兩種功能整理文獻:建立能捕捉世界運作方式的內部表示,以及預測未來狀態以模擬並引導決策 [1]。本章採用一個操作型定義:世界模型是一個學習得到的模型,它表示足夠多的環境資訊,能在指定條件(通常包括代理人自己的動作)下預測相關的變化。它的用處取決於任務。用來渲染場景的模型、用來學習表示的模型,以及用來控制機器人的模型,可能需要非常不同的資訊。
觀測、狀態、信念與動作
白話版。 影像只揭露環境的一部分,記憶或信念須處理隱藏物件與未觀測運動。
令 表示時間 的真實環境狀態, 為觀測, 為執行的動作:
第一個分布是轉移(動態)模型,第二個是觀測模型。狀態可能包含物體位置、速度與接觸條件。影像只呈現一個投影,帶有遮擋與感測器雜訊;Szeliski 的教科書涵蓋這個觀測過程中的幾何與運動 [3]。兩張完全相同的影像可能有不同的未來:同一個位置的球,可能正往左也可能正往右。
因此,學習得到的模型會從歷史建立表示:
其中 是參數為 的編碼器, 是到時間 為止的觀測序列, 是學到的潛在轉移。編碼器不會自動讓 成為充分的狀態。若它丟掉了速度、被遮住的物體或某個相關的材質性質,轉移模型就無法找回這些資訊。循環記憶或一小段影片上下文會有幫助,但必須在實際的遮擋與延遲下測試。
當狀態只能被部分觀測時,有原則的對象是信念:在已知歷史下,對可能狀態的一個機率分布。Bishop 對序列潛在變數模型(隱藏馬可夫模型與線性動態系統)的說明提供了機率背景 [2]。一個緊湊的潛在向量可以近似這個分布中有用的部分;它不必一對一地對應到人類看得懂的物理變數。
預測的分解
預測未來可以拆成三個問題:現在處在什麼狀態?在這些動作下狀態怎麼變化?攝影機會看到什麼?
對一個候選的動作序列,未來觀測的機率可分解為
其中 是預測視野。三個因子分別是推論(給定過去,目前的潛在狀態是什麼?)、轉移(它在這些動作下如何演變?)與渲染(相機會看到什麼?)。如果目標與成本定義在潛在空間中,規劃器可以直接在 上運作,省略像素解碼器。本章許多設計選擇,其實就是決定要學哪些因子、怎麼學。
模型式強化學習
白話版。 學得的動態模型讓代理人在模擬中測試動作;預測有用時,可能減少真實嘗試。
問題設定
RL 代理人以離散步驟與環境互動。每一步它觀測環境,依策略 選擇 ,得到獎勵 ,環境隨之改變。目標是最大化期望回報
其中 是折扣因子,讓近期獎勵比遠期獎勵更重要。價值 是從狀態 出發、依循 時的期望回報。
無模型(model-free)方法直接從真實轉移學習策略或價值。模型式(model-based)方法另外學習轉移與獎勵的模型,並用它減少真實互動。這個想法由來已久:Sutton 的 Dyna 架構(1991)就已經把從真實經驗學習與在學到的模型所模擬的經驗上規劃結合起來,兩者使用同樣的價值更新 [4]。Moerland 等人的綜述沿兩個軸整理這個領域:如何學習動態模型(處理隨機性、不確定性、部分可觀測性與時間抽象),以及規劃與學習如何整合(從哪裡開始規劃、給規劃多少預算、怎麼規劃,以及如何把結果回饋到行動與學習中)[5]。
使用模型的三種方式
學到模型之後,主要有三種方式把它的預測變成決策。
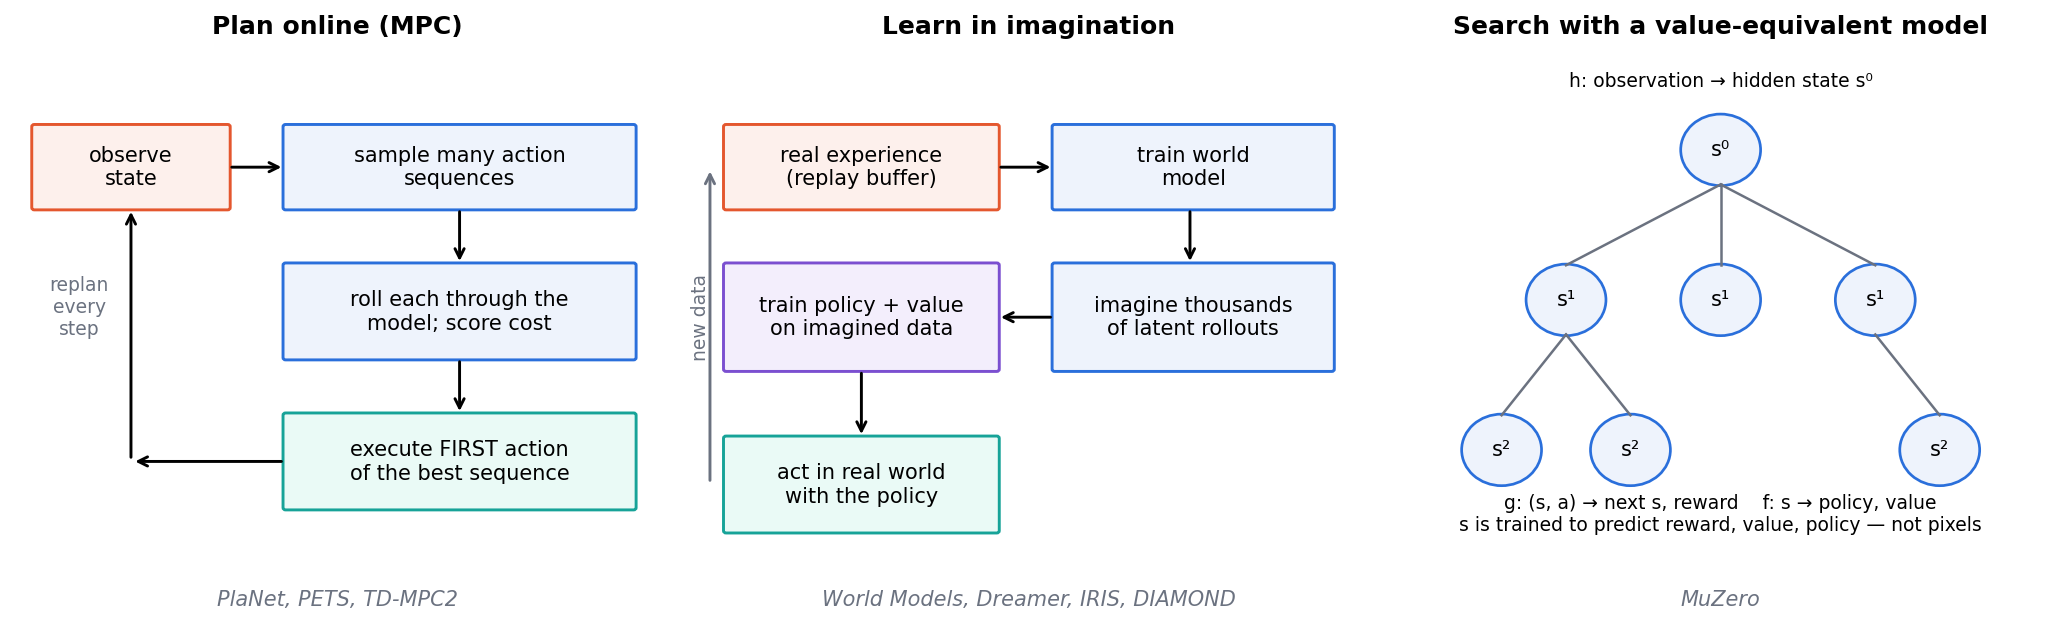
- 線上規劃(模型預測控制)。 每一個真實步驟,都在模型中模擬候選動作序列以尋找好的序列,只執行第一個動作,觀測,再重複。PlaNet [7]、PETS [29] 與 TD-MPC2 [11] 屬於這一類。
- 在想像中學習。 用模型產生的軌跡訓練一個策略(通常還有價值函數),執行時直接用策略行動,不再搜尋。World Models [6]、Dreamer 系列 [8], [9], [10]、IRIS [12] 與 DIAMOND [13] 屬於這一類。
- 用價值等價模型搜尋。 學一個只預測規劃所需量(獎勵、價值、策略)、不預測觀測的模型,並在它的潛在空間中做樹搜尋。MuZero [14] 是代表。
三者有一個共同的危險:模型總會在某些地方出錯,而最佳化器非常擅長找到正好是那些地方。我們會在「不確定性與模型被利用」一節回到這點。
為什麼誤差會累積
每一步想像都從上一步想像的結果出發,所以小小的預測錯誤會被帶進下一步的預測,並可能每走一步就變大一些。
假設學到的轉移 的單步誤差最多為 ,而真實動態 是常數為 的 Lipschitz 函數(狀態的小變化最多讓下一個狀態變化 倍)。從同一個狀態出發、施加相同動作, 步後預測與真實狀態的差距 滿足 ,因此
當 時,這個上界隨視野 指數成長;當 時,它飽和於 。這是最壞情況的上界,但它解釋了兩個常見設計:頻繁重新規劃(MPC)與使用短的模型推演。Janner 等人把第二個想法具體化:他們的 MBPO 演算法從真實狀態分岔出短的模型推演,而不是從頭想像長軌跡,並從理論與實驗兩方面論證這能保留模型資料的好處、同時限制其偏差 [30]。
World Models:壓縮、預測、控制
白話版。 先編碼觀測、預測表示的變化,再利用學得的動態訓練控制器。
Ha 與 Schmidhuber 的 World Models(以「Recurrent World Models Facilitate Policy Evolution」發表於 NeurIPS 2018,另有互動式線上版本)讓這個想法在深度學習中廣為人知 [6]。他們的代理人有三個部分:
- V(視覺):一個變分自編碼器,把每張 的畫面壓縮成小的潛在向量 。
- M(記憶):一個帶混合密度輸出的循環網路,在給定 、動作與隱藏狀態 時,預測 的分布。
- C(控制器):一個刻意設計得極小的線性策略 ,以演化策略而非反向傳播訓練。
在賽車任務中,使用 V 與 M 特徵的控制器解決了任務;在 VizDoom 任務中,控制器完全在 M 模擬的環境中訓練,再轉移到真實遊戲 [6]。這個設計把感知、預測與決策分開,並顯示當表示已經帶有相關動態時,控制器可以非常小。它也揭露了核心風險:在不完美夢境中訓練的控制器,可能學會利用夢境的錯誤。
潛在動態:從 PlaNet 到 Dreamer 系列
白話版。 不預測未來的影像,而是預測一個緊湊的隱藏狀態,只在訓練時才把影像解碼出來。一個同時包含確定性記憶與隨機部分的隱藏狀態,可以表示代理人記得的東西,也能表示它不確定的東西。
循環狀態空間模型
Hafner 等人的 PlaNet 從影像學習環境動態,並在潛在空間中以快速線上規劃選擇動作;它的關鍵建模想法是同時包含確定性與隨機成分的潛在動態模型,即循環狀態空間模型(recurrent state-space model, RSSM)[7]。RSSM 保留一個確定性記憶 與一個隨機狀態 :
這裡 是一個循環單元;先驗(prior)在沒看到目前影像的情況下預測 (想像時就用它);後驗(posterior)還會看到影像 (訓練時以及過濾真實觀測時使用)。多個輸出頭讀取模型狀態 ,預測影像 、獎勵 與延續旗標(回合是否繼續)。
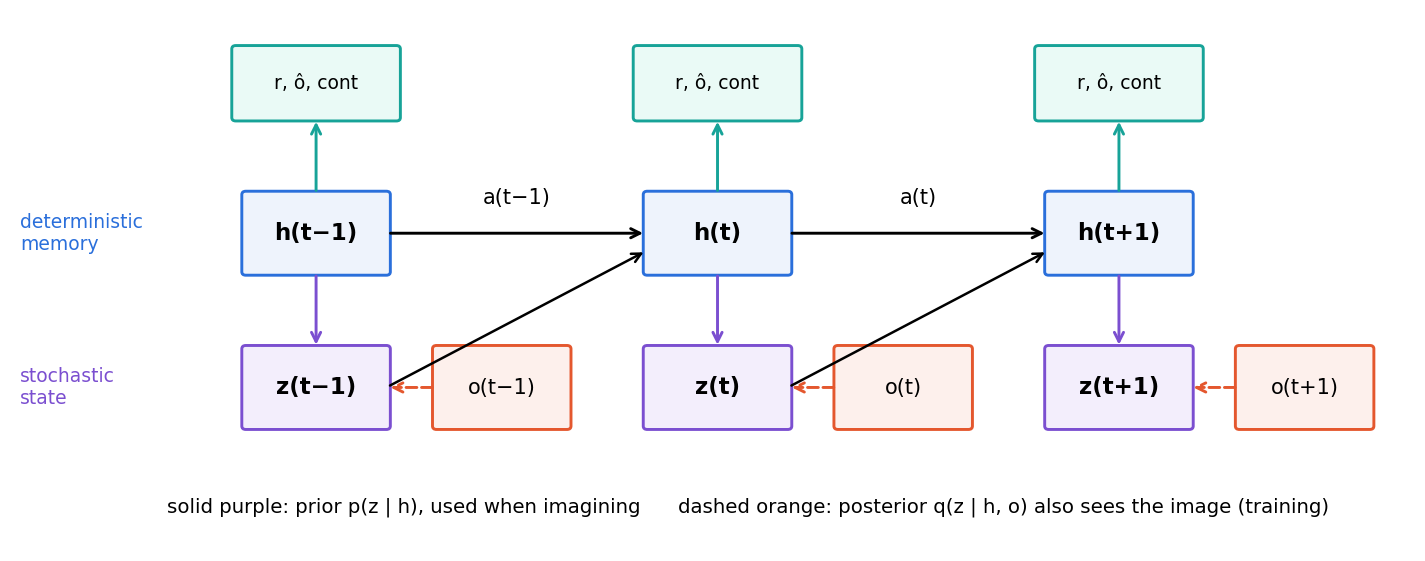
訓練時最大化觀測序列概似的變分下界。一個簡化的單步損失為
其中 是 KL 項的權重。重建項讓狀態帶有資訊;KL 項則教先驗去預測後驗將會看到的東西,這正是想像所需要的能力。實際實作還會加入損失平衡與其他穩定化技巧,所以請把這個式子當成教學大綱,而不是任何一篇論文的精確損失。
選讀:ELBO 與重新參數化技巧(見「補充資料」頁)。說明這個損失從何而來,以及梯度如何通過取樣出的狀態,並附一個單變數的例子。
Dreamer:在想像中學習行為
Dreamer(2020)保留 RSSM,但把線上規劃換成一個完全在想像出的潛在軌跡上訓練的 actor–critic。它的關鍵做法是把學到的狀態價值的解析梯度,沿著在緊湊潛在空間中想像出的軌跡反向傳播 [8]。代理人從由真實資料推得的潛在狀態出發,用 actor 想像 步,用學到的 critic 評分,並以自舉目標(例如 -回報)訓練 critic:
其中 與 是預測的獎勵與延續, 是 critic, 在單步自舉()與較長的想像回報()之間取捨。actor 則被更新以提高這些價值。
這條路線持續發展:
- DreamerV2(2021)改用離散(類別型)潛在變數,成為第一個藉由在獨立訓練的世界模型中學習行為、在 55 款遊戲的 Atari 基準上達到人類水準的代理人 [9]。
- DreamerV3(Nature,2025)使用以正規化、平衡與轉換為基礎的穩健化技巧,使單一設定就能在超過 150 個任務上勝過專門方法,並且是第一個在沒有人類資料或課程設計的情況下、從零開始在 Minecraft 中收集到鑽石的演算法 [10]。
另外兩條相關路線說明 RSSM 只是眾多選擇之一。TD-MPC2 在一個隱式、沒有解碼器的世界模型(不重建影像)的潛在空間中規劃,以單一組超參數在 104 個線上 RL 任務上取得強勁結果,並訓練出一個能執行 80 個任務的 317M 參數代理人 [11]。IRIS 以離散自編碼器加上對影像 token 的自迴歸 Transformer 取代 RSSM,只用相當於兩小時的 Atari 遊戲經驗學習 [12]。DIAMOND 更進一步走向像素:它讓代理人在擴散世界模型中訓練,主張離散潛在變數可能丟掉對控制重要的視覺細節,並展示了這個模型可作為 3D 遊戲的互動式神經遊戲引擎 [13]。
MuZero:只預測規劃需要的東西
白話版。 要下好一盤棋,你不需要預測畫面會長什麼樣子。你只需要預測局面有多好、哪些著法看起來有希望,以及會得到哪些獎勵。MuZero 正是學這些,然後進行搜尋。
AlphaZero 式的樹搜尋需要一個遊戲規則的模擬器。MuZero 移除了這個需求:它學一個反覆套用時能預測與規劃最直接相關之量的模型,也就是獎勵、動作選擇策略與價值 [14]。它有三個函數:
其中 (表示函數)把觀測歷史編碼成隱藏狀態 ,(動態函數)把隱藏狀態與假設動作 映射到預測獎勵 與下一個隱藏狀態,(預測函數)輸出策略向量 與價值 。蒙地卡羅樹搜尋展開 來選擇動作。訓練時沿著真實軌跡把模型展開 步,並最小化
其中 是觀測到的獎勵, 是價值目標(自舉回報), 是搜尋產生的造訪次數分布, 是各量的損失, 是 L2 懲罰的權重。
隱藏狀態 從不被要求重建觀測。它只需要價值等價:用它規劃,必須得到與在真實環境中規劃相同的獎勵、價值與策略。以這個設計,MuZero 在 57 款 Atari 遊戲上創下新的最佳成績,並在沒有被告知規則的情況下,於圍棋、西洋棋與將棋上追平 AlphaZero 的超人表現 [14]。對視覺而言的教訓是:世界模型的預測目標應依用途而定;預測每個像素只是一種選擇,不是必要條件。
影片預測與生成:作為世界模擬器
白話版。 如果模型能生成逼真的未來影片,也許它學會了世界如何運作。有時候確實如此;但更常見的是,它只學會了影片通常看起來像什麼。判斷是哪一種,才是難處所在。
以動作為條件的影片預測
Finn 等人在一個含 59,000 次機器人推動互動的資料集上,訓練了以動作為條件的影片預測模型;由於模型預測的是像素運動而非原始像素,它對沒見過的物體有部分泛化能力,而以不同的未來動作為條件,就產生了對不同未來的「視覺想像」[15]。這是最字面意義上的世界模型:影像進、動作進、影像出。
為什麼平方誤差預測器會模糊
真實的未來是不確定的。假設從同樣的過去出發,球有 的機率往左、 的機率往右。對平方誤差而言,最佳的單一預測是條件平均:
在這裡就是兩顆半亮的球,一張永遠不會發生的影像。一個從兩種未來中取樣的生成模型會產生逼真的影像,但平均而言平方誤差更高。
程式碼 · Python · 17 行
import numpy as np

x = np.arange(64)
def frame(center):                      # a 1-D "image" with one bright ball
    return np.exp(-0.5 * ((x - center) / 2.0) ** 2)

# Same past, two equally likely futures: the ball bounces left or right.
futures = np.stack([frame(20), frame(44)])
mean_pred = futures.mean(axis=0)        # what an MSE-trained predictor converges to
sample_pred = futures[0]                # what a good generative sampler might output

def expected_mse(pred):                 # average over the two possible futures
    return np.mean([(pred - f) ** 2 for f in futures])

print(f"peak brightness: true future 1.00, mean prediction {mean_pred.max():.2f}")
print(f"expected MSE of mean prediction:   {expected_mse(mean_pred):.4f}")
print(f"expected MSE of a sharp sample:    {expected_mse(sample_pred):.4f}")
輸出:
程式碼 · 3 行
peak brightness: true future 1.00, mean prediction 0.50
expected MSE of mean prediction:   0.0277
expected MSE of a sharp sample:    0.0554
清晰的樣本的期望誤差恰好是模糊平均的兩倍。這就是為什麼像素 MSE 會獎勵模糊、為什麼會出現隨機式影片模型,以及為什麼只用一個平方誤差數字評估世界模型,可能選錯模型。
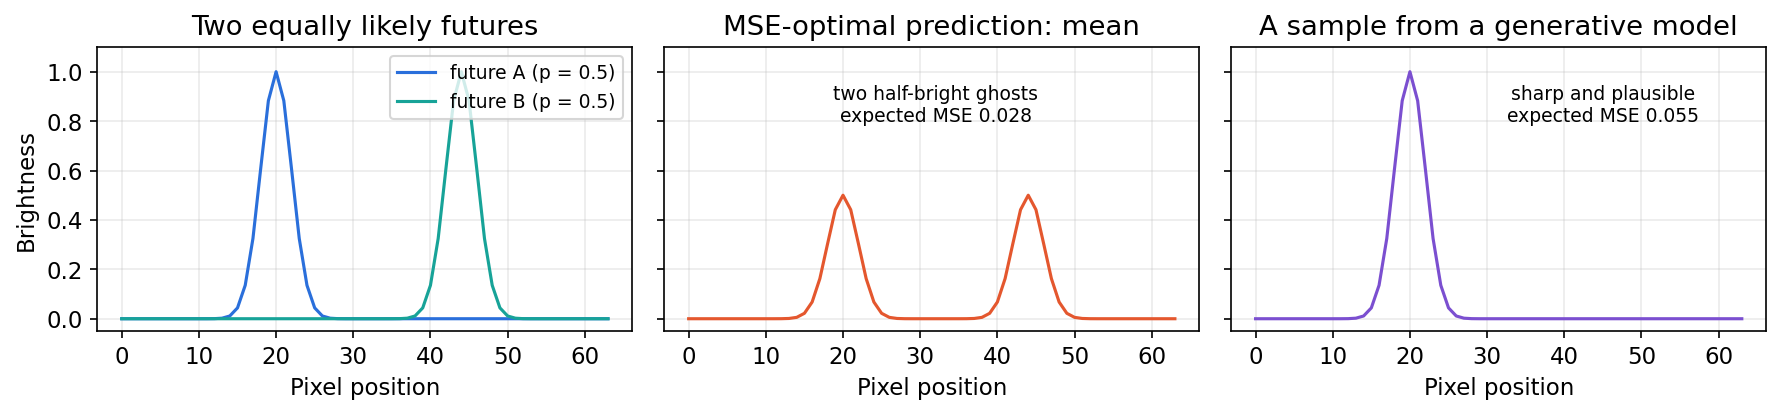
Babaeizadeh 等人的 SV2P 為潛在變數的每個樣本預測一個不同的可能未來,結果比沒有隨機性的同一模型好得多 [16]。現代影片生成器在大得多的規模上使用同樣的原理,採用自迴歸 token 模型或擴散與流模型(見 ML 08 與 ML 09)。
大型生成式世界模型
有幾個大型模型能以動作、文字或從影片本身推斷出的動作為條件來生成影片,並被當作世界模擬器提出。
- GAIA-1 把駕駛世界建模視為對影片、文字與動作離散 token 的下一個 token 預測,能產生逼真的駕駛情境,並可細部控制自車行為與場景特徵 [17]。
- UniSim 結合在不同面向上豐富的資料集(影像中的物體、機器人資料中的密集動作、導航資料中的運動),學習真實世界互動的「通用模擬器」;它能模擬高階指令與低階控制,而完全在其中訓練的策略可零樣本部署到真實機器人上 [18]。
- Genie 是一個在未標註的網路影片上、不使用動作標籤訓練出的生成式互動環境。它由影片 tokenizer、自迴歸動態模型與一個從畫面變化推斷動作的潛在動作模型組成,因此即使訓練時沒有動作標籤,使用者仍能在生成的世界中逐格行動 [19]。這類潛在動作不一定對應到經過校正的實體致動器。
- Genie 3 由 Google DeepMind 於 2025 年 8 月發布,能從文字生成可即時導覽的世界,每秒 24 格、720p,並維持數分鐘的一致性。公告列出了限制:動作空間受限、難以模擬多個獨立代理人、真實地點不精確,以及互動只能持續數分鐘而非數小時 [20]。
- Cosmos 是 NVIDIA 的開放「世界基礎模型」平台:包含預訓練影片模型、影片 tokenizer、資料整理流程與後訓練範例,目的是微調成機器人與車輛專用的世界模型 [21]。
逼真的影片就代表理解物理嗎?
兩項仔細的研究給出的答案是:不一定。Motamed 等人的 Physics-IQ 基準測試流體力學、光學、固體力學、磁學與熱力學;在目前的影片模型(包括 Sora、Runway、Pika、Lumiere、Stable Video Diffusion 與 VideoPoet)中,物理理解嚴重不足,且與視覺真實感無關 [22]。Kang 等人在由古典力學支配的 2D 模擬器上訓練擴散影片模型,發現分布內完美泛化、組合式泛化可觀察到隨規模改善,但分布外則失敗;模型的行為像是在找最相近的訓練樣本,而不是抽象出規則 [23]。
用於機器人控制時,也要問「動作」指的是什麼:力、關節目標、夾爪指令、相機移動,還是推斷出的 token。單位錯誤、時間偏移或控制頻率不同,都會改變條件預測問題,即使影片看起來很有說服力。
預測式表示:JEPA 家族
白話版。 預測每一個像素,會把力氣浪費在不重要的細節上,例如樹葉的紋理。不如預測缺失或未來部分的抽象描述。如果描述夠好,這個預測就對規劃有用。
聯合嵌入預測架構(joint-embedding predictive architecture, JEPA)用編碼器分別編碼可見的上下文 與被隱藏的目標 ,並訓練一個預測器把上下文嵌入映射到目標嵌入:
其中 是上下文編碼器, 是目標編碼器, 是以目標位置資訊 (例如在影像或時間中的位置)為條件的預測器,(stop-gradient)阻止梯度流入目標分支。沒有任何東西在像素空間中重建。危險在於崩塌(collapse):如果兩個編碼器都輸出常數,損失就是零。實務上用不對稱設計(只有一側有預測器、stop-gradient,以及不以同一梯度訓練的目標編碼器)來避免崩塌;ML 06 更詳細地討論這些自監督機制。
JEPA 系列一開始是表示學習:先用在影像上(I-JEPA [24]),再用在影片上(V-JEPA [25]),之後 V-JEPA 2.1 [27] 又改進了它的密集特徵。下面兩個模型說明它如何變成世界模型:以動作為條件的預測,以及在特徵空間中朝目標規劃。
- V-JEPA 2 先在超過一百萬小時的網路影片上預訓練不含動作的 JEPA,再用不到 62 小時的未標註機器人影片,後訓練出一個潛在的以動作為條件的世界模型 V-JEPA 2-AC;以影像目標進行規劃後,它在兩個實驗室的 Franka 機械手臂上實現零樣本的拾取與放置,且沒有使用來自這些環境的資料、任務專屬訓練或獎勵 [26]。被動影片與動作資料的分工,讓本章所說的觀測/動作區別變得具體。
- DINO-WM 用現成的編碼器展示同樣的想法:它從離線軌跡預測未來的 DINOv2 patch 特徵,並把動作序列最佳化到接近目標影像的特徵來規劃,不重建像素,也不學獎勵模型 [28]。
選讀:JEPA 系列的其他模型:I-JEPA、V-JEPA 與 V-JEPA 2.1(見「補充資料」頁)。I-JEPA 對遮罩策略的發現、V-JEPA 如何只靠影片訓練,以及 V-JEPA 2.1 為密集特徵加了什麼。
特徵空間中的目標需要小心。距離 只會獎勵表示中保留下來的東西。如果表示忽略了夾爪是否閉合,規劃器可能到達一個看起來相似的狀態,卻沒有真的抓住物體。單憑特徵品質更好,並不能證明編碼器能預測任意動作的後果。
各家族之間的關係
這些家族的主要差別在於預測什麼,而每種預測目標都帶出一個需要檢驗的問題。
| 家族 | 預測目標 | 主要好處 | 要檢驗的問題 |
|---|---|---|---|
| 潛在動態(RSSM、TD-MPC2) | 緊湊狀態、獎勵、價值 | 便宜、可重複推演 | 潛在狀態是否保留任務相關動態? |
| 價值等價(MuZero) | 只有獎勵、價值、策略 | 不在無關細節上花力氣 | 獎勵改變時還能遷移嗎? |
| 自迴歸影片(GAIA-1、Genie、IRIS) | 下一張畫面或 token | 明確的序列分解 | 長推演時誤差會漂移嗎? |
| 擴散/流影片(DIAMOND、Cosmos) | 一起生成的畫面或片段 | 表達力強、能表示不確定的未來 | 能否在控制延遲內以動作操控結果? |
| 預測式嵌入(JEPA、DINO-WM) | 目標特徵 | 不需像素重建就能學到結構 | 動作是否被表示?目標是否有意義? |
這些選擇彼此相容。Transformer 可以參數化其中任何一種;潛在世界模型可以透過擴散解碼;影片生成器可以外層用自迴歸、內層用擴散。架構、預測目標、時間分解與訓練目標是各自獨立的設計決策。
從資料學習動態
白話版。 動態模型的好壞取決於資料:影格、動作與獎勵必須保持順序並正確對齊,測試回合也必須真正與訓練回合分開。
訓練樣本應保留順序與動作對齊:
其中 標記回合結束。記錄每個動作發生在每個相機時間戳之前或之後。依完整回合、環境實例與相關受試者切分;隨機切分相鄰畫面會洩漏幾乎相同的場景,讓轉移預測器看起來比實際更好(資料洩漏的一般討論見 ML 11)。
資料收集策略很重要。在緩慢、輕柔互動上訓練的模型,可能在劇烈運動時失敗。當資料中沒有動作時,觀察到的相關性特別麻煩:模型可能學到手靠近時杯子會動,卻完全沒有證據知道其他推法會怎樣。這就是被動影片與介入式資料的差別。
單步損失衡量從真實歷史出發的預測。多步損失展開模型自己的預測並懲罰累積誤差。展開會改變訓練難度與梯度路徑;它並不能消除觀測互動範圍之外的分布偏移。
完整 CPU 實驗:擬合、預測、規劃
白話版。 現在我們在一個玩具系統上跑完整個流程:收集資料、擬合模型、檢查它一步與多步的預測,再用它來規劃。
我們使用二維狀態 (位置與速度)、純量動作 ,以及一個有阻尼的線性系統:
其中 是 狀態轉移矩陣, 是動作輸入向量, 是微小的高斯雜訊。這個系統刻意設計成完全可觀測,以便在加入影像編碼器與部分可觀測性之前,先單獨檢視動態與規劃。訓練與測試回合各自獨立產生。我們只在訓練轉移上擬合,並用相同的保留動作同時評估單步預測與開迴路推演。
規劃器使用交叉熵方法(cross-entropy method, CEM):從高斯分布取樣候選動作序列,保留模型下成本最低的「菁英」序列,把高斯的平均與分散重新擬合到它們,然後重複。它只執行一個動作,取得新的真實狀態後重新規劃。這就是模型預測控制。
選讀:交叉熵方法(見「補充資料」頁)。把「取樣、排序、重新擬合」的迴圈寫清楚,並在已知模型上跑一個小例子。
程式碼 · Python · 60 行
import numpy as np

rng = np.random.default_rng(7)
A = np.array([[1.0, 0.1], [0.0, 0.94]])
B = np.array([0.005, 0.1])

def collect(n, steps=40):
    x = np.zeros((n, steps + 1, 2))
    x[:, 0] = rng.normal(size=(n, 2)) * [0.8, 0.3]
    u = rng.uniform(-1, 1, size=(n, steps))
    for t in range(steps):
        x[:, t + 1] = (x[:, t] @ A.T + u[:, t, None] * B
                       + rng.normal(scale=0.002, size=(n, 2)))
    return x, u

train, train_u = collect(120)
test, test_u = collect(80)
phi = np.column_stack([train[:, :-1].reshape(-1, 2), train_u.ravel()])
target = train[:, 1:].reshape(-1, 2)
W = np.linalg.lstsq(phi, target, rcond=None)[0]
W_no_action = np.linalg.lstsq(phi[:, :2], target, rcond=None)[0]

def predict(x, u):
    return np.concatenate([x, np.asarray(u)[..., None]], axis=-1) @ W

one_step = predict(test[:, :-1], test_u)
rollout = np.zeros_like(test)
rollout[:, 0] = test[:, 0]
for t in range(test_u.shape[1]):
    rollout[:, t + 1] = predict(rollout[:, t], test_u[:, t])
rmse = lambda a, b: np.sqrt(np.mean((a - b) ** 2))
print("One-step:", rmse(one_step, test[:, 1:]))
print("Without actions:", rmse(test[:, :-1] @ W_no_action, test[:, 1:]))
print("Final-horizon rollout:", rmse(rollout[:, -1], test[:, -1]))

def plan(x, mean, horizon=20, population=256):
    std = np.ones(horizon)
    for _ in range(4):
        candidates = np.clip(rng.normal(mean, std, (population, horizon)), -1, 1)
        imagined = np.broadcast_to(x, (population, 2)).copy()
        costs = np.zeros(population)
        for t in range(horizon):
            imagined = predict(imagined, candidates[:, t])
            costs += (imagined[:, 0] ** 2 + 0.15 * imagined[:, 1] ** 2
                      + 0.02 * candidates[:, t] ** 2)
        costs += 20 * imagined[:, 0] ** 2
        elite = candidates[np.argsort(costs)[:32]]
        mean = elite.mean(axis=0)
        std = elite.std(axis=0) + 0.05
    return mean

real = np.array([1.5, 0.0])
mean = np.zeros(20)
for _ in range(40):
    sequence = plan(real, mean)
    real = A @ real + B * sequence[0]  # real system; never used inside plan()
    mean = np.r_[sequence[1:], 0.0]
print("Controlled final state:", real)
assert rmse(one_step, test[:, 1:]) < 0.01
assert abs(real[0]) < 0.1
輸出:
程式碼 · 4 行
One-step: 0.0019866110218121832
Without actions: 0.04106321931941812
Final-horizon rollout: 0.013772759824274517
Controlled final state: [-0.00453985 -0.0210205 ]
單步 RMSE()落在雜訊水準;拿掉動作輸入後增加到二十倍(),可見動作確實重要。即使是這個幾乎完美的線性模型,視野 40 的開迴路推演誤差()也約為單步誤差的七倍,是上面推導的誤差累積的溫和例子。MPC 把位置從 帶到約 ,而零動作時位置停在 。這些是本腳本的合成結果,不是已發表的比較。
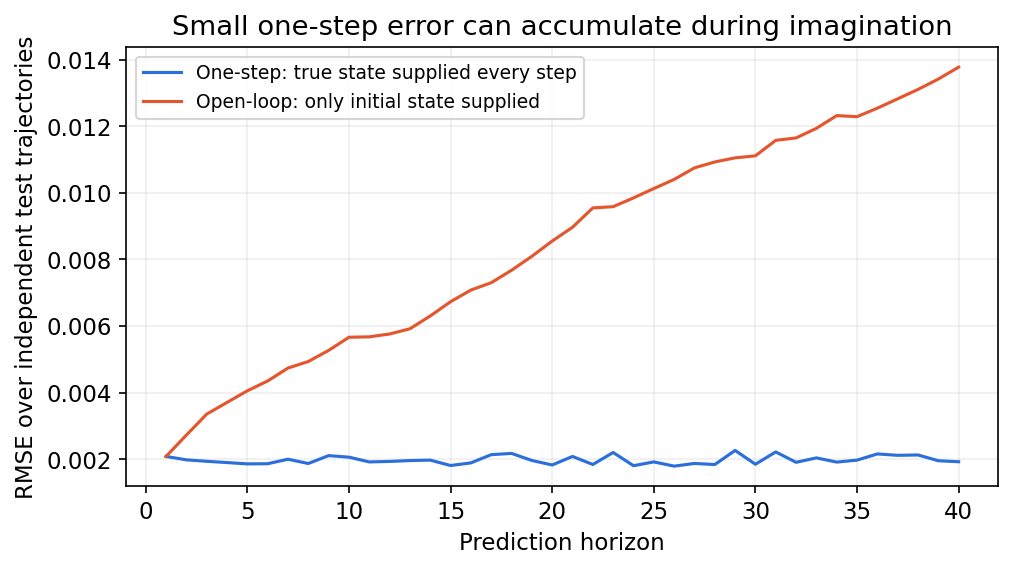
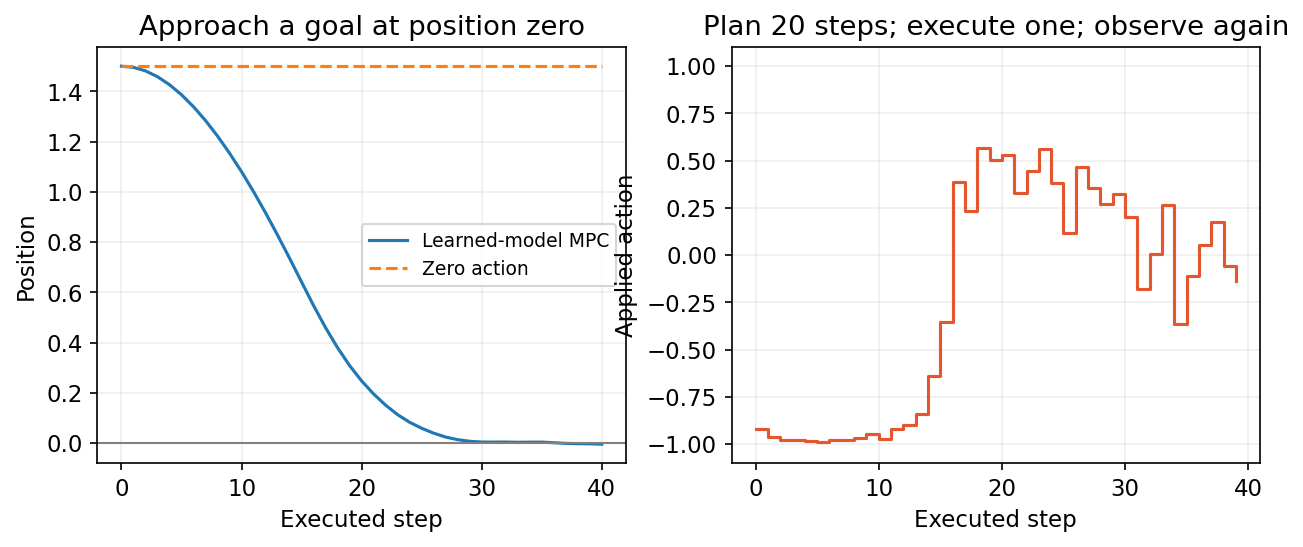
把 換成影像嵌入,並不能重現 Dreamer 或 V-JEPA 2-AC:那會多出編碼器學習問題、潛在不確定性,以及需要一個有效的目標或獎勵。
規劃、不確定性與模型被利用
白話版。 規劃器會去找模型最喜歡的動作。如果模型在某處是錯的,規劃器會很樂意往那裡跑。知道模型在哪裡不確定,才能讓它保持誠實。
有限視野的規劃目標可寫成
其中 是每步成本, 是以 加權的終端成本,期望值針對模型預測的潛在狀態 。模型預測控制執行第一個動作、重新觀測、再重新規劃。回饋可以修正漂移,但無法挽救一個其直接後果就被嚴重誤判的動作。
兩種不確定性
偶然(aleatoric)不確定性是本質上的隨機性(擲硬幣、可能往左也可能往右的球);資料再多也消除不了。認知(epistemic)不確定性來自資料不足(模型從沒見過這種情況);更多資料可以消除它。對生成模型取樣可以表示偶然不確定性,但樣本多樣不代表已校準。認知不確定性常以集成(ensemble)近似:在 bootstrap 重抽樣上或以不同初始化訓練的多個模型,在資料密集處意見一致,在資料稀少處則傾向分歧。Chua 等人的 PETS 把機率式網路(處理偶然雜訊)組成集成(處理認知不確定性),搭配以取樣為基礎的不確定性傳遞與 CEM 規劃,在數個基準上以少得多的樣本追平強大無模型方法的最終表現 [29]。
程式碼:規劃器利用學到的模型
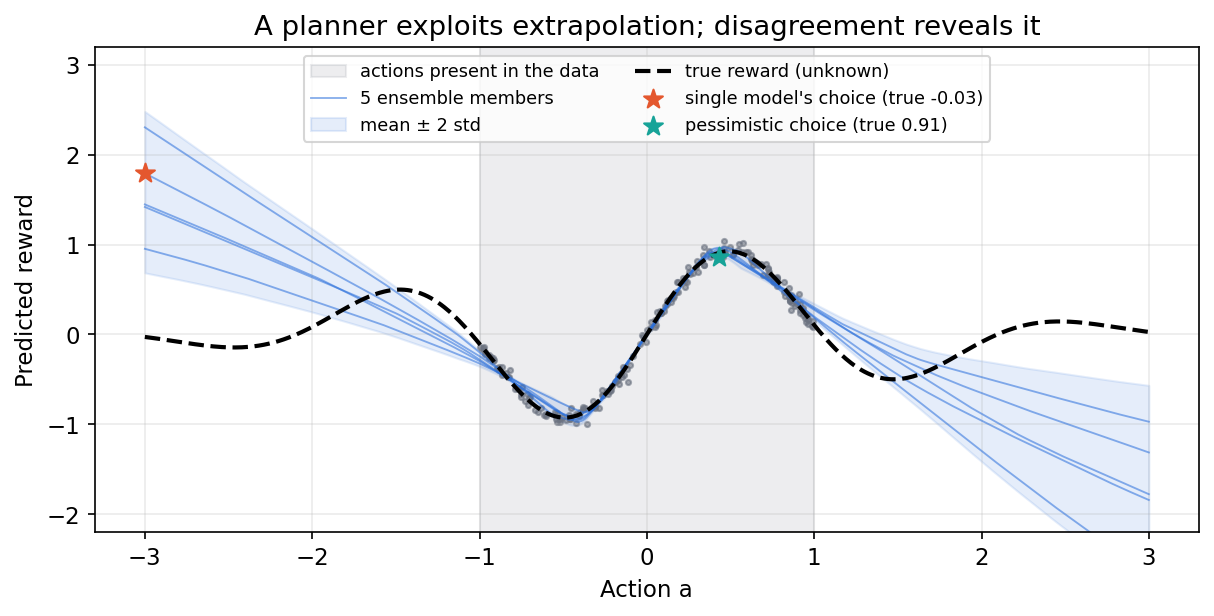
代理人只有動作落在 的記錄資料,但規劃器可以選擇 之間的任何動作。
程式碼 · Python · 28 行
import numpy as np
from sklearn.neural_network import MLPRegressor

rng = np.random.default_rng(0)
true_reward = lambda a: np.sin(3 * a) * np.exp(-0.3 * a ** 2)   # unknown to the agent

# Logged interactions only cover actions in [-1, 1].
a_data = rng.uniform(-1, 1, 200)
r_data = true_reward(a_data) + 0.05 * rng.normal(size=200)

ensemble = []
for k in range(5):                       # bootstrap + different initialization
    idx = rng.integers(0, 200, 200)
    m = MLPRegressor(hidden_layer_sizes=(64, 64), max_iter=3000, random_state=k)
    ensemble.append(m.fit(a_data[idx, None], r_data[idx]))

grid = np.linspace(-3, 3, 601)
preds = np.stack([m.predict(grid[:, None]) for m in ensemble])
mean, std = preds.mean(0), preds.std(0)

for name, score in [("single model", preds[0]),
                    ("ensemble mean", mean),
                    ("pessimistic: mean - 2 std", mean - 2 * std)]:
    a_star = grid[np.argmax(score)]       # the "planner": pick the best-looking action
    print(f"{name:26s} picks a = {a_star:+.2f}, predicted {score.max():.2f}, "
          f"true {true_reward(a_star):.2f}")
print(f"mean std inside data {std[np.abs(grid) <= 1].mean():.3f}, "
      f"outside {std[np.abs(grid) > 1.5].mean():.3f}")
輸出:
程式碼 · 4 行
single model               picks a = -3.00, predicted 1.79, true -0.03
ensemble mean              picks a = -3.00, predicted 1.58, true -0.03
pessimistic: mean - 2 std  picks a = +0.43, predicted 0.87, true 0.91
mean std inside data 0.025, outside 0.321單一模型與集成平均都在資料範圍外外插出一條上升直線,規劃器於是衝到動作空間的邊緣,而那裡真實獎勵約為零。集成在資料外的分歧是資料內的十三倍;悲觀分數(平均減兩倍標準差)讓規劃器留在資料範圍內,找到真實獎勵為 的動作。限制動作、縮短視野、懲罰分歧以及用真實回饋測試,是實務上的對策。不過,集成成員意見一致並不保證正確:五個模型可能共享同樣的偏差。
如何評估世界模型
白話版。 沒有任何單一數字能說明世界模型好不好。要問好幾個問題,每個問題各有自己的量測方式與控制條件。
| 問題 | 量測 | 重要的控制條件 |
|---|---|---|
| 能預測已知動態嗎? | 單步與依視野索引的狀態或特徵誤差 | 獨立回合;固定動作序列 |
| 外觀能保持一致嗎? | 重建與影片品質指標、身分一致性 | 比較相機運動與遮擋 |
| 動作的作用正確嗎? | 相同初始上下文、指定不同動作 | 真實的以動作為條件的參考軌跡 |
| 遵守物理限制嗎? | 碰撞、物體恆存、守恆;Physics-IQ 等基準 [22] | 任務專屬容許誤差;分布外案例 [23] |
| 對決策有幫助嗎? | 成功率、回報、人工介入次數、控制延遲 | 在真實或可信的環境中測試 |
像素保真度與決策用處可能不一致,模糊的例子已經說明了這點。平均出來的預測可能平方誤差很低,卻呈現一個不可能的場景;準確的潛在預測器可能省略視覺上無關的紋理。每個指標都要一起報告預測目標、視野、條件與輸出解析度。
比較時,請納入持續性基準(預測「什麼都不變」)、無動作預測器,以及一個適合任務的簡單動態模型。分別評估保留的物體、視角、動作範圍與環境性質。除了想像中的結果,也要報告閉迴路控制結果,並計入編碼器與取樣器的延遲:每個動作要花十秒規劃的規劃器,對以 10 Hz 運作的機器人可能毫無用處。
現代觀點
白話版。 現在有三條研究路線都被稱為「世界模型」:模型式強化學習、被重新定位為模擬器的影片生成器,以及預測式表示。尚未解決的問題,大多在於它們的預測是否可靠到足以據此行動。
綜述。 Moerland 等人對模型式 RL 提供了最系統化的整理:動態模型學習(隨機性、不確定性、部分可觀測性、時間抽象)、規劃與學習整合方式的分類,以及隱式(價值等價、MuZero 式)方法 [5]。Ding 等人(ACM Computing Surveys)依功能整理更廣泛的「世界模型」文獻,也就是理解世界與預測未來兩類,並回顧在生成式遊戲、自動駕駛、機器人與社會模擬上的應用 [1]。Zhu 等人從影片生成的角度綜述「通用世界模型」,涵蓋影片生成器、自動駕駛世界模型以及自主代理人中的世界模型,並討論其限制 [31]。Guan 等人則提供了專門針對自動駕駛世界模型的初步綜述 [32]。
2023–2026 年的現況。
- 模型式 RL 趨於成熟。 DreamerV3 展示了單一設定在超過 150 個任務上都能運作,並於 2025 年發表在 Nature [10];TD-MPC2 展示了無解碼器的潛在規劃能擴展到 317M 參數的多任務代理人 [11];IRIS 與 DIAMOND 顯示 Transformer 與擴散世界模型在 Atari 100k 基準上具競爭力 [12], [13]。
- 影片生成器被重新定位為模擬器。 GAIA-1、UniSim、Genie、Genie 3 與 Cosmos 在帶有動作、文字或推斷出之潛在動作的影片上訓練大型模型 [17], [18], [19], [20], [21]。它們能幫助代理人的最強證據,是 UniSim 把在模擬器中訓練的策略零樣本轉移到真實世界 [18];最強的警告則是:真實感不代表懂物理 [22], [23]。
- 預測式表示走向控制。 JEPA 系列從影像(I-JEPA)走到影片(V-JEPA),再到真實機器人上以動作為條件的規劃(V-JEPA 2-AC)與更密集的特徵(V-JEPA 2.1)[24], [25], [26], [27];DINO-WM 顯示凍結的自監督特徵已能支援零樣本規劃 [28]。
開放問題。
- 長視野一致性。 誤差會累積;生成的世界會漂移;物體身分與畫面外的狀態很難維持數分鐘,更別說數小時 [20]。
- 因果與物理正確性。 在被動影片上訓練的模型學到的是相關性;分布外的物理會失敗 [22], [23]。介入式(動作)資料稀少又昂貴。
- 動作介面。 從影片推斷的潛在動作、機器人關節指令與文字指令是不同的東西;可靠地在它們之間轉換仍未解決。
- 被利用與不確定性。 在想像中訓練的規劃器與策略會利用模型錯誤;大型影片模型大多缺乏校準過的認知不確定性。
- 評估。 目前沒有公認的基準能跨領域把預測品質與後續決策品質連結起來;多數論文只報告影片指標或任務回報其中之一,很少兩者都有。
- 成本。 對大型影片模型取樣可能遠慢於即時,這與閉迴路控制相衝突。
重點整理
- 預測目標與動作介面決定世界模型能支援什麼。
- 局部觀測需要記憶或信念估計,一張影像不是完整狀態。
- 規劃、想像中的策略訓練與價值等價搜尋,以不同方式使用學得動態。
- 像素逼真不代表物理正確;特徵預測也需要有意義目標與避免坍縮的機制。
- 長展開會累積誤差,最佳化可能利用這些誤差;須檢查不確定性並重新規劃。
- 評估保留資料預測、受控動作效果,以及真實環境中的行為。
練習
- 動作消融。 在 CPU 實驗中拿掉動作欄位。比較單步誤差、視野 40 的誤差與控制行為。為什麼一個不看動作的短期預測器仍可能看起來還不錯?
提示
想像的動作不再影響無動作預測器,所以規劃器完全無法比較它們的後果:每個候選都得到相同的預測成本。在一步之內,有阻尼的動態只讓狀態改變一點點,因此類似「保持不變」的預測仍能得到中等分數,這也是為什麼只看單步誤差是很弱的測試。
- 部分觀測。 隱藏速度,擬合「位置到位置」的動態。然後改用最後兩個位置與前一個動作作為特徵。這段歷史何時有幫助?觀測雜訊在哪裡造成傷害?
提示
兩個位置的差可以估計速度(有限差分),所以雙位置模型能恢復大部分狀態。每個位置上的雜訊在除以時間步長時會被放大,因此觀測雜訊越大,好處越小。
- 規劃視野。 比較視野 5、20 與 40,並把初始平均調整成對應長度。在多個獨立種子上量測最終距離、動作力度與執行時間。
提示
保持成本定義不變,並計算所有模型呼叫次數。太短的視野「看不到」提早煞車可以避免衝過頭;太長的視野成本更高,也累積更多模型誤差,不過在這個線性系統中誤差很小。
- 領域偏移。 以速度阻尼 收集訓練回合,然後在阻尼為 的環境中執行控制。比較開迴路執行一個計畫與每一步重新規劃。找出一個訓練資料涵蓋不足的動作範圍。
提示
把學到的動態(以 0.94 擬合)與真實執行的動態(0.75)分開;不要在評估轉移上重新擬合。重新規劃使用新的觀測,所以能部分修正有偏差的模型;開迴路執行則做不到。
- 平均與樣本。 把模糊的例子延伸成三個同樣可能的未來,位置在 10、32 與 54。計算平均預測與單一清晰樣本的期望 MSE。再提出一個會偏好樣本的指標。
提示
平均現在有三個三分之一高度的峰;期望 MSE 約為 (平均)與 (樣本),又是兩倍。這個倍數是普遍的:若 與 是同一分布的獨立抽樣,則 ,所以完美的取樣器的 MSE 永遠是平均的兩倍。分布層級的指標(例如比較生成樣本集合與真實未來集合,就像 FID 類指標對影像所做的)或多個樣本中取最佳的 best-of- 誤差,會獎勵清晰且合理的預測。
- 悲觀的取捨。 在集成程式碼中,把「mean − 2 std」的係數 2 換成 0、0.5、1 與 4。畫出每種情況下選到的動作與其真實獎勵。係數太大時會出什麼問題?
提示
係數為 0 時規劃器會利用外插;係數增大時它會留在資料範圍內。過度悲觀會讓規劃器避開任何有些微分歧的動作,可能錯過資料範圍內的最佳動作,而在 RL 情境中還會停止探索。
參考文獻
- J. Ding et al., “Understanding world or predicting future? A comprehensive survey of world models,” ACM Computing Surveys, vol. 58, no. 3, 2025. doi arXiv
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006, ch. 13 “Sequential Data”. book
- R. Szeliski, Computer Vision: Algorithms and Applications, 2nd ed., Springer, 2022. book
- R. S. Sutton, “Dyna, an integrated architecture for learning, planning, and reacting,” ACM SIGART Bulletin, vol. 2, no. 4, 1991. doi
- T. M. Moerland, J. Broekens, A. Plaat and C. M. Jonker, “Model-based reinforcement learning: a survey,” Foundations and Trends in Machine Learning, vol. 16, no. 1, 2023. doi arXiv
- D. Ha and J. Schmidhuber, “Recurrent world models facilitate policy evolution,” NeurIPS, 2018; interactive version “World Models,” arXiv:1803.10122. paper interactive
- D. Hafner et al., “Learning latent dynamics for planning from pixels,” ICML, 2019. paper
- D. Hafner, T. Lillicrap, J. Ba and M. Norouzi, “Dream to control: learning behaviors by latent imagination,” ICLR, 2020. arXiv
- D. Hafner, T. Lillicrap, M. Norouzi and J. Ba, “Mastering Atari with discrete world models,” ICLR, 2021. arXiv
- D. Hafner, J. Pasukonis, J. Ba and T. Lillicrap, “Mastering diverse control tasks through world models,” Nature, vol. 640, 2025. doi arXiv
- N. Hansen, H. Su and X. Wang, “TD-MPC2: scalable, robust world models for continuous control,” ICLR, 2024. arXiv
- V. Micheli, E. Alonso and F. Fleuret, “Transformers are sample-efficient world models,” ICLR, 2023. arXiv
- E. Alonso et al., “Diffusion for world modeling: visual details matter in Atari,” NeurIPS, 2024. arXiv
- J. Schrittwieser et al., “Mastering Atari, Go, chess and shogi by planning with a learned model,” Nature, vol. 588, 2020. doi arXiv
- C. Finn, I. Goodfellow and S. Levine, “Unsupervised learning for physical interaction through video prediction,” NIPS, 2016. arXiv
- M. Babaeizadeh, C. Finn, D. Erhan, R. H. Campbell and S. Levine, “Stochastic variational video prediction,” arXiv:1710.11252, 2017. arXiv
- A. Hu et al., “GAIA-1: a generative world model for autonomous driving,” technical report, arXiv:2309.17080, 2023. arXiv
- S. Yang et al., “Learning interactive real-world simulators,” arXiv:2310.06114, 2023. arXiv
- J. Bruce et al., “Genie: generative interactive environments,” arXiv:2402.15391, 2024. arXiv
- Google DeepMind, “Genie 3: a new frontier for world models,” blog post, August 5, 2025. blog
- NVIDIA (N. Agarwal et al.), “Cosmos world foundation model platform for physical AI,” arXiv:2501.03575, 2025. arXiv
- S. Motamed, L. Culp, K. Swersky, P. Jaini and R. Geirhos, “Do generative video models understand physical principles?,” arXiv:2501.09038, 2025. arXiv
- B. Kang et al., “How far is video generation from world model: a physical law perspective,” ICML, 2025. arXiv
- M. Assran et al., “Self-supervised learning from images with a joint-embedding predictive architecture,” CVPR, 2023. doi arXiv
- A. Bardes et al., “Revisiting feature prediction for learning visual representations from video,” arXiv:2404.08471, 2024. arXiv
- M. Assran et al., “V-JEPA 2: self-supervised video models enable understanding, prediction and planning,” arXiv:2506.09985, 2025. arXiv
- L. Mur-Labadia et al., “V-JEPA 2.1: unlocking dense features in video self-supervised learning,” arXiv:2603.14482, 2026. arXiv
- G. Zhou, H. Pan, Y. LeCun and L. Pinto, “DINO-WM: world models on pre-trained visual features enable zero-shot planning,” arXiv:2411.04983, 2024. arXiv
- K. Chua, R. Calandra, R. McAllister and S. Levine, “Deep reinforcement learning in a handful of trials using probabilistic dynamics models,” NeurIPS, 2018. arXiv
- M. Janner, J. Fu, M. Zhang and S. Levine, “When to trust your model: model-based policy optimization,” NeurIPS, 2019. arXiv
- Z. Zhu et al., “Is Sora a world simulator? A comprehensive survey on general world models and beyond,” arXiv:2405.03520, 2024. arXiv
- Y. Guan et al., “World models for autonomous driving: an initial survey,” arXiv:2403.02622, 2024. arXiv
- D. P. Kingma and M. Welling, “Auto-encoding variational Bayes,” International Conference on Learning Representations (ICLR), 2014; arXiv:1312.6114. arXiv
- D. J. Rezende, S. Mohamed and D. Wierstra, “Stochastic backpropagation and approximate inference in deep generative models,” ICML, 2014. paper
- R. Y. Rubinstein, “The cross-entropy method for combinatorial and continuous optimization,” Methodology and Computing in Applied Probability, vol. 1, no. 2, 1999. doi
- P.-T. de Boer, D. P. Kroese, S. Mannor and R. Y. Rubinstein, “A tutorial on the cross-entropy method,” Annals of Operations Research, vol. 134, no. 1, 2005. doi
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 14・穩健性:分布偏移、對抗樣本與異常 · 39 分鐘