DLCV 05・人體姿態與關鍵點估計
先備知識:DLCV 03・物件偵測:從 R-CNN 到 DETR
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
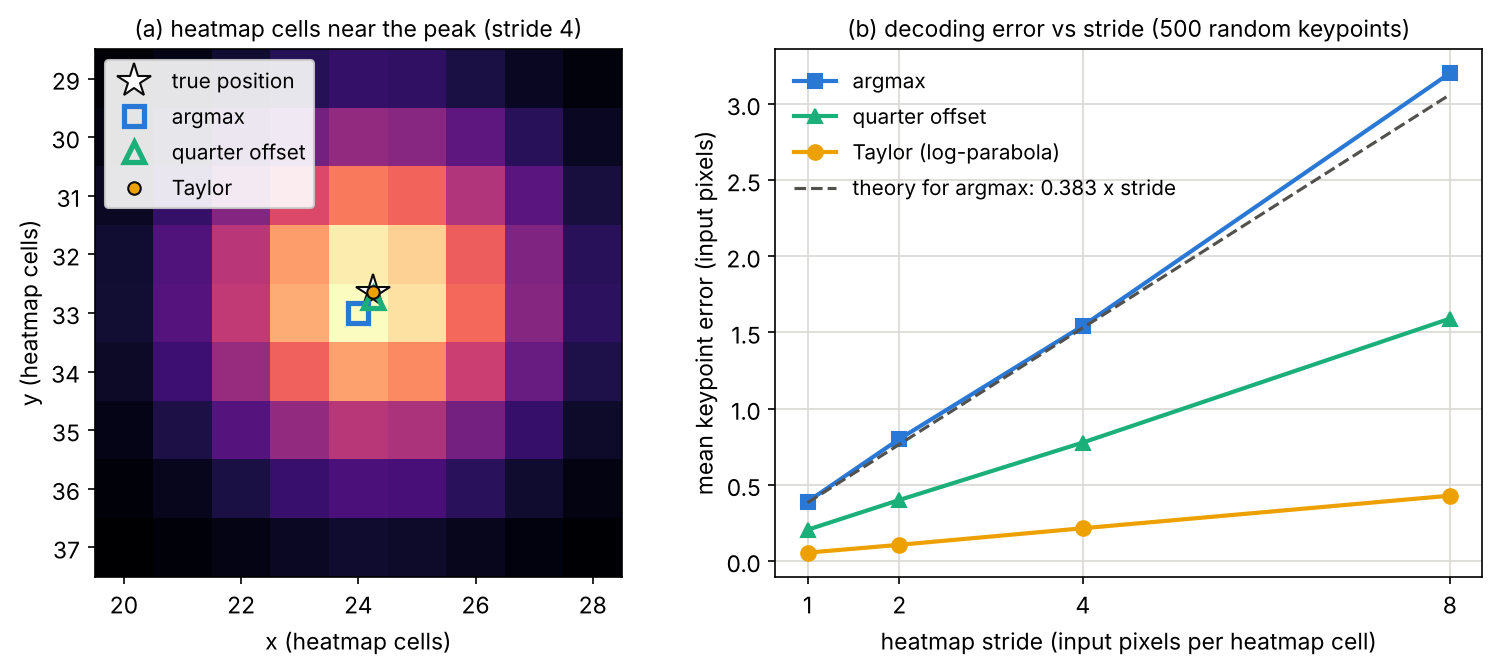
對 500 個隨機的子像素關鍵點,以步幅 1、2、4 或 8 繪製高斯熱圖,比較三種讀回位置的方法:最亮的格子、四分之一格偏移與 Taylor 步驟。
你將學到
- 以具名關鍵點、可見性標籤與骨架連線表示姿態。
- 比較座標迴歸與熱圖,包含次像素解碼。
- 選擇由上而下、由下而上或直接多人預測。
- 解讀以 OKS 為基礎的 AP、PCK/PCKh 與三維關節誤差。
- 理解三維提升、三角測量與身體模型擬合,再診斷常見錯誤。
先看全貌
偵測器會在每個人身上畫一個框(DLCV 03)。框只說明人在哪裡,卻沒說他在做什麼:站著、揮手、跌倒或踢球,框看起來都差不多。姿態估計(pose estimation)再往前一步。它找出身體上少數有意義的點,也就是關鍵點(鼻子、肩膀、手肘、手腕、臀部、膝蓋、腳踝等),再把它們連成火柴人。
為什麼重要。 火柴人是身體動作的精簡摘要。運動分析、物理治療、跌倒偵測與健身 App 都從它量測關節角度。動畫、遊戲與擴增實境用它來驅動虛擬角色。機器人與自駕車用它預測行人接下來會往哪走。神經科學家不用貼標記,就能追蹤小鼠與果蠅的關節 [1]。同樣的想法,熱圖、關鍵點分組與關鍵點指標,也被拿去處理人臉、手、動物與物件的部位。
本篇在人物偵測、非極大值抑制(non-maximum suppression, NMS)與 AP 的做法上,建立在 DLCV 03 之上;在密集預測與上取樣上,建立在 DLCV 04 之上;這些內容我們直接連結,不再重複。隨時間追蹤姿態會用到 DLCV 07 的關聯方法,3D 三角測量則用到 DLCV 11 的相機幾何。兩篇綜述勾勒出這個領域:Zheng 等人 [2] 涵蓋以深度學習做的 2D 與 3D 姿態,Chen 等人 [3] 則依任務整理單目方法。我們會在「現代觀點」回頭談這兩篇。
什麼是姿態
白話版。 姿態由具名身體點、座標與可見性標籤組成,再以預定義骨架連接。
精確版。 骨架(skeleton)是一張圖 。頂點 是 種關鍵點類型(例如「左手腕」),邊 是連接它們的肢段(limb)。一個人的 2D 姿態是
其中 是關鍵點 在影像中的位置(單位為像素), 是它的可見性旗標(visibility flag)。COCO 關鍵點格式用 表示「未標註」, 表示「已標註但看不見」(被遮擋,位置由標註者推測), 表示「已標註且可見」[4]。3D 姿態則把 換成點 ,通常以毫米為單位,位於相機座標系或世界座標系。
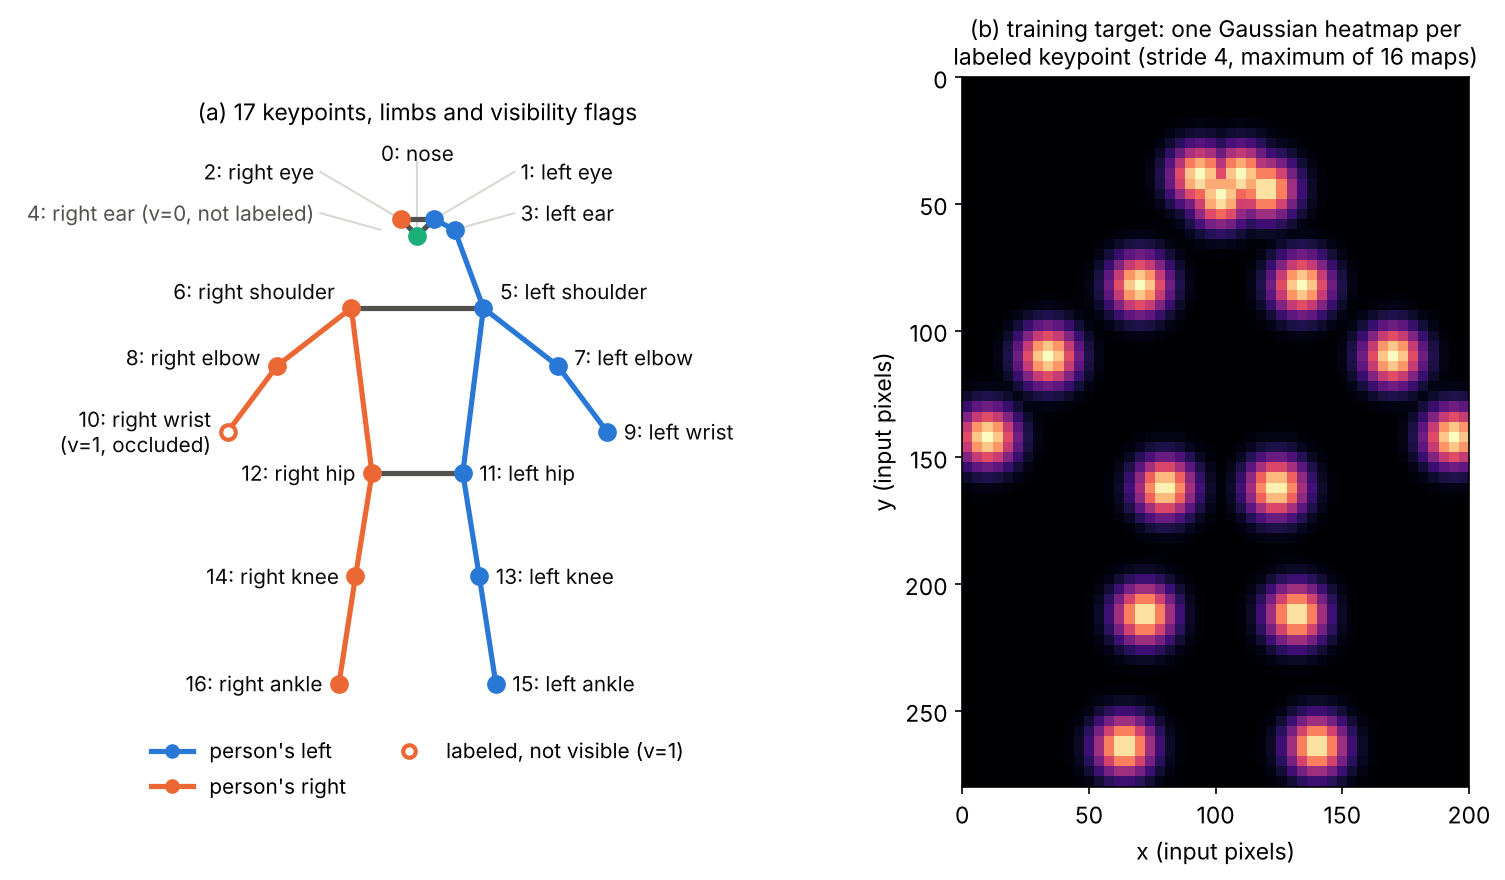
COCO 的人物骨架有 個關鍵點:鼻子、雙眼、雙耳、肩膀、手肘、手腕、臀部、膝蓋與腳踝 [4]。圖 1 在一個合成的火柴人上標出它們。有兩個慣例會讓每個初學者踩到:
- 左與右是指那個人的,不是觀看者的。 面對相機的人,他的左肩在影像的右側。因此把影像水平翻轉,會讓每個左側關鍵點變成右側關鍵點,資料增強時除了鏡射座標,也必須對調標籤。
- 看不見不等於未標註。 被遮擋的手腕()仍有位置,也仍會被評估;未標註的關鍵點()則直接被忽略。
姿態估計與相鄰任務的比較
有四個相關任務很容易混淆:
| 任務 | 輸出 | 在本課程的位置 |
|---|---|---|
| 通用關鍵點偵測 | 在另一張影像中容易再次找到的角點與斑點,附描述子;沒有語意名稱 | IP 12 |
| 物件偵測 | 每個物件一個框、類別與分數 | DLCV 03 |
| 實例分割 | 每個物件一張像素遮罩 | DLCV 04 |
| 姿態估計 | 每個物件一組具名關鍵點,由固定骨架連接 | 本篇 |
IP 12 的關鍵點是由影像決定的:哪裡剛好有角點或斑點就在哪裡。這裡的關鍵點是由任務決定的:即使左手肘落在一片平滑、沒有任何角點的袖子上,也必須找出來。這就是為什麼語意關鍵點要從有標註的範例學習,而不是用公式偵測。
這個任務有好幾種變體。單人 2D 估計假設每個輸入裁切區域只有一個人。多人 2D 估計還得判斷有幾個人,以及每個關鍵點屬於誰。3D 估計要還原深度。全身(whole-body)估計加上腳、手與臉部的特徵點,網格重建(mesh recovery)則輸出完整的人體表面,而不是稀疏的骨架 [5]。
輸出關鍵點的兩種方式
白話版。 網路可以直接說出數字(「手腕在 、」),這是迴歸;也可以畫一張圖,在手腕所在之處發亮,這是熱圖。在深度學習的大部分時期,畫圖贏了,因為卷積網路畫圖比報數字拿手。
直接迴歸
DeepPose [6] 是早期以迴歸為基礎的深度姿態估計器。卷積網路把影像對應到 個數字的向量,也就是以人物框正規化後的關鍵點座標,並用平方誤差訓練,
其中 是關鍵點 的預測位置, 是真值位置(皆為正規化座標)。DeepPose 以一串後續的迴歸器修正它的初步猜測,這些迴歸器作用在每個關節周圍解析度更高的裁切區域上。
迴歸簡單、快速,也沒有解析度上限;但全連接的輸出丟掉了卷積擅長處理的空間配置,因此多年來迴歸在準確度上落後熱圖。
高斯熱圖
Tompson 等人 [7] 改為要求網路針對每種關鍵點類型輸出一張影像,也就是一張熱圖,在關鍵點附近高、其他地方低。關鍵點 的目標是以真實位置為中心的高斯光斑:
其中 是熱圖的一個格子(整數座標), 是輸出步幅(output stride,一個熱圖格子涵蓋幾個輸入像素,通常為 4), 是以熱圖單位表示的真實關鍵點位置, 是光斑的寬度(以格子為單位)。網路用預測熱圖 與目標之間逐像素的均方誤差來訓練,
其中 是熱圖格子的集合, 對未標註的關鍵點為 0,其餘為 1。堆疊沙漏網路(stacked hourglass network)沿用 Tompson 等人的作法使用這種監督,取 像素 [8]。
為什麼這比迴歸好這麼多?熱圖符合卷積的運作方式:它是密集的,而且具平移等變性(人移動,光斑就跟著移動),所以每個輸出格子回答的都是局部問題:「這裡有手腕嗎?」它能表達疑慮:兩個合理的手腕位置會變成兩個較弱的光斑,而單一迴歸座標會落在兩者之間。而且峰值高度就是每個關鍵點免費的信心分數。
代價是解析度:在步幅 4 下,峰值只能落在間距 4 像素的格點上,而且 張圖所需的記憶體遠多於 個數字。密集預測網路如何恢復解析度,見 DLCV 04;下一節說明格點造成多少損失,以及如何把大部分損失補回來。
解碼熱圖:argmax、量化誤差與子像素修正
白話版。 熱圖最亮格子提供粗略位置,相鄰反應則協助細化到格點之間。
最簡單的解碼器取最亮的格子,再對應回影像:
如果真實位置在格子內均勻隨機分布,這個解碼器在每個軸上的誤差會均勻分布在 ,預期的歐幾里得誤差約為 (單位正方形中心到其中一個隨機點的平均距離,,再乘以 )。在步幅 4 下,那就是約 1.5 像素的誤差,而且是在網路還沒犯任何錯之前。對一個 100 像素高的人來說,這已足以在稍後介紹的 OKS 指標的嚴格門檻上丟分。
常見的改進有三種:
- 四分之一偏移。 把估計值從峰值朝較亮的鄰格方向移動四分之一個格子。堆疊沙漏論文加入這一步來改善高精度門檻下的結果 [8],SimpleBaseline 也把它當作標準作法 [9]。
- 對數熱圖上的 Taylor 步驟。 高斯的對數是二次函數(拋物線),所以可以由最亮格子上的值、斜率與曲率,精確求出它的最大值位置:,其中 是最亮的格子, 與 是 在該處的梯度與 Hessian,以有限差分估計。這是 DARK [10] 的解碼步驟。DARK 在解碼前還會先對預測熱圖做高斯平滑,因為真實的預測並非完美的高斯;它也把訓練目標以精確(未四捨五入)的關鍵點位置為中心,這正是我們 公式已經採用的作法。
- Soft-argmax(積分迴歸)。 把熱圖當成機率分布,輸出它的平均值:,其中 是對所有格子取的 softmax。Sun 等人 [11] 證明這能把熱圖變成可微分的迴歸輸出,所以網路可以直接針對座標做端到端訓練,沒有量化問題。
DARK 的消融實驗讓這個效果的大小很具體:對 HRNet-W32 模型、小尺寸 輸入、在 COCO 驗證集上,純 argmax 的 AP 為 61.2,四分之一偏移為 66.9,它的 Taylor 解碼為 68.4 [10]。單靠解碼器就讓 AP 動了 7 點以上。
選讀:以 Taylor 步驟做子像素解碼(見「補充資料」頁)。推導 Newton 步驟、說明它為什麼對高斯是精確的,以及邊界、平坦與多峰熱圖等特殊情況。
這段程式碼把 500 個隨機關鍵點編碼成步幅 1、2、4、8 的熱圖,加入少量雜訊來模擬不完美的預測,再用各種方法解碼。所有數字都來自這次合成實驗。
程式碼 · Python · 63 行
import numpy as np

def encode(xy, shape, stride, sigma=2.0):
    """Gaussian heatmap of size shape=(H, W) cells for a keypoint at image position xy."""
    cx, cy = xy[0] / stride, xy[1] / stride            # exact (unrounded) center in cells
    ys, xs = np.mgrid[0:shape[0], 0:shape[1]]
    return np.exp(-((xs - cx) ** 2 + (ys - cy) ** 2) / (2 * sigma ** 2))

def peak(h):
    y, x = np.unravel_index(np.argmax(h), h.shape)
    return x, y

def decode_argmax(h, stride):
    x, y = peak(h)
    return np.array([x, y], float) * stride

def decode_quarter(h, stride):
    """Move a quarter cell from the peak toward the higher neighbour on each axis."""
    x, y = peak(h)
    p = np.array([x, y], float)
    if 0 < x < h.shape[1] - 1: p[0] += 0.25 * np.sign(h[y, x + 1] - h[y, x - 1])
    if 0 < y < h.shape[0] - 1: p[1] += 0.25 * np.sign(h[y + 1, x] - h[y - 1, x])
    return p * stride

def decode_taylor(h, stride):
    """One Newton step on log h at the peak: offset = -Hessian^-1 * gradient."""
    x, y = peak(h)
    p = np.array([x, y], float)
    if 1 <= x < h.shape[1] - 1 and 1 <= y < h.shape[0] - 1:
        L = np.log(np.maximum(h[y - 1:y + 2, x - 1:x + 2], 1e-10))
        g = np.array([L[1, 2] - L[1, 0], L[2, 1] - L[0, 1]]) / 2
        hxx = L[1, 2] - 2 * L[1, 1] + L[1, 0]
        hyy = L[2, 1] - 2 * L[1, 1] + L[0, 1]
        hxy = (L[2, 2] - L[2, 0] - L[0, 2] + L[0, 0]) / 4
        Hs = np.array([[hxx, hxy], [hxy, hyy]])
        if np.linalg.det(Hs) > 0 and hxx < 0:          # a proper maximum
            p += -np.linalg.solve(Hs, g)
    return p * stride

def decode_soft(logits, stride):
    """Soft-argmax: the expected position under softmax(logits)."""
    w = np.exp(logits - logits.max()); w /= w.sum()
    ys, xs = np.mgrid[0:w.shape[0], 0:w.shape[1]]
    return np.array([(w * xs).sum(), (w * ys).sum()]) * stride

rng = np.random.default_rng(0)
W, H = 192, 256                                    # input crop size in pixels (width, height)
pts = rng.uniform([16, 16], [W - 16, H - 16], (500, 2))

def mean_error(decoder, s, noise=0.01, use_log=False):
    shape, e = (H // s, W // s), 0.0
    for xy in pts:
        h = encode(xy, shape, s)
        h = np.clip(h + rng.normal(0, noise, h.shape), 1e-6, None)   # an imperfect "prediction"
        e += np.linalg.norm(decoder(np.log(h) if use_log else h, s) - xy)
    return e / len(pts)

print("stride  argmax  quarter  taylor   (mean error in input pixels)")
for s in (1, 2, 4, 8):
    print(f"{s:6d}  {mean_error(decode_argmax, s):6.2f}  {mean_error(decode_quarter, s):7.2f}"
          f"  {mean_error(decode_taylor, s):6.2f}")
print(f"soft-argmax, stride 4: clean map {mean_error(decode_soft, 4, 0.0, True):.2f},"
      f" noisy map {mean_error(decode_soft, 4, 0.01, True):.2f}")
輸出
stride  argmax  quarter  taylor   (mean error in input pixels)
     1    0.39     0.20    0.05
     2    0.80     0.40    0.11
     4    1.54     0.78    0.21
     8    3.20     1.59    0.43
soft-argmax, stride 4: clean map 0.04, noisy map 24.42
可以看出四個重點,圖 2 畫出前三個。
- argmax 誤差隨步幅線性成長,並緊貼 的預測(步幅 1 到 8 分別是 0.38、0.77、1.53、3.06)。
- 四分之一偏移讓誤差減半,而且不花任何成本。
- Taylor 步驟去除了剩下的大部分誤差,因為高斯的對數確實是拋物線;剩下的來自加入的雜訊。
- Soft-argmax 在乾淨的熱圖上是精確的,但在有雜訊的熱圖上嚴重失敗。 當 logits 等於 時,softmax 權重正比於 ,而散布在數千個格子上的微小雜訊底,總量會超過狹窄的峰值,把平均值拉向圖的中心。積分迴歸是讓網路透過 soft-argmax 一起訓練,迫使網路在關鍵點以外幾乎不放任何質量;若把 soft-argmax 事後套用在以 MSE 訓練的熱圖上,它就是個很差的解碼器。
其他輸出表示法
有兩種較新的表示法介於熱圖與單純迴歸之間。座標分類(SimCC [12])對每個關鍵點預測兩個一維分布,分別針對 與 ,每個像素分成多個 bin,不需大型 2D 圖就能降低量化誤差。以似然為基礎的迴歸(RLE [13])維持直接迴歸,但在訓練中學習誤差分布的形狀,其論文報告迴歸在多人姿態上勝過熱圖方法。兩者都是本篇稍後單階段與基於 query 的模型的自然輸出形式。
選讀:座標分類與以似然為基礎的迴歸(見「補充資料」頁)。SimCC 的 bin 與分割因子如何運作,以及為什麼迴歸損失的選擇其實是對誤差分布的假設。
單人熱圖網路
白話版。 精確定位需要高解析度細節,辨認正確關節還需要身體上下文。
輸入是人物裁切區域(person crop):圍著一個人的框,略微放大、補邊成固定的長寬比,再縮放成固定尺寸,例如 (高 × 寬)。輸出是步幅 4 的 張熱圖,這個例子裡是 。
- Convolutional Pose Machines(CPM) [14] 堆疊數個階段。每個階段看到影像特徵以及上一階段的熱圖(信念圖),所以後面的階段可以用其他關節的位置當脈絡,例如「手肘位於肩膀與手腕之間」。每個階段都有監督(中間監督,intermediate supervision),對抗深層堆疊中的梯度消失。
- 堆疊沙漏網路(stacked hourglass)[8] 把對稱的編碼器–解碼器(「沙漏」)模組重複多次,每次之後都有中間監督。每個沙漏先池化到非常粗的解析度以蒐集全身脈絡,再用跳接上取樣回來,這和 DLCV 04 為分割描述的編碼器–解碼器是同一個想法。
- SimpleBaseline [9] 證明這些機制大多沒有必要。它採用 ImageNet 預訓練的 ResNet(DLCV 02),在最後一個階段之上加三層反卷積(轉置卷積)層,對 的輸入產生 的熱圖。它的消融實驗發現,三層反卷積(熱圖 )比兩層()高 2.5 AP,直接量到了上面討論的解析度代價。
- HRNet [15] 讓高解析度分支貫穿整個網路,而不是到最後才恢復解析度。它逐步加入較低解析度的分支,讓它們平行執行,並反覆在所有解析度之間交換資訊(多尺度融合)。熱圖從高解析度分支讀出,而這個分支已經多次接收過粗尺度的脈絡。本篇後面有好幾個方法建立在 HRNet 之上:DARK 用 HRNet 模型回報它的解碼結果,HigherHRNet 與 DEKR 則把它擴展到由下而上的姿態。
- ViTPose [16] 把卷積骨幹換成不分層級的單純視覺 Transformer(ML 05),使用 的 patch,後面接由幾層反卷積(甚至只有一層上取樣加一層卷積)組成的輕量解碼器。論文把它從 1 億擴大到 10 億參數,顯示簡單的設計加上大型預訓練 Transformer,創造了新的準確度–吞吐量取捨。
選讀:Simple Baselines(Xiao 等人,2018)(見「論文導讀」頁)。論文的消融實驗量測了什麼,以及把它的數字與其他方法比較時要檢查什麼。
以上每個模型都有兩個重要的訓練細節。資料增強會對裁切區域做旋轉、縮放與翻轉;水平翻轉時必須對調左右關鍵點的通道。翻轉測試(flip testing)讓模型分別處理裁切區域與它的鏡像,把鏡像輸出的通道換回來,再把熱圖平均;堆疊沙漏論文報告這讓驗證集平均提升約 1% [8],後來的模型也把它當作標準作法 [9]。
選讀:翻轉測試與左右對調的記帳(見「補充資料」頁)。鏡射熱圖時的索引運算,以及沒有對調通道時會出什麼問題。
多人:由上而下與由下而上
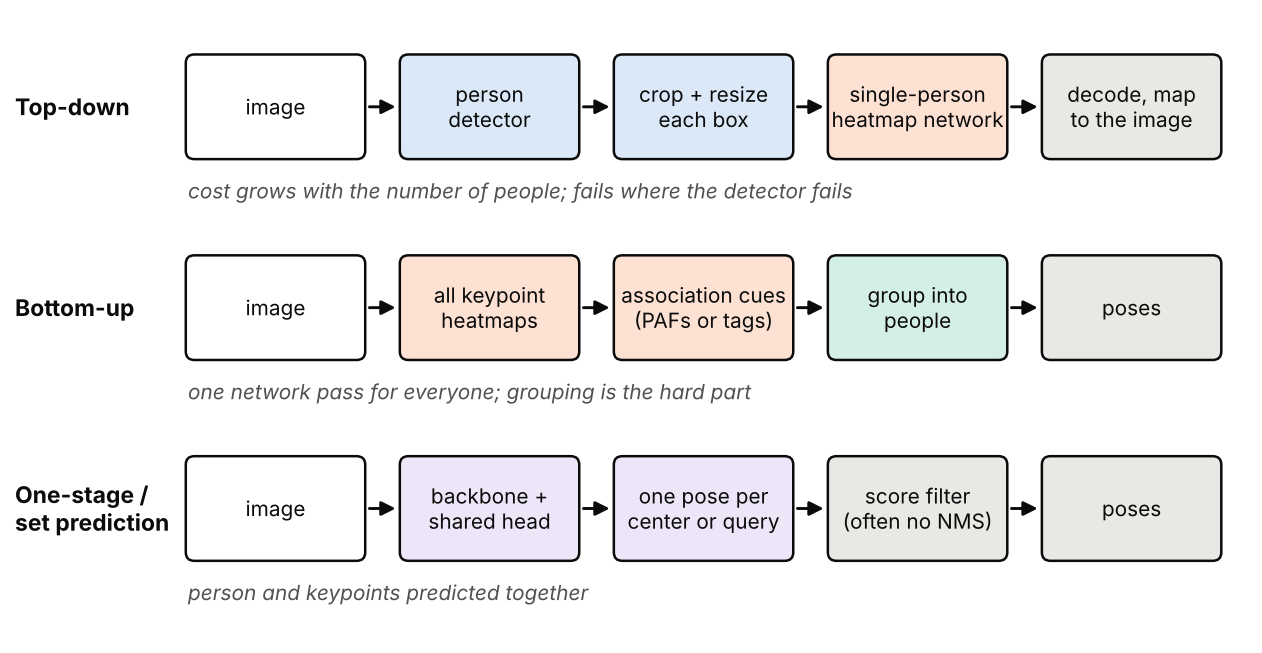
白話版。 照片裡有好幾個人時,有兩種工作順序。由上而下:先找出每個人,再在每個人的框裡找關節。由下而上:先找出圖中所有的關節,再判斷哪些關節屬於同一個人。第三類方法則兩件事一次做完。
由上而下:先偵測,再估計
人物偵測器(DLCV 03)提出框;每個框被裁切、縮放,再送進 SimpleBaseline、HRNet 或 ViTPose 這類單人網路;熱圖經過解碼,關鍵點再對應回影像座標。Mask R-CNN [17] 把同樣的想法建進偵測器:它的關鍵點分支在每個感興趣區域內預測 張大小為 的遮罩,每張都以 類 softmax 訓練,目標是關鍵點所在的單一「one-hot」像素(RoI 的機制見 DLCV 03)。
由上而下的方法很準確,因為每個人在關鍵點網路看到之前,都被縮放到同一個舒適的尺度,這對小尺寸與中等尺寸的人幫助最大 [18]。它的弱點來自流程本身:
- 成本隨人數成長,因為關鍵點網路每個框都要跑一次。
- 偵測器失敗的地方它也會失敗。 漏掉的人就沒有姿態;NMS(DLCV 03)可能刪掉兩個重疊者其中一個;而一個框裡若有兩個人,單人網路會有兩個左手腕可選。OpenPose 的作者在一個 COCO 驗證子集上量測過:同一個單人模型用真值框得到 62.7 AP,用 SSD 偵測器的框只有 52.7 AP [18]。
由下而上:先偵測所有關鍵點,再分組
由下而上的模型對整張影像只跑一次,輸出 張包含所有人關鍵點的熱圖。峰值用局部最大值檢驗找出,這相當於每種關鍵點各做一次 NMS。困難的部分是分組(grouping):決定哪個左手肘該跟哪個左手腕配對。
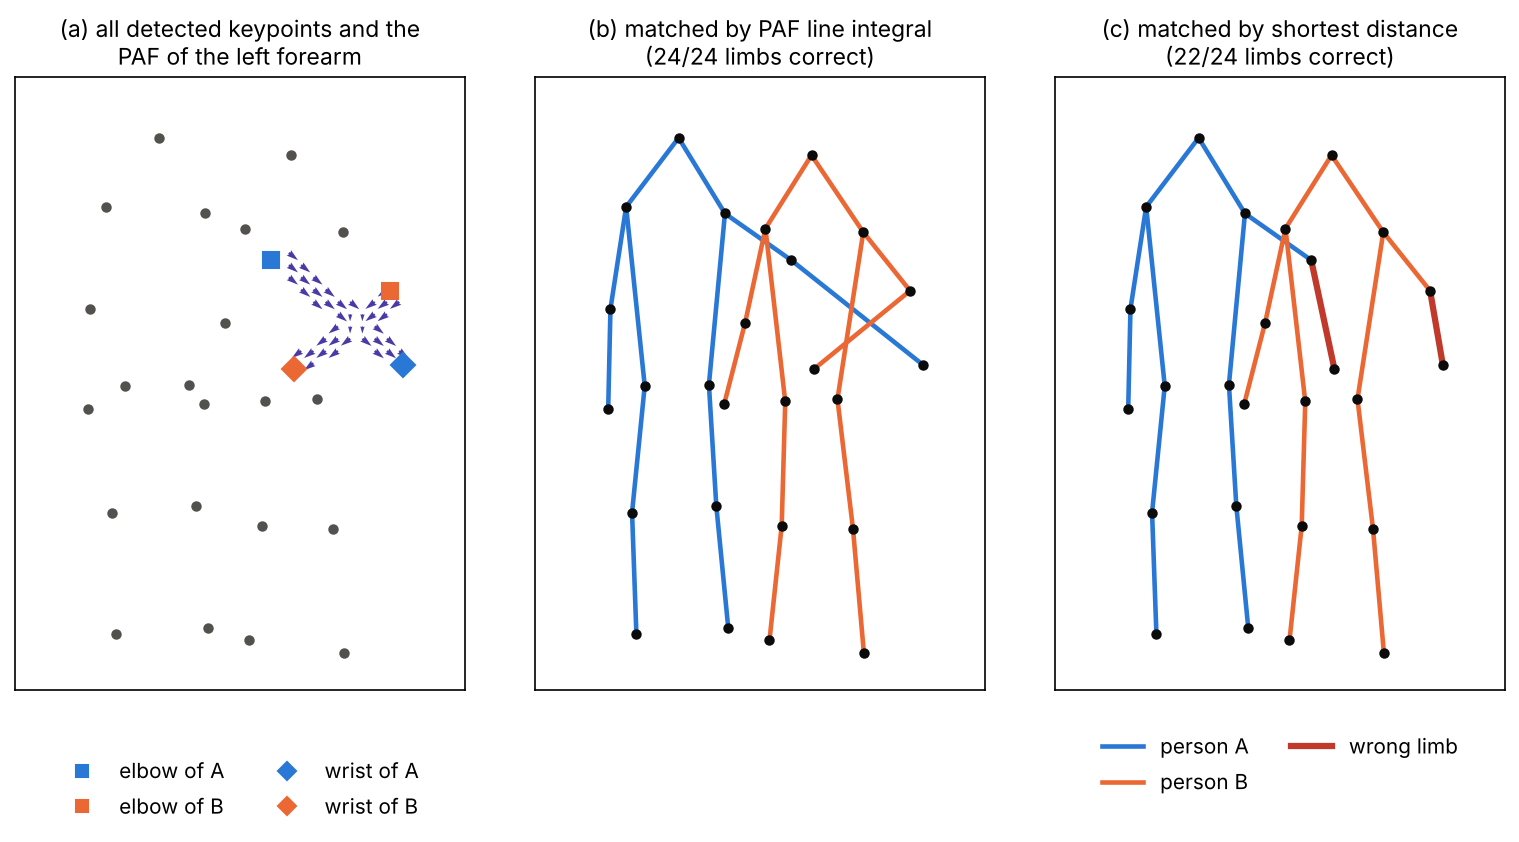
部分親和場(PAF)。 OpenPose [18] 除了熱圖之外,還對每種肢段預測一個 2D 向量場。在第 個人的肢段 上的像素,目標是指向該肢段方向的單位向量;其他地方為零:
其中 與 是肢段 連接的兩種關鍵點類型(例如左手肘與左手腕), 是第 個人的關鍵點 的位置,而「在肢段上」的意思是離它們之間的線段不超過 (肢段寬度,單位為像素)。幾個人的肢段重疊處,目標取平均。要為兩個偵測到的關鍵點 與 之間的候選連接打分,OpenPose 沿著連接兩者的線段對預測場 做積分:
其中 沿著線段變化,積分用幾個等間距的 取樣值來近似。當線段上的場和線段方向一致時, 就高,而這只有在兩個關鍵點真的是同一個肢段的兩端時才會發生。同時為所有肢段找最佳指派是 NP-hard,所以 OpenPose 做了鬆弛:只保留樹狀骨架的邊,對每種肢段各解一次二分圖匹配(bipartite matching),例如用匈牙利演算法(見 DLCV 07),再把共用關鍵點的肢段接成人。
選讀:OpenPose:部分親和場(Cao 等人,2017)(見「論文導讀」頁)。雙分支架構、貪婪式解析,以及如何閱讀論文中由上而下與由下而上的比較。
這段程式碼為兩個並肩站著、左前臂交叉的人建立真值 PAF,在關鍵點位置加入少量雜訊,再逐個肢段分組,一次用 PAF 分數,一次只用單純的距離(總肢段長度最短)。座標是合成的。
程式碼 · Python · 55 行
import numpy as np
from scipy.optimize import linear_sum_assignment

# 13 body keypoints and the 12 limbs of a tree that connects them
J = ["nose", "l_sho", "r_sho", "l_elb", "r_elb", "l_wri", "r_wri",
     "l_hip", "r_hip", "l_knee", "r_knee", "l_ank", "r_ank"]
LIMBS = [(0, 1), (0, 2), (1, 3), (3, 5), (2, 4), (4, 6),
         (1, 7), (2, 8), (7, 9), (9, 11), (8, 10), (10, 12)]

# two people side by side; their left forearms cross (synthetic coordinates)
A = np.array([[40, 20], [52, 38], [28, 38], [70, 50], [24, 62], [100, 74], [22, 86],
              [48, 80], [32, 80], [50, 110], [30, 110], [52, 140], [28, 140]], float)
B = np.array([[72, 24], [84, 42], [62, 42], [98, 58], [56, 64], [74, 76], [52, 86],
              [80, 84], [66, 84], [82, 114], [64, 114], [84, 144], [62, 144]], float)
people = [A, B]
H, W, width = 160, 120, 3.0

def render_paf(c):
    """Ground-truth part affinity field of limb c: unit vectors near each person's limb."""
    ys, xs = np.mgrid[0:H, 0:W]
    field, count = np.zeros((H, W, 2)), np.zeros((H, W))
    for P in people:
        a, b = P[LIMBS[c][0]], P[LIMBS[c][1]]
        v = (b - a) / np.linalg.norm(b - a)
        along = (xs - a[0]) * v[0] + (ys - a[1]) * v[1]
        across = np.abs(-(xs - a[0]) * v[1] + (ys - a[1]) * v[0])
        on = (along >= 0) & (along <= np.linalg.norm(b - a)) & (across <= width)
        field[on] += v; count[on] += 1
    return field / np.maximum(count, 1)[..., None]          # average where limbs overlap

def limb_score(field, p, q, n=10):
    """Line integral of the field along the segment p -> q, approximated by n samples."""
    d = (q - p) / np.linalg.norm(q - p)
    u = np.linspace(0, 1, n)[:, None]
    pts = np.round(p + u * (q - p)).astype(int)
    return np.mean(field[pts[:, 1], pts[:, 0]] @ d)

rng = np.random.default_rng(0)
cands = [np.stack([A[j], B[j]]) + rng.normal(0, 1.0, (2, 2)) for j in range(13)]  # detections

ok_paf = ok_near = 0
for c, (j1, j2) in enumerate(LIMBS):
    field = render_paf(c)
    S = np.array([[limb_score(field, p, q) for q in cands[j2]] for p in cands[j1]])
    D = np.linalg.norm(cands[j1][:, None] - cands[j2][None], axis=2)
    if (j1, j2) == (3, 5):                                    # the crossing forearms
        print("left elbow -> left wrist, PAF scores (rows: elbows A, B; cols: wrists A, B)")
        print(np.round(S, 2))
        print("distances in pixels"); print(np.round(D, 1))
    r, k = linear_sum_assignment(-S)                          # maximize total affinity
    ok_paf += np.sum(k == r)                                  # candidate i belongs to person i
    r, k = linear_sum_assignment(D)                           # baseline: shortest total length
    ok_near += np.sum(k == r)
print(f"correct limbs with PAF scores:     {ok_paf}/{2 * len(LIMBS)}")
print(f"correct limbs with distance only:  {ok_near}/{2 * len(LIMBS)}")
輸出
left elbow -> left wrist, PAF scores (rows: elbows A, B; cols: wrists A, B)
[[0.67 0.04]
 [0.29 0.78]]
distances in pixels
[[41.1 27.2]
 [18.4 30.2]]
correct limbs with PAF scores:     24/24
correct limbs with distance only: 22/24印出的矩陣顯示只靠幾何會失敗。每個手肘都更靠近另一個人的手腕(27.2 與 18.4 像素),而不是自己的(41.1 與 30.2),所以依距離配對會把兩條前臂都接錯。PAF 分數只在真正的肢段上高(0.67 與 0.78),因為那裡的場指向線段的方向;在錯誤的配對上則很低。圖 4 畫出兩種結果。請注意這裡的 PAF 是真值;訓練好的網路預測的場會比較模糊,方法的準確度取決於它預測得多好。
關聯嵌入(associative embedding)。 Newell 等人 [19] 完全不用肢段場。網路在每張關鍵點熱圖旁邊輸出一張 tag 圖:每個像素一個實數。訓練時讓同一個人的關鍵點 tag 彼此相等,不同人的 tag 彼此相異。令 為關鍵點類型 在像素 處的 tag, 為第 個人的關鍵點 的真值位置,共 個人, 為第 個人的平均 tag,則分組損失為
其中第一項把每個人的 tag 拉向他們的平均,第二項把不同人的平均推開,懲罰會隨兩者距離增加而衰減( 決定多遠才算「夠遠」)。tag 的絕對值不重要,只有差值重要。測試時,關鍵點一個關節接一個關節地加入人物,配對 tag 接近且偵測信心高的那些。CornerNet 借用了完全相同的想法來配對框的角點(DLCV 03)。
尺度。 由下而上的方法以影像本身的尺度看所有人,所以小尺寸的人只佔到很少的熱圖格子;OpenPose 在中等尺寸的人上不如由上而下的方法準確,原因就在這裡 [18]。HigherHRNet [20] 加入解析度更高的熱圖(HRNet 的輸出用轉置卷積上取樣),並對多個解析度做監督與聚合;其論文報告在 CrowdPose 測試集上勝過所有由上而下的方法,那裡的框並不可靠。DEKR [21] 回到密集迴歸,每個關鍵點有一個分支,其自適應卷積專注在該關鍵點的區域,並報告在 COCO 與 CrowdPose 上優於偵測加分組的方法。
單階段與集合預測姿態
第三類方法直接為每個人預測完整的姿態,不需要獨立的分組步驟。
- 以中心為基礎。 CenterNet(「Objects as Points」)[22] 在熱圖上把每個人偵測為一個中心點,並迴歸從中心到各關鍵點的 個偏移量;接著把每個迴歸出的關鍵點吸附到另一張關鍵點熱圖上最近的峰值,所以中心扮演了分組的線索。
- 即時密集頭。 RTMO [23] 把姿態頭放進 YOLO 風格的單階段偵測器,用一對一維熱圖(座標分類)表示每個關鍵點,目標是以單階段的速度達到由上而下的準確度。
- 集合預測。 DETR 風格的 Transformer 偵測器(DLCV 03)輸出固定數量的 query,並與真值一對一匹配,所以不需要 NMS 或分組。ED-Pose [24] 以兩個明確的框偵測階段把它套用到姿態上:人物解碼器偵測人,人到關鍵點解碼器則把每個關鍵點當成一個要偵測的小框。它用 L1 迴歸損失訓練、不用熱圖,並報告在 COCO 上,使用相同骨幹時優於以熱圖為基礎的由上而下方法。
選擇哪種流程
| 由上而下 | 由下而上 | 單階段/集合預測 | |
|---|---|---|---|
| 主要步驟 | 先偵測人,再逐一估計 | 先偵測所有關鍵點,再分組 | 直接預測每個人的姿態 |
| 成本與人數的關係 | 線性成長 | 網路成本幾乎固定;分組成本會成長 | 幾乎固定 |
| 小尺寸的人 | 好(每個裁切區域都會縮放) | 較難(所有人共用一個影像尺度) | 取決於特徵金字塔 |
| 擁擠與重疊 | 框會重疊;NMS 可能刪掉人 | 分組可能把人混在一起 | query 或中心可能碰撞 |
| 典型用途 | 人少且分得開時要求高準確度 | 同時有很多人;即時系統 | 端到端訓練;即時 |
衡量姿態準確度
白話版。 預測的關鍵點只要離真實位置近,就算「好」;但「近」必須取決於人的大小,也取決於是哪一種關鍵點:在很小的人的鼻子上偏 5 像素是大錯;在很大的人的臀部上偏 5 像素就不是。
PCK 與 PCKh
正確關鍵點百分比(percentage of correct keypoints, PCK)把預測關鍵點落在真值的門檻距離之內視為正確,門檻是人物大小的某個比例。Yang 與 Ramanan 使用人物邊界框大小的某個比例 [25]。MPII 的 PCKh [26] 則改用頭部線段長度的 50%,因為人彎腰或伸展時頭的大小不會改變。形式上,
其中 是人的索引, 是關鍵點的索引, 是第 個人的頭部線段長度, 是比例(標準 PCKh 取 ), 與 在條件成立時為 1,否則為 0,且只計入已標註的關鍵點。PCK 假設人已經被找到;它不會懲罰漏掉或憑空多出的人,這就是為什麼多人基準使用 AP 類型的指標。
物件關鍵點相似度與關鍵點 AP
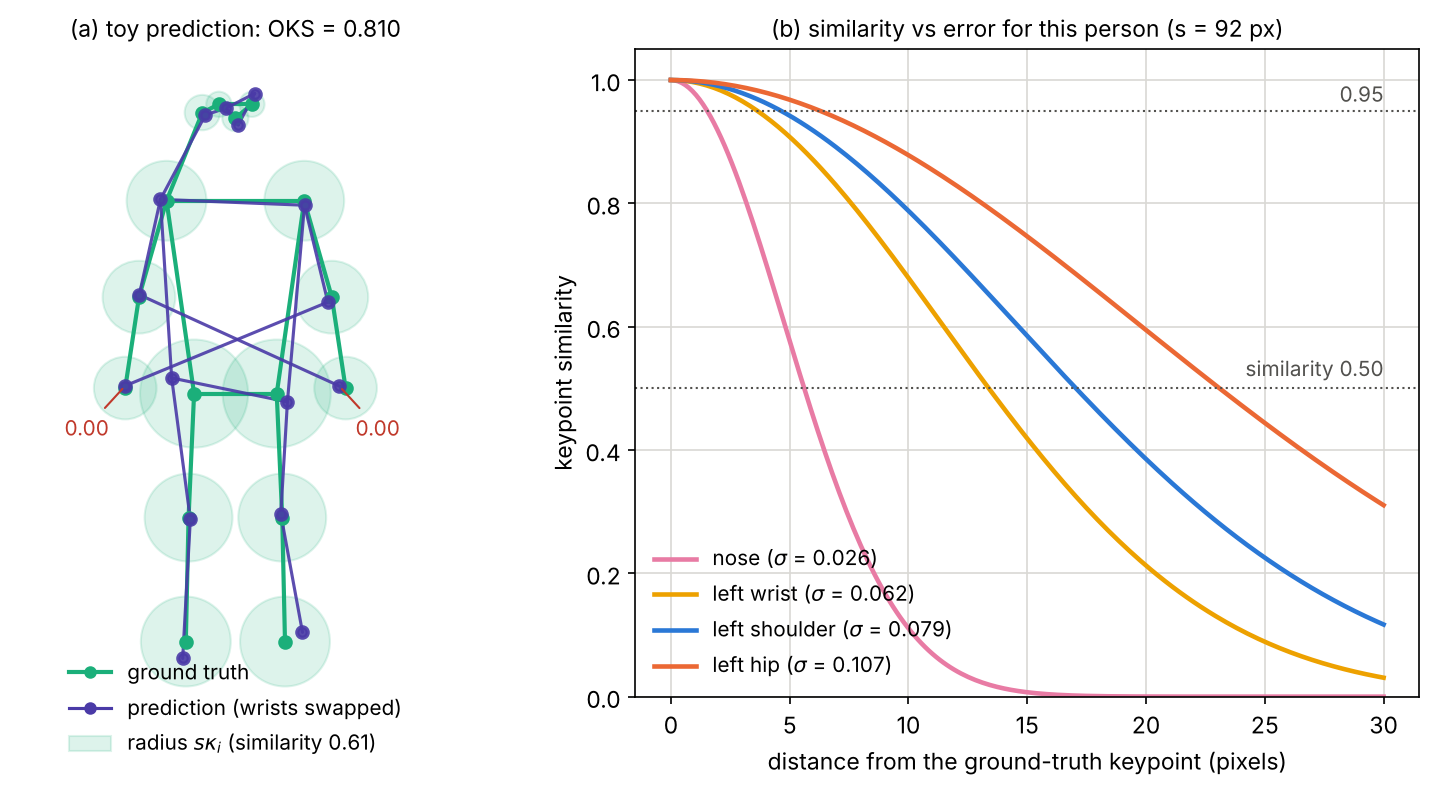
COCO 的指標仿照框偵測(DLCV 03)。在框 AP 中,偵測與真值框的 IoU 超過門檻時就算配對成功。在關鍵點 AP 中,預測姿態與真值人物的物件關鍵點相似度(object keypoint similarity, OKS)超過門檻時才算配對成功 [4]:
其中 遍歷所有關鍵點, 是預測與真值關鍵點 之間的歐幾里得距離, 是真值的可見性旗標, 是物件尺度,定義為該人物分割面積的平方根, 是各關鍵點的常數。每一項都是誤差的未正規化高斯,標準差為 ,所以完美的關鍵點為 1,誤差變大時趨近 0;OKS 對已標註的關鍵點取平均。預測的可見性旗標不會被使用。
常數從哪裡來。 COCO 取 5,000 張驗證影像,由兩組人各標註一次,對每種關鍵點類型量測人類標註者相對於人物尺度的分歧程度,,再設 [4]。 的值為:鼻子 0.026、眼睛 0.025、耳朵 0.035、肩膀 0.079、手肘 0.072、手腕 0.062、臀部 0.107、膝蓋 0.087、腳踝 0.089 [4], [27]。眼睛容易精確定位;臀部藏在衣服下面就不容易,所以這個指標對臀部比較寬容。取 時,一、二、三個標註者標準差的誤差,相似度分別是 、 與 ,而人類標註者彼此之間的 OKS 中位數約為 0.91 [4]。
從 OKS 到 AP。 其餘部分就是 DLCV 03 的 AP:依人物層級的分數排序所有預測姿態,把每個姿態配對到 OKS 最高且尚未被配對的真值人物,再在 OKS 門檻 下計算 AP。主要指標 AP 是這十個值的平均。附屬指標有 、、中等尺寸的人 (面積介於 與 之間)、大尺寸的人 (面積大於 ),以及對應的 AR 值。每張影像最多計分 20 個姿態,而小尺寸的人沒有關鍵點標註 [4]。
選讀:深入 OKS:未標註的人、擁擠區域與尺度 s(見「補充資料」頁)。評估程式碼如何處理沒有關鍵點標註的人、為什麼每個人的權重相同,以及對一個被部分遮住的人來說 是什麼意思。
這段程式碼用 COCO 的常數,對一個約 200 像素高的合成人物計算 OKS。
程式碼 · Python · 34 行
import numpy as np

NAMES = ["nose", "l_eye", "r_eye", "l_ear", "r_ear", "l_shoulder", "r_shoulder",
         "l_elbow", "r_elbow", "l_wrist", "r_wrist", "l_hip", "r_hip",
         "l_knee", "r_knee", "l_ankle", "r_ankle"]
SIGMAS = np.array([.26, .25, .25, .35, .35, .79, .79, .72, .72, .62, .62,
                   1.07, 1.07, .87, .87, .89, .89]) / 10.0       # COCO per-keypoint constants

def oks(pred, gt, vis, area):
    """pred, gt: (17, 2) pixel coordinates; vis: (17,) COCO flags; area: segment area (s^2)."""
    d2 = ((pred - gt) ** 2).sum(1)
    kappa = 2 * SIGMAS
    ks = np.exp(-d2 / (2 * area * kappa ** 2))                 # per-keypoint similarity
    labeled = vis > 0
    return ks[labeled].mean(), ks

# a standing person about 200 px tall, facing the camera (synthetic coordinates)
gt = np.array([[100, 30], [106, 25], [94, 25], [112, 28], [88, 28], [125, 60], [75, 60],
               [135, 95], [65, 95], [140, 128], [60, 128], [115, 130], [85, 130],
               [117, 175], [83, 175], [118, 220], [82, 220]], float)
vis = np.full(17, 2); vis[3] = 0                                # left ear not labeled
area = 0.6 * (70 * 200)                                         # segment area: ~60% of its box

rng = np.random.default_rng(1)
jitter = gt + rng.normal(0, 3, gt.shape)                        # every keypoint off by ~3 px per axis
flipped = jitter.copy(); flipped[[9, 10]] = flipped[[10, 9]]    # left/right wrists swapped
print(f"perfect          OKS = {oks(gt, gt, vis, area)[0]:.3f}")
print(f"3 px jitter      OKS = {oks(jitter, gt, vis, area)[0]:.3f}")
print(f"+ wrists swapped OKS = {oks(flipped, gt, vis, area)[0]:.3f}")

# the same 5-pixel error costs very different amounts on different keypoints
for k in (0, 5, 11):
    p = gt.copy(); p[k, 0] += 5
    print(f"5 px error on {NAMES[k]:10s}: similarity {oks(p, gt, vis, area)[1][k]:.3f}")
輸出
perfect          OKS = 1.000
3 px jitter      OKS = 0.933
+ wrists swapped OKS = 0.810
5 px error on nose      : similarity 0.577
5 px error on l_shoulder: similarity 0.942
5 px error on l_hip : similarity 0.968這個合成範例有三個重點。到處有小抖動,代價很小(0.933)。單一的手腕左右對調會讓兩個手腕的相似度都變成幾乎為零,OKS 降到 0.810:這個姿態在門檻到 0.80 為止仍算正確,但在 0.85 以上就失敗,所以十個 AP 門檻中大約損失三分之一。而同樣 5 像素的誤差,在鼻子上要花掉 0.42 的相似度,在臀部上只花 0.03。圖 5 顯示每個關鍵點的容忍半徑與相似度曲線。
3D 姿態的指標
3D 姿態的標準指標是平均每關節位置誤差(mean per-joint position error, MPJPE),即預測與真值 3D 關節之間歐幾里得距離的平均,
以毫米為單位,並對所有測試影格取平均,其中 與 是關節 的預測與真實 3D 位置。Human3.6M 上常見兩種協定:把預測與真值的根(中央臀部)關節對齊後計算誤差,稱為協定 #1;再額外把預測骨架剛性對齊到真值後計算誤差,稱為協定 #2 [28];第二種指標也稱為 PA-MPJPE 或重建誤差 [2]。第二種會掩蓋全域旋轉與尺度的誤差,所以兩個數字絕對不能互相比較。
數字沒告訴你的事
和框 AP 一樣,關鍵點 AP 混合了好幾種誤差。Ronchi 與 Perona [29] 把關鍵點定位誤差分成四種:抖動(jitter,靠近正確的關鍵點,但超出人類誤差範圍)、反轉(inversion,落在這個人自己的左右對應點或另一個關鍵點上)、對調(swap,落在另一個人的關鍵點上)與漏失(miss,附近沒有任何關鍵點)。他們發現誤差最取決於可見關鍵點的數量,以及附近其他人造成的雜亂。連 COCO 經過兩次標註的資料也有 1–2% 的離群值,多半是左右混淆或標到錯的人 [4]。診斷模型時要依誤差類型,而不是只看 AP。
資料集與基準
白話版。 少數幾個資料集定義了什麼叫「好」:COCO 代表日常照片中的多人,MPII 代表廣泛的活動,CrowdPose 代表嚴重重疊,Human3.6M 代表 3D,另外還有較新的資料集涵蓋全身、影片與動物。
| 資料集 | 內容(取自論文或官方頁面) | 指標 | 為什麼重要 |
|---|---|---|---|
| COCO keypoints [30], [4] | 日常照片中人物的 17 個身體關鍵點;小尺寸的人未標註 | OKS AP | 主要的多人基準 |
| MPII Human Pose [26] | 40,522 個有標註的人,影像來自 YouTube 影片,以超過 800 種活動為查詢詞蒐集 | PCKh | 活動多樣;有單人與多人賽道 |
| CrowdPose [31] | 20,000 張影像、約 80,000 人、14 個關鍵點,挑選成擁擠程度均勻分布 | OKS AP | 擁擠場景 |
| COCO-WholeBody [32] | 每人 133 個特徵點:臉部 68、手部 42、身體與腳部 23 | OKS AP | 臉、手與腳一起處理 |
| PoseTrack [33] | 含人物軌跡與關節姿態的影片 | AP、MOTA | 影片中的姿態估計與追蹤 |
| Human3.6M [34] | 11 位演員、17 種情境的 360 萬個 3D 姿態,由 4 台校正過的相機搭配動作捕捉記錄 | MPJPE | 最廣泛使用的 3D 基準 |
| AP-10K [35] | 23 個科、54 種哺乳動物的 10,015 張影像,以 COCO 風格標註 | AP | 動物姿態與跨物種泛化 |
CrowdPose 值得細看,因為它對擁擠程度有精確的定義。對第 個人,令 為落在其框內的自己的關節數, 為落在同一個框內的其他人的關節數;有 個人的影像的擁擠指數(Crowd Index)為 [31]。常見資料集以不擁擠的影像為主;CrowdPose 的挑選方式讓這個指數在 0 與 1 之間近乎均勻分布,其作者發現強模型在擁擠影像上的準確度比不擁擠的影像低約 20 AP [31]。
閱讀結果時有兩點要小心。Human3.6M 是只有少數演員的室內資料集 [2], [34],所以在那裡 MPJPE 低,不代表在室外影片上也有好結果。而在 COCO 上,結果取決於由上而下方法所用的人物偵測器(見 Simple Baselines 導讀)、輸入解析度與額外的訓練資料,所以只有在相同設定下才能比較數字。
人體之外
白話版。 熱圖網路裡沒有任何東西是專屬於人的。換掉關鍵點的清單和訓練資料,同一套機制就能找出臉的角落、手的關節,或狗的爪子。
- 全身。 COCO-WholeBody [32] 在身體關鍵點之外加入腳、手與密集的臉部特徵點,這在同一個人身上造成極大的尺度範圍;它的基準模型 ZoomNet 圍繞身體的階層結構設計來處理這一點。OpenPose 的期刊版本 [36] 加入了腳部關鍵點。
- 動物。 AP-10K [35] 對 54 種哺乳動物的姿態做基準測試,並檢驗對未見過的動物科別的泛化能力。在神經科學中,DeepLabCut [1] 以預訓練網路做遷移學習,在其實驗中用約 200 個標註影格,就能追蹤小鼠與果蠅使用者自訂的身體部位,取代反光標記。
- 物件。 同樣的表述適用於任何具有一致特徵點的類別,例如汽車的車輪與車燈,前提是關鍵點的定義一致,並且像處理人體那樣處理該類別的左右對稱。
從 2D 到 3D 姿態
白話版。 照片把世界壓平了:從單張影像看,指向相機的手和放在臀部的手可能看起來幾乎一樣。要把深度找回來有三種方法:憑經驗猜(提升)、用兩台以上的相機量(三角測量),或擬合一個只允許合理體型的人體模型。
提升 2D 關鍵點
Martinez 等人 [28] 證明,單目 3D 姿態估計中令人意外大的一部分,只要 2D 關鍵點已知就解決了。他們的模型取偵測到的 2D 姿態的 個座標,用簡單的全連接網路(含批次正規化、dropout 與殘差連接的線性層)對應到 個座標。在 Human3.6M 上訓練後,給定真值 2D 關鍵點時,它大幅超越先前最佳的方法,這暗示剩餘的困難大部分在 2D 偵測,而不是提升。提升也是有歧義的:好幾個 3D 姿態會投影成同一個 2D 姿態,而只有單一輸出的網路只能傳回其中一個。
VideoPose3D [37] 用擴張時間卷積提升整段 2D 姿態序列,所以相鄰影格之間的運動有助於解決深度與抖動問題。它還提出反投影(back-projection),這是一種半監督損失:對沒有標註的影片估計 3D 姿態,並要求它們投影回偵測到的 2D 關鍵點。
多視角三角測量
有兩台以上校正過的相機時,深度就不再是猜測。每台相機的 2D 關鍵點在空間中定義一條射線,3D 關節就是這些射線(幾乎)相交的那一點。這個幾何就是 DLCV 11 的三角測量,逐個關節套用:相機矩陣就是該篇的針孔模型,線性(DLT)解則推導於它的補充資料。可學習的三角測量 [38] 讓這一步成為網路的一部分:它依影像預測的信心為每個視角加權,所以關節被遮擋的視角貢獻較少;它的第二種變體則把所有視角的 2D 特徵聚合成 3D 體積,再用 3D 卷積精修。
這段程式碼把一個合成的 13 關節骨架(站在兩台朝內對準的相機前方 4 公尺處)投影到兩張影像中,在 2D 關鍵點上加入 2 像素的雜訊,用 DLT 對每個關節做三角測量,並在三種相機間距(基線,baseline)下回報 MPJPE。數字來自這次合成實驗,沒有做根對齊。
程式碼 · Python · 38 行
import numpy as np

def camera(K, angle_deg, center):
    """3x4 projection P = K [R | t] for a camera at `center` rotated about the y axis."""
    a = np.deg2rad(angle_deg)
    R = np.array([[np.cos(a), 0, -np.sin(a)], [0, 1, 0], [np.sin(a), 0, np.cos(a)]])
    return K @ np.hstack([R, -R @ center[:, None]])

def project(P, X):
    x = (P @ np.hstack([X, np.ones((len(X), 1))]).T).T
    return x[:, :2] / x[:, 2:]

def triangulate(Ps, xs):
    """Linear (DLT) triangulation of one point seen in several views."""
    A = []
    for P, (u, v) in zip(Ps, xs):
        A += [u * P[2] - P[0], v * P[2] - P[1]]
    X = np.linalg.svd(np.array(A))[2][-1]
    return X[:3] / X[3]

# a 13-joint 3D skeleton in millimetres, standing 4 m in front of the cameras (synthetic)
skel = np.array([[0, -1650, 0], [170, -1400, 0], [-170, -1400, 0], [250, -1120, 50], [-250, -1120, 50],
                 [280, -860, 120], [-280, -860, 120], [100, -900, 0], [-100, -900, 0],
                 [110, -480, 30], [-110, -480, 30], [110, -60, 0], [-110, -60, 0]], float)
skel += [0, 900, 4000]
K = np.array([[1000, 0, 640], [0, 1000, 360], [0, 0, 1]], float)

rng = np.random.default_rng(0)
for baseline in (200, 1000, 3000):                          # distance between the cameras (mm)
    half = baseline / 2
    Ps = [camera(K, np.degrees(np.arctan2(half, 4000)), np.array([-half, 0, 0.])),
          camera(K, -np.degrees(np.arctan2(half, 4000)), np.array([half, 0, 0.]))]
    errs = []
    for trial in range(200):                                  # 2D detections with 2 px noise
        obs = [project(P, skel) + rng.normal(0, 2.0, (13, 2)) for P in Ps]
        est = np.array([triangulate(Ps, [o[j] for o in obs]) for j in range(13)])
        errs.append(np.linalg.norm(est - skel, axis=1).mean())   # MPJPE of this trial
    print(f"baseline {baseline:4d} mm: MPJPE = {np.mean(errs):6.1f} mm")
輸出
baseline  200 mm: MPJPE =  183.7 mm
baseline 1000 mm: MPJPE =   37.9 mm
baseline 3000 mm: MPJPE =   17.4 mm
相機相距 20 公分時,2 像素的影像誤差在 3D 中變成約 18 公分,幾乎全部在深度方向(同一次實驗的逐軸檢查顯示深度方向 182 毫米,橫向分別為 9 與 18 毫米):射線幾乎平行,所以微小的位移會讓交點沿著射線移動很遠。較寬的基線讓射線以較大的角度相交,把誤差降低為十分之一。
參數化人體模型與網格重建
骨架完全沒有說明體型,也沒有任何機制阻止提升網路預測出每個影格長度都在變的前臂。參數化人體模型(parametric body model)用一小組參數描述人體,解決了這兩個問題。最常用的是 SMPL [39]。它從一個有 個頂點的模板網格,以及有 個關節的骨架出發,產生擺好姿態的人體:
其中 是體型參數(身體形狀變異主要模式的係數), 是姿態參數(每個關節相對其父關節的軸角旋轉,加上全域朝向: 個數字), 是模板網格, 與 是頂點偏移量,分別建模個人差異與隨姿態變化的形變(例如肌肉隆起), 是由上了體型的網格迴歸出的關節位置, 是混合權重, 是標準的混合蒙皮(blend-skinning)函數,讓每個頂點繞著關節旋轉。關鍵點是從網格上讀出的,所以擬合好的 SMPL 人體永遠有一致的骨長。
人體網格重建(human mesh recovery, HMR)[40] 直接從影像迴歸 SMPL 參數與相機。它的主要損失是模型關節對 2D 關鍵點標籤的重投影誤差,這使得可以在野外影像上訓練;另有一個用真實 3D 人體訓練的對抗式先驗,會排除不合理的參數。HMR 2.0 是 4DHumans [41] 的一部分,它讓網路完全以 Transformer 為基礎,並在影片中追蹤重建出的人物度過遮擋。
選讀:SMPL 細說(見「補充資料」頁)。模型每一項的作用、關節與關鍵點如何從網格取得,以及為什麼姿態混合形狀在休息姿態下會消失。
失效模式與實務建議
白話版。 姿態模型失敗的地方,也是人會猶豫的地方:被藏起來的關節、纏在一起的人、鏡像混淆、被畫面切掉的身體、訓練中很少見的姿勢,以及模糊。
- 遮擋。 被遮擋的關節()有標註但看不到,所以網路必須從脈絡推斷;自遮擋讓雙腿特別容易發生左右混淆 [29]。
- 擁擠。 重疊的人會讓偵測器失靈、讓分組混淆,並造成對調誤差 [29];擁擠指數升高時準確度就下降 [31]。
- 左右翻轉。 正面與背面看起來很像,所以模型可能把一條肢段或整個人鏡像(反轉);翻轉增強時忘了對調通道,也會造成系統性的同類錯誤。
- 截斷。 畫面外的關節沒有標註或只能猜測,局部人物的裁切區域也很難對中。
- 罕見姿勢。 體操、舞蹈或躺著的人在訓練資料中很少見;HMR 2.0 的作者特別指出這是先前方法吃力的情況 [41]。
- 動態模糊、低解析度與領域偏移。 快速的肢體會被拖影,小尺寸的人每條肢段只有很少像素,而以成人照片訓練的模型對嬰兒或藝術作品的遷移效果不佳 [2]。
本篇帶出的實務建議是:使用無偏的編碼器與子像素解碼器;檢查翻轉時有對調左右通道;回報由上而下結果所用的偵測器與輸入尺寸;分開評估擁擠與不擁擠的影像;依類型拆解誤差;影片中則在時間上平滑或追蹤關鍵點。以偵測為基礎的追蹤(tracking-by-detection)與 DLCV 07 的關聯方法可以直接沿用:例如 SimpleBaseline 用光流把姿態傳播到下一個影格,並用以 OKS 為基礎的相似度來配對 [9],PoseTrack 則提供了基準 [33]。追蹤個別表面點而不是具名關節,則是 DLCV 07 的點追蹤問題。
現代觀點
綜述怎麼說
Zheng 等人 [2] 回顧 2014 年以來超過 250 篇以深度學習做 2D 與 3D 姿態的論文,組織方式與本篇相同:迴歸對熱圖、由上而下對由下而上,3D 則分為提升、網格重建與多視角方法。他們的未來方向包括領域適應、人與場景的約束,以及時間平滑度的指標。
Chen 等人 [3] 把單目方法整理成四種任務(2D 或 3D、單人或多人),列出被證明有效的設計技巧(多階段結構、中間監督、多尺度融合、身體結構約束),並指出遮擋與擁擠是主要尚未解決的挑戰。
Tian 等人 [5] 綜述以人體模型做的單目 3D 網格重建,對比以最佳化為基礎的擬合與迴歸網路,並指出缺乏野外 3D 標籤是核心困難。
選讀:「現代觀點」綜述導讀(見「論文導讀」頁)。每篇綜述涵蓋什麼、如何組織,以及如何把它當作地圖使用。
2023–2026 年的最先進技術
- 放大規模的由上而下 Transformer 姿態。 ViTPose [16] 證明單純的視覺 Transformer 搭配簡單的解碼器可以良好地擴大規模(論文中從 1 億到 10 億參數),其最大的模型在發表時刷新了 COCO 關鍵點基準的最佳紀錄。
- 以人為中心的基礎模型。 Sapiens [42] 以自監督方式,在超過 3 億張人類影像上預訓練 3 億到 20 億參數的視覺 Transformer,再微調到 2D 姿態、身體部位分割、深度與表面法向量;其作者報告,在相同的運算預算下,這種針對人的預訓練改善了全部四項任務。
- 即時系統。 RTMPose [43](由上而下、座標分類,針對 CPU、GPU 與行動裝置部署而設計)與 RTMO [23](單階段)瞄準的是應用的延遲預算,而不是排行榜的巔峰。
- 端到端多人模型。 ED-Pose [24] 這類基於 query 的模型去除了 NMS、分組與熱圖;ED-Pose 報告在相同骨幹下,COCO 準確度高於以熱圖為基礎的由上而下方法。
- 影片中的 3D 人體。 HMR 2.0 [41] 這類 Transformer 網格重建,能從單目影片重建並追蹤完整的 3D 人體,讓這個領域從稀疏的骨架邁向完整的人體表面。
尚待解決的問題
- 擁擠與嚴重遮擋仍是最大的準確度落差 [31], [3]。
- 野外 3D。 實驗室以外很難取得準確的 3D 標籤 [5],而最廣泛使用的 3D 基準 Human3.6M 是室內資料集 [2],所以單目 3D 方法的訓練與測試環境,離實際使用的環境很遠。
- 時間一致性。 MPJPE 這類逐影格的指標無法衡量抖動,也無法衡量隨時間的物理合理性 [2]。
- 跨領域與跨物種的泛化:嬰兒、藝術作品、不尋常的視角,以及未見過的動物科別 [2], [35]。
- 評估。 OKS 的常數是依 COCO 人物上標註者的分歧程度量測的 [4],不會自動適用於其他關鍵點集合;而 AP 會掩蓋反轉與對調這類誤差類型 [29]。
重點整理
- 關鍵點名稱、左右規約與可見性標籤須一致。
- 熱圖解析度與解碼影響定位,只取最亮格子會遺失次像素資訊。
- 精確關節定位需要細緻空間特徵,以及足以辨識部位的上下文。
- 由上而下方法承接偵測錯誤與逐人成本,由下而上方法則需要分組。
- 註明各指標的尺度正規化、可見性規則與座標規約。
- 三維提升有多解,三角測量需要校準,身體模型則加入形狀假設;應依類型檢查錯誤。
練習
- 手算量化。 一個手腕在裁切區域中位於 像素,熱圖步幅為 4。峰值在哪一欄熱圖?argmax 解碼傳回什麼,誤差是多少?四分之一偏移傳回什麼?在無雜訊的高斯上做精確的 Taylor 步驟會傳回什麼?
提示
以熱圖單位計,手腕在 ,所以峰值在第 25 欄,argmax 傳回 像素,誤差 1.3 像素。右鄰格(第 26 欄)比左鄰格更接近 25.325,所以四分之一偏移移到 25.25,對應 101.0 像素(誤差 0.3)。在無雜訊的高斯上,對數熱圖是精確的拋物線,所以 Taylor 步驟傳回 25.325,也就是 101.3 像素。
- 手算 OKS。 某人的分割面積是 像素²,所以 。預測的膝蓋離真值 10 像素。用 COCO 的常數計算它的關鍵點相似度。再對偏了 10 像素的鼻子重算一次。你寧願犯哪一種誤差?為什麼 COCO 對兩者的處理差這麼多?
提示
膝蓋:,,相似度 。鼻子:,,相似度 。標註者放置鼻子的一致性大約是膝蓋的三倍,而 COCO 依這種分歧程度來調整容忍度。
- 由上而下何時變得太慢? 人物偵測器每張影像花 20 ms,單人網路每個裁切區域花 5 ms。由下而上的網路每張影像花 40 ms,另外每個人需要 1 ms 的分組時間。每張影像多少人時,由下而上比較快?除了速度之外,請說出在擁擠的火車站中偏好其中一種流程的兩個理由。
提示
由上而下的成本是 ms,由下而上是 ms,所以當 ,也就是超過 5 個人時,由下而上比較快。在擁擠的車站裡,由上而下受害於重疊的框與 NMS 刪掉人,但因為每個裁切區域都會縮放,所以處理遠處的小尺寸的人比較好;由下而上的網路成本固定,但必須對嚴重重疊的肢段分組,而且小尺寸的人只佔到很少的熱圖格子。
- 破壞部分親和場。 在分組程式碼中,移動人物 B,讓他的左前臂與人物 A 的左前臂位在同一條線上並互相重疊(一個人站在另一個人後面)。兩個正確配對與兩個錯誤配對的 PAF 分數會怎麼樣?為什麼?還能用什麼額外線索解決這個情況?
提示
兩個肢段重疊處,目標場是兩個相同單位向量的平均,所以它沿著共用的那條線。這條線上任何手肘到手腕的候選線段,不論對錯,都與場對齊,得到相近的分數,所以配對變得有歧義。可以幫上忙的線索有:肢段相對於各自身體其他部分的長度、像關聯嵌入那樣的 tag、每個人的其他肢段(採全域而非逐肢段的解析),或影片中的時間連續性。
- 相機看不見的對調。 修改三角測量的程式碼,讓兩台相機都瞄準骨架的中心,並在第二台相機中對調左右膝蓋的 2D 位置(2D 偵測器的反轉誤差)。對左膝蓋做三角測量,計算它在兩個視角中的平均重投影誤差,分別比較有對調與沒有對調的情況。接著把第二台相機移到第一台上方 1 公尺處(而不是旁邊)再做一次。解釋兩者的差異。
提示
在我們對這個實驗的執行中,相機並排時,不管有沒有對調,重投影誤差都約 1 像素,但對調後的膝蓋落點離真值超過半公尺。兩個膝蓋高度幾乎相同,水平基線下對極線幾乎是水平的,所以對調膝蓋是把觀測點移到它的對極線上:兩條射線仍然相交,只是深度錯了。第二台相機在第一台上方時,對極線變成幾乎垂直,對調會把觀測點移離它的線,重投影誤差跳到幾十像素,因此能標示出這個錯誤。所以多視角姿態的相機配置不應該把所有相機放在同一條水平線上。
- 忘了對調通道。 你做了翻轉測試,但在平均之前忘了對調鏡像熱圖的左右通道。對一個面向相機、雙臂張開的人,平均後的左手腕熱圖看起來如何?argmax 解碼傳回什麼?
提示
想想網路在鏡像影像裡看到什麼:一個面向相機的人,所以它把影像右側的手腕標成「左手腕」。那個手腕其實是那個人的右手腕,被鏡射了。把圖翻回來卻不對調通道,就會在左手腕通道中,把光斑放在真正的右手腕上。平均後有兩個高度只有一半的光斑,每個手腕上各一個,argmax 挑到稍微高一點的那個,所以大約有一半的時間,左手腕會被回報在右手腕的位置:這是反轉誤差。
參考文獻
- A. Mathis, P. Mamidanna, K. M. Cury, T. Abe, V. N. Murthy, M. W. Mathis and M. Bethge, “DeepLabCut: Markerless pose estimation of user-defined body parts with deep learning,” Nature Neuroscience, vol. 21, no. 9, 2018. doi · arXiv
- C. Zheng, W. Wu, C. Chen, T. Yang, S. Zhu, J. Shen, N. Kehtarnavaz and M. Shah, “Deep learning-based human pose estimation: A survey,” ACM Computing Surveys, vol. 56, no. 1, 2024. doi · arXiv
- Y. Chen, Y. Tian and M. He, “Monocular human pose estimation: A survey of deep learning-based methods,” Computer Vision and Image Understanding, vol. 192, 102897, 2020. doi · arXiv
- COCO Consortium, “Keypoint evaluation,” COCO dataset official documentation (accessed 2026-11-01). cocodataset.org
- Y. Tian, H. Zhang, Y. Liu and L. Wang, “Recovering 3D human mesh from monocular images: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, no. 12, 2023. doi · arXiv
- A. Toshev and C. Szegedy, “DeepPose: Human pose estimation via deep neural networks,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2014. doi · arXiv
- J. Tompson, A. Jain, Y. LeCun and C. Bregler, “Joint training of a convolutional network and a graphical model for human pose estimation,” in Advances in Neural Information Processing Systems (NeurIPS), 2014. NeurIPS · arXiv
- A. Newell, K. Yang and J. Deng, “Stacked hourglass networks for human pose estimation,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2016. doi · arXiv
- B. Xiao, H. Wu and Y. Wei, “Simple baselines for human pose estimation and tracking,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2018. doi · arXiv
- F. Zhang, X. Zhu, H. Dai, M. Ye and C. Zhu, “Distribution-aware coordinate representation for human pose estimation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020. doi · arXiv
- X. Sun, B. Xiao, F. Wei, S. Liang and Y. Wei, “Integral human pose regression,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2018. doi · arXiv
- Y. Li, S. Yang, P. Liu, S. Zhang, Y. Wang, Z. Wang, W. Yang and S.-T. Xia, “SimCC: A simple coordinate classification perspective for human pose estimation,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2022. doi · arXiv
- J. Li, S. Bian, A. Zeng, C. Wang, B. Pang, W. Liu and C. Lu, “Human pose regression with residual log-likelihood estimation,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV), 2021. doi · arXiv
- S.-E. Wei, V. Ramakrishna, T. Kanade and Y. Sheikh, “Convolutional pose machines,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2016. doi · arXiv
- K. Sun, B. Xiao, D. Liu and J. Wang, “Deep high-resolution representation learning for human pose estimation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019. doi · arXiv
- Y. Xu, J. Zhang, Q. Zhang and D. Tao, “ViTPose: Simple vision transformer baselines for human pose estimation,” in Advances in Neural Information Processing Systems (NeurIPS), 2022. NeurIPS · arXiv
- K. He, G. Gkioxari, P. Dollár and R. Girshick, “Mask R-CNN,” in Proc. IEEE International Conference on Computer Vision (ICCV), 2017. doi · arXiv
- Z. Cao, T. Simon, S.-E. Wei and Y. Sheikh, “Realtime multi-person 2D pose estimation using part affinity fields,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2017. doi · arXiv
- A. Newell, Z. Huang and J. Deng, “Associative embedding: End-to-end learning for joint detection and grouping,” in Advances in Neural Information Processing Systems (NeurIPS), 2017. NeurIPS · arXiv
- B. Cheng, B. Xiao, J. Wang, H. Shi, T. S. Huang and L. Zhang, “HigherHRNet: Scale-aware representation learning for bottom-up human pose estimation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2020. doi · arXiv
- Z. Geng, K. Sun, B. Xiao, Z. Zhang and J. Wang, “Bottom-up human pose estimation via disentangled keypoint regression,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2021. doi · arXiv
- X. Zhou, D. Wang and P. Krähenbühl, “Objects as points,” arXiv:1904.07850, 2019. arXiv
- P. Lu, T. Jiang, Y. Li, X. Li, K. Chen and W. Yang, “RTMO: Towards high-performance one-stage real-time multi-person pose estimation,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024. doi · arXiv
- J. Yang, A. Zeng, S. Liu, F. Li, R. Zhang and L. Zhang, “Explicit box detection unifies end-to-end multi-person pose estimation,” in Proc. International Conference on Learning Representations (ICLR), 2023. OpenReview · arXiv
- Y. Yang and D. Ramanan, “Articulated human detection with flexible mixtures of parts,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, no. 12, 2013. doi
- M. Andriluka, L. Pishchulin, P. Gehler and B. Schiele, “2D human pose estimation: New benchmark and state of the art analysis,” in Proc. IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2014. doi · CVF
- COCO Consortium,
cocoeval.py(keypoint OKS computation and the per-keypoint sigmas), official COCO API source code (accessed 2026-11-01). GitHub - J. Martinez, R. Hossain, J. Romero and J. J. Little, “A simple yet effective baseline for 3d human pose estimation,” in Proc. IEEE International Conference on Computer Vision (ICCV), 2017. doi · arXiv
- M. R. Ronchi and P. Perona, “Benchmarking and error diagnosis in multi-instance pose estimation,” in Proc. IEEE International Conference on Computer Vision (ICCV), 2017. doi · arXiv
- T.-Y. Lin, M. Maire, S. Belongie, J. Hays, P. Perona, D. Ramanan, P. Dollár and C. L. Zitnick, “Microsoft COCO: Common objects in context,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2014. doi · arXiv
- J. Li, C. Wang, H. Zhu, Y. Mao, H.-S. Fang and C. Lu, “CrowdPose: Efficient crowded scenes pose estimation and a new benchmark,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019. doi · arXiv
- S. Jin, L. Xu, J. Xu, C. Wang, W. Liu, C. Qian, W. Ouyang and P. Luo, “Whole-body human pose estimation in the wild,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2020. doi · arXiv
- M. Andriluka, U. Iqbal, E. Insafutdinov, L. Pishchulin, A. Milan, J. Gall and B. Schiele, “PoseTrack: A benchmark for human pose estimation and tracking,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2018. doi · arXiv
- C. Ionescu, D. Papava, V. Olaru and C. Sminchisescu, “Human3.6M: Large scale datasets and predictive methods for 3D human sensing in natural environments,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 36, no. 7, 2014. doi · project page
- H. Yu, Y. Xu, J. Zhang, W. Zhao, Z. Guan and D. Tao, “AP-10K: A benchmark for animal pose estimation in the wild,” in Advances in Neural Information Processing Systems (NeurIPS) Datasets and Benchmarks Track, 2021. NeurIPS · arXiv
- Z. Cao, G. Hidalgo, T. Simon, S.-E. Wei and Y. Sheikh, “OpenPose: Realtime multi-person 2D pose estimation using part affinity fields,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 43, no. 1, 2021. doi · arXiv
- D. Pavllo, C. Feichtenhofer, D. Grangier and M. Auli, “3D human pose estimation in video with temporal convolutions and semi-supervised training,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019. doi · arXiv
- K. Iskakov, E. Burkov, V. Lempitsky and Y. Malkov, “Learnable triangulation of human pose,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV), 2019. doi · arXiv
- M. Loper, N. Mahmood, J. Romero, G. Pons-Moll and M. J. Black, “SMPL: A skinned multi-person linear model,” ACM Transactions on Graphics (Proc. SIGGRAPH Asia), vol. 34, no. 6, 2015. doi
- A. Kanazawa, M. J. Black, D. W. Jacobs and J. Malik, “End-to-end recovery of human shape and pose,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2018. doi · arXiv
- S. Goel, G. Pavlakos, J. Rajasegaran, A. Kanazawa and J. Malik, “Humans in 4D: Reconstructing and tracking humans with transformers,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV), 2023. doi · arXiv
- R. Khirodkar, T. Bagautdinov, J. Martinez, S. Zhaoen, A. James, P. Selednik, S. Anderson and S. Saito, “Sapiens: Foundation for human vision models,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2024. doi · arXiv
- T. Jiang, P. Lu, L. Zhang, N. Ma, R. Han, C. Lyu, Y. Li and K. Chen, “RTMPose: Real-time multi-person pose estimation based on MMPose,” arXiv:2303.07399, 2023. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 06・影像中的文字:OCR 與文件理解 · 35 分鐘