DLCV 09A.3・影片超解析度:用時間找回細節
先備知識:DLCV 09・深度影像復原:低階視覺、DLCV 09A・非盲影像超解析度
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 說明鄰近影格如何增加量測與時間限制。
- 建模跨影格的運動、模糊、下採樣、雜訊與壓縮。
- 比較光流扭曲、可變形對齊與注意力。
- 在延遲與記憶體限制下選擇視窗、循環或雙向處理。
- 同時評估空間忠實度、時間穩定性與生成偽影。
先看全貌
影片就是一疊間隔不到一秒拍下的照片。每張照片都很小、有點模糊,但相機或物體在兩次拍攝之間會稍微移動。影片超解析度把附近所有影格看到的東西合在一起,讓這樣的片段變得更清楚、更大。
為什麼重要:人們看的像素大多來自影片。頻寬不足時串流會降到低解析度,老電影與家庭影片原本就是以低解析度錄製,手機、監視攝影機、衛星與顯微鏡拍下的也是小而有雜訊的影像序列。好的 VSR 模型能讓這些影片更清楚,又不會像逐影格處理的影像模型那樣出現畫面閃爍。VSR 也是許多現在影片模型常見想法的發源地:以光流對齊特徵、可變形對齊、長距離循環傳播與影片 Transformer。
本篇建立在 DLCV 09 之上;那一篇談退化模型、用合成配對訓練、損失函數與通用的影像指標,我們直接連結過去,不再重複。單張影像超解析度(輸入一個影格、輸出一個影格的設定)在 DLCV 09A 討論。這裡我們專注在時間多帶來了什麼。
為什麼影片不只是很多張影像
白話版。 逐影格獨立放大會忽略鄰近量測,也未要求細節在時間上穩定。
子像素位移帶來新資訊
假設相機用一組粗糙的像素格取樣場景。在某一個影格中,落在取樣點之間的細節會遺失(更糟的是,會被折疊成錯誤的低頻圖樣,稱為混疊,aliasing)。如果下一個影格中場景位移了四分之一個像素,同一組像素格就會在不同的位置取樣場景。位移 個像素的四個影格,合起來對場景的取樣密度是其中任何一個的四倍(圖 1 是一維情形;在二維中,倍率 需要 種不同的位移)。這就是多影格超解析度能勝過單張影像超解析度的基本原因:多出來的影格是新的量測,而不是複本 [1]。
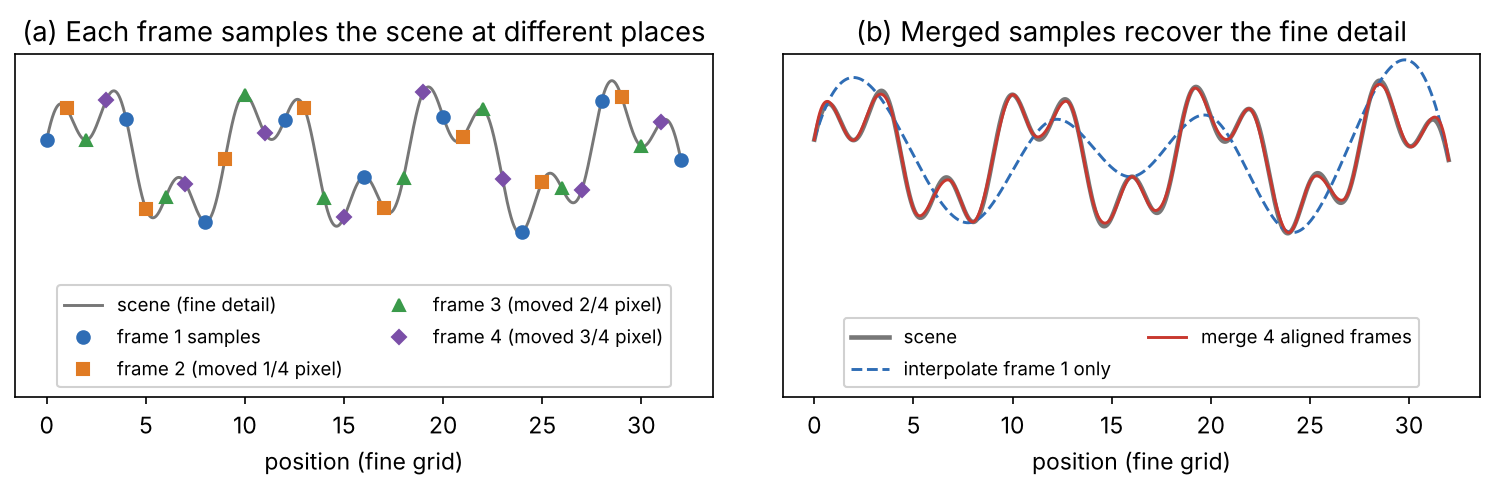
必須同時滿足兩個條件。第一,運動必須是子像素的:位移整數個低解析度像素,會取到相同的位置,只多了雜訊平均的效果。第二,我們必須知道運動,而且準確到足以把每個取樣放到正確的位置。真實的運動不是整體平移:物體各自移動、旋轉、變形、出現與消失。估計並補償這些運動是 VSR 的核心問題,本篇大部分內容都圍繞著它。
時間上的冗餘
相鄰影格也高度冗餘:場景的大部分會被再看一次。獨立的雜訊在重複觀察中會被平均掉,模型也可以重複利用處理先前影格時做過的工作。影片編碼器利用的是同樣的冗餘:用運動向量由前一個影格預測每個影格(見 IP 08 的運動補償預測)。
時間一致性與閃爍
單張影像模型逐影格套用時,每個影格都會獨立做出許多小決定。凡是它捏造紋理的地方(草地、頭髮、水面、類似雜訊的細節),捏造出的紋理在每個影格都不同,影片就會閃爍(flicker),或像水沸騰般波動。即使每個影格單獨看都沒問題,這種時間瑕疵還是看得出來。VESPCN [2] 與 FRVSR [3] 都把時間一致性列為共同處理影格、而不是各自獨立處理的主要動機。所以 VSR 模型有兩個目標:每個影格要忠實而清晰,而且相鄰影格只應隨場景改變而改變。
影片退化模型
白話版。 每個低解析度影格,都是那一刻的高解析度影格經過模糊、縮小、加雜訊,通常還經過壓縮的結果。影格之間的差異來自場景在移動。
每個影格一個方程式
把 DLCV 09 的超解析度模型延伸到由 個高解析度(HR)影格組成的片段 ,得到
其中 是時間 的低解析度(LR)影格, 是模糊核(相機光學、感測器積分、抗混疊濾波器), 是二維卷積, 在每個方向上每隔 個像素保留一個( 是放大倍率,基準測試通常是 4), 是每個影格都全新產生的雜訊, 是有失真的影片壓縮(在乾淨的基準測試中是恆等映射)。運動進入模型的方式是:每個 都是其鄰近影格移動後的版本。在影格 附近可以寫成
其中 是從影格 到影格 的運動(扭曲), 是小的影格偏移量,而 藏起了運動解釋不了的部分:被遮擋的區域、進入畫面的物體、光照變化。把兩個式子合起來,
所以每個鄰近的 LR 影格,都是同一個未知量 的一次不同的量測。VSR 從 (寬度 個影格的視窗)或整段片段來估計 。
多影格重建是一個反問題
如果運動、模糊與倍率都已知,而且沒有壓縮,就能用最小平方法求出 :
其中 是用 做的模糊, 是降取樣 ,總和遍及視窗中的各個影格。只有一個影格時,這個問題嚴重欠定( 時,每個 LR 像素對應 個未知的 HR 像素)。有許多位於不同子像素位置的影格時,它就變得好解得多。對這個目標函數做梯度下降,會反覆由目前的估計模擬出 LR 影格,與觀測到的影格比較,再把誤差分攤回 HR 格點;這就是 Irani 與 Peleg 提出的經典迭代反向投影(iterative back-projection)想法 [4], [1],它也啟發了後面會談到的 RBPN 架構 [5]。
選讀:傳統多影格超解析度(見「補充資料」頁)。在細緻格點上融合已配準的取樣、穩健(中位數)融合,以及多影格問題何時是良置的。
玩具實驗:對齊帶來什麼
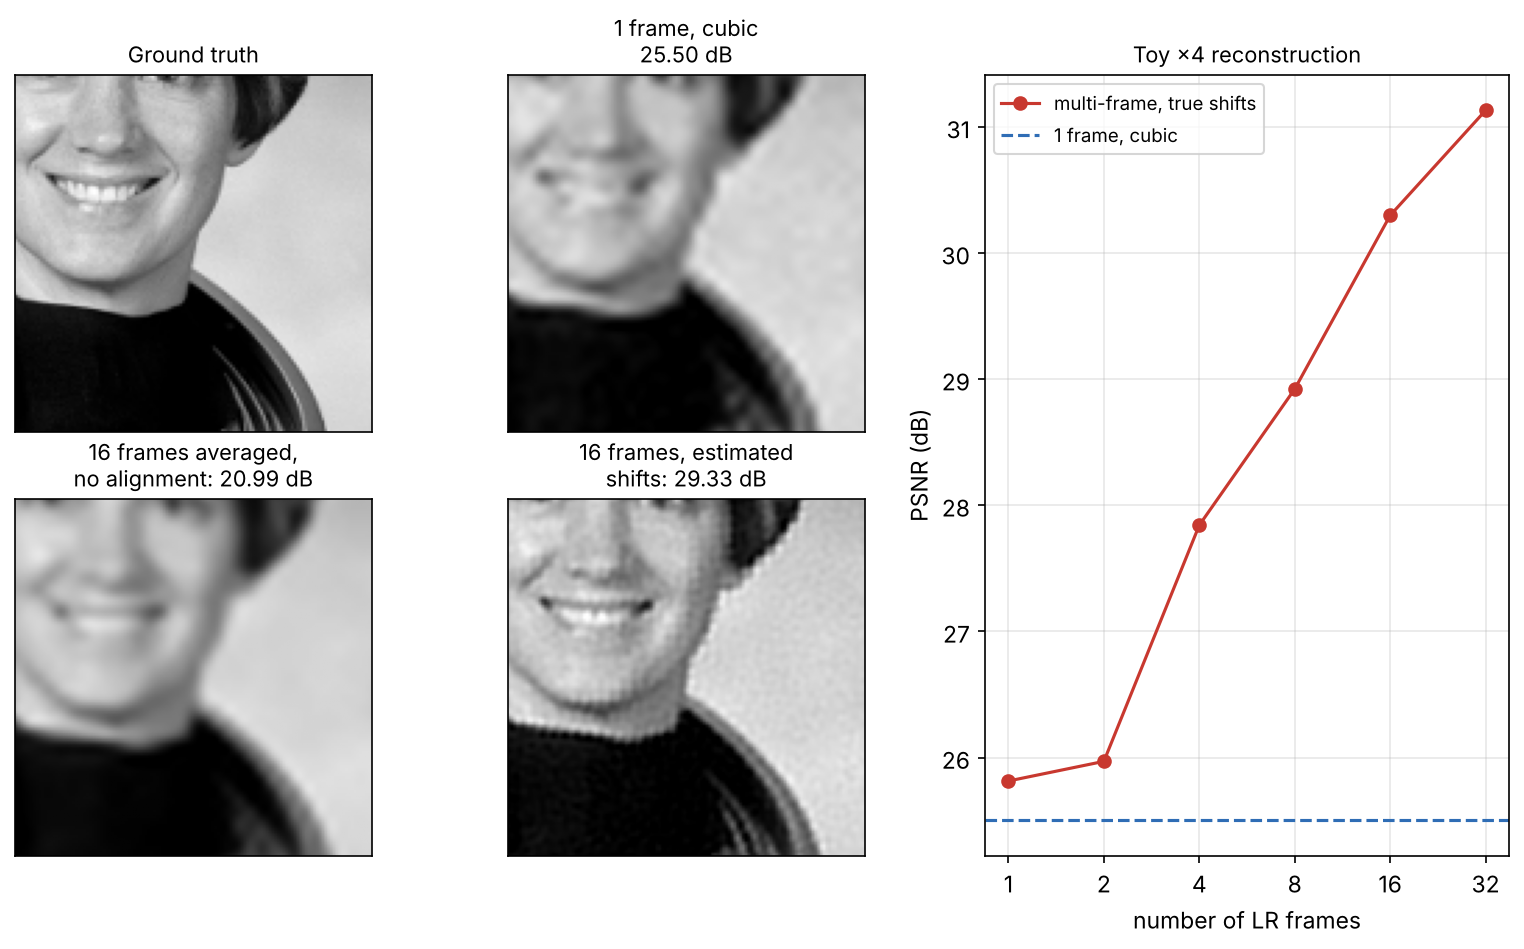
這段程式碼用一張 skimage 照片,加上隨機的子像素相機位移、高斯模糊、 子取樣與雜訊,造出一段 16 個影格的 LR 影片。接著比較第一個影格的四種重建:只用該影格的三次內插;不對齊就把所有上取樣影格平均;只用第一個影格的上述最小平方求解器;以及用全部 16 個影格、分別搭配真實位移與由 LR 影格估計出的位移(以子像素相位相關法 [6])的同一個求解器。它在筆電 CPU 上大約十秒跑完。
程式碼 · Python · 49 行
import numpy as np
from scipy import ndimage as ndi
from skimage import data, color
from skimage.registration import phase_cross_correlation

rng = np.random.default_rng(0)
s, T, blur, noise = 4, 16, 1.2, 0.01                       # scale, frames, blur sigma (HR px), noise std
hr = color.rgb2gray(data.astronaut())[64:320, 128:384]     # 256 x 256 ground-truth frame, values in [0, 1]
shifts = rng.uniform(0, s, size=(T, 2)); shifts[0] = 0     # sub-pixel camera motion of each frame (HR px)

def degrade(x, d):                                         # y_t = D B W_t x : shift, blur, keep every s-th pixel
    return ndi.gaussian_filter(ndi.shift(x, d, order=3, mode="reflect"), blur)[::s, ::s]
def degrade_T(r, d):                                       # adjoint: zero-fill, blur, shift back
    z = np.zeros((r.shape[0] * s, r.shape[1] * s)); z[::s, ::s] = r
    return ndi.shift(ndi.gaussian_filter(z, blur), -d, order=3, mode="reflect")
def upsample(y):                                           # cubic-spline interpolation on the HR grid
    u, v = np.mgrid[0:y.shape[0] * s, 0:y.shape[1] * s] / s
    return ndi.map_coordinates(y, [u, v], order=3, mode="nearest")
def psnr(x):
    c = (slice(8, -8), slice(8, -8))                       # skip a border, as benchmarks do
    return 10 * np.log10(1 / np.mean((np.clip(x, 0, 1)[c] - hr[c]) ** 2))

lr = np.stack([degrade(hr, d) + noise * rng.standard_normal((64, 64)) for d in shifts])
print("LR video:", lr.shape)

def reconstruct(frames, ds, iters=20):
    """Multi-frame least squares by gradient descent (iterative back-projection)."""
    x = np.mean([ndi.shift(upsample(f), -d, order=3, mode="reflect") for f, d in zip(frames, ds)], 0)
    for _ in range(iters):
        grad = np.mean([degrade_T(degrade(x, d) - f, d) for f, d in zip(frames, ds)], 0)
        x -= s * s * grad
    return x

# shifts estimated from the LR frames themselves (sub-pixel phase correlation), in HR pixels
est = np.array([-s * phase_cross_correlation(lr[0], f, upsample_factor=100)[0] for f in lr])
print(f"mean shift error: {np.abs(est - shifts).mean():.2f} HR px")

print(f"single frame, cubic interpolation {psnr(upsample(lr[0])):.2f} dB")
print(f"average of frames, no alignment   {psnr(np.mean([upsample(f) for f in lr], 0)):.2f} dB")
print(f"single frame, same solver         {psnr(reconstruct(lr[:1], shifts[:1])):.2f} dB")
print(f"{T} frames, true shifts            {psnr(reconstruct(lr, shifts)):.2f} dB")
print(f"{T} frames, estimated shifts       {psnr(reconstruct(lr, est)):.2f} dB")
# LR video: (16, 64, 64)
# mean shift error: 0.13 HR px
# single frame, cubic interpolation 25.50 dB
# average of frames, no alignment   20.99 dB
# single frame, same solver         25.81 dB
# 16 frames, true shifts            30.30 dB
# 16 frames, estimated shifts 29.33 dB這次玩具實驗有三個教訓(所有數字都來自我們自己的執行,不是來自任何論文)。第一,不對齊就平均,比只用一個影格更糟(20.99 對 25.50 dB):錯位的影格會把影像抹糊,正是比喻中「忘了移動多遠」的失敗。第二,進步來自影格,而不是求解器:同一個最小平方求解器只用一個影格,勉強勝過內插(25.81 dB),用 16 個影格則有 30.30 dB。第三,運動可以直接由 LR 影格本身估計,平均誤差約為八分之一個 HR 像素,仍保住大部分進步(29.33 dB)。圖 2 顯示裁切結果,以及 PSNR 如何隨影格數增加。
拖動滑桿,在放大的裁切圖上比較單影格內插與 16 影格重建。
 1 個影格,三次內插16 個影格,估計位移
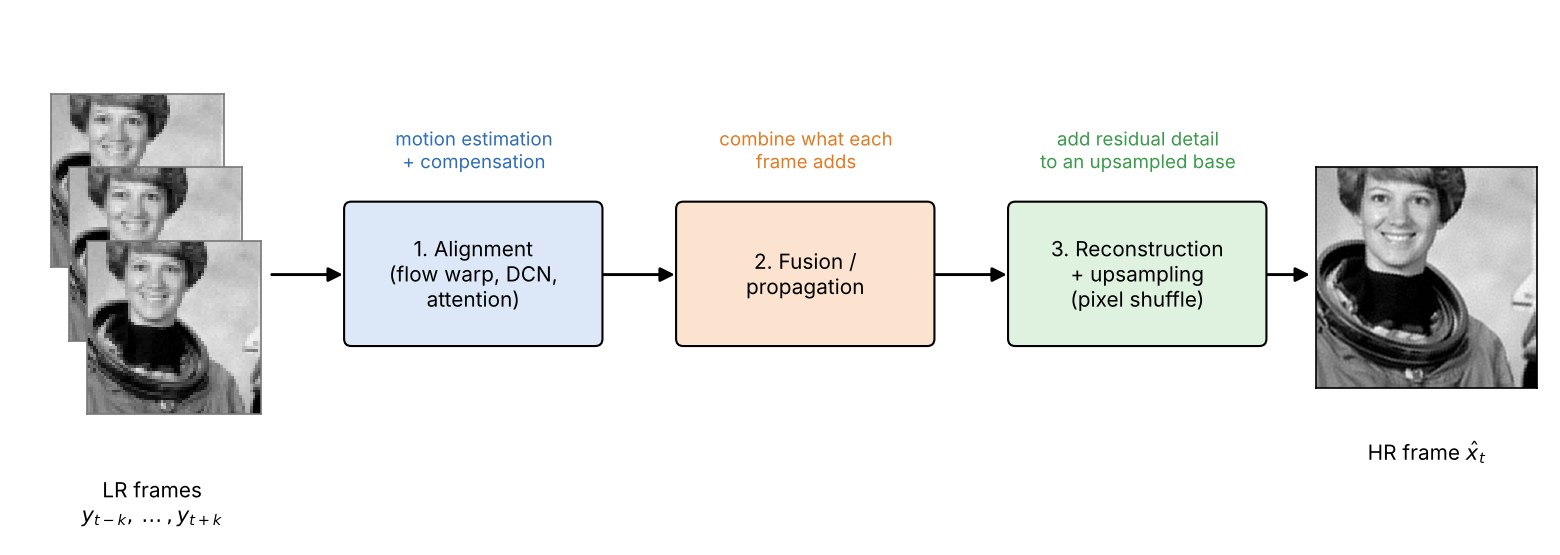
真實的影片會打破玩具實驗的假設(整體平移、已知的模糊、沒有遮擋或壓縮)。深度 VSR 保留了這個結構(估計運動、對齊、融合、重建),並從資料中學習每一個部分。圖 3 顯示幾乎所有方法都以某種形式遵循的流程;BasicVSR [7] 把它的四個元件稱為傳播、對齊、聚合與上取樣。
運動:光流與扭曲
白話版。 光流估計影格間的像素對應,扭曲則依對應重新取樣,使內容對齊。
光流
經典的出發點是亮度恆定(brightness constancy):一個點在移動時保持它的亮度,
其中 是第 欄、第 列、時間 的強度, 是該點在影格 與 之間的位移。所有像素位移所構成的場,就是光流(optical flow),對每個像素 各有一組。每個像素只有一個方程式,無法決定兩個未知數(這是「孔徑問題」:沿著一條直邊,只看得到垂直於邊的運動),所以每種方法都要加入「相鄰像素的運動相近」這個假設。Horn 與 Schunck [8] 加上整體平滑度的懲罰;OpenCV 內建的 Farnebäck 方法 [9] 則對每個鄰域擬合二次多項式,再由多項式如何移動來估計位移。
深度光流估計器從資料中學習這個映射。SPyNet [10] 以由粗到細的方式估計大的運動:在影像金字塔的每一層,先用目前的光流扭曲其中一張影像,再由一個小網路預測剩下的小幅更新;它很精簡,是 BasicVSR [7] 的光流模組。RAFT [11] 建立所有像素配對之間的相關體(correlation volume),並用循環單元反覆改進光流場。例如 BasicVSR 從預訓練的 SPyNet 出發,與模型其餘部分一起微調 [7]。
選讀:亮度恆定與傳統光流求解器(見「補充資料」頁)。線性化的光流方程式、孔徑問題,以及整體(Horn–Schunck)、局部視窗與多項式展開(Farnebäck)求解器各自加了什麼。
以雙線性取樣做反向扭曲
要把影格 對齊到影格 ,我們使用從 到 的光流,並把值拉過來:對參考影格的每個像素 ,找出該點在另一個影格中的位置,並讀取那裡的值,
其中 是被扭曲到影格 座標系的影格 , 是像素 的位移。這就是反向扭曲:每個輸出像素都恰好得到一個值,沒有空洞。(前向扭曲是把每個來源像素推到它的新位置,會留下空洞與碰撞。)位置 通常不在像素格點上,所以要用周圍四個像素做雙線性內插:
其中 , 為整數, 為小數部分, 是位置 的值。雙線性取樣對影像值與光流都可微分,所以網路可以透過扭曲端到端地學習光流;這個「雙線性取樣器」是空間轉換網路(spatial transformer networks)[12] 的核心,也是每個以光流為基礎的 VSR 模型的核心。
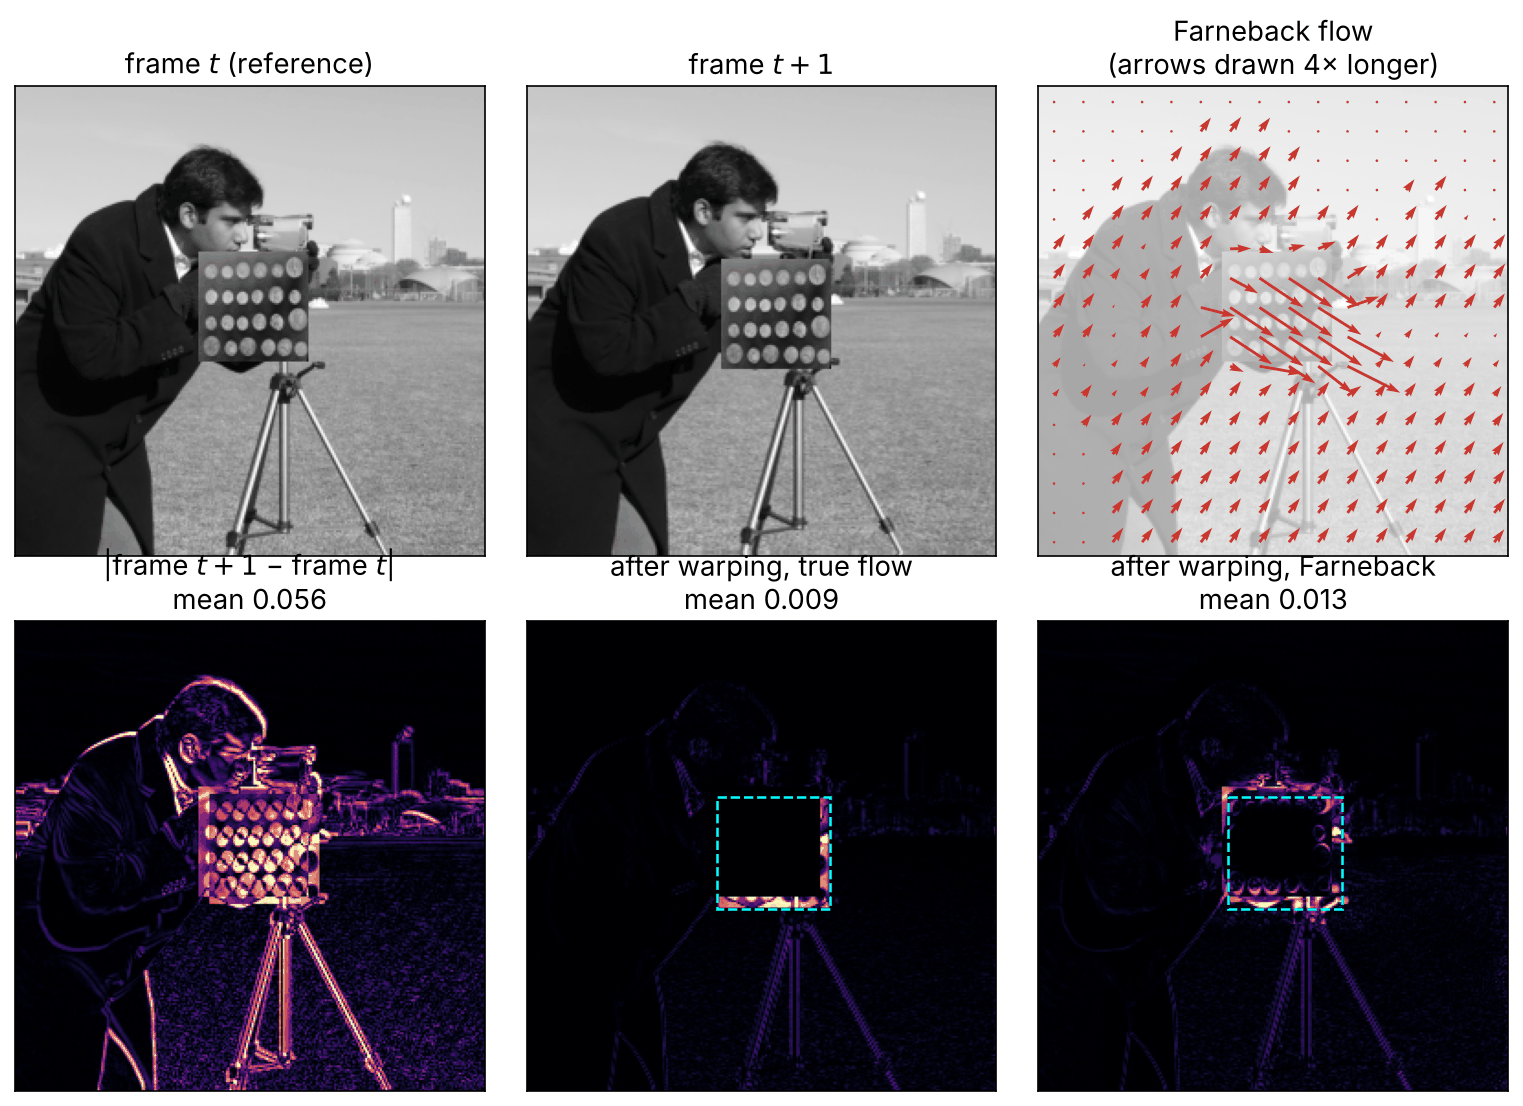
下面的程式碼手寫了反向扭曲,並與 cv2.remap 比對;它造出兩個影格,其中背景移動 個像素,一個有紋理的方塊移動 個像素;然後分別用真實光流與 OpenCV 的 Farnebäck 光流,把第二個影格扭曲到第一個影格上。
程式碼 · Python · 49 行
import numpy as np, cv2
from scipy import ndimage as ndi
from skimage import data, transform

def bilinear_warp(img, flow):
    """Backward warping: out(p) = img(p + flow(p)), bilinear sampling. flow[..., 0] = dx, flow[..., 1] = dy."""
    H, W = img.shape
    yy, xx = np.mgrid[0:H, 0:W].astype(np.float64)
    x = np.clip(xx + flow[..., 0], 0, W - 1); y = np.clip(yy + flow[..., 1], 0, H - 1)
    x0 = np.minimum(np.floor(x).astype(int), W - 2); y0 = np.minimum(np.floor(y).astype(int), H - 2)
    ax, ay = x - x0, y - y0                                   # fractional parts = bilinear weights
    return ((1 - ay) * ((1 - ax) * img[y0, x0] + ax * img[y0, x0 + 1])
            + ay * ((1 - ax) * img[y0 + 1, x0] + ax * img[y0 + 1, x0 + 1]))

# two frames: the background moves by (dx, dy) = (1.5, -2.0) px, a textured square moves by (6, 4) px
bg = transform.resize(data.camera() / 255.0, (256, 256), anti_aliasing=True)
obj = transform.resize(data.coins() / 255.0, (60, 60), anti_aliasing=True)
def frame(t):
    f = ndi.shift(bg, (-2.0 * t, 1.5 * t), order=3, mode="reflect")   # ndi.shift takes (rows, cols)
    r, c = 90 + 4 * t, 100 + 6 * t
    f[r:r + 60, c:c + 60] = obj
    return f
I0, I1 = frame(0).astype(np.float32), frame(1).astype(np.float32)

# true backward flow from frame 0 to frame 1: where is pixel p of frame 0 found in frame 1?
flow = np.zeros((256, 256, 2), np.float32); flow[..., 0], flow[..., 1] = 1.5, -2.0
flow[90:150, 100:160] = (6.0, 4.0)
mine = bilinear_warp(I1, flow)
H, W = I0.shape; yy, xx = np.mgrid[0:H, 0:W].astype(np.float32)
ocv = cv2.remap(I1, xx + flow[..., 0], yy + flow[..., 1], cv2.INTER_LINEAR, borderMode=cv2.BORDER_REPLICATE)
print(f"max |ours - cv2.remap| = {np.abs(mine - ocv)[5:-5, 5:-5].max():.4f}")

u8 = lambda a: (np.clip(a, 0, 1) * 255).round().astype(np.uint8)        # Farneback expects 8-bit images
est = cv2.calcOpticalFlowFarneback(u8(I0), u8(I1), None, pyr_scale=0.5, levels=4, winsize=21,
                                   iterations=5, poly_n=7, poly_sigma=1.5, flags=0)
m0 = np.zeros((H, W), np.float32); m0[90:150, 100:160] = 1          # square in frame 0
m1 = np.zeros((H, W), np.float32); m1[94:154, 106:166] = 1          # square in frame 1
occl = (bilinear_warp(m1, flow) > 0) & (m0 == 0)                  # background of frame 0 hidden in frame 1
inner = (slice(8, -8), slice(8, -8))
for name, img in [("no alignment", I1), ("warped, true flow", mine), ("warped, Farneback", bilinear_warp(I1, est))]:
    e = np.abs(img - I0)
    print(f"{name:18s} mean |error| {e[inner].mean():.4f}   on occluded pixels {e[occl].mean():.4f}")
print("Farneback median flow (dx, dy): square", np.median(est[100:140, 110:150], axis=(0, 1)).round(2),
      " background", np.median(est[200:240, 20:60], axis=(0, 1)).round(2))
# max |ours - cv2.remap| = 0.0000
# no alignment       mean |error| 0.0562   on occluded pixels 0.2367
# warped, true flow  mean |error| 0.0089   on occluded pixels 0.2617
# warped, Farneback  mean |error| 0.0133   on occluded pixels 0.1733
# Farneback median flow (dx, dy): square [6. 4.]  background [ 1.42 -1.88]
用真實光流扭曲,把兩個影格之間的平均差異降低到約六分之一,而 Farnebäck 的估計已經達到大部分效果(我們的執行結果)。但請看被遮擋的像素:就是在影格 中被方塊蓋住的那一條背景。在那裡,即使是真實的光流也有很大的誤差,因為那些內容根本不在影格 裡,它們被藏在方塊後面。任何光流都救不了這一點。VSR 模型必須學會在扭曲後的影格一致時相信它,不一致時就忽略它(圖 4)。
對齊策略
白話版。 對齊可使用顯式光流、學得的可變形取樣位置,或對對應內容的注意力。
顯式對齊:以光流扭曲
最直接的做法是估計每個鄰近影格到參考影格的光流,再用它扭曲鄰近影格。
- VESPCN [2](CVPR 2017)端到端訓練一個快速的多解析度空間轉換運動補償模組,搭配子像素卷積(pixel shuffle)網路 ESPCN [13] 的時空版本。
- TOFlow [14](IJCV 2019)把光流網路與復原網路一起訓練,所以光流是以任務為導向的:它會移動任何能讓輸出最好的東西,即使這與實際的物理運動不同。這篇論文也提出了 Vimeo-90K。
- 影像扭曲與特徵扭曲。 早期的方法扭曲 LR 影像。不準確的光流會產生模糊或錯誤的扭曲影像,而損失的細節之後就無法挽回。後來的方法在影像上計算光流,卻扭曲特徵圖,讓後續各層能修正小幅的錯位;BasicVSR 的消融實驗發現,特徵扭曲優於影像扭曲 [7]。
以光流為基礎的對齊可解釋,在中等運動下效果很好。它的弱點是光流網路的成本、遮擋與運動邊界處的誤差,以及每個像素只有一個光流向量,只能指向一個位置。
隱式對齊:可變形卷積
一般的 卷積,是在每個像素周圍固定的格點上讀取輸入。可變形卷積(deformable convolution)[15] 則為每個取樣位置加上一個學得的偏移:
其中 是像素 的輸出, 是卷積核的取樣點數( 時為 9), 是第 個取樣點的權重, 是它固定的格點位置(例如 ), 是由一個小網路為每個像素與每個取樣點預測的實數偏移, 以雙線性取樣讀取。DCNv2 [16] 另外把每個取樣點乘上一個落在 的學得調變權重,讓這一層能壓低不可靠位置的權重。
用於對齊時,偏移由參考影格與鄰近影格的特徵預測,可變形卷積則套用在鄰近影格的特徵上。TDAN [17] 以這種方式在特徵層級把每個支援影格對齊到參考影格,不需要計算光流。EDVR [18] 在金字塔、串接與可變形(Pyramid, Cascading and Deformable, PCD)模組中套用可變形對齊,在特徵金字塔上由粗到細處理大的運動,再用時間與空間注意力(temporal and spatial attention, TSA)融合對齊後的特徵;它拿下了 NTIRE 2019 影片復原挑戰賽的全部四個賽道。
Chan 等人 [19] 證明,可變形卷積可以拆解成數個空間扭曲(每個取樣點一個,各有自己的偏移場),再接一個卷積。所以可變形對齊是光流扭曲的推廣:用數個光流場取代一個;這種偏移多樣性(offset diversity)正是它對齊得更好的原因。同一項研究與 BasicVSR++ [20] 都回報,可變形對齊訓練起來不穩定:偏移可能變得非常大(「偏移溢位」,offset overflow)。因此 BasicVSR++ 把可變形偏移預測成疊加在光流上的殘差(光流引導的可變形對齊),結合光流的穩定性與可變形取樣的多樣性。
選讀:可變形卷積即「扭曲加卷積」(見「補充資料」頁)。用兩行寫出這個拆解、一個測試過的範例,以及為什麼多個偏移場在遮擋處有幫助。
不需顯式運動步驟的對齊
有些模型完全跳過運動估計,讓網路自行吸收運動。DUF [21] 為每個輸出像素,從輸入影格的時空鄰域預測一個動態上取樣濾波器與一個殘差,所以運動是由依內容而變的濾波器隱式處理的。PFNL [22] 逐步融合影格,並用非區域(non-local)運算(它把每個位置與其他每個位置比較)取代運動估計與補償。在(時間、高度、寬度)上做 3-D 卷積是第三種選擇。這些方法避開了光流的誤差,但有效搜尋範圍受限於感受域,所以大的運動較難處理。
注意力與 Transformer
注意力讓每個位置能與其他影格中許多候選位置比較,並對最佳匹配取加權平均,這是運動搜尋的軟式、學習版本。VRT [23] 把影片切成短的片段,並使用時間互相自注意力(temporal mutual self-attention, TMSA):兩個影格之間的互相注意力執行聯合的運動估計、對齊與融合,自注意力則負責擷取特徵;片段的切分在相鄰層之間會位移,讓資訊能跨越片段邊界,另有一個平行扭曲(parallel warping)模組,額外加入鄰近特徵的光流扭曲。VRT 應用於影片 SR、去模糊、去雜訊、影格內插與時空 SR。RVRT [24] 使用引導式可變形注意力(guided deformable attention):從光流出發,在前一個片段中預測數個相關位置,並以注意力權重聚合它們的特徵。
依時間設計分類的架構
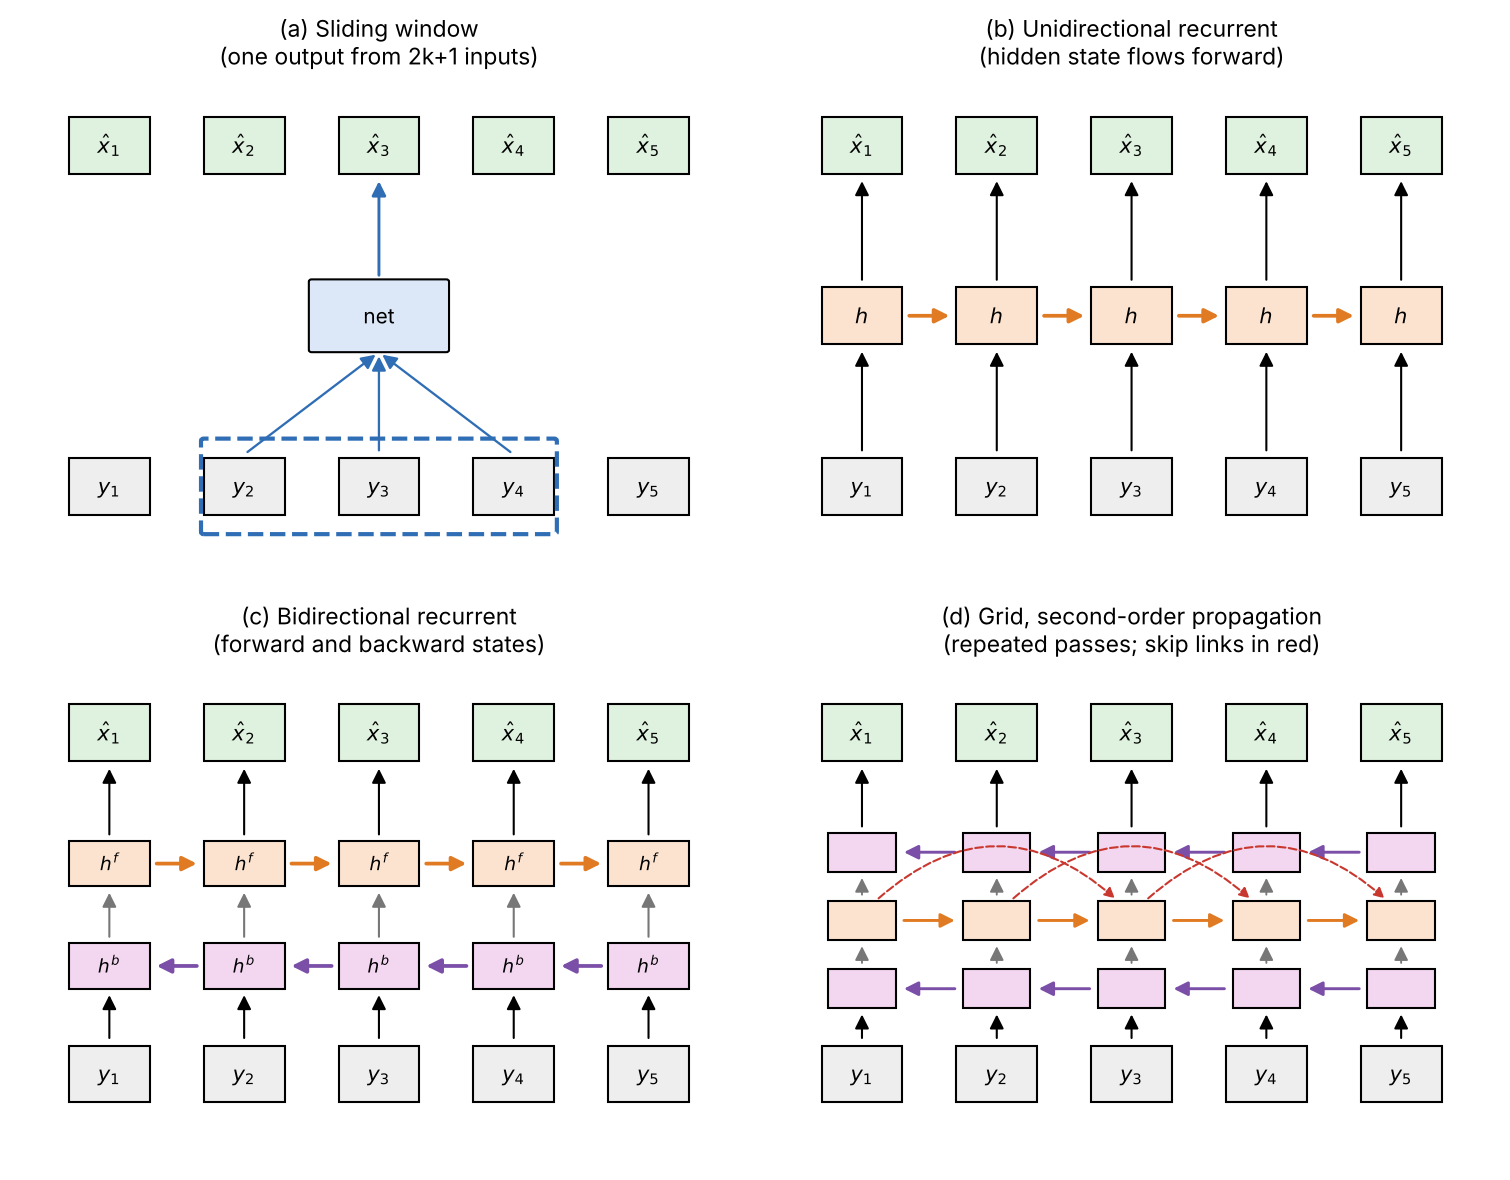
白話版。 一旦影格能夠對齊,問題就變成:每個輸出能看到哪些影格,以及資訊如何沿著影片傳遞。主要有四種答案,如圖 5 所示。
滑動視窗
滑動視窗(sliding-window)模型取 個連續的 LR 影格,產生一個 HR 影格(中間那一個),然後把視窗移動一個影格。VESPCN、DUF、TDAN 與 EDVR 都是滑動視窗模型。它簡單又可平行,誤差也不會隨時間累積。FRVSR [3] 指出兩個弱點:每個輸入影格要被處理與扭曲 次,而且每個輸出都是獨立估計的,限制了時間一致性。固定的視窗也無法利用更遠處的資訊;BasicVSR 的作者測量到,把測試序列切成較短的獨立片段會降低 PSNR,而且在片段末端降得最多 [7]。
循環
循環(recurrent)模型保有一個概括過去的隱藏狀態 ,並逐影格更新它:
其中 是一個網路,把目前的 LR 影格 與被光流 扭曲到影格 的前一個狀態結合起來(扭曲 就是上一節的反向扭曲),而 是重建與上取樣的輸出頭。因為狀態在重複使用之前已經對齊,資訊可以用每個影格固定的成本傳遞許多個影格。(關於一般的循環網路,請見 ML 04。)FRVSR [3] 把前一個 HR 輸出經光流扭曲並重新排列成 LR 大小後,餵給下一個影格的網路,這有助於產生時間一致的結果,而且每一步只需要一次扭曲。RBPN [5] 是混合式:在視窗內,它用受反向投影啟發的循環編碼器–解碼器,一次整合一個鄰近影格,並把估計出的運動當作輸入餵進去,而不是扭曲影格。
單向循環模型只看得到過去。早期的影格得到的資訊很少,而狀態中的誤差(來自不好的光流、遮擋或場景切換)會被帶進後面的影格:這就是誤差累積(error accumulation)。
雙向循環
BasicVSR [7] 執行兩條循環分支,一條沿時間向前,一條沿時間向後:
其中 與 是影格 的後向與前向特徵, 與 是兩條分支(各自用 SPyNet 在它的兩個輸入影格之間估計光流,用它扭曲傳播而來的特徵,再以殘差區塊改進), 則把兩種特徵串接起來,並用 pixel shuffle 上取樣。現在每個輸出都看得到整段片段,包括過去與未來。論文的消融實驗發現,單向版本在早期影格的 PSNR 明顯下降,而不做對齊則下降更多,這支持了它的配方:雙向傳播加上以光流為基礎的特徵對齊,就足以成為強大的基線。它的延伸版本 IconVSR 加入一個資訊補充(information-refill)模組,從稀疏的關鍵影格重新擷取特徵,以限制遮擋與邊界處的誤差累積;以及耦合傳播(coupled propagation),把後向分支的輸出餵給前向分支。
代價是延遲:後向分支需要未來的影格,所以在第一個輸出之前,必須先取得整段片段(或一大段)。這適合離線處理,以及有緩衝區的串流,但不適合即時影片。
選讀:BasicVSR 與 IconVSR(見「論文導讀」頁)。四元件分析呈現了什麼、要看哪些消融實驗,以及這個設定的限制。
網格與二階傳播
BasicVSR++ [20] 從兩方面讓傳播更豐富。網格傳播(grid propagation)以交替方式把特徵向後、向前傳遞數次,讓每個影格的特徵一再地用整段序列的資訊改進。二階連接(second-order connections)讓影格 的狀態同時使用影格 與 (二階馬可夫鏈,而不是一階),使資訊能繞過一個壞掉的影格,這對遮擋與細緻結構有幫助。搭配前面描述的光流引導可變形對齊,BasicVSR++ 在相近的參數量下,回報比 BasicVSR 高 0.82 dB 的 PSNR,並在 NTIRE 2021 影片超解析度與壓縮影片增強挑戰賽中拿下三個賽道的第一名、一個賽道的第二名 [20]。
Transformer 與循環–Transformer 混合
VRT [23] 以多個尺度的長距離時間注意力,平行處理所有影格,威力強大但很吃資源。RVRT [24] 直接描述了這個取捨:平行模型能把時間資訊融合得很好,但模型大、記憶體用量高;循環模型在各影格之間共用參數,所以精簡,但長距離建模較弱,也較難平行化。RVRT 在整體循環的框架內,把相鄰影格當成一個片段平行處理,用推論出的前一個片段來估計下一個,並以引導式可變形注意力做片段到片段的對齊。
下表整理了本篇的代表方法。
| 方法 | 發表處 | 時間設計 | 對齊 |
|---|---|---|---|
| VESPCN [2] | CVPR 2017 | 滑動視窗 | 光流(空間轉換),影像層級 |
| FRVSR [3] | CVPR 2018 | 循環(前一個 HR 輸出) | 光流,影像層級 |
| DUF [21] | CVPR 2018 | 滑動視窗 | 無(動態濾波器) |
| TOFlow [14] | IJCV 2019 | 滑動視窗 | 以任務為導向的光流 |
| EDVR [18] | CVPRW 2019 | 滑動視窗 | 可變形(PCD)+注意力融合 |
| RBPN [5] | CVPR 2019 | 視窗內循環 | 運動當作輸入,反向投影 |
| PFNL [22] | ICCV 2019 | 滑動視窗(漸進融合) | 無(非區域) |
| TDAN [17] | CVPR 2020 | 滑動視窗 | 可變形,特徵層級 |
| BasicVSR / IconVSR [7] | CVPR 2021 | 雙向循環 | 光流,特徵層級 |
| BasicVSR++ [20] | CVPR 2022 | 網格,二階 | 光流引導的可變形 |
| RVRT [24] | NeurIPS 2022 | 片段循環 Transformer | 引導式可變形注意力 |
| VRT [23] | TIP 2024 | 平行 Transformer | 互相注意力+平行扭曲 |
真實世界影片與壓縮
白話版。 基準測試的 LR 影片是用一套乾淨、已知的配方做出來的。真實的影片有雜訊、以未知的方式模糊,最重要的是還被壓縮過。用乾淨配方訓練的模型,常常把壓縮瑕疵銳化了,而不是場景。
壓縮是真實世界最主要的退化
大部分影片都以 H.264/AVC [25] 這類以區塊為基礎的編碼器儲存與串流;它們用運動向量由先前的影格預測每個區塊,並把殘差量化。由此產生的瑕疵(區塊效應、振鈴、模糊的紋理、邊緣周圍的蚊式雜訊)在影格之間各不相同:不參考其他影格而編碼的影格(內部影格,intra frame)看起來與預測影格不同,品質也隨位元率改變。這些瑕疵不是獨立的雜訊,而且會隨內容移動,所以 VSR 模型可能把它們誤認為真實細節並傳播下去。COMISR [26] 為壓縮輸入設計 VSR,用雙向循環扭曲、保留細節的光流估計,以及拉普拉斯增強模組,把內部影格的位置等壓縮特性納入考量,並在一系列壓縮率下評估。
真實世界 VSR:RealBasicVSR
RealBasicVSR [27](CVPR 2022)發現,對輕微退化有幫助的長期傳播,會放大嚴重的瑕疵:雜訊與壓縮瑕疵會與有用的資訊一起被傳播與放大。它的解法是在 BasicVSR 網路之前,對每個影格先套用一個影像預清理(pre-cleaning)模組。它也提出了 VideoLQ,這是一組沒有真實標準答案的真實低品質影片,以無參考指標與視覺比較來評估。
選讀:RealBasicVSR(見「論文導讀」頁)。它找出的三個取捨,以及如何閱讀它的實驗。
這些退化流程是 DLCV 09 中盲退化流程的影片版:隨機模糊、縮放、雜訊與壓縮,另外還要選擇對片段的所有影格套用相同或不同的參數。
以擴散模型為基礎的 VSR
預訓練的文字生成影像擴散模型,能為真實世界影像 SR 產生非常逼真的紋理(見 DLCV 09)。在影片中,它們的隨機性是個問題:逐影格獨立取樣,會讓每個影格的紋理都不同,這是最嚴重的閃爍。因此近期的方法在預訓練的生成模型上加入時間機制:時間層加上光流引導、跨序列的潛在變數傳播(Upscale-A-Video [28],CVPR 2024)、引導取樣路徑的運動引導損失(MGLD-VSR [29],ECCV 2024)、本來就會建模運動的文字生成影片模型(STAR [30],ICCV 2025)、可處理任意長度與解析度影片的擴散 Transformer(SeedVR [31],CVPR 2025),以及降低成本的一步蒸餾(DLoRAL [32],NeurIPS 2025)。
選讀:以擴散模型為基礎的 VSR 模型(見「補充資料」頁)。這五個模型各在預訓練的擴散模型上加了什麼,來維持影片的一致性。
這些模型在真實影片上給出最令人信服的紋理,但它們承襲了影像層級的捏造細節(hallucinated detail,合理但從未存在於場景中的內容)風險,並多了影片層級的風險:每個影格看起來都合理,但影格之間不一致的細節。它們也比 CNN 或 Transformer 的 VSR 貴得多。
訓練 VSR 模型
白話版。 訓練與影像復原相同,只是每個訓練樣本是一小段影片,而不是單一影像。
配對的做法是用上述模型把 HR 影片片段退化:基準測試用雙三次(BI)或模糊後降取樣(BD)配方(見「評估」),或用隨機化的真實世界流程。每一步取樣一小段片段,並在所有影格的同一位置隨機裁切;翻轉與旋轉對所有影格做相同處理,影格順序也可以反轉當作時間上的資料擴增(BasicVSR 就這樣反轉 Vimeo-90K 的 7 影格序列 [7])。循環模型用較長的片段訓練(BasicVSR 在 REDS 上的設定使用 15 個影格的輸入),好讓傳播確實被練到;RealBasicVSR 發現較長的序列勝過較大的批次,指向同一個方向 [27]。在 BasicVSR 中,預訓練的光流網路與特徵擷取器在前 5,000 次迭代中是凍結的,之後光流網路以比其餘部分更小的學習率訓練 [7]。
損失函數通常是在每個輸出影格上的 L1 類型像素損失(BasicVSR 使用平滑版本 ,其中 是一個小常數, 是輸出與真實像素之間的差 [7]),真實世界模型再加上感知與對抗項;DLCV 09 討論了這些。有些方法加入時間損失,懲罰經運動補償後連續輸出之間的差異,例如 Lai 等人 [33] 的短期扭曲損失,它把每個輸出影格與經光流扭曲的前一個輸出比較,並在扭曲不可靠的地方遮罩掉。
評估
白話版。 把每個影格都與真實標準答案比較評分,將分數平均,並明確說明 LR 影格是怎麼做出來的。然後觀看實際播放的影片,因為逐影格的分數看不到閃爍。
逐影格保真度:Y 通道 PSNR 與 SSIM
大多數 VSR 論文回報在亮度(Y)通道上的 PSNR 與 SSIM [34](定義見 DLCV 09);每個影格各自計算,先對片段內的影格平均,再對片段平均。Y 通道依循 ITU-R BT.601 [35]:由 中經過 gamma 校正的 RGB 算出亮度 ,並以 8 位元的「studio」刻度量化為 。這個慣例並不通用:在 BasicVSR 與 BasicVSR++ 的比較表中,除了 REDS4 是算在 RGB 上之外,所有結果都算在 Y 上 [7], [20]。混用不同的慣例會讓數字差好幾 dB,下面的程式碼就是例子。
程式碼 · Python · 22 行
import numpy as np
from skimage import data, color

def rgb_to_y(rgb):
    """BT.601 luma on the 8-bit studio scale: Y = 16 + 219 * (0.299 R + 0.587 G + 0.114 B), RGB in [0, 1]."""
    return 16 + 65.481 * rgb[..., 0] + 128.553 * rgb[..., 1] + 24.966 * rgb[..., 2]

def psnr(a, b, peak=255.0):
    return 10 * np.log10(peak ** 2 / np.mean((a.astype(np.float64) - b) ** 2))

rng = np.random.default_rng(0)
gt = np.stack([np.roll(data.astronaut(), 2 * t, axis=1) for t in range(5)]) / 255.0   # 5 ground-truth frames
out = np.clip(gt + rng.normal(0, 0.02, gt.shape) * np.array([1.0, 0.3, 1.5]), 0, 1)  # unequal error per channel

y_scores = [psnr(rgb_to_y(o), rgb_to_y(g)) for o, g in zip(out, gt)]
rgb_scores = [psnr(255 * o, 255 * g) for o, g in zip(out, gt)]
print("matches skimage rgb2ycbcr:", np.allclose(rgb_to_y(gt[0]), color.rgb2ycbcr(gt[0])[..., 0]))
print(f"Y-channel PSNR, mean of frames: {np.mean(y_scores):.2f} dB")
print(f"RGB PSNR,       mean of frames: {np.mean(rgb_scores):.2f} dB")
# matches skimage rgb2ycbcr: True
# Y-channel PSNR, mean of frames: 43.74 dB
# RGB PSNR,       mean of frames: 33.94 dB
同一個輸出在 Y 上的分數比在 RGB 上高約 10 dB(我們的執行結果),一部分是因為 Y 是三個通道的加權平均,獨立的通道誤差會部分抵消,另一部分是因為 Y 只涵蓋 255 個階層中的 219 個,而公式中的峰值仍是 255。務必說明所用的通道、邊界裁切,以及影格是否已四捨五入成 8 位元。
退化設定:BI 與 BD
兩種 LR 配方主導了乾淨的基準測試,而且在它們之下的結果不能直接比較:
- BI(雙三次,bicubic): 用 MATLAB 的
imresize把每個 HR 影格縮小 ,它先用三次濾波器模糊,再做子取樣。Vimeo-90K SR 基準測試就是這樣建立的 [14]。 - BD(模糊後降取樣,blur-downsampling): 先用標準差 的高斯函數模糊每個 HR 影格,再每隔四個像素保留一個,如 BasicVSR [7] 所規定。
BD 包含更強而且已知的模糊,所以模型除了上取樣,還必須去模糊。BasicVSR 的表格中,REDS4 只回報 BI,UDM10 只回報 BD,而 Vimeo-90K-T 與 Vid4 兩者都有 [7]。閱讀比較表時,先檢查每一欄的設定。
時間一致性
逐影格的 PSNR 看不到閃爍:每個影格隨機變動的誤差,可能和穩定的誤差得到相同的平均 PSNR。常用的指標有三類:
- 扭曲誤差(warping error)[33]:用光流把輸出影格 扭曲到影格 ,並量測加上遮罩的差異,
其中 是輸出影格 的像素 , 是被扭曲到影格 的影格 , 是像素數, 是非遮擋遮罩;影片的分數是對所有連續配對取平均。它的弱點是:模糊、毫無細節的影片非常穩定,分數也很好。
- tOF 與 tLP(TecoGAN [36])比較輸出與真實標準答案的時間行為,而不是要求完全不變:
其中 與 是輸出與真實標準答案的影格, 是用 Farnebäck 方法估計的光流, 是 LPIPS 感知距離 [37]。TecoGAN 的作者提出它們,是因為單純的扭曲差異指標「很容易被欺騙」,例如被雙三次內插這類模糊的結果騙過。
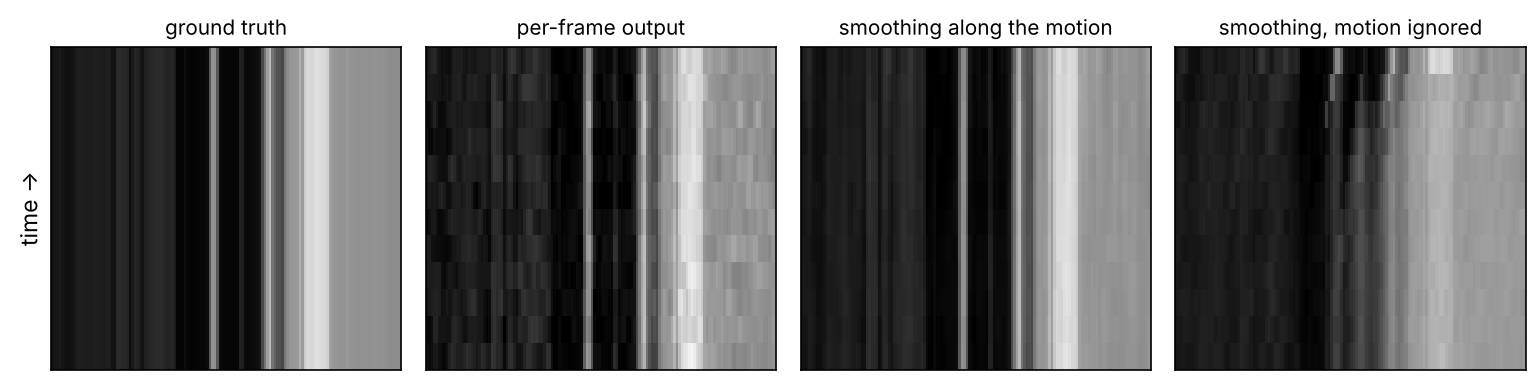
- 時間剖面(temporal profile):取一列像素沿時間追蹤,堆疊成一張影像;斑點與條紋會顯露閃爍。VESPCN 用它做質化比較 [2]。
下面的程式碼造出一個運動已知的玩具場景和四種「輸出」:每個影格獨立捏造的紋理、沿運動方向遞迴平滑的同一批輸出、忽略運動的同樣平滑,以及一個模糊的輸出。閃爍的量測精神近似 tOF:輸出在運動補償後的時間變化,減去真實標準答案的時間變化。
程式碼 · Python · 36 行
import numpy as np
from scipy import ndimage as ndi
from skimage import data, transform

rng = np.random.default_rng(0)
T, v = 12, (1, 2)                                         # 12 frames, the scene moves 1 px down and 2 px right per frame
base = transform.resize(data.camera() / 255.0, (256, 256), anti_aliasing=True)
gt = np.stack([np.roll(base, (v[0] * t, v[1] * t), axis=(0, 1)) for t in range(T)])
warp_prev = lambda f: np.roll(f, v, axis=(0, 1))          # exact motion compensation for this toy scene

def fake_detail():                                        # zero-mean "hallucinated texture", new every frame
    n = ndi.gaussian_filter(rng.standard_normal(base.shape), 0.8)
    return 0.03 * n / n.std()

per_frame = gt + np.stack([fake_detail() for _ in range(T)])  # each frame restored independently
smoothed, unaligned, blurry = per_frame.copy(), per_frame.copy(), np.stack([ndi.gaussian_filter(g, 1.5) for g in gt])
for t in range(1, T):
    smoothed[t] = 0.3 * per_frame[t] + 0.7 * warp_prev(smoothed[t - 1])   # recursive filter along the motion
    unaligned[t] = 0.3 * per_frame[t] + 0.7 * unaligned[t - 1]           # same filter, motion ignored

c = (slice(None), slice(16, -16), slice(16, -16))          # ignore borders (np.roll wraps around)
def psnr(out):
    return np.mean([10 * np.log10(1 / np.mean((o - g) ** 2)) for o, g in zip(out[c], gt[c])])
def flicker(out):
    """Mean |temporal change of output - temporal change of ground truth| after motion compensation."""
    d_out = out[1:] - np.stack([warp_prev(f) for f in out[:-1]])
    d_gt = gt[1:] - np.stack([warp_prev(f) for f in gt[:-1]])
    return np.abs(d_out - d_gt)[c].mean()

for name, out in [("per-frame", per_frame), ("aligned smoothing", smoothed),
                  ("unaligned smoothing", unaligned), ("blurry output", blurry)]:
    print(f"{name:20s} PSNR {psnr(out):5.2f} dB   flicker {flicker(out):.4f}")
# per-frame            PSNR 30.50 dB   flicker 0.0338
# aligned smoothing    PSNR 36.40 dB   flicker 0.0082
# unaligned smoothing  PSNR 21.74 dB   flicker 0.0223
# blurry output PSNR 25.99 dB flicker 0.0000把這四行合起來讀(都來自我們的玩具實驗)。沿著運動傳播資訊,會降低閃爍,在這個玩具中 PSNR 也提高了,因為捏造的紋理是零平均的雜訊,會被平均掉;真實的捏造紋理不是這樣,所以不要期待 PSNR 有這麼大的進步。不對齊就傳播,會讓移動中的場景產生鬼影:PSNR 崩落,閃爍仍然很高。而模糊的輸出閃爍為零,但 PSNR 很差,這就是縮小版的 TecoGAN 警告:時間指標務必與保真度或感知指標一起回報。圖 6 以經過運動補償的時間剖面顯示同樣的效應。
資料集與測試集
| 資料集 | 內容 | 典型用途 |
|---|---|---|
| Vimeo-90K [14] | 取自 Vimeo 的 89,800 段影片(720p 或更高);SR 基準測試使用 448 × 256 的 7 影格序列,×4 的 LR 輸入為 112 × 64,以 MATLAB imresize 製作 | 訓練;測試切分 Vimeo-90K-T |
| REDS [38] | 300 段序列,每段 100 個影格,720 × 1280(240 段訓練、30 段驗證、30 段測試),為 NTIRE 2019 影片挑戰賽拍攝,運動大而複雜 | 訓練;REDS4 測試集 |
| REDS4 | 四段 REDS 訓練片段(000、011、015、020),依循 EDVR [7] 保留作測試 | BI 下的測試 |
| Vid4 [39] | 取自 Liu 與 Sun 的貝氏適應式 VSR 研究的四段短序列 | BI 與 BD 下的測試 |
| UDM10 | 與 PFNL [22] 一起釋出的十段測試序列 | BD 下的測試 |
| VideoLQ [27] | 沒有真實標準答案的真實低品質影片 | 真實世界評估(無參考指標、視覺) |
Liu 等人的綜述指出,隨著方法瞄準更複雜的運動與場景變化,測試影片從 Vid4 逐漸演變到 REDS [40];BasicVSR 則把 REDS4 描述為包含大而複雜的運動 [7]。由於 Vimeo-90K-T 的序列只有七個影格,長距離傳播在那裡沒有太多可發揮的空間:BasicVSR 在 Vimeo-90K-T 上回報的分數略低於 EDVR 等滑動視窗方法,並把原因歸於序列太短 [7]。
挑戰賽
NTIRE(CVPR)與 AIM(ECCV)研討會的挑戰賽建立了資料集,並追蹤最新技術水準。NTIRE 2019 提出了 REDS [38];它的影片 SR 挑戰賽 [41] 有一個雙三次賽道與一個含真實運動模糊的賽道,EDVR 當年拿下了全部四個影片復原賽道 [18]。NTIRE 2021 影片 SR [42] 有一個復原品質賽道與一個較低影格率賽道,後者把問題變成時空 SR(同時提高解析度與影格率);BasicVSR++ 回報在那次挑戰賽與壓縮影片增強挑戰賽合計拿下三個第一名與一個第二名 [20]。效率挑戰賽評斷每單位運算量的品質:Mobile AI & AIM 2022 報告 [43] 要求在手機的神經處理單元上即時進行 ×4 VSR,以 REDS 訓練,並以執行時間與耗電評比;AIM 2024 的壓縮內容高效率 VSR 挑戰賽 [44] 則針對串流,要求把 540p 以 ×4 放大到 4K,以及把 360p 以 ×3 放大到 1080p。
效率與串流
白話版。 影片模型必須對每個影格都執行,常常要即時,而且常常在未來影格還不存在時就得輸出。這些限制對架構的影響不亞於準確度。
- 每個影格的成本。 除非快取特徵,滑動視窗會把每個輸入影格處理 次;循環模型每個影格只處理一次並攜帶一個狀態,所以每個影格的成本不會隨影片長度增加 [3]。
- 延遲與因果性。 雙向與網格傳播需要未來的影格,所以第一個輸出得等到整段片段結束。即時影片(通話、遊戲串流)只容許因果設計或短的前瞻緩衝區,品質會有所損失(BasicVSR 的單向消融實驗 [7])。長影片要分段處理,品質會在段落末端下降,如 BasicVSR 的分段實驗所示。
- 記憶體。 像 VRT 這樣的平行 Transformer,會在多個尺度上跨許多影格做注意力;它們的模型大小與記憶體用量是 RVRT 以片段層級的循環要解決的缺點 [24]。擴散式 VSR 更貴,這也是推動一步模型的動機 [32]。
- 部署。 效率挑戰賽為手機與串流設定了目標:少量參數與運算、即時影格率與低耗電,品質則與內插基線而不是最大的模型相比 [43], [44]。
失效模式
白話版。 VSR 會在它的主要假設不成立的地方失敗:這個假設是,相鄰影格顯示的是同樣的內容,只是稍微移動過。
- 遮擋與去遮擋。 在鄰近影格中被藏起來的內容(圖 4)沒有額外的量測;模型若在那裡相信扭曲後的特徵,就會產生鬼影或雙重邊緣。調變遮罩與注意力權重讓模型能壓低這些區域的權重 [20]。
- 大而複雜的運動。 快速的非剛體運動與動態模糊會讓對齊不準確;由粗到細的對齊(EDVR 的 PCD、SPyNet 的金字塔)有幫助,但不能消除問題。REDS 正是用來對這一點施加壓力 [18]。
- 誤差累積。 在循環模型中,錯誤的狀態會被往前帶,尤其是在遮擋或場景切換之後;IconVSR 的關鍵影格補充與 BasicVSR++ 的二階連結,都是直接的對策 [7], [20]。長距離傳播也會放大嚴重的輸入瑕疵,RealBasicVSR 以預清理來對付 [27]。
- 閃爍。 在單張影像模型或擴散取樣中,獨立的逐影格決策會造成時間上的不穩定,而逐影格指標看不到。
- 捏造的細節。 GAN 與擴散式 VSR 可能創造出從未存在的合理紋理、文字或人臉,而在影片中,捏造的內容還可能漂移。對於監視、鑑識、醫療或科學影片,請優先選用以保真度為導向的模型,並說明輸出是由哪一種模型產生的。
- 領域差距。 用 BI 或 BD 退化訓練的模型,沒有考慮壓縮與真實雜訊 [26], [27]。
現代觀點
綜述論文
- Liu 等人,「Video Super-Resolution Based on Deep Learning: A Comprehensive Survey」(Artificial Intelligence Review,2022) [40]。回顧 37 個深度 VSR 方法,依如何利用影格間資訊分成七個子類別:有對齊(運動估計與補償、可變形卷積)或無對齊(2-D 與 3-D 卷積、循環 CNN、非區域運算、其他),並在基準測試上比較。重點:這個領域從對齊的短視窗,走向混合的設計與長序列,REDS 取代 Vid4 成為嚴格的測試集。
- Tu 等人,「Optical Flow for Video Super-Resolution: A Survey」(Artificial Intelligence Review,2022) [45]。涵蓋指標以及傳統與深度的光流式 VSR,並分析代表性的深度方法。重點:稠密的子像素光流是最常用的運動補償工具之一,所以理解光流,就是理解 VSR 對齊的一大部分。
- Baniya 等人,「A Survey of Deep Learning Video Super-Resolution」(IEEE Transactions on Emerging Topics in Computational Intelligence,2024) [46]。一套元件分類法(輸入、對齊、融合、改進與重建、上取樣),加上損失函數、品質與效率評估、應用,以及線上、真實世界、資源受限與時空 VSR 等趨勢。重點:設計選擇常由基準測試的進步所驅動,而不是被解釋清楚,實務情境值得更多關注。
2023–2026 年的最新進展
- 傳播加對齊是以保真度為導向的 VSR 的核心。 帶光流引導可變形對齊的雙向或網格循環傳播(BasicVSR++),以及平行或片段循環的 Transformer(VRT、RVRT),是本篇的參考設計,在準確度與記憶體、延遲之間取捨。
- 真實世界 VSR 轉向生成式先驗。 繼 RealBasicVSR 等以 CNN 為基礎的真實世界模型之後,出現了建立在影像擴散模型上的擴散式 VSR(Upscale-A-Video、MGLD-VSR),接著是建立在影片擴散模型與擴散 Transformer 上的(STAR、SeedVR),時間一致性是核心的技術問題。
- 生成式 VSR 的降低成本。 一步擴散(DLoRAL)走的路,與一步影像 SR 相同。
- 效率與壓縮成為一級目標,挑戰賽中有針對行動硬體與壓縮串流內容的賽道 [43], [44]。
尚未解決的問題
- 忠實與合理。 在影片中量測並控制幻覺仍未解決,因為捏造的細節在時間上也可能不穩定。
- 時間評估。 扭曲誤差可以靠模糊鑽漏洞,tOF 與 tLP 依賴光流與特徵估計,沒有公認的時間品質感知指標,而使用者研究又很昂貴。
- 真實退化與編碼器。 合成流程仍然漏掉了真實的相機處理與編碼器行為;真實影片很少有標準答案。
- 長影片、線上處理與場景切換。 要把雙向與全域模型的品質,與因果、固定記憶體的處理結合起來,仍然困難。
- 遮擋與大的運動。 在快速的非剛體運動與去遮擋下,對齊仍是弱點。
- 生成式 VSR 的成本,對於長的高解析度影片,仍遠高於 CNN 與 Transformer 的 VSR。
重點整理
- 次像素運動可能提供額外場景量測,逐影格獨立放大會忽略它們。
- 合併前須對齊對應內容,遮擋區域可能沒有有效匹配。
- 光流、可變形取樣與注意力提供不同對應機制及成本。
- 循環會傳遞資訊,也會傳遞錯誤;雙向處理還需要未來影格。
- 壓縮偽影與生成紋理可能隨時間累積或閃爍。
- 同時報告退化、色彩、邊界協定及空間、時間指標;單靠模糊也能顯得穩定。
練習
- 整數運動與子像素運動。 在多影格程式碼中,把隨機位移換成整數位移(
rng.integers(0, s, size=(T, 2)).astype(float),保留shifts[0] = 0),重新執行。再試試所有位移都等於零。用圖 1 的取樣論證,解釋你在每種情況得到的 PSNR。
提示
以 HR 像素為單位的整數位移,仍會讓 LR 取樣落在不同的 HR 相位上(HR 位移 1 等於四分之一個 LR 像素),所以它們仍然有幫助;重要的是位移對 個 HR 像素取餘數之後的值。所有位移都為零時,每個影格取樣的是相同的 HR 位置,所以只有雜訊被平均,結果會停留在接近單影格求解器的程度。試試 4 個 HR 像素的倍數位移,就能直接看到「沒有新資訊」的情況。
- 配準誤差預算。 在呼叫
reconstruct之前,對真實位移加上標準差為 0.25、0.5 與 1.0 個 HR 像素的高斯雜訊,並畫出 PSNR 對位移誤差的圖。與相位相關法 0.13 個像素的誤差比較。這對超解析度所需的對齊準確度,相較於去雜訊,說明了什麼?
提示
一旦位移誤差接近要還原的細節大小(一個 HR 像素的幾分之一),PSNR 應該會快速下降,因為取樣落在錯的位置,重建會變模糊或出現振鈴。靠平均來去雜訊能容忍較大的誤差,因為它只需要相同的內容,而不需要內容確切的子像素位置。這就是為什麼 VSR 需要子像素準確的光流,而許多影片去雜訊器用較粗的對齊就能運作。
- 前向扭曲與反向扭曲。 寫一個前向扭曲函式,把影格 的每個像素推到 (四捨五入到最近的像素),並在兩影格範例上與
bilinear_warp的輸出比較。數出空洞(沒有收到任何值的像素)與碰撞(收到多個值的像素)各有多少。
提示
空洞出現在場景擴張或去遮擋的地方(移動方塊的後方),碰撞則出現在場景收縮或被遮擋的地方。反向扭曲兩者都沒有,因為每個輸出像素都恰好讀取一個(內插後的)值,這就是網路使用它的原因;代價是它需要在參考影格上定義的光流。
- 滑動視窗與循環的成本。 一個視窗為 7 個影格的滑動視窗模型,對視窗中每個輸入影格各執行一次特徵擷取器,並對每個鄰近影格各執行一個光流網路。一個雙向循環模型每個影格執行一次特徵擷取器,以及兩次光流估計(每個方向一次)。數出每種設計在每個輸出影格上的特徵擷取次數與光流估計次數,分別計算有快取與沒有快取視窗之間的特徵的情況。對於一段 100 個影格的片段,哪一種設計的第一個輸出延遲較低?
提示
沒有快取時,視窗模型每個輸出要做 7 次特徵擷取與 6 次光流估計;有快取時,每個輸出只要 1 次新的擷取,但仍是 6 次光流(每個鄰近影格都必須對齊到新的中心影格)。雙向模型每個影格做 1 次擷取與 2 次光流。但它的第一個輸出需要對全部 100 個影格做後向傳遞,視窗模型則只需要影格 1 到 4。每個影格的成本有利於循環;延遲則有利於視窗。
- 閃爍指標的陷阱。 在閃爍程式碼中,把零平均的捏造細節換成一個隨場景移動的固定紋理圖樣(只產生一次,並隨場景一起滾動)。重新執行,並解釋為什麼閃爍指標改變了,PSNR 卻沒有多大變化。這說明了 tOF/tLP 類型的指標能偵測什麼、不能偵測什麼?
提示
與場景一致移動的紋理,時間變化與真實標準答案相同,所以經運動補償的閃爍會降到約為零,而 PSNR 仍和之前差不多低,因為紋理仍然是錯的。時間指標偵測的是不一致,而不是不正確:一致地捏造出來的紋理能通過這些指標。保真度(或感知)指標與時間指標回答的是不同的問題。
參考文獻
- S. Farsiu, M. D. Robinson, M. Elad and P. Milanfar, “Fast and Robust Multiframe Super Resolution,” IEEE Transactions on Image Processing, vol. 13, no. 10, pp. 1327–1344, 2004. doi
- J. Caballero, C. Ledig, A. Aitken, A. Acosta, J. Totz, Z. Wang and W. Shi, “Real-Time Video Super-Resolution with Spatio-Temporal Networks and Motion Compensation,” in Proc. IEEE CVPR, 2017. CVF · arXiv
- M. S. M. Sajjadi, R. Vemulapalli and M. Brown, “Frame-Recurrent Video Super-Resolution,” in Proc. IEEE/CVF CVPR, 2018. CVF · arXiv
- M. Irani and S. Peleg, “Improving Resolution by Image Registration,” CVGIP: Graphical Models and Image Processing, vol. 53, no. 3, pp. 231–239, 1991. doi
- M. Haris, G. Shakhnarovich and N. Ukita, “Recurrent Back-Projection Network for Video Super-Resolution,” in Proc. IEEE/CVF CVPR, 2019. CVF · arXiv
- M. Guizar-Sicairos, S. T. Thurman and J. R. Fienup, “Efficient Subpixel Image Registration Algorithms,” Optics Letters, vol. 33, no. 2, p. 156, 2008. doi
- K. C. K. Chan, X. Wang, K. Yu, C. Dong and C. C. Loy, “BasicVSR: The Search for Essential Components in Video Super-Resolution and Beyond,” in Proc. IEEE/CVF CVPR, 2021. CVF · arXiv
- B. K. P. Horn and B. G. Schunck, “Determining Optical Flow,” Artificial Intelligence, vol. 17, no. 1–3, pp. 185–203, 1981. doi
- G. Farnebäck, “Two-Frame Motion Estimation Based on Polynomial Expansion,” in Image Analysis (Lecture Notes in Computer Science), pp. 363–370, Springer, 2003. doi
- A. Ranjan and M. J. Black, “Optical Flow Estimation Using a Spatial Pyramid Network,” in Proc. IEEE CVPR, 2017. CVF · arXiv
- Z. Teed and J. Deng, “RAFT: Recurrent All-Pairs Field Transforms for Optical Flow,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 402–419, 2020. doi · arXiv
- M. Jaderberg, K. Simonyan, A. Zisserman and K. Kavukcuoglu, “Spatial Transformer Networks,” in Advances in Neural Information Processing Systems (NeurIPS), 2015. proceedings · arXiv
- W. Shi, J. Caballero, F. Huszár, J. Totz, A. P. Aitken, R. Bishop, D. Rueckert and Z. Wang, “Real-Time Single Image and Video Super-Resolution Using an Efficient Sub-Pixel Convolutional Neural Network,” in Proc. IEEE CVPR, 2016. arXiv
- T. Xue, B. Chen, J. Wu, D. Wei and W. T. Freeman, “Video Enhancement with Task-Oriented Flow,” International Journal of Computer Vision, vol. 127, no. 8, pp. 1106–1125, 2019. doi · arXiv
- J. Dai, H. Qi, Y. Xiong, Y. Li, G. Zhang, H. Hu and Y. Wei, “Deformable Convolutional Networks,” in Proc. IEEE ICCV, 2017. CVF · arXiv
- X. Zhu, H. Hu, S. Lin and J. Dai, “Deformable ConvNets V2: More Deformable, Better Results,” in Proc. IEEE/CVF CVPR, 2019. CVF · arXiv
- Y. Tian, Y. Zhang, Y. Fu and C. Xu, “TDAN: Temporally-Deformable Alignment Network for Video Super-Resolution,” in Proc. IEEE/CVF CVPR, 2020. CVF · arXiv
- X. Wang, K. C. K. Chan, K. Yu, C. Dong and C. C. Loy, “EDVR: Video Restoration with Enhanced Deformable Convolutional Networks,” in Proc. IEEE/CVF CVPR Workshops, 2019. CVF · arXiv
- K. C. K. Chan, X. Wang, K. Yu, C. Dong and C. C. Loy, “Understanding Deformable Alignment in Video Super-Resolution,” in Proc. AAAI Conference on Artificial Intelligence, vol. 35, no. 2, pp. 973–981, 2021. doi · arXiv
- K. C. K. Chan, S. Zhou, X. Xu and C. C. Loy, “BasicVSR++: Improving Video Super-Resolution with Enhanced Propagation and Alignment,” in Proc. IEEE/CVF CVPR, 2022. CVF · arXiv
- Y. Jo, S. W. Oh, J. Kang and S. J. Kim, “Deep Video Super-Resolution Network Using Dynamic Upsampling Filters Without Explicit Motion Compensation,” in Proc. IEEE/CVF CVPR, 2018. CVF
- P. Yi, Z. Wang, K. Jiang, J. Jiang and J. Ma, “Progressive Fusion Video Super-Resolution Network via Exploiting Non-Local Spatio-Temporal Correlations,” in Proc. IEEE/CVF ICCV, 2019. CVF · code and test data (Vid4, UDM10)
- J. Liang, J. Cao, Y. Fan, K. Zhang, R. Ranjan, Y. Li, R. Timofte and L. Van Gool, “VRT: A Video Restoration Transformer,” IEEE Transactions on Image Processing, vol. 33, pp. 2171–2182, 2024. doi · arXiv
- J. Liang, Y. Fan, X. Xiang, R. Ranjan, E. Ilg, S. Green, J. Cao, K. Zhang, R. Timofte and L. Van Gool, “Recurrent Video Restoration Transformer with Guided Deformable Attention,” in Advances in Neural Information Processing Systems (NeurIPS), vol. 35, pp. 378–393, 2022. arXiv
- T. Wiegand, G. J. Sullivan, G. Bjøntegaard and A. Luthra, “Overview of the H.264/AVC Video Coding Standard,” IEEE Transactions on Circuits and Systems for Video Technology, vol. 13, no. 7, pp. 560–576, 2003. doi
- Y. Li, P. Jin, F. Yang, C. Liu, M.-H. Yang and P. Milanfar, “COMISR: Compression-Informed Video Super-Resolution,” in Proc. IEEE/CVF ICCV, 2021. CVF · arXiv
- K. C. K. Chan, S. Zhou, X. Xu and C. C. Loy, “Investigating Tradeoffs in Real-World Video Super-Resolution,” in Proc. IEEE/CVF CVPR, 2022. CVF · arXiv
- S. Zhou, P. Yang, J. Wang, Y. Luo and C. C. Loy, “Upscale-A-Video: Temporal-Consistent Diffusion Model for Real-World Video Super-Resolution,” in Proc. IEEE/CVF CVPR, pp. 2535–2545, 2024. CVF · arXiv
- X. Yang, C. He, J. Ma and L. Zhang, “Motion-Guided Latent Diffusion for Temporally Consistent Real-World Video Super-Resolution,” in Proc. ECCV (Lecture Notes in Computer Science), pp. 224–242, 2024. doi · arXiv
- R. Xie, Y. Liu, P. Zhou, C. Zhao, J. Zhou, K. Zhang, Z. Zhang, J. Yang, Z. Yang and Y. Tai, “STAR: Spatial-Temporal Augmentation with Text-to-Video Models for Real-World Video Super-Resolution,” in Proc. IEEE/CVF ICCV, 2025. CVF · arXiv
- J. Wang, Z. Lin, M. Wei, Y. Zhao, C. Yang, C. C. Loy and L. Jiang, “SeedVR: Seeding Infinity in Diffusion Transformer Towards Generic Video Restoration,” in Proc. IEEE/CVF CVPR, 2025. CVF · arXiv
- Y. Sun, L. Sun, S. Liu, R. Wu, Z. Zhang and L. Zhang, “One-Step Diffusion for Detail-Rich and Temporally Consistent Video Super-Resolution,” in Advances in Neural Information Processing Systems (NeurIPS), vol. 38, 2025. arXiv
- W.-S. Lai, J.-B. Huang, O. Wang, E. Shechtman, E. Yumer and M.-H. Yang, “Learning Blind Video Temporal Consistency,” in Proc. ECCV, 2018. CVF · arXiv
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image Quality Assessment: From Error Visibility to Structural Similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- ITU-R, “Recommendation ITU-R BT.601-7: Studio Encoding Parameters of Digital Television for Standard 4:3 and Wide-Screen 16:9 Aspect Ratios,” International Telecommunication Union, 2011. ITU
- M. Chu, Y. Xie, J. Mayer, L. Leal-Taixé and N. Thuerey, “Learning Temporal Coherence via Self-Supervision for GAN-based Video Generation,” ACM Transactions on Graphics, vol. 39, no. 4, article 75, 2020. doi · arXiv
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018. CVF · arXiv
- S. Nah, S. Baik, S. Hong, G. Moon, S. Son, R. Timofte and K. M. Lee, “NTIRE 2019 Challenge on Video Deblurring and Super-Resolution: Dataset and Study,” in Proc. IEEE/CVF CVPR Workshops, 2019. CVF
- C. Liu and D. Sun, “On Bayesian Adaptive Video Super Resolution,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 36, no. 2, pp. 346–360, 2014. doi
- H. Liu, Z. Ruan, P. Zhao, C. Dong, F. Shang, Y. Liu, L. Yang and R. Timofte, “Video Super-Resolution Based on Deep Learning: A Comprehensive Survey,” Artificial Intelligence Review, vol. 55, no. 8, pp. 5981–6035, 2022. doi · arXiv
- S. Nah, R. Timofte, S. Gu, S. Baik, S. Hong, G. Moon, S. Son and K. M. Lee, “NTIRE 2019 Challenge on Video Super-Resolution: Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2019. CVF
- S. Son, S. Lee, S. Nah, R. Timofte and K. M. Lee, “NTIRE 2021 Challenge on Video Super-Resolution,” in Proc. IEEE/CVF CVPR Workshops, 2021. CVF · arXiv
- A. Ignatov, R. Timofte et al., “Power Efficient Video Super-Resolution on Mobile NPUs with Deep Learning, Mobile AI & AIM 2022 Challenge: Report,” arXiv:2211.05256, 2022. arXiv
- M. V. Conde, Z. Lei, W. Li, C. Bampis, I. Katsavounidis, R. Timofte et al., “AIM 2024 Challenge on Efficient Video Super-Resolution for AV1 Compressed Content,” in Proc. ECCV Workshops (Lecture Notes in Computer Science), pp. 304–325, 2025. doi · arXiv
- Z. Tu, H. Li, W. Xie, Y. Liu, S. Zhang, B. Li and J. Yuan, “Optical Flow for Video Super-Resolution: A Survey,” Artificial Intelligence Review, vol. 55, no. 8, pp. 6505–6546, 2022. doi · arXiv
- A. A. Baniya, T.-K. Lee, P. W. Eklund and S. Aryal, “A Survey of Deep Learning Video Super-Resolution,” IEEE Transactions on Emerging Topics in Computational Intelligence, vol. 8, no. 4, pp. 2655–2676, 2024. doi · arXiv
- B. Wronski, I. Garcia-Dorado, M. Ernst, D. Kelly, M. Krainin, C.-K. Liang, M. Levoy and P. Milanfar, “Handheld Multi-Frame Super-Resolution,” ACM Transactions on Graphics, vol. 38, no. 4, 2019. doi · arXiv
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 09B・生成式影像復原:取樣出一個合理的答案 · 36 分鐘