DLCV 12B・單步生成
先備知識:ML 08・擴散模型與流匹配、DLCV 12・影像生成:從 GAN 到文字生成影像系統
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 解釋為何一次局部去雜訊方向不一定能到達遠方端點。
- 比較端點迴歸、一致性、重流與分布匹配。
- 區分匹配教師軌跡與匹配輸出分布。
- 理解以步長為條件的捷徑與平均速度目標。
- 報告網路評估次數、完整延遲、對齊與多樣性。
先看全貌
擴散去雜訊器通常預測某個雜訊程度下的局部修正;單步生成器則必須把隨機輸入變成完整樣本。它需要學會有限位移,不能只把局部修正做得更有信心。本章整合擴散蒸餾、一致性模型、rectified flow,以及 shortcut/平均速度模型。有些借助預訓練教師,有些直接訓練生成器。「單步」描述推論方式,並不代表大家使用同一種訓練演算法。
先讀 ML 08:擴散模型與流匹配,理解加雜訊排程、預測目標與機率流方程式;DLCV 12:影像生成 則介紹整體管線與評估。本章聚焦:把反覆迭代壓縮成一次或少數幾次呼叫時,究竟要改變什麼? 超解析度以觀測影像為條件,另見單步擴散超解析度。
第一次先看數值實驗、方法家族表與評估原則,再挑一篇論文導讀。公式用來分辨訓練目標;不必先讀懂所有推導,才能掌握家族之間的差異。
為什麼放大一步會不同
白話說。 局部切線提供目前方向,不是到遠方端點的位移;局部預測準確,單步跳躍仍可能很差。
將機率流或流匹配的常微分方程式寫成:
是目前的影像或潛在向量, 是連續時間, 是瞬時速度, 是帶正負號的時間增量。右式是 Euler 更新。局部誤差取決於路徑上速度如何隨時間與位置改變;放大 就忽略更多變化。即使神經網路更準確地預測同一個瞬時速度,也不會自動修好積分誤差。
必須區分三種誤差:學到的向量場偏離目標,形成模型誤差;有限步求解器近似連續動態,形成數值誤差;推論的起始雜訊、條件或解析度與訓練不同,形成分布不匹配。改善其中一項不會消除另外兩項。機率流理論 [1] 說明理想邊際分布的連結,並不保證有限的神經取樣器精確遵循它。
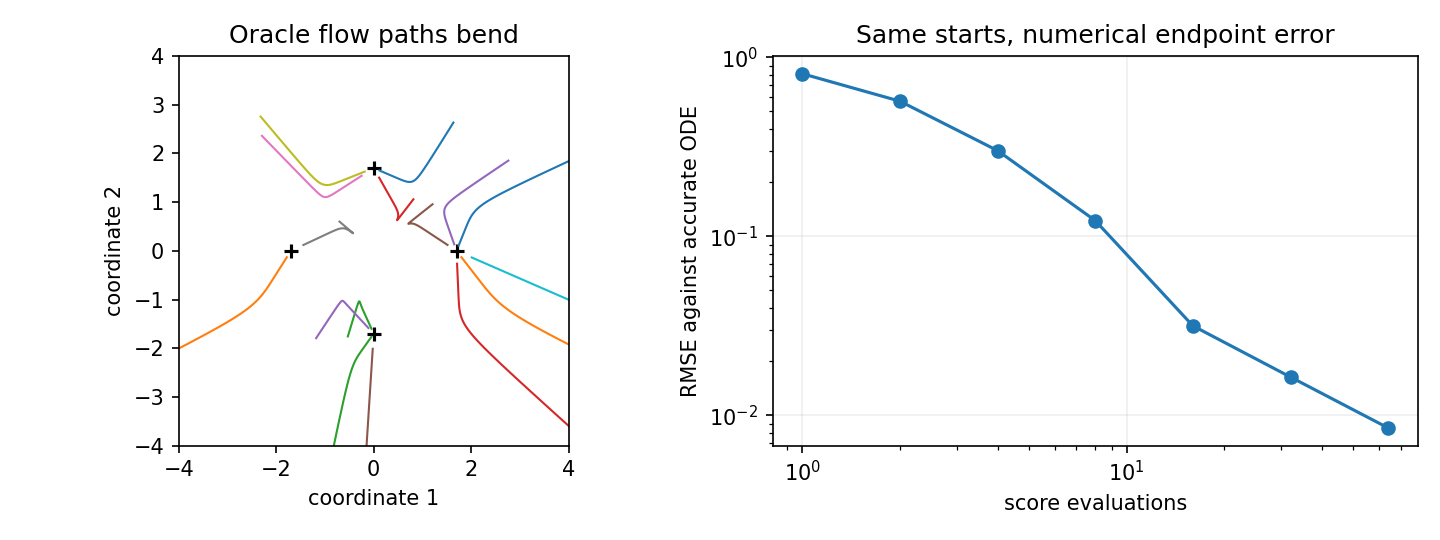
流匹配 [2] 也一樣。即使訓練配對沿直線內插,同一位置的邊際速度仍可能平均多組配對的方向,使實際軌跡彎曲。訓練內插線是直的,不等於學到的邊際流也筆直。
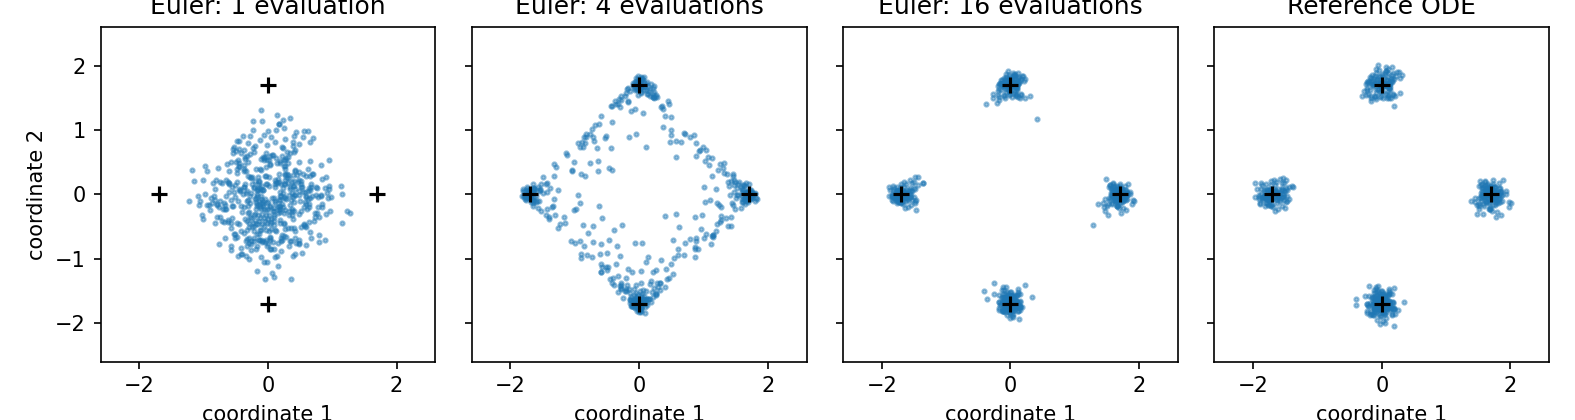
已知精確分數函數的小實驗
以下排除神經網路近似誤差,以等權重的四個二維高斯分布為目標。加入標準差 的高斯雜訊後,各成分變異數為 ,其中原始標準差 。精確分數函數為:
是第 個成分的中心, 是在位置 的正規化後驗權重。這種加性雜訊族以雜訊尺度參數化時,機率流方程式為 [3]。積分方向從大 到小 。
起點取自精確的加雜訊混合分布,並非直接假設為標準高斯,因此能控制數值比較的條件。實際生成器還要處理起始分布與訓練邊界是否吻合。我們從同一批起點比較粗略 Euler 終點與高精度自適應 ODE 解;此誤差不是影像品質指標,也不是訓練模型的基準成績。
程式碼 · Python · 33 行
import numpy as np
from scipy.integrate import solve_ivp

centers = np.array([[-1.7, 0.], [1.7, 0.], [0., -1.7], [0., 1.7]])
base_var = 0.12**2
sigma_start, sigma_end = 3.0, 0.04

def score(x, sigma):
    """Exact score of the equally weighted Gaussian mixture after Gaussian noising."""
    var = base_var + sigma**2
    delta = x[:, None, :] - centers[None, :, :]
    logits = -(delta**2).sum(-1) / (2 * var)
    weights = np.exp(logits - logits.max(1, keepdims=True))
    weights /= weights.sum(1, keepdims=True)
    return -(weights[:, :, None] * delta).sum(1) / var

def euler(initial, steps):
    x = initial.copy()
    grid = np.linspace(sigma_start, sigma_end, steps + 1)
    for s0, s1 in zip(grid[:-1], grid[1:]):
        x += (s1 - s0) * (-s0 * score(x, s0))
    return x

rng = np.random.default_rng(7)
initial = centers[rng.integers(4, size=512)] + np.sqrt(base_var + sigma_start**2) * rng.normal(size=(512, 2))
shape = initial.shape
solution = solve_ivp(lambda sigma, flat: (-sigma * score(flat.reshape(shape), sigma)).ravel(),
                     (sigma_start, sigma_end), initial.ravel(), rtol=1e-9, atol=1e-10, dense_output=True)
reference = solution.y[:, -1].reshape(shape)
for steps in [1, 2, 4, 8, 16, 32, 64]:
    estimate = euler(initial, steps)
    rmse = np.sqrt(np.mean((estimate - reference)**2))
    print(f'{steps:2d} evaluations: endpoint RMSE {rmse:.4f}')
輸出
 1 evaluations: endpoint RMSE 0.8098
 2 evaluations: endpoint RMSE 0.5686
 4 evaluations: endpoint RMSE 0.3011
 8 evaluations: endpoint RMSE 0.1224
16 evaluations: endpoint RMSE 0.0316
32 evaluations: endpoint RMSE 0.0164
64 evaluations: endpoint RMSE 0.0085
這些數字來自固定種子的實際執行。即使用精確分數函數,一次 Euler 評估仍有很大的終點誤差;增加評估次數才能更準確地跟隨彎曲路徑。參考解也是容許誤差很小的數值解,並非解析的封閉形式傳輸映射。
加速方法的地圖
白話說。 分開看待更快積分既有模型,以及重新訓練端點、跳躍或分布預測器。
| 家族 | 學習或改變什麼 | 需要獨立教師嗎? | 主要限制 |
|---|---|---|---|
| 快速求解器 | 改善既有向量場的數值更新 | 使用原模型 | 少步準確度仍取決於向量場與排程 |
| 漸進/軌跡蒸餾 | 把教師多步壓成學生一步 | 需要 | 遵循選定的教師映射 |
| 一致性模型 | 同一路徑不同位置預測相同乾淨端點 | 蒸餾需要;直接訓練不需要 | 不同雜訊程度的端點預測須一致 |
| Reflow 與端點蒸餾 | 先改善雜訊—影像耦合,再學直接映射 | 大型影像應用通常需要 | 拉直路徑與近似映射是兩個階段 |
| 對抗蒸餾 | 寫實輸出與教師指引 | ADD/LADD 需要 | 判別器穩定性與多樣性 |
| 分布匹配 | 學生輸出分布符合教師定義的目標 | 需要 | 學生分數模型必須追蹤持續變動的分布 |
| Shortcut/平均速度 | 以時間區間為條件的有限位移 | 可從頭訓練 | 自我目標準確度、時間條件與邊界行為 |
此表依擴散蒸餾綜述 [4] 區分目標,另加入直接訓練家族,因為本章談的是單步生成,不限於蒸餾。分類會重疊:DMD2 結合分布匹配與對抗目標;InstaFlow 結合 reflow 與端點蒸餾。檢查實際損失,比替模型貼上唯一標籤更有用。
訓練學生前,先以 DDIM [5]、DPM-Solver [6] 作為基準。它們改善每次評估的離散化誤差,卻不會自行學出完整端點映射。拿沒有效率的教師取樣器比較,可能誇大蒸餾加速;中等步數表現良好的求解器,也未必能縮到一次評估。
壓縮教師軌跡
白話說。 教師為各含雜訊輸入指定目的地,端點迴歸讓學生直接重現選定的映射。
漸進蒸餾
Progressive Distillation [7] 反覆讓學生一步符合教師確定性的兩步。訓練後學生接任教師,再把步數減半,形成逐步放大跳躍的學習課程,避免新網路立刻近似完整映射。
設確定性教師從 經過中間時間到達 。以乾淨預測 表示的 DDIM 式單步更新為:
是含雜訊狀態, 是訊號與雜訊排程係數。反解這個仿射方程式,就得到能重現教師兩步終點的學生目標。目標取決於教師映射與起點;它不同於一般乾淨影像去雜訊,後者的平方誤差最優解可能平均多個相容樣本。
推論節省的計算轉移到訓練:教師要做多次評估來產生目標,且階段之間可能累積誤差。學生也依賴特定排程與輸出參數化;任意更換取樣器,不等於使用訓練好的程序。
選讀:Progressive Distillation(見「論文導讀」)。完整目標、穩定參數化、原文成績與逐階段限制。
耦合也是目標的一部分
從雜訊分布到影像分布可以有許多合法映射。教師軌跡選定一種耦合(coupling),指定哪個隨機輸入對應哪個輸出。匹配這組配對,比只匹配輸出分布更嚴格。
例如對稱隨機輸入 , 與 都有平衡的兩模態輸出分布,但逐樣本對應完全相反。配對迴歸會強烈懲罰交換兩者,即使邊際分布沒有改變。
因此,單步生成不必然「太確定」。隨機潛在輸入經確定性映射仍能產生多樣輸出;模式崩潰發生在模型忽略隨機輸入,或只涵蓋少數目標模態時。把不同種子的無關終點拿來平均又是另一個問題:平均值可能落在模態之間,成為不合理樣本。
一致性模型的端點一致性
白話說。 不學下一個小修正,改學路徑最後到哪裡。同一路徑上的兩個狀態,應該給出同一個答案。
一致性函數滿足:
位於同一條機率流軌跡, 是小正邊界時間 的近乾淨端點。神經網路以以下參數化強制邊界條件:
是可學網路,、。邊界因此回傳輸入,而非允許所有位置都輸出同一常數。邊界錨定與正確配對很重要;只要求兩個預測相等,仍有無用的平凡解。
一致性蒸餾使用預訓練分數模型與求解器產生相鄰路徑狀態,讓較吵狀態的學生輸出,符合較乾淨狀態上停止梯度的目標網路輸出。一致性訓練則從資料、鄰近雜訊程度與共用雜訊建構配對,不需要獨立預訓練擴散教師 [8]。後續研究 [9] 修改權重、雜訊抽樣及目標更新;不能把最初設定當成所有一致性模型的最終形式。
單步取樣在起始雜訊上評估 ;少步取樣則在端點預測之間,於較低雜訊程度重新加雜訊再預測。它不是反覆把同一確定性映射套用到自己的輸出。模型訓練的雜訊範圍與取樣排程必須相符。
選讀:Consistency Models(見「論文導讀」)。邊界條件、蒸餾與直接訓練,以及一步和兩步結果的差異。
潛在一致性與引導
Latent Consistency Models(LCM)在預訓練自動編碼器的潛在空間進行一致性蒸餾 [10]、[11]。空間計算減少,但仍有編解碼成本與重建限制。去雜訊器轉為受引導潛在機率流的端點預測器。
一般無分類器引導結合有條件與無條件預測。LCM 將引導強度作為學生條件,蒸餾已引導的流,使每一步不必另做兩次去雜訊預測。可用引導範圍取決於訓練;蒸餾與原管線的相同引導數字,也可能因慣例和參數化而代表不同效果。
LCM 的 skipping-step 配對跨越較遠的時間間隔,強化有限跳躍的端點目標,但仍依賴教師與訓練排程。一步可能比兩步或四步差;支援單步推論,不代表一步永遠是最佳設定。
選讀:Latent Consistency Models(見「論文導讀」)。引導端點參數化、跨步配對與原文的解析度別實驗。
先拉直路徑再蒸餾
白話說。 教師的路線比較不繞,學生就較容易學完整動作。Reflow 先改變路徑,再以端點迴歸壓縮它。
Rectified Flow [12] 以端點配對的內插訓練瞬時速度。每輪 reflow 先抽取雜訊 ,沿目前的流到達 ,再以這些有耦合關係的 訓練下一個流,而非任意獨立配對雜訊和資料。目標為:
此處時間從雜訊端的 0 增加到資料端的 1; 是瞬時速度, 是前一模型的端點映射。它與前面實驗的雜訊尺度方向不同,必須明示慣例,避免正負號反轉。
理想 reflow 在假設成立時具分布保留與傳輸成本性質;有限網路和近似取樣仍會引入誤差。一輪 reflow 不保證所有軌跡都筆直,也可能仍需多次 Euler 評估。InstaFlow [13] 特別區分此階段與後續的單步端點蒸餾。
端點學生可最小化 ; 是文字條件, 是重建或感知距離。Reflow 改變配對並在理想情況保留邊際分布,端點迴歸再近似改變後的映射,兩者並非同一目標。
選讀:InstaFlow(見「論文導讀」)。直接蒸餾、單步 reflow,以及先 reflow 再蒸餾,為什麼結果不同。
加入寫實度訊號
白話說。 模仿教師終點也可能複製教師錯誤。判別器補上另一種訊號:輸出是否像目標資料?它能改善外觀,但仍須穩定訓練並檢查多樣性。
Adversarial Diffusion Distillation(ADD)結合預訓練學生、凍結擴散教師與判別器 [14]。擴散蒸餾項把學生輸出拉向教師去雜訊目標;對抗項則在預訓練特徵空間獎勵寫實外觀。教師與判別器用於訓練,部署時不必再執行迭代教師取樣。
一般生成器的對抗項可含 ,其中 提供真實感分數, 是學生。判別器以自己的損失與正規化分辨真實、生成樣本;此分數不是影像真實或符合提示詞的校準機率。
ADD 可在訓練過的少數雜訊程度間細化。LADD [15] 把對抗蒸餾移到潛在擴散特徵,減少訓練時反覆解碼像素及執行大型影像特徵編碼器的需求。比較成本時,要分別計入訓練的教師、判別器與特徵抽取,以及推論的最終解碼器。
對抗與擴散損失都不自動保證多樣性。檢查不同種子的構圖、罕見概念與重複紋理;低 FID 仍可能伴隨條件覆蓋不足。實際資料、提示詞如何進入判別器與訓練穩定性,也都是比較條件。
選讀:ADD(見「論文導讀」)。兩種訊號、初始化消融,以及一步和四步偏好結果的區別。
匹配分布,而非每個指定終點
白話說。 學生可以學著產生正確的一整群影像,不必每個雜訊種子都複製教師的同一張圖。但學生一直變動,訓練也必須持續估計它目前的輸出分布。
DMD [16] 訓練單步生成器,使用兩個擴散分數估計:凍結模型描述教師定義的目標分布;另一模型追蹤學生目前的輸出分布。在相同雜訊程度下,兩者的分數差提供把生成樣本移向目標的方向。
令 、,代表性的更新形式為:
是生成器的隨機輸入, 是條件, 是新抽取的高斯雜訊, 是加雜訊係數; 是分數函數, 是訓練權重。此式簡寫回傳生成器參數的向量—Jacobian 乘積。它使用近似分數與時間權重,並非直接、精確計算影像密度的 KL 散度。
為什麼需要學生分數?只追隨目標分數可能把樣本推往少數吸引模態;分數差也考量學生已經放了多少機率質量。為什麼加雜訊?乾淨分布可能幾乎不重疊,加雜訊提供較平滑的比較空間。為什麼另訓練分數網路?學生更新後,其分布也變了,凍結教師無法描述它。
原始 DMD 另以教師產生的雜訊—影像配對做迴歸,維持穩定與覆蓋,因此並非完全沒有軌跡目標。SwiftBrush 的變分分數蒸餾與 SiD 的分數恆等式目標 [17]、[18] 相關,但目標、權重與資料需求不同,不能視為同一公式的相同實作。
DMD2 改變了什麼
DMD2 [19] 移除離線端點迴歸資料集,增加學生分數網路相對於生成器的更新頻率,並加入真實影像的對抗學習,以修正教師目標的偏差。圖中標為「real」的教師分數仍是近似,並非直接取得真實資料密度。
多步學生訓練也模擬自己的中間取樣狀態,減少教師加雜訊輸入與實際學生路徑不符的問題。大型模型的四步成績不能當成相同模型的一步成績;表格每列都要連同骨幹、引導、步數與評估規則一起讀。
選讀:DMD、DMD2(見「論文導讀」)。分數網路、迴歸取捨、更新頻率消融與多步輸入模擬。
直接學習有限跳躍
白話說。 網路可以學「這段時間要移動多遠」,不只學「現在往哪裡走」。輸入與目標改變後,就能不靠獨立教師,直接訓練大步長模型。
Shortcut 模型
Shortcut 模型 [20] 以指定區間 為條件,預測正規化位移 ,更新為 。 時用流匹配速度目標提供基礎;較長區間則要求一次長跳符合兩次連續短跳:
是目前時間, 是短區間長度。第二項必須在更新後的位置與時間評估;以停止梯度的短跳目標訓練長跳。如果仍使用原時間,就改變了目標。
流監督避免只靠任意自我一致性。模型可在同一訓練階段混合局部目標與自舉長跳。「無獨立教師」仍有自我目標、訓練成本與近似誤差;大步品質受容量與短跳目標準確度限制。
MeanFlow 的平均速度
MeanFlow [21] 區分區間平均速度與端點的瞬時速度。以資料到雜訊的時間慣例定義:
, 是流上的狀態, 是瞬時速度, 是同一軌跡的區間平均速度。積分效果不能用一次 評估取代;模型要直接學會這個平均效果。
固定 ,沿路徑微分該定義,可得:
這裡是沿狀態變動的全微分。訓練透過 Jacobian—向量乘積(JVP)及停止梯度目標計算,不必實體化整張影像的 Jacobian。流匹配建構用來替代未知邊際速度目標;它學的量與「放大 Euler 步長」不同。
模型必須表示起始與終止時間。當 ,平均速度趨近瞬時速度;完整區間則由一次平均速度預測給出整段位移。理想恆等式只啟發目標,有限網路仍是近似。原文 JVP 消融也顯示,對哪些變數微分會實質影響結果。
完整評估速度與品質的取捨
白話說。 快速輸出仍必須完成原本任務。生成分布、條件、多樣性與總成本要一起評估。
步數、評估次數與時間
取樣一步是一次狀態更新;網路函數評估次數(NFE)計算網路執行。求解器每步可能多次評估,無分類器引導也可能各做有條件與無條件預測。把兩者合批雖只呼叫一次 API,仍處理雙倍樣本。應清楚說明計數慣例。
完整延遲包含文字編碼、條件抽取、生成/去雜訊、解碼及後處理。分開模型載入與穩態推論,固定硬體、精度、解析度、批次大小與同步方式。單次執行的大模型也可能超過記憶體預算。
已蒸餾進學生的引導是系統加速的一部分,但要報告可用範圍。若快取提示詞嵌入,也須明示;拿有快取的學生與沒有快取的教師比較,並非只測蒸餾效果。
品質、符合度與多樣性
FID [22] 比較影像特徵分布的平均與共變異數,不比較成對影像,也不直接檢查提示的關係是否成立。特徵模型、參考切分、樣本數與縮放都影響分數;FID-5k 與 FID-30k 是不同規則。
CLIP 類分數 [23] 比較影像與文字嵌入,實作的正規化、尺度及骨幹可能不同。0.3 與 30 可能只是縮放慣例。GenEval [24] 以結構化規則檢查物件、數量、顏色與關係,補足分布指標和人類評估,而非取代它們。
多樣性要跨提示詞檢查,也要固定提示詞、改變種子。模型可能涵蓋許多類別,卻每個提示都只畫一種構圖;反過來,變化很多也可能是忽略提示。保留隨機輸入不保證模型有善用它。
正確閱讀基準表格
CIFAR-10、類別條件 ImageNet、文字條件 COCO [25]、[26]、[27] 回答不同問題。低解析度無條件成績,不代表高解析度提示遵循能力;四步成績也不是一步的操作點。
比較時記錄任務、骨幹與初始化、資料與教師、解析度、引導、NFE、總延遲與記憶體、分布品質、條件符合度、多樣性及有限樣本不確定性。個別元件的因果主張,優先看同篇論文的控制消融;跨論文數字無法排除資料、架構與訓練預算的差異。
失敗模式與方法選擇
白話說。 加速會轉移工作與假設,不會讓它們消失。先決定哪些行為必須保留,再挑目標。
- 固定種子要有相同終點: 可先考慮軌跡或端點迴歸;它保留特定耦合,也可能複製教師缺陷。
- 需要彈性步數: 一致性、shortcut 與區間條件模型支援多種預算,但須遵循訓練好的取樣程序。
- 要改變分布,不要求逐樣本配對: 分布匹配提供自由度;注意輔助分數落後、模態遺漏與穩定性。
- 重視感知外觀: 對抗項可能有幫助,仍須評估多樣性與條件符合度。
- 不能使用預訓練教師: 直接一致性、shortcut 或平均速度訓練可符合條件;仍要比較總訓練成本。
單步模型可能繼承偏差、遺失罕見概念、過度擬合評估提示詞,或在蒸餾後改動控制時失敗。分布目標與自我目標也可能遇到分數不準、目標崩潰、邊界條件不良及訓練/測試輸入不匹配。窄範圍時間或引導訓練的模型,並非教師的通用替代品。
現代觀點
白話說。 研究逐漸轉向:有限推論預算下,應該學哪一種量?不同改進並不一定都在近似同一個去雜訊步驟。
Fan 等人的蒸餾綜述 [4] 區分保真/輸出目標、軌跡方法及對抗方法,幫助辨識學生的監督與教師保留部分;類別並不互斥,例如 DMD2 同時使用分布和對抗訊號。Yang 等人的擴散綜述 [28] 將高效率取樣放在整體模型與應用中;流匹配指南 [2] 則從傳輸角度區分局部速度、端點耦合及數值積分。
2023–2025 年的一致性、reflow、對抗與分布匹配,形成不同的少步影像生成路徑。Shortcut 與 MeanFlow [20]、[21] 另展示直接學有限跳躍的路線;類別條件基準不能直接外推為大型文字生成系統的能力。2026 年 DMAD 預印本 [29] 探討對抗分布匹配,避免另維護持續更新的學生分數網路;比較時要保留其預印本身分及較廣的視覺生成設定。
開放問題包括罕見模態、組合控制、蒸餾後的編輯能力、超越特徵分布摘要的評估、訓練成本,以及跨解析度/領域轉移。復原任務還要求輸出符合特定觀測;單步超解析度 將加入這個限制。
重點整理
- 有限跳躍需要端點或位移目標,不只是把局部方向使用一次。
- 區分求解器誤差、學得模型誤差與訓練/測試不匹配。
- 軌跡迴歸保留選定的耦合,分布匹配則可學到不同耦合。
- 一致性需要邊界錨定,重流則在壓縮步數前改變耦合。
- 分布、對抗與平均速度目標提供不同監督,也有不同估計難題。
- 比較品質、提示遵循與多樣性時,同時比較完整流程延遲及網路評估次數。
練習
- 精確場與求解器誤差。 固定分數評估次數,比較非均勻與均勻雜訊尺度網格。哪些位置應放較多點?答案是否取決於起始尺度?
提示
觀察軌跡彎曲及成分歸屬急遽變化之處,從相同起點比較終點 RMSE。調整網格可以改善求解器,沒有改變分數函數;不能用特定起點調好網格後,就宣稱普遍最優。
- 端點還是分布? 對稱高斯 下,比較 與 的期望成對平方差與輸出機率。哪一種目標分得出兩者?
提示
除零機率邊界外,兩輸出相差 2,平方差為 4;兩者都各以二分之一機率輸出兩個模態。理想邊際分布比較無法分辨,配對迴歸可以。
- 錯誤的 shortcut。 在兩次短跳公式中,把第二個時間 改為 。即使更新了位置,為什麼也不再是相同一致性關係?
提示
向量場也隨時間變化。例如純量場 ,兩次方向的差異完全來自時間推進。第二跳仍問原時間,就問錯了區間。
- 計算整條管線。 教師每次更新做兩次去雜訊預測,共 20 次更新;學生已蒸餾引導,共四次更新。兩者都各做一次文字編碼與解碼。求去雜訊評估比,說明實際時間比為何不同。
提示
教師與學生分別為 40 與 4 次,比值 10。共同編解碼成本、批次效率、精度與記憶體行為都會改變時間比,應先建立含固定成本的模型。
- 可疑的進步。 學生 FID 較低,但提示關係正確率下降、不同種子輸出幾乎相同。在接受其保留教師品質前,提出三項檢查。
提示
檢查固定提示的種子多樣性、保留提示集的物件及關係條件,並以相同樣本數與參考切分重做分布評估。單一彙總統計無法確定條件覆蓋。
參考文獻
- Y. Song, J. Sohl-Dickstein, D. P. Kingma, A. Kumar, S. Ermon, B. Poole, “Score-Based Generative Modeling through Stochastic Differential Equations,” ICLR, 2021. paper
- Y. Lipman, M. Havasi, P. Holderrieth, et al., “Flow Matching Guide and Code,” arXiv tutorial, 2024. paper
- T. Karras, M. Aittala, T. Aila, S. Laine, “Elucidating the Design Space of Diffusion-Based Generative Models,” NeurIPS, 2022. source
- X. Fan, Z. Wu, H. Wu, L. Cao, “A Survey on Pre-Trained Diffusion Model Distillations,” arXiv preprint, version 2, 2025. paper
- J. Song, C. Meng, S. Ermon, “Denoising Diffusion Implicit Models,” ICLR, 2021. paper
- C. Lu, Y. Zhou, F. Bao, J. Chen, C. Li, J. Zhu, “DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 Steps,” NeurIPS, 2022. paper
- T. Salimans, J. Ho, “Progressive Distillation for Fast Sampling of Diffusion Models,” ICLR, 2022. paper
- Y. Song, P. Dhariwal, M. Chen, I. Sutskever, “Consistency Models,” ICML, 2023. paper
- Y. Song, P. Dhariwal, “Improved Techniques for Training Consistency Models,” ICLR, 2024. paper
- S. Luo, Y. Tan, L. Huang, J. Li, H. Zhao, “Latent Consistency Models: Synthesizing High-Resolution Images with Few-Step Inference,” arXiv preprint, 2023. paper
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. source
- X. Liu, C. Gong, Q. Liu, “Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow,” ICLR, 2023. paper
- X. Liu, X. Zhang, J. Ma, J. Peng, Q. Liu, “InstaFlow: One Step is Enough for High-Quality Diffusion-Based Text-to-Image Generation,” ICLR, 2024. paper
- A. Sauer, D. Lorenz, A. Blattmann, R. Rombach, “Adversarial Diffusion Distillation,” ECCV, 2024. paper
- A. Sauer, F. Boesel, T. Dockhorn, A. Blattmann, P. Esser, R. Rombach, “Fast High-Resolution Image Synthesis with Latent Adversarial Diffusion Distillation,” SIGGRAPH Asia Conference Papers, 2024. paper · published version
- T. Yin, M. Gharbi, R. Zhang, E. Shechtman, F. Durand, W. T. Freeman, T. Park, “One-step Diffusion with Distribution Matching Distillation,” CVPR, 2024. paper
- T. H. Nguyen, A. Tran, “SwiftBrush: One-Step Text-to-Image Diffusion Model with Variational Score Distillation,” CVPR, 2024. paper
- M. Zhou, H. Zheng, Z. Wang, M. Yin, H. Huang, “Score identity Distillation: Exponentially Fast Distillation of Pretrained Diffusion Models for One-Step Generation,” ICML, 2024. paper
- T. Yin, M. Gharbi, T. Park, R. Zhang, E. Shechtman, F. Durand, W. T. Freeman, “Improved Distribution Matching Distillation for Fast Image Synthesis,” NeurIPS, 2024. paper
- K. Frans, D. Hafner, S. Levine, P. Abbeel, “One Step Diffusion via Shortcut Models,” ICLR, 2025. paper
- Z. Geng, M. Deng, X. Bai, J. Z. Kolter, K. He, “Mean Flows for One-step Generative Modeling,” NeurIPS, 2025. paper
- M. Heusel, H. Ramsauer, T. Unterthiner, B. Nessler, S. Hochreiter, “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” NeurIPS, 2017. source
- A. Radford, J. W. Kim, C. Hallacy, et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML, 2021. paper
- D. Ghosh, H. Hajishirzi, L. Schmidt, “GenEval: An Object-Focused Framework for Evaluating Text-to-Image Alignment,” NeurIPS Datasets and Benchmarks, 2023. paper
- A. Krizhevsky, V. Nair and G. Hinton, “CIFAR-10 and CIFAR-100 datasets,” official dataset page; companion technical report: A. Krizhevsky, “Learning Multiple Layers of Features from Tiny Images,” 2009. dataset and report
- J. Deng, W. Dong, R. Socher, L. Li, Kai Li, Li Fei-Fei, “ImageNet: A large-scale hierarchical image database,” CVPR, 2009. doi
- T. Lin, M. Maire, S. Belongie, et al., “Microsoft COCO: Common Objects in Context,” ECCV, 2014. paper
- L. Yang, Z. Zhang, Y. Song, et al., “Diffusion Models: A Comprehensive Survey of Methods and Applications,” ACM Computing Surveys, 2023. paper
- Z. Yu, J. Yuan, H. Yang, et al., “DMAD: Distribution Matching as Adversarial Distillation for Fast Visual Generation,” arXiv preprint, 2026. paper
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018, pp. 586–595. doi · arXiv
- C. Schuhmann, R. Beaumont, R. Vencu, et al., “LAION-5B: An open large-scale dataset for training next generation image-text models,” NeurIPS Datasets and Benchmarks, 2022. paper
檢查理解
本篇有 5 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 13・世界模型:影片、潛在動態與規劃 · 26 分鐘