DLCV 10・影像融合:互補來源與有用輸出
先備知識:DLCV 09・深度影像復原:低階視覺、IP 07・小波與其他影像轉換
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
同一個場景的兩張照片,各自在不同區域是清晰的。把它們取平均,或逐像素選取局部細節較多的那一張,並以全清晰的真實影像評分。
你將學到
- 定義紅外線—可見光、多焦點或多曝光融合需要保留的資訊。
- 比較平均、決策圖、品質加權與多尺度混合。
- 理解缺少目標影像時,損失如何定義學得的融合結果。
- 評估配準假設與下游任務目標。
- 解讀互相衝突的融合指標,並檢查典型偽影。
先看全貌
許多相機看同一個場景的方式各不相同。熱像儀在黑暗中看得到人,卻看不到他身後牆面的紋理。對焦在前景的鏡頭會把背景拍糊。短曝光保住天空,卻丟了陰影。影像融合(image fusion)取兩張或更多這樣的影像,合成一張保留各自優點的影像。
為什麼重要:
- 夜間駕駛、監視與搜救會同時使用可見光與熱像相機。駕駛或操作員只看一個螢幕,所以兩種畫面必須合成一張,同時顯示溫暖的行人與路面標線。
- 攝影也會用到融合。 一組包圍曝光可以合成一張同時有明亮窗戶與昏暗房間的照片;焦點堆疊讓微距與顯微鏡照片從前到後都清楚。
- 融合在影像任務中很特別:沒有正確答案可以照抄。 沒有人擁有一張同時是熱像又是可見光的影像。光是這一點,就決定了整個領域:方法怎麼設計、網路怎麼訓練,以及評估為什麼這麼難。
本篇建立在前面兩篇之上。DLCV 09 用一段文字把影像融合放進復原的分類中;這裡才完整講它。IP 07 建立了小波融合會用到的小波轉換;本篇補上 IP 07 沒有涵蓋的拉普拉斯金字塔。至於一般的無參考影像品質評估,請見 DLCV 09;這裡只談融合特有的指標。
什麼是影像融合
白話版。 融合把同一場景的互補觀測整合成一張影像,須先定義輸出應保留各來源的哪些資訊。
精確版。 給定 張尺寸為 且已對位的來源影像 ,融合方法是一個映射
是融合影像, 是通道數(灰階為 1、彩色為 3), 是人工設計或學得的融合規則。「已配準」表示各來源的同一像素位置 對應場景中的同一點。許多傳統方法會對像素或轉換係數做加權組合;在像素域中,例如:
是來源 在像素 的權重。這個凸組合模型適用於許多像素混合規則,但一般學習式解碼器不必受限於來源的逐像素值域。遙測融合也可能輸出多波段資料立方體,形狀與輸入不同。
本篇談的是輸出影像的像素層級融合 [1]。另一條路是把兩個來源都餵給網路,只在決策層級合併,這樣可以把某一項任務做得很好,但就拿不到人可以直接看、其他任務也可重複使用的融合影像了 [2]。深度融合網路介於兩者之間:它在網路內部合併特徵,但最後仍輸出像素。
三項任務
本篇的三項任務,差別在於每個來源各提供什麼、對位有多難,以及是否可能有真值(圖 1)。
| 紅外線—可見光 | 多焦點 | 多曝光 | |
|---|---|---|---|
| 來源 | 兩種感測器的熱影像(長波紅外線)與可見光影像 | 同一相機在不同對焦距離拍攝兩張以上影像 | 同一相機以不同曝光時間拍攝兩張以上影像 |
| 各來源的貢獻 | 紅外線:適當條件下的熱對比;可見光:反射光的紋理、顏色與細節 | 各張照片中清晰的區域 | 長曝光的暗部與短曝光的亮部 |
| 常見規則 | 保留紅外線的顯著熱目標與可見光紋理 | 逐區域選擇最清晰的來源 | 以偏好曝光適當且有細節的權重混合 |
| 對齊 | 困難:鏡頭、解析度與外觀不同 | 相機與場景靜止時較容易 | 靜態場景較容易;移動物體會產生鬼影 |
| 真值? | 沒有 | 僅合成資料有,例如把清晰影像模糊化 | 沒有;色調映射後的 HDR 只是可能參考,並非唯一答案 |
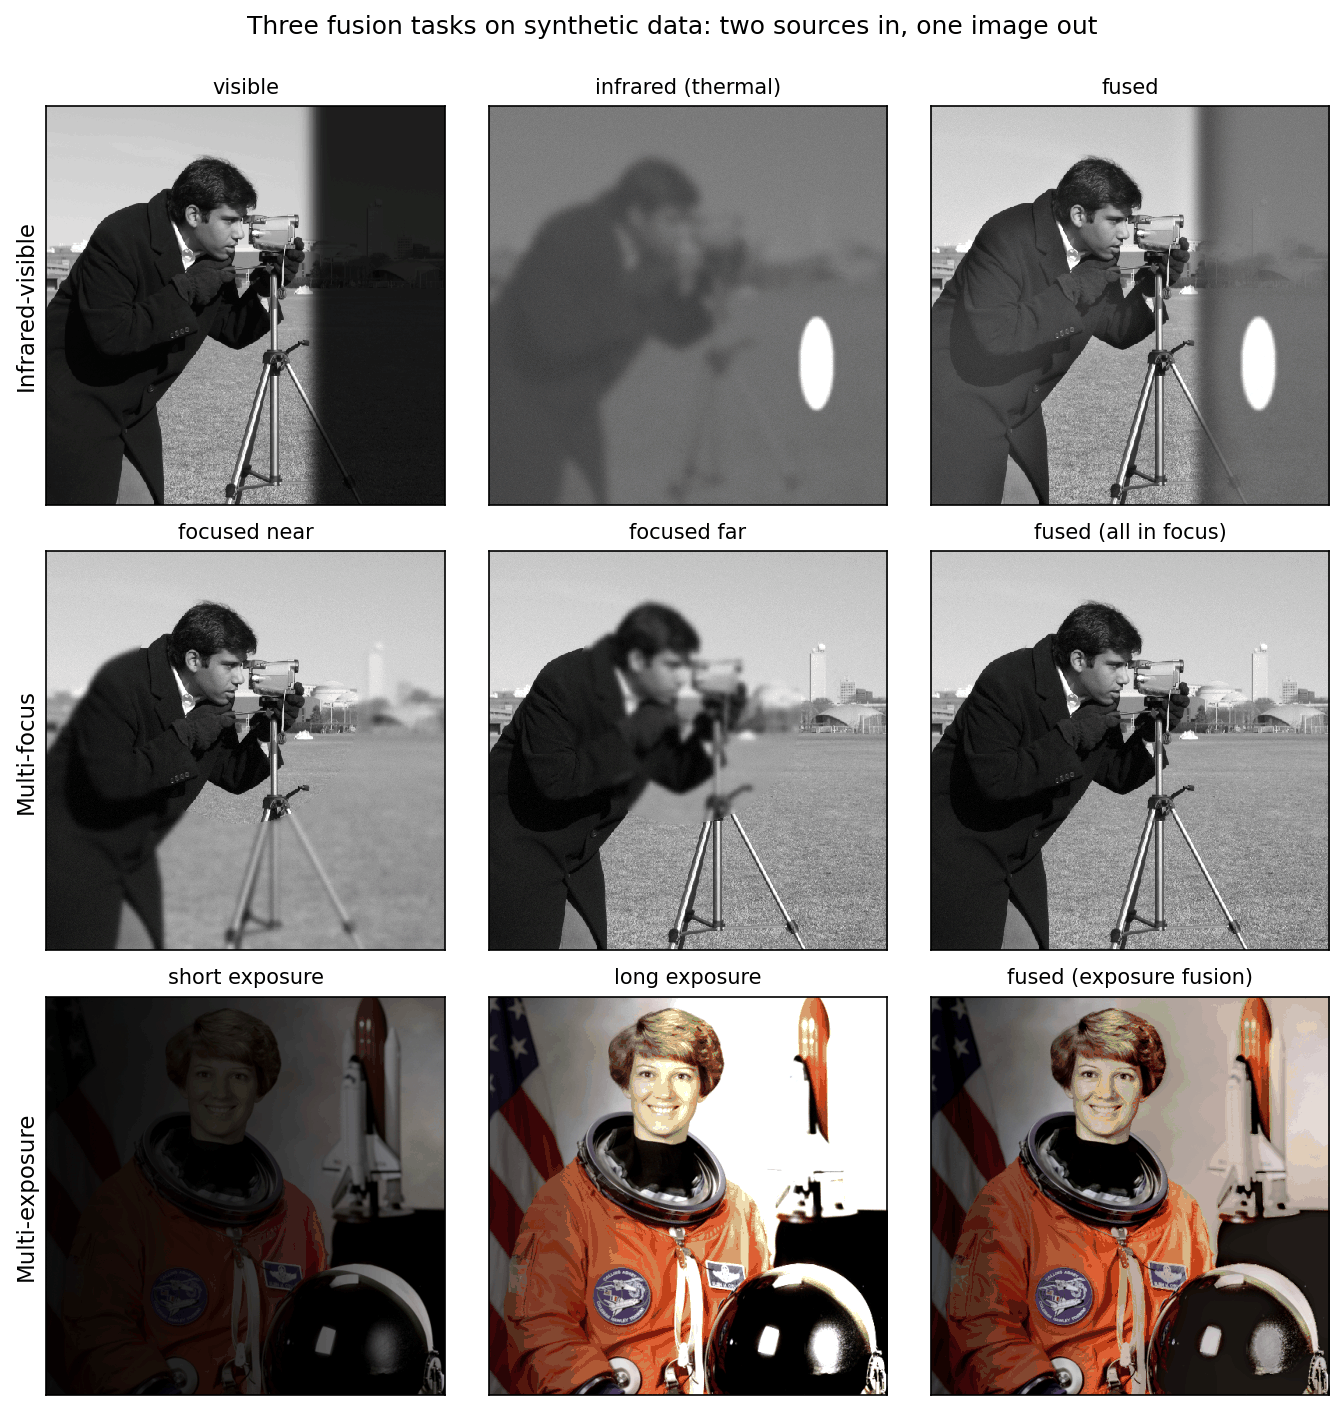
紅外線—可見光融合。 熱相機量測紅外線輻射,受溫度、放射率與反射輻射影響。熱對比足夠的目標可在黑暗中突出,但可見程度仍取決於溫差、大氣與感測器。可見光相機量測反射光,能呈現符合人眼習慣的紋理細節,但暗處訊號很少 [3]、[2]。融合希望同時突顯熱目標與保留背景細節。然而「各取所長」不是唯一規則:同一像素無法同時像熱目標那麼亮,又像可見光陰影那麼暗。
多焦點融合。 鏡頭景深有限,某距離清晰,更近與更遠的物體則模糊。把不同對焦設定的照片融合,可形成全對焦影像,也稱焦點堆疊或延伸景深。若至少一個來源含有所需的清晰證據,來源選擇可近似這個理想。但在深度邊界,真實散焦可能同時污染兩個來源,兩者都未必正確。因此多焦點方法常採取選擇,而非直接平均。
多曝光融合(multi-exposure fusion, MEF)。 相機感測器一次曝光只能記錄有限的亮度範圍,一組包圍曝光則涵蓋較寬的範圍。傳統做法是高動態範圍(high-dynamic-range, HDR)成像:從這組照片還原相機響應與場景輻射量 [4],再用色調對應(tone mapping)運算子壓縮成可顯示的影像。多曝光融合跳過輻射量這一步,直接把 8 位元的曝光混合成一張曝光良好的 8 位元影像 [5]。它不需要相機校正,速度也快;代價是輸出只是一張好看的照片,不是物理量測。
醫學與遙測融合的問題不同
上述三種攝影任務並未涵蓋整個領域;輸出的通道數與物理意義也可能改變。
| 情境 | 互補證據 | 期望輸出 | 主要檢查 |
|---|---|---|---|
| 醫學多模態融合 | CT 呈現衰減相關結構;MRI 提供不同組織對比;PET/SPECT 呈現示蹤劑分布 | 結合解剖與功能資訊的顯示影像,或特定任務的特徵 | 解剖對齊與模態特有證據的保留 |
| 全色銳化 | 高空間解析度的寬波段全色影像,加上較粗的多光譜波段 | 更細網格上的多光譜資料 | 空間細節與光譜保真 |
| 高光譜—多光譜融合 | 粗解析度的多個窄波段,加上細解析度的少數寬波段 | 更高空間解析度的高光譜立方體 | 同時符合兩個感測器的空間與光譜量測 |
U2Fusion 的 PET–MRI 評估 [32] 與 DDFM 的 CT/MRI、功能影像實驗 [41] 都涉及醫學情境。不能只把它視為「複製較亮的像素」,因為各模態的亮度意義不同。顯示融合也不會完整保留兩來源的定量值;量測時須保留原始資料,診斷效益則須透過合適的任務研究檢驗。
遙測融合常估計多波段影像,而非一張悅目的灰階圖 [54]。簡化的觀測模型可說明差異:
是未知的高解析度立方體,含 個窄光譜波段。 對各波段施加空間模糊, 降採樣, 為粗解析度高光譜觀測。 依光譜響應把窄波段混為較少的多光譜波段,產生 ; 是量測誤差。真實模型還須處理校準、配準與可能隨波段改變的模糊。
全色銳化的高解析度觀測只有一個寬波段。注入細節時須考慮其光譜響應,不能直接假設它等於多光譜通道的平均。全解析度下通常沒有目標立方體真值;可透過降低現有資料解析度建立參考實驗,但結論取決於合成退化是否符合真實感測器。
這些任務與攝影融合共享特徵擷取、組合的概念,卻需要不同損失與評估。紅外線—可見光測試並不等於醫學或光譜重建驗證。「通用融合」須說清楚:通用的是架構、分別訓練的模型,還是跨任務共用的一個檢查點。
影像對位:一切方法的前提
白話版。 融合是逐像素比較來源影像的,所以同一個像素必須在每個來源中都對應同一個點。如果有一張影像偏移了幾個像素,每條邊緣都會出現兩次。
配準估計來源間的幾何轉換,將它們扭曲到共同網格;動態場景則涉及稠密運動估計,見 DLCV 09A.3。腳架可減少誤差,但焦點變化、鏡頭畸變與移動物體仍可能需要配準。紅外線—可見光的視角、像素分布與解析度不同,精準配對不易取得,而多數融合方法仍需要逐像素對齊的來源 [3];現有基準也多採對齊影像 [2]。深度學習段落末尾會再談放寬此假設的方法。
最簡單的規則:平均,以及它為什麼讓對比變淡
白話版。 把來源影像平均,每樣東西都保留了一點,但只出現在其中一個來源的東西,會以一半的強度出現。融合的全部難處,就是避免這件事。
精確版。 取兩張共用背景 的來源影像 與 ,並假設某個振幅為 的特徵(邊緣、紋理、溫暖的目標)只出現在 中:,,其中 是特徵的形狀。平均是
所以特徵的對比減半。若有 個來源,而特徵只出現在其中一個,它會降到 。在多焦點融合中情況更糟:模糊的來源會多加上一份模糊的邊緣副本,所以平均後看到的是一條銳利的邊緣外圍帶著柔軟的暈。在紅外線與可見光融合中,在紅外線中很亮、在可見光中很暗的目標,最後會變成灰色(圖 6,最後一欄)。在多曝光融合中,把曝光不足與曝光過度的兩張平均,得到的是一張平淡、低對比的影像。
解法是讓權重 取決於每個來源在哪裡有資訊:清晰的來源、溫暖的目標、曝光良好的像素,都給高權重。傳統方法這幾節要談的,就是怎麼衡量「有資訊」,以及怎麼改變權重而不產生接縫。
多焦點融合:對焦測度與決策圖
白話版。 清晰的區域有強烈的細微細節,模糊的區域沒有。在每張照片的每個像素周圍衡量細節量,挑細節最多的那張,複製它的像素。
精確版。 對焦測度(focus measure) 為來源 在像素 周圍有多少高頻細節打分數。一個簡單的選擇,屬於傳統多焦點融合常用的一類 [5],是拉普拉斯的局部能量,
其中 是來源的拉普拉斯(一種二階導數濾波器,見 IP 03),平方使它成為能量, 表示用標準差為 的高斯平滑,把能量在鄰域內取平均。模糊會去掉高頻,所以對焦來源的 較大。決策圖(decision map)記錄勝出者,
其中 是像素 所選來源的索引。
原始的決策圖是有雜訊的:在平坦區域(天空、素色牆面),沒有任何來源有細節,勝負由雜訊決定。有兩個標準的後處理步驟。清理(cleaning)移除小島,例如用多數決(中值濾波器)或形態學運算,假設對焦區域大而且相連。** 柔化**(softening)在二值圖的邊界附近稍微模糊一下,讓從一個來源切換到另一個來源時不留下明顯的接縫。
下面的程式碼用 camera 測試影像建立一組合成影像對:圓盤內 A 張是清晰的,圓盤外 B 張是清晰的,散焦以高斯模糊建模。因為模糊是我們自己做的,所以我們有全對焦的真值,可以量 PSNR;真實的多焦點影像對是辦不到的。
程式碼 · Python · 30 行
import numpy as np
from scipy import ndimage as ndi
from skimage import data, img_as_float
from skimage.metrics import peak_signal_noise_ratio as psnr

rng = np.random.default_rng(0)
x = img_as_float(data.camera())                       # 512 x 512: the all-in-focus "truth"
yy, xx = np.mgrid[:512, :512]
near = (yy - 200) ** 2 + (xx - 250) ** 2 < 150 ** 2   # the part that is in focus in shot A
blurred = ndi.gaussian_filter(x, 3.0)                 # defocus modeled as a Gaussian blur
A = np.where(near, x, blurred) + 0.01 * rng.standard_normal(x.shape)  # sharp inside the disk
B = np.where(near, blurred, x) + 0.01 * rng.standard_normal(x.shape)  # sharp outside it

def focus_measure(img, s=2.0):
    """Local energy of the Laplacian: large where the image has sharp detail."""
    return ndi.gaussian_filter(ndi.laplace(img) ** 2, s)

raw = focus_measure(A) > focus_measure(B)                # decision map: True = take A
clean = ndi.median_filter(raw.astype(float), 31) > 0.5   # majority vote removes small islands
w = ndi.gaussian_filter(clean.astype(float), 2.0)        # soften the seam a little

results = {"average": (A + B) / 2,
           "raw decision map": np.where(raw, A, B),
           "cleaned, soft map": w * A + (1 - w) * B}
for name, F in results.items():
    print(f"{name:18s} PSNR = {psnr(x, np.clip(F, 0, 1), data_range=1):.2f} dB")
textured = ndi.gaussian_filter(np.abs(ndi.laplace(x)), 2) > 0.01   # where the choice matters
for name, m in [("raw", raw), ("cleaned", clean)]:
    print(f"{name:7s} map agrees with the true focus map on {np.mean(m == near):.1%} of all pixels, "
          f"{np.mean((m == near)[textured]):.1%} of textured pixels")
輸出
average            PSNR = 29.97 dB
raw decision map   PSNR = 39.22 dB
cleaned, soft map  PSNR = 39.81 dB
raw     map agrees with the true focus map on 80.9% of all pixels, 91.3% of textured pixels
cleaned map agrees with the true focus map on 91.2% of all pixels, 98.4% of textured pixels
決策圖比平均高出約 10 dB,因為它複製的是清晰的像素,而不是把它們和模糊的像素混在一起(圖 2)。清理讓決策圖忠實許多(在有紋理的像素上,一致率從 91.3% 提高到 98.4%),但 PSNR 只增加一點點,0.6 dB,因為原始決策圖的大部分錯誤出現在平坦區域,在那裡 A 與 B 本來就長得一樣。這些數字來自我們的玩具範例,不是來自任何論文。
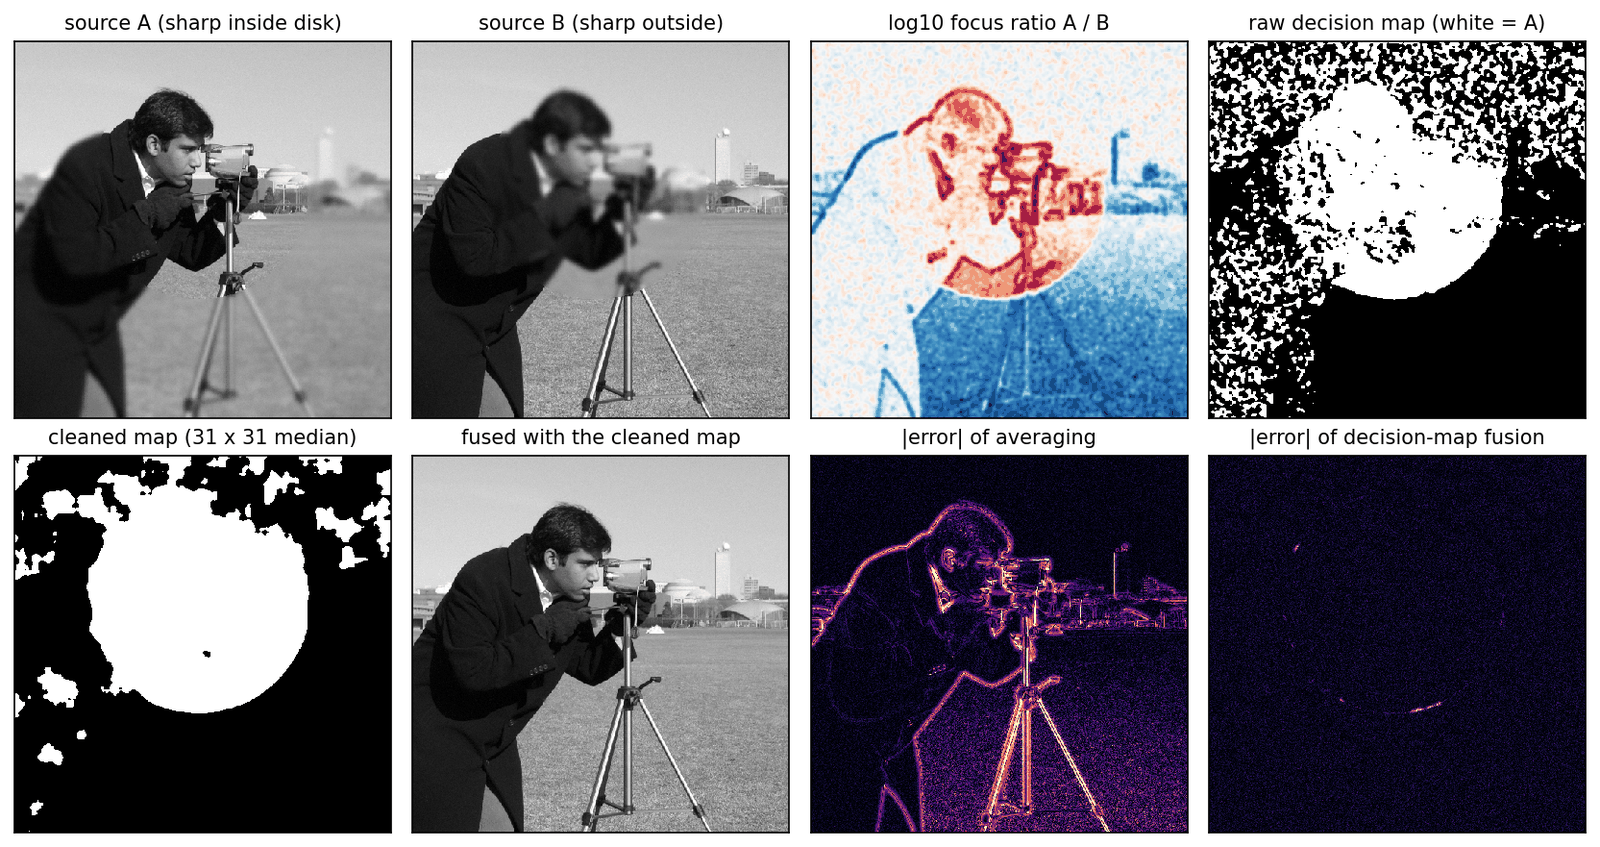
玩具範例隱藏了什麼。 真實的散焦不是把高斯模糊貼在遮罩上。在深度邊緣附近,對焦在遠處的那張照片裡,模糊的前景會擴散到背景上,所以那裡兩張都不清晰。這種散焦擴散效應(defocus spread effect)正是為什麼在模擬資料或常用的 Lytro 影像對上表現很好的方法,常在散焦強烈的真實照片上失敗 [6]、[7];圖 6 在我們玩具範例的分層版本上展示了這一點。
選讀:散焦擴散效應(見「補充資料」頁)。為什麼選擇在深度邊緣附近會失敗、分層散焦模型預測了什麼,以及方法如何因應。
多尺度融合:拉普拉斯金字塔與小波
白話版。 在多個尺度融合:選取有用細節,並平滑混合粗尺度亮度,以減少可見過渡。
拉普拉斯金字塔
精確版。 Burt 與 Adelson 的拉普拉斯金字塔(Laplacian pyramid)[8] 把影像表示成一疊帶通影像,加上一張小的低通殘差。令 ,並且
其中 用一個小的低通核做模糊,再每隔一列、每隔一行保留一個(OpenCV 的 pyrDown), 以 2 倍上取樣,並用同一個核內插(pyrUp), 是高斯金字塔(Gaussian pyramid)第 層(影像模糊後縮小的副本), 是拉普拉斯金字塔第 層,也就是 有、而更粗的一層沒有的細節。金字塔的頂端是殘差 。第 層的寬與高是影像的 倍。影像可以透過還原(collapse)精確地恢復:
而 。對任何 都能精確還原,因為每個 儲存的,正是 預測不到的部分。這個名稱來自作者的觀察:這種編碼等同於用許多尺度的拉普拉斯運算子對影像取樣 [8]。
選讀:建構與還原拉普拉斯金字塔(見「補充資料」頁)。核、奇數影像尺寸的大小處理、為什麼重建是精確的,以及該用幾層。
融合兩個金字塔
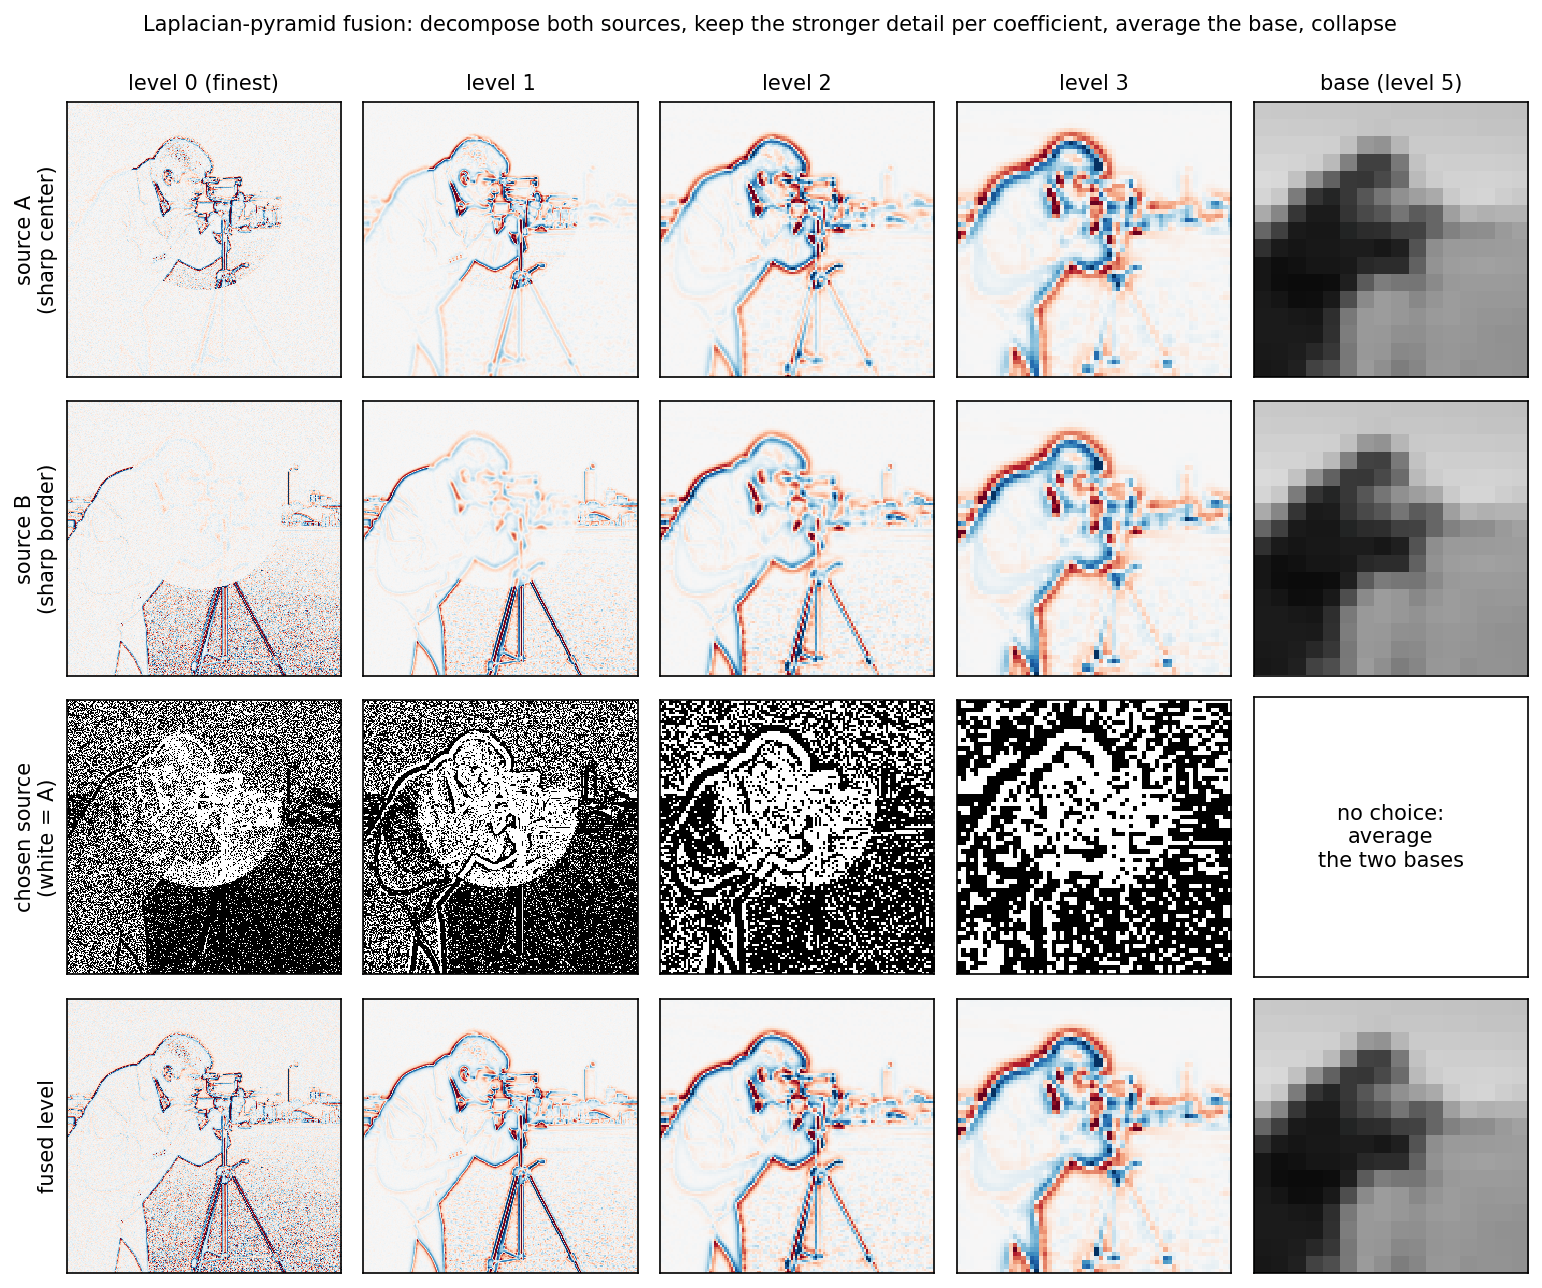
金字塔融合把每個來源分解,逐層合併金字塔,再還原結果。經典的金字塔融合選取來源中最顯著的拉普拉斯係數 [9]、[5];一個簡單的版本,規則分成兩部分:
其中 、 與 分別是來源 A、來源 B 與融合影像的金字塔第 層。取絕對值最大(max-abs)規則在每個位置與每個尺度,保留絕對值較大的係數,也就是較強的局部特徵;粗略的殘差取平均,因為它承載整體亮度,沒有哪個來源應該直接勝出。在每個尺度逐係數選擇,表示來源之間的切換會分散到金字塔濾波器的支撐範圍內,越粗的層範圍越寬;這正是 Burt 與 Adelson 為了把影像鑲嵌拼接而不留明顯接縫所提出的多解析度混合想法 [10]。Burt 與 Kolczynski 後來改良了金字塔融合,讓它對小幅位移與雜訊更穩健,也能處理顯著度相近但對比相反的特徵 [9]。
這段程式碼接續多焦點的範例(它用到 A、B、x 與 psnr)。
程式碼 · Python · 35 行
import cv2
import pywt

def laplacian_pyramid(img, levels=5):
    G = [img.astype(np.float32)]
    for _ in range(levels):
        G.append(cv2.pyrDown(G[-1]))                      # blur, then keep every 2nd pixel
    L = [G[i] - cv2.pyrUp(G[i + 1], dstsize=G[i].shape[::-1]) for i in range(levels)]
    return L + [G[-1]]                                    # band-pass details + coarse base

def collapse(L):
    img = L[-1]
    for detail in reversed(L[:-1]):
        img = cv2.pyrUp(img, dstsize=detail.shape[::-1]) + detail
    return img

def pick_stronger(p, q):
    return np.where(np.abs(p) >= np.abs(q), p, q)         # "max-abs" selection rule

def pyramid_fuse(a, b, levels=5):
    La, Lb = laplacian_pyramid(a, levels), laplacian_pyramid(b, levels)
    fused = [pick_stronger(p, q) for p, q in zip(La[:-1], Lb[:-1])]
    fused.append((La[-1] + Lb[-1]) / 2)                   # base: average the coarse level
    return collapse(fused).astype(float)

def wavelet_fuse(a, b, wavelet="db2", levels=4):
    ca, cb = pywt.wavedec2(a, wavelet, level=levels), pywt.wavedec2(b, wavelet, level=levels)
    fused = [(ca[0] + cb[0]) / 2]                         # approximation band: average
    for da, db in zip(ca[1:], cb[1:]):                    # (H, V, D) detail bands per level
        fused.append(tuple(pick_stronger(p, q) for p, q in zip(da, db)))
    return pywt.waverec2(fused, wavelet)

print(f"pyramid reconstruction error: {np.abs(collapse(laplacian_pyramid(A)) - A).max():.1e}")
for name, F in [("Laplacian pyramid", pyramid_fuse(A, B)), ("wavelet (db2)", wavelet_fuse(A, B))]:
    print(f"{name:18s} PSNR = {psnr(x, np.clip(F, 0, 1), data_range=1):.2f} dB")
輸出
pyramid reconstruction error: 5.9e-08
Laplacian pyramid  PSNR = 37.60 dB
wavelet (db2)      PSNR = 36.43 dB
重建誤差約為 ,是單精度的捨入誤差:金字塔本身是無損的。金字塔融合比平均高出 7 dB 以上,但仍比決策圖低約 2 dB。原因從圖 3 可以看出:逐係數的選擇有雜訊,尤其在細層,模糊來源的雜訊有時會在平坦區域勝出。改成比較平滑後的係數能量,而不是單一係數,也就是 Li 等人 [11] 的「區域式」(area-based)選擇,可以補上大部分差距(練習 3)。一般性的教訓是:當真正的答案是一種選擇(多焦點)時,空間上連貫的決策勝過逐係數的決策。
小波融合
小波融合遵循相同的計畫,只是用 IP 07 的離散小波轉換取代金字塔:分解兩個來源,在水平、垂直與對角的每個頻帶保留較強的細節係數,近似頻帶取平均,然後反轉換。Li、Manjunath 與 Mitra [11] 提出這個做法,使用區域式取最大規則(在小視窗內比較活動量,而不是單一係數),以及一致性驗證(consistency verification)步驟,讓係數跟隨其鄰居的選擇;他們主張小波轉換的緊緻性、正交性與方向選擇性,使它比拉普拉斯金字塔更適合。在我們的玩具範例中,簡單的逐係數規則得到 36.43 dB,比金字塔低約 1 dB。一個已知的弱點是,抽樣式小波轉換不具位移不變性:把影像移動一個像素,係數就變了,所以逐係數的決策也可能跟著改變。更好的位移不變性,也是 Burt 與 Kolczynski 改良金字塔融合的目標之一 [9]。
曝光融合:不經 HDR 也能得到曝光良好的影像
白話版。 曝光融合依對比、飽和度與良好曝光程度加權,再透過影像金字塔混合以減少接縫。
精確版。 Mertens、Kautz 與 Van Reeth [5] 對第 張曝光在像素 計算三種品質測度:
- 對比 :對灰階曝光套用拉普拉斯濾波器的絕對響應(在邊緣與紋理處較高);
- 飽和度 :像素 R、G、B 值的標準差(鮮豔的顏色散布大,褪色的顏色散布小);
- 曝光良好度 :圍繞中灰的高斯鐘形曲線,分別套用在每個色彩通道 上再相乘,他們的實作中 。
它們以帶指數的乘積組合,並對 張曝光做正規化:
其中 決定各測度的影響力(指數為 0 就是關掉該測度), 是正規化後的權重,在每個像素上對各張曝光的總和為 1。乘積的作用像「且」:像素只有在有細節、而且色彩豐富、而且曝光良好時,才會得到高權重 [5]。
為什麼要用金字塔。 直接混合像素,,會在權重快速變化的地方產生明顯的接縫,因為各張曝光的絕對亮度差異很大 [5]。用高斯平滑權重可以消除接縫,卻會在邊緣周圍產生光暈。曝光融合改成逐金字塔層混合:每張曝光的每個拉普拉斯層,乘上其權重圖的高斯金字塔中對應的那一層,
為拉普拉斯金字塔第 層, 為高斯金字塔第 層;收合 得到結果 [5]。細節使用較尖銳的權重,粗尺度亮度則使用平滑權重;在配準與金字塔設定適當時,可減少接縫與光暈。
下面的程式碼建立一個具有 8 檔光線衰減(左暗右亮)的合成場景,用三種曝光時間、透過簡單的相機模型(gamma、截斷、8 位元量化)拍攝,並融合這組包圍曝光。它也拿結果和 OpenCV 的實作 cv2.createMergeMertens 對照。
程式碼 · Python · 56 行
import numpy as np
import cv2
from skimage import data, img_as_float

# A synthetic high-dynamic-range scene: linear radiance times a light falloff of 8 stops.
rgb = img_as_float(data.astronaut()) ** 2.2                       # undo display gamma -> linear
light = 2.0 ** np.linspace(-6, 2, rgb.shape[1])[None, :, None]    # dark left, bright right
radiance = rgb * light

def camera(E, t):
    """Expose for time t, apply a 1/2.2 display gamma, clip and quantize to 8 bits."""
    return np.round(np.clip((t * E) ** (1 / 2.2), 0, 1) * 255) / 255

stack = [camera(radiance, t) for t in (1 / 8, 1.0, 8.0)]          # under, middle, over

def mertens_weights(imgs, sigma=0.2, eps=1e-12):
    W = []
    for I in imgs:
        gray = I.mean(axis=2).astype(np.float32)
        C = np.abs(cv2.Laplacian(gray, cv2.CV_32F))                # contrast
        S = I.std(axis=2)                                         # saturation
        E = np.prod(np.exp(-(I - 0.5) ** 2 / (2 * sigma ** 2)), axis=2)  # well-exposedness
        W.append(C * S * E + eps)
    W = np.array(W)
    return W / W.sum(axis=0)                                      # weights sum to 1 per pixel

def gauss_pyr(img, n):
    G = [img.astype(np.float32)]
    for _ in range(n):
        G.append(cv2.pyrDown(G[-1]))
    return G

def lap_pyr(img, n):
    G = gauss_pyr(img, n)
    return [G[i] - cv2.pyrUp(G[i + 1], dstsize=G[i].shape[1::-1]) for i in range(n)] + [G[-1]]

def exposure_fusion(imgs):
    n = int(np.log2(min(imgs[0].shape[:2])))                      # full depth: 9 levels for 512 px
    fused = None
    for I, Wk in zip(imgs, mertens_weights(imgs)):
        level = [g[..., None] * l for g, l in zip(gauss_pyr(Wk, n), lap_pyr(I, n))]
        fused = level if fused is None else [f + l for f, l in zip(fused, level)]
    out = fused[-1]
    for detail in reversed(fused[:-1]):
        out = cv2.pyrUp(out, dstsize=detail.shape[1::-1]) + detail
    return np.clip(out, 0, 1)

R = exposure_fusion(stack)
naive = np.clip(np.sum(mertens_weights(stack)[..., None] * np.array(stack), axis=0), 0, 1)
ref = cv2.createMergeMertens(1.0, 1.0, 1.0).process(
    [(255 * I[..., ::-1]).round().astype(np.uint8) for I in stack])[..., ::-1]   # OpenCV uses BGR
for name, I in [("under", stack[0]), ("middle", stack[1]), ("over", stack[2]),
                ("per-pixel blend", naive), ("pyramid blend", R)]:
    ok = np.mean(np.all((I > 0.05) & (I < 0.95), axis=2))        # no channel near black or clipped
    print(f"{name:15s} well-exposed pixels: {100 * ok:4.1f}%")
print(f"mean |ours - OpenCV MergeMertens| = {np.abs(R - np.clip(ref, 0, 1)).mean():.4f}")
輸出
under           well-exposed pixels: 45.8%
middle          well-exposed pixels: 58.7%
over            well-exposed pixels: 41.2%
per-pixel blend well-exposed pixels: 72.3%
pyramid blend   well-exposed pixels: 73.8%
mean |ours - OpenCV MergeMertens| = 0.0027
我們的實作與 OpenCV 的差異在 範圍內不到 0.003;這個小差異大概來自實作細節,例如金字塔深度、邊界處理與輸入的捨入。粗略的「曝光良好像素」比例,從任何單張曝光至多 59%,在融合後升到 74%。注意這個計數漏掉了什麼:逐像素混合的得分幾乎一樣好(72%),看起來卻明顯壞掉,在權重跳動的地方有接縫與斑點(圖 4,左下)。單一數字看不到瑕疵,這個主題會在評估那一節再度出現。
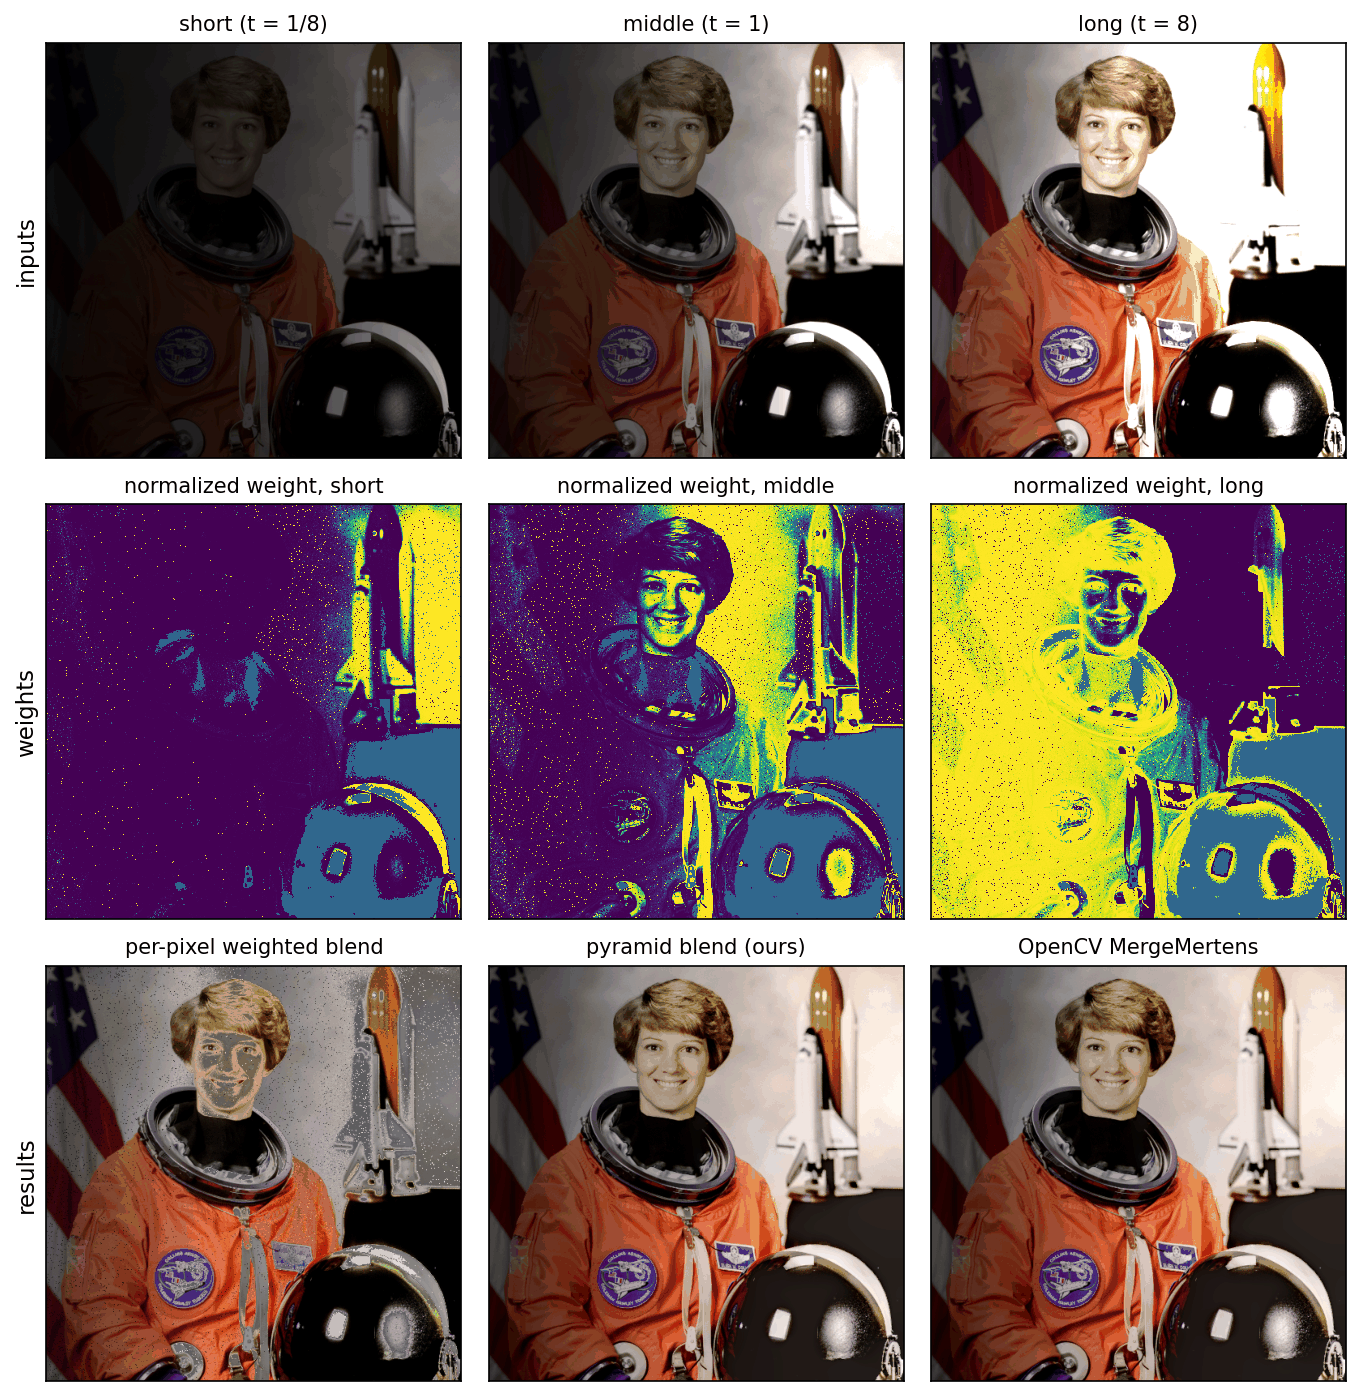
曝光融合不是 HDR。 輸出不保留輻射量的數值,所以不能重新打光或重新曝光;而且在亮度變化劇烈時,多解析度混合可能產生虛假的低頻亮度變化,Mertens 等人指出,較高的金字塔能部分解決這個問題 [5]。曝光融合也假設各張曝光完全對齊,或許需先經過對位 [5];有相機或物體移動時,結果會出現鬼影(圖 6)。最後,Mertens 等人把自己的混合與較早那種選擇最顯著係數的金字塔融合做比較,發現選擇的結果在曝光堆疊上太暗,還有色偏 [5]:對曝光而言,混合勝過選擇,與多焦點融合正好相反。
選讀:曝光融合(Mertens、Kautz 與 Van Reeth)(見「論文導讀」頁)。這篇論文想做什麼、它的比較圖顯示了什麼,以及它自己寫出的限制。
兩種較晚的傳統工具:導引濾波與稀疏編碼
白話版。 後來有兩個想法改進了傳統規則:用保邊濾波器讓權重圖跟著物體邊緣走;以及用學出來的字典描述影像區塊,讓「有多少細節」能在更豐富的表示上衡量。
導引濾波融合(guided-filtering fusion, GFF)。 Li、Kang 與 Hu [12] 把每個來源分成基底層(大尺度的強度變化)與細節層(小尺度的細節),各層用加權平均融合,而權重圖用導引濾波器 [13] 精修,讓它們符合空間一致性,也就是強度相近的鄰近像素得到相近的權重。導引濾波器在 IP 03 有說明,它的學習式與快速變體則在 DLCV 09C。作者報告,用同一個方法處理多光譜、多焦點、多模態與多曝光影像,都達到當時最先進的結果 [12]。這個設計展現了傳統時代的通用配方:二尺度或多尺度分解、活動量測度,以及一個把活動量變成乾淨權重的平滑步驟。
稀疏表示(sparse-representation, SR)融合。 Yang 與 Li [14] 用過完備字典上的稀疏係數表示來源,以取最大值規則組合係數,再由組合後的係數與字典重建融合影像;只要改變稀疏編碼的近似準則,同一套架構也能在融合的同時還原有雜訊的來源。後來的工作改成從來源影像的區塊本身學習字典 [15]。SR 方法曾是最強的傳統多焦點方法之一,但它們很慢:在一項基準中,融合一對影像花了七分鐘以上 [7]。
選讀:稀疏表示融合(見「補充資料」頁)。稀疏編碼模型、逐區塊的融合步驟、活動量測度,以及成本從哪裡來。
沒有真值時如何評估融合
白話版。 沒有正確的融合影像可以比對,融合只能用經驗法則打分數:結果細節多不多、對比高不高、從來源保留的資訊多不多?每條規則只抓到一個面向,所以它們互相矛盾,而且方法可以被調整到在選定的那幾項上表現漂亮。
這一節刻意放在深度學習之前:深度融合網路的訓練損失,和這些指標由同樣的成分構成,所以理解指標就能理解損失。
為什麼融合沒有唯一的正確答案
對合成資料上的多焦點融合,全對焦影像是已知的,拿它算 PSNR 或 SSIM [16] 是有意義的,就像我們的第一段程式碼那樣。對紅外線與可見光融合以及多曝光融合,不存在這樣的影像,而基準研究一致認為,沒有任何單一指標優於其他所有指標 [17]、[18]、[7]。所以基準會回報許多指標:VIFB 實作了 13 項 [17],多曝光基準 MEFB 與多焦點基準 MFIFB 各有 20 項 [18]、[7]。VIFB 把它們分成四個家族:以資訊理論為基礎、以影像特徵為基礎、以結構相似度為基礎,以及以人類感知為基礎 [17]。它的結果顯示了後果:某個方法贏得資訊理論指標,另一個贏得特徵類指標,第三個贏得結構類指標,沒有任何方法全贏 [17]。
選讀:VIFB:可見光與紅外線影像融合基準(見「論文導讀」頁)。基準怎麼建立、怎麼讀它的表格,以及為什麼得分最高的方法看起來最糟。
只看融合影像的指標
令 為融合影像,尺寸為 ,值在 內。
熵(entropy, EN)衡量直方圖散布得多開:
其中 是灰階數(直方圖的區間數), 是落在區間 的像素比例。EN 的單位是位元;值越大,表示灰階用得越平均。它很容易受雜訊影響,所以基準研究只把它當輔助指標 [18]。
標準差(SD)量測整體對比,, 是 的平均。有些實作省略 ,會改變尺度;只有比較影像尺寸相同時,排名才不受這個省略影響。
空間頻率(spatial frequency, SF)衡量相鄰差值的整體活動量 [19]、[18]:
其中 RF(列頻率)使用水平差值,CF(行頻率)使用垂直差值;不同實作的正規化方式不同。SF 大,表示有很多強邊緣與很多紋理。
這三者從不看來源影像。它們獎勵「更多」:更多灰階、更多對比、更多邊緣。雜訊可以免費供應這三樣東西。
與來源影像比較的指標
互資訊(mutual information, MI)衡量融合影像透露了多少關於每個來源的資訊 [20]:
其中 是來源 與 的聯合直方圖(正規化到總和為 1),、 是它的邊際分布。當 的灰階能夠準確預測每個來源的灰階時,MI 就大(定義見 IT 01)。Hossny、Nahavandi 與 Creighton 從解析上證明,這個經典的 MI 總和本身並不是有效的融合效能指標 [21],而基準工具包實作的是歸功於他們的正規化版本,把每一項除以兩個熵的總和 [18]。
選讀:互資訊作為融合指標(見「補充資料」頁)。為什麼複製一個來源也能得高分、區間數如何改變數值,以及正規化修正了什麼。
以梯度為基礎的融合效能 (Xydeas 與 Petrović [22])衡量來源的邊緣資訊有多少保留在 中。在每個像素上,它把每個來源 的邊緣強度 與方向 (由影像梯度得到)和 的做比較,把比較結果轉成保留值 ,也就是邊緣強度保留值與方向保留值的乘積,再以代表各來源重要性的權重 加權平均 [18]:
值接近 1,表示兩個來源的邊緣都保留了強度與方向。下面的程式碼實作一個簡化版本,我們稱之為 :強度保留是較小與較大梯度大小的比值,方向保留隨邊緣夾角線性下降,權重是來源的梯度大小。回報 時,請使用參考實作。
以結構與感知為基礎的指標。 Piella 與 Heijmans [23] 根據 Wang 與 Bovik 的影像品質指數,提出三種融合品質指標的變體;它們不需要真值影像,因為它們把 和來源比較,作者發現它們與主觀評估一致。VIFF [24] 把視覺資訊保真度準則改造用於融合,並在多個解析度上計算。對多曝光融合,MEF-SSIM [25] 是依據一項主觀研究設計的:作者發現一般的融合指標對多曝光融合的感知品質預測得很差,於是圍繞區塊結構一致性測度建了一個 SSIM 風格的指數,與人類判斷的相關性好得多。Liu 等人 [26] 針對夜視應用,在六種多解析度融合演算法上比較了十二種融合指標。
VIF 是資訊傳遞模型,不是原始熵。 它估計來源的模型化資訊經過候選影像與視覺通道後,還保留多少 [55]。融合版本的來源彙整方式不同,分數大於一或跨論文尺度不同時,須檢查實作;來源本身仍不是正確融合真值。
選讀:VIF 與來源參考的融合分數(見「補充資料」)。理解資訊比值、通道假設,以及來源彙整如何改變分數。
一個會騙過指標的玩具
下面的程式碼用 camera 影像建立一組紅外線與可見光影像對:可見光影像右側有一塊很深的陰影,其中的人看不見;熱像平滑、幾乎沒有紋理,而人在其中發亮。它為四個候選打分數:完全不融合(可見光影像本身)、平均、金字塔融合(細節取絕對值最大,粗略基底取兩者中較亮的,使溫暖的目標保持它的亮度),以及加了雜訊的平均。作為對使用者真正在乎的事的獨立檢查,它還量測人物對比: 在人身上的平均值,減去人周圍一圈環帶上的平均值。
程式碼 · Python · 76 行
import numpy as np
import cv2
from scipy import ndimage as ndi
from skimage import data, img_as_float

rng = np.random.default_rng(1)
scene = img_as_float(data.camera())
yy, xx = np.mgrid[:512, :512]
person = ((yy - 330) / 60) ** 2 + ((xx - 420) / 22) ** 2 < 1        # a warm "person", 120 px tall
shadow = ndi.gaussian_filter((xx > 340).astype(float), 8)          # a dark area on the right
vis = scene * (1 - 0.85 * shadow)                                  # visible: person hidden in shadow
ir = 0.25 + 0.3 * ndi.gaussian_filter(scene, 6)                    # thermal: smooth, little texture
ir = np.clip(ir + 0.6 * ndi.gaussian_filter(person.astype(float), 2)  # the warm body glows
             + 0.01 * rng.standard_normal(ir.shape), 0, 1)

def lap_pyr(img, n=5):
    G = [img.astype(np.float32)]
    for _ in range(n):
        G.append(cv2.pyrDown(G[-1]))
    return [G[i] - cv2.pyrUp(G[i + 1], dstsize=G[i].shape[::-1]) for i in range(n)] + [G[-1]]

def collapse(L):
    img = L[-1]
    for d in reversed(L[:-1]):
        img = cv2.pyrUp(img, dstsize=d.shape[::-1]) + d
    return img

def pyramid_fuse(a, b):                    # max-abs details, and the brighter coarse base
    La, Lb = lap_pyr(a), lap_pyr(b)
    out = [np.where(np.abs(p) >= np.abs(q), p, q) for p, q in zip(La[:-1], Lb[:-1])]
    out.append(np.maximum(La[-1], Lb[-1]))
    return np.clip(collapse(out), 0, 1).astype(float)

def entropy(F, bins=256):
    p = np.histogram(F, bins, (0, 1))[0] / F.size
    p = p[p > 0]
    return -np.sum(p * np.log2(p))

def spatial_frequency(F):
    rf = np.mean(np.diff(F, axis=1) ** 2)            # row frequency: horizontal differences
    cf = np.mean(np.diff(F, axis=0) ** 2)            # column frequency: vertical differences
    return np.sqrt(rf + cf)

def mutual_info(X, F, bins=64):
    pxy = np.histogram2d(X.ravel(), F.ravel(), bins, [[0, 1], [0, 1]])[0] / X.size
    px, pf = pxy.sum(1, keepdims=True), pxy.sum(0, keepdims=True)
    nz = pxy > 0
    return np.sum(pxy[nz] * np.log2(pxy[nz] / (px @ pf)[nz]))

def q_gradient(A, B, F):
    """A simplified Q^{AB/F}: how well F keeps the edge strength and direction of A and B."""
    def grad(I):
        gx, gy = ndi.sobel(I, 1), ndi.sobel(I, 0)
        return np.hypot(gx, gy), np.arctan2(gy, gx)
    gF, aF = grad(F)
    num = den = 0.0
    for X in (A, B):
        gX, aX = grad(X)
        strength = np.minimum(gX, gF) / (np.maximum(gX, gF) + 1e-12)
        d = np.abs(aX - aF) % np.pi                  # edge direction is defined modulo pi
        direction = 1 - np.minimum(d, np.pi - d) / (np.pi / 2)
        num += np.sum(strength * direction * gX)     # weight each pixel by the source edge strength
        den += np.sum(gX)
    return num / den

ring = ndi.binary_dilation(person, iterations=15) & ~person
candidates = {"visible only": vis,
              "average": (vis + ir) / 2,
              "pyramid fusion": pyramid_fuse(vis, ir),
              "average + noise": np.clip((vis + ir) / 2 + 0.08 * rng.standard_normal(vis.shape), 0, 1)}
print(f"{'':16s}  EN    SF     SD     MI    Q_G   person contrast")
for name, F in candidates.items():
    mi = mutual_info(vis, F) + mutual_info(ir, F)
    tc = F[person].mean() - F[ring].mean()           # task check: does the person stand out?
    print(f"{name:16s} {entropy(F):4.2f}  {spatial_frequency(F):.3f}  {F.std():.3f}  {mi:4.2f}  "
          f"{q_gradient(vis, ir, F):.3f}  {tc:6.3f}")
輸出
                  EN    SF     SD     MI    Q_G   person contrast
visible only     6.68  0.065  0.293  5.72  0.784  -0.000
average          6.69  0.034  0.172  4.33  0.455   0.257
pyramid fusion   7.48  0.067  0.221  3.75  0.779   0.513
average + noise  7.49  0.163  0.189  1.41  0.296   0.259
逐欄讀這張表(所有數字都來自這個玩具範例):
- 雜訊贏了 EN 與 SF。 在平均上加雜訊,得到最高的熵,以及幾乎是平均五倍的空間頻率,但影像其實變差了。
- 完全不融合贏了 SD、MI 與 。 單獨的可見光影像對比最高,互資訊最高(複製一個來源,會使 等於該來源的熵),連邊緣分數也最高,因為強烈的可見光邊緣在權重 中占大宗。然而人卻看不見:它的對比是零(印出來是 -0.000)。
- 金字塔融合只贏了任務檢查。 相對於平均,它把人的對比加倍,同時保留可見光的紋理( 幾乎和可見光影像一樣高),但五項標準指標中沒有一項它是最好的。
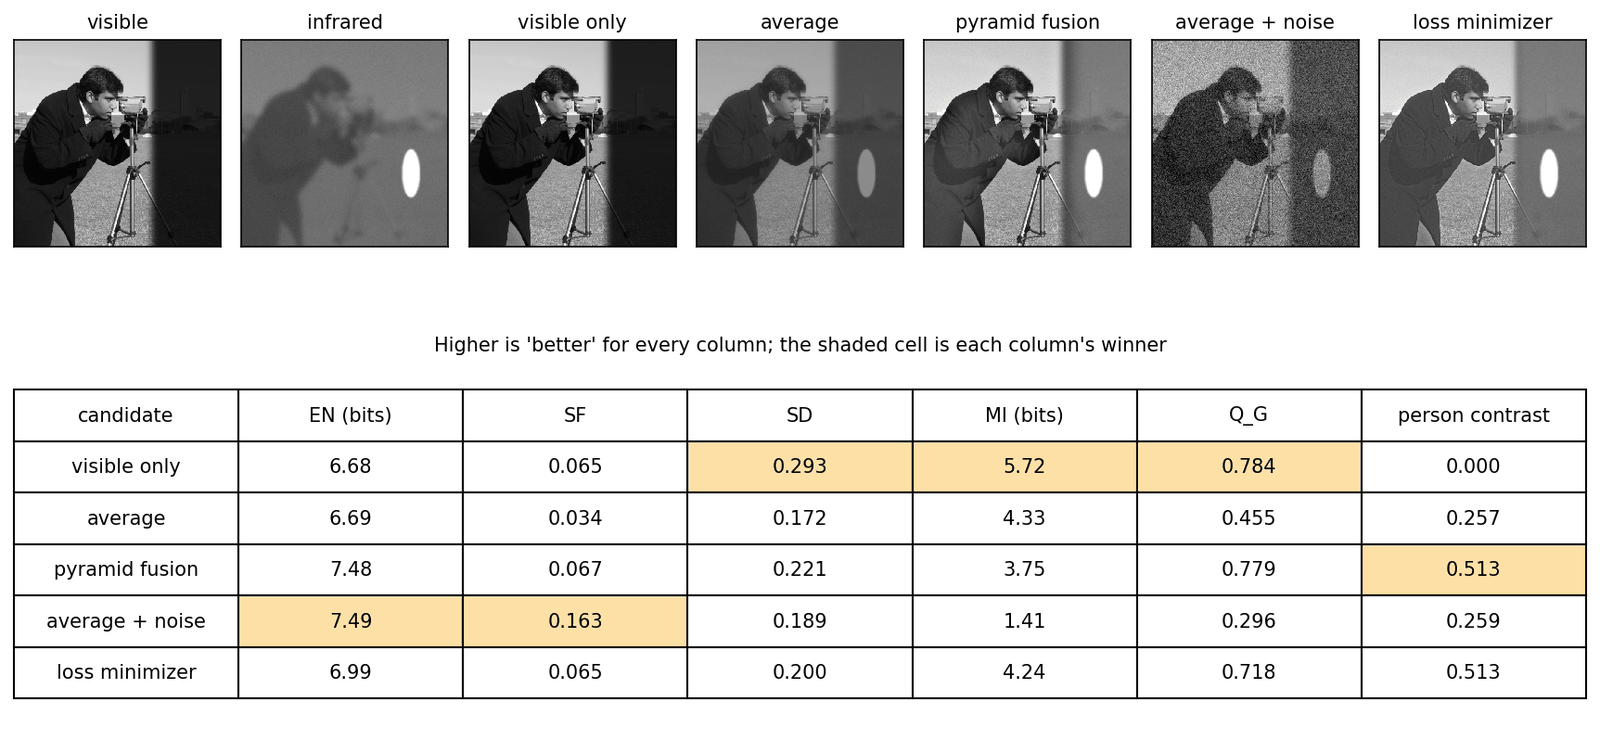
回報什麼
這個玩具範例刻意走極端,但每個效應在實務上都會出現:雜訊與過度銳化會提高 EN、SF 與 SD;看起來像某個來源的結果在 MI 上得分很高;而權重取決於來源的指標,會偏袒邊緣較強的來源。基準的作者從真實方法得到同樣的結論:研究者傾向挑選支持自己方法的指標 [17]、[7],而且定量與定性的比較可能不一致 [7]。實務建議:
- 回報來自不同家族的多個指標,其中至少包含一個與來源比較的指標(、以 SSIM 為基礎的分數或 VIFF),不要只報 EN、SD 或 SF。
- 在可能有參考影像的地方使用有參考的指標:合成的多焦點影像對,或有挑選過參考影像的多曝光資料集(但要注意,參考影像只是一種可接受的答案)。
- 當融合會餵給下游任務時,加入下游任務,例如在融合影像上的偵測或分割準確率,近年的紅外線與可見光基準就是這麼做的 [27]、[28]。
- 展示困難區域的裁切圖(深度邊緣、亮部、陰影中的溫暖目標),而且當主張與視覺品質有關時,做使用者研究。
深度影像融合
白話版。 深度網路從資料學習權重、特徵與組合規則。麻煩的是,沒有任何正確輸出的範例,所以網路是被訓練去滿足和上面那些指標同一類的規則。
缺少的真值
復原網路(DLCV 09)從成對資料(退化輸入,乾淨目標)學習。融合網路有輸入,卻沒有目標。這個領域用四種方式繞過這個問題:
- 合成一個有真值的任務。 對多焦點融合,把清晰影像的部分區域模糊化:清晰影像就是目標,模糊遮罩就是真正的決策圖。大多數深度多焦點方法都是這樣訓練的 [7];IFCNN 用一個由 RGB-D 資料集建成的合成多焦點資料集來訓練通用融合網路,使真值融合影像得以存在 [29]。
- 先訓練別的,再用規則融合特徵。 訓練一個自編碼器去重建普通影像,測試時把兩個來源都編碼,用手工規則合併特徵,再解碼 [30]。
- 非監督式損失。 定義一個損失,衡量 保留了每個來源的強度、梯度或結構到什麼程度,並在沒有標註的來源影像對上訓練網路使它最小化 [31]、[32]。
- 讓另一項任務來監督。 把 餵給偵測器或分割器,並加上它的損失,使融合以其實用性來評斷 [33]、[27]。
非監督式損失
一篇近期綜述把非監督式紅外線與可見光融合的損失分成像素層級的項(L1 或 MSE)、由評估指標構成的項(最主要是 SSIM),以及針對資料特性(例如影像梯度)的項 [2]。一種典型的組合是
其中 是由來源建立的強度目標(例如加權平均,或逐像素取最大值以保留較亮的熱目標), 是梯度大小目標(例如每個像素上兩個來源梯度大小中較大者), 是 與來源 之間的結構相似度 [16], 是各來源的權重, 則是各項的權重。方法的差別主要就在這些選擇:DeepFuse [31] 只用 MEF-SSIM [25] 訓練,SwinFusion [34] 用 SSIM、紋理與強度項,U2Fusion [32] 則用對每個來源含有多少資訊的估計,來加權一個相似度損失。
選讀:代表性融合網路的訓練訊號(見「補充資料」頁)。DenseFuse、DeepFuse、U2Fusion、SwinFusion、FusionGAN、CDDFuse、DDFM 與 EMMA 實際上在最佳化什麼,以及每種選擇對結果意味著什麼。
損失就是答案的定義
白話版。 如果沒有人給網路目標,損失就是目標。網路能做到的最好,就是針對每一對輸入,輸出使損失最小的那張影像。對簡單的二次損失,我們可以不用任何網路,直接算出那張影像並看看它。
這段程式碼接續評估那一節的玩具範例(它用到 vis、ir、person、ring 與各個指標函式)。它最小化上述損失的平方誤差版本:一個朝向來源逐像素最大值的強度項,加上一個朝向較強來源梯度的梯度項,
其中 把 的水平與垂直前向差分疊在一起, 在每個位置與每個方向上,取兩個來源中差分絕對值較大者的差分, 在強度與梯度之間取捨。把目標函數的梯度設為零,得到一個稀疏線性系統 ,其中 是差分運算子;共軛梯度法幾秒鐘就能解出來。
程式碼 · Python · 29 行
import scipy.sparse as sp
from scipy.sparse.linalg import cg

def diff_ops(H, W):
    d = lambda n: sp.diags([-np.ones(n - 1), np.ones(n - 1)], [0, 1], shape=(n - 1, n))
    return sp.kron(sp.eye(H), d(W)).tocsr(), sp.kron(d(H), sp.eye(W)).tocsr()  # Dx, Dy

def fuse_by_loss(a, b, lam=10.0):
    """Minimize ||F - max(a, b)||^2 + lam * ||grad F - g||^2, where g is the stronger source gradient."""
    H, W = a.shape
    Dx, Dy = diff_ops(H, W)
    gx = [Dx @ s.ravel() for s in (a, b)]
    gy = [Dy @ s.ravel() for s in (a, b)]
    pick_x = np.abs(gx[0]) >= np.abs(gx[1])
    pick_y = np.abs(gy[0]) >= np.abs(gy[1])
    tx, ty = np.where(pick_x, gx[0], gx[1]), np.where(pick_y, gy[0], gy[1])
    target = np.maximum(a, b).ravel()                 # intensity term: the brighter source
    M = sp.eye(H * W) + lam * (Dx.T @ Dx + Dy.T @ Dy)  # normal equations of the quadratic loss
    rhs = target + lam * (Dx.T @ tx + Dy.T @ ty)
    f, info = cg(M, rhs, x0=target, rtol=1e-6, maxiter=2000)
    if info != 0: raise RuntimeError("Conjugate gradient did not converge")
    return np.clip(f.reshape(H, W), 0, 1)

for lam in (1.0, 10.0):
    F = fuse_by_loss(vis, ir, lam)
    mi = mutual_info(vis, F) + mutual_info(ir, F)
    print(f"loss minimizer, lam={lam:4.1f}: EN {entropy(F):.2f}  SF {spatial_frequency(F):.3f}  "
          f"SD {F.std():.3f}  MI {mi:.2f}  Q_G {q_gradient(vis, ir, F):.3f}  "
          f"person contrast {F[person].mean() - F[ring].mean():.3f}")
輸出
loss minimizer, lam= 1.0: EN 6.91  SF 0.060  SD 0.195  MI 4.68  Q_G 0.659  person contrast 0.513
loss minimizer, lam=10.0: EN 6.99  SF 0.065  SD 0.200  MI 4.24  Q_G 0.718  person contrast 0.513
損失最小化的結果裡,人和金字塔融合一樣亮(對比 0.513),同時保留可見光的紋理(圖 5,右側)。把 從 1 提高到 10,會使 與 SF 上升、MI 下降:損失各項之間的權重會讓結果在各指標上移動,而選擇權重,就是選擇什麼才叫「正確」的融合。這是對非監督式深度融合誠實的總結:網路帶來了速度、從大量訓練影像對泛化的能力,以及比原始梯度更豐富的特徵,但好結果的定義仍是人寫的,就寫在損失裡。
深度融合網路的家族
綜述依架構與訓練策略整理這個領域 [35]、[2]。下表列出每個家族的代表成員;論文導讀中的紅外線與可見光融合綜述導讀對分類法有更深入的說明。
| 家族 | 想法 | 代表方法 |
|---|---|---|
| 學習式決策圖或權重 | 網路預測哪個來源對焦,或預測逐像素權重;輸出仍是來源像素的選擇或混合 | 多焦點的 CNN 對焦圖 [36];MEF-Net 在低解析度預測權重,並用導引濾波器上取樣 [37] |
| 自編碼器+融合規則 | 訓練編碼器–解碼器重建影像;用手工規則融合編碼後的特徵 | DenseFuse [30] |
| 端到端、非監督式 | 網路把來源映射成 ,以強度/梯度/SSIM 類型的損失訓練 | DeepFuse [31]、U2Fusion [32]、SwinFusion [34]、CDDFuse [38] |
| 在合成資料上監督式訓練 | 在有已知融合影像的合成影像對上訓練 | IFCNN [29] |
| 對抗式(GAN) | 判別器促使 看起來像某一個來源的紋理,內容損失則保留另一個來源的強度 | FusionGAN [39]、TarDAL [27] |
| 任務導向 | 對 的偵測或分割損失引導融合網路 | SeAFusion [33]、TarDAL [27]、SegMiF [28]、TDFusion [40] |
| 生成式先驗與語言 | 預訓練的擴散模型或文字編碼器引導融合 | DDFM [41]、Text-IF [42] |
有兩個家族依賴在其他篇章說明過的生成模型:GAN 見 ML 07,擴散模型見 ML 08。在所有家族中,架構對結果特性的影響,不如訓練訊號來得大,這正是表中間那一欄真正區分的東西。
各類學習式方法究竟學到什麼
架構表是地圖,不是訓練配方。沿著監督訊號的來源,才能理解結果。
自編碼器加規則。 DenseFuse 從一般影像學特徵與重建 [30],推論時再用固定規則合併特徵。訓練不需融合真值,但重建本身不會教它哪個模態應優先。同一組網路權重,使用相加或活動度加權,也會產生不同偏好。
監督式卷積融合。 IFCNN 以有真值的合成配對訓練,再逐元素合併來源特徵 [29]。它有直接監督,但也承接合成資料的假設;若模糊模型忽略前景擴散或感測器差異,真實影像上的選擇就可能錯誤。
直接無監督融合。 U2Fusion 用自適應資訊權重,讓輸出接近來源 [32];必須同時理解其結構與強度項。VGG 權重估計與持續學習懲罰用於訓練,最終產圖網路推論時不需要 VGG 或 EWC。
對抗式融合。 FusionGAN 在來源保留目標外加入判別器,以保留紅外線強度並鼓勵可見光般的紋理 [39]。逼真外觀只是分布偏好,不能證明某條邊緣有來源支持。TarDAL 則將對抗角色分為熱目標與可見光細節,並加入下游監督 [27]。
注意力融合。 SwinFusion 以視窗與移位視窗注意力,學習來源內與來源間的互動 [34]。查詢、鍵與值讓特徵引用不同位置或模態的證據;視窗限制成本,連續移位則跨越邊界。它仍需要融合目標與對齊證據,也可能傳遞雜訊。
擴散融合。 DDFM 反覆結合預訓練去雜訊先驗與來源修正 [41],省去融合專用的去雜訊器訓練,但要付出迭代推論成本。每個擴散步內做一次 EM,不代表整個融合只需一步;概似模型與影像先驗都會影響結果。
統一與任務感知系統。 「統一」可能指損失或架構,而非共用權重,須查檢查點及訓練設定。U2Fusion 明確追求跨任務共用參數 [32]。任務感知模型則透過偵測或分割來評判融合 [27]、[33],需要對應標註,也可能專精於該任務。兩種名稱都不保證一個模型可處理任意模態或未配準輸入。
選讀:DenseFuse、U2Fusion、TarDAL 與 DDFM(見「論文導讀」)。各自的完整設計、實驗設定、消融與限制。
為下游任務而融合
白話版。 如果融合影像要餵給偵測器,最好的融合就是讓偵測器好用的那一個,而不是熵最高的那一個。
SeAFusion [33] 把即時融合網路和分割網路串接起來,加上語意損失,並在迴圈中訓練兩者 [2]。** TarDAL** [27] 把融合與偵測寫成同一個雙層最佳化問題,將它展開成一個融合網路,包含一個生成器與兩個判別器(一個負責紅外線目標,一個負責可見光紋理),後面接著偵測器,並引入以同步的紅外線與可見光系統拍攝的 M3FD 基準。** SegMiF** [28] 透過階層式注意力,在融合與分割兩個子網路之間交換中間特徵,並收集了一個全天候的基準,含有 15 個像素層級標註的類別。** TDFusion** [40] 更進一步,學習融合損失本身:用元學習(meta-learning)訓練一個損失生成模組,使它所監督的融合網路最小化下游任務損失。任務導向的訓練以可量測的目標回答了「什麼才是正確」的問題,但它是針對一項任務與一個網路最佳化的,而且任務表現並不能完全反映視覺品質 [2]。
融合未對齊的影像
白話版。 真實的紅外線與可見光相機很少完全對齊。對位容錯的方法會估計錯位,並在融合網路內部修正它。
對錯位的影像對逐像素融合,會在物體周圍產生鬼影與雙重邊緣 [43]、[44]。近期工作有兩種策略 [2]。風格轉換路線先把一種模態轉換成另一種,使跨模態對位變成單一模態對位:UMF-CMGR [43] 由可見光影像生成偽紅外線影像,用多層級對位網路把真實的紅外線影像對位到它上面,然後融合。** 共享特徵路線**把兩種模態映射到共同的特徵空間,並在其中預測形變場。SuperFusion [44] 把對位(雙向形變場)、融合,以及來自預訓練分割模型的語意約束,結合在一個框架中。多曝光融合也有類似的問題,來自相機晃動與移動的物體(鬼影)。
資料集與基準
白話版。 紅外線與可見光融合有幾個公開的對齊影像對集合,有些附有物體標註;多焦點與多曝光融合則有較小的測試集與基準工具包。真實的紅外線與可見光資料都沒有真值融合影像。
| 資料集 | 任務 | 內容(依作者的描述) |
|---|---|---|
| TNO [45] | 紅外線與可見光 | 軍事與監視場景的增強視覺、近紅外線與長波紅外線夜間影像 |
| RoadScene [32] | 紅外線與可見光 | 從 FLIR 影片中挑選的 221 對對齊道路場景影像,隨 U2Fusion 發布 |
| MSRS [46] | 紅外線與可見光 | 1,444 對對齊的道路場景影像,由 MFNet 資料集 [47] 去除 125 對錯位影像並增強紅外線影像而成 |
| LLVIP [48] | 紅外線與可見光 | 15,488 對嚴格對齊的影像,多數在非常暗的場景拍攝,附行人標註 |
| M3FD [27] | 紅外線與可見光 | 4,200 對已對位且附偵測標註的影像,另有 300 對來自獨立場景、供融合使用;影像多為 1024 × 768 |
| FMB [28] | 紅外線與可見光 | 全天候基準,含 15 個像素層級標註的類別,供融合與分割使用 |
| VIFB [17] | 紅外線與可見光 | 21 對的測試集、含 20 種融合演算法的程式庫,以及 13 項指標 |
| Lytro [15] | 多焦點 | 20 對多焦點影像,長期是最廣泛使用的測試集 [7] |
| MFFW [6] | 多焦點 | 從網路收集的 19 對真實影像,散焦擴散效應很強 |
| MFIFB [7] | 多焦點 | 含 105 對測試影像、30 種演算法與 20 項指標的基準 |
| SICE [49] | 多曝光 | 589 個多曝光序列(4,413 張影像),每個序列的參考影像,是透過主觀比較 13 種融合與 HDR 演算法而選出的 |
| MEFB [18] | 多曝光 | 含 100 對測試影像、16 種演算法與 20 項指標的基準 |
讀這張表要留意三點。前處理也是資料的一部分:RoadScene 的紅外線影像處理過背景熱雜訊,MSRS 的紅外線影像用基於暗通道先驗的方法增強過對比,所以「紅外線來源」其實已經被處理過。** 場景很窄:大多數紅外線與可見光資料是都市道路與校園,而 2025 年的綜述把更多樣的場景與對位真值,列為缺少的基準 [2]。 舊的測試集已經飽和:**在 20 對 Lytro 影像上,常用方法表現非常相近,因為那裡的散焦擴散效應很弱 [6]、[7]。SICE 也在 DLCV 09C 中用於曝光校正。
失效模式
白話版。 融合在它的假設不成立的地方失敗:來源沒有對齊、來源不是單純的「清晰或模糊」、權重變化太快或太慢,以及把該選擇的東西拿去平均的規則。
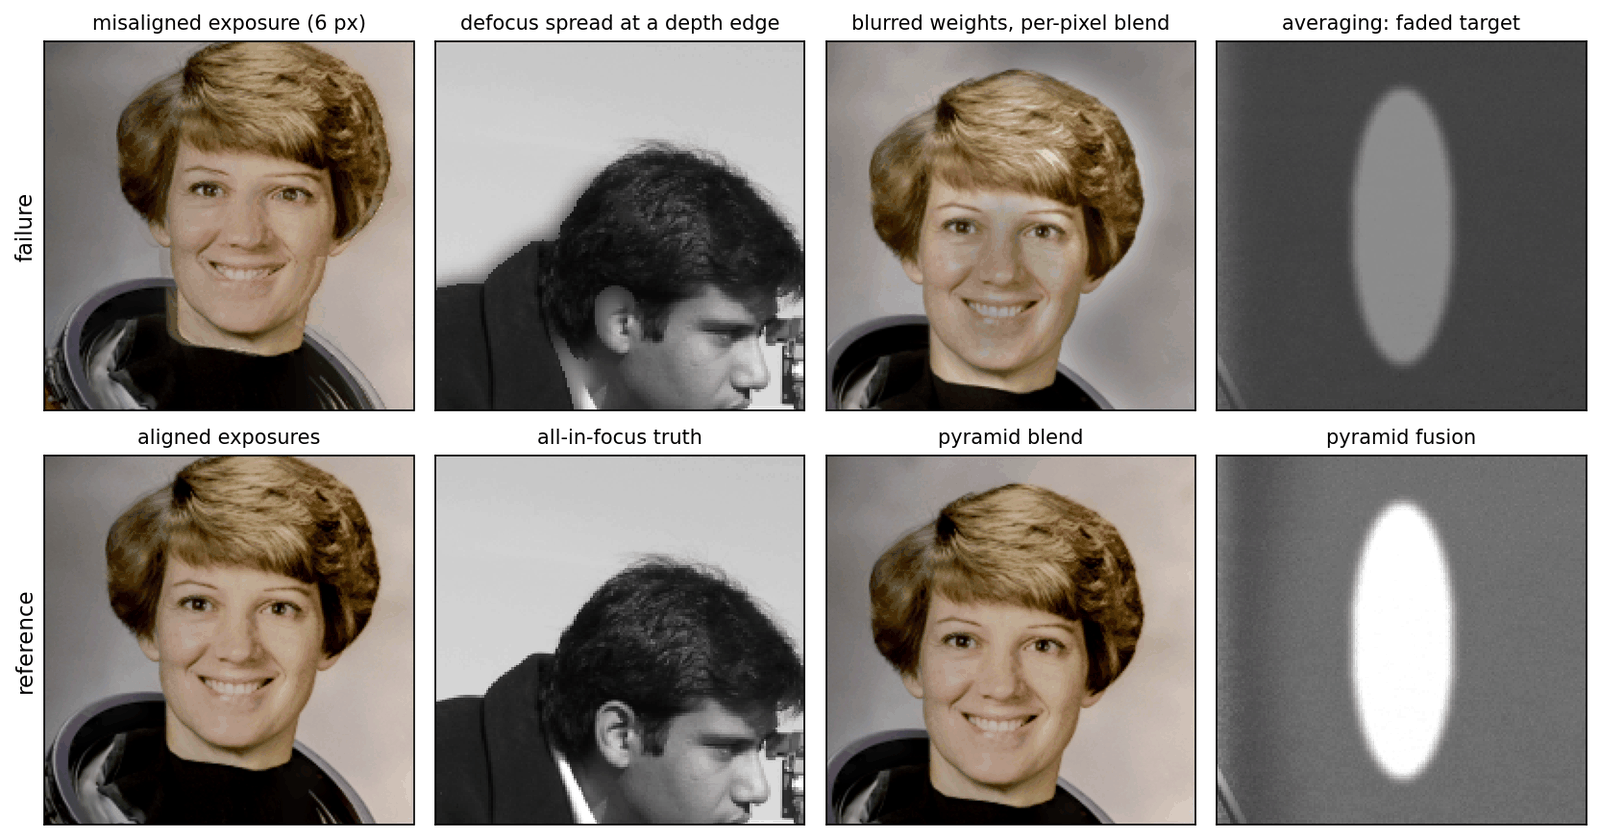
- 配準鬼影。 來源差幾個像素,就會出現雙重邊緣(圖 6 第一欄);多曝光的移動物體也一樣。先檢查對齊。
- 決策圖邊界偽影。 深度邊緣附近,前景散焦會擴散到背景,使兩來源都不清晰,二元選擇可能留下軟環或方塊邊緣(第二欄)。錯誤的硬切換也會產生接縫。
- 光暈。 權重過度平滑,或基底層在太細的尺度融合,會在強邊緣附近形成明暗帶(第三欄)[5]。多尺度可改善,但金字塔太淺仍會產生接縫與低頻誤差(練習 4)。
- 熱目標被沖淡。 平均或過度偏重可見光的損失,會削弱熱目標對比(第四欄);反過來則會讓背景像缺乏紋理的熱影像。
- 色偏。 常見作法只融合亮度,例如 YCbCr 的 Y,再複製或混合色度,DeepFuse 的多曝光方法即如此 [31]。若融合亮度與色度來源差異很大,例如暗背景上的亮熱目標,顏色就可能褪色或偏色。Mertens 等人的比較也顯示,選擇而非混合金字塔係數會造成色偏 [5]。
- 放大雜訊。 最大絕對值選擇與梯度損失偏好高頻,暗處的雜訊可能主導高頻響應,使結果更銳利卻更吵。EN、SF 也會獎勵這種結果。
- 迎合指標。 專門最佳化 EN、SF、SD 的方法,可能產生以上偽影卻得到更好分數(圖 5)。
現代觀點
綜述。 六篇綜述合起來涵蓋這個領域:
- Ma、Ma 與 Li(Information Fusion 2019)[3] 回顧傳統與早期深度紅外線與可見光融合,引入對位作為前提,整理應用與評估指標,並用九項指標比較十八種方法。重點:深度學習接手之前,傳統方法及其評估習慣的參考點。
- Liu 等人(Information Fusion 2018)[1] 寫了一篇早期(2018)的回顧,談跨任務的像素層級融合的深度學習。他們列出傳統融合的困難(手工設計的活動量測度與融合規則),主張學習到的特徵可以取代它們,並把早期方法(CNN、卷積稀疏表示、堆疊自編碼器)歸納成通用框架。
- Zhang 與 Demiris(TPAMI 2023)[35] 依架構(以 CNN、自編碼器、GAN 與 Transformer 為基礎)回顧深度可見光與紅外線融合,並附資料集與評估方法。重點:深度方法已成為這項任務的主流做法。
- Liu 等人(TPAMI 2025)[2] 沿著三個維度整理超過 180 種學習式紅外線與可見光方法:資料相容性(對位)、融合(架構與損失)與任務適應(偵測、分割),並在對位、融合與下游任務上比較它們。
- Zhang(TPAMI 2022)[50] 綜述深度多焦點融合(方法、資料集、指標),並以實驗比較深度與傳統方法。
- Xu 等人(Remote Sensing 2022)[51] 回顧針對靜態與動態場景的多曝光融合,並用九項指標比較 18 種方法。
選讀:Liu 等人的紅外線與可見光融合綜述(見「論文導讀」頁)。它的分類法如何建立、怎麼讀它的比較表,以及它列出的尚未解決的問題。
最新進展(2023–2026)。 有四個趨勢很突出。第一,融合越來越以下游任務來評斷:方法以偵測或分割損失訓練,M3FD 與 FMB 等基準附有標註,融合損失本身也可以從任務損失中學習 [27]、[28]、[40]。第二,生成式先驗與語言已經進場:不需要特定任務訓練的擴散式融合 [41]、由成像先驗做的自監督訓練 [52],以及也能處理退化來源的文字引導融合 [42]。第三,對位正在移進模型內部,出現了針對未對齊紅外線與可見光影像對的聯合對位與融合網路 [43]、[44]。第四,影片融合正在起步:一項 CVPR 2026 的工作引入了 M3SVD,包含 220 段同步且已對位的紅外線與可見光影片、共 153,797 個影格,以及一個以雙時間注意力減輕逐影格影像融合時間不一致性的模型 [53]。對多焦點融合,一項 2020 年的基準研究發現,用模擬資料訓練的深度方法無法很好地泛化到具挑戰性的真實影像對,而傳統方法仍具競爭力 [7]。對於聲稱大幅進步的說法要小心,並檢查它們依據的是哪些指標。
尚未解決的問題。
- 評估。 仍然沒有任何一個指標或一組指標,既與人類判斷一致又與任務表現一致;2025 年的綜述把更好的評估指標列為必要的方向 [2]。
- 真實的錯位與退化。 大多數方法假設來源已對位而且乾淨。具有對位真值的基準,以及對任一來源中的雜訊、模糊、低光與惡劣天氣都穩健的融合,仍待解決 [2]、[42]。
- 真實的散焦。 要讓多焦點融合能泛化,需要能重現散焦擴散效應的訓練資料,以及能處理深度邊緣的方法 [6]、[7]。
- 效率。 許多近期的網路很大;在無人機、汽車與手持裝置上做融合,需要輕量、對硬體友善的設計 [2](通用技術見 DLCV 09C)。
- 影片。 研究一直在融合影像而不是影片,主要是因為缺少大型的同步多感測器影片資料集 [53];以低成本達到時間一致性仍是待解決的問題。
重點整理
- 選擇融合規則前,先決定各來源應提供什麼。
- 平均可能削弱單一來源特徵,權重應反映有用資訊。
- 多尺度混合把細節選擇與粗尺度亮度混合分開,降低接縫風險。
- 沒有唯一融合目標時,訓練損失表達所需答案及其取捨。
- 配準錯誤會產生重影;須檢查邊界、光暈、色彩、雜訊與來源特定目標。
- 搭配多類指標、局部裁切與任務結果;高分也可能獎勵雜訊或單一來源複製。
練習
- 平均下的對比。 溫暖的目標在紅外線影像中的強度是 ,在可見光影像中是 ,兩者的背景強度都是 。(a) 證明平均後的目標對比是 ,而任何權重為 的逐像素加權平均都會給出 。(b) 在我們的玩具範例中,平均的人物對比是 0.257,金字塔融合是 0.513。金字塔融合在目標上的行為,像是紅外線來源取多少權重?為什麼它能做到這一點,又不會讓其他地方的可見光紋理變暗?
提示
(a) 利用 ,。(b) 0.513 大約是 0.257 的兩倍,所以在目標上,金字塔融合的行為像是 。它之所以做得到,是因為權重不是全域的:粗略基底取較亮的來源(紅外線目標),細節層則取任何一個更強的細節,也就是目標以外的可見光紋理。全域權重則必須在兩者之間取捨。
- 對焦視窗與清理。 在多焦點的程式碼中,改變對焦測度的平滑 與中值視窗 ( 表示不清理),最後一律接標準差為 2 的高斯柔化混合。回報 PSNR。哪種設定贏?為什麼在真實照片上答案可能不同?
提示
在我們的執行中,所有設定都落在 39.43 到 40.05 dB 之間;最好的是 且不做中值清理(40.05 dB),而最大的視窗 對每個 都最差(約 39.4–39.5 dB)。不清理時,柔化混合會在布滿斑點的平坦區域混合 A 與 B,使它們各自獨立的雜訊被平均掉,那裡的 PSNR 略微上升;很大的中值視窗則會讓圓盤邊界附近的決策圖錯位。在真實照片上,沒清理的斑點會在來源不同的地方(雜訊、小幅錯位、散焦擴散效應)顯現為明顯的斑塊,所以對外觀而言,清理通常比在玩具範例的 PSNR 上顯得更重要。
- 區域式選擇。 把金字塔程式碼中的
pick_stronger換成比較局部能量的規則:用標準差為 的高斯平滑 與 ,並選擇能量較大者的係數。試 ,並與逐係數規則比較。
提示
使用 ndi.gaussian_filter(p**2, s)。在我們的執行中,PSNR 從 37.60 dB(逐係數)上升到 時的 39.14、39.42 與 39.62 dB,接近決策圖。平滑活動量使相鄰的係數做出相同的決策,這正是區域式規則與 Li 等人的一致性驗證所要達成的:在多焦點融合中,對焦是區域的性質,不是單一係數的性質。
- 曝光融合中的金字塔深度與品質測度。 (a) 用 層的金字塔重跑曝光融合( 就是逐像素混合),回報曝光良好比例;並觀察影像。(b) 一次只用一種品質測度(只用對比、只用飽和度,或只用曝光良好度),在完整深度下做融合。你觀察到什麼?
提示
(a) 在我們的執行中, 時比例是 72.3%, 時依序是 72.2%、70.9%、69.6% 與 68.5%, 時是 73.8%; 時與 9 層結果的平均絕對差仍有 0.068。淺的金字塔保留接縫與低頻亮度誤差,因為缺少了權重混合得最平滑的最粗幾層;在 512 像素的影像上,即使從 7 層到 9 層,結果也變化很大。(b) 只用曝光良好度,得到最高的比例(77.5%),只用對比是 69.1%,只用飽和度是 71.5%。Mertens 等人也發現,單靠曝光良好度就能給出相當不錯的影像;對比與飽和度對細節與色彩有貢獻,而這個計數並不量測它們。
- 雜訊如何灌高空間頻率。 令 ,其中 是每個像素上獨立、均值為零、變異數為 的雜訊。(a) 證明 的期望值大約增加 。(b) 在玩具範例上驗證:對平均影像加上 的雜訊,把量到的 SF 與 比較。
提示
(a) 的水平差值,等於 的差值加上 ,後者的變異數是 ,且與 不相關;所以 ,CF 同理,於是 。(b) 在我們的執行中(隨機種子與程式碼中的不同), 時量到與預測的 SF 都是 0.0528,0.04 時都是 0.0871,0.08 時分別是 0.1631 與 0.1637;0.08 時的小差距來自截斷到 。EN 從 6.69 上升到 6.99、7.20 與 7.49 位元。
- 互資訊獎勵複製。 (a) 證明若 ,則 ,其中 是分箱後影像的熵。(b) 用 64 個區間在玩具範例上驗證。(c) 用 16、64 與 256 個區間,計算平均影像與可見光影像的 MI 分數。排名會隨區間數改變嗎?數值呢?
提示
(a) ,因為知道 就消除了關於 的所有不確定性。(b) 在我們的執行中, 位元, 位元,兩者相加是 5.723,也就是程式碼中「僅可見光」的 MI 分數。(c) 平均影像得到 2.64、4.33 與 5.00 位元,可見光影像得到 3.42、5.72 與 7.82 位元:排名不變,但可見光影像的數值從 16 個區間到 256 個區間增加了一倍以上,所以使用不同區間數或不同實作的論文,其 MI 數值不能直接比較。
參考文獻
- Y. Liu, X. Chen, Z. Wang, Z. J. Wang, R. K. Ward and X. Wang, “Deep learning for pixel-level image fusion: Recent advances and future prospects,” Information Fusion, vol. 42, pp. 158–173, 2018. doi
- J. Liu, G. Wu, Z. Liu, D. Wang, Z. Jiang, L. Ma, W. Zhong, X. Fan and R. Liu, “Infrared and visible image fusion: From data compatibility to task adaption,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 47, no. 4, pp. 2349–2369, 2025. doi arXiv
- J. Ma, Y. Ma and C. Li, “Infrared and visible image fusion methods and applications: A survey,” Information Fusion, vol. 45, pp. 153–178, 2019. doi
- P. E. Debevec and J. Malik, “Recovering high dynamic range radiance maps from photographs,” in Proc. SIGGRAPH, 1997, pp. 369–378. doi
- T. Mertens, J. Kautz and F. Van Reeth, “Exposure fusion: A simple and practical alternative to high dynamic range photography,” Computer Graphics Forum, vol. 28, no. 1, pp. 161–171, 2009. doi
- S. Xu, X. Wei, C. Zhang, J. Liu and J. Zhang, “MFFW: A new dataset for multi-focus image fusion,” arXiv:2002.04780, 2020. arXiv
- X. Zhang, “Multi-focus image fusion: A benchmark,” arXiv:2005.01116, 2020. arXiv
- P. J. Burt and E. H. Adelson, “The Laplacian pyramid as a compact image code,” IEEE Transactions on Communications, vol. 31, no. 4, pp. 532–540, 1983. doi
- P. J. Burt and R. J. Kolczynski, “Enhanced image capture through fusion,” in Proc. 4th International Conference on Computer Vision (ICCV), 1993, pp. 173–182. doi
- P. J. Burt and E. H. Adelson, “A multiresolution spline with application to image mosaics,” ACM Transactions on Graphics, vol. 2, no. 4, pp. 217–236, 1983. doi
- H. Li, B. S. Manjunath and S. K. Mitra, “Multisensor image fusion using the wavelet transform,” Graphical Models and Image Processing, vol. 57, no. 3, pp. 235–245, 1995. doi
- S. Li, X. Kang and J. Hu, “Image fusion with guided filtering,” IEEE Transactions on Image Processing, vol. 22, no. 7, pp. 2864–2875, 2013. doi
- K. He, J. Sun and X. Tang, “Guided image filtering,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, no. 6, pp. 1397–1409, 2013. doi
- B. Yang and S. Li, “Multifocus image fusion and restoration with sparse representation,” IEEE Transactions on Instrumentation and Measurement, vol. 59, no. 4, pp. 884–892, 2010. doi
- M. Nejati, S. Samavi and S. Shirani, “Multi-focus image fusion using dictionary-based sparse representation,” Information Fusion, vol. 25, pp. 72–84, 2015. doi
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image quality assessment: From error visibility to structural similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- X. Zhang, P. Ye and G. Xiao, “VIFB: A visible and infrared image fusion benchmark,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) Workshops, 2020. CVF arXiv
- X. Zhang, “Benchmarking and comparing multi-exposure image fusion algorithms,” Information Fusion, vol. 74, pp. 111–131, 2021. doi arXiv
- A. M. Eskicioglu and P. S. Fisher, “Image quality measures and their performance,” IEEE Transactions on Communications, vol. 43, no. 12, pp. 2959–2965, 1995. doi
- G. Qu, D. Zhang and P. Yan, “Information measure for performance of image fusion,” Electronics Letters, vol. 38, no. 7, pp. 313–315, 2002. doi
- M. Hossny, S. Nahavandi and D. Creighton, “Comments on ‘Information measure for performance of image fusion’,” Electronics Letters, vol. 44, no. 18, pp. 1066–1067, 2008. doi
- C. S. Xydeas and V. Petrović, “Objective image fusion performance measure,” Electronics Letters, vol. 36, no. 4, pp. 308–309, 2000. doi
- G. Piella and H. Heijmans, “A new quality metric for image fusion,” in Proc. IEEE International Conference on Image Processing (ICIP), 2003, vol. 3, pp. III-173–176. doi
- Y. Han, Y. Cai, Y. Cao and X. Xu, “A new image fusion performance metric based on visual information fidelity,” Information Fusion, vol. 14, no. 2, pp. 127–135, 2013. doi
- K. Ma, K. Zeng and Z. Wang, “Perceptual quality assessment for multi-exposure image fusion,” IEEE Transactions on Image Processing, vol. 24, no. 11, pp. 3345–3356, 2015. doi
- Z. Liu, E. Blasch, Z. Xue, J. Zhao, R. Laganiere and W. Wu, “Objective assessment of multiresolution image fusion algorithms for context enhancement in night vision: A comparative study,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 34, no. 1, pp. 94–109, 2012. doi
- J. Liu, X. Fan, Z. Huang, G. Wu, R. Liu, W. Zhong and Z. Luo, “Target-aware dual adversarial learning and a multi-scenario multi-modality benchmark to fuse infrared and visible for object detection,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2022, pp. 5802–5811. CVF arXiv M3FD
- J. Liu, Z. Liu, G. Wu, L. Ma, R. Liu, W. Zhong, Z. Luo and X. Fan, “Multi-interactive feature learning and a full-time multi-modality benchmark for image fusion and segmentation,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV), 2023, pp. 8115–8124. CVF arXiv
- Y. Zhang, Y. Liu, P. Sun, H. Yan, X. Zhao and L. Zhang, “IFCNN: A general image fusion framework based on convolutional neural network,” Information Fusion, vol. 54, pp. 99–118, 2020. doi
- H. Li and X.-J. Wu, “DenseFuse: A fusion approach to infrared and visible images,” IEEE Transactions on Image Processing, vol. 28, no. 5, pp. 2614–2623, 2019. doi arXiv
- K. R. Prabhakar, V. S. Srikar and R. V. Babu, “DeepFuse: A deep unsupervised approach for exposure fusion with extreme exposure image pairs,” in Proc. IEEE International Conference on Computer Vision (ICCV), 2017, pp. 4724–4732. doi CVF
- H. Xu, J. Ma, J. Jiang, X. Guo and H. Ling, “U2Fusion: A unified unsupervised image fusion network,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 1, pp. 502–518, 2022. doi RoadScene
- L. Tang, J. Yuan and J. Ma, “Image fusion in the loop of high-level vision tasks: A semantic-aware real-time infrared and visible image fusion network,” Information Fusion, vol. 82, pp. 28–42, 2022. doi
- J. Ma, L. Tang, F. Fan, J. Huang, X. Mei and Y. Ma, “SwinFusion: Cross-domain long-range learning for general image fusion via Swin Transformer,” IEEE/CAA Journal of Automatica Sinica, vol. 9, no. 7, pp. 1200–1217, 2022. doi
- X. Zhang and Y. Demiris, “Visible and infrared image fusion using deep learning,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, no. 8, pp. 10535–10554, 2023. doi
- Y. Liu, X. Chen, H. Peng and Z. Wang, “Multi-focus image fusion with a deep convolutional neural network,” Information Fusion, vol. 36, pp. 191–207, 2017. doi
- K. Ma, Z. Duanmu, H. Zhu, Y. Fang and Z. Wang, “Deep guided learning for fast multi-exposure image fusion,” IEEE Transactions on Image Processing, vol. 29, pp. 2808–2819, 2020. doi
- Z. Zhao, H. Bai, J. Zhang, Y. Zhang, S. Xu, Z. Lin, R. Timofte and L. Van Gool, “CDDFuse: Correlation-driven dual-branch feature decomposition for multi-modality image fusion,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2023, pp. 5906–5916. CVF arXiv
- J. Ma, W. Yu, P. Liang, C. Li and J. Jiang, “FusionGAN: A generative adversarial network for infrared and visible image fusion,” Information Fusion, vol. 48, pp. 11–26, 2019. doi · public article transcription
- H. Bai, J. Zhang, Z. Zhao, Y. Wu, L. Deng, Y. Cui, T. Feng and S. Xu, “Task-driven image fusion with learnable fusion loss,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2025, pp. 7457–7468. CVF arXiv
- Z. Zhao, H. Bai, Y. Zhu, J. Zhang, S. Xu, Y. Zhang, K. Zhang, D. Meng, R. Timofte and L. Van Gool, “DDFM: Denoising diffusion model for multi-modality image fusion,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV), 2023, pp. 8082–8093. CVF arXiv
- X. Yi, H. Xu, H. Zhang, L. Tang and J. Ma, “Text-IF: Leveraging semantic text guidance for degradation-aware and interactive image fusion,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024, pp. 27026–27035. CVF arXiv
- D. Wang, J. Liu, X. Fan and R. Liu, “Unsupervised misaligned infrared and visible image fusion via cross-modality image generation and registration,” in Proc. International Joint Conference on Artificial Intelligence (IJCAI), 2022, pp. 3508–3515. doi arXiv
- L. Tang, Y. Deng, Y. Ma, J. Huang and J. Ma, “SuperFusion: A versatile image registration and fusion network with semantic awareness,” IEEE/CAA Journal of Automatica Sinica, vol. 9, no. 12, pp. 2121–2137, 2022. doi
- A. Toet, “The TNO multiband image data collection,” Data in Brief, vol. 15, pp. 249–251, 2017. doi
- L. Tang, J. Yuan, H. Zhang, X. Jiang and J. Ma, “PIAFusion: A progressive infrared and visible image fusion network based on illumination aware,” Information Fusion, vol. 83–84, pp. 79–92, 2022. doi MSRS
- Q. Ha, K. Watanabe, T. Karasawa, Y. Ushiku and T. Harada, “MFNet: Towards real-time semantic segmentation for autonomous vehicles with multi-spectral scenes,” in Proc. IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), 2017, pp. 5108–5115. doi
- X. Jia, C. Zhu, M. Li, W. Tang and W. Zhou, “LLVIP: A visible-infrared paired dataset for low-light vision,” in Proc. IEEE/CVF International Conference on Computer Vision (ICCV) Workshops, 2021, pp. 3496–3504. CVF arXiv
- J. Cai, S. Gu and L. Zhang, “Learning a deep single image contrast enhancer from multi-exposure images,” IEEE Transactions on Image Processing, vol. 27, no. 4, pp. 2049–2062, 2018. doi
- X. Zhang, “Deep learning-based multi-focus image fusion: A survey and a comparative study,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 9, 2022. doi
- F. Xu, J. Liu, Y. Song, H. Sun and X. Wang, “Multi-exposure image fusion techniques: A comprehensive review,” Remote Sensing, vol. 14, no. 3, art. 771, 2022. doi
- Z. Zhao, H. Bai, J. Zhang, Y. Zhang, K. Zhang, S. Xu, D. Chen, R. Timofte and L. Van Gool, “Equivariant multi-modality image fusion,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024, pp. 25912–25921. CVF arXiv
- L. Tang, Y. Wang, M. Gong, Z. Li, Y. Deng, X. Yi, C. Li, H. Xu, H. Zhang and J. Ma, “VideoFusion: A spatio-temporal collaborative network for multi-modal video fusion,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2026, pp. 19559–19569. CVF
- N. Yokoya, C. Grohnfeldt and J. Chanussot, “Hyperspectral and multispectral data fusion: A comparative review of the recent literature,” IEEE Geoscience and Remote Sensing Magazine, 2017. doi
- H. R. Sheikh and A. C. Bovik, “Image information and visual quality,” IEEE Transactions on Image Processing, 2006. doi
- H. Xu et al., “U2Fusion,” official implementation accompanying the TPAMI paper, 2022. code
- K. Simonyan and A. Zisserman, “Very deep convolutional networks for large-scale image recognition,” ICLR, 2015. arXiv
- J. Kirkpatrick et al., “Overcoming catastrophic forgetting in neural networks,” Proceedings of the National Academy of Sciences, 2017. doi
- Y. Zhang et al., “IFCNN,” official implementation and errata accompanying the Information Fusion paper, 2020. code
- K. He, X. Zhang, S. Ren and J. Sun, “Deep residual learning for image recognition,” CVPR, 2016. CVF
- J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li and L. Fei-Fei, “ImageNet: A large-scale hierarchical image database,” CVPR, 2009. doi
- N. Silberman, D. Hoiem, P. Kohli and R. Fergus, “Indoor segmentation and support inference from RGBD images,” ECCV, 2012. project
- P. Dhariwal and A. Nichol, “Diffusion models beat GANs on image synthesis,” NeurIPS, 2021. arXiv
- J. Liu et al., “TarDAL,” official implementation accompanying the CVPR paper, 2022. code
- G. Jocher et al., “YOLOv5,” Ultralytics object-detection software, 2020 onward. code
- J. Ma et al., “FusionGAN,” official implementation accompanying the Information Fusion paper, 2019. code
- L. Tang, J. Yuan and J. Ma, “SeAFusion,” official implementation accompanying the Information Fusion paper, 2022. code
- T. Mertens, J. Kautz and F. Van Reeth, “Exposure Fusion,” in Proc. Pacific Graphics, 2007. paper · author project
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 11・三維重建:從多視角幾何到 NeRF 與 Gaussian Splatting · 37 分鐘