DLCV 09A・非盲影像超解析度
先備知識:DLCV 09・深度影像復原:低階視覺、IP 02・數位影像基礎、IP 04・頻域濾波
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 2 個互動實驗
一個模糊的觀測同時符合兩種清晰的乾淨訊號。模糊的平均值期望平方誤差最低;清晰的猜測看起來較好,但通常離真相較遠。
你將學到
- 說明即使退化已知,超解析度仍有多解。
- 區分 MSE 的條件平均與 L1 的逐座標中位數。
- 比較上採樣、殘差學習、正規化與注意力選擇。
- 解讀感知與生成目標的忠實度—真實感取捨。
- 註明色彩、邊界及退化協定進行評估,並檢查偽影。
先看全貌
超解析度要把小圖放大,也讓它更清楚。伸展像素容易,補足從未記錄的細節才難;模型從自然影像知識補上內容,同時帶來能力與風險。
手機數位變焦、遊戲與影片放大、衛星與顯微影像都會遇到 SR,許多殘差學習與生成先驗也先在此接受檢驗。
範圍。 本章談退化已知的非盲單圖 SR,主要是固定 bicubic,適合先學架構。未知退化見 DLCV 09A.1;影片見 DLCV 09A.3;一般生成先驗見 DLCV 09B;損失與指標見 DLCV 09。先備是 IP 02 插值 和 IP 04 混疊。
貫穿範例。 以 skimage.data 的 512 × 512 太空人,經已知模糊及區塊平均縮小四倍再放大。程式用 NumPy、SciPy、scikit-image、scikit-learn、OpenCV,可在 CPU 快速執行。
問題:一個輸入,許多答案
縮圖會失去資訊,多個 HR 可產生同一 LR;平方誤差以它們的平均為目標,可能模糊位置不一致的邊緣和紋理。
問題設定與符號
單圖超解析度(SISR)從 估計 , 是倍率, 是 LR 尺寸, 是色彩通道。DLCV 09 的前向模型為:
是光學、像素積分或抗混疊核, 是逐通道二維卷積, 每 留一個樣本, 為雜訊。非盲推論已知核、倍率及雜訊,條件模型可接受變動值;本章多用訓練/測試相符的固定退化,通常每倍率另訓練。多張位移 LR 的舊式多幀問題 [1] 見影片 SR。
為什麼這是病態問題
HR 未知數是量測的 倍。 時,整體維度每個量測對應 16 個未知,即使無雜訊且算子滿列秩,仍至少有 15 個自由維度。模糊會跨區塊混合,這不是每塊有 15 個獨立不可見像素。 有大零空間:若 ,加上 不改變觀測。細紋、精確邊緣和小字常落在這類未約束資訊。
所以 SR 需要一個先驗(prior),也就是「哪些 HR 影像是合理的」的模型。依貝氏定理,每個 HR 候選都有一個後驗機率
其中 是概似(likelihood,在給定雜訊下 能多好地解釋 ), 是先驗。傳統方法手寫先驗;深度 SR 則從(LR, HR)配對中學習先驗。
後驗平均造成的模糊
大多數 SR 網路都是在配對上最小化像素損失來訓練的。用平方誤差時,最好的網路輸出的是後驗平均(posterior mean)
這是最小均方誤差(MMSE)估計;L1 則以逐座標後驗中位數為最優,未必等於平均。若多個清楚候選的邊位置/紋理相位不同,平均會變平滑,甚至不是合理樣本。更多資料不能消除目標本身的平均效果。
一個一維的小例子可以把這件事講清楚。一個 64 個取樣的 HR 訊號是一個位置未知的階梯邊緣。我們把每 4 個取樣平均成一個,加上標準差 0.2 的雜訊,然後精確算出 32 個可能邊緣位置上的後驗、它的平均,以及從中隨機抽出的一個樣本。
程式碼 · Python · 22 行
import numpy as np

rng = np.random.default_rng(0)
n, s, sigma = 64, 4, 0.2                 # HR length, scale factor, LR noise level
cand = np.arange(16, 48)                 # possible edge positions t (the prior: uniform)
X = (np.arange(n)[None, :] >= cand[:, None]).astype(float)    # every HR step edge x_t
DX = X.reshape(len(cand), n // s, s).mean(axis=2)              # their LR versions D(x_t)

err_mmse, err_samp, jump_mmse, jump_samp = [], [], [], []
for _ in range(2000):
    t = rng.integers(len(cand))
    y = DX[t] + sigma * rng.standard_normal(n // s)               # observed LR signal
    logp = -((y - DX) ** 2).sum(axis=1) / (2 * sigma**2)          # log posterior over t
    post = np.exp(logp - logp.max()); post /= post.sum()
    x_mmse = post @ X                                             # posterior mean E[x | y]
    x_samp = X[rng.choice(len(cand), p=post)]                     # one posterior sample
    err_mmse.append(np.mean((x_mmse - X[t]) ** 2)); err_samp.append(np.mean((x_samp - X[t]) ** 2))
    jump_mmse.append(np.diff(x_mmse).max()); jump_samp.append(np.diff(x_samp).max())

print(f"MSE   posterior mean {np.mean(err_mmse):.4f} | posterior sample {np.mean(err_samp):.4f} "
      f"| ratio {np.mean(err_samp) / np.mean(err_mmse):.2f}")
print(f"largest one-pixel jump (a real edge has 1.00): mean {np.mean(jump_mmse):.2f} | sample {np.mean(jump_samp):.2f}")
輸出
MSE   posterior mean 0.0072 | posterior sample 0.0143 | ratio 1.97
largest one-pixel jump (a real edge has 1.00): mean 0.48 | sample 1.00
後驗平均的誤差只有後驗樣本的一半,但它的邊緣是斜坡:平均而言,它最大的單像素跳躍只有 0.48,而每個真實邊緣(以及每個樣本)都跳 1.00。樣本看起來和真實邊緣一模一樣,只是有時位置不對。比值約為 2 並非巧合。Blau 與 Michaeli 證明,如果一個估計器的輸出分布與真實影像完全相同(例如後驗取樣器),它的 MSE 永遠不需要超過 MMSE 估計器的兩倍,也就是 PSNR 差 3 dB [2]。圖 1 顯示一個例子,以及兩個估計器之間的整個範圍。
選讀:為什麼後驗樣本的誤差是 MMSE 的兩倍(見「補充資料」頁)。用幾行推導出這個 2 倍。
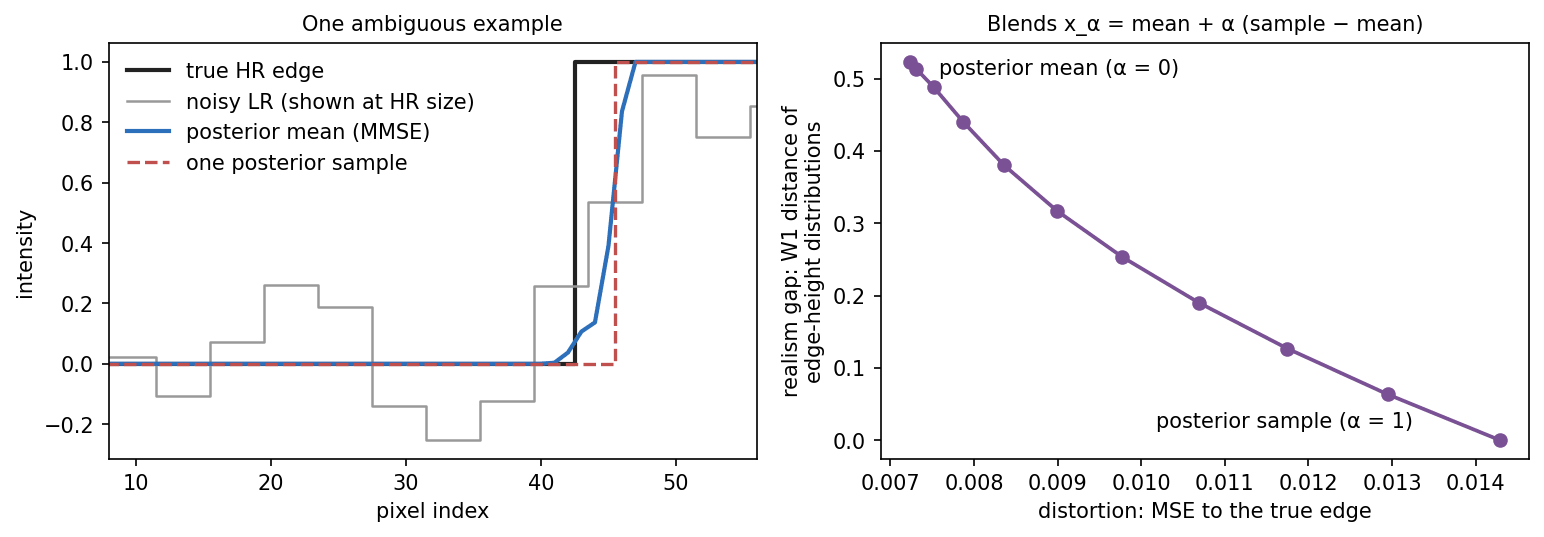
這個小例子串起全章:MSE 取平均,L1 取中位數,兩者給中心預測;感知/GAN 偏好合理細節,隨機擴散能抽不同候選。評估須分開保真、自然外觀及不確定性。
從頻域看 LR 失去的資訊
白話說。 下採樣可能造成混疊並削弱細節;SR 須恢復受損結構,也須推估輸入已無法決定的資訊。
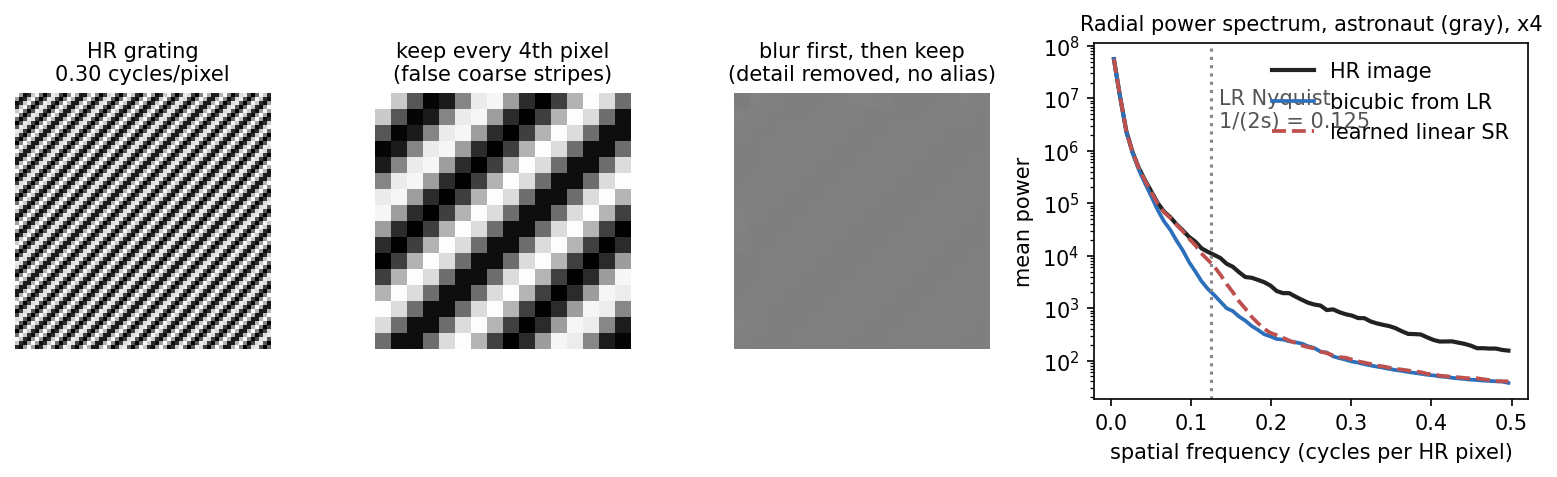
LR Nyquist 上限為每 HR 像素 週期, 時 0.125。更高頻可能折回低頻成混疊,或被前模糊移除,見 IP 04。上限以上無法由量測唯一確定,下方被模糊削弱的頻帶則須復原。
選讀:LR 頻譜的混疊(見「補充資料」)。頻率折疊公式及圖 2 條紋例子。
基準設定:已知退化
用固定已知算子產生 LR—HR 配對,再對原圖計算重建誤差;常見規則是亮度通道 PSNR。
多數基準用 MATLAB imresize 預設 bicubic,縮小時預設抗混疊 [3]、[4];沒有額外雜訊、相機模糊或壓縮。可重現使多年結果可比,但模型只學反解這個算子。
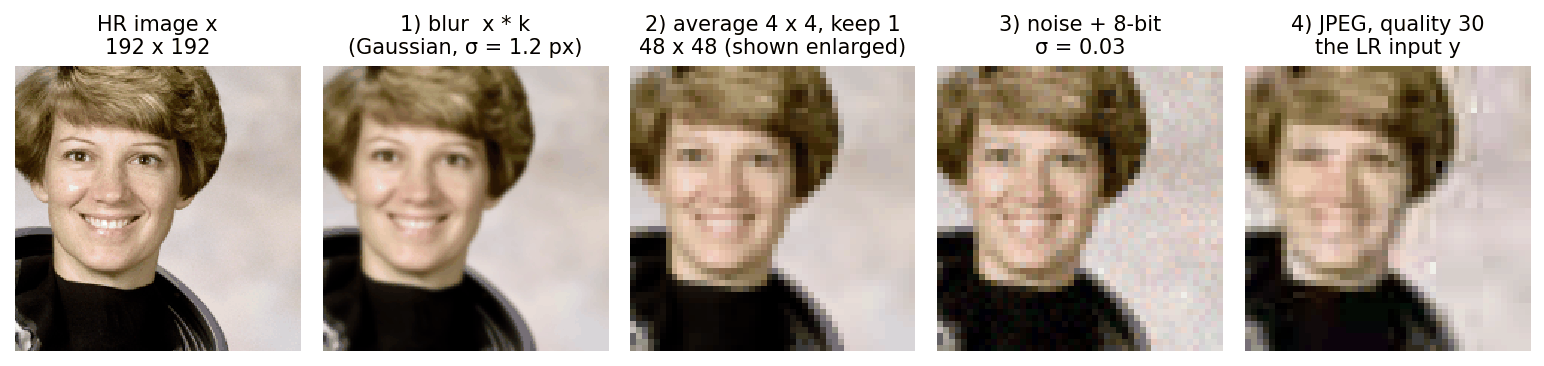
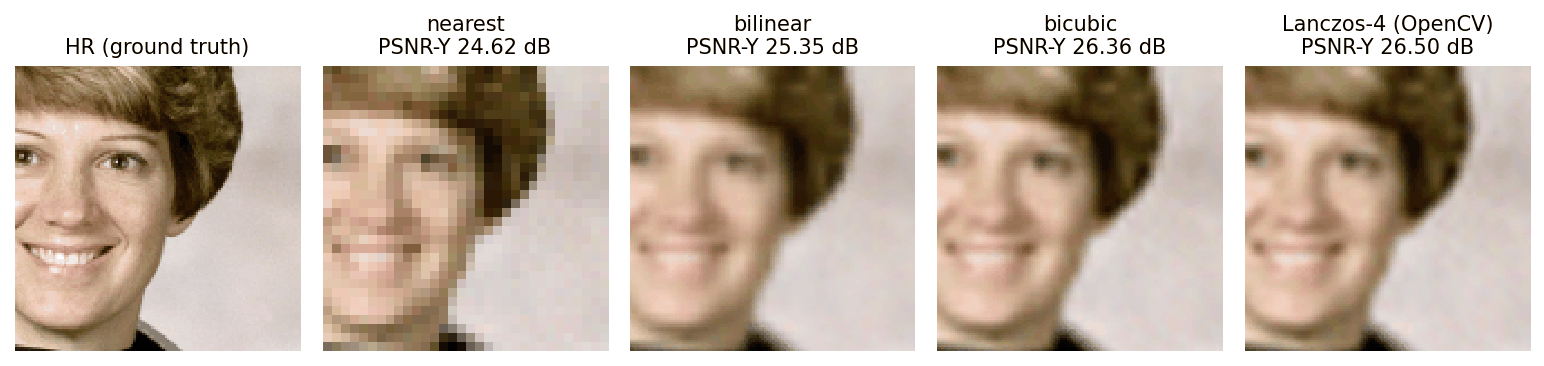
本章用另一個已知配方:HR 高斯寬 1.2、4 × 4 平均、Gaussian 0.01、八位元量化。比較四種插值,按 Y 通道、裁 邊框計 PSNR。
程式碼 · Python · 32 行
import numpy as np, cv2
from scipy import ndimage as ndi
from skimage import data, img_as_float64

def degrade(hr, s=4, blur=1.2, noise=0.01, rng=None):
    """hr: (H, W, 3) in [0, 1], H and W divisible by s. Returns the LR image y."""
    rng = rng or np.random.default_rng(0)
    x = ndi.gaussian_filter(hr, sigma=(blur, blur, 0))          # 1) lens blur
    H, W, C = x.shape
    x = x.reshape(H // s, s, W // s, s, C).mean(axis=(1, 3))      # 2) s x s pixel integration + decimation
    x = x + noise * rng.standard_normal(x.shape)                  # 3) sensor noise
    return np.round(np.clip(x, 0, 1) * 255) / 255                 # 4) 8-bit quantization

def y_channel(rgb):
    """BT.601 luma on the [16, 235] scale (the MATLAB rgb2ycbcr convention)."""
    return 16 + rgb @ np.array([65.481, 128.553, 24.966])

def psnr(a, b, shave, peak):
    if shave:
        a, b = a[shave:-shave, shave:-shave], b[shave:-shave, shave:-shave]
    return 10 * np.log10(peak**2 / np.mean((a - b) ** 2))

hr = img_as_float64(data.astronaut())                             # (512, 512, 3)
lr = degrade(hr)                                                  # (128, 128, 3)
print("LR shape:", lr.shape)
for name, flag in [("nearest", cv2.INTER_NEAREST), ("bilinear", cv2.INTER_LINEAR),
                   ("bicubic", cv2.INTER_CUBIC), ("lanczos", cv2.INTER_LANCZOS4)]:
    sr = cv2.resize(lr, (512, 512), interpolation=flag)
    sr = np.clip(sr, 0, 1)
    y_hr, y_sr = y_channel(hr), y_channel(sr)
    print(f"{name:8s}  Y, shave 4: {psnr(y_hr, y_sr, 4, 255):.2f} dB | "
          f"Y, no shave: {psnr(y_hr, y_sr, 0, 255):.2f} dB | RGB, shave 4: {psnr(hr, sr, 4, 1):.2f} dB")
輸出
LR shape: (128, 128, 3)
nearest   Y, shave 4: 24.62 dB | Y, no shave: 24.66 dB | RGB, shave 4: 23.06 dB
bilinear  Y, shave 4: 25.35 dB | Y, no shave: 25.40 dB | RGB, shave 4: 23.83 dB
bicubic   Y, shave 4: 26.36 dB | Y, no shave: 26.40 dB | RGB, shave 4: 24.81 dB
lanczos   Y, shave 4: 26.50 dB | Y, no shave: 26.54 dB | RGB, shave 4: 24.94 dB
此例各規則的排名相同,Y 與 RGB 卻差約 1.5 dB,因此只比相同計算規則。
圖 3 再加入 JPEG。非盲是假設整條鏈已知;未知或逐圖變化則轉入盲/真實 SR。
傳統基準方法
插值以固定濾波器分配既有樣本;學得線性濾波可補部分細節,但仍難描述自然影像的多樣性。
插值:固定線性濾波
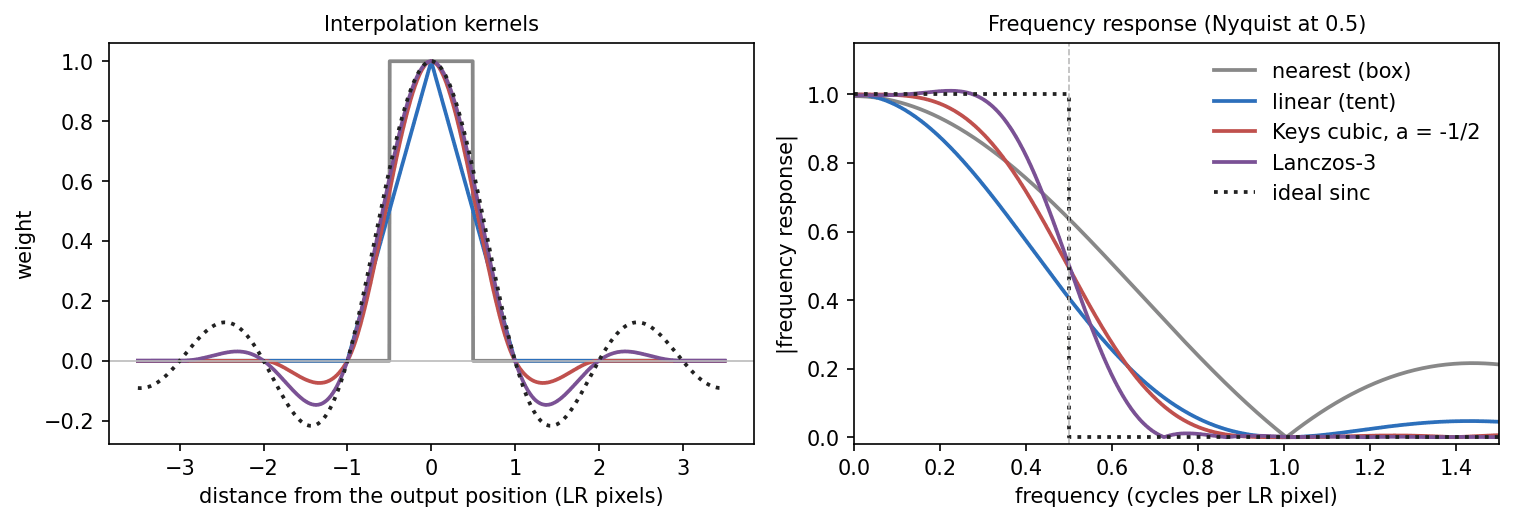
內插把 LR 取樣放到 HR 網格上,再用鄰近取樣的加權和填補空隙。在一維中,
是 HR 索引, 是 LR 索引, 為插值核,半像素項對齊 OpenCV 的像素中心慣例;二維沿列與行分離套用。IP 02 有常見核推導。
- 最近鄰/線性: 寬 1 方盒與寬 2 三角,分別偏塊狀和柔軟。
- 三次卷積: Keys [5] 的寬 4 分段三次式, 有該家族的最佳近似階;小負瓣略銳化。OpenCV
INTER_CUBIC用 。 - Lanczos: ,,其餘零;, 為單側葉數 [6]。
INTER_LANCZOS4用 4。
較寬的核更接近理想 sinc,Lanczos 此例 26.50 dB 略高於 bicubic 26.36。但固定插值對邊緣和平坦區使用同一線性規則,不能從 LR 唯一確定缺失真實頻率;有限核也會產生頻譜複本和振鈴,有高頻不代表恢復原細節。
從配對區塊學線性濾波
白話說。 從配對範例學習區塊映射,再用預先計算的線性修正有效率地處理相似區塊。
範例法從外部資料 [7] 或單圖跨尺度重複 [8] 找配對,稀疏編碼用雙字典 [9];ANR/A+ 預算 ridge 迴歸 [10]、[11],RAISR 依梯度方向、強度及一致性分桶 [12]。共同形式為:
其中 是 LR 區塊, 是它的特徵向量, 是它所屬的類別(原子或雜湊桶), 是要預測的 HR 細節, 是類別 的訓練配對,分別堆疊成 與 的列, 是嶺迴歸的權重, 是 Frobenius 範數。
選讀:以範例為基礎的 SR 與稀疏編碼細節(見「補充資料」頁)。列出稀疏編碼的目標函數,以及 ZSSR 背後的內部學習想法。
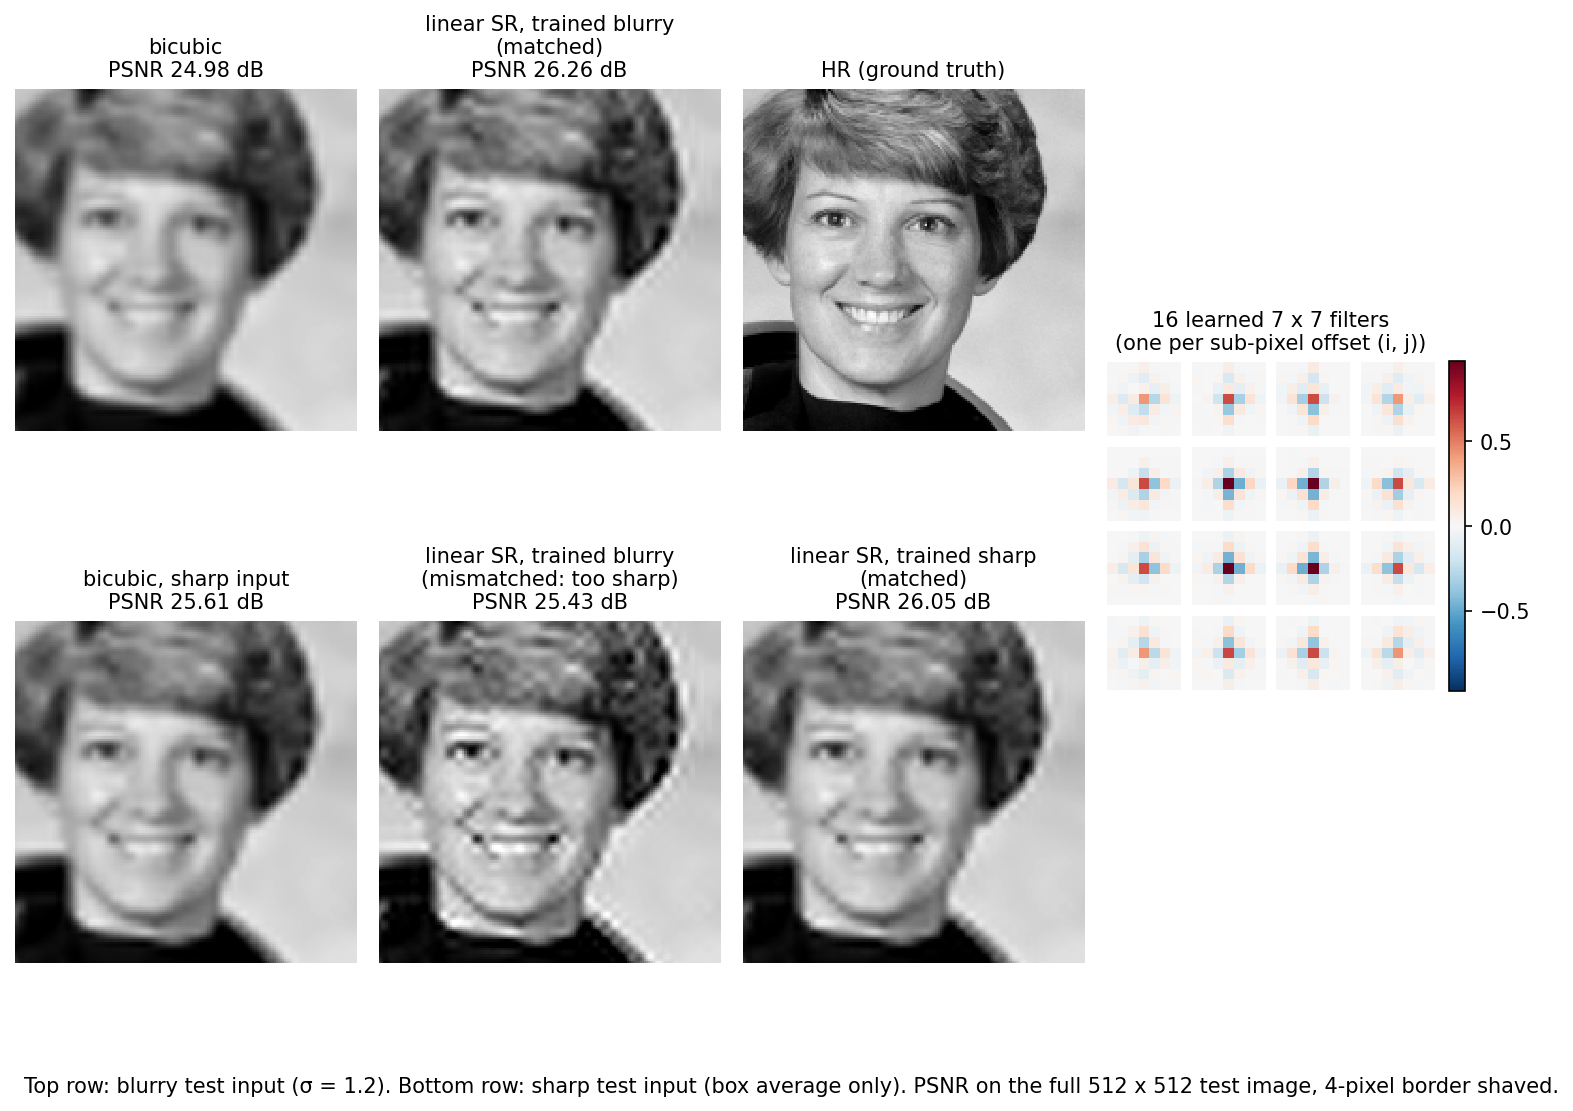
此例灰階每個 LR 點取 7 × 7 鄰域、去平均加偏置,預測 4 × 4 HR 殘差。每點輸出 再重排為區塊,即單層線性子像素卷積。用另 11 張 skimage 圖,分別以只有平均的銳利 LR、及先模糊 1.2 再平均的 LR 訓練,測太空人。
程式碼 · Python · 53 行
import numpy as np, cv2
from numpy.lib.stride_tricks import sliding_window_view
from scipy import ndimage as ndi
from skimage import data, img_as_float64
from skimage.color import rgb2gray

s, p = 4, 7                                     # scale factor, LR patch size

def degrade(x, blur):                           # blur (optional) -> s x s average
    x = ndi.gaussian_filter(x, blur) if blur else x
    H, W = x.shape[0] // s * s, x.shape[1] // s * s
    return x[:H, :W].reshape(H // s, s, W // s, s).mean(axis=(1, 3))

def bicubic(lr):
    return cv2.resize(lr, None, fx=s, fy=s, interpolation=cv2.INTER_CUBIC)

def features(lr):                               # one p x p patch per LR pixel, mean removed, plus a bias
    f = sliding_window_view(np.pad(lr, p // 2, mode="reflect"), (p, p)).reshape(lr.size, p * p)
    return np.c_[f - f.mean(axis=1, keepdims=True), np.ones(lr.size)]

def to_blocks(r):                               # HR residual -> one s*s vector per LR pixel (space-to-depth)
    h, w = r.shape[0] // s, r.shape[1] // s
    return r.reshape(h, s, w, s).transpose(0, 2, 1, 3).reshape(h * w, s * s)

def from_blocks(b, h, w):                       # inverse: depth-to-space (pixel shuffle)
    return b.reshape(h, w, s, s).transpose(0, 2, 1, 3).reshape(h * s, w * s)

def train(images, blur, lam=1e-3):
    A, B = [], []
    for im in images:
        im = im[: im.shape[0] // s * s, : im.shape[1] // s * s]
        lr = degrade(im, blur)
        A.append(features(lr)); B.append(to_blocks(im - bicubic(lr)))
    A, B = np.concatenate(A), np.concatenate(B)
    return np.linalg.solve(A.T @ A + lam * np.eye(A.shape[1]), A.T @ B)   # ridge: (p*p+1, s*s)

def super_resolve(lr, Wt):
    return bicubic(lr) + from_blocks(features(lr) @ Wt, *lr.shape)

def psnr(a, b):
    a, b = a[s:-s, s:-s], b[s:-s, s:-s]          # shave s border pixels
    return 10 * np.log10(1.0 / np.mean((a - np.clip(b, 0, 1)) ** 2))

train_imgs = [img_as_float64(im) for im in (data.camera(), data.moon(), data.coins(), data.page(),
              data.text(), data.brick(), data.grass(), data.gravel(),
              rgb2gray(data.coffee()), rgb2gray(data.chelsea()), rgb2gray(data.rocket()))]
models = {"trained sharp": train(train_imgs, 0.0), "trained blurry": train(train_imgs, 1.2)}
test = img_as_float64(rgb2gray(data.astronaut()))           # never seen in training
print("weights per model:", models["trained sharp"].shape)
for name, blur in [("sharp", 0.0), ("blurry", 1.2)]:
    lr = degrade(test, blur)
    row = "  ".join(f"{m} {psnr(test, super_resolve(lr, W)):.2f}" for m, W in models.items())
    print(f"test {name:6s} | bicubic {psnr(test, bicubic(lr)):.2f} | {row}  (dB)")
輸出
weights per model: (50, 16)
test sharp  | bicubic 25.61 | trained sharp 26.05  trained blurry 25.43  (dB)
test blurry | bicubic 24.98 | trained sharp 25.66  trained blurry 26.26  (dB)
每模型只有 權重,約一秒封閉求解。退化相符時比 bicubic 增 0.44/1.28 dB。模糊訓練模型遇銳利輸入會過銳化,25.43 低於 bicubic 25.61;銳利訓練遇模糊修不足,25.66 低於匹配模型 26.26。正確退化假設很重要,Efrat 等人 [13] 也有相關經典結果。圖 6 的 16 濾波對應 16 子像素偏移。
 雙三次線性 SR(退化相符)
深度 SR:六個設計決策
深網路是前面線性迴歸的非線性擴充。從三層 CNN 到 Transformer,可沿六個解決具體問題、也帶來成本的決策理解。
表 1 是本節地圖,下文按同一順序解釋。
| 決策 | 代表模型 | 解決問題 | 代價 |
|---|---|---|---|
| 1. Bicubic 後端到端學習 | SRCNN [14] | 手工區塊管線 | 每層在 HR 工作 |
| 1. 改在末端放大 | FSRCNN [15]、ESPCN [16] | HR 的 成本 | 每倍率放大尾端 |
| 2. 子像素卷積 | ESPCN [16] | 學得放大器成本 | 初始化棋盤紋 |
| 3. 深網路及殘差 | VDSR [17] | 深層訓練慢/不穩 | 計算與啟動記憶體 |
| 4. 去 BN、殘差縮放 | EDSR [18] | 記憶體及動態範圍 | 寬模型須穩定化 |
| 5. 通道注意力、殘差中殘差 | RCAN [19] | 通道等權、400 多層訓練 | 深度帶來延遲 |
| 6. 遠距內容注意力 | SwinIR [20]、HAT [21] | 固定局部卷積 | 注意力時間/記憶體 |
這些像素損失模型仍是中心估計:MSE 為條件平均,L1 為逐座標中位數,不代表完整分布。架構可改善預測,下一節則改變統計目標。
決策一:在哪裡放大
白話說。 每軸放大 倍後有 倍像素。先放大使後續每層都在大圖工作,後放大則讓主體留在小圖。
SRCNN [14] 先 bicubic,再三卷積做區塊抽取、非線性映射與重建。前放大簡單,也可共用多倍率,如 VDSR [17];但 、、 卷積需要:
次乘加。成本正比 ,相同層在 HR 精確多 倍。
程式碼 · Python · 11 行
def conv_macs(h, w, c_in, c_out, k=3):
    """Multiply-accumulates of one k x k convolution on an h x w feature map."""
    return h * w * c_in * c_out * k * k

s, H, W, C = 4, 128, 128, 64                    # x4 SR of a 128 x 128 input, 64 feature channels
body_pre = conv_macs(s * H, s * W, C, C)        # one body layer at HR size (pre-upsampling)
body_post = conv_macs(H, W, C, C)               # the same layer at LR size (post-upsampling)
tail = conv_macs(H, W, C, 3 * s * s)            # sub-pixel tail: 64 -> 3*s*s channels, then pixel shuffle
print(f"one body layer, pre-upsampling : {body_pre / 1e9:.2f} GMAC")
print(f"one body layer, post-upsampling: {body_post / 1e9:.2f} GMAC (ratio {body_pre / body_post:.0f})")
print(f"sub-pixel tail, 64 -> 48 channels at LR size: {tail / 1e9:.2f} GMAC")
輸出
one body layer, pre-upsampling : 9.66 GMAC
one body layer, post-upsampling: 0.60 GMAC (ratio 16)
sub-pixel tail, 64 -> 48 channels at LR size: 0.45 GMAC
128 × 128 LR、×4 的 64 通道層,HR 約 9.66 GMAC、LR 0.60。FSRCNN [15] 用末端轉置卷積及薄映射,在 C++ Intel i7 比較中比 SRCNN-Ex 快逾 40 倍。代價是尾端依倍率;MDSR [18] 共享主體、×2/×3/×4 各尾端。後續多採末端放大。
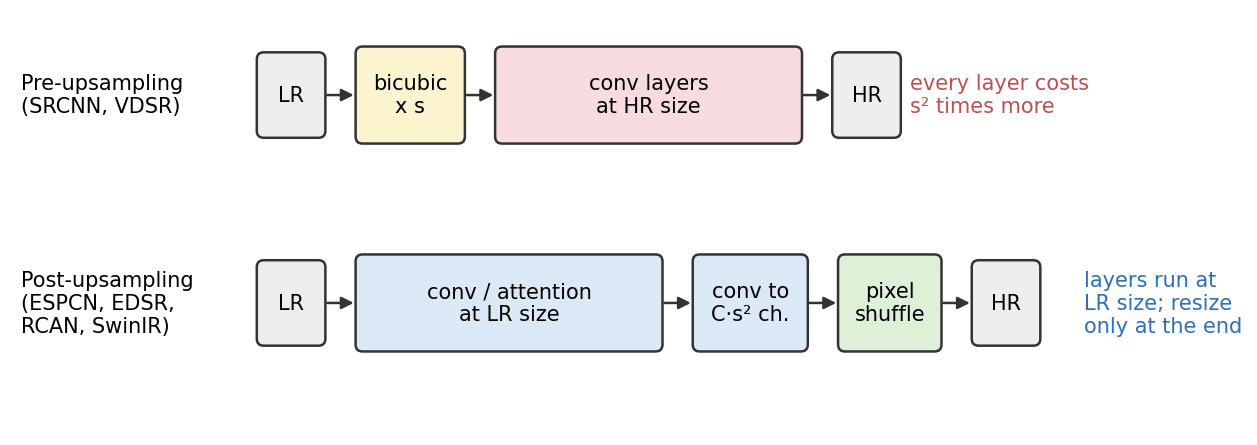
決策二:轉置或子像素卷積
白話說。 每 LR 點需產生 個輸出。轉置卷積把每點以學得印章分散出去;子像素卷積在 LR 算成 通道,再重排為區塊。
stride 的轉置卷積等價於樣本間插 零再卷積。不同輸出偏移只使用不同核係數,總共 模式,因此可寫成 LR 的多個卷積再交錯輸出 [16]。ESPCN 末層直接輸出 ,無參數 pixel shuffle 變成 通道大圖;EDSR/RCAN/SwinIR/HAT 也使用 [18]、[19]、[20]、[21]。
精確的版本是一條索引規則。設 是形狀為 的 LR 特徵張量, 是形狀為 的輸出,則
是輸出通道, 是 LR 位置, 是區塊內子像素偏移;依行優先將 通道散到區塊。這符合 PyTorch PixelShuffle [22] 將通道拆成 再排列的慣例。反向 pixel unshuffle 把區塊收回通道,高效率模型可用它先降低空間大小。
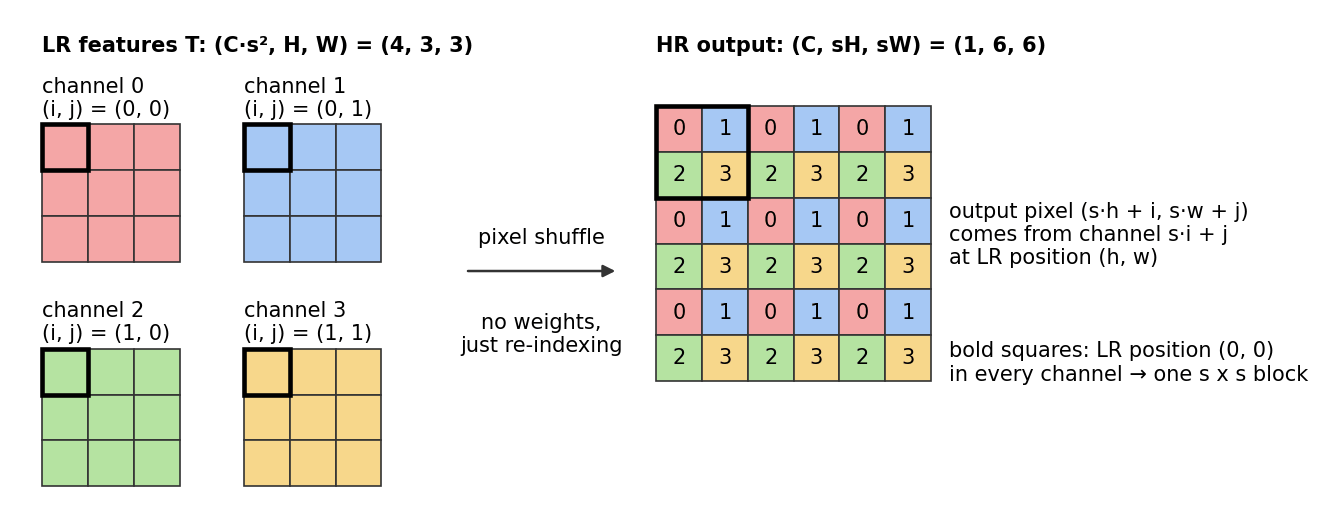
NumPy 用 reshape/transpose/reshape 實作兩方向,逐元素檢查索引式及精確互逆。
程式碼 · Python · 27 行
import numpy as np

def pixel_shuffle(t, s):
    """Depth-to-space: (C*s*s, H, W) -> (C, H*s, W*s)."""
    Cs2, H, W = t.shape
    C = Cs2 // (s * s)
    return t.reshape(C, s, s, H, W).transpose(0, 3, 1, 4, 2).reshape(C, H * s, W * s)

def pixel_unshuffle(x, s):
    """Space-to-depth: (C, H*s, W*s) -> (C*s*s, H, W)."""
    C, Hs, Ws = x.shape
    H, W = Hs // s, Ws // s
    return x.reshape(C, H, s, W, s).transpose(0, 2, 4, 1, 3).reshape(C * s * s, H, W)

rng = np.random.default_rng(0)
s, C, H, W = 3, 2, 4, 5
t = rng.standard_normal((C * s * s, H, W))
x = pixel_shuffle(t, s)
print(x.shape)                                                   # (2, 12, 15)

# The index rule: output (c, s*h + i, s*w + j) comes from channel c*s*s + s*i + j at (h, w).
ok = all(x[c, s*h + i, s*w + j] == t[c*s*s + s*i + j, h, w]
         for c in range(C) for h in range(H) for w in range(W)
         for i in range(s) for j in range(s))
print("index rule holds:", ok)
print("unshuffle(shuffle(t)) == t:", np.array_equal(pixel_unshuffle(x, s), t))
print("shuffle(unshuffle(x)) == x:", np.array_equal(pixel_shuffle(pixel_unshuffle(x, s), s), x))
輸出
(2, 12, 15)
index rule holds: True
unshuffle(shuffle(t)) == t: True
shuffle(unshuffle(x)) == x: True
核尺寸為 倍數時,可對應兩種放大表示。Pixel shuffle 是排列、精確可逆、梯度為反排列,但各偏移獨立濾波,隨機初始化可能讓平坦輸入變棋盤紋。ICNR [23] 將偏移濾波初始化為副本,起始等價卷積後最近鄰放大。DLCV 01B 有程式分析;線性例子的 16 個核就是此偏移。
決策三:深度與殘差預測
白話說。 深層網路捕捉較廣上下文,但較難最佳化;殘差學習只預測簡單放大輸入的修正量。
VDSR [17] 以 20 層 3 × 3 卷積和兩項設計使深層可訓練。先用全域殘差,讓 只補插值修正:
為 bicubic, 接收 HR 大小輸入, 是輸出, 為配對損失;再用高學習率搭配可調梯度裁切 [17]。
選讀:可調梯度裁切(見「補充資料」)。VDSR 裁切規則與學習率的關係。
插值已含低頻,目標 較小、以零為中心;以下在貫穿範例測量。
程式碼 · Python · 12 行
import numpy as np, cv2
from scipy import ndimage as ndi
from skimage import data, img_as_float64
from skimage.color import rgb2gray

s = 4
hr = img_as_float64(rgb2gray(data.astronaut()))                        # (512, 512), values in [0, 1]
lr = ndi.gaussian_filter(hr, 1.2).reshape(128, s, 128, s).mean(axis=(1, 3))   # the running example
up = cv2.resize(lr, None, fx=s, fy=s, interpolation=cv2.INTER_CUBIC)   # bicubic upsampling
r = hr - up                                                            # what a residual network predicts
print(f"HR image: mean {hr.mean():.3f}  std {hr.std():.3f}")
print(f"residual: mean {r.mean():+.3f}  std {r.std():.3f}  |r| < 0.05 at {np.mean(np.abs(r) < 0.05):.0%} of pixels")
輸出
HR image: mean 0.442  std 0.296
residual: mean -0.000 std 0.056 |r| < 0.05 at 82% of pixels殘差標準差約為影像五分之一,82% 像素絕對值低於 0.05。零輸出已接近 bicubic,可集中容量處理邊紋。末端放大模型保留局部殘差及長跳接,見 DLCV 01B。加法便宜,不代表增加主體深度免費。
決策四:移除批次正規化
白話說。 BN 重新縮放特徵,分類常有用,但 SR 要保留精確強度與範圍。EDSR 移除它,將記憶體用於更寬網路。
訓練 BN 用批次統計,測試用移動統計。SRResNet [24] 保留 BN,EDSR [18] 為範圍彈性與記憶體移除,訓練相較約省 40%。完整模型 32 殘差塊、256 通道,以 0.1 殘差縮放穩定;改 L1,×3/×4 由 ×2 初始化,贏 NTIRE 2017 [25]。ESRGAN [26] 又指出統計不符時 BN 可生偽影。
去 BN 仍須小心初始化及縮放。啟動範圍也可能更大,使量化困難,見 DLCV 01C;一般正規化選擇見 DLCV 01B。
決策五:通道重新加權(RCAN)
白話說。 不同通道承載低頻或細節,通道注意力依影像調高低,而非一律等權。
RCAN [19] 對各通道取平均,經瓶頸產生縮放。對 個 通道 :
是值, 為通道平均, 將 降為 , 是 ReLU, 還原, 是 sigmoid, 縮放通道。,瓶頸僅 4 通道。一般 SE 背景見 DLCV 01B。
殘差中殘差含 10 組、每組 20 通道注意力塊、短及長跳接,超過 400 層 [19]。低頻可走跳接,主體偏細節,但深度仍增加序列執行延遲。
決策六:遠距內容注意力(SwinIR、HAT)
白話說。 卷積用固定權重,注意力依內容產生權重,可借相似結構資訊。整圖昂貴,因此使用交替位移小視窗。
每個 LR token 視窗,注意力為:
為線性投影、各 列, 是 query/key 維度, 為相對位置偏置 [21]。每輸出按 query—key 相似度平均 values,見 ML 05。 token、 通道成本:
MSA 是全域,W-MSA 是視窗,首項投影、次項注意力 [27]。固定視窗時對像素線性,整圖則平方。、128 × 128 LR,每層約 98.8 GMAC 全域、2.50 GMAC 視窗,是本章算術例。
SwinIR [20] 淺層 3 × 3、殘差 Swin 主體及 pixel shuffle;標準設定 6 塊、各 6 層、視窗 8、寬 180、L1。HAT [21] 依 LAM 歸因發現利用範圍有限,加入平行通道注意力、視窗 16、重疊交叉注意力,及同 SR 任務的 ImageNet 預訓練,再微調 DIV2K/Flickr2K。DAT [28] 交替空間/通道,MambaIR [29] 用狀態掃描擴大上下文。
視窗、容量及大圖分塊增加時間與記憶體,也可能留接縫。L1 架構的改善來自更有效上下文,不是隨機抽樣。
共同配方。 DIV2K 或加 Flickr2K 小裁切,翻轉、90° 旋轉、L1、Adam;EDSR 用 48 × 48 LR。「+」如 EDSR+ 為八種幾何變換輸出還原平均 [18],並非免費。一般損失見 DLCV 09。
感知式與對抗式 SR
改變損失可獎勵自然細節,代價可能是較低 PSNR 與虛構,而非只改網路架構。
感知損失與 GAN
Johnson 等人 [31] 用 VGG [30] 感知距離得到較清晰但較低 PSNR;SRGAN [24] 加判別器與 16 殘差塊 SRResNet,提升人類偏好。ESRGAN [26] 用無 BN 的 RRDB、相對判別器和啟動前 VGG 特徵,其變體贏 PIRM 2018 區域 3 [32]。常見生成損失為:
為輸出, 為目標, 為固定特徵層, 為對抗項, 為權重;GAN 見 ML 07。
ESRGAN [26] 的網路內插以 、 混合像素模型及 GAN 微調權重,不重訓探索平滑/紋理取捨。
選讀:ESRGAN 設計詳解(見「補充資料」)。相對判別器、啟動前感知特徵與區塊結構。
感知–失真權衡
Blau 與 Michaeli [2] 以輸出和真值的期望差異定義失真,以輸出分布與真實分布的距離定義感知品質,研究最佳邊界。允許失真越小,最佳可達分布品質不會更好;歧義後驗的平均可能不自然,但無雜訊可逆問題未必有衝突。詳見 DLCV 09。本章從平均移向後驗樣本,MSE 0.0072→0.0143,自然度差距縮小。非線性權重內插不等於輸出內插,也不保證位於理論最優邊界。
- 方法應該說明它瞄準權衡上的哪個位置。只用 PSNR,或只用一個感知指標,去比較 GAN 與 MSE 網路,無法說明哪一個比較好。
- 基準必須同時量測兩個軸。PIRM 2018 挑戰賽就是這樣做的:它依 RMSE 把感知–失真平面分成三個區域(RMSE 上限分別為 11.5、12.5 與 16),在每個區域內以一個感知指數為方法排名,這個指數由兩個無參考指標組成:NIQE [33] 與 Ma 等人的 SR 專用指標 [34], [32]。
已知退化的擴散 SR
條件擴散近似條件影像分布,可產生多個合理候選,代價是迭代推論。訓練好的取樣器不自動證明精確貝氏後驗或量測一致性。
SR3 [35] 以 bicubic LR 做非盲條件,U-Net [36] 輸入為吵 HR 與 bicubic 放大 LR 的通道串接,學多種雜訊程度去除。推論從純高斯開始,原文最多 100 步。
×8 人臉 16→128 的研究,受試者把 SR3 當真照片接近 50%,GAN 基準至多 34%。×4 ImageNet 同骨幹回歸 PSNR/SSIM 較高,SR3 樣本品質較好;它也檢查縮回 LR 的一致性 [35]。訓練程序見 DLCV 09B,擴散機制見 ML 08。
生成細節未對齊會降 PSNR,即使人類偏好,但不是所有模型必然較低。內容仍可能錯且多次評估昂貴;大型先驗、少步/一步真實照片方法見 DLCV 09A.1。
退化未知:盲與真實世界 SR
白話說。 真圖帶未知模糊、雜訊及壓縮,固定 bicubic 模型會像前面錯配線性例子般誤判。方法可廣泛合成、先估退化或實拍配對,也須在無真值下評估;完整內容見 DLCV 09A.1:盲與真實世界超解析度。
任意倍率 SR
白話說。 固定 ×4 模型只能產生特定大小;任意倍率模型把影像視為連續函數,能查詢 ×2.7 等非整數輸出。
Meta-SR [37] 依倍率及輸出相對位置預測放大濾波權重;LIIF [38] 學局部隱式影像函數:
是連續查詢座標, 是 LR 編碼器在最近網格 的特徵, 是輸出 RGB 的小 MLP。原文以 ×1–×4 訓練,展示至 ×30。代價是每輸出像素一次 MLP;極端倍率依賴學得假設,不會增加量測資訊。
選讀:LIIF 的三項改良(見「補充資料」頁)。說明特徵展開、局部集成與像素格解碼。
效率
白話版。 許多 SR 用途(手機、視訊通話、遊戲算繪)需要在小晶片上以毫秒級的時間給出結果。高效率 SR 問的是:在維持品質門檻的前提下,網路可以做到多小、多快。
末端 pixel shuffle 先省空間成本,其他如 IMDN [39] 分出保留特徵、繼續處理部分,再以對比感知通道注意力融合。參數、FLOPs、時間不同;NTIRE 高效率 2024/2025 ×4 [40]、[41] 要求驗證 26.90 dB、測試 26.99 dB 以上再降低成本。壓縮見 DLCV 01C。
評估 SR
保真依固定 PSNR/SSIM 規則,外觀另加感知及人類評估,不能只用一個數字混排。一般指標見 DLCV 09,此處聚焦 SR 特有細節。
在 Y 通道上計算並裁去邊界的 PSNR 與 SSIM
經典 MATLAB 社群規則通常是:
- 把 HR 影像與 SR 輸出都轉成 YCbCr,只保留亮度(luma)通道
為 gamma 編碼,;係數依 MATLAB/scikit-image rgb2ycbcr 的 BT.601 [42]、[43]。
2. 兩張圖裁掉邊框,避免 padding 邊界主導。
3. 剩餘 Y 以峰值 255 算 PSNR 及 SSIM [44],定義見 DLCV 09。
同篇也可能不同:EDSR [18] 基準 Y 裁 ,消融 DIV2K 則 RGB 裁 ;NTIRE ×4 裁 4 [45]、[46]。通道/色域曾在報告例子差達 4 dB [4]。若 ,以 Y/峰 255 比 /峰 1 多 dB。量化、裁切和縮放也有影響,公平比較應用同一評估腳本。
標準測試集
SR 論文在一小組公開測試集上回報結果,每個測試集各有特色 [4]:
| 測試集 | 影像數 | 內容 | 出處 |
|---|---|---|---|
| Set5 | 5 | 嬰兒、鳥、蝴蝶、頭像、女性 | [47] |
| Set14 | 14 | 人物、動物、花、漫畫、投影片 | [48] |
| BSD100 (B100) | 100 | 自然場景,即 Berkeley 分割資料集的測試影像 | [49] |
| Urban100 | 100 | 具有規則結構的建築與城市景觀 | [50] |
| Manga109 | 109 | 日本漫畫單行本(線稿與網點) | [51], [52] |
| DIV2K validation | 100 | 多樣的 2K 解析度照片 | [53] |
Set5、Set14 很小,百分之幾 dB 意義有限;Urban100 重複結構多,大視窗 HAT 在此尤其受益 [21]。
為什麼 PSNR 與感知排名不一致
三種原因造成分歧:MSE 最優中心可能模糊;紋理統計對卻位移,像素誤差仍大;感知/無參考模型如 LPIPS [54]、NIQE [33] 評外觀,也可能被過銳化影響。NTIRE 2025 [46] 分 PSNR 復原及六指標合成感知賽道。DLCV 09 建議同報保真、感知,生成模型另做人類研究。
資料集與基準
白話說。 幾個資料集與年度競賽形塑了非盲 SR 的常見基準。
- DIV2K [53] 有 1,000 張 2K 圖,訓練/驗證/測試 800/100/100 [46];Flickr2K 有 2,650,合稱 DF2K。HAT [21] 先 ImageNet 同任務預訓練,再微調。
- NTIRE 2017 [25] 各有 bicubic、可由配對學習的未知退化,×2/×3/×4。
- NTIRE 2024/2025 [45]、[46] 用 DIV2K ×4 bicubic,2025 加感知賽道。
- 高效率 SR [40]、[41] 在固定品質門檻下比較時間、參數與 FLOPs。
真實資料與挑戰不只有乾淨 bicubic,見 DLCV 09A.1。
失效模式
白話版。 SR 模型失敗的方式,可能是太謹慎(模糊),也可能是太大膽(捏造細節)。大膽的失敗比較危險,因為結果看起來很有說服力。
- 過度平滑: 中心估計可能抑制歧義細節,MSE/L1 分別學平均/中位數,不保證每張都模糊,也不表示所有候選。
- 假文字/人臉: 清楚卻錯字或身分;Ren 等人 [55] 指出既有指標不足,提議多模態虛構評估。
- 紋理偽影: GAN 重複噪狀細節、錯核暈邊 [26]。
- 偏色: 擴散仍有全域色彩漂移 [56]。
- 退化錯配: 修不足/過度,補救見 DLCV 09A.1。
- 接縫: 大圖非重疊分塊可留下邊界 [20]。
對任何 SR 輸出都很有用的一個合理性檢查,是與輸入的一致性:用假設的模型把輸出退化,再與 比較。差異很大,代表模型改動了 LR 影像確實量測到的內容。
現代觀點
綜述論文
Wang、Chen、Hoi [4] 分監督、無監督、領域專用,再以放大位置、算子、殘差/遞迴/密集/注意力、損失與訓練策略等獨立軸描述,提醒新模型通常只改其中幾項。它早於 Transformer/擴散。Moser 等人 [56] 則按像素/潛在/小波、條件、引導、損傷空間及零樣本整理擴散 SR,指出成本、比較、可解釋性與偏色。盲及真實綜述見 DLCV 09A.1。
2023–2026 年的最新進展
- 保真架構: HAT、DAT、MambaIR [21]、[28]、[29] 搭配預訓練,在 NTIRE 復原賽道評估 [45]、[46]。
- 評估跟上生成: 感知專用賽道及虛構評估 [46]、[55],不再只依 PSNR。
- 效率獨立比較: 在品質門檻下測成本 [40]、[41]。
尚未解決的問題
- 可信生成: 如何提供自然細節,同時辨識哪些已量測、哪些只是推估。
- 評估: 中心估計、感知分數迎合與新虛構指標的限制。
- 小基準飽和: 微小 dB 增益不代表真實相機用途。
- 成本: 大注意力/擴散與高效率網路差異很大。
- 極端倍率: 訓練範圍外、幾乎全靠先驗時的行為仍不明確。
重點整理
- 已知下採樣仍會遺失資訊,未確定細節由先驗決定。
- MSE 偏向條件平均,L1 偏向逐座標中位數;兩者都可能平滑不確定結構。
- 非盲設定的結果,取決於假設退化是否符合輸入。
- 後段上採樣、殘差路徑與特徵混合影響成本及細節恢復,應在相同配方下比較。
- 感知—失真前緣不禁止從較弱基準同時改善兩類指標;學得的生成器也沒有精確取樣保證。
- 註明色彩通道與邊界裁切,檢查低解析度一致性,以及文字、人臉、紋理和接縫。
練習
- OpenCV 用的是哪一種三次核? 做一個由 16 個 0 組成、正中間有一個 1 的一維訊號,用
cv2.resize(..., interpolation=cv2.INTER_CUBIC)放大 4 倍,再把結果與 Keys 核在半像素對齊位置 上的值比較,分別取 與 。接著畫出兩個核的頻率響應,比較它們在 LR 奈奎斯特頻率處的值。
提示
對單位脈衝做縮放,輸出就是在輸出位置上取樣的核本身。在我們的執行中, 的最大絕對差為 0.0, 約為 0.037。 越負,負瓣越深,響應在 1 附近維持得稍久一點,然後略微過衝:這是更銳利、但振鈴更明顯的內插器。用 INTER_LANCZOS4 與 的 Lanczos 核重做一次;結果很接近但並不完全相同(我們量到的最大差約為 0.0016),因為函式庫會把權重正規化。
- 評估算術。 (a)證明 Y/峰 255 的 PSNR 等於 /峰 1 的 PSNR 加 。(b)把裁邊從 4 改 0 或 16,比較。(c)為什麼零 padding 網路尤其需要裁邊,
cv2.resize影響較小?
提示
(a) ,所以 MSE 乘上 ,PSNR 變成 ,也就是 ,約為 dB。(b) 在這裡裁邊只讓結果改變幾百分之一 dB(最近鄰為 24.66 對 24.62 dB),因為 OpenCV 對邊界的外插相當合理,影像的邊緣也很平滑。(c) 零填補讓卷積網路在影像之外看到黑色,所以靠近邊界的輸出系統性地較差;裁邊去掉的是一塊品質取決於填補方式、而不是取決於方法本身的區域。
- 通道順序的錯誤。 假設某個函式庫把 個通道排成 (我們的公式),另一個排成 。你把用第一種順序訓練的權重載入第二種。、 時,12 個通道中有哪些會落在正確的位置?輸出看起來會是什麼樣子?
提示
令 ,解 :,所以只有 與 重合,12 個通道中只有 2 個(我們逐一列舉全部 12 個確認過)。其他值被移到錯誤的色彩通道與錯誤的子像素偏移,所以即使粗略的影像仍認得出來,每個 2 × 2 區塊都會出現細碎的彩色馬賽克。 時兩種順序一致,這就是為什麼這類錯誤常常要到從灰階模型換成彩色模型時才出現。
- 讓線性模型更好。 從迴歸器的程式出發,(a) 把區塊大小 改成 3、5、9 與 11;(b) 依局部梯度的角度把 LR 像素分類(如 RAISR 的做法),每一類擬合一個迴歸器;(c) 在 LR 訓練影像上加 σ = 0.01 的雜訊、測試影像不加,再反過來做一次。回報每項改動的 PSNR 並解釋。
提示
(a) 在模糊的測試輸入上,我們量到 為 25.94 dB、 為 26.18 dB, 都是 26.26 dB:超過 7 × 7 之後,線性模型就不再進步。(b) 四個角度類別(由稍微平滑過的 LR 影像梯度算出)得到 26.33 dB,八個類別得到 26.32 dB,提升很小:類別讓濾波器能順著邊緣方向,這正是 RAISR 與 A+ 勝過單一全域濾波器的原因。(c) 用有雜訊的輸入訓練,模型學會平滑,所以對乾淨輸入銳化不足;用乾淨輸入訓練,模型學會放大細緻的細節,所以會連雜訊也一起放大。這是圖 6 中模糊不匹配的雜訊版本。
- 手算後驗平均。 兩個 HR 像素 彼此獨立,為 0 或 1 的機率相等。LR 像素為 ,沒有雜訊。(a) 對 的每個可能值,寫出 的後驗平均與一個後驗樣本。(b) 計算兩個估計器每個像素的期望 MSE。(c) 哪一個估計器的輸出看起來像 HR 資料?
提示
(a) 與 完全確定了 。當 (機率 1/2)時,後驗是 或 ,機率相等,所以平均為 ,樣本則是兩者之一。(b) 只有 有貢獻。平均在那裡每個像素的平方誤差為 ,所以它的 MSE 是 。樣本有一半的時間完全正確,另一半的時間兩個像素都錯 1,所以它的 MSE 是 :剛好兩倍。(c) 只有樣本:真實像素是 0 或 1,0.5 這個值從不出現在 HR 資料中。
- 全域注意力的代價。 用決策六公式,計算 、64 × 64 與 128 × 128 LR 的 、。邊長倍增時比值如何變?多大的視窗會與全域同成本?
提示
64 × 64 約 6.6/0.63 GMAC、比 10.5;128 × 128 約 98.8/2.50、比 39.5。像素四倍,投影 與視窗項四倍,全域 十六倍。 時一窗覆全圖,兩注意力項相等。
參考文獻
- S. C. Park, M. K. Park and M. G. Kang, “Super-Resolution Image Reconstruction: A Technical Overview,” IEEE Signal Processing Magazine, vol. 20, no. 3, pp. 21–36, 2003. doi
- Y. Blau and T. Michaeli, “The Perception-Distortion Tradeoff,” in Proc. IEEE/CVF CVPR, 2018, pp. 6228–6237. doi · arXiv
- MathWorks, “imresize: Resize image,” MATLAB documentation (default method bicubic; antialiasing on when shrinking). link
- Z. Wang, J. Chen and S. C. H. Hoi, “Deep Learning for Image Super-Resolution: A Survey,” IEEE TPAMI, vol. 43, no. 10, pp. 3365–3387, 2021. doi · arXiv
- R. Keys, “Cubic Convolution Interpolation for Digital Image Processing,” IEEE Transactions on Acoustics, Speech, and Signal Processing, vol. 29, no. 6, pp. 1153–1160, 1981. doi
- C. E. Duchon, “Lanczos Filtering in One and Two Dimensions,” Journal of Applied Meteorology, vol. 18, no. 8, pp. 1016–1022, 1979. doi
- W. T. Freeman, T. R. Jones and E. C. Pasztor, “Example-Based Super-Resolution,” IEEE Computer Graphics and Applications, vol. 22, no. 2, pp. 56–65, 2002. doi
- D. Glasner, S. Bagon and M. Irani, “Super-Resolution from a Single Image,” in Proc. IEEE ICCV, 2009, pp. 349–356. doi
- J. Yang, J. Wright, T. S. Huang and Y. Ma, “Image Super-Resolution via Sparse Representation,” IEEE Transactions on Image Processing, vol. 19, no. 11, pp. 2861–2873, 2010. doi
- R. Timofte, V. De Smet and L. Van Gool, “Anchored Neighborhood Regression for Fast Example-Based Super-Resolution,” in Proc. IEEE ICCV, 2013, pp. 1920–1927. doi · CVF
- R. Timofte, V. De Smet and L. Van Gool, “A+: Adjusted Anchored Neighborhood Regression for Fast Super-Resolution,” in Computer Vision – ACCV 2014, Lecture Notes in Computer Science, Springer, 2015, pp. 111–126. doi
- Y. Romano, J. Isidoro and P. Milanfar, “RAISR: Rapid and Accurate Image Super Resolution,” IEEE Transactions on Computational Imaging, vol. 3, no. 1, pp. 110–125, 2017. doi · arXiv
- N. Efrat, D. Glasner, A. Apartsin, B. Nadler and A. Levin, “Accurate Blur Models vs. Image Priors in Single Image Super-Resolution,” in Proc. IEEE ICCV, 2013, pp. 2832–2839. doi · CVF
- C. Dong, C. C. Loy, K. He and X. Tang, “Image Super-Resolution Using Deep Convolutional Networks,” IEEE TPAMI, vol. 38, no. 2, pp. 295–307, 2016. doi · arXiv
- C. Dong, C. C. Loy and X. Tang, “Accelerating the Super-Resolution Convolutional Neural Network,” in Proc. ECCV, 2016, pp. 391–407. doi · arXiv
- W. Shi, J. Caballero, F. Huszár, J. Totz, A. P. Aitken, R. Bishop, D. Rueckert and Z. Wang, “Real-Time Single Image and Video Super-Resolution Using an Efficient Sub-Pixel Convolutional Neural Network,” in Proc. IEEE CVPR, 2016, pp. 1874–1883. doi · arXiv
- J. Kim, J. K. Lee and K. M. Lee, “Accurate Image Super-Resolution Using Very Deep Convolutional Networks,” in Proc. IEEE CVPR, 2016, pp. 1646–1654. doi · arXiv
- B. Lim, S. Son, H. Kim, S. Nah and K. M. Lee, “Enhanced Deep Residual Networks for Single Image Super-Resolution,” in Proc. IEEE CVPR Workshops, 2017, pp. 1132–1140. doi · arXiv
- Y. Zhang, K. Li, K. Li, L. Wang, B. Zhong and Y. Fu, “Image Super-Resolution Using Very Deep Residual Channel Attention Networks,” in Proc. ECCV, 2018, pp. 294–310. doi · arXiv
- J. Liang, J. Cao, G. Sun, K. Zhang, L. Van Gool and R. Timofte, “SwinIR: Image Restoration Using Swin Transformer,” in Proc. IEEE/CVF ICCV Workshops, 2021, pp. 1833–1844. doi · arXiv
- X. Chen, X. Wang, J. Zhou, Y. Qiao and C. Dong, “Activating More Pixels in Image Super-Resolution Transformer,” in Proc. IEEE/CVF CVPR, 2023, pp. 22367–22377. doi · arXiv
- PyTorch contributors, “PixelShuffle.cpp” (implementation of
torch.nn.PixelShuffleandtorch.nn.PixelUnshuffle), PyTorch source code. GitHub - A. Aitken, C. Ledig, L. Theis, J. Caballero, Z. Wang and W. Shi, “Checkerboard Artifact Free Sub-Pixel Convolution: A Note on Sub-Pixel Convolution, Resize Convolution and Convolution Resize,” arXiv:1707.02937, 2017. arXiv
- C. Ledig, L. Theis, F. Huszár, J. Caballero, A. Cunningham, A. Acosta, A. Aitken, A. Tejani, J. Totz, Z. Wang and W. Shi, “Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network,” in Proc. IEEE CVPR, 2017, pp. 105–114. doi · arXiv
- R. Timofte, E. Agustsson, L. Van Gool, M.-H. Yang, L. Zhang et al., “NTIRE 2017 Challenge on Single Image Super-Resolution: Methods and Results,” in Proc. IEEE CVPR Workshops, 2017, pp. 1110–1121. doi · CVF
- X. Wang, K. Yu, S. Wu, J. Gu, Y. Liu, C. Dong, Y. Qiao and C. C. Loy, “ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks,” in Proc. ECCV Workshops, 2018 (Lecture Notes in Computer Science, 2019), pp. 63–79. doi · arXiv
- Z. Liu, Y. Lin, Y. Cao, H. Hu, Y. Wei, Z. Zhang, S. Lin and B. Guo, “Swin Transformer: Hierarchical Vision Transformer using Shifted Windows,” in Proc. IEEE/CVF ICCV, 2021, pp. 9992–10002. doi · arXiv
- Z. Chen, Y. Zhang, J. Gu, L. Kong, X. Yang and F. Yu, “Dual Aggregation Transformer for Image Super-Resolution,” in Proc. IEEE/CVF ICCV, 2023, pp. 12278–12287. doi · arXiv
- H. Guo, J. Li, T. Dai, Z. Ouyang, X. Ren and S.-T. Xia, “MambaIR: A Simple Baseline for Image Restoration with State-Space Model,” in Proc. ECCV, 2024, pp. 222–241. doi · arXiv
- K. Simonyan and A. Zisserman, “Very Deep Convolutional Networks for Large-Scale Image Recognition,” in Proc. ICLR, 2015. arXiv
- J. Johnson, A. Alahi and L. Fei-Fei, “Perceptual Losses for Real-Time Style Transfer and Super-Resolution,” in Proc. ECCV, 2016, pp. 694–711. doi · arXiv
- Y. Blau, R. Mechrez, R. Timofte, T. Michaeli and L. Zelnik-Manor, “The 2018 PIRM Challenge on Perceptual Image Super-Resolution,” in Proc. ECCV Workshops, 2018. arXiv
- A. Mittal, R. Soundararajan and A. C. Bovik, “Making a “Completely Blind” Image Quality Analyzer,” IEEE Signal Processing Letters, vol. 20, no. 3, pp. 209–212, 2013. doi
- C. Ma, C.-Y. Yang, X. Yang and M.-H. Yang, “Learning a No-Reference Quality Metric for Single-Image Super-Resolution,” Computer Vision and Image Understanding, vol. 158, pp. 1–16, 2017. doi · arXiv
- C. Saharia, J. Ho, W. Chan, T. Salimans, D. J. Fleet and M. Norouzi, “Image Super-Resolution via Iterative Refinement,” IEEE TPAMI, 2022. doi · arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” in Proc. MICCAI, 2015, pp. 234–241. doi · arXiv
- X. Hu, H. Mu, X. Zhang, Z. Wang, T. Tan and J. Sun, “Meta-SR: A Magnification-Arbitrary Network for Super-Resolution,” in Proc. IEEE/CVF CVPR, 2019, pp. 1575–1584. doi · arXiv
- Y. Chen, S. Liu and X. Wang, “Learning Continuous Image Representation with Local Implicit Image Function,” in Proc. IEEE/CVF CVPR, 2021, pp. 8624–8634. doi · arXiv
- Z. Hui, X. Gao, Y. Yang and X. Wang, “Lightweight Image Super-Resolution with Information Multi-distillation Network,” in Proc. ACM International Conference on Multimedia, 2019, pp. 2024–2032. doi · arXiv
- B. Ren, Y. Li, N. Mehta, R. Timofte et al., “The Ninth NTIRE 2024 Efficient Super-Resolution Challenge Report,” in Proc. IEEE/CVF CVPR Workshops, 2024. CVF · arXiv
- B. Ren, H. Guo, L. Sun, Z. Wu, R. Timofte, Y. Li et al., “The Tenth NTIRE 2025 Efficient Super-Resolution Challenge Report,” in Proc. IEEE/CVF CVPR Workshops, 2025. CVF · arXiv
- ITU-R, “Recommendation BT.601: Studio Encoding Parameters of Digital Television for Standard 4:3 and Wide Screen 16:9 Aspect Ratios.” ITU
- MathWorks, “rgb2ycbcr: Convert RGB color values to YCbCr color space,” Image Processing Toolbox documentation. link
- Z. Wang, A. C. Bovik, H. R. Sheikh and E. P. Simoncelli, “Image Quality Assessment: From Error Visibility to Structural Similarity,” IEEE Transactions on Image Processing, vol. 13, no. 4, pp. 600–612, 2004. doi
- Z. Chen, Z. Wu, E. Zamfir, K. Zhang, Y. Zhang, R. Timofte et al., “NTIRE 2024 Challenge on Image Super-Resolution (×4): Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2024, pp. 6108–6132. doi · arXiv
- Z. Chen, K. Liu, J. Gong, J. Wang, L. Sun, Z. Wu, R. Timofte, Y. Zhang et al., “NTIRE 2025 Challenge on Image Super-Resolution (×4): Methods and Results,” in Proc. IEEE/CVF CVPR Workshops, 2025, pp. 1525–1535. doi · arXiv
- M. Bevilacqua, A. Roumy, C. Guillemot and M.-L. Alberi Morel, “Low-Complexity Single-Image Super-Resolution based on Nonnegative Neighbor Embedding,” in Proc. BMVC, 2012, pp. 135.1–135.10. doi
- R. Zeyde, M. Elad and M. Protter, “On Single Image Scale-Up Using Sparse-Representations,” in Curves and Surfaces, Lecture Notes in Computer Science, Springer, 2012, pp. 711–730. doi
- D. Martin, C. Fowlkes, D. Tal and J. Malik, “A Database of Human Segmented Natural Images and Its Application to Evaluating Segmentation Algorithms and Measuring Ecological Statistics,” in Proc. IEEE ICCV, 2001, vol. 2, pp. 416–423. doi
- J.-B. Huang, A. Singh and N. Ahuja, “Single Image Super-Resolution from Transformed Self-Exemplars,” in Proc. IEEE CVPR, 2015, pp. 5197–5206. doi · CVF
- A. Fujimoto, T. Ogawa, K. Yamamoto, Y. Matsui, T. Yamasaki and K. Aizawa, “Manga109 Dataset and Creation of Metadata,” in Proc. 1st International Workshop on coMics ANalysis, Processing and Understanding (MANPU), 2016, pp. 1–5. doi
- Y. Matsui, K. Ito, Y. Aramaki, A. Fujimoto, T. Ogawa, T. Yamasaki and K. Aizawa, “Sketch-Based Manga Retrieval Using Manga109 Dataset,” Multimedia Tools and Applications, vol. 76, no. 20, pp. 21811–21838, 2017. doi
- E. Agustsson and R. Timofte, “NTIRE 2017 Challenge on Single Image Super-Resolution: Dataset and Study,” in Proc. IEEE CVPR Workshops, 2017, pp. 1122–1131. doi · CVF
- R. Zhang, P. Isola, A. A. Efros, E. Shechtman and O. Wang, “The Unreasonable Effectiveness of Deep Features as a Perceptual Metric,” in Proc. IEEE/CVF CVPR, 2018, pp. 586–595. doi · arXiv
- W. Ren, R. Goyal, Z. Hu, T. T. Aumentado-Armstrong, I. Mohomed and A. Levinshtein, “Hallucination Score: Towards Mitigating Hallucinations in Generative Image Super-Resolution,” arXiv:2507.14367, 2025. arXiv
- B. B. Moser, A. S. Shanbhag, F. Raue, S. Frolov, S. Palacio and A. Dengel, “Diffusion Models, Image Super-Resolution, and Everything: A Survey,” IEEE Transactions on Neural Networks and Learning Systems, vol. 36, no. 7, pp. 11793–11813, 2025. doi · arXiv
- A. Shocher, N. Cohen and M. Irani, “‘Zero-Shot’ Super-Resolution Using Deep Internal Learning,” in Proc. IEEE/CVF CVPR, 2018, pp. 3118–3126. doi · arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 09A.1・盲與真實世界影像超解析度 · 18 分鐘