DLCV 03B・三維物件偵測:光達、相機與鳥瞰視角
先備知識:DLCV 03・物件偵測:從 R-CNN 到 DETR、DLCV 11・三維重建:從多視角幾何到 NeRF 與 Gaussian Splatting
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 定義三維方框、座標框架與感測器校準。
- 比較點、體素、柱狀與混合表示。
- 理解僅相機的深度推論與多感測器融合。
- 編碼方向,並區分鳥瞰重疊與完整三維重疊。
- 解讀基準指標,並測試距離、天氣、校準與部署成本。
先看全貌
二維偵測器在影像上畫矩形。三維偵測器則把框放進真實世界:每個物體在幾公尺外、有多大、面向哪個方向,而對會移動的東西,還有它跑得多快。自駕車不會因為一個像素矩形而煞車;它煞車,是因為一位行人在前方 14 公尺處,正走進它的車道。
為什麼重要。 三維偵測是自動駕駛感知系統的核心,它的輸出餵給追蹤、運動預測與規劃 [1]。機器人需要它來抓取與避開物體,擴增實境需要它把虛擬內容錨定在真實物體上。這項任務也逼出了二維視覺從未需要的新想法:處理無序點集的網路、稀疏卷積、鳥瞰視角表示,以及把平面影像「提升」到三維的方法。
本篇假設你已經熟悉 DLCV 03・物件偵測:從 R-CNN 到 DETR 的二維偵測詞彙:框的迴歸目標、IoU、錨框與標籤指派、NMS 與焦點損失(見其核心基本元件)、以中心為基礎的偵測(無錨框偵測器)、DETR 式的集合預測(以 Transformer 做集合預測),以及平均精確率(偵測器的評估)。我們沿用這些想法,只說明在三維中改變了什麼。兩篇綜述為這個領域搭起框架:Mao 等人 [1] 與 Qian 等人 [2];我們在「現代觀點」中回頭談它們。
三維偵測問題
白話版。 三維偵測器把感測觀測轉成方框、類別與分數;直立框設定描述偏航,不包含滾轉與俯仰。
精確版。 三維偵測器輸出一個集合
其中 是框的中心(單位為公尺), 是它的長、寬、高, 是偏航角(yaw,繞垂直軸的朝向角), 是 個類別之一, 是信心值, 是選用的地面平面速度(單位為公尺每秒),而 隨場景而異。這種 7 個數字的框稱為 7-DoF(自由度,degrees of freedom)框;例如 Waymo Open Dataset 就是這樣標註每個物體,長、寬、高沿著框自己的 、 與 軸量測 [3]。翻滾角與俯仰角假設為零,這對大致平坦道路上的用路人來說是合理的。
和二維偵測相比,有三件事改變了:
- 框存在於公制空間。 尺寸不會隨距離縮小,所以一輛車不管在 5 m 還是 80 m 外,都約 4.5 m 長。這讓尺寸先驗(錨框、各類別的平均尺寸)遠比在影像中有用。
- 朝向很重要。 二維框是與座標軸對齊的。三維框必須隨物體轉動,而錯誤的偏航角即使中心完全正確,也可能毀掉重疊程度。
- 資料稀疏且不均勻。 光達看到的是表面而不是體積,而且多半是面向它的那幾面,遠處的物體只得到幾個點。
感測器與座標系
白話版。 每個感測器都在自己的座標中量測。要把它們結合起來,我們用每個感測器已知的位置與朝向,也就是它的校正(calibration),把所有東西搬進一個固定在車上的共同座標系。
三種感測器占主導地位(圖 1,左):
- 光達(LiDAR)發出雷射脈衝並計時它們的回波。旋轉式的光達每次掃描回傳一個點雲(point cloud):數萬個點 ,每個點帶一個強度(intensity,即反射率)。深度是直接且準確地量到的,但沒有顏色,而且點很稀疏。
- 相機以低成本提供稠密的顏色與紋理,但沒有深度:一個像素只告訴你一條射線的方向,不告訴你物體在這條射線上的多遠處。
- 雷達(radar)對每個物體只回傳寥寥幾個點,帶有距離,並透過都卜勒效應得到徑向速度。它在霧和雨中也能運作,但角解析度很差。
例如 nuScenes 的車子配有 6 台相機、5 個雷達與 1 個光達,涵蓋 360 度 [4];Waymo 的車子配有五個光達與五台相機 [3]。
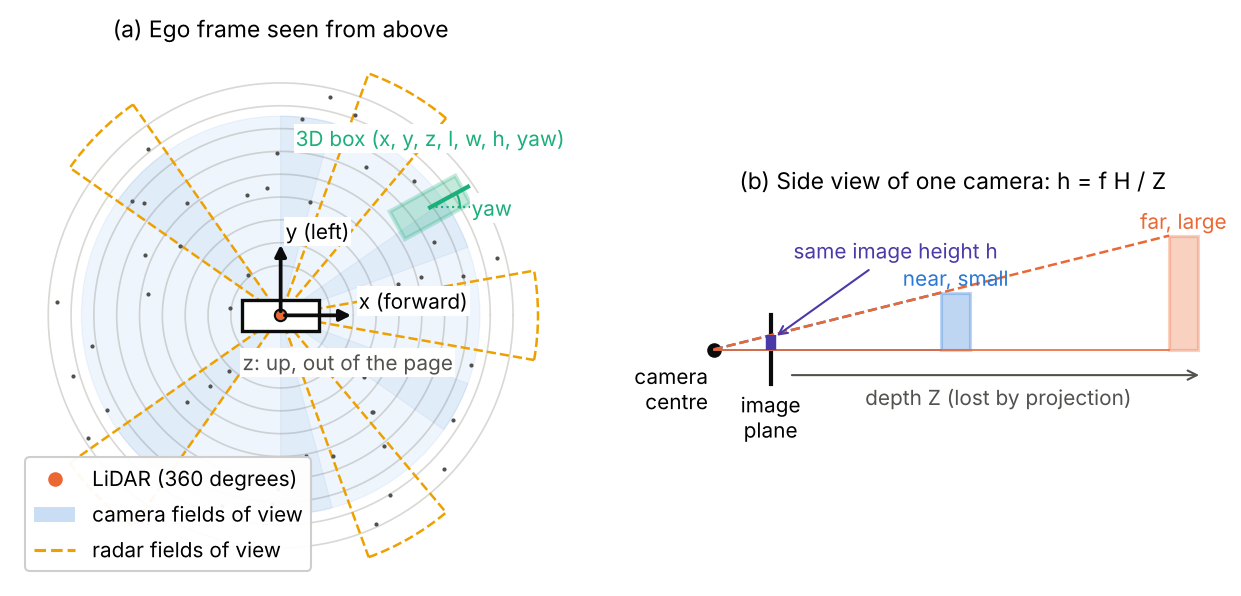
Waymo 資料集與本篇採用的慣例是右手系的車輛座標系(vehicle frame): 朝前、 朝左、 朝上;每個感測器有自己的座標系,一個稱為外參(extrinsics)的 4×4 矩陣把感測器座標映射到車輛座標系 [3]。用公式表示,感測器量到的一點 變成
其中 是 3×3 旋轉矩陣, 是 3 維平移向量,兩者合起來就是該感測器的外參。相機另外還有內參(intrinsics),一個 3×3 矩陣,內含以像素為單位的焦距與影像中心。相機座標中的一點 ( 指向鏡頭外)投影到像素
其中 是像素座標。除以 是整件事的核心:射線 上的每一點()都落在同一個像素上,所以深度就丟失了(圖 1,右)。校正在實務上很重要:如果 差了半度,60 m 外的一點會移動約半公尺,足以把行人的像素塗到他身後的牆上。
鳥瞰視角
白話版。 鳥瞰視角由上方表示道路場景,方便在公尺空間比較物件大小與位置,但仍可能有垂直重疊。
在 BEV 中,我們捨棄 ,在 上保留一個二維網格,例如 m 的格子。高度變成特徵通道,而不是一條座標軸。因為物體在這個視角中保持公制尺寸、也不會互相遮擋,一個普通的二維卷積偵測器就能在 BEV 網格上執行,下游的規劃器也是用這張地圖思考。代價是高度的細節被壓縮了;這對路上的車影響不大,對有桌子與架子的室內場景則影響較大。
點雲:網路實際看到的東西
白話版。 點雲無固定順序且空間稀疏;遠處物件通常回波較少,表示方式須處理不均勻取樣。
一次光達掃描是一個集合 ,其中 , 是強度, 是點數,常常有數萬個。三個性質塑造了本篇的每一個網路:
- 無序。 清單的任何排列描述的都是同一個場景,所以處理這些點的網路 必須是排列不變(permutation invariant)的:對索引的每個排列 ,都有 。
- 稀疏。 點位於表面上。把車子周圍的空間切成 16 cm 的柱,超過 9/10 的柱是空的(我們在下面量測)。
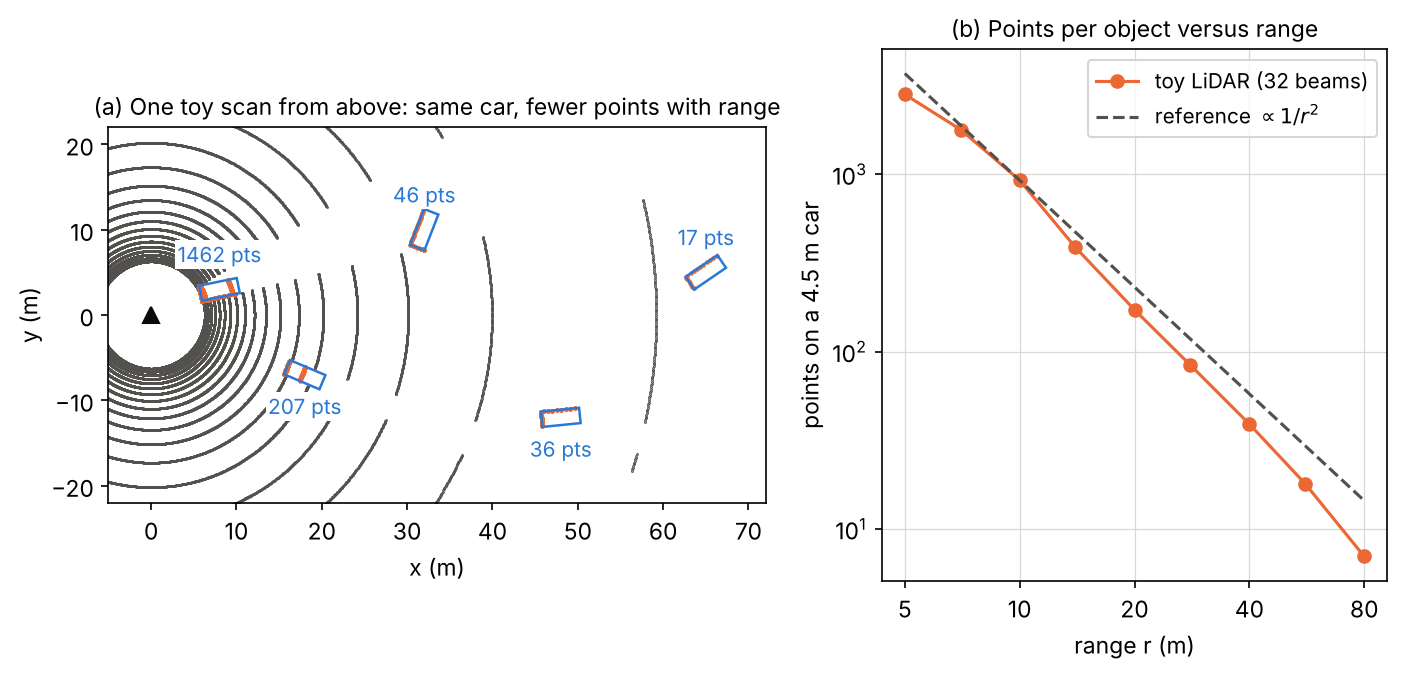
- 密度與距離有關。 旋轉式光達以固定的角度間隔 (水平)與 (垂直)發射射線。在距離 處,相鄰射線相隔約 與 ,所以一個正對面積固定為 的物體大約會得到
個點,其中 是點數的期望值,角度以弧度計。距離加倍,點數約減為四分之一。
下面的程式碼建立一個玩具旋轉式光達(32 條光束,每 0.2 度一條射線),並計算打到放在不同距離、大小如一輛車的框的射線數。它使用平板法(slab method):如果一條射線在每一對平行面之間的區間互相重疊,它就打到了這個框。
程式碼 · Python · 26 行
import numpy as np

# A toy spinning LiDAR mounted 1.8 m above the ground: 32 beams between -16 and +10 degrees
# elevation, one ray every 0.2 degrees of azimuth (1800 rays per beam per turn).
elev = np.deg2rad(np.linspace(-16, 10, 32))
azim = np.deg2rad(np.arange(0, 360, 0.2))
E, A = np.meshgrid(elev, azim, indexing="ij")
dirs = np.stack([np.cos(E) * np.cos(A), np.cos(E) * np.sin(A), np.sin(E)], -1).reshape(-1, 3)
origin = np.array([0.0, 0.0, 1.8])

def hits_on_box(center, size):
    """Count rays whose first hit is an axis-aligned box (slab method)."""
    lo, hi = center - size / 2, center + size / 2
    with np.errstate(divide="ignore", invalid="ignore"):
        t1, t2 = (lo - origin) / dirs, (hi - origin) / dirs
    t_near = np.nanmax(np.minimum(t1, t2), axis=1)
    t_far = np.nanmin(np.maximum(t1, t2), axis=1)
    return int(np.sum((t_far >= t_near) & (t_far > 0)))

car = np.array([4.5, 1.8, 1.5])                      # length, width, height in metres
ranges = np.array([5, 10, 20, 40, 80])
counts = np.array([hits_on_box(np.array([r, 0, car[2] / 2]), car) for r in ranges])
for r, c in zip(ranges, counts):
    print(f"car at {r:2d} m: {c:5d} points")
slope = np.polyfit(np.log(ranges[1:]), np.log(counts[1:]), 1)[0]
print(f"log-log slope (10-80 m): {slope:.2f}")
輸出
car at  5 m:  2817 points
car at 10 m:   924 points
car at 20 m:   172 points
car at 40 m:    39 points
car at 80 m:     7 points
log-log slope (10-80 m): -2.33
點數從 5 m 處的數千個,掉到 80 m 處的 7 個。擬合出的斜率比 略陡,因為在遠處,32 條光束中只有少數幾條會穿過 1.5 m 高的物體,垂直取樣變得很粗;擁有更多光束的真實感測器會更接近 。圖 2 在整個場景上顯示同樣的效應:完全相同的車,證據卻天差地別。
傳統基準:地面移除、分群與框擬合
白話版。 在深度學習之前,常見的光達流程是:把路面移除,把剩下的點分成一塊一塊,再在每一塊外面畫一個緊貼的矩形。它不需要訓練資料,也準確地告訴你後來的網路必須解決哪些問題。
三個步驟如下:
- 用 RANSAC 移除地面 [5]。擬合一個平面 (單位法向量 、偏移量 ):重複隨機挑三個點、建出通過它們的平面,並計算內點(inlier)數,也就是滿足 ( 為容許誤差)的點。內點最多的平面就是地面。(RANSAC 在 IP 12・特徵擷取的補充資料中有更詳細的說明。)
- 用 DBSCAN 分群 [6]。在 BEV 中把剩下的點分組:兩點若距離小於 就是鄰居,擁有至少 個鄰居的點是核心點,群從核心點長出去;孤立的點被標為雜訊。DBSCAN 不需要事先指定群數,適合物體數量未知的場景。(分群的一般介紹見 PR 07・分群、混合模型與 EM。)
- 有向框擬合。 對每個群,嘗試各個偏航角 ,把點旋轉到框的座標系,取緊貼的軸對齊矩形,並給它打分。沿著角度搜尋、配上擬合準則,就是搜尋式 L 形擬合(L-shape fitting)的想法 [7]。我們採用一個簡單的準則:每個點到最近矩形邊的平均距離。光達通常看到的是一個「L」(車子的兩個側面),而正確的偏航角會讓這些點落在兩條邊上。
程式碼 · Python · 58 行
import numpy as np
from sklearn.cluster import DBSCAN

rng = np.random.default_rng(0)

def box_surface(cx, cy, l, w, h, yaw, n):
    """n points on the sides of a yawed box that face the sensor at the origin."""
    c, s = np.cos(yaw), np.sin(yaw)
    pts = []
    for nx, ny, half, along in [(1, 0, l / 2, w), (-1, 0, l / 2, w), (0, 1, w / 2, l), (0, -1, w / 2, l)]:
        normal = np.array([c * nx - s * ny, s * nx + c * ny])
        mid = np.array([cx, cy]) + half * normal
        if normal @ mid >= 0:                      # face points away from the sensor: hidden
            continue
        t = rng.uniform(-along / 2, along / 2, n)
        tangent = np.array([-normal[1], normal[0]])
        xy = mid + t[:, None] * tangent
        pts.append(np.column_stack([xy, rng.uniform(0, h, n)]))
    return np.vstack(pts)

# ground plane z = 0 with slight noise, sampled uniformly in range and angle (density ~ 1/r)
r, a = rng.uniform(2, 60, 20000), rng.uniform(-np.pi / 2, np.pi / 2, 20000)
ground = np.column_stack([r * np.cos(a), r * np.sin(a), rng.normal(0, 0.03, r.size)])
objects = [(12, -4, 4.5, 1.8, 1.5, 0.3), (25, 6, 4.2, 1.7, 1.4, -1.0), (40, -10, 0.8, 0.6, 1.7, 0.0)]
cloud = [ground] + [box_surface(*o, n=int(40000 / np.hypot(o[0], o[1]) ** 2) + 5) for o in objects]
pts = np.vstack(cloud) + rng.normal(0, 0.02, (sum(len(c) for c in cloud), 3))

# 1) RANSAC plane fit: pick 3 points, count inliers within 0.1 m, keep the best plane
best = None
for _ in range(100):
    p = pts[rng.choice(len(pts), 3, replace=False)]
    n = np.cross(p[1] - p[0], p[2] - p[0])
    if np.linalg.norm(n) < 1e-9:
        continue
    n /= np.linalg.norm(n)
    inl = np.abs((pts - p[0]) @ n) < 0.1
    if best is None or inl.sum() > best.sum():
        best = inl
above = pts[~best]
print(f"{len(pts)} points, {best.sum()} ground inliers, {len(above)} left")

# 2) DBSCAN in the bird's-eye view
labels = DBSCAN(eps=0.7, min_samples=5).fit_predict(above[:, :2])

# 3) oriented box per cluster: search the yaw; score = mean distance of points to the nearest edge
for k in range(labels.max() + 1):
    q = above[labels == k]
    best_score, best_fit = np.inf, None
    for yaw in np.deg2rad(np.arange(0, 180, 1)):
        R = np.array([[np.cos(yaw), -np.sin(yaw)], [np.sin(yaw), np.cos(yaw)]])
        uv = q[:, :2] @ R                              # coordinates along the box axes
        lo, hi = uv.min(0), uv.max(0)
        edge_dist = np.minimum(np.minimum(uv - lo, hi - uv)[:, 0], np.minimum(uv - lo, hi - uv)[:, 1])
        if edge_dist.mean() < best_score and hi[0] - lo[0] >= hi[1] - lo[1]:   # x axis = long side
            best_score, best_fit = edge_dist.mean(), (R @ ((lo + hi) / 2), hi - lo, np.rad2deg(yaw))
    ctr, size, yaw = best_fit
    print(f"cluster {k}: {len(q):4d} pts, centre ({ctr[0]:5.1f}, {ctr[1]:5.1f}), "
          f"size {size[0]:.1f} x {size[1]:.1f} m, yaw {yaw:4.0f} deg, height {q[:, 2].max():.1f} m")
輸出
20694 points, 19944 ground inliers, 750 left
cluster 0:  471 pts, centre ( 12.0,  -4.0), size 4.6 x 1.9 m, yaw   17 deg, height 1.5 m
cluster 1:  124 pts, centre ( 25.0,   6.1), size 4.1 x 1.9 m, yaw  123 deg, height 1.4 m
cluster 2:   53 pts, centre ( 40.0,  -9.9), size 0.8 x 0.6 m, yaw    0 deg, height 1.7 m
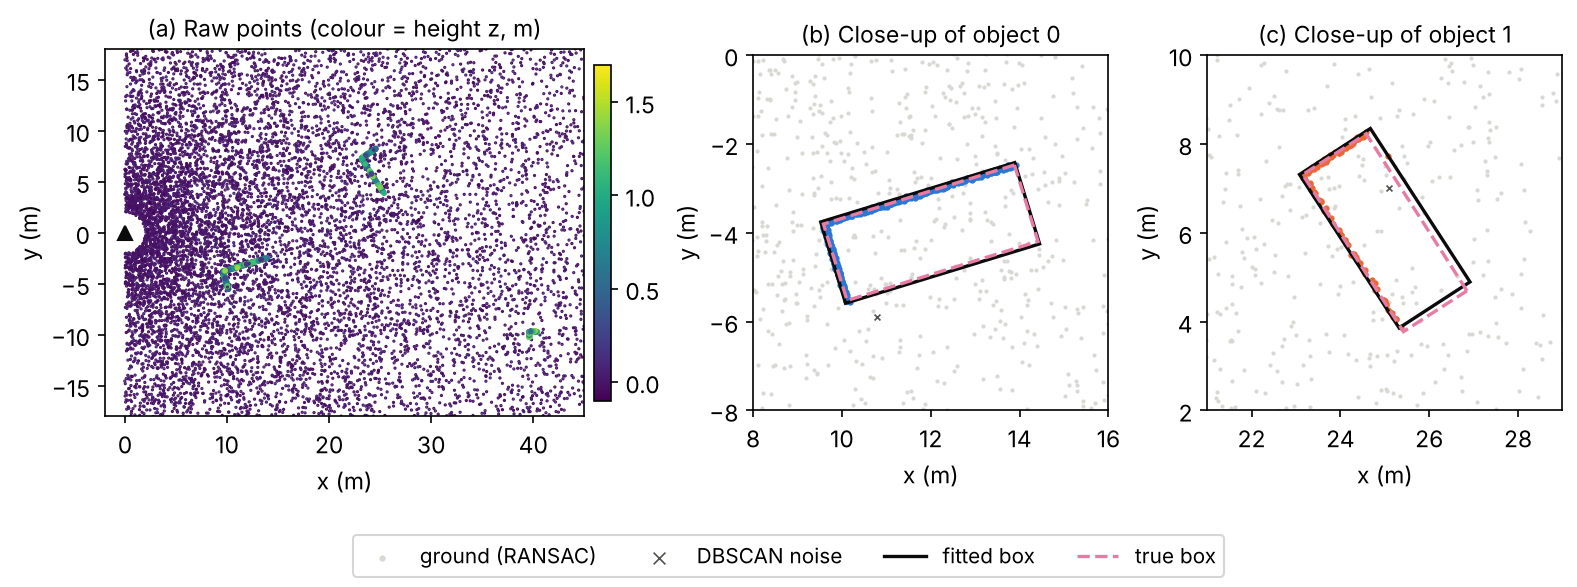
在這個合成場景上(真實物體:位於 、偏航角 17° 的一輛車,位於 、偏航角 −57° 的一輛車(模 180° 即 123°),以及位於 、0.8 × 0.6 m 的一位行人),這個流程能把中心、尺寸與偏航角都還原得很好。圖 3 顯示結果。一個看似更簡單的準則,最小矩形面積,在這裡會失敗:L 形點集的凸包大致是一個三角形,沿著三角形長對角線的矩形能以相同的面積把它框住,所以面積準則可能選出偏差約 20° 的偏航角。
這個基準也顯示了它的極限,而每一項極限都是學習的理由:
- 沒有語意。 一個群就只是「某個東西」。要分辨行人與電線桿、汽車與灌木,需要學習到的特徵。
- 只看到局部。 框只對可見的點擬合。從後面看到的遠處汽車只給出一條短線,所以它的長度未知。學習式偵測器用類別層級的尺寸先驗來補全看不到的部分。
- 合併與分裂。 兩個並肩走的人會合併成一個群;隔著縫隙看到的卡車會分裂成兩個。
- 朝向。 擬合只給出模 180° 的偏航角:它分不出車頭與車尾。
三維框:編碼、IoU 與 NMS
這些是 DLCV 03 基本元件的三維版本。我們只說明新的部分。
框的編碼與偏航角問題
白話版。 和二維一樣,網路預測的是對一個參考框(錨框或一個點)的小幅修正。新的部分是角度:角度會繞回來,而且轉了 180° 的框涵蓋的空間完全相同,所以天真的角度損失會懲罰幾何上正確的答案。
VoxelNet [8]、SECOND [9] 與 PointPillars [10] 使用相同的殘差,作用在真值框(上標 )與錨框(上標 )之間:
其中 是錨框底面的對角線,用同一個長度把兩個方向的水平偏移正規化。這些就是 DLCV 03 的二維目標多加一個維度。
對於角度,VoxelNet 迴歸的是原始差值 。SECOND [9] 指出這會造成衝突:預測正好差 時,框是一樣的,損失卻很大。它的正弦誤差損失(sine-error loss)
( 是預測角、 是目標角,SmoothL1 是 DLCV 03 的平滑 L1 損失:誤差小於 1 時是二次,大於 1 時是線性)在預測完全正確與預測翻轉了 時都是零。因為它分不出前後,SECOND 加了一個很小的方向分類器(direction classifier),有兩個分格,用來決定框指向哪一邊 [9];PointPillars 使用同樣這一對損失 [10]。CenterPoint 則迴歸 ,再用 還原角度,這既連續又沒有歧義 [11]。
選讀:偏航角編碼比較(見「補充資料」頁)。把四種編碼放在實際的角度配對上並排比較,包括框被翻轉的情形。
旋轉框的 BEV IoU 與三維 IoU
白話版。 IoU 仍然是「重疊面積除以總面積」,但框現在是旋轉的,所以重疊部分是一個多邊形,不是矩形。在三維中,再把這個多邊形的面積乘上兩個高度區間的重疊長度。
對兩個直立的框 與 ,令 為它們 BEV 矩形的交集(一個最多有 8 個角的凸多邊形),並令
為它們垂直範圍的重疊長度,其中 是框的中心高度, 是它的高度。於是
其中 表示面積, 是框的尺寸。兩個凸多邊形的交集多邊形,可以用 Sutherland–Hodgman 裁切法(clipping)[12] 算出:依序用第二個多邊形的每條邊所在的直線去切第一個多邊形,只保留內側的部分。接著,多邊形的面積由它各角 的鞋帶公式(shoelace formula) 得到,其中索引循環取值。
程式碼 · Python · 58 行
import numpy as np

def corners(box):
    """BEV corners (counter-clockwise) of box = (x, y, z, l, w, h, yaw); z is the box centre."""
    x, y, _, l, w, _, yaw = box
    c, s = np.cos(yaw), np.sin(yaw)
    local = np.array([[l, w], [-l, w], [-l, -w], [l, -w]]) / 2
    return local @ np.array([[c, s], [-s, c]]) + [x, y]

def clip(subject, clipper):
    """Sutherland-Hodgman: keep the part of polygon `subject` inside convex CCW polygon `clipper`."""
    out = list(subject)
    for i in range(len(clipper)):
        a, b = clipper[i], clipper[(i + 1) % len(clipper)]
        inside = lambda p: (b[0] - a[0]) * (p[1] - a[1]) - (b[1] - a[1]) * (p[0] - a[0]) >= 0
        pts, out = out, []
        for j in range(len(pts)):
            p, q = pts[j], pts[(j + 1) % len(pts)]
            if inside(q):
                if not inside(p):
                    out.append(cross_point(p, q, a, b))
                out.append(q)
            elif inside(p):
                out.append(cross_point(p, q, a, b))
        if not out:
            break
    return np.array(out)

def cross_point(p, q, a, b):
    """Intersection of segment p-q with the infinite line through a and b."""
    d1, d2 = q - p, b - a
    t = ((a[0] - p[0]) * d2[1] - (a[1] - p[1]) * d2[0]) / (d1[0] * d2[1] - d1[1] * d2[0])
    return p + t * d1

def area(poly):                                   # shoelace formula
    if len(poly) < 3:
        return 0.0
    x, y = poly[:, 0], poly[:, 1]
    return 0.5 * abs(x @ np.roll(y, -1) - y @ np.roll(x, -1))

def iou_bev_3d(a, b):
    inter = area(clip(corners(a), corners(b)))
    bev = inter / (a[3] * a[4] + b[3] * b[4] - inter)
    dz = max(0.0, min(a[2] + a[5] / 2, b[2] + b[5] / 2) - max(a[2] - a[5] / 2, b[2] - b[5] / 2))
    inter3 = inter * dz
    return bev, inter3 / (a[3] * a[4] * a[5] + b[3] * b[4] * b[5] - inter3)

car = (0, 0, 0, 4, 2, 1.5, 0)
cases = {"identical":                 (car, car),
         "rotated by 180 deg":        (car, (0, 0, 0, 4, 2, 1.5, np.pi)),
         "rotated by 90 deg":         (car, (0, 0, 0, 4, 2, 1.5, np.pi / 2)),
         "unit square vs 45 deg":     ((0, 0, 0, 1, 1, 1, 0), (0, 0, 0, 1, 1, 1, np.pi / 4)),
         "shifted 1 m along length":  (car, (1, 0, 0, 4, 2, 1.5, 0)),
         "same BEV, raised 0.5 m":    (car, (0, 0, 0.5, 4, 2, 1.5, 0)),
         "far apart":                 (car, (10, 0, 0, 4, 2, 1.5, 0.3))}
for name, (a, b) in cases.items():
    bev, iou3 = iou_bev_3d(np.array(a, float), np.array(b, float))
    print(f"{name:26s} BEV IoU {bev:.4f}   3D IoU {iou3:.4f}")
輸出
identical                  BEV IoU 1.0000   3D IoU 1.0000
rotated by 180 deg         BEV IoU 1.0000   3D IoU 1.0000
rotated by 90 deg          BEV IoU 0.3333   3D IoU 0.3333
unit square vs 45 deg      BEV IoU 0.7071   3D IoU 0.7071
shifted 1 m along length   BEV IoU 0.6000   3D IoU 0.6000
same BEV, raised 0.5 m     BEV IoU 1.0000   3D IoU 0.5000
far apart                  BEV IoU 0.0000   3D IoU 0.0000
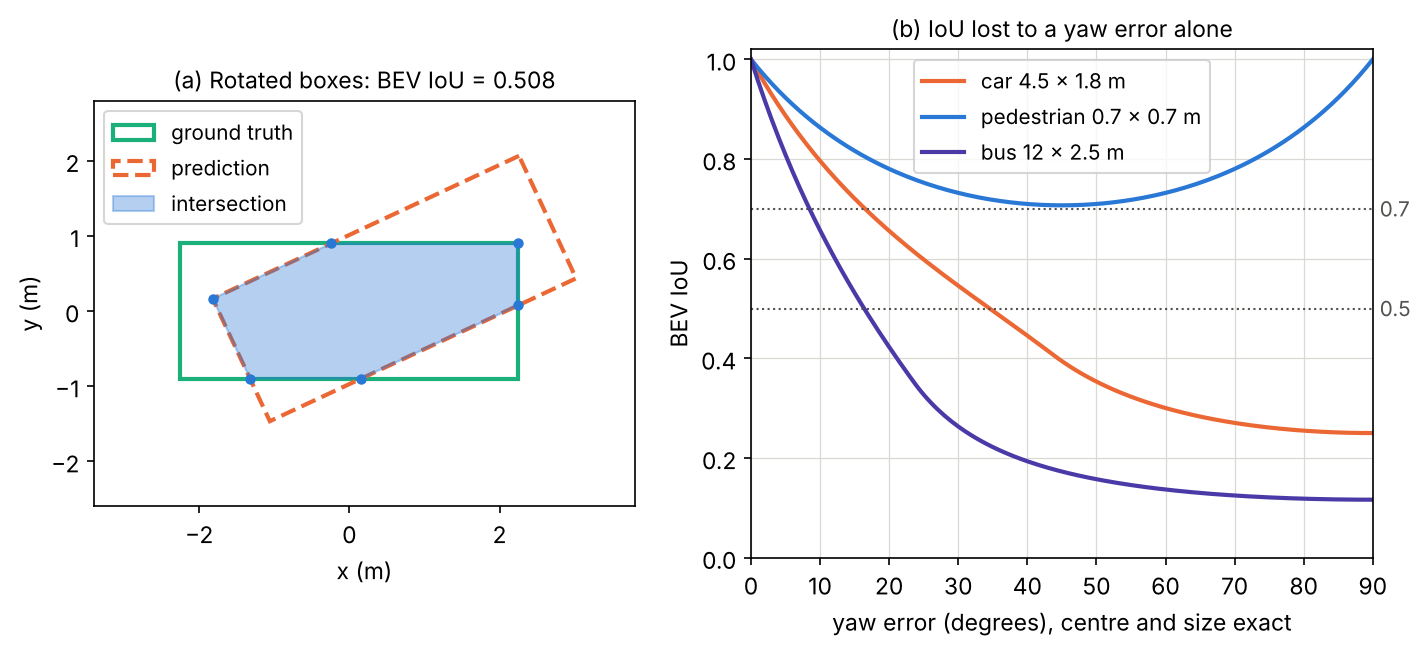
每個值都與手算相符:4 × 2 的框對上自己旋轉 90° 後的框,重疊成一個 2 × 2 的正方形,所以 ;單位正方形對上自己旋轉 45° 後的版本,重疊成一個面積為 的正八邊形,得到 ;抬高了自身高度三分之一的框,BEV 重疊完整保留,三維重疊卻只剩一半。請注意第二行:轉了 180° 的框,IoU 是 1。IoU 對朝向的方向是盲的,這正是 Waymo 的指標要加上朝向項的原因(見下文)。
圖 4(右)顯示偏航角誤差對細長物體有多嚴苛。在中心與尺寸都完美的情況下,車子大小的框在偏航角誤差約 17° 時,IoU 就掉到 0.7 以下;巴士大小的框約在 8.5°;而方形的行人框永遠不會低於 0.7。
旋轉 NMS 及其替代方案
白話版。 移除重複的框,做法和二維相同,但「重疊」現在必須在旋轉的框之間量測,這比較慢。兩種捷徑很常見:用軸對齊的框近似重疊,或是用中心峰值或集合預測,完全避開 NMS。
三維中的貪婪 NMS 依分數排序,並移除與某個已保留的框之間 BEV IoU 超過門檻的框,使用上面的旋轉 IoU。因為道路上的物體在 BEV 中很少重疊,門檻可以設得低。PointPillars 發現,對軸對齊的 BEV 框用門檻 0.5 做 NMS,結果與旋轉 NMS 相近,卻快得多 [10]。CenterPoint 從中心熱圖的局部極大值讀出物體,就像 CenterNet [13] 一樣,這在設計上就移除了大部分重複;論文仍在第二階段之前對這些峰值套用 NMS [11]。DETR 家族 [14] 的相機方法(例如 DETR3D)直接預測一組框,完全不需要 NMS [15]。
以光達為基礎的偵測器
白話版。 光達偵測器的差別,主要在於它們如何把一個無序的點集變成網路能處理的東西:保留點本身(以點為基礎)、把點丟進三維網格(體素)、把點丟進垂直的柱(pillar),或是混用。在那之後,大多數方法會在 BEV 上使用二維偵測頭。
以點為基礎:PointNet、PointNet++ 與 PointRCNN
白話版。 用同一個小網路處理每一個點,再用取最大值把所有點彙整起來。最大值不在乎輸入的順序,所以結果是排列不變的。
PointNet [16] 計算
其中 是套用在每個點上的共用多層感知器, 對所有點逐元素取最大(這是對稱函數,所以順序無關緊要), 是第二個網路,把彙整後的特徵映射到輸出。它先單獨看每個點,再一次看整個集合,所以會錯過局部結構。PointNet++ [17] 用集合抽象(set abstraction)層修正這一點:用最遠點取樣(farthest point sampling,每個新的中心是離已選中心最遠的點)選出一個中心點子集,收集每個中心半徑內的鄰居(球查詢,ball query),再對每個鄰域執行一個小型 PointNet。把這些層疊起來,就得到一個局部特徵的階層,就像 CNN 逐步擴大的感受野。兩者主要都是骨幹網路:它們產生特徵,偵測頭另外建在上面。
PointRCNN [18] 是直接在點上運作的二階段偵測器。第一階段用 PointNet++ 骨幹把場景分割成前景點與背景點,並由下而上地從每個前景點提出一個三維框。第二階段在每個提議內部做點的池化,把它們轉換到提議自己的標準座標(canonical coordinates,經過平移與旋轉,使框與座標軸對齊),再精修這個框。以點為基礎的偵測器對小物體很準確,但在大型點雲上的取樣與鄰居搜尋很慢。
以體素為基礎:VoxelNet 與 SECOND
白話版。 把空間切成小的三維格子(體素),用一個小型 PointNet 彙整每個格子裡的點,再對得到的三維網格做卷積。由於幾乎所有體素都是空的,只在有點的地方計算。
VoxelNet [8] 依體素把點分組,並讓每個點帶上它相對於體素質心的偏移,得到 7 維輸入 ,其中 是該體素內各點的平均。一疊體素特徵編碼(voxel feature encoding,VFE)層,每層是一個共用的全連接層,後接體素內的逐元素最大池化,把每個體素變成一個特徵向量。接著三維卷積處理這個網格,再由 Faster R-CNN [19] 風格的區域提議網路在 BEV 特徵圖上預測框。它是端到端的,而且很強,但稠密的三維卷積讓它很慢。
SECOND [9] 以稀疏卷積(sparse convolution)取代稠密的三維卷積,只儲存與計算有被占用的體素。它多半使用子流形(submanifold)稀疏卷積 [20],其輸出只在輸入為活躍的地方才活躍,所以被占用位置的集合不會一層一層地長大。SECOND 也引入了正弦誤差角度損失與真值取樣資料增強(兩者都在本篇中說明),而這類稀疏體素骨幹後來被 PV-RCNN [21] 等偵測器採用。
選讀:稀疏卷積與子流形卷積(見「補充資料」頁)。規則表、為什麼一般的稀疏卷積會讓活躍集合「膨脹」,以及一個小量測。
以柱為基礎:PointPillars
白話版。 讓格子無限高。每一根垂直的柱(pillar)由一個小型 PointNet 彙整,結果是一張平面的「偽影像」,普通的二維 CNN 就能很快地處理它。
PointPillars [10] 有三個階段:柱特徵網路、二維卷積骨幹,以及 SSD 風格的偵測頭 [22]。柱中的每個點被裝飾成 維:、它相對於柱內各點平均值的偏移 ,以及它在 – 平面上相對於柱中心的偏移 。非空的柱被打包成形狀為 的稠密張量,每個樣本最多 根柱、每根柱最多 個點(論文在 0.16 m 網格下用 12,000 與 100),不足的補零,過多的隨機子取樣。對每個點套用一個線性層、批次正規化與 ReLU,對 個點取最大值,每根柱得到一個 維特徵,再把這些特徵散佈(scatter)回它們的網格位置,形成 的偽影像。論文報告完整流程為 62 Hz,較快的變體為 105 Hz [10]。
選讀:PointPillars:閱讀指南(見「論文導讀」頁)。如何閱讀論文中的速度與準確度表格,以及 KITTI 改用 40 個召回點之後有什麼改變。
下面的程式碼在一個玩具點雲上執行這個流程的輸入端:分格、9 維裝飾、稠密的 張量,以及散佈(PointNet 的權重在這裡是隨機的;真實模型中則是學出來的)。
程式碼 · Python · 43 行
import numpy as np

rng = np.random.default_rng(0)
# toy cloud: ground sampled uniformly in range and angle (so density falls as 1/r) + two "cars"
r, a = rng.uniform(2, 70, 10000), rng.uniform(-0.5, 0.5, 10000)
ground = np.column_stack([r * np.cos(a), r * np.sin(a), rng.normal(-1.7, 0.03, r.size)])
cars = [c + rng.uniform([-2.2, -0.9, -1.7], [2.2, 0.9, -0.2], (n, 3))
        for c, n in [(np.array([10.0, 2.0, 0.0]), 3000), (np.array([35.0, -6.0, 0.0]), 60)]]
xyz = np.vstack([ground] + cars)
pts = np.column_stack([xyz, rng.uniform(0, 1, len(xyz))])          # x, y, z, reflectance

# 1) bin into a bird's-eye-view grid of 0.16 m pillars over x in [0, 70.4), y in [-40, 40)
vx, x0, y0, W, H = 0.16, 0.0, -40.0, 440, 500
ix = np.floor((pts[:, 0] - x0) / vx).astype(int)
iy = np.floor((pts[:, 1] - y0) / vx).astype(int)
ok = (ix >= 0) & (ix < W) & (iy >= 0) & (iy < H)
pts, ix, iy = pts[ok], ix[ok], iy[ok]
pillar_id, inv, counts = np.unique(iy * W + ix, return_inverse=True, return_counts=True)
print(f"{len(pts)} points -> {len(pillar_id)} non-empty pillars out of {W * H} "
      f"({100 * (1 - len(pillar_id) / (W * H)):.1f}% empty); max {counts.max()} points in one pillar")

# 2) per-point 9-D features: x, y, z, r, offsets to the pillar mean, offsets to the pillar centre
mean = np.zeros((len(pillar_id), 3))
np.add.at(mean, inv, pts[:, :3])
mean /= counts[:, None]
centre = np.column_stack([(ix + 0.5) * vx + x0, (iy + 0.5) * vx + y0])
feat = np.column_stack([pts, pts[:, :3] - mean[inv], pts[:, :2] - centre])

# 3) dense tensor (P pillars, N points, D=9): pad with zeros, keep at most N points per pillar
P, N = len(pillar_id), 16          # PointPillars caps P at 12000 and N at 100, sampling at random
order = np.argsort(inv, kind="stable")
slot = np.arange(len(inv)) - np.searchsorted(inv[order], inv[order])   # rank inside its pillar
keep = slot < N
dense = np.zeros((P, N, 9))
dense[inv[order][keep], slot[keep]] = feat[order][keep]
print("dense pillar tensor:", dense.shape, "| points dropped by the cap N:", int((~keep).sum()))

# 4) a one-layer 'PointNet' (random weights here): linear + ReLU per point, max over points, scatter
Wt = rng.normal(0, 0.3, (9, 64))
pillar_feat = np.maximum(dense @ Wt, 0).max(axis=1)                      # (P, 64)
canvas = np.zeros((64, H * W))
canvas[:, pillar_id] = pillar_feat.T
print("pseudo-image:", canvas.reshape(64, H, W).shape)
輸出
13060 points -> 9481 non-empty pillars out of 220000 (95.7% empty); max 24 points in one pillar
dense pillar tensor: (9481, 16, 9) | points dropped by the cap N: 23
pseudo-image: (64, 500, 440)
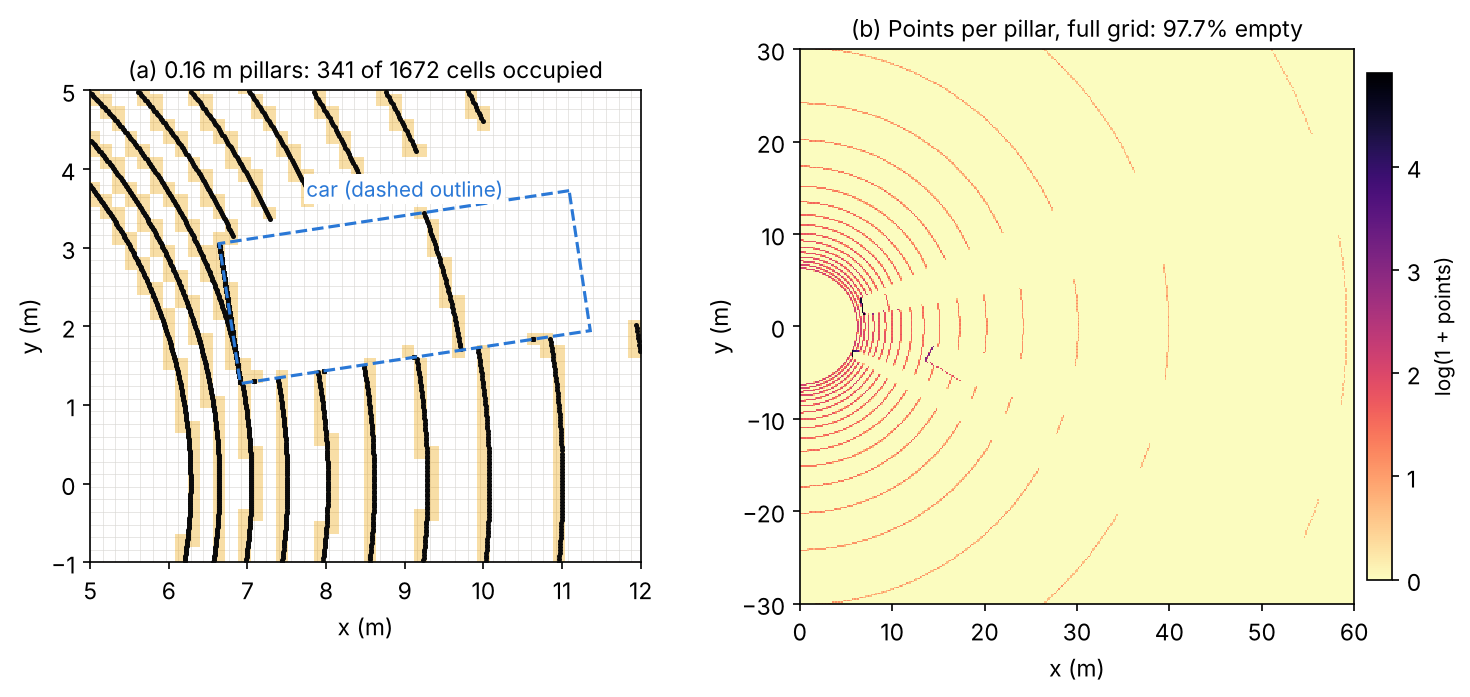
在這個玩具中,22 萬個格子有超過 95% 是空的,接近 PointPillars 論文針對相同網格大小下真實 64 線掃描所報告的約 97% 稀疏度 [10]。這就是為什麼輸入步驟需要多少記憶體,取決於柱化與散佈,而不是卷積。圖 5 在一次光線投射的掃描上顯示這個網格。
以中心為基礎的偵測頭:CenterPoint
白話版。 不使用多種朝向的錨框,而是把物體的中心當成 BEV 熱圖中的峰值找出來,再從峰值處的特徵讀出其他所有屬性。中心沒有朝向,所以錨框的旋轉問題就消失了。
CenterPoint [11] 保留標準的體素或柱骨幹,並以 CenterNet [13] 精神的中心偵測頭取代錨框偵測頭。熱圖每個類別一個通道,用焦點損失 [23] 對著畫在投影後框中心的高斯峰值訓練;因為物體在 BEV 中很小,高斯半徑被放大到至少 2 個格子。在每個中心,迴歸頭預測次體素偏移、離地高度、三維尺寸、以 表示的偏航角,以及二維速度。速度來自餵入連續兩次掃描,並讓追蹤變成在幀間對中心做貪婪的最近點配對。一個輕量的第二階段在框各面的中心取樣特徵,預測精修後的框,以及一個朝著該框與真值的三維 IoU 訓練的信心值。以中心為基礎的偵測頭也擴展到光達之外:例如相機偵測器 BEVDet 就使用 CenterPoint 的偵測頭 [24]。
點–體素混合:PV-RCNN
白話版。 體素快,並能給出好的提議;點則保有精確的位置。用體素來提議,用點來精修。
PV-RCNN [21] 先執行稀疏三維體素 CNN 取得特徵與提議,再把多尺度的體素特徵彙整成一小組關鍵點(keypoints,即體素集合抽象)。對每個提議,RoI 網格池化(RoI-grid pooling)在框內的一個規則點網格上、以數種半徑收集關鍵點特徵,再由精修頭預測最終的框與信心值。在 Transformer 骨幹出現之前,這類二階段混合方法是最準確的光達偵測器之一。
點上的 Transformer 與序列模型
白話版。 一輛車只占 150 m 場景中極小的一部分,所以像二維網路那樣縮小特徵圖,會丟掉細節。如果把注意力限制在被占用的體素上,它就能讓特徵在不縮小的情況下長距離互動。
SST [25] 觀察到降取樣在光達偵測中帶來的好處很小,因此全程只用單一步幅,並在鄰近的被占用體素之間使用注意力,來取回降取樣原本會提供的感受野;論文報告這對行人等小物體幫助最大。DSVT [26] 重新組織這種注意力,使它能在 GPU 上完全平行地執行,也容易部署。LION [27] 與 Voxel Mamba [28] 以線性時間的序列模型(線性遞迴網路與狀態空間模型)取代注意力,把體素當作長序列來讀。唯一要記住的一點是:這些骨幹用來換取長距離脈絡的成本,隨被占用體素的數量成長,而不是隨場景的大小成長。
選讀:稀疏體素上的注意力(見「補充資料」頁)。視窗、等大小集合與空間填充曲線序列化,如何讓注意力與序列模型在稀疏體素上變得實用。
純相機的三維偵測
白話版。 相機便宜,看得到顏色、紋理與標誌,但照片是平的。每個相機偵測器都必須回答同一個問題:它看到的每樣東西有多遠?本節先說明為什麼這很困難,再介紹從影像建出三維地圖的兩種主要方式:把像素推出到三維,或把影像特徵拉到三維位置。
為什麼單一相機不夠:深度歧義
白話版。 近距離的一輛玩具車,與遠處的一輛真車,在照片上可能看起來一模一樣。要從單張影像得到深度,網路必須依賴一些線索,例如物體的典型尺寸、它接觸路面的位置,以及透視,而這些線索中的小誤差,到了遠處會變成以公尺計的大誤差。
對於焦距為 (以像素計)的針孔相機,一個真實高度為 、深度為 的物體,在影像中高 像素,所以 。微分得到
所以一個像素的量測誤差所造成的深度誤差,隨距離的平方成長,而假設的尺寸 若有誤差,深度會被乘上相同的倍數。
程式碼 · Python · 9 行
import numpy as np

f, H = 1000.0, 1.5                       # focal length in pixels, true car height in metres
for Z in [10, 20, 40, 80]:
    h = f * H / Z                        # image height of the car in pixels
    z_pix = f * H / (h - 1)              # depth if we mis-measure the height by one pixel
    z_size = f * (1.1 * H) / h           # depth if we assume a car 10% taller than it is
    print(f"Z = {Z:2d} m: car is {h:6.2f} px tall | 1 px error -> {z_pix - Z:5.2f} m | "
          f"10% size error -> {z_size - Z:4.1f} m")
輸出
Z = 10 m: car is 150.00 px tall | 1 px error ->  0.07 m | 10% size error ->  1.0 m
Z = 20 m: car is  75.00 px tall | 1 px error ->  0.27 m | 10% size error ->  2.0 m
Z = 40 m: car is  37.50 px tall | 1 px error ->  1.10 m | 10% size error ->  4.0 m
Z = 80 m: car is  18.75 px tall | 1 px error ->  4.51 m | 10% size error ->  8.0 m
在 80 m 處,單單一個像素就能讓車子移動約 4.5 m,遠遠超出三維 IoU 0.7 能容忍的範圍。這就是為什麼單眼三維偵測器在遠處物體上遠遠落後光達。像 FCOS3D [29] 這樣的單眼方法,改造二維一階段偵測器(FCOS [30]),在投影後的三維中心迴歸深度、尺寸與朝向。Pseudo-LiDAR [31] 提出了一個有影響力的觀點:影像式與光達式偵測器之間的差距,很大一部分來自表示方式,而不只是深度品質;把估計出的深度圖轉成三維點雲,再對它執行光達偵測器,效果遠比把深度圖當成影像來處理好。
把影像提升到鳥瞰視角
白話版。 每個像素不知道自己的深度,所以給它一個深度的機率分布,在每個可能的深度放一份它的特徵副本、以該機率加權,然後把所有這些三維特徵丟到 BEV 網格上。結果可以跨相機融合,並像光達的 BEV 圖那樣處理。
Lift-Splat-Shoot(LSS)[32] 把每張影像「提升」成特徵的視錐。在每個像素,網路預測一個脈絡向量 ,以及一個在離散深度集合 上的分布 (,)。放在像素射線上深度 處的特徵是
也就是深度機率與脈絡的外積。有把握的深度把特徵放在一個地方;不確定的深度則把它沿著射線散開。「splat」步驟用相機外參與內參,把視錐中所有的點轉換到車輛座標系,再以加總池化放進 BEV 的柱中,並用累積和的技巧讓池化變快 [32]。論文評估的是 BEV 分割與規劃;BEVDet [24] 則用 BEV 編碼器與以中心為基礎的偵測頭,加上同時在影像與 BEV 空間進行的資料增強,把同一個視角轉換變成三維偵測器。BEVDepth [33] 發現只從偵測損失學到的深度分布品質很差,於是用投影到影像中的光達點所提供的深度明確監督它,並搭配一個感知相機參數的深度網路。
選讀:Lift-Splat-Shoot:閱讀指南(見「論文導讀」頁)。LSS 論文實際評估了什麼、它的穩健性實驗,以及它的限制。
從三維回頭查詢影像:DETR3D、PETR 與 BEVFormer
白話版。 反過來走。從三維的猜測出發,無論是物體查詢還是一個 BEV 格子的網格,用已知的相機矩陣把它們投影到影像中,再取出它們落點上的影像特徵。不需要深度圖。
DETR3D [15] 把每個物體查詢解碼成一個三維參考點,投影到所有相機中,以雙線性內插在那裡取樣影像特徵,並用它們精修查詢;訓練使用 DETR 的集合對集合損失 [14],所以不需要 NMS。PETR [34] 則把三維位置編碼進影像特徵本身:把相機視錐離散成數個深度上的點,用相機參數轉換到三維,再通過一個小型網路產生三維位置嵌入(3D position embedding),加到影像特徵上;然後普通的 DETR 式查詢去關注這些具位置感知的特徵。BEVFormer [35] 保留一個由可學習的 BEV 查詢組成的網格,每個 BEV 格子一個。空間交叉注意力讓每個 BEV 查詢,用可變形注意力 [36],在它的位置所投影到的影像區域中取樣特徵;時間自注意力則讓它去看前一幀的 BEV 特徵,這對速度和暫時被遮住的物體有幫助。它的 BEV 圖支援偵測與地圖分割的偵測頭。
事實證明,時間是相機深度的強力來源:幀與幀之間的運動就是一種立體視覺。StreamPETR [37] 在線上把物體查詢從一幀傳到下一幀,並報告在 nuScenes 上,純相機的結果可與光達方法相提並論;Far3D [38] 則以 2D 偵測產生的 3D 查詢,瞄準長距離的相機偵測。
融合光達、相機與雷達
白話版。 光達擅長「在哪裡」,相機擅長「是什麼」。融合把兩者結合起來,而主要的設計問題是在哪裡結合:在原始點、在提議、在共用的 BEV 圖,或是透過注意力。
我們依融合發生的位置把方法分組;Wang 等人 [39] 給出更細緻的分類。
- 點層級(早期)融合。 PointPainting [40] 把每個光達點投影到影像語意分割結果上,並把類別分數附加到該點;然後任何光達偵測器都能在這個「上色」的點雲上執行。
- 提議層級融合。 MV3D [41] 從點雲的 BEV 圖產生三維提議,並融合來自 BEV、光達前視圖與影像的區域特徵。Frustum PointNets [42] 則由 2D 走向 3D:2D 偵測器在影像中找到物體,PointNet 只處理那個 2D 框後方視錐內的點。
- BEV 層級融合。 兩個都叫 BEVFusion 的方法,把相機特徵轉成 BEV 圖(用 LSS 風格的視角轉換),再與光達 BEV 圖結合。其中一個來自 MIT [43],以串接與卷積編碼器融合,支援偵測與地圖分割,並把相機到 BEV 的池化加速了 40 倍以上。另一個 [44] 讓相機分支獨立於光達,因此光達故障時偵測器仍能運作,並報告在模擬的光達故障下有很大的增益。
- 查詢層級融合。 TransFusion [45] 先從光達預測物體查詢,再用 Transformer 解碼器讓每個查詢去關注影像特徵。這種透過注意力的「軟」關聯,而不是把點硬投影到像素,讓它對不佳的影像條件與校正誤差更穩健。UniTR [46] 更進一步,用一個共用的 Transformer 骨幹處理相機與光達的 token。
雷達。 雷達帶來速度資訊,以及對天氣的穩健性。CenterFusion [47] 在影像中偵測物體中心,透過圍繞每個偵測的視錐把雷達回波與它關聯起來,再用雷達特徵改善深度、旋轉與速度,使相機偵測器的 nuScenes 偵測分數大幅提高。
訓練:指派與資料增強
白話版。 訓練三維偵測器和訓練二維很像,只有兩個轉折:指派使用旋轉的 BEV 重疊或中心熱圖;而資料增強可以把物體從一個場景切出來、貼進另一個場景,這在照片上不可能做得令人信服。
指派。 以錨框為基礎的偵測頭在每個 BEV 格子放幾個錨框(每個類別一種尺寸,通常偏航角為 0° 與 90°),並依 BEV IoU 指派,就像 DLCV 03 的二維規則。例如 VoxelNet 的車輛錨框,BEV IoU 高於 0.6 為正樣本、低於 0.45 為負樣本 [8]。因為三維場景中的錨框遠多於物體,這些偵測頭使用焦點損失 [23]。以中心為基礎的偵測頭則以高斯熱圖目標取代 IoU 指派 [11]。
資料增強。 光達場景數量不多(KITTI 有 7,481 筆訓練掃描 [48]),每個場景裡的物體更少。標準的資料增強有 [8], [9], [10]:
- 真值取樣(ground-truth sampling)。把所有標註框以及框內的點建成資料庫,再把隨機挑選的物體貼進每個訓練場景 [9]。PointPillars 在 KITTI 上每個場景取樣 15 輛車、0 位行人與 8 位單車騎士 [10]。VoxelNet 在擾動框時就已使用碰撞測試,來剔除物理上不可能的結果 [8],貼上時也需要相同的檢查。
- 逐物體擾動。 把每個框連同它的點一起旋轉與平移;VoxelNet 的旋轉角從 抽取,平移從標準差為 1 m 的零平均高斯分布抽取 [8]。
- 全域轉換。 繞垂直軸旋轉整個場景(VoxelNet 的角度從 抽取,模擬車子在轉彎)、以 中的倍率縮放,以及左右翻轉 [8], [10]。
這些做法很便宜,因為點雲不過就是一堆座標:把點與框一起旋轉,標註就能保持精確。麻煩在於跨感測器的一致性:貼進光達掃描的物體並不在相機影像裡,所以融合模型需要格外小心。
選讀:真值取樣細說(見「補充資料」頁)。資料庫、碰撞檢查與陷阱(漂浮的物體、不一致的遮擋、相機不匹配)。
資料集與指標
白話版。 三個公開基準塑造了這個領域。KITTI 規模小、只看前方,指標是嚴格的三維 IoU。nuScenes 與 Waymo 規模大、涵蓋 360 度;nuScenes 以中心距離配對框並加上誤差項,Waymo 則依朝向吻合的程度,對每個正確的框加權。
| 資料集 | 感測器(取自論文) | 規模(取自論文) | 主要偵測指標 |
|---|---|---|---|
| KITTI 3D [49], [48] | 兩組立體相機(灰階與彩色)、一個 Velodyne HDL-64E 光達 | 7,481 筆訓練與 7,518 筆測試的影像與點雲;80,256 個標註物體 | IoU 0.7(車)/0.5(行人、單車)的 3D AP,分簡單/中等/困難 |
| nuScenes [4], [50] | 6 台相機、5 個雷達、1 個光達,360° | 1,000 個 20 秒的場景;23 個類別與 8 種屬性(偵測用 10 個類別) | 以中心距離配對的 mAP;NDS |
| Waymo Open [3], [51] | 5 個光達、5 台相機 | 1,150 個 20 秒的場景;約 1,200 萬個標註的三維光達物體 | LEVEL_1/LEVEL_2 的 mAPH |
KITTI:分難度等級的 3D AP
在 KITTI 的三維基準上,一個偵測若與某個真值框的三維 IoU 至少為 0.7(車)或 0.5(行人與單車騎士),就是正確的 [48]。物體依其影像外觀被分成三個累積的難度等級 [48]:
- 簡單: 2D 框高度至少 40 px、完全可見、截斷最多 15%。
- 中等: 高度至少 25 px、最多部分被遮擋、截斷最多 30%。
- 困難: 高度至少 25 px、最多「難以看見」、截斷最多 50%。
方法依中等難度的 AP 排名。自 2019 年 10 月 8 日起,基準依 Simonelli 等人的分析 [48], [52],改用 40 個召回點而不是原本的 11 個來計算 AP;論文把它寫成 ,兩種規則算出的數字不能拿來比較。標註只涵蓋前方相機可見的物體,所以 KITTI 的光達偵測器通常只保留投影到影像內的點 [10]。
nuScenes:以中心距離計算的 mAP 與 NDS
用距離配對。 nuScenes 不用 IoU 判斷偵測是否正確。一個預測會與地面平面上二維中心距離最小的真值物體配對,只要該距離低於門檻 [50]。AP 針對每個類別,在門檻 m 下計算,並只在召回率與精確率都超過 0.1 的範圍內對精確率–召回率曲線積分,而
其中 是 10 個偵測類別的集合, 是以公尺為單位的距離門檻集合 [50]。每個類別只在離自車的自己那一段範圍內評估(障礙物與交通錐為 30 m,自行車、機車與行人為 40 m,各種車輛類別為 50 m),而且每個樣本最多可以提交 500 個框 [50]。
為什麼用距離?同樣的中心誤差,IoU 對小物體的懲罰遠比對大物體重(圖 6)。例如,0.25 m 的誤差會讓 0.7 m 的行人框掉到 IoU 約 0.47,低於 0.5,而一輛車沿著車長方向平移同樣的量,IoU 仍接近 0.9。
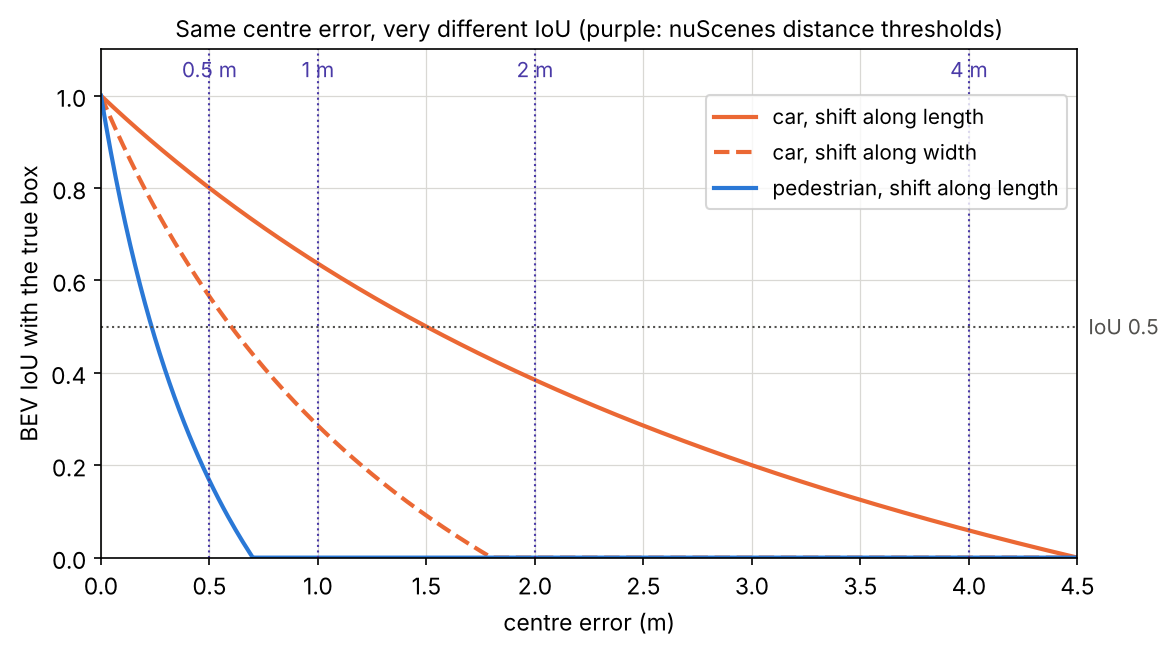
下面的程式碼用 AP 說明同一件事。兩個類別得到相同的中心誤差(高斯分布,每個軸的標準差 0.25 m)和相同數量的偽陽性;只有尺寸不同。(我們計算的是一般的 101 點內插 AP,並略過 nuScenes 的 0.1 截斷,這不影響比較。)
程式碼 · Python · 37 行
import numpy as np

rng = np.random.default_rng(0)
size = {"car": (4.5, 1.8), "pedestrian": (0.7, 0.7)}     # BEV length x width in metres

def bev_iou(a, b):
    """Axis-aligned BEV IoU of boxes (x, y, l, w); yaw is 0 in this toy."""
    ox = max(0, min(a[0] + a[2] / 2, b[0] + b[2] / 2) - max(a[0] - a[2] / 2, b[0] - b[2] / 2))
    oy = max(0, min(a[1] + a[3] / 2, b[1] + b[3] / 2) - max(a[1] - a[3] / 2, b[1] - b[3] / 2))
    return ox * oy / (a[2] * a[3] + b[2] * b[3] - ox * oy)

def average_precision(gts, preds, is_match):
    """Greedy matching in score order; AP = mean interpolated precision at 101 recall points."""
    used, tp = np.zeros(len(gts), bool), []
    for p in sorted(preds, key=lambda p: -p[-1]):
        ok = [j for j in range(len(gts)) if not used[j] and is_match(p, gts[j])]
        if ok:
            j = min(ok, key=lambda j: np.hypot(p[0] - gts[j][0], p[1] - gts[j][1]))
            used[j] = True
        tp.append(bool(ok))
    tp = np.array(tp)
    recall = np.cumsum(tp) / len(gts)
    precision = np.cumsum(tp) / np.arange(1, len(tp) + 1)
    envelope = np.maximum.accumulate(precision[::-1])[::-1]
    return np.mean([envelope[recall >= r].max() if np.any(recall >= r) else 0
                    for r in np.linspace(0, 1, 101)])

for cls, (l, w) in size.items():
    gts = [(x, y, l, w) for x, y in rng.uniform(-50, 50, (100, 2))]
    preds = [(g[0] + dx, g[1] + dy, l, w, s) for g, (dx, dy), s in
             zip(gts, rng.normal(0, 0.25, (100, 2)), rng.uniform(0.3, 1, 100))]
    preds += [(x, y, l, w, s) for (x, y), s in zip(rng.uniform(-50, 50, (20, 2)), rng.uniform(0, 0.6, 20))]
    ap_iou = average_precision(gts, preds, lambda p, g: bev_iou(p, g) >= 0.5)
    ap_d = [average_precision(gts, preds, lambda p, g, t=t: np.hypot(p[0] - g[0], p[1] - g[1]) <= t)
            for t in (0.5, 1, 2, 4)]
    print(f"{cls:10s} AP(BEV IoU>=0.5) = {ap_iou:.3f} | AP(centre dist <= 0.5/1/2/4 m) = "
          f"{' / '.join(f'{a:.3f}' for a in ap_d)} | mean = {np.mean(ap_d):.3f}")
輸出
car        AP(BEV IoU>=0.5) = 0.951 | AP(centre dist <= 0.5/1/2/4 m) = 0.789 / 0.988 / 0.988 / 0.990 | mean = 0.939
pedestrian AP(BEV IoU>=0.5) = 0.126 | AP(centre dist <= 0.5/1/2/4 m) = 0.791 / 0.979 / 0.979 / 0.979 | mean = 0.932
在這次玩具實驗中,IoU 配對把行人偵測器評為幾乎沒用(AP 0.126),把車輛偵測器評為極好(0.951),雖然兩者的中心誤差完全相同。中心距離配對則給兩者大致相同的分數。距離配對並沒有忽略框的品質;它把品質移到另外的誤差項中。
真陽性誤差與 NDS。 對於在 2 m 門檻下配對成功的偵測,nuScenes 量測五種真陽性誤差(TP errors):平移誤差 ATE(中心距離,單位公尺)、尺度誤差 ASE(對齊中心與朝向之後的 )、朝向誤差 AOE(最小偏航角差,單位弧度)、速度誤差 AVE(m/s)與屬性誤差 AAE( 屬性準確率)[50]。它們的類別平均與 mAP 結合成 nuScenes 偵測分數(nuScenes detection score,NDS):
其中 是平均 TP 誤差的集合 [50]。NDS 有一半來自 mAP,另一半來自框的品質、朝向、速度與屬性,所以能把速度估得好的方法(靠多次掃描或多幀)能在 NDS 上獲得很大的增益。
選讀:一步步計算 NDS(見「補充資料」頁)。TP 誤差如何平均、哪些類別略過哪些項,以及兩個偵測器的實例比較。
Waymo:以朝向加權的 AP
Waymo Open Dataset 使用三維 IoU 配對,車輛的門檻為 0.7,行人與單車騎士為 0.5,它的主要指標是 APH,即依朝向(heading)加權的平均精確率 [51]。每個真陽性不是算 1,而是算成一個朝向準確度
其中 與 分別是預測與真值的朝向,範圍在 [3], [53]。因此一個正確但正好朝著反方向的框()算 0,這堵住了 IoU 留下的漏洞。真值框被分成兩個難度等級:LEVEL_2 是有 1 到 5 個光達點的框(或在釋出標註中被標為 LEVEL_2 的框),LEVEL_1 是其餘的框(沒有光達點的框不評估),而 LEVEL_2 的指標兩者都包含 [51]。它的 2020 年三維偵測挑戰賽以 LEVEL_2 的 mAPH(車輛、行人與單車騎士的平均)排名,並依距離細分結果:、 與超過 50 m [51]。
效率與部署
白話版。 車上的電腦必須在下一次掃描到來之前,早早完成感知,在嵌入式硬體上,每一次都是如此。表示方式決定了大部分的成本:有多少格子、每個格子多少個點,以及運算子能否在目標晶片上跑得快。
- 網格大小與範圍決定預算。 格子尺寸減半,BEV 格子數就變成四倍。PointPillars 正是這樣拿準確度換速度,從預設網格的 62 Hz 到較粗柱的 105 Hz [10]。
- 稀疏運算子需要支援。 稀疏卷積與點取樣原則上很有效率,但它們依賴自訂核心(kernel);柱網路則跑在每個推論引擎都支援的稠密二維卷積上。DSVT 把部署明確當作設計目標,其池化不需要自訂的 CUDA 運算子,並報告部署後可即時推論 [26]。
- 相機的視角轉換很昂貴。 把每個像素提升到許多深度,會產生巨大的中間點集;BEVFusion 優化後的 BEV 池化,把這一步的延遲降低了 40 倍以上 [43]。
- 基準上的速度不是車上的速度。 PointPillars 的論文指出,KITTI 只使用前方相機視野內的點,大約是一次掃描的 10%,而且桌上型 GPU 的計時不能直接換算到嵌入式電腦 [10]。要在目標硬體上、用完整 360 度的輸入、從頭到尾地量測。
- 後處理與時間輸入也要算進來。 旋轉 NMS 要處理很多框;多次掃描的輸入會讓點數成倍增加。nuScenes 把偵測方法可使用的過去感測器資料,限制在約 0.5 秒 [50]。
失敗模式
白話版。 三維偵測器會在證據薄弱處(遠的、小的或被遮住的物體)、感測器受到干擾處(天氣、髒汙、校正不準),以及測試資料與訓練資料不同處(另一座城市、另一種感測器)失敗。
- 遠處與稀疏的物體。 點數大致隨 下降(圖 2),所以遠處的物體只有幾個點,甚至一個也沒有。基準也承認這一點:Waymo 把含 1–5 個點或有明確難度標記的框歸為 LEVEL_2,而 LEVEL_2 評估同時包含兩個難度等級 [51],而 nuScenes 只在 30–50 m 內評估每個類別 [50]。相機的深度誤差隨 成長,對同樣這些物體傷害更大。
- 遮擋與截斷。 感測器只看到面向它的表面,而一輛停著的車會擋住它後面的行人。KITTI 的難度等級就是依遮擋與截斷定義的 [48];時間模型能靠記住暫時被擋住的物體來幫忙 [35]。
- 容易混淆的類別。 PointPillars 報告,行人與單車騎士常被彼此混淆,行人也會與電線桿和樹幹混淆 [10]。
- 天氣。 霧、雨和雪會散射雷射脈衝,產生虛假的近距離回波並丟掉遠處的回波。Hahner 等人在晴天的光達掃描上模擬基於物理的霧,並證明用它訓練能改善真實霧中的偵測 [54]。
- 校正與同步誤差。 把點硬投影到像素的融合,在外參漂移時會壞掉;TransFusion 的軟關聯正是為此設計的 [45],而 LSS 則顯示,用帶雜訊的外參或丟棄相機來訓練,能讓相機 BEV 模型對它們更穩健 [32]。
- 常見的損壞。 一個針對 KITTI、nuScenes 與 Waymo 套用 27 種光達與相機損壞、測試 24 個偵測器的基準發現:與運動相關的損壞對所有模型傷害最大,光達–相機融合模型比較穩健,而純相機模型對影像損壞極其脆弱 [55]。
- 資料集之間的領域偏移。 在一個資料集上訓練的偵測器,到了另一個資料集可能大幅下滑。Wang 等人發現,德國與美國駕駛資料集之間的主要障礙,單純就是平均車輛尺寸不同,修正它就能彌補大部分差距 [56]。Waymo 論文本身也報告不同城市的資料之間有明顯的落差 [3]。不同的光達型號(光束數、安裝高度)也會讓點的分布偏移。
現代觀點
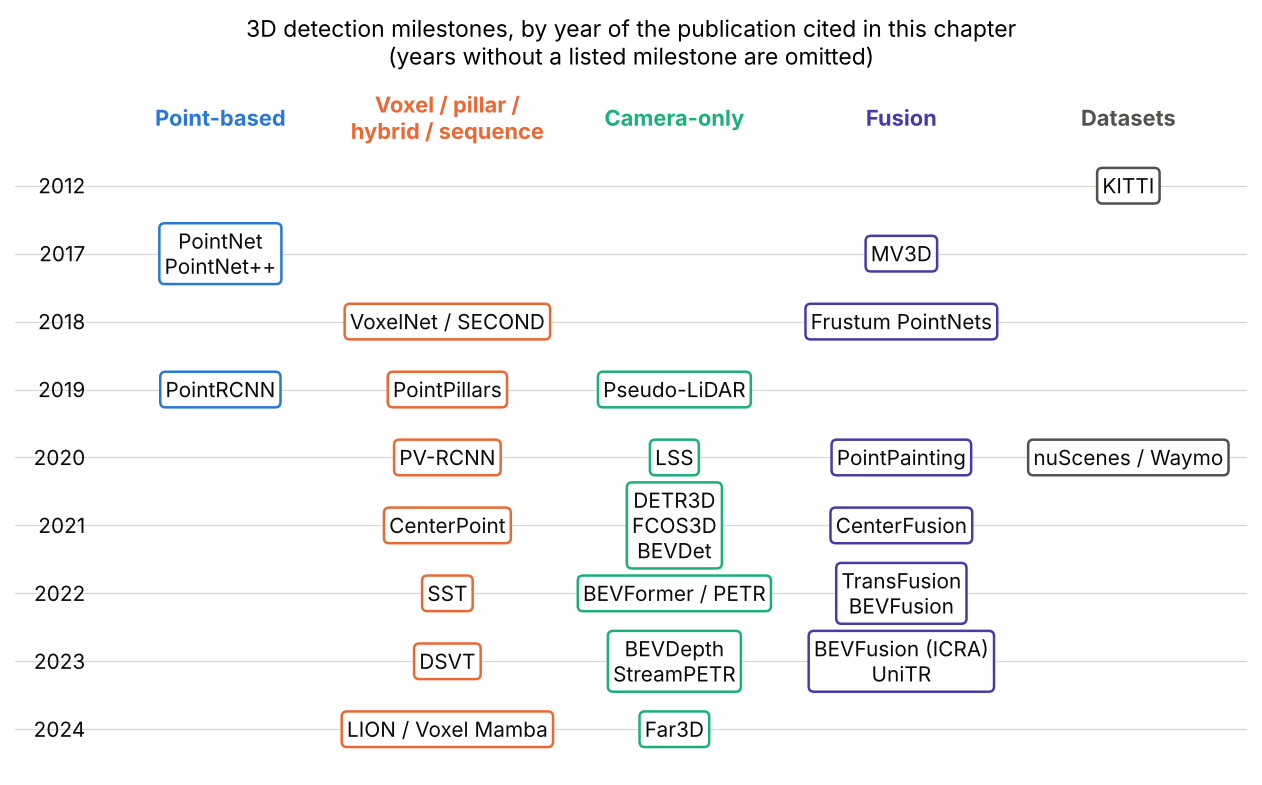
圖 7 依各篇引用的論文發表年份,把本篇的方法放在時間軸上。
綜述怎麼說
六篇綜述為這個領域搭起框架,各有自己的分類法。Mao 等人 [1] 給出自駕三維偵測最完整的地圖:光達方法依資料表示分類(點、網格、點–體素、距離影像),相機方法(單眼、立體、多視角)、融合、Transformer、時間與標註高效的偵測,並分析準確度與速度的趨勢。Qian 等人 [2] 涵蓋感測器、資料集與指標,並附有一個含執行時間、誤差與穩健性分析的案例研究。Guo 等人 [57] 回顧整個點雲深度學習,偵測只是其中一項任務。在相機方面,Ma 等人 [58] 與 Li 等人 [59] 綜述鳥瞰視角感知;後者把核心問題歸納為視角轉換、BEV 真值、多感測器流程,以及跨感測器配置的泛化,並補上一份實用的技巧「配方」。Wang 等人 [39] 則依融合階段、輸入與粒度來整理融合方法。兩個共通的結論:BEV 已成為各種感測器與任務共同的交會點,而標準基準上準確度的進步,已經超過穩健性與可部署性的進步。
選讀:現代觀點綜述導讀(見「論文導讀」頁)。每篇綜述涵蓋什麼、如何組織這個領域,以及怎麼使用它。
2023–2026 年的最先進技術
- 光達骨幹已從稀疏卷積走向稀疏 Transformer,以及對序列化體素的線性時間序列模型(DSVT [26]、LION [27]、Voxel Mamba [28])。Point Transformer V3 [60] 主張規模比繁複的設計更重要,並在多個資料集聯合訓練下進一步提升。
- 純相機偵測已經縮小了與光達的差距,主要靠時間建模與稀疏查詢(StreamPETR [37])以及更好的深度監督(BEVDepth [33]);長距離相機偵測是活躍的方向(Far3D [38])。
- 在共用的 BEV 或 token 空間中做融合(BEVFusion [43], [44]、UniTR [46]),是最強系統的標準配方,而對感測器缺失或劣化的穩健性,現在已是設計目標,而不是事後補救。
- 端到端駕駛。 偵測越來越常是為規劃而訓練的單一網路中的一個階段,例如 UniAD [61],其中感知、預測與規劃任務透過統一的查詢介面溝通。
尚待解決的問題
- 遠處、小型與罕見的物體。 遠距離的稀疏證據,以及訓練資料中罕見的類別(動物、碎片、特殊車輛),仍是弱點;封閉集合的資料集並未涵蓋長尾 [1]。
- 穩健性。 天氣、感測器故障、校正漂移與運動損壞仍會造成大幅下降 [55], [54]。
- 跨感測器與跨地點的泛化。 在一種光達型號、相機配置或城市上訓練的模型,常常在另一種上失敗 [56], [3]。
- 符合駕駛需求的指標。 AP 對 10 m 處漏掉的行人與 45 m 處漏掉的行人一視同仁;nuScenes 與 Waymo 加入了朝向、速度與距離細分,但正如 Mao 等人所指出,只最大化 AP 對整個駕駛系統來說未必是最佳的 [1]。
- 標註。 三維框的標註很昂貴,這催生了半監督、自監督與自動標註的方法 [1]。
重點整理
- 解讀偵測前,先註明方框規約、單位與座標變換。
- 點雲稀疏性與隨距離變化的取樣,決定哪些表示有用。
- 鳥瞰視角簡化公尺空間推理,垂直結構與校準仍然重要。
- 僅相機偵測須推論深度;時間與額外感測器證據可協助,但也引入對齊要求。
- 重疊指標可能掩蓋方向錯誤,須檢查偏航規約與方向敏感指標。
- KITTI、nuScenes 與 Waymo 使用不同匹配及評分規則;應報告協定並量測部署流程。
練習
- 距離上的點數。 某個光達的水平間隔為 0.1°、垂直間隔為 0.4°。用 ,估計一輛車 1.8 m × 1.5 m 的車尾,在 20 m 與 60 m 處各有多少個點。在 60 m 處,有幾條光束垂直穿過這輛車?
提示
換算成弧度:,。取 m²,則 ,。垂直方向上,射線在 60 m 處相隔 m,所以只有約 3–4 條光束穿過 1.5 m 高的物體;其餘的點來自細小的水平間隔。
- 手算 IoU。 兩個 4 m × 2 m × 1.5 m 的框共用同一個中心;其中一個繞垂直軸旋轉 90°。計算 BEV IoU 與三維 IoU。接著把第二個框抬高 0.75 m,重新計算三維 IoU。用 IoU 的程式碼檢查你的答案。
提示
BEV 交集是 2 m × 2 m 的正方形:。高度相等時,三維 IoU 也是 。抬高 0.75 m 之後,高度重疊是 0.75 m,所以交集是 3 m³,。
- 弄壞傳統流程。 在傳統基準的程式碼中,把行人移到 ,貼著第一輛車(在我們的執行中,它的點與車的點相距不到約 0.15 m),再執行一次。DBSCAN 會怎麼做?改變
eps來修正它,並說明太小的eps會對遠處的物體造成什麼新的失敗。
提示
在我們的執行中,eps 從 0.7 一路降到 0.15,都會把行人與車子合併成同一個群,得到錯誤的框(5.1 × 1.8 m、偏航角 28°,而不是 4.5 × 1.8 m、17°)。在 eps=0.12 時行人分開了,但 25 m 處的車已經碎成好幾塊;在 eps=0.1 時,連近處的車也裂成兩個可見的側面。遠處物體的點較少,所以點與點之間的間隙較大(在真實掃描器上,間隙以 的方式成長)。固定的 eps 無法適用所有距離,這是 密度的直接後果。
- 配對協定。 使用配對的程式碼,找出中心誤差的標準差為多少時,車的 AP(IoU ≥ 0.5)會等於行人在標準差 0.25 m 時的 AP。這對於比較用 IoU 配對算出的各類別 AP,說明了什麼?
提示
在我們的執行中,車的 IoU 型 AP 在標準差 0.75 m 時降到 0.117,約是行人的 0.25 m 的三倍(大致是車寬與行人寬的比值),與圖 6 一致。因此各類別的 IoU 型 AP 把偵測品質與物體大小混在一起,所以行人 AP 低,並不表示行人偵測器以公尺計的定位比較差。
- 依朝向加權的 AP。 某個偵測器找到場景中全部 10 輛車,沒有偽陽性,IoU 也完美,但其中 3 輛朝向相反,2 輛偏差 30°。它的 AP 與 APH 各是多少(假設所有偵測的分數相同)?哪一個 nuScenes TP 誤差會揭露同樣的問題?
提示
AP 是 1,因為每個框都配對成功。朝向準確度:,所以 APH 。在 nuScenes 中,朝向誤差 AOE(弧度)會上升,透過 這一項拉低 NDS。
- 柱的預算。 在柱化的程式碼中,把網格改成 0.32 m 與 0.08 m(調整
W與H,使網格仍涵蓋 70.4 m × 80 m)。回報非空柱的數量、空格子的比例,以及被上限 丟掉的點數。把這個趨勢與 PointPillars 所報告的速度–準確度取捨連起來。
提示
在我們的執行中,0.32 m 得到 7,567 根非空柱(86.2% 為空),在 時丟掉 1,734 個點;0.08 m 得到 10,908 根柱(98.8% 為空),沒有丟掉任何點。較粗的柱表示柱比較少、比較滿:偽影像較小,被上限丟掉的點較多,所以較快但較不精確。較細的柱表示柱比較多、每根只有一兩個點,偽影像較大,空格子也較多。PointPillars 報告較粗的網格速度較高,損失主要出現在行人與單車騎士。
偵測結果是追蹤的輸入,追蹤把它們跨時間連起來;見 DLCV 07・物件追蹤:從單一物件到多物件。
參考文獻
- J. Mao, S. Shi, X. Wang and H. Li, “3D object detection for autonomous driving: A comprehensive survey,” International Journal of Computer Vision, vol. 131, no. 8, 2023. doi
- R. Qian, X. Lai and X. Li, “3D object detection for autonomous driving: A survey,” Pattern Recognition, vol. 130, 2022. doi
- P. Sun, H. Kretzschmar, X. Dotiwalla, A. Chouard, V. Patnaik et al., “Scalability in perception for autonomous driving: Waymo Open Dataset,” in Proc. IEEE/CVF CVPR, 2020. CVF
- H. Caesar, V. Bankiti, A. H. Lang, S. Vora, V. E. Liong et al., “nuScenes: A multimodal dataset for autonomous driving,” in Proc. IEEE/CVF CVPR, 2020. CVF
- M. A. Fischler and R. C. Bolles, “Random sample consensus: A paradigm for model fitting with applications to image analysis and automated cartography,” Communications of the ACM, vol. 24, no. 6, 1981. doi
- M. Ester, H.-P. Kriegel, J. Sander and X. Xu, “A density-based algorithm for discovering clusters in large spatial databases with noise,” in Proc. KDD, 1996. AAAI
- X. Zhang, W. Xu, C. Dong and J. M. Dolan, “Efficient L-shape fitting for vehicle detection using laser scanners,” in Proc. IEEE Intelligent Vehicles Symposium (IV), 2017. doi
- Y. Zhou and O. Tuzel, “VoxelNet: End-to-end learning for point cloud based 3D object detection,” in Proc. IEEE CVPR, 2018. CVF
- Y. Yan, Y. Mao and B. Li, “SECOND: Sparsely embedded convolutional detection,” Sensors, vol. 18, no. 10, 3337, 2018. doi
- A. H. Lang, S. Vora, H. Caesar, L. Zhou, J. Yang and O. Beijbom, “PointPillars: Fast encoders for object detection from point clouds,” in Proc. IEEE/CVF CVPR, 2019. CVF
- T. Yin, X. Zhou and P. Krähenbühl, “Center-based 3D object detection and tracking,” in Proc. IEEE/CVF CVPR, 2021. CVF
- I. E. Sutherland and G. W. Hodgman, “Reentrant polygon clipping,” Communications of the ACM, vol. 17, no. 1, 1974. doi
- X. Zhou, D. Wang and P. Krähenbühl, “Objects as points,” arXiv:1904.07850, 2019. arXiv
- N. Carion, F. Massa, G. Synnaeve, N. Usunier, A. Kirillov and S. Zagoruyko, “End-to-end object detection with transformers,” in Proc. ECCV, 2020. doi
- Y. Wang, V. Guizilini, T. Zhang, Y. Wang, H. Zhao and J. Solomon, “DETR3D: 3D object detection from multi-view images via 3D-to-2D queries,” in Proc. Conference on Robot Learning (CoRL), 2021. arXiv
- C. R. Qi, H. Su, K. Mo and L. J. Guibas, “PointNet: Deep learning on point sets for 3D classification and segmentation,” in Proc. IEEE CVPR, 2017. arXiv
- C. R. Qi, L. Yi, H. Su and L. J. Guibas, “PointNet++: Deep hierarchical feature learning on point sets in a metric space,” in Advances in Neural Information Processing Systems (NeurIPS), 2017. NeurIPS
- S. Shi, X. Wang and H. Li, “PointRCNN: 3D object proposal generation and detection from point cloud,” in Proc. IEEE/CVF CVPR, 2019. arXiv
- S. Ren, K. He, R. Girshick and J. Sun, “Faster R-CNN: Towards real-time object detection with region proposal networks,” IEEE TPAMI, vol. 39, no. 6, 2017. doi
- B. Graham, M. Engelcke and L. van der Maaten, “3D semantic segmentation with submanifold sparse convolutional networks,” in Proc. IEEE CVPR, 2018. CVF
- S. Shi, C. Guo, L. Jiang, Z. Wang, J. Shi, X. Wang and H. Li, “PV-RCNN: Point-voxel feature set abstraction for 3D object detection,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- W. Liu, D. Anguelov, D. Erhan, C. Szegedy, S. Reed, C.-Y. Fu and A. C. Berg, “SSD: Single shot multibox detector,” in Proc. ECCV, 2016. arXiv
- T.-Y. Lin, P. Goyal, R. Girshick, K. He and P. Dollár, “Focal loss for dense object detection,” in Proc. IEEE ICCV, 2017. doi
- J. Huang, G. Huang, Z. Zhu, Y. Ye and D. Du, “BEVDet: High-performance multi-camera 3D object detection in bird-eye-view,” arXiv:2112.11790, 2021. arXiv
- L. Fan, Z. Pang, T. Zhang, Y.-X. Wang, H. Zhao, F. Wang, N. Wang and Z. Zhang, “Embracing single stride 3D object detector with sparse transformer,” in Proc. IEEE/CVF CVPR, 2022. CVF
- H. Wang, C. Shi, S. Shi, M. Lei, S. Wang, D. He, B. Schiele and L. Wang, “DSVT: Dynamic sparse voxel transformer with rotated sets,” in Proc. IEEE/CVF CVPR, 2023. CVF
- Z. Liu, J. Hou, X. Wang, X. Ye, J. Wang, H. Zhao and X. Bai, “LION: Linear group RNN for 3D object detection in point clouds,” in Advances in Neural Information Processing Systems (NeurIPS), 2024. NeurIPS
- G. Zhang, L. Fan, C. He, Z. Lei, Z. Zhang and L. Zhang, “Voxel Mamba: Group-free state space models for point cloud based 3D object detection,” in Advances in Neural Information Processing Systems (NeurIPS), 2024. NeurIPS
- T. Wang, X. Zhu, J. Pang and D. Lin, “FCOS3D: Fully convolutional one-stage monocular 3D object detection,” in Proc. IEEE/CVF ICCV Workshops, 2021. arXiv
- Z. Tian, C. Shen, H. Chen and T. He, “FCOS: Fully convolutional one-stage object detection,” in Proc. IEEE/CVF ICCV, 2019. arXiv
- Y. Wang, W.-L. Chao, D. Garg, B. Hariharan, M. Campbell and K. Q. Weinberger, “Pseudo-LiDAR from visual depth estimation: Bridging the gap in 3D object detection for autonomous driving,” in Proc. IEEE/CVF CVPR, 2019. arXiv
- J. Philion and S. Fidler, “Lift, splat, shoot: Encoding images from arbitrary camera rigs by implicitly unprojecting to 3D,” in Proc. ECCV, 2020. arXiv
- Y. Li, Z. Ge, G. Yu, J. Yang, Z. Wang, Y. Shi, J. Sun and Z. Li, “BEVDepth: Acquisition of reliable depth for multi-view 3D object detection,” in Proc. AAAI, 2023. arXiv
- Y. Liu, T. Wang, X. Zhang and J. Sun, “PETR: Position embedding transformation for multi-view 3D object detection,” in Proc. ECCV, 2022. arXiv
- Z. Li, W. Wang, H. Li, E. Xie, C. Sima, T. Lu, Y. Qiao and J. Dai, “BEVFormer: Learning bird’s-eye-view representation from multi-camera images via spatiotemporal transformers,” in Proc. ECCV, 2022. arXiv
- X. Zhu, W. Su, L. Lu, B. Li, X. Wang and J. Dai, “Deformable DETR: Deformable transformers for end-to-end object detection,” in Proc. ICLR, 2021. arXiv
- S. Wang, Y. Liu, T. Wang, Y. Li and X. Zhang, “Exploring object-centric temporal modeling for efficient multi-view 3D object detection,” in Proc. IEEE/CVF ICCV, 2023. CVF
- X. Jiang, S. Li, Y. Liu, S. Wang, F. Jia, T. Wang, L. Han and X. Zhang, “Far3D: Expanding the horizon for surround-view 3D object detection,” in Proc. AAAI, 2024. arXiv
- Y. Wang, Q. Mao, H. Zhu, J. Deng, Y. Zhang, J. Ji, H. Li and Y. Zhang, “Multi-modal 3D object detection in autonomous driving: A survey,” International Journal of Computer Vision, vol. 131, no. 8, 2023. doi
- S. Vora, A. H. Lang, B. Helou and O. Beijbom, “PointPainting: Sequential fusion for 3D object detection,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- X. Chen, H. Ma, J. Wan, B. Li and T. Xia, “Multi-view 3D object detection network for autonomous driving,” in Proc. IEEE CVPR, 2017. arXiv
- C. R. Qi, W. Liu, C. Wu, H. Su and L. J. Guibas, “Frustum PointNets for 3D object detection from RGB-D data,” in Proc. IEEE CVPR, 2018. CVF
- Z. Liu, H. Tang, A. Amini, X. Yang, H. Mao, D. Rus and S. Han, “BEVFusion: Multi-task multi-sensor fusion with unified bird’s-eye view representation,” in Proc. IEEE ICRA, 2023. arXiv
- T. Liang, H. Xie, K. Yu, Z. Xia, Z. Lin, Y. Wang, T. Tang, B. Wang et al., “BEVFusion: A simple and robust LiDAR-camera fusion framework,” in Advances in Neural Information Processing Systems (NeurIPS), 2022. arXiv
- X. Bai, Z. Hu, X. Zhu, Q. Huang, Y. Chen, H. Fu and C.-L. Tai, “TransFusion: Robust LiDAR-camera fusion for 3D object detection with transformers,” in Proc. IEEE/CVF CVPR, 2022. arXiv
- H. Wang, H. Tang, S. Shi, A. Li, Z. Li, B. Schiele and L. Wang, “UniTR: A unified and efficient multi-modal transformer for bird’s-eye-view representation,” in Proc. IEEE/CVF ICCV, 2023. arXiv
- R. Nabati and H. Qi, “CenterFusion: Center-based radar and camera fusion for 3D object detection,” in Proc. IEEE/CVF WACV, 2021. doi
- A. Geiger, P. Lenz, C. Stiller and R. Urtasun, “3D object detection evaluation 2017,” The KITTI Vision Benchmark Suite, official benchmark page (data sizes, IoU thresholds, difficulty levels, 40 recall positions). link
- A. Geiger, P. Lenz and R. Urtasun, “Are we ready for autonomous driving? The KITTI vision benchmark suite,” in Proc. IEEE CVPR, 2012. doi
- nuScenes devkit, “nuScenes detection task,” official evaluation documentation (classes, detection ranges, mAP, TP metrics, NDS, submission rules). link
- Waymo Open Dataset, “3D detection challenge (2020),” official challenge page (APH, IoU thresholds, LEVEL_1/LEVEL_2, range breakdown). link
- A. Simonelli, S. Rota Bulò, L. Porzi, M. López-Antequera and P. Kontschieder, “Disentangling monocular 3D object detection,” in Proc. IEEE/CVF ICCV, 2019. doi
- Waymo Open Dataset,
metrics_utils.cc, official metric implementation (functionComputeHeadingAccuracy). code - M. Hahner, C. Sakaridis, D. Dai and L. Van Gool, “Fog simulation on real LiDAR point clouds for 3D object detection in adverse weather,” in Proc. IEEE/CVF ICCV, 2021. arXiv
- Y. Dong, C. Kang, J. Zhang, Z. Zhu, Y. Wang, X. Yang, H. Su, X. Wei et al., “Benchmarking robustness of 3D object detection to common corruptions in autonomous driving,” in Proc. IEEE/CVF CVPR, 2023. arXiv
- Y. Wang, X. Chen, Y. You, L. E. Li, B. Hariharan, M. Campbell, K. Q. Weinberger and W.-L. Chao, “Train in Germany, test in the USA: Making 3D object detectors generalize,” in Proc. IEEE/CVF CVPR, 2020. arXiv
- Y. Guo, H. Wang, Q. Hu, H. Liu, L. Liu and M. Bennamoun, “Deep learning for 3D point clouds: A survey,” IEEE TPAMI, vol. 43, no. 12, 2021. doi
- Y. Ma, T. Wang, X. Bai, H. Yang, Y. Hou, Y. Wang, Y. Qiao, R. Yang and X. Zhu, “Vision-centric BEV perception: A survey,” IEEE TPAMI, vol. 46, no. 12, 2024. doi
- H. Li, C. Sima, J. Dai, W. Wang, L. Lu, H. Wang, J. Zeng, Z. Li et al., “Delving into the devils of bird’s-eye-view perception: A review, evaluation and recipe,” IEEE TPAMI, vol. 46, no. 4, 2024. doi
- X. Wu, L. Jiang, P.-S. Wang, Z. Liu, X. Liu, Y. Qiao, W. Ouyang, T. He and H. Zhao, “Point Transformer V3: Simpler, faster, stronger,” in Proc. IEEE/CVF CVPR, 2024. arXiv
- Y. Hu, J. Yang, L. Chen, K. Li, C. Sima, X. Zhu, S. Chai, S. Du et al., “Planning-oriented autonomous driving,” in Proc. IEEE/CVF CVPR, 2023. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 04・影像分割:語意、實例與全景分割 · 33 分鐘