DLCV 08・影片理解與動作辨識
先備知識:DLCV 02・深度影像分類
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 為影片任務配對片段、區間、人員層級或語言輸出。
- 區分時間推理與外觀捷徑。
- 比較光流分支、時間卷積、取樣與注意力。
- 理解遮罩影片預訓練與影片語言遷移。
- 評估效能與成本時,控制影格、視圖、解析度及預訓練。
先看全貌
影像分類器看一張圖,說出圖裡有什麼。影片模型還得理解發生了什麼事:誰做了什麼、先後順序、持續多久。多出來的輸入是時間軸,也帶來影像沒有的兩個問題。第一,時間很貴:30 影格/秒的 10 秒片段就有 300 張影像。第二,時間很容易被忽略:網路常常光看球場就能猜出「打網球」,根本不必看揮拍的動作。
影片理解很重要,因為大部分視覺資料都是影片:手機錄影、監視器與交通攝影機、運動轉播、機器人、汽車與醫療處置。辨識動作是許多應用的基礎:搜尋影片典藏、分析運動、監控安全、協助居家生活與控制機器人。這個領域也產生了擴散到深度學習其他角落的想法,例如把預訓練的 2D 網路膨脹成 3D、把空間與時間分解開來,以及極高遮罩比例的遮罩式預訓練。
本篇假設你已熟悉 DLCV 02 的影像分類、訓練與評估。它會重用 DLCV 03 的偵測指標,以及 ML 05 的注意力。有五篇綜述為這個領域勾勒出輪廓:Zhu 等人談深度動作辨識 [1]、Kong 與 Fu 談辨識與預測 [2]、Selva 等人談影片 Transformer [3]、Madan 等人談影片基礎模型 [4],以及 Tang 等人談以大型語言模型做影片理解 [5]。我們會在「現代觀點」回頭討論它們。
相關章節。 在時間上追蹤物件是 DLCV 07・物件追蹤;骨架式辨識所用的人體關鍵點在 DLCV 05;光流的估計在 DLCV 11A;用時空注意力與影片自編碼器生成影片在 DLCV 12A;預測場景的未來以便規劃則在 DLCV 13・世界模型。
影片理解的任務
白話版。 影片輸出可以是片段標籤、動作區間、人員偵測或語言答案;選模型前先定義輸出。
精確版。 影片是一個張量 ,其中 是影格數, 是影格大小,3 是色彩通道。模型很少一次看到整個 ,它看到的是一個片段(clip),由 張取樣出來的影格組成,並已縮放與裁切成 。圖 1 畫出四類任務。
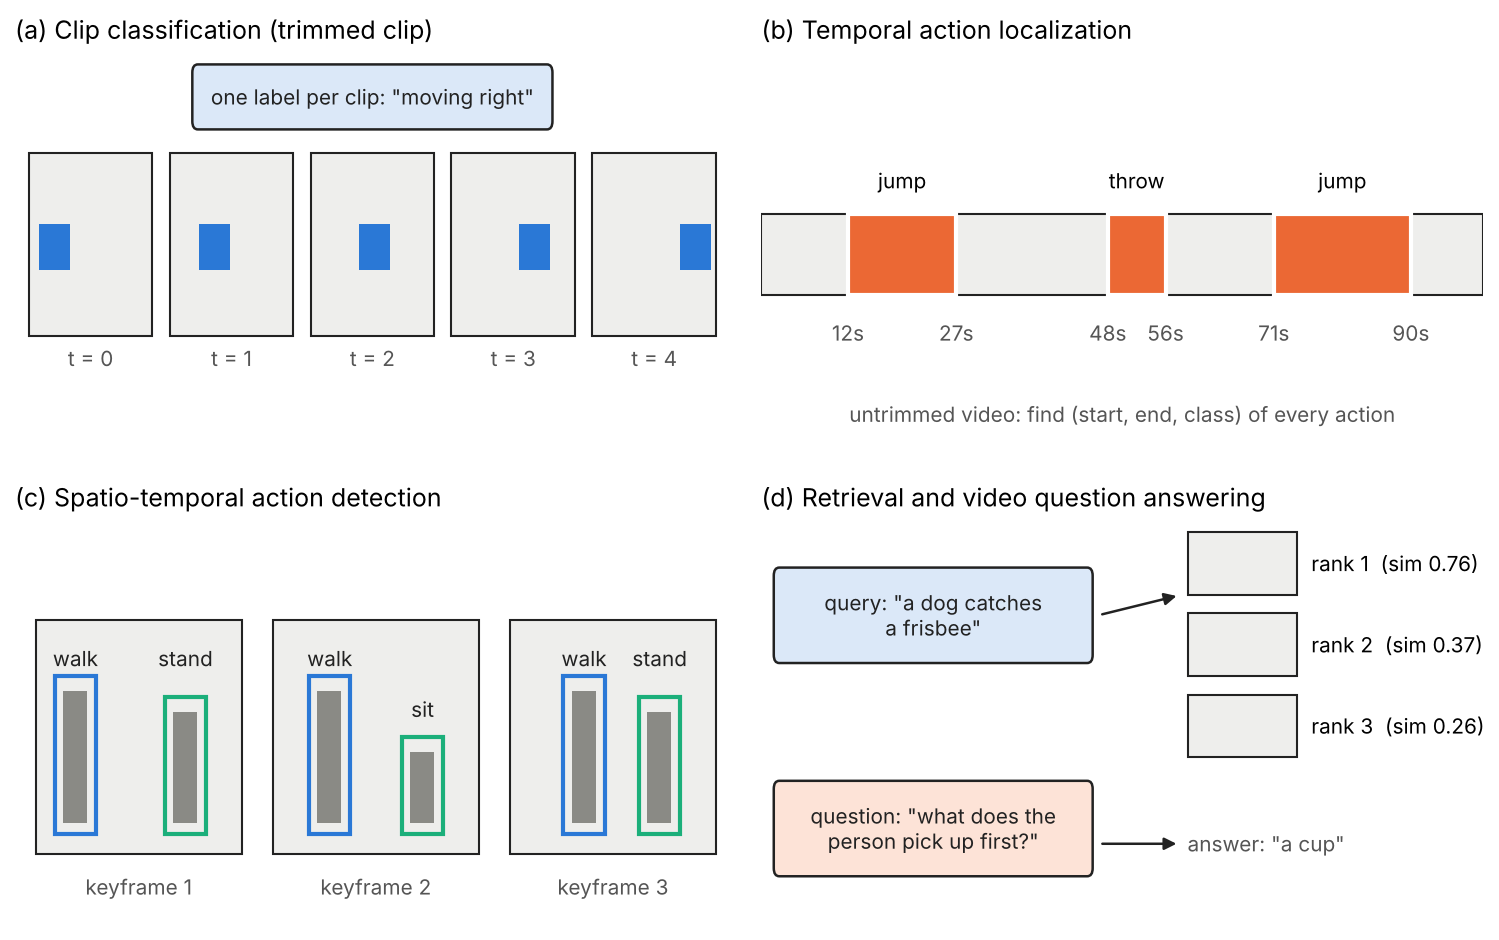
- 片段(動作)分類。 給定一段含有單一動作的已裁剪片段,預測它的類別 。以交叉熵訓練,並以 top-1 與 top-5 準確率評估,與 DLCV 02 完全相同。有些資料集是多標籤的(同時有好幾個動作),以各類別的平均精確率均值(mean average precision, mAP)評估。
- 時序動作定位(temporal action localization,也稱時序動作偵測)。給定一支未裁剪的影片,輸出一組片段 ,分別是開始時間 、結束時間 、類別 與信心分數 。這就是沿著一個維度做的物件偵測,以數個時序 IoU(temporal IoU)門檻下的 mAP 來評估。
- 時空動作偵測。 找出誰在哪裡、何時做了什麼:在每張有標註的關鍵影格中給出人物框,每個框帶一個或多個動作標籤。以固定框 IoU 門檻下的影格層級 mAP 評估。
- 影片–語言任務。 文字到影片檢索(text-to-video retrieval)依影片與一個句子的相似度為影片集合排序,以 Recall@ 評估(正確影片落在前 名的查詢所占的比例)。影片問答(video question answering)產生簡短的答案,常是從多個選項中挑選,以準確率計分。
相鄰的問題在別處討論。在各影格之間連結同一個物件是追蹤(DLCV 07)。預測接下來發生什麼是動作預期或世界建模(DLCV 13)。替每張影格的每個像素貼標籤則是影片分割。
為什麼影片很難
白話版。 有三件事讓影片比影像更難:標籤常常取決於順序與運動、資料集讓模型可以省掉這些功夫,而且輸入量非常大。
時間很重要,但資料不一定逼你使用它
有些動作只能靠運動分辨:「開門」與「關門」、「把東西推向左」與「把東西推向右」、「坐下」與「站起來」。這些動作的單張影格是模稜兩可的。許多其他動作靠單張影格就能認出,因為有場景與物件:游泳池、馬、吉他。從網路蒐集的資料集裡,有很多動作屬於第二類。
這件事很早就看得出來。Karpathy 等人用 100 萬支 YouTube 影片、487 個運動類別的資料集訓練 CNN,比較了幾種跨時間融合資訊的方式;他們最好的時空網路只比單影格模型略有進步 [6]。後來的研究直接量測這個問題。Li 等人定義了資料集的表徵偏差(representation bias),並顯示常見的動作資料集偏向靜態線索(物件、場景與人物);他們也建立了 Diving48,一個包含 48 種細緻跳水類別的競技跳水資料集,以降低這種偏差 [7]。Sevilla-Lara 等人請人們辨認影格被打亂順序的影片中的動作,只保留變得無法辨認的類別;模型能不能使用時間,就在這個「時序」子集上顯現出來 [8]。Something-Something 則是為了捕捉動作的細部物理面向,而不是高層概念而建立的:它的 174 個類別是像「把東西從左推到右」這樣的描述樣板 [9],VideoMAE 的作者稱之為以運動為中心 [10]。
網路用手邊最容易的線索解決訓練任務,這個一般現象就是 DLCV 02 的捷徑學習(shortcut learning)。在影片裡,最容易的線索通常是場景。
一個單張影格毫無資訊的資料集
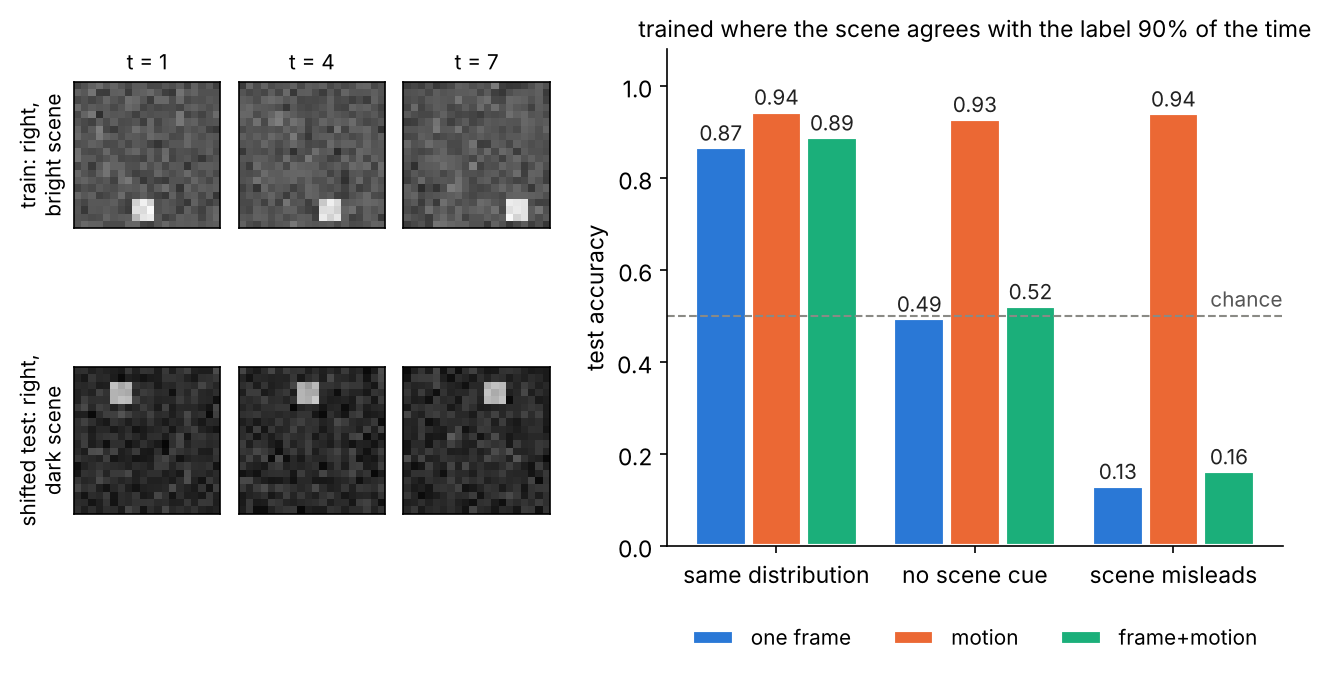
下面的程式碼用合成片段把這件事具體化。一個小方塊向左或向右移動,標籤就是方向。方塊在中間影格的位置,在兩種標籤下分布相同,所以單看中間影格,完全得不到標籤的資訊。接著我們加上「場景」:背景亮度在 90% 的訓練片段中與標籤一致。三個邏輯迴歸分類器分別看到 (1) 中間影格的像素、(2) 一個運動特徵,以及 (3) 兩者。
運動特徵是經典的亮度恆常性估計(見 DLCV 11A)。如果某個圖樣每影格位移 個像素,則 ,所以時間差分為 。對整張影格以最小平方法擬合 ,得到
其中 是第 張影格在第 欄、第 列的亮度, 是它的水平導數, 是第 與 張影格之間估計的水平運動(正值表示向右)。它是一個時間導數濾波器和一個空間導數濾波器的乘積,這正是 3D 卷積能學到的那類圖樣。
程式碼 · Python · 38 行
import numpy as np
from sklearn.linear_model import LogisticRegression

def make_clips(n, T=8, S=20, noise=0.5, scene_bias=0.5, seed=0):
    """A 3x3 square moves 1 px/frame left (y=0) or right (y=1) on a noisy background.
    scene_bias = P(background brightness agrees with the label); 0.5 = no bias."""
    rng = np.random.default_rng(seed)
    y = rng.integers(0, 2, n)
    X = noise * rng.standard_normal((n, T, S, S))
    for i in range(n):
        step = 1 if y[i] == 1 else -1
        c_mid = rng.integers(T // 2, S - 3 - T // 2 + 1)   # middle-frame position: same for both labels
        r = rng.integers(0, S - 3 + 1)
        agree = rng.random() < scene_bias
        X[i] += 0.3 * (y[i] if agree else 1 - y[i])       # the "scene": background brightness
        for t in range(T):
            c = c_mid + step * (t - T // 2)
            X[i, t, r:r + 3, c:c + 3] += 1.0
    return X, y

def frame_features(X):     # appearance only: the pixels of the middle frame
    return X[:, X.shape[1] // 2].reshape(len(X), -1)

def motion_features(X):    # temporal difference times horizontal gradient, per frame pair
    dt = X[:, 1:] - X[:, :-1]
    dx = np.gradient(X[:, :-1], axis=3)
    u = -(dt * dx).sum(axis=(2, 3)) / ((dx ** 2).sum(axis=(2, 3)) + 1e-6)
    return u                                            # one motion estimate per frame pair

data = {"train": make_clips(2000, scene_bias=0.9, seed=1),  # scene agrees with the label 90%
        "same": make_clips(1000, scene_bias=0.9, seed=2),   # test: same distribution
        "no cue": make_clips(1000, scene_bias=0.5, seed=3), # test: scene says nothing
        "shift": make_clips(1000, scene_bias=0.1, seed=4)}  # test: scene misleads 90%
for name, f in [("one frame", frame_features), ("motion", motion_features),
                ("frame+motion", lambda X: np.c_[frame_features(X), motion_features(X)])]:
    clf = LogisticRegression(C=0.1, max_iter=5000).fit(f(data["train"][0]), data["train"][1])
    acc = {k: clf.score(f(X), y) for k, (X, y) in data.items() if k != "train"}
    print(f"{name:13s}", "  ".join(f"{k} {v:.3f}" for k, v in acc.items()))
輸出
one frame     same 0.867  no cue 0.495  shift 0.131
motion        same 0.945  no cue 0.929  shift 0.941
frame+motion  same 0.889  no cue 0.522  shift 0.163
(這個區塊與圖 2 的所有數字都來自這次玩具實驗。)在與訓練相同分布的測試資料上,單影格模型看起來不錯(0.867),因為場景有 90% 的機率能預測標籤。拿掉場景線索,它就掉到隨機猜測的水準(0.495);讓場景產生誤導,它就跌到 0.131。運動模型在每種情況下都約在 0.93–0.94,因為它用的是真正決定標籤的線索。組合模型是個警訊:它有運動特徵,卻學成依賴數百個亮度像素,在分布偏移下失敗(0.163)。它對場景的依賴程度,取決於特徵尺度與正則化(練習 1),但從訓練分布抽出來的基準,永遠不會暴露這個問題。
運算量與記憶體
對逐影格的網路,一段 張影格的片段,成本大約是一張影像的 倍;對會混合影格的模型則更多。對一個卷積,設輸入通道 、輸出通道 、核大小 (時間 × 高 × 寬),在 的輸入上用步幅 1 與「same」補零,
其中 MACs 是乘加運算(multiply–accumulate)的次數(每次一個乘法加一個加法)。因此 的核,參數量與運算量都是對同樣影格施加 核的 3 倍。對 Transformer 來說,問題在於 token 數 :自注意力要比較 對查詢–鍵,而 與影格數成線性成長。下一節的程式碼會把這兩者量化出來。
如何讓影像網路學會時間
白話版。 影片模型透過池化、光流、時間卷積、多影格率或時空注意力結合影格特徵。
逐影格網路與後期融合
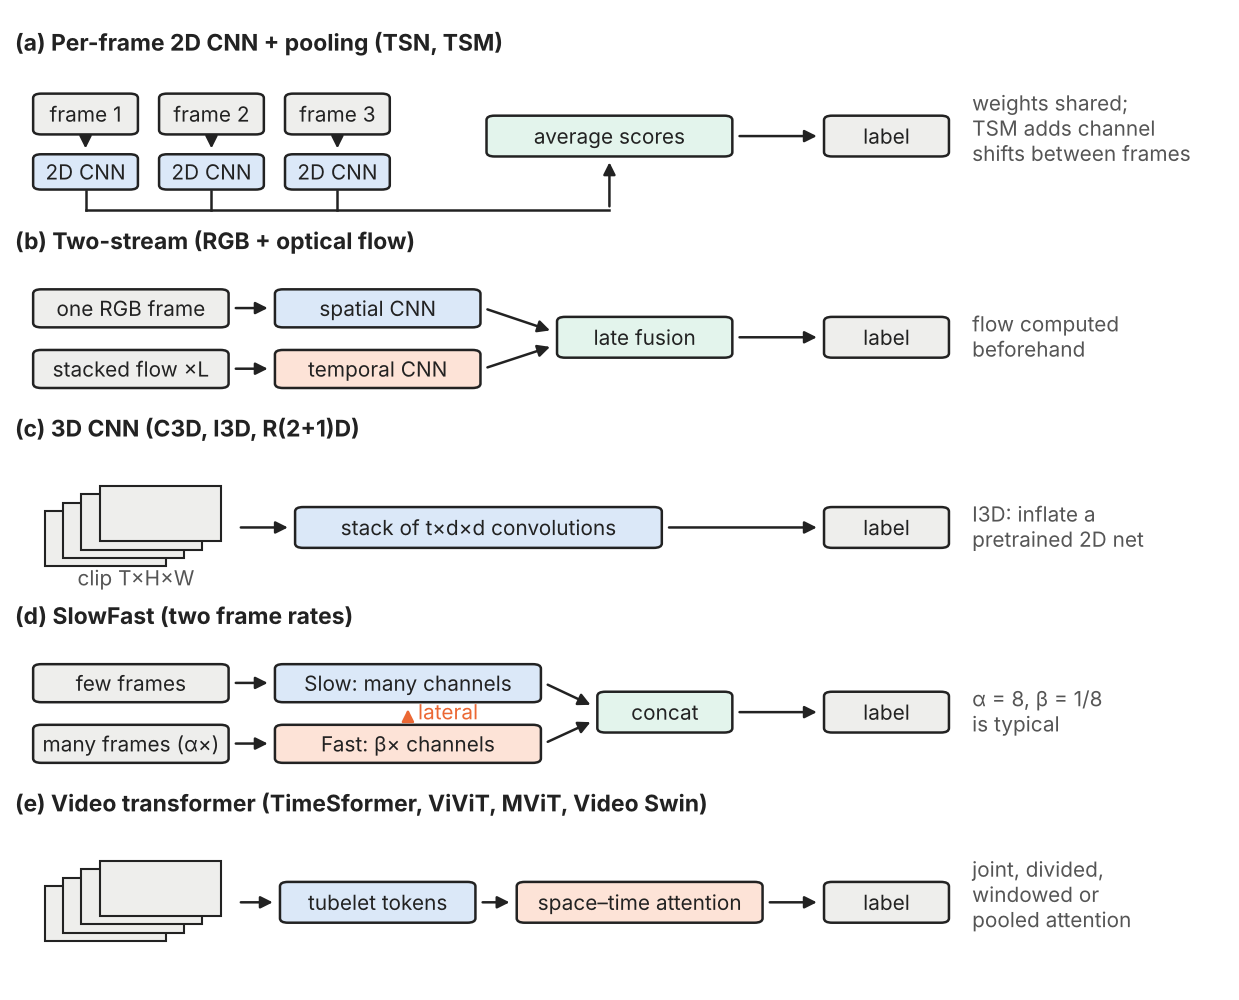
最簡單的影片模型,是把影像分類器 套用在 張影格 上,再把類別分數平均:
其中 是單張影格的類別分數向量(logits), 是類別數。這個模型對順序視而不見:打亂影格順序,答案不變,所以它分不出「打開」與「關上」。它在偏重場景的資料集上仍是很強的基準,而且成本低,可以從任何預訓練的影像骨幹開始(DLCV 02)。在逐影格特徵上接 LSTM [11] 這類循環網路,可以加入順序;這種設計在 ML 04 討論。
雙流網路:外觀加光流
白話版。 雙流模型結合彩色影格的外觀與光流場的運動資訊。
Simonyan 與 Zisserman 的雙流 ConvNet [12] 有一條空間流,是對單張 RGB 影格的影像 CNN,以及一條時間流,是輸入為 對連續影格之稠密光流的 CNN。每個光流場 有水平分量 與垂直分量 ,所以影格 的堆疊輸入有 個通道:
其中 是像素位置, 與 是該像素從第 張到第 張影格的水平與垂直位移。兩條流分開訓練,在後期融合:對 softmax 分數取平均,或在堆疊的分數上用線性 SVM [12]。這篇論文顯示,即使訓練資料有限,作用在堆疊光流上的 ConvNet 表現也很好,而且兩條流是互補的 [12]。
它的弱點是成本:必須在訓練前先為每張影格計算(通常還要儲存)稠密光流,用的是傳統求解器或光流網路(用光流做扭曲見 DLCV 09A.3)。光流也不是針對辨識任務學出來的。Temporal Segment Networks [13] 與 I3D [14] 仍使用光流流;SlowFast(見下)後來直接從原始影格端到端學出運動,不用光流,其作者在實驗上發現它比雙流方法更有效 [15]。
3D 卷積:C3D 與 I3D 膨脹
白話版。 讓每個濾波器都變成一個小立方體,不只在空間上滑動,也在時間上滑動。這樣網路就能直接從像素學到運動偵測器,例如「一條向右移動的亮邊」。
核為 的 3D 卷積,對一個輸入通道與一個輸出通道,計算
其中 是第 張影格、第 列、第 欄的輸入(實際上會對所有輸入通道求和,邊界也要補零)。C3D [16] 在一個大型影片資料集上訓練了由這種層組成的網路,發現所有層都用小的 核的同質架構是最好的之一;用它的特徵加線性分類器,在數個基準上都很強。
從頭訓練 3D 網路所需的資料,遠比 2015 年有的多。Carreira 與 Zisserman 在 2017 年同時解決了這兩個問題 [14]。他們提出了 Kinetics,一個含有 400 個人類動作類別的資料集,每個類別至少 400 段 YouTube 片段,每段約 10 秒 [17];以及 Inflated 3D ConvNet(I3D):拿一個成功的 2D 影像架構,把每個 的濾波器與池化核膨脹成 。為了從 ImageNet [18] 預訓練的權重開始,他們讓膨脹後的網路在「無聊影片」(同一張影像在時間上重複)上的反應,與 2D 網路在該影像上的反應相同:把每個 2D 濾波器沿時間重複 次,再除以 [14]。設 為預訓練的濾波器,
所以對於在時間上為常數的輸入, 個時間分接點加起來,恰好等於 2D 的反應。下面的程式碼用數值驗證這一點。
程式碼 · Python · 14 行
import numpy as np
from scipy.ndimage import correlate

rng = np.random.default_rng(0)
w2d = rng.standard_normal((3, 3))            # a "pretrained" 2D filter
N = 3                                        # temporal size of the inflated filter
w3d = np.repeat(w2d[None] / N, N, axis=0)    # (N, 3, 3): copy N times, divide by N

img = rng.standard_normal((32, 32))
boring = np.repeat(img[None], 8, axis=0)     # an 8-frame "video" of one still image

r2d = correlate(img, w2d, mode="nearest")
r3d = correlate(boring, w3d, mode="nearest")  # 3D filtering over (t, y, x)
print("max |3D response on any frame - 2D response| =", np.abs(r3d - r2d[None]).max())
輸出
max |3D response on any frame - 2D response| = 1.7763568394002505e-15差異在浮點數捨入的等級。接著,訓練會在濾波器學習運動的過程中,把它們從「在時間上為常數」推開。論文的最終模型是雙流 I3D:一個 I3D 吃 RGB、一個吃光流,預測取平均,因為作者仍然覺得光流流很有價值 [14]。在 Kinetics 上預訓練後,I3D 在小型的 UCF101 與 HMDB51 基準上大幅進步 [14],這讓「在 Kinetics 上預訓練、再到目標資料上微調」成為影片的標準配方。同樣的膨脹想法也出現在影片生成器中(DLCV 12A),而 I3D 特徵是 Fréchet Video Distance [19] 背後的特徵網路(DLCV 12A)。
選讀:Quo Vadis:I3D 與 Kinetics 資料集(見「論文導讀」頁)。論文如何比較五個架構家族,以及它的遷移實驗顯示了什麼。
分解式 (2+1)D 卷積
白話版。 立方體形的濾波器可以拆成兩個比較便宜的步驟:先用一個平面濾波器在每張影格內部看,再用一個細長的濾波器在每個位置上跨影格看。只要中間寬度選對,拆開後參數量不變,卻多了一個非線性,也比較容易訓練。
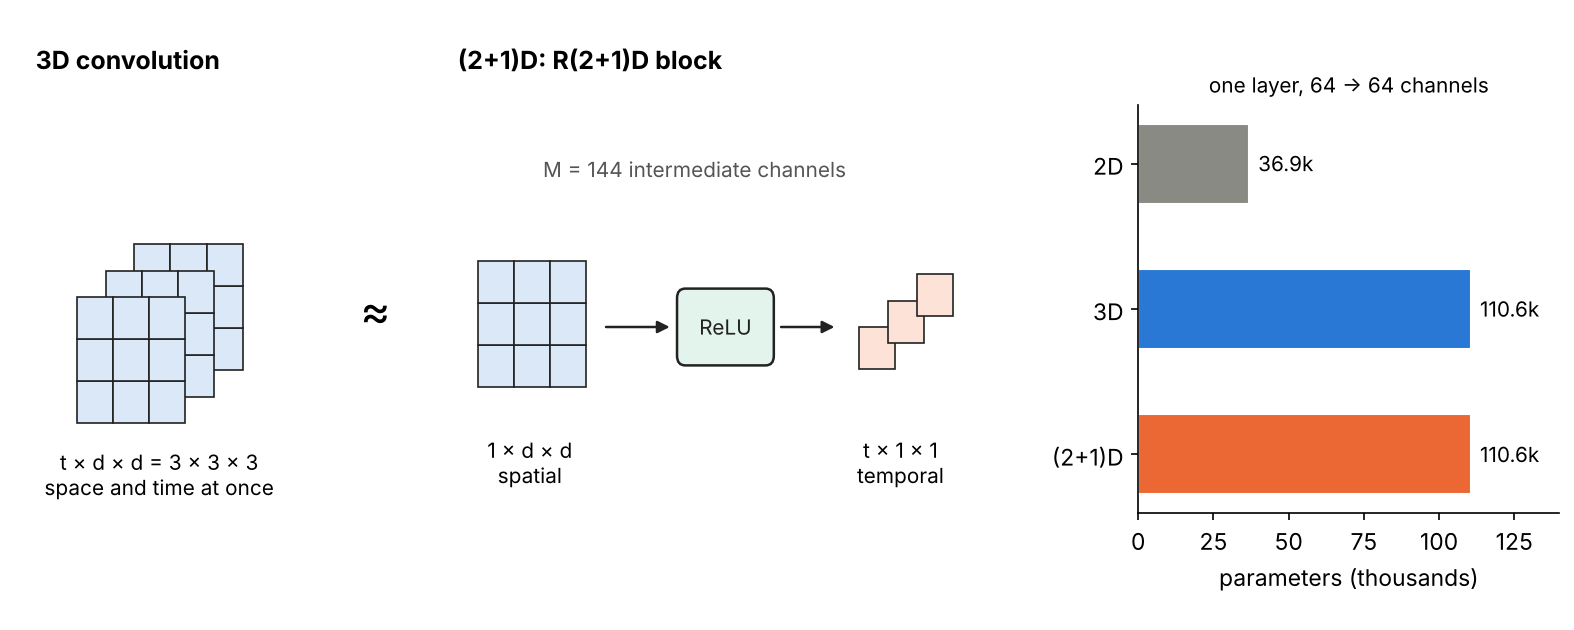
Tran 等人 [20] 在殘差網路中比較了幾種時空卷積:只用 2D、全部用 3D、混合式(只在早期層用 3D,或只在後期層用 3D),以及分解式的 (2+1)D 區塊。(2+1)D 區塊把 個大小為 的濾波器,換成 個大小為 的空間濾波器、一個 ReLU,以及 個大小為 的時間濾波器。這裡 與 是第 層的輸入與輸出通道數, 與 是時間與空間的核大小, 是中間空間的寬度,選擇的方式是讓參數量與 3D 層一致 [20]:
論文提出兩個好處:多出來的 ReLU 讓非線性的數量在相同參數量下加倍,而分解讓最佳化變容易,表現為比同樣大小的 3D 網路有更低的訓練誤差 [20]。它是影像 CNN 中深度可分離技巧(ML 03)在影片上的對應:把一個大運算沿著不同的軸拆成較便宜的運算。
程式碼計算一個 64 到 64 通道的層,在 16 張影格的片段、 特徵圖上的參數量與乘加次數,並順便算出影片 Transformer 的 token 數作為比較。
程式碼 · Python · 24 行
import math

def conv_cost(c_in, c_out, kt, kh, kw, T, H, W):
    """Parameters and multiply-adds of one convolution (stride 1, 'same' padding, no bias)."""
    params = c_in * c_out * kt * kh * kw
    return params, params * T * H * W

c, t, d = 64, 3, 3                           # channels in = out, temporal and spatial kernel size
T, H, W = 16, 56, 56                         # a 16-frame clip, 56x56 feature maps
M = math.floor(t * d * d * c * c / (d * d * c + t * c))   # R(2+1)D's matched middle width

layers = {
    "2D  (1x3x3), per frame": [conv_cost(c, c, 1, d, d, T, H, W)],
    "3D  (3x3x3)":            [conv_cost(c, c, t, d, d, T, H, W)],
    f"(2+1)D, M={M}":         [conv_cost(c, M, 1, d, d, T, H, W), conv_cost(M, c, t, 1, 1, T, H, W)],
}
for name, parts in layers.items():
    p = sum(x[0] for x in parts); f = sum(x[1] for x in parts)
    print(f"{name:24s} params {p:>8,d}   GMACs {f / 1e9:5.2f}")

# a video transformer's token count with 2x16x16 tubelets on a 16x224x224 clip
n_tok = (16 // 2) * (224 // 16) ** 2
print(f"tokens {n_tok}, joint attention pairs {n_tok**2:,}, "
      f"divided (time, then space) pairs {n_tok * 8 + n_tok * 196:,}")
輸出
2D  (1x3x3), per frame   params   36,864   GMACs  1.85
3D  (3x3x3)              params  110,592   GMACs  5.55
(2+1)D, M=144            params  110,592   GMACs  5.55
tokens 1568, joint attention pairs 2,458,624, divided (time, then space) pairs 319,872
在輸入與輸出寬度相等時, 使 (2+1)D 區塊的參數量與運算量恰好與 3D 層相同;它的好處在表達能力與最佳化,而不在成本。選擇較小的 ,就可以得到更便宜的拆法。圖 4 畫出這個分解。
選讀:選擇 (2+1)D 區塊的中間寬度(見「補充資料」頁)。公式從哪裡來,以及輸入與輸出寬度不同、或想要更便宜的區塊時會發生什麼事。
低成本的時序建模:TSN 取樣與時序位移模組
白話版。 兩個技巧讓普通的 2D 網路也能便宜地處理長影片。TSN 看的是分散在整支影片的幾張影格,而不是某一刻附近的許多影格。TSM 讓相鄰影格在網路內部交換少數幾個特徵通道,幾乎不花成本就能跨時間混合資訊。
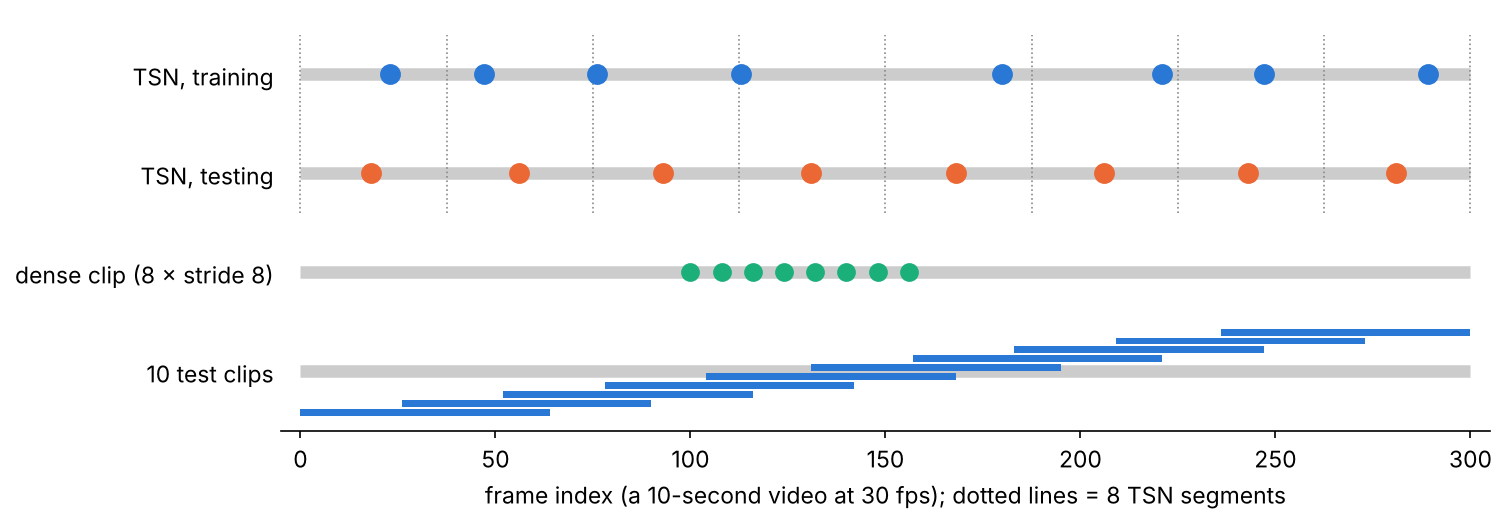
Temporal Segment Networks(TSN) [13] 把影片分成 個等長的區段,從每段取一小段短片段(訓練時取隨機位置),用同一個網路替每個片段打分,再用區段共識(segmental consensus)合併分數,例如在 softmax 之前取平均。損失是對共識計算的,所以是整支影片在監督網路,而不只是一個短視窗 [13]。論文的預設是 個區段 [13]。這種稀疏取樣用固定且少量的影格涵蓋長距離結構(圖 5)。
程式碼 · Python · 22 行
import numpy as np

def tsn_indices(n_frames, K, train, rng=None):
    """TSN-style sparse sampling: split the video into K equal segments, take one frame
    per segment (random position when training, the segment centre when testing)."""
    edges = np.linspace(0, n_frames, K + 1)
    if train:
        return np.floor(edges[:-1] + rng.random(K) * np.diff(edges)).astype(int)
    return np.floor((edges[:-1] + edges[1:]) / 2).astype(int)

def dense_clip(n_frames, length, stride, start):
    """A dense clip: `length` frames, `stride` apart, starting at `start`."""
    return start + stride * np.arange(length)

rng = np.random.default_rng(0)
n = 300                                          # a 10-second video at 30 fps
print("TSN train:", tsn_indices(n, 8, True, rng))
print("TSN test :", tsn_indices(n, 8, False))
print("dense 8x8:", dense_clip(n, 8, 8, start=100))   # 8 frames, every 8th frame
# multi-view testing: 10 clip start positions spread uniformly over the video
starts = np.linspace(0, n - 8 * 8, 10).astype(int)
print("10 clip starts:", starts)
輸出
TSN train: [ 23  47  76 113 180 221 247 289]
TSN test : [ 18  56  93 131 168 206 243 281]
dense 8x8: [100 108 116 124 132 140 148 156]
10 clip starts: [  0  26  52  78 104 131 157 183 209 236]
八張稀疏影格橫跨整支影片;稠密片段則以細節涵蓋大約 2 秒。(測試時取區段中心,是後來實作中常見的選擇;原始 TSN 論文是用 25 張影格、各做 10 個裁切來測試 [13]。)稠密片段是 3D 網路與 SlowFast 所吃的輸入;最後一行,分散在整支影片的十個片段,就是下面評估一節要討論的多視角測試協定。
時序位移模組(Temporal Shift Module, TSM) [21] 在 2D 網路中加入真正的時間交互作用,而且完全不增加參數,也不增加乘加運算。在每個殘差區塊內,特徵張量的一部分通道沿時間向前位移一張影格,另一部分向後位移一張影格,其餘留在原處;接下來的 2D 卷積就會混合來自三張不同影格的通道。位移太多通道,延遲(資料搬移)與準確率(每張影格剩下的空間資訊變少)都會變差,所以論文位移 1/4 的通道(每個方向 1/8),並把位移放在殘差分支上 [21]。對即時影片,單向版本只從過去位移到現在的影格 [21]。
選讀:時序位移是一種稀疏的時序卷積(見「補充資料」頁)。一段簡短的推導與一段測試過的程式,顯示位移加上 1×1 卷積,等於一個多數權重固定為零的時序卷積。
SlowFast:兩種影格率
白話版。 東西是什麼,變化得很慢;東西怎麼動,可能變化得很快。所以用兩條路徑:一條很重、只看少數影格來理解場景;一條很輕、看很多影格來捕捉運動。
SlowFast 網路 [15] 有一條 Slow 路徑,以較大的時間步幅 取樣 張影格;以及一條 Fast 路徑,以步幅 取樣 張影格,所以在時間上比 Slow 路徑密 倍。Fast 路徑只有 Slow 路徑通道數的 倍。典型的值是 與 [15]。由於一層的成本大致與通道數的平方成正比,在論文的實例中,Fast 路徑只占總運算量的大約 20% [15]。橫向連接(lateral connection)在每個階段把 Fast 的特徵送進 Slow 路徑;為了讓形狀匹配,它們把 張 Fast 影格轉換成 張,例如用時間步幅的 3D 卷積,這是論文的預設做法 [15]。
有兩個設計細節帶有通用的教訓。Slow 路徑只在最後兩個階段使用大於 1 的時間核,因為作者發現,當影格步幅很大時,早期層的時間卷積反而有害:除非空間感受野也很大,否則快速移動的內容在相隔很久的時間步之間幾乎沒有相關性 [15]。而且 SlowFast 不使用光流:它直接從原始影格端到端學習運動 [15]。它在 Kinetics、Charades 與 AVA 的分類與偵測上報告了很強的結果 [15]。
選讀:SlowFast 網路(見「論文導讀」頁)。怎麼讀它對橫向連接與通道比例 β 的消融實驗。
還有兩個相關的想法補完了 CNN 家族。Non-local 區塊 [22] 把每個位置的反應,算成對所有時空位置的加權和,也就是插在 3D CNN 中的一種注意力層,用來捕捉長距離相依。X3D [23] 從一個很小的 2D 影像網路出發,一次沿一個軸(空間、時間、寬度與深度)擴張它,來尋找低成本且準確的網路;一個令人意外的發現是,高時空解析度的網路可以非常窄 [23]。
影片 Transformer:TimeSformer、ViViT、MViT 與 Video Swin
白話版。 把片段切成小小的時空塊,每塊變成一個 token,讓 Transformer 決定哪些塊該看哪些塊。困難在於一段片段有幾千個 token,所以各種設計主要的差別,在於每個 token 可以注意哪些 token。
Vision Transformer [24](ML 05)把影像變成小塊。影片 Transformer 則在時空中做同樣的事。用 tubelet 嵌入(tubelet embedding)[25],把互不重疊、大小為 像素的管狀區塊做線性投影(等價於步幅等於核大小的 3D 卷積),於是 的片段變成
個 token,其中 是 tubelet 的影格長度, 是小塊邊長的像素數。例如 VideoMAE 的 ViT-Base,吃 的片段與 的方塊,得到 個 token [10]。聯合時空注意力要比較全部 對,上面的程式碼算出每層約 246 萬對。有四種設計可以馴服它:
- TimeSformer [26] 比較了幾種自注意力方案,發現它試過的方案中以分離式注意力(divided attention)最好:在每個區塊中,一個 token 先注意其他影格中相同空間位置的 token(時間注意力),再注意自己這張影格中的 token(空間注意力)[26]。在上面的設定中,這大約是 32 萬對,而不是 246 萬對。它也能處理超過一分鐘的片段 [26]。聯合與分離式注意力的成本比,在 DLCV 12A 中推導,那裡也說明了為什麼影片生成器常偏好完整注意力。
- ViViT [25] 提出四種模型:聯合時空注意力;分解式編碼器(對每張影格用一個空間 Transformer,再對影格嵌入用一個時間 Transformer,是一種後期融合);每個區塊內的分解式自注意力;以及分解式點積注意力,其中一半的注意力頭注意空間,一半注意時間。它也顯示了如何正則化這些模型,並用預訓練的影像模型初始化它們,使它們可以在相對小的資料集上訓練 [25]。
- MViT [27] 帶回 CNN 的多尺度階層:各階段從高時空解析度、少量通道開始,逐步增加通道並降低解析度,並使用池化注意力(pooling attention),也就是在注意力內部對查詢、鍵與值序列做池化 [27]。
- Video Swin Transformer [28] 主張局部性:注意力只在局部 3D 視窗內計算,視窗在相鄰層之間位移,讓資訊可以跨過視窗邊界。它延伸了影像的 Swin Transformer [29](DLCV 02),並從預訓練的影像權重開始,在速度與準確率的取捨上優於全域注意力 [28]。
注意力不是建模長片段的唯一方式。VideoMamba [30] 把 Mamba 狀態空間模型 [31](其成本與 token 數成線性成長)調整到影片上;底層的選擇性掃描在 ML 04 說明。
不用標籤學習影片表示
白話版。 標註影片又慢又貴,但沒有標籤的影片非常多。所以把片段的大部分遮起來,訓練網路把它補回來;要補得好,它就必須學會東西長什麼樣子、怎麼移動。
VideoMAE [10] 把遮罩式自編碼(MAE [32],見 ML 06)用到影片上。它遮住時空方塊,只用 ViT 編碼可見的部分,再用輕量解碼器重建被遮住部分的像素。有兩件事是影片特有的。第一,相鄰影格高度冗餘,所以遮罩比例可以極高:90% 到 95% 仍然很有效 [10]。第二,如果每張影格獨立抽遮罩,被遮住的小塊常常可以從相鄰影格的同一位置直接複製過來,這種資訊洩漏(information leakage)讓任務變得太簡單。所以 VideoMAE 使用管狀遮罩(tube masking):每張影格都用同一個空間遮罩 [10]。下面的片段量測這種洩漏。
程式碼 · Python · 16 行
import numpy as np

rng = np.random.default_rng(0)
T, P, ratio = 8, 196, 0.9               # 8 token frames of 14x14 patches, 90% masked

def leak(mask):
    """Fraction of masked tokens whose same-position token in a neighbouring frame is visible."""
    vis = ~mask
    nb = np.zeros_like(mask)
    nb[1:] |= vis[:-1]; nb[:-1] |= vis[1:]
    return (mask & nb).sum() / mask.sum()

random_mask = rng.random((T, P)) < ratio                  # independent per token
tube_mask = np.repeat((rng.random(P) < ratio)[None], T, 0) # same spatial mask in every frame
print(f"random masking: {random_mask.mean():.2f} masked, leak {leak(random_mask):.2f}")
print(f"tube masking  : {tube_mask.mean():.2f} masked, leak {leak(tube_mask):.2f}")
輸出
random masking: 0.90 masked, leak 0.16
tube masking  : 0.89 masked, leak 0.00
使用獨立遮罩時,大約每六個被遮住的 token 中,就有一個在相鄰影格有可見的同位置 token(對中間的影格,期望值為 ;第一張與最後一張影格只有一個鄰居)。管狀遮罩完全消除了這個捷徑,這正是重點:預訓練任務只有在它的捷徑都被堵住時才有用。VideoMAE 也報告,在只有幾千支影片的小資料集上,不需額外資料就能有很強的結果;發現對這類預訓練而言,資料品質比資料數量更重要;並指出預訓練資料與目標資料之間的領域偏移是個重要的議題 [10]。VideoMAE V2 [33] 以雙重遮罩(dual masking)把這個方法擴展到十億參數的 ViT,雙重遮罩也會遮住解碼器的輸入,以節省運算。
第二條路線預測的是特徵而不是像素。V-JEPA [34] 只用特徵預測的目標來訓練影片模型,不用預訓練的影像編碼器、文字、負樣本或重建,使用大約 200 萬支影片,並用凍結的骨幹在以運動為主與以外觀為主的任務上評估它們 [34]。它的後繼者 V-JEPA 2 [35] 與 JEPA 的想法,在 ML 06 與 DLCV 13 中討論。
影片與語言(簡介)
白話版。 不使用固定的動作名稱清單,而是用自由文字描述影片。把影片和句子放在同一個空間中的模型,可以用描述來搜尋影片;把影片 token 送進語言模型的模型,可以回答關於影片的問題。
檢索。 CLIP 式的影像–文字模型 [36](ML 10)可以遷移到影片:CLIP4Clip [37] 把 CLIP 端到端地遷移到文字–影片檢索,並研究影像特徵是否足夠、在影片–文字資料上做後預訓練(post-pretraining)有什麼幫助,以及如何建模影格之間的相依關係,使用的基準如 MSR-VTT,這是一個包含 1 萬段網路影片片段與 20 萬組片段–句子配對的集合 [38]。影片基礎模型如 InternVideo2 [39],在一個漸進式的訓練方案中結合了遮罩式影片建模、影片–文字對比學習與下一個 token 預測,影片編碼器最大達 60 億個參數 [39]。
問答。 多模態大型語言模型(ML 10)接受取樣出來的影格作為視覺 token。長影片會讓它們吃力:Video-MME [40] 在 900 支人工標註、長度從 11 秒到 1 小時的影片(2,700 組問答配對)上評估它們,字幕與音訊是可選的輸入,並發現處理更長的序列仍是弱點 [40]。一個實務上的提醒,類比場景偏差:在把時間理解的功勞歸給模型之前,先檢查問題是否光靠單張影格、或光靠問題文字就能回答;單影格基準是很便宜的健全性檢查。
在時間與空間中定位動作
白話版。 真實的影片沒有被裁剪過。一支料理影片包含「切」、「攪拌」與「倒」,中間夾著很長的無聊片段。時序定位找出每個動作從哪裡開始、到哪裡結束;時空偵測還會說是哪個人在做。
時序動作定位
這個任務沿著時間軸呼應物件偵測(DLCV 03),方法也是如此。片段層級的骨幹(常常是凍結的,例如 I3D 或 SlowFast 特徵)沿時間產生一個特徵序列;定位頭再把它轉成帶分數的區段。
- 以提案為基礎(兩階段)。 先產生不分類別的候選區段,再對它們分類。BMN [41] 把一個提案表示成一對開始與結束邊界,並在一張邊界匹配信心圖(boundary-matching confidence map)中一次為所有稠密分布的配對打分;結合動作分類器後就得到偵測結果 [41]。
- 無錨框、單階段。 ActionFormer [42] 對時間上的每個時刻分類,並迴歸到動作開始與結束的距離,不需要提案,也不需要預先定義的錨框視窗。它使用具有局部自注意力的多尺度 Transformer 與一個輕量解碼器 [42],是 DLCV 03 無錨框偵測器在時間上的對應。重複的區段用時間上的非極大值抑制移除,與框的做法相同(ActionFormer 用的是軟式變體 [42])。
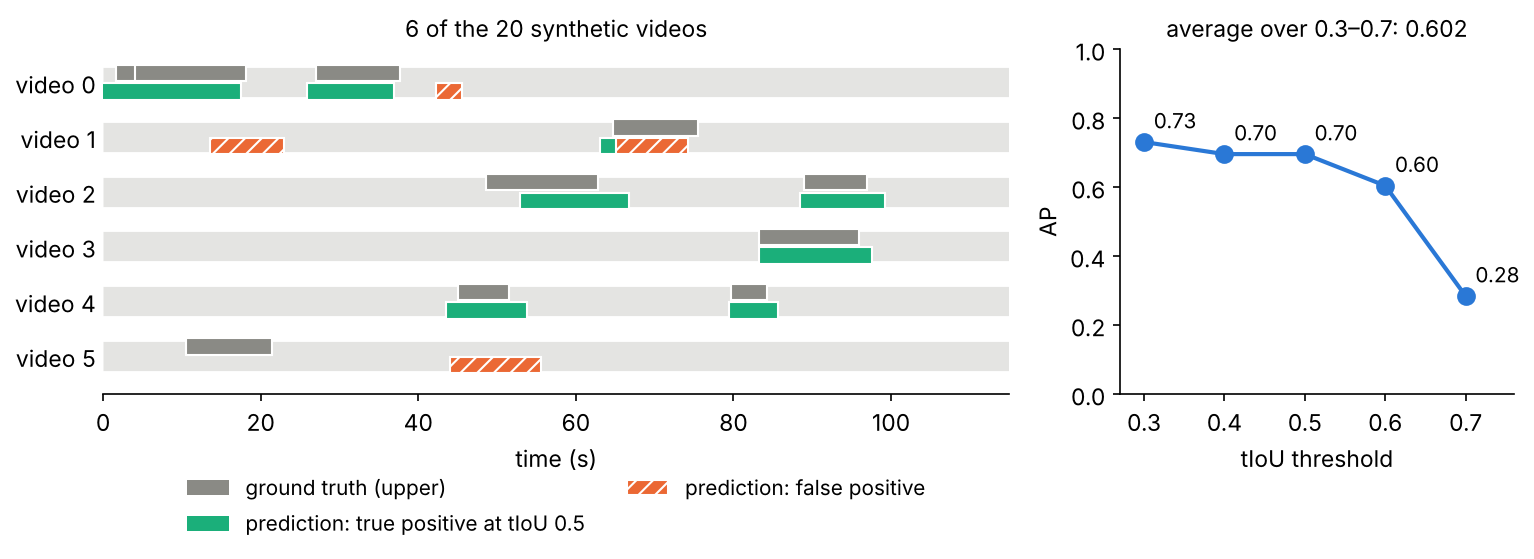
時序 IoU 與 mAP。 對預測區段 與真實區段 ,
其中分子是重疊的長度,分母是聯集的長度。對某一類別與門檻 ,把預測依分數排序;若某個預測與該類別尚未被配對的真實區段的 tIoU 至少為 ,它就是真陽性。平均精確率(average precision, AP)是所得精確率–召回率曲線下的面積,mAP 是對各類別的 AP 取平均,而平均 mAP 則再對多個門檻取平均。常見的有兩種慣例:THUMOS14 對 tIoU 取平均,ActivityNet 1.3 則對 取平均 [42]。程式碼在合成的偵測結果上計算單一類別的 AP(找到 85% 的動作,帶有邊界誤差,再加上隨機的誤報)。
程式碼 · Python · 46 行
import numpy as np

def tiou(seg, segs):
    """Temporal IoU of one segment [s, e] with an array of segments (n, 2)."""
    inter = np.clip(np.minimum(seg[1], segs[:, 1]) - np.maximum(seg[0], segs[:, 0]), 0, None)
    union = (seg[1] - seg[0]) + (segs[:, 1] - segs[:, 0]) - inter
    return inter / union

def average_precision(preds, gts, thr):
    """preds: list of (video, start, end, score); gts: dict video -> (m, 2) array.
    Greedy matching in score order; each ground truth can be matched once."""
    n_gt = sum(len(g) for g in gts.values())
    used = {v: np.zeros(len(g), bool) for v, g in gts.items()}
    tp = []
    for v, s, e, _ in sorted(preds, key=lambda p: -p[3]):
        ious = tiou(np.array([s, e]), gts[v])
        ious[used[v]] = -1                       # already matched ground truths are off limits
        j = int(np.argmax(ious))
        hit = ious[j] >= thr
        if hit:
            used[v][j] = True
        tp.append(hit)
    tp = np.array(tp, float)
    recall = np.cumsum(tp) / n_gt
    precision = np.cumsum(tp) / np.arange(1, len(tp) + 1)
    precision = np.maximum.accumulate(precision[::-1])[::-1]   # monotone envelope
    return np.sum(np.diff(np.r_[0, recall]) * precision)

rng = np.random.default_rng(0)
gts, preds = {}, []
for v in range(20):                              # 20 untrimmed videos, 1-3 actions each
    starts = np.sort(rng.uniform(0, 100, rng.integers(1, 4)))
    g = np.c_[starts, starts + rng.uniform(4, 15, len(starts))]
    gts[v] = g
    for s, e in g:
        if rng.random() < 0.85:                  # the detector finds 85% of actions...
            j = rng.normal(0, 0.2 * (e - s), 2)  # ...with boundary errors
            preds.append((v, s + j[0], e + j[1], rng.uniform(0.5, 1.0)))
    for _ in range(rng.integers(0, 3)):          # plus some false alarms
        s = rng.uniform(0, 100)
        preds.append((v, s, s + rng.uniform(3, 12), rng.uniform(0.0, 0.7)))

thrs = [0.3, 0.4, 0.5, 0.6, 0.7]
aps = [average_precision(preds, gts, t) for t in thrs]
print("AP at tIoU:", "  ".join(f"{t}: {a:.3f}" for t, a in zip(thrs, aps)))
print(f"average over [0.3:0.1:0.7]: {np.mean(aps):.3f}")
輸出
AP at tIoU: 0.3: 0.731  0.4: 0.696  0.5: 0.696  0.6: 0.604  0.7: 0.284
average over [0.3:0.1:0.7]: 0.602
(玩具數字。)到 tIoU 0.5 為止,AP 主要受 15% 漏掉的動作與誤報所限制;到 0.7 時它崩落,因為約為動作長度 20% 的邊界誤差已經不夠好。動作的邊界本來就模稜兩可(「倒」是從什麼時候開始的?),這就是為什麼嚴格的門檻即使對人來說也很難,也是為什麼基準會報告多個門檻。
選讀:時序定位的平均精確率,一步一步來(見「補充資料」頁)。手算一個例子,說明配對規則、重複預測與精確率包絡線。
時空動作偵測
這裡模型必須說出哪個人做了哪個動作。在 AVA [43] 中,從 15 分鐘電影片段以 1 Hz 取樣出的關鍵影格裡,每個人都有一個框,以及來自 80 個原子動作(14 個姿勢類別、49 個人–物互動與 17 個人–人互動)的一個或多個標籤 [43]。常見的流程是偵測加上影片分類,如 SlowFast 的 AVA 偵測器 [15]:現成的人物偵測器(DLCV 03)在關鍵影格上提出框,影片骨幹為它周圍的一段片段計算時空特徵圖,對每個框內的特徵做池化,再由每個類別各一個 sigmoid 分類器給出多標籤預測,因為一個人可以同時「站著」、「對話」又「拿著東西」。指標是 IoU 0.5 下的影格 mAP(frame-mAP):對所有關鍵影格偵測,逐動作類別計算 AP,偵測只有在它的框與該類別的某個真實框的 IoU 至少為 0.5 時才算數,再對各類別取平均 [43]。把偵測結果在時間上連成管狀序列,則借用追蹤的關聯方法(DLCV 07)。
骨架式動作辨識
模型也可以不讀像素,而是讀姿態:身體關節隨時間變化的 2D 或 3D 座標,可以像 DLCV 05 那樣估計,或用深度感測器擷取,例如含 60 個動作類別的 NTU RGB+D 資料集 [44]。ST-GCN [45] 建立一張圖,節點是每張影格中的關節,空間邊沿著骨頭連接,時間邊則連接連續影格中的同一個關節,並在這張圖上做圖卷積 [45]。骨架很精簡,不受衣著與背景影響,因此較不容易出現場景偏差:在 Mimetics 資料集(沒有一般的物件與場景、只做出模仿動作)上,以姿態為基礎的模型比 3D CNN 表現好得多 [46]。代價是骨架會漏掉物件(「喝」與「吃」),而且依賴姿態估計器的誤差。
選讀:骨架序列上的圖卷積(ST-GCN)(見「補充資料」頁)。正規化的鄰接矩陣、鄰居的劃分,以及這個卷積怎麼實作。
訓練與評估影片分類器
白話版。 你怎麼挑影格、測試時平均多少個視角、報告在哪個資料集上,對數字的影響不亞於許多架構上的改動。比較兩篇論文之前,先讀它們的協定。
取樣與訓練
有三個選擇決定了輸入:影格數 、影格之間的步幅(影格率),以及稠密與稀疏(TSN 式)取樣。以運動為中心的資料集獎勵稠密、細緻的取樣;以場景為中心的資料集可以容忍稀疏取樣。例如 VideoMAE 在 Something-Something V2 上使用 TSN 式均勻取樣,在 Kinetics-400 上使用稠密取樣 [10]。空間資料增強與影像相同(隨機縮放裁切、翻轉),但有一個影片特有的陷阱:水平翻轉會改變標籤,對與方向相關的類別,如「把東西從左推到右」就是如此。其餘訓練則依 DLCV 02。初始化通常來自影像模型(膨脹,或預訓練的 ViT),或來自自監督的影片模型。
多視角測試
測試時,一段片段很少涵蓋整支影片,所以預測會在 個時間片段與 個空間裁切上取平均:
其中 是在第 個空間位置裁切的第 個片段。例如 SlowFast 沿著影片均勻取樣 10 個片段,每個再取 3 個 的裁切,共 30 個視角,並把成本報告為每個視角的 GFLOPs × 視角數,同時指出一些早期工作用了超過 100 個視角 [15]。VideoMAE 在 Something-Something V2 上用 2 個片段 × 3 個裁切評估,在 Kinetics-400 上用 5 × 3 [10]。總推論成本是每個視角的成本乘以視角數,所以每個視角看起來便宜的模型,實務上可能很貴。兩者都要報告,而且只在相同協定下比較模型。
資料集與基準
| 資料集 | 任務 | 內容(依其作者的描述) |
|---|---|---|
| UCF101 [47] | 片段分類 | 101 個動作類別,超過 1.3 萬段片段,27 小時使用者上傳的影片 |
| HMDB51 [48] | 片段分類 | 來自電影與網路影片的 51 個動作類別;規模小且刻意設計得很難 |
| Kinetics-400 [17] | 片段分類 | 400 個人類動作類別,每類至少 400 段片段,每段約 10 秒,來自 YouTube |
| Something-Something V2 [9], [10] | 片段分類 | 174 個以運動為中心、定義為描述樣板的類別;約 16.9 萬支訓練與 2 萬支驗證影片 |
| Diving48 [7] | 片段分類 | 超過 18,000 段片段,48 種細緻的跳水類別,為降低靜態偏差而建立 |
| Charades [49] | 多標籤分類、定位 | 267 人錄製的 9,848 支日常室內活動影片,157 個動作類別 |
| THUMOS14 [50] | 時序定位 | 未裁剪的影片,包含沒有目標動作的背景影片 |
| ActivityNet [51] | 未裁剪分類、定位 | 針對未裁剪網路影片中人類活動的大規模基準 |
| AVA [43] | 時空偵測 | 430 段 15 分鐘電影片段中的 80 個原子動作,158 萬個動作標籤 |
| EPIC-KITCHENS-100 [52], [53] | 第一人稱辨識、偵測、預期 | 45 個環境中 100 小時未編排的頭戴式影片,9 萬個動作 |
| NTU RGB+D [44] | 骨架/RGB-D 辨識 | 超過 5.6 萬個樣本,60 個動作類別,40 位受試者 |
| MSR-VTT [38] | 檢索、描述生成 | 1 萬段網路片段,20 萬組片段–句子配對 |
| Video-MME [40] | 多模態 LLM 的影片問答 | 900 支 11 秒到 1 小時的影片,2,700 組問答配對 |
UCF101 與 HMDB51 報告在三個官方訓練/測試切分上的平均準確率 [12], [13];Kinetics 與 Something-Something 報告其驗證集上的 top-1 與 top-5;Charades 與 AVA 報告 mAP。有兩個提醒。第一,Kinetics 與 Something-Something 獎勵的東西不同:VideoMAE 的作者形容 Kinetics 的影片大多靜止且與場景有關,而 Something-Something V2 則以運動為中心 [10]。模型的排名可能在兩者之間改變。第二,EPIC-KITCHENS-100 的作者設計了一個「時間考驗」(test of time):拿在 2018 年蒐集的影片訓練的模型,去測兩年後新蒐集的影片,並設有一個非監督式領域適應挑戰賽 [53]。像這樣的基準,量測的是單一保留切分量測不到的穩健性。
失效模式
白話版。 影片模型會以幾種可預測的方式失敗。大多數都是因為模型用了一個剛好在訓練資料上有效的線索。
- 場景與物件偏差。 模型從網球場預測「打網球」。證據:常見資料集偏向靜態線索的表徵偏差 [7];模型在沒有一般物件與場景的模仿動作上失敗 [46]。補救方式包括去偏差損失,例如對抗式場景分類器,以及懲罰在人物被遮掉的影片上仍做出高信心預測的損失 [54]、以運動為中心的訓練資料 [9],以及姿態輸入 [46]。
- 時序捷徑。 模型忽略影格順序。測試:打亂或反轉影格。如果準確率幾乎沒變,模型(或基準)就沒有用到時間;Sevilla-Lara 等人就是這樣建立他們的時序類別子集 [8]。
- 時間脈絡太短。 大多數片段模型一次只看幾秒。以分鐘計的動作(「組裝家具」)或關於整部電影的問題,需要長距離記憶,即使對大型多模態模型,這仍是弱點 [40]。
- 領域偏移。 第三人稱的 YouTube 影片、第一人稱的廚房、夜間監視器與醫療內視鏡看起來截然不同。在其中一種上訓練的模型,遷移到另一種時並不完美;EPIC-KITCHENS-100 用沒看過的廚房與較晚錄製的影片量測這件事 [52], [53]。DLCV 02 的分佈偏移測試也適用。
- 含糊的標籤與邊界。 動作會重疊、開始與結束模糊,而且取決於意圖。多標籤資料集(Charades、AVA)與多個 tIoU 門檻承認了這一點;單標籤準確率則把它藏起來。
- 不公平的比較。 視角數、影格數、解析度與預訓練資料各不相同,讓報告的數字無法比較 [1]。務必檢查結果表中的協定那一行。
兩個便宜的診斷就能抓出大部分問題:單影格基準(有多少分數根本不需要時間?)與打亂影格測試(順序對模型有影響嗎?)。在信任影片模型之前,先把兩個都跑過。
現代觀點
綜述論文
五篇綜述從不同角度涵蓋這個領域。Zhu 等人 [1] 回顧了超過 200 篇深度動作辨識的論文,介紹 17 個資料集,依時間順序呈現模型(早期嘗試、雙流網路、3D 卷積、高效率運算模型),在同一套協定下以公開的程式碼對常用方法做基準測試,並指出這個領域的主要挑戰:長距離時序建模、運算成本,以及因資料集與協定不同而無法比較的結果。Kong 與 Fu [2] 同時涵蓋辨識(為完整的動作貼標籤)與預測(從動作的前段預期動作),包含資料集與評估協定。Selva 等人 [3] 依輸入如何 token 化、如何減少冗餘並重新引入歸納偏差、如何捕捉長期動態,以及如何訓練,來整理影片 Transformer,並發現它們在動作分類上即使運算成本較低,也勝過 3D CNN。Madan 等人 [4] 把超過 200 個影片基礎模型分成三組來分析(改造成影片用途的影像模型、以影片為基礎的模型,以及跨模態的通用模型),並報告在大多數影片理解任務上,影像模型勝過以影片為基礎的模型,而通用的多模態模型表現最好。Tang 等人 [5] 依影片如何送到語言模型(影片分析器、影片嵌入器,或兩者皆有),以及語言模型的角色(摘要器、管理者、文字解碼器、迴歸器或隱藏層),來分類以大型語言模型做影片理解的方法。
選讀:「現代觀點」綜述導讀(見「論文導讀」頁)。每篇綜述的組織方式,以及該先讀哪裡。
2023–2026 年的最新進展
- 自監督預訓練是常見的起點。 遮罩式影片建模(VideoMAE [10]、VideoMAE V2 [33])與特徵預測(V-JEPA [34])產生的編碼器,可以為下游任務微調或探測;VideoMAE V2 的作者稱規模是這類基礎模型的首要因素 [33]。
- 影片基礎模型統一了各種任務。 如 InternVideo2 [39] 的模型,用遮罩式建模、影片–文字對比與下一個 token 預測訓練同一個編碼器,並在辨識、檢索與對話上評估。Madan 等人發現改造後的影像模型依然非常有競爭力 [4],這提醒我們,影片理解的很大一部分仍然是外觀。
- 多模態 LLM 接手開放式理解。 影片問答、描述生成與時序定位(grounding),越來越多由帶有視覺 token 的語言模型處理,並在 Video-MME [40] 等基準上評估。瓶頸在於長影片的視覺 token 數量。
- 高效率的長距離模型。 成本呈線性的序列模型如 VideoMamba [30],以及串流式設計(精神上類似線上 TSM [21]),針對的是長影片與即時影片。
- 定位建立在預訓練編碼器之上。 時序定位器執行在預訓練影片模型的特徵上;例如 ActionFormer 在 THUMOS14 上使用在 Kinetics 上預訓練的雙流 I3D 特徵 [42],所以更好的編碼器與更好的定位頭會一起提升結果。
尚未解決的問題
- 真正的時序推理。 光靠單張影格或語言先驗不夠的基準,以及會使用順序、因果與持續時間的模型。
- 長影片。 數小時影片的記憶體與 token 預算,以及對長距離理解的評估。
- 細粒度與第一人稱動作。 手、小物件與意圖;跨視角與環境的遷移。
- 高效率與線上辨識。 在裝置上的低延遲,並誠實報告成本(FLOPs × 視角數、真實延遲)。
- 評估。 可比較的協定、網路規模預訓練資料對基準的汙染,以及獎勵時間理解而不是外觀的指標。
重點整理
- 依輸出選擇指標:片段標籤、動作區間、人員方框或檢索結果。
- 高分可能反映場景線索,而非運動理解。
- 光流、時間卷積與注意力以不同方式納入時間,應檢查各自能讀取哪些資訊。
- 取樣與多速率分支在時間涵蓋範圍及計算量之間取捨。
- 預訓練若要學到有用結構,遮罩須避免容易的時間資訊洩漏。
- 比較時固定測試視圖與預訓練,再測試單影格基準與打亂影格輸入。
練習
- 組合模型作弊到什麼程度? 在場景偏差的程式碼中,把特徵標準化(在 pipeline 中使用
sklearn.preprocessing.StandardScaler),並讓C在 0.01、0.1 與 1 之間變化。影格加運動模型的「no cue」與「shift」準確率如何變化?為什麼標準化能幫助它使用運動特徵?
提示
運動特徵的數值範圍,比 400 個像素特徵小,所以在 L2 懲罰下,模型覺得把權重分散到許多像素上比較划算。在我們的執行中,標準化後影格加運動模型的「no cue」/「shift」準確率,在 C = 0.01 時為 0.752/0.547,在 C = 0.1 時為 0.824/0.685,在 C = 1 時為 0.842/0.708,仍遠低於只用運動的模型。縮放降低了捷徑,但只要場景在訓練中仍然有預測力,捷徑就不會消失。
- 手算膨脹。 一個 2D 濾波器 (水平導數)被膨脹到 張影格。寫出 ,並計算它在某一位置的反應,分別對 (a) 每張影格都是同一列 的無聊影片,以及 (b) 三張影格的列分別為 、 與 的影片。兩者的差異告訴你訓練必須改變什麼?
提示
有三個時間切片,每個都是 。(a) 每個切片給出 ,總和為 ,與 2D 的反應相同。(b) 三個切片給出 、 與 ,總和為 。膨脹後的濾波器是對影格取平均,所以它只能透過模糊來反映運動;要變成運動偵測器,訓練必須讓各時間切片不同(例如第一個與最後一個的正負號相反)。
- 寬度不相等的 (2+1)D。 對輸入 、輸出 個通道、、 的層,計算 、3D 的參數量與 (2+1)D 的參數量。接著選 ,計算節省了多少。
提示
。3D:。 的 (2+1)D:(因為向下取整,所以略少)。 時:,約為 3D 層的 28%。
- 視角與成本。 模型 A 每個視角成本 36 GFLOPs,用 10 × 3 個視角測試;模型 B 每個視角成本 180 GFLOPs,用 1 × 3 個視角測試。每支影片哪個比較貴?設計一個公平的比較。
提示
A: GFLOPs;B: GFLOPs,所以雖然 A 每個視角便宜五倍,但每支影片的成本卻是兩倍。公平的比較,是在相同的影格與解析度下,對每個模型的數種視角數,畫出準確率對總推論成本的曲線。
- 打亂影格測試。 擴充場景偏差的程式碼:把每個測試片段的影格順序打亂,每個片段用新的排列(
rng = np.random.default_rng(5),然後np.stack([x[rng.permutation(8)] for x in X])),再重新評估三個用有序片段訓練的模型。執行前先預測結果。
提示
單影格模型仍然只讀場景,所以幾乎沒變(在我們的執行中,三個測試集上為 0.868 / 0.499 / 0.127)。運動模型每對影格的估計現在有隨機的正負號,掉到隨機猜測的水準(0.522 / 0.500 / 0.466)。影格加運動模型沒有動(0.864 / 0.497 / 0.133),這暴露了它從來沒有依賴順序。一個在打亂後準確率依然不變的模型,並沒有使用時間。
- 手算 tIoU。 一個真實動作從 10 秒持續到 20 秒。預測:P1 [12, 22],分數 0.9;P2 [9, 19],分數 0.8;P3 [30, 35],分數 0.7。計算各自的 tIoU,在 與 下標出 TP/FP,並計算兩個門檻下的 AP。
提示
P1:重疊 8,聯集 12,tIoU 0.667。P2:重疊 9,聯集 11,tIoU 0.818。P3:0。在 0.5 下:P1 是 TP(分數順序中第一個),P2 是重複預測(FP),P3 是 FP;在召回率 1 時精確率為 1,所以 AP = 1。在 0.75 下:P1 是 FP,P2 是 TP(召回率 1 時精確率為 1/2),P3 是 FP;AP = 0.5。在嚴格的門檻下,分數較高的較差框可能讓 AP 損失一半。
參考文獻
- Y. Zhu, X. Li, C. Liu, M. Zolfaghari, Y. Xiong, C. Wu, Z. Zhang, J. Tighe et al., “A comprehensive study of deep video action recognition,” technical report, arXiv:2012.06567, 2020. arXiv
- Y. Kong and Y. Fu, “Human action recognition and prediction: A survey,” International Journal of Computer Vision, vol. 130, no. 5, pp. 1366–1401, 2022. doi
- J. Selva, A. S. Johansen, S. Escalera, K. Nasrollahi, T. B. Moeslund and A. Clapés, “Video transformers: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, no. 11, pp. 12922–12943, 2023. doi
- N. Madan, A. Moegelmose, R. Modi, Y. S. Rawat and T. B. Moeslund, “Foundation models for video understanding: A survey,” arXiv:2405.03770, 2024. arXiv
- Y. Tang, J. Bi, S. Xu, L. Song, S. Liang, T. Wang, D. Zhang, J. An et al., “Video understanding with large language models: A survey,” arXiv:2312.17432, 2023 (accepted to IEEE Transactions on Circuits and Systems for Video Technology according to the arXiv record). arXiv
- A. Karpathy, G. Toderici, S. Shetty, T. Leung, R. Sukthankar and L. Fei-Fei, “Large-scale video classification with convolutional neural networks,” in Proc. IEEE CVPR, pp. 1725–1732, 2014. CVF
- Y. Li, Y. Li and N. Vasconcelos, “RESOUND: Towards action recognition without representation bias,” in Proc. ECCV, 2018. CVF
- L. Sevilla-Lara, S. Zha, Z. Yan, V. Goswami, M. Feiszli and L. Torresani, “Only time can tell: Discovering temporal data for temporal modeling,” in Proc. IEEE WACV, 2021. doi
- R. Goyal, S. Ebrahimi Kahou, V. Michalski, J. Materzyńska, S. Westphal, H. Kim, V. Haenel, I. Fruend et al., “The ‘something something’ video database for learning and evaluating visual common sense,” in Proc. IEEE ICCV, 2017. CVF
- Z. Tong, Y. Song, J. Wang and L. Wang, “VideoMAE: Masked autoencoders are data-efficient learners for self-supervised video pre-training,” in Advances in Neural Information Processing Systems (NeurIPS), 2022. NeurIPS · arXiv
- S. Hochreiter and J. Schmidhuber, “Long short-term memory,” Neural Computation, vol. 9, no. 8, pp. 1735–1780, 1997. doi
- K. Simonyan and A. Zisserman, “Two-stream convolutional networks for action recognition in videos,” in Advances in Neural Information Processing Systems (NeurIPS), 2014. NeurIPS · arXiv
- L. Wang, Y. Xiong, Z. Wang, Y. Qiao, D. Lin, X. Tang and L. Van Gool, “Temporal segment networks: Towards good practices for deep action recognition,” in Proc. ECCV, pp. 20–36, 2016. doi · arXiv
- J. Carreira and A. Zisserman, “Quo vadis, action recognition? A new model and the Kinetics dataset,” in Proc. IEEE CVPR, 2017. CVF · arXiv
- C. Feichtenhofer, H. Fan, J. Malik and K. He, “SlowFast networks for video recognition,” in Proc. IEEE/CVF ICCV, 2019. CVF · arXiv
- D. Tran, L. Bourdev, R. Fergus, L. Torresani and M. Paluri, “Learning spatiotemporal features with 3D convolutional networks,” in Proc. IEEE ICCV, pp. 4489–4497, 2015. CVF
- W. Kay, J. Carreira, K. Simonyan, B. Zhang, C. Hillier, S. Vijayanarasimhan, F. Viola, T. Green et al., “The Kinetics human action video dataset,” arXiv:1705.06950, 2017. arXiv
- J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li and L. Fei-Fei, “ImageNet: A large-scale hierarchical image database,” in Proc. IEEE CVPR, 2009. doi
- T. Unterthiner, S. van Steenkiste, K. Kurach, R. Marinier, M. Michalski and S. Gelly, “Towards accurate generative models of video: A new metric & challenges,” arXiv:1812.01717, 2018. arXiv
- D. Tran, H. Wang, L. Torresani, J. Ray, Y. LeCun and M. Paluri, “A closer look at spatiotemporal convolutions for action recognition,” in Proc. IEEE/CVF CVPR, 2018. CVF · arXiv
- J. Lin, C. Gan and S. Han, “TSM: Temporal shift module for efficient video understanding,” in Proc. IEEE/CVF ICCV, 2019. CVF · arXiv
- X. Wang, R. Girshick, A. Gupta and K. He, “Non-local neural networks,” in Proc. IEEE/CVF CVPR, 2018. CVF
- C. Feichtenhofer, “X3D: Expanding architectures for efficient video recognition,” in Proc. IEEE/CVF CVPR, 2020. CVF
- A. Dosovitskiy, L. Beyer, A. Kolesnikov, D. Weissenborn, X. Zhai, T. Unterthiner, M. Dehghani, M. Minderer et al., “An image is worth 16x16 words: Transformers for image recognition at scale,” in Proc. ICLR, 2021. arXiv
- A. Arnab, M. Dehghani, G. Heigold, C. Sun, M. Lučić and C. Schmid, “ViViT: A video vision transformer,” in Proc. IEEE/CVF ICCV, 2021. CVF · arXiv
- G. Bertasius, H. Wang and L. Torresani, “Is space-time attention all you need for video understanding?,” in Proc. ICML, PMLR 139, 2021. PMLR · arXiv
- H. Fan, B. Xiong, K. Mangalam, Y. Li, Z. Yan, J. Malik and C. Feichtenhofer, “Multiscale vision transformers,” in Proc. IEEE/CVF ICCV, 2021. CVF · arXiv
- Z. Liu, J. Ning, Y. Cao, Y. Wei, Z. Zhang, S. Lin and H. Hu, “Video Swin Transformer,” in Proc. IEEE/CVF CVPR, 2022. CVF · arXiv
- Z. Liu, Y. Lin, Y. Cao, H. Hu, Y. Wei, Z. Zhang, S. Lin and B. Guo, “Swin Transformer: Hierarchical vision transformer using shifted windows,” in Proc. IEEE/CVF ICCV, 2021. doi
- K. Li, X. Li, Y. Wang, Y. He, Y. Wang, L. Wang and Y. Qiao, “VideoMamba: State space model for efficient video understanding,” in Proc. ECCV, pp. 237–255, 2024. doi · arXiv
- A. Gu and T. Dao, “Mamba: Linear-time sequence modeling with selective state spaces,” in Proc. Conference on Language Modeling (COLM), 2024. arXiv
- K. He, X. Chen, S. Xie, Y. Li, P. Dollár and R. Girshick, “Masked autoencoders are scalable vision learners,” in Proc. IEEE/CVF CVPR, 2022. doi
- L. Wang, B. Huang, Z. Zhao, Z. Tong, Y. He, Y. Wang, Y. Wang and Y. Qiao, “VideoMAE V2: Scaling video masked autoencoders with dual masking,” in Proc. IEEE/CVF CVPR, 2023. CVF · arXiv
- A. Bardes, Q. Garrido, J. Ponce, X. Chen, M. Rabbat, Y. LeCun, M. Assran and N. Ballas, “Revisiting feature prediction for learning visual representations from video,” Transactions on Machine Learning Research (TMLR), 2024. OpenReview · arXiv
- M. Assran, A. Bardes, D. Fan, Q. Garrido, R. Howes et al., “V-JEPA 2: Self-supervised video models enable understanding, prediction and planning,” arXiv:2506.09985, 2025. arXiv
- A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, S. Agarwal et al., “Learning transferable visual models from natural language supervision,” in Proc. ICML, PMLR 139, 2021. PMLR
- H. Luo, L. Ji, M. Zhong, Y. Chen, W. Lei, N. Duan and T. Li, “CLIP4Clip: An empirical study of CLIP for end to end video clip retrieval and captioning,” Neurocomputing, vol. 508, pp. 293–304, 2022. doi · arXiv
- J. Xu, T. Mei, T. Yao and Y. Rui, “MSR-VTT: A large video description dataset for bridging video and language,” in Proc. IEEE CVPR, 2016. CVF
- Y. Wang, K. Li, X. Li, J. Yu, Y. He, G. Chen, B. Pei, R. Zheng et al., “InternVideo2: Scaling foundation models for multimodal video understanding,” in Proc. ECCV, pp. 396–416, 2024. doi · arXiv
- C. Fu, Y. Dai, Y. Luo, L. Li, S. Ren, R. Zhang, Z. Wang, C. Zhou et al., “Video-MME: The first-ever comprehensive evaluation benchmark of multi-modal LLMs in video analysis,” in Proc. IEEE/CVF CVPR, 2025. CVF · arXiv
- T. Lin, X. Liu, X. Li, E. Ding and S. Wen, “BMN: Boundary-matching network for temporal action proposal generation,” in Proc. IEEE/CVF ICCV, 2019. CVF
- C.-L. Zhang, J. Wu and Y. Li, “ActionFormer: Localizing moments of actions with transformers,” in Proc. ECCV, pp. 492–510, 2022. doi · arXiv
- C. Gu, C. Sun, D. A. Ross, C. Vondrick, C. Pantofaru, Y. Li, S. Vijayanarasimhan, G. Toderici et al., “AVA: A video dataset of spatio-temporally localized atomic visual actions,” in Proc. IEEE/CVF CVPR, 2018. CVF · arXiv
- A. Shahroudy, J. Liu, T.-T. Ng and G. Wang, “NTU RGB+D: A large scale dataset for 3D human activity analysis,” in Proc. IEEE CVPR, 2016. doi · arXiv
- S. Yan, Y. Xiong and D. Lin, “Spatial temporal graph convolutional networks for skeleton-based action recognition,” in Proc. AAAI, vol. 32, no. 1, 2018. doi · arXiv
- P. Weinzaepfel and G. Rogez, “Mimetics: Towards understanding human actions out of context,” International Journal of Computer Vision, vol. 129, no. 5, pp. 1675–1690, 2021. doi · arXiv
- K. Soomro, A. R. Zamir and M. Shah, “UCF101: A dataset of 101 human actions classes from videos in the wild,” technical report CRCV-TR-12-01, arXiv:1212.0402, 2012. arXiv
- H. Kuehne, H. Jhuang, E. Garrote, T. Poggio and T. Serre, “HMDB: A large video database for human motion recognition,” in Proc. IEEE ICCV, pp. 2556–2563, 2011. doi
- G. A. Sigurdsson, G. Varol, X. Wang, A. Farhadi, I. Laptev and A. Gupta, “Hollywood in homes: Crowdsourcing data collection for activity understanding,” in Proc. ECCV, pp. 510–526, 2016. doi · arXiv
- H. Idrees, A. R. Zamir, Y.-G. Jiang, A. Gorban, I. Laptev, R. Sukthankar and M. Shah, “The THUMOS challenge on action recognition for videos ‘in the wild’,” Computer Vision and Image Understanding, vol. 155, pp. 1–23, 2017. doi
- F. Caba Heilbron, V. Escorcia, B. Ghanem and J. C. Niebles, “ActivityNet: A large-scale video benchmark for human activity understanding,” in Proc. IEEE CVPR, pp. 961–970, 2015. CVF
- D. Damen, H. Doughty, G. M. Farinella, S. Fidler, A. Furnari, E. Kazakos, D. Moltisanti, J. Munro et al., “Scaling egocentric vision: The EPIC-KITCHENS dataset,” in Proc. ECCV, 2018. CVF
- D. Damen, H. Doughty, G. M. Farinella, A. Furnari, E. Kazakos, J. Ma, D. Moltisanti, J. Munro et al., “Rescaling egocentric vision: Collection, pipeline and challenges for EPIC-KITCHENS-100,” International Journal of Computer Vision, vol. 130, no. 1, 2022. doi · arXiv
- J. Choi, C. Gao, J. C. E. Messou and J.-B. Huang, “Why can’t I dance in the mall? Learning to mitigate scene bias in action recognition,” in Advances in Neural Information Processing Systems (NeurIPS), 2019. NeurIPS · arXiv
- C. Szegedy, W. Liu, Y. Jia, P. Sermanet, S. Reed, D. Anguelov, D. Erhan, V. Vanhoucke and A. Rabinovich, “Going deeper with convolutions,” in Proc. IEEE CVPR, 2015. doi
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 09・深度影像復原:低階視覺 · 53 分鐘