ML 04・循環與遞迴神經網路
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 展開循環更新,追蹤共用參數。
- 說明時間反向傳播與長距離梯度困難。
- 比較 LSTM 與 GRU 的記憶路徑及閘門。
- 區分雙向、序列到序列與樹狀模型。
- 從上下文、串流與記憶體需求評估注意力及狀態空間方法。
先看全貌
ML 03 對影像只用了一個假設:相鄰像素彼此相關,而且同一個圖樣可能出現在任何位置,所以同一個濾波器可以在空間上重複使用。序列也適用同樣的技巧,只是換成在時間上重複使用。影片是一連串影格,圖說是一連串字詞,筆跡是一連串座標。循環神經網路(recurrent neural network, RNN)一次讀入序列中的一個元素,把一份稱為隱藏狀態(hidden state)的摘要從這一步帶到下一步,並在每一步使用相同的權重 [1]。遞迴神經網路(recursive neural network)則把這個想法從鏈推廣到樹:它反覆套用同一條共享的組合規則,把局部拼成整體。
中文文獻常把這兩個英文名詞混用;本篇固定以「循環神經網路」指 recurrent neural network、以「遞迴神經網路」指 recursive neural network,以免混淆。
既然 Transformer 已經主宰大規模的語言與視覺任務,為什麼還要學 RNN?有三個理由。第一,現代序列建模的每一個概念——教師強制、編碼器–解碼器、注意力、遮罩、因果式生成——都是在 RNN 上發展出來的,而把 Transformer 理解成「對 RNN 局限的回答」是最容易的理解方式。第二,循環結構很適合串流處理:每一步只需要固定大小的狀態,適合機器人、感測器和裝置端的影片。第三,循環結構回來了:Mamba 等現代狀態空間模型本質上就是參數化方式很巧妙的循環式,而 ML 05 會把它們應用到影像上。
循環狀態
白話版。 在每一步,把目前的輸入和前一步的狀態結合成新的狀態,每次都使用相同的權重。需要輸出時,就從狀態讀出來。
精確版。 設輸入序列為 ,其中 ;隱藏狀態為 ,起始狀態 固定(通常是零)。簡單(Elman [9])RNN 為
把輸入映射到狀態空間, 是把前一步資訊帶過來的循環權重矩陣, 與 是偏差, 把狀態映射成輸出, 是輸出函數,例如 softmax。關鍵在於這些參數都不依賴 。這就是跨時間的參數共享,相當於 CNN 權重共享在時間上的版本:不論序列有 5 步還是 5,000 步,模型的參數數量都相同,而在第 3 步學到的圖樣也能在第 300 步被辨認出來。
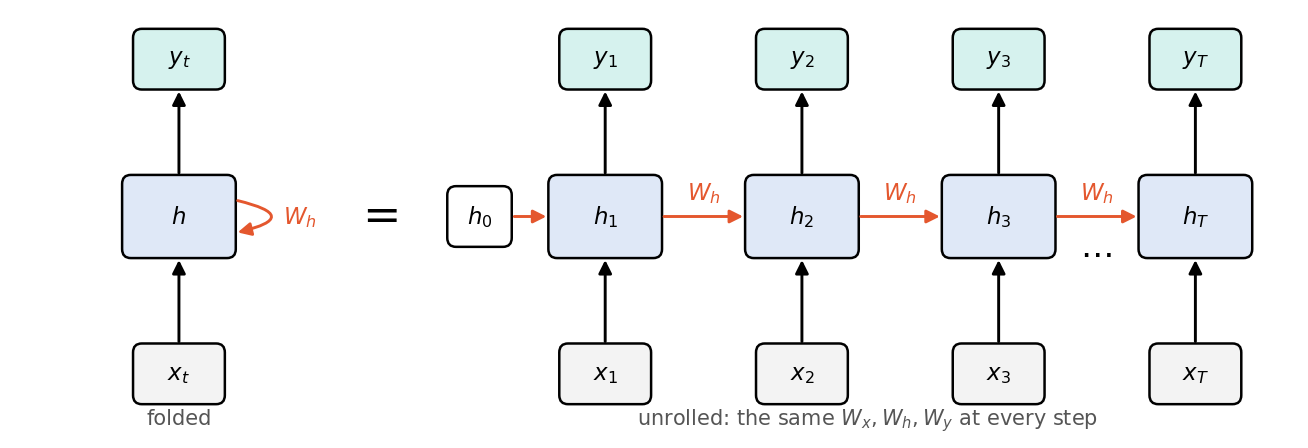
展開(unrolling,圖 1)是最關鍵的思考步驟。把迴圈寫開 步,就得到一個 層深的普通前饋網路,而每一層的權重都相同。你在 ML 02 學到的反向傳播,全部都能套用在這張展開後的計算圖上。
同一個循環式可以支援好幾種輸入–輸出型態:
| 型態 | 例子 | 從哪裡讀取輸出 |
|---|---|---|
| 多對一 | 分類一段影片;判斷一句話的情感 | 最後的狀態 (或池化後的狀態) |
| 多對多、對齊 | 為每張影格貼標籤;為每個字詞標註詞性 | 每一個 |
| 一對多 | 從一個影像向量生成圖說 | 一個把自己的輸出再餵回去的解碼器 |
| 多對多、不對齊 | 翻譯一句話;描述一段影片 | 編碼器–解碼器(稍後介紹) |
由 預測 的 RNN 是一個自迴歸(autoregressive)模型,從中取樣就能生成新的序列;但當作編碼器使用的 RNN 並不會自動變成生成器。決定任務的是輸出頭與損失函數。
程式碼:用 NumPy 寫出 RNN 與它的反向傳播
下面的程式碼手動實作前向傳遞與時間反向傳播,損失為 ,再用有限差分檢查其中一個梯度元素。請注意 dWh += … 這一行:因為 在每一步都被使用,它的梯度是所有步貢獻的總和。
程式碼 · Python · 36 行
import numpy as np

rng = np.random.default_rng(0)
d, m, T = 3, 5, 7                                   # input size, state size, length
Wx = rng.normal(0, 0.5, (m, d))
Wh = rng.normal(0, 0.5, (m, m))
b = np.zeros(m)

def rnn_forward(xs, h0):
    hs = [h0]
    for x in xs:                                     # the SAME Wx, Wh, b at every step
        hs.append(np.tanh(Wx @ x + Wh @ hs[-1] + b))
    return hs

def rnn_backward(xs, hs, dhT):
    """BPTT for the loss L = dhT . h_T; returns dL/dWh and dL/dx_t for every t."""
    dWh, dxs, dh = np.zeros_like(Wh), [None] * len(xs), dhT
    for t in reversed(range(len(xs))):
        da = dh * (1 - hs[t + 1] ** 2)               # through tanh
        dWh += np.outer(da, hs[t])                   # shared weight: gradients ADD up
        dxs[t] = Wx.T @ da
        dh = Wh.T @ da                               # pass the gradient one step back
    return dWh, dxs

xs = rng.normal(size=(T, d))
hs = rnn_forward(xs, np.zeros(m))
dhT = rng.normal(size=m)
dWh, dxs = rnn_backward(xs, hs, dhT)

# finite-difference check of one entry of dL/dWh
eps, (i, j) = 1e-6, (2, 3)
Wh[i, j] += eps; up = dhT @ rnn_forward(xs, np.zeros(m))[-1]
Wh[i, j] -= 2 * eps; down = dhT @ rnn_forward(xs, np.zeros(m))[-1]
Wh[i, j] += eps
print("BPTT vs finite difference:", np.isclose(dWh[i, j], (up - down) / (2 * eps)))
print("|dL/dx_t| from first to last step:", np.round([np.linalg.norm(g) for g in dxs], 3))
它會印出 True,而輸入梯度的範數為 :即使序列只有七步,早期輸入收到的梯度也比後期小了大約十到五十倍。這就是縮小版的梯度消失問題。
時間反向傳播
白話版。 把網路展開,在展開後的計算圖上執行普通的反向傳播,再把每個共享權重的梯度加總起來。
精確版。 把激活前的值寫成 ,因此 。假設損失是各步的總和 。從 往回推,抵達 的總梯度為
第一項是第 步的局部損失;第二項是 影響到的所有後續部分,往回傳了一步。令 (激活前的梯度),參數梯度就是對時間的總和:
這個演算法稱為時間反向傳播(BPTT),Werbos [8] 對它有清楚的闡述。它的計算量與 成線性,但記憶體也一樣:每個 都必須保存下來,供反向傳遞使用。
截斷式 BPTT
對非常長的資料流(一小時的影片、連續的感測紀錄)而言,保存所有狀態是不可能的。截斷式 BPTT(truncated BPTT)把資料流切成每段 步的視窗來處理。它會把隱藏狀態從一個視窗帶到下一個視窗,所以模型仍然「看得到」完整的過去;但它在每個視窗邊界把狀態從計算圖上切斷(detach),所以梯度最多只往回傳 步。因此,模型只有在視窗內的梯度訊號促使它學會保存長距離資訊時,才能利用這些資訊。
程式碼 · Python · 21 行
import torch
from torch import nn

torch.manual_seed(0)
rnn, head = nn.GRU(1, 16, batch_first=True), nn.Linear(16, 1)
params = list(rnn.parameters()) + list(head.parameters())
opt = torch.optim.Adam(params, lr=1e-2)
t = torch.arange(0, 2000) * 0.05
stream = torch.sin(t) + 0.1 * torch.randn_like(t)   # one long noisy signal
x, y = stream[:-1, None][None], stream[1:, None][None]   # predict the next sample

h, window = None, 50
for start in range(0, x.shape[1] - window, window):
    out, h = rnn(x[:, start:start + window], h)
    loss = nn.functional.mse_loss(head(out), y[:, start:start + window])
    opt.zero_grad()
    loss.backward()                       # gradients flow back at most `window` steps
    nn.utils.clip_grad_norm_(params, 1.0)
    opt.step()
    h = h.detach()                        # keep the state, cut the graph
print("final window MSE:", round(loss.item(), 4), "(noise variance is 0.01)")
把資料流走過一遍之後,最後一個視窗的均方誤差約為 0.014,接近加入雜訊所設定的 0.01 下限。如果忘了 h.detach(),第二個視窗會試圖反向傳播進一張已經被釋放的計算圖,PyTorch 會丟出錯誤;反過來,若在每個視窗都把 h = None 重設,就等於把上下文丟掉了。
梯度消失與梯度爆炸
白話版。 反向傳播跨時間連乘狀態的 Jacobian;乘積可能快速縮小或放大,使遠距離依賴難以學習。
精確版。 把每一步的 Jacobian 串起來,得到
這是 個矩陣依序相乘的乘積(矩陣乘法不可交換,所以順序很重要)。因為 ,
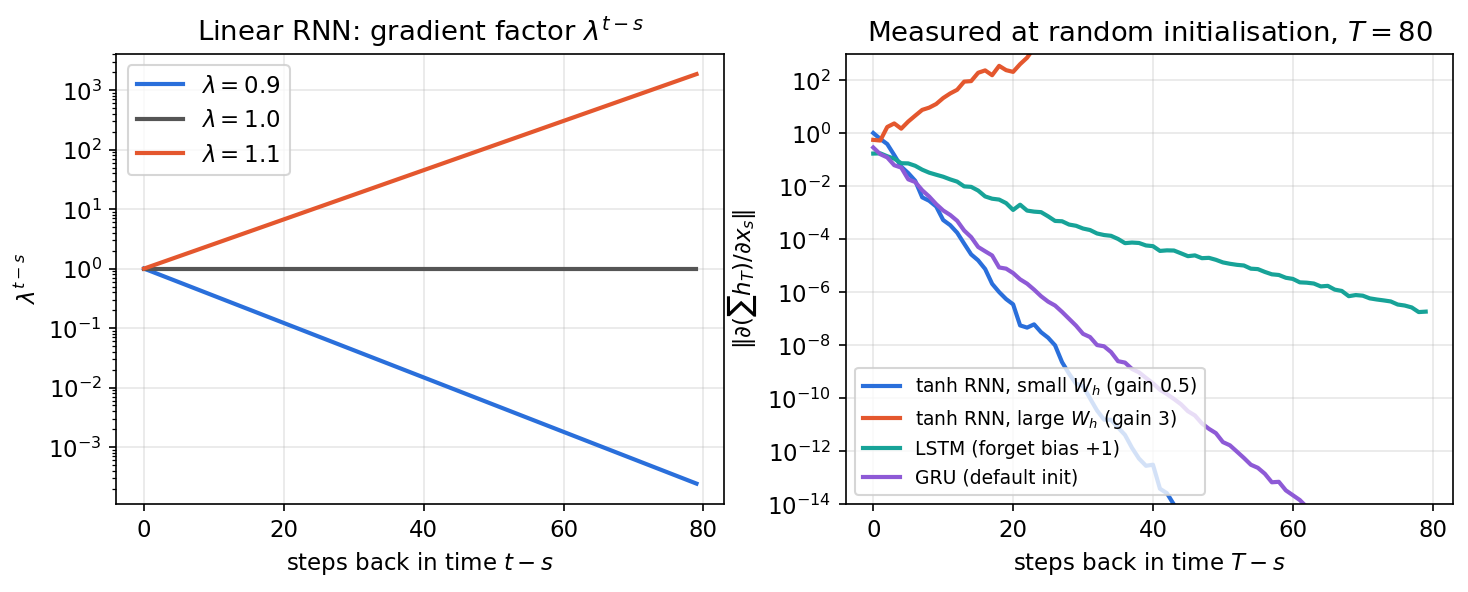
其中 是最大奇異值。若 ,來自遠處步驟的梯度會以指數速度消失。若 有很大的奇異值、而且神經元沒有飽和,梯度就可能爆炸。Bengio、Simard 與 Frasconi [6] 在 1994 年證明,這不是某種特定訓練方法的缺陷:一個能在雜訊下穩健保存資訊的系統,必然處於長距離依賴梯度會縮小的狀態。Pascanu、Mikolov 與 Bengio [7] 用動態系統的工具重新分析這個問題,並提出處理梯度爆炸的實用方法。
用純量線性 RNN 最容易看出直覺:此時 ;當 時是 ,當 時是 。圖 2 顯示在真實網路中量測到的相同行為。
對策。 梯度爆炸用梯度裁剪(gradient clipping)[7] 處理:若梯度範數 超過門檻 ,就把它縮放成 。這樣能保留更新方向、同時限制步長。PyTorch 的 clip_grad_norm_ 做的正是這件事。梯度消失就比較難處理:需要換一種架構,讓狀態更新接近恆等映射,梯度才能穿過許多步。這種架構就是 LSTM。
長短期記憶(LSTM)
白話版。 給網路一條獨立的記憶通道,也就是細胞狀態(cell state),它透過加法而不是反覆的矩陣乘法來更新,並讓學習得到的閘門(gate)決定要擦掉什麼、寫入什麼、顯露什麼。
精確版。 以 表示串接、 表示 logistic sigmoid,標準的 LSTM 一步計算為
每個閘門都是一個介於 0 到 1 之間的數值向量,而 是逐元素相乘,所以每個閘門就像一排調光開關,每個記憶單元各一個。遺忘閘(forget gate) 決定保留多少舊記憶,輸入閘(input gate) 決定寫入多少候選記憶 ,輸出閘(output gate) 決定把多少記憶顯露成 。
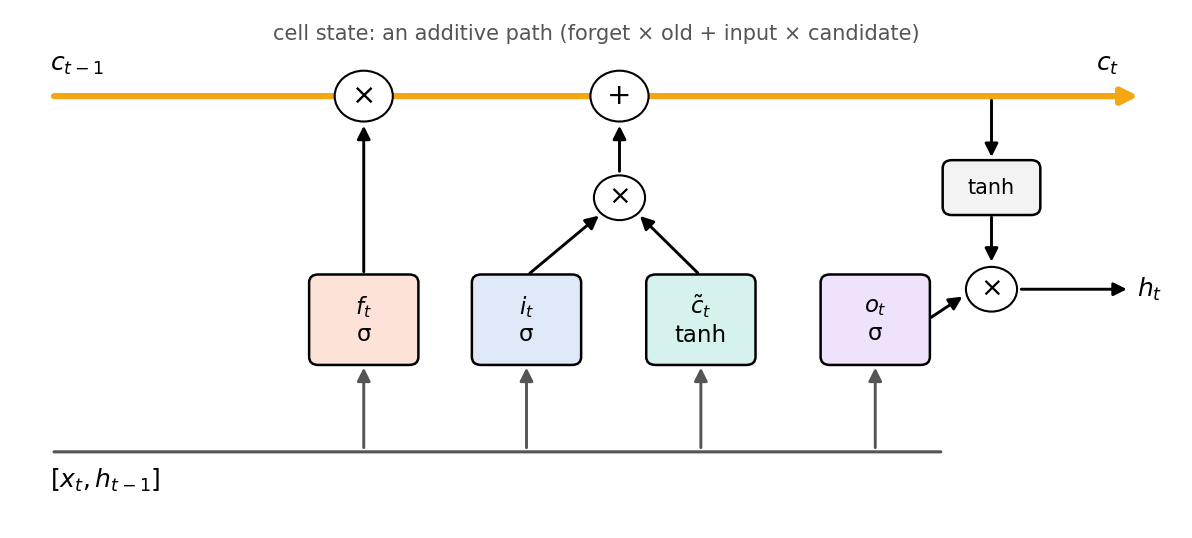
為什麼有效。 沿著細胞狀態路徑,(忽略經過閘門的較小間接路徑)。這條路徑上沒有反覆出現的權重矩陣,也沒有壓縮型的非線性函數。只要遺忘閘維持在接近 1,梯度就能幾乎不變地穿過許多步。這就是圖 2 中 LSTM 曲線衰減得這麼慢的原因,也是常見的初始化會把遺忘閘偏差設成正值(例如 )的原因:讓網路一開始就傾向於記住。但這並不保證無限長的記憶:遺忘閘能夠、也確實會學著關閉,而長距離的功勞分配(credit assignment)仍然會隨距離變得更困難。
歷史與出處。 Hochreiter 與 Schmidhuber 在 1997 年提出 LSTM [2],當時用的是「恆定誤差旋轉木馬」(constant-error carousel):細胞狀態原封不動地往下傳,沒有遺忘閘。Gers、Schmidhuber 與 Cummins 在 2000 年加入遺忘閘 [5],讓細胞能學會重設記憶,例如在連續資料流中相互獨立的片段之間。上面這組含遺忘閘的方程式,才是實務上與所有主流框架使用的版本。Greff 等人 [19] 在語音、手寫與音樂任務上比較了八種 LSTM 變體,發現沒有一種顯著勝過標準架構,而遺忘閘與輸出激活函數是其中最關鍵的元件。
參數量。 四個閘門區塊各有一個 的權重矩陣和一個偏差,所以一層 LSTM 大約有 個參數,是相同狀態大小的簡單 RNN 的四倍。(PyTorch 把輸入偏差和循環偏差分開存,所以是 。)
程式碼:從零寫出一步 LSTM,並與 PyTorch 比對
PyTorch 依照輸入閘、遺忘閘、候選細胞()、輸出閘的順序把四個閘門區塊堆疊在一起。親手實作一步,再和 nn.LSTMCell 比較,是確認自己沒讀錯方程式的最好方法:
程式碼 · Python · 24 行
import torch
from torch import nn

torch.manual_seed(0)
d, m = 4, 6
cell = nn.LSTMCell(d, m)                 # PyTorch stacks gate weights in order i, f, g, o

def lstm_step(x, h, c):
    z = x @ cell.weight_ih.T + cell.bias_ih + h @ cell.weight_hh.T + cell.bias_hh
    i, f, g, o = z.chunk(4, dim=-1)
    i, f, o = torch.sigmoid(i), torch.sigmoid(f), torch.sigmoid(o)
    g = torch.tanh(g)                    # candidate memory, often written c~_t
    c = f * c + i * g                    # additive cell update
    h = o * torch.tanh(c)
    return h, c

x = torch.randn(2, d)
h0, c0 = torch.randn(2, m), torch.randn(2, m)
h_ref, c_ref = cell(x, (h0, c0))
h_ours, c_ours = lstm_step(x, h0, c0)
print("matches nn.LSTMCell:", torch.allclose(h_ours, h_ref, atol=1e-6),
      torch.allclose(c_ours, c_ref, atol=1e-6))
print("parameters:", sum(p.numel() for p in cell.parameters()), "= 4 * m * (d + m + 2) =",
      4 * m * (d + m + 2))
它會印出 True True 以及 288 = … = 288。
選讀:LSTM(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
閘控循環單元(GRU)
白話版。 GRU 是精簡版的 LSTM:它把細胞狀態和隱藏狀態合而為一,並用兩個閘門取代三個。
精確版。 依照 Cho 等人 [3] 以及 PyTorch 的 nn.GRU:
重設閘(reset gate) 決定在形成候選狀態時使用多少舊狀態;更新閘(update gate) 在保留舊狀態()與替換成新狀態()之間內插。這個內插扮演了 LSTM 加法細胞路徑的角色。有兩點值得注意。有些論文與教科書會把 與 的角色對調;兩種模型等價,但閘門的意義正好相反。此外,原始論文把重設閘放在循環矩陣之前(),而 PyTorch 與 cuDNN 則像上式一樣放在之後。在替閘門賦予意義之前,務必先查閱框架的文件。
GRU 有三個閘門區塊而不是四個,所以在相同寬度下參數比 LSTM 少約 25%。兩者都沒有在所有任務上穩定勝出;當資料或運算資源有限時,GRU 是合理的預設選擇。
程式碼:能推廣到新序列的循環分類器
這個完整的 CPU 範例學習判斷序列總和的正負號,必須把全部十二步的資訊累積起來才辦得到。一組全新的測試資料用來確認模型不是只把訓練序列背下來。
程式碼 · Python · 26 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
torch.set_num_threads(1)
rnn = nn.GRU(input_size=1, hidden_size=24, batch_first=True)
head = nn.Linear(24, 2)
opt = torch.optim.Adam(list(rnn.parameters())+list(head.parameters()), lr=.003)
def batch(n):
    x = torch.randn(n, 12, 1)
    y = (x.sum(dim=(1, 2)) > 0).long()
    return x, y
for step in range(400):
    x, y = batch(64)
    _, h = rnn(x)
    loss = F.cross_entropy(head(h[-1]), y)
    opt.zero_grad(); loss.backward()
    nn.utils.clip_grad_norm_(list(rnn.parameters())+list(head.parameters()), 1.)
    opt.step()
rnn.eval(); head.eval()
with torch.no_grad():
    x, y = batch(512)
    _, h = rnn(x)
    acc = (head(h[-1]).argmax(1) == y).float().mean()
    print("fresh-sequence accuracy:", acc.item())
它在長度 12 的新序列上達到約 99% 的準確率。即使設定了 batch_first=True,回傳的隱藏狀態張量形狀仍是 layers × batch × hidden;這個旗標只影響輸入與輸出序列的排列方式。用更長的序列測試是在問另一個問題——長度推廣(length generalization)——模型可能在長度 12 成功、卻在長度 100 失敗(見練習 2)。
深層、雙向與串流 RNN
堆疊。 深層 RNN 把某一層循環網路輸出的隱藏狀態序列,餵給另一層循環網路(PyTorch 中的 num_layers)。較低的層可以捕捉短距離的圖樣,較高的層則捕捉較長距離的圖樣。常見的是二到四層;更深的堆疊通常需要在層與層之間加入殘差連接。
雙向。 Schuster 與 Paliwal [10] 提出讓一個 RNN 沿時間往前跑、另一個往後跑,再把兩者的狀態串接起來:。如此每個位置都同時總結了它的過去與未來。這非常適合整段輸入都已取得的離線任務(標註錄好的影片、編碼一個句子),但它不具因果性:不能用在必須在未來影格抵達之前就做出預測的即時任務。把離線雙向模型的準確率拿來報告線上應用,會高估部署後系統實際能掌握的資訊。
變動長度。 一個批次裡的序列長度不一,會被填補(padding)到相同長度。若不小心處理,填補值會滲入狀態與損失。請使用每條序列的實際長度(PyTorch 的 pack_padded_sequence)或遮罩,讓填補的步驟既不更新狀態、也不計入損失。
串流。 對即時資料流,要在多次呼叫之間保留狀態,只在彼此獨立的資料流之間重設。不小心把某位使用者、某份文件或某段影片的狀態帶到下一個,會洩漏資訊並造成無法重現的結果。
編碼器–解碼器模型與教師強制
白話版。 基本編碼器—解碼器先把輸入序列讀成狀態,再據此生成輸出序列;兩者長度可以不同。
精確版。 在 Sutskever、Vinyals 與 Le [11] 的序列到序列(sequence-to-sequence, seq2seq)模型,以及 Cho 等人 [3] 密切相關的編碼器–解碼器中,編碼器 RNN 讀入 ,其最終狀態成為上下文向量 。以 初始化的解碼器 RNN 建模
其中 是解碼器狀態, 是在詞彙表上的 softmax。當解碼器輸出序列結束符記時生成就停止,所以輸入與輸出的長度互不相關。
教師強制(teacher forcing)。 訓練時,解碼器在第 步的輸入是真實答案中的前一個符記 ,而不是模型自己的預測。這讓所有步驟都能針對已知目標平行訓練,大幅穩定學習。然而在測試時,模型必須吃進自己的預測,而這些預測可能含有訓練時從未見過的錯誤。這種訓練與測試之間的落差稱為曝光偏差(exposure bias)。排程取樣(scheduled sampling)[25] 在訓練過程中逐步用模型的取樣取代真實輸入,以減輕這個問題。解碼時通常使用貪婪搜尋或集束搜尋(beam search),而不是隨機取樣。
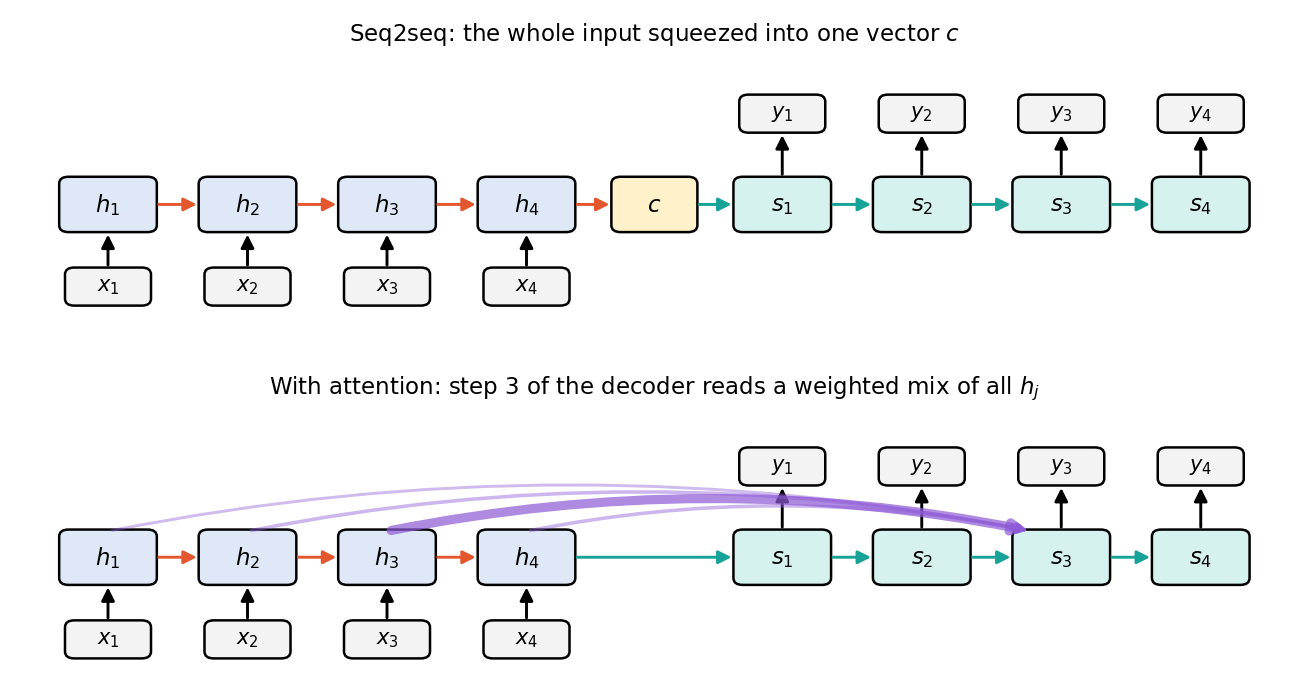
圖 4(上)清楚顯示了弱點:解碼器對輸入所知道的一切,都必須通過一個固定大小的向量 ,不論輸入有多長。單純 seq2seq 模型的翻譯品質在長句子上會下降。Sutskever 等人發現,單純把來源句子反轉就有幫助,因為這縮短了對應字詞之間的距離——這暗示問題出在瓶頸與過長的路徑 [11]。
注意力:通往 Transformer 的橋梁
白話版。 注意力讓解碼器在每一步選取相關的編碼器狀態,不必只依賴固定摘要。
精確版。 Bahdanau、Cho 與 Bengio [12] 保留了每一個編碼器狀態 (來自雙向編碼器),並在解碼器的每一步 計算
是解碼器當下需求()與編碼器位置 之間經學習得到的對齊分數(alignment score);、 與 是可學習參數。softmax 把分數轉成皆為正、總和為一的權重 ,而上下文向量 就是用這些權重對編碼器狀態做的加權平均。解碼器接著把 與自己的狀態一起使用。這種形式稱為加法注意力(additive attention)。因為 在每一步都會改變,而且能直接存取每一個輸入位置,任何輸入到任何輸出之間的路徑長度都變成一步,與序列長度無關。
程式碼 · Python · 29 行
import torch
from torch import nn

class AdditiveAttention(nn.Module):
    """Bahdanau-style scores e_j = v^T tanh(W s + U h_j), then softmax over j."""
    def __init__(self, d_dec, d_enc, d_att):
        super().__init__()
        self.W = nn.Linear(d_dec, d_att, bias=False)
        self.U = nn.Linear(d_enc, d_att, bias=False)
        self.v = nn.Linear(d_att, 1, bias=False)

    def forward(self, s, H, mask=None):
        # s: B x d_dec (decoder state), H: B x T x d_enc (all encoder states)
        e = self.v(torch.tanh(self.W(s)[:, None] + self.U(H))).squeeze(-1)   # B x T
        if mask is not None:                       # True where the input is padding
            e = e.masked_fill(mask, float("-inf"))
        alpha = e.softmax(dim=-1)                  # attention weights, rows sum to 1
        context = (alpha[:, :, None] * H).sum(1)   # B x d_enc weighted average
        return context, alpha

torch.manual_seed(0)
att = AdditiveAttention(d_dec=16, d_enc=32, d_att=8)
H = torch.randn(2, 5, 32)
s = torch.randn(2, 16)
pad = torch.tensor([[False] * 5, [False, False, False, True, True]])   # 2nd sequence has length 3
ctx, alpha = att(s, H, pad)
print("context:", tuple(ctx.shape), "| weights sum to 1:",
      torch.allclose(alpha.sum(-1), torch.ones(2)))
print("weights on padding:", alpha[1, 3:].tolist())
它會印出形狀為 (2, 32) 的上下文,確認權重總和為一,並顯示填補位置的權重恰好為零:在 softmax 之前用 遮罩,是讓注意力忽略填補(以及在 ML 05 中忽略未來)的標準做法。
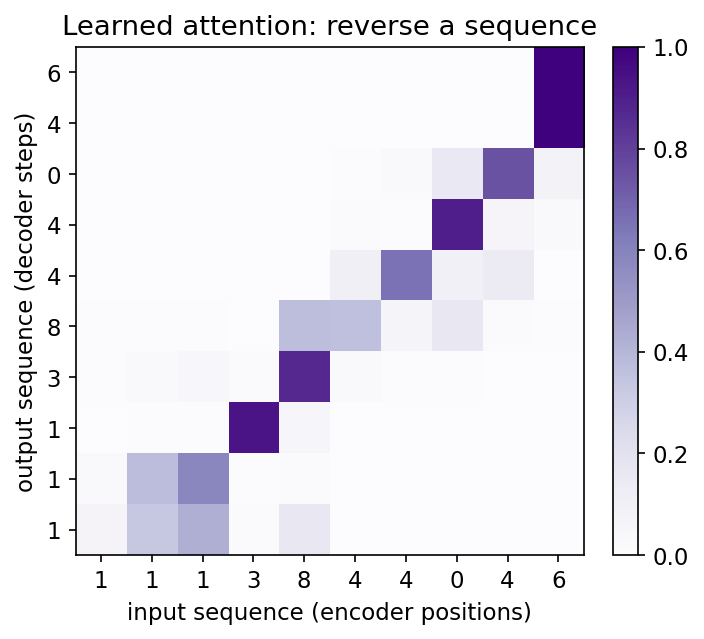
注意力權重也可以解讀成一種軟性的對齊(alignment)。圖 5 顯示一個帶有這種注意力的小型 GRU 編碼器–解碼器,在 CPU 上訓練不到一分鐘,學習把隨機數字序列反轉(在教師強制下,對新序列的逐符記準確率約 96%)。沒有人告訴它,它卻學會了在寫第 個輸出時去看第 個輸入位置:也就是反對角線。
從這裡走向 Transformer。 注意力解決了瓶頸,但編碼器與解碼器仍然是循環式的,所以處理長度 的序列需要 個無法在訓練時平行化的循序步驟。Vaswani 等人 [28] 問:如果完全拿掉循環,在編碼器與解碼器內部也使用注意力(自注意力,self-attention),再用位置編碼恢復順序,會怎麼樣?答案就是 Transformer:它能在所有位置上平行訓練,成為語言領域的主流架構,並且隨著 ViT 成為視覺領域的主流架構。ML 05 會從縮放點積注意力(scaled dot-product attention)接續這個故事,它以 取代加法分數。
循環網路在電腦視覺中的應用
影像描述(image captioning)。 Show and Tell [13](Vinyals 等人)是一個直接的影像到序列模型:一個 CNN(ML 03)把影像編碼成一個向量,用它初始化一個 LSTM 語言模型,再由這個語言模型逐字生成圖說,並以教師強制在影像–圖說配對上訓練。Show, Attend and Tell [14](Xu 等人)保留 CNN 的空間特徵網格而不是單一向量,讓 LSTM 在生成每個字時對影像區域做注意力,所產生的注意力圖常常會凸顯正在被說出名稱的物體。這是最早廣為人知的視覺注意力展示之一。
影片理解。 長期循環卷積網路(Long-term Recurrent Convolutional Networks, LRCN)[15](Donahue 等人)對每張影格套用 CNN、跨影格套用 LSTM,並端到端訓練,用於動作辨識、影像描述與影片描述。CNN 處理空間,RNN 處理時間:這是處理任何逐影格特徵序列的常見模式,例如姿態軌跡,或物件追蹤中的逐影格偵測結果。
時空預測。 當狀態本身就應該是一張影像時,全連接的閘門會浪費空間結構。Shi 等人的 ConvLSTM [16] 把 LSTM 閘門中的矩陣乘法換成卷積,,所以輸入、狀態與閘門都是三維張量(通道 × 高 × 寬)。它最初是為了從雷達圖做降雨即時預報而提出,如今廣泛用於影片預測與其他網格上的預測任務。
發生了什麼改變。 在大規模的影像描述與影片分類上,Transformer 與視覺–語言模型(見 ML 10)已大致取代 LSTM,因為它們能平行訓練,而且隨著資料增加擴展得更好。循環與卷積–循環模型仍常見於影格逐張抵達、記憶體必須維持固定的場合:線上影片處理、追蹤、機器人與低功耗裝置。
遞迴網路:沿著樹組合
白話版。 遞迴網路沿著一棵樹,套用同一條共享的組合規則,把兩個子節點的表示合併成父節點,直到抵達根節點。
精確版。 對一棵葉節點帶有向量(詞嵌入、區域特徵)的二元樹,每個內部節點計算
每個節點都使用同一個 與 。根節點向量代表整個結構,可以拿來分類;每個節點也可以有自己的標籤。訓練使用結構反向傳播(backpropagation through structure):和 BPTT 是同一個想法,只是沿著樹的邊進行。長度為 的鏈是完全不平衡的樹這個特例;平衡樹把任一葉節點到根節點的路徑從 步縮短到大約 步(圖 6),縮短了梯度要走的路。
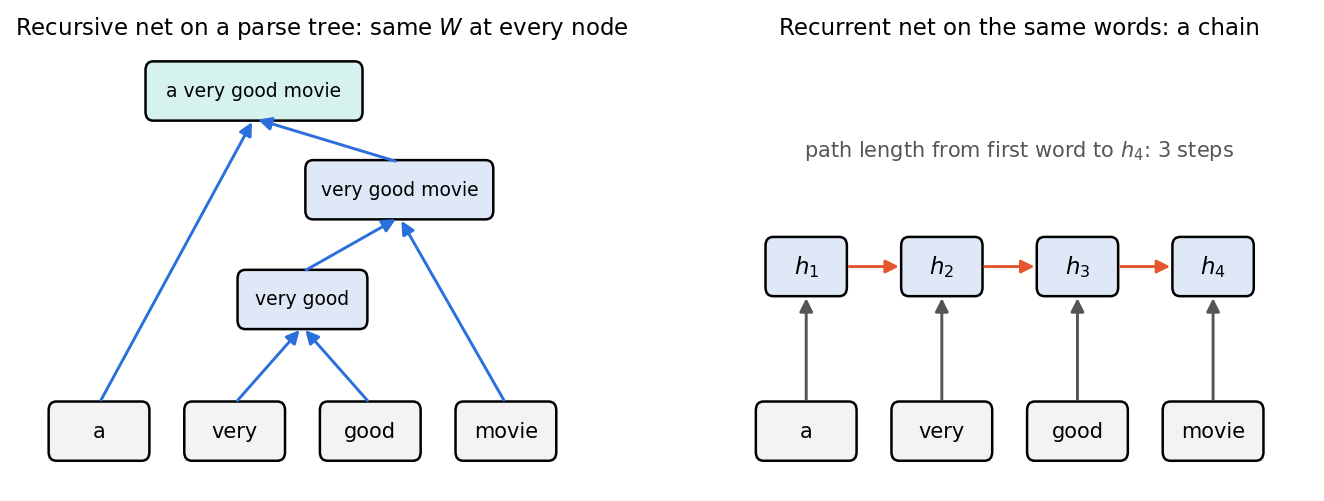
Socher 等人 [18] 最早是在視覺情境中使用遞迴網路:他們把影像切成超像素,接著同時學習把相鄰區域合併成場景剖析樹、以及計算區域表示,並用同一套方法剖析句子。他們後來的遞迴神經張量網路(Recursive Neural Tensor Network)與 Stanford Sentiment Treebank [17] 顯示,沿著剖析樹組合能捕捉否定(“not very good”)之類的現象。Tai、Socher 與 Manning 的 Tree-LSTM [4] 為樹狀組合加入 LSTM 式的閘門,每個子節點各有一個遺忘閘,讓父節點能有選擇地保留來自每棵子樹的資訊。
程式碼 · Python · 25 行
import torch
from torch import nn

torch.manual_seed(0)
D = 8
vocab = {"a": 0, "very": 1, "good": 2, "movie": 3}
emb = nn.Embedding(len(vocab), D)
compose = nn.Linear(2 * D, D)            # ONE weight matrix shared by every internal node
classify = nn.Linear(D, 2)               # e.g. negative / positive sentiment

def encode(tree):
    """tree is a word (leaf) or a pair (left, right)."""
    if isinstance(tree, str):
        return emb(torch.tensor(vocab[tree]))
    left, right = tree
    return torch.tanh(compose(torch.cat([encode(left), encode(right)])))

tree = ("a", (("very", "good"), "movie"))          # (a ((very good) movie))
root = encode(tree)
loss = nn.functional.cross_entropy(classify(root)[None], torch.tensor([1]))
loss.backward()                                     # backpropagation through structure
print("root vector:", tuple(root.shape), "| loss:", round(loss.item(), 4))
print("gradient reached the shared W:", compose.weight.grad.abs().sum().item() > 0)
swapped = encode((("movie", ("good", "very")), "a"))
print("swapping children changes the root:", not torch.allclose(root, swapped))
遞迴就是一般的 Python 遞迴呼叫,而 autograd 會即時建立樹狀的計算圖。交換子節點會改變結果,因為串接讓左右兩個位置扮演不同的角色。
實務上的主要限制在於樹本身:得有人提供它(剖析器、分割階層),而且要有效率地把形狀各異的樹組成批次並不容易。同時學習結構與表示是可行的,但更困難。在目前的實務中,自注意力能在沒有明確樹結構的情況下,學到柔性、隨輸入而變的分組,這也是遞迴網路如今少見的原因之一;不過階層式組合的想法仍延續在階層式視覺骨幹網路與場景圖(scene graph)中。
Mamba:選擇性狀態空間與掃描
有用的記憶應該能在干擾之間保留重要觀察,並在情境改變時覆寫舊資訊。Mamba [21] 讓記憶更新取決於目前輸入,同時維持更新對前一個狀態的仿射形式。這個差別讓模型保有循環的解讀方式,又能用平行前綴掃描(parallel prefix scan)計算整段序列。
從連續動態到選擇性更新
先從小型的連續時間記憶開始。穩定的轉移使儲存的資訊逐漸衰減;輸入投影寫入新資訊;輸出投影讀出記憶:
其中 是連續時間, 是單一輸入通道, 是該通道的 維狀態, 是轉移矩陣, 負責寫入輸入, 負責讀取狀態, 是輸出。完整的神經網路區塊會以可學習投影混合多個通道,並加入局部卷積與閘控 [21]。這個方程式只抽出記憶機制。
在每個區間內保持輸入與寫入矩陣不變。精確的零階保持(zero-order hold)離散化得到
其中 是離散 token 的索引, 是區間長度, 是積分變數, 是固定的輸入, 是目前的寫入與讀取矩陣,上橫線表示離散係數。即使 是奇異矩陣,積分形式仍然成立;使用反矩陣的公式則需要額外假設。若 是對角矩陣,這些運算可以逐元素執行。
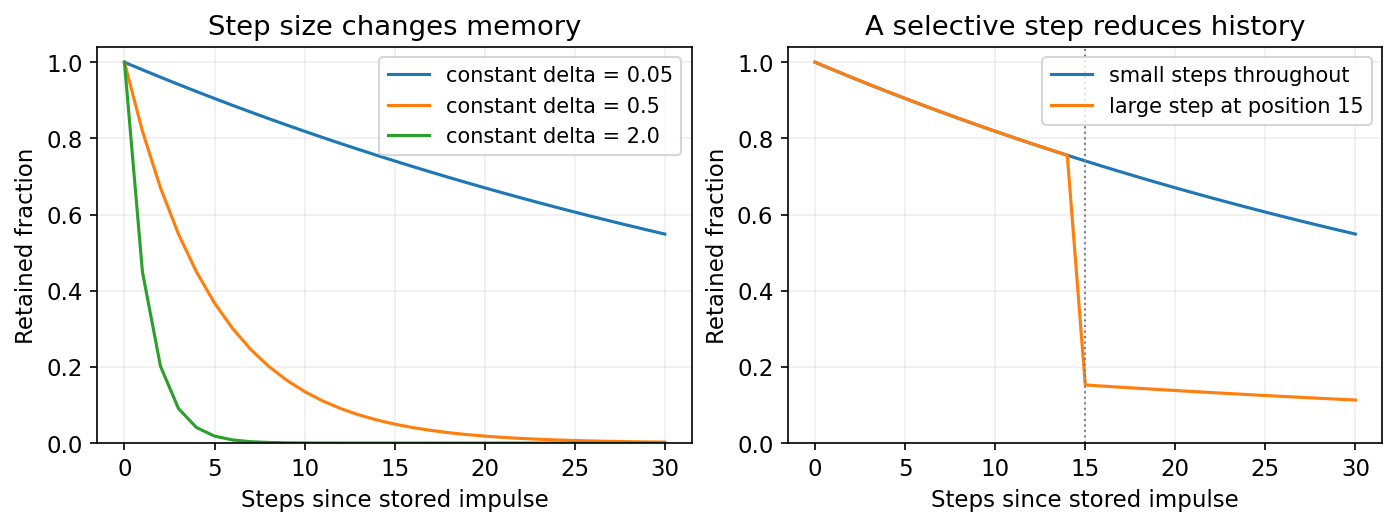
選擇性表示從目前 token 預測 。例如,可學習的仿射投影接上 ,就能產生正的區間長度。底層可學習的 可以保持固定,但 仍會透過 改變。當對角元素為負時,較長的區間會降低舊狀態的保留比例。選擇性的寫入與讀取也決定哪些內容進入或離開記憶。因此,即使每次狀態更新都是仿射的,整體映射對輸入仍是非線性的。圖 7 使用合成係數單獨呈現保留效果,並未量測訓練好的模型。
為什麼這種循環可以掃描
輸入相依的係數算好後,組合兩次仿射更新仍然只需要一次仿射更新:
其中配對 表示映射 , 標示連續的兩次更新, 表示先套用第一次,再套用第二次。組合具有結合律;對角轉移的乘法是逐元素運算。因此,前綴掃描可以把運算重新分組成樹狀結構,卻保留時間順序造成的效果。一般 LSTM/GRU 的閘門取決於前一個隱藏狀態,通常無法在狀態尚未算出之前先準備這些係數。
以下可獨立執行的 CPU 範例使用精確的對角離散化,以及手動指定的選擇性係數,檢查因果性與分塊之間的狀態連續性。這是教學用的循環,並非預訓練 Mamba 實作或速度基準。
程式碼 · Python · 31 行
import numpy as np

rng = np.random.default_rng(44)
u = rng.normal(size=24)
A = -np.array([0.1, 0.8])  # two stable diagonal entries

def selective_scan(values, state=None):
    h = np.zeros(2) if state is None else state.copy()
    outputs = []
    for x in values:
        delta = np.logaddexp(0.0, 0.5 * x)
        B = np.array([1.0, np.tanh(x)])
        C = np.array([1.0, 0.5 + 0.1 * np.tanh(x)])
        a = np.exp(delta * A)
        b = np.expm1(delta * A) / A * B * x
        h = a * h + b
        outputs.append(C @ h)
    return np.array(outputs), h

y, final_state = selective_scan(u)
changed = u.copy()
changed[12:] += 10.0
changed_y, _ = selective_scan(changed)
assert np.allclose(y[:12], changed_y[:12])
left, boundary = selective_scan(u[:12])
right, resumed_state = selective_scan(u[12:], boundary)
assert np.allclose(y, np.r_[left, right])
assert np.allclose(final_state, resumed_state)
reset_right, _ = selective_scan(u[12:])
assert not np.allclose(right, reset_right)
print('causal prefix and carried-state chunk checks passed')
輸出確認兩項檢查都通過。在批次邊界把狀態歸零會改變計算;反過來,在獨立範例之間共用狀態則會洩漏資訊。串流實作必須追蹤每個狀態屬於哪段序列,並在真正的序列邊界重設。
Mamba-2 與注意力的連結
Mamba-2 [29] 同時改變內部序列混合器與外圍區塊。其結構化狀態空間對偶性(structured state-space duality)在每個頭內使用「純量乘上單位矩陣」的轉移,並把計算切成適合加速器硬體執行密集矩陣乘法的區塊。它也重新安排參數投影與正規化。這比在原始 Mamba 區塊中加入注意力更為具體。
初始狀態為零時,純量轉移的循環可以展開為
其中 索引先前輸入, 索引中間的轉移, 是乘在單位矩陣上的離散純量轉移, 是離散寫入列向量, 是讀取行向量,空的連乘等於一。括號內是具有結構的因果混合係數。這提供類似注意力的矩陣觀點,卻不需要一般 softmax 注意力,也不必儲存完整矩陣。Hu 等人 [30](ICML 2026)把對偶性延伸到對角轉移,並釐清為何無法直接延伸到標準 softmax 注意力。
在固定寬度與狀態維度下,循環推論只攜帶固定大小的狀態;一般具有快取的因果注意力則保留 key 與 value,儲存量隨上下文長度增加。壓縮能省下記憶體,但精確回想許多互不相關細節的能力也受到考驗。序列成本呈線性並不代表訓練記憶體固定:活化值、梯度與重新計算策略都會影響結果。應一起評估檢索品質、上下文長度與裝置實測延遲。影像特有的排序問題接著在 ML 05 討論。
現代觀點
綜述文獻。 Goodfellow 等人書中的第 10 章 [1] 至今仍是循環與遞迴網路、回聲狀態(echo-state)想法與長期依賴問題最清楚的統一論述。Lipton、Berkowitz 與 Elkan [20] 在 2015 年寫了一篇 RNN 序列學習的批判性回顧:以時間順序、自成一體地交代三十年來通往 LSTM 與雙向 RNN 的研究,統一了互相衝突的記號與名稱,並涵蓋影像描述、翻譯與手寫辨識等應用。Greff 等人 [19] 與其說是綜述,不如說是大型實證研究,但它是「LSTM 哪些元件重要」這個問題的參考依據。Tiezzi 等人近年的兩篇回顧,則為 Transformer 時代重新定位循環結構:一篇詳盡的綜述 [26] 把 Transformer–RNN 混合模型、具循環形式的注意力變體,以及深度狀態空間模型(一類特殊的線性 RNN)統一放在「循環」這個大傘之下,並強調從可能無限長的資料流中線上學習、而非處理固定長度序列所帶來的研究機會;另一篇刊登於 Nature Machine Intelligence 的較短觀點文章 [27],則重新檢視位於 Transformer 與狀態空間模型交會處的循環處理。
循環的回歸(2023–2026)。 Transformer 處理所有位置兩兩之間的關係,記憶體與運算量隨長度呈平方成長。一系列模型重新採用循環結構,以固定大小的狀態取得線性時間的推論:
- 線性循環單元。 Orvieto 等人 [24](ICML 2023)證明,一個經過精心參數化的線性循環式——對角的複數狀態矩陣、穩定的初始化與正規化——在長距離基準測試上可媲美深度狀態空間模型,而且非線性可以放在循環式之外。
- 選擇性狀態空間。 Mamba [21] 讓狀態空間的參數成為輸入的函數,所以模型能像 LSTM 的閘門那樣選擇要儲存或忽略什麼,同時以考慮硬體特性的平行掃描(parallel scan)維持訓練效率。視覺上的變體,以及它們對影像是否真有必要的爭論,會在 ML 05 討論。
- 復興的 LSTM 與 GRU。 xLSTM [22](NeurIPS 2024)為 LSTM 加入指數型閘門與矩陣形式的記憶,並把它擴展到語言模型的規模。Feng 等人 [23](2024)移除 LSTM 與 GRU 閘門對隱藏狀態的依賴(“minLSTM”、“minGRU”),使訓練時能使用平行掃描,並報告了與近期序列模型相當的結果。
共同的教訓是:為 LSTM 發明的閘控、加法式狀態更新是對的;限制經典 RNN 的主要是循序訓練。讓循環式對狀態呈線性(因此能用平行掃描計算),就能恢復平行訓練,同時保留便宜的串流推論。
開放問題。 超出訓練長度範圍的長度推廣;在非常長的資料流上、不用完整 BPTT 的功勞分配;固定大小的狀態相較於注意力不斷成長的快取究竟能記住多少——對需要精確回想遠處細節的任務而言,這是實際存在的限制;以及為二維影像與三維影片選擇掃描順序,因為它們沒有唯一自然的序列順序。
重點整理
- RNN 跨時間重用同一狀態更新規則,共用參數不保證有用的長期記憶。
- BPTT 加總共用參數的梯度;截斷限制梯度回溯範圍,但可繼續傳遞狀態。
- 裁剪限制梯度爆炸,加性閘控路徑有助梯度傳遞,但無法消除所有長距離學習困難。
- 雙向編碼器使用未來輸入;因果串流需要不同的存取與狀態處理。
- 注意力讓解碼器讀取多個編碼器狀態,遞迴網路則沿樹狀結構組合表示。
- 選擇性狀態空間以精簡串流狀態壓縮歷史;須依實際工作負載比較回憶能力與計算。
練習
- 因果性。 你的團隊報告一個使用雙向 LSTM 的動作辨識模型,逐影格準確率達 92%,並提議把它部署成即時警報系統。這個計畫有什麼問題?你要如何公平地評估可部署的替代方案? 執行選擇性掃描範例,再加上反向掃描:哪個因果性檢查應該失敗?
提示
第 張影格上的反向 LSTM 已經讀過 之後的影格,而即時系統還沒看到這些影格。請重新訓練一個單向(因果)模型,或允許固定的前瞻延遲,並以完全相同的延遲做評估。把準確率表示成延遲的函數來報告。 反向掃描讀過被改動的未來,因此即使正向前綴不變,合併後的前綴通常仍會改變。
- 長度推廣。 用長度 12 訓練 GRU 總和分類器,接著在不重新訓練的情況下,用長度 6、24、100 與 400 的新序列評估。畫出準確率對長度的圖。再用 LSTM、以及用長度 6–24 混合訓練,重複一次。
提示
每種長度都要產生新的資料。總和的尺度隨 成長,所以即使邏輯正確,狀態在長輸入上也可能飽和。混合長度訓練通常比更換細胞種類更有幫助。在長度 12 上成功,本身並不能說明長度 400 的表現。
- 梯度上界。 對純量 RNN ,證明 。梯度在 取哪些值時可能爆炸?為什麼 的飽和會抑制爆炸?
提示
每個因子都是 ,且 。爆炸需要 ,但很大的 也會把 推向 ,使 變小。梯度只會在停留於非飽和區域的軌跡上爆炸,這就是實務上爆炸往往是突發性的原因。
- LSTM 的記憶。 在 LSTM 方程式中,假設從 到 的每一步都有 且 。 用 表示是多少?沿著細胞路徑的 是多少?如果像 1997 年原始設計那樣,把遺忘閘永遠固定為 1,在一個永不結束的輸入流上會發生什麼事?
提示
且 :完美的記憶與完美的梯度流動。若 而寫入不為零,細胞狀態會在無止盡的資料流上無限累積,這正是 Gers 等人讓網路學會遺忘所解決的問題。
- 注意力的形狀與遮罩。 在加法注意力的程式碼中,一個批次的編碼器狀態形狀為 (其中有些序列經過填補),解碼器狀態形狀為 。請給出 、 與上下文的形狀,並說明若用 而不是 遮罩填補位置,會出什麼問題。
提示
與 是 ;上下文是 。分數 0 只是一個普通的分數: 仍會給填補位置正的權重,上下文就會混入沒有意義的填補狀態。
- 遞迴與循環。 對一棵有 個葉節點的平衡二元樹,葉節點與根節點之間有幾個組合步驟?與一個由左到右讀取同樣 1024 個輸入的 RNN 比較,並把答案與梯度消失的上界連結起來。
提示
步,鏈則最多 1023 步。梯度上界的衰減方式是(因子),所以從每個輸入到輸出的路徑越短,越有利於最佳化。注意力把這一點推到極致:路徑長度為一。
參考文獻
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 10. Book
- S. Hochreiter and J. Schmidhuber, “Long Short-Term Memory,” Neural Computation, 1997. DOI
- K. Cho et al., “Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation,” EMNLP, 2014. arXiv
- K. S. Tai, R. Socher and C. D. Manning, “Improved Semantic Representations From Tree-Structured Long Short-Term Memory Networks,” ACL, 2015. arXiv
- F. A. Gers, J. Schmidhuber and F. Cummins, “Learning to Forget: Continual Prediction with LSTM,” Neural Computation, 2000. DOI
- Y. Bengio, P. Simard and P. Frasconi, “Learning long-term dependencies with gradient descent is difficult,” IEEE Transactions on Neural Networks, 1994. DOI
- R. Pascanu, T. Mikolov and Y. Bengio, “On the difficulty of training Recurrent Neural Networks,” ICML, 2013. arXiv
- P. J. Werbos, “Backpropagation through time: what it does and how to do it,” Proceedings of the IEEE, 1990. DOI
- J. L. Elman, “Finding Structure in Time,” Cognitive Science, 1990. DOI
- M. Schuster and K. K. Paliwal, “Bidirectional recurrent neural networks,” IEEE Transactions on Signal Processing, 1997. DOI
- I. Sutskever, O. Vinyals and Q. V. Le, “Sequence to Sequence Learning with Neural Networks,” NeurIPS, 2014. arXiv
- D. Bahdanau, K. Cho and Y. Bengio, “Neural Machine Translation by Jointly Learning to Align and Translate,” ICLR, 2015. arXiv
- O. Vinyals, A. Toshev, S. Bengio and D. Erhan, “Show and Tell: A Neural Image Caption Generator,” CVPR, 2015. arXiv
- K. Xu et al., “Show, Attend and Tell: Neural Image Caption Generation with Visual Attention,” ICML, 2015. arXiv
- J. Donahue et al., “Long-term Recurrent Convolutional Networks for Visual Recognition and Description,” CVPR, 2015. arXiv
- X. Shi et al., “Convolutional LSTM Network: A Machine Learning Approach for Precipitation Nowcasting,” NeurIPS, 2015. arXiv
- R. Socher et al., “Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank,” EMNLP, 2013. Paper
- R. Socher, C. C.-Y. Lin, A. Y. Ng and C. D. Manning, “Parsing Natural Scenes and Natural Language with Recursive Neural Networks,” ICML, 2011. Paper
- K. Greff, R. K. Srivastava, J. Koutník, B. R. Steunebrink and J. Schmidhuber, “LSTM: A Search Space Odyssey,” IEEE Transactions on Neural Networks and Learning Systems, 2017. arXiv
- Z. C. Lipton, J. Berkowitz and C. Elkan, “A Critical Review of Recurrent Neural Networks for Sequence Learning,” arXiv:1506.00019, 2015. arXiv
- A. Gu and T. Dao, “Mamba: Linear-Time Sequence Modeling with Selective State Spaces,” COLM, 2024. arXiv
- M. Beck et al., “xLSTM: Extended Long Short-Term Memory,” NeurIPS, 2024. Paper
- L. Feng et al., “Were RNNs All We Needed?,” arXiv:2410.01201, 2024. arXiv
- A. Orvieto et al., “Resurrecting Recurrent Neural Networks for Long Sequences,” ICML, 2023. arXiv
- S. Bengio, O. Vinyals, N. Jaitly and N. Shazeer, “Scheduled Sampling for Sequence Prediction with Recurrent Neural Networks,” NeurIPS, 2015. arXiv
- M. Tiezzi, M. Casoni, A. Betti, T. Guidi, M. Gori and S. Melacci, “On the Resurgence of Recurrent Models for Long Sequences: Survey and Research Opportunities in the Transformer Era,” arXiv:2402.08132, 2024. arXiv
- M. Tiezzi, M. Casoni, A. Betti, T. Guidi, M. Gori and S. Melacci, “Back to recurrent processing at the crossroad of transformers and state-space models,” Nature Machine Intelligence, 2025. DOI
- A. Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. arXiv
- T. Dao and A. Gu, “Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,” ICML, PMLR 235, 2024. Paper
- J. Y.-C. Hu, X. Zhang, A. Elsheikh, W. Wu and H. Liu, “On Structured State-Space Duality,” ICML, PMLR 306, 2026. Paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 05・注意力與視覺 Transformer · 24 分鐘