ML 09・視覺自迴歸:像素、Tokens 與尺度
先備知識:ML 07・生成模型:自編碼器、VAE、GAN 與正規化流、ML 05・注意力與視覺 Transformer
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 以機率連鎖法則分解影像分布。
- 區分教師強制訓練與循序取樣。
- 比較像素預測與學得的視覺 token 化。
- 區分下一 token、下一尺度、遮罩與連續 token 方法。
- 評估解碼控制、快取及與擴散模型的比較。
先看全貌
自迴歸(autoregressive, AR)生成器一塊一塊地建立樣本。每一步,它看著目前為止產生的所有內容,預測下一塊的機率分布,從中抽樣,再把結果接到序列後面。這裡的「一塊」可以是一個像素值、學習出來的 codebook 中的一個整數 token、一個連續特徵向量,甚至是下一個解析度的整張圖。
這為什麼重要?自迴歸正是大型語言模型背後的配方:用 transformer 做下一個 token 預測。把影像帶進這套配方,就能用同一種架構讀寫文字與圖片、沿用語言模型的部署工程,並用精確的似然(likelihood)衡量進展。代價是影像本來就不是序列,必須有人決定什麼是 token,以及 token 用什麼順序產生。本章大部分內容都在討論這兩個決定。
Xiong 等人的綜述 [1] 依照預測單位,把視覺 AR 模型分成三大類:以像素為基礎、以 token 為基礎、以尺度為基礎。我們沿用這張地圖,再加上遮罩式(非由左至右)與連續 token 模型,它們模糊了 AR 與擴散之間的界線。前面關於生成模型與擴散與 flow matching的章節提供本章用到的 VAE 與擴散背景;Prince 的教科書 [9] 則以教材層級涵蓋一般的機率基礎。
鏈鎖法則不需要獨立假設
白話版:任何聯合分布都可以寫成一連串「給定前面元素,下一個元素的分布」的乘積。這是機率論的事實,而不是建模假設。
對於有順序的序列 ,
其中 是所選順序中的第 個元素, 是它之前的所有元素, 是網路參數, 是單一訓練樣本的負對數似然(實務上會對整個資料集取平均)。
鏈鎖法則對任何順序都精確成立。近似只來自模型本身:有限的網路、有限的上下文視窗,或對每個條件分布形式的限制。離散值的條件分布通常是 softmax;二值像素可用 Bernoulli 分布;連續特徵則需要密度函數或另一個條件生成器(MAR 一節會看到一個例子)。
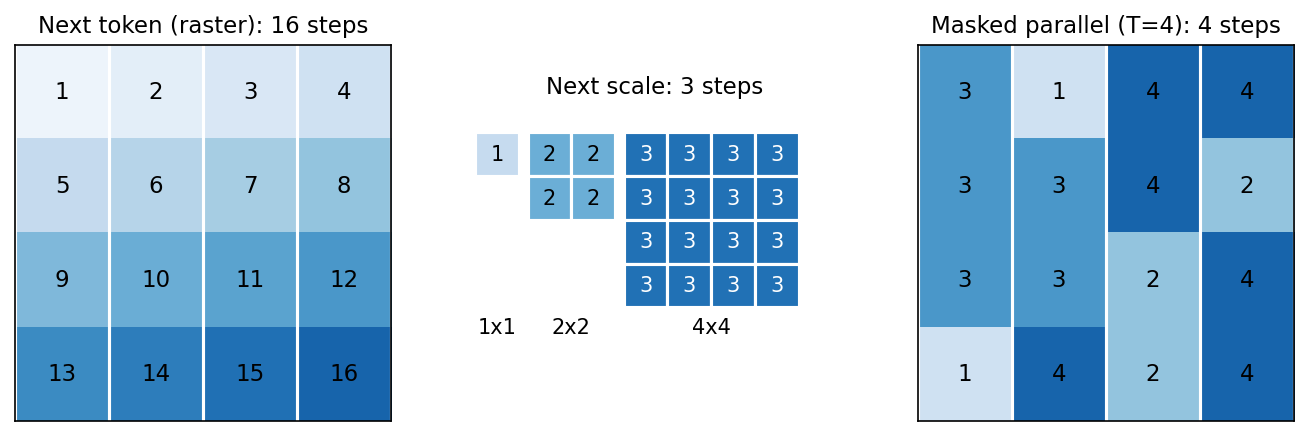
順序是計算上的選擇,不是對物理世界的主張。光柵順序(raster order)(由左到右、由上到下)很方便,但對二維影像來說是任意的:你下方的像素和右邊的像素一樣相關。不同順序會產生不同的條件分布,而有限的模型可能覺得某些順序比較容易學。圖 1 展示本章用到的三種預測單位。
衡量 AR 模型:每維位元數
因為鏈鎖法則給出精確的 ,AR 模型通常用每維位元數(bits per dimension, bpd)表示的負對數似然來比較:
其中 是影像中離散值的個數(例如 的 RGB 影像 ), 把 nat 換成位元。如果模型對每個 8 位元值都給均勻機率,分數恰好是 8 bpd;任何更低的值都代表模型學到了結構。bpd 在保留(held-out)影像上量測,因此同時能偵測過擬合(overfitting)與欠擬合。
有兩點要注意。第一,bpd 和視覺品質可能不一致:模型可能把大部分似然花在肉眼看不到的雜訊上,卻在整體構圖上犯奇怪的錯。第二,對 token 模型而言,似然是定義在 codebook 索引上,而非像素上。有損的 tokenizer 會丟掉資訊,所以 token 層級的似然不是精確的像素空間似然,不能直接和像素模型的 bpd 比較。
Teacher forcing、因果遮罩與曝光偏差
白話版:教師強制在訓練時提供真實前綴,取樣時則使用生成前綴;輸入位移與遮罩須隱藏各預測的目標。
使用 teacher forcing 時,訓練損失中的每個條件分布都以真實的前文計算。由於整張訓練影像都在手上,只要禁止位置 讀取位置 ,所有 個條件分布就能在一次前向傳遞中算完。因果 transformer 用注意力遮罩做到這一點;PixelCNN 則用遮罩過的卷積核。
常見的輸入慣例有兩種,遮罩必須與慣例相符:
- 在位移輸入(shifted-input)的解碼器中,輸入
[BOS, x1, x2, ...],預測[x1, x2, x3, ...]。這時包含對角線的下三角遮罩是正確的,因為位置 的輸入是前一個元素。 - 在接收未位移值的模型中,依賴關係必須嚴格在前。若包含對角線,網路就能直接複製它該預測的值。
推論時,先前抽樣的錯誤會進入後續步驟的上下文。這種訓練與推論的落差常稱為曝光偏差(exposure bias)。它不會讓最大似然變成錯的(分解依然精確),但對不完美的模型和長序列確實有實務影響:影像版面一開始的小錯,可能把後續步驟推進訓練中從未出現過的情境。
像素模型:PixelRNN 與 PixelCNN
白話版:把每個像素的強度當成 256 類的分類問題,輸入是它上方和左方的所有像素。
PixelRNN 與 PixelCNN 由 van den Oord、Kalchbrenner 與 Kavukcuoglu 在同一篇論文中提出 [2]。兩者都用 256 類 softmax 而不是高斯分布來建模每個 8 位元值,因此分布可以是多峰的(像素可以「要嘛黑、要嘛白,但不是灰」)。色彩則在每個像素內部採固定順序:先紅、再綠、再藍,讓綠色可以依賴紅色,藍色可以依賴兩者。PixelRNN 使用二維 LSTM 層(Row LSTM 與 Diagonal BiLSTM),依賴範圍可能沒有上限;PixelCNN 則以堆疊的遮罩卷積取代,感受野有限,但因為所有位置可以平行計算,訓練快得多。
遮罩卷積
遮罩卷積把卷積核乘上一個二值遮罩,將「未來」位置的權重設為零。在 [2] 中,遮罩 A 只用在第一層:它排除中心像素,所以第一層永遠看不到它要預測的值(彩色時,也只看得到已預測的通道)。遮罩 B 用在之後的所有層:它允許中心位置,因為第一層之後,中心的特徵已經只匯總了較早的像素。正式地說,對中心在 、 的 卷積核,
其中 是卷積核的列索引, 是行索引。下面的程式建立兩種遮罩、堆疊五層,並用梯度找出 影像中,哪些輸入像素能影響中心位置的輸出。
程式碼 · Python · 30 行
import torch
from torch import nn
from torch.nn import functional as F

class MaskedConv2d(nn.Conv2d):
    """PixelCNN-style masked convolution for one channel (raster order)."""
    def __init__(self, cin, cout, k, mask_type):
        super().__init__(cin, cout, k, padding=k//2, bias=False)
        mask = torch.ones(k, k)
        c = k//2
        mask[c, c + (mask_type == "B"):] = 0   # centre (type A) and pixels to its right
        mask[c+1:] = 0                         # all rows below
        self.register_buffer("mask", mask)
    def forward(self, x):
        return F.conv2d(x, self.weight*self.mask, padding=self.padding)

torch.manual_seed(0)
layers = [MaskedConv2d(1, 8, 3, "A"), nn.Tanh()]
for _ in range(4):                            # 5 layers: reach of 5 pixels
    layers += [MaskedConv2d(8, 8, 3, "B"), nn.Tanh()]
net = nn.Sequential(*layers, MaskedConv2d(8, 1, 1, "B"))
print(net[0].mask.int())
x = torch.rand(1, 1, 9, 9, requires_grad=True)
net(x)[0, 0, 4, 4].backward()                 # logit for pixel (row 4, col 4)
dep = (x.grad[0, 0].abs() > 0).int()
print(dep)
later = torch.zeros(9, 9, dtype=torch.bool)
later[4, 4:] = True; later[5:] = True
assert dep[later].sum() == 0                  # never reads itself or later pixels
print("earlier pixels never seen (blind spot):", int(((dep == 0) & ~later).sum()))
assert 通過:目標位置本身及之後的像素都不會影響它的 logit,所以模型是合法的自迴歸分解。但輸出還揭露了另一件事:有六個在光柵順序中較早的像素,在目標右上方排成階梯狀,梯度為零。這就是堆疊遮罩卷積的盲點(blind spot)(圖 2):每一層的感受野往左上方擴張,右上方的區域卻永遠到不了。模型依然正確,只是得到的資訊比它能得到的少。
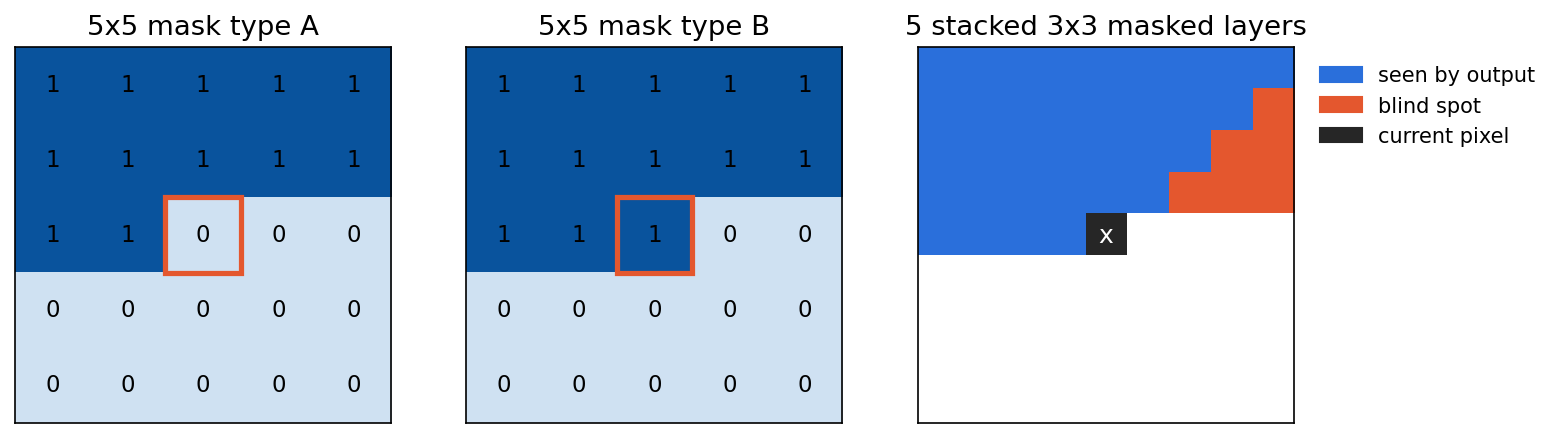
van den Oord 等人的 Gated PixelCNN [3] 把網路拆成兩個堆疊來消除盲點:垂直堆疊不受限制地看到目前這列以上的所有列,水平堆疊看到目前這列中直到目前像素為止的部分,兩者在每層之後合併。它也把 ReLU 換成閘控單元 ,其中 是卷積, 是 logistic sigmoid, 是逐元素乘法;並示範如何以類別標籤或嵌入向量為條件。加上這些改變後,PixelCNN 在 ImageNet [23] 上達到與 PixelRNN 相當的似然,計算成本卻低得多 [3]。
程式:最小的自迴歸模型
遮罩卷積只是強制因果性的一種方式,也不一定需要 transformer。以下完整的 CPU 實驗產生 二值影像,每一列都重複同樣四個隨機位元。一個帶遮罩的線性層,用嚴格下三角遮罩排除目前像素與之後所有像素,直接學習條件分布。
程式碼 · Python · 34 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
torch.set_num_threads(1)
class BinaryAR(nn.Module):
    def __init__(self, n=16):
        super().__init__()
        self.weight = nn.Parameter(torch.zeros(n, n))
        self.bias = nn.Parameter(torch.zeros(n))
        self.register_buffer("mask", torch.tril(torch.ones(n, n), diagonal=-1))
    def forward(self, x):
        return F.linear(x, self.weight*self.mask, self.bias)

model = BinaryAR()
opt = torch.optim.Adam(model.parameters(), lr=.04)
for step in range(600):
    first_row = torch.randint(2, (128, 4)).float()
    x = first_row.repeat(1, 4)
    loss = F.binary_cross_entropy_with_logits(model(x), x)
    opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
    a = torch.rand(2, 16)
    b = a.clone(); b[:, 8:] = torch.rand(2, 8)
    assert torch.allclose(model(a)[:, :9], model(b)[:, :9])
    samples = torch.zeros(8, 16)
    for i in range(16):
        p = model(samples)[:, i].sigmoid()
        samples[:, i] = torch.bernoulli(p)
    rows = samples.reshape(-1, 4, 4)
    print("one generated image:\n", rows[0].int())
    print("repeat agreement:", (rows[:, 1:] == rows[:, :1]).float().mean().item())
assert 檢查因果性:改變第 8 個位置以後的輸入,不會改變位置 0 到 8 的 logit,因為這些輸出只讀較早的輸入。訓練之後,後面各列與第一列的一致率達到 1.0,而第一列仍保持隨機(模型不應該背下某一列)。
真實分布有 16 張機率相同的影像,所以熵是每張 位元,也就是每像素 0.25 位元。後面幾列不含任何新的不確定性。若模型把 16 個像素都當成獨立的公平硬幣,每張影像需要 16 位元。16 與 4 位元之間的差距,正是自迴歸模型能捕捉、而獨立像素模型捕捉不到的結構。
為什麼像素模型擴展不下去
一張 的 RGB 影像有 個值,所以像素層級的取樣需要大約二十萬次循序的網路計算。大部分似然也被花在細微、局部容易預測的細節上,而人們真正注意的整體構圖只占位元的一小部分。Image GPT [11] 證明,在低解析度影像上以自迴歸方式預測像素的純序列 transformer,學到的特徵在線性探測(linear probing)下遷移效果很好;但在較高解析度下,像素路線依然太昂貴。下一步就是學習更短、更有意義的序列。
離散視覺 token:VQ-VAE 與 VQGAN
白話版:另外訓練一個網路,把影像壓縮成一小格來自學習字典的「單字」,然後對單字做自迴歸,而不是對像素。
VQ-VAE
VQ-VAE [4] 有一個編碼器,在降取樣網格的每個位置輸出特徵向量 ;一個由 個學習向量組成的 codebook ;以及一個解碼器。每個特徵都被替換成最近的 code:
影像於是由 值組成的整數網格表示。訓練目標是
其中 是解碼器, 是停止梯度(stop-gradient)運算子(前向傳遞時是恆等函數,反向傳遞時梯度為零), 是 commitment 項的小權重(下面的程式用 0.25)。這裡把重建項寫成平方誤差;也可以換成任何重建似然。
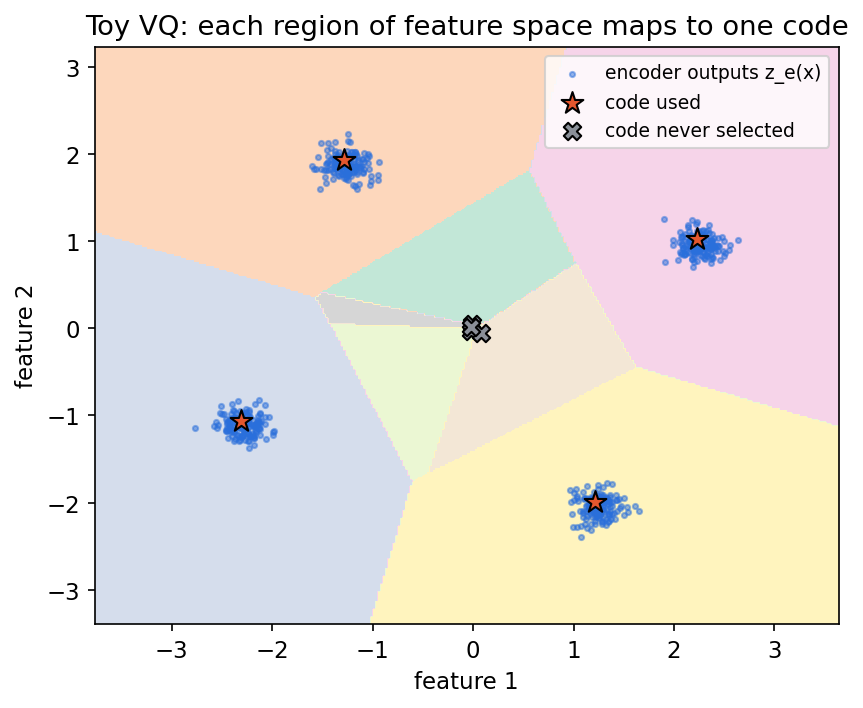
三項各司其職。codebook 項把選中的 code 拉向編碼器輸出,就像 k-means 的更新。commitment 項把編碼器拉向它的 code,讓編碼器輸出不會離 codebook 太遠。argmin 沒有有用的梯度,所以重建損失的梯度要透過直通估計器(straight-through estimator)傳到編碼器:前向傳遞使用 ,反向傳遞則把 的梯度原封不動複製給 ,彷彿量化是恆等函數。在程式中只要一行:z_q = z_e + (e - z_e).detach()。
下面的玩具例子在四個群集上訓練一個二維「編碼器」、codebook 與解碼器,共有八個 code 可用:
程式碼 · Python · 37 行
import torch
from torch import nn
from torch.nn import functional as F

def quantize(z_e, codebook, beta=0.25):
    """z_e: (n, d) encoder outputs; codebook: (K, d). Returns z_q with straight-through gradient."""
    dist = torch.cdist(z_e, codebook)            # (n, K) Euclidean distances
    idx = dist.argmin(1)                         # nearest code index per vector
    e = codebook[idx]
    codebook_loss = F.mse_loss(e, z_e.detach())  # moves codes toward encoder outputs
    commit_loss = F.mse_loss(z_e, e.detach())    # keeps the encoder near its code
    z_q = z_e + (e - z_e).detach()               # forward: e; backward: identity
    return z_q, idx, codebook_loss + beta*commit_loss

torch.manual_seed(0)
torch.set_num_threads(1)
centres = torch.tensor([[2., 0.], [-2., 0.], [0., 2.], [0., -2.]])
encoder = nn.Linear(2, 2)                        # toy "encoder" and "decoder"
decoder = nn.Linear(2, 2)
codebook = nn.Parameter(torch.randn(8, 2)*.1)    # K = 8 codes, 4 are enough
opt = torch.optim.Adam([*encoder.parameters(), *decoder.parameters(), codebook], lr=.03)
for step in range(800):
    x = centres[torch.randint(4, (256,))] + .1*torch.randn(256, 2)
    z_q, idx, vq_loss = quantize(encoder(x), codebook)
    loss = F.mse_loss(decoder(z_q), x) + vq_loss
    opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
    x = centres.repeat_interleave(100, 0) + .1*torch.randn(400, 2)
    z_q, idx, _ = quantize(encoder(x), codebook)
    print("reconstruction MSE:", round(F.mse_loss(decoder(z_q), x).item(), 4))
    print("codes used:", idx.unique().numel(), "of", len(codebook))
    print("codes per cluster:", [idx[i*100:(i+1)*100].unique().tolist() for i in range(4)])
z = torch.randn(3, 2, requires_grad=True)
z_q, _, _ = quantize(z, codebook.detach())
z_q.sum().backward()
print("straight-through gradient:", z.grad[0].tolist())
輸出顯示重建 MSE 約 0.0096,只用了 8 個 code 中的 4 個(每個群集一個),直通梯度是 [1.0, 1.0]。這些數字藏著兩個教訓。重建誤差幾乎正好等於群集內的雜訊變異數 :量化保留了「屬於哪一群」,丟掉了「在群內哪個位置」。另外,一半的 codebook 是死碼(dead code):從未被選到的 code 收不到 codebook 梯度,永遠不會移動(圖 3)。在真正的 tokenizer 中,codebook 使用率低會浪費容量,是需要監控的典型失敗。
兩個階段:先 tokenizer,再先驗
VQ-VAE 本身只是自編碼器,並不會告訴你哪些 token 網格比較可能出現。因此生成分成兩個階段(圖 4)。第一階段訓練 tokenizer。第二階段把它凍結,把每張訓練影像轉成索引網格,再對 個索引訓練自迴歸模型 。取樣時,先從先驗抽出索引網格,再解碼。[4] 中的先驗是建立在 code 上的 PixelCNN;VQ-VAE-2 [10] 使用兩層 code 圖(較粗的上層與較細的下層)搭配 PixelCNN 式先驗,產生了多樣且高保真度的 ImageNet 樣本。
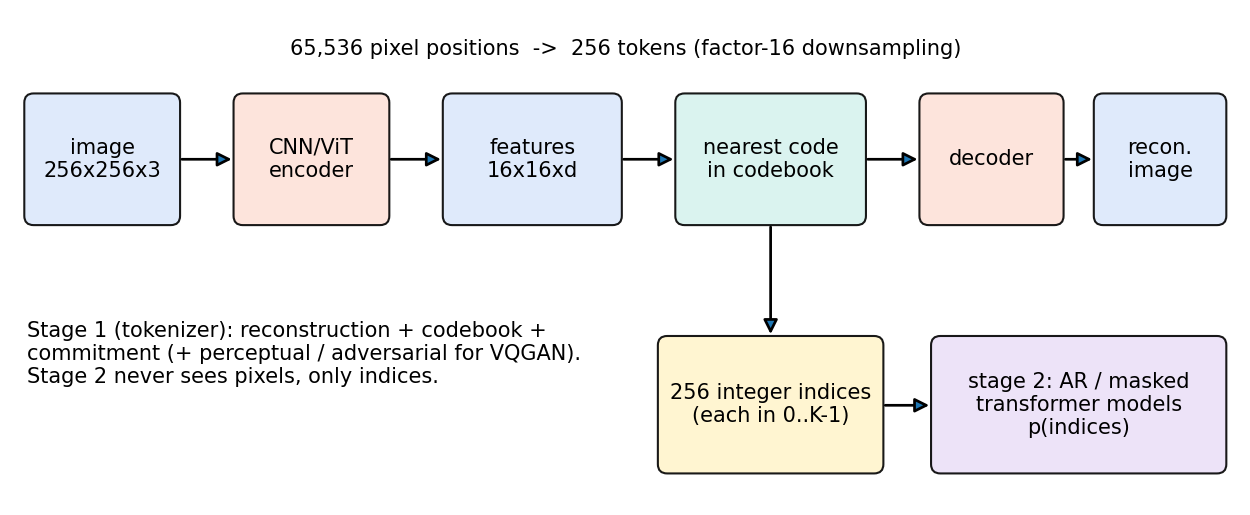
簡單的算術說明了它的吸引力。若 tokenizer 把 影像在每個方向降取樣 16 倍,先驗看到的是 個 token,而不是 65,536 個像素位置(或 196,608 個色彩值)。自注意力的成本隨序列長度平方成長,這就是可行與不可行之間的差別。
VQGAN:感知導向的 token
Esser、Rombach 與 Ommer 的 VQGAN [5] 保留兩階段設計,但訓練 tokenizer 時除了重建損失,還加上感知損失(perceptual loss)與以區塊為單位的對抗損失(patch-based adversarial loss),並用 transformer 對 token 網格建模。對抗與感知項讓解碼器能從很少的 token 產生清晰、逼真的紋理,因為 token 不再需要精確編碼每個像素,只需要編碼足夠的資訊,讓解碼器產生一個合理的版本。這就是 VQGAN 式 tokenizer 成為 token 式生成標準前端的原因。注意分工:tokenizer 使用對抗訓練,先驗則是用最大似然訓練的普通自迴歸模型。
Codebook 的問題與替代方案
真實的 tokenizer 反覆遇到三個問題:死碼(如玩具例子)、tokenizer 能重建的內容與先驗能建模的內容之間的落差,以及文字、細線等小細節的遺失。幾種設計分別回應這些問題:
- ViT-VQGAN [12] 使用 Vision Transformer 的編碼器與解碼器,在低維的分解(factorized)空間中查找 code,並對 code 與特徵做 正規化,改善了 codebook 使用率與重建品質。
- RQ-VAE [15] 使用殘差量化(residual quantization):每個位置由一小疊 code 表示,每個 code 量化前面幾個 code 沒表示到的部分。這讓空間網格可以更粗(序列更短),保真度卻相近。
- FSQ [16](有限純量量化,finite scalar quantization)把特徵投影到少數幾維,每一維四捨五入到少數固定的值。隱含的 codebook 大小是各維層級數的乘積;沒有會崩潰的學習 codebook,也不需要 commitment 損失。
壓縮一定會造成瓶頸。請分別量測 codebook 使用率、重建品質與生成器品質:生成器無法產生 tokenizer 表示不了的細節。
選讀:VQ-VAE(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
建立在 token 上的自迴歸 transformer
白話版:僅解碼器 Transformer 可像預測文字 token 一樣預測下一個視覺 token;視覺 tokenizer 與解碼器決定 token 表示什麼。
從像素到 token
Image GPT [11] 把 GPT 式 transformer 直接用在低解析度像素序列上。它的主要發現是關於表徵學習:只訓練來預測下一個像素的模型,其特徵在上面訓練線性分類器時遷移得很好。改用 token 而不是像素,序列短到足以在更高解析度下生成。VQGAN transformer [5] 是經典例子:一個在 VQGAN 索引上以光柵順序運作的類 GPT 模型,讓 transformer 能合成若以像素序列表示會長得無法處理的高解析度影像。
把文字生成影像當成翻譯:Parti
Parti [13] 把文字生成影像視為機器翻譯。transformer 編碼器讀取文字提示;transformer 解碼器以它為條件,自迴歸地生成 ViT-VQGAN 影像 token [12]。報告把這個序列到序列(sequence-to-sequence)模型擴展到 200 億參數,並提出 PartiPrompts:一個涵蓋多種內容類別、超過 1,600 個英文提示的基準。
原封不動的語言模型架構:LlamaGen
LlamaGen [14] 問的是:沒有任何影像專屬歸納偏置的標準語言模型架構,擴大規模後能不能把影像生成好?它在 16 倍降取樣、 個 8 維 code 的 VQ tokenizer 上,使用 Llama 式 [24] 解碼器(RMSNorm 前置正規化、SwiGLU 前饋層、二維旋轉位置編碼)。類別標籤或投影後的文字嵌入作為前綴(prefix)token 輸入,之後以光柵順序生成。論文釋出 1.11 億到 31 億參數的類別條件模型,並指出標準的 LLM 推論服務軟體(vLLM)能加速推論。它更廣的訊息是架構重用:除了 tokenizer,影像生成器幾乎可以和文字模型共用一切。
自迴歸模型的 classifier-free guidance
Classifier-free guidance(CFG)[18] 原本是為擴散模型提出的,但可以直接搬到 AR 的 logit 上。訓練時,條件 會隨機被替換成學習出來的空(null)嵌入,讓同一個網路同時學會條件與無條件預測。取樣的每一步計算兩組 logit 再組合:
其中 是有條件時的下一個 token logit, 是空條件時的 logit, 是 guidance 強度; 就回到普通的條件模型。LlamaGen 使用的正是這個形式 [14]。較大的 通常提升對提示或類別的貼合度與樣本銳利度,代價是多樣性。除非把兩次計算合併成一個批次,否則它也會讓每步計算量加倍,所以只看步數會低估成本。
Next-scale 預測(VAR)
白話版:不再依固定閱讀順序預測下一個 token,而是在所有較粗版本的條件下,預測整張影像下一個更清晰的版本。
光柵順序會造成奇怪的依賴:影像左上角在完全不知道右下角的情況下被生成。VAR(Visual AutoRegressive modeling)[6] 主張這種單向順序違背影像 token 之間的雙向相關與空間局部性,因此改用解析度遞增的 token 圖 上的由粗到細順序:
其中 是 的 token 索引網格, 是 , 是完整的潛在解析度。在較粗的圖給定之下, 的所有 token 平行預測,所以循序步數等於尺度數,而不是 token 數。
tokenizer 是方法的一部分。VAR 的多尺度 VQ 編碼器以殘差方式運作:從編碼器特徵圖 開始,對 ,把 降取樣到 ,量化得到 (所有尺度共用一個 codebook),把查到的 code 升取樣回完整解析度,經過一個小卷積 ,再從 減掉,然後進入下一個尺度 [6]。因此每個尺度編碼的是較粗尺度還沒解釋的部分。單純把普通 token 圖縮放並不能重現這個方法。
訓練時,區塊式因果(block-wise causal)注意力遮罩讓 的每個 token 可以注意 的所有 token,但看不到更細的尺度;推論時以 KV cache 儲存較粗的尺度。VAR 也使用 CFG。論文報告在類別條件的 ImageNet 上,VAR 把其 AR 基準的 FID 從 18.65 改善到 1.73,推論也更快,而且模型呈現類似語言模型的冪律擴展趨勢 [6]。VAR 獲得 NeurIPS 2024 最佳論文獎。和往常一樣,這些數字只適用於論文的資料、解析度與訓練設定。
尺度內的平行預測本身就是一個假設: 中的 token 在給定 時被獨立抽樣。遮罩模型一節會在玩具問題上展示這個假設的代價。
遮罩生成模型(MaskGIT 與 Muse)
白話版:從一格全是空白的網格開始。每一輪同時猜所有空格,只保留最有把握的猜測,其餘的再塗回空白。
MaskGIT [8] 使用與 AR 模型相同的 VQ token,但改用能看到所有位置的雙向 transformer。訓練目標是遮罩 token 預測:選一個遮罩比例,把這個比例的 token 換成特殊的 [MASK] token,然後在被遮住的位置上最小化交叉熵,
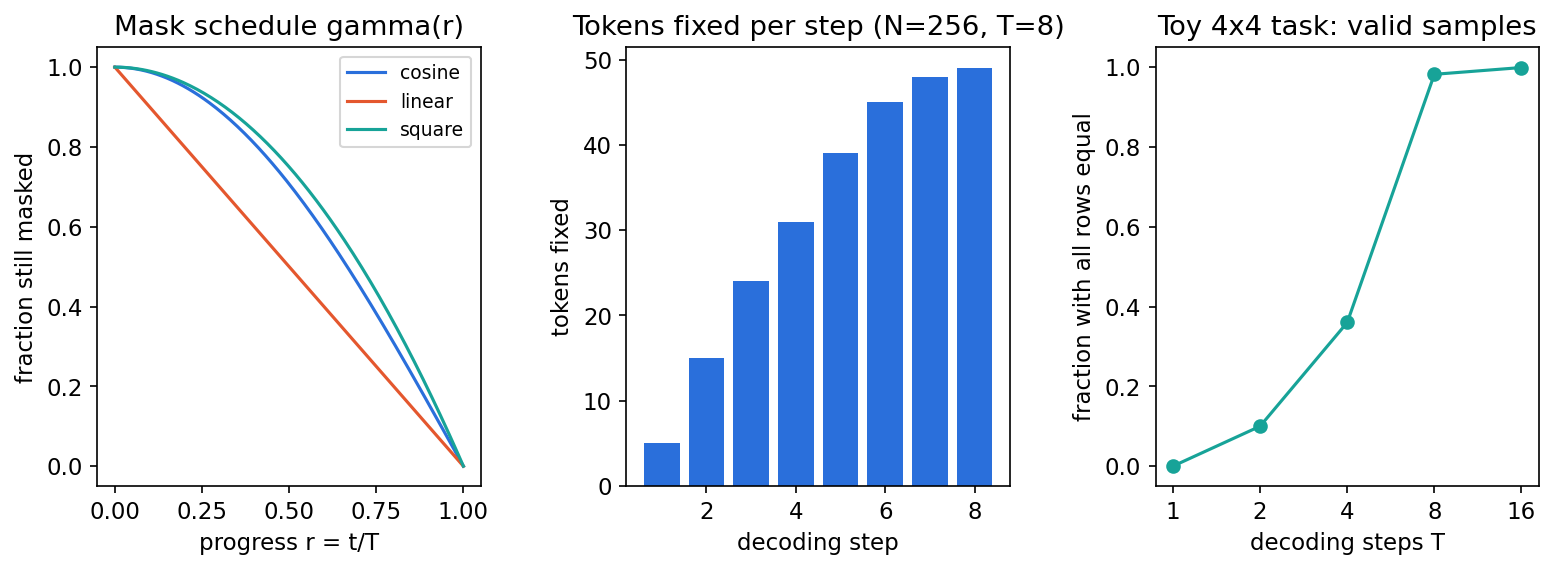
其中 是 token 網格, 是被遮住的位置集合, 是沒被遮住的 token。遮罩比例取為 ,其中 ,遮罩排程(mask schedule) 從 1 遞減到 0。
生成進行 次迭代。第 次迭代時,模型平行預測並抽樣所有被遮住的 token;每個樣本的機率就是它的信心(confidence)。這次迭代後仍保持遮住的 token 數為
是 token 總數;信心最低的 個新 token 會被重新遮住,其餘的則固定下來。MaskGIT 比較了數種排程,選擇餘弦排程 :早期(模型所知甚少時)只固定少數 token,後期才固定較多;它以 16×16 的 token 網格和 1,024 個條目的 codebook,在 8 次迭代內生成 影像 [8]。Muse [17] 把同樣的想法擴展到文字生成影像,以預訓練大型語言模型的文字嵌入作為遮罩 token transformer 的條件。
MaskGIT 不是一般由左到右的鏈鎖法則自迴歸:順序是依信心即時決定的,而且同一步會抽樣好幾個 token。這些同時產生的 token 在目前上下文給定下是獨立抽樣的。下面的玩具例子顯示這何時會造成影響。它在前面那個重複列的 影像上訓練一個小型雙向網路,並用餘弦排程解碼。
程式碼 · Python · 49 行
import math
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
torch.set_num_threads(1)
N, MASK = 16, 2                                   # 16 binary tokens; state 2 = [MASK]
gamma = lambda r: math.cos(math.pi*r/2)          # cosine schedule: fraction still masked
net = nn.Sequential(nn.Flatten(), nn.Linear(3*N, 128), nn.ReLU(), nn.Linear(128, N))

def data(n):                                      # 4x4 images whose rows repeat
    return torch.randint(2, (n, 4)).repeat(1, 4)

def logits(tokens):                               # sees every position: bidirectional
    return net(F.one_hot(tokens, 3).float())

opt = torch.optim.Adam(net.parameters(), lr=3e-3)
for step in range(1500):
    x = data(256)
    ratio = torch.tensor([gamma(r) for r in torch.rand(256).tolist()])
    n_mask = (ratio*N).ceil().clamp(min=1)
    masked = torch.rand(256, N).argsort(1) < n_mask[:, None]   # random positions
    inp = torch.where(masked, MASK, x)
    loss = F.binary_cross_entropy_with_logits(logits(inp)[masked], x[masked].float())
    opt.zero_grad(); loss.backward(); opt.step()

@torch.no_grad()
def generate(n, T=4):
    tokens = torch.full((n, N), MASK)
    for t in range(1, T+1):
        p = logits(tokens).sigmoid()
        sample = torch.bernoulli(p).long()
        conf = torch.where(sample == 1, p, 1-p)               # prob. of the drawn value
        still = tokens == MASK
        conf = torch.where(still, conf, torch.inf)            # never re-mask fixed tokens
        proposal = torch.where(still, sample, tokens)
        n_keep_masked = math.floor(gamma(t/T)*N)              # 0 after the last step
        order = conf.argsort(1)                               # least confident first
        remask = torch.zeros_like(still)
        remask.scatter_(1, order[:, :n_keep_masked], True)
        tokens = torch.where(remask, MASK, proposal)
    return tokens

for T in (1, 2, 4, 8, 16):
    rows = generate(1000, T).reshape(-1, 4, 4)
    agree = (rows[:, 1:] == rows[:, :1]).float().mean().item()
    valid = (rows == rows[:, :1]).all(2).all(1).float().mean().item()
    print(f"T={T:2d}  repeat agreement={agree:.3f}  valid images={valid:.3f}")
(程式用 floor 而不是論文中的上取整,好讓這個小例子在 時剩餘數量剛好是零。)輸出為:
程式碼 · 5 行
T= 1  repeat agreement=0.511  valid images=0.000
T= 2  repeat agreement=0.812  valid images=0.100
T= 4  repeat agreement=0.908  valid images=0.360
T= 8  repeat agreement=0.998  valid images=0.982
T=16 repeat agreement=1.000 valid images=0.999時,每個 token 都從全遮罩的上下文獨立抽樣,所以各列幾乎從不一致。迭代次數增加後,前幾個 token 早早被固定,後面的 token 可以以它們為條件;到 時幾乎每個樣本都合法。在自然影像上,同一輪解碼的 token 之間依賴較弱,所以少數幾次迭代就夠用;但較少步數與較多獨立假設之間的取捨是真實存在的(圖 5)。
連續 token 與擴散條件分布(MAR)
白話版:自迴歸定義條件順序,小型擴散模型則可表示各連續 token 的條件分布。
向量量化有損,而且不好訓練。Li 等人 [7] 指出,自迴歸需要的是一種建模 的方法,不一定是類別分布。他們讓 AR(或遮罩 AR)transformer 為每個連續值 token 輸出條件向量 ,並以擴散損失(diffusion loss)訓練一個小型 MLP 去噪器 :
其中 , 是擴散時間步, 是 ML 08 中的雜訊排程。梯度也會經由 流進 transformer。要抽樣一個 token,就以 為條件執行小型去噪器的反向擴散過程;temperature 用來縮放注入的雜訊。論文的主要變體 MAR(masked autoregressive)採隨機順序、每步預測一組 token,把 MaskGIT 的外層結構和內層的連續取樣器結合在一起 [7]。
因此,「AR 對擴散」並不是二選一。一個系統可以用自迴歸決定 token 的順序與分組,再用擴散抽樣每一組。同樣地,語言解碼器可以自迴歸地生成描述影像的文字,而完全不生成像素;統一這些方法的是分解的概念,而不是某種特定的輸出類型。
取樣、temperature 與快取
白話版:訓練好的模型在每一步給出一個分布;取樣器決定抽樣時要多大膽,快取則避免重算過去。
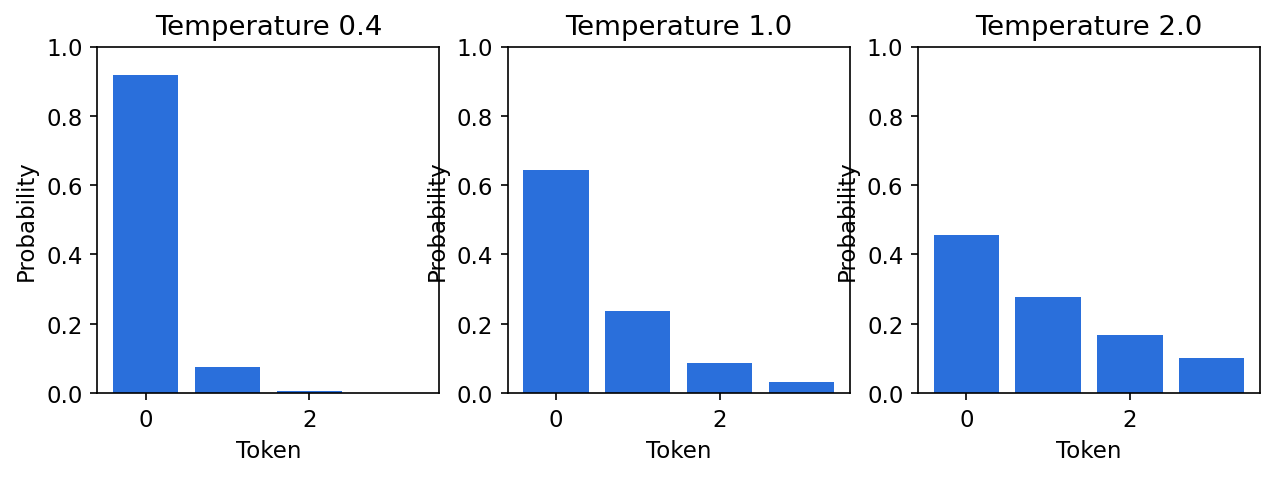
對 個可能值的 logit ,temperature 會重新縮放分布:
較低的 讓機率集中在最高的幾個值;較高的 則讓機率分散(圖 6)。Top- 取樣只保留最高的 個 logit;top-(nucleus)取樣保留機率總和達到 的最小集合。兩者都會把剩下的部分重新正規化。
程式碼 · Python · 22 行
import torch

def filtered_probs(logits, temperature=1.0, top_k=None, top_p=None):
    """Return the (renormalized) distribution actually sampled from."""
    logits = logits / temperature
    if top_k is not None:                               # keep the k largest logits
        kth = logits.topk(top_k).values[..., -1, None]
        logits = logits.masked_fill(logits < kth, -torch.inf)
    if top_p is not None:                               # smallest set with mass >= p
        sorted_logits, order = logits.sort(descending=True)
        cum = sorted_logits.softmax(-1).cumsum(-1)
        drop = cum - sorted_logits.softmax(-1) >= top_p  # mass before this token already >= p
        sorted_logits = sorted_logits.masked_fill(drop, -torch.inf)
        logits = torch.empty_like(logits).scatter(-1, order, sorted_logits)
    return logits.softmax(-1)

logits = torch.tensor([2.0, 1.0, 0.0, -1.0])
for name, kw in [("T=1", {}), ("T=0.5", {"temperature": .5}), ("T=2", {"temperature": 2.}),
                 ("top-k=2", {"top_k": 2}), ("top-p=0.8", {"top_p": .8})]:
    p = filtered_probs(logits, **kw)
    entropy = -(p[p > 0]*p[p > 0].log2()).sum().item()
print(f"{name:10s}", [round(v, 3) for v in p.tolist()], f"entropy={entropy:.2f} bits")模型本身的分布()熵為 1.37 位元; 把它降到 0.66 位元, 提高到 1.80 位元。在這個例子中,top- 與 top- 都保留最可能的兩個值(第一個值的機率 0.644 小於 0.8,所以還需要第二個)。這些設定全都改變了實際抽樣的分布,因此不要把取樣器的視覺品質和模型的似然混為一談。
KV cache
在因果 transformer 中,新增一個 token 時,較早 token 的 key 與 value 不會改變。KV cache 把它們存起來,因此每一步只需計算最新 token 的 query、key 與 value,再對快取做注意力:
程式碼 · Python · 24 行
import torch
from torch.nn import functional as F

torch.manual_seed(0)
d, n = 8, 6
Wq, Wk, Wv = (torch.randn(d, d) for _ in range(3))
x = torch.randn(n, d)                                 # embeddings of n tokens

# Full causal attention over the whole sequence (what training computes).
q, k, v = x@Wq, x@Wk, x@Wv
mask = torch.ones(n, n).tril().bool()
scores = (q@k.T/d**.5).masked_fill(~mask, -torch.inf)
full = scores.softmax(-1)@v

# Incremental decoding: each step computes q, k, v for the newest token only.
K_cache, V_cache, outputs = [], [], []
for i in range(n):
    K_cache.append(x[i]@Wk); V_cache.append(x[i]@Wv)
    K, V = torch.stack(K_cache), torch.stack(V_cache)
    att = F.softmax((x[i]@Wq)@K.T/d**.5, -1)        # attends to tokens 0..i
    outputs.append(att@V)
assert torch.allclose(full, torch.stack(outputs), atol=1e-5)
print("cached decoding matches full causal attention")
print("dot products per step:", [i+1 for i in range(n)], "total:", n*(n+1)//2)
assert 確認快取解碼的結果與訓練時的因果輸出完全相同(這裡只有一層;真實模型會快取每一層、每個 head)。快取省去重算,卻沒有消除循序依賴,而且會隨序列長度線性成長。第 步仍要對 個快取的 key 做注意力,所以長度 的序列總注意力工作量是 ,對 呈平方成長。這就是更短的序列(更好的 tokenizer)與更少的循序步驟(next-scale 或遮罩解碼)如此重要的原因。
對影片而言,token 可以依空間與時間排序,或分組成區塊。這時快取、壓縮與時間順序主導了成本,而物件一致性與長時間漂移需要另外評估。
自迴歸與擴散的比較
白話版:兩個家族都把一個困難的生成問題拆成許多比較簡單的問題。AR 把影像切成小塊;擴散則把雜訊程度切成多個步驟。
| 面向 | 自迴歸(token/尺度) | 遮罩生成 | 擴散/flow(ML 08) |
|---|---|---|---|
| 每步生成什麼 | 一個 token(或一個尺度) | 依信心選出的一組 token | 對整個樣本的一次修正 |
| 循序步數 | token 數或尺度數 | 固定且通常很少() | 求解器步數(NFE) |
| 常見表示 | 離散 code(或搭配擴散頭的連續 token [7]) | 離散 code | 連續的像素或潛在表示 |
| 訓練目標 | 精確 NLL(交叉熵) | 遮罩交叉熵 | 去噪/速度回歸(與 ELBO 相關) |
| 似然 | 在 token 上精確 | 不是單一精確的鏈鎖法則似然 | 下界或基於 ODE 的估計 |
| 天然優勢 | 與 LLM 共用架構與部署;容易與文字混合 | 步數少;修補與編輯容易 | 影像品質強;guidance 彈性大 |
| 常見弱點 | 循序解碼長;tokenizer 瓶頸;錯誤累積 | 同一步內的獨立假設 | 除非蒸餾,否則網路計算次數多 |
有三點讓這張表保持公允。第一,家族之間會混合:MAR [7] 在 AR 迴圈中放了一個擴散模型,而潛在擴散也依賴一個類似 tokenizer 的學習自編碼器。第二,某個家族「勝過」另一個的說法(例如 LlamaGen 的論文標題 [14],或 VAR 與 DiT 的比較 [6]),只在特定基準、tokenizer、模型大小與 guidance 設定下成立,並非普遍成立。第三,成本應該以網路計算次數、guidance 計算次數、序列長度與實際延遲比較,不能只看「步數」。
現代觀點
這個領域已經從原始像素走向學習出來的表示,從固定的光柵順序走向彈性的預測單位,從獨立的影像生成器走向能同時讀寫文字與影像的模型。以下幾篇綜述描繪了這片版圖:
- Xiong 等人 [1](TMLR)是最直接的視覺自迴歸綜述。它依表示方式分類(以像素、token、尺度為基礎的模型),也就是本章採用的分類,並涵蓋影像、影片、3D、多模態生成,以及具身智慧與醫學等應用。
- Bond-Taylor 等人 [19](TPAMI 2022)並列比較 VAE、GAN、正規化流(normalizing flow)、能量模型與自迴歸模型,包括執行時間、樣本多樣性與架構限制上的取捨。它把 AR 模型放進更大的生成模型版圖中:精確的似然與穩定的訓練,代價是緩慢的循序取樣。
- Li 等人 [20](TPAMI 2026)綜述多模態 LLM 的離散 tokenization,整理向量量化的各種變體,以及它們在傳統系統、單一模態 LLM 與多模態 LLM 中的應用,並討論 codebook 崩潰與梯度估計不穩定等問題。
- Jia 等人 [22] 綜述離散 tokenizer 在生成、理解、推薦與檢索中的應用,先拆解 tokenizer 的子模組與運作機制,再依應用整理方法,並列出現有限制與未來方向。
- Zhao 等人 [21] 綜述統一的多模態理解與生成模型,把它們分成以擴散為基礎、以自迴歸為基礎,以及 AR 與擴散混合三類,這正是 2025–2026 年大部分研究活動所在。
最新進展(2023–2026)。在經過查證的文獻中,有三條主線特別突出。(i) 在更好的 tokenizer 上擴展單純的 AR transformer:LlamaGen [14] 顯示,幾乎沒有影像專屬設計的語言模型架構,只要 tokenizer 與訓練夠好,就能在類別條件 ImageNet 上具競爭力。(ii) 改變預測單位:VAR 的 next-scale 預測 [6] 與 MaskGIT、Muse 的遮罩解碼 [8], [17] 減少了循序步數;MAR [7] 用每個 token 一個擴散頭,去掉了向量量化。(iii) 統一的多模態模型:同一套下一個 token 預測機制在單一模型中生成文字與影像 token,tokenizer 也被設計成同時服務理解與生成 [20], [21]。我們的解讀是:選擇表示方式與預測單位,如今至少和選擇骨幹網路一樣重要。
開放問題。這些綜述反覆指出以下幾點:
- Tokenizer 品質。重建能力決定了生成品質的上限;小字、人臉與精細幾何通常是最先受損的部分。如何在不丟細節的前提下提升 codebook 使用率與語意結構,仍是活躍的研究主題 [20], [22]。
- 離散與連續 token。離散 token 適合 LLM 的機制;連續 token 重建得更好,但需要連續的條件模型,例如擴散頭 [7]。
- 速度。循序解碼受延遲限制。next-scale、遮罩與平行解碼以獨立假設換取更少步數。
- 評估。token 似然、FID 類指標、提示貼合度與人類偏好衡量的是不同的東西;有損 tokenizer 的 token 似然並不是像素似然。
- 影片與長上下文。token 數量隨時間暴增,時間一致性、物件恆存性與漂移都需要專門的評估 [1]。
重點整理
- 自迴歸是一種分布分解,不限定使用 Transformer 架構。
- 教師強制提供真實前綴;因果遮罩與位移輸入須防止目標洩漏。
- token 化縮短序列,也限制解碼器的表示能力。
- token、尺度與遮罩預測採用不同分解或更新規則,須比較其相依假設。
- 溫度與截斷改變取樣機率;快取重用運算,而不改變預期的條件分布。
- 以相同資料、表示、引導及成本條件,比較自迴歸與擴散流程。
練習
- 洩漏答案。把
BinaryAR的遮罩改成包含對角線(diagonal=0)。說明為什麼訓練損失可以降到接近零,取樣卻會失敗。
提示
每個輸出現在都能讀到自己的目標並直接複製,所以訓練損失崩落。取樣時,計算目前位置的 logit 時它的值還是 0(尚未抽樣),學到的「複製」規則因此產生無意義的結果。程式中的因果性 assert 也會失敗。
- 每維位元數。對重複列的 二值資料,計算以下情況的每像素位元數:(a) 真實分布;(b) 把每個像素當成獨立公平硬幣的模型;(c) 完美學會第一列、但把後面各列當成獨立公平硬幣的模型。
提示
(a) 4 位元 / 16 像素 = 0.25。(b) 16 / 16 = 1.0。(c) 每張 4 + 12 = 16 位元,同樣是每像素 1.0 位元:學會第一列的邊際分布沒有幫助,因為它的位元本來就是均勻的。所有的改善都來自建模後面各列對第一列的依賴。
- Tokenizer 預算。一張 影像以 8 倍或 16 倍降取樣做 tokenization。分別計算序列長度,以及完整自注意力的成本比。用 16 倍時可能失去什麼?
提示
對 個 token。注意力成本隨長度平方成長,所以比值是 16。用 16 倍時,每個 token 要描述一個 區塊,除非 codebook 或解碼器能補償,否則小字和細線更容易遺失。
- 盲點。把遮罩卷積的程式改成 7 層、 輸入、目標在中心。有多少較早的像素永遠看不到?接著畫出垂直堆疊加水平堆疊如何消除它們。
提示
盲點是目標右上方、往左上擴張的感受野永遠到不了的階梯區域;計算光柵順序中較早、梯度為零的格子,答案是 10。垂直堆疊看到上方完整的列(沒有左右限制),並把結果送進只處理目前這列的水平堆疊,於是每個較早的像素都變得可達。
- 遮罩解碼步數。用 、餘弦排程、、,計算每一步固定多少 token。為什麼排程一開始只固定少數 token?
提示
剩餘遮罩數為 252、237、213、182、143、98、50、0,所以每步固定 4、15、24、31、39、45、48、50 個 token(圖中使用 floor,數字最多差一)。在精確算術中 ;但浮點數的 是極小的正數,直接取上整數會留下一個被遮住的 token,這也是程式改用 floor 的另一個原因。一開始模型的上下文很少,平行猜測最不可靠、也最可能互相矛盾;只固定少數 token,能讓後面的步驟以它們為條件。
- 為方法分類。對 PixelCNN、VQGAN transformer、Parti、LlamaGen、VAR、MaskGIT 與 MAR,寫出預測單位、表示方式(像素、離散 token、連續 token、多尺度圖)、條件分布類型,以及 token 網格所需的循序步數。
提示
PixelCNN:光柵順序的像素,256 類 softmax,每個值一步。VQGAN transformer、Parti、LlamaGen:光柵順序的離散 token,codebook 上的 softmax,256 步。VAR:多尺度離散圖,每個 token 一個 softmax、尺度內平行,每個尺度一步。MaskGIT:離散 token,雙向遮罩預測, 步(論文中為 8)。MAR:隨機順序分組的連續 token,每個 token 一個擴散頭,步數等於組數(每組另有內層擴散步驟)。
參考文獻
- J. Xiong, G. Liu, L. Huang et al., “Autoregressive Models in Vision: A Survey,” Transactions on Machine Learning Research (TMLR), 2025 (arXiv:2411.05902, 2024). arXiv
- A. van den Oord, N. Kalchbrenner and K. Kavukcuoglu, “Pixel Recurrent Neural Networks,” in Proc. ICML, PMLR 48, 2016. PMLR
- A. van den Oord, N. Kalchbrenner, O. Vinyals, L. Espeholt, A. Graves and K. Kavukcuoglu, “Conditional Image Generation with PixelCNN Decoders,” in NeurIPS, 2016. NeurIPS
- A. van den Oord, O. Vinyals and K. Kavukcuoglu, “Neural Discrete Representation Learning,” in NeurIPS, 2017. NeurIPS
- P. Esser, R. Rombach and B. Ommer, “Taming Transformers for High-Resolution Image Synthesis,” in Proc. IEEE/CVF CVPR, 2021. CVF
- K. Tian, Y. Jiang, Z. Yuan, B. Peng and L. Wang, “Visual Autoregressive Modeling: Scalable Image Generation via Next-Scale Prediction,” in NeurIPS, 2024 (Best Paper Award). arXiv
- T. Li, Y. Tian, H. Li, M. Deng and K. He, “Autoregressive Image Generation without Vector Quantization,” in NeurIPS, 2024. arXiv
- H. Chang, H. Zhang, L. Jiang, C. Liu and W. T. Freeman, “MaskGIT: Masked Generative Image Transformer,” in Proc. IEEE/CVF CVPR, 2022. CVF
- S. J. D. Prince, Understanding Deep Learning, MIT Press, 2023. Book
- A. Razavi, A. van den Oord and O. Vinyals, “Generating Diverse High-Fidelity Images with VQ-VAE-2,” in NeurIPS, 2019. NeurIPS
- M. Chen, A. Radford, R. Child, J. Wu, H. Jun, D. Luan and I. Sutskever, “Generative Pretraining From Pixels,” in Proc. ICML, PMLR 119, 2020. PMLR
- J. Yu, X. Li, J. Y. Koh et al., “Vector-quantized Image Modeling with Improved VQGAN,” in ICLR, 2022. arXiv
- J. Yu, Y. Xu, J. Y. Koh et al., “Scaling Autoregressive Models for Content-Rich Text-to-Image Generation,” Transactions on Machine Learning Research, 2022. arXiv
- P. Sun, Y. Jiang, S. Chen, S. Zhang, B. Peng, P. Luo and Z. Yuan, “Autoregressive Model Beats Diffusion: Llama for Scalable Image Generation,” arXiv:2406.06525, 2024. arXiv
- D. Lee, C. Kim, S. Kim, M. Cho and W.-S. Han, “Autoregressive Image Generation using Residual Quantization,” in Proc. IEEE/CVF CVPR, 2022. CVF
- F. Mentzer, D. Minnen, E. Agustsson and M. Tschannen, “Finite Scalar Quantization: VQ-VAE Made Simple,” in Proc. International Conference on Learning Representations (ICLR), 2024. arXiv
- H. Chang, H. Zhang, J. Barber et al., “Muse: Text-To-Image Generation via Masked Generative Transformers,” in Proc. ICML, PMLR 202, 2023. PMLR
- J. Ho and T. Salimans, “Classifier-Free Diffusion Guidance,” arXiv:2207.12598, 2022 (short version at the NeurIPS 2021 Workshop on Deep Generative Models and Downstream Applications). arXiv
- S. Bond-Taylor, A. Leach, Y. Long and C. G. Willcocks, “Deep Generative Modelling: A Comparative Review of VAEs, GANs, Normalizing Flows, Energy-Based and Autoregressive Models,” IEEE TPAMI, vol. 44, no. 11, 2022. doi
- J. Li, Y. Fu, J. Liu, L. Cao, W. Ji, M. Yang, I. King and M.-H. Yang, “Discrete Tokenization for Multimodal LLMs: A Comprehensive Survey,” IEEE TPAMI, 2026 (arXiv:2507.22920). doi
- S. Zhao, X. Zhang, J. Guo et al., “Unified Multimodal Understanding and Generation Models: Advances, Challenges, and Opportunities,” arXiv:2505.02567, 2025; revised 2026. arXiv
- J. Jia, J. Gao, B. Xue et al., “From Principles to Applications: A Comprehensive Survey of Discrete Tokenizers in Generation, Comprehension, Recommendation, and Information Retrieval,” arXiv:2502.12448, 2025. arXiv
- J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li and L. Fei-Fei, “ImageNet: A Large-Scale Hierarchical Image Database,” CVPR, 2009, pp. 248–255. doi
- H. Touvron, T. Lavril, G. Izacard et al., “LLaMA: Open and Efficient Foundation Language Models,” arXiv:2302.13971, 2023. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 10・基礎模型與視覺語言學習 · 25 分鐘