ML 06A・線性因子模型與自編碼器
先備知識:ML 01B・機率與資訊理論、ML 02・類神經網路:從感知器到深度網路
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 2 個互動實驗
用 8 × 8 區塊 DCT 或 Haar 小波轉換一張真實照片,把每個係數捨入到較粗的步長,觀察遺失的資訊出現在哪裡。
你將學到
- 說明潛在因素如何描述相關量測。
- 比較 PCA、機率式 PCA 與因素分析的雜訊假設。
- 區分獨立性、稀疏性與非負限制。
- 連結線性及非線性自編碼器與重建目標。
- 理解流形假設,以及為何只有重建不足以定義取樣。
先看全貌
一張 8 × 8 的數字影像有 64 個像素值,一張手機照片則有數百萬個。然而,一批這類影像中真正有意義的變化,只取決於少得多的潛在量:是哪個數字、筆畫粗細、傾斜角度、位置、光照。因子模型試圖用少數幾個隱藏(潛在)座標來解釋每一筆觀測。自編碼器則是一種神經網路,它學著把輸入擠進這樣的座標,再展開還原。
為什麼要用一整章談這個?因為現代表示學習與生成模型裡幾乎每個想法,都能在這裡找到祖先。用於視覺化的降維、去噪、壓縮、異常偵測、把影像轉成緊湊編碼供擴散模型使用的「tokenizer」,以及 VAE 的機率架構,全都從同一個問題出發:哪一小組原因可能產生了這些觀測? 從線性因子模型到自編碼器的脈絡,依循 Goodfellow、Bengio 與 Courville [1, 第 13–14 章] 以及 Murphy [2];Bengio、Courville 與 Vincent 的回顧論文 [3] 則說明了學習到的表示為何重要。
一個範本,多種模型
本章每一個方法都套用同一個範本。編碼器(encoder)把觀測 映射成編碼 ,解碼器(decoder)再把編碼映回重建結果 。各模型的差別只在三個選擇:
| 選擇 | 本章出現的選項 |
|---|---|
| 編碼器/解碼器的形式 | 線性(PCA、因子分析、ICA、NMF、稀疏編碼)或非線性(深度自編碼器) |
| 編碼的大小 | 欠完備(undercomplete,:瓶頸迫使模型壓縮)或過完備(overcomplete,:必須靠其他機制阻止模型直接複製) |
| 額外假設或懲罰 | 高斯雜訊(PPCA、FA)、獨立且非高斯(ICA)、稀疏(稀疏編碼、稀疏自編碼器)、非負(NMF)、對破壞具穩健性(去噪)、對微小輸入變化不敏感(收縮) |
請記住這張表。兩個方法結論不同時,幾乎總是因為它們在某一列做了不同的選擇,而不是其中一個「錯了」。
PCA:最佳的線性重建子空間
白話版。 找幾個彼此正交的方向,使得每筆資料只保留在這些方向上的座標時,損失的資訊越少越好。
令 的每一列是一筆已中心化(減去各欄平均)的資料,共 筆。PCA 選擇一個欄向量互相正交且長度為 1 的矩陣 ,使平方重建誤差最小:
其中 是 Frobenius 範數(所有元素平方和的平方根), 是編碼(也稱分數), 是重建結果。編碼器是 ,解碼器是 :PCA 本身就是一個自編碼器,只是線性且權重共用。
解從哪裡來
兩種等價的觀點會得到同一個答案。
最大變異數。 取一個單位向量 。投影後資料 的變異數是 ,其中 是樣本共變異數矩陣。用拉格朗日乘數 ,在 的限制下最大化 :
所以 必須是 的特徵向量,而它捕捉到的變異數就是對應的特徵值 。最好的方向是特徵值最大的特徵向量;在與第一個方向正交的限制下,次好的方向是第二個特徵向量,依此類推。
最小重建誤差。 由於 的欄向量正交歸一,誤差可以拆成「總變異數減去保留的變異數」。因此最小化誤差等同於最大化保留的變異數,而殘差恰好是被捨棄的特徵值總和(乘上 )。Eckart–Young 定理用矩陣語言說了同一件事:把奇異值分解 截斷到最大的 個奇異值,就得到 Frobenius 範數下最佳的秩 近似。PCA 方向就是前 個右奇異向量( 的欄),而共變異數的特徵值為 。
程式:用 SVD 實作 PCA
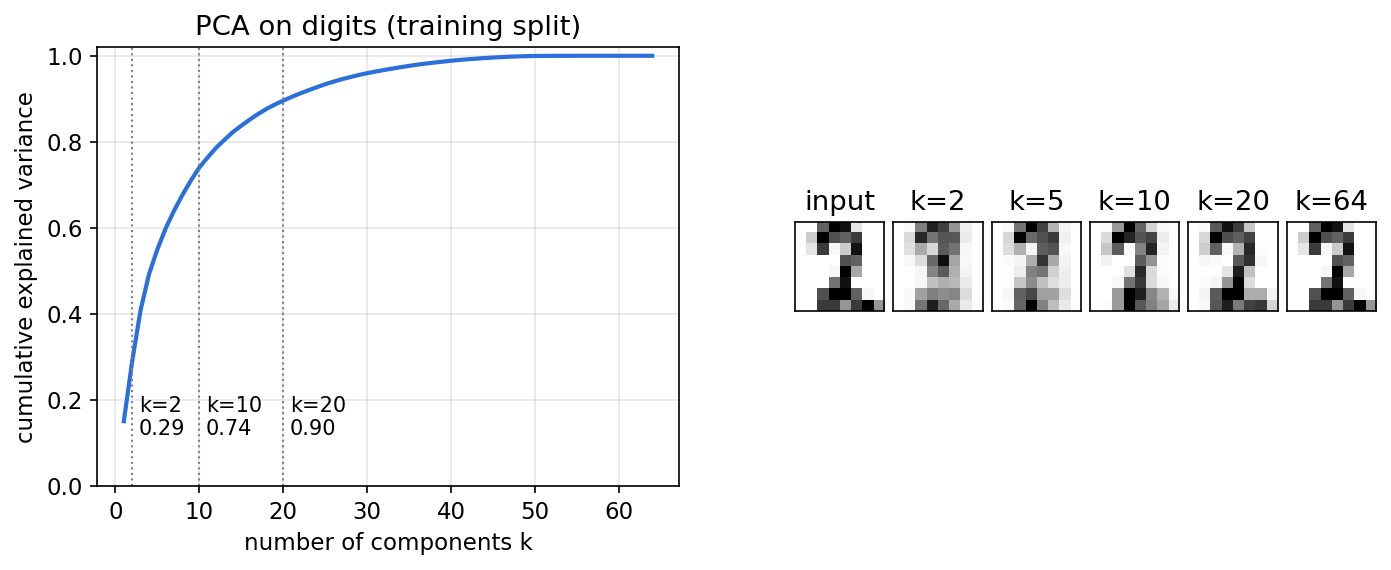
下面的程式在 scikit-learn 內建 digits 資料集的訓練部分上擬合 PCA,在保留的測試影像上評估重建,並與 scikit-learn 的實作互相核對。
程式碼 · Python · 20 行
import numpy as np
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA
from sklearn.model_selection import train_test_split

X = load_digits().data / 16.
train, test = train_test_split(X, test_size=.2, random_state=0)

mean = train.mean(axis=0)
U, s, Vt = np.linalg.svd(train - mean, full_matrices=False)
var = s**2 / (len(train) - 1)              # eigenvalues of the covariance
ratio = np.cumsum(var) / var.sum()
for k in (2, 10, 20):
    W = Vt[:k].T                            # d x k, orthonormal columns
    rec = (test - mean) @ W @ W.T + mean
    print(f"k={k:2d}  explained={ratio[k-1]:.3f}  "
          f"test MSE={np.mean((test - rec)**2):.4f}")

sk = PCA(n_components=10).fit(train)
print("matches sklearn:", np.allclose(np.abs(sk.components_), np.abs(Vt[:10])))
輸出:
程式碼 · 4 行
k= 2  explained=0.291  test MSE=0.0546
k=10  explained=0.740  test MSE=0.0202
k=20  explained=0.896  test MSE=0.0084
matches sklearn: True
最後一行的 np.abs 並不是投機取巧:每個主方向本來就只確定到正負號,因為 與 張成同一條直線。也請注意,平均值只在訓練資料上估計,再套用到測試資料;若用測試資料估計平均值,就會洩漏資訊。
PCA 沒有承諾的事
從目標函數可以直接得出三個提醒。
- 中心化與尺度會改變答案。 沒有中心化時,第一個「成分」大多指向平均值。若把每個特徵標準化為單位變異數,每個像素的權重就相同,因此原始像素 PCA 與標準化 PCA 解的是不同問題。
- 變異數不等於相關性。 變異數最大的方向可能是光照或背景,而不是你關心的類別。PCA 是非監督式的;它最大化保留的變異數,而不是類別分離度(那是線性判別分析等方法的工作)。
- PCA 是線性的。 若資料落在彎曲的曲面上,平坦的子空間可能需要很多維度,才能描述其實是低維的形狀。我們會在流形一節回到這一點。
機率 PCA 與因子分析
白話版。 與其只找一個子空間,不如寫下一個資料如何產生的故事:先抽出幾個隱藏因子,把它們線性混合,再加上雜訊。接著用最大概似法擬合這個故事。
兩個模型共用同一條生成方程式:
其中 是平均值, 是負荷矩陣(loading matrix,描述每個因子如何出現在每個量測座標上), 是潛在因子向量, 是與 獨立的雜訊。兩者只差在雜訊。
機率 PCA(PPCA)
在 PPCA [4] 中,雜訊是等向的,:每個座標的雜訊變異數都相同。把 積分掉,得到高斯邊際分布
這個共變異數有清楚的解讀:低秩部分 由因子解釋,再加上一個因子解釋不了的固定「底噪」。Tipping 與 Bishop 證明最大概似解有封閉形式 [4]:
其中 是樣本共變異數前 個特徵向量, 是對應的特徵值 , 是任意 正交矩陣。換句話說:負荷矩陣恰好張成 PCA 子空間,而雜訊變異數就是 PCA 丟掉的變異數的平均。因此 PPCA 就是 PCA 再加上一個概似函數。這個概似函數很有用:你可以在保留資料上比較不同 的模型、用期望最大化(EM)演算法處理缺值,也能建立 PPCA 的混合模型。
給定一筆觀測,其因子的後驗分布是高斯分布,平均為
這就是機率式的編碼器。當 時,它趨近一般的 PCA 投影;當 時,它會把編碼往零收縮,因為看到的東西有一部分被歸因於雜訊。
因子分析(FA)
因子分析(factor analysis)保留相同結構,但允許對角的雜訊共變異數,,。每個觀測座標各有自己的殘差雜訊水準 ,而潛在因子負責解釋座標之間共享的共變異數。邊際分布為 ,因子的後驗平均為 。
FA 沒有封閉解,因此用 EM 或直接最佳化概似函數來擬合。當量測來自雜訊程度不一的感測器,或某些像素幾乎恆定(例如 digits 影像邊框上永遠空白的像素)時,這份額外的彈性就很重要。PCA 會毫不猶豫地把成分花在任何高變異數的座標上;FA 則可以把個別雜訊很大的座標解釋成「雜訊」,把因子留給座標之間的相關性。
旋轉問題
兩個模型都有同一種不確定性。對任意正交矩陣 ,把 換成 、 換成 , 不變,因此 的分布也不變,因為 仍是標準常態。子空間可以被確定,個別的座標軸卻不行。這就是因子分析文獻使用 varimax 等旋轉來挑選較好解讀的座標軸的原因,也說明了因子不會自動等同於物理上的成因。若要確定個別因子,我們必須在高斯以外再假設些什麼,而 ICA 正是這麼做的。
選讀:Probabilistic PCA(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
獨立成分分析(ICA)
白話版。 一個房間裡好幾個人同時講話,幾支麥克風各自錄到不同比例的混音。ICA 試著找出統計上盡可能獨立、而且盡可能不像高斯分布的組合,藉此還原每個人的聲音。
無雜訊的 ICA 模型為
其中 是觀測到的混合訊號, 是未知的混合矩陣,來源 彼此獨立且非高斯。目標是找一個解混矩陣 (或其偽逆),使 還原出來源 [5]。
為什麼關鍵在於非高斯
上一節的旋轉問題說明了 ICA 為何需要非高斯來源。先把資料白化(whitening):轉換 使其共變異數為單位矩陣(先做 PCA,再把每個成分縮放到單位變異數即可)。白化之後,剩下的未知量只是一個旋轉。如果來源是高斯,獨立單位高斯的任何旋轉仍然是獨立單位高斯,於是沒有任何旋轉比較好。ICA 的可識別性定理說的是反方向:只要至多一個來源是高斯,來源就能被還原,只剩三種無傷大雅的不確定性 [5]:
- 順序(我們無法得知哪個來源是「第一個」),
- 正負號,以及
- 尺度(大聲的來源配上較小的混合係數,看起來一模一樣)。
中央極限定理提供了找到正確旋轉的直覺:獨立變數的總和往往比各部分更像高斯。所以 的投影中最不像高斯的那些,最可能是單一來源而不是混合。因此 ICA 演算法會最大化某種非高斯程度的量度。一個有理論依據的量度是負熵(negentropy):
其中 是微分熵, 是與 變異數相同的高斯變數。在變異數固定的所有分布中,高斯分布的熵最大,所以 恰好發生在 為高斯時。由於熵很難估計,FastICA 演算法用 等對比函數近似負熵,並以快速的不動點迭代找出每個解混方向 [5]。最大化非高斯程度,與最小化各估計成分之間的互資訊、以及 ICA 模型的最大概似估計密切相關。
程式:把三個訊號解混
這個玩具問題用了一個正弦波、一個方波與一個鋸齒波,全都是非高斯,並以固定矩陣混合。
程式碼 · Python · 21 行
import numpy as np
from sklearn.decomposition import FastICA, PCA

rng = np.random.default_rng(0)
t = np.linspace(0, 8, 2000)
S = np.c_[np.sin(2*t),                 # smooth sine
          np.sign(np.sin(3*t)),        # square wave
          2*(t % 1) - 1]               # sawtooth
S += 0.05 * rng.normal(size=S.shape)
A = np.array([[1.0, 1.0, 1.0],
              [0.5, 2.0, 1.0],
              [1.5, 1.0, 2.0]])        # unknown mixing matrix
X = S @ A.T                            # three "microphones"

def best_match(est):
    C = np.abs(np.corrcoef(S.T, est.T)[:3, 3:])
    return np.round(C.max(axis=1), 3)

ica = FastICA(n_components=3, whiten="unit-variance", random_state=0)
print("ICA |corr| with each source:", best_match(ica.fit_transform(X)))
print("PCA |corr| with each source:", best_match(PCA(3).fit_transform(X)))
輸出:
程式碼 · 2 行
ICA |corr| with each source: [0.997 0.999 0.997]
PCA |corr| with each source: [0.689 0.811 0.735]
我們用相關係數的絕對值並取最佳配對來比較,因為 ICA 回傳的來源順序、正負號與尺度都是任意的。PCA 只做去相關:它找的是高變異數的正交方向,在這裡仍然是混合訊號。
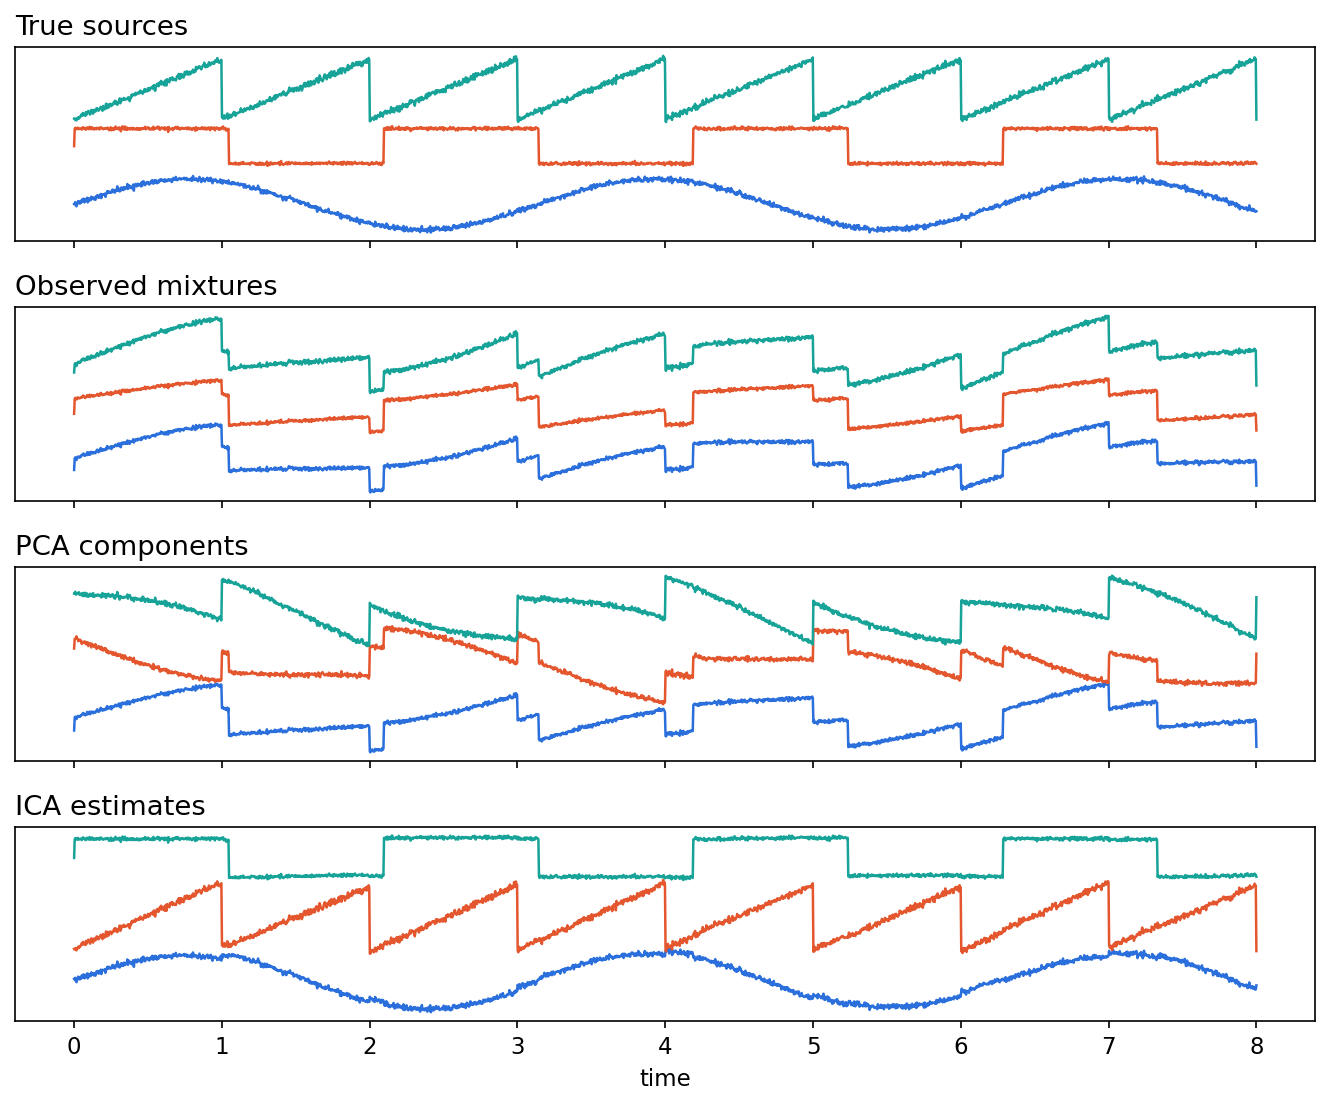
ICA 廣泛用於分離腦電圖(EEG)等感測紀錄中的雜訊與偽影。它的假設也劃出了它的極限:它需要真正獨立、非高斯的來源,以及接近線性且瞬時的混合過程。在影像區塊(patch)上,ICA 往往學到局部化、有方向性的邊緣狀濾波器,這也引出一個密切相關的想法。
稀疏編碼
白話版。 準備一本很大的小圖樣字典(「原子」,atom),每次描述一個輸入時只用其中少數幾個。
稀疏編碼學習一個字典 ,並為每筆資料 學一個稀疏編碼 ,求解
第一項要求準確重建; 範數 把大多數編碼元素推成恰好為零; 決定兩者的取捨。原子的範數限制防止模型作弊,也就是把原子放得很大、編碼縮得很小。字典常是過完備的():原子比像素維度多,但對任何一個輸入只有少數幾個會啟動。
Olshausen 與 Field [6] 在自然影像的區塊上訓練這類模型,發現學到的原子是局部化、有方向性、帶通的,非常像初級視覺皮質中簡單細胞的感受野。這個結果影響深遠,因為它顯示:只靠稀疏性、不需要任何標籤,就能解釋生物視覺的一項已知特性。
有兩個實務重點讓稀疏編碼不同於本章稍後的自編碼器:
- 推論本身是一個最佳化問題。 給定 ,要為新輸入找出 ,就得解一個 lasso 問題。這裡沒有固定的編碼器網路;「編碼器」是一個演算法。訓練時交替更新編碼(固定 )與字典(固定編碼)。
- 稀疏性是一種先驗。 懲罰對應於編碼上的 Laplace 先驗,所以稀疏編碼可以看成:在一個具有稀疏、非高斯先驗的線性因子模型中做最大後驗(MAP)推論,而這正是 ICA 所屬的同一個家族。
程式:稀疏程度與重建精確度
程式碼 · Python · 17 行
import numpy as np
from sklearn.datasets import load_digits
from sklearn.decomposition import DictionaryLearning
from sklearn.model_selection import train_test_split

X = load_digits().data / 16.
train, test = train_test_split(X, test_size=.2, random_state=0)
for alpha in (0.1, 1.0):
    dl = DictionaryLearning(n_components=32, alpha=alpha, max_iter=30,
                            transform_algorithm="lasso_lars",
                            transform_alpha=alpha, random_state=0)
    dl.fit(train[:600])
    codes = dl.transform(test)
    rec = codes @ dl.components_
    active = np.mean(np.abs(codes) > 1e-8, axis=1).mean()
    print(f"alpha={alpha}: active atoms per image={active*32:.1f}/32, "
          f"test MSE={np.mean((test - rec)**2):.4f}")
輸出(在筆電 CPU 上約需半分鐘):
程式碼 · 2 行
alpha=0.1: active atoms per image=17.9/32, test MSE=0.0075
alpha=1.0: active atoms per image=3.0/32, test MSE=0.0401
提高 (這裡的 alpha)可以換到稀疏得多的描述,每張影像約啟動 3 個原子而不是 18 個,代價是重建誤差變高。兩種設定都沒有「對錯」:壓縮編解碼器、去噪器與可解釋性工具各自會做不同的選擇。請注意,這個字典沒有減去平均值,所以它的誤差不能直接與上面的 PCA 數字比較。
非負矩陣分解(NMF)
白話版。 把每筆資料描述成非負部件的加法組合:你可以加上筆畫,但永遠不能減掉筆畫。
對非負資料 (像素強度、詞頻、光譜),NMF 尋找 與 ,使下列重建準則最小:
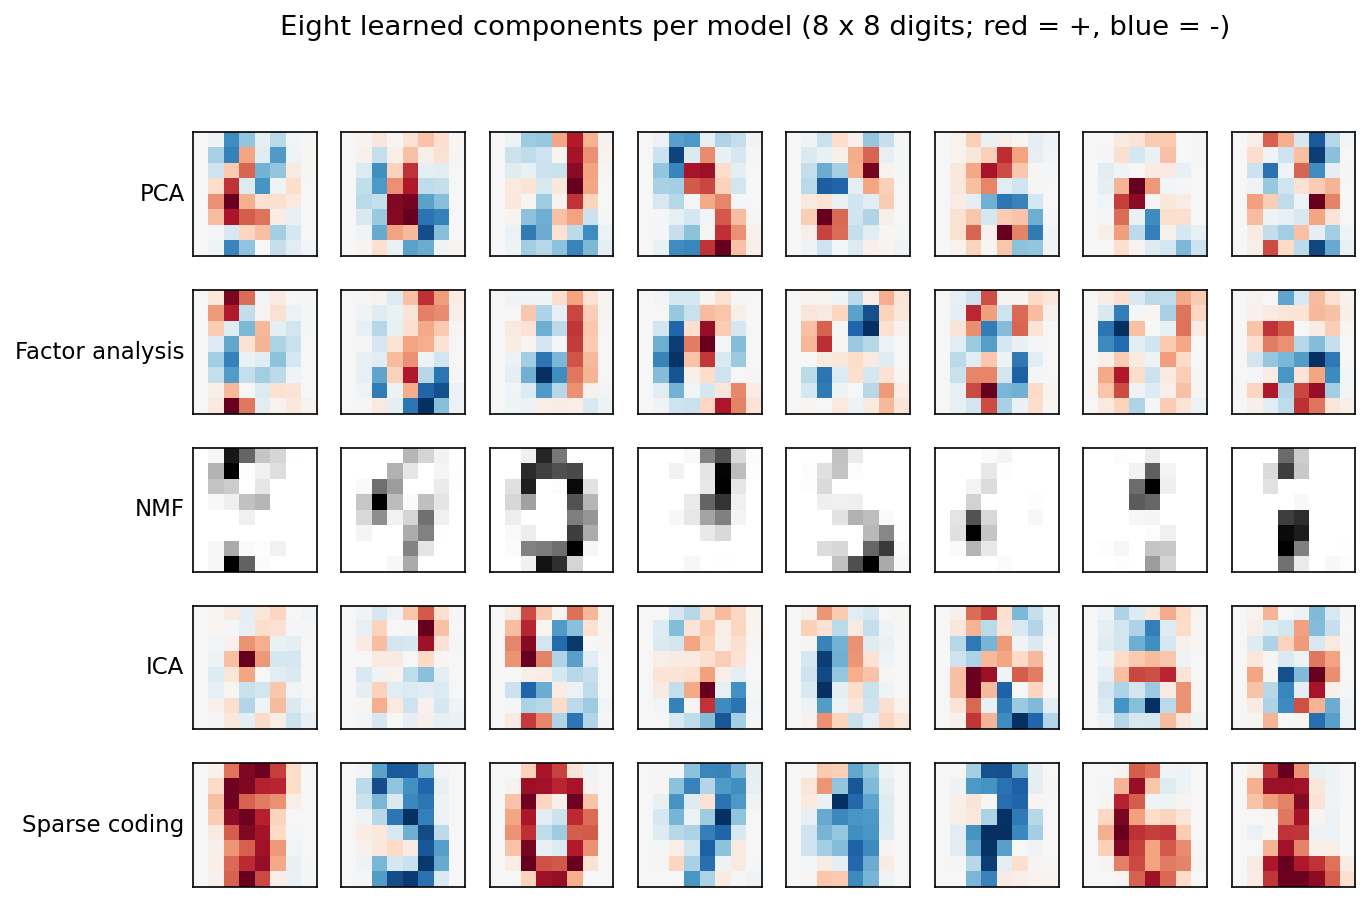
其中 的每一列是一個非負部件, 的每一列是非負的混合權重。因為沒有東西可以互相抵消,這些部件往往看起來像物體的局部,而不是 PCA 那種有正有負的「幽靈」圖樣。Lee 與 Seung [7] 在人臉與文字上展示了這種以部件為基礎的行為,並推廣了簡單的乘法更新規則來擬合模型。
兩點提醒。第一,以部件為基礎是一種傾向,而不是保證:在某些資料集上,因子並不是乾淨的部件。第二,目標函數對 與 聯合而言是非凸的,所以初始化很重要,不同次執行可能得到不同的因子。scikit-learn 的 init="nndsvda" 用以 SVD 為基礎的起點讓結果更穩定。
程式:比較各因子模型的重建
這個 CPU 範例只在訓練用的數字上擬合各模型,並在保留的影像上評估重建。它比較的是不同的模型假設,並不是宣稱某個方法在所有任務上都勝出。
程式碼 · Python · 22 行
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.decomposition import PCA, FactorAnalysis, NMF

X = load_digits().data / 16.
train, test = train_test_split(X, test_size=.2, random_state=0)
models = {
    "PCA": PCA(n_components=12),
    "factor analysis": FactorAnalysis(n_components=12, random_state=0),
    "NMF": NMF(n_components=12, init="nndsvda", max_iter=1000,
               random_state=0),
}
for name, model in models.items():
    model.fit(train)
    z = model.transform(test)
    if name == "factor analysis":
        reconstructed = z @ model.components_ + model.mean_
    else:
        reconstructed = model.inverse_transform(z)
    mse = np.mean((test-reconstructed)**2)
    print(name, "held-out reconstruction MSE:", round(mse, 5))
輸出:
程式碼 · 3 行
PCA held-out reconstruction MSE: 0.01652
factor analysis held-out reconstruction MSE: 0.02501
NMF held-out reconstruction MSE: 0.02207
這次執行中,PCA 的保留測試重建 MSE 最低。但最佳性定理針對的是擬合子空間所用、已中心化的訓練矩陣,不保證在每一份新測試集上誤差都最低。其他模型的假設若更適合目標母體,也可能有較好的泛化表現。這裡因子分析的重建是後驗平均,會把每個像素的一部分歸因於雜訊;FA 的完整機率模型也不能只用 MSE 概括。NMF 則加入非負、可加的因素限制。保留測試誤差應靠實驗比較,不能把這次排名當成定理。
線性自編碼器與 PCA
白話版。 對置中資料使用平方重建誤差時,線性瓶頸自編碼器可在全域最佳解恢復 PCA 子空間,但訓練未必到達該解。
對中心化的輸入,線性自編碼器計算
其中編碼器 、解碼器 ,且 。乘積 的秩至多為 ,所以由 Eckart–Young 定理,最好的乘積就是投影到前 個主成分子空間。Baldi 與 Hornik [8] 證明了更多:對這種平方誤差的線性網路,每個局部極小值都是全域極小值,而在全域極小值處,網路投影到主成分子空間。然而個別的權重矩陣並不唯一。對任意可逆的 矩陣 ,把 換成 、 換成 ,乘積不變,所以編碼座標可以是 PCA 分數的任何可逆線性轉換。
程式:線性自編碼器重新找到 PCA 子空間
程式碼 · Python · 23 行
import numpy as np, torch
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA
from scipy.linalg import subspace_angles

torch.manual_seed(0)
X = load_digits().data / 16.
X = X - X.mean(axis=0)
Xt = torch.tensor(X, dtype=torch.float32)
k = 5
enc = torch.nn.Linear(64, k, bias=False)
dec = torch.nn.Linear(k, 64, bias=False)
opt = torch.optim.Adam([*enc.parameters(), *dec.parameters()], lr=1e-2)
for step in range(3000):
    loss = (dec(enc(Xt)) - Xt).square().mean()
    opt.zero_grad(); loss.backward(); opt.step()

Wd = dec.weight.detach().numpy()            # 64 x k decoder columns
P = PCA(n_components=k).fit(X).components_.T
angles = np.degrees(subspace_angles(Wd, P))
print("largest angle to PCA subspace (deg):", round(angles.max(), 3))
print("decoder columns orthonormal?",
      np.allclose(Wd.T @ Wd, np.eye(k), atol=1e-2))
輸出:
程式碼 · 2 行
largest angle to PCA subspace (deg): 0.003
decoder columns orthonormal? False
子空間夾角(兩個 維子空間之間的最大夾角)基本上是零:網路找到了 PCA 子空間。但它的解碼器欄向量並不正交歸一,所以它們不是主成分本身。這就是座標不確定性的實際表現,也是本章反覆出現的主題的第一個線索:光靠重建,只能確定保留了什麼,無法確定如何標記它。
非線性自編碼器
白話版。 把線性映射換成神經網路,編碼就能描述任何平坦子空間都無法捕捉的彎曲結構。
一般的自編碼器有編碼器 與解碼器 ,兩者都是神經網路:
其中 是重建損失函數,例如實數值用平方誤差, 之間的值用二元交叉熵。 的選擇本身就是一個假設:平方誤差對應以 為中心的高斯概似,交叉熵對應 Bernoulli 概似。
Hinton 與 Salakhutdinov [9] 在 2006 年展示:先以逐層貪婪預訓練初始化、再端到端微調的深度自編碼器,在相同維度下找到的低維編碼,重建影像的效果比 PCA 好得多。今天,更好的初始化、正規化層與最佳化器已讓預訓練步驟變得不必要,但核心教訓依然成立:當資料是彎曲的,非線性編碼器可以比線性編碼器壓縮得更徹底。
欠完備還不夠,過完備需要規則
欠完備自編碼器()被迫壓縮。這很有用,但並不保證能學到好特徵。夠強大的編碼器與解碼器在原理上可以把每個訓練樣本映到它自己的任意編碼(例如它的索引),再把解碼記下來,在沒學到任何可重用結構的情況下達到很低的訓練誤差 [1, 第 14 章]。過完備自編碼器()則可以直接學成恆等函數。兩種情況下,讓表示有用的都不是瓶頸本身,而是歸納偏誤(inductive bias):有限的容量、架構(例如卷積),以及明確的懲罰項。下一節介紹三種經典懲罰,合稱正則化自編碼器(regularized autoencoders)。
正則化自編碼器:稀疏、去噪與收縮
每一種懲罰都用不同方式回答「編碼應該忽略什麼?」這個問題。
稀疏自編碼器
白話版。 允許有很多編碼單元,但要求對任何一個輸入只有少數幾個啟動。
損失函數在編碼 上加一個稀疏懲罰:
其他做法包括:懲罰每個單元平均啟動率偏離一個小目標值的程度,或只保留最大的 個啟動值(「top-」或 -稀疏自編碼器)。稀疏自編碼器是稀疏編碼的「攤銷式」(amortized)表親:編碼器網路一次前向傳遞就預測出稀疏編碼,而不必為每個輸入解一次 lasso。Goodfellow 等人把這個懲罰解讀為編碼上的近似先驗,而不是一般的權重正則化 [1, 第 14 章]。正如現代觀點一節會說明的,稀疏自編碼器近年已成為解讀大型神經網路內部的關鍵工具。
去噪自編碼器
白話版。 給網路看一個受損的輸入,要它重建出乾淨的版本。要做到這點,它必須學會乾淨的資料長什麼樣子。
去噪自編碼器(denoising autoencoder,DAE)先抽出一個受破壞的副本 ,再最小化
其中 是事先選定的破壞過程:加性高斯雜訊、遮罩雜訊(把隨機一部分輸入設為零),或椒鹽雜訊 [10], [11]。Vincent 等人在 2008 年提出這個想法 [10],並在 2010 年證明把 DAE 層堆疊起來,能為分類器提供有用的特徵 [11]。由於輸入與目標不同,即使編碼是過完備的,直接複製也不再是解。
破壞過程決定了模型學會對什麼具有穩健性。用高斯雜訊訓練的 DAE 沒有理由去補齊缺失的區塊,而用遮罩雜訊訓練的 DAE 則會學到補全。現代的遮罩影像建模,例如 ML 06 中的遮罩自編碼器(MAE),就是遮罩雜訊 DAE 的直系後代。
這裡還有更深一層的幾何解讀。對微小的高斯破壞,向量 會從受損的點指回資料密度較高的區域;它近似估計了分數(score),也就是對數密度的梯度 [1, 第 14 章]。這個關聯是分數式與擴散生成模型的根源之一,詳見 ML 08。
程式:在數字上訓練去噪自編碼器
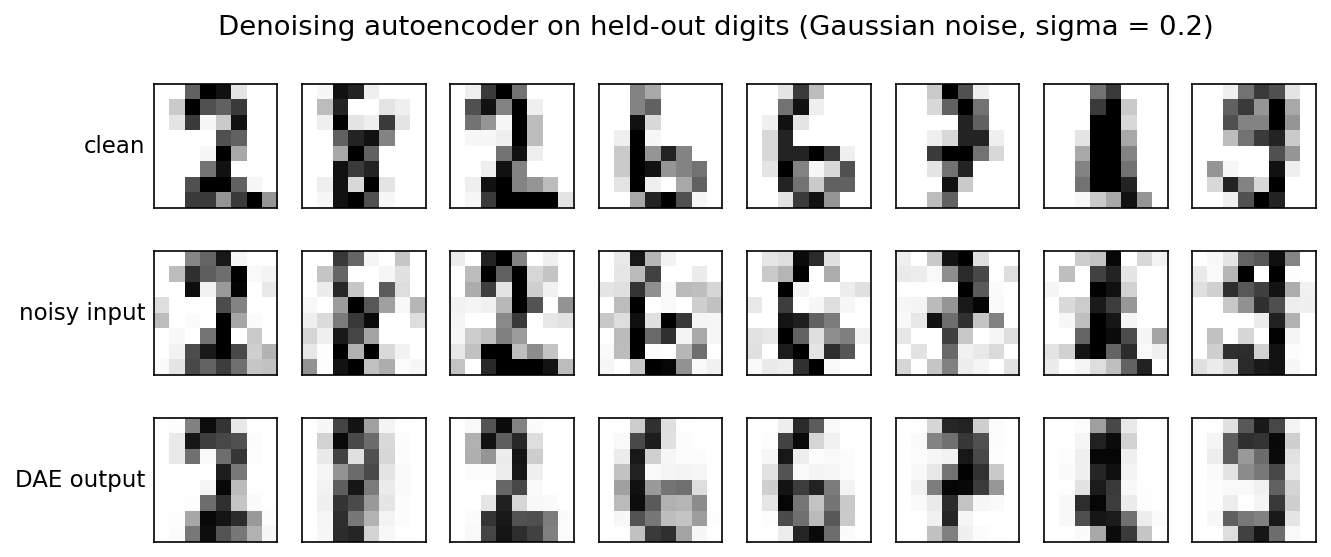
這個獨立的 PyTorch 範例在訓練用的數字上訓練一個小型非線性 DAE,並評估從加了雜訊的保留輸入重建乾淨影像的效果。
程式碼 · Python · 23 行
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0); torch.set_num_threads(1)
train, test = train_test_split(load_digits().data/16., test_size=.2, random_state=0)
X = torch.tensor(train, dtype=torch.float32)
Xt = torch.tensor(test, dtype=torch.float32)
encoder = nn.Sequential(nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 12))
decoder = nn.Sequential(nn.Linear(12, 32), nn.ReLU(), nn.Linear(32, 64), nn.Sigmoid())
model = nn.Sequential(encoder, decoder)
opt = torch.optim.Adam(model.parameters(), lr=.003)
for step in range(2000):
    clean = X[torch.randint(len(X), (64,))]
    noisy = (clean + .2*torch.randn_like(clean)).clamp(0, 1)
    loss = (model(noisy)-clean).square().mean()
    opt.zero_grad(); loss.backward(); opt.step()
model.eval()
with torch.no_grad():
    noisy = (Xt + .2*torch.randn_like(Xt)).clamp(0, 1)
    print("noisy-input MSE:", (noisy-Xt).square().mean().item())
    print("reconstructed MSE:", (model(noisy)-Xt).square().mean().item())
輸出(含雜訊輸入約 0.0248,經過 DAE 後約 0.0197;最後幾位數依 PyTorch 版本而異):
程式碼 · 2 行
noisy-input MSE: 0.024781296029686928
reconstructed MSE: 0.01968955807387829
改善是真實的,但幅度不大,圖 4 說明了原因:在 12 維的編碼下,DAE 去除了斑點雜訊,但也把一些筆畫細節抹平了。去噪與忠實壓縮往不同方向拉扯;更寬的編碼或卷積架構會改變兩者的平衡。
收縮自編碼器
白話版。 收縮懲罰抑制小輸入擾動造成的大編碼變化,但本身不知道哪些變化對任務重要。
Rifai 等人 [12] 加上編碼器 Jacobian 矩陣的 Frobenius 範數平方:
其中 ,Jacobian 元素 衡量輸入座標 變動時,編碼單元 移動多少。對單層 sigmoid 編碼器 ,該元素為 ,所以懲罰項很容易計算:
重建項希望編碼隨輸入改變(否則無法重建不同的輸入),懲罰項則希望編碼盡量少變。折衷的結果是:編碼只沿著訓練資料實際變化的少數方向保持敏感。DAE 以隱含方式達到相關的效果:對微小高斯雜訊,去噪訓練懲罰的是整個重建函數的敏感度 [1, 第 14 章];而 CAE 則明確地只懲罰編碼器。
程式:收縮懲罰的實際效果
程式碼 · Python · 31 行
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

train, test = train_test_split(load_digits().data/16., test_size=.2, random_state=0)
X = torch.tensor(train, dtype=torch.float32)
Xt = torch.tensor(test, dtype=torch.float32)

def fit(lam):
    torch.manual_seed(0)
    W = nn.Linear(64, 16)                    # encoder h = sigmoid(Wx + b)
    dec = nn.Linear(16, 64)
    opt = torch.optim.Adam([*W.parameters(), *dec.parameters()], lr=3e-3)
    for step in range(1500):
        x = X[torch.randint(len(X), (64,))]
        h = torch.sigmoid(W(x))
        rec = (dec(h) - x).square().sum(1).mean()
        # ||J||_F^2 = sum_j (h_j(1-h_j))^2 * ||W_j||^2 for a sigmoid layer
        jac = ((h*(1-h))**2 * W.weight.square().sum(1)).sum(1).mean()
        loss = rec + lam*jac
        opt.zero_grad(); loss.backward(); opt.step()
    with torch.no_grad():
        h = torch.sigmoid(W(Xt))
        mse = (dec(h) - Xt).square().mean().item()
        jac = ((h*(1-h))**2 * W.weight.square().sum(1)).sum(1).mean().item()
    return mse, jac

for lam in (0.0, 0.5):
    mse, jac = fit(lam)
    print(f"lambda={lam}: test MSE={mse:.4f}, mean ||J||_F^2={jac:.2f}")
輸出:
程式碼 · 2 行
lambda=0.0: test MSE=0.0141, mean ||J||_F^2=4.79
lambda=0.5: test MSE=0.0194, mean ||J||_F^2=0.70
懲罰項把編碼器的平均敏感度降低了將近七倍,代價是重建誤差略為上升。這筆交易值不值得,取決於下游用途:較平滑的編碼通常有助於最近鄰檢索或少標籤分類,而壓縮編解碼器則會偏好未加懲罰的模型。
流形觀點
白話版。 流形假說把資料建模為接近低維曲面,如房間中捲起的紙張;有用座標描述沿曲面的位置。
流形假說(manifold hypothesis)認為,影像等自然資料集中在嵌入高維輸入空間中的低維流形附近 [3]。一個隨機的 64 像素陣列幾乎不可能像一個數字;合理數字的集合是一個極小而有結構的區域。在任何資料點附近,流形局部看起來像一個平面,即切空間(tangent space),由少數幾個能讓你保持「真實」的移動方向張成(筆畫變粗、稍微傾斜、小幅平移)。與切空間正交的方向則會離開流形、進入雜訊。
這個觀點為本章所有內容提供了單一的視角:
- PCA 擬合一張全域的平面紙。流形接近平坦時有效,彎曲時就失效。
- PPCA 或 FA 的混合模型擬合許多張局部平面紙。
- 非線性自編碼器學到流形的彎曲座標圖:編碼器給出紙上的座標,解碼器再把座標映回房間裡。
- 去噪教模型把掉出流形的點移回流形上。
- 收縮懲罰讓編碼器對垂直於流形的方向不敏感,而重建項讓它沿著切方向保持敏感 [1, 第 14 章], [12]。
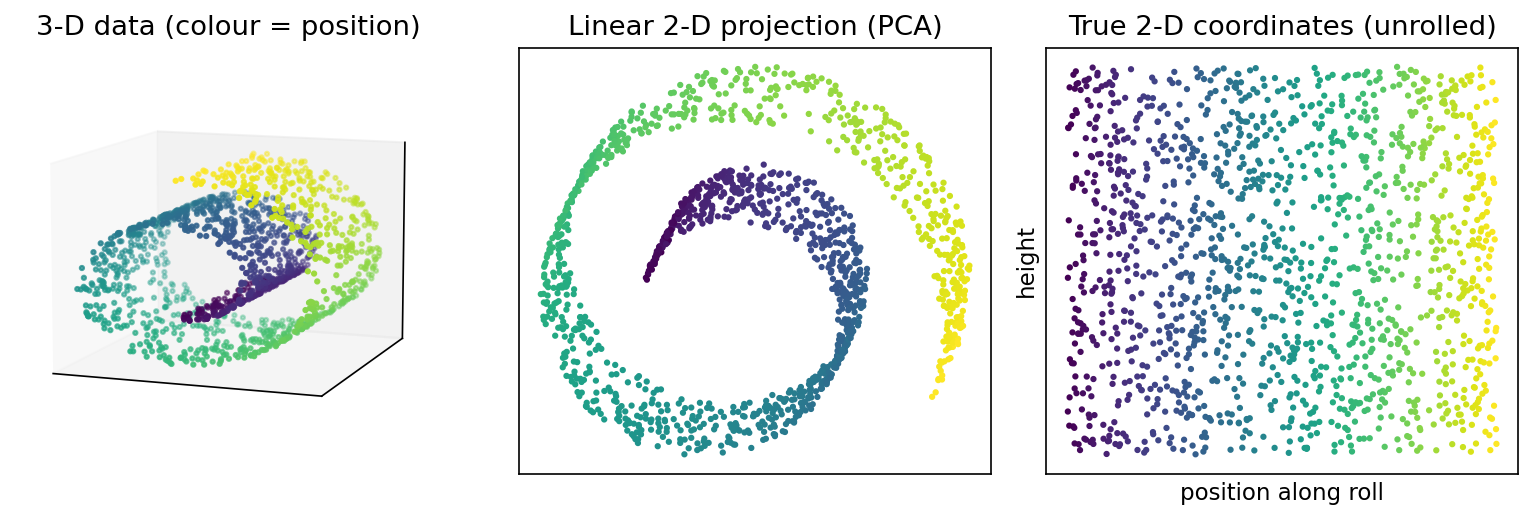
圖 5 讓線性方法的限制變得具體。瑞士捲有兩個內在維度——沿捲方向的位置與高度——但沒有任何二維線性投影能把它攤開:PCA 的視圖保留了螺旋,紙面上相距很遠的點並沒有依序排開。非線性編碼器原則上可以學到攤開後的座標。實務上能否做到,取決於容量、正則化與資料量;高維空間中的流形學習至今仍然困難。
從自編碼器到 VAE
白話版。 一般的自編碼器學會壓縮與解壓縮,卻沒有提供憑空創造新編碼的規則。VAE 加上了這條規則。
假設訓練好的自編碼器把每個訓練用的數字映射到 中的一個編碼。為了生成新數字,我們想隨機挑一個編碼再解碼。但要挑哪個隨機編碼?訓練編碼可能占據一個奇怪、成團的區域,而它們之間的隨機點解碼後可能是一團亂。重建損失函數從來沒有要求編碼空間平滑、填滿,或符合任何已知分布。所以極佳的重建並不代表良好的生成。
變分自編碼器(variational autoencoder)[13] 的解法是回到 PPCA 與 FA 的機率因子模型故事,只是改用神經網路解碼器:
其中 是一個分布,其參數由解碼器網路產生。由於真正的後驗 此時已無法計算,就由第二個網路——編碼器——輸出近似後驗 ,通常是對角高斯分布。訓練時最大化 的證據下界(evidence lower bound,ELBO):
對照前面所有內容來讀這兩項:
- 重建項(reconstruction)正是自編碼器的損失,只是現在在編碼中注入了雜訊。高斯解碼器下它變成平方誤差,Bernoulli 解碼器下則是二元交叉熵。
- KL 項(讓編碼靠近先驗)是一個正則化項,就像稀疏與收縮懲罰,但它的設計讓所有訓練樣本的編碼合起來填滿先驗分布。這正是從 取樣之所以有意義的原因。
- 若使用線性高斯解碼器,這個模型就是 PPCA。它的精確後驗是高斯分布,可以被線性高斯編碼器完全匹配,所以下界變成等號,最佳解與 PPCA 的最大概似解一致。VAE 是我們一開始那些因子模型的非線性推廣。
Kingma 與 Welling 的導論 [14] 詳細發展了這個關聯。把 KL 項乘上 就得到 β-VAE [15],它的提出是為了以重建品質為代價、鼓勵學到解耦(disentangled)的因子;請注意當 時,目標函數就不再是 ELBO。ELBO 的完整推導、重參數化技巧,以及後驗崩塌(posterior collapse)等失效模式,請見 ML 07。
重建誤差能告訴你什麼、不能告訴你什麼
離開自編碼器之前,先給一個實務上的警告。重建誤差常被當作異常分數:用正常資料訓練的自編碼器,應該能把正常輸入重建得很好、把異常輸入重建得很差。這有時行得通,但當自編碼器泛化得太好、連異常輸入也重建得不錯,或異常只存在於瓶頸本來就會丟掉的細節時,就會失敗。同樣地,重建得好的編碼可能不利於分類,而分類效果好的編碼可能丟掉了影像復原任務所需的像素細節。壓縮、去噪、下游效用與生成,請分開評估。
現代觀點
白話版。 本章的古典模型並沒有消失,而是變成了零件:生成模型的壓縮階段、視覺的預訓練目標,以及觀察大型網路內部的顯微鏡。
值得一讀的綜述
- Bengio、Courville 與 Vincent(2013) [3] 是表示學習的標準回顧。它用一串通用先驗來界定好的表示(平滑性、多重解釋因子、概念的階層、跨任務共享的因子、流形假說、稀疏性等),並在這個框架下串起自編碼器、機率模型與流形學習。想知道本章那些懲罰項為什麼存在,它是很好的地圖。
- Bank、Koenigstein 與 Giryes(2020) [16] 是一篇精簡的自編碼器綜述章節。它依序介紹正則化變體(稀疏、去噪、收縮)、VAE 與解耦變體、各種應用(生成建模、分類、分群、異常偵測、推薦系統與降維),以及結合對抗式訓練的混合方法,是本篇很好的補充讀物。
- Kingma 與 Welling(2019) [14] 是作者親自撰寫的 VAE 延伸導論,涵蓋 ELBO、重參數化技巧、更豐富的後驗分布與階層模型,並把 VAE 放進其他深度潛在變數模型的脈絡中。
- Goodfellow、Bengio 與 Courville [1, 第 13–14 章] 與 Murphy [2] 仍是線性因子模型、DAE 與分數的關聯,以及流形詮釋最清楚的教科書說明。
解耦:一個冷靜的結果
一個反覆出現的期望是:非監督式因子模型能找回那組真正的潛在因子,每個編碼單元對應一個(「解耦」,disentanglement)。Locatello 等人 [17] 從理論上證明,若對模型與資料都沒有歸納偏誤,非監督式地學習解耦表示在根本上是不可能的,這在更大的尺度上呼應了因子分析的旋轉不確定性。他們在一個大規模、可重現的研究中也發現:沒有監督就無法辨認出解耦良好的模型,而且更高的解耦程度並不會可靠地降低下游任務的樣本複雜度。實務教訓與 ICA 相同:可識別性永遠來自額外的假設,所以請把假設講清楚。
自編碼器作為 tokenizer
自編碼器在現代最重要的角色,是大型生成模型的第一階段。VQ-VAE [18] 把連續編碼換成一本學習出來的離散向量碼本,使影像變成離散 token 的網格,供自迴歸模型預測(見 ML 09)。潛在擴散(latent diffusion)[19] 先訓練一個做感知壓縮的自編碼器,再在它的潛在空間、而不是像素空間中執行擴散模型,大幅降低運算量。兩者都受到自編碼器重建品質的上限限制:生成器無法還原編碼器已經丟掉的細節。如何設計這些 tokenizer——在壓縮、重建,以及潛在空間是否容易被生成器建模之間取得平衡——在 2026 年仍是活躍的研究領域。
用於可解釋性的稀疏自編碼器(2023–2026)
稀疏自編碼器找到了一個嶄新且非常活躍的應用:大型語言與視覺模型的機制可解釋性(mechanistic interpretability)。出發點是一個觀察:單一神經元往往是多義的(polysemantic),會對好幾個不相關的概念產生反應。Cunningham 等人 [20] 訓練過完備的稀疏自編碼器來重建語言模型的內部啟動值,找到一些稀疏啟動的特徵,自動化評估認為它們比神經元或其他分解方式更具可解釋性、更單義。Gao 等人 [21] 使用 -稀疏(top-)自編碼器直接控制稀疏程度,報告了自編碼器大小與稀疏程度的乾淨縮放定律,提出評估特徵品質的新指標,並在 GPT-4 的啟動值上訓練了一個有 1,600 萬個潛在單元的自編碼器。概念上,這就是把稀疏編碼(Olshausen 與 Field 的想法)套用到網路的啟動值,而不是影像區塊。
開放問題
- 評估。 重建誤差、稀疏程度與下游準確率彼此不一致,而且對於學到的特徵是否「正確」——無論是解耦還是可解釋性——都沒有公認的衡量方式。
- 可識別性。 什麼時候可以相信學到的因子對應真實的成因?非線性 ICA 與因果表示學習研究的是哪些額外假設(時間結構、輔助變數、介入)能讓這件事成立。
- Tokenizer 設計。 要壓縮多少、編碼該是離散還是連續、如何讓潛在表示既利於重建又容易建模,仍是開放的工程與理論問題。
重點整理
- 因素模型透過潛在變數解釋觀測,假設決定哪些表示可識別。
- PCA 最佳化線性重建子空間;PPCA 與因素分析加入不同雜訊模型。
- ICA、稀疏編碼與 NMF 分別利用獨立性、稀疏性及非負性,偏好不同分解。
- 平方誤差線性自編碼器在合適的全域最佳解可恢復 PCA 子空間,但權重不必是 PCA 軸。
- 瓶頸與稀疏、去雜訊或收縮目標,以不同方式約束編碼;重建品質不等於語意品質。
- VAE 加入機率式潛在模型與近似推論;線性高斯選擇使其與 PPCA 相連。
練習
- 雜訊假設。 你記錄了 20 個感測器,其中 5 個的雜訊遠大於其他感測器,但它們全都反映同樣幾個潛在成因。你會從 PPCA 還是因子分析開始?PCA 會怎麼處理那些雜訊大的感測器?
提示
選因子分析:它的對角 可以把較大的殘差變異數分配給那 5 個雜訊大的感測器,而不必為它們花費因子。PCA(以及只有單一共享 的 PPCA)可能會把成分花在高變異數的雜訊感測器上,因為 PCA 眼中只有變異數。
- 潛在不確定性。 對可逆的 矩陣 ,證明把 換成 、 換成 ,線性自編碼器的重建結果不變。哪些矩陣 也能保持 PPCA 的概似函數不變?
提示
乘積為 。對 PPCA,概似函數取決於 ;把 換成 得到 ,當 ,也就是 為正交矩陣時不變。
- 為什麼 ICA 對高斯來源失效。 產生兩個獨立的標準高斯來源,用任意可逆的 矩陣混合,再用不同隨機種子執行 FastICA 數次。你觀察到什麼?為什麼?
提示
白化之後,兩個獨立單位高斯的任何旋轉仍是兩個獨立單位高斯,所以沒有「正確」的旋轉可找。不同種子會給出不同但同樣合理的解混方向,與真實來源的相關係數每次都不一樣。
- 稀疏編碼與 PCA 編碼。 使用稀疏編碼的程式,比較每張測試影像的非零編碼元素數量,與相同維度(32)的 PCA 編碼。接著把
alpha設為 0.05、0.1、0.3、1.0,畫出稀疏編碼的測試 MSE。
提示
PCA 編碼是稠密的:32 個元素基本上全都非零。隨著 alpha 增大,啟動的原子數下降、誤差上升,畫出一條稀疏程度與精確度的取捨曲線。記得字典沒有平均值項,所以請比較曲線,而不是拿單一數字與 PCA 比。
- 去噪的不匹配。 用高斯雜訊訓練本篇的 DAE,再拿隨機一個 3 × 3 區塊被設為零的輸入來測試。接著用這種遮罩破壞訓練第二個 DAE,並把兩個模型在兩種破壞下都測一遍。
提示
這是兩種不同的破壞過程。用高斯雜訊訓練的模型從沒被要求補齊缺失的結構,所以通常會留下空洞;用遮罩訓練的模型則學會補全。請列出一張 2 × 2 的表(訓練破壞 × 測試破壞),而不是從其中一種的成功推論出對另一種的穩健性。
- 手算收縮懲罰。 對單一 sigmoid 單元 ,推導 。它何時最大?這說明收縮自編碼器允許編碼在什麼地方保持敏感?
提示
,所以平方範數為 。它在 (sigmoid 中段最陡處)最大,單元飽和時則幾乎為零。這個懲罰把單元推向對大多數輸入都飽和的狀態,只在資料確實需要變化的地方留在敏感區間。
參考文獻
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 13–14. Book
- K. P. Murphy, Probabilistic Machine Learning: An Introduction, MIT Press, 2022. Book
- Y. Bengio, A. Courville and P. Vincent, “Representation Learning: A Review and New Perspectives,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, no. 8, 2013. Paper
- M. E. Tipping and C. M. Bishop, “Probabilistic Principal Component Analysis,” Journal of the Royal Statistical Society: Series B, vol. 61, no. 3, 1999. Paper
- A. Hyvärinen and E. Oja, “Independent component analysis: algorithms and applications,” Neural Networks, vol. 13, no. 4–5, 2000. Paper
- B. A. Olshausen and D. J. Field, “Emergence of simple-cell receptive field properties by learning a sparse code for natural images,” Nature, vol. 381, 1996. Paper
- D. D. Lee and H. S. Seung, “Learning the parts of objects by non-negative matrix factorization,” Nature, vol. 401, 1999. Paper
- P. Baldi and K. Hornik, “Neural networks and principal component analysis: Learning from examples without local minima,” Neural Networks, vol. 2, no. 1, 1989. Paper
- G. E. Hinton and R. R. Salakhutdinov, “Reducing the Dimensionality of Data with Neural Networks,” Science, vol. 313, 2006. Paper
- P. Vincent, H. Larochelle, Y. Bengio and P.-A. Manzagol, “Extracting and composing robust features with denoising autoencoders,” ICML, 2008. Paper
- P. Vincent, H. Larochelle, I. Lajoie, Y. Bengio and P.-A. Manzagol, “Stacked Denoising Autoencoders: Learning Useful Representations in a Deep Network with a Local Denoising Criterion,” JMLR, vol. 11, 2010. Paper
- S. Rifai, P. Vincent, X. Muller, X. Glorot and Y. Bengio, “Contractive Auto-Encoders: Explicit Invariance During Feature Extraction,” ICML, 2011. Paper
- D. P. Kingma and M. Welling, “Auto-Encoding Variational Bayes,” ICLR, 2014. Paper
- D. P. Kingma and M. Welling, “An Introduction to Variational Autoencoders,” Foundations and Trends in Machine Learning, vol. 12, no. 4, 2019. Paper
- I. Higgins et al., “β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework,” ICLR, 2017. Paper
- D. Bank, N. Koenigstein and R. Giryes, “Autoencoders,” survey chapter, arXiv:2003.05991, 2020. Survey
- F. Locatello et al., “Challenging Common Assumptions in the Unsupervised Learning of Disentangled Representations,” ICML, 2019. Paper
- A. van den Oord, O. Vinyals and K. Kavukcuoglu, “Neural Discrete Representation Learning,” NeurIPS, 2017. Paper
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser and B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. Paper
- H. Cunningham, A. Ewart, L. Riggs, R. Huben and L. Sharkey, “Sparse Autoencoders Find Highly Interpretable Features in Language Models,” arXiv:2309.08600, 2023. Paper
- L. Gao et al., “Scaling and evaluating sparse autoencoders,” arXiv:2406.04093, 2024. Paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 07・生成模型:自編碼器、VAE、GAN 與正規化流 · 26 分鐘