ML 08・擴散模型與流匹配
先備知識:ML 07・生成模型:自編碼器、VAE、GAN 與正規化流、ML 05・注意力與視覺 Transformer
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 2 個互動實驗
把太空人照片與固定雜訊混合,並排檢視雜訊、乾淨影像與速度三種目標,再讓網路帶一點誤差,看看哪一種轉換回乾淨影像的方式承受得住。
你將學到
- 建立前向加雜訊程序與反向預測任務。
- 連結變分訓練與雜訊、乾淨影像及速度目標。
- 區分模型預測與數值取樣方法。
- 比較條件化、生成表示與流匹配。
- 評估完整影像/影片流程與少步方法。
先看全貌
擴散模型學的是「把受控的破壞復原」。訓練時,我們拿一個真實樣本,加上已知強度的 Gaussian 雜訊,然後請神經網路告訴我們加了什麼雜訊。因為雜訊是我們自己加的,正確答案永遠拿得到:不需要標籤,也不需要對手,就是迴歸而已。生成時,我們從純雜訊出發,反覆套用學到的「去掉一點雜訊」步驟,直到一個樣本浮現出來。
為什麼重要?從 2021 年起,擴散類模型在影像、影片與音訊合成上拿下了許多最先進的結果,同一套機制也用於影像修補、超解析度、影像編輯、3D 生成與科學資料。擴散模型也解決了 ML 07 中較早模型家族的兩個痛點:GAN 需要脆弱的雙人賽局,VAE 的樣本則容易模糊。擴散模型的訓練是穩定的迴歸,而因為生成被拆成許多小而容易的步驟,樣本也很清晰。
代價是取樣成本:經典取樣器每產生一張影像要呼叫網路數百次。2021 年以來的大量研究——DDIM、快速 ODE 求解器、蒸餾、一致性模型、流匹配、整流流——都是在維持品質的同時減少網路呼叫次數。
本章依照幾篇主要綜述的架構安排。Yang 等人 [1] 把領域分成高效取樣、改進概似(likelihood)與特殊結構資料三個方向;Croitoru 等人 [27] 依公式化方式(DDPM、雜訊條件分數網路、SDE)分類;Lipman 等人的流匹配指南 [2] 與 Lai 等人的專書 [29] 則把擴散與流視為同一族「學習出來的傳輸」。Prince 的教科書 [14] 是推導時很好的入門參考。全文每一節只使用一種明確的時間方向慣例,換慣例時會特別說明——混用慣例是這個領域最常見的正負號錯誤來源。
前向擴散有封閉解
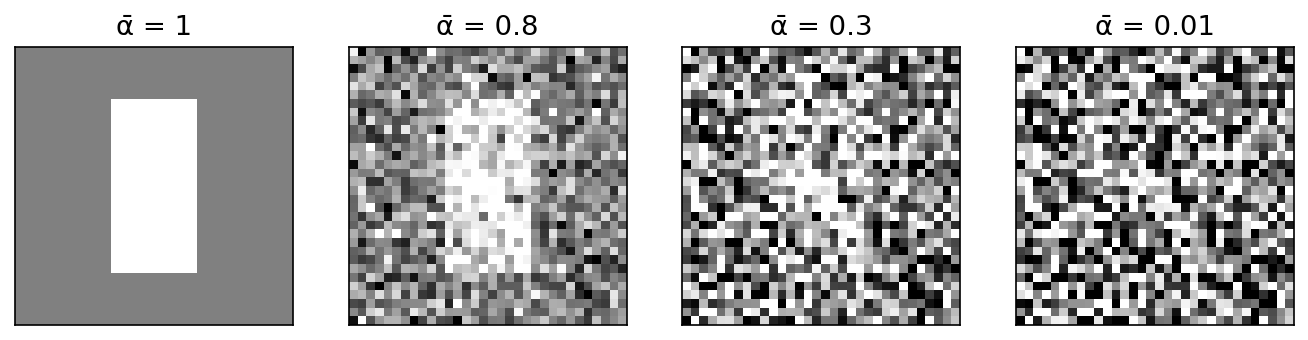
白話版。 前向程序逐漸減弱影像訊號並加入高斯雜訊;適當的終點排程使分布近似標準高斯。
這個想法可追溯到 Sohl-Dickstein 等人 [15]:用緩慢的前向擴散破壞結構,再學習把它反轉;DDPM [3] 讓它變得實用。令 為一筆資料(把影像攤平成 個數字,大致縮放到 )。選一組雜訊排程(noise schedule) ,其中 ,並記 。前向(加噪)過程是一條馬可夫鏈
其中 表示平均為 、共變異數為 的 Gaussian, 是 單位矩陣。係數 把訊號稍微縮小,讓總變異數維持有界而不會一路變大;這也是這一族被稱為變異數保持(variance preserving, VP)的原因。
推導一次到位的公式
把一步寫成 ,其中 。代入前一步,
兩個雜訊項是獨立、平均為零的 Gaussian,所以相加後仍是 Gaussian,變異數為 。把同樣的論證一路推回 ,令 ,得到
這裡 是到第 步仍保留的訊號變異數比例, 是一個標準 Gaussian 向量。這條公式讓訓練很便宜:我們可以直接跳到任何雜訊程度,不必模擬前面的每一步。
雜訊排程與訊雜比
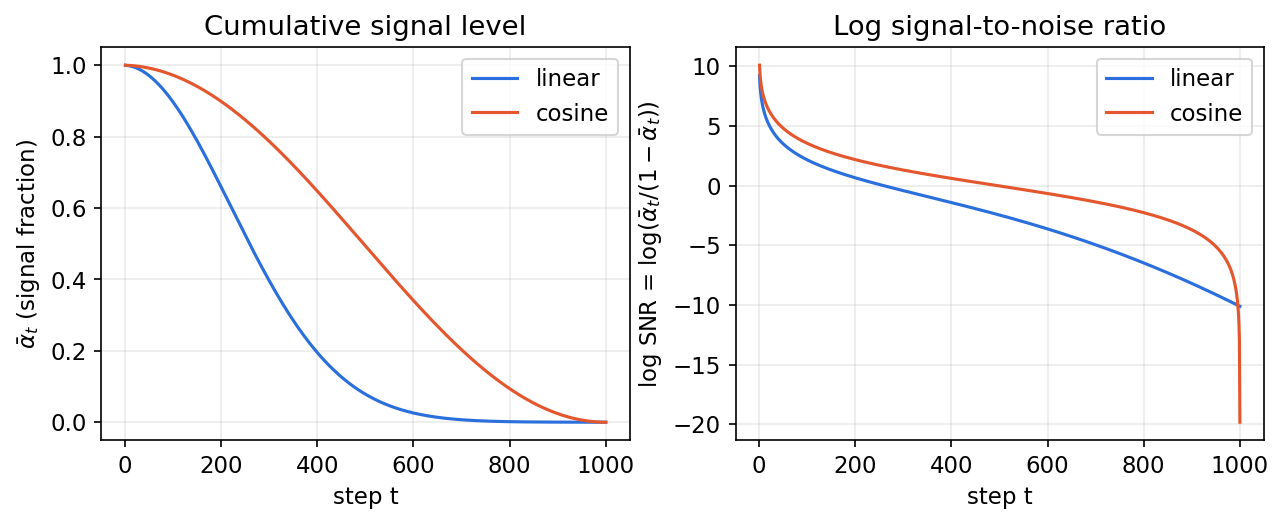
第 步的訊雜比(signal-to-noise ratio, SNR)為
即訊號變異數與雜訊變異數之比(假設資料變異數為 1)。它從 時非常大,單調下降到 時接近零。排程有兩個要求: 必須接近 ,讓 實際上就是標準 Gaussian(取樣器從 出發);中間各步則應把訓練資源花在網路真的有東西可學的雜訊程度上。
DDPM [3] 使用 與線性排程, 從 線性增加到 。Nichol 與 Dhariwal [19] 觀察到這樣會太快摧毀資訊:鏈的相當一大段裡,影像幾乎已經是純雜訊。他們的餘弦排程定義 ,其中 ,小偏移量 ,並把每個 截在 。圖 2 比較兩者。Karras 等人 [20] 後來主張:排程、網路輸入輸出的縮放,以及訓練時雜訊程度的分布,是應該分開調整的獨立設計選擇。
反向過程與變分下界
白話版。 要生成,就需要反向的一步:「給一個有雜訊的樣本,稍微乾淨一點的樣本長什麼樣?」對真實資料我們無法直接算出來,但如果同時知道乾淨樣本,就算得出來——而這正好給出一個簡單的訓練損失。
模型與下界
生成模型是一條反向馬可夫鏈,從 出發,使用學習出來的 Gaussian 轉移
其中 是參數為 的神經網路, 是我們稍後要選的變異數。這是一個以 為潛在變數的模型,就像一個編碼器 固定而非學習的深層 VAE(見 ML 07)。同樣的 Jensen 不等式論證給出證據下界(ELBO)。依照 [3]、[15],負的下界可以整理成一串 KL 散度的和:
是 Kullback–Leibler 散度。 沒有可學參數(當 時很小); 是最後一步的解碼項;每個 則把模型的反向一步與前向後驗分布 相比——也就是「如果知道乾淨樣本 ,反向一步會是什麼」的精確答案。
前向後驗是 Gaussian
由貝氏定理,。兩個因子對 都是 Gaussian,所以乘積也是 Gaussian。把 的二次項與一次項收集起來(配方),得到
後驗平均是乾淨樣本與目前雜訊樣本的加權平均;後驗變異數 比 略小。你不必相信代數:下面的程式抽樣前向鏈,並以 對 做迴歸。
程式碼 · Python · 23 行
import numpy as np

rng = np.random.default_rng(0)
beta = np.linspace(1e-4, 0.02, 1000)
alpha = 1 - beta
abar = np.cumprod(alpha)
t, x0, n = 300, 1.3, 400_000           # check q(x_{t-1} | x_t, x_0) at step t

# Sample the forward chain: x_{t-1} from q(x_{t-1}|x_0), then one more step.
x_prev = np.sqrt(abar[t-1])*x0 + np.sqrt(1-abar[t-1])*rng.normal(size=n)
x_t = np.sqrt(alpha[t])*x_prev + np.sqrt(beta[t])*rng.normal(size=n)

# Empirical regression of x_{t-1} on x_t (the posterior mean is linear in x_t).
slope, intercept = np.polyfit(x_t, x_prev, 1)
resid_var = np.var(x_prev - (slope*x_t + intercept))

# Closed-form posterior from the derivation.
c_x0 = np.sqrt(abar[t-1])*beta[t] / (1-abar[t])
c_xt = np.sqrt(alpha[t])*(1-abar[t-1]) / (1-abar[t])
var = beta[t]*(1-abar[t-1]) / (1-abar[t])
print(f"slope     {slope:.4f}  vs  {c_xt:.4f}")
print(f"intercept {intercept:.4f}  vs  {c_x0*x0:.4f}")
print(f"variance  {resid_var:.6f}  vs  {var:.6f}")
輸出在小數點後三到四位吻合(斜率 0.9934 對 0.9930,變異數 0.006050 對 0.006052);微小差距是蒙地卡羅誤差。
從下界到簡化損失
現在把前向公式反過來用:。代入 ,再用 化簡,
取樣時網路看得到 ,卻看不到 。所以 DDPM 讓模型平均採用完全相同的形式,只是把未知的雜訊換成預測值 :
兩個共變異數同為固定 的 Gaussian,其 KL 散度就是兩個平均之間平方距離的縮放,因此
其中 與 無關。下界的每一項因此都是加權的雜訊預測誤差。Ho 等人 [3] 發現,拿掉權重並均勻抽樣 ,訓練效果反而更好:
把它當成演算法來讀:挑一筆訓練資料、挑一個隨機步數、挑隨機雜訊,用一行算出 ,然後迴歸這個雜訊。時間 會餵給網路(通常透過正弦嵌入),因為同樣的像素值在不同雜訊程度下代表不同意義。
有兩點容易弄錯。第一, 不是概似下界:拿掉權重相對降低了低雜訊步的比重,這有助於樣本品質,卻會讓報告的對數概似變差。Improved DDPM [19] 用混合損失學習變異數 (在 與 之間內插),找回了好的概似。第二,同一個網路也給出乾淨估計
每個現代取樣器內部都會用到它。當 非常小時,這個除法會放大預測誤差,所以高雜訊時的 是一個模糊的平均,而不是一個樣本。
選讀:DDPM(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
雜訊、乾淨資料、速度與分數
白話版。 預測雜訊、預測乾淨影像、預測「往哪個方向走會讓這個樣本更典型」,是表達同一份知識的三種方式。差別在縮放,而縮放會改變訓練損失對不同雜訊程度的加權。
三種參數化
因為 是固定的線性關係,網路可以輸出下列任何一個:
給定 與 ,三者可以彼此精確換算。但是對 、 或 做不加權的 MSE,對各雜訊程度的加權並不相同,所以這個選擇會影響訓練。Karras 等人 [20] 用輸入輸出的「預條件(preconditioning)」係數把這件事講清楚:讓網路在每個雜訊程度下的輸入與目標都維持單位變異數。注意,這裡擴散模型的「速度」是訊號與雜訊的一種重新參數化;它與本章後面流匹配的傳輸速度相關,但不相同。
精確轉換不代表有限容量網路等價
對保留變異數的路徑,令 與 ,因此 ,而 。擴散速度 與前向狀態共同構成一個旋轉:
這裡 是已知的排程係數; 是 [22] 使用的目標;帽號表示估計值;上標指出網路直接輸出的量。最後兩種轉換的除數必須非零。即使內部時間的代數精確,端點附近仍有數值與統計上的不穩定問題。
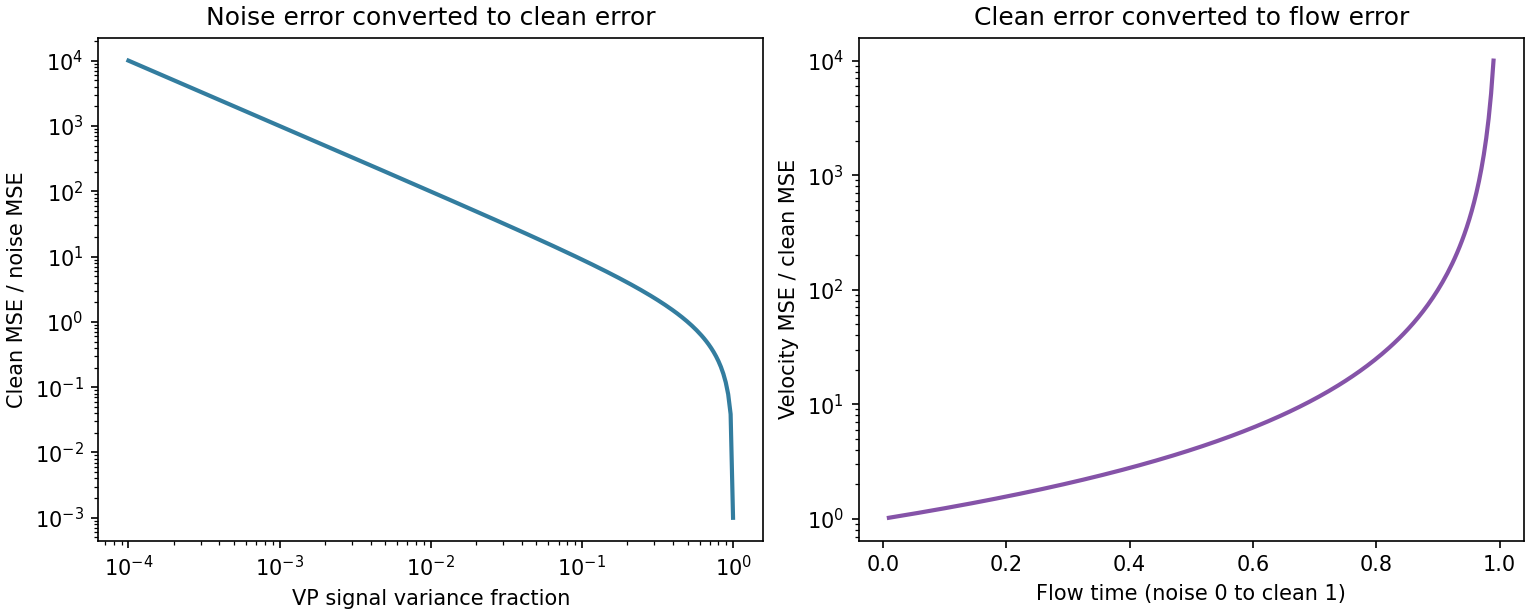
雜訊誤差 會變成乾淨影像誤差 。因此,固定雜訊程度下互相對應的預測滿足:
是訊雜比;第二個恆等式由前述旋轉得到。相同形式的無加權損失因此會強調不同時間。改變目標卻未記錄時間抽樣與損失權重,就混入了其他實驗變因 [20]、[22]。
另外還有容量問題。若網路直接輸出乾淨影像,最後的表徵可以捨棄干擾性的雜訊。直接輸出雜訊的網路可能必須保留輸入中更多座標,或透過跳接取得那些座標。事後轉換某個網路的輸出,不會讓它的架構等同於直接學習另一種目標的網路。對大像素區塊與高維潛在表徵,這個差異尤其值得檢查;後面的 JiT 討論提供近期證據 [42]。這不代表雜訊預測普遍失敗:前面的 DDPM 範例與密集影像去雜訊網路就是反例。
程式碼 · Python · 28 行
import numpy as np

rng = np.random.default_rng(7)
x0 = rng.normal(size=32)
eps = rng.normal(size=32)
a, b = np.sqrt(.2), np.sqrt(.8)
xt = a*x0 + b*eps
v_vp = a*eps - b*x0
assert np.allclose(a*xt - b*v_vp, x0)
assert np.allclose(b*xt + a*v_vp, eps)

# A deliberately imperfect noise estimate: compare equivalent losses.
eps_hat = eps + .03*rng.normal(size=32)
x_hat = (xt - b*eps_hat)/a
noise_mse = np.mean((eps_hat - eps)**2)
clean_mse = np.mean((x_hat - x0)**2)
assert np.allclose(clean_mse/noise_mse, b*b/(a*a))
print("Clean/noise MSE ratio:", round(clean_mse/noise_mse, 3))

# A straight flow uses a different path and a different velocity.
t = .35
zt = (1-t)*eps + t*x0
u = x0 - eps
x_from_flow = zt + (1-t)*u
u_from_clean = (x0 - zt)/(1-t)
assert np.allclose(x_from_flow, x0)
assert np.allclose(u_from_clean, u)
print("VP velocity equals straight-flow target:", np.allclose(v_vp, u))
範例印出損失比例 4.0,並以 False 指出兩種速度目標不同。文獻有時都用字母 ;檢查點的排程器必須指出真正的路徑、正規化與時間方向。
什麼是分數?為什麼去雜訊能估計它?
密度 的分數(score)是 :一個指向更高機率方向的向量場。如果知道分數,就能用 Langevin 動力學取樣:沿著分數走一小步、加一點雜訊,反覆進行。Song 與 Ermon [17] 在多個雜訊程度上訓練「雜訊條件分數網路(NCSN)」,並以退火 Langevin 動力學取樣——這是一條與擴散平行的路線,後來證明是同一個想法。
連接兩者的橋梁是去雜訊分數匹配(denoising score matching)(Vincent [16])。對 Gaussian 破壞而言,(在均方誤差意義下)最好的雜訊預測器是一個條件期望值 ,而 Tweedie 公式 [40] 把它連到雜訊邊際分布 的分數:
其中 是學到的分數。同一個公式用「乾淨」單位寫成 。兩個提醒:這是第 層加噪後的邊際分布的分數,不是任何單張訓練影像的梯度;而且它對最佳預測器成立——訓練出來的網路只是近似。
你可以在一切都已知的情況下驗證 Tweedie 公式:一維 Gaussian 資料,此時最佳雜訊預測器對 是線性的。
程式碼 · Python · 16 行
import numpy as np

rng = np.random.default_rng(0)
s, abar, n = 0.7, 0.4, 500_000     # data x0 ~ N(0, s^2); one noise level
x0 = s*rng.normal(size=n)
eps = rng.normal(size=n)
xt = np.sqrt(abar)*x0 + np.sqrt(1-abar)*eps

# "Train" the best linear noise predictor eps_hat = w * x_t by least squares.
w = (xt @ eps) / (xt @ xt)
score_from_eps = -w / np.sqrt(1-abar)       # s(x_t) = -eps_hat / sqrt(1-abar)

# Exact: x_t ~ N(0, abar s^2 + 1 - abar), so grad log p_t(x) = -x / var.
exact = -1 / (abar*s**2 + 1 - abar)
print(f"score slope from noise predictor: {score_from_eps:.4f}")
print(f"exact score slope:                {exact:.4f}")
它印出 對 :對雜訊做迴歸就能找回分數。
SDE 觀點
Song 等人 [4] 讓步數趨於無窮。用連續時間 與速率 ,VP 前向過程變成隨機微分方程(SDE)
其中 是標準 Wiener 過程(布朗運動)。一個經典結果指出:這個過程倒著時間跑,仍然是一條 SDE,而其中唯一未知的量就是分數:
此處 為負, 是反向時間的 Wiener 過程。此外,還存在一條確定性的機率流 ODE(probability-flow ODE),其解在每個時間點的邊際分布 都相同:
這把整個領域統一起來。DDPM 的祖先取樣與反向 SDE 的離散化相連;NCSN [17] 對應到「變異數爆炸(variance exploding)」SDE。機率流 ODE 定義一個連續正規化流,其對數密度遵循瞬時變數變換恆等式 [4]。恆等式是精確的,但實際計算仍有 ODE 積分誤差;若以隨機方式估計散度,還有估計誤差。使用近似的學得分數時,ODE 與反向 SDE 的邊際分布也不一定完全相同。ODE 觀點同時說明了確定性取樣與一般數值求解器的用途。
取樣是一個反向過程
白話版。 在單一隨機雜訊程度上算出的損失並不是生成器。要生成,必須從純雜訊出發,以一致的排程串起許多反向步驟——而你可以選擇要走幾步、每步注入多少新的隨機性。
DDPM 祖先取樣
DDPM 沿著學到的反向鏈取樣:
最後一步不再加入雜訊。Ho 等人 [3] 報告 與 的結果相近;學習出的變異數 [19] 在步數較少時幫助最大。
程式:二維分布上的 DDPM
這個完整的 CPU 範例(約 10 秒)使用兩個中心在 、標準差 的 Gaussian 群集。它包含影像模型的每個運算——排程、隨機時間訓練、雜訊預測、反向平均——卻不需要影像等級的計算量。在 100 步與這個排程下,到 時幾乎沒有訊號殘留。
程式碼 · Python · 41 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
torch.set_num_threads(1)
T = 100
beta = torch.linspace(.001, .15, T)
alpha = 1-beta
abar = alpha.cumprod(0)
previous = torch.cat([torch.ones(1), abar[:-1]])
post_var = beta * (1-previous) / (1-abar)
net = nn.Sequential(nn.Linear(3, 64), nn.SiLU(),
                    nn.Linear(64, 64), nn.SiLU(), nn.Linear(64, 2))
opt = torch.optim.Adam(net.parameters(), lr=.002)
def data(n):
    side = torch.randint(2, (n, 1))*2-1
    return torch.cat([side*1.5, torch.zeros(n, 1)], 1) + .25*torch.randn(n, 2)
for step in range(3000):
    x0 = data(128)
    t = torch.randint(T, (len(x0),))
    eps = torch.randn_like(x0)
    a = abar[t, None]
    xt = a.sqrt()*x0 + (1-a).sqrt()*eps
    predicted = net(torch.cat([xt, t[:, None].float()/(T-1)], 1))
    loss = F.mse_loss(predicted, eps)
    opt.zero_grad(); loss.backward(); opt.step()
net.eval()
with torch.no_grad():
    x = torch.randn(512, 2)
    for t in reversed(range(T)):
        time = torch.full((len(x), 1), t/(T-1))
        eps = net(torch.cat([x, time], 1))
        mean = (x-beta[t]/(1-abar[t]).sqrt()*eps)/alpha[t].sqrt()
        x = mean + post_var[t].sqrt()*torch.randn_like(x) if t else mean
    assert torch.isfinite(x).all()
    print("terminal signal:", round(abar[-1].item(), 6))
    left = x[x[:, 0] < 0]
    print("fraction in left cluster:", round((x[:, 0] < 0).float().mean().item(), 3))
    print("left cluster: mean x", round(left[:, 0].mean().item(), 2),
          "std", round(left[:, 0].std().item(), 2), "(data: -1.5 and 0.25)")
在我們的機器上,它印出終端訊號 0.000349、左群集比例 0.441,左群集平均與標準差為 與 。群集的形狀是對的;44/56 的分配則顯示這個小網路沒有精確學到各模態的權重。這就是為什麼單一摘要數字永遠不夠:一定要把樣本畫出來,並對照新抽的資料檢查模態涵蓋、模態內離散程度與離群值。
DDIM:同樣的訓練,不同的取樣器
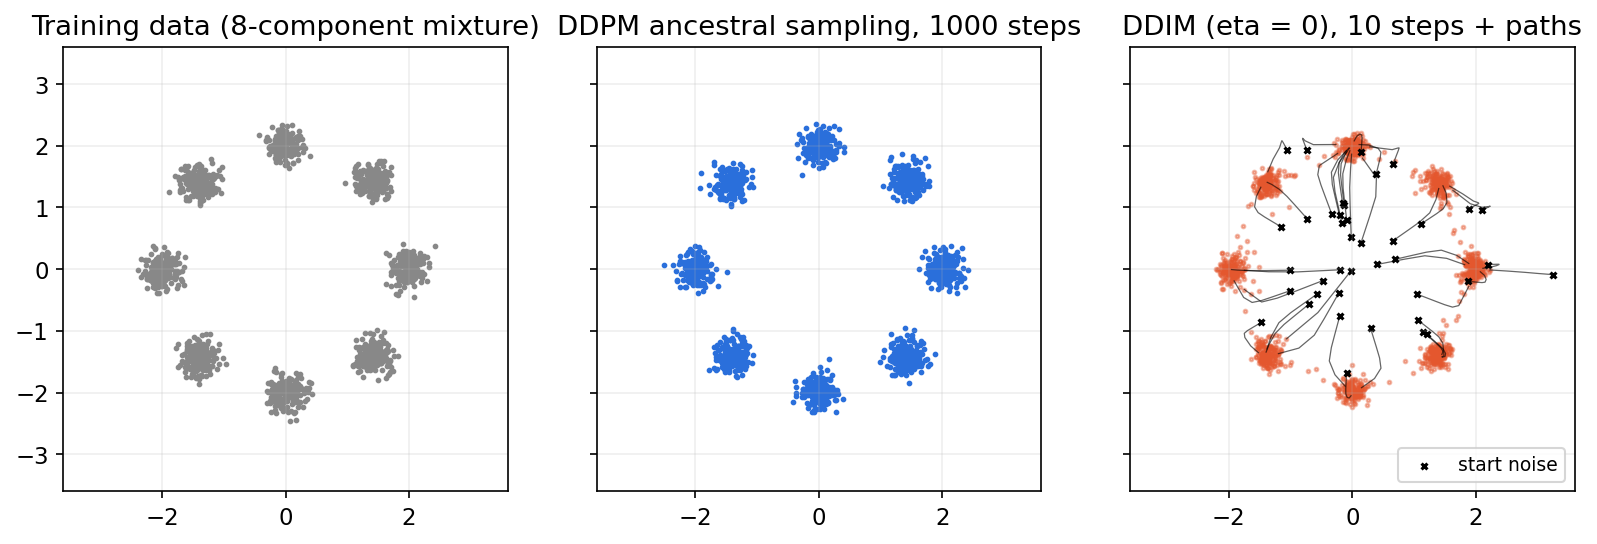
Song、Meng 與 Ermon [5] 注意到 只依賴邊際分布 ,而不依賴產生它們的馬可夫鏈。許多非馬可夫的前向過程擁有相同的邊際分布,每一個都給出不同的反向取樣器——而且全部都能用同一個訓練好的 。對任何遞減的步數子序列 ,DDIM 的更新是
其中 是在 的乾淨估計, 控制隨機性。讀法是:「先估計乾淨樣本,再沿著預測的雜訊方向,把它重新加噪到下一個較低的雜訊程度。」當 且步數連續時,它還原 DDPM 的後驗變異數;當 時,取樣器是確定性的,也是機率流 ODE 的一種離散化。確定性有實際影響:同樣的起始雜訊永遠得到同樣的輸出,所以可以在雜訊空間內插,或把真實影像反推回它的雜訊(DDIM inversion),這是許多影像編輯方法的基礎。
以下獨立範例重複相同的小型訓練設定,讓程式能單獨執行。在同一工作階段實驗時,可直接重用已訓練的 net、abar 與 T:
程式碼 · Python · 50 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
torch.set_num_threads(1)
T = 100
beta = torch.linspace(.001, .15, T)
alpha = 1-beta
abar = alpha.cumprod(0)
previous = torch.cat([torch.ones(1), abar[:-1]])
post_var = beta * (1-previous) / (1-abar)
net = nn.Sequential(nn.Linear(3, 64), nn.SiLU(),
                    nn.Linear(64, 64), nn.SiLU(), nn.Linear(64, 2))
opt = torch.optim.Adam(net.parameters(), lr=.002)
def data(n):
    side = torch.randint(2, (n, 1))*2-1
    return torch.cat([side*1.5, torch.zeros(n, 1)], 1) + .25*torch.randn(n, 2)
for step in range(3000):
    x0 = data(128)
    t = torch.randint(T, (len(x0),))
    eps = torch.randn_like(x0)
    a = abar[t, None]
    xt = a.sqrt()*x0 + (1-a).sqrt()*eps
    predicted = net(torch.cat([xt, t[:, None].float()/(T-1)], 1))
    loss = F.mse_loss(predicted, eps)
    opt.zero_grad(); loss.backward(); opt.step()
net.eval()

def ddim_sample(n, steps, eta=0.0, seed=1):
    g = torch.Generator().manual_seed(seed)
    taus = torch.linspace(T-1, 0, steps).round().long()
    x = torch.randn(n, 2, generator=g)
    with torch.no_grad():
        for i, t in enumerate(taus):
            time = torch.full((n, 1), t.item()/(T-1))
            eps = net(torch.cat([x, time], 1))
            a_t = abar[t]
            a_prev = abar[taus[i+1]] if i+1 < steps else torch.tensor(1.)
            x0_hat = (x - (1-a_t).sqrt()*eps) / a_t.sqrt()
            sigma = eta*((1-a_prev)/(1-a_t)*(1-a_t/a_prev)).sqrt()
            x = (a_prev.sqrt()*x0_hat + (1-a_prev-sigma**2).sqrt()*eps
                 + sigma*torch.randn(n, 2, generator=g))
    return x

for steps in [5, 20, 100]:
    s = ddim_sample(2000, steps)
    left = s[s[:, 0] < 0]
    print(f"{steps:3d} steps: left fraction {(s[:, 0] < 0).float().mean():.3f}, "
          f"left-cluster mean x {left[:, 0].mean():.2f}, std {left[:, 0].std():.2f}")
輸出呈現典型的規律。用 5 步時,左群集中心在 、標準差 ——樣本被拉向中間並被抹開,因為大步長是用直線去走一條彎曲的軌跡。用 20 步時是 與 ;100 步時是 與 ,接近資料。改變步數完全不需要重新訓練。
更快的求解器
一旦取樣等同於「解一條 ODE」,數值分析就派得上用場。Karras 等人(EDM)[20] 使用二階 Heun 求解器搭配仔細選擇的雜訊程度間距,並證明取樣器、排程、預條件與訓練雜訊分布可以分開調整。DPM-Solver [21] 利用擴散 ODE 的半線性結構——線性部分可以精確積分——在大約 10 次網路評估內達到良好品質。隨機取樣器在每一步加一點新雜訊;這需要更多步,但可以修正累積的誤差。無論用哪種求解器,都要報告函數評估次數(number of function evaluations, NFE):網路被呼叫的次數才是真正的取樣成本,而不是「步數」。
操控生成:條件與引導
白話版。 條件指定所需輸出,引導調整取樣偏向條件的強度;更強引導不一定產生更好影像。
條件化
條件模型學習 ,其中 是條件。類別標籤透過嵌入加到時間嵌入上;文字透過交叉注意力(cross-attention),讓影像特徵去關注文字編碼器的 token [7];影像(用於超解析度、修補、編輯)則串接到輸入通道,或經由額外的編碼器送入。
分類器引導
對加噪後的邊際分布套用貝氏定理,得到 。Dhariwal 與 Nichol [18] 在加噪影像上另外訓練一個分類器 ,把它的梯度乘上 加到無條件模型上。以雜訊單位表示,
尺度 大致是從 取樣——一個被銳化的分布,用多樣性換取擬真度。加上架構改進,這篇論文展示了擴散模型在 ImageNet [35] 的樣本品質上勝過 GAN [18]。缺點是需要額外的分類器,而且必須在每個雜訊程度的雜訊輸入上訓練。
無分類器引導(CFG)
Ho 與 Salimans [6] 拿掉了分類器。訓練時,隨機一部分樣本的條件被換成「空」標記,於是同一個網路同時學到 與 。貝氏定理告訴我們,分類器梯度等於條件分數與無條件分數之差,所以上式的「隱式分類器」版本是
在這個慣例下, 是無條件, 是普通的條件模型, 則外插超過它。(有些論文把同一件事寫成 ,因此他們的「尺度」是我們記號中的 ;比較數字之前一定要先確認慣例。)
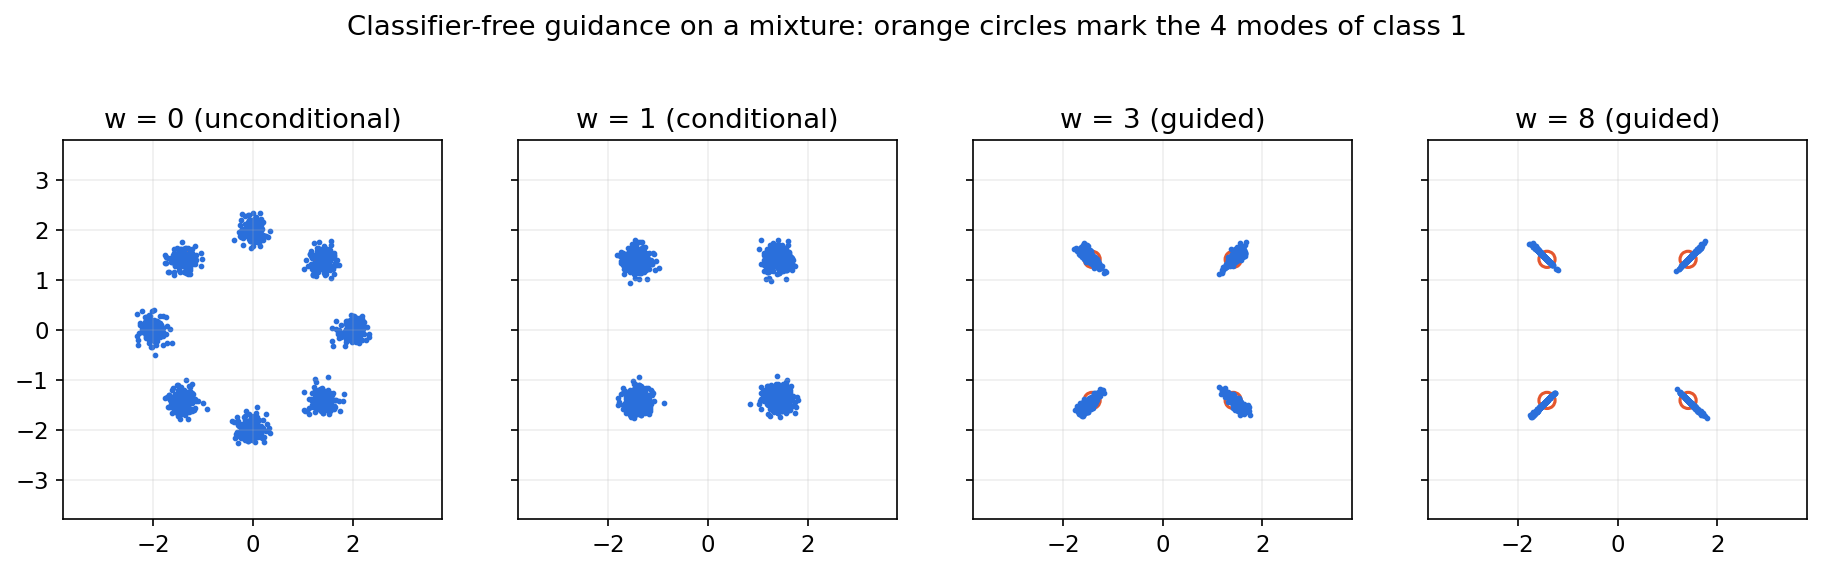
下面的程式使用四團混合分布的精確雜訊預測器,因此任何奇怪的行為都來自引導本身,而不是網路沒訓練好。類別 1 是 的那兩團。
程式碼 · Python · 32 行
import numpy as np

# Data: four Gaussian blobs at the corners of a square; class c is the sign of x.
MU = np.array([[-1.5, -1.5], [-1.5, 1.5], [1.5, -1.5], [1.5, 1.5]])
SIG = 0.2
CLASS = np.array([0, 0, 1, 1])

def eps_exact(x, abar, comps):
    """Exact E[eps | x_t] for a Gaussian mixture restricted to `comps`."""
    m = np.sqrt(abar)*MU[comps]
    var = abar*SIG**2 + 1 - abar
    logw = -((x[:, None] - m[None])**2).sum(-1) / (2*var)
    w = np.exp(logw - logw.max(1, keepdims=True))
    w /= w.sum(1, keepdims=True)
    score = -(w[..., None]*(x[:, None] - m[None])).sum(1) / var
    return -np.sqrt(1-abar)*score

abar = np.cumprod(1 - np.linspace(1e-4, 0.02, 1000))
taus = np.linspace(999, 0, 50).round().astype(int)
everything, class1 = np.arange(4), np.where(CLASS == 1)[0]
print("data: mean distance to its mode", round(SIG*np.sqrt(np.pi/2), 3))
for w in [0, 1, 3, 8]:
    x = np.random.default_rng(0).normal(size=(4000, 2))
    for i, t in enumerate(taus):                    # deterministic DDIM
        e_u, e_c = eps_exact(x, abar[t], everything), eps_exact(x, abar[t], class1)
        e = e_u + w*(e_c - e_u)                     # classifier-free guidance
        x0 = (x - np.sqrt(1-abar[t])*e) / np.sqrt(abar[t])
        a_prev = abar[taus[i+1]] if i+1 < len(taus) else 1.0
        x = np.sqrt(a_prev)*x0 + np.sqrt(1-a_prev)*e
    dist = np.linalg.norm(x[:, None] - MU[None], axis=-1).min(1)
    print(f"w={w}: class-1 fraction {(x[:, 0] > 0).mean():.3f}, "
          f"mean distance to nearest mode {dist.mean():.3f}")
資料到其模態的平均距離是 0.251。 時約一半樣本(0.490)屬於類別 1; 時全部屬於類別 1,距離為 0.225(50 步 DDIM 略微低估離散程度)。 時距離為 0.259, 時增加到 0.446:強引導不只是「讓它更像類別 1」——它把樣本推超過資料,這是影像模型在非常高引導下出現過飽和色彩與變形的玩具版本。圖 4 在八模態混合上呈現同樣的效應。
引導也有計算成本:每一步都需要一次條件預測和一次無條件預測,所以 30 步的引導取樣器需要 60 次網路評估,除非兩者被合併計算。而且 是取樣的旋鈕,不是影像與提示詞相符程度的校準指標。
潛在擴散與擴散 Transformer
白話版。 像素很昂貴。先用自編碼器把影像壓縮成較小的特徵網格,在這個壓縮空間裡做擴散,最後再解碼。另外,去雜訊網路本身也可以是 Transformer,而不是卷積式 U-Net [37]。
潛在擴散
Rombach 等人 [7] 先訓練一個自編碼器:編碼器 把 影像映射成 的潛在表示,空間降取樣倍率為 ;解碼器 再映射回來。自編碼器以重建、感知與對抗損失,加上輕量的正則化(朝向 Gaussian 的小 KL 項,或向量量化)訓練,讓潛在空間保持良好性質。接著在 上照原樣訓練擴散模型,生成最後以 結束。當 時, 影像變成 的潛在表示:每次網路呼叫的空間位置少了 64 倍。
取捨是重建瓶頸:編碼器丟棄的資訊無法由該代碼忠實找回,雖然解碼器可能合成合理細節。潛在表示的尺度也必須與擴散模型訓練時一致;實作上會把潛在表示重新縮放到大約單位變異數。[7] 的文字條件化在 U-Net 中使用交叉注意力層,這也是 Stable Diffusion 系列背後的設計。
擴散 Transformer
DiT(Peebles 與 Xie [8])把 U-Net 換成在潛在 patch 上運作的 Vision Transformer [41](見 ML 05)。大小為 的潛在表示被切成 的 patch,得到 個 token; 越小,token 越多、計算量越大、品質越好。時間步與類別標籤透過自適應層正規化(adaptive layer norm)為每個區塊提供條件:它們預測每個 LayerNorm 的縮放與平移;在「adaLN-Zero」變體中還預測一個初始化為零的閘控係數,讓每個殘差區塊一開始等於恆等映射。這篇論文的主要發現是一個縮放趨勢:在不同模型大小與 patch 大小之間,Transformer 計算量(GFLOPs)越多,FID 就穩定地越低 [8]。
把三個選擇分開來看很有幫助。架構(U-Net 或 Transformer)是函數近似器。目標(雜訊、、 或流速度)是它要迴歸的對象。取樣器(DDPM、DDIM、ODE 求解器)則決定預測如何變成影像。Stable Diffusion 3 [9] 是一種新組合的例子:一個潛在 Transformer,影像與文字 token 串流使用各自的權重但共同做注意力(「MM-DiT」),以整流流目標訓練,並讓訓練時間步的分布偏向中間雜訊程度。
對影片而言,潛在表示與注意力必須同時涵蓋時間與空間,因此壓縮與注意力模式成為主要的工程問題。Melnik 等人的綜述 [31] 回顧了影片擴散的架構、時間一致性機制與評估。在影片上,逐格品質不夠:物體恆存、動作合理性與長時間一致性都需要各自的評估。
像素空間、潛在空間與表徵自編碼器
白話版。 生成器需要一個反覆更新的空間。它可以是影像本身、緊湊的重建代碼,也可以是視覺表徵模型學到的特徵。加入潛在階段,是選擇特定的計算與統計取捨,而不是生成模型必備的條件。
為什麼像素要變成潛在表徵,再變回像素?
訓練影像以像素形式進來,輸出也必須是可觀看的像素。在兩端之間,編碼器可以去除冗餘,產生適合反覆更新、成本較低的網格 [7]。先用重建訓練編碼器與解碼器,再對編碼後的訓練影像學習生成分布。兩項工作不同:重建保留某個指定樣本;生成學習哪些編碼樣本合理。
訓練與取樣路徑如下:
這裡 是訓練影像; 與 是編碼器與解碼器; 是編碼後的影像; 是其受污染狀態; 是生成預測器的參數; 是生成的代碼; 是生成影像; 是重建影像。純文字到影像取樣不需要先編碼一張輸入影像。編輯與影像到影像生成則可以編碼實際輸入,從部分污染的代碼開始。
主要節省來自去雜訊器或流預測器會反覆執行,而編碼訓練資料與解碼樣本的次數相對少。空間縮減因子 使網格位置減少 倍,但潛在通道數同樣重要。三通道影像與 通道潛在表徵的純量數量縮減比例是 。不能把網格縮減比例直接說成所有浮點數量或總執行時間的縮減比例。
對 Transformer,還必須區分詞元數與詞元寬度。完整注意力儲存的矩陣元素數與 成正比,其中 是詞元數;特徵投影也受詞元寬度影響 [41]。像素與潛在空間都能以區塊大小降低 。這些數量本身不能預測實際速度,因為運算核心、記憶體傳輸、解碼器與條件化也有成本。
程式碼 · Python · 15 行
# Synthetic shape bookkeeping, not a benchmark or a specific checkpoint.
H = W = 512
channels, spatial_factor, patch = 4, 8, 2
pixel_values = H*W*3
h = H//spatial_factor
w = W//spatial_factor
latent_values = h*w*channels
pixel_tokens = (H//patch)*(W//patch)
latent_tokens = (h//patch)*(w//patch)
print("Spatial positions reduction:", (H*W)//(h*w))
print("Scalar values reduction:", pixel_values//latent_values)
print("Dense attention entries reduction:", pixel_tokens**2//latent_tokens**2)
assert pixel_values//latent_values == 48
assert pixel_tokens//latent_tokens == 64
assert pixel_tokens**2//latent_tokens**2 == 4096
此人工例子得到空間位置少 64 倍、純量少 48 倍、注意力矩陣元素少 4096 倍,條件是兩個座標空間都採用數值相同的區塊大小。改變區塊大小,比較結果就會改變。像素 Transformer 可以使用大得多的區塊,得到與潛在 Transformer 相同的詞元數。
代價是資訊流失。若兩張影像具有相同代碼,確定性的解碼器無法還原各自不同的精確細節。解碼器可以補出合理紋理,但那沒有找回原始影像的資訊。因此,生成訓練之前應獨立評估重建。檢查細線、文字與跨影格變化,而不只看平均影像誤差。
下例的簡單編碼器對區塊取平均,解碼器重複這些平均值。它示範瓶頸,不宣稱重現學習式 VAE 或 RAE。
程式碼 · Python · 13 行
import numpy as np

y, x = np.mgrid[:64, :64]
checker = ((x+y) % 2).astype(float)
smooth = x/63
image = .6*smooth + .4*checker
f = 4
latent = image.reshape(64//f, f, 64//f, f).mean(axis=(1, 3))
reconstruction = np.repeat(np.repeat(latent, f, axis=0), f, axis=1)
print("Synthetic reconstruction MSE:", round(np.mean((image-reconstruction)**2), 6))
assert np.mean((image-reconstruction)**2) > .04
# Recovering the exact latent does not recover the missing checkerboard.
assert np.allclose(reconstruction[0, :f], reconstruction[0, 0])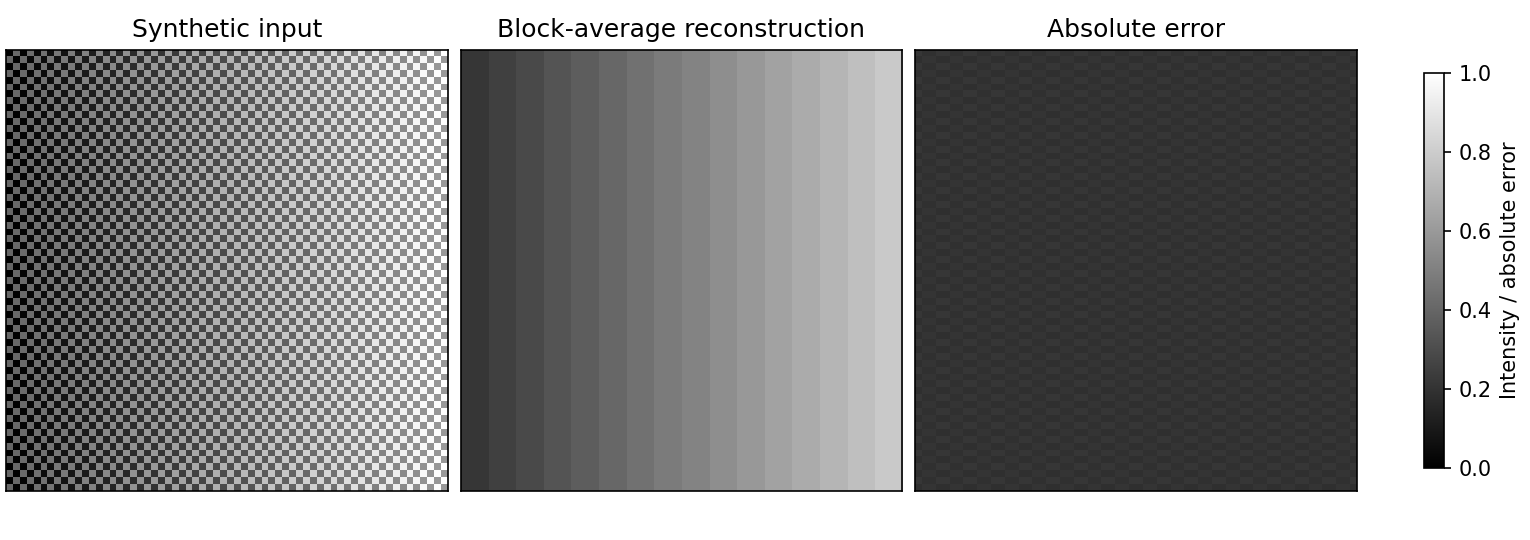
在編輯時,反覆編碼與解碼結果可能累積失真。若流程允許,可將中間編輯保留在相容的潛在空間,並檢查最後的像素輸出。優良的無條件生成器仍可能不擅長重建。自編碼器的上限指的是對編碼資訊的忠實還原,並不表示生成解碼器永遠無法合成新的細緻紋理。
重建代碼與語意表徵代碼
VAE 編碼器以重建目標與分布正則化訓練,其代碼設計是為了支援解碼與取樣 [7]。預訓練辨識編碼器則學習有用的視覺特徵。兩者目標可以一致,但辨識所需的不變性也可能捨棄忠實重建需要的細節。解碼器與保留下來的特徵結構,決定表徵是否適合成為生成空間。
Zheng、Ma、Tong 與 Xie 的表徵自編碼器(Representation Autoencoders,RAEs)[43],把凍結的預訓練表徵編碼器搭配可訓練解碼器。其 ICLR 2026 研究以語意視覺特徵作為生成模型的空間,檢查高維詞元特徵、依維度調整的雜訊排程、解碼器穩健性,以及淺而寬的擴散輸出頭。這改變了模型生成的表徵,而不只是對傳統潛在預測器加入特徵對齊損失。
不要把「潛在」等同於「每一維都更小」。空間稀疏的特徵網格仍可能有很多通道。RAE 也不會自動成為變分模型:凍結特徵擷取器加上解碼器,本身並未定義 Gaussian 後驗、KL 正則化或概似下界。應分別測量重建、表徵品質與生成品質。
Tong 等人 [44] 在 2026 年將此方法延伸到自由形式的文字到影像生成。研究在更大規模比較 RAE 與 VAE 空間,並檢查解碼器資料組成。結果顯示,依維度調整的雜訊排程仍重要,而某些小規模架構與解碼器調整在其較大規模設定下幫助有限。這提醒我們在規模與資料變化時重新測試配方,不能把 ImageNet 結果當成普遍設計規則。
對新應用,檢查所選編碼器是否保留重要內容:文件的細小文字、檢測影像的小缺陷,或影片的影格間差異。用保留的真實特徵與生成特徵分別評估解碼器。只用精確訓練代碼學習的解碼器,可能對取樣代碼的小幅分布外誤差敏感。依訓練配方正規化特徵,並將編碼器版本與生成檢查點一起記錄。
JiT:在像素上直接預測乾淨影像
Li 與 He 的 Just image Transformers(JiT)[42] 在 2025 年發布預印本,並於 CVPR 2026 發表,重新檢查直接操作像素的大區塊 Transformer。網路預測乾淨影像,再由該預測推得取樣用的流速度。其控制實驗支持以流形解釋的觀點:瓶頸能保留有結構的乾淨影像資訊,卻可能讓直接預測高維雜訊或速度變困難。該實驗設定不使用預訓練潛在詞元化器或額外表徵損失。這是特定架構與訓練條件的證據,不是像素模型總能勝過潛在生成器的證明。
關鍵是區分網路直接輸出與損失或求解器使用的量。對後面定義的直線路徑,使用 , 是雜訊, 是乾淨資料。直接預測 的網路可以提供:
這裡 是乾淨影像; 是抽出的雜訊; 是兩者內插; 是直接預測; 是對應的傳輸速度。恆等式適用於 且尚未進行數值截限的情況。因此,輸出 的網路可以用速度空間的損失訓練。稱為「乾淨預測」不代表損失是無加權的乾淨影像 MSE。JiT 的釋出實作清楚呈現此差異 [42]。
附近,除以 必須有端點慣例與數值保護。就內部時間的代數而言,固定乾淨影像誤差越靠近端點,放大程度越高。取樣時應使用檢查點的時間分布、雜訊縮放與求解器配方。只改直接輸出的標籤,無法重現方法。
有意義的比較應固定訓練資料、計算量、解析度、詞元數與取樣器,再逐一改變表徵或目標。依重建需求、生成品質與總成本,比較像素 Transformer、緊湊 VAE 潛在 Transformer 與表徵潛在 Transformer。記錄編碼器/解碼器成本與表徵預訓練。即使生成階段從零開始,使用預訓練視覺編碼器的模型仍承接了先前的訓練。
選讀:JiT(見「論文導讀」頁)。檢查像素架構與預測空間消融。
流匹配:學習一個傳輸速度
白話版。 對直線條件路徑,配對雜訊與資料並迴歸速度;生成沿學得的速度場前進,軌跡未必筆直。
時間慣例改變。 本節的時間從 的雜訊走到 的資料,與前面擴散各節相反(前面 越大代表雜訊越多)。
條件流匹配目標
連續正規化流用一條 ODE 移動點。如果速度場 正確,它會把雜訊分布 傳輸到資料分布 。Lipman 等人 [10](以及同時期的 Liu 等人 [11]、Albergo 與 Vanden-Eijnden 的隨機內插 [34])展示了如何在完全不模擬 ODE 的情況下訓練 。
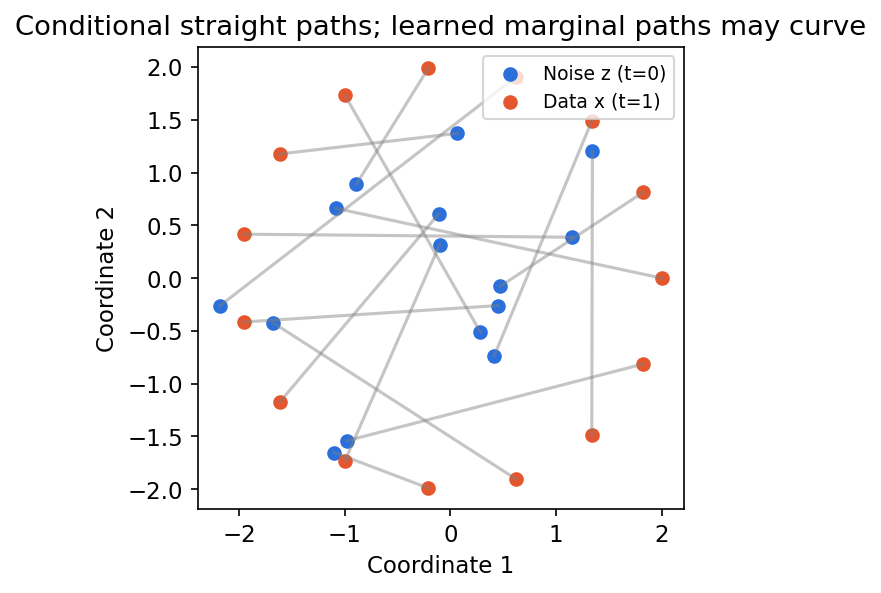
把雜訊 與資料 配對,定義直線的條件路徑
每一對都以等速沿直線移動。我們真正想要的邊際速度,是通過該點的所有配對之條件速度的平均:
我們算不出這個平均,但其實也不需要。比較「理想」損失與我們算得出來的損失:
其中 。把兩個平方展開。 項完全相同。交叉項也相等,因為由重複期望值定律,。剩下的項都不含 。因此
也就是說,迴歸每一對的速度 就能訓練出邊際速度場。這和擴散模型是同一個技巧:一個對單一樣本而言充滿雜訊的目標,其條件平均卻是對的。生成時用任何 ODE 求解器,從 到 解 。
流匹配與擴散的關係
線性路徑是一條 Gaussian 路徑:給定 ,。記 (一個雜訊預測),並利用 ,
所以對這條路徑而言,流匹配速度、雜訊預測器與分數仍然可以互相換算;不同的是路徑(直線或 VP 曲線)、損失對雜訊程度的加權,以及時間慣例。擴散模型的機率流 ODE 本身就是沿著某條特定 Gaussian 路徑的流。Lipman 等人的指南 [2] 與隨機內插框架 [34] 都把兩者視為同一個建構的特例。實務上的建議與參數化時相同:這些目標是靠推導彼此關聯,而不是改個名字就能互換。
程式:兩個群集上的流匹配
這個獨立範例用線性條件路徑學習與 DDPM 程式相同的兩群集分布,再用步長 的 Euler 法取樣。
程式碼 · Python · 32 行
import torch
from torch import nn
from torch.nn import functional as F

torch.manual_seed(0)
torch.set_num_threads(1)
net = nn.Sequential(nn.Linear(3, 64), nn.SiLU(),
                    nn.Linear(64, 64), nn.SiLU(), nn.Linear(64, 2))
opt = torch.optim.Adam(net.parameters(), lr=.002)
for step in range(3000):
    z = torch.randn(128, 2)
    side = torch.randint(2, (128, 1))*2-1
    x = torch.cat([1.5*side, torch.zeros(128, 1)], 1) + .25*torch.randn(128, 2)
    t = torch.rand(128, 1)
    xt = (1-t)*z+t*x
    loss = F.mse_loss(net(torch.cat([xt, t], 1)), x-z)
    opt.zero_grad(); loss.backward(); opt.step()
net.eval()
def euler_sample(n, steps, seed=1):
    x = torch.randn(n, 2, generator=torch.Generator().manual_seed(seed))
    with torch.no_grad():
        for k in range(steps):
            t = torch.full((n, 1), k/steps)
            x = x + net(torch.cat([x, t], 1))/steps
    return x

for steps in [1, 4, 50]:
    s = euler_sample(2000, steps)
    assert torch.isfinite(s).all()
    left = s[s[:, 0] < 0]
    print(f"{steps:2d} Euler steps: left fraction {(s[:, 0] < 0).float().mean():.3f}, "
          f"left-cluster mean x {left[:, 0].mean():.2f}, std {left[:, 0].std():.2f}")
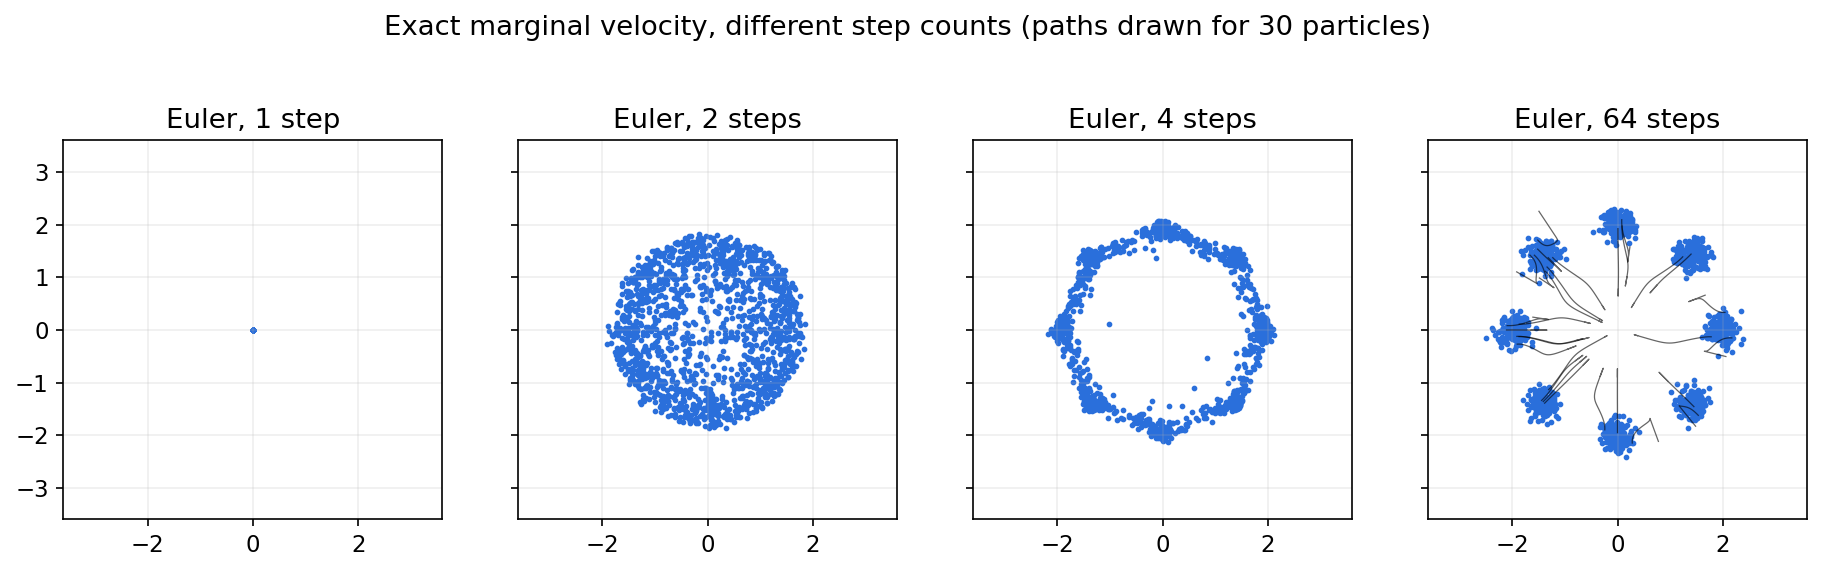
對 1、4、50 步,它印出左群集平均 、、,標準差 、、。一步 Euler 幾乎落在整體資料平均:在 時邊際速度是 ,所以一整步會把每一個雜訊點都送到 。直線的條件路徑並不會讓學到的邊際流變直。圖 8 用八模態混合的精確速度呈現同樣的效應。
整流流與 reflow
Liu、Gong 與 Liu [11] 使用同樣的直線內插(「整流流」),並加上 reflow:訓練後,從每個 解學到的 ODE 產生配對 ,再用這些已耦合的配對(而非獨立配對)重新訓練。因為新配對本來就由流相連,它們的直線較少交叉,學到的軌跡變得更直,需要的 Euler 步數也更少;夠直的流還可以再蒸餾成一步模型。Stable Diffusion 3 [9] 證明了整流流訓練的大型潛在 Transformer 在文字生成影像的規模上可行。
選讀:Flow Matching(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
Flow Matching 之後:區間、影像輸出與一步像素生成
白話版。 學會流之後,有兩個不同問題:一次預測能否涵蓋整段區間?網路又該直接輸出什麼?MeanFlow 改變所建模的區間,JiT 改變輸出表示,Pixel MeanFlow 再把兩個方向接起來。依這個順序讀,不要把每個新名字都當成另一種取樣器。
先對齊時間方向
前面的 flow-matching 範例從零端雜訊走到一端資料;MeanFlow [13]、improved MeanFlow [49] 與 pixel MeanFlow [50] 採相反慣例:
其中 為乾淨訓練範例, 為先驗雜訊, 是插值訓練狀態。生成從一走到零。與 JiT 的時間 比較時,使用 並反轉速度正負號。這是座標改變,不是不同生成原理。建立訓練配對的條件直線插值,也仍不代表學得的邊際 ODE 軌跡必為直線。
MeanFlow:把切線改成區間平均
瞬時速度告訴你現在往哪裡走;MeanFlow [13] 學習整段區間的平均,讓一次預測描述完整位移:
其中 為邊際瞬時速度, 位於其 ODE 軌跡, 為區間端點, 為該軌跡上的平均速度。零長邊界使用極限 。積分定義所要學的量;訓練並不對每筆資料積分求出教師軌跡。
對定義微分可得 。全導數沿移動狀態計算,並固定 ,不只是對時間輸入做偏微分。原始配方使用 Jacobian-vector product,以及由當前網路建立、阻斷梯度的目標。只要學得平均夠準,完整區間 就能用於一次呼叫生成。
以下精確曲線示範兩者差異;它是代數檢查,不是訓練好的 MeanFlow 模型:
程式碼 · Python · 9 行
r, t = 0.0, 1.0
start = (t, t*t)                    # curve z(t) = (t, t^2)
instant = (1.0, 2*t)                # tangent at the starting time
average = (1.0, t+r)                # exact interval-average derivative
one_euler = tuple(z-(t-r)*v for z, v in zip(start, instant))
one_average = tuple(z-(t-r)*u for z, u in zip(start, average))
assert one_average == (r, r*r)
print("Instantaneous Euler jump:", one_euler)
print("Average-velocity jump:", one_average)
輸出為 (0.0, -1.0) 與 (0.0, 0.0)。正確局部切線在一次大步後仍可能錯過終點,正確區間平均則能到達;難點就在於學好那個平均。
選讀:MeanFlow(見「論文導讀」頁)。對照原圖、控制比較與限制。
Improved MeanFlow:明確處理預測輸入與引導
iMF [49] 把訓練改寫成瞬時速度損失,網路仍輸出平均速度。關鍵改動位於導數計算內:原始配方把抽樣條件速度送入 JVP,iMF 改用網路預測的邊際速度,使乾淨訓練標籤不再成為複合預測器輸入。實作可重用零長邊界,或在訓練時使用輔助速度頭。
另一項改進把引導尺度與作用區間設為明確條件,使同一模型在推論時可調整設定,同時維持一次呼叫。這不同於事後加上有條件/無條件兩次網路計算。in-context 條件 token 也改變模型大小,因此最終系統比較不是單純的損失函數消融。
選讀:Improved MeanFlow(見「論文導讀」頁)。對照原圖、控制比較與限制。
JiT:影像輸出是另一條設計軸線
前面的 JiT 說明 已區分直接乾淨影像輸出與速度空間損失 [42]。採此處時間慣例,導出的瞬時速度為 ,其中 為預測乾淨影像;靠近零時須小心處理。JiT 仍沿多步軌跡取樣;輸出形狀像影像,不會自動提供區間平均速度或一步樣本。
其控制比較特別有用:固定損失空間,再改直接輸出與區塊維度。它說明目標間可做代數轉換,不代表有限容量網路都同樣好訓練。不要只比較訓練配方不同的最強摘要模型。
選讀:JiT(見「論文導讀」頁)。對照原圖、控制比較與限制。
Pixel MeanFlow:把影像輸出接到區間場
Pixel MeanFlow [50] 定義雙時間影像狀場 。其中 由平均速度場誘發,不一定等於與 配對的乾淨訓練影像。網路以 預測此場,再轉回 。轉換使用 ,並需端點保護。
導出的 進入 iMF 瞬時速度損失:影像輸出 → 平均速度 → 瞬時速度損失。在完整區間,更新簡化成網路的影像輸出,便能一次呼叫生成像素。中間區間的影像狀流形解釋,是由視覺化及消融支持的假設,不是精確流形保證。
生成時不需要潛在 tokenizer,但較強配方使用預訓練特徵網路計算感知訓練損失。與 JiT 或潛在生成器比較時,須記錄此訓練依賴。「沒有解碼器」「一個 NFE」與「任何元件都沒有預訓練」是三種不同主張。
選讀:Pixel MeanFlow(見「論文導讀」頁)。對照原圖、控制比較與限制。
區分相鄰方法
Reflow [11] 改變訓練配對的耦合,使軌跡更直。Consistency models [12] 學習同一軌跡上終點預測的一致性;有教師蒸餾與無教師訓練是不同設定。MeanFlow 參數化區間平均,JiT 則處理網路輸出空間。少步總覽 比較這些相鄰家族。
選方法前,先寫出表示空間、直接輸出、損失目標、時間方向及取樣呼叫數,再固定解析度與條件比較;區分生成器訓練及表示預訓練,適用時也算入解碼器成本。NFE 較低是呼叫次數的有用證據,不是完整延遲或品質評估。
預訓練影像與影片生成器是完整流程
白話版。 預訓練生成器是一組相容元件。只載入去雜訊器權重,還不能確定表徵、文字條件、預測目標與取樣排程正確。從影像跨到影片,也會改變重建必須保留的內容。
執行檢查點前,先閱讀元件
實務流程結合文字編碼器、可選的影像/影片編碼器、時間條件預測器、取樣器,以及可選的解碼器。初次生成之後,可能還有獨立的細化模型。每個元件都預期特定張量形狀與縮放。排程器宣告 v_prediction 時,可能指 VP 速度;流排程器則可能預期直線內插的導數。應檢查訓練路徑,而不是從設定字串猜測。
以下已核實的例子呈現架構差異。它們是固定的研究基準,不是最新產品排行榜。參考文獻包含論文或技術報告,以及官方釋出文件。
| 基準 | 生成表徵與預測器 | 預訓練流程需要檢查的項目 |
|---|---|---|
| SDXL [45] | 重建潛在表徵與卷積去雜訊器 | 文字條件、潛在縮放、可選的基礎/細化模型組合與相容取樣設定 |
| Stable Diffusion 3 [9] | 潛在整流流與聯合文字/影像 Transformer | 流的時間慣例、文字串流、時間抽樣與自編碼器相容性 |
| FLUX.1 [46] | 潛在整流流 Transformer | 確切釋出版本、引導行為、文字條件、自編碼器與釋出條款 |
| JiT [42] | 直接在像素上做類別條件乾淨影像預測 | 影像正規化、區塊/解析度設定、推得的速度與取樣配方;不是自由文字到影像檢查點 |
| HunyuanVideo [47] | 壓縮影片潛在表徵與流匹配 Transformer | 影片自編碼器、影像/影片聯合訓練、時間維度與文字條件元件 |
| Wan2.1 [48] | 影片擴散 Transformer 與時空自編碼器 | 文字到影片或影像到影片版本、因果影片壓縮、時間長度與解碼快取 |
SDXL [45] 說明較大的潛在影像生成架構與可選細化階段。Stable Diffusion 3 [9] 示範相同的大方向如何改用整流流與聯合文字/影像注意力。FLUX.1 的官方模型卡 [46] 描述釋出的整流流 Transformer,.1-dev 版本採用引導蒸餾。這些特性不代表檢查點可以互換。一般雙次推論的 CFG 與蒸餾後的引導輸入,可能有不同含義與成本。
影像到影像生成會編碼輸入,並加入部分雜訊,在保留原始內容與改變能力間取捨。實際雜訊程度由排程決定,不只是介面上「strength」這類標籤。比較編輯時,保留相同輸入,記錄初始時間、種子、提示、引導與重建基準。否則可能把重建偽影誤當成文字要求的編輯。
影片加入時間壓縮與一致性問題
令影片有 個影格、高度 與寬度 。假想編碼器以 壓縮時間,以 壓縮兩個空間軸,約得到 個潛在位置。確切形狀取決於填補與首影格的特殊處理。切分區塊後,跨所有位置的密集注意力成本隨剩餘詞元數平方成長;分別壓縮時間與空間,因此可能大幅改變成本。
HunyuanVideo 技術報告 [47] 結合 3D 影片自編碼器、流匹配 Transformer 與分階段影像/影片訓練。Wan 報告 [48] 說明因果影片 VAE,包括首影格特殊處理、空間與時間壓縮,以及分塊編碼/解碼的特徵快取。自編碼器具因果性,不代表整個影片生成器就以自回歸方式取樣;仍須另外檢查生成注意力與取樣程序。
單一影格可能很漂亮,但整段影片可能改變物體身分、突然反轉運動,或忘記被遮蔽的物體。生成前先測試保留影片的重建,再評估外觀、運動、提示對應與跨影格一致性。Melnik 等人 [31] 的綜述提供這些影片特有問題的閱讀地圖。單張影像指標無法診斷時間行為。
預訓練影片生成器也不會自動成為可靠的世界模型。預測合理影片與預測指定動作的後果不同。世界模型章節以狀態、動作、展開預測與評估進一步說明此差異。使用實際的條件化介面,並評估系統宣稱要解決的任務。
可重現的第一個實驗
先記錄流程清單:檢查點版本、編碼器/解碼器版本、文字編碼器、表徵形狀與縮放、預測目標、時間方向、求解器、評估次數、引導、資料型別與種子。若有自編碼器,接著做重建檢查,再對固定的小組提示與種子生成結果。一次比較一項變動。報告潛在方法成本時,納入解碼延遲與記憶體峰值。
本章 CPU 範例不下載權重,用來檢驗基本恆等式與失敗情況。完整解析度的預訓練生成,應依官方釋出說明 [42]、[45]–[48],在另外配置資源的實驗中執行。實際測量、論文已發表結果與簡化計算,是三種不同證據。
少步與一步生成
白話版。 如果取樣器需要 50 次網路呼叫,就訓練第二個模型,用幾次呼叫沿著軌跡跳躍——或者從頭訓練一個本來就設計成會跳的模型。
主要家族有:
- 漸進式蒸餾 [22]:學生模型學著用一步匹配老師的兩個確定性步驟;重複這個程序,每一輪把步數減半。
- 一致性模型 [12]:學習一個函數 ,把機率流 ODE 軌跡上的任何一點映射到該軌跡的起點(乾淨點)。它必須滿足邊界條件:在最小時間 時 ,作法是寫成 ,並令 、。訓練要求同一條軌跡上相鄰兩點的輸出一致。在一致性蒸餾中,相鄰點來自預訓練擴散模型的一步 ODE 求解;在一致性訓練中,則來自同一筆資料在兩個雜訊程度下的加噪版本,不需要老師。取樣只需一步,或幾步「跳到乾淨、重新加噪、再跳」。改進的訓練方法 [32] 簡化了連續時間一致性模型,並在 ImageNet 上把它擴展到 15 億參數、以兩步取樣。
- 對抗式蒸餾:ADD [33] 結合來自大型預訓練擴散老師的分數蒸餾與對抗損失,讓學生模型在一到四步內產生清晰影像。
- 平均速度模型:MeanFlow [13] 透過平均速度學習區間位移;iMF [49] 改良迴歸與引導,pixel MeanFlow [50] 再接到影像輸出。Flow Matching 後的說明 展開這些差異及各自的預訓練依賴。
少步數是學出來的能力,而不是換個漂亮方程式就免費得到的結果。比較時要計算 NFE(包含引導評估)、潛在模型中解碼器的成本、解析度、品質以及多樣性——也要記得,一步網路每次呼叫可能比多步網路更大、更慢。
評估生成模型
白話版。 「看起來好不好?」至少藏了三個問題:單一樣本是否逼真(擬真度)、樣本集合是否涵蓋資料的多樣性(多樣性)、樣本是否符合條件(對齊)。沒有任何單一數字能同時回答三者。
Fréchet Inception Distance
FID(Heusel 等人 [23])用 Inception-v3 網路 [36] 嵌入真實與生成影像,對兩組特徵各擬合一個 Gaussian,再計算兩個 Gaussian 之間的 Fréchet(2-Wasserstein)距離:
其中 與 是真實集合與生成集合的特徵平均與共變異數, 是矩陣的跡。越低越好。下面的程式把公式套用在二維「特徵」上。
程式碼 · Python · 21 行
import numpy as np
from scipy import linalg

def frechet_distance(a, b):
    """Frechet distance between Gaussians fitted to feature sets a and b."""
    mu1, mu2 = a.mean(0), b.mean(0)
    c1, c2 = np.cov(a, rowvar=False), np.cov(b, rowvar=False)
    covmean = linalg.sqrtm(c1 @ c2).real
    return float(((mu1 - mu2)**2).sum() + np.trace(c1 + c2 - 2*covmean))

rng = np.random.default_rng(0)
centers = np.array([[-1.5, 0.], [1.5, 0.]])
real = centers[rng.integers(2, size=5000)] + .25*rng.normal(size=(5000, 2))
good = centers[rng.integers(2, size=5000)] + .25*rng.normal(size=(5000, 2))
one_mode = centers[[0]] + .25*rng.normal(size=(5000, 2))      # mode collapse
blurry = .6*rng.normal(size=(5000, 2))                         # mass in the gap
print("good     :", round(frechet_distance(real, good), 3))
print("one mode :", round(frechet_distance(real, one_mode), 3))
print("blurry   :", round(frechet_distance(real, blurry), 3))
small = [frechet_distance(real[:50], good[i*50:(i+1)*50]) for i in range(20)]
print("good, 50 samples: mean", round(np.mean(small), 3), "std", round(np.std(small), 3))
正確的取樣器得到約 0.001,只會產生左邊模態的取樣器得到 3.9,把機率質量放在兩個模態之間的「模糊」取樣器得到 0.976。最後一行顯示一個實務陷阱:只用 50 個樣本時,即使完美的取樣器也得到 ,因為樣本數少時 FID 有向上的偏差。只有在樣本數、參考集合、特徵擷取器與前處理都相同時,才能比較 FID。
FID 之外
- 精確率與召回率(Kynkäänniemi 等人 [24])把擬真度與多樣性分開:在特徵空間用 近鄰球估計真實與生成資料的「流形」;精確率是落在真實流形內的生成樣本比例,召回率則是落在生成流形內的真實樣本比例。我們的「單一模態」取樣器會有高精確率、低召回率。
- 特徵擷取器很重要。 Stein 等人 [25] 做了大規模的人類評估,發現沒有任何常用指標與人類判斷強烈相關;尤其擴散模型的感知真實度沒有反映在 FID 上。他們建議以 DINOv2-ViT-L/14 [39] 的特徵取代 Inception,並指出現有指標無法把記憶(memorization)與欠擬合或模態收縮區分開來。
- CMMD(Jayasumana 等人 [26])把 Inception 特徵換成 CLIP [38] 嵌入,並把 Gaussian 假設換成使用 Gaussian RBF 核的最大平均差異(MMD),得到一個不偏且更省樣本的估計量。
- 概似。 機率流 ODE 可透過變數變換評估對數密度 [4],但應回報數值容許誤差與散度估計方式。DDPM 的變分界限 [19] 是不同的量。把連續密度換成影像 bpd,還需要交代去量化與縮放慣例;這些分數本身都不等於視覺品質。
- 條件模型需要對齊檢查(影像是否呈現提示詞所說的內容?),通常靠人工評分或視覺語言模型;也需要對訓練集做記憶檢查。
- 成本。 報告 NFE、引導評估次數、解析度,以及在註明硬體上的實際時間。
評估章節 ML 11 會再回到樣本數效應與誠實比較。
現代觀點
綜述與參考書。 文獻很多,以下幾篇回顧是很好的地圖。
- Yang 等人 [1](ACM Computing Surveys,2023)把擴散研究組織成三個改進方向——高效取樣、改進概似估計、特殊結構資料(流形、離散資料、不變性)——並涵蓋與 VAE、GAN、流的結合,以及跨領域應用。
- Croitoru 等人 [27](IEEE TPAMI,2023)聚焦於視覺。他們指出三種通用公式化——DDPM、雜訊條件分數網路與 SDE——並將視覺應用分類,例如生成、超解析度、修補、編輯、轉換與分割。
- Cao 等人 [28](IEEE TKDE,2024)從方法面切入:基礎公式化、演算法改進(取樣加速、目標設計、條件化),以及從影像到生物與醫療的應用。
- Lipman 等人 [2](2024)是一份附程式碼的流匹配指南,涵蓋 Gaussian 與一般機率路徑、與擴散的關係,以及延伸到離散與黎曼資料。
- Lai、Song、Kim、Mitsufuji 與 Ermon [29](2025)是一本專書長度的著作,把變分、分數與流三種觀點呈現為通往同一個時間相依速度場的三條路,接著討論引導、快速求解器與流映射(少步)模型。
- Shen 等人 [30](TMLR,2025)從演算法層面(訓練、取樣、壓縮)、系統層面(硬體與服務部署)與框架層面綜述效率問題。
- Melnik 等人 [31](TMLR,2024)綜述影片擴散:架構、時間一致性機制、資料集與評估。
2023–2026 的現況。 綜合這些回顧與本章的原始論文,可以看到幾個趨勢。(1) 潛在空間中的 Transformer:DiT 類主幹 [8] 在許多大型系統中取代了 U-Net,而以整流流目標訓練的文字–影像聯合 Transformer [9] 成為文字生成影像的標準配方之一。(2) 流匹配成為預設目標:直線路徑的流匹配 [10]、[11] 現在與雜訊預測並用或取而代之,擴散則被理解為機率路徑的一種選擇 [2]、[29]。(3) 更少的評估次數:蒸餾 [22]、[33]、一致性模型 [12]、[32] 與平均速度模型 [13] 把取樣降到一到四次網路呼叫,品質逼近多步取樣器。(4) 更好的評估:社群正從以 Inception 為基礎的 FID 轉向更豐富的特徵空間、人類研究與對齊指標 [25]、[26]。(5) 影像之外:影片、3D、音訊與科學資料都重用同一套機制,其中影片的時間一致性與成本是主要的開放挑戰 [31]。
表徵與預測,2025–2026。 JiT [42] 測試像素上的直接乾淨影像預測;RAE [43] 測試凍結語意特徵空間中的生成;後續文字到影像研究 [44] 檢查更大規模的行為。這些研究區分模型操作的空間與網路直接預測的目標。前述預訓練例子 [45]–[48] 說明實際影像/影片流程為何需要元件相容性與時間重建。比較時應匹配計算量與資料,並納入表徵預訓練。
開放問題。 高解析度與長影片的取樣成本;不犧牲多樣性、也不造成過飽和的有原則的引導;與人類判斷一致且能偵測記憶的評估指標;理解泛化(為什麼模型會產生新樣本而不是複製訓練資料);有保證的可控性與編輯;以及資料來源、授權同意與濫用——這些是社會問題,而不只是技術問題。下一章 ML 09 介紹主要的另一條路線:在像素與 token 上的自迴歸生成,以及它與擴散的混合方法。
重點整理
- 已知前向擾動在抽取的雜訊程度上提供訓練目標。
- 簡化去雜訊目標改變變分下界各項的加權,本身不是精確概似。
- 預測目標可在指定路徑下互換,但加權、端點行為與模型容量仍會影響訓練。
- 取樣器需要相容排程與預測規約;應回報網路評估次數及完整延遲。
- 引導改變取樣分布;更強的條件遵循可能降低多樣性並引入偽影。
- 直線條件訓練路徑不保證學得軌跡筆直;應在相同評估協定下比較表示、求解器與少步訓練。
練習
- 找回乾淨估計。 從 出發,由雜訊預測推導 。如果 有誤差 ,在 與 時, 的誤差有多大?接著由乾淨預測推導直線流速度,說明 JiT 為何能輸出 卻使用速度損失。
提示
,所以誤差是 :在 時約 ,在 時約 。高雜訊時, 是許多可能影像的平均,而不是一張影像。
- 後驗平均的兩種形式。 把 代入 ,證明它等於 。接著把後驗程式中的
t改成 50 與 900,確認公式仍然吻合。
提示
使用 與 。 的係數變成 ,因為分子等於 。
- 計算成本。 一個潛在文字生成影像模型用 30 步 DDIM 取樣,並以分開的條件與無條件前向計算做無分類器引導,最後跑一次解碼器。總共需要幾次去雜訊器評估?若換成一個已把引導「內建」的 4 步蒸餾模型,次數如何變化?對人工形狀範例,把潛在通道改成 16、像素區塊大小改成 16,重新計算純量與注意力矩陣元素數。哪些節省仍成立,哪些取決於區塊切分?
提示
60 次去雜訊器評估加一次解碼器;把兩個 CFG 分支批次處理可以減少實際時間,但不會減少計算量。內建引導的 4 步蒸餾模型需要 4 次評估加解碼器。要比較品質與多樣性,而不只是次數。
- 時間慣例。 擴散各節使用「 大=雜訊多」;流匹配一節使用「 是雜訊、 是資料」。用 重新參數化這個流。 是什麼?如果只改時間輸入的標籤,會出什麼錯?
提示
。如果把 餵給一個以 訓練的網路,卻沒有翻轉正負號與時間輸入,就會朝錯誤方向積分,把樣本推離資料。
- 引導掃描。 在 CFG 程式中加入 ,並記錄類別 1 樣本中落得比較靠近錯誤類別模態的比例。畫出到最近模態的平均距離對 的關係。引導從哪裡開始不再有幫助?
提示
在 時,精確的條件模型就已把每個樣本放進類別 1,所以更大的 在這裡無法提升類別正確率——只會讓群集變形。對一個學習出來、並不完美的條件模型而言,適度的 可以提升遵循度,這也是實務上使用它的原因。
- 取樣器消融實驗。 固定訓練好的流匹配網路。把 1、2、5、20、100 步的 Euler 與二階 Heun 步驟(先用 Euler 預測,再平均兩端的速度)比較。使用相同的起始雜訊,測量群集平均與離散程度。在相同網路呼叫次數下,2 步 Heun 取樣器是否勝過 4 步 Euler?
提示
Heun 每步需要兩次網路呼叫。要畫出樣本,而不只看數字。對一個以瞬時速度訓練的模型做一步 Euler,並不能檢驗另外訓練的一步模型(例如一致性模型或 MeanFlow)。
參考文獻
- L. Yang, Z. Zhang, Y. Song, S. Hong, R. Xu, Y. Zhao, W. Zhang, B. Cui and M.-H. Yang, “Diffusion Models: A Comprehensive Survey of Methods and Applications,” ACM Computing Surveys, 2023. arXiv
- Y. Lipman, M. Havasi, P. Holderrieth, N. Shaul, M. Le, B. Karrer, R. T. Q. Chen, D. Lopez-Paz, H. Ben-Hamu and I. Gat, “Flow Matching Guide and Code,” arXiv:2412.06264, 2024. arXiv
- J. Ho, A. Jain and P. Abbeel, “Denoising Diffusion Probabilistic Models,” NeurIPS, 2020. arXiv
- Y. Song, J. Sohl-Dickstein, D. P. Kingma, A. Kumar, S. Ermon and B. Poole, “Score-Based Generative Modeling through Stochastic Differential Equations,” ICLR, 2021. arXiv
- J. Song, C. Meng and S. Ermon, “Denoising Diffusion Implicit Models,” ICLR, 2021. arXiv
- J. Ho and T. Salimans, “Classifier-Free Diffusion Guidance,” NeurIPS 2021 Workshop on Deep Generative Models and Downstream Applications; arXiv:2207.12598, 2022. arXiv
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser and B. Ommer, “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. arXiv
- W. Peebles and S. Xie, “Scalable Diffusion Models with Transformers,” ICCV, 2023. arXiv
- P. Esser, S. Kulal, A. Blattmann et al., “Scaling Rectified Flow Transformers for High-Resolution Image Synthesis,” ICML, PMLR 235, 2024. PMLR
- Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel and M. Le, “Flow Matching for Generative Modeling,” ICLR, 2023. arXiv
- X. Liu, C. Gong and Q. Liu, “Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow,” ICLR, 2023. arXiv
- Y. Song, P. Dhariwal, M. Chen and I. Sutskever, “Consistency Models,” ICML, 2023. arXiv
- Z. Geng, M. Deng, X. Bai, J. Z. Kolter and K. He, “Mean Flows for One-step Generative Modeling,” NeurIPS, 2025. arXiv
- S. J. D. Prince, Understanding Deep Learning, MIT Press, 2023. book site
- J. Sohl-Dickstein, E. Weiss, N. Maheswaranathan and S. Ganguli, “Deep Unsupervised Learning using Nonequilibrium Thermodynamics,” ICML, PMLR 37, 2015. PMLR
- P. Vincent, “A Connection Between Score Matching and Denoising Autoencoders,” Neural Computation, vol. 23, no. 7, pp. 1661–1674, 2011. doi
- Y. Song and S. Ermon, “Generative Modeling by Estimating Gradients of the Data Distribution,” NeurIPS, 2019. arXiv
- P. Dhariwal and A. Nichol, “Diffusion Models Beat GANs on Image Synthesis,” NeurIPS, 2021. NeurIPS
- A. Q. Nichol and P. Dhariwal, “Improved Denoising Diffusion Probabilistic Models,” ICML, PMLR 139, 2021. PMLR
- T. Karras, M. Aittala, T. Aila and S. Laine, “Elucidating the Design Space of Diffusion-Based Generative Models,” NeurIPS, 2022. arXiv
- C. Lu, Y. Zhou, F. Bao, J. Chen, C. Li and J. Zhu, “DPM-Solver: A Fast ODE Solver for Diffusion Probabilistic Model Sampling in Around 10 Steps,” NeurIPS, 2022. arXiv
- T. Salimans and J. Ho, “Progressive Distillation for Fast Sampling of Diffusion Models,” ICLR, 2022. arXiv
- M. Heusel, H. Ramsauer, T. Unterthiner, B. Nessler and S. Hochreiter, “GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium,” NeurIPS (NIPS), 2017. arXiv
- T. Kynkäänniemi, T. Karras, S. Laine, J. Lehtinen and T. Aila, “Improved Precision and Recall Metric for Assessing Generative Models,” NeurIPS, 2019. arXiv
- G. Stein, J. C. Cresswell, R. Hosseinzadeh et al., “Exposing Flaws of Generative Model Evaluation Metrics and Their Unfair Treatment of Diffusion Models,” NeurIPS, 2023. arXiv
- S. Jayasumana, S. Ramalingam, A. Veit, D. Glasner, A. Chakrabarti and S. Kumar, “Rethinking FID: Towards a Better Evaluation Metric for Image Generation,” CVPR, 2024. CVF
- F.-A. Croitoru, V. Hondru, R. T. Ionescu and M. Shah, “Diffusion Models in Vision: A Survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023. doi
- H. Cao, C. Tan, Z. Gao, Y. Xu, G. Chen, P.-A. Heng and S. Z. Li, “A Survey on Generative Diffusion Models,” IEEE Transactions on Knowledge and Data Engineering, vol. 36, no. 7, pp. 2814–2830, 2024. doi
- C.-H. Lai, Y. Song, D. Kim, Y. Mitsufuji and S. Ermon, “The Principles of Diffusion Models,” monograph, arXiv:2510.21890, 2025. arXiv
- H. Shen, J. Zhang, B. Xiong et al., “Efficient Diffusion Models: A Survey,” Transactions on Machine Learning Research, 2025. arXiv
- A. Melnik, M. Ljubljanac, C. Lu, Q. Yan, W. Ren and H. Ritter, “Video Diffusion Models: A Survey,” Transactions on Machine Learning Research, 2024. arXiv
- C. Lu and Y. Song, “Simplifying, Stabilizing and Scaling Continuous-Time Consistency Models,” ICLR, 2025. arXiv
- A. Sauer, D. Lorenz, A. Blattmann and R. Rombach, “Adversarial Diffusion Distillation,” ECCV, 2024. arXiv
- M. S. Albergo and E. Vanden-Eijnden, “Building Normalizing Flows with Stochastic Interpolants,” ICLR, 2023. arXiv
- J. Deng, W. Dong, R. Socher, L.-J. Li, K. Li and L. Fei-Fei, “ImageNet: A Large-Scale Hierarchical Image Database,” CVPR, 2009, pp. 248–255. doi
- C. Szegedy, V. Vanhoucke, S. Ioffe, J. Shlens and Z. Wojna, “Rethinking the Inception Architecture for Computer Vision,” CVPR, 2016, pp. 2818–2826. arXiv
- O. Ronneberger, P. Fischer and T. Brox, “U-Net: Convolutional Networks for Biomedical Image Segmentation,” MICCAI, LNCS 9351, pp. 234–241, 2015. arXiv
- A. Radford, J. W. Kim, C. Hallacy et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML, 2021. arXiv
- M. Oquab, T. Darcet, T. Moutakanni et al., “DINOv2: Learning Robust Visual Features without Supervision,” Transactions on Machine Learning Research, 2024. arXiv
- B. Efron, “Tweedie’s Formula and Selection Bias,” Journal of the American Statistical Association, vol. 106, no. 496, pp. 1602–1614, 2011. doi
- A. Dosovitskiy, L. Beyer, A. Kolesnikov et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” ICLR, 2021. arXiv
- T. Li and K. He, “Back to Basics: Let Denoising Generative Models Denoise,” CVPR, 2026 (preprint 2025). paper, publication record, official JiT code.
- B. Zheng, N. Ma, S. Tong and S. Xie, “Diffusion Transformers with Representation Autoencoders,” ICLR, 2026 (preprint 2025). proceedings, manuscript.
- S. Tong, B. Zheng, Z. Wang, B. Tang, N. Ma, E. Brown, J. Yang, R. Fergus, Y. LeCun and S. Xie, “Scaling Text-to-Image Diffusion Transformers with Representation Autoencoders,” CVPR Findings Track, 2026. manuscript, author publication record.
- D. Podell, Z. English, K. Lacey, A. Blattmann, T. Dockhorn, J. Müller, J. Penna and R. Rombach, “SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis,” ICLR, 2024. proceedings, official model card.
- Black Forest Labs, “FLUX.1 [dev],” official pretrained-model card, 2024. model card.
- W. Kong, Q. Tian, Z. Zhang et al., “HunyuanVideo: A Systematic Framework For Large Video Generative Models,” technical report, arXiv:2412.03603, 2024. report, official release.
- Team Wan, A. Wang, B. Ai, B. Wen et al., “Wan: Open and Advanced Large-Scale Video Generative Models,” technical report, arXiv:2503.20314, 2025. report, official Wan2.1 release.
- Z. Geng, Y. Lu, Z. Wu, E. Shechtman, J. Z. Kolter and K. He, “Improved Mean Flows: On the Challenges of Fastforward Generative Models,” CVPR, pp. 30467–30476, 2026. CVF
- Y. Lu, S. Lu, Q. Sun, H. Zhao, Z. Jiang, X. Wang, T. Li, Z. Geng and K. He, “One-step Latent-free Image Generation with Pixel Mean Flows,” ICML, PMLR 306, pp. 81265–81277, 2026. PMLR
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 09・視覺自迴歸:像素、Tokens 與尺度 · 25 分鐘