ML 11・評估、效率與部署
先備知識:ML 10・基礎模型與視覺語言學習
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 設計能支持部署主張的基準與資料切分。
- 依取樣結構選擇交叉驗證與不確定性估計。
- 區分準確率、校準與轉移下的穩健性。
- 在目標系統量測運算量、記憶體與延遲。
- 驗證匯出模型、監控部署,並記錄可重現的實驗。
先看全貌
訓練模型只是專案的中段,不是終點。在任何人依賴它之前,你必須回答四個問題:它在真正會遇到的案例上有效嗎?這個數字有多可靠?它知道自己什麼時候可能出錯嗎?它符合要執行的裝置、延遲與預算嗎?上線之後還有第五個問題:它現在還有效嗎?
這一章是 ML 系列的最後一章。它整理 Goodfellow 等人 [1, ch. 11] 的實務方法論與 James 等人 [2] 的統計學習觀點,再補上把訓練好的網路變成可靠服務所需的工程步驟。視覺任務專屬的指標(top-1、mAP、PSNR、FID 等)在 DLCV 02 與 DLCV 03 中說明;本章聚焦所有任務共通的部分。
先建立有意義的基準模型
白話版。 在投入更多算力之前,先看看簡單方法在完全相同的切分上表現如何。基準模型告訴你複雜模型到底多換到了什麼。
影像任務常見的好基準包括:在原始像素或手工特徵上做邏輯迴歸;最近鄰或 SVM 分類器;以及在預訓練模型凍結特徵上接一個小型線性分類頭(見 ML 10)。邏輯迴歸學習線性邊界;支援向量機(support vector machine, SVM)最大化帶正則化的間隔;最近鄰直接比較樣本;樹集成則切分特徵空間。傳統圖形識別章節 IP 13 有更完整的推導。
作為參考,二元線性 SVM 最小化
其中 與 是權重與偏差, 是第 個特徵向量, 在間隔寬度與訓練錯誤之間取捨。 稱為鉸鏈損失(hinge loss):位於正確一側且間隔至少為 1 的點損失為零,其餘則線性增加。
程式碼:把前處理放進 pipeline 的基準模型
這個例子只使用內建資料。模型選擇用驗證集;選出的模型只在測試集上評估一次。標準化與 PCA 都在各自的訓練 pipeline 內擬合,絕不在整份資料上擬合。
程式碼 · Python · 28 行
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, balanced_accuracy_score

X, y = load_digits(return_X_y=True)
Xa, Xt, ya, yt = train_test_split(X, y, test_size=.2, stratify=y, random_state=0)
Xtr, Xv, ytr, yv = train_test_split(Xa, ya, test_size=.25, stratify=ya, random_state=1)
models = {      # listed from simplest to most complex
    "linear": make_pipeline(StandardScaler(),
                           LogisticRegression(max_iter=2000)),
    "PCA + RBF SVM": make_pipeline(StandardScaler(), PCA(n_components=30),
                                  SVC(C=10, gamma="scale")),
}
scores = {}
for name, model in models.items():
    model.fit(Xtr, ytr)
    scores[name] = accuracy_score(yv, model.predict(Xv))
best = max(scores, key=scores.get)   # tie -> first listed, i.e. the simpler model
pred = models[best].predict(Xt)
print("validation:", scores)
print("selected:", best)
print("test accuracy:", accuracy_score(yt, pred))
print("test balanced accuracy:", balanced_accuracy_score(yt, pred))
在這個切分上,兩個候選模型的驗證準確率剛好都是 (360 張中答對 347 張)。「平手時選較簡單的模型」這條規則是事先定好的,因此選出線性模型,它在測試集上的準確率為 、平衡準確率為 。這個小實驗藏著兩個教訓。第一,平手規則是評估協定的一部分,應該在看結果之前寫下來。第二,驗證集只有 360 張時,一張影像就值 個百分點,所以小實驗中許多看似「勝出」的差距其實只是雜訊;後面的信賴區間一節會把這點說得更精確。
資料切分與資料洩漏
白話版。 測試資料的新穎方式應符合部署情境;若主張適用於新群組或未來資料,共用病人、場景或時段可能高估結果。
依主張決定切分單位
同一位病人、同一段影片、同一批產品或同一台相機的影像彼此相關。把相鄰影格隨機切分,會讓幾乎相同的畫面同時出現在訓練與測試中。先問部署時「新」代表什麼,再依該單位切分:模型會遇到新病人就依病人切,會遇到新影片就依影片切,要裝到新醫院就依院區切,要預測未來就依時間切。
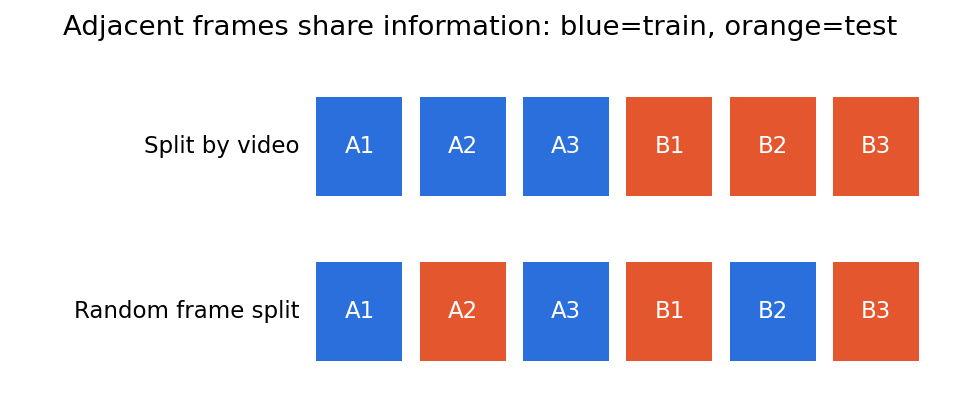
分層抽樣(stratification)讓各切分的類別比例相近,但它不能取代群組切分。切分前先去除重複,並把完全或近似重複的樣本放在同一側。若部署母體會隨時間漂移,依時間切分(用過去訓練、用最近一段時間測試)才是誠實的做法。
資料洩漏的各種面貌
資料洩漏是指任何讓「預測當下不該取得的資訊」流進模型或模型選擇過程的途徑。Kapoor 與 Narayanan 發現資料洩漏錯誤影響了 17 個使用 ML 的科學領域、共 329 篇論文,並提出洩漏類型的分類,其中包括缺少訓練/測試分離、在整份資料上做前處理、重複樣本、時間洩漏與不正當特徵 [4]。scikit-learn 文件也列出最常見的程式錯誤 [3]。實用檢查表:
| 洩漏 | 例子 | 修正 |
|---|---|---|
| 在全部資料上前處理 | 在訓練+測試上擬合 StandardScaler、PCA 或詞彙表 | 把前處理放進只在訓練折上擬合的 Pipeline |
| 相關的單位 | 同一段影片的影格、同一次掃描的切片、同一張照片的裁切 | 依群組切分 |
| 重複樣本 | 同一張影像被爬取兩次 | 切分前先用雜湊或嵌入去重 |
| 時間 | 用下週的資料預測本週 | 依時間順序切分 |
| 目標代理變數 | 在結果之後才記錄的特徵(例如「是否已接受治療」) | 稽核每個特徵的記錄時間 |
| 重複使用測試集 | 一邊看測試分數一邊調超參數 | 決策用驗證集,測試只做一次 |
最後一列最隱微。每次看了測試分數再修改,測試集就變得更像驗證集一點。公開基準在整個社群的規模上都面臨這個問題。
交叉驗證
白話版。 不只做一次訓練/驗證切分,而是輪流:把資料分成 份,訓練 次,每次留出不同的一份來評估,再取平均。每個樣本都恰好被評估一次,也能看到分數的變動幅度。
K 折交叉驗證與其變形
把索引分成 個互斥的折 。對每個 ,用除了 以外的所有折訓練出 ,並在 上計算誤差。交叉驗證估計值為
其中 是單一樣本的損失(例如 0–1 錯誤), 是該折的大小。常見選擇為 或 [2]。各種變形只差在如何組成各折:
- 分層 折讓各折的類別比例相同;類別不平衡時很有用。
- 群組 折把每個群組(病人、影片、院區)只分到一個折,因此沒有群組同時出現在訓練與留出資料中。
- 時間序列切分永遠用較早的資料訓練、用較晚的資料驗證。
- 留一群組是每折只放一個群組的群組 折;群組很少時有用。
各折分數並不獨立(訓練集互相重疊),所以各折之間的標準差會低估真正的不確定性。把它當成穩定性的粗略指標,而不是正式的信賴區間。
程式碼:隨機 K 折對群組資料做了什麼
我們模擬 40 位病人、每人 25 張影像。同一位病人的影像共享一個「指紋」(病人特有的外觀),而標籤以病人為單位固定。真正的類別訊號很弱。
程式碼 · Python · 17 行
import numpy as np
from sklearn.model_selection import KFold, GroupKFold, cross_val_score
from sklearn.ensemble import RandomForestClassifier

rng = np.random.default_rng(0)
n_groups, per_group = 40, 25                   # e.g. 40 patients, 25 images each
groups = np.repeat(np.arange(n_groups), per_group)
y = np.repeat(rng.integers(0, 2, n_groups), per_group)   # label fixed per patient
identity = rng.normal(size=(n_groups, 20))[groups]       # patient "fingerprint"
signal = 0.3 * y[:, None] * np.ones((1, 20))             # weak real class signal
X = identity + signal + 0.3 * rng.normal(size=(len(y), 20))

model = RandomForestClassifier(n_estimators=200, random_state=0)
random_cv = cross_val_score(model, X, y, cv=KFold(5, shuffle=True, random_state=0))
group_cv = cross_val_score(model, X, y, cv=GroupKFold(5), groups=groups)
print(f"random K-fold accuracy: {random_cv.mean():.3f} +/- {random_cv.std():.3f}")
print(f"group  K-fold accuracy: {group_cv.mean():.3f} +/- {group_cv.std():.3f}")
輸出:
程式碼 · 2 行
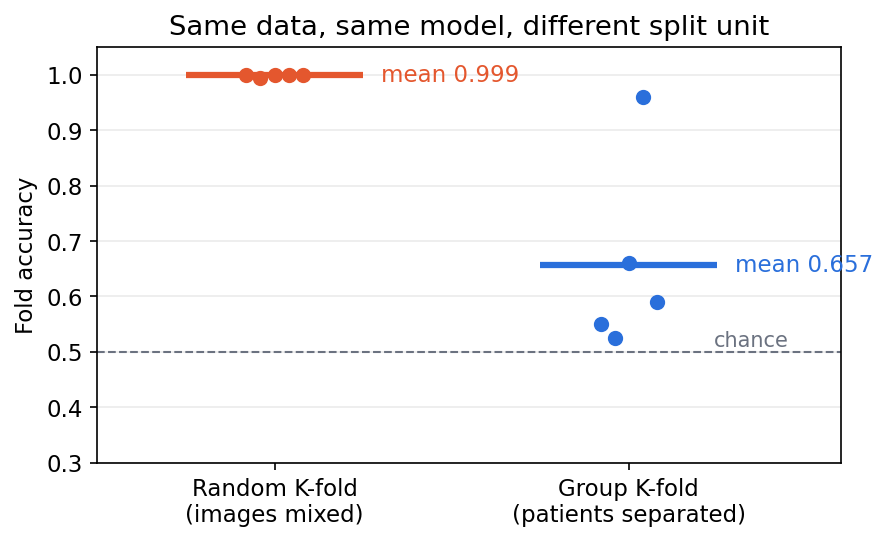
random K-fold accuracy: 0.999 +/- 0.002
group  K-fold accuracy: 0.657 +/- 0.158
隨機切分回報近乎完美的準確率,因為隨機森林認出了每位病人的指紋,直接抄該病人的標籤。群組 折符合「對新病人有效」這個主張,回報的是 ,而且各折差異很大。兩個數字在算術上都沒錯,但只有一個回答了真正的問題。
巢狀交叉驗證
如果同時用交叉驗證來選超參數又回報表現,回報的數字會偏樂觀:你挑的是剛好在那些折上看起來最好的設定。Varma 與 Simon 用兩類在統計上完全相同的「虛無」資料示範了這點:用交叉驗證調整 SVM 後,在 38% 的模擬資料集上 CV 誤差估計低於 30%,而調好的分類器在獨立測試資料上並不比亂猜好 [5];Cawley 與 Talbot 則顯示,對模型選擇準則的過擬合可能和不同學習演算法之間的差距一樣大 [6]。
巢狀交叉驗證用兩層迴圈解決這個問題。外層留出一折做評估;在每個外層訓練集內,由內層交叉驗證選擇超參數。外層折只用來為內層選出的設定打分數。在 scikit-learn 中,這只是把 GridSearchCV 放進 cross_val_score。得到的結果估計的是整個程序(包含調參)的表現,也就是你重新訓練時實際會執行的東西。
對深度網路而言,完整的巢狀交叉驗證通常太昂貴。常見的折衷是固定一組訓練/驗證/測試切分,為每個被比較的方法訂明調參預算,並只打開測試集一次。
指標回顧
白話版。 先決定一個錯誤的代價,再選數字。單一純量很少能說完整個故事。
| 任務 | 有用的量測 | 常見陷阱 |
|---|---|---|
| 分類 | 各類別精確率/召回率、macro-F1、平衡準確率、AUROC/AUPRC | 準確率隱藏罕見失敗;PR 曲線受盛行率影響 |
| 偵測/分割 | AP、IoU/Dice、邊界誤差 | 比較不同 IoU 門檻或評估協定的結果 |
| 檢索 | Recall@、在明確相關集合下的 mAP | 圖庫中的重複樣本灌高匹配率 |
| 影像復原 | PSNR/SSIM、感知指標、與觀測的一致性 | 看似合理的紋理不一定是真實細節 |
| 生成 | FID/KID、涵蓋率、條件對齊、人工評估 | 特徵層面的真實感不代表忠於提示 |
| 影片/幾何 | 時間一致性、任務準確率、幾何誤差 | 單張影格好看可能掩蓋結構不一致 |
分類指標(混淆矩陣、top-、ROC/PR 曲線)的定義與陷阱在 DLCV 02 中詳細說明,偵測指標(IoU、AP、COCO mAP)則在 DLCV 03。對生成模型而言,FID 比較特徵分布的高斯擬合(平均與共變異數);KID 則使用無偏的核最大平均差異估計,因此在樣本數少時表現較穩定 [7]。兩者都不是人類偏好的通用量度。務必寫明特徵擷取器、參考集合、樣本數、解析度與取樣設定。
正例只有 1% 時,永遠預測負例的分類器有 99% 準確率而召回率為零,因此只看準確率會掩蓋失敗。精確率也受盛行率影響。若只有類別比例改變,而各類別內的輸入分布與決策門檻保持固定,召回率與偽陽性率才會不變,精確率則會改變 [17]。這是標籤偏移假設;換醫院、相機或母體時,各類別內的外觀也可能改變,因此三種比率都應重新測量,不能直接假設穩定。
統計顯著性與信賴區間
白話版。 測試分數是從有限樣本算出來的,換一批樣本就會有些不同。要回報一個範圍而不只是一個點,並在相同樣本上比較兩個模型。
準確率的標準誤
若 個測試樣本彼此獨立,模型真正的準確率為 ,則答對的個數服從二項分布,觀測準確率 的標準誤為
這裡 是答對比例, 是標準常態分布的第 97.5 百分位數。當 、 時,,區間大約是 個百分點。當 非常接近 0 或 1、或 很小時,這個常態近似很差,應改用 Wilson 或精確二項區間。若測試樣本有群組結構(每位病人多張影像),有效樣本數比較接近群組數,此時必須以群組為單位重抽樣來計算區間。
Bootstrap
Bootstrap 以「從觀測資料中放回抽樣」來估計任意統計量的抽樣分布 [9]。抽出 組大小為 的重抽樣,在每組上重新計算統計量,並取第 2.5 與第 97.5 百分位數作為近似的 95% 區間(百分位數區間)。它適用於沒有簡單公式的指標,例如 macro-F1、AUROC 或 mAP。
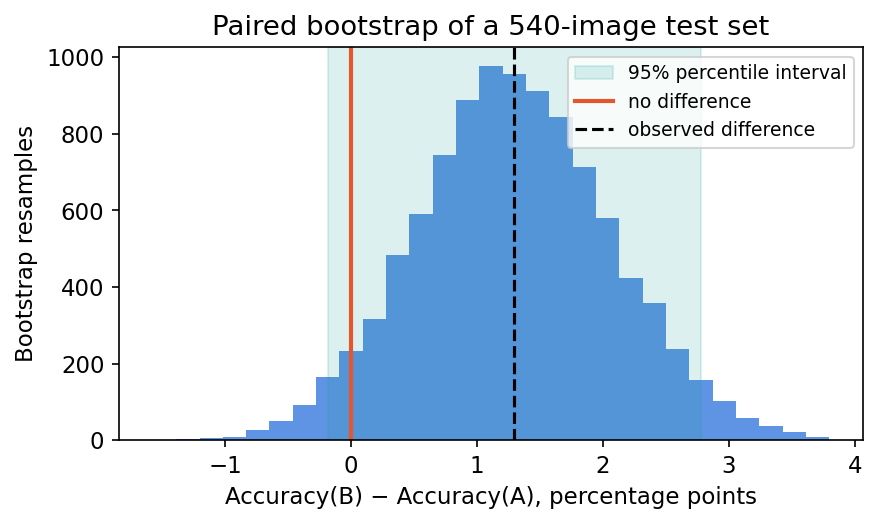
比較兩個模型時,要用成對 bootstrap:每次只抽一次樣本索引,並在同一組重抽樣上評估兩個模型。因為兩個模型通常在許多相同的困難樣本上失敗,配對能消除這部分共同變異,使差值的區間比兩個獨立區間緊得多。
McNemar 檢定
兩個分類器在同一個測試集上評估時,只有它們意見不同的樣本才帶有「誰比較好」的資訊。令 為模型 A 答對而 B 答錯的樣本數, 為相反情況。在「兩個模型錯誤率相同」的虛無假設下,每個不一致樣本落在兩邊的機率相等,所以 。精確 McNemar 檢定就由此計算雙尾二項 p 值。Dietterich 比較了五種比較學習演算法的檢定,發現對只能執行一次的演算法(昂貴模型的典型情況),McNemar 檢定是唯一第一型錯誤可以接受的方法;若能負擔執行十次,他建議使用 5×2 交叉驗證 t 檢定 [8]。
程式碼:成對 bootstrap 與 McNemar
程式碼 · Python · 28 行
import numpy as np
from scipy.stats import binomtest
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0)
a = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(Xtr, ytr)
b = make_pipeline(StandardScaler(), SVC(C=10, gamma="scale")).fit(Xtr, ytr)
ca, cb = a.predict(Xte) == yte, b.predict(Xte) == yte    # per-example correctness

# 1) Percentile bootstrap: resample test examples with replacement.
rng = np.random.default_rng(0)
idx = rng.integers(0, len(yte), size=(10_000, len(yte)))
diff = cb[idx].mean(axis=1) - ca[idx].mean(axis=1)       # paired: same resample
lo, hi = np.percentile(diff, [2.5, 97.5])
print(f"accuracy A={ca.mean():.4f}  B={cb.mean():.4f}  n={len(yte)}")
print(f"B - A = {cb.mean() - ca.mean():+.4f}, 95% bootstrap CI [{lo:+.4f}, {hi:+.4f}]")

# 2) Exact McNemar test: only the discordant examples carry information.
n01 = int(np.sum(ca & ~cb))      # A right, B wrong
n10 = int(np.sum(~ca & cb))      # A wrong, B right
p = binomtest(n10, n01 + n10, 0.5).pvalue
print(f"discordant pairs: A-only={n01}, B-only={n10}, exact McNemar p={p:.4f}")
輸出:
程式碼 · 3 行
accuracy A=0.9722  B=0.9852  n=540
B - A = +0.0130, 95% bootstrap CI [-0.0019, +0.0278]
discordant pairs: A-only=5, B-only=12, exact McNemar p=0.1435
SVM 高出 1.3 個百分點,但區間包含零,McNemar 的 p 值是 。540 張中只有 17 張能區分兩個模型,而 12 比 5 在公平硬幣下並不罕見。以這個測試集而言,誠實的結論是:「B 大概至少一樣好;說它更好的證據很薄弱。」
其他變異來源
測試樣本不是唯一的隨機來源。對神經網路而言,隨機種子會改變初始化、資料順序與資料擴增;資料切分本身也是隨機的;某些 GPU 核心是非確定性的。Bouthillier 等人為整個基準評測過程建模,發現資料取樣、參數初始化與超參數選擇造成的變異會明顯影響結論,並建議在重複實驗中盡可能隨機化這些來源 [10]。實務原則:
- 每個設定用多個種子執行(常見 3–5 個),回報平均與分散程度。
- 用成對檢定,在相同樣本與切分上比較方法。
- 若比較很多模型或很多資料集,總會有一些純屬偶然地「勝出」;要做多重比較校正,或在新資料上確認。
- 回報效果大小與區間。統計顯著的差異在實務上可能無關緊要;實務上很大的差異,在小資料集上也可能尚未被統計證實。
校準:知道自己可能出錯
白話版。 模型的信心應該和它答對的頻率相符。在所有以 80% 信心做出的預測中,大約 80% 應該是對的。準確率與校準是兩種不同的性質。
量測機率品質
令 為樣本 屬於類別 的預測機率, 為 one-hot 標籤。兩個合適評分規則(proper scoring rule,在期望上由真實機率達到最小)為:
其中 是樣本 的真實類別, 是類別數。NLL 是負對數概似(negative log-likelihood)。有些函式庫會把 Brier 分數再除以 ;請說明你使用哪種慣例。
期望校準誤差(expected calibration error, ECE)依最高類別信心把預測分到 個區間 ,並在每個區間比較平均信心與準確率:
其中 是第 個區間的答對比例, 是該區間的平均信心。可靠度圖(reliability diagram)逐區間畫出 對 ;完美校準的模型落在對角線上。ECE 不是合適評分規則,且取決於區間數與分箱方式,因此應與 NLL 或 Brier 分數及可靠度圖一起回報。
溫度縮放
Guo 等人觀察到,比起數十年前的網路大得多的現代深度網路常常過度自信,而一個純量修正就出奇地有效 [11]。溫度縮放(temperature scaling)在 softmax 之前把 logits 除以 :
會軟化過度自信的預測; 則讓信心不足的預測更尖銳。因為把所有 logits 除以同一個正數不會改變誰最大,預測類別(也就是準確率)不變。 必須在留出的校準集上擬合,絕不能在測試集上擬合。後來 Minderer 等人發現,最新的影像分類器,尤其是 Vision Transformer 這類不使用卷積的模型,屬於校準最好的一群,而且「校準隨分布偏移而衰退」等舊趨勢在它們身上較不明顯 [12]。
程式碼:溫度縮放,以及偏移對它的影響
程式碼 · Python · 41 行
import numpy as np
from scipy.optimize import minimize_scalar
from scipy.special import log_softmax, softmax
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier

X, y = load_digits(return_X_y=True)
X = X / 16.0
Xa, Xte, ya, yte = train_test_split(X, y, test_size=0.4, stratify=y, random_state=0)
Xtr, Xcal, ytr, ycal = train_test_split(Xa, ya, test_size=0.3, stratify=ya, random_state=0)
net = MLPClassifier(hidden_layer_sizes=(128,), alpha=1e-6, max_iter=300,
                    random_state=0).fit(Xtr, ytr)

def logits(X):                       # log-probabilities = logits up to a constant
    return np.log(np.clip(net.predict_proba(X), 1e-12, 1.0))

def ece(prob, y, bins=10):
    conf, pred = prob.max(1), prob.argmax(1)
    edges = np.linspace(0, 1, bins + 1)
    total = 0.0
    for lo, hi in zip(edges[:-1], edges[1:]):
        m = (conf > lo) & (conf <= hi)
        if m.any():
            total += m.mean() * abs((pred[m] == y[m]).mean() - conf[m].mean())
    return total

def nll(T, z, y):
    return -log_softmax(z / T, axis=1)[np.arange(len(y)), y].mean()

T = minimize_scalar(nll, bounds=(0.05, 20), method="bounded",
                    args=(logits(Xcal), ycal)).x
print(f"fitted temperature T = {T:.2f}")
noise = np.random.default_rng(0).normal(size=Xte.shape)
for sigma in [0.0, 0.3, 0.6]:        # Gaussian pixel noise = a simple covariate shift
    Xs = np.clip(Xte + sigma * noise, 0, 1)
    z = logits(Xs)
    p_raw, p_ts = softmax(z, axis=1), softmax(z / T, axis=1)
    print(f"noise {sigma:.1f}: acc={(p_raw.argmax(1) == yte).mean():.3f}  "
          f"ECE raw={ece(p_raw, yte):.3f}  ECE scaled={ece(p_ts, yte):.3f}  "
          f"NLL raw={nll(1, z, yte):.3f}  NLL scaled={nll(T, z, yte):.3f}")
輸出(scikit-learn 可能印出收斂警告,在這裡無害):
程式碼 · 4 行
fitted temperature T = 1.19
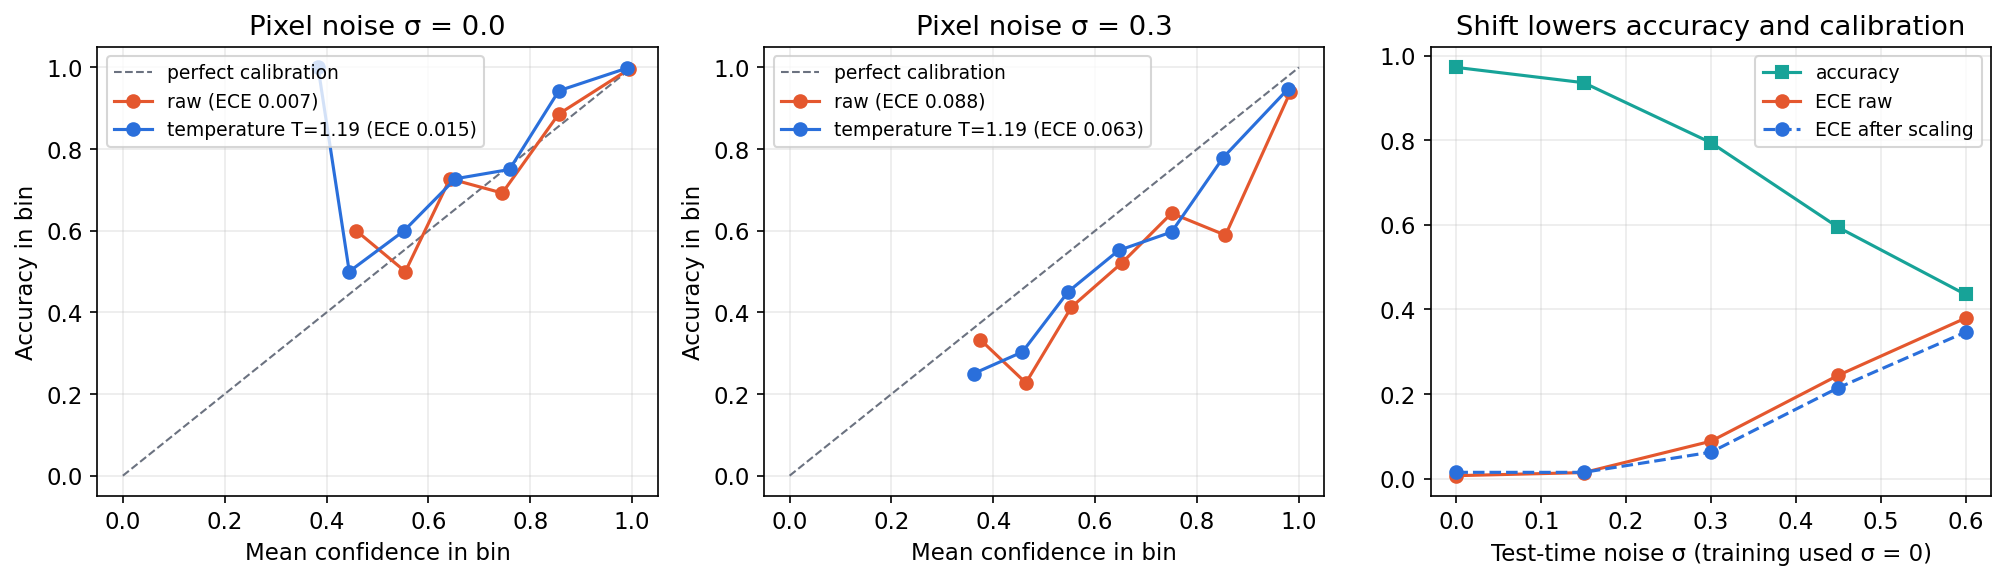
noise 0.0: acc=0.972  ECE raw=0.007  ECE scaled=0.015  NLL raw=0.108  NLL scaled=0.110
noise 0.3: acc=0.794  ECE raw=0.088  ECE scaled=0.063  NLL raw=0.693  NLL scaled=0.639
noise 0.6: acc=0.435  ECE raw=0.380  ECE scaled=0.347  NLL raw=2.998  NLL scaled=2.598
有三點觀察。在乾淨資料上,這個小網路本來就校準得很好,而用 324 張校準影像擬合 反而讓 ECE 略微變差:在小資料上擬合的修正可能引入雜訊。加入像素雜訊後,模型嚴重過度自信:在 時它只有 43.5% 答對,信心卻高得多。在乾淨資料上擬合的溫度縮放,在偏移下只幫上一點忙。這與 Ovadia 等人的大型研究一致:他們發現許多不確定性方法的校準會隨偏移增加而惡化 [16]。
選讀:Temperature Scaling(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
穩健性與分布偏移
白話版。 新相機、光線或族群可能改變表現與校準;應測試相關轉移,不假設部署與訓練相同。
三種偏移
把聯合分布寫成 ,其中 是輸入、 是標籤。偏移依訓練時()與部署時()哪一部分改變來命名:
- 共變量偏移(covariate shift):,但 不變。新相機、新光線、新掃描儀。
- 標籤(先驗)偏移(label shift):,但 不變。疫情爆發時某種疾病變得更常見。
- 概念偏移(concept shift): 本身改變。「垃圾郵件」的定義隨時間演變。
在純共變量偏移下,期望測試損失可改寫成加權的訓練損失:,重要性權重 。對影像而言這些權重很難估計,但這個等式說明了:測試輸入落在訓練資料稀少的區域時,偏移的影響最大。在標籤偏移下,Lipton 等人證明,只要有固定黑箱分類器在留出訓練資料上的混淆矩陣,加上它在未標註測試資料上的預測頻率,就足以估計新的類別先驗並重新加權模型 [17]。
探測偏移的基準
- ImageNet-C 對 ImageNet 驗證影像施加 15 種損壞(雜訊、模糊、天氣、數位),並分多個嚴重程度;ImageNet-P 則加入擾動序列。兩者量測的是對常見損壞的穩健性,而不是對抗攻擊 [13]。我們的像素雜訊掃描就是一個迷你版本。
- ImageNetV2 盡可能依照原始收集流程重新建立 ImageNet 測試集。許多模型的準確率下降了 11–14%,但在原始測試集上的進步轉換成在新測試集上更大的進步,所以這個下降反映的是影像稍微更難,而不是對重複使用的測試集過擬合 [14]。即使是小心的重新收集,本身也是一種偏移。
- WILDS 收集了十個具有自然偏移的資料集,包括來自不同醫院的腫瘤組織、新地點的自動相機以及來自新國家的衛星影像,並報告分布內與分布外表現之間有很大落差,而現有的緩解方法都沒能補上 [15]。
實務教訓:一定要加入至少一個依照你預期的部署變化(新院區、新裝置、較晚的時間)建立的偏移評估集,並把分布內與偏移後的結果並列回報。
效率:FLOPs、記憶體與延遲
白話版。「快」與「小」各有好幾種意思。運算量較少的模型不一定比較快,參數較少的模型也不一定比較省記憶體。要在目標裝置上量測。
計算運算量
一次乘加運算(multiply–accumulate, MAC)是一次乘法加一次加法,所以 1 MAC ≈ 2 個浮點運算(FLOPs)。對有 個輸入、 個輸出的全連接層,以及有 個輸入通道、 個輸出通道、 卷積核與 輸出的卷積層:
以上是每個樣本的運算量(偏差與激活函數的成本很小)。各函式庫回報的是 MAC 還是 FLOPs 並不一致,請寫明。
為什麼 FLOPs 不等於速度
Dehghani 等人指出,常見的成本指標(參數量、FLOPs、吞吐量、延遲)可能彼此矛盾,只回報其中一個會讓效率看起來失真 [18]。主要原因:
- 記憶體流量。 若某層必須從記憶體讀取權重,卻只做很少的運算,它受限於記憶體頻寬而非運算。對單一樣本套用線性層時,要讀取 位元組的 fp32 權重,只做 個 FLOPs:每位元組 0.5 個 FLOPs,遠不足以讓現代加速器忙起來。批次化可以提高這個比率(稱為運算強度,arithmetic intensity)。
- 平行度。 深度可分離卷積與許多小層的 FLOPs 很少,卻無法充分利用硬體。
- 核心支援。 在目標執行環境上沒有最佳化核心的運算,無論 FLOPs 多少都可能很慢。
記憶體帳
推論時,記憶體要放權重()、目前仍在使用的各層激活值、核心的工作空間,對自迴歸 Transformer 還有會隨上下文長度與批次大小成長的 KV 快取。訓練時還要加上梯度與最佳化器狀態:Adam 每個參數多存兩個值,所以使用 Adam 的 fp32 模型在計入激活值之前,就大約需要權重記憶體的 。
延遲量測協定
實際延遲取決於硬體、執行環境、批次大小、輸入解析度、數值精度與執行緒設定,而且前幾次呼叫因為一次性的初始化會比較慢。可靠的協定:
- 固定並回報裝置、執行環境版本、精度、批次大小、輸入尺寸與執行緒數。
- 先執行暖機迭代並丟棄結果。
- 計時多次並回報百分位數(p50 與 p90 或 p99),而不只是平均:使用者感受到的是尾端。
- 在 GPU 上,停止計時前要先同步裝置,因為核心是非同步啟動的。
- 除了網路本身,也要量測端到端時間(前處理、資料傳輸、解碼)。
柏拉圖前緣(Pareto frontier)包含那些「沒有其他候選在每個面向(準確率、延遲、記憶體)都至少一樣好、且至少在一個面向嚴格更好」的候選模型。呈現前緣能讓取捨一目了然,而不必捏造一個唯一的「最佳模型」。
部署:匯出、壓縮與執行環境
白話版。 匯出、壓縮與執行環境選擇可能改變預測及效能;應重新評估實際在目標裝置執行的產物。
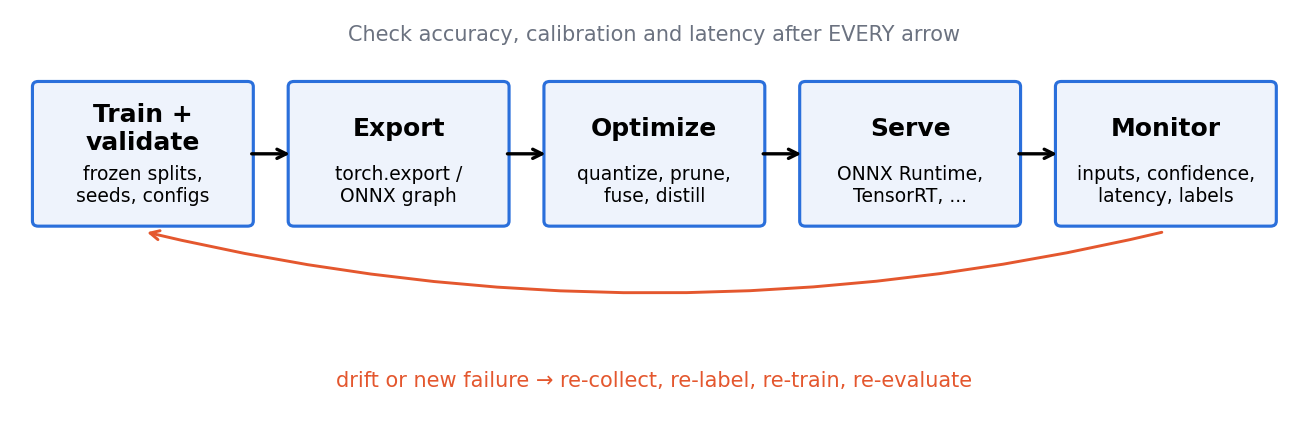
匯出與推論執行環境
訓練程式碼寫在彈性高、由 Python 驅動的框架中。部署則偏好靜態的計算描述:
torch.export以預先(ahead-of-time)的方式把 PyTorch 模組追蹤成ExportedProgram,也就是一張張量運算圖,可以序列化,並在沒有原始 Python 類別的情況下用不同輸入執行 [19]。- ONNX(Open Neural Network Exchange)是機器學習模型的開放標準檔案格式,讓在一個框架中訓練的模型能被其他工具執行 [20]。
- ONNX Runtime 是 ONNX 模型的跨平台推論引擎。它把運算圖切成子圖,交給各個硬體專屬的執行提供者(execution provider,例如 CUDA、TensorRT、OpenVINO 或 CoreML)[21]。
- NVIDIA TensorRT 是一套 SDK,把模型(來自各框架或 ONNX)編譯成 NVIDIA GPU 上的最佳化引擎,使用層融合與 FP16、BF16、FP8、INT8 等較低精度 [22]。
這些執行環境靠融合運算、為確切的張量形狀挑選快速核心以及降低精度來加速。因此同一個模型在不同執行環境上的輸出可能略有差異。請在一批驗證資料上比較匯出後與原始模型的輸出,並在轉換後重新量測準確率。
量化
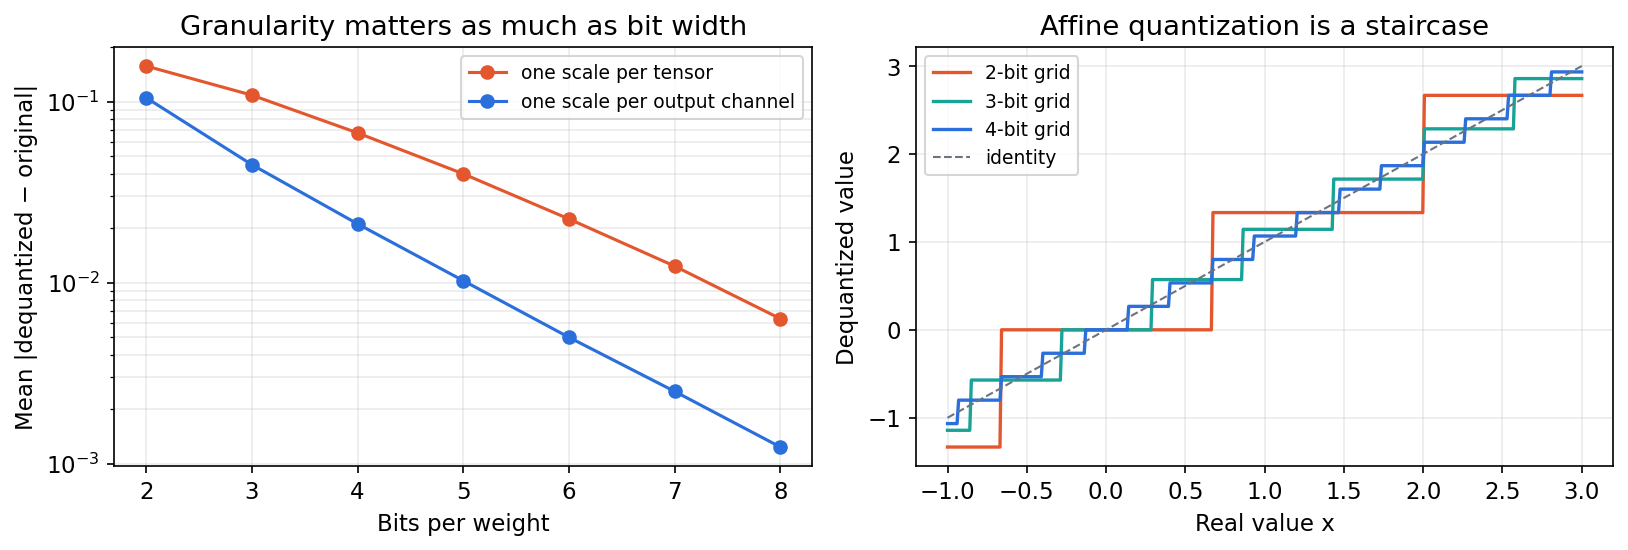
量化(quantization)用較少的位元來儲存與計算。在常見的仿射(非對稱)均勻量化中,實數值 會被映射成整數 ,再映射回來:
其中 是位元寬度, 是尺度(可表示值之間的間距), 是整數零點,選擇它使實數 0 能被精確表示, 是反量化後的近似值。對包含 0 的範圍 ,、。對稱變體固定 並使用有號範圍。Jacob 等人的純整數運算方案說明了如何用 8 位元整數矩陣乘法執行整個網路,以及如何為此進行訓練 [23]。
誤差有兩個來源:範圍內的捨入(每個值最多 )與範圍外的截斷。兩者都取決於尺度的粒度:每個張量一個尺度、每個輸出通道一個,或每一小組權重一個。Nagel 等人提供實用指南,涵蓋這些選擇、訓練後量化(post-training quantization, PTQ:訓練後用一小份具代表性的資料校準範圍)與量化感知訓練(quantization-aware training, QAT:訓練時模擬捨入,讓權重去適應)[24]。Gholami 等人則綜述了更廣的設計空間 [25]。
程式碼 · Python · 21 行
import numpy as np

def quantize(x, bits=8, axis=None):
    """Asymmetric (affine) uniform quantization, per tensor or per channel."""
    qmin, qmax = 0, 2**bits - 1
    lo = x.min(axis=axis, keepdims=True) if axis is not None else x.min()
    hi = x.max(axis=axis, keepdims=True) if axis is not None else x.max()
    lo, hi = np.minimum(lo, 0), np.maximum(hi, 0)      # keep 0 exactly representable
    s = (hi - lo) / (qmax - qmin)                       # scale
    z = np.round(qmin - lo / s)                         # zero point (integer)
    q = np.clip(np.round(x / s) + z, qmin, qmax)        # stored integers
    return s * (q - z)                                  # dequantized values

rng = np.random.default_rng(0)
# 64 output channels whose weight magnitudes differ by up to 100x
W = rng.normal(size=(64, 256)) * np.logspace(-2, 0, 64)[:, None]
for bits in [8, 4]:
    e_t = np.abs(quantize(W, bits) - W).mean()
    e_c = np.abs(quantize(W, bits, axis=1) - W).mean()
    print(f"{bits}-bit mean |error|: per-tensor {e_t:.5f}  per-channel {e_c:.5f}")
print("zero maps back to:", quantize(np.array([-1.0, 0.0, 3.0]))[1])
輸出:
程式碼 · 3 行
8-bit mean |error|: per-tensor 0.00632  per-channel 0.00124
4-bit mean |error|: per-tensor 0.06718  per-channel 0.02112
zero maps back to: 0.0
當各通道的範圍差異很大時,共用一個尺度會把大部分格點浪費在最大的通道上,讓小通道被粗糙地捨入。在這裡,逐通道尺度讓 8 位元時的誤差降到約五分之一。在大型語言模型中,少數離群的激活通道會在更大規模上造成同樣的問題,這正是 GPTQ(逐層、補償誤差的權重捨入)與 AWQ(依激活找出並保護重要權重通道)等方法在 3–4 位元純權重量化中處理的問題 [42], [43]。
剪枝
剪枝(pruning)移除貢獻很小的權重、通道、注意力頭或區塊。非結構化剪枝把個別權重設為零;它可以移除很大比例的參數,例如 Deep Compression 結合剪枝、以量化實現的權重共享與 Huffman 編碼,大幅縮小網路 [26]。但零星分布的零只有在執行環境具備該稀疏樣式的核心時才會省時間。結構化剪枝移除整個通道或注意力頭,產生較小的稠密張量,任何執行環境都能利用。Blalock 等人彙整了 81 篇剪枝論文,發現基準與指標不一致,使人難以判斷哪些方法真的有效,並提出標準化的評測框架 [27]。Hoefler 等人深入綜述了訓練與推論中的稀疏性 [28]。
知識蒸餾
蒸餾(distillation)訓練一個小的學生模型去模仿大的教師模型。Hinton 等人提出讓學生匹配教師軟化後的輸出分布 [29]。設溫度為 ,教師與學生的 logits 分別為 與 ,軟化機率為 ,權重 :
軟化的教師分布帶有「暗知識」:哪些錯誤類別彼此相似。軟項的梯度按 縮放,所以乘上 能在改變 時保持兩項的平衡 [29]。Gou 等人依傳遞什麼(輸出、中間特徵、樣本間關係)與如何傳遞(離線、線上、自蒸餾)整理了後續研究 [30]。學生會繼承教師的能力,也會繼承它的錯誤與偏差。
程式碼:純權重 int8、延遲與匯出
這個範例把一個小 MLP 的權重以 int8 儲存(每個輸出通道一個尺度),並在 CPU 上量測檔案大小與延遲。只用到 PyTorch 核心功能。
程式碼 · Python · 53 行
import io, time
import numpy as np
import torch
from torch import nn

torch.manual_seed(0)
model = nn.Sequential(nn.Linear(512, 2048), nn.ReLU(),
                      nn.Linear(2048, 2048), nn.ReLU(),
                      nn.Linear(2048, 10)).eval()
x = torch.randn(32, 512)

class Int8WeightLinear(nn.Module):
    """Weight-only int8 storage, symmetric per output channel."""
    def __init__(self, lin):
        super().__init__()
        w = lin.weight.detach()
        scale = w.abs().amax(dim=1, keepdim=True) / 127
        self.register_buffer("q", torch.round(w / scale).to(torch.int8))
        self.register_buffer("scale", scale)
        self.register_buffer("bias", lin.bias.detach().clone())
    def forward(self, x):                       # dequantize, then fp32 matmul
        return nn.functional.linear(x, self.q.float() * self.scale, self.bias)

int8 = nn.Sequential(*[Int8WeightLinear(m) if isinstance(m, nn.Linear) else m
                       for m in model]).eval()

def size_mb(m):
    buf = io.BytesIO()
    torch.save(m.state_dict(), buf)
    return buf.getbuffer().nbytes / 1e6

def latency_ms(m, x, warmup=10, runs=100):
    with torch.inference_mode():
        for _ in range(warmup):                 # first calls pay one-off costs
            m(x)
        times = []
        for _ in range(runs):
            t0 = time.perf_counter()
            m(x)
            times.append((time.perf_counter() - t0) * 1e3)
    return np.percentile(times, [50, 90]).round(2)

with torch.inference_mode():
    gap = (model(x) - int8(x)).abs().max().item()
    agree = (model(x).argmax(1) == int8(x).argmax(1)).float().mean().item()
print(f"fp32 file: {size_mb(model):.1f} MB  p50/p90 latency {latency_ms(model, x)} ms")
print(f"int8 file: {size_mb(int8):.1f} MB  p50/p90 latency {latency_ms(int8, x)} ms")
print(f"max |logit difference| = {gap:.4f}, top-1 agreement = {agree:.3f}")

# Ahead-of-time graph capture: a portable program, independent of this Python class.
exported = torch.export.export(model, (x,))
ops = [n.target for n in exported.graph.nodes if n.op == "call_function"]
print(type(exported).__name__, "->", [str(o).split(".")[1] for o in ops])
在 CPU 上(四個執行緒)執行一次的輸出:
程式碼 · 4 行
fp32 file: 21.1 MB  p50/p90 latency [2.74 4.49] ms
int8 file: 5.3 MB  p50/p90 latency [ 9.23 11.06] ms
max |logit difference| = 0.0018, top-1 agreement = 1.000
ExportedProgram -> ['linear', 'relu', 'linear', 'relu', 'linear']
你的延遲數字會不同;重點在於趨勢。檔案小了四倍,輸出幾乎沒變。但 int8 版本反而更慢,因為它每次呼叫都把權重轉回 fp32,再執行同樣的 fp32 矩陣乘法。只有在執行環境具備該運算的整數(或低精度)核心時,或工作負載受記憶體頻寬限制、讀取較少位元組成為主因時,較低精度才會變快。這正是「壓縮了」與「加速了」之間的落差,也是 TensorRT、ONNX Runtime 以及 PyTorch 自家的 torchao 函式庫 [46] 要彌補的地方。這個 MLP 的運算量為每個樣本 MFLOPs,兩個版本完全相同。
部署後的監控
白話版。 即使程式碼完全沒變,模型也可能變差,因為資料變了。要觀察輸入與輸出,盡可能收集新的標籤,並事先決定什麼情況會觸發調查。
Sculley 等人描述 ML 系統如何累積隱藏的「技術債」:糾纏的特徵、未申報的預測使用者、模型輸出影響未來訓練資料的回饋迴圈,以及依賴會在無預警下改變的外部資料 [33]。Paleyes 等人收集已發表的部署案例研究,發現部署流程的每個階段都會出問題 [39]。有用的訊號,由便宜到最有資訊量:
- 系統健康:延遲百分位數、錯誤率、記憶體、吞吐量。
- 輸入統計:影像亮度、解析度、裝置類型、缺失欄位;與訓練時的參考時段比較。
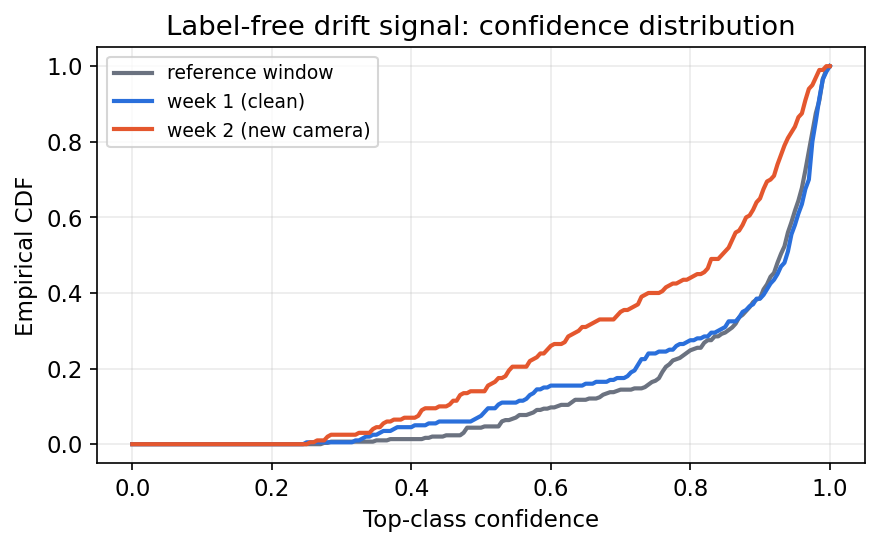
- 輸出統計:預測類別與信心的分布。這些不需要標籤。
- 延遲到來的標籤:定期標註一小部分線上資料,是直接估計準確率的唯一方式。
要比較線上時段與參考時段,雙樣本檢定是簡單的起點。對經驗累積分布函數分別為 與 的一維樣本,Kolmogorov–Smirnov 統計量為
也就是兩條曲線之間最大的垂直差距。Rabanser 等人比較了多種偏移偵測方法,發現先用預訓練分類器降維(例如取其 softmax 輸出)再做雙樣本檢定,在他們研究的偏移中表現最好 [32]。
程式碼 · Python · 22 行
import numpy as np
from scipy.stats import ks_2samp
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

X, y = load_digits(return_X_y=True)
X = X / 16.0
Xtr, Xlive, ytr, ylive = train_test_split(X, y, test_size=0.5, random_state=0)
Xtr, Xref, ytr = Xtr[:600], Xtr[600:], ytr[:600]   # reference window from training time
clf = LogisticRegression(max_iter=2000).fit(Xtr, ytr)
ref_conf = clf.predict_proba(Xref).max(1)     # label-free signal: top-class confidence

rng = np.random.default_rng(0)
for name, noise in [("week 1 (clean)", 0.0), ("week 2 (new camera)", 0.25)]:
    batch = rng.choice(len(Xlive), 200, replace=False)
    Xb = np.clip(Xlive[batch] + noise * rng.normal(size=Xlive[batch].shape), 0, 1)
    conf = clf.predict_proba(Xb).max(1)
    stat, p = ks_2samp(ref_conf, conf)
    acc = (clf.predict(Xb) == ylive[batch]).mean()   # usually NOT available live
    print(f"{name}: mean confidence {conf.mean():.3f}, KS={stat:.3f}, p={p:.2g}, "
          f"(hidden) accuracy {acc:.3f}")
輸出:
程式碼 · 2 行
week 1 (clean): mean confidence 0.846, KS=0.089, p=0.28, (hidden) accuracy 0.950
week 2 (new camera): mean confidence 0.757, KS=0.277, p=1.3e-08, (hidden) accuracy 0.885
信心分布在沒有任何標籤的情況下就標記出第 2 週,而隱藏的準確率證實確實發生了變化。偵測器告訴你資料有沒有改變,而不是準確率是否下降:無害的偏移也會觸發它,而在很大的時段下,即使微小的變化也會變得「顯著」。用它來觸發調查與標註,而不是自動重新訓練。
可重現性與文件
白話版。 別人(包括六個月後的你)應該能重跑你的實驗並得到相同的數字,讀者也應該能看出這個模型是做什麼用的、哪些場合不該使用。
讓實驗可重複
為每個函式庫固定並記錄隨機種子,但要知道它的極限:PyTorch 文件明言,不同版本、不同 commit 或不同平台之間無法保證完全可重現的結果,並建議在需要逐位元一致時設定種子、呼叫 torch.use_deterministic_algorithms(True) 並關閉 cuDNN benchmark [34]。除了種子,還要記錄:
- 資料集版本、切分 ID(實際的樣本 ID 清單)與去重規則;
- 前處理與資料擴增程式碼、預訓練檢查點及其來源;
- 完整設定(最佳化器、學習率排程、停止規則)、軟體環境與硬體;
- 每一個驗證階段的決策,以及唯一一次的最終測試評估。
Pineau 等人報告的 NeurIPS 2019 可重現性計畫,推出了程式碼提交政策、社群可重現性挑戰,以及正好涵蓋上述項目的檢查表 [37]。
為模型與資料寫文件
模型卡(model cards)是隨訓練好的模型附上的簡短文件,說明預期用途、評估資料、依相關群體與條件細分的表現,以及已知限制 [35]。資料集說明書(datasheets for datasets)要求資料集建立者記錄動機、組成、收集過程、前處理、建議用途與維護方式 [36]。兩者都讓本章的評估決策,對依賴它們的人變得透明。
結業實驗
選一個具備適當規模、可合法使用資料集的任務。定義部署母體與切分單位。比較三個候選:一個傳統基準、凍結預訓練特徵加小分類頭,以及一個微調過的網路。對每一個,回報附 bootstrap 區間的測試指標、與最佳基準的成對比較、可靠度圖、一個偏移集上的結果,以及目標裝置上的延遲百分位數。寫一頁模型卡。最終測試集只打開一次;若它揭露了失敗而你修改了模型,就把舊結果視為開發證據,並為修改後的主張取得新的評估。
現代觀點
評估與部署的工程本身已經成為一個研究領域。以下幾篇綜述與回顧勾勒了它的樣貌。
資料洩漏與可重現性。 Kapoor 與 Narayanan 對以 ML 為基礎之科學的回顧,記錄了 17 個領域中 329 篇論文的洩漏問題,並提出「模型資訊表」(model info sheets),要求作者論證其訓練/測試分離為何成立 [4]。結合 Bouthillier 等人的變異研究 [10] 與 NeurIPS 可重現性計畫 [37],共識是:多數過度樂觀的結果來自評估協定的錯誤,而不是什麼特殊的統計問題。
不確定性與校準。 Gawlikowski 等人綜述深度網路的不確定性估計:他們區分可降低的模型(認知)不確定性與不可降低的資料(偶然)不確定性,把方法分為確定性網路、貝氏網路、集成與測試時資料擴增,並回顧校準方法及其實務限制 [38]。Ovadia 等人則補上實證警告:事後校準在偏移下不夠用,而對多個模型做邊際化的方法(例如集成)表現較好 [16]。
實務部署。 Paleyes 等人綜述已發表的案例研究,把挑戰對應到部署流程的各個階段,並顯示實務工作者在每個階段都會遇到問題 [39],延伸了 Sculley 等人的技術債觀點 [33]。
模型壓縮。 Cheng 等人提供了 CNN 剪枝、低秩分解、緊湊卷積與蒸餾的經典綜覽 [31];Gholami 等人 [25] 與 Nagel 等人 [24] 聚焦量化;Hoefler 等人聚焦稀疏性 [28];Gou 等人聚焦蒸餾 [30]。對大型語言模型,Zhu 等人綜述了針對數十億參數模型的量化、剪枝、蒸餾與低秩方法 [41]。2023–2026 年一個明顯的趨勢是:4 位元純權重量化(GPTQ [42]、AWQ [43])與 FP8 等低精度格式,已經從論文走進生產工具:TensorRT 列出 FP8、INT8、FP4 與 INT4 等支援精度 [22],而 PyTorch 的量化工具正整合到 torchao 函式庫中 [46]。
全面評估。 對基礎模型,HELM 同時在許多情境與多個指標上評估許多模型(準確率、校準、穩健性、公平性、偏差、毒性與效率),並主張單一排行榜數字會掩蓋這些取捨 [40]。同樣的多指標習慣也適用於視覺模型。
規模化。 規模定律(scaling laws)擬合模型大小、資料、算力與損失之間的經驗關係。Hoffmann 等人發現在固定算力預算下,語言模型的參數量與訓練 token 數應大致等比例擴增 [44];Zhai 等人研究 ViT 準確率如何隨模型大小、資料與算力擴展 [45]。一個領域擬合出的常數不應直接搬到另一個領域;可以遷移的教訓是:每個結果都要報告背後的算力與資料。
開放問題。 評估資料混入網路規模的預訓練資料(資料污染)很難排除;未知偏移下的校準仍未解決;延遲數字很少能在不同硬體世代之間轉移;生成式與互動式系統的評估(見 DLCV 13)仍缺乏公認的協定。
重點整理
- 依部署時的新資料單位切分,並在各訓練折內擬合前處理。
- 相依資料使用分組或時間切分,並把模型選擇與回報評估分開。
- 在配對範例上比較模型,並依實際獨立取樣單位估計不確定性。
- 校準不同於準確率;溫度縮放可能改善相符資料的校準,但不保證轉移後仍成立。
- 運算量、參數量、記憶體與延遲衡量不同成本,應測試完整目標流程。
- 匯出或壓縮後重新評估,監控資料變化,並記錄版本、協定及預期用途。
練習
- 洩漏稽核。 同事先在全部 1,797 張數字影像上擬合 PCA,再切分訓練與測試並回報測試準確率。說明洩漏在哪裡,以及為什麼 PCA 從未看過標籤卻仍有洩漏。你會如何修正程式碼?
提示
主成分方向是用測試影像算出來的,所以表示法被調整得貼近測試分布。把 PCA 放進 Pipeline,使它只在每個訓練折上擬合。對 PCA 而言這個偏差常常不大,但對使用標籤的監督式前處理(例如依標籤做特徵選擇),偏差可能很大。
- 罕見的正例。 某資料集只有 1% 是正例影像。永遠預測負例的分類器,準確率、正例召回率與平衡準確率各是多少?你會向醫師回報哪個指標?為什麼?
提示
準確率 99%、召回率 0、平衡準確率 0.5(正例召回率 0 與負例召回率 1 的平均)。應回報在臨床選定操作點下的召回率(敏感度)與特異度或精確率,並附上區間,因為真正重要的是漏掉一個正例的代價。
- 測試集要多大? 你預期準確率約 90%,希望 95% 信賴區間約為 個百分點。用常態近似,大約需要多少個獨立測試樣本?如果影像來自 50 位病人,會有什麼不同?
提示
解 ,得 。若只有 50 位病人,樣本並不獨立;有效樣本數比較接近 50 而非影像張數,所以區間會寬得多。請用以病人為單位重抽樣的 bootstrap。
- 手算溫度。 一個三類別模型輸出 logits 。計算 與 時最高類別的機率。預測類別會改變嗎?什麼時候擬合出的 會小於 1?
提示
:。:。argmax 不變。當模型信心不足時(例如強正則化或標籤平滑之後),擬合出的 。
- 壓縮的宣稱。 一個剪枝後的模型參數只剩原本的一半,但在你的 GPU 上延遲完全相同。提出三種可能解釋,以及一個能區分它們的實驗。
提示
非結構化的零仍被稠密核心拿去相乘;剩下的成本主要來自激活值、記憶體流量或未改變的層;或批次太小,使核心啟動開銷成為主因。逐層剖析時間,並與一個張量真正變小的結構化剪枝模型比較。
- 設計一個監控方案。 你的瑕疵偵測器在工廠產線上執行;人工檢驗的標籤要兩週後才會回來。設計監控方案:記錄什麼、哪些統計量要與哪個參考比較、什麼門檻會觸發警報,以及警報後要做什麼。
提示
每天記錄延遲、影像統計(亮度、模糊程度)、預測瑕疵率與信心直方圖;以 KS 或族群穩定度指標與驗證時的參考時段比較;在持續性變化時才發出警報,而不是單日波動。警報後立即標註一批樣本、計算附區間的準確率,然後才決定要重新校準、微調還是回滾。
參考文獻
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 11 “Practical Methodology”. book
- G. James, D. Witten, T. Hastie, R. Tibshirani and J. Taylor, An Introduction to Statistical Learning: with Applications in Python, Springer, 2023. book
- scikit-learn developers, “Common pitfalls and recommended practices,” scikit-learn documentation. docs
- S. Kapoor and A. Narayanan, “Leakage and the reproducibility crisis in machine-learning-based science,” Patterns, vol. 4, no. 9, 2023. doi
- S. Varma and R. Simon, “Bias in error estimation when using cross-validation for model selection,” BMC Bioinformatics, vol. 7, art. 91, 2006. doi
- G. C. Cawley and N. L. C. Talbot, “On over-fitting in model selection and subsequent selection bias in performance evaluation,” Journal of Machine Learning Research, vol. 11, pp. 2079–2107, 2010. paper
- M. Bińkowski, D. J. Sutherland, M. Arbel and A. Gretton, “Demystifying MMD GANs,” ICLR, 2018. arXiv
- T. G. Dietterich, “Approximate statistical tests for comparing supervised classification learning algorithms,” Neural Computation, vol. 10, no. 7, 1998. doi
- B. Efron, “Bootstrap methods: another look at the jackknife,” The Annals of Statistics, vol. 7, no. 1, 1979. doi
- X. Bouthillier et al., “Accounting for variance in machine learning benchmarks,” MLSys, 2021. arXiv
- C. Guo, G. Pleiss, Y. Sun and K. Q. Weinberger, “On calibration of modern neural networks,” ICML, 2017. arXiv
- M. Minderer et al., “Revisiting the calibration of modern neural networks,” NeurIPS, 2021. arXiv
- D. Hendrycks and T. Dietterich, “Benchmarking neural network robustness to common corruptions and perturbations,” ICLR, 2019. arXiv
- B. Recht, R. Roelofs, L. Schmidt and V. Shankar, “Do ImageNet classifiers generalize to ImageNet?,” ICML, 2019. paper
- P. W. Koh et al., “WILDS: A benchmark of in-the-wild distribution shifts,” ICML, 2021. paper
- Y. Ovadia et al., “Can you trust your model’s uncertainty? Evaluating predictive uncertainty under dataset shift,” NeurIPS, 2019. arXiv
- Z. C. Lipton, Y.-X. Wang and A. Smola, “Detecting and correcting for label shift with black box predictors,” ICML, 2018. arXiv
- M. Dehghani, A. Arnab, L. Beyer, A. Vaswani and Y. Tay, “The efficiency misnomer,” ICLR, 2022. arXiv
- PyTorch, “torch.export,” PyTorch documentation. docs
- ONNX, “Open Neural Network Exchange: the open standard for machine learning interoperability.” site
- ONNX Runtime, “Welcome to ONNX Runtime,” documentation. docs
- NVIDIA, “NVIDIA TensorRT documentation.” docs
- B. Jacob et al., “Quantization and training of neural networks for efficient integer-arithmetic-only inference,” CVPR, 2018. doi
- M. Nagel et al., “A white paper on neural network quantization,” arXiv:2106.08295, 2021. arXiv
- A. Gholami, S. Kim, Z. Dong, Z. Yao, M. W. Mahoney and K. Keutzer, “A survey of quantization methods for efficient neural network inference,” book chapter in Low-Power Computer Vision; arXiv:2103.13630, 2021. arXiv
- S. Han, H. Mao and W. J. Dally, “Deep compression: compressing deep neural networks with pruning, trained quantization and Huffman coding,” ICLR, 2016. arXiv
- D. Blalock, J. J. Gonzalez Ortiz, J. Frankle and J. Guttag, “What is the state of neural network pruning?,” MLSys, 2020. arXiv
- T. Hoefler, D. Alistarh, T. Ben-Nun, N. Dryden and A. Peste, “Sparsity in deep learning: pruning and growth for efficient inference and training in neural networks,” Journal of Machine Learning Research, vol. 22, 2021. arXiv
- G. Hinton, O. Vinyals and J. Dean, “Distilling the knowledge in a neural network,” NIPS Deep Learning Workshop, 2014; arXiv:1503.02531. arXiv
- J. Gou, B. Yu, S. J. Maybank and D. Tao, “Knowledge distillation: a survey,” International Journal of Computer Vision, vol. 129, 2021. doi
- Y. Cheng, D. Wang, P. Zhou and T. Zhang, “Model compression and acceleration for deep neural networks: the principles, progress, and challenges,” IEEE Signal Processing Magazine, vol. 35, no. 1, 2018. doi arXiv
- S. Rabanser, S. Günnemann and Z. C. Lipton, “Failing loudly: an empirical study of methods for detecting dataset shift,” NeurIPS, 2019. arXiv
- D. Sculley et al., “Hidden technical debt in machine learning systems,” NeurIPS, 2015. paper
- PyTorch, “Reproducibility,” PyTorch documentation. docs
- M. Mitchell et al., “Model cards for model reporting,” ACM FAT*, 2019. arXiv
- T. Gebru et al., “Datasheets for datasets,” Communications of the ACM, vol. 64, no. 12, 2021. doi
- J. Pineau et al., “Improving reproducibility in machine learning research (a report from the NeurIPS 2019 reproducibility program),” Journal of Machine Learning Research, vol. 22, 2021. paper
- J. Gawlikowski et al., “A survey of uncertainty in deep neural networks,” Artificial Intelligence Review, vol. 56, 2023. doi
- A. Paleyes, R.-G. Urma and N. D. Lawrence, “Challenges in deploying machine learning: a survey of case studies,” ACM Computing Surveys, vol. 55, no. 6, 2022. doi
- P. Liang et al., “Holistic evaluation of language models,” Transactions on Machine Learning Research, 2023. arXiv
- X. Zhu, J. Li, Y. Liu, C. Ma and W. Wang, “A survey on model compression for large language models,” Transactions of the Association for Computational Linguistics, vol. 12, 2024. doi
- E. Frantar, S. Ashkboos, T. Hoefler and D. Alistarh, “GPTQ: accurate post-training quantization for generative pre-trained transformers,” ICLR, 2023. arXiv
- J. Lin et al., “AWQ: activation-aware weight quantization for LLM compression and acceleration,” MLSys, 2024. arXiv
- J. Hoffmann et al., “Training compute-optimal large language models,” arXiv:2203.15556, 2022; NeurIPS 2022 version titled “An empirical analysis of compute-optimal large language model training.” arXiv
- X. Zhai, A. Kolesnikov, N. Houlsby and L. Beyer, “Scaling vision transformers,” CVPR, 2022. doi
- PyTorch, “torchao documentation.” docs
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑這是「機器學習」單元的最後一篇。 回到學習地圖 →