ML 01A・學習所需的線性代數
先備知識:ML 01・機器學習入門
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
移動兩個基底向量的像,看一張真實照片跟著改變。行列式是帶正負號的面積倍率,奇異值是沿兩個互相垂直方向的伸縮量,秩為 1 時整張影像被壓成一條線。
你將學到
- 追蹤陣列形狀,理解矩陣乘法。
- 用秩、零空間與範數理解線性系統。
- 從特徵值與奇異值理解幾何性質。
- 解最小平方問題,診斷對雜訊的敏感度。
- 推導 PCA,並連結矩陣恆等式與學習運算。
先看全貌
神經網路裡幾乎每個運算,都是「線性映射」接上一個簡單的非線性函數。全連接層是乘上權重矩陣;卷積是有結構的矩陣乘法;注意力機制先計算向量之間的內積,再用一個權重矩陣把向量混合起來。線性代數就是描述這一切的語言。它告訴我們一個映射保留了什麼、丟掉了什麼、拉長了什麼,以及怎樣計算才不會損失精確度。
本篇對應 Goodfellow、Bengio 與 Courville 所著《Deep Learning》的「應用數學」部分 [1],以及《Mathematics for Machine Learning》的線性代數章節 [2]。想多做練習,Strang 的教科書 [3] 是最平易近人的完整課程;Golub 與 Van Loan [4]、Trefethen 與 Bau [5] 則是「如何在電腦上可靠地完成這些計算」的標準參考書。如果你還不熟悉矩陣符號,建議在 ML 02 之前先讀本篇。姊妹篇是 ML 01B・機率與資訊理論 與 ML 01C・數值計算。
本篇有一條主線。我們從物件與形狀開始,接著談乘法與解方程式,再用範數量測大小。特徵分解與 SVD 說明一個矩陣的「個性」;偽反矩陣、跡與行列式則是建立在它們之上的工具。最後,我們用上述每一項工具推導 PCA——這個經典的資料壓縮方法——推導方式與 [1] 相同。
純量、向量、矩陣與張量
白話版。機器學習裡的每個數字都住在一個有命名軸的陣列裡。做任何乘法之前,先說清楚每個軸代表什麼。
純量(scalar)是單一數字,寫成 。向量(vector)是 個數字的有序清單:,分量為 ;依慣例,向量是一個行向量(直的)。矩陣(matrix)是二維的數字格子: 有 列(row)與 行(column), 是第 列、第 行的元素。張量(tensor)則是任意多個軸的陣列。
這些物件可以直接對應到資料:
- 高 、寬 的灰階影像是 的矩陣;攤平後就是向量 (見影像即陣列)。
- 筆樣本、每筆 個特徵,每列放一筆樣本,就得到設計矩陣(design matrix)。
- 權重 、偏差 的全連接層一次處理整個批次:,其中 是全為 1 的向量。
- PyTorch 的影像批次通常是形狀 (批次、通道、高、寬)的四維張量;Transformer 的 token 嵌入批次通常是 (批次、序列長度、嵌入維度)。
轉置(transpose) 把列與行對調:。它滿足 與 ——注意順序反過來了。
廣播
寫 在數學上很誠實,但很繁瑣,所以程式庫允許你直接把向量加到矩陣的每一列。這叫廣播(broadcasting):兩個陣列形狀不同時,長度為 1 的軸(或缺少的前導軸)會被延展成相同大小。廣播很方便,也很危險,因為形狀錯了程式往往照樣執行。最常見的錯誤是把形狀 的行向量和形狀 的一維陣列相減,結果悄悄變成 的矩陣,而不是 個殘差。
程式碼 · Python · 22 行
import numpy as np

rng = np.random.default_rng(0)
X = rng.normal(size=(32, 64))      # batch of 32 examples, 64 features
W = rng.normal(size=(64, 10))      # linear map 64 -> 10
b = rng.normal(size=10)            # one bias per output
Y = X @ W + b                      # b broadcasts over the 32 rows
assert Y.shape == (32, 10)

# A classic broadcasting bug: (32,) - (32, 1) silently becomes (32, 32)
y_true = rng.normal(size=32)
y_pred = rng.normal(size=(32, 1))
print("buggy residual shape:", (y_true - y_pred).shape)
print("fixed residual shape:", (y_true - y_pred[:, 0]).shape)

# Four equivalent views of the same matrix product
A, B = rng.normal(size=(3, 4)), rng.normal(size=(4, 2))
entry = np.array([[A[i] @ B[:, j] for j in range(2)] for i in range(3)])
cols = np.stack([A @ B[:, j] for j in range(2)], axis=1)
outer = sum(np.outer(A[:, k], B[k]) for k in range(4))
assert np.allclose(A @ B, entry) and np.allclose(A @ B, cols) and np.allclose(A @ B, outer)
print("all views agree")
錯誤的那一行印出 (32, 32),修正後是 (32,)。對 陣列取平均仍然只得到一個數字,所以用這種方式算出的損失函數可以順利訓練,卻在最佳化錯誤的目標。凡是重要的程式碼,都替形狀加上 assert。
矩陣與向量的乘法
白話版。矩陣乘法把兩台線性機器串成一台。輸出的每個數字,是第一個矩陣的某一列與第二個矩陣的某一行的內積。
對 與 ,矩陣乘積 為
其中 是 (也是 )的列索引, 是 (也是 )的行索引, 走遍共同的內部維度 。內部維度必須相同——遇到形狀錯誤時,這是第一個要檢查的地方。
同一個乘積有四種讀法,各有用處:
- 元素觀點。 是 的第 列與 的第 行的內積。注意力分數 就是這樣讀:每個 query 和每個 key 比較。
- 行觀點。 的第 行等於 乘上 的第 行; 的每一行都是 各行的線性組合。
- 列觀點。 的第 列等於 的第 列乘上 。在 中,每筆輸出樣本就是它的輸入列通過同一組權重。
- 外積觀點。,是 個秩一矩陣的總和,每個由 的第 行與 的第 列構成。這個觀點會在本篇後面解釋低秩近似與 LoRA。
上面的程式碼驗證了四種讀法結果相同。
矩陣乘法滿足結合律 與分配律 ,但不滿足交換律:一般而言 ,而且其中一個乘積常常根本沒有定義。逐元素(Hadamard)乘積 則是把對應元素相乘,需要形狀相同。在 NumPy 與 PyTorch 中,A @ B 是矩陣乘法,A * B 是逐元素乘法。兩個向量 的內積是特例 ,而且對稱:。
單位矩陣、反矩陣與線性方程組
條方程式、 個未知數的線性方程組可以簡寫成
的每一列是一條方程式的係數, 是未知數, 是等號右邊的值。
單位矩陣 對角線為 1、其餘為 0,不改變任何向量:。若方陣 存在矩陣 使 ,就稱 可逆,此時方程組恰有一解 。
這個公式很適合推導,卻不適合計算。直接算出 ,比用 LU、Cholesky 或 QR 分解直接求解更費時、也更不精確 [4], [5]。在 NumPy 中請寫 np.linalg.solve(A, b),而不是 np.linalg.inv(A) @ b。本篇中的 是思考工具。
線性相依、生成空間與秩
白話版。秩計算一個矩陣真正能產生多少個不同方向。重複或多餘的行不會增加新東西。
向量 的線性組合是 , 為純量。一組向量的生成空間(span)是它們所有線性組合構成的集合。由於 ,向量 是 各行 的線性組合。因此 有解,若且唯若 落在各行的生成空間裡,這個空間稱為 的行空間(column space,或值域)。
若一組向量中沒有任何一個是其他向量的線性組合——等價地說, 只在所有 時成立——就稱它們線性獨立。 的秩(rank)是線性獨立的行數,而它永遠等於線性獨立的列數。對 ,;等號成立時稱 滿秩。
的零空間(null space)是所有滿足 的向量 ,也就是被 摧毀的輸入方向。秩–零度定理說
其中 是行數, 是零空間中獨立方向的個數。這一條等式就解釋了 的三種情況:
| 形狀與秩 | 會發生什麼 | 典型的機器學習情境 |
|---|---|---|
| 方陣、滿秩 | 恰有一解 | 良好設定的座標轉換 |
| 高瘦()、行滿秩 | 通常沒有精確解;改求最小平方解 | 樣本數多於特徵數的迴歸 |
| 矮胖()或秩不足 | 若有解則有無限多解 | 參數多於限制條件,例如深度網路 |
對方陣來說,「可逆」「滿秩」「各行線性獨立」「零空間只有零向量」是同一件事;不滿足的方陣稱為奇異(singular)矩陣。
範數:量測大小
白話版。範數把一個向量變成一個非負數,表示它有多大。不同的範數對「大」有不同看法。
範數是滿足以下條件的函數 :;(三角不等式);對任何純量 ,。最常見的是 範數:
- 是歐幾里得範數,也就是一般的長度,常簡寫為 。它的平方 更好微分,出現在均方誤差損失與權重衰減中。
- 在每個地方——包括靠近零的地方——都以相同速率成長。當「恰好為零」和「稍微不為零」的差別很重要時它特別有用,這也是 懲罰會鼓勵稀疏解的原因。
- 是最大範數,即最大元素的大小。對抗強健性的研究常用它限制擾動。
- 非零元素的個數有時被稱為「 範數」,但它不是範數:把 乘以 2 並不會改變它。
內積透過夾角與歐幾里得範數相連:, 是 與 的夾角。餘弦相似度
只對非零向量有定義,並且忽略尺度。這對某些嵌入很有用(對比學習正因如此會把特徵正規化),但當大小本身有意義時——例如影像亮度——就不適用。
矩陣範數
矩陣最常用兩種範數。Frobenius 範數把矩陣當成一條長向量:
譜範數(spectral norm,即算子 2-範數)量測 能把單位向量拉長的最大倍數:
其中 是最大奇異值,定義見下方 SVD 一節。若以全部奇異值 表示,則 ,而 。所以許多小奇異值可以讓 Frobenius 範數變大,卻不改變最大放大倍數。譜範數限制了一層網路最多能把輸入擾動放大多少,因此出現在強健性與 GAN 穩定性的研究中 [17]。
程式碼 · Python · 13 行
import numpy as np

x = np.array([3.0, -4.0, 0.0, 1.0])
for p in [1, 2, np.inf]:
    print(f"L{p} norm:", np.linalg.norm(x, p))
print("L0 'norm' (count of nonzeros):", np.count_nonzero(x))

A = np.array([[3.0, 0.0], [4.0, 5.0]])
s = np.linalg.svd(A, compute_uv=False)
print("singular values:", s.round(4))
print("Frobenius:", np.linalg.norm(A, "fro"), "=", np.sqrt((s**2).sum()))
print("spectral :", np.linalg.norm(A, 2), "=", s[0])
assert np.isclose(np.linalg.norm(A, "fro")**2, np.trace(A.T @ A))
對 ,程式印出 、、,以及三個非零元素。這個 矩陣的奇異值是 與 ,因此 、。
特殊的矩陣與向量
白話版。有些矩陣比其他矩陣好處理得多。學會辨認它們,可以省下計算量,也能理解許多設計選擇。
- 對角矩陣 只有主對角線上有非零元素。乘上它等於把每個座標分別縮放:。當每個 時,它的反矩陣是 。正規化層中逐通道的縮放,其實就是對角矩陣。長方形的對角矩陣也存在,會出現在 SVD 中。
- 對稱矩陣滿足 。共變異數矩陣、Gram 矩陣 、平滑函數的 Hessian 與距離矩陣都是對稱的。
- 單位向量滿足 。若 ,兩向量正交;若它們同時也是單位向量,就是單範正交(orthonormal)。
- 正交矩陣 是各列、各行皆單範正交的方陣,因此 且 ——反矩陣不花成本。它保持長度與角度不變,,幾何上是旋轉、鏡射或兩者的組合。
若 有 個單範正交的行,則 ,但 。矩陣 是投影到 各行生成空間的正交投影。投影 是該子空間中離 最近的點,殘差 與 的每一行都垂直。投影兩次不會再改變任何東西:。下面的 PCA 正是在尋找最好的這種 。
特徵分解
白話版。實特徵向量變換後仍在同一直線上;特徵值決定縮放,也可能反轉方向。
方陣 的特徵向量是滿足
的非零向量 ,純量 是對應的特徵值。若 是特徵向量,任何 的 也是,所以通常把特徵向量正規化成單位長度。
假設 有 個線性獨立的特徵向量 ,特徵值為 。把特徵向量當成 的各行,把特徵值放進 ,就有 ,因此
這就是特徵分解。它的意思是:先換到特徵向量座標(),每個座標各自縮放(),再換回來()。不是每個矩陣都有特徵分解。剪切矩陣 只有一個獨立的特徵向量;旋轉 的矩陣特徵值是 ,是複數,因為沒有任何實數方向能保持不轉。
對稱的情形
對稱矩陣是好相處的情形,也是機器學習最常遇到的。譜定理指出,每個實對稱矩陣都可以寫成
其中 是正交矩陣(各行是單範正交的特徵向量), 是實數對角矩陣 [3], [4]。因為 ,完全不需要求反矩陣。幾何上, 沿著方向 ( 的第 行)把空間拉伸 倍。除了特徵值的排列順序,以及重複特徵值內部基底的選擇之外,這個分解是唯一的;慣例上把特徵值由大到小排列。
對對稱的 ,把二次型 限制在單位向量上,其值被最大與最小特徵值夾住:
最大值出現在最大特徵值的特徵向量,最小值出現在最小特徵值的特徵向量。比值 稱為 Rayleigh 商。這個事實是後面 PCA 推導的引擎。
正定矩陣
特徵值的正負號可以為對稱矩陣分類:
| 名稱 | 特徵值 | 等價條件 |
|---|---|---|
| 正定(PD) | 全部 | 對所有 , |
| 半正定(PSD) | 全部 | 對所有 , |
| 負定(半負定) | 全部 (或 ) | 不等式反向 |
| 不定 | 正負都有 | 正負皆可能 |
每個共變異數矩陣與每個 Gram 矩陣 都是半正定的,因為 。高斯密度需要正定的共變異數矩陣才能求反。損失函數的 Hessian 在嚴格局部最小值處是正定的,在鞍點處則是不定的;ML 01C 會用這一點解釋最佳化為什麼可能很慢。正定矩陣有 Cholesky 分解 ( 為下三角矩陣),這是用它解方程組、以及從高斯分佈抽樣最快又穩定的方式 [4]。
程式碼 · Python · 17 行
import numpy as np

rng = np.random.default_rng(1)
M = rng.normal(size=(4, 4))
S = M @ M.T + 0.1 * np.eye(4)        # symmetric positive definite
lam, Q = np.linalg.eigh(S)           # ascending eigenvalues, orthonormal Q
assert np.allclose(Q @ np.diag(lam) @ Q.T, S)
assert np.allclose(Q.T @ Q, np.eye(4))
print("eigenvalues:", lam.round(3), "all positive:", bool((lam > 0).all()))

# The quadratic form x^T S x is bounded by the extreme eigenvalues
x = rng.normal(size=4); x /= np.linalg.norm(x)
print("Rayleigh quotient in range:", lam[0] <= x @ S @ x <= lam[-1])

# A non-symmetric matrix can have complex eigenvalues
R = np.array([[0.0, -1.0], [1.0, 0.0]])  # 90-degree rotation
print("rotation eigenvalues:", np.linalg.eigvals(R))
對稱矩陣請用 np.linalg.eigh:它比較快,回傳由小到大排列的實數特徵值與單範正交的特徵向量。np.linalg.eig 處理一般情形,可能回傳複數,如旋轉矩陣所示。
奇異值分解
白話版。SVD 把實矩陣分解成正交座標變換與逐軸縮放;座標變換也可能包含鏡射。
特徵分解需要方陣,而且不一定存在。奇異值分解(singular value decomposition, SVD)則對每個實矩陣 都存在:
- 是正交矩陣,各行是左奇異向量,屬於輸出空間的方向。
- 是長方形對角矩陣,對角元素 是奇異值。
- 是正交矩陣,各行是右奇異向量,屬於輸入空間的方向。
由右往左讀, 先把 表示成 座標(旋轉或鏡射),再把第 個座標乘上 ,最後沿著 的方向擺放。圖 1 以 矩陣示範:單位圓變成一個橢圓,半軸長分別是 與 。
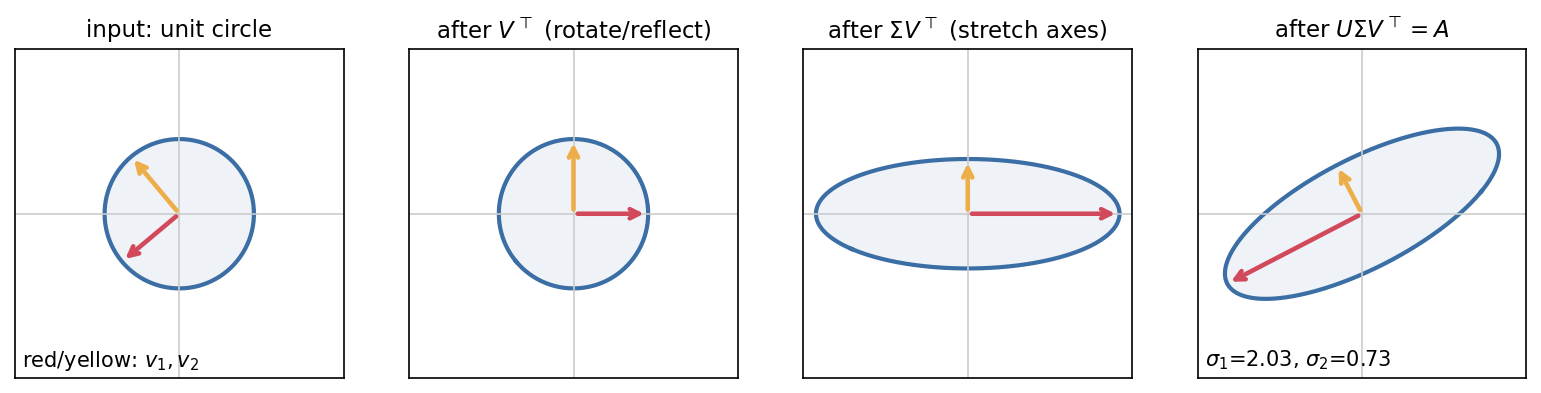
SVD 與特徵分解關係密切。由於 且 ,右奇異向量是 的特徵向量,左奇異向量是 的特徵向量,而 。對於對稱半正定矩陣,SVD 與特徵分解一致。
非零奇異值的個數等於秩 。只保留它們,就得到精簡(thin)SVD:,也就是 個秩一矩陣的總和——又是矩陣乘法的外積觀點。
最佳低秩近似
把這個總和截斷在第 項,得到 。Eckart–Young 定理 [6] 指出, 是 在 Frobenius 範數下的最佳秩 近似:
同一個 在譜範數下也是最佳的,誤差為 [4]。換句話說:丟掉最小的那些奇異值,損失的能量剛好就是丟掉的部分。儲存 只需要 個數字,而不是 個。
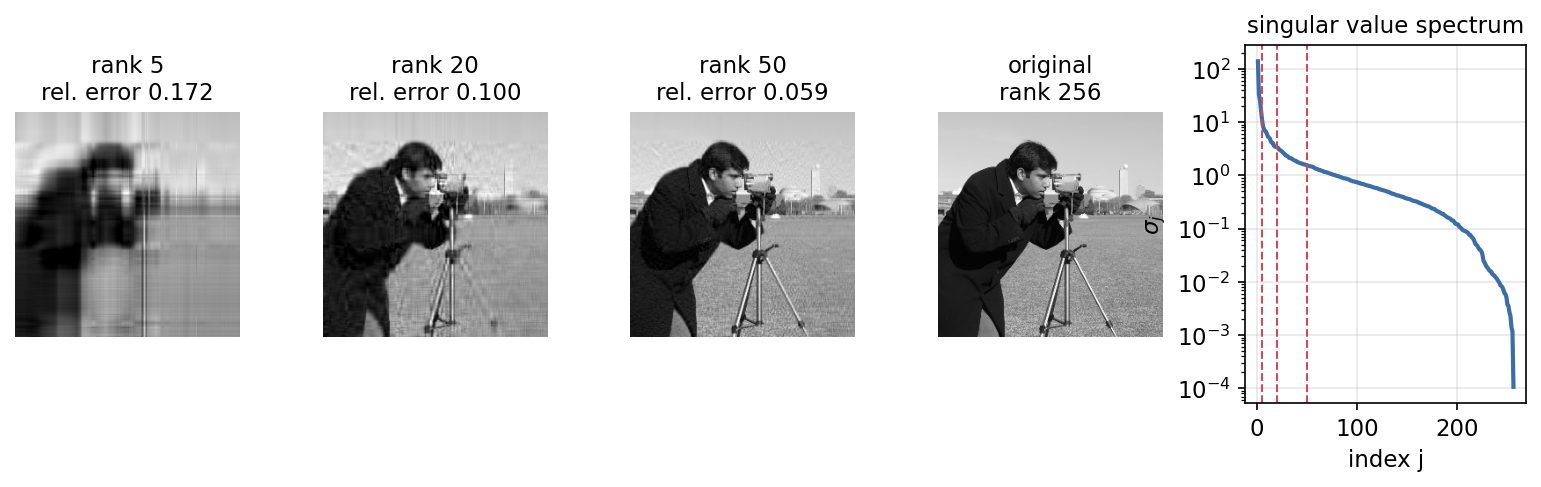
圖 2 把這套方法用在一張 的灰階照片上。自然影像的奇異值衰減得很快,所以秩 50 的近似已經保留了主要結構。低秩時的條紋狀瑕疵,來自每個秩一項都是一個行樣式與一個列樣式的外積。
程式碼 · Python · 16 行
import numpy as np

rng = np.random.default_rng(0)
A = rng.normal(size=(12, 8))
U, s, Vt = np.linalg.svd(A, full_matrices=False)
assert np.allclose(U @ np.diag(s) @ Vt, A)
k = 3
Ak = (U[:, :k] * s[:k]) @ Vt[:k]
err_F = np.linalg.norm(A - Ak, "fro")**2
err_2 = np.linalg.norm(A - Ak, 2)
assert np.isclose(err_F, (s[k:]**2).sum()) and np.isclose(err_2, s[k])
print("rank-k squared Frobenius error:", round(err_F, 3))
print("rank-k spectral error = sigma_{k+1}:", round(err_2, 3), round(s[k], 3))
# Eigenvalues of A^T A are squared singular values of A
assert np.allclose(np.sort(np.linalg.eigvalsh(A.T @ A))[::-1], s**2)
print("storage: full", A.size, "numbers; rank-3 factors", k * (12 + 8 + 1))
full_matrices=False 回傳精簡 SVD,這幾乎總是你要的。(U[:, :k] * s[:k]) 用廣播縮放 的各行,不必建立對角矩陣。兩條 Eckart–Young 等式都在機器精確度內成立。
一個提醒:奇異值最大的方向承載最多能量,卻不一定承載最有用的資訊。對分類而言,變異數小的方向可能正是把類別分開的那個方向。PR 05 正是為此比較了 PCA 與判別式方法。
Moore–Penrose 偽反矩陣
白話版。矩陣沒有反矩陣時,偽反矩陣給出次佳的答案:盡可能貼近資料的解,而在同樣好的解之中,選最小的那一個。
只有滿秩方陣才有反矩陣。對任意 ,Moore–Penrose 偽反矩陣(pseudo-inverse) 是唯一滿足以下四個 Penrose 條件的矩陣 [7]:
用 SVD 計算最容易。若 ,則
其中 是把 轉置、並把每個非零奇異值 換成 (零維持為零)。Goodfellow 等人給出等價的極限形式 [1],這已經暗示了嶺迴歸。
在秩的表格的每一種情況下,偽反矩陣都給出正確答案:
- 高瘦、行滿秩()。 通常沒有精確解。此時 是最小平方解:它使 最小。
- 矮胖、列滿秩()。解有無限多個。此時 是 最小的解,稱為最小範數解。其他任何解都多加了一個零空間向量,只會讓範數變大。
- 秩不足。 同時兼具兩者:在所有最小平方解之中,範數最小的那一個。
最小範數性質是通往一個現代問題的小窗口。對欠定的最小平方問題從零開始做梯度下降,會收斂到最小範數解,因為每個梯度 都落在 的列空間中。過參數化的網路不是線性的,但思考「在眾多完美擬合中,訓練演算法會選哪一個」時,這個簡單情形通常是起點。
最小平方、正規方程式與條件數
對迴歸設計矩陣 與目標 ,最小平方法最小化 。令梯度為零,得到正規方程式
它們是對的,但在數值上有風險。線性問題的敏感度用條件數 量測。粗略地說,資料中的相對誤差在解中最多可能被放大 倍 [5]。形成 會把條件數平方:,於是輕微病態的問題變成嚴重病態。程式庫的最小平方求解器(np.linalg.lstsq、torch.linalg.lstsq)直接對 做 QR 或 SVD 分解,避免了這個平方 [4]。
當兩個特徵幾乎相同時, 非常小,即使預測沒問題,個別係數也會極度敏感。嶺迴歸(ridge regression)[8] 加上懲罰項 ,:
右邊的 SVD 形式說明了嶺迴歸在做什麼。一般最小平方使用係數 ,在 很小時爆炸;嶺迴歸使用 ,上限是 。大 的方向幾乎不受影響,小 的方向被壓抑,代價是引入偏差。在神經網路中,同一個懲罰項稱為權重衰減(weight decay)。
程式碼 · Python · 28 行
import numpy as np

rng = np.random.default_rng(0)
# Over-determined: more equations than unknowns -> least squares
x = np.linspace(-1, 1, 40)
X = np.c_[np.ones_like(x), x]
y = 2 + 3*x + rng.normal(0, .05, len(x))
w, residuals, rank, sv = np.linalg.lstsq(X, y, rcond=None)
print("intercept and slope:", w.round(3), "rank:", rank)
assert np.allclose(w, np.linalg.pinv(X) @ y)

# Under-determined: fewer equations than unknowns -> minimum-norm solution
A = rng.normal(size=(2, 5)); b = rng.normal(size=2)
w_min = np.linalg.pinv(A) @ b
null = np.linalg.svd(A)[2][-1]             # a direction with A @ null = 0
w_other = w_min + 0.7 * null
print("both solve Aw=b:", np.allclose(A @ w_min, b), np.allclose(A @ w_other, b))
print("norms:", np.linalg.norm(w_min).round(3), "<", np.linalg.norm(w_other).round(3))

# Near-collinear features: condition number and ridge
z = rng.normal(size=200)
F = np.c_[z, z + 1e-4 * rng.normal(size=200)]
t = z + 0.01 * rng.normal(size=200)
print("cond(F) = %.1e, cond(F^T F) = %.1e" % (np.linalg.cond(F), np.linalg.cond(F.T @ F)))
w_ls = np.linalg.lstsq(F, t, rcond=None)[0]
lam = 1e-2
w_ridge = np.linalg.solve(F.T @ F + lam * np.eye(2), F.T @ t)
print("least squares:", w_ls.round(2), " ridge:", w_ridge.round(3))
直線擬合得到截距 、斜率 ,而 pinv 與 lstsq 結果一致。欠定系統有兩個精確解,偽反矩陣給的那一個範數較小(0.885 對 1.128)。在共線的例子中,,而 ,正好是它的平方。最小平方回傳誇張的係數 ,但兩者相加仍約為 1,所以預測沒有問題;嶺迴歸則回傳穩定的 。第一個例子中的截距行讓直線可以有非零偏移。在實際流程中,置中與縮放只能在訓練集上擬合,再原封不動套用到驗證與測試資料。
跡運算子
白話版。跡就是把對角線加起來。它看起來簡單到不值一提,卻能把麻煩的總和改寫成矩陣運算式,並讓你在式子裡搬動矩陣。
方陣的跡(trace)是
它有這些好用的性質:
- Frobenius 範數。。
- 轉置。。
- 循環性質。只要乘積有定義,,即使矩陣不是方陣、中間乘積形狀不同也成立。特別地,對 、,。可以循環,但不能任意重排:一般而言 。
- 純量。純量等於自己的跡,。這能把二次型變成跡:。
- 特徵值。。對共變異數矩陣而言,這就是總變異數,也就是沿每個主方向的變異數總和。
許多期望值就是用這個純量技巧算出來的。若隨機向量 的平均為零、共變異數為 ,則 ,因為跡與期望值都是線性的。
行列式
白話版。行列式絕對值表示體積縮放,正負表示定向;行列式為零代表方陣壓縮了維度,因而不可逆。
方陣的行列式 是一個數字,具有以下性質:
- ,即特徵值的乘積。
- 是 縮放體積的倍數:單位立方體被映射成體積為 的平行多面體。
- 正負號記錄方向(定向)。行列式為負表示 包含鏡射。
- 恰好表示 是奇異的:某個方向被壓成零,資訊遺失。
- 、、。
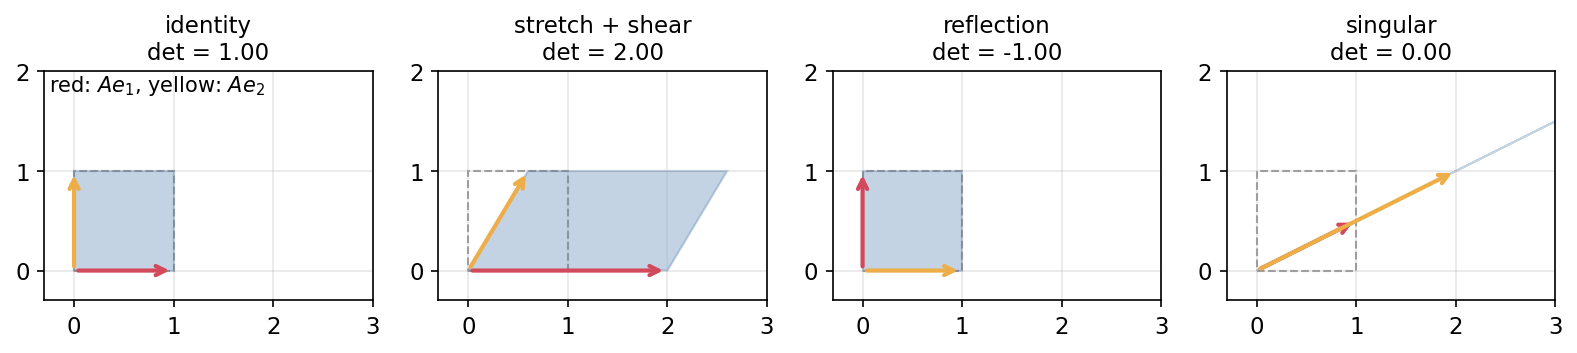
行列式在機器學習中主要出現在兩個地方。多變量高斯密度中有 ,是共變異數的體積正規化;ML 01B 會用到它。正規化流(normalizing flow,見 ML 07)需要 Jacobian 矩陣 的 ,來記錄可逆網路如何拉伸機率質量。這兩種情況都需要對數,絕不要直接算原始值:一個對角元素皆為 的 對角矩陣,行列式是 ,在 float64 中會下溢成零。
程式碼 · Python · 19 行
import numpy as np

rng = np.random.default_rng(2)
A, B, C = rng.normal(size=(3, 4)), rng.normal(size=(4, 5)), rng.normal(size=(5, 3))
print("cyclic trace:", np.isclose(np.trace(A @ B @ C), np.trace(C @ A @ B)),
      np.isclose(np.trace(A @ B @ C), np.trace(B @ C @ A)))

S = rng.normal(size=(4, 4))
lam = np.linalg.eigvals(S)
print("trace = sum of eigenvalues:", np.isclose(np.trace(S), lam.sum().real))
print("det = product of eigenvalues:", np.isclose(np.linalg.det(S), np.prod(lam).real))

# log-determinant of a covariance without overflow/underflow
Sigma = np.diag(np.full(500, 1e-3))
print("det underflows:", np.linalg.det(Sigma))
sign, logdet = np.linalg.slogdet(Sigma)
print("slogdet:", sign, round(logdet, 2))
L = np.linalg.cholesky(Sigma)
print("via Cholesky:", round(2 * np.log(np.diag(L)).sum(), 2))
直接計算行列式印出 0.0,而 slogdet 與 Cholesky 兩種做法都得到 。對正定矩陣,若 ,則 ,所以 。
實例:推導主成分分析
白話版。PCA 要找出資料點雲最貼近的那個平坦子空間。把資料投影上去,每個點就能壓縮成少數幾個數字,同時損失最少。
PCA 可追溯到 Pearson 的「最貼近點集的直線與平面」[9] 與 Hotelling 對「主成分」的分析 [10];Jolliffe 與 Cadima 提供了現代的綜述 [11]。我們依照 [1] 的方式,只用上面介紹的工具來推導。
設定。有 個點 ,想讓每個點只用 個數字儲存。先從每個點減去平均 ,因此可以假設資料已置中。把置中後的點當作 的各列。
步驟 1:選定編碼的形式。使用線性解碼器 ,。為了讓問題良好設定,要求 的各行單範正交:。(否則可以無止境地縮小 、放大 。)
步驟 2:固定解碼器,找最佳編碼。對給定的 ,選擇 使重建誤差最小:
我們展開平方、丟掉與 無關的 ,並使用 。對 的梯度是 ,令其為零就得到編碼器
所以編碼就是一次矩陣–向量乘法,而重建 正是 到 生成空間的正交投影。
步驟 3:找最佳解碼器。現在選擇 ,使所有點的總重建誤差最小:
先看 ,此時 是單一單位向量 。把 Frobenius 範數寫成跡並展開:
第二項與第三項用循環性質把 移到最前面,最後一行用 化簡。第一項與 無關,所以最小化誤差等同於
這是對稱半正定矩陣 的 Rayleigh 商。由特徵分解一節可知,它在 最大特徵值對應的特徵向量處達到最大。
步驟 4:多個主成分。對一般的 重複這個論證(例如用歸納法,要求每個新方向與先前的方向正交),答案是: 的各行是 前 大特徵值對應的特徵向量 [1]。最小誤差等於被捨棄的特徵值總和。
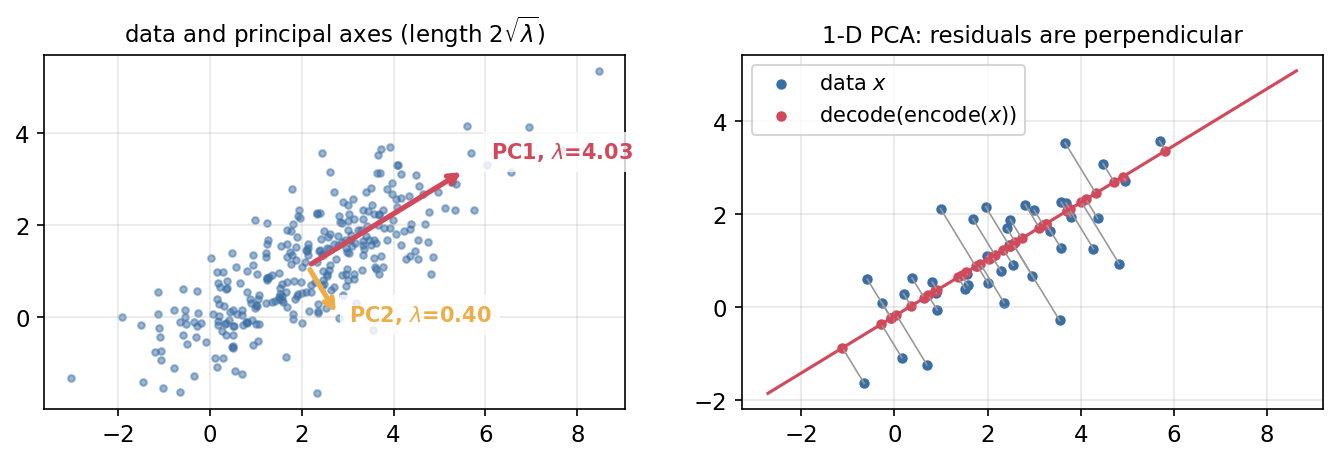
步驟 5:變異數觀點與 SVD 的連結。把 除以 ,得到樣本共變異數 (有些教科書用 )。 是投影後資料 的變異數。所以「最小化重建誤差」與「最大化保留的變異數」選出的是同樣的方向——Pearson 與 Hotelling 的觀點一致。最後,若置中資料矩陣的精簡 SVD 為 ,則 :主方向就是右奇異向量 ,特徵值是 ,編碼是 。實務上 PCA 是用 的 SVD 計算,而不是先形成共變異數矩陣,理由與最小平方法中的條件數相同。
程式碼 · Python · 26 行
import numpy as np

rng = np.random.default_rng(0)
n, d, l = 500, 5, 2
Z = rng.normal(size=(n, l))
X = Z @ rng.normal(size=(l, d)) + 0.1 * rng.normal(size=(n, d)) + 3.0

mu = X.mean(axis=0)
Xc = X - mu                                  # centre first
S = Xc.T @ Xc / n                            # sample covariance (d x d)
lam, Q = np.linalg.eigh(S)
lam, Q = lam[::-1], Q[:, ::-1]               # descending
D = Q[:, :l]                                 # decoder matrix, orthonormal columns

codes = Xc @ D                               # encode: f(x) = D^T (x - mu)
X_hat = codes @ D.T + mu                     # decode: g(c) = D c + mu
mse = np.mean(np.sum((X - X_hat)**2, axis=1))
print("explained variance ratio:", (lam[:l].sum() / lam.sum()).round(4))
print("reconstruction MSE:", mse.round(5), " sum of discarded eigenvalues:", lam[l:].sum().round(5))
assert np.isclose(mse, lam[l:].sum())

# Same subspace from the SVD of the centred data matrix
U, s, Vt = np.linalg.svd(Xc, full_matrices=False)
assert np.allclose(s[:l]**2 / n, lam[:l])
assert np.allclose(np.abs(Vt[:l] @ D), np.eye(l), atol=1e-8)
print("SVD and eigendecomposition agree")
這份合成資料是五維的點,實際上落在一個二維平面附近,再加上小雜訊。兩個主成分解釋了 99.36% 的變異數,而平均平方重建誤差剛好等於被捨棄的三個特徵值總和,與步驟 4 的預測一致。SVD 的做法找到同樣的方向(差一個正負號,特徵向量的正負號本來就是任意的)。
三個實務提醒。一定要先置中,否則第一個「主成分」只會指向平均值。若特徵的單位無法比較,要先標準化,因為 PCA 不具尺度不變性。平均與方向都只能在訓練資料上擬合。PCA 是自編碼器的線性祖先;ML 06A 會發展它的機率版本與非線性後繼者。
選讀:PCA(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
你會遇到的矩陣微積分
白話版。訓練就是沿著梯度走,而機器學習中的大多數梯度,都是少數幾條矩陣公式反覆使用。
對向量 的純量函數 ,梯度 收集所有偏導數 。對向量函數 ,Jacobian 矩陣 的元素為 。最常用的規則如下:
| 函數 | 梯度 | 備註 |
|---|---|---|
| 線性函數 | ||
| 對稱時為 | ||
| 最小平方損失 | ||
| 權重衰減 | ||
| 對 | 搭配上面的跡技巧 |
每一條都可以把運算式寫成對索引的總和、逐項微分來驗證 [2]。向量函數的連鎖律是把 Jacobian 相乘:若 ,而 是純量,則 。反向傳播逐層套用這條規則,把轉置的局部 Jacobian 乘上傳進來的梯度,而不必真的建出完整的 Jacobian(那會大得驚人)。ML 02 會詳細建構這個過程,ML 01C 則加入 Hessian,也就是二階導數矩陣。
令最小平方梯度為零,就回到前一節的正規方程式。這個損失的 Hessian 是 ,為半正定,所以損失是凸函數,每個駐點都是全域最小值。用有限差分快速檢查公式:
程式碼 · Python · 13 行
import numpy as np

rng = np.random.default_rng(3)
X, y = rng.normal(size=(30, 4)), rng.normal(size=30)
w = rng.normal(size=4)
L = lambda w: 0.5 * np.sum((X @ w - y)**2)
grad = X.T @ (X @ w - y)                    # analytic gradient
eps = 1e-6
num = np.array([(L(w + eps*e) - L(w - eps*e)) / (2*eps) for e in np.eye(4)])
print("max gradient mismatch:", np.abs(grad - num).max())
# Setting the gradient to zero gives the normal equations
w_star = np.linalg.lstsq(X, y, rcond=None)[0]
print("gradient at solution ~ 0:", np.abs(X.T @ (X @ w_star - y)).max() < 1e-10)
解析梯度與數值梯度相差約 ,正是有限差分捨入誤差預期的大小。
現代觀點
本篇的定義已有百年歷史,但它們在機器學習中的用法仍不斷改變。以下四條研究方向值得認識。
隨機化數值線性代數。大型矩陣的精確 SVD 很昂貴,大約需要 次運算。Halko、Martinsson 與 Tropp 在 SIAM Review 的綜述 [12] 讓一個簡單的想法成為標準做法:用一個細長的隨機矩陣 乘上 ,「草描」出它的值域;把結果正交化得到基底 ;再對小矩陣 做精確 SVD。加上少量過取樣與幾次冪迭代,對奇異值會衰減的矩陣就能得到準確的結果。Martinsson 與 Tropp 在 Acta Numerica 的綜述 [13] 涵蓋理論與大量演算法:範數估計、隨機嵌入、迴歸、低秩近似、半正定矩陣的 Nyström 近似、串流演算法,以及機器學習中的核矩陣。Murray 等人 [14](LAPACK Working Note 299,2023)從軟體角度切入:他們指出 RandNLA 方法已進入 MATLAB、NAG Library、NVIDIA 的 cuSOLVER 與 scikit-learn,並主張建立標準的「RandBLAS」與「RandLAPACK」程式庫。scikit-learn 的隨機化 PCA 求解器就是直接的後代。核心演算法只要幾行:
程式碼 · Python · 21 行
import numpy as np

def randomized_svd(A, k, oversample=10, power_iters=2, seed=0):
    rng = np.random.default_rng(seed)
    Omega = rng.normal(size=(A.shape[1], k + oversample))  # random test matrix
    Y = A @ Omega                                          # sample the range of A
    for _ in range(power_iters):                           # sharpen a slow spectrum
        Y = A @ (A.T @ Y)
    Q, _ = np.linalg.qr(Y)                                 # orthonormal basis
    B = Q.T @ A                                            # small (k+p) x n matrix
    Ub, s, Vt = np.linalg.svd(B, full_matrices=False)
    return (Q @ Ub)[:, :k], s[:k], Vt[:k]

rng = np.random.default_rng(1)
m, n, r = 2000, 500, 20
A = rng.normal(size=(m, r)) @ rng.normal(size=(r, n)) + 0.01 * rng.normal(size=(m, n))
U, s, Vt = randomized_svd(A, k=r)
s_exact = np.linalg.svd(A, compute_uv=False)[:r]
print("max relative error in top singular values:", np.max(np.abs(s - s_exact) / s_exact))
rel = np.linalg.norm(A - (U * s) @ Vt) / np.linalg.norm(A)
print("relative reconstruction error:", round(rel, 5))
對這個近似秩 20 的矩陣,前 20 個奇異值與精確值的相對誤差約 ,而秩 20 重建的誤差(約 0.2%)由加入的雜訊決定。冪迭代是奇異值衰減緩慢時仍能成功的關鍵;若矩陣的奇異值完全平坦,任何秩 的方法——隨機或非隨機——都做不好。
大型模型中的低秩結構。矩陣乘法的外積觀點,已經成為調整大型網路的實用工具。LoRA [15] 凍結預訓練權重 ,只學習更新量 ,其中 、,且 。可訓練的數字只有 個,而不是 個;以 、 為例,每個矩陣是 65,536 個,而不是約 1,680 萬個。 初始化為零,所以訓練恰好從預訓練模型出發。GaLore [16](ICML 2024)則讓所有權重都可訓練,但把梯度投影到低秩子空間,以縮小最佳化器的記憶體用量;作者認為像 LoRA 那樣把權重更新本身限制在低秩子空間,可能不如全秩訓練。兩者都依賴 Eckart–Young 的直覺:矩陣中有用的內容大多集中在少數幾個奇異方向。這在特定任務上是否成立,是實證問題,不是定理。
控制譜範數。網路對輸入擾動的敏感度,上限是各層譜範數的乘積(在 ReLU 這類 1-Lipschitz 激勵函數下)。譜正規化(spectral normalization)[17] 把每個權重矩陣除以最大奇異值的估計值,而這個估計在每個訓練步驟只需一次冪迭代,成本很低。它原本是為了穩定 GAN 的判別器而提出(見 ML 07),凡是需要 Lipschitz 上界的地方都能看到同樣的想法。
超越矩陣。卷積核與影片特徵天生就是三軸以上的張量。Kolda 與 Bader 在 SIAM Review 的綜述 [18] 是張量分解的標準入門,涵蓋 CP 分解(秩一張量的總和,推廣了外積觀點)與 Tucker 分解(一個小的核心張量沿每個模態乘上一個矩陣,推廣了 SVD)。與矩陣不同,張量的秩一般而言很難計算,最佳低秩近似也不一定存在,Eckart–Young 那幅清楚的圖像無法直接沿用。這些分解被用來壓縮網路層,以及分析多向資料。
開放問題。為什麼訓練後的權重矩陣常有快速衰減的奇異值?這和泛化有什麼關係?調整用的秩可以多低才不損失品質?這取決於任務還是模型?隨機化演算法要如何與低精度硬體結合——那裡的捨入誤差遠大於 float64?這些問題都還沒有定論,而本篇的工具正是閱讀相關論文所需要的。若想找把線性代數與深度學習連起來的完整教科書,可參考 [1]、[2] 與 [19]。
重點整理
- 矩陣相乘或陣列廣播前,先說明各軸意義並檢查形狀。
- 秩與零空間限制可能的解;解線性系統時,使用求解器而非顯式計算反矩陣。
- 實對稱矩陣具有正交規一特徵基底;特徵值正負描述其二次型。
- 截斷 SVD 在譜範數或 Frobenius 誤差下給出最佳低秩近似。
- 偽反矩陣選出最小範數的最小平方解,小奇異值可能放大雜訊。
- 對置中資料,在固定子空間維度下,PCA 最大化保留變異並最小化平方重建誤差。
練習
- 形狀與偏差。一個批次形狀為 ,權重矩陣形狀為 。偏差應該是什麼形狀?若改用形狀 的偏差,會出什麼問題?
提示
形狀 的偏差會沿 32 列廣播:每個輸出單元一個偏移量,由所有樣本共用。 的偏差則沿 10 行廣播,變成每個樣本一個偏移量。程式照樣能跑,但「偏差」現在取決於樣本在批次中的位置,這沒有意義,而且會隨批次大小改變。
- 投影。設 的各行單範正交,。證明 、,且 與 的每一行正交。 的特徵值是什麼?
提示
。正交性:計算 。由 ,任何特徵值滿足 ,所以 :特徵值 1 的重數為 (子空間本身),0 的重數為 (它的正交補空間)。因此 。
- 手算 SVD。透過計算 的特徵值,求 的奇異值。驗證 以及 。
提示
的特徵值是 與 ,所以 、。於是 ,且 。一般而言,方陣的 ,因為 。
- 條件數與嶺迴歸。從最小平方的程式碼出發,把第二個特徵換成第一個特徵的完全複本。
np.linalg.lstsq會回傳什麼?為什麼它是最小範數解?接著推導嶺迴歸解的 SVD 形式,並證明每個係數 最多是 。
提示
兩行完全相同時秩為 1,解集合是一條直線 。lstsq 使用 SVD,回傳偽反矩陣解,也就是平分權重 ,因為直線上離原點最近的就是這一點。至於上界,最大化 : 發生在 ,此時 。
- PCA 的誤差。利用本篇的推導,證明 個主成分的 PCA 總重建誤差等於 ,而保留的變異數比例是 。接著對
sklearn.datasets.load_digits()做 PCA,找出保留 90% 變異數所需的最小 。
提示
寫成 (使用 與循環性質)。當 是前 個特徵向量時,第二個跡等於 ,而 。手寫數字資料:把 的矩陣置中,計算奇異值,再對 取累積和。請回報你自己算出的數字,不要相信別人引用的數字。
- 行列式與體積。某個 矩陣把單位正方形映射成頂點為 、、、 的平行四邊形。寫出這樣的矩陣,計算它的行列式,並說明為什麼正規化流必須記錄每一層的 。
提示
把兩條邊向量放進各行:,,所以面積放大 5 倍。若一個映射把體積放大 5 倍,機率密度就必須縮小同樣倍數,總機率才能維持為 1。疊加多層時這些倍數相乘,取對數後變成相加,這就是正規化流逐層加總對數行列式的原因。
參考文獻
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 2 “Linear Algebra”. Book
- M. P. Deisenroth, A. A. Faisal and C. S. Ong, Mathematics for Machine Learning, Cambridge University Press, 2020. Book
- G. Strang, Introduction to Linear Algebra, 6th ed., Wellesley-Cambridge Press, 2023. Book site
- G. H. Golub and C. F. Van Loan, Matrix Computations, 4th ed., Johns Hopkins University Press, 2013. DOI
- L. N. Trefethen and D. Bau III, Numerical Linear Algebra, SIAM, 1997. DOI
- C. Eckart and G. Young, “The Approximation of One Matrix by Another of Lower Rank,” Psychometrika, vol. 1, pp. 211–218, 1936. DOI
- R. Penrose, “A Generalized Inverse for Matrices,” Mathematical Proceedings of the Cambridge Philosophical Society, vol. 51, pp. 406–413, 1955. DOI
- A. E. Hoerl and R. W. Kennard, “Ridge Regression: Biased Estimation for Nonorthogonal Problems,” Technometrics, vol. 12, pp. 55–67, 1970. DOI
- K. Pearson, “On Lines and Planes of Closest Fit to Systems of Points in Space,” The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, vol. 2, pp. 559–572, 1901. DOI
- H. Hotelling, “Analysis of a Complex of Statistical Variables into Principal Components,” Journal of Educational Psychology, vol. 24, pp. 417–441, 1933. DOI
- I. T. Jolliffe and J. Cadima, “Principal Component Analysis: A Review and Recent Developments,” Philosophical Transactions of the Royal Society A, vol. 374, 20150202, 2016. DOI
- N. Halko, P.-G. Martinsson and J. A. Tropp, “Finding Structure with Randomness: Probabilistic Algorithms for Constructing Approximate Matrix Decompositions,” SIAM Review, vol. 53, no. 2, pp. 217–288, 2011. DOI · arXiv
- P.-G. Martinsson and J. A. Tropp, “Randomized Numerical Linear Algebra: Foundations and Algorithms,” Acta Numerica, vol. 29, pp. 403–572, 2020. DOI · arXiv
- R. Murray, J. Demmel, M. W. Mahoney, N. B. Erichson, M. Melnichenko, O. A. Malik, L. Grigori, P. Luszczek, M. Dereziński, M. E. Lopes, T. Liang, H. Luo and J. Dongarra, “Randomized Numerical Linear Algebra: A Perspective on the Field With an Eye to Software,” LAPACK Working Note 299, 2023. arXiv
- E. J. Hu, Y. Shen, P. Wallis, Z. Allen-Zhu, Y. Li, S. Wang, L. Wang and W. Chen, “LoRA: Low-Rank Adaptation of Large Language Models,” in Proc. International Conference on Learning Representations (ICLR), 2022. arXiv
- J. Zhao, Z. Zhang, B. Chen, Z. Wang, A. Anandkumar and Y. Tian, “GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection,” ICML, 2024. arXiv
- T. Miyato, T. Kataoka, M. Koyama and Y. Yoshida, “Spectral Normalization for Generative Adversarial Networks,” ICLR, 2018. arXiv
- T. G. Kolda and B. W. Bader, “Tensor Decompositions and Applications,” SIAM Review, vol. 51, no. 3, pp. 455–500, 2009. DOI
- C. M. Bishop and H. Bishop, Deep Learning: Foundations and Concepts, Springer, 2024. Book
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 01B・機率與資訊理論 · 24 分鐘