PR 05・特徵選擇、轉換與降維
先備知識:PR 04・近鄰、核與非線性分類器
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
圖形識別
你將學到
- 為什麼較少但較好的特徵常常勝過更多特徵,以及特徵選擇、特徵萃取與特徵學習的差別。
- 過濾式、包裝式與嵌入式選擇,以及最常見的錯誤:在交叉驗證之外選特徵。
- 如何為特徵與特徵子集評分:Fisher 比值、散佈矩陣準則、Bhattacharyya 距離與互資訊。
- 線性萃取:PCA(含白化)與 Fisher 線性判別分析的推導與比較。
- 非線性與非高斯的萃取:核 PCA、ICA(與 NMF),以及以 Isomap、LLE、t-SNE、UMAP 進行的流形學習,包括它們的圖能證明什麼、不能證明什麼。
- 經典的人工設計影像與訊號描述子,以及這一切在 2026 年的位置。
先看全貌
兩個辨識系統可以使用完全相同的分類器,行為卻大不相同,因為它們描述輸入的方式不同。紋理直方圖丟掉了「東西在哪裡」;形狀描述子可能忽略顏色;從網路照片學來的嵌入(embedding)可能悄悄編碼了背景。每一種表徵都保留部分變異、捨棄其餘部分,而分類器只能使用被保留的部分。
本章談的就是如何建立這種簡短而有用的描述。有三種做法:
- 選擇保留原始量測的一個子集,例如從 5,000 個基因表現量中保留 20 個。保留的特徵仍然可以解釋。
- 萃取以所有量測的函數計算出新座標,例如投影到前幾個主成分。
- 學習從資料估計萃取規則,常用深度網路(ML 06)。PCA 本身就已是(非常簡單的)學習得到的萃取規則;這幾類是互相重疊的。
如果彈性很大的分類器可以使用全部特徵,為什麼還要費事?有三個理由。在訓練樣本數固定時,加入資訊量很弱的特徵可能讓訓練出的分類器變差,因為每多一維就多了要估計的參數與過擬合的空間:這就是 Theodoridis 與 Koutroumbas 所討論的「維度詛咒」與峰值現象(peaking phenomenon)[1]。特徵越少,量測、儲存與計算越便宜。而且一組小而有意義的特徵,能幫助人理解分類器依賴的是什麼。Guyon 與 Elisseeff 在特徵選擇的經典導論中列出的也是這三個動機 [3]。本章的教科書背景是 Theodoridis 與 Koutroumbas 第 5–7 章 [1],以及 Bishop 第 4.1.4–4.1.6 與 12.1–12.4 節 [2]。人工設計的影像特徵另請參考 IP 12。
特徵選擇
白話版。 特徵選擇問的是:在已有的量測中,我該保留哪些?你需要一種為特徵(或特徵組合)評分的方法,以及一種搜尋方法,因為不可能把每個子集都試一遍。
個特徵共有 個非空子集: 時約為 個。除了極小的 ,窮舉搜尋都不可行。各種方法的差別在於如何評分與如何搜尋 [3], [22], [23]。
過濾式方法
過濾式(filter)方法直接由資料計算某個準則,為每個特徵(或子集)評分,與最終的分類器無關,再保留最好的。典型的準則包括變異數(剔除近乎常數的特徵)、類別分離統計量(例如 ANOVA 統計量或下一節的 Fisher 比值)、與標籤的相關係數,以及互資訊(mutual information)
其中 是第 個特徵(離散化為數值 ), 是取值為 的類別標籤,、 是由訓練集估計的聯合與邊際機率。 若且唯若該特徵與標籤在統計上獨立。
過濾式方法快速,且與分類器無關,但單變量過濾有兩個盲點。冗餘:同一個好特徵的兩份複本都會得高分,但第二份毫無貢獻。Peng、Long 與 Ding 的 mRMR 準則處理這個問題:獎勵與標籤的相關性,同時懲罰與已選特徵之間的互資訊 [6]。交互作用:兩個特徵可能各自毫無用處、合在一起卻具決定性。在互斥或(XOR)型態 中,每個特徵單獨看都和 獨立,所以任何單變量過濾都會把兩者都丟掉。
包裝式方法
包裝式(wrapper)方法以實際的分類器在候選子集上訓練,並以驗證表現作為該子集的分數 [4]。由於窮舉不可行,包裝式方法使用啟發式搜尋,例如:
- 循序前向選擇:從空集合開始,每次加入最能提升驗證分數的特徵;
- 循序後向刪除:從全部特徵開始,每次移除最沒用的一個;
- 允許撤回先前步驟的浮動(floating)變體 [1]。
包裝式方法透過分類器的眼睛看見交互作用與冗餘,但成本高(每個候選都要完整訓練一次),而且因為它在同一份驗證資料上嘗試許多子集,可能會對驗證集本身過擬合。提出這個名詞的 Kohavi 與 John 論文,至今仍是討論這些取捨的標準參考 [4]。
嵌入式方法
嵌入式(embedded)方法在訓練過程中順帶完成特徵選擇。最有名的例子是 lasso,它在線性模型上加入 懲罰 [5]:
其中 為目標值, 為輸入, 為懲罰強度。 球的尖角會讓 的許多座標恰好為零,存活下來的座標就是被選中的特徵。同樣的想法也適用於分類用的邏輯斯迴歸。決策樹及其集成(PR 04、PR 09)也內建選擇:從未幫上任何切分的特徵就不會被使用。
選擇偏差的陷阱
監督式選擇會用到標籤。如果你先在完整資料集上選特徵,再只對分類器做交叉驗證,那麼保留的測試摺早已影響了選出哪些特徵,誤差估計就會過於樂觀。Ambroise 與 McLachlan 指出,這個錯誤讓已發表的基因表現分類器看起來近乎完美;把選擇放進每個交叉驗證摺內執行後,誤差就不再是零 [7]。下面的程式用純雜訊特徵把這個效應具體呈現出來。
程式碼 · Python · 20 行
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline

rng = np.random.default_rng(0)
X = rng.normal(size=(60, 5000))          # 60 samples, 5000 pure-noise features
y = rng.integers(0, 2, size=60)          # labels unrelated to X

# Wrong: select on all data, then cross-validate the classifier only.
X_sel = SelectKBest(f_classif, k=20).fit_transform(X, y)
wrong = cross_val_score(LogisticRegression(max_iter=1000), X_sel, y, cv=5)

# Right: selection is part of the model and is refitted in every fold.
model = make_pipeline(SelectKBest(f_classif, k=20),
                      LogisticRegression(max_iter=1000))
right = cross_val_score(model, X, y, cv=5)
print(f"selection outside CV: {wrong.mean():.2f}")
print(f"selection inside CV:  {right.mean():.2f}")
標籤是隨機的,所以沒有任何方法真正能超過 50% 的準確率。在交叉驗證之外做選擇,回報的是 0.98;把選擇器放進 pipeline,回報 0.58,扣掉 60 個樣本估計的雜訊後就是隨機水準。這個規則可以推廣:每一個會看標籤的步驟(特徵選擇、LDA 這類監督式投影、決定保留幾個特徵)都屬於訓練程序的一部分。即使是 PCA 與標準化這類非監督步驟,也應該只在訓練摺上擬合,讓你評估的程序就是你要部署的程序。
評估特徵與特徵子集
白話版。 好的特徵會讓各類別彼此離得遠,相對於每個類別本身的分散程度而言。有好幾個公式把這個想法變成一個數字,從單一特徵的簡單比值,到整個子集的準則。
單一特徵的 Fisher 判別比值比較類別平均之間的分散與類別之內的分散:
其中 是類別 的比例, 與 是特徵 在類別 中的平均與變異數, 是整體平均 [1]。(兩類時,Theodoridis 與 Koutroumbas 寫成 ,概念相同。)
對特徵的子集,則使用散佈矩陣。令 為限制在該子集上的特徵向量,、 分別為類別平均與整體平均向量,
其中 是類別 的共變異數矩陣, 是類內散佈, 是類間散佈, 是跡。當類別平均相對於類內分散相距很遠(在真正重要的方向上量測)時, 就大 [1]。和把各特徵比值相加不同, 考慮了特徵之間的相關。
另外兩個準則來自機率。兩個高斯類別 與 之間的 Bhattacharyya 距離為
為行列式。第一項衡量平均的分離,第二項衡量共變異數的差異。在先驗相等時,它給出貝氏錯誤率的上界 [1]。前面介紹的、與標籤之間的互資訊,則是不依賴分布假設的對應版本。
下面的程式在 13 個特徵的葡萄酒(wine)資料上,比較單一特徵分數與子集準則。
程式碼 · Python · 30 行
import numpy as np
from sklearn.datasets import load_wine
from sklearn.preprocessing import StandardScaler

X, y = load_wine(return_X_y=True)
X = StandardScaler().fit_transform(X)
classes = np.unique(y)
mu = X.mean(axis=0)

# Per-feature Fisher ratio: between-class over within-class variance.
between = sum((y == c).mean() * (X[y == c].mean(0) - mu) ** 2 for c in classes)
within = sum((y == c).mean() * X[y == c].var(0) for c in classes)
fdr = between / within
print("top-3 features by Fisher ratio:", np.argsort(fdr)[::-1][:3],
      np.round(np.sort(fdr)[::-1][:3], 2))

def J(cols):  # scatter-matrix criterion trace(Sw^-1 Sb) on a feature subset
    Z = X[:, cols]
    m = Z.mean(0)
    Sw = sum((y == c).mean() * np.cov(Z[y == c].T, bias=True).reshape(len(cols), -1)
             for c in classes)
    Sb = sum((y == c).mean() * np.outer(Z[y == c].mean(0) - m, Z[y == c].mean(0) - m)
             for c in classes)
    return np.trace(np.linalg.solve(Sw, Sb))

top2 = list(np.argsort(fdr)[::-1][:2])
print("J(top-2 by ratio) =", round(J(top2), 2))
best_pair = max(((i, j) for i in range(13) for j in range(i + 1, 13)),
                key=lambda p: J(list(p)))
print("best pair by J:", best_pair, "J =", round(J(list(best_pair)), 2))
特徵 6、12、11 的個別比值最高(2.67、2.38、2.17)。然而依 選出的最佳配對是特徵 6 與 9(),而不是個別最好的前兩名():特徵 12 的資訊和特徵 6 重疊,特徵 9 則與它互補。這就是單變量過濾的冗餘問題,以數字呈現。
這些準則都只是代理指標。特徵集合的最終裁判,是整條流程在不洩漏資訊的情況下估計出的交叉驗證表現(PR 09)。
主成分分析
白話版。 PCA 旋轉座標系,讓第一個軸指向資料變化最大的方向,第二個軸指向剩餘變化最大的方向,依此類推。只保留前幾個軸,就得到最小平方意義下最好的低維摘要。它從不看標籤。
推導
設 的平均為 ,共變異數為 。資料投影到單位向量 上的變異數為 。在 的約束下以拉格朗日乘數 最大化它,得到
所以最佳方向是 的特徵向量,它捕捉到的變異數就是對應的特徵值 。第一主方向是特徵值最大的特徵向量;之後的主方向是其餘特徵向量,依特徵值遞減排列,且彼此正交 [2], [8], [9]。保留前 個方向也使重建誤差最小 [2]。本節共變異數除以 ,因此每個樣本的平均平方歐氏誤差為 。若改除以 ,才恰好等於被捨棄的特徵值總和;若要每個座標的平均,還需再除以 。比較誤差圖與特徵值前,先說清楚正規化方式。
實務上,PCA 以中心化資料矩陣 (第 列為 )的奇異值分解(SVD)來計算:
其中 與 的行向量正交歸一, 依遞減順序存放奇異值, 是 的前 行(主方向), 是分數(scores)。比值 是第 個成分的解釋變異比例。重建時計算 。
白化
白化(whitening)把每個分數縮放為單位變異數:
其中 是第 個成分上的分數, 是由訓練資料估計的該成分變異數, 是避免極小特徵值造成爆量的小常數。保留的成分若皆有 ,取 才得到單位共變異數;若 ,對角元素實際是 ,因此極小變異方向會被刻意壓低。零變異成分應捨棄,或使用正的 ,不能直接除以零。這讓所有方向一樣「大聲」,有助於某些演算法(下文的 ICA、-means、某些神經網路),但也會放大那些原本因為主要是雜訊而很小的方向。白化是一種建模選擇,不是免費的改進。
程式碼 · Python · 26 行
import numpy as np
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA

X, _ = load_digits(return_X_y=True)          # 1797 images of 8x8 = 64 pixels
Xc = X - X.mean(axis=0)
U, S, Vt = np.linalg.svd(Xc, full_matrices=False)
eigvals = S ** 2 / (len(X) - 1)               # variances along each direction
ratio = eigvals / eigvals.sum()
r = int(np.searchsorted(np.cumsum(ratio), 0.90) + 1)
print("components for 90% variance:", r)

Z = Xc @ Vt[:r].T                             # scores, N x r
X_hat = Z @ Vt[:r] + X.mean(axis=0)           # reconstruction
print("relative reconstruction error:",
      round(np.linalg.norm(X - X_hat) / np.linalg.norm(Xc), 3))

mse_per_sample = np.mean(np.sum((X - X_hat) ** 2, axis=1))
assert np.isclose(mse_per_sample, (len(X) - 1) / len(X) * eigvals[r:].sum())

pca = PCA(n_components=r).fit(X)
assert np.allclose(pca.explained_variance_, eigvals[:r])
assert np.allclose(np.abs(pca.components_), np.abs(Vt[:r]))   # equal up to sign
Zw = Z / np.sqrt(eigvals[:r])                 # whitened scores
print("whitened covariance is identity:",
      np.allclose(np.cov(Zw.T), np.eye(r)))
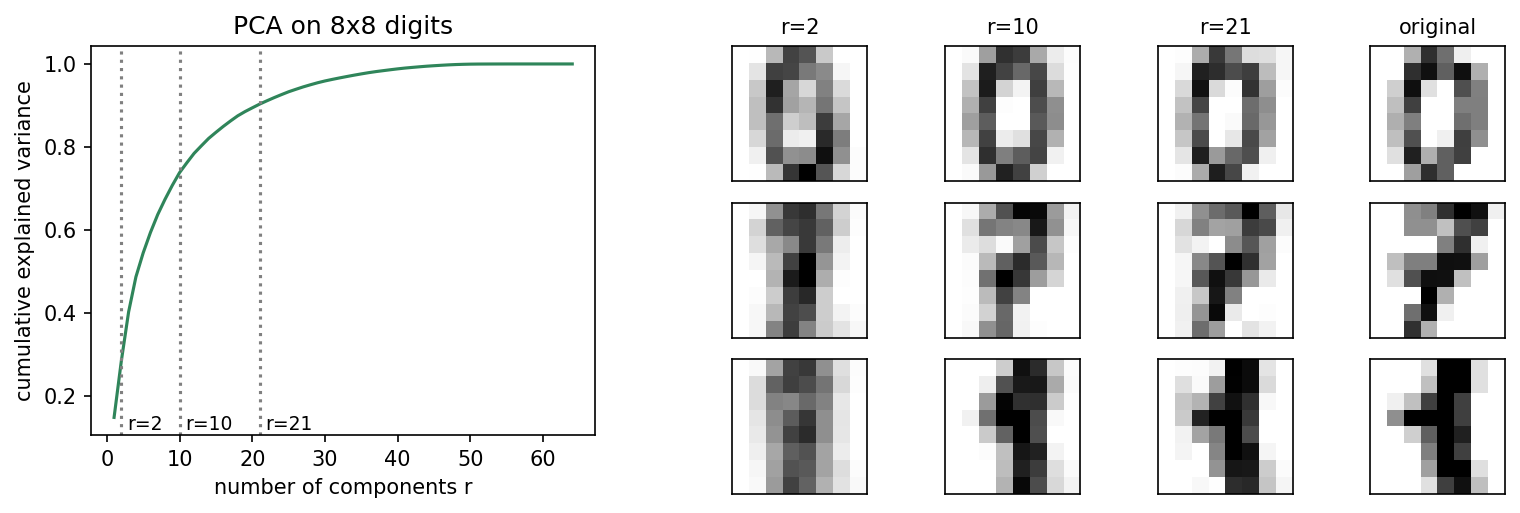
64 個像素維度中,有 21 維就包含了數字影像 90% 的變異,以它們重建的相對誤差為 0.31。手寫的 SVD 與 scikit-learn 的結果除了每個成分的正負號外完全一致(特徵向量的正負號是任意的)。圖 1 顯示累積曲線與重建結果。
變異不等於類別資訊
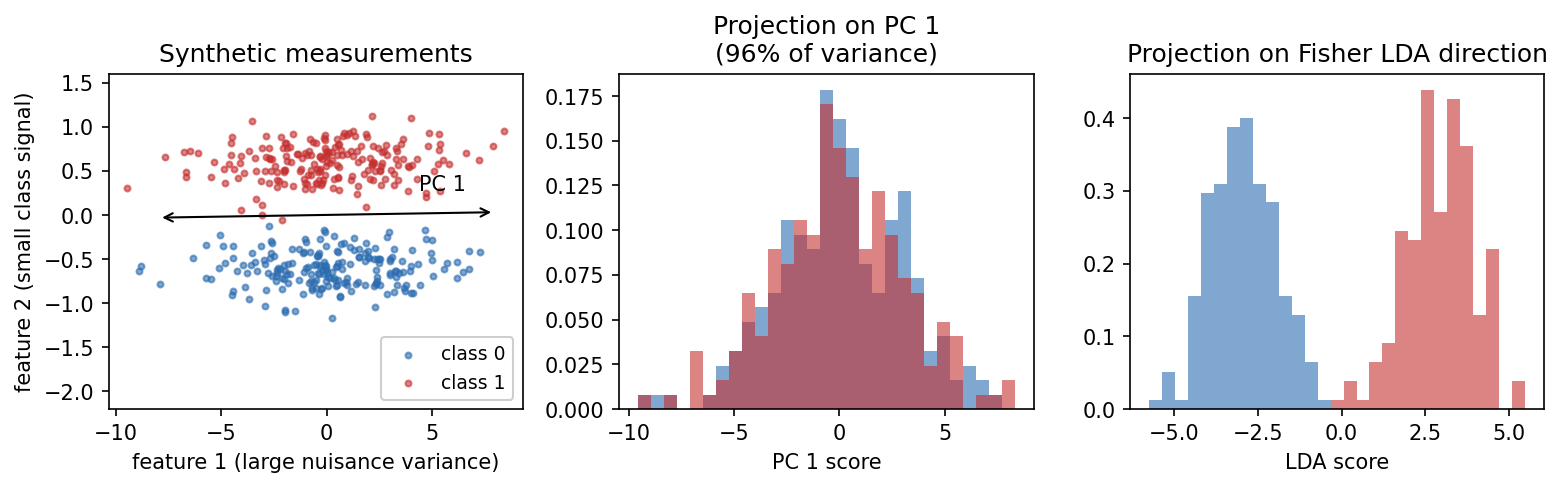
PCA 依變異數為方向排序,而變異數和對分類的用處並不相同。在圖 2 中,一個很大的干擾變異(想像成光照)主宰了第一主成分,而類別差異位在一個變異很小的方向。投影到 PC 1 保留了 96% 的變異,卻幾乎丟掉了全部的類別資訊。監督式投影(下一節的 Fisher LDA)則立刻找到有用的方向。
Jolliffe 與 Cadima 的綜述 [10] 說明了 PCA 能做與不能做的事,以及它的許多變體(例如稀疏 PCA 與穩健 PCA)。把 PCA 變成潛在變數模型的機率 PCA 與因素分析,在 Bishop 第 12 章 [2] 與 ML 06A 中有完整推導。
Fisher 線性判別分析
白話版。 LDA 尋找這樣的方向:在這些方向上,類別平均相距很遠,相對於各類別本身的分散程度。它使用標籤,所以找到的方向對分類有意義;但它最多只能產生比類別數少一個的方向。
投影方向 的 Fisher 準則是沿 的類間散佈與類內散佈之比 [11]:
與 的定義同上一節。令梯度為零得到廣義特徵值問題
最佳方向是特徵值 最大的特徵向量(當 可逆時,等同於 的特徵向量)[1], [2]。兩類時有封閉解 ,它在 PR 03 中以高斯 LDA 分類器的形式再次出現。
為什麼最多 個方向。 是 個秩為一的矩陣 的加權和。向量 線性相依,因為 。所以 的秩至多為 ,非零特徵值至多 個。不論輸入維度多高,十個數字類別最多給出九個判別方向。
當 奇異時。 樣本數少於特徵數時(影像中很常見), 無法求逆。標準做法是先用 PCA、再在降維後的空間做 LDA,或把 往單位矩陣的倍數收縮(正則化 LDA)。
程式碼 · Python · 17 行
from sklearn.datasets import load_digits
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis as LDA
from sklearn.model_selection import cross_val_score
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

X, y = load_digits(return_X_y=True)
lda = LDA().fit(X, y)
print("discriminant directions for 10 classes:", lda.transform(X).shape[1])
for name, reducer in [("PCA", PCA(n_components=2)),
                      ("LDA", LDA(n_components=2))]:
    pipe = make_pipeline(StandardScaler(), reducer,
                         KNeighborsClassifier(n_neighbors=5))
    acc = cross_val_score(pipe, X, y, cv=5).mean()
    print(f"{name} to 2-D, then 5-NN: CV accuracy {acc:.3f}")
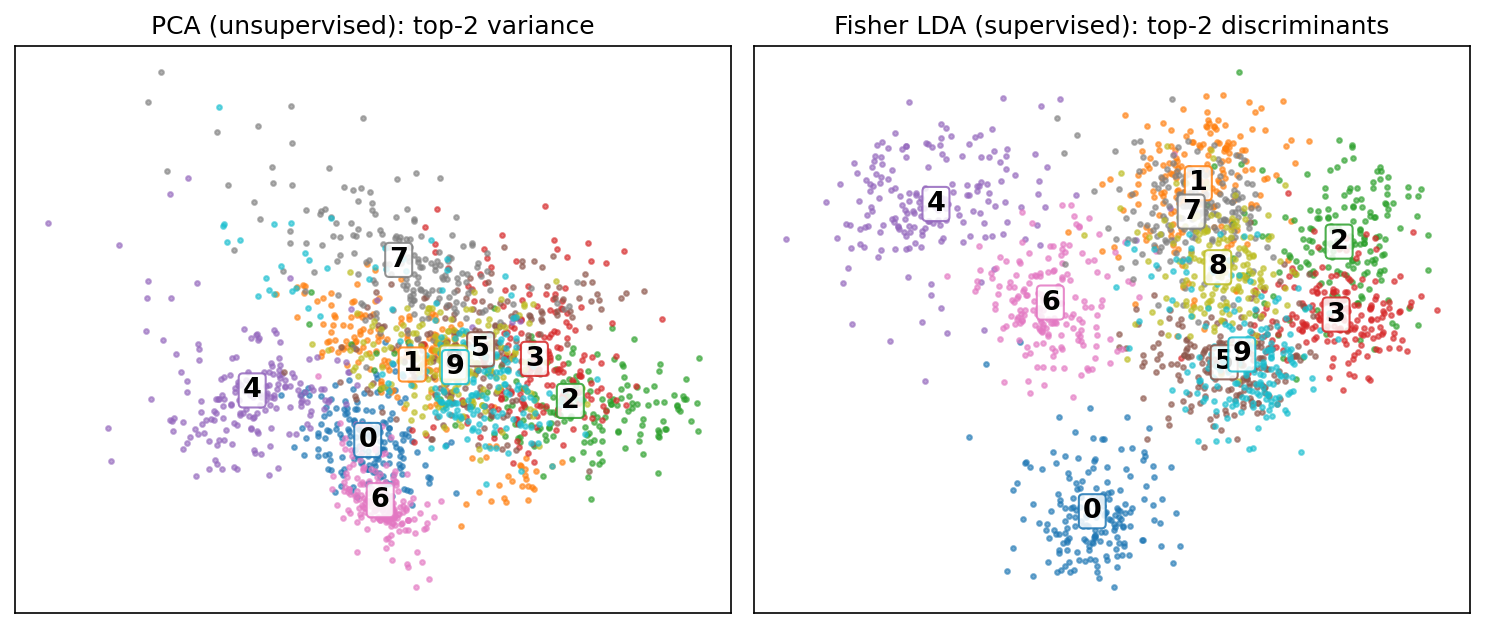
一如預測,十個類別的 LDA 回傳九個方向。壓縮到二維後,在 LDA 座標上的 5-NN 分類器交叉驗證準確率為 0.624,在前兩個主成分上則為 0.512。因為 LDA 使用標籤,它被放在 pipeline 內,在每個摺中重新擬合。圖 3 說明原因:LDA 把整個數字類別拉開,PCA 則主要呈現像素變化最大的方向。
核 PCA
白話版。 核 PCA 就是在核的豐富特徵空間中做 PCA(PR 04),而且從不需要算出那些特徵。它能把任何線性投影都攤不開的結構攤開。
Schölkopf、Smola 與 Müller 證明,在特徵空間 中做 PCA 只需要核矩陣 [12]。先在特徵空間中將它中心化:
其中 是每個元素皆為 的 矩陣。對係數向量 解特徵值問題 ,並正規化使 。點 的第 個核主成分為
是以同樣方式中心化的核。成本是一個 的特徵值問題,新點則需要 次核計算。
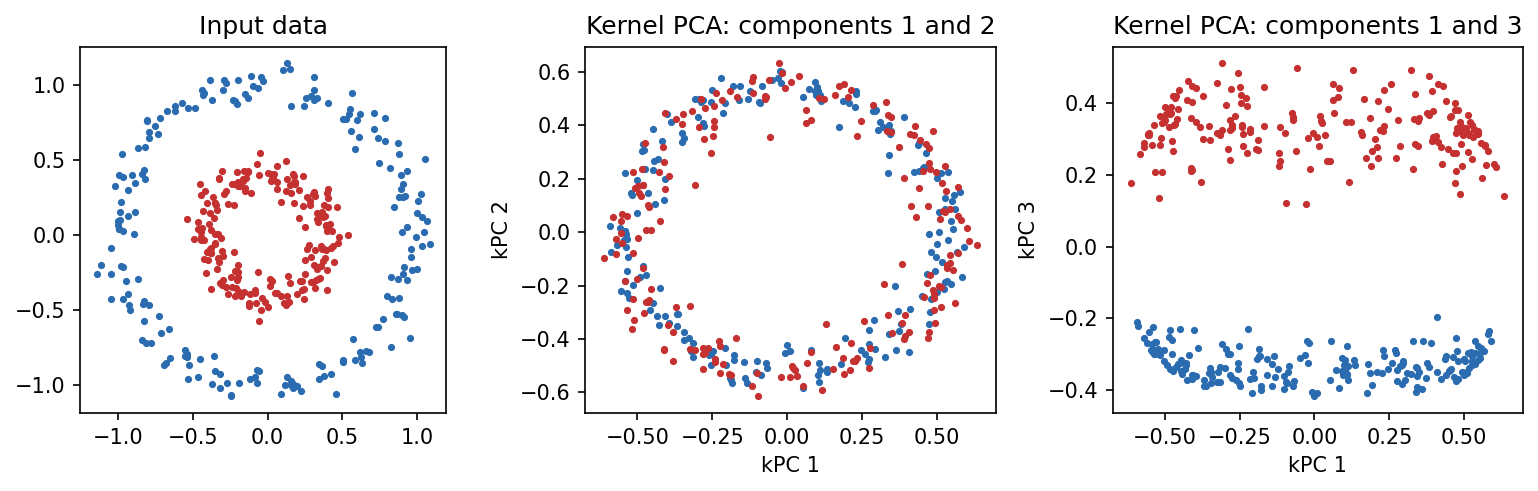
核 PCA 仍然是非監督的:它依特徵空間中的變異數為成分排序,而不是依類別分離程度。在雙環資料上,前兩個 RBF 核成分描述的是繞著環的角度,把兩類混在一起;第三個成分描述的是半徑,能把兩類完全分開(圖 4)。
程式碼 · Python · 18 行
import numpy as np
from sklearn.datasets import make_circles
from sklearn.decomposition import PCA, KernelPCA
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline

X, y = make_circles(n_samples=400, factor=0.4, noise=0.07, random_state=0)
Z = KernelPCA(n_components=4, kernel="rbf", gamma=2).fit_transform(X)
print("|corr(component, label)|:",
      np.round([abs(np.corrcoef(Z[:, i], y)[0, 1]) for i in range(4)], 3))

for name, reducer in [("linear PCA, 2 comps", PCA(n_components=2)),
                      ("kernel PCA, 3 comps", KernelPCA(n_components=3,
                                                        kernel="rbf", gamma=2))]:
    acc = cross_val_score(make_pipeline(reducer, LogisticRegression()),
                          X, y, cv=5).mean()
    print(f"{name} -> logistic regression: {acc:.3f}")
只有第三個成分和標籤相關(0.982;其餘都低於 0.05)。在兩個線性主成分上,邏輯斯迴歸無法勝過隨機猜測(0.432);在三個核成分上則完全正確(1.000)。
獨立成分分析
白話版。 在派對上,兩支麥克風各錄到兩個人聲的混合。ICA 試圖只從混合訊號中還原出各別的人聲,所依靠的是這些人聲彼此統計獨立而且不是高斯分布。
ICA 假設觀測向量是獨立訊號源的線性混合 [13]:
其中 是統計獨立、非高斯的訊號源, 是未知的混合矩陣, 是觀測到的訊號。目標是找到解混矩陣 ,使 的各成分彼此獨立。為什麼要非高斯?根據中央極限定理,混合訊號往往比訊號源「更像高斯」,所以最大化 的非高斯性就能找到一個訊號源。FastICA 以負熵(negentropy)的近似衡量非高斯性,並在資料白化後執行固定點迭代 [13]。有兩種模糊性永遠無法消除:訊號源的順序與尺度(包括正負號)。
和 PCA 的對比正是重點。PCA 只讓成分不相關(二階統計量);ICA 使用高階統計量,讓成分獨立。如果訊號源是高斯的,不相關就已經等於獨立,白化後資料的任何旋轉都一樣好,ICA 就會失敗。
程式碼 · Python · 16 行
import numpy as np
from sklearn.decomposition import FastICA

t = np.linspace(0, 8, 2000)
S = np.c_[np.sin(3 * t),                      # source 1: sine
          np.sign(np.sin(5 * t)),             # source 2: square wave
          ((2 * t) % 2) - 1]                  # source 3: sawtooth
A = np.array([[1.0, 0.5, 0.3],
              [0.6, 1.0, 0.4],
              [0.4, 0.3, 1.0]])               # unknown mixing matrix
X = S @ A.T                                   # what the sensors record

S_hat = FastICA(n_components=3, whiten="unit-variance",
                random_state=0).fit_transform(X)
corr = np.abs(np.corrcoef(S.T, S_hat.T)[:3, 3:])
print(np.round(corr, 3))                      # one entry near 1 per row
每個真實訊號源都恰好對應一個還原出的成分,相關係數絕對值為 0.999 或 1.000,其餘配對都低於 0.05。圖 5 顯示,對同樣的混合訊號做 PCA,得到的是互不相關、但仍然是混合的訊號。
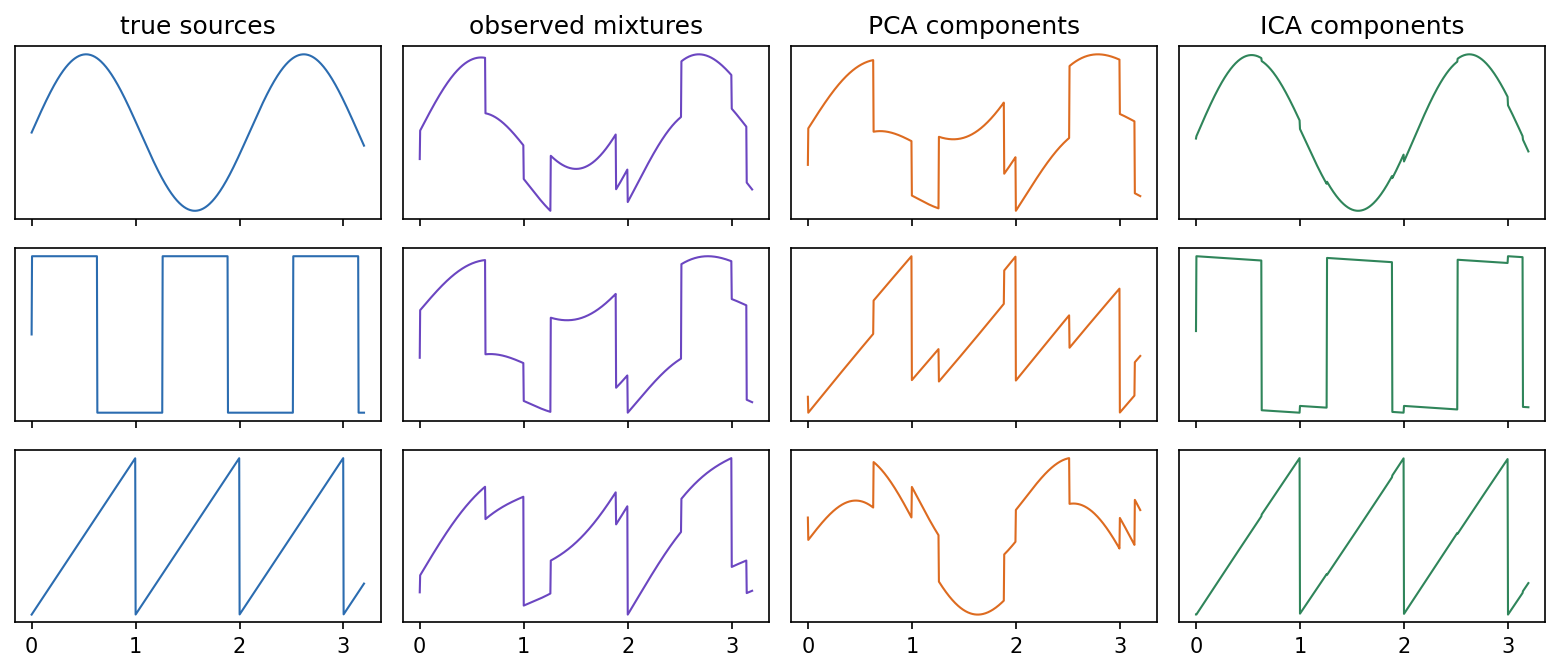
非負矩陣分解(non-negative matrix factorization, NMF)是適用於非負資料(例如像素強度或字詞計數)的相關分解:它把資料寫成 ,其中 的每個元素都 。由於不能做減法,分解出的因子傾向於是可相加的「部件」,Lee 與 Seung 在人臉影像上展示了這一點 [14]。
流形學習
白話版。 有時高維資料落在一張彎曲的低維薄片上,就像一張捲起來的海報。流形學習試著把薄片攤開:沿著薄片相鄰的點要保持靠近,而且不能被那些只是因為海報捲起來、才在三維中靠近的點騙過。
圖 6 的瑞士捲(Swiss roll)是標準例子:一個二維長方形在三維中捲起來。PCA 以投影把它壓平,讓捲的不同層疊在一起。以鄰域為基礎的方法表現較好:
- Isomap [15] 建立 近鄰圖,以圖上的最短路徑長度估計沿流形的測地距離,再找出歐氏距離與這些測地距離相符的低維座標(經典多維尺度法)。
- 局部線性嵌入(locally linear embedding, LLE)[16] 把每個點寫成鄰居的加權組合 ,且 ,再找出能以同一組權重重建的低維點 。
- t-SNE [17] 把距離轉換成輸入空間中的鄰居機率 (高斯,頻寬由「perplexity」參數決定)與嵌入空間中的 (重尾的 Student-),並最小化 Kullback–Leibler 散度 。重尾讓分得很開的群可以散開。
- UMAP [18] 建立加權的 近鄰圖(一種「模糊」的拓撲表示),再以交叉熵目標最佳化低維配置。它通常比 t-SNE 快,也常用於相同目的。
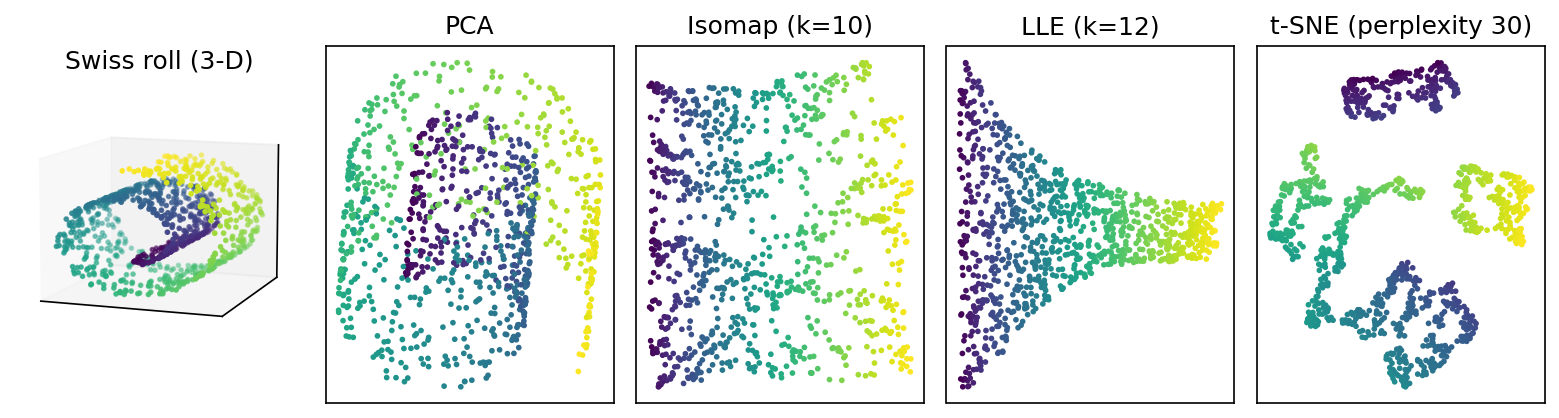
一種定量檢查是可信度(trustworthiness):嵌入中每個點的 個最近鄰,在輸入空間中也是近鄰的程度(1.0 為完美)。
程式碼 · Python · 17 行
from sklearn.datasets import make_swiss_roll
from sklearn.decomposition import PCA
from sklearn.manifold import Isomap, LocallyLinearEmbedding, TSNE, trustworthiness

X, t = make_swiss_roll(n_samples=1000, noise=0.05, random_state=0)
methods = {
    "PCA": PCA(n_components=2),
    "Isomap": Isomap(n_neighbors=10, n_components=2),
    "LLE": LocallyLinearEmbedding(n_neighbors=12, n_components=2,
                                  random_state=0),
    "t-SNE": TSNE(n_components=2, perplexity=30, init="pca",
                  random_state=0),
}
for name, method in methods.items():
    Y = method.fit_transform(X)
    print(f"{name:7s} trustworthiness (k=10): "
          f"{trustworthiness(X, Y, n_neighbors=10):.3f}")
PCA 得 0.905;Isomap 與 t-SNE 得 0.999;LLE 得 0.996。注意這個數字看不到的東西:即使圖 6 顯示 t-SNE 把捲撕成了島嶼,它的分數仍和 Isomap 一樣高。局部鄰域保留了,全域結構卻沒有。
嵌入圖能證明什麼、不能證明什麼
這些方法主要是用來觀察資料的工具。從它們的運作方式可以推出三點提醒 [19]:
- 群的大小與間距預設沒有意義。 t-SNE 會把局部密度正規化,所以緊密的群和鬆散的群可能看起來一樣大,群與群之間的距離也可能說明不了什麼。
- 結果取決於設定。 perplexity、鄰居數、初始化與隨機種子都會改變圖形。Wattenberg、Viégas 與 Johnson 的互動式文章展示了同一份資料產生非常不同的 t-SNE 圖 [19]。
- 二維可能不夠。 投影到二維必然扭曲高維距離;圖中分得很開的島嶼並不能證明存在分開的族群。
在分類上還有一個實務缺口:t-SNE 與標準 LLE 只為訓練點學出座標,沒有自然的規則能嵌入新點。Isomap、核 PCA 與 UMAP 提供樣本外轉換,但如果非線性嵌入是分類器的一部分,就必須像其他步驟一樣在訓練摺內擬合。
影像與訊號描述子
白話版。 在特徵可以學習之前,人們手工設計特徵,精確量測他們認為重要的性質:紋理、邊緣、形狀、頻率內容。它們至今仍是有用的基準與可解釋的檢查工具。
Theodoridis 與 Koutroumbas 以兩章篇幅介紹以轉換為基礎與針對應用的特徵 [1];IP 12 詳細討論影像描述子。想一想每一種保留了什麼、對什麼敏感:
| 描述子 | 保留 | 典型的敏感因素 |
|---|---|---|
| 強度直方圖 | 數值的分布 | 完全失去空間排列 |
| 共生矩陣(GLCM)統計量 [20] | 某一位移下成對強度的關係 | 量化階數與位移方向 |
| 方向梯度直方圖(HOG)[21] | 格狀小區塊內的局部邊緣方向 | 裁切、尺度與對齊 |
| 面積、周長、緊緻度 | 區域幾何 | 分割錯誤與解析度 |
| Fourier/DCT 係數 | 頻率內容 | 對齊方式與保留哪些頻率 |
| 小波係數 | 變化的位置與尺度 | 基底選擇與邊界處理 |
對量化影像 與位移 ,灰階共生矩陣計算所有像素位置 上的配對 ;正規化為機率 後,Haralick 的紋理特徵包括對比 與能量 [20]。務必註明位移與灰階數,因為數值取決於兩者。對面積為 、周長為 的分割物件,緊緻度 在理想連續圓時等於 1,形狀越不規則越小;以像素估計周長會讓小物件的數值失真。Dalal 與 Triggs 的 HOG 描述子由小區塊內正規化的梯度方向直方圖構成,最初用於行人偵測,後來成為最廣泛使用的人工設計影像特徵之一 [21]。
對音訊與其他一維訊號,特徵是在訊號近似穩定的短時窗內計算:各頻帶的頻譜能量、過零率等。時窗長度在時間解析度與頻率解析度之間取捨。
程式碼:同一個分類器,三種特徵集合
這個例子在內建的 digits 資料上,以同一個分類器比較固定的特徵策略。
程式碼 · Python · 21 行
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=9)
transforms = {
    "all features": "passthrough",
    "24 PCA coordinates": PCA(n_components=24, random_state=9),
    "24 selected coordinates": SelectKBest(f_classif, k=24),
}
for name, transform in transforms.items():
    model = make_pipeline(
        StandardScaler(), transform, LogisticRegression(max_iter=1500))
    model.fit(Xtr, ytr)
    print(name, "test accuracy:", round(model.score(Xte, yte), 4))
全部 64 個像素的測試準確率為 0.969,24 個主成分為 0.956,ANOVA 分數最高的 24 個像素為 0.953。在這裡降到約三分之一的維度,準確率損失很小。數字影像有些邊緣像素是常數,所以 檢定會對常數特徵發出警告;這個警告反映的是變異數為零,不是資訊洩漏,那些像素只是得不到有意義的分數。
現代觀點
人工的特徵工程大多已被學習得到的表徵取代,但本章的概念遍布現代流程:深度特徵同樣會被選擇、投影、白化、視覺化,並用相同的工具評估。以下是綜述文獻對這個領域的描繪。
特徵選擇。 Guyon 與 Elisseeff 的導論 [3] 確立了詞彙(過濾式、包裝式、嵌入式),討論了特徵建構、排序與驗證,並強調一個特徵可能單獨無用、組合起來卻有用。Chandrashekar 與 Sahin [23] 提供一份依同樣的過濾式/包裝式/嵌入式架構整理的精簡綜述。Li 等人 [22]「從資料的角度」重新檢視特徵選擇:他們把傳統資料的演算法分為基於相似度、基於資訊理論、基於稀疏學習與基於統計四類,加入結構化、異質與串流資料的方法,並釋出開源的評測資料庫。Ambroise 與 McLachlan 關於資訊洩漏的警告 [7],仍是最重要的單一實務教訓。
PCA 與其後繼者。 Jolliffe 與 Cadima 的綜述 [10] 把 PCA 說明為一種由資料定義的自適應技術,並整理了針對不同資料型態的變體。在現代深度學習中,PCA 以診斷工具(某一層的激活中,有多少方向承載了大部分變異)以及前處理與初始化步驟的形式延續,例如 t-SNE 建議採用的 PCA 初始化 [26]。
用於視覺化的降維。 Espadoto 等人 [24] 對投影技術做了大規模的定量綜述:他們以多種定量指標(例如鄰域與距離的保留程度)刻畫資料集、技術與投影品質,量測結果如何隨技術與資料變化,並把觀察整理成在特定情境下選擇投影方法的指引,所有程式與結果都以開放基準的形式釋出。Wang、Huang、Rudin 與 Shaposhnik [25] 分析了 t-SNE、UMAP 與 TriMAP 為何會有各自的行為,聚焦於保留局部結構與全域結構之間的取捨,並提出兼顧兩者的 PaCMAP。
二維嵌入的陷阱。 在 t-SNE 與 UMAP 已成例行工具的單細胞生物學中,出現了最尖銳的批評。Kobak 與 Berens [26] 提出讓 t-SNE 圖更忠實的流程:PCA 初始化、較高的學習率與多尺度相似度。Kobak 與 Linderman [27] 指出,常被歸功於 UMAP 的較佳全域結構,大部分來自它的初始化;使用同樣有資訊的初始化時,t-SNE 也能同樣好地保留全域結構。Chari 與 Pachter [28] 更進一步主張:極端地降到二維必然扭曲高維資料,這類圖不應用來做定量結論。
再談變異與有用性。 圖 2 的教訓在自監督學習中以更大的規模重現。Balestriero 與 LeCun [29] 認為,以重建輸入為目標訓練表徵,會強調資料中高變異的成分,而這些成分對感知任務的資訊量往往不如低變異的細節;因此以重建訓練的特徵需要額外步驟(例如微調)才能用於分類。這正是 PCA 的限制,換成了深度學習的場景。
未解問題。 在特徵高度相關、樣本又少的情況下,選擇結果依然不穩定:不同子集可能表現一樣好,讓解釋變得困難。評估嵌入仍缺乏能同時涵蓋局部與全域忠實度的公認指標 [24], [25]。至於學習得到的特徵,如何判斷哪些方向承載的是與任務相關、而不只是高變異的資訊,是活躍的研究問題 [29]。
重點整理
- 特徵選擇保留原始量測;萃取建立新座標;學習則從資料擬合萃取規則。三者都決定了分類器看得到什麼。
- 過濾式方法快速,但會漏掉交互作用與冗餘;包裝式方法看得見,但成本較高且可能對驗證資料過擬合;嵌入式方法(lasso、樹)在訓練中完成選擇。
- 任何使用標籤的步驟(特徵選擇、LDA、決定特徵數量)都必須在每個交叉驗證摺內重新擬合。在完整資料上選擇,可能在純雜訊上回報 98% 的準確率。
- Fisher 比值、、Bhattacharyya 距離與互資訊可為特徵評分;由於冗餘,子集必須整體評分。
- PCA 保留最大變異(共變異數的特徵向量,以 SVD 計算);白化讓各方向變異相等。變異不等於類別資訊。
- Fisher LDA 解 ,最多給出 個方向。核 PCA、ICA 與 NMF 把線性萃取延伸到非線性、獨立或非負的結構。
- Isomap、LLE、t-SNE 與 UMAP 主要是視覺化工具:它們的圖取決於設定,群與群之間的間隙不能證明族群分離。
練習
- 相同直方圖、不同影像。 構造兩張 的二值影像,強度直方圖相同但紋理不同。表中哪一種描述子能分辨它們?
提示
用八個值為 1 的像素,一張排成棋盤格,另一張填滿左半邊。兩者直方圖相同。水平位移 的共生矩陣可以分辨:棋盤格只有不相等的鄰居配對,左半填滿的影像則大多是相等的配對。
- 的上限。 證明 個類別的類間散佈 秩至多為 。這對兩類問題上的 LDA 代表什麼?
提示
,其中 ,且 ,所以 個向量 至多張成 維。兩類時 LDA 只給出一個方向 。
- 99% 的變異也不夠時。 描述一個實際的成像情境,其中保留 99% 的 PCA 變異仍會丟掉類別訊號。你要如何偵測這個問題?又該怎麼做?
提示
大幅且獨立的光照或姿態變化,加上一個小而一致的瑕疵標記(換了外衣的圖 2)。比較有無 PCA 時的交叉驗證準確率,或逐一檢查各成分的類別分離程度(Fisher 比值)即可偵測。改用監督式投影、先把干擾因素(例如光照)正規化,或乾脆不用 PCA。
- XOR 陷阱。 產生在 上均勻分布的 與八個無關的雜訊特徵,令 。分別以
f_classif與mutual_info_classif為十個特徵排序,再以決策樹做循序前向選擇。哪些方法找得到 與 ?
提示
兩種單變量過濾給 、 的分數都接近零,和雜訊特徵一樣,因為每一個單獨都與 獨立。一次加一個特徵的包裝式方法,第一步也可能因為同樣的理由而卡住;能評估特徵配對的樹狀包裝式方法,或從全部特徵開始的後向刪除,則找得到它們。
- 量化資訊洩漏。 在選擇偏差的程式中,改變雜訊特徵數(100、1,000、5,000)與樣本數(30、60、200)。「錯誤做法」的準確率如何變化?解釋這個趨勢。
提示
樂觀程度隨候選特徵數增加、隨樣本數減少:雜訊特徵越多,在小樣本中碰巧與標籤相關的就越多,而挑出最好的 20 個,挑中的正是這些。
- 解讀 t-SNE 圖。 在 digits 資料上以 perplexity 5、30、100 執行 t-SNE,每種各用兩個隨機種子。圖中哪些特徵是穩定的(哪些數字彼此相鄰?),哪些會改變(群的大小、間隙、位置)?從單張這種圖,你願意宣稱什麼?
提示
局部鄰域的成員相當穩定;絕對位置、群的面積與群間距離則不穩定。站得住腳的說法是「這些點在輸入空間中局部相似」,而不是「這兩群相距很遠」或「這一群的多樣性是另一群的兩倍」。
參考文獻
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2009, Chapters 5–7. publisher page
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006, Sections 4.1.4–4.1.6 and 12.1–12.4. official book page and PDF
- I. Guyon and A. Elisseeff, “An Introduction to Variable and Feature Selection,” Journal of Machine Learning Research, vol. 3, pp. 1157–1182, 2003. JMLR
- R. Kohavi and G. H. John, “Wrappers for Feature Subset Selection,” Artificial Intelligence, vol. 97, pp. 273–324, 1997. doi:10.1016/S0004-3702(97)00043-X
- R. Tibshirani, “Regression Shrinkage and Selection via the Lasso,” Journal of the Royal Statistical Society, Series B, vol. 58, no. 1, pp. 267–288, 1996. doi:10.1111/j.2517-6161.1996.tb02080.x
- H. Peng, F. Long, and C. Ding, “Feature Selection Based on Mutual Information: Criteria of Max-Dependency, Max-Relevance, and Min-Redundancy,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 27, no. 8, pp. 1226–1238, 2005. doi:10.1109/TPAMI.2005.159
- C. Ambroise and G. J. McLachlan, “Selection Bias in Gene Extraction on the Basis of Microarray Gene-Expression Data,” Proceedings of the National Academy of Sciences, vol. 99, no. 10, pp. 6562–6566, 2002. doi:10.1073/pnas.102102699
- K. Pearson, “On Lines and Planes of Closest Fit to Systems of Points in Space,” The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, vol. 2, no. 11, pp. 559–572, 1901. doi:10.1080/14786440109462720
- H. Hotelling, “Analysis of a Complex of Statistical Variables into Principal Components,” Journal of Educational Psychology, vol. 24, no. 6, pp. 417–441, 1933. doi:10.1037/h0071325
- I. T. Jolliffe and J. Cadima, “Principal Component Analysis: A Review and Recent Developments,” Philosophical Transactions of the Royal Society A, vol. 374, 20150202, 2016. doi:10.1098/rsta.2015.0202
- R. A. Fisher, “The Use of Multiple Measurements in Taxonomic Problems,” Annals of Eugenics, vol. 7, no. 2, pp. 179–188, 1936. doi:10.1111/j.1469-1809.1936.tb02137.x
- B. Schölkopf, A. Smola, and K.-R. Müller, “Nonlinear Component Analysis as a Kernel Eigenvalue Problem,” Neural Computation, vol. 10, no. 5, pp. 1299–1319, 1998. doi:10.1162/089976698300017467
- A. Hyvärinen and E. Oja, “Independent Component Analysis: Algorithms and Applications,” Neural Networks, vol. 13, no. 4–5, pp. 411–430, 2000. doi:10.1016/S0893-6080(00)00026-5
- D. D. Lee and H. S. Seung, “Learning the Parts of Objects by Non-Negative Matrix Factorization,” Nature, vol. 401, pp. 788–791, 1999. doi:10.1038/44565
- J. B. Tenenbaum, V. de Silva, and J. C. Langford, “A Global Geometric Framework for Nonlinear Dimensionality Reduction,” Science, vol. 290, no. 5500, pp. 2319–2323, 2000. doi:10.1126/science.290.5500.2319
- S. T. Roweis and L. K. Saul, “Nonlinear Dimensionality Reduction by Locally Linear Embedding,” Science, vol. 290, no. 5500, pp. 2323–2326, 2000. doi:10.1126/science.290.5500.2323
- L. van der Maaten and G. Hinton, “Visualizing Data using t-SNE,” Journal of Machine Learning Research, vol. 9, pp. 2579–2605, 2008. JMLR
- L. McInnes, J. Healy, and J. Melville, “UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction,” arXiv:1802.03426, 2018. arXiv
- M. Wattenberg, F. Viégas, and I. Johnson, “How to Use t-SNE Effectively,” Distill, 2016. doi:10.23915/distill.00002
- R. M. Haralick, K. Shanmugam, and I. Dinstein, “Textural Features for Image Classification,” IEEE Transactions on Systems, Man, and Cybernetics, vol. SMC-3, no. 6, pp. 610–621, 1973. doi:10.1109/TSMC.1973.4309314
- N. Dalal and B. Triggs, “Histograms of Oriented Gradients for Human Detection,” IEEE Conference on Computer Vision and Pattern Recognition (CVPR), vol. 1, pp. 886–893, 2005. doi:10.1109/CVPR.2005.177
- J. Li, K. Cheng, S. Wang, F. Morstatter, R. P. Trevino, J. Tang, and H. Liu, “Feature Selection: A Data Perspective,” ACM Computing Surveys, vol. 50, no. 6, 2018. doi:10.1145/3136625
- G. Chandrashekar and F. Sahin, “A Survey on Feature Selection Methods,” Computers & Electrical Engineering, vol. 40, no. 1, pp. 16–28, 2014. doi:10.1016/j.compeleceng.2013.11.024
- M. Espadoto, R. M. Martins, A. Kerren, N. S. T. Hirata, and A. C. Telea, “Toward a Quantitative Survey of Dimension Reduction Techniques,” IEEE Transactions on Visualization and Computer Graphics, vol. 27, no. 3, pp. 2153–2173, 2021. doi:10.1109/TVCG.2019.2944182
- Y. Wang, H. Huang, C. Rudin, and Y. Shaposhnik, “Understanding How Dimension Reduction Tools Work: An Empirical Approach to Deciphering t-SNE, UMAP, TriMAP, and PaCMAP for Data Visualization,” Journal of Machine Learning Research, vol. 22, 2021. arXiv:2012.04456
- D. Kobak and P. Berens, “The Art of Using t-SNE for Single-Cell Transcriptomics,” Nature Communications, vol. 10, 2019. doi:10.1038/s41467-019-13056-x
- D. Kobak and G. C. Linderman, “Initialization Is Critical for Preserving Global Data Structure in Both t-SNE and UMAP,” Nature Biotechnology, vol. 39, pp. 156–157, 2021. doi:10.1038/s41587-020-00809-z
- T. Chari and L. Pachter, “The Specious Art of Single-Cell Genomics,” PLOS Computational Biology, vol. 19, e1011288, 2023. doi:10.1371/journal.pcbi.1011288
- R. Balestriero and Y. LeCun, “Learning by Reconstruction Produces Uninformative Features for Perception,” arXiv:2402.11337, 2024. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 06・模板比對與結構化辨識 · 21 分鐘