PR 04・近鄰、核與非線性分類器
先備知識:PR 03・迴歸與分類的線性模型
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
圖形識別
用實驗理解本章 1 個互動實驗
對真實的鳶尾花量測資料做留一法 k 近鄰分類,再改變其中一個特徵的單位:沒有任何一朵花移動,鄰居與準確率卻改變了。
你將學到
- 最近鄰規則為什麼不必擬合任何參數就能產生非線性決策區域,以及距離度量為何和 一樣重要。
- 核技巧(kernel trick)是什麼、什麼樣的函數才是有效的(Mercer)核,以及如何在有限的 Gram 矩陣上檢查。
- 軟間隔支持向量機(soft-margin SVM):原始問題與對偶問題、支持向量,以及超參數 與 如何塑造邊界。
- 高斯過程與相關向量機如何以機率的角度重複利用核。
- 另外三條通往非線性的路:徑向基函數(RBF)網路、以不純度(impurity)準則生長的決策樹(CART),以及多層感知器。
- 如何公平比較這些方法家族,以及它們在 2026 年的位置。
先看全貌
PR 03 建立的分類器,決策邊界都是直線、平面或超平面。許多真實問題並非如此:環內的點無法用任何一條直線和環外的點分開;手寫的「1」與「7」在像素空間中沿著彎曲、扭轉的區域互相重疊。我們需要會彎的邊界。
讓邊界彎曲的基本做法只有幾種:
- 和儲存的樣本比較。 找出與新點最相似的訓練點,參考它們的標籤(最近鄰)。
- 先換表徵,再維持線性。 把每個輸入 映射成新特徵 ,讓超平面在新空間中可行。核方法隱式地做這件事;RBF 網路與多層感知器則以固定或學習得到的基底函數明確地做。
- 把空間切成小塊。 決策樹提出一連串是非題,每條回答路徑最後落在一個帶有自己標籤的小方塊。
本章每一種方法都有同一個前提:非線性分類器只能利用量測中已有的資訊。如果兩個類別在你記錄的特徵裡看起來一模一樣,再怎麼彎曲邊界也分不開。特徵設計是 PR 05 的主題。本章的教科書背景是 Theodoridis 與 Koutroumbas 第 2、4 章 [1],以及 Bishop 第 2.5.2、5.1–5.3、6.1–6.4、7.1–7.2 與 14.4 節 [2]。
最近鄰分類
白話版。 要分類一個新點,就找出離它最近的 個訓練點,讓它們投票。除了把資料存起來,什麼都沒有「學」,但得到的邊界可以順著資料呈現任何形狀。
規則與它的保證
給定訓練資料對 ,,以及查詢點 ,令 為在某個距離 之下最接近 的 個訓練點索引。 近鄰(-NN)規則預測
其中 走遍所有類別; 在括號內條件成立時為 1,否則為 0; 是投票權重:單純多數決時 ,距離加權投票時則取 的遞減函數。
各類票數比例是類別後驗機率 的粗略估計:-NN 其實是一種換了外衣的無母數密度方法(PR 02),鄰域大小由 決定,而非固定的頻寬 [2]。Cover 與 Hart 證明了 1-NN 規則的經典結果:當訓練樣本數無限增加時,它的錯誤率至多是貝氏錯誤率的兩倍 [3]。這是漸近的敘述;在有限資料下,尤其是高維度時,-NN 可能離這個界限很遠。
度量方式是一種建模決策
歐氏距離把每個座標上的一單位差異視為同樣重要。如果一個特徵以公釐量測、另一個以公里量測,前者會主宰每個鄰域。把特徵標準化、學習一個 Mahalanobis 度量 ( 為半正定矩陣),或以 cosine 相似度比較正規化後的嵌入(embedding),都會改變誰算是鄰居。
對於已正規化為單位長度的向量 與 ,
因此歐氏距離最近的鄰居,恰好就是 cosine 相似度最大的鄰居:兩個準則對候選點的排序剛好相反,選出的鄰居卻相同。這就是為什麼在正規化的深度特徵上做最近鄰搜尋(ML 06)時,兩者可以互換。
選擇 ,以及預測的成本
小的 (例如 1)會給出鋸齒狀的邊界,緊跟每個帶雜訊的訓練點:偏差低、變異高。大的 在較大區域內平均,使邊界平滑,但可能把小類別整個抹掉。、度量方式與尺度都應該只用訓練資料,以交叉驗證來選擇。
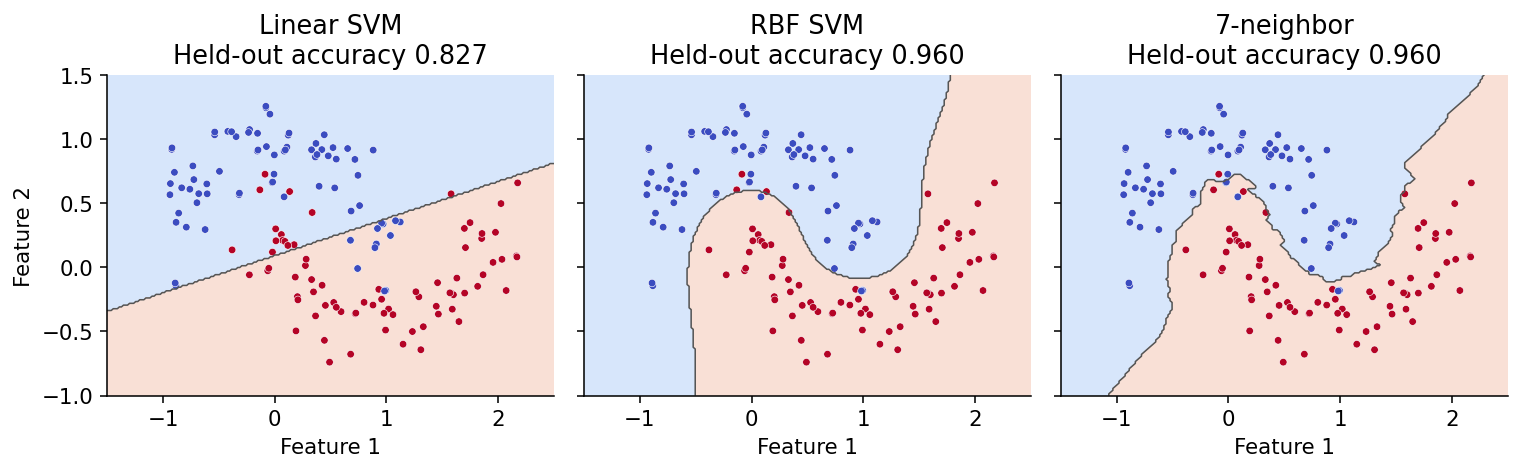
-NN 把所有成本都推到預測階段。單純的查詢要把 和全部 個訓練點比較,對 維輸入的成本是 。樹狀索引與近似最近鄰搜尋在實務上可以降低這個成本。在高維度時還會出現另一個問題:當許多座標帶有無關的變異,隨機點之間的距離會集中在某個共同值附近,「最近」便不再代表「最相似」。本章稍後圖 3 的右圖顯示二維玩具問題上的 7-NN 邊界,那裡不會出現這些問題。
核:核技巧與 Mercer 條件
白話版。 許多線性演算法只透過內積 使用輸入。如果把每個內積換成某個「相似度函數」,而它恰好等於某個更豐富特徵空間中的內積,我們就能用線性演算法的價格得到非線性演算法,而且從頭到尾不必算出那些豐富的特徵。
把資料抬升
看圖 1 左邊的環狀資料。沒有任何直線能把內圈的圓盤和外環分開。加入第三個特徵:半徑平方 。在新的三維空間中,內圈點位置低、外環點位置高,一個平面就能完美分開它們。抬升後空間中的線性分類器,在原空間中就是一個圓。
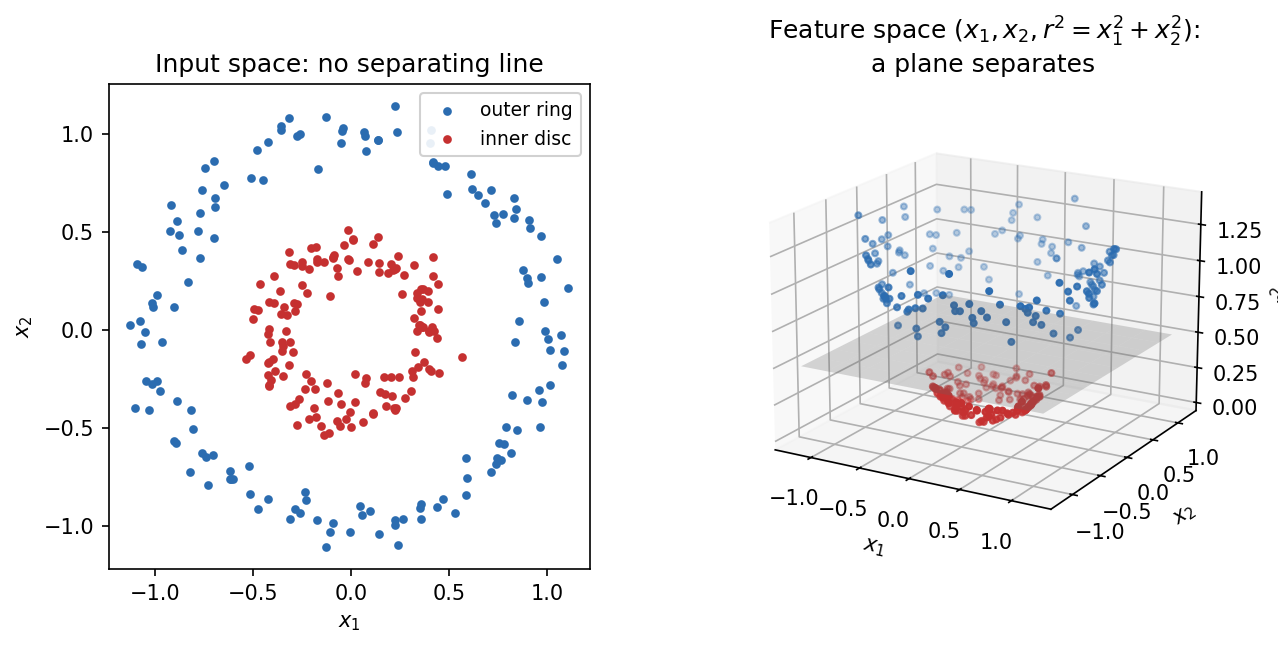
明確抬升很快就變得昂貴。 個變數、次數不超過 的所有單項式共有 個;對 的影像()且 ,大約是 290 萬個特徵。核方法可以避免把它們建出來。
核技巧
核是一個函數 ,存在某個映射到內積空間的特徵映射 ,使得
其中 與 是輸入, 是 的(可能非常長、甚至無限維的)特徵向量,右式是它們的內積。舉例來說,在二維中令 ,
計算左式只需一次內積與一次平方;右式每個點需要六個特徵。在 維、次數 時,左式的成本仍是 。
核技巧指的是:任何完全以資料點之間內積寫成的演算法,都可以把 換成 而「核化」[7]。SVM 對偶問題、核嶺迴歸、核 PCA(PR 05)與高斯過程都屬於這一類。所有核值收集在 Gram 矩陣 ,。
下面的程式以數值驗證這個等式,接著示範一個常見、卻不是有效核的「相似度」。
程式碼 · Python · 18 行
import numpy as np

rng = np.random.default_rng(0)
x, z = rng.normal(size=2), rng.normal(size=2)

def phi(v):  # explicit feature map of (v.w + 1)^2 in 2-D
    a, b = v
    s = np.sqrt(2)
    return np.array([1, s * a, s * b, a * a, b * b, s * a * b])

lhs = (x @ z + 1) ** 2
rhs = phi(x) @ phi(z)
print("kernel:", round(lhs, 6), " explicit:", round(rhs, 6))
assert np.isclose(lhs, rhs)

X = rng.normal(size=(40, 2))
K_sig = np.tanh(2.0 * X @ X.T - 1.0)        # "sigmoid kernel"
print("sigmoid Gram min eigenvalue:", np.linalg.eigvalsh(K_sig).min().round(3))兩個數字相同。「sigmoid 核」的 Gram 矩陣有明顯為負的特徵值(此例約為 ),所以在這組參數下,不存在任何特徵映射 能重現它。
哪些函數是核?Mercer 條件
函數 是有效的核,若且唯若它對稱,即 ,而且半正定:對任何有限點集 與任何實數向量 ,
換句話說,每個 Gram 矩陣的特徵值都非負。只有對稱是不夠的,sigmoid 的例子就說明了這點。
Mercer 定理 [4] 給出連續版本。對緊緻定義域 上連續且對稱的 ,若它在積分意義下半正定,
則可以展開成 ,其中特徵值 , 為正交歸一的特徵函數。此時特徵映射就是 。用現代的說法,每個半正定核都定義一個函數構成的再生核希爾伯特空間(reproducing kernel Hilbert space, RKHS),而表示定理(representer theorem)指出:在這個空間中做正則化擬合,解必定是有限組合 [7]。
有效的核可以由有效的核組合出來。若 與 是核,那麼 、()、、,以及對任意函數 的 也都是核 [2]。常見的核如下:
| 核 | 公式 | 參數 | 說明 |
|---|---|---|---|
| 線性 | 無 | 回到線性模型 | |
| 多項式 | ,,整數 | 包含次數至多 的所有單項式( 時只有 次項) | |
| 高斯 RBF | 無限維特徵空間;局部相似度 | ||
| Laplacian | 函數比高斯核粗糙 | ||
| Sigmoid | 一般而言不是半正定 |
高斯 RBF 核是預設的非線性選擇。參數 (有時寫成 , 為頻寬)決定相似度能延伸多遠。 大時,每個訓練點只影響極小的鄰域; 小時,核在資料範圍內幾乎是常數,模型趨近非常平滑、近乎線性的函數。由於 乘在距離平方上,它和特徵的尺度綁在一起:尺度處理本身就是模型的一部分。不同單位混用時,標準化是實用的起點;若特徵本來就具有一致且有意義的單位,不標準化也可能較好,PR 10 綜合專題就是例子。應在驗證流程中比較選項,每個縮放器只用當折訓練資料擬合 [27]。
核嶺迴歸:一行看懂核技巧
使用特徵 的嶺迴歸最小化 。它的解可以寫成 ,於是
其中 是目標值, 是正則化強度, 是 單位矩陣, 是查詢點 與各訓練點的相似度。原本 維特徵空間中的求解,變成 樣本空間中的求解:特徵多、樣本少時很划算; 很大時則很昂貴(時間 ,記憶體 )。
程式碼 · Python · 16 行
import numpy as np
from sklearn.kernel_ridge import KernelRidge
from sklearn.metrics.pairwise import rbf_kernel

rng = np.random.default_rng(1)
X = rng.uniform(-3, 3, size=(60, 1))
t = np.sin(X[:, 0]) + 0.1 * rng.normal(size=60)
lam, gamma = 0.1, 0.5

K = rbf_kernel(X, X, gamma=gamma)
alpha = np.linalg.solve(K + lam * np.eye(len(X)), t)
Xq = np.linspace(-3, 3, 5)[:, None]
f_ours = rbf_kernel(Xq, X, gamma=gamma) @ alpha
f_skl = KernelRidge(alpha=lam, kernel="rbf", gamma=gamma).fit(X, t).predict(Xq)
print(np.round(f_ours, 4))
assert np.allclose(f_ours, f_skl)
手寫的求解與 scikit-learn 的 KernelRidge 結果一致,五個查詢點上的預測也貼合 。
支持向量機
白話版。 在所有能分開兩類的邊界中,挑出中間那條空白「街道」最寬的一條。只有位在街道邊緣或街道內的點才重要,它們就是支持向量。允許少數點以代價 進入街道,方法就能處理互相重疊的資料;把內積換成核,街道就能彎曲。
硬間隔與軟間隔
使用標籤 與分數 , 是權重向量, 是偏差;預測取 的正負號。若資料可分,可以調整 與 的尺度,使最近的點滿足 。兩條線 之間的距離,也就是間隔(margin),等於 。最大化間隔,等於在所有 都滿足 的條件下最小化 :這是 Boser、Guyon 與 Vapnik 的硬間隔 SVM [5]。
真實資料會重疊,因此 Cortes 與 Vapnik 引入鬆弛變數 ,衡量每個點違反間隔的程度 [6]。軟間隔 SVM 求解
的點位在正確的一側,且間隔至少為 1;在最佳解處, 表示點落在街道內但仍分類正確; 位於決策邊界, 才是分類錯誤。常數 是違反間隔的價格。消去 可得等價的無約束形式
也就是加上正則化的鉸鏈損失(hinge loss)。滿足 的點完全不貢獻損失,這正是 SVM 稀疏性的來源。(有些教科書把損失取平均、把常數放在正則項,寫成 ;兩者在 時相同。)
對偶問題與支持向量
對每個間隔約束引入拉格朗日乘數 ,再消去 、 與 ,就得到對偶問題 [2], [6]:
這是 個乘數 的凸二次規劃問題,而資料只透過核值 出現,核技巧就是從這裡進入。最佳權重向量是 ,所以預測也只需要核:
Karush–Kuhn–Tucker(KKT)最佳性條件把訓練點分成三組:
- :點在街道外(),對 沒有影響;
- :點恰好落在間隔上(),由這些點決定 ;
- :點在街道內或被分錯()。
的點就是支持向量。刪掉任何其他點再重新訓練,得到的分類器完全相同。支持向量有多少取決於資料:在嚴重重疊的問題上,訓練集中很大一部分都可能成為支持向量,預測就會和最近鄰搜尋一樣昂貴。
與 如何塑造 RBF-SVM
使用高斯核時,一切由兩個數字控制。 決定訓練錯誤相對於寬間隔的代價; 決定核有多局部。圖 2 在同一份帶雜訊資料上掃過兩者。
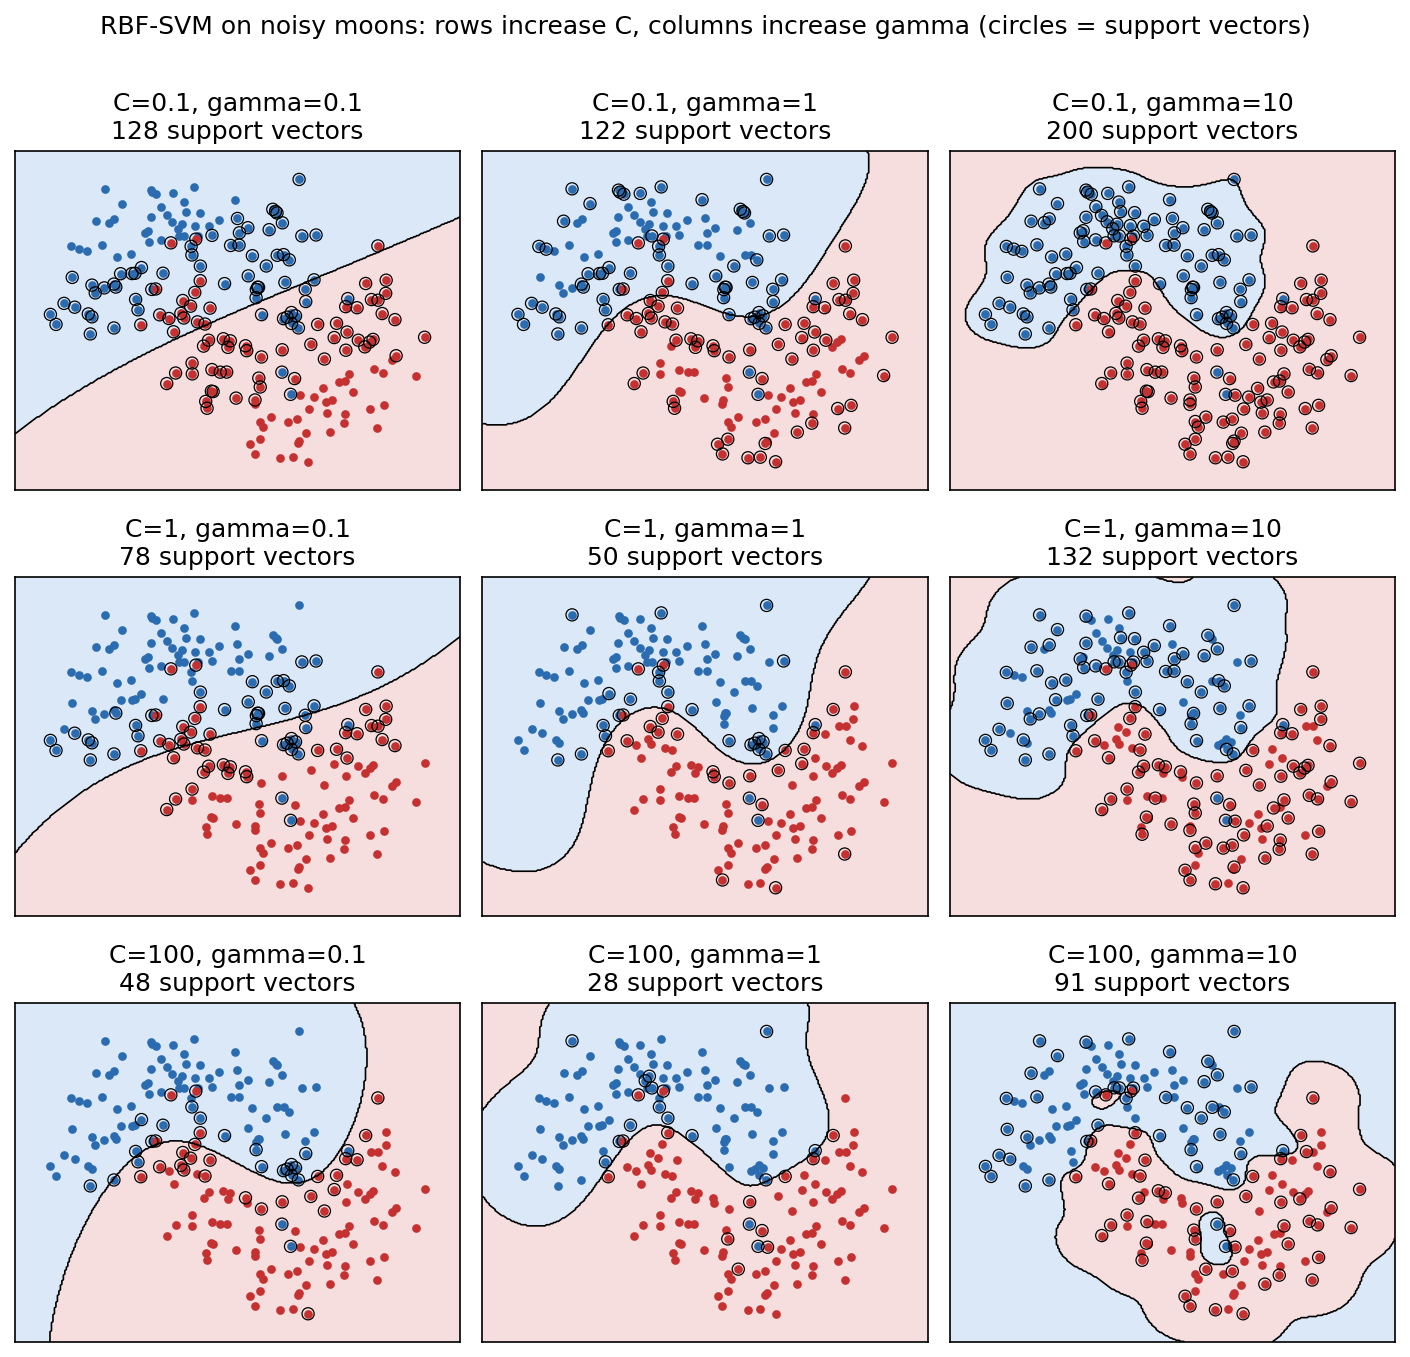
這張格狀圖可以這樣讀。往下走( 變大),邊界會追著個別訓練點跑,而支持向量數變少,因為允許進入間隔的點變少了。往右走( 變大),每個點的影響範圍縮小;到 時分類器開始畫出小島,這就是過擬合(overfitting)。好的區域是一條對角帶: 變大時,通常需要較小的 。實務上,會在對數尺度的網格上用交叉驗證搜尋 與 。
程式碼 · Python · 30 行
import numpy as np
from sklearn.datasets import make_moons
from sklearn.model_selection import GridSearchCV, train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = make_moons(n_samples=500, noise=0.18, random_state=2)
Xtr, Xte, ytr, yte = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=2)
models = {
    "linear SVM": SVC(kernel="linear", C=1),
    "RBF SVM": SVC(kernel="rbf", C=3, gamma=0.7),
    "7-neighbor": KNeighborsClassifier(n_neighbors=7),
}
for name, estimator in models.items():
    model = make_pipeline(StandardScaler(), estimator).fit(Xtr, ytr)
    print(name, "test accuracy:", round(model.score(Xte, yte), 4))

search = GridSearchCV(
    make_pipeline(StandardScaler(), SVC(kernel="rbf")),
    {"svc__C": [0.1, 1, 10, 100], "svc__gamma": [0.01, 0.1, 1, 10]},
    cv=5)
search.fit(Xtr, ytr)
best = search.best_estimator_
print("best:", search.best_params_,
      "CV acc:", round(search.best_score_, 4),
      "test acc:", round(best.score(Xte, yte), 4),
      "support vectors:", best[-1].n_support_.sum(), "of", len(Xtr))
在這個切分上,線性 SVM 的測試準確率是 0.827,手選參數的 RBF-SVM 與 7-NN 都是 0.96。網格搜尋選出 、(交叉驗證準確率 0.971),350 個訓練點中有 59 個是支持向量,測試準確率 0.953。調參後的模型並沒有任何實質意義上的「比較差」:150 個測試點中,一個點就等於 0.0067 的準確率,兩者只差一個點。單一切分上這種大小的差異應視為雜訊(PR 09)。標準化器放在 pipeline 裡,才會在每個訓練摺上重新擬合。
分數不是機率
SVM 的輸出 是一個帶正負號、類似距離的分數,不是 ;它的訓練目標從未要求它經過校準。若需要機率(例如拒絕選項,PR 01,或是要結合多個模型),應在保留資料上另外擬合一個由分數到機率的單調映射,並用可靠度圖檢查(PR 09)。多類別 SVM 通常由二元 SVM 組成,採用一對其餘(one-versus-rest)或一對一(one-versus-one);scikit-learn 的 SVC 使用一對一。
高斯過程與相關向量
白話版。 高斯過程使用同樣的核,但它不只回傳一個最佳函數,而是回傳一整個「合理函數」的分布,所以每個預測都附帶誤差棒。
高斯過程(Gaussian process, GP)是函數 上的先驗,使得任何有限組函數值 都服從聯合高斯分布,平均(通常)為零、共變異數為 [8]。因此核必須是有效的共變異數,也就是半正定。對於觀測雜訊為高斯、變異數 的迴歸,查詢點 的後驗是高斯分布,
其中 是預測平均, 是潛在函數的變異數。平均值正好就是 的核嶺迴歸。變異數是新的資訊:它在訓練輸入附近很小,遠離訓練輸入時回升到先驗變異數 。核的超參數(如 與 )可以用最大化邊際概似(marginal likelihood)來選擇,而不必用交叉驗證 [2], [8]。
有兩點要注意。不確定度是以所選的核為條件;核選錯時,GP 可能很有自信地犯錯。另外,GP 分類比較困難:在高斯潛在函數上接伯努利概似,會讓後驗不再是高斯,因此需要 Laplace、期望傳播(expectation propagation)或變分近似(PR 08)。
相關向量機(relevance vector machine, RVM)由 Tipping 提出 [9],並收錄於 Bishop 第 7.2 節 [2]。它使用和 SVM 相同的函數形式 ,但為每個權重 設定一個平均為零的高斯先驗,各自帶有自己的精度超參數。最大化邊際概似會把許多精度推向無窮大,等於把對應的基底函數關掉。存活下來的訓練點稱為「相關向量」,數量通常遠少於 SVM 的支持向量;輸出具有機率意義;基底函數也不必滿足 Mercer 條件。代價是訓練問題不再是凸的。因此「稀疏」有好幾種意思:儲存的基底函數少(SVM、RVM)、非零的輸入權重少(lasso),或輸入資料本身稀疏。請說清楚你指的是哪一種。
徑向基函數網路
白話版。 在輸入空間中幾個有代表性的位置放上高斯「小山丘」,量測新點讓每座山丘被激發的程度,再把這些激發值交給線性分類器。這就是圖 1 的抬升想法,只是改用一小組明確的特徵。
RBF 網路計算
其中 是 個中心, 決定每座山丘的寬度, 是輸出權重, 是偏差。Moody 與 Darken 提出經典的兩階段訓練 [10]:先不使用標籤放置中心,例如用 -means 分群(PR 07);中心固定後,輸出權重就是一般的線性最小平方或邏輯斯迴歸問題。Park 與 Sandberg 證明 RBF 網路是萬能近似器:只要中心夠多,就能在緊緻集合上任意逼近任何連續函數 [11]。
和前面的核機器比較:核 SVM 等於在每個支持向量上放一座山丘,由間隔準則決定;RBF 網路則使用 座山丘,位置來自分群(若所有參數一起訓練,則來自梯度下降),所以預測很便宜。它的弱點是非監督地放置中心時忽略了標籤,中心可能浪費在兩類根本不相接的地方。
程式碼 · Python · 24 行
import numpy as np
from sklearn.cluster import KMeans
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

X, y = make_moons(n_samples=500, noise=0.18, random_state=2)
Xtr, Xte, ytr, yte = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=2)
scaler = StandardScaler().fit(Xtr)
Xtr, Xte = scaler.transform(Xtr), scaler.transform(Xte)

M, gamma, lam = 12, 1.0, 1e-3
centers = KMeans(M, n_init=10, random_state=0).fit(Xtr).cluster_centers_

def design(X):  # N x (M+1): Gaussian bumps plus a bias column
    d2 = ((X[:, None, :] - centers[None, :, :]) ** 2).sum(-1)
    return np.c_[np.exp(-gamma * d2), np.ones(len(X))]

Phi = design(Xtr)
t = 2.0 * ytr - 1.0                      # targets in {-1, +1}
w = np.linalg.solve(Phi.T @ Phi + lam * np.eye(M + 1), Phi.T @ t)
pred = (design(Xte) @ w > 0).astype(int)
print("RBF network test accuracy:", round((pred == yte).mean(), 4))
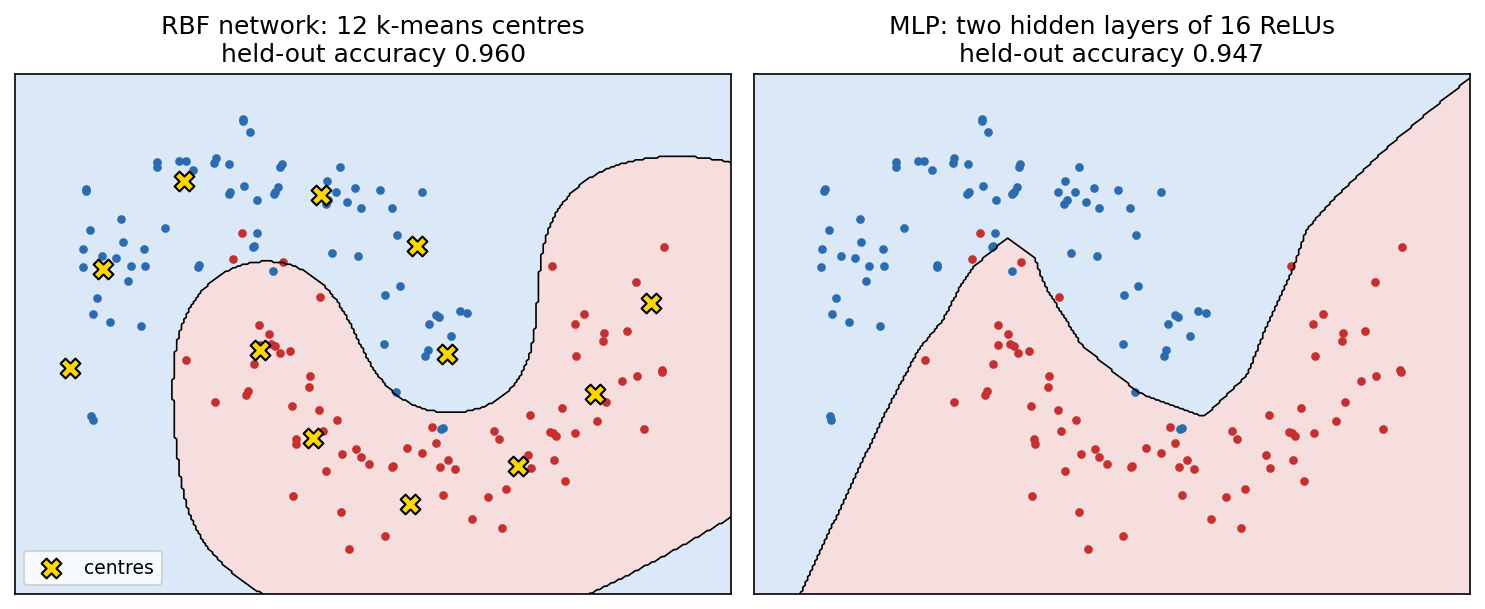
十二座山丘加上最小平方輸出層,在雙月形切分上得到 0.953 的測試準確率,和保留數十個支持向量的 RBF-SVM 相當。圖 5 左邊是同樣的網路改用邏輯斯輸出層的結果。
決策樹
白話版。 決策樹和資料玩「二十個問題」。每個問題只看一個特徵,問「它是否不超過這個門檻?」每個答案把點送往左邊或右邊,直到抵達一片帶有標籤的葉節點。樹是貪婪地長出來的:每一步都挑出能讓分出來的兩群盡可能「純」的那個問題。
不純度準則
設某個節點中的訓練點類別比例為 (節點中屬於各類別 的點所占比例)。不純度函數在某一類占據全部點時為零,在各類均勻混合時最大。三種標準選擇為
Gini 指標是從節點中隨機(取後放回)抽兩個點、它們標籤不同的機率。熵(entropy)是標籤在資訊理論意義下的不確定度,單位是位元。誤分類率是節點以多數類別作為預測時的錯誤率。圖 4 左邊畫出兩類情況下的三者。
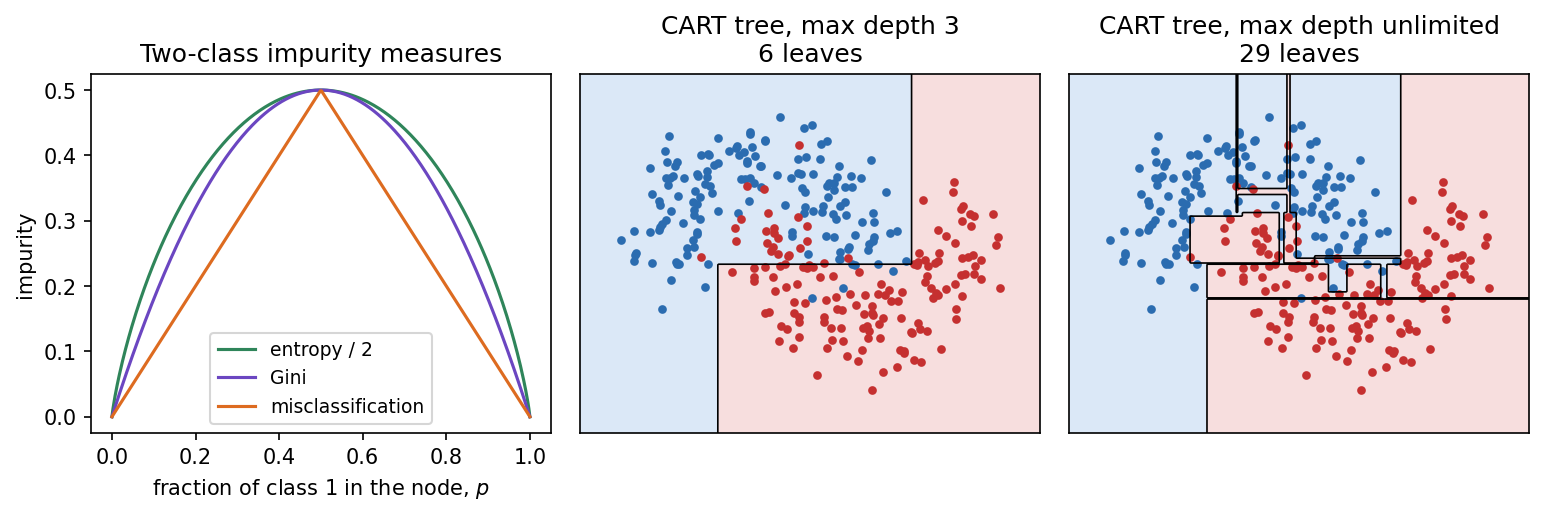
Gini 與熵都是嚴格凹函數,因此切分節點永遠不會讓它們的加權平均變大。誤分類率是分段線性的,當一次切分讓子節點更純、卻沒有改變任何子節點的多數類別時,它常常無法給予獎勵。這就是為什麼生長樹時用 Gini 或熵,評估時才用錯誤率。
長一棵樹:CART 演算法
Breiman、Friedman、Olshen 與 Stone 的 CART 程序 [12] 由上而下生長二元樹。在點集為 的節點,它考慮每個特徵 與相鄰觀測值之間的每個門檻 ,把 分成 與 ,並選擇不純度下降量最大的切分:
其中 是所選的不純度, 是集合中的點數。接著對兩個子節點遞迴,直到停止規則成立(節點已純、節點太小、達到最大深度)。Quinlan 的 ID3 [13] 是近親:它使用熵,把 稱為資訊增益(information gain),並對類別型特徵做多路切分。
下面的程式以暴力法找出最佳根節點切分,並和 scikit-learn 比對;scikit-learn 的 DecisionTreeClassifier 實作的是最佳化過的 CART。
程式碼 · Python · 26 行
import numpy as np
from sklearn.datasets import make_moons
from sklearn.tree import DecisionTreeClassifier

def gini(labels):
    p = np.bincount(labels, minlength=2) / len(labels)
    return 1.0 - (p ** 2).sum()

def best_split(X, y):
    best = (np.inf, None, None)
    for j in range(X.shape[1]):
        values = np.unique(X[:, j])
        for thr in (values[:-1] + values[1:]) / 2:
            left = X[:, j] <= thr
            n_l, n_r = left.sum(), (~left).sum()
            score = (n_l * gini(y[left]) + n_r * gini(y[~left])) / len(y)
            if score < best[0]:
                best = (score, j, thr)
    return best

X, y = make_moons(n_samples=300, noise=0.25, random_state=1)
score, j, thr = best_split(X, y)
root = DecisionTreeClassifier(max_depth=1).fit(X, y).tree_
print(f"ours: feature {j}, threshold {thr:.4f}, weighted Gini {score:.4f}")
print(f"sklearn: feature {root.feature[0]}, threshold {root.threshold[0]:.4f}")
assert j == root.feature[0] and np.isclose(thr, root.threshold[0])
兩者都選擇特徵 1、門檻 0.0547,把不純度從根節點的 0.5 降到加權後的 0.287。
剪枝與樹的性格
一棵長到每片葉子都純的樹會把訓練集背下來(圖 4 右)。CART 的解法是成本複雜度剪枝(cost-complexity pruning)[12]:先長一棵大樹 ,再對每個由合併內部節點得到的子樹 計算
其中 是訓練誤分類率, 是葉節點數, 是複雜度的價格。增加 會得到一串巢狀、越來越小的樹;再以交叉驗證選擇 (scikit-learn 中的 ccp_alpha)。
樹有鮮明的性格。它不需要特徵標準化,能處理數值與類別混合的輸入,若某個無關特徵從未幫上切分就會被忽略,還能產生人看得懂的規則。它的邊界是軸對齊的階梯,所以斜的邊界要花很多次切分。它也不穩定:資料的小變動可能改變根節點的切分,進而改變整棵樹。把許多隨機化的樹平均起來(bagging、隨機森林),或依序加入(boosting),可以解決不穩定的問題,這是 PR 09 的主題。
多層感知器作為非線性分類器
白話版。 多層感知器(multilayer perceptron, MLP)就像把 RBF 網路的山丘換成學習得到的「斜坡」,而且斜坡本身是從標籤學來的。每個隱藏單元畫一條線;下一層把這些線組合成彎曲的區域。
對 個類別,單一隱藏層的 MLP 計算
其中 把 個輸入映射到 個隱藏單元, 是逐元素的非線性函數(ReLU 、logistic 或 ), 把隱藏單元映射到各類分數。所有權重以梯度下降最小化交叉熵、共同訓練,梯度由反向傳播計算 [14]。和前面所有方法不同,特徵()與分類器都從標籤學來。Cybenko [15] 與 Hornik [16] 的萬能近似定理保證:只要單元夠多,單一隱藏層就能在緊緻集合上逼近任何連續函數;但定理沒有說需要多少單元,也沒有說梯度下降一定找得到它們。從神經元、激活函數到反向傳播與訓練技巧的完整內容在 ML 02;影像分類的版本在 IP 13。
從幾何上看,使用 ReLU 時每個隱藏單元以一個超平面切開輸入空間,網路輸出在切出的各個區塊上是分段線性的,所以圖 5 中 MLP 的邊界由直線段組成。
程式碼 · Python · 16 行
from sklearn.datasets import make_moons
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = make_moons(n_samples=500, noise=0.18, random_state=2)
Xtr, Xte, ytr, yte = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=2)
for hidden in [(2,), (16,), (16, 16)]:
    mlp = make_pipeline(
        StandardScaler(),
        MLPClassifier(hidden_layer_sizes=hidden, alpha=1e-3,
                      max_iter=3000, random_state=0))
    mlp.fit(Xtr, ytr)
    print(hidden, "test accuracy:", round(mlp.score(Xte, yte), 4))
只有兩個隱藏單元時,網路只能把邊界彎一次,準確率 0.833。十六個單元達到 0.947,再加第二層 16 個單元在這個簡單的二維問題上沒有幫助。深度在影像這類高維輸入上才顯出價值,因為它讓網路能層層建構特徵(ML 03)。
如何在非線性分類器之間選擇
| 方法 | 邊界形狀 | 訓練成本 | 預測成本 | 主要超參數 | 典型優點 |
|---|---|---|---|---|---|
| -NN | 任意;順著資料 | 無(儲存資料) | 每次查詢 | 、度量、尺度 | 簡單的基準;搭配好的嵌入時效果好 |
| 核 SVM | 平滑(RBF) | 約 – | 、核、 | 中小型資料、理論完整 | |
| 高斯過程 | 平滑,附不確定度 | 精確解 | 平均 、變異數 | 核;以邊際概似設定 | 校準良好的不確定度(迴歸) |
| RBF 網路 | 平滑、局部 | 分群 + 線性求解 | 、 | 預測便宜 | |
| 決策樹 | 軸對齊方塊 | 每層 | 深度、葉大小、 | 可解釋;可處理混合型特徵 | |
| MLP | 分段線性(ReLU) | 迭代式 SGD | 寬度、深度、權重衰減、學習率 | 可擴展到大型資料;自行學習特徵 |
其中 是支持向量數, 是 RBF 中心數。複雜度欄位是數量級,不是精確計數。沒有任何一列在所有情況下都勝出。請在同一套驗證流程下比較候選方法,並記住網格搜尋範例的教訓:單一切分上不到一個百分點的差異,很少是真的。
現代觀點
從 1990 年代末到 2012 年左右深度網路接手大規模感知任務之前,核方法主導了圖形識別。它們並沒有消失,而是換了角色。以下六條線索勾勒出目前的樣貌。
經典領域的綜述。 Hofmann、Schölkopf 與 Smola 發表於 Annals of Statistics 的綜述 [7] 是核方法的標準地圖:正定核與其 RKHS、表示定理、為字串與圖等結構化資料建構核,以及大間隔背後的統計學習理論。Cervantes 等人 [19] 從應用面綜述 SVM 分類:在基本 SVM 表現不佳之處發展出的變體(非常大的資料集、多類別、類別不平衡)、與演化式參數搜尋的結合、大量應用案例,以及方法本身的限制。關於決策樹,Costa 與 Pedreira [20] 圍繞任何預測學習器的三個目標來回顧近年的研究:擬合訓練資料、推廣到訓練資料之外,以及保持可解釋性。
讓核方法擴展。 Gram 矩陣 的記憶體需求曾是主要障礙。Rahimi 與 Recht 的隨機特徵 [17] 以一個明確的隨機映射 近似 RBF 這類平移不變核,使 ,於是在 個隨機特徵上的線性模型就能代替核機器。Liu 等人的綜述 [18] 整理了十年來的後續研究:隨機特徵的取樣方式、達到給定精度需要多少特徵的理論,以及與深度網路的關聯。把這類近似與 GPU 線性代數結合,FALKON 系列研究能在數十億個點上訓練核嶺迴歸 [23];GPyTorch [24] 則以迭代式的矩陣–矩陣求解,讓精確與近似的高斯過程推論在 GPU 上變得實用。
以核的角度看深度學習。 Jacot、Gabriel 與 Hongler 證明:在適當尺度下的無限寬度極限中,以梯度下降訓練神經網路等價於使用固定神經正切核(neural tangent kernel)的核迴歸 [21]。Belkin、Ma 與 Mandal 指出,深度學習中令人困惑的現象,例如完全擬合訓練資料卻仍能推廣,在核機器中同樣會出現,因此理解核是理解深度網路的前提 [22]。真實的有限寬度網路確實會學習特徵,這是固定的核做不到的,所以這個類比是理論工具,而不是替代品。
樹仍然稱霸表格資料。 對於表格資料(由異質量測構成的資料列,而非像素或文字),Grinsztajn、Oyallon 與 Varoquaux 在 45 個中型資料集上比較樹集成與深度架構,發現樹模型仍然領先,並把差距歸因於神經網路對無資訊特徵較敏感、具有旋轉不變性,以及偏好平滑函數 [25]。最新的挑戰者是表格基礎模型:TabPFN 是一個在數百萬個合成資料集上訓練的 transformer,只要一次前向傳播就能對新的小型資料集做預測。作者報告它在樣本數至多 10,000 的資料集上勝過先前的方法,包括經過調參的梯度提升樹集成,而且訓練時間少得多 [26]。
在學習到的特徵上找鄰居。 最近鄰規則作為大型預訓練嵌入之上的分類器,重新受到重視。一旦特徵夠好,-NN 或 cosine 相似度分類器往往是最簡單又強的基準,而且不必重新訓練就能加入新類別。IP 13 與 ML 06 討論了這種做法。
未解問題。 精確的核方法與 GP 在 上的擴展性仍然不佳,近似品質與速度之間的取捨仍是活躍的研究方向 [18]。為結構化資料選擇核大多仍靠人工。單棵樹依然不穩定,而全域最佳的樹計算代價很高 [20]。至於表格資料,基礎模型式的方法能否在小型資料集以外取代調好參數的樹集成,到 2026 年仍是開放問題。
重點整理
- 非線性邊界來自三個想法:和儲存樣本比較(-NN)、抬升到線性規則可行的特徵空間(核、RBF 網路、MLP),或切割空間(樹)。
- -NN 的行為由度量與尺度決定的程度不亞於 ;對單位向量而言,歐氏與 cosine 鄰居相同。
- 一個核有效,若且唯若每個 Gram 矩陣都對稱半正定(Mercer 條件)。核技巧在任何以內積寫成的演算法中,把內積換成核值。
- 軟間隔 SVM 最小化 加上 倍的鉸鏈損失。它的對偶問題只透過核依賴資料,只有支持向量()影響預測。在標準化的特徵上,以交叉驗證同時調整 與 。
- GP 給出附帶不確定度的核預測;RVM(Tipping)給出稀疏的機率式核模型。SVM 分數不是機率。
- RBF 網路使用少數明確的高斯山丘;樹依不純度下降(Gini 或熵)貪婪生長,需要剪枝;MLP 自行學習特徵,詳見 ML 02。
- 沒有哪個家族處處勝出:中小型平滑問題用核,表格資料用樹及其集成,原始感知資料用深度網路,好的嵌入之上用近鄰。
練習
- 距離與 cosine。 推導單位向量的 ,並證明歐氏距離下的 1-NN 等於 cosine 相似度下的 1-NN。若向量沒有正規化,結論還成立嗎?
提示
展開 。單位長度時,距離是 的遞減函數,所以一者的最小值就是另一者的最大值。沒有正規化時長度會介入:一個方向稍有不同的長向量,在歐氏距離上可能比方向完全一致的短向量更近。
- 建構核。 寫出 中 的特徵映射,藉此證明它是有效的核。再用組合規則論證高斯核 是有效的。
提示
。對高斯核,寫成 。中間的因子是有效(縮放過的線性)核取 ,外側兩個因子構成 的形式。
- 的極限。 對固定的有限資料集,當 與 時,RBF Gram 矩陣分別趨近什麼?把兩個極限分別對應到圖 2 最左與最右的欄。
提示
時每個元素都趨近 1(全為 1 的矩陣):所有點看起來都一樣,邊界變得近乎線性或常數。 時非對角元素趨近 0,:每個點只和自己相似,SVM 可以背下每個訓練標籤,也就是「小島」的情形。
- 支持向量與成本。 一個在 100,000 張影像上訓練的 RBF-SVM,保留了 90% 的影像作為支持向量。這代表資料有什麼特性?預測時間會如何?請提出兩個可以嘗試的做法。
提示
許多點落在間隔內或被分錯:類別在這個特徵空間中嚴重重疊,或是 太小、 選得不好。每次預測需要約 90,000 次核計算。可以重新調整 與 、改善特徵、改用隨機特徵加線性 SVM,或換一個模型家族。
- 手算不純度。 某節點有 40 個 A 類點與 40 個 B 類點。切分 1 得到子節點 (30 A, 10 B) 與 (10 A, 30 B);切分 2 得到 (40 A, 20 B) 與 (0 A, 20 B)。計算兩種切分的誤分類率下降量與 Gini 下降量。兩種準則各偏好哪一個切分?
提示
根節點 Gini ,錯誤率 。切分 1:兩個子節點的錯誤率都是 ,Gini 都是 ;加權錯誤率 ,加權 Gini 。切分 2:左子節點錯誤率 ,Gini ;右子節點是純的。加權錯誤率 ,加權 Gini 。錯誤率無法區分兩者(都是 0.25);Gini 偏好切分 2,因為它產生了純節點。
- 設計 RBF 網路。 在 RBF 網路的程式中,改變 與 。哪些組合欠擬合、哪些過擬合?為什麼 小而 大的組合表現很差?
提示
中心少而 大時,山丘很窄,大多數點幾乎不激發任何一座,設計矩陣在遠離中心處近乎為零,分類器只能退回偏差項。中心多且 大時,行為開始像正則化不足的核機器。
參考文獻
-
S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2009, Chapters 2 and 4. publisher page
-
C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006, Sections 2.5.2, 5.1–5.3, 6.1–6.4, 7.1–7.2 and 14.4. official book page and PDF
-
T. Cover and P. Hart, “Nearest Neighbor Pattern Classification,” IEEE Transactions on Information Theory, vol. 13, no. 1, pp. 21–27, 1967. doi:10.1109/TIT.1967.1053964
-
J. Mercer, “Functions of Positive and Negative Type, and Their Connection with the Theory of Integral Equations,” Philosophical Transactions of the Royal Society of London, Series A, vol. 209, pp. 415–446, 1909. doi:10.1098/rsta.1909.0016
-
B. E. Boser, I. M. Guyon, and V. N. Vapnik, “A Training Algorithm for Optimal Margin Classifiers,” Proceedings of the Fifth Annual Workshop on Computational Learning Theory (COLT), pp. 144–152, 1992. doi:10.1145/130385.130401
-
C. Cortes and V. Vapnik, “Support-Vector Networks,” Machine Learning, vol. 20, pp. 273–297, 1995. doi:10.1007/BF00994018
-
T. Hofmann, B. Schölkopf, and A. J. Smola, “Kernel Methods in Machine Learning,” The Annals of Statistics, vol. 36, no. 3, 2008. doi:10.1214/009053607000000677
-
C. E. Rasmussen and C. K. I. Williams, Gaussian Processes for Machine Learning, MIT Press, 2006. book page
-
M. E. Tipping, “Sparse Bayesian Learning and the Relevance Vector Machine,” Journal of Machine Learning Research, vol. 1, pp. 211–244, 2001. JMLR
-
J. Moody and C. J. Darken, “Fast Learning in Networks of Locally-Tuned Processing Units,” Neural Computation, vol. 1, no. 2, pp. 281–294, 1989. doi:10.1162/neco.1989.1.2.281
-
J. Park and I. W. Sandberg, “Universal Approximation Using Radial-Basis-Function Networks,” Neural Computation, vol. 3, no. 2, pp. 246–257, 1991. doi:10.1162/neco.1991.3.2.246
-
L. Breiman, J. H. Friedman, R. A. Olshen, and C. J. Stone, Classification and Regression Trees, Chapman and Hall/CRC, 2017 edition. doi:10.1201/9781315139470
-
J. R. Quinlan, “Induction of Decision Trees,” Machine Learning, vol. 1, pp. 81–106, 1986. doi:10.1007/BF00116251
-
D. E. Rumelhart, G. E. Hinton, and R. J. Williams, “Learning Representations by Back-Propagating Errors,” Nature, vol. 323, pp. 533–536, 1986. doi:10.1038/323533a0
-
G. Cybenko, “Approximation by Superpositions of a Sigmoidal Function,” Mathematics of Control, Signals, and Systems, vol. 2, pp. 303–314, 1989. doi:10.1007/BF02551274
-
K. Hornik, “Approximation Capabilities of Multilayer Feedforward Networks,” Neural Networks, vol. 4, no. 2, pp. 251–257, 1991. doi:10.1016/0893-6080(91)90009-T
-
A. Rahimi and B. Recht, “Random Features for Large-Scale Kernel Machines,” Advances in Neural Information Processing Systems 20 (NIPS), 2007. paper
-
F. Liu, X. Huang, Y. Chen, and J. A. K. Suykens, “Random Features for Kernel Approximation: A Survey on Algorithms, Theory, and Beyond,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 44, no. 10, pp. 7128–7148, 2022. doi:10.1109/TPAMI.2021.3097011
-
J. Cervantes, F. Garcia-Lamont, L. Rodríguez-Mazahua, and A. Lopez, “A Comprehensive Survey on Support Vector Machine Classification: Applications, Challenges and Trends,” Neurocomputing, vol. 408, pp. 189–215, 2020. doi:10.1016/j.neucom.2019.10.118
-
V. G. Costa and C. E. Pedreira, “Recent Advances in Decision Trees: An Updated Survey,” Artificial Intelligence Review, vol. 56, pp. 4765–4800, 2023. doi:10.1007/s10462-022-10275-5
-
A. Jacot, F. Gabriel, and C. Hongler, “Neural Tangent Kernel: Convergence and Generalization in Neural Networks,” NeurIPS, 2018. arXiv:1806.07572
-
M. Belkin, S. Ma, and S. Mandal, “To Understand Deep Learning We Need to Understand Kernel Learning,” arXiv:1802.01396, 2018. arXiv
-
G. Meanti, L. Carratino, L. Rosasco, and A. Rudi, “Kernel Methods Through the Roof: Handling Billions of Points Efficiently,” Advances in Neural Information Processing Systems 33 (NeurIPS), 2020. paper
-
J. R. Gardner, G. Pleiss, D. Bindel, K. Q. Weinberger, and A. G. Wilson, “GPyTorch: Blackbox Matrix-Matrix Gaussian Process Inference with GPU Acceleration,” NeurIPS, 2018. arXiv:1809.11165
-
L. Grinsztajn, E. Oyallon, and G. Varoquaux, “Why Do Tree-Based Models Still Outperform Deep Learning on Typical Tabular Data?,” Advances in Neural Information Processing Systems 35 (NeurIPS), Datasets and Benchmarks Track, 2022. paper
-
N. Hollmann, S. Müller, L. Purucker, A. Krishnakumar, et al., “Accurate Predictions on Small Data with a Tabular Foundation Model,” Nature, vol. 637, pp. 319–326, 2025. doi:10.1038/s41586-024-08328-6
-
scikit-learn developers, “Support Vector Machines,” user guide, accessed 2026-11-05. documentation
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 05・特徵選擇、轉換與降維 · 22 分鐘