PR 08・近似推論與貝氏模型複雜度
先備知識:PR 07・分群、混合模型與 EM
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
圖形識別
你將學到
- 為什麼貝氏後驗在差一個常數的意義下很容易「計算」,卻很難「積分」;以及為什麼網格法在幾個維度之後就失效。
- 普通 Monte Carlo、拒絕取樣(rejection sampling)與重要性取樣(importance sampling)如何把積分變成平均,以及如何判斷權重已經崩潰。
- 馬可夫鏈 Monte Carlo(MCMC)如何運作:細緻平衡(detailed balance)、Metropolis–Hastings(含非對稱提議的修正項)、Gibbs 取樣、Hamiltonian Monte Carlo,以及讓你保持誠實的診斷工具(、有效樣本數)。
- 變分推論(variational inference)如何把積分變成最佳化:用兩種方法推導證據下界(ELBO)、mean-field 座標上升、反向與正向 KL 的差別,以及搭配重參數化技巧(reparameterization trick)的隨機梯度。
- Laplace 近似與期望傳播(expectation propagation)的定位、模型證據如何懲罰複雜度,以及同樣的想法如何驅動 VAE 與擴散模型。
先看全貌
前面的章節都在找一組「最好」的參數:最大概似、MAP,或混合模型的 EM。貝氏辨識系統問的是更大的問題:看過資料之後,每一組參數各有多可信?把它們全部考慮進來,平均會預測什麼?回答這個問題需要對所有未知量積分,而幾乎所有實用模型的積分都沒有閉式解。本章介紹兩大類替代方案:抽樣,產生行為像後驗的樣本;或擬合一個較簡單、但盡量貼近後驗的分布。
為什麼對辨識很重要:不確定性告訴系統何時該拒絕判斷(見 PR 01);積分後的證據可以在沒有保留驗證集的情況下比較模型;而本章的工具,尤其是 ELBO 與 Langevin 式取樣,正是現代生成模型所用的方法。本章依循 Bishop 關於近似推論與取樣的章節 [1];Theodoridis 與 Koutroumbas 則提供估計與最佳化的背景(第 2 章與附錄 C),並非與本章方法一一對應 [2]。
為什麼精確推論很難
白話版。 貝氏定理說:後驗等於「先驗乘以概似,再除以一個正規化的數」。分子對任何單一猜測通常都好算;分母卻是對所有可能猜測的總和,麻煩就從這裡開始。
精確版。 把所有未知量(潛在變數與參數)合記為 ,觀測資料記為 ,則
其中 是聯合密度(概似乘以先驗), 是證據(evidence),又稱邊際概似。我們想要的幾乎都是後驗下的期望值:
例如後驗平均()、預測機率(),或某參數為正的機率()。以下記 為未正規化後驗:逐點計算很便宜,但正規化常數 未知。
積分困難有三個原因:
- 維度。 每軸 個點的網格在 維需要 次計算。、 時約為 ,遠超任何電腦的能力。
- 集中。 資料多時,後驗只占廣大空間中極小的區域,隨機猜測幾乎永遠落不進去。
- 離散結構。 有 個成分、 個點的混合模型,潛在指派有 種組合;即使每一項都很簡單,也無法精確加總。
MAP 估計藉由最大化 繞過這些困難,但最大值不是積分。後驗的最高點可能位於一個很窄、質量很少的尖峰上,而單一點完全不帶有分散程度的資訊。PR 07 的 EM 介於兩者之間:它在 E step 對潛在指派積分(高斯混合可以精確做到),但最後仍回傳參數的點估計。
實例:貝氏邏輯斯迴歸
考慮二類問題,輸入 (一個偏差特徵與一個量測值),標籤 ,權重 ,模型為
對數聯合密度為 加上常數。高斯先驗與邏輯斯概似不共軛,因此後驗不是高斯,正規化常數也沒有公式。只有兩個權重時,我們仍可以用網格暴力計算,得到一個可以拿來檢驗所有近似方法的標準答案。
程式碼 · Python · 25 行
import numpy as np

rng = np.random.default_rng(0)
n = 40
X = np.c_[np.ones(n), rng.normal(size=n)]
w_true = np.array([-0.5, 1.5])
y = rng.random(n) < 1 / (1 + np.exp(-X @ w_true))

def log_joint(w):                       # log p(y | X, w) + log p(w), w ~ N(0, 2^2 I)
    s = X @ w
    return np.sum(y * s - np.logaddexp(0, s)) - 0.5 * np.sum(w**2) / 4.0

# Brute-force normalization on a grid: fine in 2-D, hopeless in 50-D.
g = np.linspace(-4, 4, 201)
W0, W1 = np.meshgrid(g, g, indexing="ij")
logp = np.array([[log_joint(np.array([a, b])) for b in g] for a in g])
cell = (g[1] - g[0])**2
log_evidence = np.log(np.sum(np.exp(logp - logp.max())) * cell) + logp.max()
post = np.exp(logp - log_evidence)
mean = np.array([np.sum(W0 * post), np.sum(W1 * post)]) * cell
sd = np.sqrt(np.array([np.sum((W0 - mean[0])**2 * post),
                       np.sum((W1 - mean[1])**2 * post)]) * cell)
print("log evidence:", round(log_evidence, 3))
print("posterior mean:", mean.round(3), " sd:", sd.round(3))
print("grid points for 201 per axis in 50-D:", f"{201.0**50:.2e}")
輸出的對數證據為 ,後驗平均為 ,標準差為 。注意取指數前先減去 logp.max():真實資料的對數密度是很大的負數,在對數空間運算(log-sum-exp 技巧)是每位實作者的第一個習慣。稍後我們會用同一個模型來評估 Laplace 與變分近似。
Monte Carlo:把積分變成平均
白話版。 如果能從某個分布抽出隨機樣本,那麼某個量在這些樣本上的平均,就能估計它的期望值。樣本越多估計越準,而誤差縮小的速度可以預測,而且與維度無關。
精確版。 給定獨立樣本 , 的 Monte Carlo 估計量為
其中 是樣本數, 是 在 下的變異數。假設 有限,估計量就是不偏的;上面的變異數與 標準誤敘述,還需要 有限:誤差要減半,樣本要變四倍。最驚人的是式中沒有 。收斂速率的指數不直接依賴維度,但 的變異數與取得每個樣本的成本仍可能隨維度增加。若重尾量具有無限變異數,就沒有這項標準誤保證。
問題在於「從 抽樣」這個假設。後驗通常無法直接抽樣。本章取樣部分的其餘內容,就是在製造這樣的樣本,或修正從錯誤分布抽出的樣本。
拒絕取樣
假設我們能從簡單的提議分布(proposal) 抽樣,並知道常數 使得對所有 都有 。抽 與 ,若 就保留 。保留下來的點正是來自 的精確樣本,因為包絡 底下被接受的區域形狀恰好就是 。接受機率為 ,其中 。在高維空間,可用的包絡必須比目標大上許多,幾乎所有樣本都會被拒絕。因此拒絕取樣是處理一維條件分布(例如在 Gibbs 取樣器內部)的積木,而不是通用的後驗引擎 [1]。
重要性取樣
白話版。 從一個方便的分布抽樣,再給每個樣本一個權重,說明它在你真正關心的分布下比較可能(或比較不可能)多少。當方便的分布涵蓋重要區域時效果很好;涵蓋不到時,它會默默地失敗。
精確版。 對任何在 之處都滿足 的 ,
比值 稱為重要性權重。若只有 可用,把權重正規化就能消去未知的 :
自我正規化與證據估計需要更強的支撐條件:凡 之處都必須有 ,包含 的區域,因為分母必須涵蓋整個目標分布的質量。否則正規化後估計的是截斷分布,而不是原本的後驗。
這個自我正規化(self-normalized)估計量在 有限時通常有偏差,但當 時一致。附帶的好處是 是證據 的不偏估計,這就是重要性取樣用於模型比較的方式。
估計的品質取決於權重有多不均勻。常用的摘要是權重的有效樣本數(effective sample size, ESS):
所有權重相等時為 ,一個權重獨占全部時為 。有兩種失敗模式值得注意:
- 提議分布太窄或放錯位置。 有質量而 很小的區域,會產生罕見但巨大的權重。估計被少數樣本主導,變異數甚至可能是無限大。
- 尾部太輕。 比值 在尾部必須有界。經驗法則是讓 的尾部比 更重(用 Student- 取代高斯,或用更寬的高斯)。
程式碼 · Python · 28 行
import numpy as np
from scipy.stats import norm

rng = np.random.default_rng(1)
N = 10_000
exact = norm.sf(3.0)                      # P(X > 3) for X ~ N(0, 1)

# Plain Monte Carlo: most samples never reach the tail.
x = rng.normal(0, 1, N)
plain = np.mean(x > 3)

# Importance sampling with a proposal centered on the tail, q = N(3, 1).
z = rng.normal(3, 1, N)
w = norm.pdf(z) / norm.pdf(z, loc=3)      # p(z) / q(z)
is_est = np.mean(w * (z > 3))
print(f"exact {exact:.6f}  plain MC {plain:.6f}  importance {is_est:.6f}")

# Self-normalized IS for an unnormalized target, with effective sample size.
def log_p_tilde(t):                       # N(1.5, 0.7^2) without its constant
    return -0.5 * ((t - 1.5) / 0.7) ** 2

for scale in [1.0, 3.0, 0.3]:
    t = rng.normal(0, scale, N)
    log_w = log_p_tilde(t) - norm.logpdf(t, scale=scale)
    wn = np.exp(log_w - log_w.max())
    wn /= wn.sum()
    ess = 1.0 / np.sum(wn**2)
    print(f"proposal N(0,{scale}^2): mean {np.sum(wn * t):.3f}  ESS {ess:7.1f} of {N}")
稀有事件的估計說明了重要性取樣存在的理由:精確的尾端機率是 ;10,000 個樣本的普通 Monte Carlo 給出 (只有 19 個樣本落在尾端),平移後的提議分布則給出 。第二部分的目標平均為 。兩個寬的提議分布給出 與 ,ESS 約為 1,870 與 2,830;窄的提議分布 給出 ,ESS 只有 13,看起來很有把握,答案卻是錯的。ESS 極小就是警鈴。
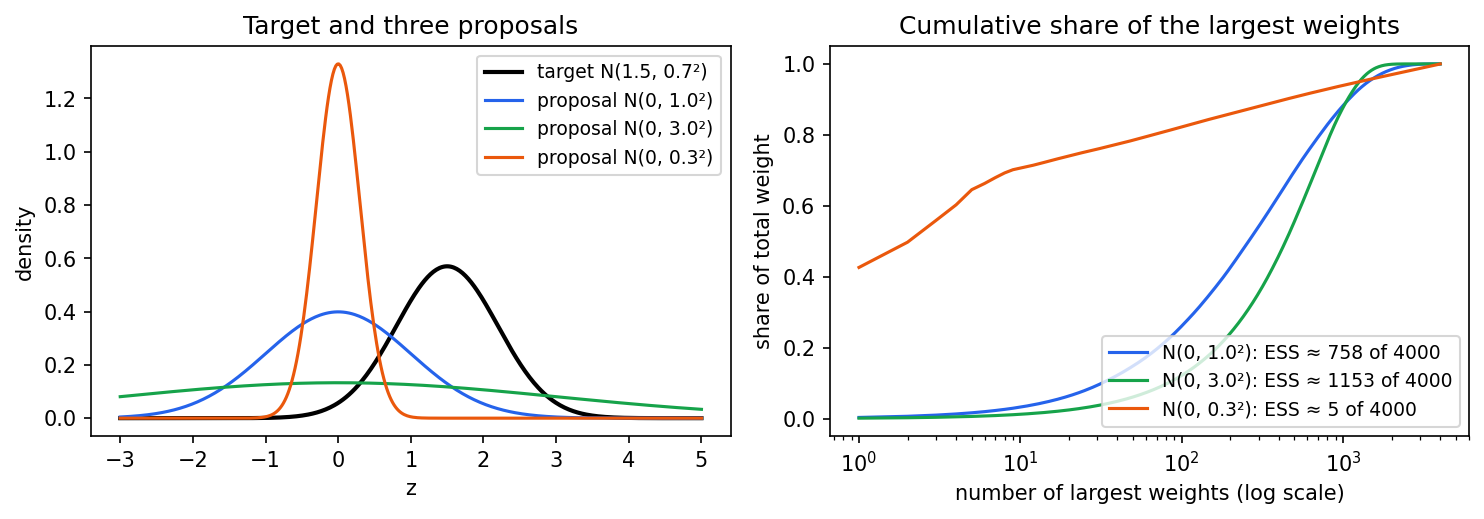
即使不是主要引擎,重要性取樣仍然很重要:它能把舊模型的樣本重新加權到新模型、能估計證據,也是序列 Monte Carlo(粒子濾波器)的核心;在序列 Monte Carlo 中,權重隨資料到來逐步更新並重新取樣。
馬可夫鏈 Monte Carlo
白話版。 不再抽獨立樣本,而是進行一場隨機漫步,並設計規則讓它長期下來在每個區域停留的時間比例,恰好等於該區域的後驗機率。這樣沿路的時間平均就能估計後驗期望值。相鄰步驟彼此相關,所以一段長漫步的價值少於同樣數量的獨立樣本。
精確版。 若轉移核 滿足
則 是此馬可夫鏈的穩態(不變)分布。一個簡單的充分條件是細緻平衡(可逆性):
兩邊對 積分即得穩態條件。若鏈還能到達每個區域(不可約)且不會週期循環(非週期),則無論從哪裡出發,狀態的分布都會收斂到 ,遍歷平均 也會收斂到 。重點是細緻平衡只涉及比值 ,因此未知的正規化常數會消去。
Metropolis–Hastings
Metropolis 演算法 [3] 經 Hastings 推廣 [4],可以從任何提議分布 建構出這樣的轉移核:
- 從目前狀態 提議 。
- 以下列機率接受:
- 若接受就移到 ;否則停在 ,並再記錄一次 。
其中 是提議反向移動的密度。因子 稱為 Hastings 修正:它抵銷提議分布對某些方向的偏好。對稱提議(例如高斯隨機漫步)滿足 ,規則就化簡為 Metropolis 原本的 。
為什麼行得通?取 ,並假設 。則 ;反方向的接受率為 1,所以 。兩邊相等,細緻平衡成立。
忘了第 3 步(只記錄被接受的狀態)是經典錯誤:它會高估鏈容易穿過的區域,讓所有估計都產生偏差。
已知動差的高斯目標可以用來檢查隨機漫步鏈。斷言刻意設得寬鬆:這是數值上的基本檢查,不是收斂證明。
程式碼 · Python · 20 行
import numpy as np

rng = np.random.default_rng(12)
def log_target(x):
    return -0.5 * ((x - 1.5) / 0.7)**2
x, accepted = -3.0, 0
samples = []
for step in range(18000):
    proposal = x + rng.normal(0, 0.8)
    if np.log(rng.random()) < min(0.0, log_target(proposal) - log_target(x)):
        x = proposal
        accepted += 1
    if step >= 2000:                      # discard warm-up, keep repeats
        samples.append(x)
samples = np.asarray(samples)
rho1 = np.corrcoef(samples[:-1], samples[1:])[0, 1]
print("mean, std:", samples.mean(), samples.std())
print("acceptance:", accepted / 18000, "lag-one correlation:", rho1)
assert abs(samples.mean() - 1.5) < 0.12
assert abs(samples.std() - 0.7) < 0.12
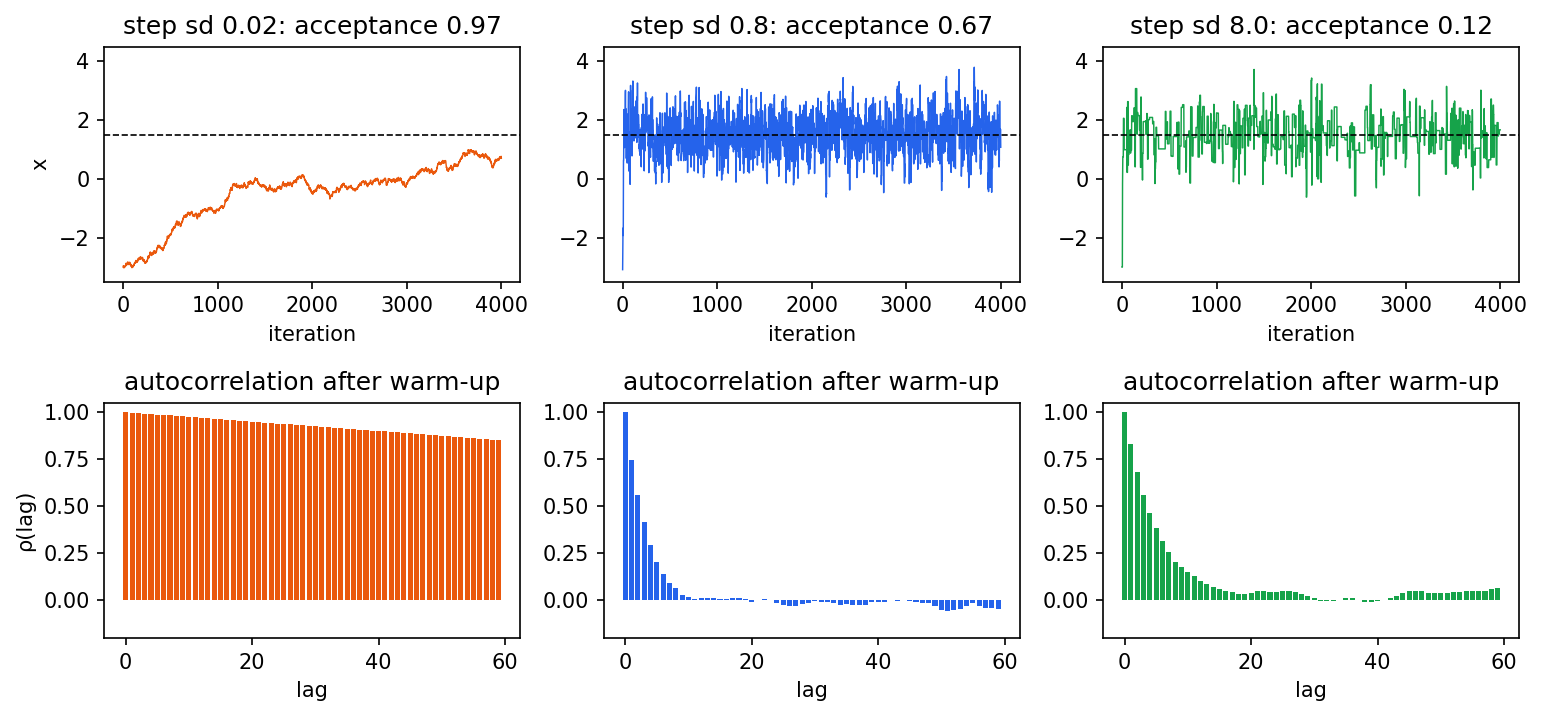
這條鏈得到平均 、標準差 ,接受率 ,lag-1 自相關 。步長是主要的調整旋鈕,而光看接受率無法判斷步長好不好。極小的步長幾乎全被接受,卻像在爬行;極大的步長大多被拒絕,鏈停在原地。兩者都會產生高度相關的樣本。
Gibbs 取樣
白話版。 一次只更新一個變數(或一個區塊),從「給定其他所有變數」的分布中抽它。如果這些條件分布很容易抽(共軛模型常是如此),每一步都會被接受。
精確版。 Gibbs 取樣由 Geman 與 Geman 為了以馬可夫隨機場做影像復原而提出 [5]。它依序走過區塊 ,並抽
其中 表示除了 以外的所有區塊。它是 Metropolis–Hastings 的特例:提議為 且 ,代入接受比恰好等於 1 [1]。以高斯混合為例,可以交替地依 responsibility 為每個點抽成分標籤,再從共軛後驗抽成分參數,這是 EM 的隨機版親戚。
對平均為零、變異數為一、相關係數為 的二維高斯,條件分布為 , 亦同。下面的程式從四個分散的角落各跑一條鏈,並計算下一小節介紹的 split- 收斂診斷。
程式碼 · Python · 31 行
import numpy as np

rng = np.random.default_rng(3)
rho = 0.85                     # target: zero-mean bivariate Gaussian, unit variances
sd = np.sqrt(1 - rho**2)       # conditional standard deviation

def gibbs(n_steps, start):
    z = np.array(start, dtype=float)
    out = np.empty((n_steps, 2))
    for t in range(n_steps):
        z[0] = rng.normal(rho * z[1], sd)   # z1 | z2 ~ N(rho z2, 1 - rho^2)
        z[1] = rng.normal(rho * z[0], sd)   # z2 | z1 ~ N(rho z1, 1 - rho^2)
        out[t] = z
    return out

def split_rhat(chains):        # chains: (m, n) draws of one scalar quantity
    m, n = chains.shape
    halves = chains[:, : n // 2 * 2].reshape(2 * m, n // 2)
    W = halves.var(axis=1, ddof=1).mean()          # within-chain variance
    B = (n // 2) * halves.mean(axis=1).var(ddof=1) # between-chain variance
    var_plus = (n // 2 - 1) / (n // 2) * W + B / (n // 2)
    return np.sqrt(var_plus / W)

starts = [(-4, -4), (4, 4), (-4, 4), (4, -4)]
chains = np.stack([gibbs(3000, s)[500:] for s in starts])   # drop warm-up
draws = chains.reshape(-1, 2)
print("sample correlation:", np.corrcoef(draws.T)[0, 1].round(3))
print("sample variances:", draws.var(axis=0).round(3))
lag1 = np.mean([np.corrcoef(c[:-1, 0], c[1:, 0])[0, 1] for c in chains])
print("lag-1 autocorrelation of z1:", lag1.round(3), " (theory rho^2 =", rho**2, ")")
print("split R-hat for z1:", split_rhat(chains[:, :, 0]).round(4))
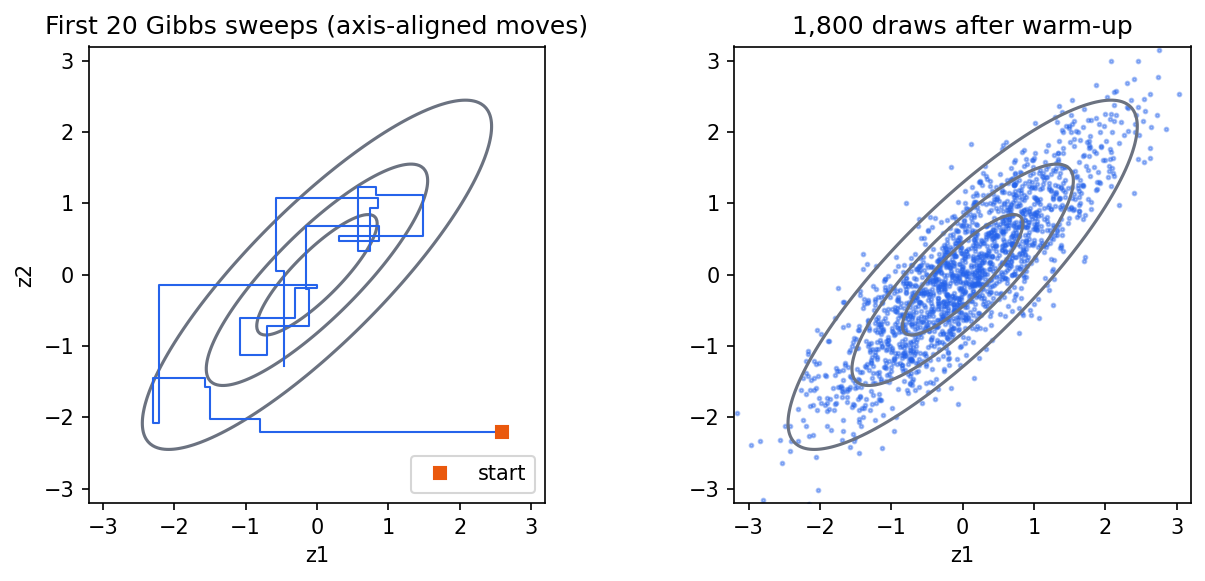
輸出:樣本相關 ,變異數約 ,lag-1 自相關 (理論值 ),split- 為 。自相關是沿座標軸移動的代價:目標是一條細長的斜脊時,每個座標只能走一小段就撞到「牆」。當 ,鏈會慢到幾乎不動。重新參數化(旋轉或白化變數),或把相關的變數當成一個區塊一起更新,就能解決這個問題。
Hamiltonian Monte Carlo
白話版。 隨機漫步把力氣浪費在來回踱步上。Hamiltonian Monte Carlo(HMC)利用對數後驗的梯度,像一顆在曲面上無摩擦滑行的冰球一樣沿著分布滑行,做出又長又有方向的移動,同時仍以很高的機率被接受。
精確版。 定義位能 ,加入輔助動量 ( 為質量矩陣),組成 Hamiltonian
Hamiltonian 動力學保持 守恆並保持體積。實作上以步長 的 個 leapfrog 步驟模擬:
leapfrog 積分器可逆且保持體積,但不完全守恆能量,因此終點 以 的機率被接受,也就是在聯合空間上的一步 Metropolis [6]。軌跡順著目標的幾何走,因此 HMC 能穿越會困住 Gibbs 或隨機漫步的相關斜脊。它的調整參數 與 很敏感;No-U-Turn Sampler(NUTS)在路徑開始折返時停止,自動決定軌跡長度,並在暖機期間調整 [7]。Betancourt 的概念性導論以典型集合(typical set,後驗質量實際所在的那層薄殼)解釋 HMC 為何能擴展到高維 [8]。HMC 需要可微、連續的目標;離散潛在變數必須先加總掉,或用其他移動方式處理。
一個近親是 Langevin 更新
它相當於重新抽動量後只走一步 leapfrog。沒有接受/拒絕步驟時,有限的 只是近似正確;加上 Metropolis 修正就成為 Metropolis-adjusted Langevin algorithm。請記住這個更新,它會在擴散模型中再次出現。
診斷:這條鏈說的是實話嗎?
有限次的執行不可能證明收斂,診斷只能揭露問題。標準做法:
- 從分散的起點跑多條鏈,並捨棄每條鏈開頭的暖機部分。
- 用 比較各鏈。 有 條(切成兩半的)長度為 的鏈,令 為鏈內變異數的平均、 為各鏈平均的變異數,則
若所有鏈探索的是同一個分布,;明顯大於 1 表示各鏈意見不一。Vehtari 等人指出傳統版本會漏掉重尾與尺度差異,並提出秩正規化(rank-normalized)、折疊的 split-,以及 bulk 與 tail 有效樣本數;這就是目前軟體所回報的版本 [9]。
- 回報有效樣本數。 對於穩態鏈,若目標量的 lag- 自相關為 ,
當估計的自相關變得雜亂時就截斷總和。Monte Carlo 標準誤大約是 ,而不是 。對上面的 Gibbs 鏈,,所以 :儲存的 10,000 個樣本約只值 1,600 個獨立樣本。
- 檢查軌跡圖;對梯度式取樣器,也要注意 divergence 警告,它標示出積分器跟不上的高曲率區域。
不同的量混合速度不同:平均看起來沒問題,尾端分位數卻可能還沒收斂。而且即使鏈混合得完美,它描述的也只是你寫下的模型的後驗,完全無法說明模型本身是否正確。
變分推論
白話版。 選一族簡單的分布(例如彼此獨立的高斯),在其中尋找最接近後驗的那一個。積分變成最佳化,速度快、能處理巨量資料,代價是一種無法靠跑更久來消除的偏差。
精確版。 選擇一族可處理的密度 ,以變分參數 編號。變分推論(VI)[10] 求解
這個 KL 含有未知的 ,無法直接計算。訣竅就是 ELBO。
用兩種方法推導 ELBO
推導一:分解。 把 代入 KL:
移項得到
與 無關,所以最大化 恰好等於最小化 KL。KL 非負,所以 :它是證據下界(evidence lower bound),簡稱 ELBO。
推導二:Jensen 不等式。 在證據積分中同乘同除 ,再利用 的凹性:
第一個等號假設 涵蓋 的支撐集。若漏掉正的聯合機率質量,期望只積分 的支撐範圍,不再等於完整證據。只要各項定義良好,推導一仍保證 ELBO 是下界;在支撐涵蓋假設下,Jensen 不等式的差距才正好是該 KL。ELBO 有一個好用的讀法:,也就是要擬合資料,但不要離先驗太遠。EM 是一個特例:在 E step 把潛在變數的 設為精確後驗(讓下界變緊),再於 M step 對參數最大化下界 [1]。
Mean field 與座標上升(CAVI)
最常見的分布族是 mean field:,即 各區塊上彼此獨立的因子。固定 以外的所有因子,對 最大化 ELBO,得到
其中 對其他所有因子取平均,常數讓 正規化。(推導方式:把 寫成只含 的函數,它等於 加上常數,其中 。)依序輪流更新各個 ,就是座標上升變分推論(CAVI)。每次更新都不會降低 ELBO,所以 CAVI 會收斂,但只收斂到局部最佳 [11]。對條件共軛的模型,每個 會與先驗同族,更新有閉式解。
實例:平均與精確度都未知的高斯。 觀測 ,先驗 、。精確後驗已知(Normal–Gamma),因此可以為近似打分數。取 ,mean-field 更新規則給出 與 ,其中 [1]
為樣本平均,。兩個因子透過 以及 、 互相依賴,所以要反覆迭代。
程式碼 · Python · 28 行
import numpy as np

# Data x_n ~ N(mu, 1/tau); prior mu | tau ~ N(mu0, 1/(lam0 tau)), tau ~ Gamma(a0, b0).
rng = np.random.default_rng(4)
x = rng.normal(2.0, 0.5, size=30)
N, xbar = len(x), x.mean()
mu0, lam0, a0, b0 = 0.0, 1.0, 1.0, 1.0

# Mean field q(mu, tau) = q(mu) q(tau) with q(mu) = N(mu_N, 1/lam_N), q(tau) = Gamma(a_N, b_N).
E_tau = a0 / b0
for it in range(50):
    mu_N = (lam0 * mu0 + N * xbar) / (lam0 + N)
    lam_N = (lam0 + N) * E_tau
    a_N = a0 + (N + 1) / 2
    E_mu, E_mu2 = mu_N, mu_N**2 + 1 / lam_N
    b_N = b0 + 0.5 * (np.sum(x**2) - 2 * E_mu * np.sum(x) + N * E_mu2
                      + lam0 * (E_mu2 - 2 * mu0 * E_mu + mu0**2))
    E_tau = a_N / b_N

# Exact posterior is Normal-Gamma: compare the marginal moments of mu.
lam_post = lam0 + N
mu_post = (lam0 * mu0 + N * xbar) / lam_post
a_post = a0 + N / 2
b_post = b0 + 0.5 * (np.sum((x - xbar) ** 2) + lam0 * N * (xbar - mu0) ** 2 / lam_post)
var_mu_exact = b_post / ((a_post - 1) * lam_post)       # Student-t marginal variance
print("E[mu]   VI %.4f  exact %.4f" % (mu_N, mu_post))
print("Var[mu] VI %.5f  exact %.5f" % (1 / lam_N, var_mu_exact))
print("E[tau]  VI %.3f   exact %.3f" % (a_N / b_N, a_post / b_post))
平均一致(皆為 ), 也一致(),但 的變異數在 VI 下是 ,精確值是 :小了約 6%。在精確後驗中, 與 相依( 的分散程度隨 縮放),其邊際分布是尾部較重的 Student-;因子化的高斯無法表達這兩種性質。
這種低估是系統性的。對精確度矩陣為 的高斯目標,最佳的 mean-field 因子 的變異數是 ,也就是條件變異數,永遠不大於邊際變異數。圖 4 顯示極端情況。
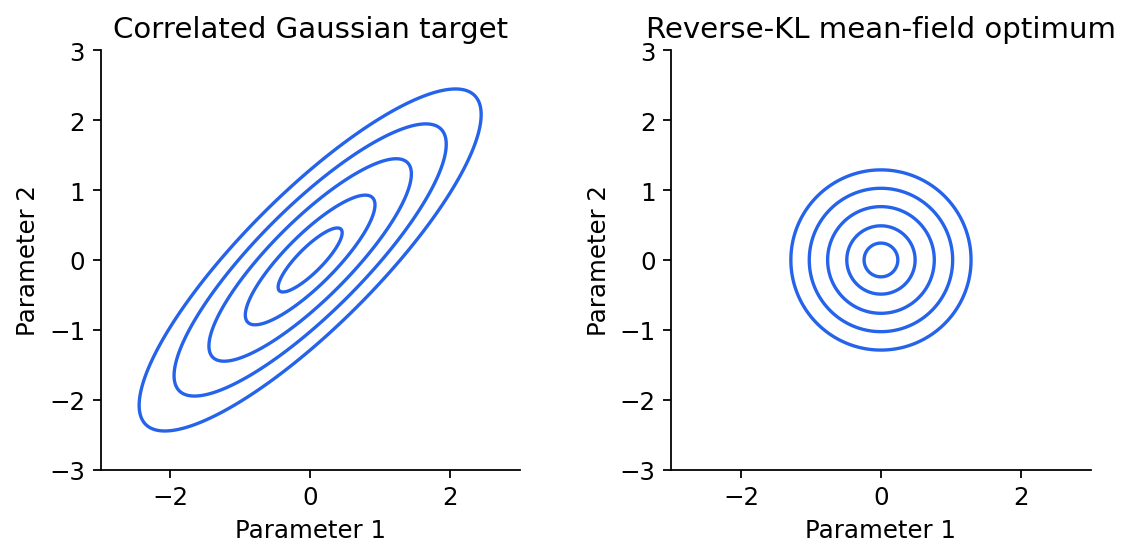
用哪個 KL?找峰與覆蓋質量
KL 不對稱,方向不同答案就不同。標準 VI 使用的反向 KL 在 下取期望:它重罰把 的質量放在 極小的地方,卻不在意 忽略 的某些部分。結果是找峰(mode seeking)且分散不足。正向 KL 在 下取期望:它重罰漏掉 有質量的任何區域,因此 會伸展開來涵蓋一切,即覆蓋質量(mass covering),也可能把質量放在峰與峰之間的低谷。在高斯這類指數族之內,最小化正向 KL 恰好就是動差匹配: 取 的平均與共變異數。
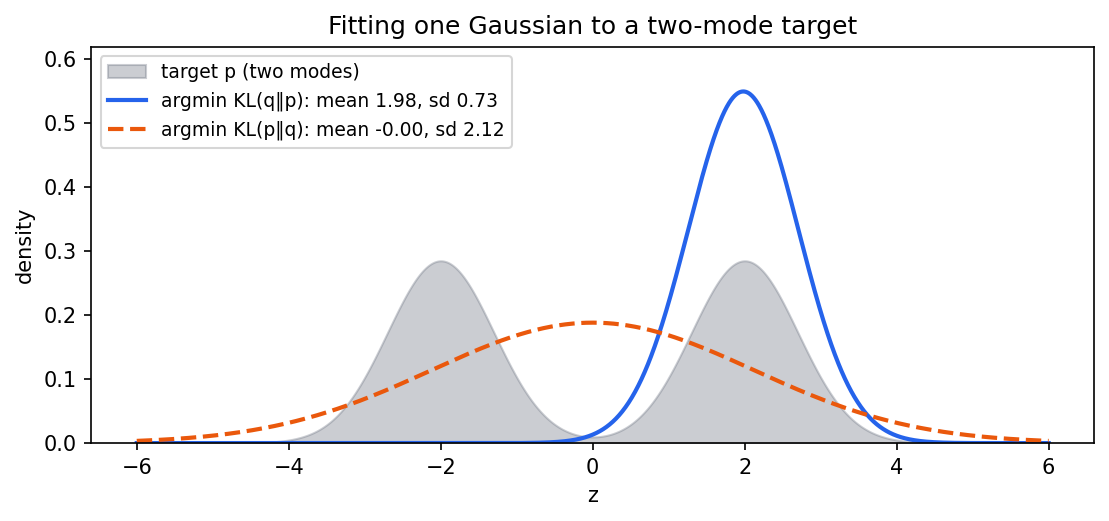
兩個方向都不是「唯一正確」的。反向 KL 好計算,答案銳利好用,但低估不確定性。正向 KL 是期望傳播背後的目標,也是以最大概似把模型擬合到資料時的目標;當漏掉一個峰的代價很高時,它比較安全。
隨機與黑箱 VI
CAVI 需要共軛性,而且每次更新都要掃過整個資料集。現代 VI 改用 ELBO 的隨機梯度,幾乎適用於任何模型,也能透過小批次(minibatch)抽樣處理大量資料 [11, 12]。 主要有兩種梯度估計量:
- Score function(REINFORCE)估計量,黑箱 VI 採用此法 [13]:
它只需要計算 ,也適用於離散的 ,但變異數高,需要控制變量(control variates)。
- 重參數化(pathwise)估計量。 把 寫成 ,其中雜訊 來自固定分布,例如 、。則
它需要 可微、 連續,但變異數通常低得多。VAE 讓這個估計量廣為人知 [15]。
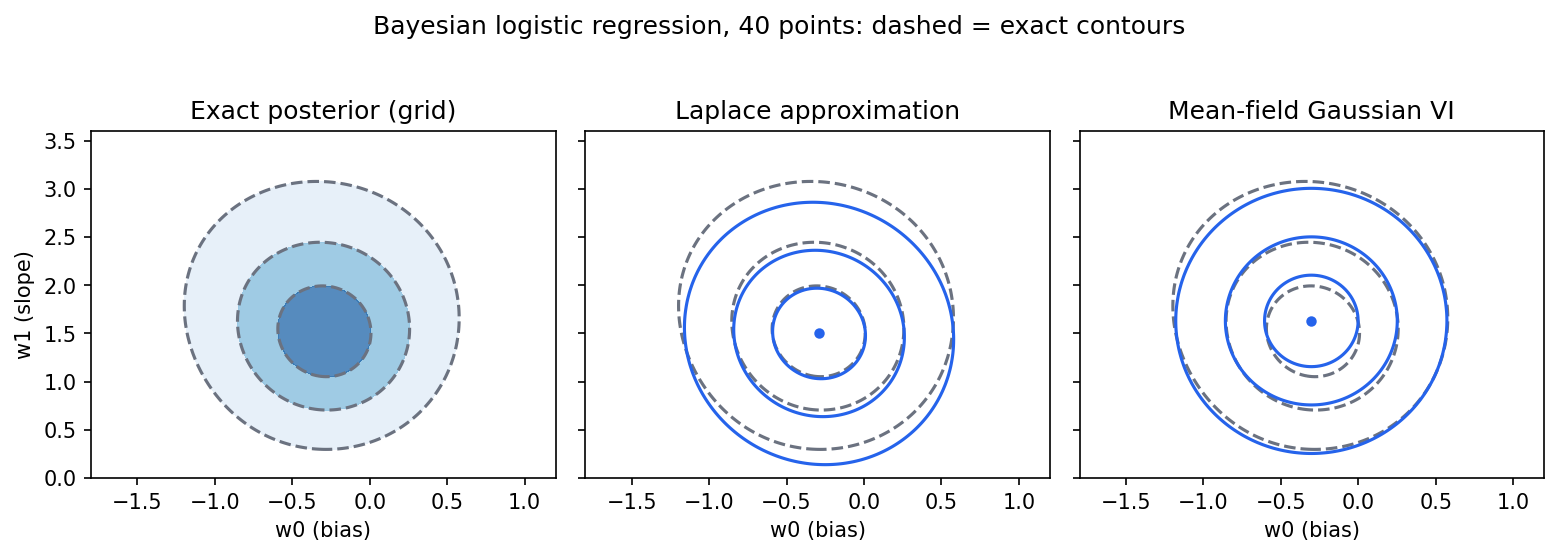
對參數為 、 的對角高斯,熵項等於 加上常數,所以它對 的梯度就是 1。套用到邏輯斯迴歸後驗:
程式碼 · Python · 32 行
import numpy as np

rng = np.random.default_rng(0)
n = 40
X = np.c_[np.ones(n), rng.normal(size=n)]
y = (rng.random(n) < 1 / (1 + np.exp(-X @ np.array([-0.5, 1.5])))).astype(float)
prior_var = 4.0

def grad_log_joint(W):                  # W: (S, 2) -> gradients (S, 2)
    p = 1 / (1 + np.exp(-W @ X.T))      # (S, n)
    return (y - p) @ X - W / prior_var

# Laplace: Newton's method to the MAP, then invert the Hessian.
w = np.zeros(2)
for _ in range(25):
    p = 1 / (1 + np.exp(-X @ w))
    H = X.T @ (X * (p * (1 - p))[:, None]) + np.eye(2) / prior_var
    w = w + np.linalg.solve(H, grad_log_joint(w[None])[0])
print("Laplace mean:", w.round(3), " sd:", np.sqrt(np.diag(np.linalg.inv(H))).round(3))

# Mean-field Gaussian VI with reparameterization: w = m + exp(s) * eps.
m, s = np.zeros(2), np.full(2, -1.0)
lr, S = 0.02, 64
for step in range(3000):
    eps = rng.normal(size=(S, 2))
    W = m + np.exp(s) * eps
    g = grad_log_joint(W)
    grad_m = g.mean(axis=0)                                # d ELBO / d m
    grad_s = (g * eps).mean(axis=0) * np.exp(s) + 1.0      # + entropy term
    m += lr * grad_m
    s += lr * grad_s
print("VI mean:     ", m.round(3), " sd:", np.exp(s).round(3))
與網格的標準答案比較:平均 、標準差 。程式輸出 Laplace 平均 、標準差 ;VI 平均 、標準差 。VI 幾乎完全找回後驗平均,因為它對偏斜的後驗取了平均;Laplace 回報的是眾數,後驗偏斜時與平均不同。兩者都略為低估分散程度。40 個資料點時後驗接近高斯,差異不大;資料更少或類別可分時,差異會迅速擴大。
Laplace 近似與期望傳播
Laplace:在峰頂放一個高斯
白話版。 找到後驗的最高點,然後擬合一個在該處曲率相同的高斯。
精確版。 在梯度為零的眾數 附近,把 展開到二階。令 為負對數後驗的 Hessian,
其中 是 的維度。第二個式子是 Laplace 證據近似;只保留隨 成長的項,就得到 PR 07 中用來選擇混合成分數的 BIC 準則 [1]。Laplace 很便宜(一次最佳化加一個 Hessian),而且資料越多越準確,因為正則模型的後驗會越來越接近高斯。它在下列情況會失敗:後驗偏斜、眾數位於邊界上(例如變異數趨近零)、Hessian 奇異,以及多峰後驗(它只描述其中一個峰)。現代的「深度網路 Laplace」方法只對最後一層使用 Laplace,或採用結構化的 Hessian 近似,為訓練好的神經網路提供便宜的不確定性估計。
期望傳播
期望傳播(EP)[14] 處理可分解為 的後驗,例如每個資料點一個因子。它用指數族中的簡單站點(site) 近似每個因子,使 ,並逐一修正站點:
- 移除站點 ,形成空腔(cavity)分布 。
- 形成傾斜(tilted)分布 ,即空腔乘上精確的因子。
- 把新的 設為分布族中與 動差相同的成員,也就是最小化正向 KL 。
- 更新站點:。
由於每一步在局部使用正向 KL,EP 傾向於覆蓋質量,變異數往往比 mean-field VI 校準得更好,例如在高斯過程分類中。代價是它沒有保證會改善的全域目標函數,可能不收斂,也可能產生無效(負變異數)的站點,需要阻尼(damping)[1, 14]。
證據與複雜度:貝氏版奧坎剃刀
白話版。 一個什麼都能解釋的模型,把先驗的賭注分散得很薄,所以解釋你實際看到的資料時拿不到多少功勞。一個押注在這類資料上的較簡單模型,反而能拿到較多功勞。
精確版。 模型 的證據是把概似對先驗積分:
彈性大的模型可以達到很高的峰值概似,但如果它大部分的先驗質量都落在擬合很差的參數上,積分仍然很小。Laplace 公式讓這一點一目了然:證據等於峰值乘上一個比較後驗體積與先驗體積的「奧坎因子」(Occam factor)。由此有兩點提醒。第一,證據取決於先驗,甚至取決於幾乎不影響後驗的面向,例如模糊先驗有多寬。第二,它回答的是「哪個模型最能預料到這份資料?」,這與「哪個模型最能預測新資料?」相關但不相同,後者由保留驗證回答(PR 09)。跨模型比較 ELBO 也要小心:每個 ELBO 與其證據的差距是不同且未知的 KL。
從 ELBO 到 VAE 與擴散模型
本章的工具是 ML 系列中兩類深度生成模型的骨幹。
VAE 是攤銷式(amortized)變分推論。 變分自編碼器以潛在碼 、先驗 與神經網路解碼器 為影像 建模。它不為每張影像各自最佳化一組變分參數,而是讓編碼器網路直接輸出這些參數:。這就是攤銷式推論:一個網路學會對任何輸入做推論。每張影像的目標函數正是 ELBO:
並以重參數化梯度對 與 聯合訓練 [15, 16]。它已知的弱點正是上面談過的:攤銷差距(編碼器的答案比逐張最佳化差)、反向 KL 的分散不足,以及會造成模糊的高斯解碼器。完整說明與程式碼見 ML 07。
擴散模型以 ELBO 訓練,並以 Langevin 式動力學取樣。 去噪擴散機率模型固定一個逐步加入高斯雜訊的前向過程 ,並學習反向過程 。前向的含雜訊狀態扮演潛在變數的角色,前向過程則是固定的變分後驗;訓練目標是 的變分上界,常用的雜訊預測損失函數則是此上界的重新加權版本 [17]。Score-based 觀點 [18] 改為學習 ,也就是含雜訊資料對數密度的梯度,並透過積分反向時間的隨機微分方程來產生樣本;其 predictor–corrector 取樣器明確地穿插 Langevin MCMC 步驟,以 取代 。與本章前面的 Langevin 更新相比,唯一的差別是 score 是從資料學來的,而不是由公式算出來的。見 ML 08。
如何選擇方法
| 方法 | 回傳什麼 | 優點 | 主要失敗模式 |
|---|---|---|---|
| 網格/數值積分 | 數值近似 | 檢查網格加密後的低維參考值 | 截斷與離散化誤差;成本隨維度快速成長 |
| 重要性取樣 | 加權樣本、證據 | 簡單、可平行、能給出 | 漏掉 時權重崩潰 |
| 隨機漫步 MH | 相關樣本 | 只需要 | 高維時很慢;需調參 |
| Gibbs | 相關樣本 | 條件分布容易時不需調參 | 變數相關時很慢 |
| HMC/NUTS | 相關樣本 | 能擴展到大量連續參數 | 需要梯度;離散變數;divergence |
| Mean-field VI | 分布 | 快速、可擴展、適合小批次 | 分散不足;局部最佳 |
| Laplace | 眾數上的高斯 | 便宜;可估計證據 | 偏斜、邊界、多峰 |
| EP | 高斯/指數族 | 變異數常較準 | 可能不收斂 |
合理的工作流程是:先用最佳化方法(MAP 或 VI)求速度,在較小版本的問題上用謹慎的取樣器對照檢查,再用已知參數模擬資料,確認整條流程能還原它應該還原的東西。
現代觀點
值得一讀的綜述。 Blei、Kucukelbir 與 McAuliffe 寫給統計學者的綜述 [11] 是 VI 的標準入門:它推導 ELBO 與 CAVI、完整走過高斯混合的例子、介紹隨機 VI,並明確指出 VI 以犧牲 MCMC 的漸近精確性換取速度,且傾向低估後驗變異數。Zhang、Bütepage、Kjellström 與 Mandt [12] 把後續文獻整理成四個方向:可擴展的 VI(隨機與分散式)、適用於非共軛模型的通用 VI(黑箱與重參數化梯度)、更準確的 VI(反向 KL 以外的散度、更豐富的分布族),以及攤銷式 VI(推論網路、VAE)。Jordan、Ghahramani、Jaakkola 與 Saul [10] 是圖模型變分方法的經典導論,至今仍是凸對偶觀點最清楚的來源。取樣方面,Neal 的專章 [6] 是 HMC 的標準推導,Betancourt [8] 提供 HMC 在高維為何有效的幾何圖像,Hoffman 與 Gelman [7] 描述 NUTS,也就是現代機率程式系統的預設取樣器。Vehtari 等人 [9] 訂定了目前收斂診斷的標準。Kingma 與 Welling 的專書 [16] 把 VAE 當作攤銷式 VI 加以綜述,Yang 等人 [19] 則綜述擴散模型,包括其變分與 score-based 表述。
2023–2026 的現況。 有三個明顯趨勢。
- 機器學習進入貝氏計算。 Winter、Campbell、Lin、Srivastava 與 Dunson [20] 回顧了正規化流(normalizing flows)、貝氏 coreset、分散式推論與變分方法如何被用來加速後驗計算,以及這些方法的理論保證在哪些地方仍弱於傳統 MCMC。
- 擴散的想法被用於取樣,而不只是生成。 即使只有未正規化的密度(沒有資料),仍然可以訓練擴散式的取樣器。Denoising Diffusion Samplers [21] 學習反轉一個加雜訊的過程,使其終點落在只知道差一個常數的目標上,得到近似樣本與正規化常數的估計;它與最佳控制及 Schrödinger bridge 有所連結,是快速成長的學習式取樣器家族中具代表性的一員。
- 重視工作流程而非單一演算法。 實務上已轉向預設執行 NUTS、回報秩正規化 與 bulk/tail ESS [9] 的機率程式系統,並把 VI 或 Laplace 當作快速的第一步,而不是最終答案。
開放問題。 為非常大的模型提供可靠的不確定性仍然困難:全批次 MCMC 太昂貴,而便宜的近似(mean-field VI、最後一層 Laplace、集成)彼此結論不一。多峰後驗會同時擊敗局部 VI 與單一鏈。在沒有標準答案時評估近似的品質,大體上仍靠經驗法則;透過 ELBO 比較模型,也會受到未知近似差距的干擾。
重點整理
- 後驗在差一個常數的意義下容易計算、卻難以積分;網格成本是 ,超過幾個維度就非近似不可。
- Monte Carlo 誤差以 下降且與維度無關,但前提是能從正確的分布抽樣。重要性取樣修正錯誤的分布,權重的 ESS 告訴你修正何時已經崩潰。
- Metropolis–Hastings 只需要 的比值,非對稱提議則需加上 Hastings 修正。Gibbs 是接受率為 1 的 MH。HMC 利用梯度走得更遠。一定要記錄被拒絕時的狀態、跑多條鏈,並檢查 與 ESS。
- VI 最大化 ELBO,等同最小化對後驗的反向 KL。它快速、可擴展、會找峰,並傾向低估變異數,在 mean field 下尤其如此。
- Laplace 在眾數上擬合高斯,提供便宜的證據估計(以及 BIC);EP 在局部匹配動差,變異數常較準,但可能不收斂。
- 證據實現了奧坎剃刀,但取決於先驗,回答的問題也與保留資料上的預測不同。
- VAE 是搭配重參數化梯度的攤銷式 VI;擴散模型以變分上界訓練,並以學習到的 score 驅動類似 Langevin 的動力學來取樣。
練習
- 手推 ELBO。 從 出發,推導 。再證明 時下界是緊的,並說明這如何讓 EM 成為最大化 ELBO 的特例。
提示
代入 ,並因為 與 無關而把它移出期望值。 等於後驗時 KL 為零。EM 的 E step 把 設為目前參數下潛在變數的後驗(下界變緊);M step 固定 ,對參數最大化 。
- Hastings 修正。 你對一個正值參數使用對數常態隨機漫步提議:,。計算 與比值 。若直接使用 Metropolis 原本的規則,會出什麼問題?
提示
。指數部分對稱,所以比值為 。省略它會讓鏈從正比於 的密度取樣,偏向較小的值。
- 步長與混合。 在 Metropolis 程式中,把提議標準差改為 ,再改為 。對每種情況回報接受率、lag-1 自相關,並用診斷小節的公式估計 (在第一個負的自相關處截斷總和)。哪個步長每次迭代得到的有效樣本最多?
提示
對照圖 2。極小的步長接受率接近 1,但自相關也接近 1,所以 非常小,鏈甚至可能還沒到達目標。極大的步長接受率低,會長時間重複同一個值。中間的步長(約為目標的標準差)能得到多得多的有效樣本。
- 斜脊上的 Gibbs。 以 重新執行 Gibbs 取樣器。先預測 的 lag-1 自相關與 ,再用模擬驗證。提出並實作一個修正方法。
提示
鏈是係數為 的自迴歸過程,所以 。修正方法:把 當成一個區塊一起抽,或旋轉到 、,兩者在目標下彼此獨立。
- Mean field 低估變異數。 對高斯目標 ,精確度 ,用 mean-field 更新規則證明最佳的 是變異數為 的高斯。證明 ,並在變異數為一、相關係數 時計算兩者。
提示
常數;對 取期望,保留含 的項:,這是精確度為 的高斯。 是給定其餘變數時 的條件變異數,由 Schur 補數可知它等於 減去一個非負項。 時:約 對 。
- 用重要性取樣估計證據。 對兩權重邏輯斯迴歸,分別以 (a) 先驗作為提議分布、(b) 共變異數放大 1.5 倍的 Laplace 高斯作為提議分布,以重要性取樣估計 。把兩者與網格值 及權重 ESS 比較。在 50 維時你會信任哪一個?為什麼?
提示
估計值為 ,用 log-sum-exp 計算。先驗比後驗寬得多,大部分樣本權重微不足道,ESS 只占 的一小部分;以 Laplace 為基礎的提議分布落在後驗上,ESS 大得多。在高維時,先驗與後驗的落差呈指數擴大,以先驗為提議分布會變得毫無用處,而擬合良好、尾部略重的提議分布仍然可行。
參考文獻
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006, Sections 4.4 (Laplace), 10.1–10.2 and 10.7 (variational inference, EP) and 11.1–11.5 (sampling). 官方書籍頁面與 PDF
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2009, Chapter 2 (Bayes decision theory and parameter estimation) and Appendix C (cost function optimization)。這些是先備知識,並非與本章內容完全相同。doi
- N. Metropolis, A. W. Rosenbluth, M. N. Rosenbluth, A. H. Teller and E. Teller, “Equation of state calculations by fast computing machines,” The Journal of Chemical Physics, vol. 21, no. 6, pp. 1087–1092, 1953. doi
- W. K. Hastings, “Monte Carlo sampling methods using Markov chains and their applications,” Biometrika, vol. 57, no. 1, pp. 97–109, 1970. doi
- S. Geman and D. Geman, “Stochastic relaxation, Gibbs distributions, and the Bayesian restoration of images,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. PAMI-6, no. 6, pp. 721–741, 1984. doi
- R. M. Neal, “MCMC using Hamiltonian dynamics,” in S. Brooks, A. Gelman, G. Jones and X.-L. Meng (eds.), Handbook of Markov Chain Monte Carlo, Chapman and Hall/CRC, 2011 (arXiv:1206.1901). arXiv
- M. D. Hoffman and A. Gelman, “The No-U-Turn Sampler: Adaptively setting path lengths in Hamiltonian Monte Carlo,” Journal of Machine Learning Research, vol. 15, pp. 1593–1623, 2014. JMLR
- M. Betancourt, “A conceptual introduction to Hamiltonian Monte Carlo,” arXiv:1701.02434, 2017. arXiv
- A. Vehtari, A. Gelman, D. Simpson, B. Carpenter and P.-C. Bürkner, “Rank-normalization, folding, and localization: An improved for assessing convergence of MCMC (with discussion),” Bayesian Analysis, vol. 16, no. 2, 2021. doi
- M. I. Jordan, Z. Ghahramani, T. S. Jaakkola and L. K. Saul, “An introduction to variational methods for graphical models,” Machine Learning, vol. 37, no. 2, pp. 183–233, 1999. doi
- D. M. Blei, A. Kucukelbir and J. D. McAuliffe, “Variational inference: A review for statisticians,” Journal of the American Statistical Association, vol. 112, no. 518, pp. 859–877, 2017. doi
- C. Zhang, J. Bütepage, H. Kjellström and S. Mandt, “Advances in variational inference,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 41, no. 8, pp. 2008–2026, 2019. doi
- R. Ranganath, S. Gerrish and D. M. Blei, “Black box variational inference,” in Proc. International Conference on Artificial Intelligence and Statistics (AISTATS), PMLR vol. 33, 2014. PMLR
- T. P. Minka, “Expectation propagation for approximate Bayesian inference,” in Proc. Conference on Uncertainty in Artificial Intelligence (UAI), 2001 (arXiv:1301.2294). arXiv
- D. P. Kingma and M. Welling, “Auto-encoding variational Bayes,” International Conference on Learning Representations (ICLR), 2014; arXiv:1312.6114. arXiv
- D. P. Kingma and M. Welling, “An introduction to variational autoencoders,” Foundations and Trends in Machine Learning, vol. 12, no. 4, pp. 307–392, 2019. arXiv
- J. Ho, A. Jain and P. Abbeel, “Denoising diffusion probabilistic models,” in Advances in Neural Information Processing Systems (NeurIPS), 2020 (arXiv:2006.11239). arXiv
- Y. Song, J. Sohl-Dickstein, D. P. Kingma, A. Kumar, S. Ermon and B. Poole, “Score-based generative modeling through stochastic differential equations,” in Proc. International Conference on Learning Representations (ICLR), 2021. arXiv
- L. Yang, Z. Zhang, Y. Song, S. Hong, R. Xu, Y. Zhao, W. Zhang, B. Cui and M.-H. Yang, “Diffusion models: A comprehensive survey of methods and applications,” ACM Computing Surveys, vol. 56, no. 4, 2023. doi
- S. Winter, T. Campbell, L. Lin, S. Srivastava and D. B. Dunson, “Machine learning and the future of Bayesian computation,” arXiv:2304.11251, 2023. arXiv
- F. Vargas, W. Grathwohl and A. Doucet, “Denoising diffusion samplers,” in Proc. International Conference on Learning Representations (ICLR), 2023 (arXiv:2302.13834). arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 09・集成、驗證與分群有效性 · 28 分鐘