PR 01・模式、機率與貝氏決策
先備知識:ML 01B・機率與資訊理論
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
圖形識別
你將學到
- 把辨識問題拆成觀測、特徵、預測與行動,並先想清楚「一筆樣本」代表什麼。
- 區分類別先驗、類別似然與類別後驗,並看懂先驗改變時決策邊界如何移動。
- 推導最小錯誤率規則、任意損失矩陣下的最小風險規則,以及 Chow 的拒絕規則。
- 把分類器寫成判別函數,推導高斯情形下的線性(LDA)與二次(QDA)決策邊界。
- 讀懂 ROC 曲線與精確率–召回率曲線,連結 Neyman–Pearson 準則,並依成本選擇操作點。
先看全貌
相機拍下一個零件。系統量測它的形狀,估計它是否有缺陷,再決定要不要送去人工檢查。這些是不同的階段:拍到的像素是觀測(observation);形狀量測值是特徵(feature);缺陷機率是預測(prediction);送去檢查則是行動(action)。貝氏決策理論處理的正是最後兩者之間的連結:在目前的信念之下,應該採取什麼行動?
本系列沿用經典的圖形識別教科書:Duda、Hart 與 Stork 的《Pattern Classification》[1]、Bishop 的《Pattern Recognition and Machine Learning》[2],以及 Theodoridis 與 Koutroumbas 的《Pattern Recognition》[3],統計觀點則參考 Hastie、Tibshirani 與 Friedman [4]。各章的範例與推導都是原創的,較長的證明請回到教科書。這些教科書都從貝氏決策理論開始,因為後面所有方法都可以拿它來衡量:一個分類器好不好,取決於它多接近「如果知道真實分布,貝氏規則會做的決定」。
辨識不限於影像。觀測也可以是一段錄音、一串筆畫或一份文件。分類預測類別,迴歸預測數值,分群則在沒有標籤時找出群組。本章談分類,但這套思考方式(先為不確定性建模,再選期望成本最低的行動)適用於三者。
先定義實驗
白話版。 在寫任何公式之前,先寫下一筆樣本是什麼,以及資料是怎麼蒐集的。辨識系統許多出人意料的失敗都來自這一步,而不是分類器本身。
一張影像、一位病人、一段影片、影片中的一個裁切區域,是不同的抽樣單位(sampling unit)。如果二十個影格來自同一段錄影,把它們當成二十個獨立個案,會讓測試看起來比實際部署容易得多,因為測試影格幾乎就是訓練影格的複本。
精確版。 辨識流程可以寫成
其中 是原始觀測(影像、波形); 是前處理與特徵抽取,把觀測映射成特徵向量 ; 是 個類別之一; 是模型對類別的信念; 是最後採取的行動。學習階段用訓練樣本調整 與機率模型的參數;驗證樣本用來選擇門檻、正則化等設定;保留的測試集只用一次,評估整個已選定的程序(PR 09 會仔細討論:驗證與集成方法)。
手工特徵(邊緣直方圖、形狀矩)與學習得到的嵌入(預訓練網路的輸出)佔據同一個位置 。換掉特徵抽取器,就改變了分類器能拿到的資訊。被裁切、量化或池化移除的資訊,下游任何分類器都救不回來。用決策理論的語言說:問題的貝氏錯誤率是相對於特徵而定義的;差的 會抬高任何分類器都無法低於的下限。
貝氏定理:證據如何改變信念
白話版。 貝氏定理告訴我們,如何利用「這個量測值在各類別中有多典型」,把「各類別有多常見」更新成「對這個物體而言各類別的可能性」。
精確版。 令類別為 。貝氏定理給出
- 先驗(prior) 是看這筆觀測之前類別 的機率,例如產線上缺陷零件的比例。
- 似然(likelihood,或類別條件密度) 描述類別 內量測值的分布。
- 證據(evidence) 是 的整體密度;它對每個類別都相同,只負責正規化。
- 後驗(posterior) 是觀測到 之後類別 的機率。
連續量測的似然是密度,數值不一定介於零與一之間,也不是「恰好觀測到這個實數」的機率。類別後驗機率則落在 ,並且對 加總為一。把兩個條件方向 與 搞混,就是經典的基本率謬誤(base-rate error),下面的程式範例會具體呈現。
因為證據是共用的,做決策只需要乘積 。圖 1 以兩個一維高斯類別說明其幾何意義:邊界落在兩條乘上先驗後的似然曲線交會之處。當類別 的先驗從 降到 ,它的加權曲線縮小,邊界往 的平均值移動:系統現在需要更強的證據,才會判定為較稀少的類別。
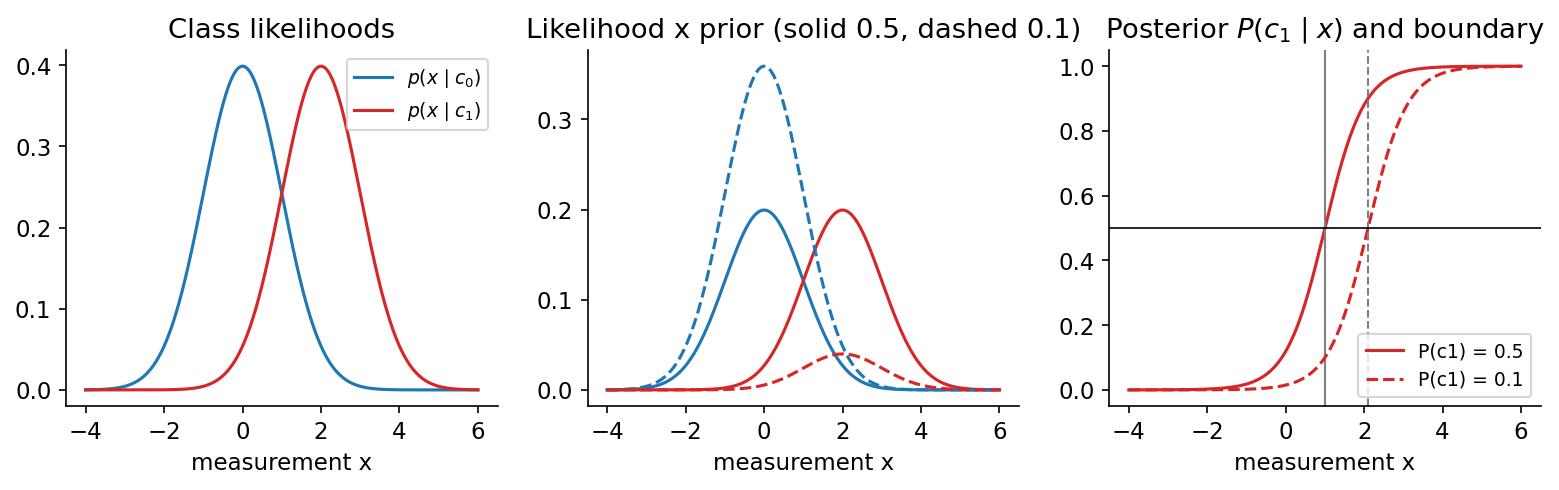
圖 1 的單位變異數情形有封閉解。平均值 、、變異數為 時,加權似然的對數比為 ,在 處為零。先驗相等時是 , 時則是 。
程式碼:稀有事件改變後驗
這個 NumPy 範例使用假設的檢測統計:偵測器能標出 的缺陷零件(靈敏度),也會誤標 的良品(偽陽性率),而缺陷零件佔 。程式計算偵測器輸出陽性與陰性後的後驗,再比較最小錯誤率與最小風險的行動(後面幾節會推導)。
程式碼 · Python · 18 行
import numpy as np

prior = 0.02
sensitivity = 0.90
false_positive_rate = 0.08
p_positive = (sensitivity * prior /
              (sensitivity * prior + false_positive_rate * (1 - prior)))
p_negative = ((1 - sensitivity) * prior /
              ((1 - sensitivity) * prior + (1 - false_positive_rate) * (1 - prior)))
p = np.array([p_negative, p_positive])
c_fp, c_fn = 1.0, 9.0
threshold = c_fp / (c_fp + c_fn)
risks = np.column_stack([c_fn * p, c_fp * (1 - p)])
decisions = risks.argmin(axis=1)
assert np.array_equal(decisions, (p > threshold).astype(int))
print("posteriors [negative observation, positive observation]:", p)
print("minimum-risk actions:", decisions, "threshold:", threshold)
print("minimum-error actions:", (p > 0.5).astype(int))
輸出顯示:陰性後的後驗約為 ,陽性後也只有 。陽性觀測並不代表 的缺陷機率:靈敏度以真實類別為條件,後驗則以觀測為條件;在 的先驗下,大部分陽性標記其實來自數量龐大的良品。成本相同時,兩種觀測都不會判為「缺陷」()。若漏掉缺陷的代價是多做一次檢查的九倍,門檻降到 ,陽性標記就會送去檢查。機率模型沒變,變的只有決策規則。
最小錯誤率決策
白話版。 如果每種錯誤的代價都一樣,就永遠選擇對這筆觀測而言機率最高的類別。平均而言,沒有其他規則能犯更少的錯。
精確版。 決策規則 把每個 指派到一個類別,因而把特徵空間切成決策區域 ,其中 。錯誤機率為
其中 是所選類別的後驗。被積函數非負,而 與規則無關,所以只要在每個 上分別讓 最小,整個積分就最小,也就是選
這就是最大後驗(MAP)規則,也稱貝氏分類器。它的錯誤率
稱為貝氏錯誤率(Bayes error):在這組特徵下,任何分類器能達到的最低錯誤率。只有當各類別在特徵空間中完全不重疊時,它才是零。在貝氏錯誤率為 的問題上,測試錯誤率 已接近最佳;同樣的 ,若貝氏錯誤率是 ,就還有很大的改進空間。真實任務的貝氏錯誤率通常未知,但這個概念能把兩個問題分開:「特徵的資訊夠不夠?」(貝氏錯誤率),以及「分類器有沒有把特徵中的資訊榨乾?」(與下限之間的差距)。
兩類別時,MAP 規則成為似然比檢定(likelihood-ratio test):
比值超過右邊的門檻就選 ,否則選 。資料只透過 進入決策;先驗以及接下來會看到的成本,只會移動門檻。這就是同一個分數可以服務許多不同決策政策的原因。
損失矩陣與最小風險
白話版。 有些錯誤比其他錯誤嚴重。為每一種錯誤訂一個成本,在目前信念下計算每個可能行動的平均成本,然後採取最便宜的行動。
精確版。 令可用行動為 (通常是「判為類別 」,也可能包含「拒絕」)。損失矩陣 給出真實類別為 時採取行動 的成本。一個行動的條件風險(conditional risk)是它在後驗下的期望損失:
整體風險 可用與前面相同的逐點論證最小化,所以這條貝氏決策規則達到可能的最小期望損失,即貝氏風險 [1, 2]。在零一損失( 時 ,否則為 )下,,規則化約為 MAP。
兩類別時,記 為真實是 卻判為 的成本(偽陽性), 為真實是 卻判為 的成本(偽陰性)。當 時選 較便宜,整理後得到
這個比值形式假設兩類先驗皆為正,且 ,如一般分類成本。若此差為零,直接比較條件風險;若為負,除法會反轉不等號。在正確決策不花成本時,把偽陰性成本加倍,等同把先驗勝算 加倍,而不是只把陽性類別的機率加倍;兩類先驗仍須相加為一。若正確決策不花成本(),記 、、,規則就成為後驗上的門檻:
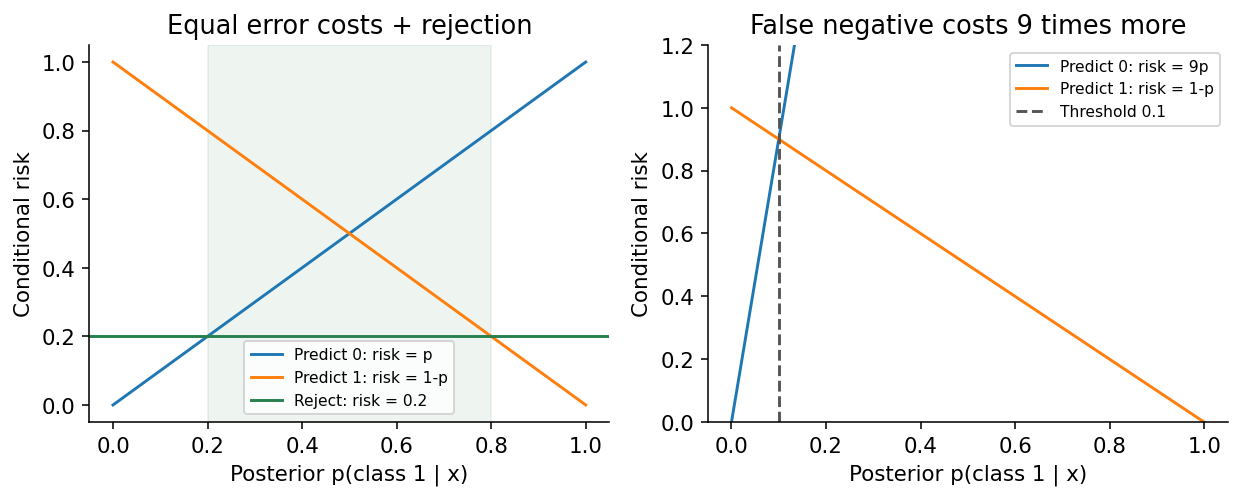
漏掉缺陷的代價是多做一次檢查的九倍時,門檻是 ,而不是 (圖 2 右)。
實務上有兩點很重要。第一,損失矩陣是一個建模決定,常常由機器學習團隊以外的人(臨床醫師、安全工程師、產品負責人)決定;請明確寫下來,讓人可以審查。第二,後驗門檻只有在後驗經過校準(calibrated)時才有意義,也就是說,被給予機率 的個案中,真的大約有 是陽性。許多現代分類器並非如此,這是下方「現代觀點」的主題之一。
拒絕選項
白話版。 系統不確定時,可以把案例交給人處理。拒絕判斷有固定成本;做出判斷的期望成本,則在後驗分散時很高。當判斷的期望成本高於拒絕成本時,就拒絕。
精確版。 加入一個行動 ,不論真實類別為何,損失都是常數 ; 個分類行動仍用零一損失。最佳分類行動的風險為 ,因此貝氏規則成為 Chow 規則 [5]:
若拒絕成本為 ,系統只在最大後驗至少為 時才接受(圖 2 左)。兩個極端有助於建立直覺:若 (請人看完全免費),系統會拒絕所有不確定的案例;若 ,系統永遠不拒絕,因為最大後驗至少是 。
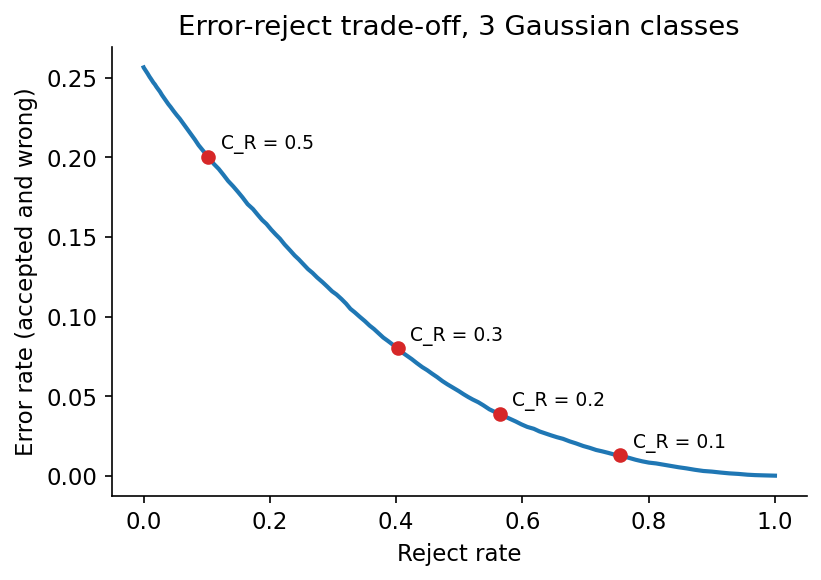
Chow 指出,掃過門檻會畫出一條錯誤–拒絕權衡曲線:每多拒絕一個百分點的樣本,就能降低剩餘樣本的錯誤,但效益遞減 [5]。圖 3 以三個重疊的高斯類別示範,它們的真實後驗是已知的。不拒絕時約有四分之一樣本被分錯;拒絕最不確定的 後,全部樣本中的錯誤降到約 。
程式碼:Chow 規則
程式碼 · Python · 20 行
import numpy as np

rng = np.random.default_rng(2)
means = np.array([[0, 0], [2, 0], [1, 1.7]])
y = rng.integers(0, 3, 20000)
X = means[y] + rng.normal(0, 1, (len(y), 2))

# exact posteriors: equal priors, identity covariance
logits = -0.5 * ((X[:, None, :] - means[None]) ** 2).sum(-1)
post = np.exp(logits - logits.max(1, keepdims=True))
post /= post.sum(1, keepdims=True)
pred, pmax = post.argmax(1), post.max(1)

for c_r in [0.5, 0.3, 0.2, 0.1]:
    accept = pmax >= 1 - c_r                     # Chow's rule
    reject_rate = 1 - accept.mean()
    err_accepted = np.mean(pred[accept] != y[accept])
    risk = np.mean(np.where(accept, pred != y, c_r))
    print(f"C_R={c_r}: reject {reject_rate:.3f}, "
          f"error on accepted {err_accepted:.3f}, average loss {risk:.3f}")
在這個亂數種子下, 約拒絕 的樣本,被接受的樣本中錯誤約為 ; 約拒絕 ,剩下約 的錯誤。平均損失隨 下降而下降,因為拒絕本身變便宜了。取指數之前先減去最大 logit(logits.max),是讓 softmax 數值穩定的標準技巧。
只有當不確定性估計有意義時,拒絕才有幫助。Chow 規則處理的是模糊性(ambiguity):落在已知類別之間的觀測。它處理不了新穎性(novelty):訓練時從未見過的物體,可能離每個類別都很遠,卻仍得到很有自信的後驗,因為後驗只在已知類別之間正規化。偵測這類輸入是開放集辨識與分布外偵測的課題(見「現代觀點」)。
判別函數與決策區域
白話版。 分類器可以寫成一組評分函數,每個類別一個:算出所有分數,選最大的。許多不同的分數會給出相同的決策。
精確版。 分類器由判別函數(discriminant function) 以及規則「若對所有 都有 ,就把 判給 」定義 [1]。取 就得到貝氏最小錯誤率分類器,但對所有判別函數套用任何單調遞增函數 ,每個決策都不變。因此以下三種選擇等價:
實務上用的是對數形式:它把許多小密度的乘積變成加總,避免數值下溢。最小風險時則用 。
與 之間的決策邊界是 、且兩者都大於其他所有分數的點集合。兩類別時只需要一個函數,稱為二分器(dichotomizer):
這是對數似然比加上對數先驗勝算。它也等於後驗的 logit,因為 ,其中 是邏輯斯 sigmoid 函數。請記住這個恆等式:在 PR 03 中,邏輯斯迴歸直接把 建模成線性函數,而不是從密度推導。
判別函數的觀點很有用,因為它把分類器計算什麼(邊界的形狀)和它如何得到(密度、直接擬合、間隔)分開。線性判別函數 產生超平面邊界與凸的決策區域;二次判別函數在二維中產生圓錐曲線,一般情形則是超二次曲面。高斯情形正好說明各自何時出現。
高斯情形:LDA 與 QDA 邊界
白話版。 如果每個類別都像一團多變量高斯形狀的「雲」,貝氏規則就是在量測 與每團雲中心的距離,而且單位會依照雲的形狀調整。所有雲形狀相同時,邊界是直的;形狀不同時,邊界會彎曲。
精確版。 假設 ,平均值 ,共變異數矩陣 (對稱、正定):
其中 是行列式。去掉所有類別共用的常數 後,對數判別函數為
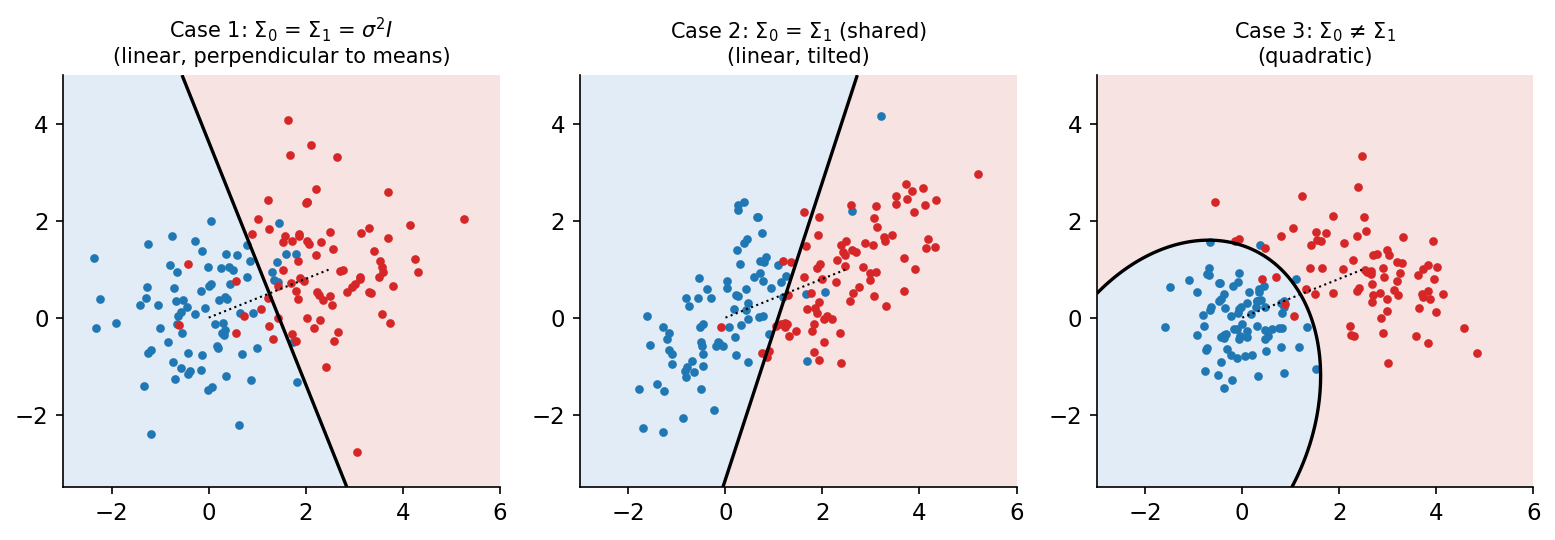
二次式 是 到 的馬氏距離(Mahalanobis distance)平方:先把類別「白化」成單位球,再量歐氏距離。圖 4 的三種情形涵蓋了所有可能 [1, 4]。
情形 1:所有 都有 。 特徵互不相關,變異數皆為 。展開 並丟掉與類別無關的 ,得到線性判別函數
類別 與 的邊界是超平面 ,其中 ,且
邊界垂直於兩平均值的連線。先驗相等時它通過中點,分類器正是 IP 13 的最小距離(最近平均值)分類器。先驗不等時,平面會往遠離較可能類別平均值的方向滑動。
情形 2:所有類別共用 。 二次項 同樣是共用的而被消去,剩下
邊界仍是超平面 ,其中 ,但不再垂直於平均值差:它會傾斜,順著共用的相關結構(圖 4 中)。這就是機率形式的線性判別分析(linear discriminant analysis, LDA)。先驗相等時,它是最小馬氏距離分類器。方向 與 Fisher 在 1936 年由投影準則推得的方向相同,PR 03 會重新推導。
情形 3:任意 。 沒有任何項會被消去:
邊界是超二次曲面:在二維中可能是直線、拋物線、橢圓或雙曲線。這就是二次判別分析(quadratic discriminant analysis, QDA)。在圖 4(右)中,緊密的藍色類別被一個橢圓包住,因為在任何方向上離藍色平均值很遠的點,都更能由分布寬廣的紅色類別解釋。決策區域甚至可以不連通,這在線性判別函數中不會發生。
兩類別共用共變異數且先驗相等時,貝氏錯誤率有封閉解:
其中 是標準常態累積分布函數, 是兩平均值之間的馬氏距離。即使兩類別相距三個標準差(),仍有 無法避免的錯誤。在高斯玩具資料上訓練分類器時,這條公式是很好的合理性檢查。
該用哪一種情形?這是偏差與變異數的取捨。每個類別的完整共變異數有 個自由元素; 時,每類別就是 個數字,所需的樣本遠多於許多資料集能提供的量。共用一個共變異數(LDA)、限制為對角矩陣(即高斯樸素貝氏),或往簡單目標收縮,都是以彈性換取穩定。如何估計這些參數,是下一章 PR 02:密度估計的主題。
程式碼:從零實作高斯判別函數
這個範例擬合高斯類別模型,用 Cholesky 分解計算對數判別函數(絕不顯式求反矩陣),並在圖 4 情形 3 的資料上,確認決策與 scikit-learn 的 LinearDiscriminantAnalysis、QuadraticDiscriminantAnalysis 一致。
程式碼 · Python · 37 行
import numpy as np
from sklearn.discriminant_analysis import (LinearDiscriminantAnalysis,
                                           QuadraticDiscriminantAnalysis)

rng = np.random.default_rng(0)
means = [np.array([0.0, 0.0]), np.array([2.5, 1.0])]
covs = [np.array([[0.4, 0.0], [0.0, 0.4]]), np.array([[2.0, -0.6], [-0.6, 1.0]])]
X = np.vstack([rng.multivariate_normal(m, S, 300) for m, S in zip(means, covs)])
y = np.repeat([0, 1], 300)

def fit_gaussians(X, y, shared):
    params = []
    pooled = sum(np.cov(X[y == k].T, bias=True) * (y == k).sum()
                 for k in (0, 1)) / len(y)
    for k in (0, 1):
        Xk = X[y == k]
        S = pooled if shared else np.cov(Xk.T, bias=True)
        params.append((Xk.mean(0), S, len(Xk) / len(y)))
    return params

def discriminants(X, params):
    g = []
    for mu, S, prior in params:
        L = np.linalg.cholesky(S)               # S = L L^T
        z = np.linalg.solve(L, (X - mu).T)      # whitened residuals
        maha = (z ** 2).sum(0)                  # squared Mahalanobis distance
        logdet = 2 * np.log(np.diag(L)).sum()
        g.append(-0.5 * maha - 0.5 * logdet + np.log(prior))
    return np.stack(g, axis=1)

for shared, ref in [(True, LinearDiscriminantAnalysis(store_covariance=True)),
                    (False, QuadraticDiscriminantAnalysis())]:
    mine = discriminants(X, fit_gaussians(X, y, shared)).argmax(1)
    theirs = ref.fit(X, y).predict(X)
    name = "LDA (shared)" if shared else "QDA (separate)"
    print(f"{name}: training error {np.mean(mine != y):.3f}, "
          f"agrees with scikit-learn on {np.mean(mine == theirs):.1%} of points")
兩個手寫分類器在每一個點上都與 scikit-learn 一致。這組資料的真實共變異數不同,QDA 的訓練錯誤率()低於 LDA()。不過這是訓練錯誤率:在高維且樣本少時,保留資料上的排序經常反過來。
ROC 分析與 Neyman–Pearson 觀點
白話版。 一個兩類別分數可以在許多門檻上切開。每個門檻都在「抓到更多陽性」與「發出更多假警報」之間取捨。ROC 曲線一次畫出所有取捨,讓你等到成本或先驗確定之後再挑門檻。
精確版。 令 為任何「越大越偏向 」的分數(對數似然比、後驗、網路的 logit),當 時判為 。對每個門檻 定義
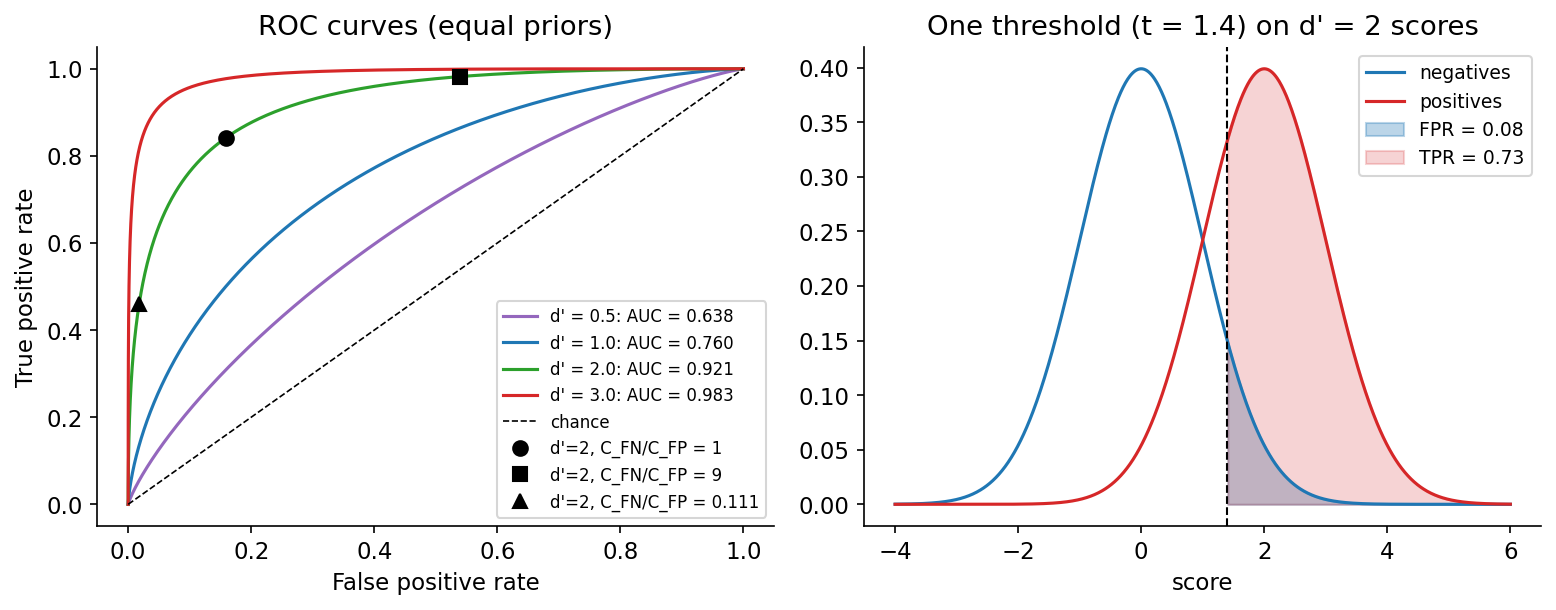
真陽性率(靈敏度、召回率)是被抓到的陽性比例;偽陽性率( 特異度)是被誤標的陰性比例。接收者操作特徵(receiver operating characteristic, ROC)曲線在 從 掃到 時,畫出 TPR 對 FPR 的關係 [7]。無用的分數落在對角線上;完美的分數會通過左上角。因為兩個比率都以真實類別為條件,類別先驗改變時,ROC 曲線不會改變。
Neyman–Pearson 準則。 有時成本很難說清楚,但限制條件很容易講:「假警報最多 」。Neyman–Pearson 引理 [6] 指出:在所有滿足 的決策規則中,TPR 最高的是似然比檢定 ,其中 選成讓偽陽性率恰好等於 (必要時在邊界上隨機化)。所以似然比的 ROC 曲線是可達到的最佳曲線;其他任何分數的 ROC 都在它之下或與之重合。貝氏規則與 Neyman–Pearson 規則都是似然比檢定,差別只在門檻怎麼選。
依成本選擇操作點。 在門檻 下,每筆樣本的期望成本為
在 ROC 空間中,成本相同的點落在斜率為 的等成本直線上;這些直線的斜率固定相同。把直線往較高 TPR(較大的縱軸截距)平移,直到最後接觸可達的點;該點使成本最小 [7]。對似然比分數而言,切點正是先前推導的貝氏門檻。
曲線下面積。 AUC 用一個數字概括整條曲線。它等於隨機抽一個陽性樣本與一個陰性樣本,陽性得分較高的機率(平手算一半)[7]。對兩個相距 個標準差、單位變異數的高斯分數分布,:圖 5 中 得到 。AUC 忽略成本、先驗與校準,所以兩個 AUC 相同的分類器,在實際部署的門檻上成本可能差很多。
精確率–召回率曲線。 當陽性很稀少(詐欺、缺陷、偵測中的小物體)時,即使 FPR 很小,假警報的絕對數量仍可能很多,因為陰性實在太多。精確率 取決於先驗,能把這件事暴露出來。Davis 與 Goadrich [8] 證明:一條曲線在 ROC 空間中支配另一條,若且唯若它在精確率–召回率空間中也支配;他們也指出 PR 點之間不能用直線內插。Saito 與 Rehmsmeier [9] 以模擬和已發表的研究說明,在不平衡資料上 PR 圖比 ROC 更有資訊量。物件偵測基準因此報告平均精確率(average precision)(見 DLCV 03)。
程式碼:ROC、AUC 與成本最佳門檻
程式碼 · Python · 25 行
import numpy as np
from sklearn.metrics import roc_auc_score, roc_curve

rng = np.random.default_rng(1)
n_neg, n_pos = 9000, 1000                       # prevalence 10%
scores = np.r_[rng.normal(0, 1, n_neg), rng.normal(2, 1, n_pos)]
labels = np.r_[np.zeros(n_neg), np.ones(n_pos)]

fpr, tpr, thr = roc_curve(labels, scores)
auc = roc_auc_score(labels, scores)
# Mann-Whitney view of AUC: P(score_pos > score_neg)
pos, neg = scores[labels == 1], scores[labels == 0]
auc_pairs = (pos[:, None] > neg[None, :]).mean()
print(f"AUC = {auc:.4f}, pairwise estimate = {auc_pairs:.4f}")

# choose the operating point with minimum expected cost per sample
c_fp, c_fn, prior = 1.0, 9.0, n_pos / (n_pos + n_neg)
cost = c_fp * fpr * (1 - prior) + c_fn * (1 - tpr) * prior
i = np.argmin(cost)
print(f"best threshold {thr[i]:.2f}: FPR {fpr[i]:.3f}, TPR {tpr[i]:.3f}, "
      f"expected cost {cost[i]:.3f}")
# Bayes threshold from the true model: predict 1 when the likelihood ratio
# exceeds c_fp (1 - prior) / (c_fn prior); for unit Gaussians, log LR = 2s - 2
t_bayes = (np.log(c_fp * (1 - prior) / (c_fn * prior)) + 2) / 2
print(f"Bayes threshold from the true densities: {t_bayes:.2f}")
經驗 AUC()與成對排序估計完全一致,也接近理論值 。先驗為 、成本比為 9:1 時,先驗勝算與成本比互相抵消,貝氏門檻是 ;經驗搜尋找到 。實際專案中,門檻搜尋必須在驗證資料上進行,絕不能用測試集。
假設在哪裡失效
貝氏規則的最佳性,是相對於假設的分布與指定的損失而言。部署時,每一項都可能出錯。
先驗偏移。 訓練集與部署環境的類別比例可能不同,例如兩座工廠之間,或平衡的研究資料集與真實診所之間。若類別條件分布 不變(標籤偏移,label shift),不必重新訓練就能修正後驗:把每個後驗乘上新舊先驗的比值,再重新正規化,
新先驗未知時,Saerens、Latinne 與 Decaestecker [10] 在未標註的部署資料上用 EM 程序估計;Lipton、Wang 與 Smola 的黑箱偏移估計(black-box shift estimation)[11] 則從分類器的混淆矩陣估計。若新相機改變的是似然本身(共變量偏移或概念偏移),只修正先驗並不夠。
後驗未校準。 本章每個門檻都假設 名副其實。SVM、提升樹或深度網路的分數常有系統性的過度自信或自信不足;在保留資料上重新校準(Platt scaling、保序迴歸、溫度縮放)是標準修正方式 [12, 14]。
標籤雜訊與代理標籤。 標籤記錄的可能是一次不完美的檢查,而非物理真相。這時模型學到的是檢查員的後驗,而不是世界的後驗。
單一數字的摘要。 兩個準確率相同的分類器,偽陰性率可能不同,期望損失也可能差很多。請一併報告混淆矩陣、操作點與成本。
現代觀點
貝氏決策理論已有半世紀以上的歷史,而它的詞彙(後驗、風險、拒絕、操作點)如今正是可信賴深度學習的詞彙。2017 年以來的研究,大多在處理一件事:當分類器是大型網路時,如何讓餵給貝氏規則的輸入值得信賴。
校準。 Guo 等人 [12] 發現現代深度網路比十年前較淺的網路校準差得多。他們把這與深度、寬度、權重衰減和批次正規化連結起來,並證明溫度縮放(temperature scaling,把所有 logit 除以一個在驗證資料上擬合的純量,即單參數版的 Platt scaling)出奇有效。Minderer 等人 [13] 在 2021 年前後的影像分類器上重新檢視這個問題,發現最新的模型,尤其是不使用卷積的模型,屬於校準最好的一群;早期觀察到的「模型越大、或分布偏移時校準越差」的趨勢,在新架構上不那麼明顯。Silva Filho 等人的綜述 [14] 是最好的入門:涵蓋適當評分規則(proper scoring rules)與校準指標、可靠度圖,以及二元與多類別的事後校準方法的完整整理。Gawlikowski 等人 [23] 回顧神經網路不確定性這個更大的領域,區分可降低的模型不確定性與不可降低的資料不確定性,並涵蓋貝氏神經網路、集成與測試時資料擴增。
拒絕與選擇性分類。 Chow 的拒絕規則 [5] 以選擇性分類(selective classification)之名被重新發現。Geifman 與 El-Yaniv [16] 示範如何在訓練好的網路外加上拒絕門檻,使被接受樣本上的風險以高機率低於使用者指定的水準,用覆蓋率換取有保證的準確率。Hendrickx 等人的綜述 [15] 形式化兩種拒絕:模糊拒絕(Chow 的情形)與新穎拒絕(與訓練資料不同的輸入),回顧如何同時評估模型的預測品質與拒絕品質,並分類學習含拒絕選項模型的架構。
不依賴分布的保證。 共形預測(conformal prediction)把單一標籤換成一個標籤集合,在「校準資料與測試資料可交換」這個唯一假設下,保證以指定機率(例如 )包含真實類別。Angelopoulos 與 Bates [17] 提供附程式碼的實作導論。預測集合很大時,扮演的就是拒絕的角色:模型在告訴你它無法縮小範圍。
開放集辨識與分布外偵測。 在 個已知類別上正規化的後驗,沒辦法說「以上皆非」。Geng、Huang 與 Chen [18] 綜述開放集辨識(open-set recognition):定義、模型家族、資料集與評估方式,以及它和含拒絕選項的分類、零樣本與少樣本學習的關係。Yang 等人 [19] 把異常偵測、新穎偵測、開放集辨識、分布外(OOD)偵測與離群值偵測統一為廣義 OOD 偵測框架下的子任務。有兩個結果與本章直接相關。Hendrycks 與 Gimpel [20] 指出,最大 softmax 機率(也就是 Chow 的統計量)是偵測誤分類與分布外輸入的強大基準。Vaze 等人 [21] 發現分類器說「以上皆非」的能力,與它的封閉集準確率高度相關,因此改善一般分類器就能改善開放集表現。Lee 等人 [22] 在預訓練網路的特徵上擬合共用共變異數的類別條件高斯(正是上面的情形 2/LDA),並以馬氏距離作為信心分數。一個 1970 年代風格的生成式分類器,放在學習到的特徵上,至今仍是有競爭力的 OOD 偵測器。
開放問題。 成本很少能精確得知,而且會隨時間改變;在一個分布上量到的校準,不一定能移轉到另一個分布;共形覆蓋率這類保證是邊際的(對輸入平均),而非針對特定輸入或子群體的條件保證。損失矩陣應該是什麼、由誰決定,仍是沒有任何估計器能回答的人類問題。
重點整理
- 辨識系統把觀測映射到特徵、特徵映射到信念、信念映射到行動;抽樣單位與資料切分是問題定義的一部分。
- 先驗、似然與後驗回答不同的問題。稀有類別需要強證據:盛行率 時,靈敏度 的檢測得到的後驗低於 。
- 最大後驗使錯誤率最小;最小條件風險可處理任何損失矩陣。兩類別時兩者都是似然比檢定,門檻取決於先驗乘上成本。
- 當最大後驗低於 時,Chow 規則拒絕;它處理模糊性,不處理新穎性。
- 判別函數在單調轉換下等價。高斯類別共用共變異數時邊界為線性(LDA),共變異數不同時為二次(QDA)。
- ROC 曲線把分數與門檻分開;Neyman–Pearson 引理使似然比成為最佳分數;陽性稀少時,PR 曲線更有資訊量。
- 這一切都仰賴校準良好的機率與穩定的先驗,而校準、選擇性分類、共形預測與 OOD 偵測等現代研究,正是在設法確保這兩件事。
練習
- 不對稱成本。 偽陽性成本為四、偽陰性成本為一時,推導後驗 上的二元決策門檻。這條規則現在偏向哪個類別?為什麼?
提示
當 時選 ,所以門檻是 。現在假警報才是昂貴的錯誤,規則需要強證據才會說「陽性」。
- 拒絕與否。 後驗為 、拒絕成本 ,在零一分類損失下選出最小風險行動。 為哪些值時答案會改變?
提示
最佳分類風險為 ,所以拒絕。當 時,系統會分類(判為 )。
- 移動的邊界。 兩個一維類別 、。求先驗相等與 時的最小錯誤率邊界;再求先驗相等、偽陰性成本為偽陽性四倍時的最小風險邊界。
提示
對數似然比為 。先驗相等:。:,所以 。:,所以 。先驗與成本透過同一個門檻作用,這裡方向相反。
- 馬氏距離與歐氏距離。 兩類別共用 ,平均值 、,先驗相等。分別用歐氏最近平均值規則與貝氏(LDA)規則分類 ,並解釋為何不一致。
提示
歐氏距離平方:到 為 ,到 為 ,所以最近平均值規則判為 。馬氏距離平方:到 為 ,到 為 ,平手: 恰好在 LDA 邊界上。第一個特徵變異很大,所以沿它偏移 2 個單位只是弱證據;歐氏規則高估了它。
- 從零計算 ROC。 只用 NumPy,把 ROC 程式範例中的分數排序後計算 ROC 曲線與 AUC,並與
roc_auc_score比對。接著把盛行率改成 ,說明 ROC、AUC 與固定門檻下的精確率中,哪些會改變。
提示
把分數由大到小排序;標籤的累積和給出 TP 數,標籤的累積和給出 FP 數;用梯形法把 TPR 對 FPR 積分。ROC 與 AUC 只取決於兩個類別條件分數分布,因此(除抽樣雜訊外)不變;固定門檻下的精確率會大幅下降,因為偽陽性現在來自大得多的陰性群體。
- 抽樣單位。 某測試集包含與訓練所用影片相同影片中的相鄰影格。說明它的準確率估計的是什麼,並提出能估計新影片、新相機或新受試者表現的切分方式。
提示
它估計的是在訓練影格近似複本上的準確率(內插任務)。請以錄影為單位切分(分組切分);如果部署時會遇到新相機或新的人,也要保留整台相機或整位受試者。
參考文獻
- R. O. Duda, P. E. Hart and D. G. Stork, Pattern Classification, 2nd ed., Wiley, 2001 (Ch. 2, Bayesian decision theory). publisher page
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006 (Sections 1.2 and 1.5). official page and free PDF
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2008 (Ch. 1–2). publisher page
- T. Hastie, R. Tibshirani and J. Friedman, The Elements of Statistical Learning, 2nd ed., Springer, 2009 (Section 4.3, linear discriminant analysis). official page
- C. K. Chow, “On optimum recognition error and reject tradeoff,” IEEE Transactions on Information Theory, vol. 16, no. 1, pp. 41–46, 1970. doi
- J. Neyman and E. S. Pearson, “On the problem of the most efficient tests of statistical hypotheses,” Philosophical Transactions of the Royal Society of London, Series A, vol. 231, pp. 289–337, 1933. doi
- T. Fawcett, “An introduction to ROC analysis,” Pattern Recognition Letters, vol. 27, no. 8, pp. 861–874, 2006. doi
- J. Davis and M. Goadrich, “The relationship between precision-recall and ROC curves,” in Proc. International Conference on Machine Learning (ICML), 2006. doi
- T. Saito and M. Rehmsmeier, “The precision-recall plot is more informative than the ROC plot when evaluating binary classifiers on imbalanced datasets,” PLOS ONE, vol. 10, no. 3, e0118432, 2015. doi
- M. Saerens, P. Latinne and C. Decaestecker, “Adjusting the outputs of a classifier to new a priori probabilities: a simple procedure,” Neural Computation, vol. 14, no. 1, pp. 21–41, 2002. doi
- Z. C. Lipton, Y.-X. Wang and A. Smola, “Detecting and correcting for label shift with black box predictors,” in Proc. ICML, PMLR 80, 2018. paper
- C. Guo, G. Pleiss, Y. Sun and K. Q. Weinberger, “On calibration of modern neural networks,” in Proc. ICML, PMLR 70, 2017. paper
- M. Minderer, J. Djolonga, R. Romijnders, F. Hubis, X. Zhai, N. Houlsby, D. Tran and M. Lucic, “Revisiting the calibration of modern neural networks,” in Advances in Neural Information Processing Systems (NeurIPS), 2021. paper
- T. Silva Filho, H. Song, M. Perello-Nieto, R. Santos-Rodriguez, M. Kull and P. Flach, “Classifier calibration: a survey on how to assess and improve predicted class probabilities,” Machine Learning, vol. 112, pp. 3211–3260, 2023. doi
- K. Hendrickx, L. Perini, D. Van der Plas, W. Meert and J. Davis, “Machine learning with a reject option: a survey,” Machine Learning, vol. 113, pp. 3073–3110, 2024. doi
- Y. Geifman and R. El-Yaniv, “Selective classification for deep neural networks,” in Advances in Neural Information Processing Systems (NeurIPS), 2017. paper
- A. N. Angelopoulos and S. Bates, “Conformal prediction: a gentle introduction,” Foundations and Trends in Machine Learning, vol. 16, no. 4, pp. 494–591, 2023. doi
- C. Geng, S.-J. Huang and S. Chen, “Recent advances in open set recognition: a survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 43, no. 10, pp. 3614–3631, 2021. doi
- J. Yang, K. Zhou, Y. Li and Z. Liu, “Generalized out-of-distribution detection: a survey,” International Journal of Computer Vision, vol. 132, pp. 5635–5662, 2024. doi
- D. Hendrycks and K. Gimpel, “A baseline for detecting misclassified and out-of-distribution examples in neural networks,” in Proc. International Conference on Learning Representations (ICLR), 2017. arXiv
- S. Vaze, K. Han, A. Vedaldi and A. Zisserman, “Open-set recognition: a good closed-set classifier is all you need,” in Proc. ICLR, 2022. arXiv
- K. Lee, K. Lee, H. Lee and J. Shin, “A simple unified framework for detecting out-of-distribution samples and adversarial attacks,” in Advances in Neural Information Processing Systems (NeurIPS), 2018. paper
- J. Gawlikowski et al., “A survey of uncertainty in deep neural networks,” Artificial Intelligence Review, vol. 56, suppl. 1, pp. 1513–1589, 2023. doi
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 02・密度估計與貝氏學習 · 19 分鐘