PR 03・迴歸與分類的線性模型
先備知識:PR 02・密度估計與貝氏學習、ML 01C・數值計算與梯度檢查
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
圖形識別
你將學到
- 看懂線性判別函數的幾何(權重向量、偏差、帶號距離),以及用兩類別分類器組成多類別分類器的陷阱。
- 推導最小平方法、ridge 迴歸及其貝氏詮釋,並理解為何最小平方法是脆弱的分類器。
- 推導 Fisher 線性判別,並連結到 PR 01 的高斯 LDA。
- 訓練感知器、證明它的收斂定理,並說明它為何可能停在任何一條分隔線上。
- 用牛頓法擬合邏輯斯迴歸,並解釋可分資料為何會把權重推向無限大。
- 推導最大間隔 SVM、它的 Lagrange 對偶問題與支援向量,並把這些方法都看成同一個線性分數上的不同損失。
先看全貌
線性模型是每門圖形識別課程中第一個真正的分類器,也一直是面對新表徵時第一個該試的方法。如果一條直線就能在特徵空間中分開兩個類別,大型非線性分類器可能只增加成本,而不增加有用的準確率。如果線性基準失敗了,它的錯誤能幫助我們找出缺少的特徵或非線性結構。在現代深度學習中,幾乎每個分類器的最後一層都是學習特徵上的線性模型,而「線性分類器在這些特徵上表現如何?」正是評估表徵的標準測試。
線性分數是 。特徵映射 可以是原始強度、平方值、梯度,或凍結的神經網路嵌入。「線性」指的是參數 與 ,不一定是原始量測 :取 時,線性模型在 上畫出的是彎曲的邊界。本章依循 Duda、Hart 與 Stork [1, Ch. 5]、Bishop [2, Ch. 3–4, 7] 以及 Theodoridis 與 Koutroumbas [3, Ch. 3],統計觀點參考 Hastie 等人 [4]。讓 變成隱式且非常豐富的核方法,是 PR 04 的主題。
線性判別函數
白話版。 兩類別線性分類器是穿過特徵空間的一刀平切:二維中是直線,三維中是平面,一般情形是超平面。權重向量決定這一刀面向哪裡,偏差決定它切在哪裡。
精確版。 兩類別時,若 判為 ,否則判為 。決策邊界 是超平面 。由線性分類器的幾何可得三個事實 [1, 2, 3]:
- 是 的法向量:對 上任兩點 ,。
- 任一點 到 的帶號距離為 。所以 正比於 離邊界多遠、在哪一側。
- 當 ,原點到 的一般距離是 ;依上面的符號慣例,有號距離為 ,而 上離原點最近的點是 。偏差只平移平面,不旋轉它。
把輸入擴增一個常數來吸收偏差很方便:、,於是 。程式中我們默默這麼做。標籤取 時,樣本被正確分類的充要條件是它的函數間隔(functional margin) 為正。下面每個方法都能用這個量來表示。
超過兩個類別。 兩類別分類器有兩種直覺的組合方式:一對其餘(one-versus-rest, 個分類器,各自把一類和其他所有類分開),以及一對一(one-versus-one,每對類別一個,共 個,再投票)。兩者都可能在輸入空間留下投票結果模糊的區域 [2, Section 4.1.2]。乾淨的解法是線性機(linear machine):每個類別一個判別函數 ,把 判給分數最大的類別。它的決策區域一定是凸且單連通的,因為若 與 都是 最大,兩點之間每一點也是如此(每個 沿線段都是線性的)。PR 01 的高斯 LDA、多類別邏輯斯迴歸,以及神經網路的最後一層,都是線性機。
最小平方法與 ridge 迴歸
白話版。 要預測一個數值,就選讓預測誤差平方最小的權重。如果權重比資料能支撐的多,再加上對大權重的懲罰。
精確版。 令設計矩陣 的第 列是特徵向量 (含截距用的常數座標), 是目標值。最小平方法最小化
其梯度 在正規方程 處為零。對滿欄秩設計矩陣,形成 就會使 2-範數條件數平方,而顯式求逆更沒有必要;基於 QR 或 SVD 的解法(np.linalg.lstsq)處理近乎相依的欄位更可靠。若假設目標值帶有獨立、同變異數的高斯雜訊,此目標函數與負對數似然只差一個正比例因子及加法常數,因此最小平方法就是最大似然估計(PR 02)。雜訊假設說明了統計詮釋,但不代表平方誤差適合所有目標。
Ridge 迴歸 [8] 加上懲罰 ,得到
只要 ,左邊的矩陣一定可逆,即使 也是。截距通常不納入懲罰。特徵縮放很重要,因為同樣的懲罰對不同單位的座標效果不同;縮放統計量只能在訓練資料上擬合。
貝氏連結
給權重高斯先驗 (精度 )與精度為 的高斯雜訊,權重的後驗是高斯分布,其共變異數與平均值為 [2, Section 3.3]
對新的特徵向量 ,預測分布為
第一個變異數項是觀測雜訊;第二項表達對權重的不確定性,在訓練資料很少涵蓋的特徵方向上會比較大。後驗平均 等於 的 ridge 解:ridge 是 MAP 估計,和 PR 02 的高斯平均是同一個故事。
用最小平方法做分類
白話版。 可以把類別標籤當成數字( 與 ,或 one-hot 向量),再用最小平方法擬合。它很快、有封閉解,但工具不對:它會懲罰「太正確」的點。
精確版。 對 個類別,把目標編碼成 one-hot 向量 ,用最小平方法擬合線性機 ,,再依最大輸出分類。兩類別時若選用適當的目標值(類別 1 為 ,類別 0 為 ),最小平方的方向正好是下一節推導的 Fisher 方向 [2, Section 4.1.5],所以這個方法並非毫無道理。
它有兩個眾所周知的失敗模式:
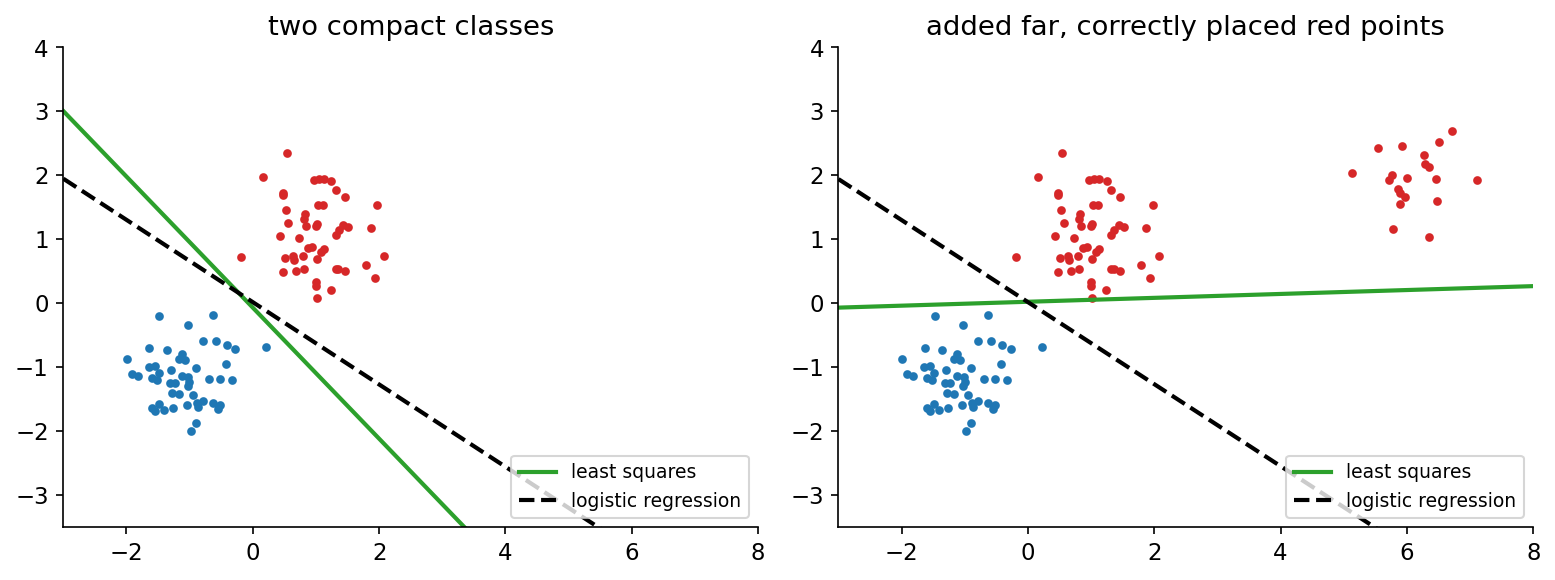
- 對遠在正確一側的點很敏感。 對目標 而言,平方誤差懲罰 和懲罰 一樣重。圖 1 加入二十個已被正確分類、但位置很遠的紅點;最小平方法為了減少它們的「誤差」而旋轉邊界,開始把藍點分錯。邏輯斯迴歸幾乎不動。
- 三類以上時的遮蔽(masking)。 當類別大致排成一直線時,中間類別的輸出可能處處被鄰居壓過,於是中間類別永遠不會被預測出來 [4, Section 4.2]。
從機率的角度看,最小平方法背後的高斯雜訊模型對二元目標根本是錯的。解法是使用為分類設計的損失,本章其餘部分就在做這件事。
Fisher 線性判別
白話版。 把所有點投影到一條線上,看兩個類別的一維直方圖。好的線會讓兩類平均值離得遠,而且每類都很窄。Fisher 方向就是讓這個比值最大的那條線。
精確版。 Fisher [5] 提議選擇投影 ,使投影後類別平均值的分離程度相對於各類內部的分散最大。令 為類別平均。投影後的平均是 ,類別 投影後的類內散布為 ,其中 。Fisher 準則為
其中
分別是類間與類內散布矩陣。 與 的長度無關,只與方向有關。
推導。 令比值的梯度為零,得到
括號中的兩項都是純量。此外 永遠指向 。因此 ,又因為只有方向重要,
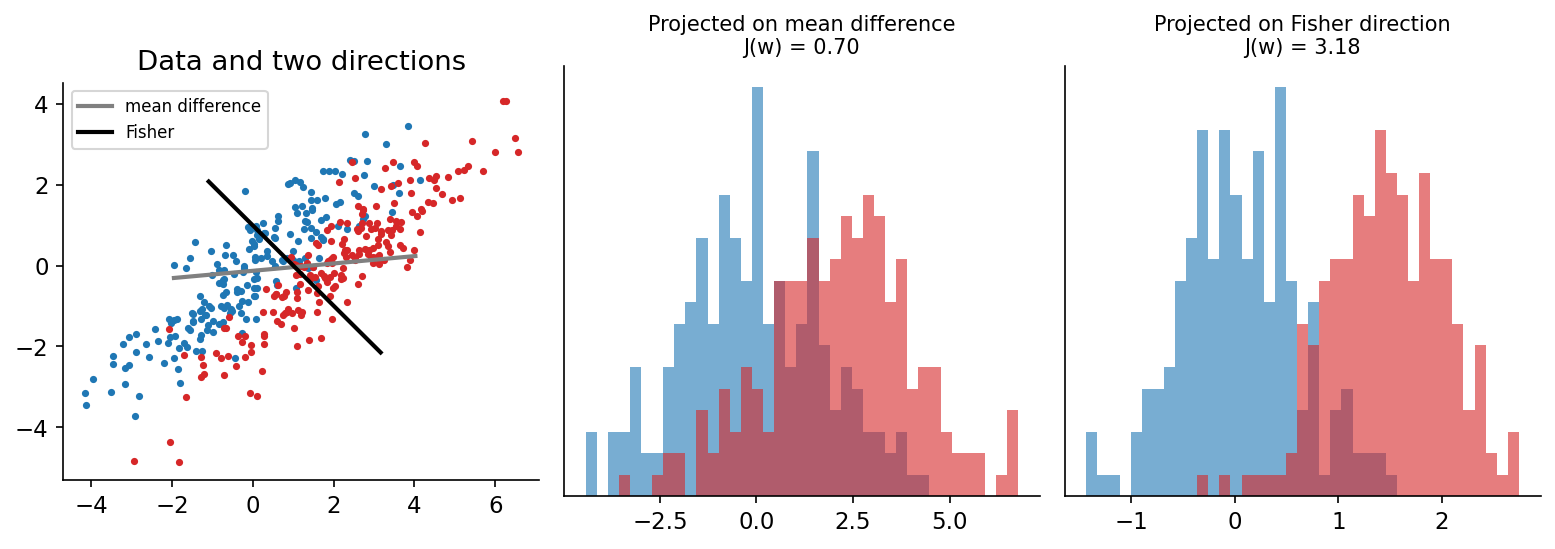
若 是單位矩陣的倍數(等向、不相關的類別),Fisher 方向就是平均值差。否則 會把它從類別分散較大的方向轉開。圖 2 顯示兩個細長、相關的類別的效果:投影到平均值差上,直方圖嚴重重疊();投影到 Fisher 方向,兩者分得很開()。
與高斯 LDA 的關係。 Fisher 準則不做任何分布假設;它是表徵的準則。但當 正比於匯集的類內共變異數時,它的方向與 PR 01 的高斯 LDA 方向 相同。兩者只差在門檻:Fisher 不指定投影軸上的切點,高斯 LDA 則由類別平均與先驗決定切點。所以兩者都稱為「LDA」。(在主題模型中,LDA 也指 latent Dirichlet allocation,與此無關。)Fisher 投影本身不提供校準過的機率。
超過兩個類別。 個類別、整體平均為 時,定義 與 。使多類別準則最大的投影 ,由 的前幾個特徵向量張成 [1, 2]。因為 是受整體平均約束的 個秩一項之和,秩最多為 ,所以 Fisher 最多只能產生 個有用的特徵。這就是 PR 05 中的監督式降維。
程式碼:Fisher 方向
程式碼 · Python · 21 行
import numpy as np
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis

rng = np.random.default_rng(2)
cov = np.array([[3.0, 2.4], [2.4, 2.4]])
X0 = rng.multivariate_normal([0, 0], cov, 200)
X1 = rng.multivariate_normal([2, 0], cov, 200)
m0, m1 = X0.mean(0), X1.mean(0)
S_W = np.cov(X0.T) + np.cov(X1.T)       # within-class scatter (per-class covariances)
w = np.linalg.solve(S_W, m1 - m0)                          # Fisher direction

def J(v):                       # Fisher criterion for two classes
    return (v @ (m1 - m0)) ** 2 / (v @ S_W @ v)

lda = LinearDiscriminantAnalysis().fit(np.vstack([X0, X1]), np.repeat([0, 1], 200))
cos = w @ lda.coef_[0] / np.linalg.norm(w) / np.linalg.norm(lda.coef_[0])
angles = np.linspace(0, np.pi, 3601)
best = max(J(np.array([np.cos(a), np.sin(a)])) for a in angles)
print(f"J(mean difference) = {J(m1 - m0):.4f}, J(Fisher) = {J(w):.4f}, "
      f"grid maximum = {best:.4f}")
print(f"cosine between Fisher direction and LDA coef_: {cos:.6f}")封閉解達到網格搜尋的最大值(),超過平均值差()的四倍;它的方向與 scikit-learn 高斯 LDA 的係數在小數點後六位一致(餘弦 )。
感知器
白話版。 從任意一條線開始。逐一檢查訓練點;每當有點落在錯誤的一側,就把線往能正確分類它的方向推一點。如果類別可以被一條線分開,這個過程保證會停下來。
精確版。 Rosenblatt 的感知器(perceptron)[6] 使用標籤 與擴增特徵 。它最小化感知器準則
其中 是被分錯的樣本集合( 者)。每一項都非負,且 的充要條件是所有樣本都被正確分類。每次對一個分錯的樣本做隨機梯度下降,得到更新規則
以零初始化 時,學習率 只會縮放 ,不會改變決策序列,所以常取 。IP 13 的感知器一節以影像圖樣的語言介紹同一條規則,並連結到多層網路。
收斂定理。 假設資料以間隔 線性可分:存在單位向量 ,使所有 都滿足 。令 。那麼感知器(從 開始)最多更新 次。證明只要三行。經過 次更新後:
- 每次更新讓 增加 ,所以 ;
- 每次更新都發生在錯誤上,此時 ,所以 ,因此 ;
- 由 Cauchy–Schwarz 不等式,,所以 。
這個上界與樣本數和維度都無關,只取決於類別之間的空隙相對於資料大小有多「寬」。
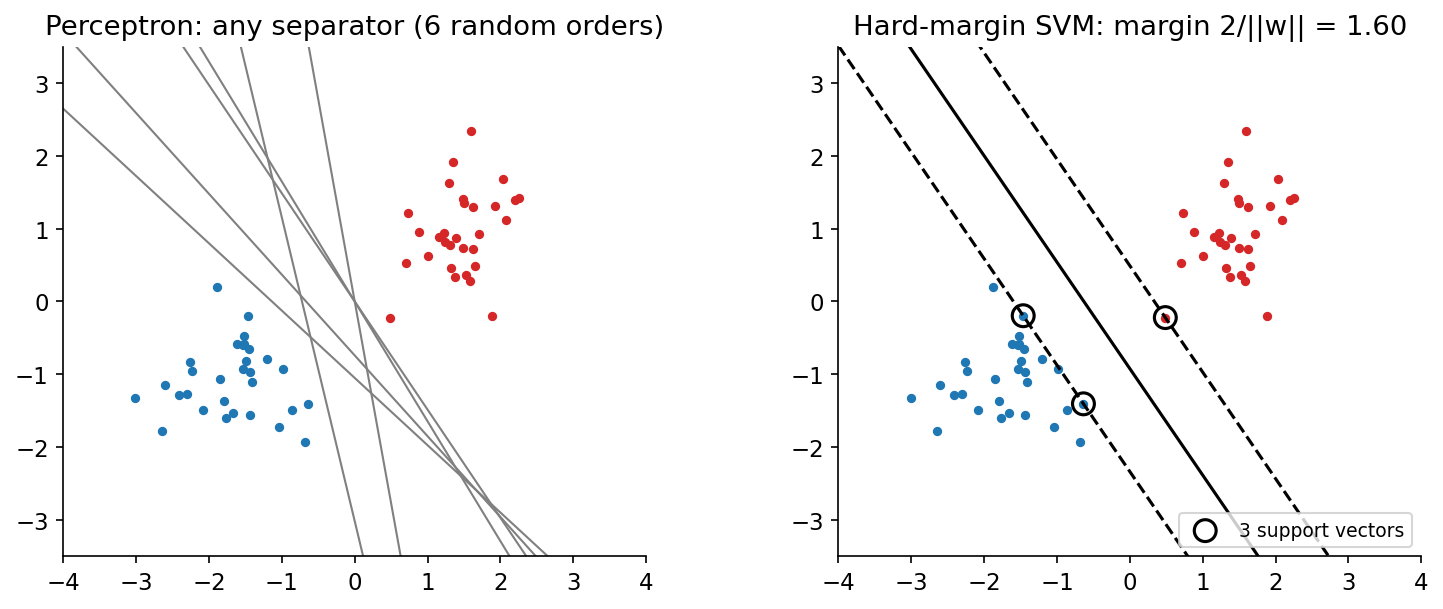
限制。 如果類別重疊,感知器永遠不會停止,權重會一直循環(實務上常見的修正是保留目前看過最好的權重)。即使收斂了,它也停在第一條碰到的分隔超平面上,而這取決於初始化與資料順序(圖 3 左)。它的分數也不是機率。從損失的角度看,感知器使用 ,任何正確分類(無論多勉強)的損失都是零。邏輯斯迴歸與 SVM 都要求比「剛好正確」更多,藉此修正這一點。
程式碼:感知器更新次數與上界
程式碼 · Python · 35 行
import numpy as np
from sklearn.svm import SVC

rng = np.random.default_rng(1)
X = np.vstack([rng.normal([-1.0, -0.7], 0.6, (30, 2)),
               rng.normal([1.0, 0.7], 0.6, (30, 2))])
y = np.r_[-np.ones(30), np.ones(30)]
Phi = np.c_[X, np.ones(len(X))]          # augmented features (bias as last weight)

def perceptron(Phi, y, rng, max_epochs=1000):
    w, updates = np.zeros(Phi.shape[1]), 0
    for epoch in range(max_epochs):
        errors = 0
        for i in rng.permutation(len(y)):
            if y[i] * (w @ Phi[i]) <= 0:  # misclassified or on the boundary
                w += y[i] * Phi[i]        # learning rate 1 (scale is irrelevant)
                errors += 1
        updates += errors
        if errors == 0:
            return w, updates
    return w, updates

runs = [perceptron(Phi, y, np.random.default_rng(s)) for s in range(200)]
updates = np.array([u for _, u in runs])
print(f"updates over 200 random orders: mean {updates.mean():.1f}, "
      f"max {updates.max()}")
print("all runs separate the data:",
      all(np.all(np.sign(Phi @ w) == y) for w, _ in runs))

# convergence bound (R / gamma)^2, with gamma from the max-margin separator
svm = SVC(kernel="linear", C=1e6).fit(X, y)
u = np.r_[svm.coef_[0], svm.intercept_[0]]
gamma = np.min(y * (Phi @ u)) / np.linalg.norm(u)
R = np.max(np.linalg.norm(Phi, axis=1))
print(f"bound (R/gamma)^2 = {(R / gamma) ** 2:.1f}")
在 200 種隨機呈現順序下,感知器平均需要 次更新(最多 次),且每次執行都能分開資料。最壞情況上界是 :它是保證,不是預測。上界需要一個有效的間隔 ;我們從硬間隔 SVM(下方 SVM 一節的主題)取得它。由於 SVM 不懲罰偏差,擴增空間中真正的最大間隔可能稍大一些,會給出稍緊的上界。
邏輯斯迴歸
白話版。 不要硬性的是/否,而是把線性分數通過一條 S 形曲線壓成機率。擬合權重,讓真實標籤被賦予的機率盡可能高。
精確版。 標籤取 ,二元邏輯斯迴歸 [7] 的模型為
分數 是對數勝算 。這個形式並非隨意選的。PR 01 證明了共用共變異數的高斯類別,其後驗正好是 ,其中 ;許多其他類別條件分布族也是如此。邏輯斯迴歸保留這個後驗的函數形式,但直接擬合 ,只有 個參數,而非高斯模型的 個。Ng 與 Jordan [18] 分析了這種生成式與判別式之間的取捨(PR 02)。
訓練。 Bernoulli 模型的負對數似然是交叉熵
因為 ,它的梯度與 Hessian 矩陣出奇簡單 [2, Section 4.3]:
梯度和最小平方法一樣是「預測減目標,乘上輸入」的形式。 是半正定的,所以 是凸函數,沒有虛假的局部最小值。牛頓法 可以改寫成每次迭代權重 都會改變的加權最小平方問題:迭代重新加權最小平方法(iteratively reweighted least squares, IRLS)。程式中請從 logit 以穩定的公式計算損失,例如 np.logaddexp(0, z),而不是對捨入後的機率取對數。
可分資料。 如果有超平面能分開訓練類別,把 放大會讓每個 更接近它的標籤,所以 一直下降趨近於零,未正則化的解並不存在:。實務上請一定要正則化,例如加上 (scikit-learn 的 C 就是 )。值得注意的是,權重如何發散是明確定義的:在可分資料上,單純的梯度下降會在方向上收斂到最大間隔 SVM 的解 [19],「現代觀點」會再回到這一點。
多類別。 把 sigmoid 換成 softmax ,交叉熵換成 類別版本。這是有機率輸出的線性機,也正是標準神經網路分類器的最後一層加損失函數。在標籤雜訊或分布偏移下,機率輸出不會自動保持校準(PR 01)。
程式碼:牛頓法(IRLS)與可分資料
程式碼 · Python · 27 行
import numpy as np
from sklearn.linear_model import LogisticRegression

rng = np.random.default_rng(0)
X = np.vstack([rng.normal(-1, 1, (100, 2)), rng.normal(1, 1, (100, 2))])
y = np.r_[np.zeros(100), np.ones(100)]
Phi = np.c_[np.ones(len(X)), X]

def nll(w, lam):
    z = Phi @ w
    # log(1 + e^z) - y z, written stably with logaddexp
    return np.sum(np.logaddexp(0, z) - y * z) + 0.5 * lam * np.sum(w[1:] ** 2)

# Newton's method (iteratively reweighted least squares)
lam, w = 1.0, np.zeros(3)
for it in range(20):
    p = 1 / (1 + np.exp(-(Phi @ w)))
    grad = Phi.T @ (p - y) + lam * np.r_[0, w[1:]]
    H = Phi.T @ (Phi * (p * (1 - p))[:, None]) + lam * np.diag([0, 1, 1])
    step = np.linalg.solve(H, grad)
    w -= step
    if np.linalg.norm(step) < 1e-10:
        break
sk = LogisticRegression(C=1 / lam, tol=1e-10, max_iter=1000).fit(X, y)
print(f"Newton converged in {it + 1} iterations, loss {nll(w, lam):.4f}")
print("Newton:      ", np.round(w, 4))
print("scikit-learn:", np.round(np.r_[sk.intercept_, sk.coef_[0]], 4))
牛頓法在 次迭代內收斂,得到與 scikit-learn 相同的權重(截距、、)。懲罰不包含截距,與 scikit-learn 的慣例一致。
下一段程式在可被一條通過原點的直線分開的資料上,對未正則化的邏輯斯損失執行單純的梯度下降,並追蹤權重範數,以及 與最大間隔方向之間的餘弦。
程式碼 · Python · 20 行
import numpy as np
from sklearn.svm import LinearSVC

rng = np.random.default_rng(1)
X = np.vstack([rng.normal([2.0, 1.0], 0.6, (40, 2)),
               rng.normal([-2.0, -1.0], 0.6, (40, 2))])
y = np.r_[np.ones(40), -np.ones(40)]              # separable through the origin

# max-margin direction without bias (hard margin approximated by large C)
svm = LinearSVC(fit_intercept=False, loss="hinge", C=1e4, max_iter=200000).fit(X, y)
u = svm.coef_[0] / np.linalg.norm(svm.coef_[0])

w, lr = np.zeros(2), 0.1
for t in range(1, 100001):
    m = y * (X @ w)
    grad = -(X * (y / (1 + np.exp(m)))[:, None]).mean(0)   # logistic loss gradient
    w -= lr * grad
    if t in (10, 100, 1000, 10000, 100000):
        print(f"step {t:6d}: ||w|| = {np.linalg.norm(w):6.2f}, "
              f"cos(w, SVM) = {w @ u / np.linalg.norm(w):.5f}")
範數無上限地增長,但很慢(10 步後 , 步後 ),而與 SVM 方向的餘弦從 緩慢爬升到 。這正是 Soudry 等人 [19] 預測的、以對數速度收斂到最大間隔方向的現象。
支援向量機:最大間隔
白話版。 在所有能分開類別的直線中,選周圍那條空「馬路」最寬的一條。只有站在馬路邊緣的點才重要;其他點只要不越過馬路,怎麼移動答案都不變。
精確版。 使用標籤 與分數 (這裡偏差分開寫)。對分隔超平面而言, 到邊界的距離是 。因為 與 定義同一個平面,我們固定尺度,使最近的點滿足 (標準形式)。於是每一側的間隔是 ,馬路寬度是 。最大化它等價於凸二次規劃 [9, 10]
Lagrange 函數與對偶。 為每個限制式引入乘數 :
令 、,得到
代回後消去 與 ,剩下對偶問題
- 支援向量。 Karush–Kuhn–Tucker(KKT)條件包含互補鬆弛性 。所以只有恰好落在間隔上的點才有 。這些點就是支援向量(support vector);其他點的 ,拿掉也不會改變解。偏差可由任一支援向量 求得:(為了數值穩定,對所有支援向量取平均)。
- 預測的稀疏性。 只取決於支援向量集合 。
- 只有內積。 資料在對偶問題與預測中只以內積 出現。把內積換成核函數 ,就得到非線性 SVM,而完全不必計算 。這就是核技巧,在 PR 04 中發展。
軟間隔與鉸鏈損失。 真實類別會重疊,所以限制式不可能全部成立。Cortes 與 Vapnik [10] 加入鬆弛變數 、限制式 與懲罰 。在最佳解處 ,所以軟間隔 SVM 等價於無限制問題
第二項是鉸鏈損失(hinge loss):超出間隔的點為零,在間隔內與錯誤一側則線性增加。對偶問題中唯一的改變是盒狀限制 。所以線性 SVM 就是「ridge 正則化的鉸鏈損失最小化」,可以直接和正則化的邏輯斯迴歸比較。、核頻寬與特徵縮放的作用,以及 SVM 分數不是機率這件事,都在 PR 04 討論。
程式碼:實際驗證對偶關係
這段檢查擬合一個(近乎)硬間隔的線性 SVM,並以數值驗證對偶關係:、,以及支援向量上 。
程式碼 · Python · 19 行
import numpy as np
from sklearn.svm import SVC

rng = np.random.default_rng(7)
X = np.vstack([rng.normal([-1.5, -1.0], 0.6, (30, 2)),
               rng.normal([1.5, 1.0], 0.6, (30, 2))])
y = np.r_[-np.ones(30), np.ones(30)]

svm = SVC(kernel="linear", C=1e6).fit(X, y)          # huge C ~ hard margin
alpha_y = svm.dual_coef_[0]                          # alpha_n * y_n for SVs
w_dual = alpha_y @ svm.support_vectors_              # w = sum_n alpha_n y_n x_n
f = X @ svm.coef_[0] + svm.intercept_[0]

print("support vectors:", len(svm.support_), "of", len(y))
print("w from dual:", np.round(w_dual, 4), " coef_:", np.round(svm.coef_[0], 4))
print("sum_n alpha_n y_n =", round(float(alpha_y.sum()), 8))
print("y f(x) on support vectors:", np.round(y[svm.support_] * f[svm.support_], 4))
print("smallest y f(x) over all points:", round(float(np.min(y * f)), 4))
print("margin width 2/||w|| =", round(2 / np.linalg.norm(svm.coef_[0]), 4)) 個點中只有 個是支援向量(圖 3 中被圈起的點)。由對偶係數重建的權重向量與 coef_ 完全一致,對偶係數總和為零,支援向量落在 (在求解器容許誤差內),沒有點落在間隔之內,間隔寬度為 。scikit-learn 的 SVC 包裝了 LIBSVM [16];對大型稀疏問題,LinearSVC 與 LogisticRegression(solver="liblinear") 使用 LIBLINEAR [14],而 Pegasos [15] 這類隨機次梯度求解器可擴展到非常大的資料集。
一張圖看懂:線性分類器就是損失函數
白話版。 本章所有方法都用同一個線性函數為點打分數。差別在於對每個間隔值 收多少費用:只要正確就不收(感知器)、安全地正確才不收(SVM)、平滑遞減的費用(邏輯斯),或以恰好 為中心的拋物線(最小平方)。
精確版。 標籤取 、間隔 ,每個方法都在最小化某個代理損失(surrogate loss) 的(可能正則化的)平均值,用來代替非凸的零一損失 (圖 4):
| 方法 | 損失 | 行為 |
|---|---|---|
| 感知器 | 任何正確的點都為零;與尺度無關,所以 是平凡的最小解 | |
| 鉸鏈(SVM) | 超出間隔即為零;解是稀疏的(支援向量) | |
| 邏輯斯 | 平滑、永不為零;能給出機率 | |
| 平方 | 懲罰 :「太正確」的點會拉動邊界 |
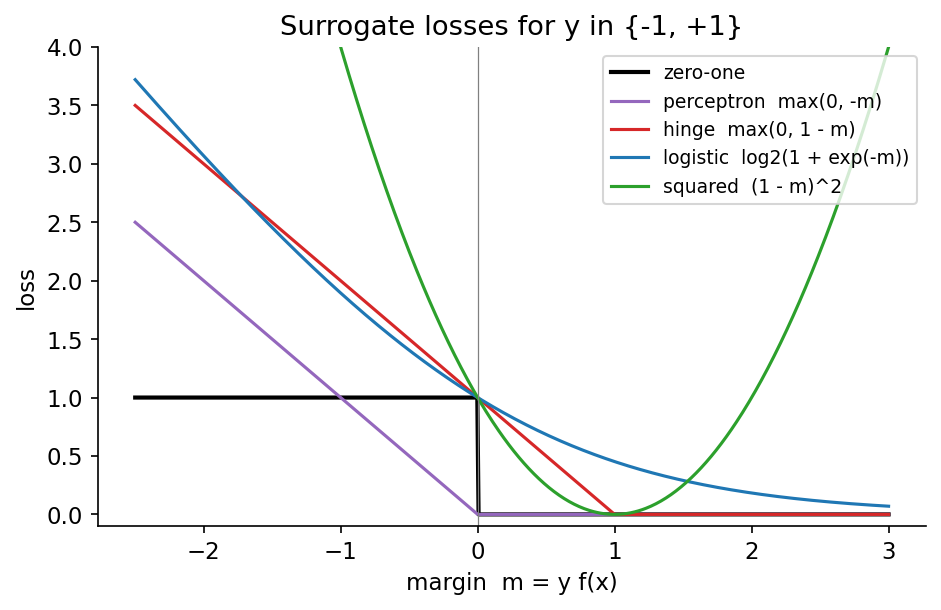
在資料足夠時,哪些代理損失會得到貝氏最佳分類器?Bartlett、Jordan 與 McAuliffe [12] 給出精確的答案:凸代理損失是分類校準的(classification-calibrated,最小化其期望值會得到貝氏決策 ,其中 ),若且唯若它在 可微且 。鉸鏈、邏輯斯、平方與指數損失都符合;感知器損失不符合。他們也把代理風險的超額量與分類風險的超額量連結起來。Rosasco 等人 [13] 比較不同凸損失所隱含的收斂速率,結論是對分類而言,鉸鏈損失收斂得和邏輯斯損失差不多快,比平方損失快得多。不過這些損失估計的東西仍不同:逐點最小化期望邏輯斯損失得到 ,所以它的分數是對數勝算(經 sigmoid 即為機率);而期望鉸鏈損失的逐點最小解是 ,不帶任何機率資訊。這就是 SVM 分數需要另外校準的原因。
程式碼:在 digits 上比較線性分類器
內建的 digits 資料集(8×8 影像、10 類)不需下載。這只是一次可重現的保留集示範,不是基準排名。每個縮放器都在管線內、只用訓練資料擬合。
程式碼 · Python · 25 行
from sklearn.datasets import load_digits
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.linear_model import LogisticRegression, Perceptron, RidgeClassifier
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import LinearSVC

X, y = load_digits(return_X_y=True)
Xtr, Xte, ytr, yte = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=7)
models = {
    "least squares (ridge)": make_pipeline(StandardScaler(), RidgeClassifier(alpha=1.0)),
    "perceptron": make_pipeline(StandardScaler(),
                                Perceptron(max_iter=1500, random_state=7)),
    "logistic": make_pipeline(StandardScaler(),
                              LogisticRegression(C=1, max_iter=1500)),
    "linear SVM": make_pipeline(StandardScaler(),
                                LinearSVC(C=0.1, max_iter=20000, random_state=7)),
    "Gaussian LDA": LinearDiscriminantAnalysis(solver="lsqr", shrinkage="auto"),
}
for name, model in models.items():
    model.fit(Xtr, ytr)
    print(f"{name:22s} test accuracy: {accuracy_score(yte, model.predict(Xte)):.4f}")
在這次切分上,邏輯斯迴歸達到 ,線性 SVM ,感知器 ,ridge 正則化最小平方法與收縮 LDA 各為 。五者都是同樣 64 個像素上的線性機;差異完全來自損失與正則化。看過這些測試結果後再調整正則化,會讓這個測試集變成驗證集。真正的模型選擇需要獨立的驗證切分,或在訓練資料內做交叉驗證(PR 09)。
現代觀點
線性分類器沒有被深度學習取代;它們移到了深度學習的最上層。三條近期的研究脈絡說明它們為何仍然重要,而經典的綜述文獻對方法本身仍很有用。
綜述與求解器。 Burges 的教學文 [11] 仍是 SVM 最易讀的推導,從 VC 維度的動機一路講到對偶與核。Cervantes 等人 [17] 綜述 2020 年時的 SVM 分類:各種變形、應用,以及大型資料集上的訓練成本、類別不平衡與模型選擇等挑戰。計算方面,LIBLINEAR [14] 讓擁有數百萬稀疏特徵的線性 SVM 與邏輯斯迴歸成為例行工作;LIBSVM [16] 是 scikit-learn SVC 背後的核 SVM 參考實作;Pegasos [15] 則證明在 SVM 原始問題上做隨機次梯度下降,對線性核而言達到指定準確度所需的執行時間不直接取決於訓練集大小,這與用 SGD 訓練神經網路是同一個概念。
線性探針:衡量表徵的尺。 Alain 與 Bengio [21] 提議在網路的每一層獨立訓練線性分類器(「探針」,probe),並觀察到線性可分性隨深度單調增加。Kornblith、Shlens 與 Le [22] 在 12 個資料集上比較 16 個網路,發現把網路當固定特徵抽取器、上接邏輯斯迴歸分類器時,ImageNet 準確率與遷移準確率高度相關;但有些讓 ImageNet 準確率略為提升的正則化方式,會讓倒數第二層的特徵差很多。CLIP [23] 把它的零樣本分類器與在凍結特徵上訓練的邏輯斯迴歸探針做比較;DINOv2 [24] 也主要以凍結骨幹上的線性分類器評估其自監督特徵。Kumar 等人 [25] 證明完整微調可能扭曲好的預訓練特徵,在分布外資料上表現不如線性探針,並提出先擬合線性探針再微調(LP-FT)。換句話說:在凍結的基礎模型上,訓練一個良好正則化的邏輯斯迴歸,是很強的基準,往往也是正確的第一個實驗。
隱式偏差:邏輯斯迴歸偷偷找到了 SVM。 Soudry 等人 [19] 證明,在線性可分資料上對未正則化的邏輯斯(或交叉熵)損失做梯度下降,會在方向上收斂到硬間隔 SVM 的解;他們也把結果推廣到其他指數尾部的損失、多類別問題,以及受限設定下的深度網路。收斂速度只有對數級,這有助於解釋為何在訓練錯誤率為零後繼續訓練,仍能持續改善間隔。上面的梯度下降程式在二維中呈現了這個效果。
神經崩塌:訓練末期的 Fisher 圖像。 Papyan、Han 與 Donoho [20] 在三種架構與七個資料集上觀察到:在訓練的終端階段(訓練錯誤率為零之後),每個類別最後一層的特徵會崩塌到類別平均;類別平均排列成最大分離的對稱構型(單純形等角緊框架,simplex equiangular tight frame);分類器權重與類別平均對齊;決策規則變成最近類別平均。用本章的語言說,類內散布 縮向零,Fisher 準則無限增大,網路最後一層變成 PR 01 的最小距離分類器。
開放問題。 線性探針的結果取決於正則化與資料量,我們何時能相信它是表徵品質的衡量?隱式偏差的結果如何推廣到真實的、不可分的、有資料擴增的訓練?線性輸出層的機率在分布偏移下何時能保持校準?這些問題把本系列最古老的分類器和當前研究連在一起。
重點整理
- 線性判別函數 是以 為法向量的超平面; 是帶號距離。多類別問題請每類用一個判別函數(線性機)。
- 最小平方法與 ridge 有封閉解與貝氏 MAP 詮釋,但最小平方法是差勁的分類器:它懲罰「太正確」的點,也可能遮蔽類別。
- Fisher 方向 最大化類間對類內的分散比;它等於高斯 LDA 的方向,後者再由平均與先驗加上門檻。
- 在可分資料上,感知器最多更新 次後收斂,但會停在任意一條分隔線上,在重疊資料上則會循環。
- 邏輯斯迴歸以凸的交叉熵最小化(牛頓法/IRLS)擬合對數勝算;沒有正則化時,在可分資料上權重會發散,方向趨向最大間隔解。
- 硬間隔 SVM 最大化間隔 ;它的對偶顯示只有支援向量重要,而且資料只以內積出現,為核方法(PR 04)開啟大門。軟間隔就是 ridge 正則化的鉸鏈損失。
- 這些方法都是同一個線性分數配上不同的代理損失;鉸鏈、邏輯斯與平方損失都是分類校準的,但只有邏輯斯損失能估計機率。
練習
- 對參數線性。 證明以最小平方法擬合 是線性迴歸問題,並描述若把同樣的特徵用在兩類別線性分類器上, 上的決策區域長什麼樣子。
提示
建立設計矩陣的列 ;模型對 是線性的。 的二次式最多變號兩次,所以一個類別的區域可以是一段區間,另一類則是它的補集(兩條半直線)。
- 單位與 ridge。 兩個特徵量測同一段距離,一個以公尺、一個以毫米表示。說明沒有特徵縮放時 ridge 迴歸會怎麼做,以及為何標準化能解決問題。
提示
描述同樣效果時,毫米特徵的係數可以小 1,000 倍,因此受到的懲罰遠小得多;ridge 會把幾乎所有權重放到毫米特徵上。標準化之後,兩個座標在同樣的尺度上受懲罰。
- 手算 Fisher。 兩類別的平均為 、,類內散布 。計算 Fisher 方向並與平均值差比較。兩個方向何時會重合?
提示
,所以 ,因為類別沿 方向拉長,所以方向從平均值差 轉開。當 是 的特徵向量時兩方向恰好重合,例如 。
- 永不停止的感知器。 建構一個讓感知器永遠更新下去的一維資料集,並說明收斂定理的哪個假設不成立。
提示
在同一座標放兩個標籤相反的點(或任何重疊的類別)。不存在 的 ,所以上界不適用;每次修正一個點的更新,都會弄壞另一個點。
- 手算 SVM。 求兩點 、 與 、 的硬間隔 SVM。給出 、、對偶變數與間隔寬度,並檢查 KKT 條件。
提示
由對稱性 、。限制式 給出 ,所以 ,寬度 ,正是兩點間的距離。由 與 得 。兩點都是支援向量。
- 邏輯斯與鉸鏈。 用 digits 管線,在訓練集上以 5 折交叉驗證,為多個
C值擬合LogisticRegression與LinearSVC。比較兩者最佳的驗證準確率,再比較它們的分數:哪一個能給出有意義的機率?另一個要如何得到機率?
提示
準確率通常很接近,正如損失分析所預測。只有邏輯斯迴歸的 predict_proba 估計後驗;對 SVM,要在保留資料上擬合校準映射(Platt scaling 或保序迴歸,例如 CalibratedClassifierCV)。
參考文獻
- R. O. Duda, P. E. Hart and D. G. Stork, Pattern Classification, 2nd ed., Wiley, 2001 (Ch. 5, linear discriminant functions). publisher page
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006 (Sections 3.1–3.3, 4.1–4.3 and 7.1). official page and free PDF
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2008 (Ch. 3, linear classifiers). publisher page
- T. Hastie, R. Tibshirani and J. Friedman, The Elements of Statistical Learning, 2nd ed., Springer, 2009 (Ch. 3–4 and 12). official page
- R. A. Fisher, “The use of multiple measurements in taxonomic problems,” Annals of Eugenics, vol. 7, no. 2, pp. 179–188, 1936. doi
- F. Rosenblatt, “The perceptron: a probabilistic model for information storage and organization in the brain,” Psychological Review, vol. 65, no. 6, pp. 386–408, 1958. doi
- D. R. Cox, “The regression analysis of binary sequences,” Journal of the Royal Statistical Society, Series B, vol. 20, no. 2, pp. 215–232, 1958. doi
- A. E. Hoerl and R. W. Kennard, “Ridge regression: biased estimation for nonorthogonal problems,” Technometrics, vol. 12, no. 1, pp. 55–67, 1970. doi
- B. E. Boser, I. M. Guyon and V. N. Vapnik, “A training algorithm for optimal margin classifiers,” in Proc. 5th Annual Workshop on Computational Learning Theory (COLT), pp. 144–152, 1992. doi
- C. Cortes and V. Vapnik, “Support-vector networks,” Machine Learning, vol. 20, no. 3, pp. 273–297, 1995. doi
- C. J. C. Burges, “A tutorial on support vector machines for pattern recognition,” Data Mining and Knowledge Discovery, vol. 2, no. 2, pp. 121–167, 1998. doi
- P. L. Bartlett, M. I. Jordan and J. D. McAuliffe, “Convexity, classification, and risk bounds,” Journal of the American Statistical Association, vol. 101, no. 473, pp. 138–156, 2006. doi
- L. Rosasco, E. De Vito, A. Caponnetto, M. Piana and A. Verri, “Are loss functions all the same?,” Neural Computation, vol. 16, no. 5, pp. 1063–1076, 2004. doi
- R.-E. Fan, K.-W. Chang, C.-J. Hsieh, X.-R. Wang and C.-J. Lin, “LIBLINEAR: a library for large linear classification,” Journal of Machine Learning Research, vol. 9, pp. 1871–1874, 2008. paper
- S. Shalev-Shwartz, Y. Singer, N. Srebro and A. Cotter, “Pegasos: primal estimated sub-gradient solver for SVM,” Mathematical Programming, vol. 127, no. 1, pp. 3–30, 2011. doi
- C.-C. Chang and C.-J. Lin, “LIBSVM: a library for support vector machines,” ACM Transactions on Intelligent Systems and Technology, vol. 2, no. 3, article 27, 2011. doi
- J. Cervantes, F. Garcia-Lamont, L. Rodríguez-Mazahua and A. Lopez, “A comprehensive survey on support vector machine classification: applications, challenges and trends,” Neurocomputing, vol. 408, pp. 189–215, 2020. doi
- A. Y. Ng and M. I. Jordan, “On discriminative vs. generative classifiers: a comparison of logistic regression and naive Bayes,” in Advances in Neural Information Processing Systems (NIPS), 2001. paper
- D. Soudry, E. Hoffer, M. S. Nacson, S. Gunasekar and N. Srebro, “The implicit bias of gradient descent on separable data,” Journal of Machine Learning Research, vol. 19, no. 70, pp. 1–57, 2018. paper
- V. Papyan, X. Y. Han and D. L. Donoho, “Prevalence of neural collapse during the terminal phase of deep learning training,” Proceedings of the National Academy of Sciences, vol. 117, no. 40, pp. 24652–24663, 2020. doi
- G. Alain and Y. Bengio, “Understanding intermediate layers using linear classifier probes,” arXiv:1610.01644, 2016. arXiv
- S. Kornblith, J. Shlens and Q. V. Le, “Do better ImageNet models transfer better?,” in Proc. IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019. paper
- A. Radford et al., “Learning transferable visual models from natural language supervision,” in Proc. International Conference on Machine Learning (ICML), PMLR 139, 2021. paper
- M. Oquab et al., “DINOv2: learning robust visual features without supervision,” Transactions on Machine Learning Research, 2024. arXiv
- A. Kumar, A. Raghunathan, R. Jones, T. Ma and P. Liang, “Fine-tuning can distort pretrained features and underperform out-of-distribution,” in Proc. International Conference on Learning Representations (ICLR), 2022. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 04・近鄰、核與非線性分類器 · 24 分鐘