PR 09・集成、驗證與分群有效性
先備知識:PR 08・近似推論與貝氏模型複雜度
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 1 個互動實驗
在 300 個帶雜訊的雙月形資料點上訓練真正的決策樹,用自助抽樣(bootstrap)做出許多棵讓它們投票,觀察測試誤差如何隨樹數下降,然後趨於平緩。
你將學到
- 推導平方誤差的偏差–變異數分解(bias–variance decomposition),並用它說明為什麼平均能幫助不穩定的學習器。
- 說明決策樹如何切分特徵空間,以及 bagging 與隨機森林(random forest)如何降低其變異數,包括 out-of-bag 估計。
- 從指數損失推導 AdaBoost,連結到梯度提升(gradient boosting),並區分 boosting、投票、貝氏模型平均與 stacking。
- 以保留法(hold-out)、k 折、群組隔離與巢狀交叉驗證,以及 bootstrap(.632 與 .632+),估計整個辨識程序的表現。
- 以 McNemar 檢定、5×2cv 與修正重抽樣 檢定,以及 Friedman/Nemenyi 程序比較兩個以上的分類器,並知道各自何時成立。
- 同時評估決策與機率,並把分群有效性視為一種模型選擇問題。
先看全貌
單一辨識器犯錯的原因有兩種,性質截然不同。有時它太簡單,表達不了真正的決策規則;有時它太有彈性,把這份訓練集的偶然細節也背了下來。集成方法組合許多模型,分別對付第二種問題(bagging、隨機森林)或第一種問題(boosting)。驗證則是故事的另一半:一旦我們能建立大量模型、調整大量旋鈕,就需要可信的方法估計「被選中的程序」在新資料上的表現,並判斷某個程序是否真的比另一個好。
為什麼重要:樹集成至今仍是表格型特徵(包括手工設計的影像描述子)上最強的方法之一 [23];深度網路集成是取得不確定性估計的標準作法 [24];而幾乎每一篇比較辨識器的論文,都建立在交叉驗證與統計檢定之上。Theodoridis 與 Koutroumbas 在第 4 章討論決策樹、分類器組合與 boosting,第 10 章(「Supervised Learning: The Epilogue」)討論誤差估計與比較,第 16 章討論分群有效性 [1]。Bishop 第 14 章區分了數種數學上不同的模型組合方式,第 3.2 節則推導偏差–變異數分解 [2]。分類器本身已在 PR 03 與 PR 04 介紹過。
偏差、變異數與雜訊
白話版。 想像用同一個學習演算法,在許多份來自同一來源的不同訓練集上重新訓練。平均預測仍可能偏離真值,這個系統性的偏離就是偏差(bias)。個別預測會在平均值周圍散開,這個散布就是變異數(variance)。即使是完美的預測器,也無法消除標籤本身的隨機性,那就是雜訊(noise)。
精確版。 令目標為 ,其中 是未知的迴歸函數, 是雜訊,滿足 、,且與其他一切獨立。學習演算法把隨機的訓練集 映射成預測器 。記 為對訓練集平均後的預測。在固定輸入 上,對訓練集與測試雜訊取期望的平方誤差為
三個交叉項都會消失: 期望為零且與 獨立; 是常數;而依 的定義,。再對輸入分布 取平均,就得到期望測試誤差。Geman、Bienenstock 與 Doursat 把這個張力稱為偏差/變異數兩難(bias/variance dilemma)[3]:讓模型更有彈性,通常會降低偏差、提高變異數,最佳複雜度在兩者之間取得平衡。
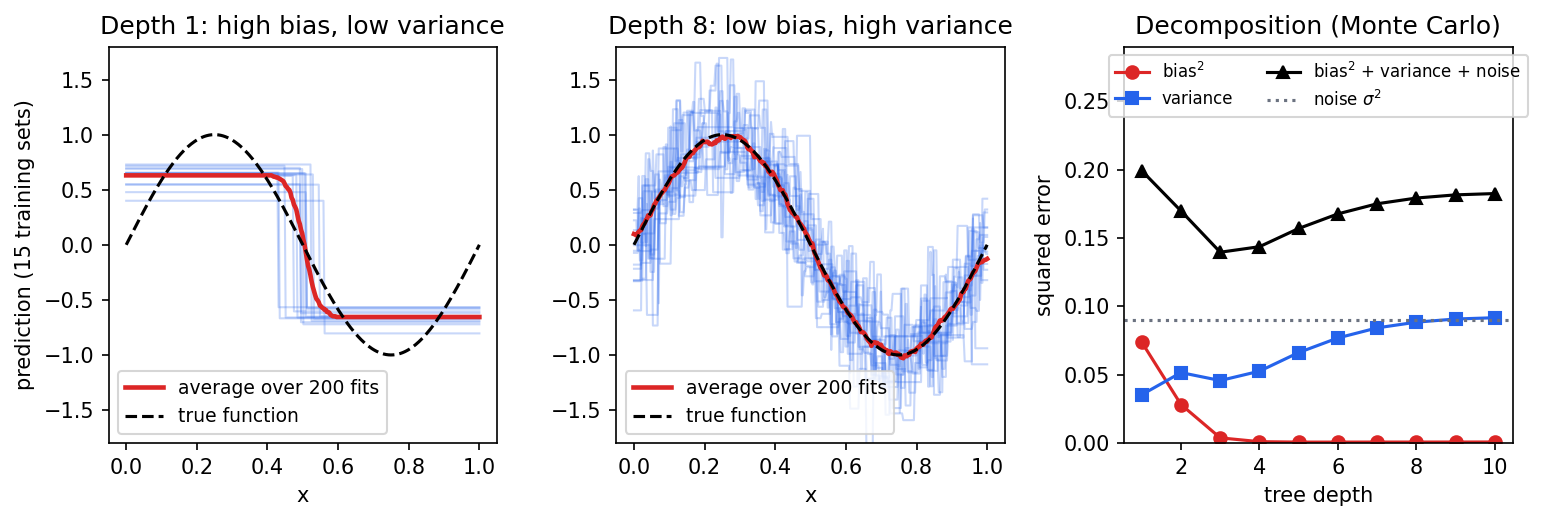
下面的程式以暴力法,對雜訊正弦曲線上不同深度的迴歸樹估計每一項。程式抽出 200 份各含 60 點的訓練集;200 棵擬合樹的經驗平均與散布,給出偏差平方與變異數。
程式碼 · Python · 24 行
import numpy as np
from sklearn.tree import DecisionTreeRegressor

rng = np.random.default_rng(0)
f = lambda x: np.sin(2 * np.pi * x)          # true regression function
sigma = 0.3                                   # noise standard deviation
x_test = np.linspace(0, 1, 200)[:, None]

def bias_variance(depth, n_sets=200, n=60):
    preds = np.empty((n_sets, len(x_test)))
    for s in range(n_sets):                   # many independent training sets
        x = rng.random((n, 1))
        y = f(x[:, 0]) + rng.normal(0, sigma, n)
        tree = DecisionTreeRegressor(max_depth=depth, random_state=0)
        preds[s] = tree.fit(x, y).predict(x_test)
    mean_pred = preds.mean(axis=0)
    bias2 = np.mean((mean_pred - f(x_test[:, 0])) ** 2)
    var = np.mean(preds.var(axis=0))
    return bias2, var

for depth in [1, 2, 3, 5, 8, None]:
    b2, v = bias_variance(depth)
    print(f"depth={str(depth):>4}  bias^2={b2:.4f}  variance={v:.4f}  "
          f"expected test MSE~{b2 + v + sigma**2:.4f}")
在我們的執行中,深度 1 的偏差平方約 0.074、變異數約 0.035;深度 3 的總和最低(偏差平方約 0.003、變異數約 0.045);完全長成的樹幾乎沒有偏差,但變異數約 0.092,和雜訊變異數 本身一樣大。圖 1 以視覺方式呈現同一個實驗。
有三點提醒讓這張圖保持誠實。第一,乾淨的分解只適用於平方誤差;對 0–1 分類損失,偏差與變異數有好幾種互相競爭的定義,而且兩者可能以非加法方式交互作用,因此對分類器而言,請把分解當作直覺,而不是精確的帳目。第二,「複雜度」不只是參數數量:樹深、正則化強度、boosting 回合數與提早停止(early stopping)都會讓模型在偏差–變異數軸上移動。第三,極大的過參數化模型,其測試誤差曲線可能在容量超過內插點後先升再降,也就是 Belkin 等人記錄的「雙重下降」(double descent)形狀 [25]。分解在每一點上仍然成立;改變的是變異數隨容量增長的行為。
選讀:雙重下降:Belkin 等人(PNAS 2019)閱讀指南(見「論文導讀」頁)。說明論文曲線的橫軸與實驗設定,並附一個可自行執行的最小範數小實驗。
決策樹與空間切分
白話版。 決策樹對特徵問一連串是非題,例如「特徵 3 是否小於 0.7?」,每個最終答案格(葉節點)存放一個預測。它是低偏差、高變異數學習器的經典例子,這也正是它成為集成方法最愛用的積木的原因。
精確版。 決策樹以 等條件遞迴分割觀測。每個葉節點估計一個類別分布(分類)或一個常數(迴歸)。對類別比例為 的分類節點,Gini 不純度為
熵則為 。兩者在純節點為零,在均勻混合時最大。把父節點 分成子節點 與 ,分別含有父節點 個樣本中的 與 個,此分割以不純度下降量評分:
學習器選擇 最大的特徵與閾值。這是局部貪婪選擇:最好的單一分割不一定通往最好的樹。深樹能捕捉交互作用與非線性、與座標軸平行的邊界,但少數訓練點改變就可能讓整棵樹大幅改變;這種不穩定,正是圖 1 中看到的高變異數。
深度限制、最小葉節點樣本數與成本–複雜度剪枝可以控制複雜度。由於分割只取決於每個特徵的排序,樹對單調尺度轉換不變,因此比距離模型較不受特徵尺度影響;但缺失值、特徵定義,以及只由訓練資料擬合的轉換,仍需要仔細處理。Theodoridis 與 Koutroumbas(第 4 章)與 Bishop(第 14.4 節)都把樹視為非線性分類器的一個家族 [1], [2]。
Bagging 與隨機森林
白話版。 Bagging(bootstrap aggregating)以「放回抽樣」從原始資料建立許多份訓練集,在每份上訓練一個不穩定的模型,再平均或投票。隨機森林再加入一個隨機來源:每次分割時只看隨機挑出的一部分特徵,讓樹之間更不一致,平均效果也就更好。
精確版。 Breiman 提出 bagging,作為改善不穩定程序的方法,也就是訓練集稍有擾動、輸出就大幅改變的程序 [4]。給定 份大小皆為 的 bootstrap 樣本 ,bagging 迴歸器為 ,bagging 分類器則採多數決(或平均類別機率)。
為什麼平均有幫助?假設在固定的 上, 個純量預測器的變異數都是 ,任兩者的相關係數都是 。展開總和的變異數:
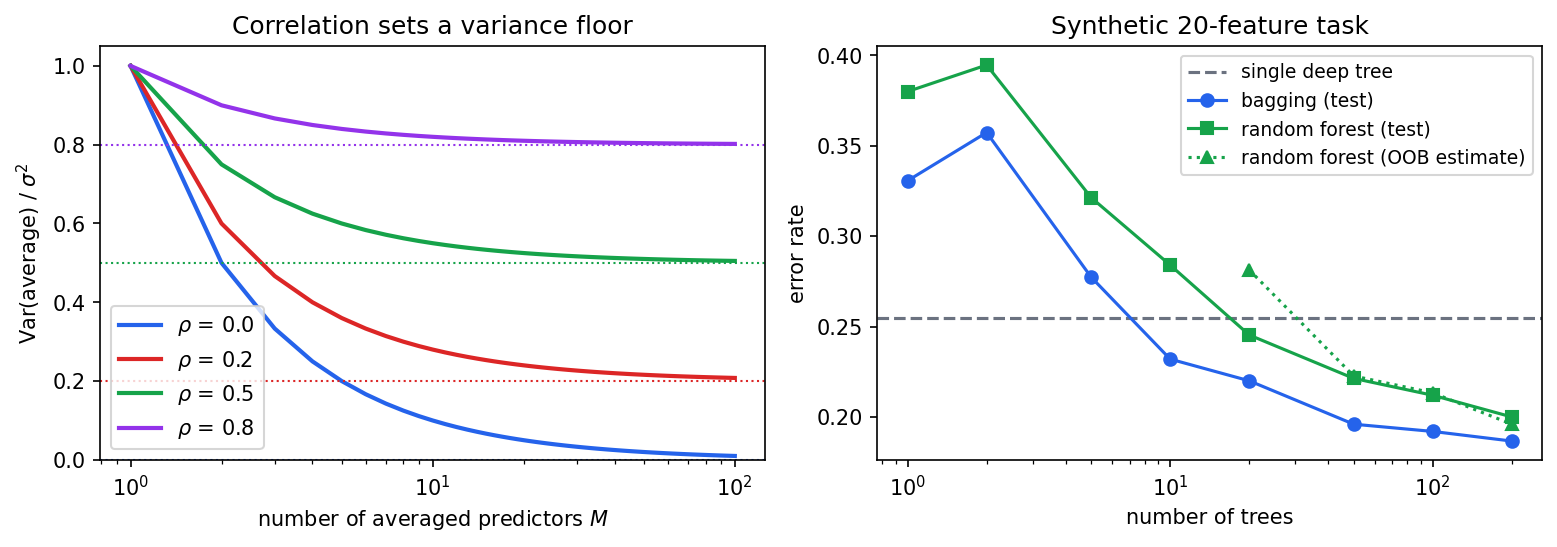
第二項隨 增大而消失,第一項 卻不會:彼此相關的錯誤形成一個下限(圖 2 左)。平均基本上不改變偏差,所以 bagging 對深樹這類低偏差、高變異數的學習器幫助最大,對線性判別式或大 的 近鄰這類穩定學習器幫助很小。這個示意公式說明了相關錯誤為何限制改善幅度;它並不保證每個分類集成都會提高準確率。
隨機森林直接降低 [5]。在每份 bootstrap 樣本上長樹時,每次分割只考慮隨機選出的 個特徵(分類問題常見的預設是 個特徵中取 個)。Breiman 證明森林的泛化誤差可以用個別樹的強度與樹之間的相關性來界定 [5],這和變異數公式是同一個取捨:較弱但相關性較低的樹,可能組成更強的森林。
Out-of-bag(OOB)估計。 在 次放回抽樣中,某一筆觀測沒有被抽到的機率是 。因此每棵樹大約漏掉 37% 的資料,而每筆觀測都可以由大約三分之一沒見過它的樹來預測。彙整這些預測,幾乎不必額外成本就能得到 OOB 誤差估計 [5]。在圖 2 右,樹夠多之後,OOB 估計就會貼近測試誤差。但一般的 bootstrap 是對「列」重抽樣:如果好幾列屬於同一位受試者、書寫者或同一次錄製,一棵樹可能在某人的一張影像上訓練,又在同一人的另一張影像上做 OOB「測試」。這時對新群組部署而言,OOB 分數就會過度樂觀。
Boosting 改變下一個學習器的工作
白話版。 Bagging 的成員彼此獨立、可以平行訓練。Boosting 則依序訓練:每個新的弱學習器專注在目前集成仍然答錯的樣本上,最後的預測是加權總和。Bagging 主要降低變異數;boosting 主要降低偏差,把許多「只比亂猜好一點」的規則變成強分類器。
精確版。 Boosting 建立加法模型
其中每個 是弱學習器(常用深度 1 的樹,即樹樁 stump), 是它的權重。對標籤 ,類別預測為 。
AdaBoost 演算法
Freund 與 Schapire 的 AdaBoost [6] 對訓練資料 ,,運作如下:
- 從均勻權重 開始。
- 對 :
- 以權重 擬合 ;
- 計算加權誤差 ;
- 令 ;
- 更新 並重新正規化。
- 輸出 。
被分錯的點滿足 ,權重乘上 ;分對的點則乘上 。 的學習器得到正的投票權,而且越準,票越重。
從指數損失推導 AdaBoost
Friedman、Hastie 與 Tibshirani 證明 AdaBoost 就是以指數損失 進行的前向逐步加法建模(forward stagewise additive modeling)[7]。假設 已固定,我們加入一項 。訓練損失為
權重 與 、 都無關。把總和拆成分對與分錯的點:
第 1 步,選 。 對任何 ,第一個係數為正,所以最佳的 就是最小化加權訓練誤差的那一個,正好是「以權重 擬合 」。
第 2 步,選 。 除以 ,並以 表示正規化後的加權誤差。我們要最小化 。令 ,得到 ,也就是
第 3 步,更新權重。 下一輪權重為 ,正是 AdaBoost 的更新式。演算法的每一步都能從指數損失的貪婪最小化推回來。
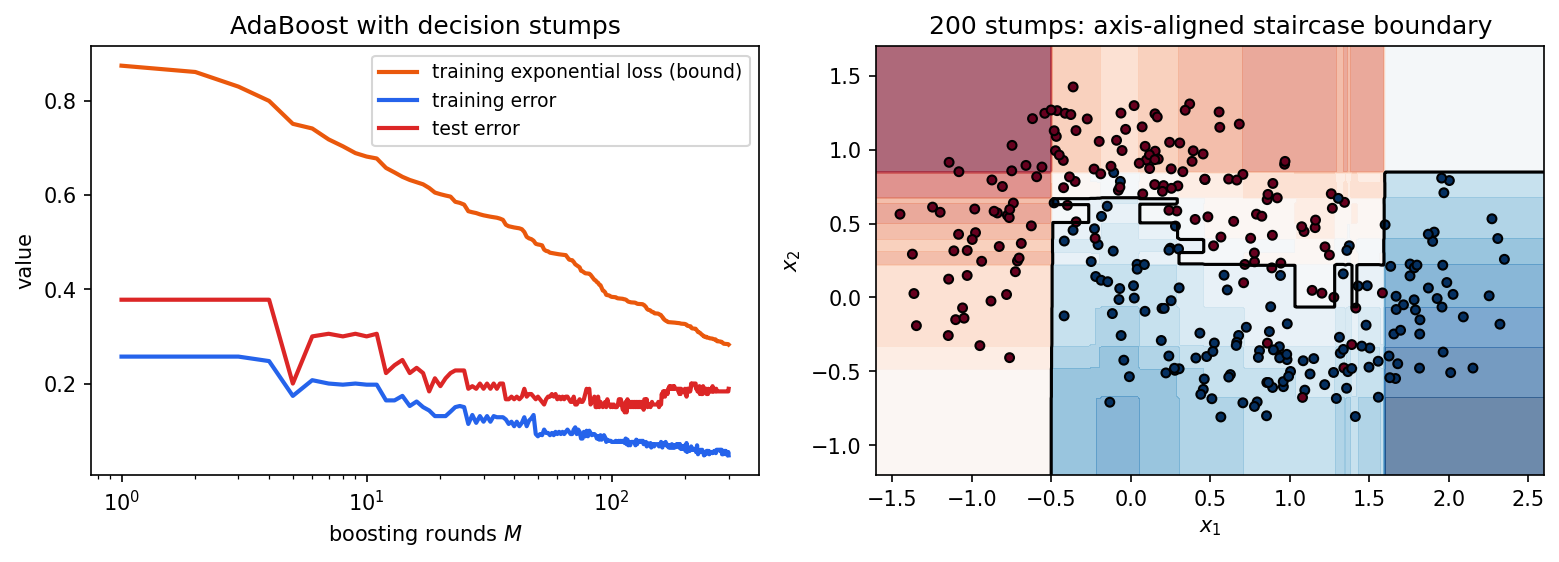
由此得到兩個結果。因為 ,訓練誤差以平均指數損失為上界;採用最佳 時,只要 ,每一回合都會把這個上界乘上 ,所以只要每個弱學習器都以某個差距勝過亂猜,訓練誤差就會指數下降 [6]。另外,期望指數損失的最小化者是 ,即對數勝算(log-odds)的一半 [7],因此 是一個機率估計(不一定校準良好)。指數權重也解釋了一個已知弱點:標錯的點會得到指數成長的權重,所以 AdaBoost 可能對標籤雜訊與離群值很敏感。
下面的程式用加權樹樁從零實作 AdaBoost,並與 scikit-learn 的 AdaBoostClassifier 比對。對兩類問題,scikit-learn 的 SAMME 變體使用 ,是我們的兩倍;這會把 放大,但每個符號、以及重新正規化後的每個權重都不變。
程式碼 · Python · 42 行
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import AdaBoostClassifier

X, y01 = make_classification(n_samples=600, n_features=10, n_informative=4,
                             flip_y=0.05, random_state=1)
y = 2 * y01 - 1                                   # labels in {-1, +1}
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=1)

def adaboost_fit(X, y, M=100):
    n = len(y)
    w = np.full(n, 1 / n)                         # step 1: uniform weights
    stumps, alphas = [], []
    for m in range(M):
        h = DecisionTreeClassifier(max_depth=1, random_state=0)
        h.fit(X, y, sample_weight=w)              # step 2a: weighted fit
        pred = h.predict(X)
        err = np.sum(w * (pred != y)) / np.sum(w) # step 2b: weighted error
        err = np.clip(err, 1e-12, 1 - 1e-12)
        alpha = 0.5 * np.log((1 - err) / err)     # step 2c: learner weight
        w = w * np.exp(-alpha * y * pred)         # step 2d: reweight
        w /= w.sum()
        stumps.append(h); alphas.append(alpha)
    return stumps, np.array(alphas)

def adaboost_score(stumps, alphas, X):
    return sum(a * h.predict(X) for h, a in zip(stumps, alphas))

stumps, alphas = adaboost_fit(Xtr, ytr)
F_tr = adaboost_score(stumps, alphas, Xtr)
F_te = adaboost_score(stumps, alphas, Xte)
print("from scratch: train err", np.mean(np.sign(F_tr) != ytr),
      " test err", np.mean(np.sign(F_te) != yte))
print("exp-loss bound on train err:", np.mean(np.exp(-ytr * F_tr)))

ref = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1, random_state=0),
                         n_estimators=100, random_state=0).fit(Xtr, ytr)
agree = np.mean(ref.predict(Xte) == np.sign(F_te))
print("sklearn test err", np.mean(ref.predict(Xte) != yte),
      " agreement with ours:", agree)
在 scikit-learn 1.6 下,我們的執行印出訓練誤差 0.076、指數損失上界 0.384,兩種實作的測試誤差都是 0.156,測試預測 100% 一致。圖 3 顯示 300 回合的曲線,以及樹樁在二維中拼出的階梯狀邊界。
梯度提升
白話版。 梯度提升把 AdaBoost 的想法推廣到任何可微分的損失:每一回合先算出每個訓練預測應該往哪個方向移動才能降低損失,再用一棵小樹去擬合這些方向。
精確版。 Friedman 的梯度提升機(gradient boosting machine)[8] 是在函數空間中做梯度下降。在第 回合,計算偽殘差(pseudo-residuals)
以最小平方法把迴歸樹 擬合到 ,用線搜尋選步長 (或每個葉節點各取一個最佳常數,即 Friedman 的 TreeBoost),再以學習率(收縮,shrinkage) 更新 。對平方誤差 ,偽殘差就是一般殘差 。對 、 為對數勝算的二元對數損失,偽殘差是 :標籤減去預測機率,而不是減去預測類別。若使用指數損失並搭配線搜尋,這個程序會化約為一種 AdaBoost。
學習率、回合數與樹的大小會互相影響:較小的 需要更多回合,但通常泛化得更好;回合數以驗證資料上的提早停止來決定,絕不用最終測試集。XGBoost [9] 以正則化目標函數、二階(牛頓法)葉節點值、能處理稀疏資料的分割搜尋與加權分位數草圖(weighted quantile sketch),讓梯度提升樹變得快速且可擴展;scikit-learn 的 HistGradientBoostingClassifier 等以直方圖為基礎的實作也遵循相同原則 [26]。
平均不一定是同一種運算
許多方法都在「組合模型」,但它們回答的是不同問題。
| 方法 | 組合由什麼決定? | 主要注意事項 |
|---|---|---|
| 投票或機率平均(bagging、森林) | 對獨立訓練的預測器做固定、等權重的組合 | 錯誤彼此相關、校準不一致 |
| Boosting | 依序擬合;權重來自損失函數 | 標籤雜訊;需要提早停止 |
| 貝氏模型平均 | 模型假設的後驗機率 | 證據與先驗必須有意義 |
| Stacking | 學習一個以基底模型輸出為輸入的預測器 | 必須用 out-of-fold 預測來訓練 |
| 條件式混合(混合專家) | 隨輸入改變的閘門或責任值 | 專家與閘門可能一起過擬合 |
貝氏模型平均(Bayesian model averaging,Bishop 第 14.1 節 [2])使用
其中 是模型 的後驗機率。這些權重是後驗模型機率,不是任意的驗證準確率;資料充足時,它們往往集中在單一模型上。BMA 表達的是「資料是哪一個模型產生的」這種不確定性;委員會或集成則是用幾個部件組成一個更豐富的模型 [2]。模型證據 與 PR 08 的近似推論工具相連。
Stacking(堆疊泛化,stacked generalization,Wolpert [10])則是學習一個從基底模型預測到目標的映射。它的訓練特徵必須來自沒有用這些樣本訓練過的基底模型;否則 stacker 學到的是不切實際、過擬合的簡單預測。標準做法是:把訓練集分成 折,每個基底模型在 折上擬合並預測保留的那一折,收集這些 out-of-fold 預測當作特徵,在其上擬合一個簡單的後設學習器(常用正則化邏輯斯迴歸),最後再用全部訓練資料重新擬合各基底模型。
下面在 scikit-learn 內建的乳癌資料集(569 筆、30 個特徵)上比較各方法,所有方法都在同一個分層 5 折交叉驗證中執行,因此數字可以互相比較。StackingClassifier 會在每個外層訓練折內部,自行建立內層的 out-of-fold 預測(cv=5)。
程式碼 · Python · 30 行
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import (BaggingClassifier, RandomForestClassifier,
                              HistGradientBoostingClassifier, StackingClassifier)

X, y = load_breast_cancer(return_X_y=True)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)
logreg = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000))
models = {
    "single tree": DecisionTreeClassifier(random_state=0),
    "bagged trees": BaggingClassifier(DecisionTreeClassifier(), n_estimators=100,
                                      random_state=0),
    "random forest": RandomForestClassifier(n_estimators=100, random_state=0),
    "hist. gradient boosting": HistGradientBoostingClassifier(random_state=0),
    "logistic regression": logreg,
}
models["stacking"] = StackingClassifier(
    estimators=[("rf", models["random forest"]),
                ("gb", models["hist. gradient boosting"]),
                ("lr", logreg)],
    final_estimator=LogisticRegression(max_iter=2000),
    cv=5, stack_method="predict_proba")
for name, model in models.items():
    s = cross_val_score(model, X, y, cv=cv, scoring="accuracy")
    print(f"{name:>24}: {s.mean():.3f} +/- {s.std():.3f}")
我們的執行得到平均準確率:單一決策樹 0.926、bagging 0.960、隨機森林 0.965、梯度提升 0.970、邏輯斯迴歸 0.979、stacking 0.979,各折標準差介於 0.009 到 0.022。由此得到兩個教訓。集成明顯修好了不穩定的單一決策樹。但在這個小而近乎線性可分的資料集上,一個正則化良好的線性模型已經和 stack 一樣好,而前四名之間的差距都在一個折標準差之內。它們之中是否有誰顯著較好,要交給本章稍後的統計檢定,而不是用眼睛看平均值。
驗證評估的是整個程序
白話版。 只有當測試資料完全沒有參與模型的建立,測試分數才值得信任。我們看著資料時做的每一個選擇,包括特徵、超參數、閾值,甚至用哪個演算法,都是「模型」的一部分,都必須在不使用評分資料的情況下決定。
訓練擬合參數。驗證選擇超參數、特徵、閾值與校準方式。測試評估被選中的程序。每一個適應性選擇,都會消耗它所檢視資料中的資訊。嚴格來說,交叉驗證估計的是一個程序(演算法加上調參規則)在給定大小的資料集上訓練後的表現,而不是你最後要部署的那一個擬合模型的誤差;Bates、Hastie 與 Tibshirani 把這一點說得很精確,並指出天真的交叉驗證信賴區間可能涵蓋率不足 [19]。
保留法、k 折與留一法
- 保留法(hold-out)。 只切一次訓練與測試。簡單又便宜,但資料少時估計的變異數高、依賴切分方式,而且模型使用的訓練資料比手上擁有的少。
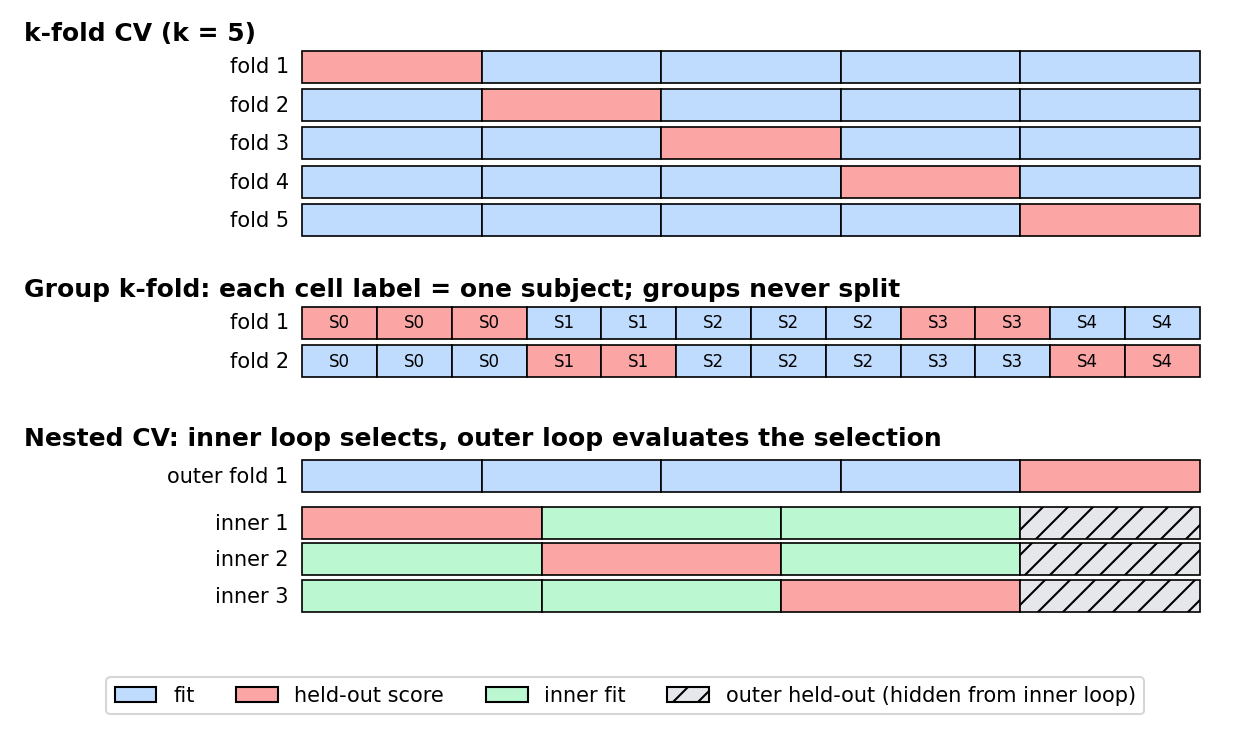
- k 折交叉驗證。 把資料分成 折;在 折上訓練、在剩下一折上評分,輪流讓每一折都被保留一次(圖 4 上)。CV 估計為 ,其中 是樣本 所在的折, 是不含第 折訓練出的模型。 或 是常見的折衷:每個模型看到 80–90% 的資料,悲觀偏差小,成本是 次擬合。
- 留一法(leave-one-out, LOO)。 即 的情形。對大小為 的程序幾乎不偏,但需要 次擬合(除非有封閉解,例如線性平滑器或 -NN),而且因為 份訓練集幾乎相同,變異數可能很高。
- 分層(stratification) 讓各折的類別比例相近,對稀有類別很重要。它無法解決樣本之間的相依性。
Arlot 與 Celisse 回顧了這些選擇在估計風險與選擇模型兩方面的理論 [18]。
群組與時間
當觀測共享同一位病患、書寫者、相機或錄製時段時,要把整個群組放在一起(圖 4 中)。否則同一個人的近似重複影像會落在切分的兩側,分數衡量的是對那個人的記憶,而不是對新的人的辨識。依時間排序的資料需要依時間切分(用過去訓練、用未來測試)。原則是:切分方式要對應部署時的問題。「已知書寫者的新影像」與「新書寫者的影像」是不同問題,應該用不同的切分。
Bootstrap、.632 與 .632+
白話版。 不用折,改抽許多份 bootstrap 樣本,在每份上訓練,再用該份漏掉的點測試。
精確版。 以放回抽樣抽出 份大小為 的 bootstrap 樣本。對每一份擬合模型,並在沒被抽到的點(約 36.8% 的資料)上評估。其平均即留一 bootstrap 誤差 。由於每個 bootstrap 模型只用到約 63.2% 的相異點訓練, 偏悲觀;而再代入(訓練)誤差 偏樂觀。Efron 的 .632 估計量把兩者混合:
它對 1-最近鄰這類嚴重過擬合、訓練誤差為零的學習器會失效。Efron 與 Tibshirani 的 .632+ 估計量 [11] 在過擬合越嚴重時,把權重越往 移動,藉此修正。令 為無資訊錯誤率(no-information error rate,假如輸入與標籤彼此獨立時的錯誤率:,其中 是類別 的觀測比例, 是預測為 的比例),並定義相對過擬合率 ,截斷到 。則
(沒有過擬合)時它化約為 .632; 時它變成 。
程式碼 · Python · 31 行
import numpy as np
from sklearn.datasets import make_classification
from sklearn.neighbors import KNeighborsClassifier
from sklearn.model_selection import cross_val_score, KFold

X, y = make_classification(n_samples=200, n_features=6, n_informative=3,
                           flip_y=0.1, random_state=3)
model = KNeighborsClassifier(n_neighbors=1)          # resubstitution error is 0
rng = np.random.default_rng(3)
n, B = len(y), 200
resub = np.mean(model.fit(X, y).predict(X) != y)
oob_errs = []
for b in range(B):
    idx = rng.integers(0, n, n)                       # draw n with replacement
    out = np.setdiff1d(np.arange(n), idx)             # ~36.8% left out
    model.fit(X[idx], y[idx])
    oob_errs.append(np.mean(model.predict(X[out]) != y[out]))
err_boot1 = np.mean(oob_errs)                          # leave-one-out bootstrap
err_632 = 0.368 * resub + 0.632 * err_boot1
cv10 = 1 - cross_val_score(model, X, y,
                           cv=KFold(10, shuffle=True, random_state=3)).mean()
print(f"resubstitution {resub:.3f}  OOB bootstrap {err_boot1:.3f}  "
      f".632 {err_632:.3f}  10-fold CV {cv10:.3f}")

# .632+ : shrink toward the out-of-bootstrap error when overfitting is large.
pred = model.fit(X, y).predict(X)
gamma = sum(np.mean(y == k) * (1 - np.mean(pred == k)) for k in np.unique(y))
R = np.clip((err_boot1 - resub) / (gamma - resub), 0, 1)
w = 0.632 / (1 - 0.368 * R)
print(f"no-information rate {gamma:.3f}  R {R:.3f}  "
      f".632+ {(1 - w) * resub + w * err_boot1:.3f}")
對 1-NN,再代入誤差為 0.000,bootstrap 外誤差 0.332,.632 估計只有 0.210(被沒有意義的零拉低),.632+ 估計為 0.278,10 折 CV 為 0.325。這裡 .632 估計量嚴重過度樂觀;.632+ 修補了大部分差距。實務上,10 折 CV(可重複多次)與 .632+ 都合理;bootstrap 在樣本極少時以及建立信賴區間時特別有吸引力。
巢狀交叉驗證
白話版。 如果你用交叉驗證調超參數,然後回報同一個交叉驗證分數,你回報的是最幸運那組設定的分數,會過度樂觀。巢狀 CV 把整個調參過程放進外層迴圈裡。
巢狀交叉驗證有負責選擇的內層迴圈,以及評估這個選擇程序的外層迴圈(圖 4 下)。在每個外層訓練集內,以內層 CV 選出超參數;選中的設定在整個外層訓練集上重新擬合,再在內層從未見過的外層保留折上評分。Varma 與 Simon 證明,回報內層(調參用)CV 分數可能有相當大的偏差,而巢狀 CV 給出幾乎不偏的估計 [12]。Cawley 與 Talbot 更進一步指出:對模型選擇準則本身過擬合,造成的損失可能與學習演算法之間的差距一樣大,因此低變異數的選擇準則與不偏的準則同樣重要 [13]。前處理(標準化、特徵選擇、PCA)要在每個內層折中重新擬合,通常把它放進 Pipeline 即可。回報外層各折之間的變異,但不要把彼此相關的折分數當成獨立測量,去算天真的信賴區間。
估計完程序之後,在開發資料上做選擇,最後在從未動過的測試集上評估一次。反覆查看測試誤差並重新設計模型,會把測試集變成另一個驗證集。
程式碼:沒有群組洩漏的巢狀選模
這個 CPU 範例為每位合成受試者產生三筆帶雜訊的重複測量。群組標籤描述的是受試者,不是類別。外層迴圈估計所選森林程序的表現;另一份群組不重疊的測試集在最終回報前都不會被動到。
程式碼 · Python · 39 行
import numpy as np
from sklearn.datasets import make_classification
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split, GroupKFold, GridSearchCV
from sklearn.metrics import balanced_accuracy_score, log_loss

rng = np.random.default_rng(9)
subject_x, subject_y = make_classification(
    n_samples=180, n_features=8, n_informative=5, n_redundant=1,
    class_sep=1.0, random_state=9)
groups = np.repeat(np.arange(180), 3)
X = subject_x[groups] + rng.normal(0, 0.03, (len(groups), 8))
y = subject_y[groups]
dev_groups, test_groups = train_test_split(
    np.arange(180), test_size=0.25, stratify=subject_y, random_state=9)
dev = np.flatnonzero(np.isin(groups, dev_groups))
test = np.flatnonzero(np.isin(groups, test_groups))
assert not set(groups[dev]) & set(groups[test])

def search():
    return GridSearchCV(
        RandomForestClassifier(n_estimators=60, random_state=9, n_jobs=1),
        {"max_depth": [3, None], "min_samples_leaf": [1, 3]},
        cv=GroupKFold(3), scoring="balanced_accuracy")

outer_scores = []
for fit, valid in GroupKFold(3).split(X[dev], y[dev], groups[dev]):
    chosen = search().fit(X[dev[fit]], y[dev[fit]], groups=groups[dev[fit]])
    pred = chosen.predict(X[dev[valid]])
    outer_scores.append(balanced_accuracy_score(y[dev[valid]], pred))
final = search().fit(X[dev], y[dev], groups=groups[dev])
p = final.predict_proba(X[test])
pred = final.predict(X[test])
positive = p[:, np.flatnonzero(final.classes_ == 1)[0]]
print("Nested outer balanced accuracy:", np.round(outer_scores, 3))
print("Selected parameters:", final.best_params_)
print("Independent group test:", balanced_accuracy_score(y[test], pred))
print("Test log loss:", log_loss(y[test], p, labels=final.classes_))
print("Test Brier:", np.mean((positive - y[test]) ** 2))
我們的執行印出外層平衡準確率 0.869、0.784 與 0.861,選中 max_depth=None, min_samples_leaf=3,並在獨立群組測試集上得到平衡準確率 0.853、對數損失 0.378 與 Brier 分數 0.118。外層分數的分散(0.78 到 0.87)提醒我們,單一切分會有多嘈雜。這些結果描述的是合成受試者,不代表在影像上的表現。若把 GroupKFold 換成逐列打亂的折,同一受試者的近似複本就會出現在兩側,分數因而虛高(練習 3)。
以統計方法比較分類器
白話版。 如果分類器 A 得 97.9%、B 得 96.5%,A 真的比較好,還是只是剛好在這份資料上運氣好?統計檢定問的是:如果兩者其實一樣好,觀察到這樣的差異有多令人意外。麻煩的是,教科書上常見的 檢定假設各次測量彼此獨立,而交叉驗證分數並不獨立。
Dietterich 對近似檢定的研究 [14] 是經典的起點;Raschka 的教學文章整理了主要選項並附有程式碼 [20]。
單一測試集:McNemar 檢定
兩個分類器各訓練一次,並在同一個測試集上評估。計算 :A 對而 B 錯的測試點數;:反過來的點數。兩者都對或都錯的點,對「誰比較好」沒有提供資訊。在錯誤率相等的虛無假設下,每一個不一致的點偏向哪一方的機會相等,因此 。連續性修正後的統計量
近似服從自由度 1 的 分布;計數小時改用精確二項檢定。Dietterich 發現 McNemar 檢定的型一錯誤率可接受,並建議在演算法只能執行一次時使用它 [14]。它沒有納入訓練集選擇所造成的變異。
重複切分:為什麼天真的 t 檢定會失敗
一個誘人的替代做法是重複 次隨機訓練/測試切分,記錄誤差差值 ,再做成對 檢定。Dietterich 證明這種重抽樣 檢定的型一錯誤率嚴重膨脹 [14]:各訓練集高度重疊,所以 之間呈正相關,一般的標準誤 遠遠太小。常見的修正有兩種。
- 5×2cv 成對 檢定 [14]。做五次 2 折 CV。在第 次中,令 為兩折上的誤差差值, 為其平均,。統計量 與自由度 5 的 分布比較。
- 修正重抽樣 檢定(Nadeau 與 Bengio [15])。保留 次隨機切分,每次有 個測試點與 個訓練點,但把變異數放大以反映重疊:
其中 與 是 的平均與樣本變異數,並與自由度 的 分布比較。多出來的 項不會隨 增大而縮小,這正是重點:對同一份資料重抽再多次,也無法創造更多資訊。
程式碼 · Python · 38 行
import numpy as np
from scipy import stats
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, ShuffleSplit
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier

X, y = load_breast_cancer(return_X_y=True)
A = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000))
B = RandomForestClassifier(n_estimators=200, random_state=0)

# 1) McNemar's test on one held-out test set (paired predictions).
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.4, stratify=y,
                                      random_state=0)
ca = A.fit(Xtr, ytr).predict(Xte) == yte
cb = B.fit(Xtr, ytr).predict(Xte) == yte
n01 = int(np.sum(ca & ~cb))      # A right, B wrong
n10 = int(np.sum(~ca & cb))      # A wrong, B right
p_exact = stats.binomtest(n01, n01 + n10, 0.5).pvalue if n01 + n10 else 1.0
chi2 = (abs(n01 - n10) - 1) ** 2 / (n01 + n10) if n01 + n10 else 0.0
print(f"McNemar: n01={n01} n10={n10} chi2_cc={chi2:.3f} "
      f"p_chi2={stats.chi2.sf(chi2, 1):.3f} p_exact={p_exact:.3f}")

# 2) Corrected resampled t-test (Nadeau & Bengio) over J random splits.
J, test_frac = 30, 0.2
d = []
for tr, te in ShuffleSplit(J, test_size=test_frac, random_state=0).split(X):
    ea = np.mean(A.fit(X[tr], y[tr]).predict(X[te]) != y[te])
    eb = np.mean(B.fit(X[tr], y[tr]).predict(X[te]) != y[te])
    d.append(ea - eb)
d = np.array(d)
naive_se = np.sqrt(d.var(ddof=1) / J)
corr_se = np.sqrt(d.var(ddof=1) * (1 / J + test_frac / (1 - test_frac)))
for name, se in [("naive", naive_se), ("corrected", corr_se)]:
    t = d.mean() / se
    print(f"{name:>9} t={t:.3f}  p={2 * stats.t.sf(abs(t), J - 1):.3f}")
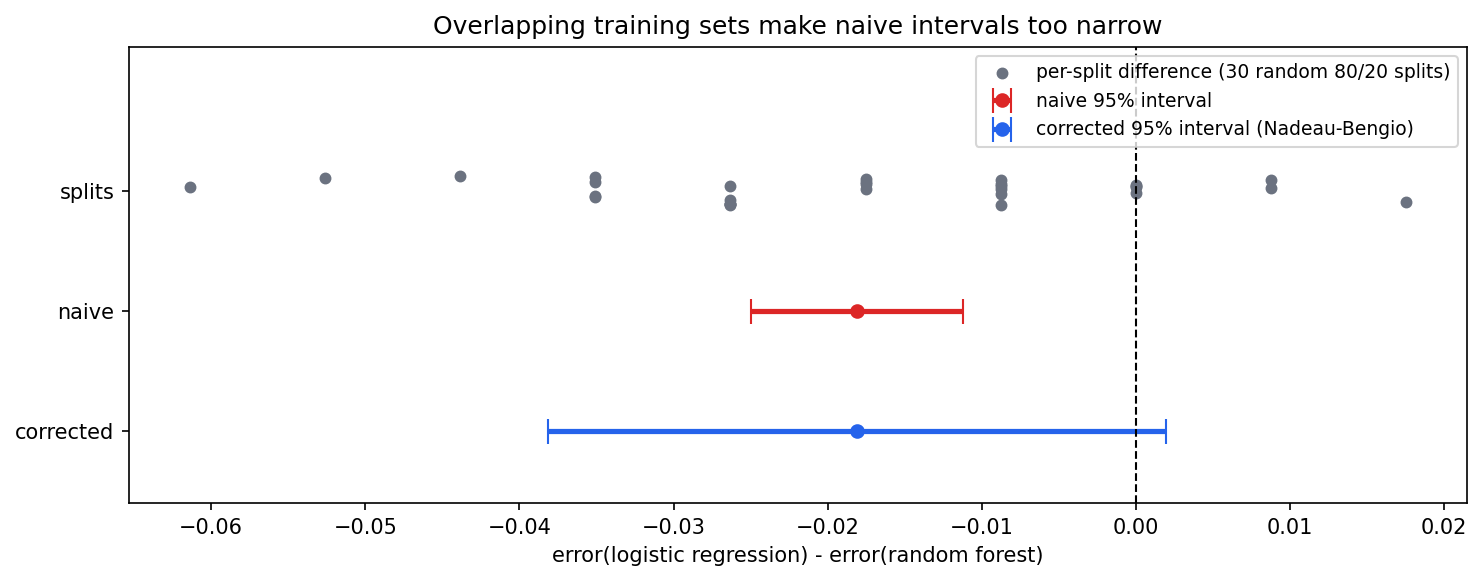
我們的執行得到 、,McNemar :在一個含 228 筆案例的測試集上,看不出差異的證據。在 30 次隨機 80/20 切分中,邏輯斯迴歸的誤差平均約低 1.8 個百分點。天真的 檢定給出 、;修正後的檢定給出 、(圖 5)。同一份資料,在 5% 水準下卻得到相反的結論:天真的檢定把 30 次高度重疊的重抽樣誤當成 30 次獨立實驗。
多個分類器、多個資料集
在 個資料集上比較 個演算法時,Demšar 建議使用基於排名的無母數檢定 [16]:兩個分類器用 Wilcoxon 符號等級檢定;更多個則用 Friedman 檢定。在每個資料集上為演算法排名(1 為最佳),令 為演算法 的平均排名。在「全部等價」的虛無假設下,
近似服從自由度 的 分布(Demšar 也給出一個較不保守、服從 分布的變體)。若虛無假設被拒絕,Nemenyi 事後檢定在兩個演算法的平均排名差距超過臨界差 時判定兩者不同,其中 來自 Studentized range 統計量除以 ;Demšar 的臨界差圖(critical difference diagram)能精簡地呈現結果 [16]。這裡彼此獨立的單位是資料集,而不是折。
Benavoli、Corani、Demšar 與 Zaffalon 主張更進一步,以貝氏分析取代虛無假設顯著性檢定,直接回報一個分類器在實務上較好、在實務等價區間(region of practical equivalence)內等價、或較差的機率 [17]。無論用哪種檢定,都要記得 值完全不說明差異有多大;也要回報效果量與區間。
同時量測決策與機率
準確率衡量答對的比例;平衡準確率(balanced accuracy)平均各類別的召回率,因此不會被多數類別主導。Macro-F1 在平均各類 F1 時給每個類別相同權重。混淆矩陣顯示發生了哪些錯誤。對稀有的正類,要在實際使用的閾值上檢查精確率與召回率;在閾值尚未決定時,檢查完整的精確率–召回率曲線或 ROC 曲線。
對數損失與 Brier 分數評估機率預測:
其中 是模型給第 筆樣本真實類別的機率;在 Brier 分數(二元情形)中, 是預測為正類的機率,。兩者都是適當評分規則(proper scoring rule):回報真實機率時,其期望值最佳。可靠度圖(reliability diagram)在各個區間中比較預測機率與觀察到的頻率。好的排序、好的準確率與好的校準是不同的性質:隨機森林平均投票,傾向把機率推向中間;回合數很多的 boosting 可能把機率推向兩端;模型也可能 ROC AUC 很好,分數卻校準得很差。
擬合校準器時(scikit-learn 提供 sigmoid 與 isotonic 兩種映射 [26]),要使用沒有參與對應基底模型擬合的資料所產生的預測。若觀測有群組,校準用的折也必須遵守群組。校準不會自動修復領域偏移(domain shift)。
把分群有效性當作模型選擇
分群沒有標籤,所以「驗證」的意義不同。Theodoridis 與 Koutroumbas 以整個第 16 章討論分群有效性,因為整齊的分割不一定能服務任務 [1]。完整的指標(silhouette、Davies–Bouldin、Calinski–Harabasz、gap statistic、混合模型的 BIC)在 PR 07 中隨演算法一起介紹;這裡把它們放進本章的驗證框架。
內部準則只使用特徵與指派結果。點 的 silhouette 比較它到自己群的平均距離 ,以及到其他群的最小平均距離 :
它偏好在所選幾何中分離良好的群。以最大化內部指標來選群數,是一個模型選擇步驟,和調超參數完全一樣;分數高並不代表各群對應到想要的語意類別。
外部準則把指派結果與獨立的參考標籤比較。調整蘭德指數(adjusted Rand index, ARI)對成對一致性做機率校正,而且對標籤排列不變,所以哪一群叫「1」並不重要。如果用標籤來選演算法或群數,那些標籤就不再是未被碰過的外部評估;選擇與評估分離的原則在這裡同樣適用。
穩定性比較重抽樣或擾動後的分割,很像 bootstrap:對多個子樣本分群,並在它們共有的觀測上衡量一致性(例如 ARI),同時處理標籤排列。穩定的群仍可能只反映與任務無關的相機或擷取假影。
現代觀點
集成學習綜述。 Dong、Yu、Cao、Shi 與 Ma 對集成學習做了廣泛的綜述 [21]:他們回顧主流的集成方法、依其特性分類、列出各方法的挑戰與研究方向,並討論集成與深度學習、強化學習的結合。Ganaie、Hu、Malik、Tanveer 與 Suganthan 回顧了集成深度學習 [22],把方法整理成以 bagging、boosting、stacking 為基礎的深度集成、負相關學習(negative correlation learning)、顯式與隱式集成(例如共享權重的 snapshot 或 dropout 式集成)、同質與異質成員,以及決策融合策略。在所有這些類別中,實務問題都和前面變異數公式提出的一樣:如何便宜地取得多樣的成員。
表格資料上的樹集成。 儘管深度網路興起,梯度提升樹(XGBoost [9] 及其以直方圖為基礎的後繼者)與隨機森林 [5] 仍是中等規模表格問題的預設選擇;在辨識中,這類問題包括手工描述子、詮釋資料,以及其他模型的輸出。Grinsztajn、Oyallon 與 Varoquaux 在 45 個資料集上評比樹模型與深度架構,發現在約一萬筆樣本的規模下,樹模型仍是最先進的方法,並把差距歸因於神經網路對無資訊特徵敏感、具有旋轉不變性,以及難以學習不規則函數 [23]。
用集成估計不確定性。 Lakshminarayanan、Pritzel 與 Blundell 證明,深度集成(deep ensembles,以不同隨機初始化並搭配適當評分規則訓練的多個網路)在他們的實驗中,給出的預測不確定性與近似貝氏方法相當或更好,而且在分布外輸入上退化得較平緩 [24]。這把 bagging 的直覺(意見分歧代表變異數)連到 PR 08 的貝氏模型平均,也是新的不確定性方法都要比較的基準。
重新檢視偏差–變異數。 Belkin、Hsu、Ma 與 Mandal 記錄了雙重下降 [25]:當容量超過模型能內插訓練資料的那一點後,測試誤差可能再次下降。這並沒有推翻分解,但提醒我們「參數越多、變異數越大」不是定律,而經典的 U 形曲線只描述了容量範圍的一部分。
交叉驗證到底在估計什麼。 Arlot 與 Celisse 的綜述 [18] 仍是 CV 在風險估計與模型選擇方面理論的參考文獻。Bates、Hastie 與 Tibshirani 證明,CV 估計的是在同樣大小的其他訓練集上擬合的模型的平均誤差,而不是手上這個特定模型的誤差,且標準的 CV 信賴區間涵蓋率可能很差;他們提出以巢狀 CV 估計變異數,得到涵蓋率較好的區間 [19]。隨著自動化超參數搜尋在同一組折上比較成千上萬種設定,Cawley 與 Talbot 關於「對選擇準則過擬合」的警告 [13] 變得更加重要。
比較演算法。 實務已從天真的重抽樣 檢定,轉向單一資料集上的 McNemar 與修正檢定 [14], [15]、跨資料集時以排名為基礎並搭配臨界差圖的 Friedman/Nemenyi 檢定 [16],以及具實務等價區間的貝氏比較 [17]。Raschka 的教學文章 [20] 是涵蓋以上所有方法的實用指南。
開放問題。 在分布偏移(新相機、新場域或新族群)下的誠實評估,因為沒有任何隨機切分能對應部署情境;大型預訓練模型的預訓練資料可能包含測試影像所造成的洩漏;在推論時便宜的集成如何提供可靠的不確定性;以及只有單一大型基準時的統計比較。ML 11 會在深度視覺模型上延續這些主題。
重點整理
- 對平方誤差而言,期望測試誤差 = 雜訊 + 偏差平方 + 變異數;深樹這類有彈性的學習器以偏差換取變異數。
- 平均 個成對相關為 的預測器,剩下的變異數是 :bagging 與隨機森林對不穩定的學習器有幫助,而降低成員間相關性(隨機特徵子集)是關鍵槓桿。
- AdaBoost 是對指數損失的貪婪前向逐步最小化;梯度提升把樹擬合到任意可微分損失的負梯度,收縮與提早停止是主要的正則化手段。
- 投票、boosting、貝氏模型平均與 stacking 以不同方式組合模型;stacking 必須用 out-of-fold 預測訓練。
- 驗證估計的是程序:每個適應性選擇都屬於迴圈內部,切分必須遵守群組與時間,而要回報調過參的模型表現需要巢狀 CV。
- Bootstrap 的 .632+ 估計量修正了 .632 對過擬合學習器的過度樂觀;out-of-bag 分數忽略了群組結構。
- 不要對重疊的 CV 折做天真的 檢定;改用 McNemar、5×2cv、修正重抽樣 檢定,或跨資料集的 Friedman/Nemenyi,並回報效果量。
- 內部分群指標、外部一致性(ARI)與穩定性回答不同的問題;用它們選 就是模型選擇。
練習
- 相關性下限。 展開總和的變異數,推導平均變異數公式。當 時,需要多少個預測器才能讓變異數落在極限值的 1% 以內?這對 bagging 非常相似的模型有什麼啟示?
提示
總和有 個變異數項,以及 個有序共變異數項 。極限是 ;超出的部分是 。要求 得到 。超過幾十個高度相關的模型後幾乎沒有收穫;要再降低,唯一的方法是降低 。
- 手算 AdaBoost。 五個點的權重都是 。第一個樹樁恰好分錯其中一點。計算 、 與新的正規化權重。在新權重下,同一個樹樁的加權誤差是多少?為什麼這不是巧合?
提示
,。未正規化權重:分錯的點為 ,其餘為 ;總和 ,所以新權重是 與 (四個)。該樹樁的新加權誤差恰好是 :採用最佳 時,AdaBoost 總是重新加權到讓上一個學習器不比亂猜好,迫使下一個學習器去找新的東西。
- 會洩漏的折。 在巢狀 CV 程式中,把每個
GroupKFold換成KFold(3, shuffle=True, random_state=0)(並移除groups參數)。比較外層分數與群組不重疊的測試分數,並說明每種切分回答的是哪一個部署問題。
提示
使用逐列的折時,同一受試者三筆幾乎相同的測量中,常有兩筆在訓練集、第三筆被拿來驗證,所以森林可以認出受試者而不是類別;內外層分數應該會高於獨立群組測試。逐列的折回答「已知受試者的新測量」;群組折回答「新的受試者」。
- 穩定學習器的 bootstrap 與 CV。 用
KNeighborsClassifier(n_neighbors=15)重跑 bootstrap 程式。再代入誤差、bootstrap 外誤差、.632、.632+ 與 10 折 CV 現在如何比較?為什麼 .632 與 .632+ 的差距縮小了?
提示
15-NN 分類器的訓練誤差不再為零,所以相對過擬合率 小得多, 接近 0.632,兩個估計量幾乎一致。所有估計值應該都落在彼此幾個百分點之內。
- 選擇檢定。 你有 (a) 一個固定的基準切分,以及兩個偵測器的預測;(b) 一個小資料集,以及足以把每個模型重新訓練十次的計算資源;(c) 五個演算法在十二個公開資料集上的評估結果。每種情況適合哪個檢定?各自彼此獨立的單位是什麼?
提示
(a) 對成對不一致使用 McNemar 檢定(或精確二項檢定);單位是測試影像,訓練集造成的變異沒有被納入。(b) 5×2cv 檢定或修正重抽樣 檢定;單位是重抽樣,並針對重疊做修正。(c) Friedman 檢定加 Nemenyi 事後檢定(或貝氏階層比較);單位是資料集。
- 意義錯誤的群。 構造(在紙上或用
make_blobs)一個物體影像資料集,它依相機強烈分群,而類別標籤描述的是物體身分。哪些有效性指標會揭露這種不一致?哪些不會?
提示
silhouette 等內部指標會給相機群很高的分數,因為它們分離得很好。對物體標籤的外部 ARI 會很低,而對相機詮釋資料的 ARI 會很高。穩定性也會很高,所以單靠穩定性無法揭露這個分群在語意上是錯的。
參考文獻
-
S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2009. 第 4 章(決策樹、分類器組合、boosting)、第 10 章(「Supervised Learning: The Epilogue」)與第 16 章(「Cluster Validity」)。doi
-
C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006. 第 1.3 與 3.2 節(模型選擇、偏差–變異數)及第 14.1–14.5 節(貝氏模型平均、委員會、boosting、樹、條件式混合)。官方書籍與 PDF
-
S. Geman, E. Bienenstock and R. Doursat, “Neural networks and the bias/variance dilemma,” Neural Computation, vol. 4, no. 1, pp. 1–58, 1992. doi
-
L. Breiman, “Bagging predictors,” Machine Learning, vol. 24, no. 2, pp. 123–140, 1996. doi
-
L. Breiman, “Random forests,” Machine Learning, vol. 45, no. 1, pp. 5–32, 2001. doi
-
Y. Freund and R. E. Schapire, “A decision-theoretic generalization of on-line learning and an application to boosting,” Journal of Computer and System Sciences, vol. 55, no. 1, pp. 119–139, 1997. doi
-
J. Friedman, T. Hastie and R. Tibshirani, “Additive logistic regression: A statistical view of boosting (with discussion),” The Annals of Statistics, vol. 28, no. 2, 2000. doi
-
J. H. Friedman, “Greedy function approximation: A gradient boosting machine,” The Annals of Statistics, vol. 29, no. 5, 2001. doi
-
T. Chen and C. Guestrin, “XGBoost: A scalable tree boosting system,” in Proc. 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 785–794, 2016. doi
-
D. H. Wolpert, “Stacked generalization,” Neural Networks, vol. 5, no. 2, pp. 241–259, 1992. doi
-
B. Efron and R. Tibshirani, “Improvements on cross-validation: The .632+ bootstrap method,” Journal of the American Statistical Association, vol. 92, no. 438, pp. 548–560, 1997. doi
-
S. Varma and R. Simon, “Bias in error estimation when using cross-validation for model selection,” BMC Bioinformatics, vol. 7, 91, 2006. doi
-
G. C. Cawley and N. L. C. Talbot, “On over-fitting in model selection and subsequent selection bias in performance evaluation,” Journal of Machine Learning Research, vol. 11, pp. 2079–2107, 2010. JMLR
-
T. G. Dietterich, “Approximate statistical tests for comparing supervised classification learning algorithms,” Neural Computation, vol. 10, no. 7, pp. 1895–1923, 1998. doi
-
C. Nadeau and Y. Bengio, “Inference for the generalization error,” Machine Learning, vol. 52, no. 3, pp. 239–281, 2003. doi
-
J. Demšar, “Statistical comparisons of classifiers over multiple data sets,” Journal of Machine Learning Research, vol. 7, pp. 1–30, 2006. JMLR
-
A. Benavoli, G. Corani, J. Demšar and M. Zaffalon, “Time for a change: A tutorial for comparing multiple classifiers through Bayesian analysis,” Journal of Machine Learning Research, vol. 18, no. 77, pp. 1–36, 2017. JMLR
-
S. Arlot and A. Celisse, “A survey of cross-validation procedures for model selection,” Statistics Surveys, vol. 4, pp. 40–79, 2010. doi
-
S. Bates, T. Hastie and R. Tibshirani, “Cross-validation: What does it estimate and how well does it do it?,” Journal of the American Statistical Association, vol. 119, no. 546, pp. 1434–1445, 2024. doi
-
S. Raschka, “Model evaluation, model selection, and algorithm selection in machine learning,” arXiv:1811.12808, 2018. arXiv
-
X. Dong, Z. Yu, W. Cao, Y. Shi and Q. Ma, “A survey on ensemble learning,” Frontiers of Computer Science, vol. 14, no. 2, pp. 241–258, 2020. doi
-
M. A. Ganaie, M. Hu, A. K. Malik, M. Tanveer and P. N. Suganthan, “Ensemble deep learning: A review,” Engineering Applications of Artificial Intelligence, vol. 115, 105151, 2022. doi
-
L. Grinsztajn, E. Oyallon and G. Varoquaux, “Why do tree-based models still outperform deep learning on typical tabular data?,” in Advances in Neural Information Processing Systems (NeurIPS) Datasets and Benchmarks Track, 2022 (arXiv:2207.08815). arXiv
-
B. Lakshminarayanan, A. Pritzel and C. Blundell, “Simple and scalable predictive uncertainty estimation using deep ensembles,” in Advances in Neural Information Processing Systems (NIPS), 2017 (arXiv:1612.01474). arXiv
-
M. Belkin, D. Hsu, S. Ma and S. Mandal, “Reconciling modern machine-learning practice and the classical bias–variance trade-off,” Proceedings of the National Academy of Sciences, vol. 116, no. 32, pp. 15849–15854, 2019. doi
-
scikit-learn developers, scikit-learn User Guide:集成方法、交叉驗證、機率校準與分群效能評估。
-
NumPy developers, “numpy.linalg.lstsq,” API documentation, accessed 2026-11-05. documentation
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 10・辨識專題:拒絕、漂移與學習式特徵 · 28 分鐘