PR 10・辨識專題:拒絕、漂移與學習式特徵
先備知識:PR 09・集成、驗證與分群有效性
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
圖形識別
你將學到
- 如何把模糊的目標(「辨識手寫數字」)寫成一份實驗協定:觀測單位、抽樣單位、損失、拒絕選項,以及每個資料切分各自能用來做什麼。
- 如何用同一條管線(pipeline)與巢狀交叉驗證,公平比較本系列介紹過的分類器(樣板、單純貝氏、k-NN、LDA、邏輯斯迴歸、核 SVM、隨機森林)。
- 如何用校正後的重抽樣 t 檢定(corrected resampled t-test)判斷兩個模型的差距是否真實,而不是只看各折平均。
- 如何在開發資料上做錯誤分析、解讀學習曲線,並且只打開鎖住的測試集一次。
- 如何區分封閉集合準確率、選擇性分類、未知類別拒絕與分布漂移下的穩健性,以及這些原則如何延伸到預訓練神經網路特徵。
先看全貌
前九章各自研究辨識器的一個部分:決策與風險(PR 01)、密度估計(PR 02)、線性與核分類器(PR 03、PR 04)、特徵(PR 05)、樣板(PR 06)、分群(PR 07)、近似推論(PR 08),以及集成與驗證(PR 09)。真實的專題需要同時用上它們,順序要對,而且每個決策能看到哪些資料都必須有紀律。
為什麼重要:多數令人失望的辨識系統,並不是因為選錯了分類器,而是因為評估回答的問題和部署時的問題不同:測試集洩漏進模型選擇、切分時把同一個人的樣本分到兩邊、系統從沒被問過遇到沒見過的東西該怎麼辦,或者沒有人檢查影像平移一個像素時會發生什麼事。Theodoridis 與 Koutroumbas 把系統設計與評估視為圖形識別本身的一部分 [1],Bishop 則把最後一步表述為在損失函數下、帶有明確拒絕選項的決策 [2]。本章圍繞這些想法,完成一個完整的專題。
專題總覽
白話版。 我們依序走九個步驟。前七步只使用開發資料;第 8 步打開鎖住的測試集一次;第 9 步提出比「準確率多少」更難的問題。
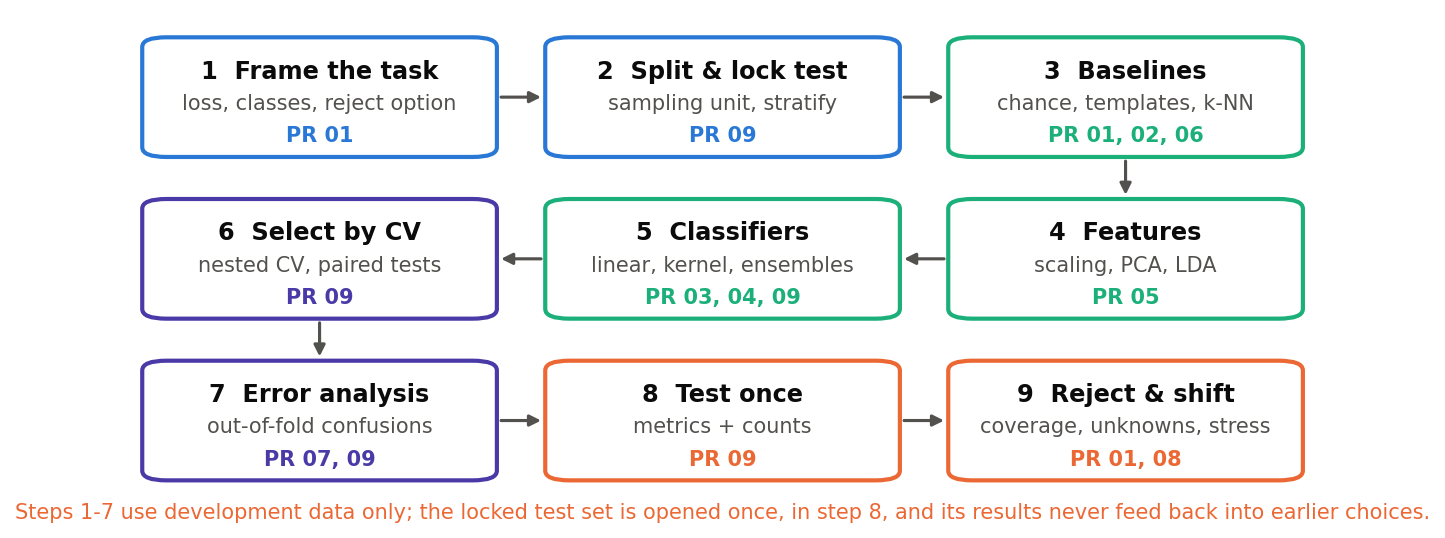
| 步驟 | 回答的問題 | 主要工具 | 對應章節 |
|---|---|---|---|
| 1 定義 | 什麼是一筆觀測、一個類別、一次錯誤? | 損失矩陣、拒絕選項 | PR 01 |
| 2 切分 | 哪些資料可以影響哪些決策? | 分層、分組切分 | PR 09 |
| 3 基準 | 在這裡「好」是什麼意思? | 機率水準、類別平均、k-NN、單純貝氏 | PR 01、02、06 |
| 4 特徵 | 分類器看到什麼表徵? | 標準化、PCA、LDA | PR 05 |
| 5 分類器 | 哪些模型家族值得一試? | 線性、核方法、集成 | PR 03、04、09 |
| 6 選模 | 選哪個設定?差距是真的嗎? | 巢狀交叉驗證、校正 t 檢定 | PR 09 |
| 7 分析 | 為何失敗?更多資料有用嗎? | 折外混淆、學習曲線 | PR 07、09 |
| 8 測試 | 凍結後的流程表現如何? | 含區間的準確率、各類別報告 | PR 09 |
| 9 壓力測試 | 不確定、新類別與漂移怎麼辦? | 涵蓋率–風險、未知類別、擾動 | PR 01、08 |
以下所有程式都能在筆電 CPU 上於一分鐘內跑完,只使用 scikit-learn 內建資料 [4]。第 2 到第 8 步的程式片段構成同一支腳本:請在同一個 Python 工作階段中依序執行。
步驟 1 — 定義任務
白話版。 動到模型之前,先寫下一筆樣本是什麼、可能的答案有哪些、犯錯的代價是多少,以及系統何時可以說「我不知道」。
一份書面協定
協定是在實驗之前寫下的簡短文件,能防止你在看到答案後才改問題。任何辨識專題至少要回答:
- 觀測。 一筆輸入是什麼?一張影像、一個裁切區塊、一段影片,還是一整份文件?
- 抽樣單位。 哪些觀測來自同一個來源(同一個人、同一台相機、同一位病人、同一天)?同源觀測彼此不獨立,在每一次切分中都必須留在同一側。
- 標籤空間。 訓練時已知哪些類別?其他類別的輸入應如何處理?
- 損失。 所有錯誤都一樣嚴重嗎?可以棄權嗎?棄權的代價是多少?
- 資料角色。 訓練、驗證、測試資料各自可以拿來做什麼?
- 部署條件。 評估必須涵蓋哪些裝置、書寫者、光照或時間區段?
我們想逼近的決策規則
PR 01 說明在 0–1 損失下,貝氏分類器會選擇後驗機率最大的類別。若加入代價為 的拒絕選項(正確決策代價為 0,錯誤代價為 1),就得到 Bishop 在決策理論一節所介紹的拒絕規則 [2]:
其中 是特徵向量, 是第 類, 是它的後驗機率, 是拒絕相對於錯誤的代價。若 ,拒絕不必付出代價,只要不是百分之百確定就拒絕;若 個類別時 ,則永遠不拒絕。之後的一切(選分類器、驗證、設定門檻)都是在用有限資料逼近這條規則。請記得它的限制:這條規則只處理已知類別之間的不確定。一個全新的類別仍可能得到很高的後驗機率,所以第 9 步會另外處理未知類別。
本專題與它的資料卡
我們使用 sklearn.datasets.load_digits 辨識手寫數字 [4]。為資料寫一張簡短的「資料卡」也是定義任務的一部分(這正是資料集資料表 datasheets for datasets 的精神 [24]):
- 來源。 這份資料是 Alpaydin 與 Kaynak 在 UCI 發布的「Optical Recognition of Handwritten Digits」資料集中測試部分的複本 [3]。
- 觀測。 共 1,797 張影像。每張原本是 的二值點陣圖,切成不重疊的 區塊;得到的 每一格計算區塊內「亮」的像素數,所以數值是 0 到 16 的整數 [3]。
- 類別。 十個數字,大致平衡(每類 174 到 183 張)。
- 來源者。 依資料集說明,這部分由 13 個人書寫,與書寫 UCI 訓練部分的 30 人不同 [3]。資料沒有提供書寫者編號。
最後一點限制了我們能做的所有宣稱。因為無法依書寫者分組,隨機切分會讓同樣這 13 個人的字同時出現在兩側。因此我們報告的測試準確率,估計的是這些書寫者的新影像上的表現,而不是新書寫者上的表現。UCI 的訓練部分由不同的人書寫,可以做到書寫者不重疊的測試,但它沒有內建在 scikit-learn 中,本章也不使用。坦白寫出這個限制,是誠實結果的一部分。
步驟 2 — 切分資料並鎖住測試集
白話版。 一開始就把四分之一的資料放進「上鎖的抽屜」。在第 8 步之前,所有決策都不能用到它。
程式碼 · Python · 15 行
import numpy as np
import warnings
warnings.filterwarnings("ignore", message=".*within_class_std_dev_.*")
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

digits = load_digits()
X, y = digits.data, digits.target          # 1797 x 64, integer intensities 0..16
print("shape:", X.shape, "range:", X.min(), X.max())
print("class counts:", np.bincount(y))

idx = np.arange(len(y))
dev, test = train_test_split(idx, test_size=0.25, stratify=y, random_state=0)
assert not set(dev) & set(test)
print("development:", len(dev), "test (locked):", len(test))輸出:shape: (1797, 64) range: 0.0 16.0,各類別數量介於 174 到 183,development: 1347 test (locked): 450。(warnings 過濾器只是關掉 NearestCentroid 的一則無害提示:某些邊緣像素在同一類別內恆為常數。)
為什麼要分層? 測試集只有 450 張,隨機切分很容易讓某個數字偏少。分層(stratification)讓兩邊的類別比例一致。它不能解決觀測之間的相依性;只有依抽樣單位分組才能做到(PR 09)。
資料洩漏:最常見的自欺方式
Kapoor 與 Narayanan 整理了以機器學習為基礎的科學研究中的再現性失敗,發現資料洩漏(data leakage)遍布許多領域;他們提出的分類包括:訓練與測試沒有乾淨分離、在全部資料上擬合前處理、跨切分的重複樣本、不正當的特徵,以及測試集與目標母體不符 [5]。在辨識專題中,最常見的形式是:
- 在切分前,就用全部資料擬合標準化、PCA 或特徵選擇;
- 看著測試分數選擇超參數、特徵或門檻;
- 近乎重複的影像(連續影格、擴增後的副本、同一個人)落在切分兩側;
- 測試集來自與部署不同的母體(例如部署時面對新書寫者,測試卻只有同一群書寫者)。
解法是從結構上著手:把每一個需要擬合的轉換都放進 scikit-learn 的 Pipeline,讓交叉驗證在每一折的訓練部分重新擬合;並且在第 8 步之前,任何函式呼叫都不碰測試索引。
步驟 3 — 觀察資料並建立基準
白話版。 訓練任何巧妙的模型之前,先看看樣本,並計算簡單方法能做到多好。一個花俏模型若只比極簡模型好一點點,就不算成功。
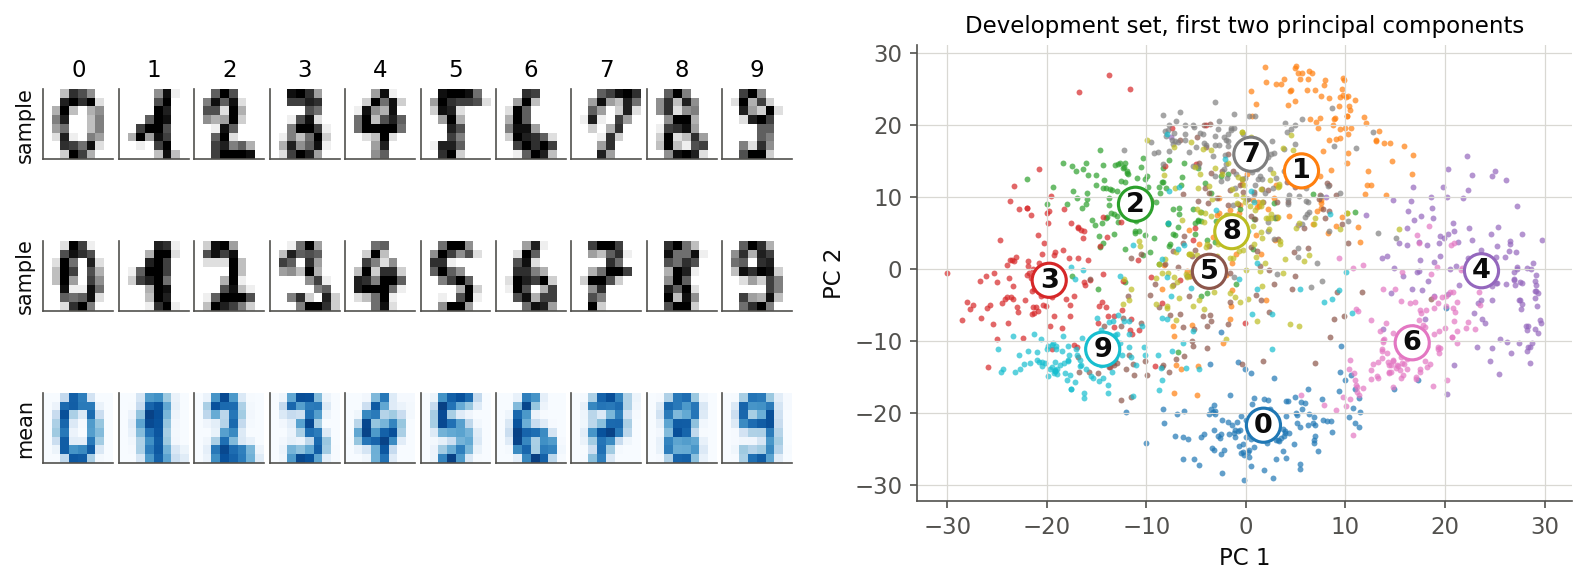
圖 2 已透露出難度的結構。類別平均看起來像乾淨的數字,所以樣板比對(PR 06)應該有不錯的效果。在兩個主成分中,有些類別分得很開,有些重疊;PR 05 解釋過,變異大的方向不一定最具鑑別力,因此兩個成分中的重疊,並不代表 64 維中也重疊。
我們使用四個基準,各自對應一章:
- 多數類別。 永遠預測最常見的數字。十個平衡類別下,準確率約 10%。這是下限。
- 最近類別平均。 把影像和每個類別平均比較,選最接近的:最簡單的樣板比對器。
- 高斯單純貝氏。 一種貝氏分類器(PR 01),類別條件密度為對角共變異數的高斯分布。像素之間高度相關,獨立假設在這裡嚴重不成立,我們預期它表現較差。
- k 最近鄰。 一種以密度為基礎的無母數規則(PR 02):由最接近的 張訓練影像投票。
步驟 4 — 決定特徵
白話版。 分類器只看得到數字。要決定用哪些數字、如何縮放、要不要壓縮,而且這些轉換只能在訓練折上擬合。
我們的原始特徵是 64 個區塊計數。有三種常見轉換值得比較:
標準化。 減去每個特徵在訓練資料上的平均,再除以標準差:
其中 是第 個像素, 與 是它在訓練折上的平均與標準差, 是標準化後的值。當特徵單位差異很大時,這對以距離或梯度為基礎的方法很重要。但這裡所有特徵本來就是同一個單位(0 到 16 的計數)。更糟的是,邊緣像素幾乎總是 0, 很小:標準化會把偶爾出現的雜散筆畫放大成很大的值。我們會看到這個選擇明顯拖累核 SVM。
主成分分析。 PCA 把資料投影到變異最大的方向(PR 05)。保留 個成分時,表徵為 ,其中 存放訓練共變異數前 個特徵向量。它能移除雜訊方向並加速核方法,但變異不等於類別資訊。
線性鑑別分析。 LDA(PR 03、PR 05)找出最多 個方向,使類間散布相對於類內散布最大。我們把它當作帶收縮(shrinkage)的分類器使用,收縮可正則化類內共變異數的估計。
對真實影像而言,這一步也是加入工程特徵(HOG、LBP、矩等,見特徵擷取一章)或預訓練嵌入的地方。在 的解析度下,原始計數是合理的起點。
步驟 5 — 比較候選分類器
白話版。 讓每個候選模型都跑過開發集上同一組交叉驗證切分,比較它們的分數分布,而不是只看最好的那一折。
程式碼 · Python · 33 行
from sklearn.model_selection import RepeatedStratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.dummy import DummyClassifier
from sklearn.neighbors import NearestCentroid, KNeighborsClassifier
from sklearn.naive_bayes import GaussianNB
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.ensemble import RandomForestClassifier

candidates = {
    "majority class (PR 01)": DummyClassifier(strategy="most_frequent"),
    "nearest class mean (PR 06)": NearestCentroid(),
    "Gaussian naive Bayes (PR 01)": GaussianNB(),
    "k-NN, k=3 (PR 02)": KNeighborsClassifier(n_neighbors=3),
    "LDA, shrinkage (PR 03/05)": LinearDiscriminantAnalysis(
        solver="lsqr", shrinkage="auto"),
    "logistic regression (PR 03)": make_pipeline(
        StandardScaler(), LogisticRegression(C=1.0, max_iter=3000)),
    "PCA-30 + RBF SVM (PR 04/05)": make_pipeline(
        StandardScaler(), PCA(n_components=30, random_state=0),
        SVC(C=10, gamma="scale")),
    "random forest (PR 09)": RandomForestClassifier(
        n_estimators=300, random_state=0, n_jobs=1),
}
cv = RepeatedStratifiedKFold(n_splits=5, n_repeats=2, random_state=0)
cv_scores = {}
for name, model in candidates.items():
    s = cross_val_score(model, X[dev], y[dev], cv=cv, scoring="accuracy")
    cv_scores[name] = s
    print(f"{name:30s} {s.mean():.3f} +/- {s.std():.3f}")
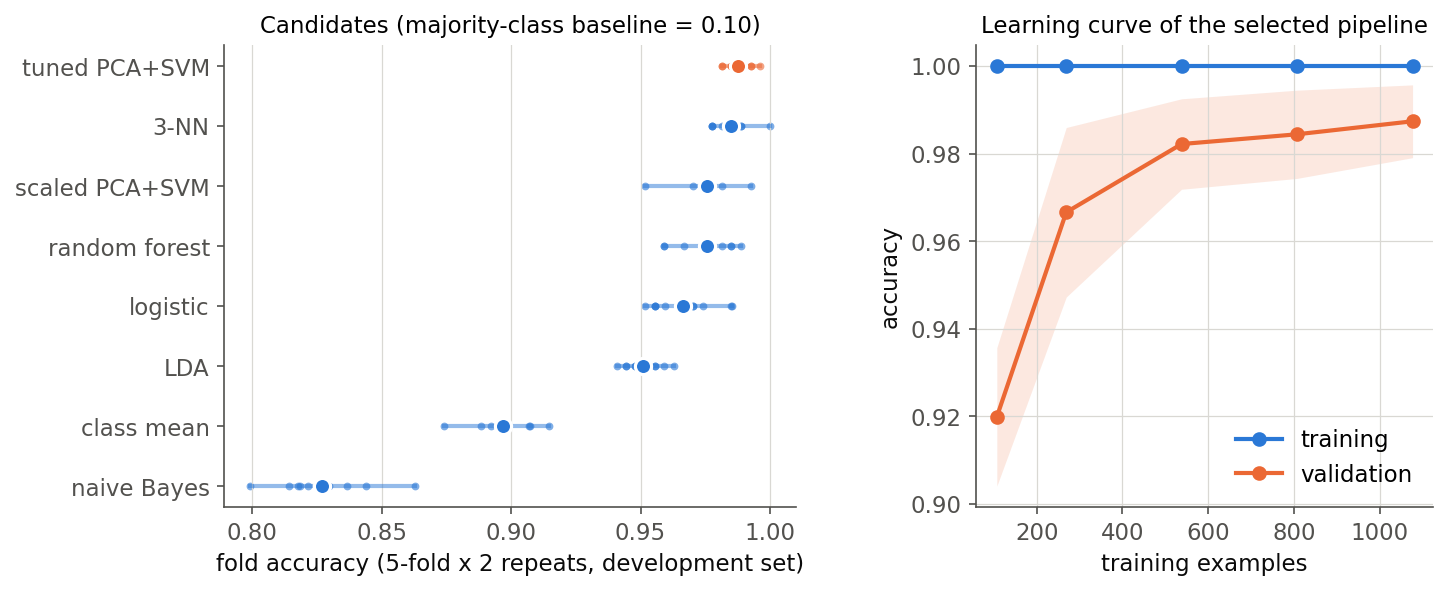
輸出(10 折的平均 ± 標準差):
| 候選模型 | 交叉驗證平均準確率 | 標準差 |
|---|---|---|
| 多數類別 | 0.100 | 0.000 |
| 高斯單純貝氏 | 0.827 | 0.017 |
| 最近類別平均 | 0.897 | 0.011 |
| 帶收縮的 LDA | 0.951 | 0.007 |
| 邏輯斯迴歸(標準化) | 0.966 | 0.012 |
| 隨機森林,300 棵樹 | 0.975 | 0.010 |
| 標準化 + PCA-30 + RBF SVM | 0.976 | 0.010 |
| 3 最近鄰 | 0.985 | 0.007 |
已經可以看出幾個教訓:
- 簡單模型的排名反映了它們的假設。 單純貝氏的獨立假設被相鄰像素間的相關性打破,是最弱的真正模型。每類只有一個樣板(最近平均)無法涵蓋同一數字的不同寫法。LDA 建模共享的完整共變異數,表現好得多。
- 未調參模型中最好的,是最簡單的無母數模型。 3-NN 勝過所有未調參的有母數模型。1,347 張小影像、只有 13 位書寫者,許多影像在訓練折中都有近乎雙胞胎的樣本,這正是最近鄰最擅長的情況。這也提醒我們,這種切分衡量的是「已知書寫者的新影像」。
- 預設值不是公平的比較。 SVM 與邏輯斯迴歸帶著標準化步驟與接近預設的設定。下結論前,強的候選模型值得調參,而且要在不會讓比較產生偏誤的協定下進行。
步驟 6 — 調參與選模,不自欺
白話版。 調參是方法的一部分。要估計「含調參的 SVM」有多好,必須在每一個外層折內重做整個調參。然後再問:與次佳模型的剩餘差距,是否大於雜訊?
巢狀交叉驗證
內層迴圈選超參數,外層迴圈評估整個流程。如果直接回報內層最佳分數,等於回報許多雜訊數字中的最大值,必然偏樂觀。Varma 與 Simon 以實驗展示了交叉驗證選模的這種偏誤 [6];Cawley 與 Talbot 則指出,過度擬合選模準則所造成的效能差異,可能與不同學習演算法之間的差異一樣大 [7]。Raschka 的教學式回顧整理了實務做法 [9]。
程式碼 · Python · 17 行
from sklearn.model_selection import GridSearchCV, StratifiedKFold
from sklearn.pipeline import Pipeline

svm = Pipeline([("scale", StandardScaler()), ("pca", PCA(random_state=0)),
                ("svc", SVC())])
grid = {"scale": [StandardScaler(), "passthrough"],
        "pca": [PCA(30, random_state=0), "passthrough"],
        "svc__C": [1, 10],
        "svc__gamma": ["scale", 0.001]}
inner = StratifiedKFold(5, shuffle=True, random_state=1)
outer = StratifiedKFold(5, shuffle=True, random_state=2)
search = GridSearchCV(svm, grid, cv=inner, scoring="accuracy")
nested = cross_val_score(search, X[dev], y[dev], cv=outer)
print("nested-CV accuracy of the tuning procedure:",
      nested.round(3), "mean", nested.mean().round(3))
search.fit(X[dev], y[dev])
print("chosen on all development data:", search.best_params_)
輸出:外層各折準確率 [0.993 0.993 0.985 0.985 0.993],平均 0.99。在全部開發資料上選出的設定是不標準化、PCA 保留 30 個成分、、。
兩點觀察。第一,網格本身包含了前處理的決定("passthrough" 表示「略過這一步」),而驗證結果拒絕了標準化,印證了步驟 4 的論點。第二,巢狀估計值(0.990)描述的是「執行這個網格搜尋,再重新擬合」這個流程,也就是我們要部署的東西;它不是某一組超參數的性質。
贏家真的比較好嗎?
調參後的 SVM(巢狀 0.990)與 3-NN(0.985)相差半個百分點。這是真的嗎?對各折分數做一般的成對 t 檢定,會把各折當成獨立樣本;但不同折的訓練集高度重疊,各折分數正相關,一般檢定因此過度自信。Nadeau 與 Bengio 為重抽樣設計提出了校正後的變異數 [8]:
其中 是兩個模型在第 次重抽樣上的分數差, 與 是這 個差值的平均與樣本變異數, 與 是每次重抽樣的訓練與測試筆數。額外的 項放大變異數,以反映重疊。統計量與自由度 的 分布比較。PR 09 推導了這個檢定,並討論 McNemar 檢定等替代方案。
程式碼 · Python · 16 行
from scipy import stats

def corrected_t(a, b, n_train, n_test):
    """Nadeau-Bengio corrected resampled t-test on paired fold scores."""
    d = np.asarray(a) - np.asarray(b)
    k = len(d)
    var = d.var(ddof=1) * (1 / k + n_test / n_train)
    t = d.mean() / np.sqrt(var)
    return t, 2 * stats.t.sf(abs(t), df=k - 1)

n_test_fold = len(dev) // 5
tuned = cross_val_score(search.best_estimator_, X[dev], y[dev], cv=cv)
t, p = corrected_t(tuned,
                   cv_scores["k-NN, k=3 (PR 02)"],
                   n_train=len(dev) - n_test_fold, n_test=n_test_fold)
print(f"tuned SVM vs k-NN: corrected t = {t:.2f}, p = {p:.3f}")輸出:tuned SVM vs k-NN: corrected t = 1.03, p = 0.331。
這個輸出應視為變異數修正的探索性示範,不是確認性的顯著性檢定。SVM 設定在重複切折前已使用全部開發標籤選定;修正處理的是折間重疊,不是這項選擇偏差 [7, 8]。不顯著也不能證明兩者等效。若要重新比較,應使用 cross_val_score(search, ...),讓每個評估折內都重新調參,並在相同外層切分上評估預先指定的比較方法,再交代統計檢定仍有的近似。此處保留 3-NN 作為強力替代方案,依先前巢狀評估及儲存/預測需求繼續使用調參後的 SVM,不宣稱已在統計上證明平手。
步驟 7 — 在開發資料上做錯誤分析
白話版。 去看錯誤,但要看開發資料上的錯誤。一旦因為測試錯誤而重新設計系統,測試集就不再是測試集了。
折外預測
cross_val_predict 會為每張開發影像回傳一個「沒有用它訓練過」的模型所做的預測。這些預測適合用於開發階段的錯誤分析。但 chosen 已使用全部開發標籤選定:每張影像只被排除於係數擬合,並未被排除於超參數選擇。因此不能把此錯誤數報成調參程序的不偏評估;若目標是評估完整程序,就要把完整搜尋放進外層預測迴圈 [7]。
程式碼 · Python · 15 行
from sklearn.model_selection import cross_val_predict
from sklearn.metrics import confusion_matrix

chosen = search.best_estimator_
oof = cross_val_predict(chosen, X[dev], y[dev],
                        cv=StratifiedKFold(5, shuffle=True, random_state=3))
cm_dev = confusion_matrix(y[dev], oof)
off = cm_dev.copy()
np.fill_diagonal(off, 0)
order = np.argsort(off.ravel())[::-1][:5]
print("out-of-fold errors:", int(off.sum()), "of", len(dev))
for t_, p_ in zip(*np.unravel_index(order, off.shape)):
    print(f"  true {t_} -> predicted {p_}: {off[t_, p_]}")
dev_errors = dev[oof != y[dev]]
print("first misclassified dataset indices:", dev_errors[:8])
輸出:1,347 張中有 17 個錯誤。最常見的混淆是 9 → 8(3 次)、5 → 9(3 次)、8 → 1(2 次),其次是 9 → 5、6 → 8 等單次錯誤。
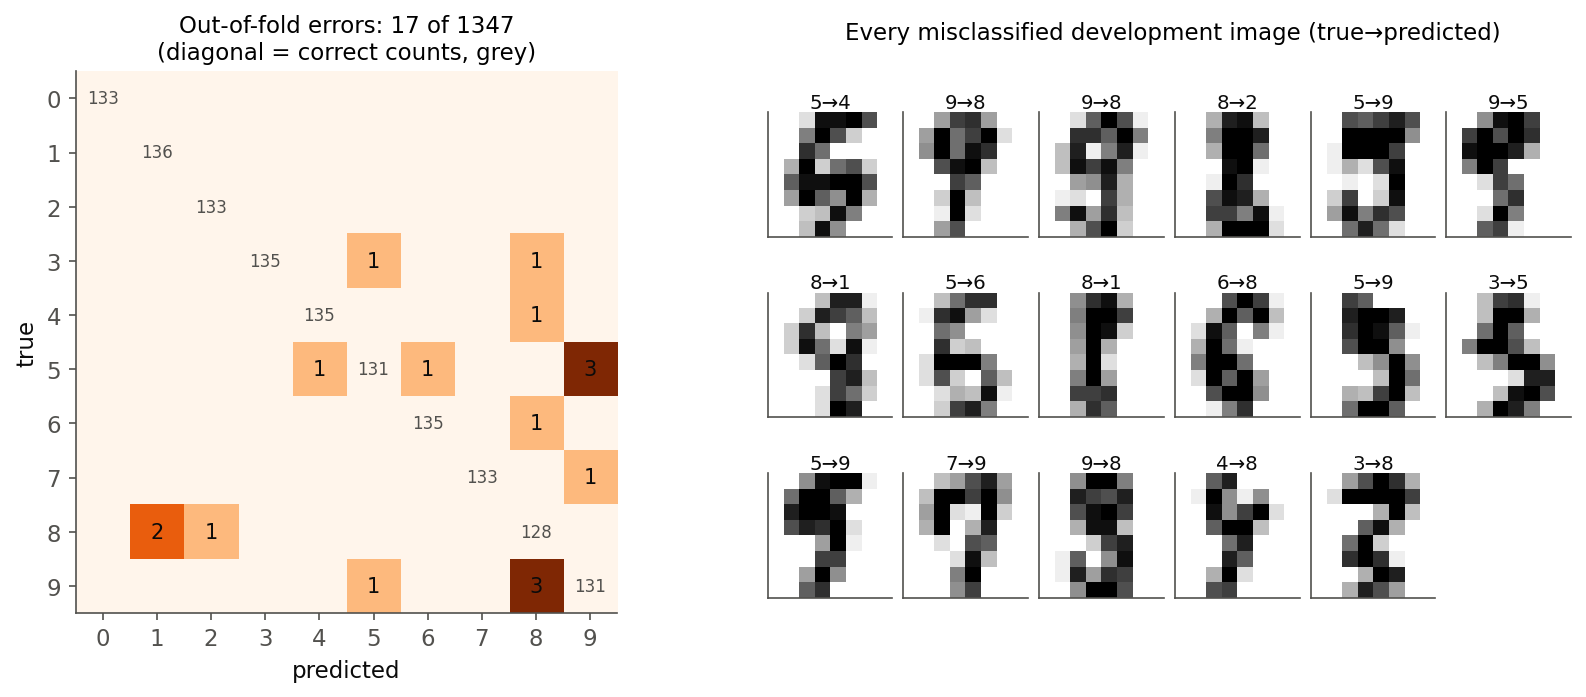
解讀圖 4 時,就需要領域知識:
- 系統性混淆。 錯誤集中在上方有封閉圈的數字(5、8、9)與細長直筆畫的數字(1、8)。在 解析度下,區分 9 與 8 的缺口可能只有一格。
- 標籤或品質問題。 有些分錯的影像連人都難以判斷。在較大的專題中,你會逐一檢視,判斷它們是標註錯誤(要修正)、本質上模稜兩可的輸入(第 9 步拒絕的候選),還是一般失誤(以特徵或資料改善)。
- 把錯誤分群。 錯誤有上百個時,無法逐一檢查。常見技巧是在特徵空間中對分錯的樣本分群(PR 07),再檢查每群的幾個成員;一個群集通常對應一種失敗模式,例如某種書寫風格或擷取問題。
好的錯誤分析最後會得到假設,每個假設都搭配一個能在開發資料上執行的實驗,例如:「讓模型對一格平移不敏感,可能改善 5/9 混淆;試著在訓練折中加入平移後的副本,再重跑巢狀比較。」
更多資料有用嗎?學習曲線
程式碼 · Python · 7 行
from sklearn.model_selection import learning_curve

sizes, tr, va = learning_curve(
    chosen, X[dev], y[dev], cv=StratifiedKFold(5, shuffle=True, random_state=3),
    train_sizes=[0.1, 0.25, 0.5, 0.75, 1.0])
for n, a, b in zip(sizes, tr.mean(1), va.mean(1)):
print(f"n={n:4d} train={a:.3f} validation={b:.3f}")| 訓練影像數 | 訓練準確率 | 驗證準確率 |
|---|---|---|
| 107 | 1.000 | 0.920 |
| 269 | 1.000 | 0.967 |
| 538 | 1.000 | 0.982 |
| 807 | 1.000 | 0.984 |
| 1,077 | 1.000 | 0.987 |
各種訓練量下訓練準確率都是滿分,驗證準確率在右端仍緩慢上升(圖 3 右)。以偏差–變異的語言(PR 09)來說,剩下的誤差主要是變異:模型已經夠有彈性,更多(或更多樣)的訓練資料可能還有一點幫助。若兩條曲線一起停在低處,建議就相反:需要表達力更強的模型或更好的特徵。
步驟 8 — 打開測試集,只打開一次
白話版。 凍結所有選擇,把最終管線用在鎖住的測試影像上,並連同不確定性與適用範圍一起報告結果。
程式碼 · Python · 17 行
from sklearn.metrics import (accuracy_score, balanced_accuracy_score,
                             classification_report)

final = search.best_estimator_            # already refit on all of dev
pred = final.predict(X[test])
print("TEST accuracy:", round(accuracy_score(y[test], pred), 4),
      "balanced:", round(balanced_accuracy_score(y[test], pred), 4),
      "errors:", int((pred != y[test]).sum()), "of", len(test))
cm = confusion_matrix(y[test], pred)
print(cm)
print(classification_report(y[test], pred, digits=3))

k, n, z = int((pred == y[test]).sum()), len(test), 1.96   # Wilson interval
phat = k / n
centre = (phat + z**2 / (2 * n)) / (1 + z**2 / n)
half = z * np.sqrt(phat * (1 - phat) / n + z**2 / (4 * n**2)) / (1 + z**2 / n)
print(f"95% Wilson interval for accuracy: [{centre - half:.3f}, {centre + half:.3f}]")
輸出:測試準確率 0.9933(450 張中 3 個錯誤:3 → 7、8 → 1、9 → 5 各一次),平衡準確率 0.9933,各類別召回率介於 0.977 到 1.000,95% Wilson 區間為 [0.981, 0.998]。
如何解讀與報告:
- 報告數量,而不只是百分比。 「450 張中錯 3 張」能讓讀者立刻知道小數點第三位有多可信。
- 報告區間。 準確率接近 1 時,常用的常態近似 可能超過 1,並不可靠;上面使用的 Wilson 分數區間會留在 之內,在邊界附近表現較好。若有 筆測試樣本、 筆正確、,其中心為 ,95% 涵蓋時 。
- 與開發估計比較。 測試結果(0.993)與巢狀估計(0.990)一致。若低很多,可能原因是開發過程有洩漏,或測試母體與開發不同,兩者都值得追查;但若因此修改系統,就需要一份新的未碰過的測試集。
- 說明範圍。 這是同樣 13 位書寫者的新影像上的準確率(步驟 1),不能證明對新書寫者、新掃描器或新前處理的表現。
程式中的協定註解很重要:search.best_estimator_ 在測試前已在全部開發資料上重新擬合一次。若再用開發加測試資料重新擬合,然後報告測試分數,就毫無意義。部署時可以用全部有標籤的資料重新擬合凍結的流程,但報告的數字必須來自上面這次執行。
步驟 9 — 超越封閉集合準確率
一個在已知數字的平衡測試上達到 99% 的辨識器,若會自信地把一個英文字母標成數字,或在掃描器把影像平移時崩潰,依然可能毫無用處。這一步檢驗三個封閉集合數字無法回答的問題。
四種容易混淆的任務
| 任務 | 系統必須做什麼 | 評估必須包含什麼 |
|---|---|---|
| 封閉集合分類 | 在訓練過的類別中選一個 | 已知類別的獨立樣本 |
| 選擇性分類 | 對困難的已知樣本棄權 | 已知樣本的涵蓋率與被接受樣本的錯誤率 |
| 開放集合辨識 | 分類已知類別,並拒絕未知類別 | 保留的未知類別,以及已知樣本 |
| 異常偵測 | 標出偏離參考母體的樣本 | 定義清楚的正常母體與相關的偏離 |
信心低的已知樣本不一定是未知類別;不熟悉的類別可能得到很高的信心;一個有效的已知物件若拍得很差,也可能被拒絕。這些任務需要不同的資料與指標。
選擇性分類:涵蓋率與風險
白話版。 讓分類器略過最沒把握的輸入,並量測兩件事:它還回答了多少輸入,以及這些回答有多常出錯。
設信心分數為 、接受門檻為 ,在 筆已知類別測試樣本上,預測為 、標籤為 :
這裡 在條件成立時為 1,否則為 0。沒有任何樣本被接受時,選擇性風險沒有定義。掃描 、畫出風險對涵蓋率的關係,就得到風險–涵蓋率曲線;Geifman 與 El-Yaniv 說明了如何為深度網路選擇門檻,使其以高機率保證達到指定的風險 [11]。有用的門檻必須在驗證資料上選定,再只在測試資料上報告。
開放集合辨識:保留的類別
白話版。 訓練時假裝某些數字不存在,再檢查它們出現時系統是否會拒絕。
Scheirer 等人將開放集合辨識形式化:分類器必須限制它標為已知的「開放空間」,否則一個以 類訓練的模型,會把世上任何輸入都歸到其中一類 [13]。最簡單的基準分數是最大 softmax(或類別)機率,由 Hendrycks 與 Gimpel 提出,用來偵測分錯的樣本與分布外樣本 [12]。
我們以縮小的標籤空間重做實驗。數字 0–5 為已知;數字 6–7 為開發階段可以看的代理未知;數字 8–9 為保留到最後評估的測試未知。驗證在兩條預先定義的管線之間做選擇,拒絕門檻設為驗證信心的第 5 百分位數,目標是接受約 95% 的已知數字。所有選擇在最後區塊之前就凍結。這支腳本是獨立的。
這是獨立的六類別實驗。變數放在 open_set_demo() 內,讓原本十類別模型、開發索引與鎖定的測試索引保持不變,供後面的壓力測試使用。
程式碼 · Python · 62 行
def open_set_demo():
    import numpy as np
    from sklearn.datasets import load_digits
    from sklearn.model_selection import train_test_split
    from sklearn.pipeline import make_pipeline
    from sklearn.preprocessing import StandardScaler
    from sklearn.decomposition import PCA
    from sklearn.linear_model import LogisticRegression
    from sklearn.svm import SVC
    from sklearn.metrics import balanced_accuracy_score, confusion_matrix, roc_auc_score

    digits = load_digits()
    X, y = digits.data, digits.target
    known = np.flatnonzero(y < 6)
    train, rest = train_test_split(known, test_size=0.4,
                                  stratify=y[known], random_state=10)
    valid, test = train_test_split(rest, test_size=0.5,
                                  stratify=y[rest], random_state=10)
    proxy_unknown = np.flatnonzero((y == 6) | (y == 7))
    test_unknown = np.flatnonzero(y >= 8)
    assert not set(train) & (set(valid) | set(test))
    assert not set(proxy_unknown) & set(test_unknown)

    candidates = {
        "linear": make_pipeline(
            StandardScaler(), LogisticRegression(C=1.0, max_iter=1500)),
        "PCA + RBF": make_pipeline(
            StandardScaler(), PCA(n_components=24, random_state=10),
            SVC(C=4.0, gamma=0.02, probability=True, random_state=10)),
    }
    scores = {}
    for name, model in candidates.items():
        model.fit(X[train], y[train])
        validation_p = model.predict_proba(X[valid])
        validation_pred = model.classes_[validation_p.argmax(axis=1)]
        scores[name] = balanced_accuracy_score(y[valid], validation_pred)
    name = max(scores, key=scores.get)
    model = candidates[name]
    threshold = np.quantile(model.predict_proba(X[valid]).max(axis=1), 0.05)
    proxy_conf = model.predict_proba(X[proxy_unknown]).max(axis=1)
    print("Validation candidates:", scores, "selected:", name)
    print("Fixed threshold:", threshold)
    print("Proxy-unknown acceptance:", np.mean(proxy_conf >= threshold))

    # Final evaluation begins here; do not revise choices from these results.
    known_p = model.predict_proba(X[test])
    known_conf = known_p.max(axis=1)
    known_pred = model.classes_[known_p.argmax(axis=1)]
    accept = known_conf >= threshold
    unknown_conf = model.predict_proba(X[test_unknown]).max(axis=1)
    print("Known test balanced accuracy:",
          balanced_accuracy_score(y[test], known_pred))
    print("Known coverage:", accept.mean())
    print("Accepted known accuracy:",
          np.mean(known_pred[accept] == y[test][accept]) if accept.any() else np.nan)
    print("Unknown-test acceptance:", np.mean(unknown_conf >= threshold))
    is_unknown = np.r_[np.zeros(len(test)), np.ones(len(test_unknown))]
    unknown_score = 1 - np.r_[known_conf, unknown_conf]
    print("Unknown detection AUROC:", roc_auc_score(is_unknown, unknown_score))
    print("Known-class confusion matrix:\n", confusion_matrix(y[test], known_pred))

open_set_demo()
依輸出順序:驗證平衡準確率 0.982(線性)對 0.995(PCA + RBF),因此選 RBF 管線;門檻 0.741;代理未知接受率 0.083;已知測試平衡準確率 0.981;已知涵蓋率 0.949;被接受的已知樣本準確率 0.995;測試未知接受率 0.350;未知偵測 AUROC 0.944。
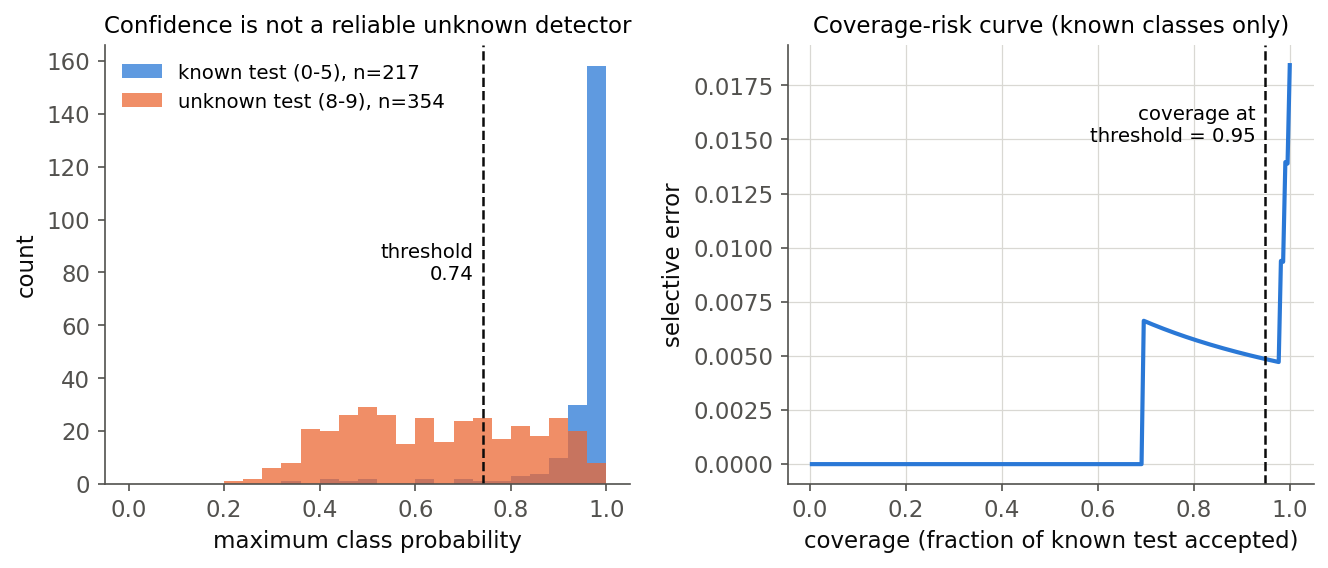
這些數字道出開放集合評估的主要教訓:
- 在已知數字上,拒絕機制如預期運作:涵蓋率 95%,被接受的樣本準確率 99.5%。
- 代理未知(6 與 7)有 92% 被拒絕,這可能讓人以為信心門檻「解決了」未知類別。
- 真正的測試未知(8 與 9)有 35% 被接受。8 看起來像多了筆畫的 3 或 5,9 看起來像 5 或 3;分類器很有信心地把它們對應到這些已知數字。
- AUROC 0.944 概括的是對這幾種特定未知類別的排序能力,它不會決定操作門檻,也不代表其他種類的新奇輸入。
在一組代理未知上的表現,不會轉移到其他未知類別。請報告保留了哪些類別,也絕不要宣稱能拒絕「所有不熟悉的輸入」。Vaze 等人發現,較強的封閉集合分類器往往也是較好的開放集合辨識器,兩者在各方法間高度相關 [16];因此改進基礎模型與使用更好的分數(特徵距離、能量或 logit 分數)是互補的。
另一類分數直接建模參考母體:單類 SVM(one-class SVM)估計包含大部分訓練資料的區域 [17];孤立森林(Isolation Forest)則標出能被隨機軸向切分迅速孤立的點 [18]。「離群值」可能是擷取錯誤、罕見但有效的案例,或是新類別;統計上的不尋常並不會告訴你是哪一種。
分布漂移與壓力測試
白話版。 部署之後,世界會改變。用受控的擾動提出「如果……」的問題,更好的做法是用來自新條件的真實資料。
令 與 分別為訓練與部署時特徵與標籤的聯合分布。Moreno-Torres 等人整理了分類問題中資料集漂移的術語 [19]。最重要的三種情況是:
- 先驗(標籤)漂移: 類別頻率 改變, 不變。例如新表單版面讓某個數字變得常見許多。
- 共變量漂移: 改變, 不變。例如新掃描器讓筆畫變粗。
- 概念漂移: 本身改變。例如寫 7 的新慣例多了一橫。
這些是建模假設,不是能從資料名稱讀出的診斷。換相機可能改變類別條件特徵;加入新類別則會徹底打破標籤空間。
我們無法在這裡蒐集新的手寫資料,但可以對測試影像施加受控擾動來探測敏感度。模型不重新訓練;擾動方式在看結果之前就決定好。
程式碼 · Python · 16 行
rng = np.random.default_rng(0)
def shift_right(X, k=1):
    imgs = X.reshape(-1, 8, 8)
    out = np.zeros_like(imgs)
    out[:, :, k:] = imgs[:, :, :-k]
    return out.reshape(len(X), 64)

conditions = {
    "clean": X[test],
    "noise sd=2": np.clip(X[test] + rng.normal(0, 2, X[test].shape), 0, 16),
    "noise sd=4": np.clip(X[test] + rng.normal(0, 4, X[test].shape), 0, 16),
    "shift 1 px right": shift_right(X[test], 1),
    "contrast x0.5": X[test] * 0.5,
}
for name, Xc in conditions.items():
    print(f"{name:18s} accuracy = {accuracy_score(y[test], final.predict(Xc)):.3f}")
(請接在步驟 8 的程式之後執行,而不是開放集合腳本之後,因為它使用十類版本的 X、test 與 final。)
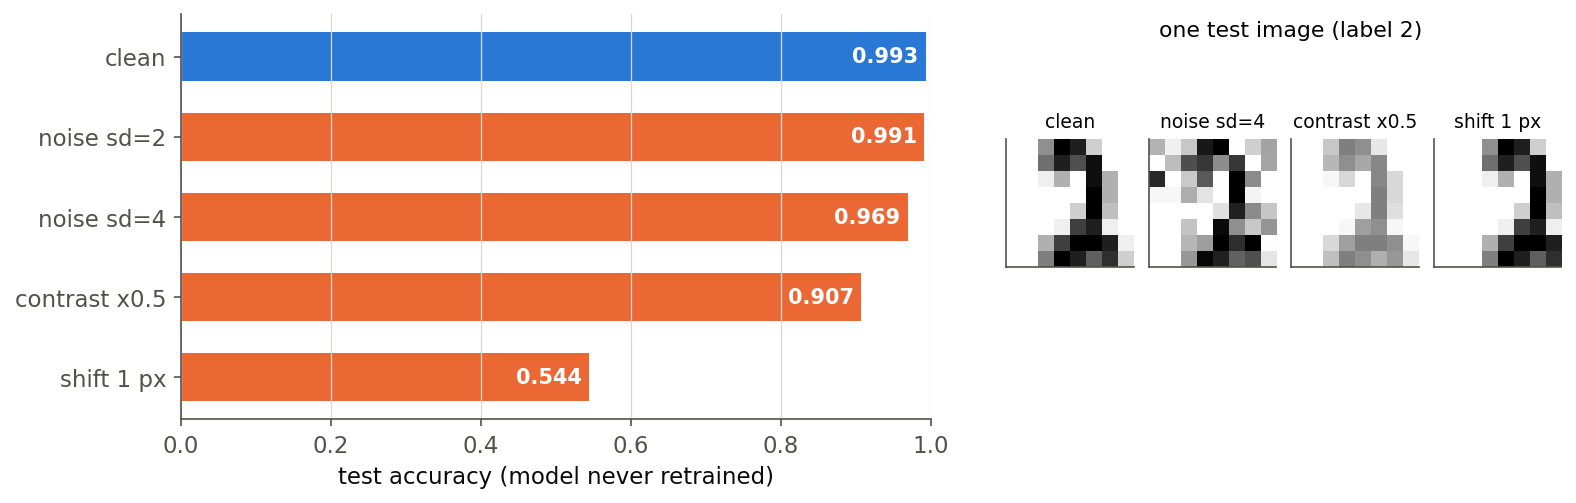
| 條件 | 測試準確率 |
|---|---|
| 乾淨 | 0.993 |
| 加性雜訊,標準差 2 | 0.991 |
| 加性雜訊,標準差 4 | 0.969 |
| 對比減半 | 0.907 |
| 向右平移一格 | 0.544 |
加性雜訊幾乎沒有影響。對比減半損失約 9 個百分點,因為 RBF 核直接比較原始強度,而 是針對全對比筆畫調的。平移一格幾乎讓準確率減半:以像素向量為輸入的分類器,並不知道平移後的 3 仍然是 3。一格相當於原始 點陣圖中 4 個像素的區塊,也就是影像寬度的八分之一,對裁切不精確的情況而言是很實際的錯位。這是把平移容忍度內建進模型的經典理由:透過資料擴增,或透過卷積與池化,LeCun 等人在文件辨識中展示了這一點 [10](見 ML 03)。
合成擾動是便宜的初步檢查,無法取代新條件下的真實資料。WILDS 等基準蒐集了跨醫院、相機與地區的真實分布漂移,顯示從分布內到分布外有明顯的效能下降 [21];Recht 等人依原始流程重建 CIFAR-10 與 ImageNet 測試集,即使沒有刻意的漂移,許多模型的準確率仍然下降 [20]。請依有意義的條件(書寫者、裝置、場域、時間)分別報告結果,而不只是彙總。
名副其實的機率
如果下游使用者會依據信心值行動,這些值就必須校準:信心 0.8 的預測中,約 80% 應該是對的。Guo 等人指出現代深度網路常常過度自信,而在驗證資料上擬合單一純量溫度(temperature scaling)是強而有效的修正 [22]。對 SVM 而言,SVC(probability=True) 會在內部以交叉驗證擬合 Platt 縮放;CalibratedClassifierCV 則提供明確的控制。校準必須在沒有用來訓練基礎模型的資料上擬合,而且它無法修復分布漂移。
銜接學習式與基礎模型特徵
白話版。 把手工特徵換成預訓練網路的特徵,本章其餘的一切都不變。
用預訓練編碼器取代特徵映射:
其中 是原始影像, 是凍結的網路(例如 DINOv2 這類自監督視覺 Transformer [25]), 是它的嵌入, 是以你的標籤訓練、參數為 的分類器。線性探測(linear probe,在凍結嵌入上做邏輯斯迴歸)是標準基準;請在固定切分與指標的前提下,將它與嵌入上的 k-NN、正則化的非線性分類頭以及微調比較。ML 06 說明這類特徵如何學得,ML 10 說明如何調適它們。
協定可以自然延伸:
- 記錄檢查點、輸入縮放、正規化、池化方式與嵌入維度;
- 下游前處理(標準化、PCA)只在訓練嵌入上擬合;
- 檢查點、提示詞或層的選擇都算模型選擇,必須在驗證資料上進行;
- 若評估影像可能出現在預訓練資料中,請說明你掌握了哪些關於重疊的證據;
- 以距離為基礎的未知分數(到訓練嵌入的 k-NN 距離)在好的嵌入上往往比在原始像素上有效得多,但仍需要保留的未知類別來評估。
表徵學習改變的是量測的取得方式,它不會改變最小風險決策、誠實的驗證,以及把已知類別準確率與拒絕、漂移分開看待的原則;這正是本系列的框架 [1], [2]。
要繳交什麼
一個完成的辨識專題,至少應包含:
- 任務定義: 觀測、標籤空間、損失、拒絕政策。
- 資料卡: 來源、授權、抽樣單位、類別數量、已知限制(本例:13 位書寫者、沒有書寫者編號)[24]。
- 切分說明: 每個切分的用途、切分單位、亂數種子。
- 基準與候選模型: 試過的所有模型,而不只是贏家,附上開發分數與其變異。
- 選模證據: 所選流程的巢狀估計,以及與第二名的統計比較。
- 錯誤分析: 混淆結構、範例、假設、學習曲線。
- 最終測試結果: 數量、區間、各類別結果、範圍說明。
- 壓力測試結果: 拒絕(涵蓋率與風險)、保留的未知類別、漂移或擾動測試;若使用機率,還要有校準。
- 可重現性: 環境與函式庫版本、完整的管線物件、類別順序;若重要,還有執行時間與記憶體。
模型卡(model cards)將這份清單中面向部署的部分形式化(預期用途、評估條件、在相關族群上的表現、注意事項)[23]。如果原本的測試集影響了任何重新設計,修改後的系統就需要一份新的受保護測試集。
現代觀點
本章流程的原則由來已久,實務仍在演進。以下回顧與研究是很好的入門。
Raschka,〈Model evaluation, model selection, and algorithm selection in machine learning〉(2018)[9]。 一篇長篇教學式回顧,把評估分成三個不同目標:估計泛化效能、選擇超參數與模型、比較演算法。內容涵蓋保留法、自助法與交叉驗證、巢狀交叉驗證,以及統計檢定(McNemar、5×2cv 等),並依資料量給出實務建議。它是最接近本章步驟 2 與步驟 6 的單一參考文獻。
Kapoor 與 Narayanan,〈Leakage and the reproducibility crisis in machine-learning-based science〉(Patterns,2023)[5]。 蒐集了許多科學領域中已發表的洩漏案例,提出洩漏類型的分類,並設計「模型資訊表」(model info sheets),要求作者逐項說明為何不存在各類洩漏。主要結論是:洩漏很常見,往往在報告的數字中看不出來,最好透過協定預防,而不是事後偵測。
Geng、Huang 與 Chen,〈Recent advances in open set recognition: a survey〉(TPAMI,2021)[14]。 區分已知的已知、已知的未知、未知的已知與未知的未知等類別,並把開放集合方法分為判別式(傳統機器學習與深度網路)與生成式(實例生成與非實例生成)兩大家族。它也說明開放集合辨識與零樣本、單樣本以及帶拒絕的分類之間的關係,並回顧常用的資料集與評估準則。
Yang、Zhou、Li 與 Liu,〈Generalized out-of-distribution detection: a survey〉(IJCV,2024)[15]。 把異常偵測、新奇偵測、開放集合辨識、分布外偵測與離群值偵測統一在同一個框架中,依漂移屬於語意或共變量、以及分布內任務是什麼來區分。決定你的專題屬於「四種任務」表的哪一列時,應該使用這套詞彙。
Vaze、Han、Vedaldi 與 Zisserman,〈Open-set recognition: a good closed-set classifier is all you need?〉(ICLR,2022)[16]。 顯示封閉集合準確率與開放集合表現高度相關,訓練良好的基準搭配最大 logit 分數即可與專門方法競爭;並提出「語意漂移基準」(Semantic Shift Benchmark),把語意上的新奇與低階漂移分開。
Koh 等人的 WILDS(ICML,2021)[21] 與 Recht 等人(ICML,2019)[20]。 這是評估漂移的兩種互補視角:WILDS 整理跨領域的真實部署漂移;Recht 等人則顯示,即使小心地「從同一分布」重新蒐集測試集,準確率仍可能下降。兩者共同主張依條件分別報告結果,並把單一的獨立同分布測試分數視為上限。
Guo 等人,〈On calibration of modern neural networks〉(ICML,2017)[22] 與 Geifman 與 El-Yaniv(NeurIPS,2017)[11] 是深度模型信心品質與選擇性預測的起點。
最新進展(2023–2026)。 實務上,辨識專題越來越常從凍結或輕度微調的基礎模型特徵(例如 DINOv2 [25])加上線性或 k-NN 分類頭開始,把省下的力氣投入資料品質、評估設計與文件記錄。分布外評估則朝向統一的基準,以及 [15] 所提出的語意與共變量區分發展。資料表 [24] 與模型卡 [23] 提供了現成的範本,可與這些結果一起記錄資料與模型。
開放問題。
- 未知的未知。 任何保留的「未知」類別都只是一個樣本;沒有通用的方法能保證拒絕所有新奇輸入。
- 漂移下的評估。 為每一種部署條件蒐集有標籤的資料代價高昂,而合成擾動並不能可靠地預測真實漂移。
- 預訓練重疊。 在網路規模的預訓練下,越來越難保證測試影像從未被看過,這讓「鎖住測試集」的原則更加複雜。
- 小樣本比較。 許多應用專題只有數百筆而非數百萬筆有標籤樣本;此時本章每個估計的變異都很大,統計比較不可或缺。
重點整理
- 先寫協定:觀測、抽樣單位、標籤空間、損失、拒絕政策與每個切分的角色。多數評估失敗其實是協定失敗。
- 在任何建模之前鎖住測試集,把每個需要擬合的轉換放進管線,並把特徵與前處理當成超參數。
- 在相同的折上比較所有候選模型;基準告訴你什麼叫「好」,而在這份數字資料上,3-NN 基準很難被打敗。
- 用巢狀交叉驗證估計含調參的流程,並在宣稱某模型較好之前使用校正後的重抽樣檢定。
- 在開發資料的折外預測上做錯誤分析;用學習曲線判斷該加資料還是換更強的模型。
- 只打開測試集一次,並報告數量、區間與範圍(本例:同樣 13 位書寫者的新影像)。
- 封閉集合準確率、選擇性風險、未知類別拒絕與漂移下的穩健性是不同的性質:一個 99% 準確的數字分類器,仍接受了 35% 的未見數字,且在平移一格時失去將近一半的準確率。
練習
- 以距離做拒絕。 在開放集合實驗中,把最大類別機率換成測試影像在「以訓練資料擬合的 PCA 空間」中到最近訓練影像的距離。只用驗證集的已知數字選門檻,再在測試集上報告已知涵蓋率與未知接受率。它是否勝過信心門檻?
提示
只在 X[train] 上擬合 StandardScaler 與 PCA,再對轉換後的訓練集使用 NearestNeighbors(n_neighbors=1)。分數就是距離(越大越像「未知」);把門檻設在驗證距離的第 95 百分位數,讓約 95% 的已知驗證數字被接受。兩個數字都要報告;看到測試結果後不得更改門檻。
- 不作弊的風險–涵蓋率曲線。 以十類調參 SVM 的決策值作為信心,先用開發資料的折外預測畫出風險–涵蓋率曲線,再(僅供報告)畫出測試集上的曲線。說明為什麼選擇性準確率可能提高,而有用的涵蓋率卻崩潰;涵蓋率為零時又會怎樣?
提示
依信心由高到低排序樣本;每個截斷點的涵蓋率是保留比例,風險是保留樣本中的錯誤率。涵蓋率很低時只剩少數樣本,風險很不穩定;涵蓋率為零時風險沒有定義。在開發曲線上選定任一操作點,再讀出它在測試上的值。
- 修補平移弱點。 在每一個訓練折中,加入影像向左、右、上、下各平移一格的副本。重跑步驟 6 的巢狀比較與步驟 9 的壓力測試。哪些準確率改變了?為什麼擴增必須在折內進行?
提示
寫一個小型轉換器或自訂迴圈,只擴增每次切分中的訓練部分;在切分前擴增,會把驗證影像的平移副本放進訓練,這就是洩漏。預期平移測試的準確率會大幅上升,而乾淨資料的準確率維持相近或略有變化。
- 以設計達成書寫者不重疊的評估。 UCI 資料集的訓練部分由 30 人書寫,測試部分由另外 13 人書寫 [3]。(在紙上)設計一個衡量新書寫者泛化能力的實驗。你預期本章哪些數字會改變?只靠內建資料,有哪些結論就無法再下?
提示
在一群書寫者上訓練與選模,在另一群上測試。預期 k-NN 的準確率特別會下降,因為它的優勢來自同一書寫者的近似重複樣本。由於同一部分內沒有書寫者編號,開發階段仍無法做分組交叉驗證,所以驗證依然混合了書寫者。
- 顯著嗎? 使用步驟 5 的 10 個折分數,對邏輯斯迴歸與隨機森林、以及 LDA 與邏輯斯迴歸套用校正後的重抽樣 t 檢定。再計算不含 項的一般成對 t 檢定。在哪種情況下,兩種檢定會得到不同結論?
提示
5 折交叉驗證下 ,遠大於 ,因此校正後的變異數約為一般變異數的 3.5 倍, 統計量約縮小 倍。差異小但一致的情況,正是兩者結論分歧之處。
- 凍結特徵對微調。 針對你選擇的真實影像資料集,設計一個比較「凍結預訓練特徵上的線性探測」與「完整微調」的實驗。列出每一個可能洩漏測試資訊的決策。
提示
包括檢查點與層的選擇、影像縮放與正規化、資料擴增、學習率與訓練輪數的選擇(提前停止)、門檻與校準的擬合、若使用視覺–語言模型則還有提示詞設計,以及預訓練資料與測試影像之間可能的重疊。
參考文獻
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press (Elsevier), 2009; Ch. 1 “Introduction”, Ch. 5–7 on feature selection and generation, Ch. 10 “Supervised Learning: The Epilogue”. doi
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006; Sec. 1.5 (decision theory and the reject option), Sec. 1.3 (model selection), Ch. 14 (combining models). official page and PDF
- E. Alpaydin and C. Kaynak, “Optical Recognition of Handwritten Digits,” UCI Machine Learning Repository, 1998. doi
- F. Pedregosa et al., “Scikit-learn: Machine learning in Python,” Journal of Machine Learning Research, vol. 12, pp. 2825–2830, 2011. JMLR; dataset loader: load_digits
- S. Kapoor and A. Narayanan, “Leakage and the reproducibility crisis in machine-learning-based science,” Patterns, vol. 4, no. 9, 2023. doi
- S. Varma and R. Simon, “Bias in error estimation when using cross-validation for model selection,” BMC Bioinformatics, vol. 7, 91, 2006. doi
- G. C. Cawley and N. L. C. Talbot, “On over-fitting in model selection and subsequent selection bias in performance evaluation,” Journal of Machine Learning Research, vol. 11, pp. 2079–2107, 2010. JMLR
- C. Nadeau and Y. Bengio, “Inference for the generalization error,” Machine Learning, vol. 52, pp. 239–281, 2003. doi
- S. Raschka, “Model evaluation, model selection, and algorithm selection in machine learning,” arXiv:1811.12808, 2018. arXiv
- Y. LeCun, L. Bottou, Y. Bengio and P. Haffner, “Gradient-based learning applied to document recognition,” Proceedings of the IEEE, vol. 86, no. 11, pp. 2278–2324, 1998. doi
- Y. Geifman and R. El-Yaniv, “Selective classification for deep neural networks,” in Advances in Neural Information Processing Systems 30 (NIPS), 2017. proceedings
- D. Hendrycks and K. Gimpel, “A baseline for detecting misclassified and out-of-distribution examples in neural networks,” in Proc. ICLR, 2017. arXiv
- W. J. Scheirer, A. de Rezende Rocha, A. Sapkota and T. E. Boult, “Toward open set recognition,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 35, no. 7, pp. 1757–1772, 2013. doi
- C. Geng, S.-J. Huang and S. Chen, “Recent advances in open set recognition: A survey,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 43, no. 10, 2021. doi
- J. Yang, K. Zhou, Y. Li and Z. Liu, “Generalized out-of-distribution detection: A survey,” International Journal of Computer Vision, 2024. doi
- S. Vaze, K. Han, A. Vedaldi and A. Zisserman, “Open-set recognition: A good closed-set classifier is all you need?,” in Proc. ICLR, 2022. arXiv
- B. Schölkopf, J. C. Platt, J. Shawe-Taylor, A. J. Smola and R. C. Williamson, “Estimating the support of a high-dimensional distribution,” Neural Computation, vol. 13, no. 7, pp. 1443–1471, 2001. doi
- F. T. Liu, K. M. Ting and Z.-H. Zhou, “Isolation forest,” in Proc. IEEE International Conference on Data Mining (ICDM), 2008. doi
- J. G. Moreno-Torres, T. Raeder, R. Alaiz-Rodríguez, N. V. Chawla and F. Herrera, “A unifying view on dataset shift in classification,” Pattern Recognition, vol. 45, no. 1, pp. 521–530, 2012. doi
- B. Recht, R. Roelofs, L. Schmidt and V. Shankar, “Do ImageNet classifiers generalize to ImageNet?,” in Proc. ICML, PMLR 97, pp. 5389–5400, 2019. PMLR
- P. W. Koh, S. Sagawa, H. Marklund et al., “WILDS: A benchmark of in-the-wild distribution shifts,” in Proc. ICML, PMLR 139, pp. 5637–5664, 2021. PMLR
- C. Guo, G. Pleiss, Y. Sun and K. Q. Weinberger, “On calibration of modern neural networks,” in Proc. ICML, 2017. arXiv
- M. Mitchell, S. Wu, A. Zaldivar, P. Barnes, L. Vasserman, B. Hutchinson, E. Spitzer, I. D. Raji and T. Gebru, “Model cards for model reporting,” in Proc. Conference on Fairness, Accountability, and Transparency (FAT*), 2019. doi
- T. Gebru, J. Morgenstern, B. Vecchione, J. W. Vaughan, H. Wallach, H. Daumé III and K. Crawford, “Datasheets for datasets,” Communications of the ACM, vol. 64, no. 12, 2021. doi
- M. Oquab, T. Darcet, T. Moutakanni et al., “DINOv2: Learning robust visual features without supervision,” arXiv:2304.07193, 2023. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑這是「圖形識別」單元的最後一篇。 回到學習地圖 →