PR 06・模板比對與結構化辨識
先備知識:PR 05・特徵選擇、轉換與降維
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 模板比對如何以差平方和、互相關與正規化互相關(NCC)運作,以及各自能容忍哪些干擾變化。
- 動態時間扭曲(dynamic time warping, DTW)如何對齊以不同速度展開的序列,以及如何加以約束。
- 句法與結構式圖形識別:把圖形描述為字串、文法與圖,並以編輯距離與圖匹配加以比較。
- 有向與無向圖模型如何分解聯合分布,以及為什麼這讓推論變得有效率。
- 隱藏式馬可夫模型(HMM):前向演算法、前向–後向平滑、Viterbi 解碼與 Baum–Welch 學習,附經過測試的程式。
- 條件隨機場(CRF)作為 HMM 的判別式對應版本,以及這些概念在 2026 年如何延續。
先看全貌
PR 03 與 PR 04 的分類器一次只看一個固定長度的特徵向量,並單獨決定它的類別。許多辨識問題並非如此:
- 要在影像中找到某個零件,你把參考圖片在影像上滑動,尋找最吻合的位置(模板)。
- 一個口說的詞或一個簽名隨時間展開,而不同的人產生它的速度不同(對齊)。
- 一個字元、一個分子或一張道路網,最好用它的部件以及部件如何連接來描述(結構)。
- 單獨一小塊影像可能是道路也可能是屋頂;潦草的手寫字母可能是「c」也可能是「e」。相鄰的區域或字母能消除這種歧義(脈絡)。
整章有一條共同的主線:動態規劃。DTW、編輯距離、HMM 前向演算法、Viterbi 解碼與 CRF 推論,用的都是同一個技巧:把對所有對齊方式或標籤序列的龐大搜尋,拆成可以重複利用的小子問題,成本就從指數降到多項式。
開頭先提醒一點:只有當脈絡的假設符合現實時,脈絡才有幫助。過強的「鄰居要一致」規則可能抹掉小物件或短暫的事件,所以脈絡並非越多越好。本章的教科書背景是 Theodoridis 與 Koutroumbas 第 8、9 章 [1],以及 Bishop 第 8.1–8.4 與 13.1–13.3 節 [2]。
模板比對
白話版。 保留一張小的參考影像,也就是模板。把它在場景上滑動,在每個位置量測底下那塊影像有多相似,分數最好的位置就是匹配處。有趣的問題在於如何量測相似度,才不會被無關的變化(例如曝光變亮或變暗)騙過。
三種相似度
把模板寫成由 個像素值組成的向量 ,模板下方的影像區塊寫成同樣長度 的 。
差平方和(SSD)。 ,越小越好。這是最自然的距離,但場景中任何亮度偏移或對比變化都會讓它變大。
互相關。 把平方展開,。模板能量 是常數,所以如果區塊能量 也大致固定,最小化 SSD 就等同於最大化相關 。實務上 變化很大,單純的相關會被明亮區域吸引。
正規化互相關(NCC)。 先減去平均,再除以範數:
其中 與 是區塊與模板的平均像素值, 是全為 1 的向量。NCC 是兩個減去平均後的向量夾角的餘弦,所以落在 ;它等於 1 若且唯若對某個 與任意 有 。因此它對正的對比變化()與亮度偏移()不變。模板或區塊為常數時 NCC 沒有定義(分母為零),各實作會回傳 0 或 NaN 之類的約定值。NCC 就是 IP 13 中的「以相關進行比對」。
有效率地計算
在 影像的每個位置以 模板計算 NCC,成本約為 次運算。分子是一個相關運算,可以用 FFT 一次算出所有位置(相關定理,IP 04)。分母中的局部平均與能量隨位置變化;Lewis 說明如何由影像及其平方的累加表(積分影像)便宜地取得它們,讓 NCC 幾乎和單純的相關一樣快 [3]。
程式碼 · Python · 22 行
import cv2
import numpy as np
from skimage import data

img = data.camera().astype(np.float32)          # 512 x 512 grayscale
r0, c0, h, w = 300, 200, 40, 40
template = img[r0:r0 + h, c0:c0 + w].copy()

def ncc_at(window, t):
    a, b = window - window.mean(), t - t.mean()
    return float((a * b).sum() / (np.linalg.norm(a) * np.linalg.norm(b)))

# The scene is captured again under different exposure: darker and lower contrast.
scene = 0.5 * img + 20.0
ncc = cv2.matchTemplate(scene, template, cv2.TM_CCOEFF_NORMED)
ssd = cv2.matchTemplate(scene, template, cv2.TM_SQDIFF)
r, c = np.unravel_index(ncc.argmax(), ncc.shape)
print("NCC best (row, col):", (int(r), int(c)), "score", round(float(ncc.max()), 4))
r, c = np.unravel_index(ssd.argmin(), ssd.shape)
print("SSD best (row, col):", (int(r), int(c)))
print("hand-computed NCC at true location:",
      round(ncc_at(scene[r0:r0 + h, c0:c0 + w], template), 4))
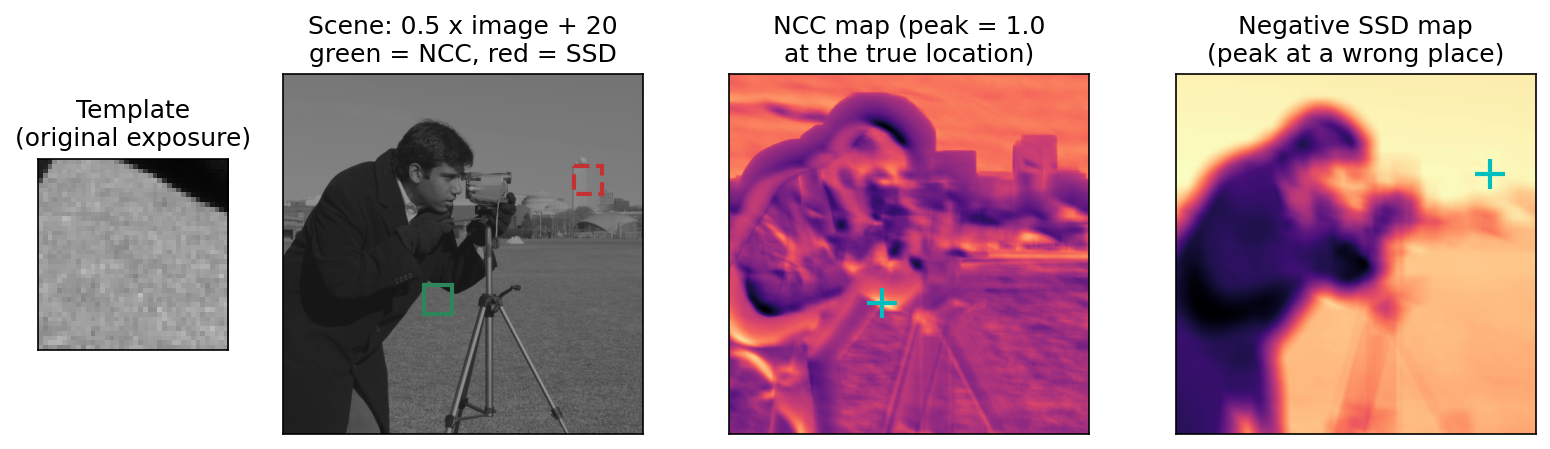
NCC 在真實位置 (300, 200) 找到模板,分數為 1.0,手算值也和 OpenCV 的 TM_CCOEFF_NORMED 一致。SSD 被曝光變化騙過,選了 (130, 413):這是一塊天空,變暗後的強度(平均約 129)比變暗後的真實區塊(平均約 92)更接近模板原本的數值(平均約 143)。
模板處理不了的事
NCC 只消除亮度與對比,其他一概不管。旋轉、尺度變化、透視、遮蔽與非剛性形變都會降低分數。經典的補救方法是儲存一整組模板(旋轉與縮放後的副本)、在影像金字塔上搜尋,或先比對小部件再檢查它們的幾何排列,後者就通往下文的結構式方法。當外觀受到嚴格控制時(例如工業檢測),模板比對仍是正確的工具,它也仍是追蹤與影像對位的核心步驟 [4]。
動態時間扭曲
白話版。 兩個人說同一個詞,一個慢、一個快。逐點比較兩段錄音會失敗,因為聲音在時間上對不齊。DTW 拉長或壓縮其中一條序列的時間軸,讓它與另一條盡可能對齊,再量測剩下的差異。
遞迴式
令 與 為兩條序列, 為局部成本,例如 ,或向量樣本的 。扭曲路徑是一串索引對 ,從 開始、在 結束,每次只走 、 或 其中一步,因此在兩條序列中都不會倒退。DTW 是所有扭曲路徑中總成本最小者,以填表方式計算:
其中 ,且對 有 。於是 。每一格只需要它的三個鄰格,所以時間成本是 。回溯每一格的最小值來自哪個鄰格,就能還原最佳對齊。這就是 Sakoe 與 Chiba 為口說詞辨識所最佳化的演算法 [5]。
約束與注意事項
不加約束的路徑可能把一條序列的單一樣本對應到另一條序列的一長段(「病態扭曲」),讓不相關的序列看起來相似。兩種標準的解法是:
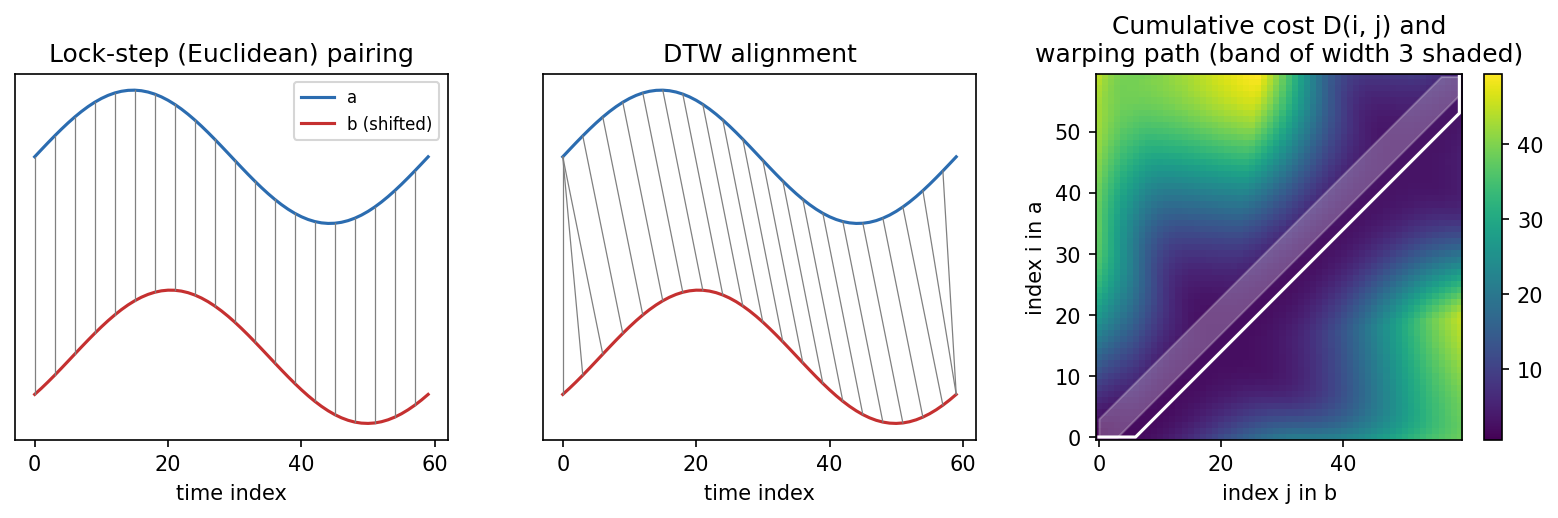
帶寬 必須容得下真實的時間差。在程式與圖 2 中,3 個樣本的帶寬比真實的位移(約 6 個樣本)窄,所以加了帶的 DTW 無法完全對齊兩條正弦波。
實務上還有兩件事很重要。DTW 不是度量:它可能違反三角不等式,所以假設度量性質的資料結構要小心使用。此外,序列在比較前通常會先做 z 正規化(平均為零、變異數為一),讓 DTW 比較的是形狀,而不是偏移與尺度。
程式碼 · Python · 25 行
import numpy as np

def dtw(x, t, band=None):
    """DTW distance between 1-D sequences x (length n) and t (length m)."""
    n, m = len(x), len(t)
    D = np.full((n + 1, m + 1), np.inf)
    D[0, 0] = 0.0
    for i in range(1, n + 1):
        lo, hi = 1, m
        if band is not None:                    # Sakoe-Chiba band
            lo, hi = max(1, i - band), min(m, i + band)
        for j in range(lo, hi + 1):
            cost = abs(x[i - 1] - t[j - 1])
            D[i, j] = cost + min(D[i - 1, j], D[i, j - 1], D[i - 1, j - 1])
    return D[n, m]

s = np.linspace(0, 2 * np.pi, 60)
a = np.sin(s)
b = np.sin(s - 0.6)                              # same shape, shifted in time
c = 0.25 * np.sign(np.sin(3 * s))                # a different shape
print("lock-step a-b:", round(np.abs(a - b).sum(), 2),
      " a-c:", round(np.abs(a - c).sum(), 2))
print("DTW       a-b:", round(dtw(a, b), 2),
      " a-c:", round(dtw(a, c), 2))
print("DTW a-b with band 3:", round(dtw(a, b, band=3), 2))
兩種比較都使用同樣的局部成本 。逐點(lock-step)比較時,平移後的副本 成本為 22.76,不同形狀的 為 35.18。DTW 把平移副本的成本降到 5.05,而不同形狀仍維持 34.57:扭曲吸收的是時間差,而不是形狀差。加上 3 個樣本的帶之後,平移副本的成本升到 12.76,因為對約 6 個樣本的位移而言,這個帶太窄了。
以 DTW 距離做 1-最近鄰分類,多年來一直是時間序列分類中強而難以超越的基準 [16]。結合便宜的下界與及早放棄無望的候選之後,在極長的序列中以 DTW 搜尋最近鄰才變得可行 [6]。
句法與結構式圖形識別
白話版。 有些圖形最好不要用一串數字描述,而是用它的部件以及部件如何組合來描述,就像句子是依文法排列的字詞。結構式圖形識別把圖形描述成由基本部件組成的字串、樹或圖,再比較或剖析這些結構。
字串與文法
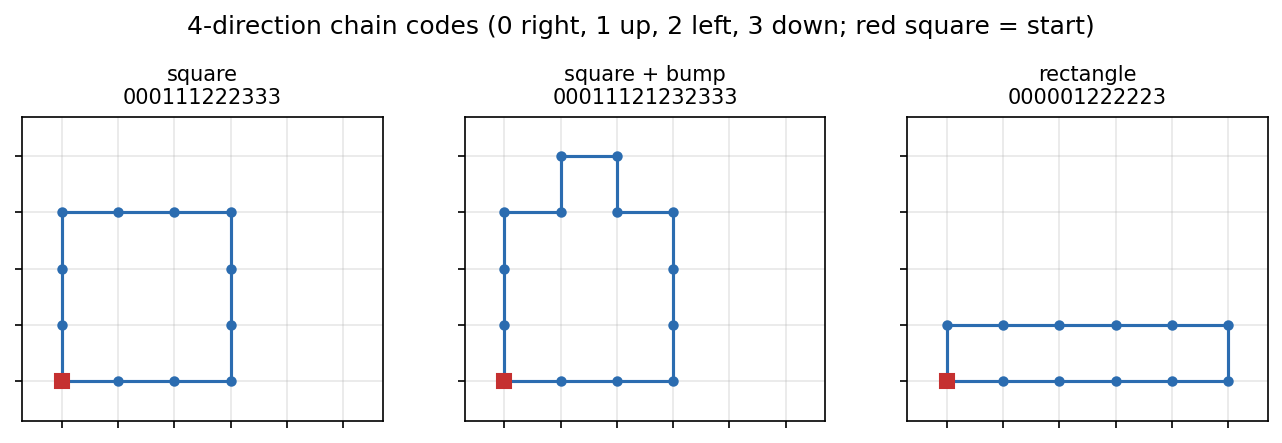
先選一小組基本元素(primitives)構成字母表,例如沿物件邊界走一步的四個方向。於是一個形狀就變成一個字串。4 方向鏈碼(chain code)在追蹤邊界時,向右一步寫 0、向上寫 1、向左寫 2、向下寫 3(參見 IP 12)。圖 3 顯示三個輪廓與它們的鏈碼。
在句法(syntactic)圖形識別中,每個類別由一套形式文法描述:一組改寫規則,恰好產生該類別所有合法的字串。辨識就是剖析:若某類別的文法能產生這個字串,字串就屬於該類別。例如規則 產生字串 ,這個「類別」中每段向右的步數都有等長的向左步數與之對應。文法可以表達遞迴結構(巢狀部件、重複的子形狀),這是固定長度特徵向量做不到的。它的弱點是:真實資料有雜訊,單一個錯誤的基本元素就會讓字串不合文法;而且文法很難從範例中學出來。為規則附上機率的隨機文法可以處理第一個問題;下文的隱藏式馬可夫模型就是最簡單的隨機文法 [1]。
編輯距離
一種更寬容的做法,是用「把一個字串變成另一個的最低成本」來比較字串。編輯距離(Levenshtein 距離)計算最少需要幾次插入、刪除與替換。Wagner 與 Fischer 給出了動態規劃解法 [7]:
其中 、,(長度 )與 (長度 )為兩個字串,答案是 。它的結構和 DTW 完全相同,只是把「拉長」換成「插入」、「刪除」與「替換」三種操作。成本可以加權,例如讓相鄰方向之間的替換比相反方向便宜。
程式碼 · Python · 22 行
import numpy as np

def edit_distance(s, t):
    """Levenshtein distance: unit-cost insertions, deletions, substitutions."""
    n, m = len(s), len(t)
    D = np.zeros((n + 1, m + 1), dtype=int)
    D[:, 0] = np.arange(n + 1)
    D[0, :] = np.arange(m + 1)
    for i in range(1, n + 1):
        for j in range(1, m + 1):
            sub = 0 if s[i - 1] == t[j - 1] else 1
            D[i, j] = min(D[i - 1, j] + 1,          # delete s[i-1]
                          D[i, j - 1] + 1,          # insert t[j-1]
                          D[i - 1, j - 1] + sub)    # match or substitute
    return D[n, m]

# 4-direction chain codes (0=right, 1=up, 2=left, 3=down) of three outlines
square = "000111222333"           # 3 x 3 square, traced counter-clockwise
square_bump = "00011121232333"   # the same square with a one-pixel bump on top
rectangle = "000001222223"       # a flat 5 x 1 rectangle
for name, code in [("square + bump", square_bump), ("rectangle", rectangle)]:
    print(f"edit distance(square, {name}) = {edit_distance(square, code)}")
有凸起的正方形和正方形相差 2 次編輯(插入一個「上」與一個「下」);扁平的長方形相差 4 次。以這個距離在字串上做最近鄰分類,就是 -NN 的結構式版本。鏈碼取決於起點與旋轉;把它們正規化(例如選擇使字串最小的起點,並改用相鄰方向之間的差)是表徵設計的一部分。
圖與圖匹配
當部件之間的連接不只是一條鏈時,圖形就成為一張帶屬性的圖:節點是部件(筆畫、區域、原子),帶有大小或顏色等屬性;邊是關係(相接、在上方、鍵結)。辨識於是成為圖匹配:找出兩張圖的節點之間的對應關係。精確匹配(圖同構或子圖同構)不容許任何差異,一般而言計算困難;容錯匹配,例如圖編輯距離,以節點與邊的插入、刪除、替換推廣字串編輯距離,計算代價更高。Conte、Foggia、Sansone 與 Vento 綜述了圖形識別中三十年的圖匹配研究,從精確演算法到不精確演算法及其應用 [8];Foggia、Percannella 與 Vento 則以十年間的圖匹配與圖學習方法更新了這幅圖像 [9]。
圖模型描述相依關係
白話版。 圖模型是一張「哪些變數直接影響哪些變數」的圖。這張圖告訴你龐大的聯合機率如何拆成小的局部片段,而小片段正是讓計算變得可行的關鍵。
有向無環圖(貝氏網路)把變數 的聯合分布分解為
其中 是 在圖中的父節點 [2]。無向圖(馬可夫隨機場)在它的團(clique,即兩兩相連的節點子集) 上使用非負的位能函數 :
位能是相容程度的分數,不一定是機率。配分函數 把乘積正規化;它對所有聯合組態求和,往往是最難計算的量。
條件獨立要依圖的規則判讀(有向圖用 d-分離,無向圖用圖分離),不能只看哪裡沒有箭頭。一個經典的意外是:兩個獨立的原因,在以它們共同的結果為條件後就會變得相依(「解釋消除」,explaining away)[2]。因子圖把變數與因子畫成兩種節點,讓局部的訊息傳遞變得明確;在樹上,訊息傳遞(sum-product 演算法)能精確算出所有邊際分布,而下文的 HMM 演算法就是它在鏈上的特例 [2]。
在影像標記中,一種常見的無向模型是由一元資料項與成對平滑項組成的能量:
其中 是像素 的標籤, 是在影像 下該標籤的成本(例如像素分類器輸出的負對數機率), 是相鄰像素對的集合, 是相鄰像素標籤改變的代價(Potts 模型)。對應的分布是 。它鼓勵相鄰標籤一致,能清除雜訊,但 太大時也會抹掉細長的結構。在一般的格點上精確最小化很困難,近似推論見 PR 08。
隱藏式馬可夫模型
白話版。 一個系統在幾個隱藏狀態之間移動(靜音、母音、子音;走路、跑步),每個時間步發出一個只取決於當下狀態的觀測。你看得到觀測,卻永遠看不到狀態。HMM 讓你能計算一串觀測有多可能、它大概是由哪些隱藏狀態產生的,以及如何從資料中學出模型的機率。
模型
有 個隱藏狀態的 HMM,包含初始機率 、轉移矩陣 ,以及發射機率(或密度)。狀態序列 與觀測 的聯合機率為
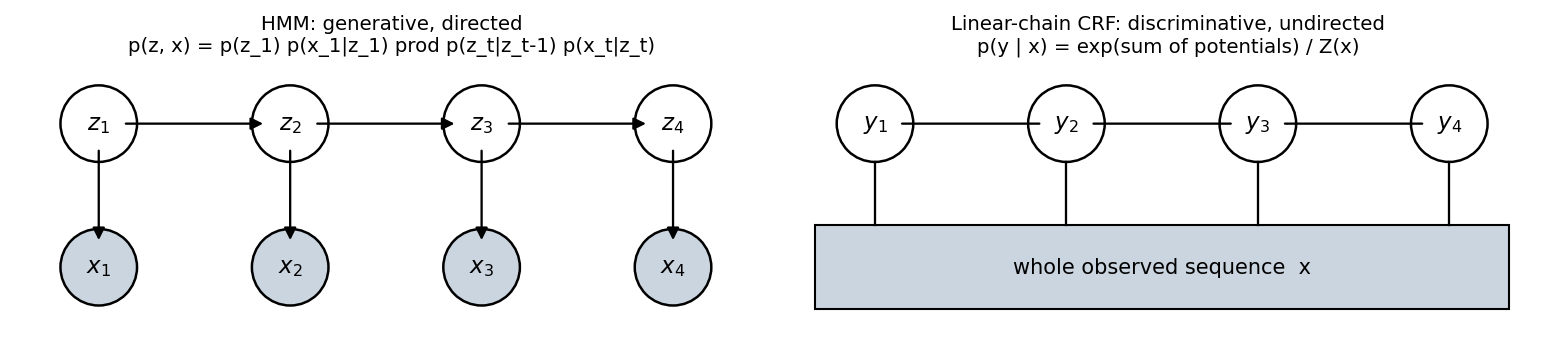
其中內建了兩個假設:隱藏狀態是一階馬可夫的(未來只透過當下狀態依賴過去),且每個觀測只取決於當下狀態。觀測本身不是馬可夫的:把隱藏狀態積分掉後,觀測之間會出現長程相依。Rabiner 的教學文章至今仍是標準入門,它把 HMM 的計算整理成三個問題 [10]:評估(計算 )、解碼(找出隱藏狀態)與學習(估計 )。圖 4 對照 HMM 的有向圖與稍後討論的 CRF。
評估:前向演算法
對全部 條狀態序列加總聯合機率,在實際的 下毫無可能。定義前向變數 。由於 總結了過去能告訴未來的一切,它滿足
且 。成本是 ,而不是 。由於 是許多機率的乘積,長序列會造成數值下溢。標準解法是每一步都正規化:記錄 與 ,其中 是未正規化的更新值。這時 恰好就是濾波狀態機率,,而且
評估直接給出一個分類器:每個類別訓練一個 HMM(例如每個口說詞一個),新序列就歸給「其 HMM 概似乘以先驗」最高的類別。
平滑:前向–後向演算法
濾波只用過去與現在計算 ,這是線上系統在時間 所能知道的一切。平滑計算 ,連之後的觀測也一起使用。後向遞迴 ,
和前向變數結合,得到 [2], [10]。加入尺度化時,每個後向步驟除以 ,於是 (逐元素乘積)恰好成立。
解碼:Viterbi 演算法
我們常常想要的是機率最高的單一狀態序列 。Viterbi 演算法 [11] 把前向遞迴中的加總換成取最大值。在對數空間中,
其中 是在時間 結束於狀態 的最佳路徑的對數機率。記錄使其最大的前一個狀態 ,選出最佳的最終狀態,再沿指標往回追溯。成本同樣是 。
機率最高的路徑,不等於在每個時間點各自挑選平滑機率 最高的狀態。逐步挑選最大化的是「預期正確的狀態數」,但可能把模型認定不能相連的狀態串在一起。下面的程式在一個狀態必須依 循環的模型上展示這一點,其中轉移 的機率為零。
程式碼 · Python · 57 行
import itertools
import numpy as np

pi = np.array([1 / 3, 1 / 3, 1 / 3])            # initial state probabilities
A = np.array([[0.5, 0.5, 0.0],                  # cyclic model: 0 -> 1 -> 2 -> 0
              [0.0, 0.5, 0.5],
              [0.5, 0.0, 0.5]])
B = np.array([[0.7, 0.3],                       # P(symbol | state)
              [0.5, 0.5],
              [0.3, 0.7]])
obs = np.array([1, 0, 1, 0, 0])
T, K = len(obs), len(pi)

# Forward pass with scaling: alpha[t] = p(z_t | x_1..t), c[t] = p(x_t | x_1..t-1).
alpha, c = np.zeros((T, K)), np.zeros(T)
alpha[0] = pi * B[:, obs[0]]
c[0] = alpha[0].sum(); alpha[0] /= c[0]
for t in range(1, T):
    alpha[t] = B[:, obs[t]] * (alpha[t - 1] @ A)
    c[t] = alpha[t].sum(); alpha[t] /= c[t]
log_lik = np.log(c).sum()

# Backward pass (scaled) and smoothed marginals gamma[t] = p(z_t | x_1..T).
beta = np.ones((T, K))
for t in range(T - 2, -1, -1):
    beta[t] = A @ (B[:, obs[t + 1]] * beta[t + 1]) / c[t + 1]
gamma = alpha * beta

# Viterbi in log space (log 0 = -inf marks forbidden transitions).
with np.errstate(divide="ignore"):
    lA, lB, lpi = np.log(A), np.log(B), np.log(pi)
delta = lpi + lB[:, obs[0]]
back = []
for t in range(1, T):
    cand = delta[:, None] + lA
    back.append(cand.argmax(axis=0))
    delta = cand.max(axis=0) + lB[:, obs[t]]
path = [int(delta.argmax())]
for b in reversed(back):
    path.append(int(b[path[-1]]))
path = path[::-1]

# Brute force over all K**T paths as an independent check.
def joint(z):
    p = pi[z[0]] * B[z[0], obs[0]]
    for t in range(1, T):
        p *= A[z[t - 1], z[t]] * B[z[t], obs[t]]
    return p
paths = list(itertools.product(range(K), repeat=T))
assert np.isclose(log_lik, np.log(sum(joint(z) for z in paths)))
assert tuple(path) == max(paths, key=joint)

marginal = gamma.argmax(axis=1)
print("log p(x):", round(log_lik, 4))
print("Viterbi path:         ", path, " p =", round(joint(path), 5))
print("per-step argmax gamma:", marginal.tolist(),
      " p =", round(joint(marginal), 5))
尺度化的前向計算給出 ,而概似與 Viterbi 路徑都和全部 條路徑的暴力列舉一致。Viterbi 回傳 ,聯合機率為 0.00179。逐步挑選機率最高的狀態得到 ,其中包含被禁止的跳躍 ,在模型下的機率恰好為零。哪一種解碼才對取決於損失:逐步準確率偏好邊際分布;要得到合法、一致的序列則需要 Viterbi。
圖 5 在一條較長的模擬序列上展示同樣的計算:濾波機率只對過去做出反應;平滑機率使用整條序列,因而更有把握;Viterbi 路徑除了觀測有歧義的地方之外,都跟得上真實狀態。
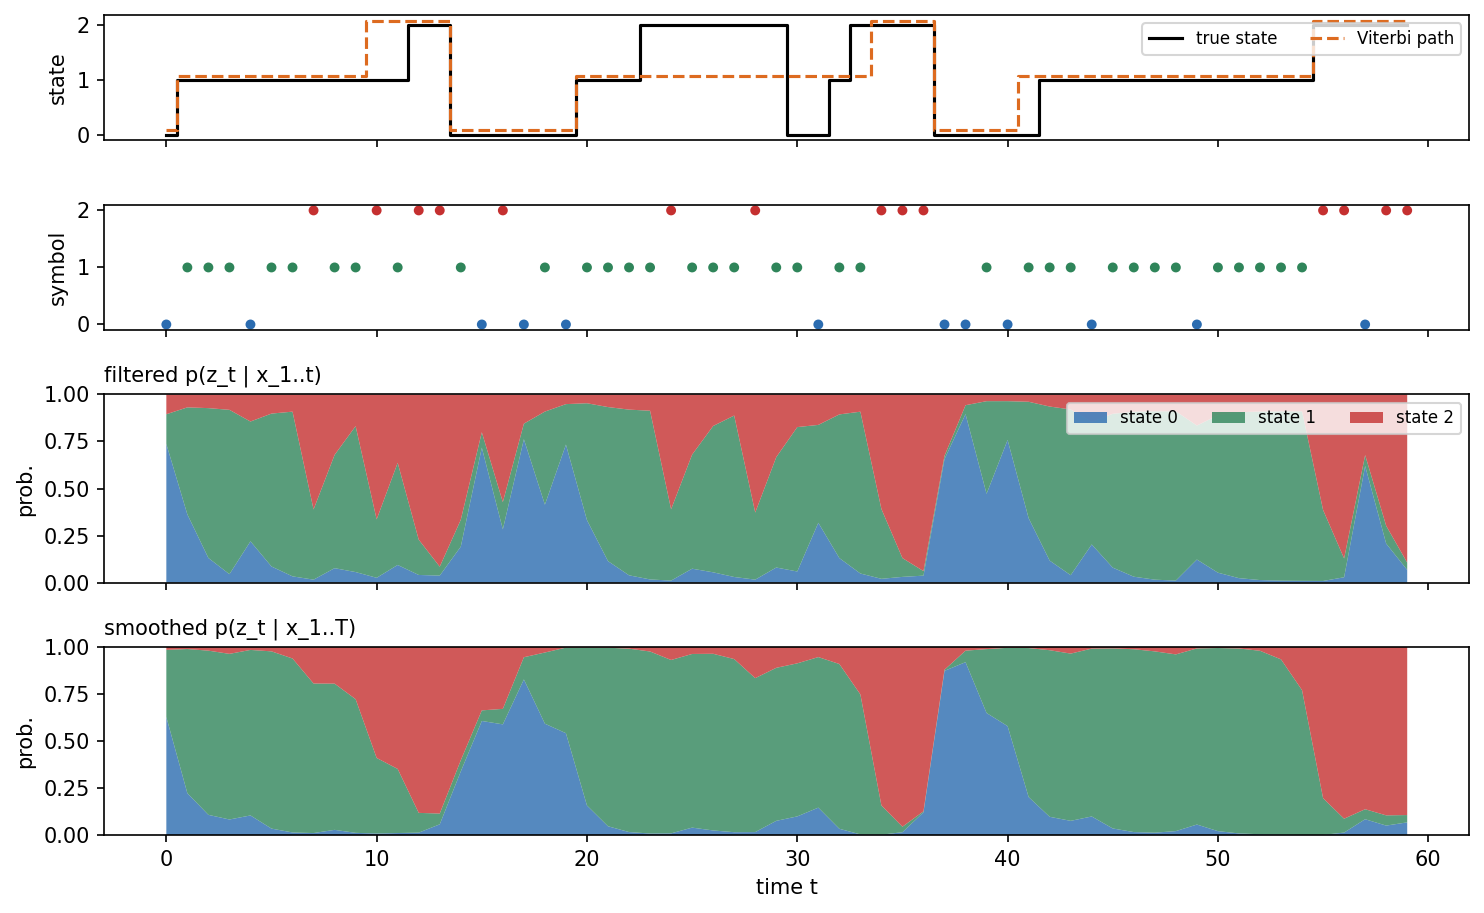
關於評估的提醒。 如果系統必須線上做決策,請回報濾波(或固定延遲)下的表現。平滑結果用到了決策當下尚不存在的觀測,會高估部署後系統的能力。
學習:Baum–Welch
當隱藏狀態沒有標註時,參數以期望值最大化(EM)估計,在 HMM 中稱為 Baum–Welch 演算法 [12]。E 步驟執行前向–後向,得到預期的狀態佔用 與預期的轉移 。M 步驟重新估計
並以 加權的觀測估計發射參數(例如高斯發射的加權平均與共變異數)。每次迭代都不會降低概似,但結果取決於初始化,可能停在局部極大值;PR 07 介紹一般形式的 EM。如果隱藏狀態是連續的,而且一切都是線性高斯,同樣的前向遞迴就成為 Kalman 濾波器 [13]。以學習得到的向量取代離散狀態的神經遞迴模型,見 ML 04。
條件隨機場
白話版。 HMM 建模的是狀態如何產生觀測,這迫使它對觀測做簡單的假設。如果你只需要「給定觀測下的標籤」,CRF 就直接建模這件事,而且可以使用整個輸入的任何特徵,不論彼此是否重疊。
HMM 是生成式的:它建模 ,包括觀測如何產生。這要求發射模型 完整描述 ;當特徵很多、彼此重疊又相依時(字詞本身、它的字尾、大小寫、相鄰的字詞……),這就很彆扭。Lafferty、McCallum 與 Pereira 提出條件隨機場,直接建模給定觀測 時標籤序列 的條件分布 [14]。線性鏈 CRF 為
其中 是特徵函數,可以看當前與前一個標籤,以及輸入序列的任何部分; 是學習得到的權重; 針對這一個輸入,對所有標籤序列 做正規化 [14], [15]。把 HMM 寫成這種形式,它就是特例:特徵只有「前一個標籤、當前標籤」與「當前標籤、當前觀測」兩類指示函數。CRF 可以加入任意的輸入特徵,而不必建模它們的分布。
推論使用和 HMM 相同的動態規劃:前向演算法(以 log-sum-exp 取代加總)計算 與邊際分布,Viterbi 找出最佳標記。訓練時最大化條件對數概似 ,通常加上 懲罰。對線性鏈 CRF 而言,這個目標是凹函數,因此沒有不好的局部最佳解;它的梯度是「觀測到的特徵計數減去預期的特徵計數」,預期值由前向–後向算出 [15]。下面的程式以暴力法檢查 的前向計算。
程式碼 · Python · 22 行
import itertools
import numpy as np

rng = np.random.default_rng(0)
T, K = 5, 3
U = rng.normal(size=(T, K))       # unary scores  theta . f(y_t, x, t)
P = rng.normal(size=(K, K))       # transition scores  theta . f(y_{t-1}, y_t)

def score(y):
    return U[np.arange(T), y].sum() + sum(P[y[t - 1], y[t]] for t in range(1, T))

# log Z by the forward recursion in log space (log-sum-exp instead of sum).
log_alpha = U[0].copy()
for t in range(1, T):
    m = log_alpha[:, None] + P
    log_alpha = U[t] + np.logaddexp.reduce(m, axis=0)
log_Z = np.logaddexp.reduce(log_alpha)

brute = np.logaddexp.reduce([score(np.array(y))
                             for y in itertools.product(range(K), repeat=T)])
print("log Z forward:", round(log_Z, 6), " brute force:", round(brute, 6))
assert np.isclose(log_Z, brute)
兩者都得到 。這裡的分數是代替 的隨機數;在真正的 CRF 中,它們來自 的特徵,在現代系統中則來自神經網路。
在影像上,同樣的想法得到像素上的格狀 CRF:一元項來自像素分類器,成對項類似上面的 Potts 能量。在有迴圈的格點上已無法做精確推論,因此使用近似方法(PR 08)。
現代觀點
模板、對齊、文法與馬可夫鏈,在深度網路旁邊看起來有點過時。事實上它們都延續了下來,有時就藏在網路內部。以下是綜述文獻與近期研究中的主要脈絡。
模板比對。 Hashemi 等人 [4] 回顧了比對的基本概念、不變特徵與可變形模型等進展,以及包括醫學影像分析在內的應用。他們的結論是:模板比對與其他辨識步驟結合時效果最好,例如在 NCC 之後接一個穩健的決策階段。當外觀受控時,以相關為基礎的比對快速、簡單又精確,至今仍是工業檢測、影像對位的標準做法,也是追蹤器的基本組件。當外觀會變化時,比對就轉移到學習得到的特徵空間:「模板」現在是一張特徵圖,相關運算在深度特徵之間進行,但運算本身是一樣的。
時間序列分類與 DTW。 Bagnall 等人的「bake off」[16] 在同一個框架中重新實作了 18 個時間序列分類演算法,並在 85 個 UCR 資料集上各做 100 次重抽樣比較。只有九個演算法顯著優於兩個基準(其中之一是 DTW 的 1-NN),而一個由轉換式集成組成的方法(COTE)勝過其他所有方法。Middlehurst、Schäfer 與 Bagnall 的「bake off redux」[17] 在擴充為 112 個資料集的資料庫與 30 個新問題上重做這項比較,在分類體系中加入以卷積、以特徵與深度學習為基礎的類別,並發現兩個較新的演算法 MultiROCKET+Hydra 與 HIVE-COTE 2 顯著優於其餘方法。Ismail Fawaz 等人 [18] 以統一的分類體系回顧了時間序列分類中的深度學習,並在同一個開放框架中於 97 個資料集上訓練了 8,730 個網路。與此同時,DTW 本身成為一個基本組件:soft-DTW [19] 把 DTW 遞迴中的最小值換成平滑的 soft-minimum,使它可微分,因此能作為訓練網路的損失,也能用來平均時間序列。
神經網路內部的對齊。 連結時序分類(connectionist temporal classification, CTC)[20] 讓遞迴網路在沒有逐幀對齊的情況下輸出標籤序列,方法是以一個和 HMM 密切相關的前向–後向遞迴,對所有對齊方式加總。動態規劃留了下來,發射模型則變成了網路。
選讀:連結時序分類(CTC)(見「補充資料」頁)。對齊加總的遞迴、損失、解碼,以及它的假設何時失效。
結合深度特徵的 CRF。 Sutton 與 McCallum 的教學 [15] 至今仍是 CRF 建模、推論與訓練的標準參考。在視覺領域,具高斯邊位能的全連接 CRF 讓所有像素對上的平均場推論變得有效率 [21],並成為語意分割常用的精修步驟;Zheng 等人接著把這個平均場推論寫成一個遞迴網路層,和 CNN 一起端到端訓練 [22]。在語言領域,Lample 等人的 BiLSTM-CRF [23] 在雙向 LSTM 上加了一層 CRF 輸出,用於命名實體辨識,讓標籤轉移被明確建模,而特徵則由學習得到。在這兩個領域,後來具有大感受野或注意力機制的架構往往已建模足夠的脈絡,使明確的 CRF 幫助有限;但在標籤約束很重要的場合,結構化輸出層仍在使用。
結構與圖。 Conte 等人 [8] 與 Foggia 等人 [9] 的圖匹配綜述,描繪了從精確與容錯匹配,走向圖核、圖嵌入與以學習為基礎之方法的轉變。它們的現代後代,圖神經網路,以訊息傳遞學習節點與整張圖的表徵,正是因子圖局部計算的直接推廣。
狀態空間模型。 「一個精簡的隱藏狀態總結了過去」這個概念,是 HMM 與 Kalman 濾波器 [13] 的核心,如今在序列建模中再度成為焦點。Mamba [24] 這類選擇性狀態空間模型使用與輸入相關的線性遞迴,執行時間與序列長度成線性關係,被提出作為長序列上注意力機制的替代方案。
未解問題。 DTW 與編輯距離每次比較都是平方成本,所以在大型資料集中搜尋必須依靠界限與剪枝 [6]。圖編輯距離的精確計算仍然昂貴。HMM 與 CRF 的結果取決於圖中內建的獨立性假設;當假設錯誤時,平滑可能很有自信地抹掉短暫事件。而對任何線上系統來說,濾波與平滑評估之間的區別都很容易弄錯。
重點整理
- NCC 減去平均並除以範數,因此對亮度偏移與正的對比變化不變;SSD 與單純的相關則否。兩者都無法處理旋轉、尺度或形變。
- DTW 以動態規劃在 內找出成本最低的單調對齊;Sakoe–Chiba 帶限制病態扭曲並降低成本,但必須比真實的時間差更寬。
- 結構式辨識把圖形描述為字串、文法或圖;編輯距離以和 DTW 相同的動態規劃模式比較字串。
- 圖模型把聯合分布分解成局部片段;在鏈與樹上的訊息傳遞既精確又有效率。
- HMM 演算法:前向( 與濾波)、前向–後向(平滑)、Viterbi(最佳路徑)、Baum–Welch(學習),成本都是 。以尺度化或對數運算避免下溢。
- Viterbi 路徑與逐步最可能狀態回答的是不同的問題;後者可能是不可能出現的序列。
- CRF 直接建模 ,可使用任意重疊的輸入特徵,與 HMM 共用推論演算法,而在線性鏈情況下訓練目標是凹函數。
練習
- NCC 與負片。 證明把區塊的每個像素換成 ()時 NCC 不變。 時會怎樣?為什麼 NCC 無法告訴你 的值?
提示
減去平均會完全消除 ,所以關於它的資訊一點都不剩。因子 出現在分子,並以 出現在分母; 時互相抵消, 時正負號翻轉(完美匹配的負片得分為 )。
- 手算 DTW。 以成本 計算 與 的 DTW 距離。寫出 的表格與最佳路徑。逐點距離是多少?為什麼在這裡它根本沒有定義?
提示
最佳路徑把 同時對應到兩個 0,接著 、,總成本為 0。逐點比較需要等長,而這兩條序列不等長;DTW 自然地處理不等長的情況。
- 被禁止的轉移。 自己構造一個兩狀態或三狀態的 HMM,把其中一個轉移機率設為零,並找出一串觀測,使 的逐步 argmax 成為不可能的狀態序列。用上面的程式驗證。
提示
你需要兩個相鄰時間步,它們各自最可能的狀態之間恰好是被禁止的轉移。發射機率接近 0.5(有歧義)的對稱或循環模型很容易做到;接著檢查 joint(marginal) 是否為 0。
- 線上與離線。 某活動辨識器以錄好的序列、根據平滑狀態機率回報 95% 的準確率。它將在手機上執行,每秒都必須做決定。這個數字包含了什麼資訊上的優勢?你應該改為回報什麼?
提示
平滑用到了每次決策之後的觀測。應回報濾波準確率,或應用可以容忍之延遲下的固定延遲平滑結果(例如延遲 2 秒的決策可以使用到 為止的觀測)。
- 從 HMM 到 CRF。 把 HMM 的 寫成特徵函數乘以權重的總和,即線性鏈 CRF 的形式。你得到哪些特徵與權重?在詞性標記中,CRF 可以加入哪些 HMM 難以使用的額外特徵?
提示
使用指示特徵 ,權重為 ;,權重為 ;以及 ,權重為 。CRF 可以加入「下一個字以 -ly 結尾」或「當前的字首字母大寫」這類特徵,它們和字詞本身重疊且相依。
- 加權編輯距離。 修改
edit_distance,使相差 90 度的兩個方向替換成本為 1、相差 180 度為 2。重新計算鏈碼範例中的距離。排名會改變嗎?
提示
替換成本是方向碼之間的循環差 。有凸起的正方形只需要插入,所以距離仍是 2;請檢查長方形最便宜的編輯序列用到了哪些替換,以判斷它的距離是否改變。
參考文獻
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2009, Chapters 8 and 9. publisher page
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006, Sections 8.1–8.4 and 13.1–13.3. official book page and PDF
- J. P. Lewis, “Fast Normalized Cross-Correlation,” Vision Interface, 1995. paper
- N. S. Hashemi, R. B. Aghdam, A. S. B. Ghiasi, and P. Fatemi, “Template Matching Advances and Applications in Image Analysis,” arXiv:1610.07231, 2016. arXiv
- H. Sakoe and S. Chiba, “Dynamic Programming Algorithm Optimization for Spoken Word Recognition,” IEEE Transactions on Acoustics, Speech, and Signal Processing, vol. 26, no. 1, pp. 43–49, 1978. doi:10.1109/TASSP.1978.1163055
- T. Rakthanmanon, B. Campana, A. Mueen, G. Batista, B. Westover, Q. Zhu, J. Zakaria, and E. Keogh, “Searching and Mining Trillions of Time Series Subsequences under Dynamic Time Warping,” Proceedings of the 18th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, pp. 262–270, 2012. doi:10.1145/2339530.2339576
- R. A. Wagner and M. J. Fischer, “The String-to-String Correction Problem,” Journal of the ACM, vol. 21, no. 1, pp. 168–173, 1974. doi:10.1145/321796.321811
- D. Conte, P. Foggia, C. Sansone, and M. Vento, “Thirty Years of Graph Matching in Pattern Recognition,” International Journal of Pattern Recognition and Artificial Intelligence, vol. 18, no. 3, pp. 265–298, 2004. doi:10.1142/S0218001404003228
- P. Foggia, G. Percannella, and M. Vento, “Graph Matching and Learning in Pattern Recognition in the Last 10 Years,” International Journal of Pattern Recognition and Artificial Intelligence, vol. 28, no. 1, 1450001, 2014. doi:10.1142/S0218001414500013
- L. R. Rabiner, “A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition,” Proceedings of the IEEE, vol. 77, no. 2, pp. 257–286, 1989. doi:10.1109/5.18626
- A. J. Viterbi, “Error Bounds for Convolutional Codes and an Asymptotically Optimum Decoding Algorithm,” IEEE Transactions on Information Theory, vol. 13, no. 2, pp. 260–269, 1967. doi:10.1109/TIT.1967.1054010
- L. E. Baum, T. Petrie, G. Soules, and N. Weiss, “A Maximization Technique Occurring in the Statistical Analysis of Probabilistic Functions of Markov Chains,” The Annals of Mathematical Statistics, vol. 41, no. 1, pp. 164–171, 1970. doi:10.1214/aoms/1177697196
- R. E. Kalman, “A New Approach to Linear Filtering and Prediction Problems,” Journal of Basic Engineering, vol. 82, no. 1, pp. 35–45, 1960. doi:10.1115/1.3662552
- J. D. Lafferty, A. McCallum, and F. C. N. Pereira, “Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data,” Proceedings of the 18th International Conference on Machine Learning (ICML), pp. 282–289, 2001. paper page
- C. Sutton and A. McCallum, “An Introduction to Conditional Random Fields,” Foundations and Trends in Machine Learning, vol. 4, no. 4, pp. 267–373, 2012. doi:10.1561/2200000013
- A. Bagnall, J. Lines, A. Bostrom, J. Large, and E. Keogh, “The Great Time Series Classification Bake Off: A Review and Experimental Evaluation of Recent Algorithmic Advances,” Data Mining and Knowledge Discovery, vol. 31, pp. 606–660, 2017. doi:10.1007/s10618-016-0483-9
- M. Middlehurst, P. Schäfer, and A. Bagnall, “Bake Off Redux: A Review and Experimental Evaluation of Recent Time Series Classification Algorithms,” Data Mining and Knowledge Discovery, vol. 38, pp. 1958–2031, 2024. doi:10.1007/s10618-024-01022-1
- H. Ismail Fawaz, G. Forestier, J. Weber, L. Idoumghar, and P.-A. Muller, “Deep Learning for Time Series Classification: A Review,” Data Mining and Knowledge Discovery, vol. 33, pp. 917–963, 2019. doi:10.1007/s10618-019-00619-1
- M. Cuturi and M. Blondel, “Soft-DTW: A Differentiable Loss Function for Time-Series,” ICML, 2017. arXiv:1703.01541
- A. Graves, S. Fernández, F. Gomez, and J. Schmidhuber, “Connectionist Temporal Classification: Labelling Unsegmented Sequence Data with Recurrent Neural Networks,” Proceedings of the 23rd International Conference on Machine Learning (ICML), pp. 369–376, 2006. doi:10.1145/1143844.1143891
- P. Krähenbühl and V. Koltun, “Efficient Inference in Fully Connected CRFs with Gaussian Edge Potentials,” NIPS, 2011. arXiv:1210.5644
- S. Zheng, S. Jayasumana, B. Romera-Paredes, V. Vineet, Z. Su, D. Du, C. Huang, and P. H. S. Torr, “Conditional Random Fields as Recurrent Neural Networks,” ICCV, 2015. arXiv:1502.03240
- G. Lample, M. Ballesteros, S. Subramanian, K. Kawakami, and C. Dyer, “Neural Architectures for Named Entity Recognition,” NAACL, 2016. arXiv:1603.01360
- A. Gu and T. Dao, “Mamba: Linear-Time Sequence Modeling with Selective State Spaces,” arXiv:2312.00752, 2023. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 07・分群、混合模型與 EM · 24 分鐘