PR 02・密度估計與貝氏學習
先備知識:PR 01・模式、機率與貝氏決策、ML 01A・學習所需的線性代數
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 為什麼貝氏分類器需要密度估計,以及參數式與非參數式估計的差別。
- 如何推導高斯分布的最大似然(ML)估計、為何樣本少時共變異數會奇異,以及收縮(shrinkage)如何解決。
- MAP 與完整貝氏估計如何使用參數的先驗,並以高斯平均值與 Bernoulli 比率實際推導。
- 直方圖、Parzen 窗(核密度估計)與 近鄰估計如何由同一條公式推出,以及如何選擇頻寬或 。
- -NN 分類器如何從 -NN 密度估計推得、Cover–Hart 上界說了什麼,以及為何所有局部方法都受維度詛咒所苦。
先看全貌
PR 01 說明了最佳分類器需要類別先驗 與類別條件密度 。實務上沒有人會把這些分布交給我們;我們只有一組有限的標註樣本。本章談的是如何把樣本變成密度。有了 與 ,就能代入貝氏規則。這是分類的生成式(generative)路線。下一章則走判別式(discriminative)路線,直接擬合決策邊界。
- 參數式(parametric)方法假設一種函數形式(例如高斯),並估計固定數量的參數。形式正確時需要的資料很少,形式錯誤時則會系統性地出錯。
- 非參數式(non-parametric)方法讓資料決定形狀,複雜度隨樣本數增加。它們很有彈性,但需要多得多的資料,在高維時尤其如此。
兩類方法都面對同一個核心問題:手上的資料能支撐多少結構?一個有彈性的估計器可以把訓練資料描述得很漂亮,卻依然對新資料預測得很差。下面每個方法都有一個「平滑旋鈕」(參數數量、先驗、組距、頻寬、),把它調好比選對方法更重要。
最大似然估計
白話版。 選擇讓觀測到的資料出現機率最高的參數值。
精確版。 令 為從密度 獨立抽出的樣本,參數向量 未知。 的似然是 ,ML 估計最大化它的對數:
獨立性假設談的是抽樣(不同觀測互不影響),而不是同一個特徵向量內各座標彼此獨立。做分類器時,我們為每個類別各擬合一個模型,只用該類別的樣本,並以類別頻率 估計先驗。
高斯情形
維高斯 的對數似然為
令對 的梯度為零,得到 。對 微分(利用 與 ),得到估計值
樣本平均是不偏的。ML 共變異數則略有偏差:,因為 是用同一批資料擬合的,比真實平均更貼近這些資料。常見的樣本共變異數除以 來消除這個偏差。 很大時,兩者差異可以忽略。
ML 失效之時:參數太多
完整共變異數有 個獨立元素。 個特徵時,每個類別就是 個數字,平均值還要再加 個。更糟的是, 是以 為中心的 個秩一矩陣之和,所以秩最多為 。當一個類別的樣本數不超過維度時,它的 ML 共變異數是奇異的:某些方向上變異數為零,,PR 01 的高斯判別函數無法定義。即使 只比 稍大,最小的特徵值也會被系統性低估,而反矩陣 會大幅放大這些方向上的雜訊。
正則化把共變異數往較簡單的目標收縮:
其中 是平均變異數相同的球形矩陣, 是收縮強度。收縮把大的特徵值往下拉、小的往上推,用一點偏差換來條件數好得多的估計。Ledoit 與 Wolf [14] 推導出使期望平方誤差最小的 的封閉式估計,因此不需要交叉驗證。其他常見的限制有對角共變異數(忽略相關;即下文的高斯樸素貝氏),以及各類別共用共變異數(匯集證據;即 PR 01 的 LDA)。這些是不同的建模假設,不是可以互換的數值技巧。
程式碼:ML 共變異數何時失效
程式碼 · Python · 21 行
import numpy as np
from scipy.stats import multivariate_normal
from sklearn.covariance import EmpiricalCovariance, LedoitWolf

rng = np.random.default_rng(0)
d = 40
A = rng.normal(size=(d, d))
true_cov = A @ A.T / d + 0.5 * np.eye(d)          # a well-conditioned truth
test = rng.multivariate_normal(np.zeros(d), true_cov, 2000)

for n in [30, 60, 200, 1000]:
    train = rng.multivariate_normal(np.zeros(d), true_cov, n)
    mu = train.mean(0)
    S_ml = EmpiricalCovariance().fit(train).covariance_   # divisor n
    S_lw = LedoitWolf().fit(train)
    rank = np.linalg.matrix_rank(S_ml)
    ll_ml = (multivariate_normal(mu, S_ml, allow_singular=True).logpdf(test).mean()
             if rank == d else -np.inf)
    ll_lw = multivariate_normal(mu, S_lw.covariance_).logpdf(test).mean()
    print(f"n={n:4d}: rank(S_ML)={rank:2d}, test log-lik ML={ll_ml:8.2f}, "
f"Ledoit-Wolf={ll_lw:8.2f} (shrinkage {S_lw.shrinkage_:.2f})")、 時,ML 共變異數的秩是 ,幾乎對每個測試點都給出零密度(對數似然 )。 時它可逆但很差(測試對數似然 ,Ledoit–Wolf 為 )。自動選出的收縮強度隨 增加從 降到 , 時兩種估計幾乎重合。經驗法則:每個參數分到的樣本越少,就該收縮得越多。
MAP 與貝氏估計
白話版。 最大似然完全相信資料。貝氏估計則從對參數的先驗信念出發,讓資料逐步推翻它。資料少時先驗很重要;資料多時幾乎無關緊要。
精確版。 把 視為隨機變數,給它參數先驗 。貝氏定理給出參數後驗
參數先驗與 PR 01 的類別先驗不同。類別先驗說的是某個類別有多常見;參數先驗說的是在看到這份訓練集之前,哪些模型設定是合理的。後驗常見的用法有三種:
- MAP 估計只保留眾數:。對數先驗扮演正則項;權重上的高斯先驗正好是 (ridge)懲罰,PR 03 會用到。
- 完整貝氏預測對所有參數值做平均,而不是只挑一個:
這個後驗預測分布把參數的不確定性帶進預測。
- 代入式預測(plug-in)使用 ,其中 來自 ML 或 MAP。它忽略參數不確定性,因此資料稀少時會過度自信。
有一個細節:MAP 對重新參數化不具不變性。 上密度的眾數,不等於對應的 上密度眾數的平方根,因為變數變換時密度會多出 Jacobian 因子。ML 估計與完整後驗沒有這個問題。
實例:高斯的平均值
令 , 已知,並給未知平均值高斯先驗 。把似然與先驗相乘,對 配方後可知後驗仍是高斯,,其中 [1, 2]
是樣本平均。有兩種讀法能讓這條公式好記。精度相加:後驗精度 等於先驗精度加上 倍單一觀測的精度。平均值是精度加權平均:先驗平均與樣本平均依精度加權。當 ,(ML 估計)且 。因為後驗是高斯,眾數等於平均,所以這裡 。後驗預測分布為 :比代入式的 寬,多出的部分就是對 剩餘的不確定性。
後驗與先驗屬於同一分布族的先驗稱為共軛(conjugate)先驗。共軛配對(高斯–高斯、Beta–Bernoulli、Dirichlet–類別分布、平均與共變異數的 Normal–inverse-Wishart)都有封閉式更新;其他先驗則需要 PR 08 的近似推論方法。
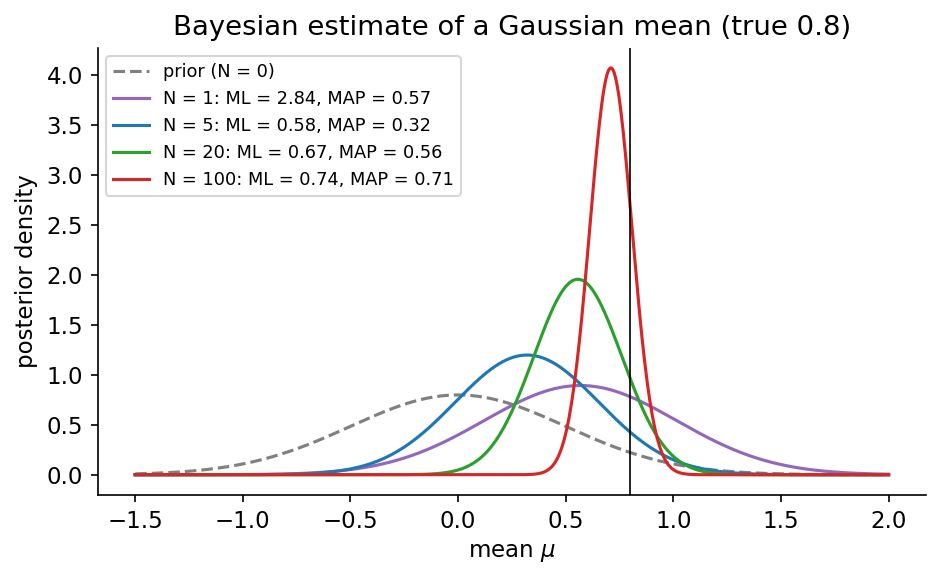
實例:Bernoulli 比率
對 Bernoulli 比率 (例如產線的缺陷率)給定先驗 ,在 次試驗中觀測到 次成功後,
先驗就像 次假想的成功與 次假想的失敗。一次成功、零次失敗時,ML 預測機率為一,這顯然荒謬。均勻先驗 預測 ,這就是 Laplace 的接續法則(rule of succession)。同樣的概念稱為加法平滑或 Laplace 平滑,它能避免樸素貝氏文字分類器只因某個字在訓練時從未與某類別一起出現,就給整份文件零機率。
程式碼:ML、MAP 與後驗預測
程式碼 · Python · 22 行
import numpy as np

rng = np.random.default_rng(3)
sigma = 1.0                 # known noise standard deviation
m0, s0 = 0.0, 0.5           # prior on the mean: N(m0, s0^2)
x = rng.normal(0.8, sigma, 5)
n = len(x)

mu_ml = x.mean()
post_var = 1 / (1 / s0**2 + n / sigma**2)
post_mean = post_var * (m0 / s0**2 + x.sum() / sigma**2)   # = MAP for a Gaussian
pred_var = sigma**2 + post_var                              # predictive variance

# brute-force check on a grid: posterior is proportional to likelihood x prior
grid = np.linspace(-3, 3, 200001)
log_post = (-0.5 * ((x[:, None] - grid) ** 2).sum(0) / sigma**2
            - 0.5 * (grid - m0) ** 2 / s0**2)
w = np.exp(log_post - log_post.max())
w /= w.sum()
print(f"ML {mu_ml:.3f} | MAP/posterior mean {post_mean:.3f} "
      f"(grid {np.sum(w * grid):.3f}) | posterior sd {np.sqrt(post_var):.3f}")
print(f"predictive sd {np.sqrt(pred_var):.3f} vs plug-in sd {sigma:.3f}")
五筆樣本時,ML 平均為 ,後驗平均為 (網格積分結果一致),後驗標準差為 。預測標準差 比代入值寬 :這裡不大,但資料越少或維度越高時會迅速變大。
由密度建立分類器
白話版。 為每個類別擬合一個密度,乘上類別頻率,選乘積最大的類別。每個密度怎麼建模,決定了分類器能學到什麼。
高斯代入式分類器。 估計 、 與 ,代入 PR 01 的高斯判別函數。各類別共變異數分開就是 QDA,共用(匯集)共變異數就是 LDA,邊界的幾何形狀與 PR 01 推導的一樣。計算時請用 Cholesky 分解或解線性方程組,不要顯式求反矩陣。
樸素貝氏。 假設特徵在給定類別下條件獨立:
每個類別只需要 個一維密度,而不是一個 維密度,因此很少的資料就能估計。它並不假設特徵在整體母體中獨立;它假設的是類別解釋了特徵之間所有的相依性。高斯樸素貝氏為每個座標在每個類別中各給一個一維高斯;當各類別的變異數不同時,邊界是二次的。當特徵高度相關(或重複)時,樸素貝氏會把同一份證據計算好幾次,所以即使決策仍算合理,後驗也會過度自信。
生成式與判別式。 Ng 與 Jordan [15] 比較了樸素貝氏與它的判別式對應方法邏輯斯迴歸。他們證明:在資料無限多的極限下,邏輯斯迴歸的錯誤率較低(或相等);但樸素貝氏以快得多的速度逼近它自己較高的漸近錯誤率,所需樣本數與維度呈對數關係,而非線性關係。所以樣本少時生成式模型常勝出,樣本多時判別式模型勝出。這是理解兩條路線取捨的好心智模型。
非參數估計:一條公式,三種估計器
白話版。 要估計某一點的密度,就看它周圍的一個小區域,數有多少樣本落在裡面。密度就是「個數除以(樣本總數乘上區域大小)」。你可以固定區域去數個數,也可以固定個數去擴大區域。
精確版。 樣本落在 周圍小區域 內的機率為 ,其中 是 的體積。若 個樣本中有 個落在裡面,,所以 [1, 2]
這裡藏了兩個近似,而且方向相反。 需要小區域(否則 是 的模糊平均:偏差)。 需要區域裡有很多樣本(否則計數充滿雜訊:變異數)。Duda、Hart 與 Stork [1] 證明:當 時,若區域縮小()而計數增加(),但增加速度比 慢(),估計就會收斂到 。有兩種滿足方式:
- 固定 、計數 :直方圖與 Parzen 窗(核密度估計);
- 固定 、量測 : 近鄰密度估計。
直方圖
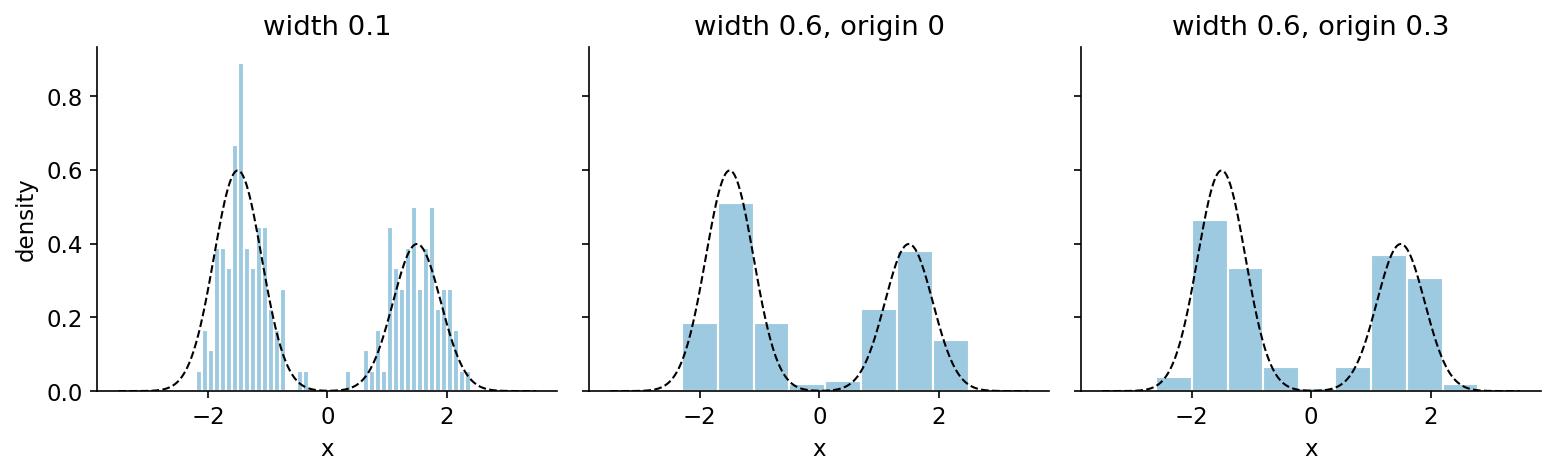
把軸切成寬 的組,對落在第 組(計數為 )的 ,令 。直方圖簡單又快,但有三個弱點,見圖 2。估計在組界處不連續。它除了組距之外還取決於網格的起點:把所有組平移 ,圖形就變了。而在 維中,組數以 成長,遠在 到達十之前,大部分的組就是空的。Scott 的分析 [8] 顯示,使平均積分平方誤差最小的組距只以 的速度縮小,所以更多資料只能慢慢換來更細的組。
Parzen 窗與核密度估計
Parzen 窗或核密度估計(kernel density estimate, KDE)由 Rosenblatt [5] 提出、Parzen [6] 加以分析,它不固定網格,而是在每個樣本上放一個窗:
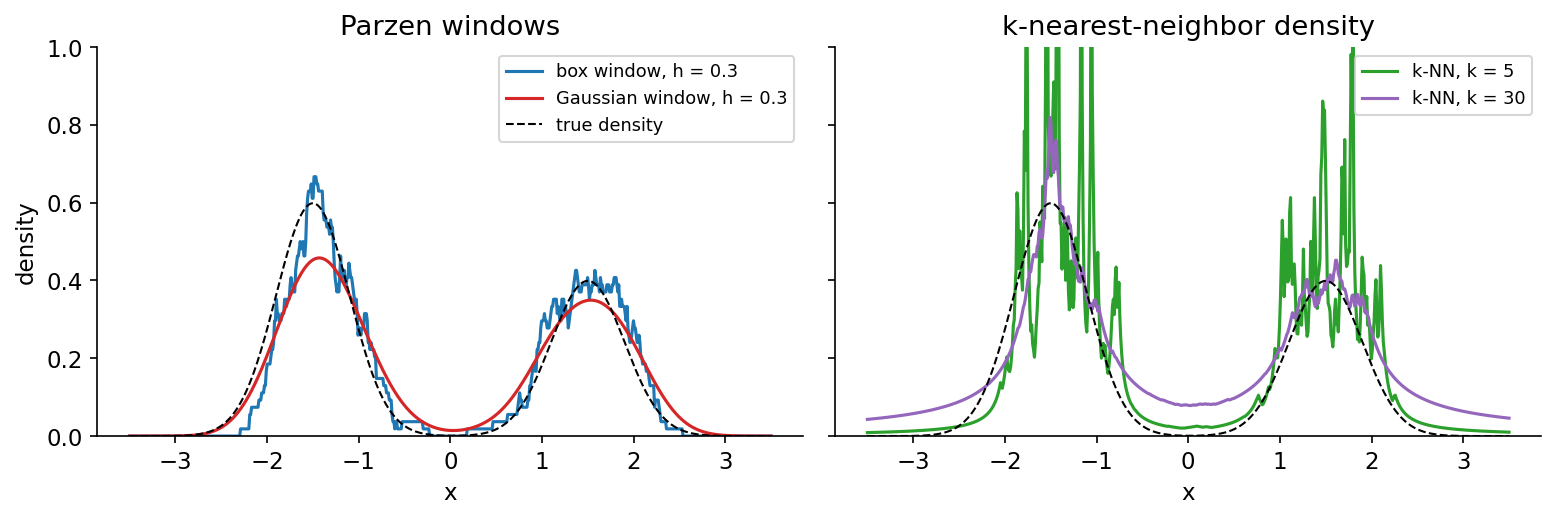
其中 是核,滿足 且 (所以 是合法的密度), 是頻寬(bandwidth),扮演組距的角色。用盒狀核(在單位立方體內 )時,這條公式字面上就是「數出 周圍邊長 的立方體內有幾個樣本」,也就是上面固定 的估計器。高斯核 把硬性計數換成平滑權重,得到平滑的估計(圖 3 左)。實務上,核的形狀遠不如頻寬重要。
偏差與變異數。 對一維的平滑密度,KDE 的偏差約隨 (乘上曲率 )成長,變異數約隨 成長。兩者之和最小時,最佳頻寬與 成正比,平均積分平方誤差以 下降,比形式正確的參數模型的 慢 [7, 8]。在 維中,最佳頻寬按 縮放,誤差按 縮放。隨 變慢,正是維度詛咒的一個面向。
選擇頻寬。 這是實務上最重要的決定。常見選項:
- 經驗法則。 Silverman 法則 [7],其中 是樣本標準差、IQR 是四分位距;資料為高斯時它是最佳的,對多峰資料則會過度平滑。
- 交叉驗證。 選擇讓保留樣本對數似然最大的 (似然交叉驗證),或讓積分平方誤差的不偏估計最小的 (最小平方交叉驗證,Scott 與 Terrell [9] 有分析)。
- 代入法。 Sheather 與 Jones [10] 從資料估計最佳頻寬公式中未知的曲率項並代入;他們的選擇器是一維情形下廣泛使用、可靠的預設值。
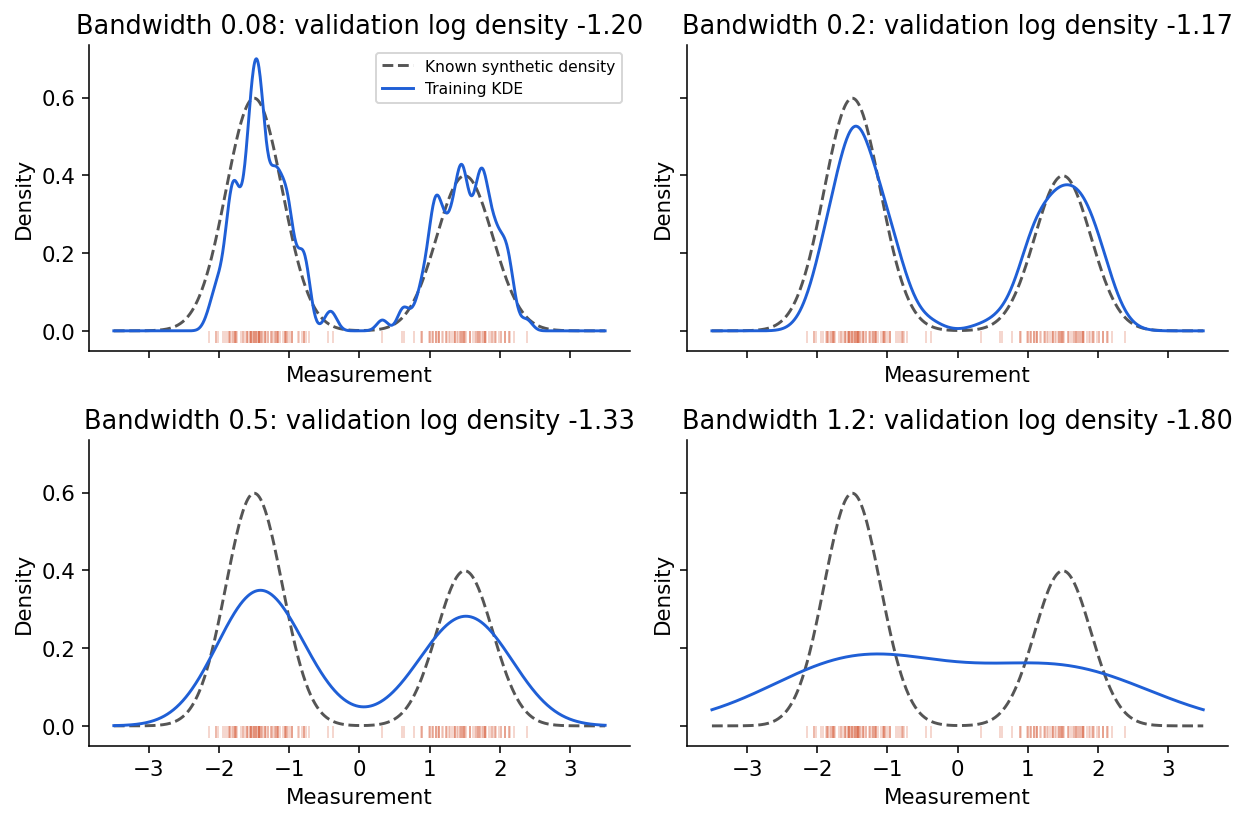
無論用哪一種規則,都不要看最終測試資料來選 。圖 4 說明選擇為何重要:在雙峰樣本上, 產生虛假的小峰, 把兩個峰合而為一,驗證對數似然則正確地偏好 。
程式碼:頻寬選擇與 Beta 後驗
這個範例在合成的雙峰分布上使用 scikit-learn 的 KernelDensity [26],搭配獨立的驗證樣本、用於比較的 Silverman 法則,以及上一節的封閉式 Beta 後驗。
程式碼 · Python · 28 行
import numpy as np
from scipy.stats import beta
from sklearn.neighbors import KernelDensity

rng = np.random.default_rng(4)
def sample(n):
    means = np.where(rng.random(n) < 0.6, -1.5, 1.5)
    return (means + rng.normal(0, 0.4, n)).reshape(-1, 1)
train, validation = sample(180), sample(100)
bandwidths = [0.08, 0.2, 0.5, 1.2]
scores = []
for h in bandwidths:
    model = KernelDensity(bandwidth=h).fit(train)
    scores.append(model.score(validation) / len(validation))
best = bandwidths[int(np.argmax(scores))]

# Silverman's rule of thumb for comparison
x = train.ravel()
iqr = np.subtract(*np.percentile(x, [75, 25]))
h_silverman = 0.9 * min(x.std(ddof=1), iqr / 1.34) * len(x) ** (-1 / 5)

posterior = beta(2, 1)  # uniform prior + one success
print("validation mean log densities:",
      {h: round(float(s), 3) for h, s in zip(bandwidths, scores)})
print("selected bandwidth:", best, "| Silverman's rule:", round(h_silverman, 3))
print("posterior mean:", posterior.mean())
print("95% credible interval:", posterior.ppf([0.025, 0.975]))
assert np.isclose(posterior.mean(), 2 / 3)
驗證選出 ,Silverman 法則則給出 。這條法則假設資料是單一高斯;而這份樣本的分散主要來自兩峰之間的間隔,所以法則過度平滑。均勻先驗下觀測一次成功後,Beta 後驗的平均為 , 可信區間約為 :一筆觀測能告訴我們的非常有限。
可信區間描述的是在假設的先驗與似然下的不確定性,並不自動等於校準過的頻率學派覆蓋率保證。同樣地,密度分數好,也不保證分類邊界好:模型描述的某些變異可能與標籤無關。
近鄰密度估計
改為固定 而非 :以 為中心擴大一個球,直到剛好包含 個樣本,令 為球的體積。則 [11]
Loftsgaarden 與 Quesenberry [11] 證明,當 且 時這個估計是一致的。它的頻寬會自動調整:資料密集處窄、稀疏處寬。但圖 3(右)顯示了它的缺點。 小時非常尖刺,因為樣本聚集處的 很小。在尾部,一維中 只隨距離線性成長,所以 以 衰減,估計積分不為一(積分發散)。因此它是很差的密度估計,但正如下一節所示,它是很好的分類基礎。
近鄰分類器
白話版。 要分類一個新點,找出離它最近的 個訓練點,然後多數決。不需要訓練模型;訓練集本身就是模型。
精確版。 在 周圍畫一個總共包含 個樣本的球,其中 個屬於類別 。對每個類別分別套用 估計,類別 有 個樣本,得到
體積消去了,後驗估計就是各類別鄰居所佔的比例。於是貝氏規則成為多數決。 時就是最近鄰規則。
它有多好? Cover 與 Hart [12] 證明,當 時,1-NN 規則的錯誤率 滿足
其中 是貝氏錯誤率, 是類別數。這是在定理取樣假設下的錯誤率上界,不是說最近鄰含有資訊理論意義下「一半的資訊」。隨著 增加(且 ),-NN 的錯誤率會逼近 本身。這是漸近的敘述;資料有限且維度很多時,情況就沒那麼樂觀。
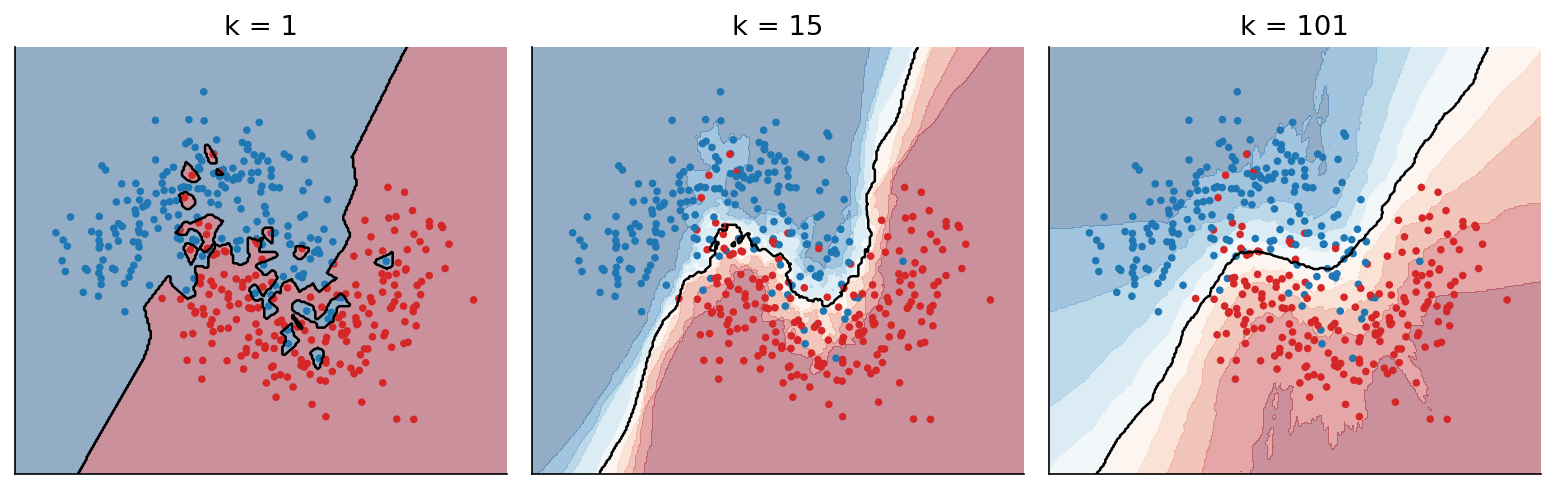
選擇 。 小則偏差低、變異數高:圖 5 中 1-NN 的邊界會繞著個別的雜訊點打轉。 大則邊界平滑,但最後會忽略真正的結構。請用交叉驗證選 。兩個實務細節:兩類別時用奇數 以避免平手,並且先標準化特徵,因為歐氏距離會被數值範圍最大的特徵主導。PR 04 會把核方法與最近鄰與其他非線性分類器比較,學習式距離度量則在該章與後續章節討論。
程式碼:k-NN 與高斯分類器
程式碼 · Python · 21 行
import numpy as np
from sklearn.datasets import make_moons
from sklearn.model_selection import GridSearchCV, train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.neighbors import KNeighborsClassifier
from sklearn.discriminant_analysis import QuadraticDiscriminantAnalysis

X, y = make_moons(1000, noise=0.3, random_state=0)
Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.5, random_state=0)

search = GridSearchCV(KNeighborsClassifier(),
                      {"n_neighbors": [1, 3, 5, 9, 15, 31, 61, 101]}, cv=5)
search.fit(Xtr, ytr)                     # k chosen on training folds only
print("cross-validated k:", search.best_params_["n_neighbors"])
models = {"1-NN": KNeighborsClassifier(1),
          f"{search.best_params_['n_neighbors']}-NN": search.best_estimator_,
          "Gaussian naive Bayes": GaussianNB(),
          "QDA": QuadraticDiscriminantAnalysis()}
for name, m in models.items():
    m.fit(Xtr, ytr)
    print(f"{name:22s} test error {1 - m.score(Xte, yte):.3f}")
交叉驗證選出 ,測試錯誤率 ;1-NN 為 。高斯模型的類別形狀只是一個橢圓,跟不上月形,表現較差(樸素貝氏 ,QDA )。在這個二維問題上,非參數方法勝出,因為參數形式是錯的。下一節說明為何維度升高時這個優勢會縮小。
維度詛咒
白話版。 局部方法需要「近」的鄰居。當許多座標帶有分散或無關的變動時,距離可能不再是好線索:即使只想蒐集一小部分資料,也得橫跨大半個空間,而最近點與最遠點的距離幾乎一樣。
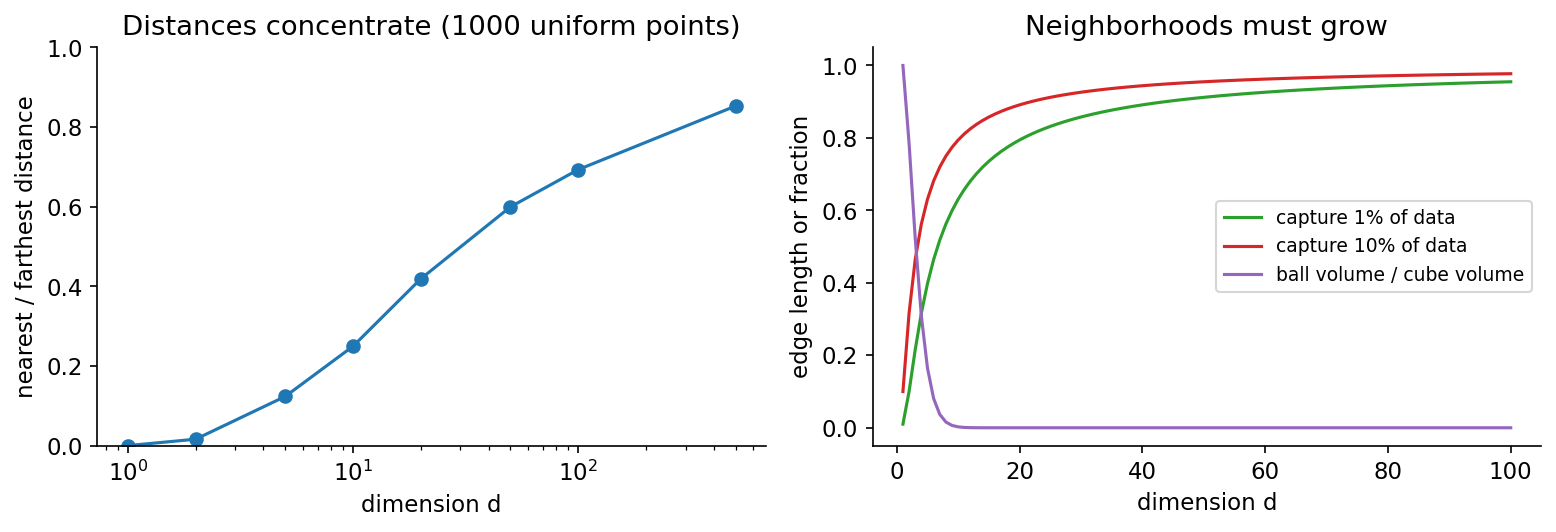
精確版。 「維度詛咒」(curse of dimensionality)這個說法涵蓋幾個相關的效應;Bishop [2, Section 1.4] 有幾何上的說明。其中三個很容易驗證(圖 6):
- 鄰域必須很大。 在單位立方體 內均勻分布的資料中,包含比例 資料的子立方體,邊長為 。要涵蓋 的資料,邊長在二維是 、十維是 、一百維是 。「局部」鄰域幾乎跨越每個特徵的全部範圍,估計就不再是局部的了。
- 體積都在角落與外殼。 單位球體積除以外接立方體 的體積,會迅速趨近於零;而球的體積幾乎全集中在靠近表面的薄殼中。高維高斯的樣本與平均值的距離幾乎相同,而不是聚在平均值附近。
- 距離集中。 Beyer 等人 [13] 證明,在資料分布滿足廣泛條件下,最遠鄰與最近鄰距離的比值隨 增加趨近於一,「最近鄰」因而失去意義。在下面的模擬中,最近與最遠距離之比從二維的 升到一百維的約 。
程式碼:距離集中
程式碼 · Python · 11 行
import numpy as np

rng = np.random.default_rng(0)
for d in [1, 2, 10, 100, 1000]:
    pts = rng.random((1000, d))          # 1000 uniform points in [0, 1]^d
    q = rng.random((50, d))              # 50 query points
    dist = np.sqrt(((q[:, None, :] - pts[None]) ** 2).sum(-1))
    ratio = (dist.min(1) / dist.max(1)).mean()
    edge = 0.1 ** (1 / d)                # sub-cube edge holding 10% of the volume
    print(f"d={d:5d}: nearest/farthest = {ratio:.3f}, "
          f"edge for 10% of data = {edge:.3f}")
最近/最遠距離比在二維是 ,十維 ,一百維 ,一千維 。
那為什麼高維時還有方法行得通? 真實資料並非均勻分布。影像、聲音與文字都貼近巨大環境空間中的低維結構(流形、群集),有資訊的方向遠少於原始座標數。因此實務上的防禦是:先降維或學習表徵(PR 05:特徵與維度)、限制模型(共用或對角共變異數、樸素貝氏),以及正則化。最近鄰方法今天之所以表現很好,正因為它們用在學習到的嵌入上,而不是原始像素上,如「現代觀點」所述。
現代觀點
自教科書寫成以來,密度估計分成兩股潮流:傳統統計學精進了 KDE 與共變異數估計;深度學習則建立了能擴展到影像的密度模型,而最近鄰搜尋成了基礎設施。
重新檢視核密度估計。 Chen 的教學文 [16] 是溫和的現代入門:收斂速率、頻寬選擇、信賴帶及其偏差處理,以及用 KDE 估計密度的幾何與拓撲特徵(峰值、等高集、脊線)的近期研究。Wang 與 Scott [17] 回顧為高維資料設計的非參數密度估計器,包括峰值分群(modal clustering)等應用,並列出開放的研究方向。Scott 的專書 [8] 與 Silverman 的經典 [7] 仍是理論的標準參考。
高維共變異數。 本章的奇異共變異數問題本身就是一整個研究領域。Fan、Liao 與 Liu [18] 回顧大型共變異數矩陣與精度(反共變異數)矩陣的估計方法,著重於基於秩的方法與基於因子模型的方法;Ledoit–Wolf 收縮 [14] 至今仍是函式庫中的預設正則化方式。
深度密度模型。 正規化流(normalizing flow)把簡單的基底分布送過一連串可逆、可微的映射,建構出有彈性的密度;變數變換公式則給出精確的對數似然。Papamakarios 等人 [19] 與 Kobyzev、Prince、Brubaker [20] 是兩篇標準綜述:前者強調設計原則、表達能力與計算取捨,後者著重流的建構方式與開放問題。自迴歸模型、VAE 與擴散模型是學習高維密度的其他方法;見 ML 07:生成模型與 ML 08:擴散與流匹配。Murphy 的兩冊教科書 [4] 以同一套記號涵蓋本章的傳統估計器與這些現代模型。
大規模最近鄰。 -NN 如今無所不在,只是用在學習到的嵌入上,而非原始特徵。Johnson、Douze 與 Jégou [21] 示範如何在 GPU 上進行十億規模的相似度搜尋;Faiss 函式庫論文 [22] 描述向量搜尋的取捨空間(準確度、速度、記憶體)以及現代向量資料庫背後的索引方法。Papernot 與 McDaniel 的深度 -NN(deep -NN)[23] 在每一層的表徵中把測試輸入與它的訓練鄰居比較,以鄰居間標籤的不一致作為信心與穩健性的訊號。在分布外偵測上,Sun 等人 [24] 直接使用特徵空間中第 個最近鄰的距離,不做任何分布假設,並報告相對於參數式馬氏距離基準的大幅改進。那個參數式基準來自 Lee 等人 [25],它在網路特徵上擬合共用共變異數的類別條件高斯,也就是 PR 01 的 LDA。本章參數式與非參數式之間的抉擇,正在深度特徵之上重演。
開放問題。 高維中可靠的密度估計依然困難。Nalisnick 等人 [27] 發現,在某個影像資料集上訓練的流模型、VAE 與 PixelCNN,可能給另一個資料集更高的似然(例如在日常物體資料集上訓練的模型,給門牌號碼照片資料集更高的分數),所以單靠似然並不是安全的新穎性分數。嵌入空間中頻寬或 的選擇,以及非參數估計的校準不確定性,都仍是活躍的研究問題。
重點整理
- 生成式分類器需要 與 ;估計器的假設決定了邊界的形狀。
- 高斯的 ML 估計是樣本平均與除以 的共變異數;樣本數 時共變異數奇異,需要收縮(例如 Ledoit–Wolf)或共用/對角結構。
- MAP 保留後驗眾數;完整貝氏預測對參數積分,資料稀少時比代入式預測更寬。共軛先驗有封閉解:高斯平均的精度相加,Beta–Bernoulli 比率的計數相加。
- 非參數估計都源自 :直方圖與 Parzen/KDE 固定 ,-NN 固定 。頻寬或 比核的形狀重要;用交叉驗證或有根據的規則選擇,絕不用測試資料。
- -NN 分類器估計 ;在漸近意義下,1-NN 的錯誤率不超過貝氏錯誤率的兩倍。
- 高維時鄰域不再局部、距離會集中;局部方法是否有效取決於內在結構、特徵尺度與樣本數,不能只看環境維度。
練習
- 計算參數數量。 計算一個 64 維高斯的平均值與共變異數參數數量。解釋為何用 30 筆樣本擬合會失敗,並提出兩種修正方式。
提示
個平均值加上 個共變異數元素。30 筆樣本時, 的秩最多為 29,所以是奇異的。修正方式:往 收縮(Ledoit–Wolf)、對角共變異數(樸素貝氏)、各類別共用共變異數,或先降維。
- Beta–Bernoulli 更新。 從 開始,觀測到三次成功、兩次失敗,計算後驗、MAP 估計與成功的後驗預測機率。
提示
後驗 。MAP(眾數)。預測機率 。與 ML 的 比較。
- 精度加權平均。 高斯平均的先驗為 、雜訊變異數 ,要幾筆樣本後資料權重才等於先驗權重?此時後驗標準差是多少?
提示
先驗精度為 ;每筆樣本增加 。 時權重相等。後驗精度為 ,所以 。
- 重複的特徵。 在高斯樸素貝氏中複製一個特徵。預測準確率與後驗信心會怎麼變,再用 scikit-learn 在
load_breast_cancer上驗證。
提示
多出的座標沒有新資訊,但分解後的似然把它算兩次,相當於把它的似然比平方。決策可能稍有改變;後驗會更靠近 0 或 1(更過度自信)。比較前後 predict_proba 的直方圖與對數損失。
- k-NN 密度不是密度。 證明在一維中,-NN 估計 在遠離資料處以 衰減,並由此推論 發散。為什麼這不影響 -NN 分類器?
提示
遠離所有樣本時,到第 個鄰居的距離約為 ,所以 、,其積分以對數方式發散。分類器只在同一點使用比例 ,共同的體積會消去。
- 頻寬規則。 從 與 的混合分布產生 500 筆樣本。比較 Silverman 法則、似然交叉驗證(對
KernelDensity做GridSearchCV),以及(若有安裝statsmodels)代入式選擇器。哪一個過度平滑?為什麼?
提示
Silverman 法則使用整體分散程度(這裡約 ),它主要來自兩峰之間的間隔,因此給出的頻寬比每個峰所需的大好幾倍。交叉驗證似然選出的值接近單峰內的最佳值。
參考文獻
- R. O. Duda, P. E. Hart and D. G. Stork, Pattern Classification, 2nd ed., Wiley, 2001 (Ch. 3, maximum-likelihood and Bayesian estimation; Ch. 4, non-parametric techniques). publisher page
- C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006 (Sections 1.4, 2.1–2.3, 2.5 and 4.2). official page and free PDF
- S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2008 (Ch. 2, density estimation and Bayesian classification). publisher page
- K. P. Murphy, Probabilistic Machine Learning: An Introduction, MIT Press, 2022. official page
- M. Rosenblatt, “Remarks on some nonparametric estimates of a density function,” The Annals of Mathematical Statistics, vol. 27, no. 3, pp. 832–837, 1956. doi
- E. Parzen, “On estimation of a probability density function and mode,” The Annals of Mathematical Statistics, vol. 33, no. 3, pp. 1065–1076, 1962. doi
- B. W. Silverman, Density Estimation for Statistics and Data Analysis, Chapman and Hall, 1986 (reissued by Routledge, 2018). doi
- D. W. Scott, Multivariate Density Estimation: Theory, Practice, and Visualization, 2nd ed., Wiley, 2015. doi
- D. W. Scott and G. R. Terrell, “Biased and unbiased cross-validation in density estimation,” Journal of the American Statistical Association, vol. 82, no. 400, pp. 1131–1146, 1987. doi
- S. J. Sheather and M. C. Jones, “A reliable data-based bandwidth selection method for kernel density estimation,” Journal of the Royal Statistical Society, Series B, vol. 53, no. 3, pp. 683–690, 1991. doi
- D. O. Loftsgaarden and C. P. Quesenberry, “A nonparametric estimate of a multivariate density function,” The Annals of Mathematical Statistics, vol. 36, no. 3, pp. 1049–1051, 1965. doi
- T. M. Cover and P. E. Hart, “Nearest neighbor pattern classification,” IEEE Transactions on Information Theory, vol. 13, no. 1, pp. 21–27, 1967. doi
- K. Beyer, J. Goldstein, R. Ramakrishnan and U. Shaft, “When is ‘nearest neighbor’ meaningful?,” in Database Theory — ICDT’99, Lecture Notes in Computer Science, Springer, 1999. doi
- O. Ledoit and M. Wolf, “A well-conditioned estimator for large-dimensional covariance matrices,” Journal of Multivariate Analysis, vol. 88, no. 2, pp. 365–411, 2004. doi
- A. Y. Ng and M. I. Jordan, “On discriminative vs. generative classifiers: a comparison of logistic regression and naive Bayes,” in Advances in Neural Information Processing Systems (NIPS), 2001. paper
- Y.-C. Chen, “A tutorial on kernel density estimation and recent advances,” Biostatistics & Epidemiology, vol. 1, no. 1, pp. 161–187, 2017. doi
- Z. Wang and D. W. Scott, “Nonparametric density estimation for high-dimensional data — algorithms and applications,” WIREs Computational Statistics, vol. 11, no. 4, 2019. doi
- J. Fan, Y. Liao and H. Liu, “An overview of the estimation of large covariance and precision matrices,” The Econometrics Journal, vol. 19, no. 1, pp. C1–C32, 2016. doi
- G. Papamakarios, E. Nalisnick, D. J. Rezende, S. Mohamed and B. Lakshminarayanan, “Normalizing flows for probabilistic modeling and inference,” Journal of Machine Learning Research, vol. 22, no. 57, pp. 1–64, 2021. arXiv
- I. Kobyzev, S. J. D. Prince and M. A. Brubaker, “Normalizing flows: an introduction and review of current methods,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 43, no. 11, pp. 3964–3979, 2021. doi
- J. Johnson, M. Douze and H. Jégou, “Billion-scale similarity search with GPUs,” IEEE Transactions on Big Data, vol. 7, no. 3, pp. 535–547, 2021. doi
- M. Douze, A. Guzhva, C. Deng, J. Johnson, G. Szilvasy, P.-E. Mazaré, M. Lomeli, L. Hosseini and H. Jégou, “The Faiss library,” arXiv:2401.08281, 2024. arXiv
- N. Papernot and P. McDaniel, “Deep k-nearest neighbors: towards confident, interpretable and robust deep learning,” arXiv:1803.04765, 2018. arXiv
- Y. Sun, Y. Ming, X. Zhu and Y. Li, “Out-of-distribution detection with deep nearest neighbors,” in Proc. International Conference on Machine Learning (ICML), PMLR 162, 2022. paper
- K. Lee, K. Lee, H. Lee and J. Shin, “A simple unified framework for detecting out-of-distribution samples and adversarial attacks,” in Advances in Neural Information Processing Systems (NeurIPS), 2018. paper
- scikit-learn developers, “Density estimation,” scikit-learn user guide. documentation
- E. Nalisnick, A. Matsukawa, Y. W. Teh, D. Gorur and B. Lakshminarayanan, “Do deep generative models know what they don’t know?,” in Proc. International Conference on Learning Representations (ICLR), 2019. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 03・迴歸與分類的線性模型 · 20 分鐘