PR 07・分群、混合模型與 EM
先備知識:PR 06・模板比對與結構化辨識
導覽:本頁與本系列: 導覽:本頁與本系列
本頁內容
圖形識別
你將學到
- 分群演算法實際上在最佳化什麼,以及為什麼特徵、尺度與距離的選擇,在任何演算法執行之前就已決定了答案。
- Lloyd 的 k-means 如何運作、為何一定收斂卻只到局部最佳,以及 k-means++ 播種如何給出可證明的 保證。
- 階層式分群(single、complete、average 與 Ward 連結)、DBSCAN 與譜分群各自如何定義「一群」。
- 如何從頭推導高斯混合模型期望值最大化(expectation–maximization, EM)的 E 步與 M 步、為何 EM 不會讓似然下降,以及它會在哪裡失敗。
- 如何用 BIC 與 AIC 選擇群數,以及如何解讀內部指標(silhouette、Davies–Bouldin、Calinski–Harabasz)、外部指標(ARI、NMI)與穩定度。
先看全貌
到目前為止,這個系列中的每一筆訓練樣本都附有標籤。分群(clustering)把標籤拿掉,問的是:資料裡有沒有自然的群組?這個問題的答案從來不只由資料本身決定。同一批影像可以依物體、依顏色、依背景,或依拍攝的相機來分組;每一種分法在它自己的相似性定義下都是「對的」。因此,一個分群演算法其實是兩件事:精確說明我們指的是哪一種相似性,再加上一個在該定義下尋找最佳分組的搜尋程序。
為什麼這對辨識很重要:分群可以建立視覺詞彙(把局部影像描述子用 k-means 量化成「視覺詞」)、初始化與壓縮模型(向量量化、調色盤)、在已標註的類別中找出子類別、找出離群值、分割影像(像素分群,見 IP 10),而在現代自監督學習中,還能產生用來訓練深度網路的偽標籤。高斯混合模型也是潛在變數模型(latent-variable model)的標準範例,而 EM 是我們在 PR 08 會遇到的許多推論演算法的原型。
本章依循 Theodoridis 與 Koutroumbas 書中的分群部分(第 11–16 章)[1],以及 Bishop 第 9 章的混合模型與 EM [2]。我們會整理主要的演算法家族,完整推導其中最重要的兩個,最後討論如何判斷一個分群結果好不好。
相似性、尺度與「群」的意義
白話版。 在選演算法之前,先決定什麼叫做「近」。換了特徵或單位,群就會跟著改變。
精確版。 大多數方法都從特徵向量 之間的相異度 出發。常見選擇有
其中 是歐氏距離; 是以正定矩陣 (通常是共變異數估計)定義的馬氏距離(Mahalanobis distance); 是餘弦相異度,它忽略向量長度,常用於深度網路的嵌入向量(embedding)。
由此有三個實務上的後果。
- 尺度是一個建模決策。 若一個座標以公釐計、另一個以公里計,歐氏距離就會被前者主導。把每個特徵標準化為單位變異數可以消除這個問題,但也會抹掉真正有意義的離散程度差異。做分類時可以交給驗證集決定;分群沒有標籤,這個選擇只能來自領域知識。
- 硬指派與軟指派。 硬分割把每個點 指派到恰好一個群 。軟指派則保存隸屬程度 ,且 。在高斯混合模型中,這些是後驗機率;在模糊分群 [1] 中,它們是由目標函數定義的隸屬度,不應被解讀為機率。
- 群不是類別。 群的編號是事後任意附上的。這一次的「第 3 群」下一次可能變成「第 1 群」,因此任何與類別標籤的比較都必須對排列不變,而這正是後面介紹的 ARI 與 NMI 的性質。
Theodoridis 與 Koutroumbas 把演算法分成序列式、階層式、以目標函數為基礎(k-means、混合模型、模糊分群),以及以圖或密度為基礎等家族 [1]。我們大致依照這個順序。
K-means 與 Lloyd 演算法
白話版。 選 個中心。重複兩個步驟:把每個點交給最近的中心,再把每個中心移到它所屬點的平均位置。直到沒有任何變化為止。
目標函數
令 one-hot 指標 (若第 點屬於第 群則 ,且 ),中心為 。k-means 最小化群內平方和
其中 是點的數量, 是維度。 也稱為 inertia 或失真(distortion)。
兩個交替步驟
Lloyd 演算法 [3](原本是為脈衝碼調變中的訊號量化而發展)以區塊座標下降(block coordinate descent)最小化 :
- 指派步驟。 固定 。每一項只牽涉一個 ,因此對 設 。
- 更新步驟。 固定 。 對每個 都是凸二次函數;令梯度為零,
也就是目前屬於第 群各點的平均。「k-means」這個名稱由 MacQueen [4] 提出;他的版本在每個點到來後立即更新中心:,其中 是第 群到目前為止的點數。
為什麼會收斂,又為什麼只是局部
每一步只會讓 下降或維持不變:指派步驟為目前的 挑出最佳的 ,更新步驟為目前的 挑出最佳的 。把 個點分成 組的分割方式是有限的,而且(只要平手時採用固定規則)演算法不會回到 更高的分割,因此在有限次迭代後一定停止。停下來的固定點是局部最小值:任何單一步驟都無法再改善的分割。不同的初始中心可能導致差異很大的固定點。
實作上有兩個細節。空群(沒有任何點被指派)沒有平均值;常見作法是保留舊中心,或在目前誤差最大的點重新播種。另外每次迭代需要 次距離計算,這促成了後面的小批次版本。
k-means 的假設
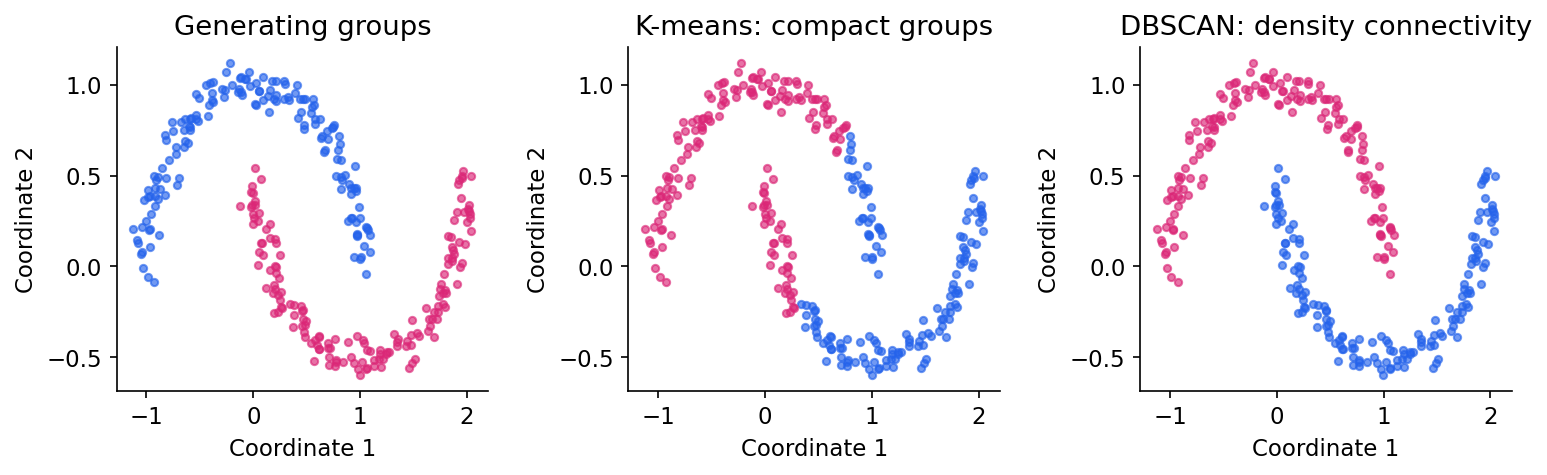
由於目標是各點到中心的歐氏距離平方和,兩群之間的邊界就是兩個中心的垂直平分線:k-means 把空間切成 Voronoi 區域。它適合緊密、大致呈球形且大小相近的群;它會切開細長的群、把靠近大群的小群併進去,也無法沿著彎曲形狀分群(圖 1,中間)。
k-means++ 播種
白話版。 先隨機選一個中心,之後每個新中心都盡量選離現有中心遠的點,但保留隨機性,免得離群值每次都被選中。
Arthur 與 Vassilvitskii [5] 提出 D² 播種:
- 從資料中均勻隨機選出第一個中心。
- 對每個點計算 ,即它到目前已選中心中最近者的距離。
- 以機率 選出 作為下一個中心。
- 重複步驟 2–3 直到選滿 個中心,再執行 Lloyd 演算法。
他們的主要定理指出,光是播種本身,在期望值意義下就已達到
其中 是最佳的 k-means 目標值;之後的 Lloyd 迭代只會讓 更低。均勻隨機播種沒有這樣的保證。這個上界是最壞情況的敘述;實務上的好處主要表現在災難性的結果變少了。函式庫會把 k-means++ 與多次重新啟動結合(scikit-learn 的 n_init),保留 最低的一次。
程式:從頭實作 k-means++ 與 Lloyd
程式碼 · Python · 46 行
import numpy as np
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans

def kmeans_pp_init(X, k, rng):
    """D^2 seeding: each new center is drawn with probability proportional
    to the squared distance to the nearest center chosen so far."""
    centers = [X[rng.integers(len(X))]]
    for _ in range(k - 1):
        d2 = np.min(((X[:, None, :] - np.array(centers)[None]) ** 2).sum(-1), axis=1)
        centers.append(X[rng.choice(len(X), p=d2 / d2.sum())])
    return np.array(centers)

def lloyd(X, centers, max_iter=100):
    history = []
    for _ in range(max_iter):
        d2 = ((X[:, None, :] - centers[None]) ** 2).sum(-1)   # N x K
        z = d2.argmin(axis=1)                                 # assignment step
        history.append(d2[np.arange(len(X)), z].sum())        # objective J
        new = np.array([X[z == k].mean(axis=0) if np.any(z == k) else centers[k]
                        for k in range(len(centers))])        # update step
        if np.allclose(new, centers):
            break
        centers = new
    return centers, z, history

X, _ = make_blobs(n_samples=600, centers=4, cluster_std=1.8, random_state=7)
rng = np.random.default_rng(0)
best = None
for restart in range(10):                      # several seeds, keep the best J
    c, z, hist = lloyd(X, kmeans_pp_init(X, 4, rng))
    if best is None or hist[-1] < best[2][-1]:
        best = (c, z, hist)
c, z, hist = best
print("J per iteration:", np.round(hist, 1))
assert all(a >= b - 1e-9 for a, b in zip(hist, hist[1:]))   # monotone
ref = KMeans(n_clusters=4, n_init=10, random_state=0).fit(X)
print("from scratch J:", round(hist[-1], 2), " sklearn inertia:", round(ref.inertia_, 2))

# single runs (no restarts): uniform random seeding vs D^2 seeding, 15 clusters
X2, _ = make_blobs(n_samples=1500, centers=15, cluster_std=0.6, random_state=2)
for name, init in [("random", lambda r: X2[r.choice(len(X2), 15, replace=False)]),
                   ("k-means++", lambda r: kmeans_pp_init(X2, 15, r))]:
    finals = [lloyd(X2, init(np.random.default_rng(s)))[2][-1] for s in range(20)]
    print(f"{name:9s} final J over 20 runs: median {np.median(finals):7.1f}, "
          f"worst {np.max(finals):7.1f}")
輸出(NumPy 2.0、scikit-learn 1.6):
程式碼 · 4 行
J per iteration: [5865.6 3633.4 3625. ]
from scratch J: 3625.0  sklearn inertia: 3625.0
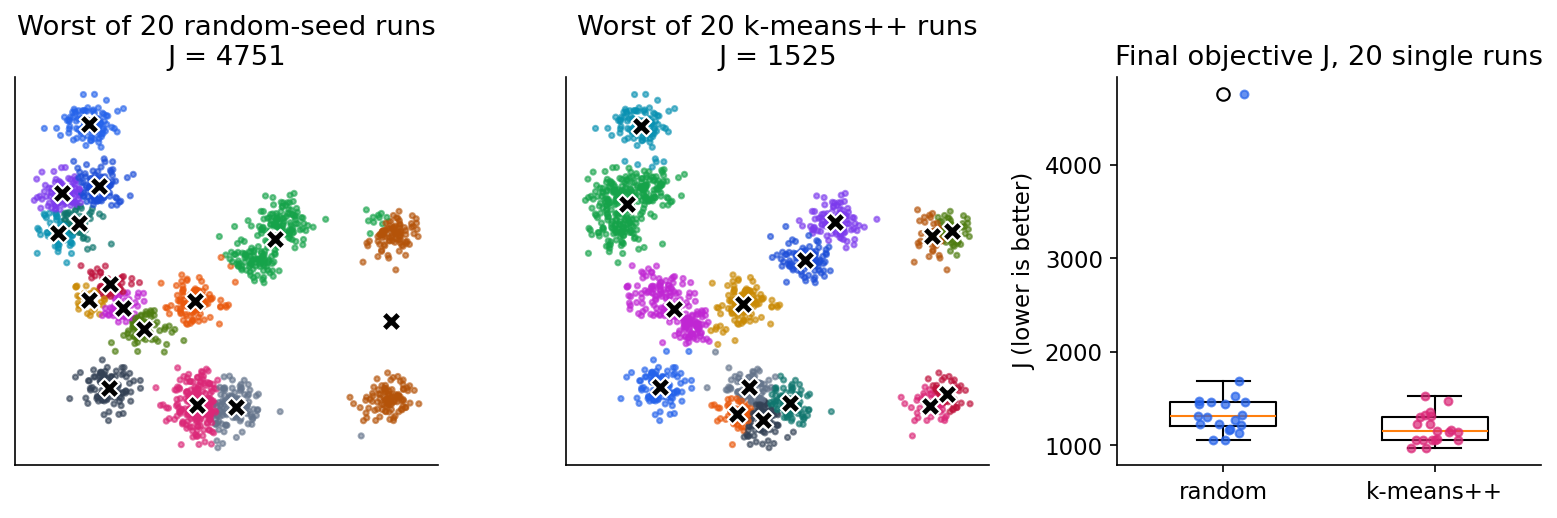
random    final J over 20 runs: median  1305.1, worst  4750.8
k-means++ final J over 20 runs: median  1147.5, worst  1525.2
從頭寫的版本與 scikit-learn 達到相同的目標值,而且 單調下降。在 15 群的問題上,均勻播種有時會把兩個種子放進同一團、另一團卻一個也沒有;Lloyd 演算法無法修正這種情況,最差的一次大約差了三倍。圖 2 顯示兩種播種各自最差的一次。
小批次 k-means
面對數百萬個點時,Sculley 的小批次 k-means [6] 用小的隨機批次來更新中心:每個中心朝被指派給它的批次點移動,每個中心的學習率依 遞減。它以略高的最終目標值換取大幅加速,在 scikit-learn 中為 MiniBatchKMeans,是建立大型視覺詞彙時的常見選擇。
階層式分群
白話版。 一開始每個點自成一群,接著反覆把最近的兩群合併。合併紀錄形成一棵樹;在某個高度切開它,就得到各群。
聚合式演算法與連結方式
聚合式(agglomerative)分群需要定義兩個群 與 之間的距離。四種經典的連結(linkage)為
其中 是 中的點數, 是兩群的平均。Ward 準則 [7] 是合併 與 所造成的群內平方和 的增量,所以 Ward 聚合是一種由下而上、貪婪地讓 保持很小的方法,目標與 k-means 相同。
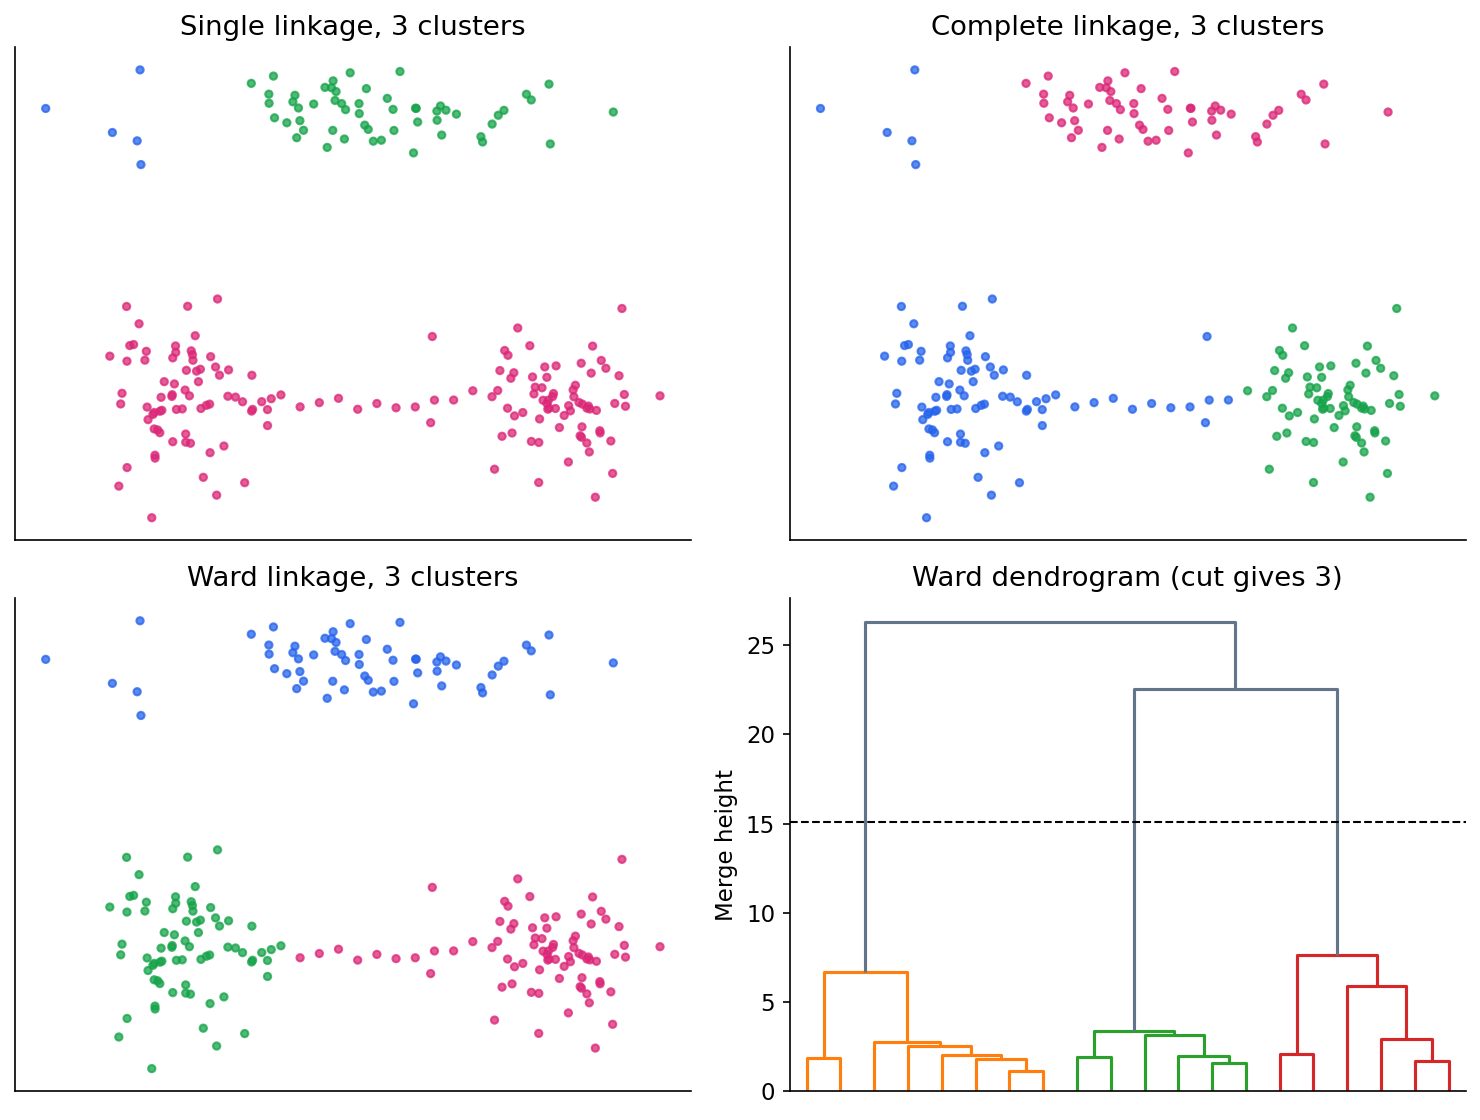
每種連結都有自己的個性(圖 3):
- Single linkage 只要任何兩點夠近就合併。它能沿著任意形狀走,但一條細細的點「橋」就可能把兩群串在一起。它等價於切斷最小生成樹(minimum spanning tree)中最長的邊,這也是 [1] 中的圖論方法之一。
- Complete linkage 要求所有點對都夠近,會產生緊密且直徑相近的群,對離群值敏感。
- Average linkage 介於兩者之間。
- Ward 產生緊密、大小相近、大致呈球形的群,很像 k-means。
樹狀圖
合併歷程是一棵二元樹,稱為樹狀圖(dendrogram);每個接點的高度就是合併當下的連結值。在高度 切開樹,就得到該層的分割;相鄰合併高度之間若有很大的落差,往往暗示一個自然的群數。不過切割高度仍然是一個選擇。
實務上有兩個限制:合併一旦發生就不會撤銷,早期的錯誤會一路傳下去;標準演算法需要儲存所有點對距離,記憶體為 ,使它只適用於數萬個點以內。分裂式(由上而下)階層方法也存在,但較少使用。
以密度為基礎的分群:DBSCAN
白話版。 一群就是一塊擁擠的區域。擁擠處的點讓群長大;空曠處的點被標為雜訊。
DBSCAN(Density-Based Spatial Clustering of Applications with Noise)[8] 有兩個參數:半徑 與點數 。令 為 的 鄰域(包含 本身)。則
- 若 , 是核心點(core point);
- 若 不是核心點,但落在某個核心點的 鄰域內,它是邊界點(border point);
- 其餘的點都是雜訊(noise)。
若存在一串核心點,相鄰兩者距離都不超過 ,最後抵達某點的鄰域,則該點從起始核心點密度可達。一群就是彼此密度相連的點所構成的極大集合。DBSCAN 能找出任意形狀的群、不需要事先指定 ,而且明確拒絕指派孤立的點。
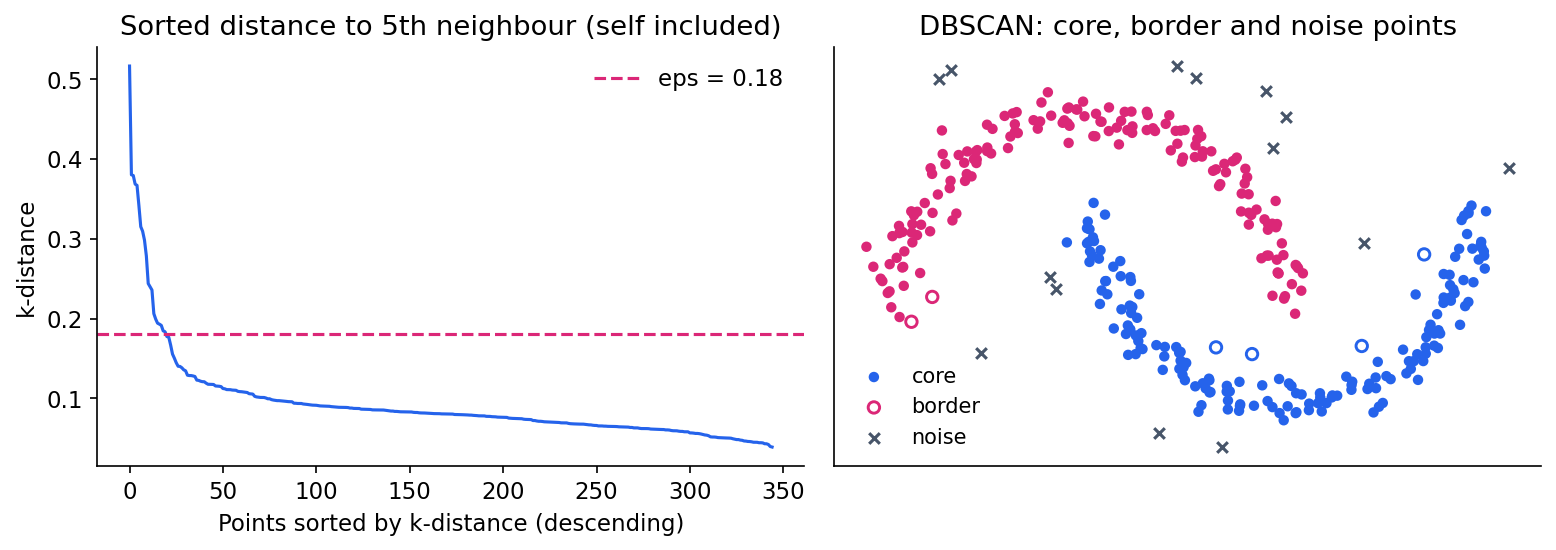
如何選 。 原論文建議使用排序後的 k 距離圖:對每個點計算它到第 個最近鄰的距離(),排序後在曲線急遽上升的「膝點」附近選 (圖 4 左)。圖中膝點左側那些距離很大的點,就是雜訊的候選。scikit-learn 的 min_samples 會把點本身算進去,與上面的定義一致。
限制。 單一 意味著單一密度水準。若一群很密、另一群很稀,就沒有任何 能同時把兩者分開。在高維空間中距離會趨於集中,鄰域點數失去對比。HDBSCAN [9] 針對第一個問題,建立涵蓋所有密度水準的階層,並取出最穩定的群,以「最小群大小」取代 ;scikit-learn 中提供 HDBSCAN。
一頁看懂譜分群
白話版。 建一張把相近點連起來的圖,再找出切斷最少強連結的切法。
給定親和矩陣 (,相似的點數值大,例如 近鄰圖或 )與對角度數矩陣 ,一種正規化圖拉普拉斯矩陣為
若圖有 個連通分量, 的特徵值 重數為 ,其特徵向量指出各分量。若圖接近不連通,最小 個特徵值對應的特徵向量仍近似指出各群。譜分群把這些特徵向量排成矩陣的行、把每一列正規化,再對各列執行 k-means [10]。結果可以沿著在原空間中會打敗 k-means 的彎曲形狀走,因為特徵向量衡量的是連通性,而不是到某個中心的距離。
圖本身就是模型的一部分。鄰居數或頻寬 都必須選擇;一張意外不連通的圖(例如有一個孤立節點)會產生一個主導結果的平凡特徵向量。von Luxburg 的教學文章 [10] 解釋了圖切割的詮釋(ratio cut 與 normalized cut),也提供如何選圖的實務建議。
程式:同一種幾何,不同的假設
下面的雙月形資料是帶標籤生成的,但標籤只在事後用來以調整蘭德指數(adjusted Rand index, ARI;1 表示在重新編號下完全一致,約 0 表示與隨機相當)評分。
程式碼 · Python · 30 行
import numpy as np
from sklearn.datasets import make_moons
from sklearn.neighbors import NearestNeighbors
from sklearn.cluster import (KMeans, AgglomerativeClustering, DBSCAN,
                             HDBSCAN, SpectralClustering)
from sklearn.mixture import GaussianMixture
from sklearn.metrics import adjusted_rand_score

X, truth = make_moons(n_samples=320, noise=0.06, random_state=5)

# k-distance curve for choosing DBSCAN's eps (k = min_samples)
dist, _ = NearestNeighbors(n_neighbors=5).fit(X).kneighbors(X)
kdist = np.sort(dist[:, -1])                    # 5th neighbour, counting the point itself
print("k-distance quantiles 50/90/99%:", np.round(np.quantile(kdist, [0.5, 0.9, 0.99]), 3))

models = {
    "k-means": KMeans(n_clusters=2, n_init=10, random_state=5),
    "single linkage": AgglomerativeClustering(n_clusters=2, linkage="single"),
    "Ward linkage": AgglomerativeClustering(n_clusters=2, linkage="ward"),
    "Gaussian mixture": GaussianMixture(n_components=2, n_init=3, random_state=5),
    "DBSCAN": DBSCAN(eps=0.18, min_samples=5),
    "HDBSCAN": HDBSCAN(min_cluster_size=15),
    "spectral": SpectralClustering(n_clusters=2, affinity="nearest_neighbors",
                                   n_neighbors=20, assign_labels="kmeans",
                                   random_state=5),
}
for name, model in models.items():
    labels = model.fit_predict(X)
    print(f"{name:17s} ARI = {adjusted_rand_score(truth, labels):.3f}"
          f"   noise points = {int((labels == -1).sum())}")
輸出
k-distance quantiles 50/90/99%: [0.079 0.11  0.144]
k-means           ARI = 0.260   noise points = 0
single linkage    ARI = 1.000   noise points = 0
Ward linkage      ARI = 0.242   noise points = 0
Gaussian mixture  ARI = 0.488   noise points = 0
DBSCAN            ARI = 1.000   noise points = 0
HDBSCAN           ARI = 0.988   noise points = 2
spectral          ARI = 1.000   noise points = 0
圖 1 顯示其中兩個結果。以中心或橢圓為基礎的方法(k-means、Ward、兩個成分的高斯混合)把每個月形切成兩半;以連通性為基礎的方法(single linkage、DBSCAN、HDBSCAN、譜分群)則找回兩個月形。所選的 高於 k 距離的第 99 百分位數,因此沒有任何月形上的點被當成雜訊。鄰居太少的 近鄰圖可能不連通,此時 scikit-learn 會警告譜嵌入可能不可靠;這裡用 個鄰居就避開了這個問題。但這並不代表以連通性為基礎的方法「比較好」:在相互重疊的高斯團上,single linkage 會把一切串在一起,而 k-means 勝出。比較方法時必須改變幾何、密度、雜訊與維度。
高斯混合模型與 EM 演算法
白話版。 假裝每個點的產生方式是:先擲一顆 面骰子選一團雲,再從那團高斯雲中取樣。我們永遠看不到骰子。EM 會先為每個點猜測各團雲產生它的可能性(E 步),再用這些猜測當作權重重新擬合每團雲(M 步),然後重複。
模型
具有 個成分的高斯混合模型(Gaussian mixture model, GMM)的密度為
其中 是混合權重(成分 的先驗機率), 是其平均, 是其 共變異數矩陣, 收集所有參數,且
引入一個潛在的 one-hot 變數 ,令 、。把 加總消去,就回到混合密度。給定資料 ,對數似然為
「和的對數」把所有參數綁在一起,令梯度為零沒有封閉解。EM 是繞過這個困難的標準方法 [11]、[2]。
步驟 1:完整資料對數似然
如果我們知道指派 , 的對數似然就是
現在對數只作用在單一高斯上,問題拆成 個各自獨立的加權高斯擬合:很容易。
步驟 2(E 步):完整資料對數似然的期望值
我們不知道 ,但在目前參數 下,我們知道它的後驗。由貝氏定理,
在 下計算。 是成分 對點 的責任值(responsibility),每一列加總為 1。由於完整資料對數似然對 是線性的,在這個後驗下取期望,只要把 換成 :
步驟 3(M 步):以封閉形式最大化
定義有效點數 。
混合權重。 只有 與 有關,且受限於 。引入拉格朗日乘數 ,
對 加總得 ,所以 。(限制 自動成立。)
平均。 對 的梯度為 。令其為零並乘上 ,
共變異數。 令 ,則 ,二次項為 。利用 ,以及對對稱矩陣 有 ,
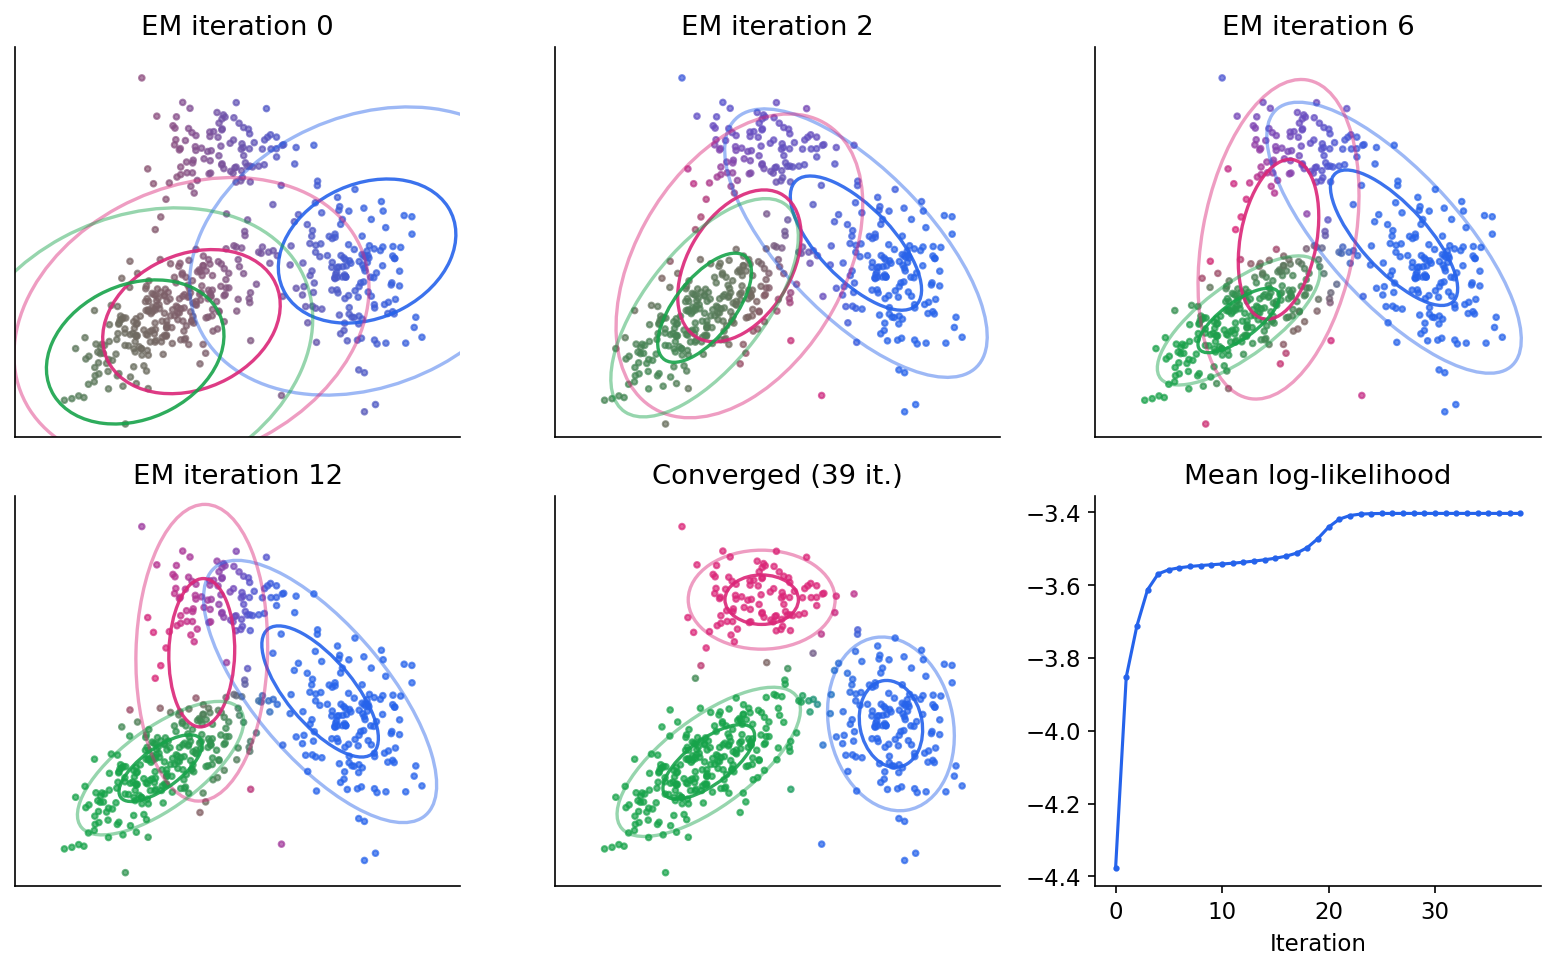
這些正是單一高斯熟悉的最大似然公式(見 PR 02),只是每個點都依其責任值加權。EM 交替執行 E 步與 M 步,直到對數似然不再改善(圖 5)。
為什麼 EM 不會讓似然下降
對潛在指派上的任何分布 ,
因此 是對數似然的下界,稱為證據下界(evidence lower bound, ELBO)。E 步令 ,使 KL 項為零、下界在 處貼合。M 步對 最大化 ;由於 ,這等同於最大化 。新的似然至少等於新的下界,新的下界至少等於舊的下界,而舊的下界等於舊的似然。因此 [11]、[2]。當精確後驗難以計算時,我們把 限制在一個可處理的分布族中,就得到變分推論(variational inference),這是 PR 08 的主題。
單調不代表全域最佳,也不保證安全收斂:在適當正則條件下,EM 可趨近駐點;不受限的高斯混合模型也可能反而走向下述奇異解。實務上的實作會先以 k-means 初始化,並多次重新啟動。
奇異解與如何避免
不受限 GMM 的似然是無界的。把某個成分的平均正好放在一個資料點上,,並令 。這一項對 的貢獻為 ,當 時趨於無限大,而其他成分仍讓其餘點的似然保持有限。因此不受限的最大似然估計不一定存在,EM 本身也不會阻止崩塌。應使用正的共變異數下限(scikit-learn 的 reg_covar [26])、明確的變異數限制,或適當先驗。只改成對角或球形共變異數並不能解決問題:正在崩塌的 原本就同時符合這兩種形式。較簡單的共變異數能減少參數,但仍須防止零變異;重新啟動成分只是操作上的處理,不是原目標函數有界的證明。
可識別性與標籤交換
把成分的編號互換,密度不變,因此有 個等價的最大值。「成分 2」沒有固有意義,要把成分編號與類別標籤比較,必須先有一個配對規則。
k-means 是 EM 的極限
對所有 固定 與 。責任值變成
當 ,距離最小的那一項主導,因此最近的中心 ,其餘為 :E 步變成 k-means 的指派步驟, 的 M 步變成 k-means 的更新 [2]。所以一般的 GMM 是在 k-means 上加入軟指派、不等大小()與橢圓形狀()的延伸。
程式:從頭實作 EM,並與 scikit-learn 對照
程式碼 · Python · 45 行
import numpy as np
from scipy.special import logsumexp
from scipy.stats import multivariate_normal
from sklearn.mixture import GaussianMixture

rng = np.random.default_rng(3)
true_means = np.array([[0.0, 0.0], [4.0, 1.0], [1.0, 4.0]])
true_covs = [np.array([[1.0, 0.6], [0.6, 0.8]]),
             np.array([[0.5, -0.2], [-0.2, 1.2]]),
             np.array([[0.7, 0.0], [0.0, 0.3]])]
counts = [250, 150, 100]
X = np.vstack([rng.multivariate_normal(m, S, n)
               for m, S, n in zip(true_means, true_covs, counts)])
N, D = X.shape
K, reg = 3, 1e-6                               # reg: small covariance floor

# initialise with K random points, shared data covariance, equal weights
mu = X[rng.choice(N, K, replace=False)]
Sigma = np.array([np.cov(X.T) for _ in range(K)])
pi = np.full(K, 1.0 / K)
loglik = []
for it in range(200):
    # E step: log of pi_k N(x_n | mu_k, Sigma_k), normalised with log-sum-exp
    log_joint = np.column_stack([np.log(pi[k]) +
                                 multivariate_normal(mu[k], Sigma[k]).logpdf(X)
                                 for k in range(K)])
    log_norm = logsumexp(log_joint, axis=1)
    R = np.exp(log_joint - log_norm[:, None])     # responsibilities r_nk
    loglik.append(log_norm.sum())
    # M step: closed-form weighted updates
    Nk = R.sum(axis=0)
    pi = Nk / N
    mu = (R.T @ X) / Nk[:, None]
    for k in range(K):
        diff = X - mu[k]
        Sigma[k] = (R[:, k, None] * diff).T @ diff / Nk[k] + reg * np.eye(D)
    if it > 0 and loglik[-1] - loglik[-2] < 1e-8:
        break

assert np.all(np.diff(loglik) > -1e-6)           # EM never decreases log-likelihood
print("iterations:", len(loglik), " final mean log-lik:", round(loglik[-1] / N, 4))
print("weights:", np.round(np.sort(pi), 3))
gm = GaussianMixture(3, covariance_type="full", n_init=5, random_state=0).fit(X)
print("sklearn mean log-lik:", round(gm.score(X), 4))
print("sklearn weights:", np.round(np.sort(gm.weights_), 3))
輸出
iterations: 40  final mean log-lik: -3.4032
weights: [0.202 0.299 0.499]
sklearn mean log-lik: -3.4033
sklearn weights: [0.203 0.3   0.497]
E 步在對數空間中計算:高維的密度值會向下溢位,而 logsumexp 能穩定地計算 。估得的權重與生成比例 及 scikit-learn 的解相符;微小差異來自 scikit-learn 自己的停止容忍度。
選擇群數
白話版。 群越多,對訓練資料的擬合總是越好。模型選擇準則對每個多出來的參數收取代價,最佳的 在擬合與代價之間取得平衡。
混合模型的 BIC 與 AIC
對一個最大化似然為 、有 個自由參數、 個資料點的模型,
越小越好。貝氏資訊準則(Bayesian information criterion, BIC)[12] 來自對數邊際似然(模型證據,見 PR 08)的大樣本近似;赤池資訊準則(Akaike information criterion, AIC)[13] 估計的是預期的預測對數損失。由於 時 ,BIC 對複雜度的懲罰較重,傾向選擇較少的成分。
對 維、完整共變異數的 GMM,
在高維時共變異數占了大部分:當 (類似 SIFT 的描述子),每個完整共變異數有 個自由數值,這就是為什麼大型描述子通常使用對角共變異數。因此共變異數的形式也是模型選擇的一部分。
程式碼 · Python · 20 行
import numpy as np
from sklearn.datasets import make_blobs
from sklearn.mixture import GaussianMixture

X, _ = make_blobs(n_samples=600, centers=4, cluster_std=1.0, random_state=7)
X = X @ np.array([[1.0, 0.0], [0.6, 0.5]])        # shear: make clusters elliptical
results = []
for cov in ["spherical", "diag", "full"]:
    for K in range(1, 9):
        gm = GaussianMixture(K, covariance_type=cov, n_init=3, random_state=0).fit(X)
        results.append((gm.bic(X), gm.aic(X), cov, K))
for bic, aic, cov, K in sorted(results)[:5]:
    print(f"BIC={bic:8.1f}  AIC={aic:8.1f}  {cov:9s} K={K}")

# check the parameter count used by BIC for a full-covariance model
gm = GaussianMixture(4, covariance_type="full", random_state=0).fit(X)
D, K = X.shape[1], 4
p = (K - 1) + K * D + K * D * (D + 1) // 2
manual = -2 * gm.score(X) * len(X) + p * np.log(len(X))
print("free parameters:", p, " manual BIC:", round(manual, 1), " sklearn:", round(gm.bic(X), 1))
輸出
BIC=  4301.1  AIC=  4200.0  full      K=4
BIC=  4320.7  AIC=  4193.2  full      K=5
BIC=  4357.6  AIC=  4203.7  full      K=6
BIC=  4388.4  AIC=  4208.2  full      K=7
BIC=  4414.9  AIC=  4243.4  diag      K=8
free parameters: 23  manual BIC: 4301.1  sklearn: 4301.1
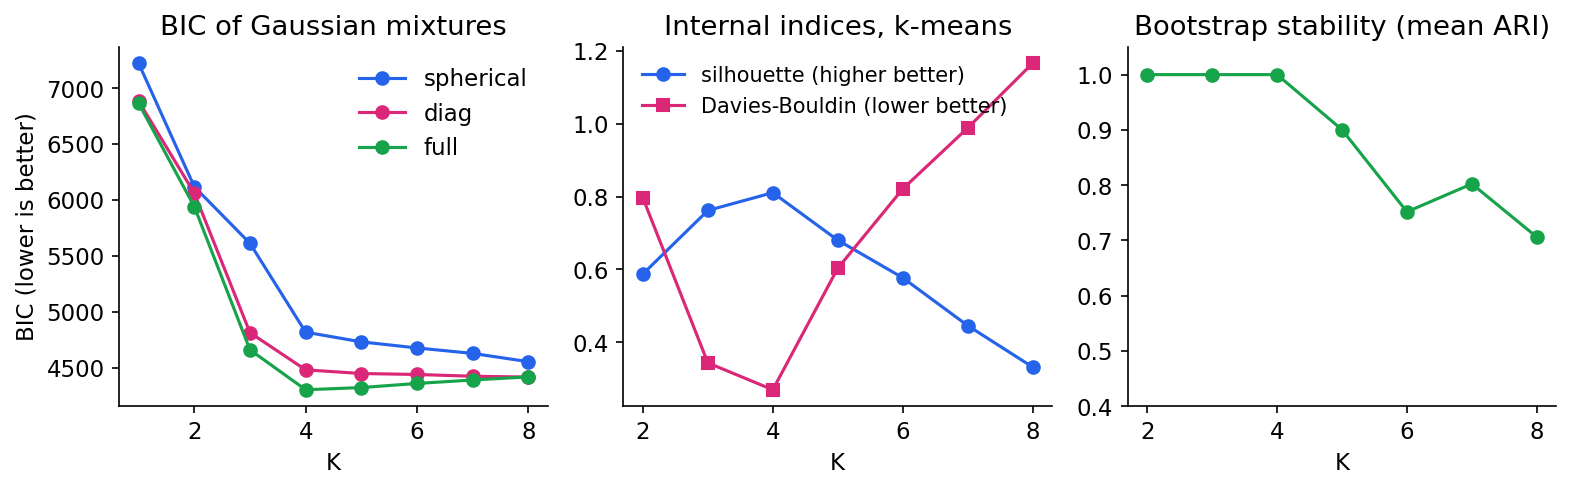
BIC 在完整共變異數下選出真正的 (剪切變換讓各群變成橢圓,所以球形與對角模型需要額外的成分)。AIC 稍微偏好 :它較輕的懲罰讓第五個成分可以用小小的似然增益「買」到位置。一般而言兩個準則都不是「正確」的;它們都假設模型族足夠合適,而對非高斯的群,BIC 會很樂意用好幾個高斯來描述一個彎曲的群。若目標是密度估計,這沒有問題;若每個成分應該對應一個語意群,就有問題了。
其他經驗法則
手肘法(elbow method)畫出 k-means 的 對 的曲線,尋找彎折處;但 總是遞減,彎折處的判斷很主觀。下一節的 silhouette 與穩定度方法提供了其他選擇。貝氏作法也可以先放比需要更多的成分,再讓混合權重上的先驗把不需要的成分關掉;Bishop 以變分高斯混合模型完整示範了這一點 [2]。
分群有效性:分群結果好不好?
白話版。 沒有標籤時,「好」必須先被定義:緊密且分得開(內部指標)、與某個可信的參考一致(外部指標),或在資料受擾動時能重現(穩定度)。Theodoridis 與 Koutroumbas 用第 16 章專門討論這些問題 [1];PR 09 會在監督式情境下回到驗證的議題。
內部指標
Silhouette [14]。對群 中的點 ,令 為它到 中其他點的平均距離, 為它到任何其他群各點平均距離中的最小值。則
接近 表示 穩穩位於所屬群內;接近 表示在邊界上;負值表示它可能被分錯群。所有點的平均 silhouette 概括了整個分割,而逐點的 silhouette 圖能指出哪些群比較弱。
Davies–Bouldin [15]。令 為群 各點到其質心 的平均距離,。則
也就是每一群與另一群之間「最壞情況相似度」的平均。越低越好。
Calinski–Harabasz [16]。以群間散佈 與群內散佈 ( 為整體平均),
這是一種變異數比統計量。越高越好。
這三個指標都偏好在所選幾何下緊密、凸、分得開的群。它們會給 k-means 在雙月形資料上的錯誤答案比正確的彎曲答案更高的分數。它們衡量的是與某種假設的群形狀是否一致,而不是語意上是否正確。
外部指標
當有參考標籤時(用於基準測試,或來自另外保留的標註),以對排列不變的指標比較分割。
調整蘭德指數(ARI) [17]。蘭德指數計算兩個分割在多少比例的點對上一致(同為「同一群」或同為「不同群」)。ARI 減去在群大小相同的隨機標記下的期望值,再重新縮放:
因此隨機分割的分數約為 ,(在重新編號下)完全相同的分割得 。
正規化互資訊(NMI)。把兩組標記 與 視為定義在點上的隨機變數,則
其中 為互資訊, 為熵(這裡示範的算術平均正規化是 scikit-learn 的預設,也有其他正規化方式)。Vinh、Epps 與 Bailey [18] 指出,當群數相對於 很大時,未調整的 NMI 會向上偏差,並建議使用經過機率校正的版本,例如調整互資訊(adjusted mutual information, AMI)。
如果參考標籤曾被用來調整演算法或 ,它們就不再是獨立的檢驗。
穩定度
在自助法樣本或擾動後的資料上重新分群,並在相同的點上以 ARI 比較新分割與原分割。產生不穩定分割的 值得懷疑。但穩定是必要條件而非充分條件:把兩團相近的資料合併是完全可重現的(圖 6 右,),而一個穩定的分割仍可能反映的是相機或光線等無關因素。
程式:有效性指標與穩定度
程式碼 · Python · 30 行
import numpy as np
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
from sklearn.metrics import (silhouette_score, davies_bouldin_score,
                             calinski_harabasz_score, adjusted_rand_score,
                             normalized_mutual_info_score)

X, truth = make_blobs(n_samples=600, centers=4, cluster_std=1.0, random_state=7)
print(" K  silhouette(+)  Davies-Bouldin(-)  Calinski-Harabasz(+)")
for K in range(2, 8):
    z = KMeans(K, n_init=10, random_state=0).fit_predict(X)
    print(f"{K:2d}  {silhouette_score(X, z):12.3f}  {davies_bouldin_score(X, z):17.3f}"
          f"  {calinski_harabasz_score(X, z):20.1f}")

z = KMeans(4, n_init=10, random_state=0).fit_predict(X)
print("external ARI:", round(adjusted_rand_score(truth, z), 3),
      " NMI:", round(normalized_mutual_info_score(truth, z), 3))
perm = np.array([2, 0, 3, 1])[z]                       # relabel clusters
print("ARI after relabelling:", round(adjusted_rand_score(truth, perm), 3))

# stability: refit on bootstrap samples, compare on the original points
rng = np.random.default_rng(1)
for K in [3, 4, 5, 6]:
    base = KMeans(K, n_init=10, random_state=0).fit(X)
    scores = []
    for b in range(10):
        idx = rng.integers(0, len(X), len(X))
        boot = KMeans(K, n_init=10, random_state=b).fit(X[idx])
        scores.append(adjusted_rand_score(base.predict(X), boot.predict(X)))
    print(f"K={K}: bootstrap stability (mean ARI) = {np.mean(scores):.3f}")
輸出
 K  silhouette(+)  Davies-Bouldin(-)  Calinski-Harabasz(+)
 2         0.588              0.796                 850.9
 3         0.762              0.343                2235.5
 4         0.811              0.270                7641.8
 5         0.680              0.603                6341.0
 6         0.577              0.821                5620.2
 7         0.446              0.988                5304.4
external ARI: 1.0  NMI: 1.0
ARI after relabelling: 1.0
K=3: bootstrap stability (mean ARI) = 1.000
K=4: bootstrap stability (mean ARI) = 1.000
K=5: bootstrap stability (mean ARI) = 0.858
K=6: bootstrap stability (mean ARI) = 0.699
在這些分得很開的團上,所有內部指標都同意 ,外部指標也確認不論群如何編號都完全吻合。真實資料很少這麼友善:各指標常常意見不一,而這種不一致本身就是資訊,它告訴你在所選尺度下,資料並沒有唯一明確的群結構。
現代觀點
白話版。 本章的演算法已有數十年歷史,至今仍無所不在。改變的是表示法:今天我們通常對學習得到的嵌入向量分群,而不是對原始像素或手工描述子;深度網路有時甚至是藉由分群來訓練的。
值得一讀的綜述
- Xu 與 Wunsch,“Survey of clustering algorithms”(2005) [19] 是從圖型識別與類神經網路觀點出發的經典廣泛綜述。它先回顧鄰近度量,再把演算法整理為階層式、平方誤差(k-means 家族)、混合密度、圖論、模糊、類神經(自組織映射、自適應共振理論)、核方法、序列資料、大規模與高維方法,最後討論分群有效性。它是古典分群領域的一張好地圖。
- Jain,“Data clustering: 50 years beyond K-means”(2010) [20] 是一篇較短、觀點鮮明的概論。它的主要訊息至今仍適用:沒有放諸四海皆準的最佳演算法;表示法與「群」的定義比演算法更重要;群數與有效性仍是開放問題;附加資訊(成對限制、半監督分群)與分群集成是有價值的方向。
- Ikotun 等人,“K-means clustering algorithms: A comprehensive review, variants analysis, and advances in the era of big data”(2023) [21] 回顧了眾多 k-means 變體:初始化(包括 k-means++)、自動選擇 、處理混合型或高維資料,以及可擴展與分散式的實作。
- Zhou 等人,“A comprehensive survey on deep clustering: Taxonomy, challenges, and future directions”(ACM Computing Surveys,2024) [22] 依「表示學習模組」與「分群模組」如何互動來整理深度分群:多階段方法(先學特徵再分群)、迭代方法(偽標籤與特徵學習交替進行)、生成式方法(如具混合先驗的自編碼器等潛在變數模型),以及同時最佳化方法(兩者聯合最佳化)。它也討論了基準、評估指標與應用。
- Ren 等人,“Deep clustering: A comprehensive survey”(IEEE TNNLS,2025) [23] 依資料來源與先驗知識整理此領域:單視角、半監督、多視角與遷移式深度分群。與 [22] 一起閱讀,可以看出深度分群的設計空間已變得多麼寬廣。
從視覺詞到自我標註
兩篇具影響力的視覺論文展示了古典分群如何變成訓練訊號。DeepCluster [24] 交替進行兩件事:對卷積網路的特徵執行 k-means,以及訓練該網路以群指派作為偽標籤來預測;在整個資料集上反覆進行,就能從無標籤影像學到有用的特徵。SCAN [25] 則把表示學習與分群分開:先用自監督的前置任務(pretext task)學特徵,再在該特徵空間中為每張影像找出最近鄰,訓練一個分群頭讓鄰居被分到同一群,最後以自我標註加以精煉。兩者都是把本章的概念(k-means 作為量化、鄰域作為相似性的證據)應用到學習得到的表示上;ML 06 說明了這些表示從何而來。
實務現況(2023–2026)與開放問題
在目前的實務中,為影像分組的常見作法是:從預訓練(通常是自監督)的編碼器取得嵌入向量,視需要降維,再執行 k-means、高斯混合或 HDBSCAN,並在一小部分已標註資料上驗證。本章的提醒依然完全適用:
- 表示法定義了相似性。 為某個目的訓練的嵌入向量,可能依風格、背景或相機分群,而不是依你在意的類別。
- 與有效性仍是開放問題。 資訊準則假設了模型族;內部指標假設了形狀;外部指標需要標籤。上述綜述沒有任何一篇宣稱有通用解法。
- 深度分群的評估通常仰賴有標籤的基準,以及對排列不變的分數,例如把群與類別做最佳配對後的分群準確率、NMI 與 ARI [22]。這些分數衡量的是與某一種選定標記的一致程度,而不是「真正的」結構。
- 規模與不平衡。 長尾資料、大量小群與串流資料,同時考驗古典與深度方法;[21] 與 [22] 都把它們列為活躍的研究問題。
重點整理
- 分群由它的相似性概念所定義。特徵、尺度與距離是在任何演算法執行前就做出的建模決策。
- K-means(Lloyd)交替進行最近中心指派與平均更新; 單調下降至局部最小值。k-means++ 播種給出 ,並大幅減少糟糕的結果;但仍應多次重新啟動。
- 連結方式定義了階層式分群:single linkage 會沿著細橋串接,complete 與 Ward 偏好緊密的群。樹狀圖仍然需要被切開。
- DBSCAN 把群定義為密度相連的區域,能找出任意形狀並標出雜訊; 由 k 距離曲線決定,HDBSCAN 能處理不同的密度。
- 高斯混合模型的 EM 由完整資料對數似然推出:E 步計算責任值,M 步計算加權平均與共變異數,並以拉格朗日乘數得到 。ELBO 分解證明了單調改善;奇異解與標籤交換需要明確處理;k-means 是硬指派、等向的極限。
- BIC 與 AIC 在擬合與參數數量之間取捨;共變異數形式也是選擇的一部分。
- 內部指標(silhouette、Davies–Bouldin、Calinski–Harabasz)獎勵某種假設的幾何;外部指標(ARI、NMI)需要獨立的標籤;穩定度是必要但不充分的條件。
練習
- Lloyd 演算法不會增加 。 證明指派步驟與更新步驟都不會增加 ,並據此論證演算法一定會停止。如果平手時隨機決定,終止論證哪裡會出問題?
提示
指派步驟分別最小化每一項 ;更新步驟利用 。分割最多有 種。若平手時隨機決定,兩個 相等的分割可能永遠來回切換;固定規則(例如平手時留在目前的群)可以避免。
- 手算 k-means++。 一維資料為 ,,第一個種子為 。計算每個點成為第二個種子的機率,並與均勻抽樣第二個種子比較。
提示
值為 ,總和 。因此 、,合計約 。若均勻抽樣,第二個種子落在右側那一群的機率只有 (若排除第一個種子則為 )。
- 一維混合模型的 M 步。 對變異數為 的一維兩成分混合,不用矩陣微積分,直接從 推導 的 M 步更新。接著證明若某成分的責任值集中在單一點 上(該點 、其餘點 ),更新會把 推向 。scikit-learn 的
reg_covar怎麼處理這件事?
提示
對 關於 微分,得到 。若所有權重都在同一點上,,總和為零。reg_covar 在每次 M 步後於對角線加上一個小常數,讓變異數不會趨近於零。
- 計算參數數量。 對 的局部描述子與 個成分,分別計算完整、對角與球形共變異數 GMM 的自由參數數量。若有 個描述子,各情況的 BIC 懲罰 有多大?
提示
完整:。對角:。球形:。再乘上 。完整模型必須讓 比對角模型改善大約 才能打平。
- 當指標誤導你。 在比較程式的雙月形資料上,以 執行 k-means 並執行 DBSCAN。計算兩個分割的 silhouette 分數,以及它們相對於生成標籤的 ARI。用各指標衡量的內容解釋兩者的分歧。
提示
Silhouette 以歐氏距離計算,偏好凸且分得開的群,因此 k-means 的切法通常比兩個月形得到更高分,儘管它的 ARI 約為 0.26,而 DBSCAN 為 1.0。內部指標隱含了形狀假設;這裡的「正確」答案是由連通性定義的。
- 穩定不等於真相。 產生四團高斯資料,其中兩團非常接近(例如中心為 與 ,標準差 )。計算 與 的自助法穩定度。哪一個比較穩定?哪一個符合生成過程?還需要什麼額外資訊才能下定論?
提示
把相近的兩團合併是非常可重現的,因此 的穩定度可能與 一樣高甚至更高。生成過程有四群,但它們是否應該被分開取決於任務。領域知識、一小部分已標註資料,或以 GMM 的 BIC 這類以密度為基礎的準則,都能提供額外證據。
參考文獻
-
S. Theodoridis and K. Koutroumbas, Pattern Recognition, 4th ed., Academic Press, 2009, Ch. 11–16 (clustering basic concepts, sequential, hierarchical, function-optimization and graph-based algorithms, cluster validity). doi
-
C. M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006, Ch. 9 (k-means, mixtures of Gaussians, EM, the general EM algorithm). book page
-
S. P. Lloyd, “Least squares quantization in PCM,” IEEE Transactions on Information Theory, vol. 28, no. 2, pp. 129–137, 1982. doi
-
J. MacQueen, “Some methods for classification and analysis of multivariate observations,” in Proc. Fifth Berkeley Symposium on Mathematical Statistics and Probability, vol. 1, pp. 281–297, 1967. Project Euclid
-
D. Arthur and S. Vassilvitskii, “k-means++: The advantages of careful seeding,” in Proc. 18th Annual ACM-SIAM Symposium on Discrete Algorithms (SODA), 2007, pp. 1027–1035. pdf
-
D. Sculley, “Web-scale k-means clustering,” in Proc. 19th International Conference on World Wide Web (WWW), 2010, pp. 1177–1178. doi
-
J. H. Ward, “Hierarchical grouping to optimize an objective function,” Journal of the American Statistical Association, vol. 58, pp. 236–244, 1963. doi
-
M. Ester, H.-P. Kriegel, J. Sander and X. Xu, “A density-based algorithm for discovering clusters in large spatial databases with noise,” in Proc. 2nd International Conference on Knowledge Discovery and Data Mining (KDD), 1996. pdf
-
R. J. G. B. Campello, D. Moulavi and J. Sander, “Density-based clustering based on hierarchical density estimates,” in Advances in Knowledge Discovery and Data Mining (PAKDD), LNCS, 2013, pp. 160–172. doi
-
U. von Luxburg, “A tutorial on spectral clustering,” Statistics and Computing, vol. 17, pp. 395–416, 2007. doi
-
A. P. Dempster, N. M. Laird and D. B. Rubin, “Maximum likelihood from incomplete data via the EM algorithm,” Journal of the Royal Statistical Society: Series B, vol. 39, no. 1, pp. 1–22, 1977. doi
-
G. Schwarz, “Estimating the dimension of a model,” The Annals of Statistics, vol. 6, no. 2, 1978. doi
-
H. Akaike, “A new look at the statistical model identification,” IEEE Transactions on Automatic Control, vol. 19, no. 6, pp. 716–723, 1974. doi
-
P. J. Rousseeuw, “Silhouettes: A graphical aid to the interpretation and validation of cluster analysis,” Journal of Computational and Applied Mathematics, vol. 20, pp. 53–65, 1987. doi
-
D. L. Davies and D. W. Bouldin, “A cluster separation measure,” IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. PAMI-1, no. 2, pp. 224–227, 1979. doi
-
T. Caliński and J. Harabasz, “A dendrite method for cluster analysis,” Communications in Statistics, vol. 3, no. 1, pp. 1–27, 1974. doi
-
L. Hubert and P. Arabie, “Comparing partitions,” Journal of Classification, vol. 2, pp. 193–218, 1985. doi
-
N. X. Vinh, J. Epps and J. Bailey, “Information theoretic measures for clusterings comparison: Variants, properties, normalization and correction for chance,” Journal of Machine Learning Research, vol. 11, pp. 2837–2854, 2010. JMLR
-
R. Xu and D. Wunsch II, “Survey of clustering algorithms,” IEEE Transactions on Neural Networks, vol. 16, no. 3, pp. 645–678, 2005. doi
-
A. K. Jain, “Data clustering: 50 years beyond K-means,” Pattern Recognition Letters, vol. 31, no. 8, pp. 651–666, 2010. doi
-
A. M. Ikotun, A. E. Ezugwu, L. Abualigah, B. Abuhaija and J. Heming, “K-means clustering algorithms: A comprehensive review, variants analysis, and advances in the era of big data,” Information Sciences, vol. 622, pp. 178–210, 2023. doi
-
S. Zhou, H. Xu, Z. Zheng, J. Chen, Z. Li, J. Bu, J. Wu, X. Wang, W. Zhu and M. Ester, “A comprehensive survey on deep clustering: Taxonomy, challenges, and future directions,” ACM Computing Surveys, vol. 57, no. 3, pp. 1–38, 2024 (arXiv:2206.07579). doi
-
Y. Ren, J. Pu, Z. Yang, J. Xu, G. Li, X. Pu, P. S. Yu and L. He, “Deep clustering: A comprehensive survey,” IEEE Transactions on Neural Networks and Learning Systems, vol. 36, no. 4, pp. 5858–5878, 2025 (arXiv:2210.04142). doi
-
M. Caron, P. Bojanowski, A. Joulin and M. Douze, “Deep clustering for unsupervised learning of visual features,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2018, pp. 139–156. doi
-
W. Van Gansbeke, S. Vandenhende, S. Georgoulis, M. Proesmans and L. Van Gool, “SCAN: Learning to classify images without labels,” in Proc. European Conference on Computer Vision (ECCV), LNCS, 2020, pp. 268–285. doi
-
scikit-learn developers, “GaussianMixture,” API documentation, accessed 2026-11-05. documentation
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 PR 08・近似推論與貝氏模型複雜度 · 25 分鐘