ML 01C・數值計算與梯度檢查
先備知識:ML 01B・機率與資訊理論
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分浮點數的範圍與精度。
- 改寫損失與正規化公式,避免數值失敗。
- 區分問題的條件性與演算法的穩定性。
- 用梯度與曲率理解最佳化及限制條件。
- 檢查導數,並驗證混合精度運算。
先看全貌
機器學習用實數的語言寫成,但電腦沒有真正的實數。它只有有限個浮點數,每一次算術運算都會把結果捨入到其中一個。大多數時候這種捨入看不見;有時卻是災難:指數溢位成無限大、極小的機率變成剛好 0 而它的對數變成負無限大,或是兩個幾乎相等的數相減,絕大部分有效位數就此消失。
故事的另一半是最佳化。訓練模型就是最小化一個有數百萬甚至數十億個參數的函數,而我們只能用數值方法做到:依照導數的指引走很多小步。這些步伐前進得多快、多可靠,取決於損失曲面的形狀(斜率與曲率),也取決於我們怎麼走。本篇以 Goodfellow、Bengio 與 Courville 的「Numerical Computation」一章 [1] 為骨架,補上現代低精度訓練所依賴的浮點細節,並用小型 NumPy 實驗串起每個概念。
如果 softmax 與交叉熵對你還很陌生,請先讀 ML 01B;特徵值與奇異值分解則可隨時回頭參考 ML 01A。之後的 ML 02 會用到本篇的所有內容來訓練神經網路。
浮點數
白話版。 浮點數儲存符號、有效數與指數;正規數的相對間距大致固定,次正規範圍接近零時則惡化。
浮點數如何儲存
IEEE 754 標準 [3] 定義了幾乎所有 CPU 與 GPU 使用的二進位浮點格式。一個正規(非特殊值)數字儲存為
其中 是正負號位元, 是有效數(significand)中儲存的 個小數位元(開頭的 1 是隱含的), 是限制在固定範圍內的整數指數。最重要的兩個數:
- 機器 epsilon :1 與下一個可表示的較大數之間的間距。
- 單位捨入誤差(unit roundoff):「捨入到最近值」的相對誤差上界。對正規範圍內的任意實數 ,儲存值為 ,且 。
標準也要求每個基本運算()都像先精確計算再捨入一次那樣:,。這條規則就是捨入誤差分析的基礎 [2]、[4]。
比最小正規數更小的範圍,格式改用次正規數(subnormal),犧牲前導精度、讓數值逐步降到 0。特殊值則補足整體:結果太大時為 ;無效運算如 、、 則得到 NaN(not a number)。NaN 一旦出現,幾乎所有碰到它的運算都會回傳 NaN,這就是為什麼單一個壞值就能毀掉整次訓練。
你會遇到的四種格式
下表以 numpy.finfo 計算(bfloat16 因 NumPy 不支援,改用 torch.finfo)。「位元」欄列出正負號/指數/小數位元數。
| 格式 | 位元 | 最大有限值 | 最小正規數 | 最小次正規數 | |
|---|---|---|---|---|---|
| float16(IEEE 半精度) | 1/5/10 | ||||
| bfloat16 | 1/8/7 | ||||
| float32(單精度) | 1/8/23 | ||||
| float64(雙精度) | 1/11/52 |
這張表要從兩個方向讀。指數位元決定範圍:float16 超過 65504 就溢位,而 bfloat16 保留了 float32 的 8 個指數位元,所以範圍與 float32 相同。小數位元決定精度:float32 約有 7 位有效十進位數字,float64 約 16 位,float16 約 3 位,bfloat16 只有約 2 位。bfloat16「範圍寬、精度粗」與 float16「範圍窄、精度較細」的取捨,正是兩種半精度格式需要不同訓練做法的原因(見後文混合精度一節與 [5]、[12])。
程式碼 · Python · 15 行
import numpy as np

for dtype in (np.float16, np.float32, np.float64):
    info = np.finfo(dtype)
    print(f"{info.dtype}: eps={float(info.eps):.3e}  max={float(info.max):.3e}  "
          f"tiny={float(info.tiny):.3e}  subnormal={float(info.smallest_subnormal):.3e}")

# Rounding: 1 + eps/2 rounds back to 1 in float32
e = np.finfo(np.float32).eps
print(np.float32(1) + np.float32(e/2) == np.float32(1))   # True
print(np.float32(1) + np.float32(e) == np.float32(1))     # False

# Addition is not associative
a, b, c = np.float32(1e8), np.float32(-1e8), np.float32(1.0)
print((a + b) + c, a + (b + c))                           # 1.0 0.0
最後一行值得停下來想。精確算術下兩種順序都得到 1;但在 float32 中, 附近相鄰浮點數的間距是 8,所以 會捨入回 ,那個 1 就不見了。實務上的後果是:用不同順序加總同一組數字(例如換了 GPU 數量,或換了歸約〔reduction〕核心),最後幾位數就可能不同。這是每次執行結果不完全一致的主要來源之一,而且不是你程式的錯 [13]。
溢位、下溢與消去
白話版。 溢位是結果大到存不下;下溢是結果小到變成 0(或以次正規數形式失去精度)。消去(cancellation)是兩個幾乎相等的數相減:捨入誤差留了下來,真正的訊號卻被丟掉。
溢位與下溢
在機器學習中,最常見的元兇是指數函數。只要 , 就超過 float32 的最大值,因此 logit 為 100 時在 float32 中會溢位(在 float16 中,logit 約 11.1 就會溢位,因為 )。另一方向, 比 float32 最小的次正規數還小,結果剛好是 0。這兩種情況預設都不會報錯,只會產生 inf 與 0,而下一個運算就把它們變成 nan 或 。
程式碼 · Python · 19 行
import numpy as np

with np.errstate(over="ignore", under="ignore", invalid="ignore"):
    print(np.exp(np.float32(100.0)))        # inf: overflow
    print(np.exp(np.float32(-110.0)))       # 0.0: underflow
    big = np.exp(np.float32(100.0))
    print(big / big)                        # nan: inf / inf

# Catastrophic cancellation and its cure
x = 1e-10
print(np.log(1 + x), np.log1p(x))           # roundoff vs accurate
print(np.exp(x) - 1, np.expm1(x))

# Variance: the one-pass formula cancels badly when the mean is large
rng = np.random.default_rng(0)
data = (1e4 + rng.normal(0, 1, 100_000)).astype(np.float32)
one_pass = np.mean(data**2) - np.mean(data)**2
two_pass = np.mean((data - data.mean())**2)
print("one-pass:", one_pass, " two-pass:", two_pass)
在這台機器上,單趟(one-pass)變異數得到 ——負的變異數——而雙趟(two-pass)公式給出正確的約 1.0。資料平均值為 、變異數為 1,所以 、;在這個量級上 float32 只能分辨約 8 的差異,真正的差值 1 完全淹沒在雜訊裡。
為什麼減法是危險的運算
假設 、 的儲存相對誤差滿足 。即使減法本身是精確的,
其中 是真實值, 是單位捨入誤差。當 時,因子 非常大:減法並沒有製造誤差,而是把兩數共有的位數消掉,暴露出輸入原本就帶有的誤差。解法是代數上的:改寫公式,讓這個減法根本不發生。你會用到的例子:
log1p(x)計算 、expm1(x)計算 ,在 很小時都很精確,天真寫法則幾乎失去所有位數(見上方輸出)。- 變異數:先減去平均值(雙趟),或使用 Welford 的串流更新。
- Softmax 與 log-sum-exp:先減去最大值,下一節說明。
- 距離: 很快,但在 時嚴重消去;需要精確時,把結果截在 0 以上,或直接計算 。
穩定的 softmax 與 log-sum-exp
白話版。 取指數前先減去一個共同常數;對數機率要直接計算,而不是先產生極小的機率再取對數。
Softmax 把 logit 向量 轉成機率:
把同一個常數 加到每個 logit 上,softmax 不變,因為因子 在分子與分母間抵銷。取 ,其中 :
現在每個指數都 ,不會溢位;最大的一項剛好是 ,所以分母至少為 1,也不會下溢成 0。同樣的技巧也能穩定 log-sum-exp 函數:
LSE 是最大值的平滑版本:;它的梯度恰好就是 softmax,。
對目標類別 ,交叉熵損失為 ,它對 logit 的梯度是那個著名的簡單形式 ,其中 是目標的 one-hot 向量。先算 softmax 再取 log 仍可能失敗:若 下溢成 0,它的對數就是 ,即使 是個完全正常的有限數。這就是框架提供接受 logit 的融合函數 log_softmax 與 cross_entropy 的原因。
程式:會讓天真指數運算溢位的 logit
這個獨立的 NumPy 範例檢查穩定的機率、對數機率,以及平移 logit 的不變性。
程式碼 · Python · 18 行
import numpy as np

def logsumexp(z):
    m = np.max(z)
    return m + np.log(np.exp(z-m).sum())
def logsoftmax(z):
    return z-logsumexp(z)

z = np.array([1000., 1001., 999.], dtype=np.float64)
logp = logsoftmax(z)
p = np.exp(logp)
assert np.allclose(p.sum(), 1)
assert np.allclose(logsoftmax(z+12345), logp)
print("probabilities:", p)
print("cross-entropy for class 1:", -logp[1])
with np.errstate(over="ignore", invalid="ignore"):
    naive = np.exp(z) / np.exp(z).sum()
print("naive softmax:", naive)
穩定版輸出機率 ,類別 1 的交叉熵為 nats;天真版輸出 [nan nan nan],因為 即使在 float64 也會溢位(float64 的上限是 )。
穩定的 logistic(二元交叉熵)損失
二元分類以另一種形式遇到同樣的問題。設 logit 為 、標籤 、sigmoid 為 ,損失 可化簡為
右邊的寫法從不對正數取指數,log1p 則讓小修正項保持精確。請優先使用 binary_cross_entropy_with_logits,不要自己先算 sigmoid 再取對數。
程式碼 · Python · 15 行
import numpy as np

def bce_naive(z, y):
    s = 1 / (1 + np.exp(-z))
    return -(y*np.log(s) + (1-y)*np.log(1-s))

def bce_stable(z, y):
    # softplus(z) - y*z, with softplus(z) = max(z,0) + log1p(exp(-|z|))
    return np.maximum(z, 0) + np.log1p(np.exp(-np.abs(z))) - y*z

z = np.array([-800., -30., 0., 30., 800.])
y = np.array([1., 1., 0., 0., 0.])
with np.errstate(over="ignore", divide="ignore", invalid="ignore"):
    print("naive :", bce_naive(z, y))
print("stable:", bce_stable(z, y))天真版對兩個「信心十足的錯誤」()回傳 inf,在 時回傳 而非 ,因為 是靠消去算出來的。穩定版回傳 、、、、,全部正確。
條件不良
白話版。 有些問題天生敏感:輸入的微小改變會造成答案的巨大改變,不論你算得多小心。條件數(condition number)就是衡量這種敏感度的量。
線性系統的條件數
考慮對可逆方陣 解 。若資料變成 ,解變成 ,則
其中 是歐氏向量範數及其誘導矩陣範數, 是 的最大與最小奇異值。對稱正定矩陣的奇異值等於特徵值,因此 。一般可逆矩陣不能只靠特徵值比值判斷條件數;應使用奇異值,如 NumPy 的預設 cond 計算方式 [23]。大條件數表示誤差可能被強烈放大,實際誤差仍取決於擾動方向 [4]。
程式碼 · Python · 15 行
import numpy as np

A = np.array([[1.0, 1.0],
              [1.0, 1.0001]])
print("condition number:", np.linalg.cond(A))

b = np.array([2.0, 2.0001])
x = np.linalg.solve(A, b)
db = np.array([0.0, 0.0001])                 # tiny change in the data
x2 = np.linalg.solve(A, b + db)
rel_in = np.linalg.norm(db) / np.linalg.norm(b)
rel_out = np.linalg.norm(x2 - x) / np.linalg.norm(x)
print("x:", x, " x after perturbation:", x2)
print(f"relative change in b: {rel_in:.1e}, in x: {rel_out:.1e}, "
f"amplification: {rel_out/rel_in:.0f}")的兩欄幾乎相同,; 只有 的相對改變,解卻從 移到 ——百分之百的改變,放大約 28,000 倍,仍在 的上界之內。沒有任何計算出錯,是這個問題本身條件不良。
條件不良的問題 vs. 不穩定的演算法
請把兩個概念分開:
- 條件不良的問題會放大輸入的小變化。任何演算法都無法修正;你需要更好的資料、正則化(它改變了問題)或重新表述問題。
- 不穩定的演算法會替一個可能條件良好的問題加入可避免的誤差。天真的 softmax 與單趟變異數就是不穩定的演算法,換演算法就能解決。
最小平方法同時展示兩者。如果特徵幾乎共線,係數本身就是條件不良的(問題)。解正規方程 會讓情況比必要的更糟,因為 (演算法);基於 QR 或 SVD 的求解器則直接處理 。Ridge 迴歸加入 ,把問題改成 ,其條件數 較小——ML 01A 會進一步發展這個主題。
以梯度為基礎的最佳化
白話版。 要最小化一個函數,就看它的斜率、往下坡走。梯度指向上升最陡的方向,所以往反方向走;步伐要夠小,讓你剛量到的斜率大致仍然有效。
導數、梯度與方向導數
我們要最小化目標函數(也稱成本、損失或誤差函數)。單變數時,導數 給出一階近似 ,所以往 的反號方向走一小步就能讓 下降。多變數時,梯度 收集所有偏導數 。單位方向 上的方向導數是沿 的斜率:
其中 是 與梯度的夾角。當 ,也就是 指向 時,它最負。這就是最陡下降法,也就是梯度下降:
其中 是學習率(步長)。 可以取一個小常數、可以試幾個值並保留目標函數最低者(線搜尋,line search),也可以依照排程變化。當梯度的每個分量都(接近)0 時,梯度下降就收斂了。
臨界點:極小值、極大值與鞍點
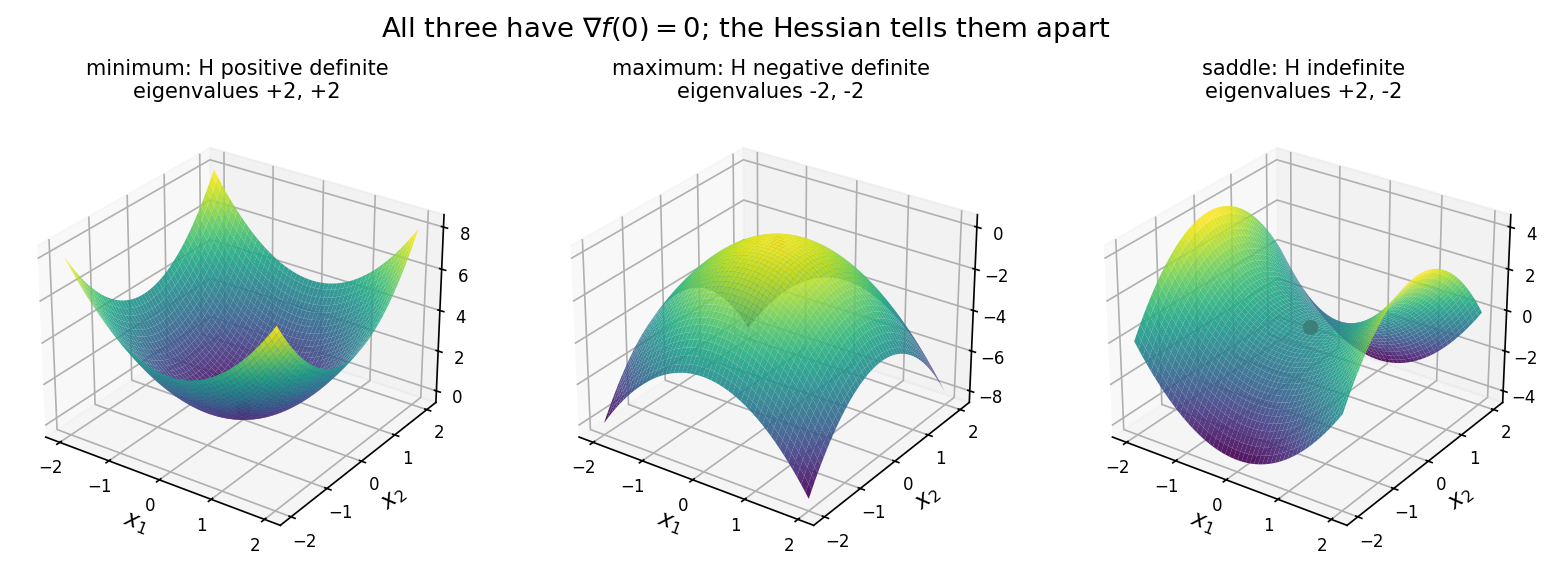
滿足 的點稱為臨界點或駐點。局部極小值比所有鄰近點都低,局部極大值比所有鄰近點都高,鞍點兩者皆非:它沿某些方向是極小、沿另一些方向是極大。全域極小值是整個定義域上的最低值;一個函數可能有好幾個全域極小值,也可能有許多不是全域極小的局部極小值。
對深度網路,我們很少找到真正的全域極小值,也不需要;只要參數讓損失夠低而且泛化良好就行。在高維空間中,對許多「類隨機」函數而言,鞍點比差勁的局部極小值更常見,而且因為梯度在鞍點附近變小,它們會拖慢以梯度為基礎的最佳化器 [8]。圖 1 顯示三種臨界點。
Jacobian 與 Hessian 矩陣
白話版。 Jacobian 收集向量值函數的所有一階導數。Hessian 收集純量函數的所有二階導數:它告訴你斜率本身如何變化,也就是曲率。
定義
對函數 ,Jacobian 矩陣 的元素為
第 列是輸出 的梯度。反向傳播就是不斷乘上 Jacobian;反向模式自動微分計算向量–Jacobian 乘積 ,卻從不顯式建出 ,這就是為什麼一次梯度的成本只是一次函數求值的小常數倍 [11]。
對純量函數 ,Hessian 矩陣 是梯度的 Jacobian:
只要二階偏導數連續,微分順序就不影響結果,所以 :Hessian 是對稱矩陣。實對稱矩陣有實數特徵值 與一組正交歸一的特徵向量 。沿單位方向 的二階方向導數是 。若 是特徵向量 ,它等於 ;其他方向則是特徵值的加權平均 ,權重介於 0 與 1 之間且總和為 1。所以 是任一方向上的最大曲率, 是最小曲率。
一步梯度到底做了什麼:二階泰勒展開
令 、。在 附近的二階泰勒近似為
代入一步梯度 得到
三項分別是目前的值、斜率預測的改善量,以及曲率的修正。若 , 越大,近似值就越小(直到近似本身失效為止)。若 ,曲率項最終會勝出,近似值在下式取得最小:
最壞情況下 與 的特徵向量同向,此時 。曲率大,就只能走小步。
二階導數檢定
在臨界點(),泰勒展開只剩二次項,所以由 Hessian 決定這是哪一種點:
- 正定(所有 ):局部極小值。
- 負定(所有 ):局部極大值。
- 至少有一個正特徵值與一個負特徵值:鞍點。
- 其他情況(有些 ,其餘同號):檢定無法判斷。
一維中不可能有鞍點;但在 維中,只要有一個特徵值的符號「不對」就是鞍點,所以隨著 變大,鞍點變得非常普遍 [8]。
Hessian 的條件數:梯度下降為何鋸齒前進
在二次函數 ( 對稱正定)上,梯度下降是線性的:。把 用 的特徵向量展開,沿 的分量每一步都乘上 。因此:
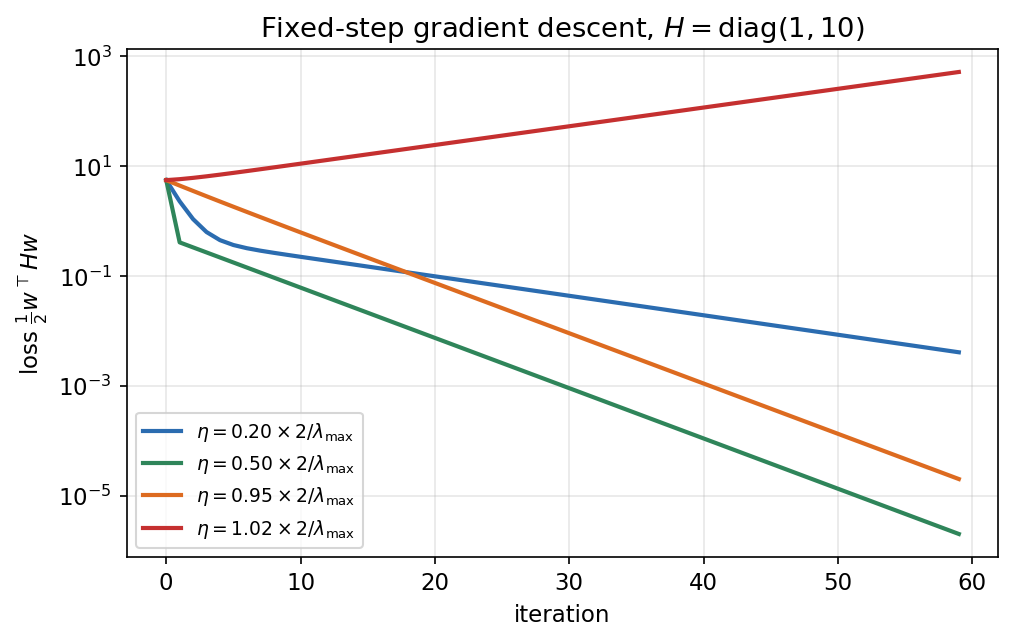
- 只有當每個 都滿足 ,也就是 時,迭代才穩定。
- 最慢的是平坦方向,每步只縮小 倍。
- 最佳固定步長 讓誤差每步縮小 倍,其中 是 Hessian 的條件數。
所以條件數大,表示某個方向要求極小的步伐(否則發散),另一個方向卻需要很多步才有進展。梯度下降把時間浪費在狹窄山谷的陡峭兩壁間來回彈跳——圖 2 中的鋸齒——同時沿著谷底緩慢前進。輸入特徵尺度不一致正好造成這種情況,這也是標準化與正規化層能加快訓練的原因之一。
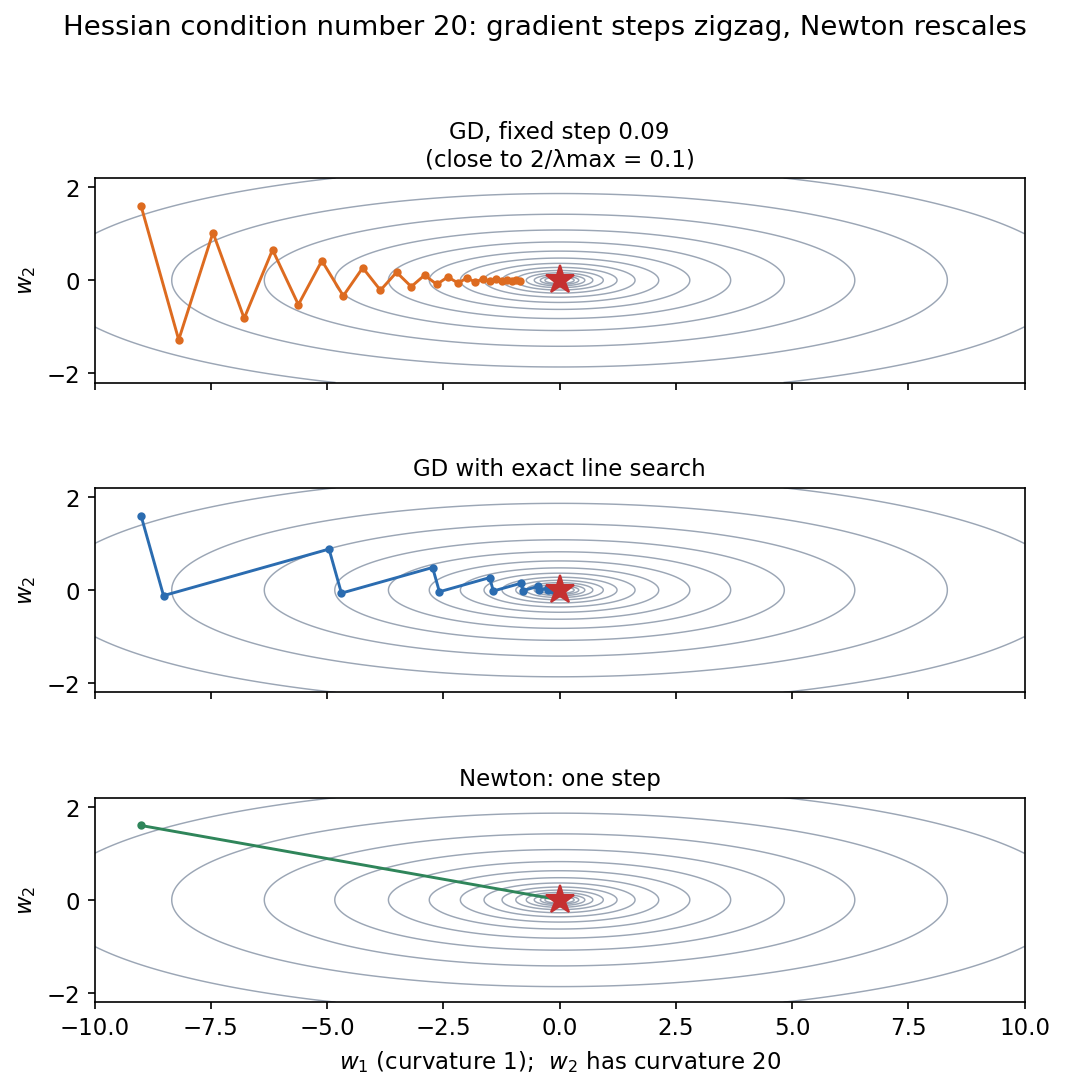
圖 3 以數值呈現穩定極限。低於 時損失下降;稍高於極限時,陡峭分量每步放大 倍,損失隨之爆炸。
程式碼 · Python · 25 行
import numpy as np

H = np.diag([1.0, 25.0])                     # Hessian: condition number 25
f = lambda w: 0.5 * w @ H @ w
grad = lambda w: H @ w

def run_gd(eta, steps=50):
    w = np.array([10.0, 1.0])
    for _ in range(steps):
        w = w - eta * grad(w)
    return f(w)

lam_max = np.linalg.eigvalsh(H).max()
for eta in (0.01, 0.07, 0.079, 0.081):       # stability limit 2/25 = 0.08
    print(f"eta={eta:<6} loss after 50 steps: {run_gd(eta):.3e}")

# Exact line search along -g for a quadratic: eps* = g'g / g'Hg
w = np.array([10.0, 1.0])
g = grad(w)
eps_star = (g @ g) / (g @ H @ g)
print("optimal step along the gradient:", round(eps_star, 4))

# One Newton step lands on the minimizer of a quadratic
w_newton = w - np.linalg.solve(H, g)
print("after one Newton step:", w_newton)
輸出說明了一切: 穩定但慢(50 步後損失 ), 降到 , 勉強穩定但陡峭分量仍在振盪(損失約 ), 發散(損失 )。沿第一個梯度的最佳步長是 ,而一步牛頓法正好落在 。
二階方法
白話版。 牛頓法利用曲率重新縮放梯度,在條件良好的極小值附近可能有幫助;不定曲率則可能給出不良方向。
牛頓法
令二階泰勒近似的梯度為零,得到牛頓步:
在正定二次函數上,這一步直接跳到極小值(圖 2 下)。對局部接近正定二次函數的一般函數,反覆套用這個更新比梯度下降收斂快得多——在標準假設下,於解附近呈二次收斂 [6]。代價是 Hessian:儲存它需要 記憶體,用它求解需要 時間,對一個有 個參數的網路根本不可能。
對非凸目標還有更根本的問題。牛頓法找的是梯度為零的點,它對待鞍點和極小值一視同仁:在鞍點附近,牛頓步會指向鞍點。在充滿鞍點的地形上,單純的牛頓法正好被我們想逃離的點吸引。Dauphin 等人提出「saddle-free Newton」,改用 Hessian 特徵值的絕對值來縮放,以避免這個問題 [8]。相對地,梯度下降不會以同樣方式被鞍點吸引,雖然它在鞍點附近可能走得很慢。
擬牛頓法與 L-BFGS
擬牛頓法(quasi-Newton)只用梯度建立 (或其反矩陣)的近似。走了一步 、梯度變化為 之後,它要求割線條件 ,意思是模型沿這一步的曲率要與觀察到的斜率變化一致。BFGS 是這類更新中最常用的;L-BFGS(有限記憶 BFGS)只保存最近 組 ,以 時間隱式套用反 Hessian 的近似 [6]、[10]。L-BFGS 很適合平滑、確定性、中等規模的問題(logistic 迴歸、單張影像的風格轉換、擬合幾千個參數);但當梯度是有雜訊的小批次估計時,它的曲率估計會受影響。
Hessian–向量乘積
許多利用曲率的方法其實不需要 本身,只需要乘積 。這可以用大約幾次梯度計算的成本精確算出,因為 是某個純量的梯度;Pearlmutter 說明了如何用自動微分做到 [9]。有限差分版本 是很實用的檢查。以 Hessian–向量乘積做冪迭代(power iteration)可以估計 ,研究者正是用這個方法追蹤訓練中損失的尖銳度(sharpness)。
程式碼 · Python · 21 行
import numpy as np

rng = np.random.default_rng(0)
X = rng.normal(size=(50, 4))
y = (rng.random(50) < 0.5).astype(float)

def grad(w):                                   # logistic regression, mean loss
    p = 1 / (1 + np.exp(-(X @ w)))
    return X.T @ (p - y) / len(y)

def hessian(w):
    p = 1 / (1 + np.exp(-(X @ w)))
    return (X.T * (p * (1 - p))) @ X / len(y)

w = rng.normal(size=4)
v = rng.normal(size=4)
r = 1e-5
hvp_fd = (grad(w + r*v) - grad(w - r*v)) / (2*r)   # never forms H
print("Hv (finite diff):", hvp_fd.round(6))
print("Hv (explicit)   :", (hessian(w) @ v).round(6))
print("eigenvalues of H:", np.linalg.eigvalsh(hessian(w)).round(4))
兩種乘積在小數點後六位都相同,而且 Hessian 的特徵值全為正:logistic 迴歸是凸的,它的 Hessian 處處半正定。
Lipschitz 連續與凸性
深度學習的目標函數幾乎沒有什麼保證,但有兩個性質能解釋大部分理論。若對所有 都有 ,則函數是常數為 的 Lipschitz 連續:它的變化率有上界。若梯度是 -Lipschitz(函數「-平滑」),曲率就以 為上界,而步長 的梯度步保證不會讓函數變大:
這是前面「」規則的一般形式,也是大多數收斂證明的起點 [7]、[14]。
若函數(二次可微時)的 Hessian 處處半正定,它就是凸函數。凸函數沒有鞍點,也沒有虛假的局部極小值:每個局部極小值都是全域極小值。最小平方、logistic 迴歸與支援向量機都是凸的;深度網路不是。凸最佳化是許多工具的來源,例如對偶性與下面的 KKT 條件,深度學習也借用了它們 [7]。
有限制條件的最佳化
白話版。 限制條件界定可接受的解;投影把更新帶回可行域,拉格朗日乘數則描述限制如何進入最佳性條件。
投影梯度下降
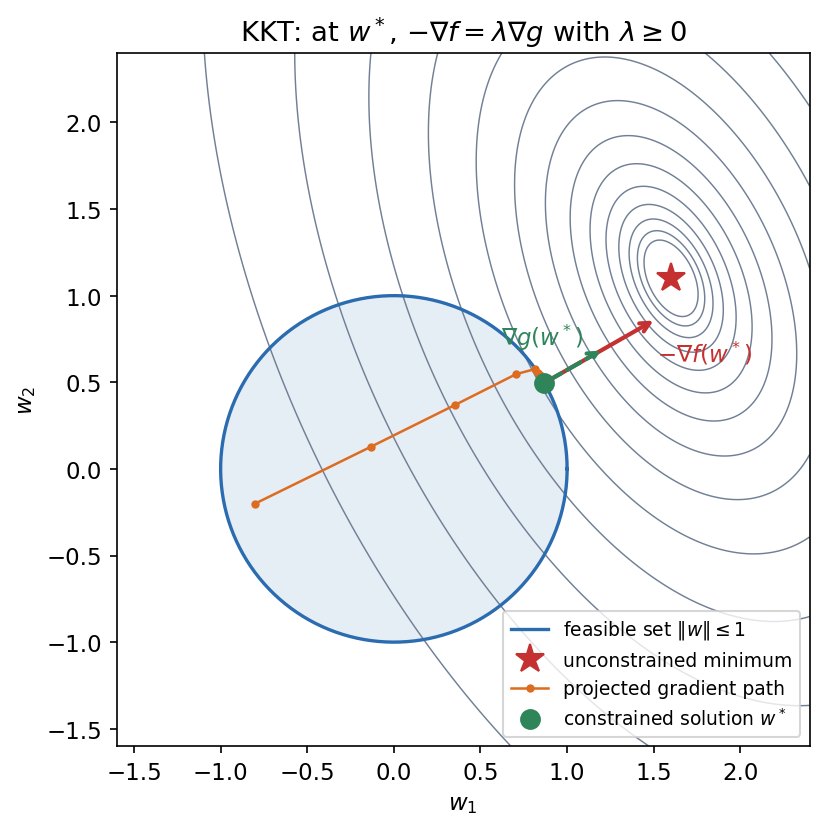
我們要在可行集合 上最小化 。如果投影到 很容易,就先走一般的梯度步,再回到最近的可行點:
對歐氏球 ,投影為 :太長就縮短。權重的最大範數限制、把參數截在一個方盒內、投影到機率單形(simplex)都屬於這個模式。另一種做法是重新參數化,讓限制條件自動成立,例如用 表示圓上的向量,或用 softmax 產生機率。
廣義拉格朗日函數
更一般的做法是用 個等式限制 與 個不等式限制 描述可行集合:
為每個限制條件引入一個 KKT 乘數,等式用 、不等式用 ,並定義廣義拉格朗日函數
原本有限制的問題等價於沒有限制的 min–max 問題
為什麼可行?若 違反某個限制,內層最大化可以選一個很大的乘數,把 推到 ,所以不可行點永遠不會被選上。若 可行,內層最大化最多只能讓這些項為零(等式本來就是 0;對 ,最好的非負 會使 ),因此值恰好是 [1]。
KKT 條件
在解 處(在稱為「限制條件規範性」〔constraint qualification〕的溫和正則條件下),存在乘數滿足 Karush–Kuhn–Tucker(KKT)條件 [1]、[7]:
- 穩定性(stationarity): 。
- 原始可行性: 滿足所有限制條件。
- 對偶可行性: 。
- 互補鬆弛性: 對每個 ,。
互補鬆弛性是說,每個不等式要嘛有效(active,:解落在邊界上,限制條件以 的力量把它推回來),要嘛無效(inactive,:限制條件在局部不起作用,)。從幾何上看,穩定性條件是說:在有效限制處,下坡方向 正好垂直指出可行集合之外,與 平行;任何可行的移動都會往上坡走(圖 4)。對凸問題,KKT 條件也是最佳性的充分條件 [7]。
範例:帶範數限制的最小平方
依照 [1] 的例子,在限制 下最小化平方誤差 ,其中 、。拉格朗日函數為
穩定性條件給出 ,所以
這就是懲罰係數為 的 ridge 迴歸。若一般最小平方解 已經滿足 ,限制條件無效,,問題解決。否則限制條件有效,就增大 直到 ;因為 隨 單調遞減,用二分法就能找到。這也正是對 做內層最大化的行為:限制被違反時乘數變大,剛好滿足時停下。下面的程式用兩種方法求解,並檢查全部四個 KKT 條件。
程式碼 · Python · 40 行
import numpy as np

# minimize ||Aw - b||^2  subject to  ||w||^2 <= r^2
rng = np.random.default_rng(1)
A = rng.normal(size=(30, 5))
b = rng.normal(size=30)
r = 0.2

def w_of(lam):                                # stationarity of the Lagrangian
    return np.linalg.solve(A.T @ A + lam * np.eye(5), A.T @ b)

w_ls = w_of(0.0)
print("unconstrained norm:", np.linalg.norm(w_ls).round(3))

lo, hi = 0.0, 1e6                             # find lambda with ||w|| = r
for _ in range(200):
    mid = 0.5 * (lo + hi)
    if np.linalg.norm(w_of(mid)) > r:
        lo = mid
    else:
        hi = mid
lam = hi
w = w_of(lam)
print("lambda:", round(lam, 3), " ||w||:", np.linalg.norm(w).round(6))

# KKT checks
stationarity = 2 * A.T @ (A @ w - b) + 2 * lam * w
print("stationarity residual:", np.abs(stationarity).max())
print("primal feasible:", w @ w <= r**2 + 1e-9, " dual feasible:", lam >= 0)
print("complementary slackness:", lam * (w @ w - r**2))

# Projected gradient descent reaches the same point
L = 2 * np.linalg.eigvalsh(A.T @ A).max()     # Lipschitz constant of the gradient
v = np.zeros(5)
for _ in range(5000):
    v = v - (1 / L) * 2 * A.T @ (A @ v - b)
    n = np.linalg.norm(v)
    if n > r:
        v = v * (r / n)                       # projection onto the ball
print("projected GD matches KKT solution:", np.allclose(v, w, atol=1e-6))
無限制解的範數為 ,大於 ,所以限制條件有效。二分法找到 ,穩定性殘差約 ,互補鬆弛性成立,而步長 的投影梯度下降收斂到同一個向量。請注意,梯度的 Lipschitz 常數 決定了安全的步長,正如上一節所說。
檢查導數
白話版。 檢查程式算出的梯度,是否與「輕推參數時損失實際的變化」一致。
中央有限差分估計偏導數:
其中 是第 個標準基底向量, 是小步長。它的截斷誤差(忽略高階泰勒項造成)是 ,優於前向差分 的 。但分子是兩個幾乎相等的數相減,所以捨入誤差以 的速度增長。總誤差在中等步長時最小——當 與其導數為單位尺度時,中央差分約在 、前向差分約在 。圖 5 顯示這種 V 形曲線,也說明為什麼 float32 的梯度檢查遠不如 float64 精確。
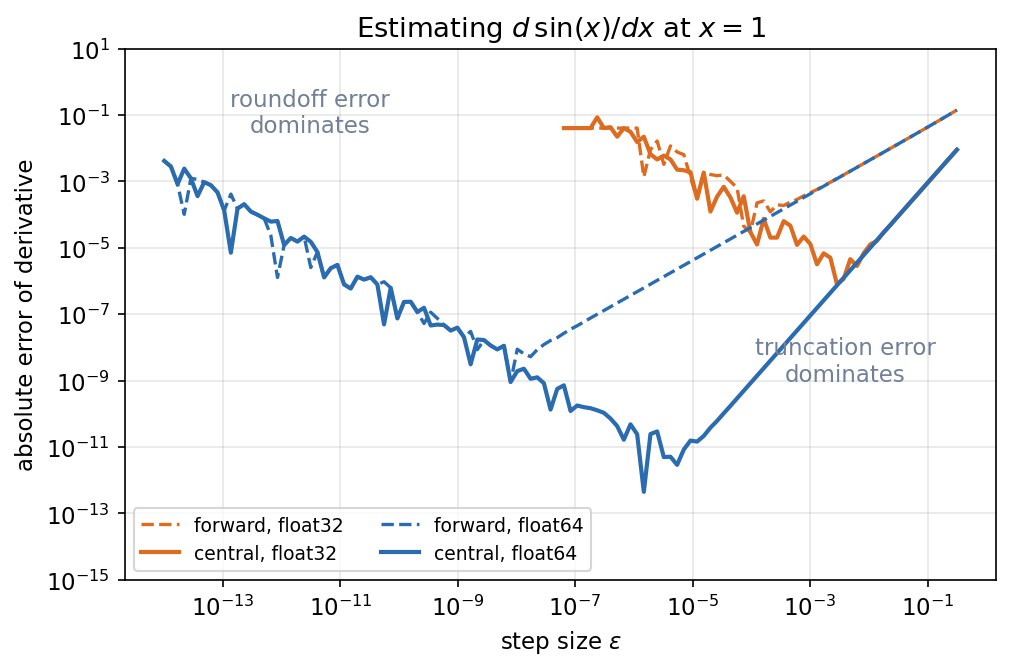
實用原則:用 float64 做檢查;嘗試多個步長;用相對誤差比較,例如 ;並在平滑的點上測試。ReLU 在 0 處不可微,那裡沒有單一導數可以比對。參數很多時,方向檢查更省:選一個隨機單位向量 ,比較 與沿 的有限差分——只需要一對函數求值,而不是 次。
程式碼 · Python · 16 行
import numpy as np

rng = np.random.default_rng(0)
X = rng.normal(size=(20, 5))
y = rng.normal(size=20)
w = rng.normal(size=5)
v = rng.normal(size=5)
v /= np.linalg.norm(v)
def loss(w):
    return .5*np.mean((X@w-y)**2)
grad = X.T@(X@w-y)/len(y)
eps = 1e-5
numeric = (loss(w+eps*v)-loss(w-eps*v))/(2*eps)
analytic = grad@v
assert np.allclose(numeric, analytic, rtol=1e-6, atol=1e-8)
print("directional derivative:", numeric, analytic)
兩個數字大約有九位有效數字相同。通過檢查只確認導數,不代表任務寫對了。錯誤歸約、意外廣播或目標洩漏,都可能定義出可微卻錯誤的目標函數,讓梯度檢查通過 [11]。意外使用 detach 則不同:若前向數值仍隨輸入改變,但自動微分切斷了這條依賴,有限差分便可能抓出不一致 [24]。應在平滑點檢查相關輸入、固定隨機性,並以已知答案的案例核對損失值。
混合精度
白話版。 大部分運算用 16 位元數字,可以讓記憶體傳輸量減半並使用高速硬體單元;但 16 位元不夠應付所有事情,少數敏感的量要保留在 32 位元。
Micikevicius 等人提出的混合精度訓練 [12] 結合三個想法:
- 保留一份 float32 主權重(master weights)。當更新量小於所加權重的約 倍時,在 float16 中加上去會被完全捨去(與上文 是同一個現象),而很多更新就是這麼小。
- float16 要用損失縮放(loss scaling):反向傳播前把損失乘上因子 ,讓小梯度不會下溢到 float16 最小次正規數()以下,更新前再把梯度除以 。動態損失縮放在出現溢位(inf 或 NaN)時降低 ,並跳過該步。
- 即使輸入是 float16,內積與歸約也以 float32 累加。
bfloat16 的指數與 float32 一樣有 8 位元,因此很少需要損失縮放;Kalamkar 等人發現,bfloat16 訓練在多種模型上都能達到 float32 的結果,而且不需要調整超參數 [5]。代價是精度: 的 bfloat16 無法區分 與 1,所以長串加總與權重更新仍需要 float32 累加。
損失縮放保護的是 float16 的小梯度;它無法修正錯誤的目標函數,也無法修正網路其他地方的溢位(例如注意力 logit 或正規化統計量)。改變精度也可能改變最佳化軌跡與輸出,特別是歸約運算與長時間訓練。請在目標硬體上驗證;較小的資料型別不保證每個運算都會變快 [13]。
選讀:Mixed Precision Training(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
非有限值的除錯順序
損失變成 nan 或 inf 時,別急著把所有東西都截斷。先找出第一個產生非有限值的運算,再判斷它屬於本篇哪一種失效模式。實用的順序:
- 輸入: 檢查形狀、範圍、資料型別與缺值。一個 NaN 像素或一張沒有正規化的 0–255 影像,就會改變下游的一切。
- 前向傳播: 檢查激活值與損失是否有限。留意
exp、log、除法、sqrt,以及變異數接近 0 的正規化層。 - 損失: 使用以 logit 為輸入的損失(
cross_entropy、binary_cross_entropy_with_logits),而不是先算機率再取log。 - 梯度: 在小模型上做梯度檢查;查看各層的梯度範數。
- 更新: 比較更新量與權重的大小;學習率超過曲率極限 時,即使算術完全精確,也會振盪甚至發散。
- 精度: 先在 float32(或 float64)中重現,再加入混合精度或編譯。
先讓模型過擬合一個極小的批次,確認整條流程能學習。梯度範數截斷(gradient-norm clipping)限制的是傳給最佳化器的梯度,並不直接限制自適應最佳化器的更新量,也無法讓 NaN 梯度變得有意義。ML 02 會更詳細地介紹最佳化器與正規化。
現代觀點
本篇的核心概念已有數十年歷史,但因為模型更大、訓練更久、硬體不斷把精度往下壓,它們仍站在當前研究的中心。
大規模學習的最佳化理論。 Bottou、Curtis 與 Nocedal 發表在 SIAM Review 的綜述 [14] 是這個領域的標準地圖。它解釋為什麼隨機梯度法主導大規模機器學習(資料有冗餘時,便宜而有雜訊的步伐勝過昂貴而精確的步伐),在類似上文 Lipschitz 條件的平滑性假設下分析其收斂,並把改進方法分成兩大類:降低雜訊(更大或逐漸增大的批次、梯度聚合/變異數縮減、迭代平均)與二階方法(Hessian-free 牛頓法、Gauss–Newton、擬牛頓法、自然梯度與對角縮放)。Nocedal 與 Wright [6]、Boyd 與 Vandenberghe [7] 仍是確定性與凸理論的標準教科書;Baydin 等人 [11] 則綜述了讓梯度變得便宜的自動微分。
損失曲面實際長什麼樣子。 Dauphin 等人 [8] 主張,高維非凸最佳化的主要障礙是鞍點,而不是差勁的局部極小值。後來 Cohen 等人 [15] 觀察到,神經網路上的全批次梯度下降通常運作在「穩定性邊緣」(edge of stability):Hessian 的最大特徵值會上升到剛好略高於 ——正是上文推導的古典穩定極限——而損失在長時間尺度上仍持續下降,只是不再單調。古典的二次分析預測此時會發散,所以如何解釋這個狀態仍是開放的理論問題。
考慮曲率的最佳化器。 完整的牛頓法在大規模下不可行,但結構化的近似很實用。K-FAC [16] 以每層小矩陣的 Kronecker 乘積近似 Fisher 資訊矩陣(一種半正定的曲率矩陣,與 Hessian 的 Gauss–Newton 近似密切相關),讓求反矩陣變得便宜。Shampoo [17] 為張量的每個維度各維護一個預條件(preconditioning)矩陣。更近期的 Muon 對每個權重矩陣的更新量做近似正交化;Liu 等人 [18] 報告,在加入權重衰減並仔細調整每個參數的更新尺度後,它在其實驗中以約兩倍於所比較之自適應最佳化器基準的計算效率訓練大型語言模型。這些方法都在重新回答本篇用 Hessian 提出的問題:一步更新應該如何依方向重新縮放?
更低的精度。 格式的演進從搭配損失縮放的 float16 [12]、bfloat16 [5],一路走到 8 位元浮點數。Micikevicius 等人 [19] 提出兩種 FP8 編碼:E4M3(精度較高)與 E5M2(範圍較大),並在影像與語言模型上展示了與 16 位元基準相當的訓練結果。上方表格中的範圍–精度取捨,正是這些設計要平衡的東西,而它們放寬的是 IEEE 754 的規則 [3]。逐張量或逐區塊的縮放因子,扮演著 float16 時代損失縮放的角色。
大規模下的穩定 softmax。 減去最大值的技巧有串流版本。Milakov 與 Gimelshein [20] 證明,只要維護一個執行中的最大值,並在最大值改變時重新縮放累加和,就能一趟算出 softmax 的正規化因子。FlashAttention [21] 以此為基礎,在高速的晶片上記憶體中逐區塊計算精確的注意力,從不實際建出完整的注意力矩陣;FlashAttention-3 [22] 進一步延伸到 FP8,並以區塊量化與「incoherent processing」降低量化誤差。這個線上技巧的核心只要幾行:
程式碼 · Python · 17 行
import numpy as np

def online_logsumexp(chunks):
    m, s = -np.inf, 0.0                 # running max and rescaled running sum
    for c in chunks:
        m_new = max(m, c.max())
        s = s * np.exp(m - m_new) + np.exp(c - m_new).sum()
        m = m_new
    return m + np.log(s)

rng = np.random.default_rng(0)
z = rng.normal(0, 50, size=10_000)
chunks = np.array_split(z, 37)          # seen one block at a time
m = z.max()
reference = m + np.log(np.exp(z - m).sum())
print(online_logsumexp(chunks), reference)
assert np.isclose(online_logsumexp(chunks), reference)
兩個值都印出 ,在顯示的位數內完全相同,雖然線上版本從未同時看到所有 logit。ML 05 介紹注意力本身,ML 11 介紹部署時的量化。
開放問題。 梯度方法為何能在穩定性邊緣成功;如何讓低精度(8 位元及以下)訓練像 float32 一樣穩健,而不必手動調整縮放;如何讓考慮曲率的最佳化器夠便宜、夠穩健,足以取代一階方法成為預設;以及在平行歸約改變加總順序時,如何得到可重現的結果。
重點整理
- 指數位元決定範圍,尾數位元決定精度;次正規數的相對精度行為不同。
- 提高精度前,先使用 log-sum-exp 與以 logits 計算損失等穩定公式。
- 條件性衡量輸入敏感度;穩定演算法無法消除問題本身的病態敏感性。
- 曲率決定二次目標的安全步長;一般非凸損失需要額外考量。
- 投影維持可行性;KKT 條件需要正則性假設,並非通用的全域最佳證明。
- 在光滑點以合適精度與步長檢查梯度,並在實際運算中驗證混合精度。
練習
- Softmax 平移。 證明 softmax 在 下不變,並說明取 時分母落在 之間。
提示
共同因子 在分子與分母間抵銷。平移後每一項 都在 之間,最大的一項等於 1,所以 項的總和介於 1 與 之間,既不會溢位,也不會下溢成 0。
- 有限差分掃描。 對 在 處,以 分別在 float32 與 float64 中計算前向與中央差分。各自在哪個 誤差最小?與 、 比較。
提示
float64 的 ,所以 (前向)、(中央)。float32 的 ,對應約 與 。觀察到的最佳步長應與這些值相差不到一個數量級,最低誤差則大約分別是 與 。
- 穩定極限。 對 ,,求最大的穩定固定學習率,以及使最壞情況收縮因子最小的步長。用這個最佳步長,需要幾次迭代才能把誤差縮小 倍?
提示
穩定需要 。最佳步長為 ,收縮因子為 。解 : 次。牛頓法只要一步。
- 判斷臨界點。 找出 的臨界點並加以分類。
提示
給出 與 。Hessian 為 :在 是 ,正定,為局部極小值;在 是 ,不定,為鞍點。兩者都不是全域極小值,因為 時 。從 附近開始的牛頓法會收斂到鞍點。
- 單形上的 KKT。 在 且 的限制下,對 最小化 。寫出拉格朗日函數與 KKT 條件,並求出解。
提示
,。穩定性給出 ;互補鬆弛性給出 。猜測只有前兩個為正:,所以 、。驗證:,所以 ,且 。這就是到機率單形的歐氏投影。
- 錯誤損失的正確梯度。 在梯度檢查的範例中,把 mean 歸約改成 sum。檢查還會通過嗎?自動微分錯了嗎?訓練上還有什麼會改變?
提示
如果同時一致地修改損失與解析梯度,檢查會通過:對新的目標函數而言,導數是正確的。自動微分沒有錯。但梯度變成原來的 倍,所以最大的穩定學習率縮小為 ;在多項損失中,各項之間的平衡也會改變。梯度檢查無法告訴你目標函數選錯了。
參考文獻
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 4 (Numerical Computation) and ch. 8. Book
- D. Goldberg, “What Every Computer Scientist Should Know About Floating-Point Arithmetic,” ACM Computing Surveys, vol. 23, no. 1, pp. 5–48, 1991. DOI
- IEEE, “IEEE Standard for Floating-Point Arithmetic,” IEEE Std 754-2019, 2019. DOI
- N. J. Higham, Accuracy and Stability of Numerical Algorithms, 2nd ed., SIAM, 2002. DOI
- D. Kalamkar et al., “A Study of BFLOAT16 for Deep Learning Training,” arXiv:1905.12322, 2019. arXiv
- J. Nocedal and S. J. Wright, Numerical Optimization, 2nd ed., Springer, 2006. DOI
- S. Boyd and L. Vandenberghe, Convex Optimization, Cambridge University Press, 2004. Book
- Y. N. Dauphin, R. Pascanu, C. Gulcehre, K. Cho, S. Ganguli and Y. Bengio, “Identifying and Attacking the Saddle Point Problem in High-Dimensional Non-Convex Optimization,” NeurIPS, 2014. Paper
- B. A. Pearlmutter, “Fast Exact Multiplication by the Hessian,” Neural Computation, vol. 6, no. 1, pp. 147–160, 1994. DOI
- D. C. Liu and J. Nocedal, “On the Limited Memory BFGS Method for Large Scale Optimization,” Mathematical Programming, vol. 45, pp. 503–528, 1989. DOI
- A. G. Baydin, B. A. Pearlmutter, A. A. Radul and J. M. Siskind, “Automatic Differentiation in Machine Learning: a Survey,” Journal of Machine Learning Research, vol. 18, no. 153, pp. 1–43, 2018. arXiv
- P. Micikevicius et al., “Mixed Precision Training,” ICLR, 2018. arXiv
- PyTorch documentation, “Numerical Accuracy.” Documentation
- L. Bottou, F. E. Curtis and J. Nocedal, “Optimization Methods for Large-Scale Machine Learning,” SIAM Review, vol. 60, no. 2, pp. 223–311, 2018. DOI
- J. M. Cohen, S. Kaur, Y. Li, J. Z. Kolter and A. Talwalkar, “Gradient Descent on Neural Networks Typically Occurs at the Edge of Stability,” ICLR, 2021. arXiv
- J. Martens and R. Grosse, “Optimizing Neural Networks with Kronecker-factored Approximate Curvature,” ICML, 2015. Paper
- V. Gupta, T. Koren and Y. Singer, “Shampoo: Preconditioned Stochastic Tensor Optimization,” ICML, 2018. Paper
- J. Liu, J. Su, X. Yao et al., “Muon is Scalable for LLM Training,” arXiv:2502.16982, 2025. arXiv
- P. Micikevicius et al., “FP8 Formats for Deep Learning,” arXiv:2209.05433, 2022. arXiv
- M. Milakov and N. Gimelshein, “Online Normalizer Calculation for Softmax,” arXiv:1805.02867, 2018. arXiv
- T. Dao, D. Y. Fu, S. Ermon, A. Rudra and C. Ré, “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” NeurIPS, 2022. Paper
- J. Shah, G. Bikshandi, Y. Zhang, V. Thakkar, P. Ramani and T. Dao, “FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision,” NeurIPS, 2024. Paper
- NumPy developers, “numpy.linalg.cond,” NumPy documentation, accessed 2026-11-05. Documentation
- PyTorch contributors, “torch.autograd.gradcheck.gradcheck,” PyTorch documentation, accessed 2026-11-05. Documentation
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 02・類神經網路:從感知器到深度網路 · 32 分鐘