ML 01B・機率與資訊理論
先備知識:ML 01A・學習所需的線性代數
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 區分機率、密度與分布。
- 連結聯合、邊際與條件機率。
- 描述變異與相依,避免混淆相關與獨立。
- 用貝氏定理、概似與先驗估計未知量。
- 連結熵、交叉熵、KL 散度與學習目標。
先看全貌
神經網路永遠看不到整個世界。它只看到有限的訓練集——由不完美的感測器量測、由忙碌的人標註——接著卻要回答從沒看過的影像。這個過程的每一步都牽涉不確定性。機率論就是描述不確定性的數學:它告訴我們如何表達自己不知道的事、如何結合證據,以及如何做出承認懷疑的預測。與它關係密切的資訊理論,則衡量不確定性有多少,以及使用錯誤分布要付出多少代價。兩者合起來,幾乎可以解釋本站 ML 與 DL 系列中的每一個損失函數。
本篇依循 Goodfellow、Bengio 與 Courville《Deep Learning》中的「應用數學」部分 [1],並補充 Bishop 與 Bishop [2]、Murphy [3] 以及《Mathematics for Machine Learning》[4] 的內容。它位於 ML 01A・線性代數與 ML 01C・數值計算之間。如果你接下來要讀圖形識別系列,PR 01・貝氏決策會直接延伸這裡的貝氏定理一節。
為什麼需要機率?
白話版。 機率讓學習系統能描述不確定的觀測、預測與模型假設。
Goodfellow 等人 [1] 列出三種不確定性的來源:
- 系統本身的隨機性。 有些系統本來就是隨機的——光子抵達相機感測器的時間(散粒雜訊)、骰子的點數,或行人踏下人行道的確切時刻。
- 觀測不完整。 即使系統是決定性的,只要我們看不到它所有的變數,它看起來就是隨機的。一張汽車照片無法告訴你煞車燈是不是快要亮起。
- 建模不完整。 模型必須捨棄資訊才有用處。只看 縮圖的分類器無法找回降取樣時遺失的細節,所以它對細粒度類別的預測必然帶有不確定性。
使用帶有不確定性的簡單規則(「大多數鳥會飛」),往往比使用永遠正確但極其複雜的規則(「鳥會飛,但企鵝、鴕鳥、受傷的鳥……除外」)更實際。
解讀機率的兩種方式
機率可以有兩種解讀,而兩者遵守相同的數學規則。
- 頻率學派機率描述可重複事件的長期頻率:「這枚硬幣擲很多次,大約 70% 會出現正面」。
- 貝氏機率描述對某件不一定能重複的事的信念程度:「看了這張 X 光片,我有 40% 的把握病人罹病」。
只要要求信念程度滿足幾項符合常識的一致性性質,就能證明它們必須遵守與頻率完全相同的規則,因此同一套計算可以同時服務兩種解讀 [1], [3]。實務上,深度學習混用兩者:資料被視為從某個分布抽出的樣本(頻率觀點),而模型的輸出常被解讀成對標籤的信念(貝氏觀點)。
隨機變數與機率分布
白話版。 隨機變數是事先不知道值的量;機率分布說明每個值出現的可能性有多大。
[1] 用正體字母(例如 )表示隨機變數;本篇用 表示變數、 表示它的一個取值。隨機變數可以是離散的(有限或可數個值,例如 中的類別標籤),也可以是連續的(實數值,例如被視為實數的像素強度)。
機率質量函數
離散變數有機率質量函數(probability mass function, PMF),常簡寫為 。它必須滿足
這裡的總和涵蓋 所有可能的值 。第一個條件說沒有事件比「確定」更確定;第二個條件說總有某件事會發生。聯合 PMF 則是兩個事件同時發生的機率。
機率密度函數
連續變數有機率密度函數(probability density function, PDF),必須滿足
密度不是機率。 落在區間 的機率是密度曲線下的面積:
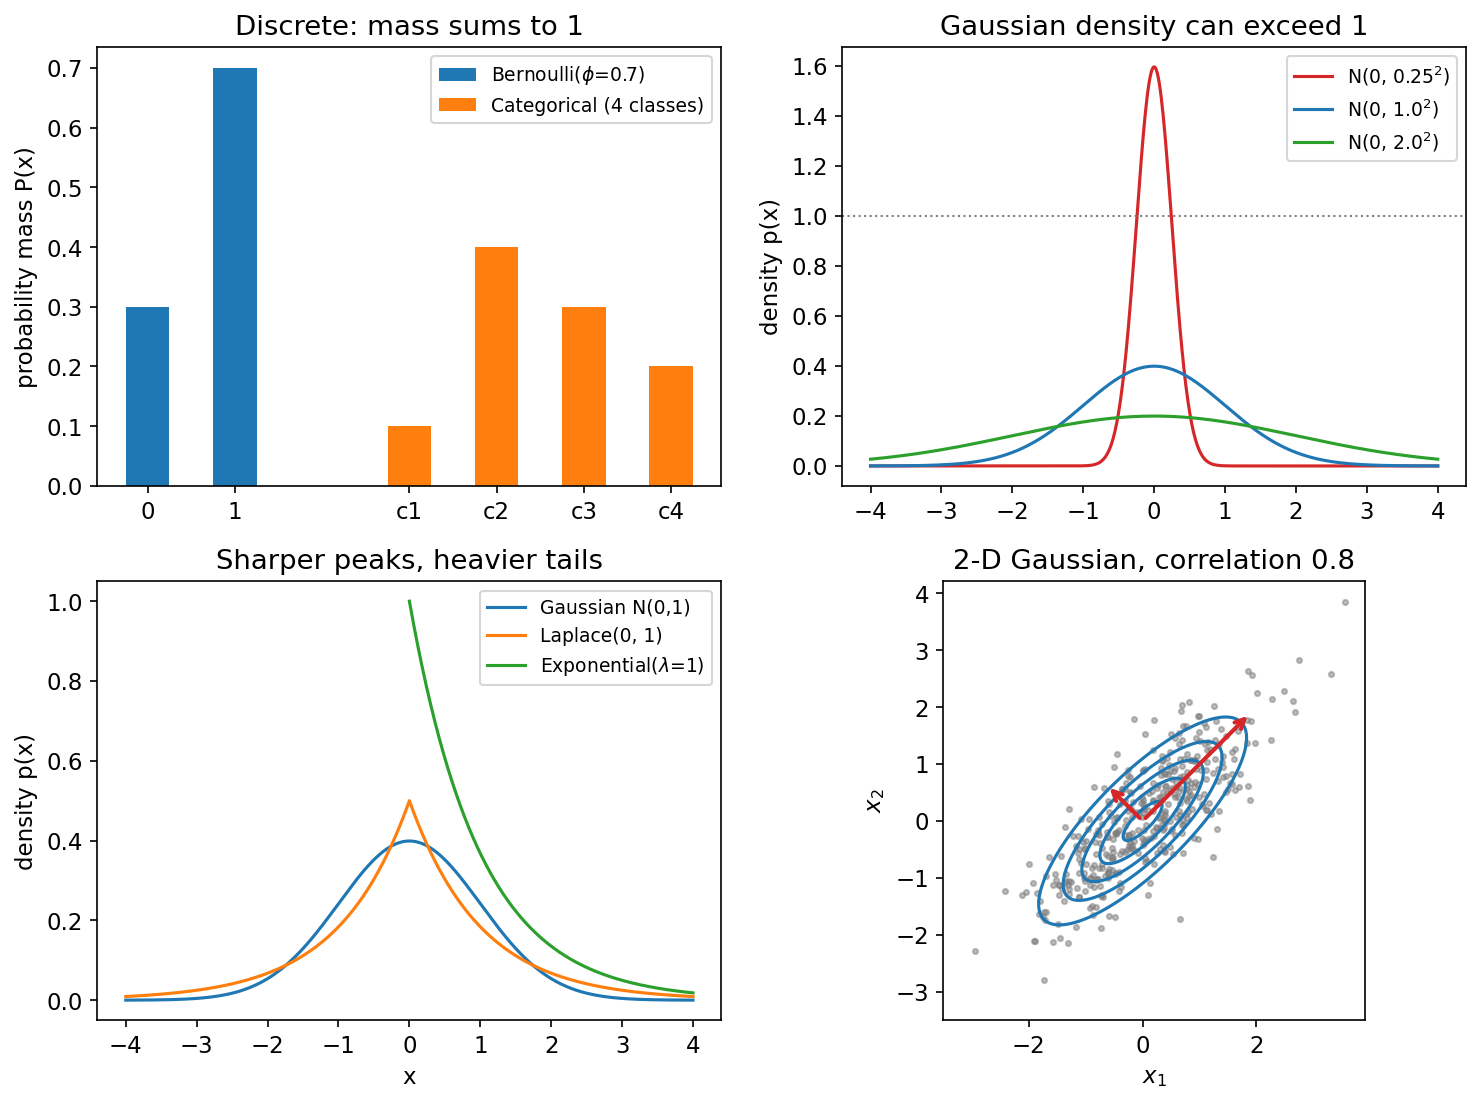
任何單一精確值的機率都是零。因為只有面積必須不超過一,密度本身可以大於一:標準差為 的窄高斯,峰值約為 (圖 1 右上)。把密度值當成「機率 1.6」回報,是常見錯誤。
邊際機率
白話版。 如果知道兩件事如何一起變化,就可以把其中一件「加總掉」,得到另一件事單獨的變化方式。
給定 與 的聯合分布, 的邊際分布為
這就是加法規則(sum rule)。如果把聯合分布寫成表格,列代表 、欄代表 ,那麼 的邊際分布就是每一列的總和——過去習慣寫在紙張的邊緣(margin),因此得名。
條件機率
白話版。 條件機率回答的是:「在已經知道那件事的情況下,這件事有多可能?」
是觀察到 之後 的機率,只有在條件真的可能發生時才有定義。移項後得到乘法規則(product rule)。
不要把條件化和介入混為一談。「有人帶傘的情況下街道是濕的」機率很高,但強迫大家帶傘並不會讓街道變濕。關於介入的問題屬於因果推論,光有聯合分布是不夠的。
機率的連鎖規則
反覆套用乘法規則,可以把任何 個變數的聯合分布分解成
這裡 是第 個變數的值。這個恆等式是精確的——不需要任何假設。它是自迴歸模型的骨幹:語言模型或自迴歸影像模型,會根據前面所有的 token 或像素,一次預測一個(ML 09、NLP 01)。建模的選擇在於如何參數化每一個條件分布,而不在分解本身。
獨立與條件獨立
如果
就稱兩個變數獨立,記為 。如果
就稱它們在給定 下條件獨立,記為 。
冰淇淋銷量和曬傷人數彼此相關,但在給定天氣之後,兩者大致獨立。條件獨立是讓高維模型變得可計算的主要工具——單純貝氏(naive Bayes)假設特徵在給定類別下彼此獨立;隱藏式馬可夫模型假設給定目前狀態後,未來與過去獨立。這些都是假設 [3]:應該由問題本身來支持,而不是因為能讓代數變簡單就採用。
程式碼:聯合機率表、邊際與條件機率
下面的例子為天氣與帶傘建立一張小型聯合機率表,計算邊際與條件機率,並檢查是否獨立。它也展示了兩個變數明顯相依、共變異數卻(幾乎)為零的情況。
程式碼 · Python · 20 行
import numpy as np

# Joint table P(weather, umbrella): rows = sunny/rainy, columns = no/yes
P = np.array([[0.56, 0.14],
              [0.06, 0.24]])
assert np.isclose(P.sum(), 1)

p_weather = P.sum(axis=1)            # marginal over umbrella
p_umbrella = P.sum(axis=0)           # marginal over weather
p_umb_given_w = P / p_weather[:, None]   # each row sums to 1
print("P(weather):", p_weather)
print("P(umbrella):", p_umbrella)
print("P(umbrella | weather):\n", p_umb_given_w)
print("independent?", np.allclose(P, np.outer(p_weather, p_umbrella)))

# Zero covariance does not imply independence
rng = np.random.default_rng(0)
x = rng.uniform(-1, 1, 200_000)
y = x**2                              # y is a deterministic function of x
print("cov(x, y) ~", np.cov(x, y)[0, 1].round(4))
輸出:邊際分布為 與 ;條件機率表為 ;兩個變數不獨立;而 與 的樣本共變異數約為 ,幾乎是零——即使 完全由 決定。
期望值、變異數與共變異數
白話版。 期望值是長期平均;變異數是數值通常偏離平均多遠;共變異數則說明兩個量是否傾向一起上升、一起下降。
函數 在某個分布下的期望值為
下標 指出對哪個分布取平均;意思明確時可以省略。期望值是線性的:對常數 ,。幾乎每一個訓練損失都是對資料分布的期望值,並用小批次(mini-batch)的平均來估計。
變異數衡量數值在平均 周圍的分散程度:
它的平方根是標準差,單位與 相同。
兩個量的共變異數衡量它們如何一起變化:
共變異數為正,代表兩者傾向同時高於(或低於)各自的平均;為負,代表一個高時另一個傾向低。它的大小取決於單位,所以我們常把它正規化成相關係數
獨立意味著共變異數為零,但共變異數為零不代表獨立。共變異數只衡量線性相依。在上面的程式碼中, 在 上均勻分布、:知道 就能確切知道 ,但因為關係對稱且非線性,共變異數為零。稍後介紹的互資訊能捕捉任何形式的相依。
共變異數矩陣
對平均為 的隨機向量 ,共變異數矩陣為
對角線是各分量的變異數 。 是對稱半正定矩陣,因此(見 ML 01A)具有非負實特徵值與正交特徵向量。特徵向量是資料雲的主軸,特徵值是沿主軸的變異數——也就是圖 1 中的紅色箭頭——這正是 PCA 所計算的東西。對仿射映射 ,有 與 。
常見機率分布
白話版。 有一小群分布會一再出現。選擇其中一個,就是對資料或目標做出一個假設。
Bernoulli 分布
單一二元變數 ,參數 :
平均為 ,變異數為 。輸出層使用 sigmoid 的二元分類器,就是在預測標籤之 Bernoulli 分布的參數 。
類別分布(multinoulli)
具有 個狀態的單一離散變數,以機率向量 ()為參數:
若標籤以 one-hot 編碼為 ,則 。softmax 分類器輸出的正是這樣的向量。(多項分布計算多次抽取的結果次數;只抽一次時就退化成類別分布,Goodfellow 等人稱之為「multinoulli」[1]。)
高斯(常態)分布
最常用的連續分布:
是平均(也是峰值位置), 是變異數。有時改用精確度(precision),在變異數經常改變時計算起來比較省。
高斯之所以成為預設選擇有兩個原因。中央極限定理說,許多變異數有限的獨立變數相加,會趨近高斯分布,所以由許多微小因素組成的量測雜訊往往接近高斯。而在實數線上、平均與變異數固定的所有分布中,高斯的熵最大:它加入的額外結構最少。
在 維中,
其中 是平均向量, 是對稱正定的共變異數矩陣。精確度矩陣 有個漂亮的意義: 恰好代表在給定其他所有座標下, 與 條件獨立。等向(isotropic)高斯的 ——這正是擴散模型使用的雜訊分布(ML 08)。
它和你會用到的損失函數有一個根本的連結:如果迴歸網路預測一個固定變異數之高斯的平均,那麼最大化概似就等於最小化均方誤差。
指數分布與 Laplace 分布
有時候我們想在特定位置放一個尖峰。
是速率, 是指示函數( 時為 1,否則為 0), 是位置, 是尺度。和高斯相比,Laplace 密度的峰值更尖、尾巴更厚(圖 1 左下)。用最大概似預測 Laplace 分布的位置,等同於最小化絕對誤差( 損失),這就是 比 更能容忍離群值的原因;而對權重使用 Laplace 先驗,就得到 正則化(稀疏性)。
Dirac 分布與經驗分布
Dirac delta 把所有質量放在點 :它在其他地方都是零,積分卻等於一。它是一種廣義函數,由它在積分中的作用來定義:。
訓練集 定義了經驗分布
在 個樣本上各放 的質量。把損失對整個資料集取平均來訓練模型,就等於在 下取期望值。經驗分布也是讓訓練資料概似最大的分布——這正是只最小化訓練損失會過擬合(overfitting)的原因。
混合分布與潛在變數
白話版。 混合分布先隨機選一個「類型」,再從那個類型的分布中抽樣。
是一個類別型的潛在變數(latent variable)——我們從未直接觀察到的變數——以機率 選出, 是第 個成分。高斯混合模型(Gaussian mixture model, GMM)使用高斯成分 ;只要成分夠多,它可以把任何平滑密度近似到任意指定的非零誤差 [1]。給定一個觀測 ,貝氏定理給出後驗責任值 :該點由第 個成分產生的可能性。用期望最大化(EM)擬合 GMM 是 PR 07 的主題。
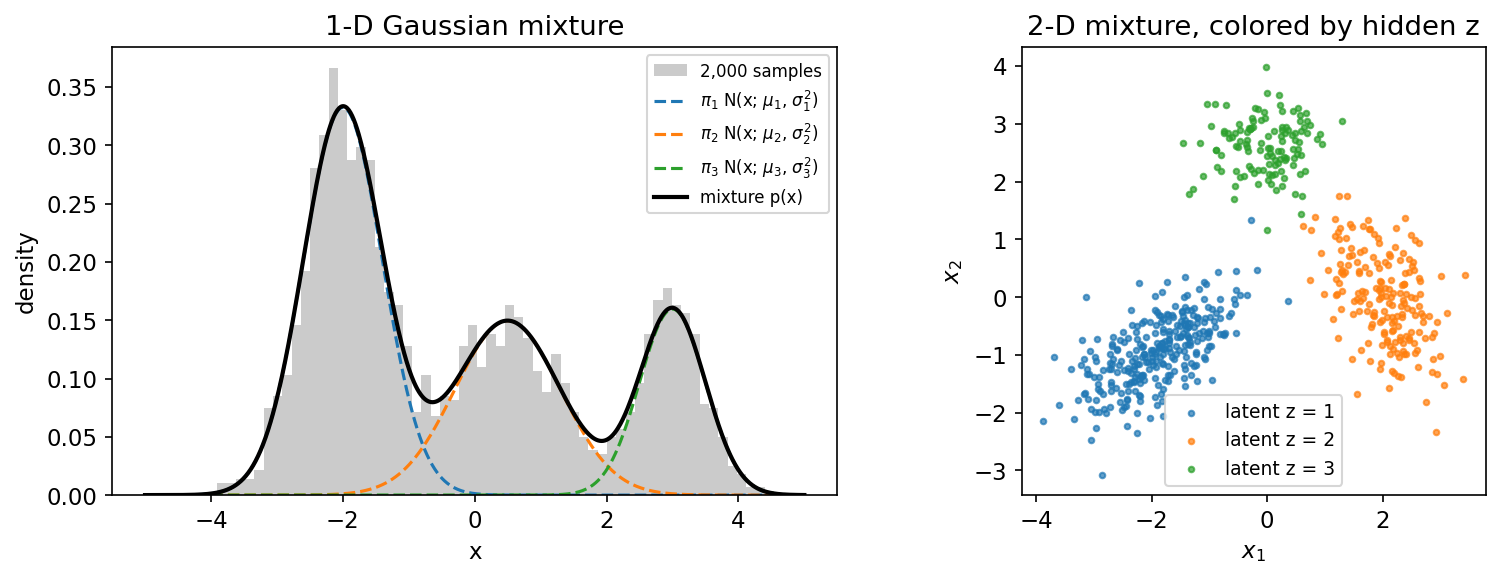
潛在變數是現代生成模型的核心。VAE(ML 07)粗略地說,就是潛在變數 為連續、且 由神經網路表示的混合模型 [8];此時邊際分布 無法直接計算,只能近似。
程式碼 · Python · 27 行
import numpy as np

rng = np.random.default_rng(0)
pi = np.array([0.5, 0.3, 0.2])      # mixing weights P(z = k)
mu = np.array([-2.0, 0.5, 3.0])     # component means
sd = np.array([0.6, 0.8, 0.5])      # component standard deviations

# Ancestral sampling: first the hidden component z, then x given z
z = rng.choice(3, size=100_000, p=pi)
x = rng.normal(mu[z], sd[z])

def log_normal(x, m, s):
    return -0.5*((x - m)/s)**2 - np.log(s) - 0.5*np.log(2*np.pi)

def mixture_logpdf(x):
    # log sum_k pi_k N(x; mu_k, sd_k^2), computed with log-sum-exp
    a = np.log(pi) + log_normal(x[:, None], mu, sd)
    m = a.max(axis=1, keepdims=True)
    return (m + np.log(np.exp(a - m).sum(axis=1, keepdims=True))).ravel()

grid = np.linspace(-6, 6, 4001)
print("density integrates to", (np.exp(mixture_logpdf(grid)).sum()*(grid[1]-grid[0])).round(4))
print("sample mean", x.mean().round(3), "vs exact", (pi*mu).sum().round(3))
# Posterior responsibility P(z | x) for one observation
a = np.log(pi) + log_normal(np.array([0.0])[:, None], mu, sd)
resp = np.exp(a - a.max()); resp /= resp.sum()
print("P(z | x=0):", resp.round(3))
密度積分為 1.0,樣本平均(−0.255)與精確平均 相符,而點 以 0.99 的機率被歸給中間的成分。這裡用到的 log-sum-exp 技巧在 ML 01C 中說明。
實用函數:sigmoid 與 softplus
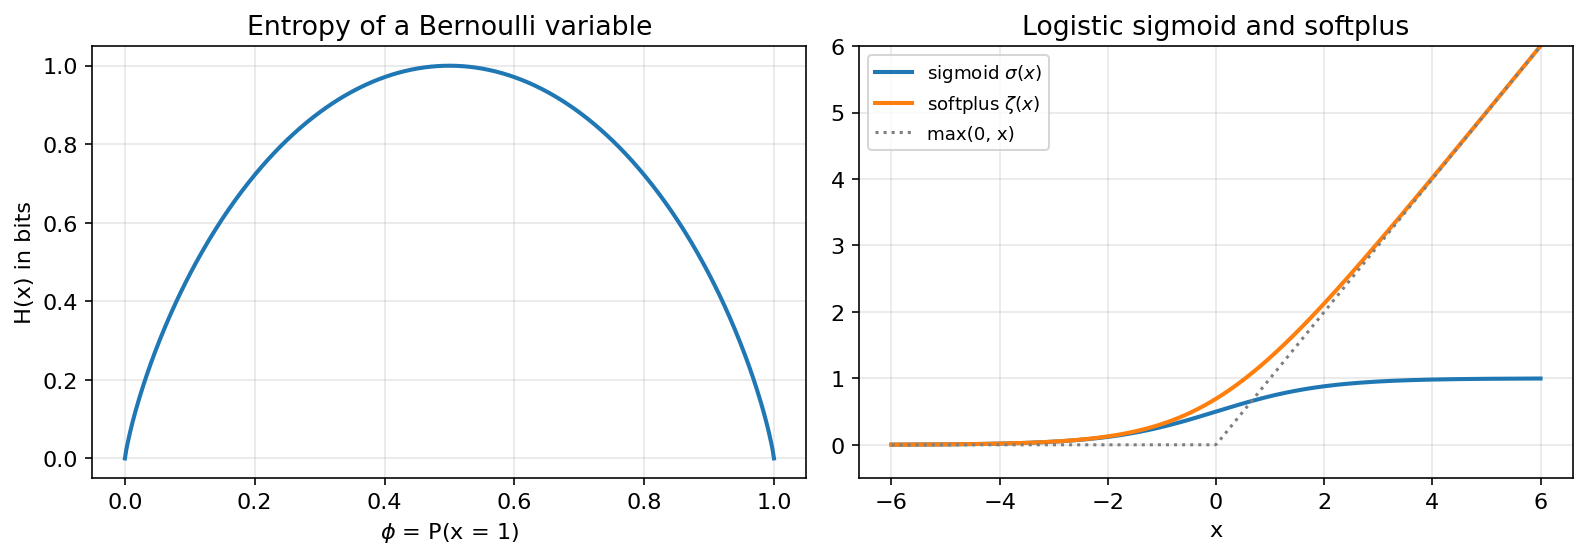
白話版。 sigmoid 把任何實數壓進 0 到 1 之間,變成一個機率;softplus 是 的平滑版本,輸出永遠為正。
logistic sigmoid 產生 Bernoulli 分布的參數 ;當 很大時它會飽和(變平),使那裡的梯度很小。softplus 產生正數,例如標準差 或精確度 ;它的名字來自它是「正部」 的柔化版本。
下列恆等式值得記住,因為每次化簡損失函數時都會用到 [1]:
是 logit(對數勝算)函數。恆等式 說明了為什麼二元交叉熵應該從 logit 直接計算:,而 softplus 可以在不溢位的情況下求值。
程式碼 · Python · 18 行
import numpy as np

def sigmoid(x):
    return 1/(1 + np.exp(-x))

def softplus(x):
    return np.logaddexp(0, x)          # log(1 + exp(x)) without overflow

x = np.linspace(-30, 30, 13)
assert np.allclose(1 - sigmoid(x), sigmoid(-x))
assert np.allclose(np.log(sigmoid(x)), -softplus(-x))
assert np.allclose(softplus(x) - softplus(-x), x)
h = 1e-6
assert np.allclose((softplus(x+h) - softplus(x-h))/(2*h), sigmoid(x), atol=1e-6)
p = sigmoid(x[4:9])
assert np.allclose(np.log(p/(1-p)), x[4:9])   # logit inverts sigmoid
print("naive log(1+exp(1000)):", np.log1p(np.exp(np.float64(1000))))
print("stable softplus(1000):", softplus(1000.0))
所有恆等式都通過檢查。直接計算的寫法傳回 inf(並出現溢位警告),而 np.logaddexp 傳回 1000.0。
貝氏定理
白話版。 貝氏定理結合假設對證據的解釋程度,以及假設原本的可信程度。
把乘法規則從兩個方向寫出來,,於是
- 是先驗(prior):看到證據之前 的可信度。
- 是在假設 下證據 的概似(likelihood)。
- 是後驗(posterior):更新後的可信度。
- 是證據(evidence,或稱邊際概似),對所有假設 加總得到的正規化常數。
實例:基本比率效應
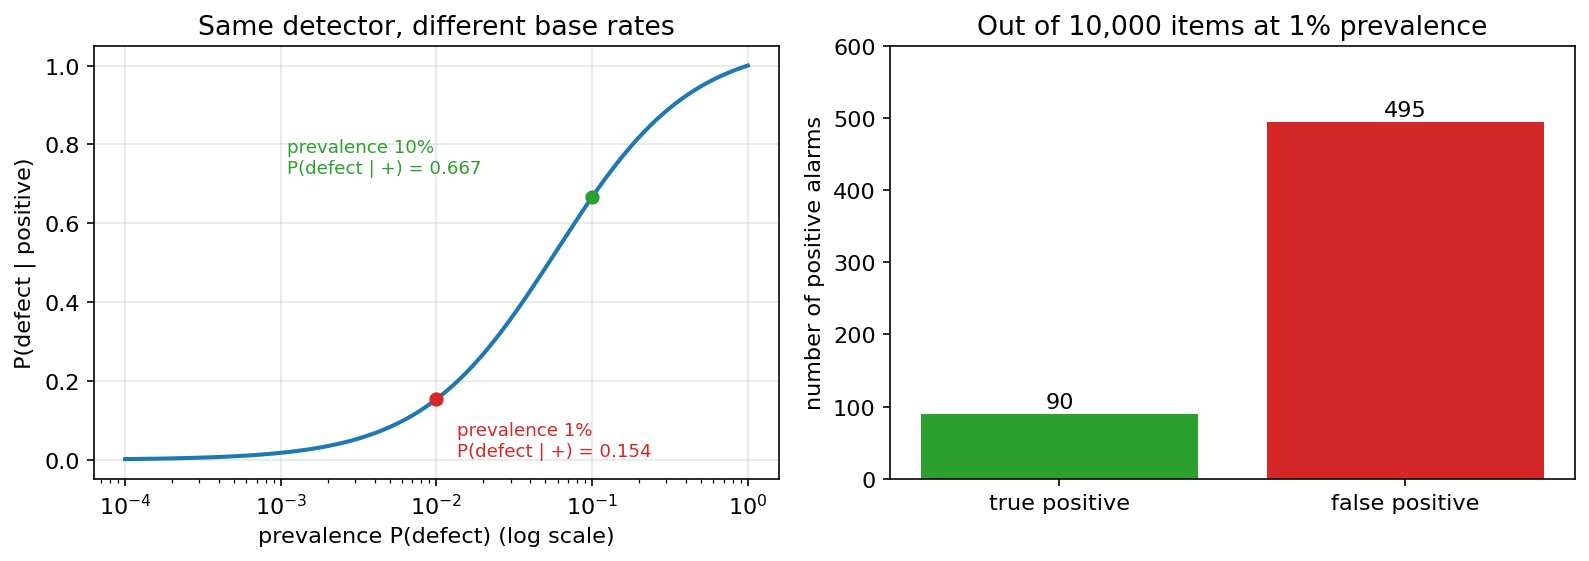
考慮一個假想的瑕疵偵測器,靈敏度 、偽陽性率 ,而盛行率(基本比率)。被判為陽性的物品真的有瑕疵的機率是
即使偵測器能抓到 90% 的瑕疵,警報中只有約 15% 是真的。用數量來想就很清楚:在 10,000 件物品中,有 100 件有瑕疵,其中 90 件觸發警報;但另外 9,900 件正常品中,也有 495 件觸發警報(圖 4 右)。同一個偵測器在 10% 盛行率下則得到 。這是數學示範,不是任何真實系統的效能宣稱。它的教訓適用於每一個部署中的分類器:光有靈敏度與偽陽性率,無法決定陽性預測有多可信;部署環境的盛行率同樣關鍵。 ML 11 在討論分布偏移下的精確率時會再回到這一點。
程式碼 · Python · 14 行
import numpy as np

def posterior_positive(prevalence, sensitivity=0.9, false_pos=0.05):
    evidence = sensitivity*prevalence + false_pos*(1 - prevalence)   # P(+)
    return sensitivity*prevalence / evidence                          # P(defect | +)

for prev in [0.001, 0.01, 0.1, 0.5]:
    print(f"prevalence {prev:>5}: P(defect | +) = {posterior_positive(prev):.3f}")

# Simulation check with 1,000,000 synthetic items
rng = np.random.default_rng(0)
defect = rng.random(1_000_000) < 0.01
alarm = np.where(defect, rng.random(defect.size) < 0.9, rng.random(defect.size) < 0.05)
print("simulated:", defect[alarm].mean().round(3))
公式對四種盛行率分別給出 0.018、0.154、0.667 與 0.947,而一百萬件物品的模擬重現了 0.154。
貝氏定理也是貝氏分類器的基礎:預測後驗 最大的類別 ,可以讓期望錯誤率最小。PR 01 會深入發展這套決策理論。
密度的變數變換
白話版。 拉伸一張橡皮布,上面的墨水會變淡。隨機變數經過變換後,它的密度也必須依照變換把空間拉伸了多少來重新縮放。
一個誘人的錯誤:若 、 的密度為 ,就以為 。這是錯的,因為它的積分不等於一。對可逆且可微的 ,一維的正確規則是
小區間內的機率必須守恆:。在 維中,若 ,則
其中 是 的 Jacobian 矩陣(第 個元素為 ), 是其行列式的絕對值——也就是 放大小體積的倍率(行列式見 ML 01A)。這個公式是正規化流(normalizing flows)的全部基礎:它堆疊 Jacobian 行列式容易計算的可逆網路,得到精確的概似 [9]。
程式碼 · Python · 18 行
import numpy as np

rng = np.random.default_rng(0)
x = rng.normal(0, 1, 500_000)        # x ~ N(0, 1)
y = np.exp(x)                        # y = g(x), invertible on (0, inf)

def p_x(x):
    return np.exp(-0.5*x**2)/np.sqrt(2*np.pi)

def p_y(y):
    # p_y(y) = p_x(g^{-1}(y)) * |d g^{-1}(y) / dy| = p_x(log y) / y
    return p_x(np.log(y))/y

counts, edges = np.histogram(y, bins=np.linspace(0.05, 4, 80), density=False)
centers = 0.5*(edges[:-1] + edges[1:])
empirical = counts/(y.size*np.diff(edges))
print("max |histogram - formula|:", np.abs(empirical - p_y(centers)).max().round(3))
print("wrong formula (no Jacobian) error:", np.abs(empirical - p_x(np.log(centers))).max().round(3))
加上 Jacobian 因子 後,直方圖與公式的差距在 0.011 以內(抽樣雜訊);少了它,誤差達到 0.46。
概似、最大概似與 MAP
白話版。 固定已觀察到的資料,問哪些參數值最能讓這些資料顯得合理。如果你對參數另有先驗知識,也把它一併考慮進去。
假設模型 的參數為 ,並觀察到由獨立同分布(i.i.d.)樣本組成的資料集 。概似為
作為 的函數,它不是參數上的機率分布:它對 的積分不必等於一。最大概似估計(maximum likelihood estimate, MLE)為
我們取對數,因為許多小於一的數相乘會下溢,而對數相加在數值上很安全,且最大值位置不變。右邊的形式說明 MLE 是在經驗分布 下最小化平均負對數概似(negative log-likelihood, NLL)。對分類器 ,同樣的想法給出條件 NLL ,也就是下面會看到的交叉熵損失。
兩個經典結果: 次擲硬幣得到 次正面時,;對高斯而言, 是樣本平均,——這是略帶偏差的估計(改除以 可以消除偏差)。
MAP 估計
貝氏推論把 本身視為隨機變數,給它一個先驗 ,再計算後驗
完整的後驗往往難以計算,常見的捷徑是取它的眾數,即最大後驗(maximum a posteriori, MAP)估計:
若使用高斯先驗 ,則 等於 加上常數:權重衰減就是使用高斯先驗的 MAP。Laplace 先驗則給出 正則化。這把機率假設和 ML 02 中的正則化項連結起來。但 MAP 點估計仍然只是一個參數向量,無法告訴你參數有多不確定。近似整個後驗是 PR 08 與變分推論 [10] 的主題。
程式碼 · Python · 20 行
import numpy as np

rng = np.random.default_rng(0)
flips = rng.random(10) < 0.7          # 10 coin flips, true P(heads) = 0.7
k, n = flips.sum(), flips.size

phi = np.linspace(1e-3, 1 - 1e-3, 999)
log_lik = k*np.log(phi) + (n - k)*np.log(1 - phi)
a, b = 5.0, 5.0                        # Beta(5, 5) prior, centered on 0.5
log_prior = (a - 1)*np.log(phi) + (b - 1)*np.log(1 - phi)

print(f"{k} heads in {n} flips")
print("MLE  grid:", phi[log_lik.argmax()].round(3), " closed form:", k/n)
print("MAP  grid:", phi[(log_lik + log_prior).argmax()].round(3),
      " closed form:", round((k + a - 1)/(n + a + b - 2), 3))

# Gaussian MLE: sample mean and the 1/m (biased) variance
x = rng.normal(2.0, 3.0, 50)
print("Gaussian MLE mean, var:", x.mean().round(3), x.var().round(3),
      " unbiased var:", x.var(ddof=1).round(3))
在這個隨機種子下,10 次擲出 6 次正面。MLE 為 0.6;Beta(5, 5) 先驗把 MAP 估計拉向 0.5,得到 0.556,與閉合解 一致。資料越多,概似就越占主導,兩種估計會逐漸接近。高斯的 MLE 變異數(7.71)小於不偏估計(7.87),符合預期。
資訊理論
白話版。 資訊理論衡量驚訝程度。罕見的事件一旦發生,帶來大量資訊;確定的事件則毫無資訊。把驚訝程度取平均就是熵;使用錯誤分布所多出的驚訝,就是 KL 散度。
Claude Shannon 為了研究透過有雜訊的通道傳送訊息需要多少位元而創立了這個領域 [5];標準教科書是 Cover 與 Thomas [7]。對機器學習而言,最有用的概念是量化兩個分布有多不同。
自資訊與熵
結果 的自資訊(self-information)為
使用自然對數時單位為 nat;使用 時單位為位元(bit)(1 nat 位元)。確定事件()的資訊量為零;不太可能的事件資訊量很大;而獨立事件的資訊可以相加,因為對數把乘積變成總和。
Shannon 熵是自資訊的期望值:
我們採用 的約定,理由是 時 。熵是編碼從 抽出之結果所需的最少平均位元數(或 nat 數)。決定性結果的熵為零; 個結果的均勻分布熵最大,為 。參數為 的 Bernoulli 變數,,在 時達到 1 位元的峰值(圖 3 左)。
對連續變數, 稱為微分熵。使用時要小心:它可以是負的( 上的均勻分布 ),而且座標尺度一改它就跟著改。它並不是離散位元數的極限版本。
KL 散度
Kullback–Leibler 散度 [6] 衡量分布 與參考分布 有多不同:
用編碼的語言說,它是:當編碼是為 設計、卻用來編碼 的樣本時,額外需要的 nat 數。它的主要性質:
- 非負:,等號成立若且唯若 (離散情況;連續情況為「幾乎處處」相等)。這來自 Jensen 不等式,因為 是凸函數。
- 在無支撐處為無限大:若某個 使 但 ,散度為無限大。
- 不對稱:一般而言 ,而且不滿足三角不等式。因此 KL 不是距離度量,儘管它常被描述成「分布之間的距離」。
正向與反向 KL
當近似用的分布族太簡單時,這種不對稱會產生看得見的後果。圖 5 用單一高斯 去擬合有兩個分得很開之峰的目標 。
- 最小化正向 KL 時,若 在 有質量的地方很小,就會受到重罰。因此最佳高斯會涵蓋兩個峰,把平均放在兩峰之間(、),並把大量質量放在空蕩的谷底。對高斯 而言,正向 KL 的最佳解就是匹配 的平均與變異數。
- 最小化反向 KL 時,若 在 很小的地方很大,就會受到重罰。因此最佳高斯會鎖定其中一個峰(、),忽略另一個。
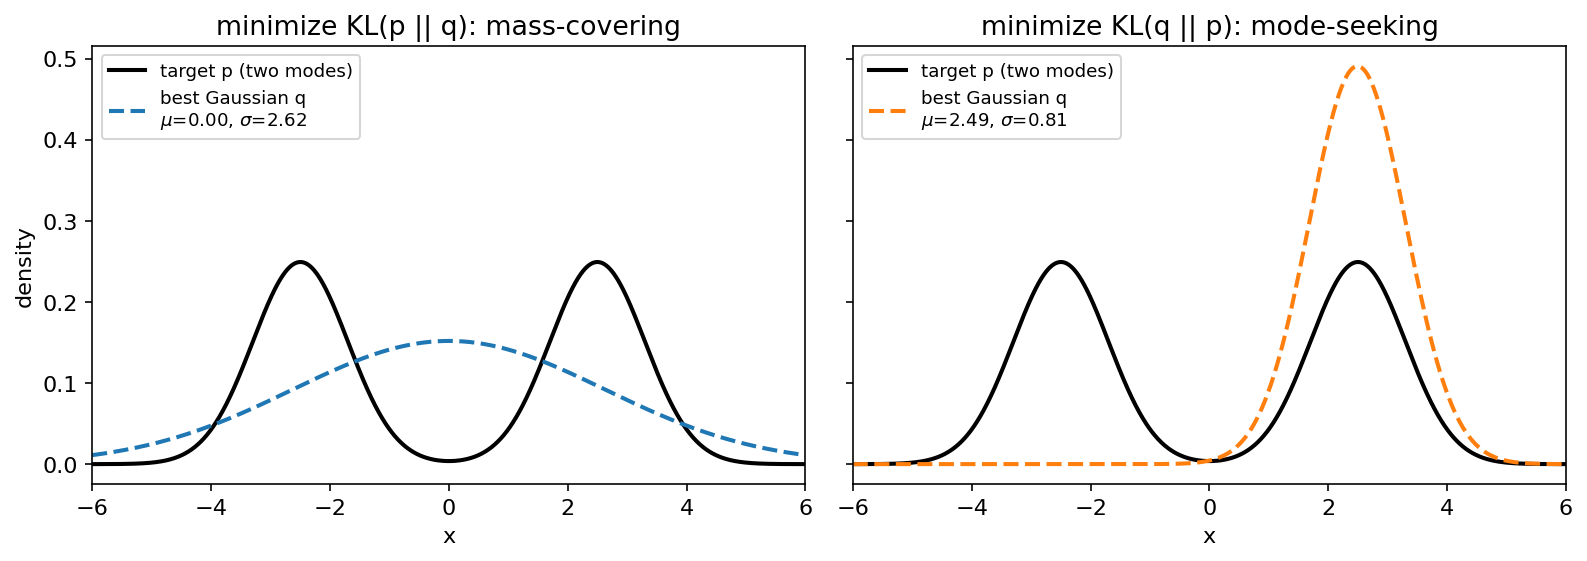
要最小化哪一個方向,是設計上的選擇。最大概似最小化的是從資料分布到模型的正向 KL,因此以概似訓練的模型(自迴歸模型、正規化流、VAE)傾向把機率分散到所有資料上,有時會產生模糊的樣本。變分推論通常最小化從近似分布到真實後驗的反向 KL [10],因此傾向低估後驗的不確定性。
交叉熵
相對於 的交叉熵為
因為 與 無關,對 最小化交叉熵就等於最小化正向 KL。在分類中, 是經驗標籤分布——每個樣本是一個 one-hot 向量——而 是模型的 softmax 輸出 。對真實類別為 的單一樣本,
其中 是類別 的 one-hot 向量。對整個資料集取平均,這正是條件負對數概似。所以「交叉熵損失」、「對數損失」與「類別模型的負對數概似」是同一個目標的三個名字。任何由負對數概似構成的損失,都是經驗分布與模型之間的交叉熵——這也是為什麼均方誤差同樣是高斯模型的「交叉熵」[1]。
互資訊
互資訊衡量知道一個變數能減少多少對另一個變數的不確定性:
其中 是條件熵, 是聯合熵。,等號成立若且唯若 與 獨立——和共變異數不同,它能偵測任何形式的相依。它對 與 是對稱的。
程式碼:資訊量
程式碼 · Python · 26 行
import numpy as np

p = np.array([.7, .2, .1])
q = np.array([.5, .3, .2])
entropy = -(p*np.log(p)).sum()
cross_entropy = -(p*np.log(q)).sum()
kl = (p*np.log(p/q)).sum()
reverse_kl = (q*np.log(q/p)).sum()
assert np.allclose(cross_entropy - entropy, kl) and kl >= 0
print("H(p), H(p,q), KL(p||q), KL(q||p) in nats:",
      np.round([entropy, cross_entropy, kl, reverse_kl], 4))
print("H(p) in bits:", (entropy/np.log(2)).round(4))

# Mutual information from a joint table (same weather/umbrella table)
P = np.array([[0.56, 0.14],
              [0.06, 0.24]])
px, py = P.sum(1), P.sum(0)
mi = (P*np.log(P/np.outer(px, py))).sum()
H = lambda t: -(t[t > 0]*np.log(t[t > 0])).sum()
assert np.isclose(mi, H(px) + H(py) - H(P.ravel()))
print("I(weather; umbrella) =", mi.round(4), "nats")

# Cross-entropy loss on one-hot labels equals mean -log q(y)
probs = np.array([[0.7, 0.2, 0.1], [0.1, 0.8, 0.1], [0.3, 0.3, 0.4]])
labels = np.array([0, 1, 2])
print("mean cross-entropy:", (-np.log(probs[np.arange(3), labels])).mean().round(4))輸出:、、、 nats——兩個方向的值不同。 為 1.1568 位元。天氣與帶傘的互資訊為 0.1637 nats,兩種公式算出的結果一致。三筆預測的平均交叉熵為 0.4987 nats。在真正的訓練程式中,請用融合函數直接從 logit 計算交叉熵,而不是先算機率(見 ML 01C)。
選讀:Shannon(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
結構化機率模型
白話版。 圖模型利用條件獨立結構,把聯合分布拆成較小部分;圖本身不足以確立因果。
100 個二元變數的聯合機率表需要 個數字。結構化機率模型,又稱圖模型(graphical models),利用條件獨立把聯合分布分解成小因子 [1], [3]。主要有兩類。
有向模型(貝氏網路)使用有向無環圖 。每個變數只依賴它的父節點 :
例如在 且 時,;刪掉邊 就是宣稱 ,最後一個因子縮短為 。有向圖很適合描述生成故事(「先選類別,再產生像素」),而混合模型 是最簡單的例子。
無向模型(馬可夫隨機場)使用無向圖。每個團(clique)(彼此全部相連的節點集合)有一個非負的因子 ,且
配分函數 用來正規化乘積;計算它往往是最困難的部分。無向模型適合對稱的交互作用,例如影像先驗中相鄰像素的關係,或用於分割的條件隨機場。
圖是對分布的一種描述,不是另一種分布:任何分布都可以用兩種方式寫出,只是其中一種可能精簡得多。深度學習常隱含地使用這些概念——自迴歸模型是全連接的有向模型,VAE 則是條件分布由神經網路表示的雙節點有向模型 [8]。
現代觀點
本篇的機率與資訊理論是古典內容。深度學習時代改變的是它如何被使用,以及實務上會在哪裡出錯。本節綜覽相關綜述文獻與近年方向;只整理它們的框架,不轉述基準數字。
校準:預測機率誠實嗎?
如果分類器在所有預測信心為 0.8 的輸入中,大約有 80% 是正確的,就稱它是校準良好的(calibrated)。Guo 等人 [11](ICML 2017)發現現代深度網路常常過度自信,並指出深度、寬度、權重衰減與批次正規化都會影響校準。他們主要推薦的溫度縮放(temperature scaling)——把所有 logit 除以一個在驗證集上擬合的純量 ——是 Platt scaling 的單參數版本;因為它只改變信心、不改變預測類別,至今仍是強力的基準方法。Wang 的綜述 [12] 把校準方法分為四大類:事後校準、訓練期間的正則化、不確定性估計,以及這些方法的組合;其修訂版也涵蓋大型語言模型的校準。從機率的角度看,教訓是:softmax 輸出是 的一個模型,和任何模型一樣,它的不確定性也可能是錯的,而不只是 argmax 會錯。
不確定性量化
兩篇主要綜述描繪了深度學習中不確定性研究的全貌。Abdar 等人 [13](Information Fusion,2021)回顧了貝氏近似、集成方法以及它們在許多領域的應用。Gawlikowski 等人 [14](Artificial Intelligence Review,2023)區分了可降低的模型(認知,epistemic)不確定性與不可降低的資料(偶然,aleatoric)不確定性——分別對應本篇開頭所說的第三與第一種不確定性來源——並比較了確定性單一網路、貝氏方法、集成與測試時資料擴增,以及校準的量測方式。
有兩篇原始研究特別有影響力。深度集成(deep ensembles)[15] 從不同的隨機初始化訓練多個網路,再平均它們的預測分布;這個簡單、可平行化的方法與近似貝氏神經網路表現相當,並且在分布外(out-of-distribution)輸入上表現出較高的不確定性。Ovadia 等人 [16](NeurIPS 2019)在資料集偏移下評測不確定性方法,發現以分布內驗證資料做的事後校準難以延續,而對多個模型做邊際化的方法(如集成)表現較穩定。
另一種假設較少的互補方法是共形預測(conformal prediction)。Angelopoulos 與 Bates [17] 提供了一份淺顯的入門:利用一組保留的校準資料,共形方法能把任何預訓練模型的分數轉成預測集合,並以使用者指定的機率包含真實標籤,前提是校準資料與測試資料可交換(exchangeable)。它不要求模型機率本身已經校準,因此對被當成黑盒子使用的視覺與語言系統很有吸引力。
表示學習中的互資訊
互資訊曾是自監督學習(ML 06)中熱門的目標。對比預測編碼(Contrastive Predictive Coding)[18] 提出了 InfoNCE 損失:它在多個負樣本中辨認出正樣本對,可以證明是在最大化互資訊的一個下界。Poole 等人 [19](ICML 2019)統一了許多變分互資訊界,並指出當真實互資訊很大時這些界會退化,在高偏差與高變異數之間取捨。Tschannen 等人 [20](ICLR 2020)主張這些方法的成功「不能只歸因於互資訊本身的性質」:編碼器架構與估計器的參數化至少同樣重要。現在的共識是把 InfoNCE 類的目標視為有資訊理論動機、行為良好的對比損失,而不是精確的互資訊估計器。
生成模型中的散度與潛在變數
生成建模就是應用機率。VAE [8] 最大化證據下界(evidence lower bound),它結合了重建概似與一個 KL 項;Blei 等人 [10] 回顧了變分推論,即在一個容易處理的分布族中最小化(反向)KL 來近似難解的後驗。正規化流 [9] 完全建立在變數變換公式上。擴散模型與流匹配模型(ML 08)結合了高斯雜訊、條件期望值與概似界。選擇哪一種散度(正向 KL、反向 KL 或其他)決定了模型是涵蓋全部資料,還是集中在少數眾數上——與圖 5 是同一幅圖像,只是規模大得多。
尚待解決的問題
- 分布偏移下的校準。 在驗證集上成立的校準,換到新的相機、醫院或提示詞時可能失效 [16];如何偵測這種情況仍是開放問題。
- 區分不確定性類型。 把預測不確定性拆成認知與偶然兩部分,在概念上很清楚,但對大型網路很難可靠地做到 [14]。
- 高維資訊量的估計。 變分互資訊界有根本的偏差–變異數限制 [19],因此對深度表示做資訊理論宣稱時需要格外謹慎。
- 基礎模型的不確定性。 把校準與共形方法應用到輸出開放式內容的大型視覺–語言模型與語言模型,是活躍的研究方向 [12], [17]。
重點整理
- 離散機率總和為一;連續密度積分為一,單點密度可以大於一。
- 邊際化與連鎖法則是恆等關係,獨立性則是額外假設。
- 共變異數為零,通常不足以推得獨立。
- 概似與先驗假設決定損失及正則化,應明確交代尺度參數。
- 貝氏定理以證據更新先驗信念;密度變換還需要體積修正。
- 交叉熵可拆成熵與 KL;KL 不對稱,涵蓋或集中於模式的行為取決於近似家族及問題。
練習
- 單位與確定性。 (a) 把 1 nat 的損失換算成位元。(b) 分別計算公平硬幣、確定結果與公平八面骰的熵(以位元為單位)。
提示
(a) 除以 :約 1.443 位元。(b) 1 位元、0 位元與 位元。 個結果的均勻分布熵為 ,是 個結果所能達到的最大值。
- 盛行率偏移。 使用貝氏定理一節中的偵測器,找出讓陽性結果恰好像擲硬幣、即 的盛行率。
提示
令盛行率為 ,解 ,得 ,約 5.3%。低於這個值時,大多數警報都是假的。
- 相依但不相關。 令 以相同機率取 ,且 。證明 ,並以位元計算 。
提示
且 ,所以共變異數為零。因為 是 的函數,,於是 。 的機率為 、 的機率為 ,所以 位元。
- 高斯 MLE 等於平方誤差。 證明在 固定時,對 最大化 等同於最小化均方誤差。如果 也由網路預測,會有什麼改變?
提示
負對數概似為 。 固定時,只有平方誤差與 有關。如果網路也預測 (例如透過 softplus),每個樣本的誤差會被 加權,而 懲罰項會防止變異數無限制地變大——這就是異質變異(heteroscedastic)迴歸模型。
- 變數變換。 若 (均勻分布)且 ,, 的密度是什麼?用 NumPy 抽樣驗證你的答案。
提示
且 ,而在 上 。所以當 時 :指數分布。這就是反轉換抽樣(inverse-transform sampling)的技巧。
- KL 的方向。 對 與 ,計算 與 。哪一個是無限大?這對以最大概似訓練模型有什麼啟示?
提示
nats(第三項是 )。,因為 在 沒有質量的地方放了質量。最大概似最小化的是 ;只要模型對任何一筆觀察到的樣本給出零機率,它就會變成無限大——所以以概似訓練的模型必須在資料可能出現的每個地方都分配一些機率。
參考文獻
- I. Goodfellow, Y. Bengio and A. Courville, Deep Learning, MIT Press, 2016, ch. 3 “Probability and Information Theory”. Book
- C. M. Bishop and H. Bishop, Deep Learning: Foundations and Concepts, Springer, 2024. Book
- K. P. Murphy, Probabilistic Machine Learning: An Introduction, MIT Press, 2022. Book
- M. P. Deisenroth, A. A. Faisal and C. S. Ong, Mathematics for Machine Learning, Cambridge University Press, 2020. Book
- C. E. Shannon, “A Mathematical Theory of Communication,” Bell System Technical Journal, vol. 27, pp. 379–423, 1948. DOI
- S. Kullback and R. A. Leibler, “On Information and Sufficiency,” The Annals of Mathematical Statistics, vol. 22, pp. 79–86, 1951. DOI
- T. M. Cover and J. A. Thomas, Elements of Information Theory, 2nd ed., Wiley, 2006. DOI
- D. P. Kingma and M. Welling, “Auto-Encoding Variational Bayes,” in Proc. International Conference on Learning Representations (ICLR), 2014. arXiv
- G. Papamakarios, E. Nalisnick, D. J. Rezende, S. Mohamed and B. Lakshminarayanan, “Normalizing Flows for Probabilistic Modeling and Inference,” Journal of Machine Learning Research, vol. 22, no. 57, pp. 1–64, 2021. arXiv
- D. M. Blei, A. Kucukelbir and J. D. McAuliffe, “Variational Inference: A Review for Statisticians,” Journal of the American Statistical Association, vol. 112, no. 518, pp. 859–877, 2017. DOI
- C. Guo, G. Pleiss, Y. Sun and K. Q. Weinberger, “On Calibration of Modern Neural Networks,” ICML, 2017. arXiv
- C. Wang, “Calibration in Deep Learning: A Survey of the State-of-the-Art,” arXiv:2308.01222, 2023 (revised 2025). arXiv
- M. Abdar et al., “A Review of Uncertainty Quantification in Deep Learning: Techniques, Applications and Challenges,” Information Fusion, vol. 76, pp. 243–297, 2021. DOI
- J. Gawlikowski et al., “A Survey of Uncertainty in Deep Neural Networks,” Artificial Intelligence Review, vol. 56, pp. 1513–1589, 2023. DOI
- B. Lakshminarayanan, A. Pritzel and C. Blundell, “Simple and Scalable Predictive Uncertainty Estimation using Deep Ensembles,” NeurIPS (NIPS), 2017. arXiv
- Y. Ovadia et al., “Can You Trust Your Model’s Uncertainty? Evaluating Predictive Uncertainty Under Dataset Shift,” NeurIPS, 2019. arXiv
- A. N. Angelopoulos and S. Bates, “A Gentle Introduction to Conformal Prediction and Distribution-Free Uncertainty Quantification,” arXiv:2107.07511, 2021. arXiv
- A. van den Oord, Y. Li and O. Vinyals, “Representation Learning with Contrastive Predictive Coding,” arXiv:1807.03748, 2018. arXiv
- B. Poole, S. Ozair, A. van den Oord, A. A. Alemi and G. Tucker, “On Variational Bounds of Mutual Information,” ICML, 2019. arXiv
- M. Tschannen, J. Djolonga, P. K. Rubenstein, S. Gelly and M. Lucic, “On Mutual Information Maximization for Representation Learning,” ICLR, 2020. arXiv
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 01C・數值計算與梯度檢查 · 25 分鐘