ML 05・注意力與視覺 Transformer
先備知識:ML 03・卷積、影像濾波與 CNN
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 追蹤 query、key、value 與注意力權重。
- 建構多頭、遮罩與交叉注意力。
- 說明位置資訊與 Transformer 區塊。
- 比較區塊式、視窗式與混合視覺模型。
- 區分注意力的運算量、記憶體流量與上下文取捨。
先看全貌
CNN(ML 03)讓資訊透過固定的局部鄰域傳遞:一個像素要經過很多層,才能「聽到」遠處像素的消息。注意力(attention)則讓每個位置根據自己目前的內容,自行決定要讀取哪些其他位置,而且一步就到。要辨認一隻鳥,含有鳥頭的 patch 可以直接參考遠處含有翅膀的 patch。
注意力的想法來自用循環網路做的機器翻譯:ML 04 說明了它如何移除編碼器–解碼器 RNN 的單一向量瓶頸。Vaswani 等人的 Transformer [1] 走得更遠,完全拿掉循環結構,編碼器與解碼器都只由注意力和逐 token 的小型網路組成。Dosovitskiy 等人的 Vision Transformer(ViT)[2] 則幾乎原封不動地把 Transformer 編碼器套用到影像 patch 序列上。Bishop 與 Bishop [10] 提供了現代的教科書式推導,而現代觀點一節討論的綜述 [3]、[11]、[12] 則整理了眾多視覺變體。讀完本篇之後,DLCV 02 會在實務上比較 CNN 與 Transformer 骨幹在分類上的表現,ML 06 則說明這些骨幹如何在沒有標註的情況下預訓練。
自注意力:query、key 與 value
白話版。 query 為可存取的 key 評分,正規化後的分數用來加權 value,讓各 token 選取可讀取的內容。
精確版。 把 個 token 疊成矩陣 的各列,其中 是模型寬度。三個可學習的矩陣將它們投影:
其中 、。縮放點積注意力(scaled dot-product attention)[1] 為
是一個 的分數矩陣:第 項是 query 與 key 的點積,衡量 token 對 token 有多相關。逐列的 softmax 把每一列轉成非負且總和為一的權重,得到注意力矩陣 。輸出 每個 token 一列:第 列是 ,也就是 value 向量的加權平均。
為什麼要三個不同的投影? 如果 query 和 key 是同一個向量,每個 token 都會和自己最吻合,而且相關性被迫是對稱的。分開的 與 讓「我要找的東西」可以不同於「我能提供的東西」(眼睛的 patch 可以去找鼻子,而不必自己就是鼻子);分開的 則讓「我能提供的東西」不同於「我實際傳出的內容」。
為什麼要除以 ? 若 query 與 key 的各分量互相獨立、平均為零、變異數為一,則點積 的平均為零、變異數為 。不縮放的話,頭越寬分數就越大,softmax 會飽和(幾乎所有權重集中在一個 token 上),梯度也會變得極小。除以 讓變異數回到一。這是一種尺度慣例,並不是把每個 query 正規化成單位長度。
決定誰跟誰交談的是內容,而不是位置。 卷積的權重綁定在相對位置上;注意力的權重則是在執行時由資料算出來的。由此衍生一個性質:自注意力是排列等變(permutation-equivariant)的。把輸入 token 打亂,輸出也會以相同方式被打亂,因為公式裡沒有任何東西涉及 token 的順序。下面的程式碼同時檢查形狀與這個對稱性。
程式碼 · Python · 15 行
import torch

torch.manual_seed(0)
X = torch.randn(5, 8)                   # N=5, D=8
Wq, Wk, Wv = [torch.randn(8, 4) for _ in range(3)]
def attention(x):
    q, k, v = x @ Wq, x @ Wk, x @ Wv
    a = (q @ k.T / q.shape[-1]**.5).softmax(dim=-1)
    return a @ v, a
y, a = attention(X)
perm = torch.tensor([3, 0, 4, 1, 2])
yp, _ = attention(X[perm])
assert torch.allclose(a.sum(-1), torch.ones(5), atol=1e-6)
assert torch.allclose(yp, y[perm], atol=1e-5)
print("output shape:", tuple(y.shape))
這個對稱性很適合處理集合,但影像不是一堆 patch 的集合:眼睛長在嘴巴下面的臉,就不是一張臉。下面介紹的位置資訊會打破這個對稱性。
多頭注意力
白話版。 平行執行好幾個注意力運算,每個都有自己較小的投影,讓不同的頭可以追蹤不同的關係(鄰近紋理、同一個物體、對稱的部位)。最後把它們的輸出串接起來再混合。
精確版。 有 個頭時,第 個頭有自己的 ,通常取 :
其中方括號把 個寬度為 的輸出串接回寬度 , 再把它們混合。由於每個頭寬度只有 ,多頭注意力的成本與一個全寬度的頭差不多,所有投影合計 個權重(另加偏差)。各個頭不保證會學到人類看得懂的角色;有些頭是多餘的,可以被剪除。
下面的實作把投影切成多個頭、逐頭計算分數、串接後再投影,結果與 nn.MultiheadAttention 完全一致。它也示範了因果遮罩:在 softmax 之前把禁止的分數設為 ,這些位置的權重就會恰好為零。
程式碼 · Python · 29 行
import torch
from torch import nn

torch.manual_seed(0)
B, N, D, h = 2, 6, 16, 4
mha = nn.MultiheadAttention(D, num_heads=h, batch_first=True, bias=False)
X = torch.randn(B, N, D)

def multi_head(x):
    Wq, Wk, Wv = mha.in_proj_weight.chunk(3)          # each D x D (rows = outputs)
    q, k, v = x @ Wq.T, x @ Wk.T, x @ Wv.T              # B x N x D
    split = lambda t: t.view(B, N, h, D // h).transpose(1, 2)   # B x h x N x d_k
    q, k, v = split(q), split(k), split(v)
    scores = q @ k.transpose(-2, -1) / (D // h) ** 0.5  # B x h x N x N
    A = scores.softmax(dim=-1)
    heads = A @ v                                       # B x h x N x d_k
    concat = heads.transpose(1, 2).reshape(B, N, D)     # put the heads side by side
    return concat @ mha.out_proj.weight.T, A

ours, A = multi_head(X)
ref, _ = mha(X, X, X)
print("matches nn.MultiheadAttention:", torch.allclose(ours, ref, atol=1e-5))
print("attention tensor:", tuple(A.shape), "| parameters:",
      sum(p.numel() for p in mha.parameters()), "= 4 * D^2 =", 4 * D * D)

# Causal mask: query i may only read keys j <= i
causal = torch.triu(torch.ones(N, N, dtype=torch.bool), diagonal=1)   # True = forbidden
out_c, w_c = mha(X, X, X, attn_mask=causal)
print("no weight on the future:", torch.all(w_c[:, causal] == 0).item())
輸出為 True、形狀 (2, 4, 6, 6) 的注意力張量(批次、頭、query、key)、1024 = 4 * D^2 = 1024,以及因果檢查的 True。正式程式可使用 torch.nn.functional.scaled_dot_product_attention,它會在支援的條件下使用融合核心 [7]。不能直接照抄布林遮罩: nn.MultiheadAttention 的 True 表示禁止讀取,scaled_dot_product_attention 的 True 卻表示允許讀取。評估時也要明確傳入 dropout_p=0.0,因為函式不會查看模組的訓練旗標。替換教學實作時,應分別確認遮罩語意與 dropout 設定。
連接 token 的三種方式
白話版。 一個 query 可以讀取哪些 token,是模型設計的一部分,以分數矩陣上的遮罩來表達。
| 機制 | query 可讀取 | 典型用途 |
|---|---|---|
| 雙向自注意力 | 同一序列中的所有 token | ViT 及其他影像編碼器 |
| 因果(遮罩)自注意力 | 只有自己與更早的位置 | 下一個 token 的生成、自迴歸影像模型 |
| 交叉注意力 | 來自另一個序列的 token | 解碼器讀取編碼器;影像 token 讀取文字 |
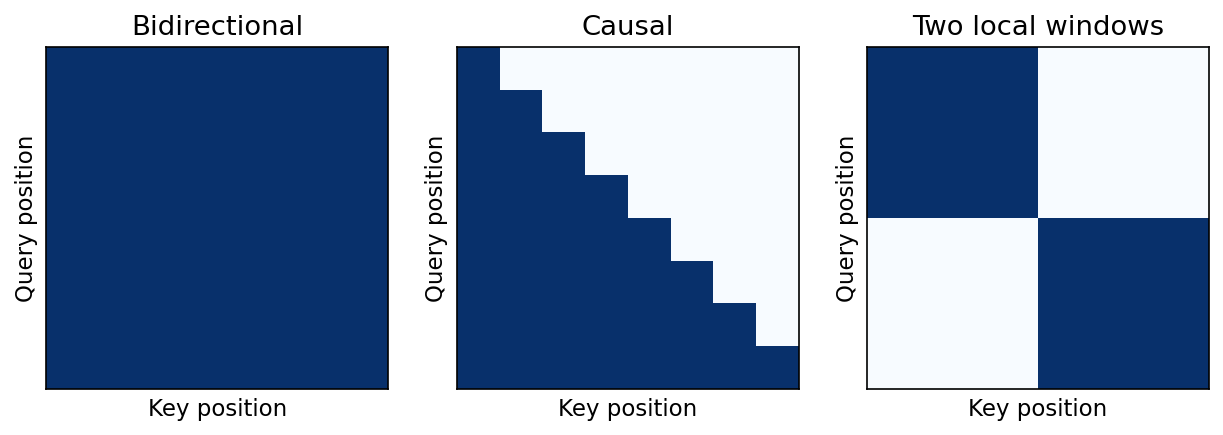
在交叉注意力中,query 來自一個序列 ,key 與 value 則來自另一個序列 :、、。分數矩陣的形狀是 ,輸出每個 query 一列。原始 Transformer 的解碼器就是這樣讀取編碼器;影像描述模型這樣讀取影像特徵;文字生成影像的擴散模型也這樣讀取文字提示(ML 08),而不需要在影像 patch 上做自迴歸。
注意力權重是計算的一部分,並不自動等於一種解釋。很大的權重可能乘上一個毫無資訊的 value,而殘差與 MLP 路徑也會影響輸出。
位置資訊
白話版。 純內容自注意力沒有內建位置標記;位置嵌入、相對位置資訊或與位置相關的遮罩提供結構。
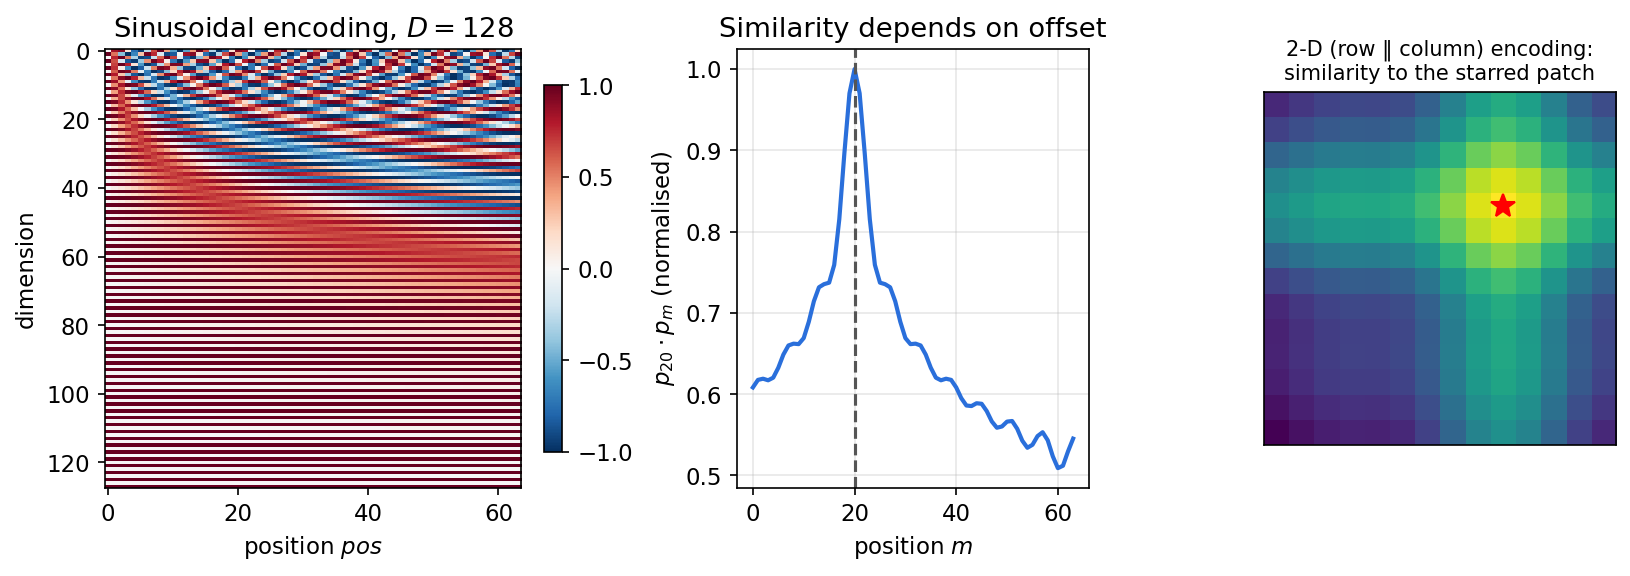
正弦位置編碼。 原始 Transformer [1] 在位置 的 token 上加一個固定向量 :
每一對維度 都是一個以角頻率 繞圓旋轉的點,頻率從很快(每個位置一弧度)到非常慢都有。由三角函數的和角公式可得兩個性質。第一,對任一固定位移 ,都有 ,其中 是一個與 無關的區塊對角旋轉矩陣;因此一個線性層就能學會「往後看 個位置」。第二, 只與位移 有關(圖 2 中)。
程式碼 · Python · 20 行
import numpy as np

def sinusoidal(n_pos, D):
    pos = np.arange(n_pos)[:, None]
    omega = 1.0 / 10000 ** (np.arange(0, D, 2) / D)    # one frequency per sin/cos pair
    pe = np.zeros((n_pos, D))
    pe[:, 0::2] = np.sin(pos * omega)
    pe[:, 1::2] = np.cos(pos * omega)
    return pe, omega

pe, omega = sinusoidal(100, 16)
k = 7                                                 # a fixed offset
# block-diagonal rotation that maps p_pos to p_{pos+k}, the same for every pos
R = np.zeros((16, 16))
for i, w in enumerate(omega):
    c, s = np.cos(w * k), np.sin(w * k)
    R[2 * i:2 * i + 2, 2 * i:2 * i + 2] = [[c, -s], [s, c]]
print("p[pos+k] == p[pos] @ R for all pos:", np.allclose(pe[:-k] @ R, pe[k:]))
print("dot products depend only on offset:",
      np.isclose(pe[10] @ pe[17], pe[50] @ pe[57]))
兩項檢查都印出 True。
其他做法。
- 可學習的絕對位置嵌入:每個位置一個可訓練的向量,ViT [2] 就是如此。ViT 依光柵(raster)順序編號的一維可學習嵌入,效果與明確的二維嵌入差不多;訓練後,同一列或同一行的 patch 嵌入會變得相似,代表模型自己學會了網格結構。換到新的解析度時,先用二維內插調整嵌入網格的大小,再進行微調。
- 相對位置表示(Shaw 等人 [17])在 token 與 的分數上,加一個取決於位移 的可學習項。Swin [5] 則在每個視窗的分數上加一張可學習的相對位置偏差(relative position bias)表。
- 旋轉位置嵌入(rotary position embedding, RoPE;Su 等人 [16])把每個 query 與 key 依其位置旋轉一個成比例的角度,使用的正是上面程式碼中的那種旋轉。於是分數 只透過 依賴位置。RoPE 已是大型語言模型的標準配備,在視覺中也越來越常見,做法是對影像的兩個軸分別旋轉。
- 不加明確編碼:網路內部的卷積(如 CvT [19]),或邊界的零填補,本身就可能洩漏足夠的位置資訊。
Transformer 區塊
白話版。 一個區塊交替做兩件事:注意力讓 token 互相交換資訊;接著一個小型 MLP 分別處理每個 token。殘差連接與正規化讓整個堆疊保持穩定。
精確版。 ViT 與大多數現代模型使用的前置正規化(pre-norm)區塊為
是層正規化(layer normalization)[14]:它把每個 token 的 個特徵標準化為平均零、變異數一,再套用可學習的縮放與平移;與 BatchNorm 不同,它不依賴同一批次中的其他樣本。MLP 把每個 token 從 擴展到通常 個隱藏單元,套用 GELU 非線性 [26](, 為標準常態分布的累積分布函數),再投影回去。殘差相加代表每個子層只需學習一個修正量,與 ResNet 完全相同。
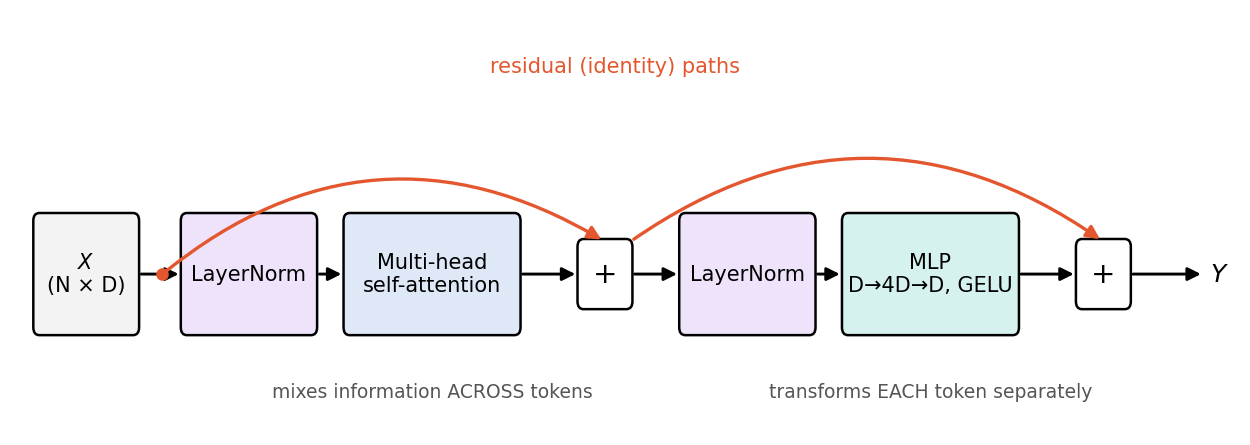
原始 Transformer 把 LayerNorm 放在每次殘差相加之後(後置正規化,post-norm)。Xiong 等人 [15] 證明,使用後置正規化時,初始化階段靠近輸出的梯度很大,這正是它需要學習率暖身(warm-up)的原因;前置正規化則讓梯度保持穩定,可以不用暖身就訓練。所以只說「一個 Transformer」並不完整,還得說明正規化放在哪裡。每個區塊的權重數:注意力 、MLP ,合計約 ,其中三分之二在 MLP。
Vision Transformer(ViT)
白話版。 把影像切成方形 patch,把每個 patch 變成向量,加上位置資訊,然後送進標準的 Transformer 編碼器。答案從一個額外的特殊 token 讀出。
切成 patch。 對一張 像素、 個通道的影像,若 patch 大小 能整除 與 ,就有 個 patch。把每個 patch 攤平成 ,再做線性投影:
其中 是可學習的 patch 嵌入, 是加在序列最前面的可學習類別 token(class token), 存放可學習的位置嵌入。經過 個區塊後,對類別 token 的輸出套用一個 LayerNorm 與線性分類頭,就得到 logits。把所有 patch 的輸出取平均(mean pooling)也是同樣常見的替代做法。
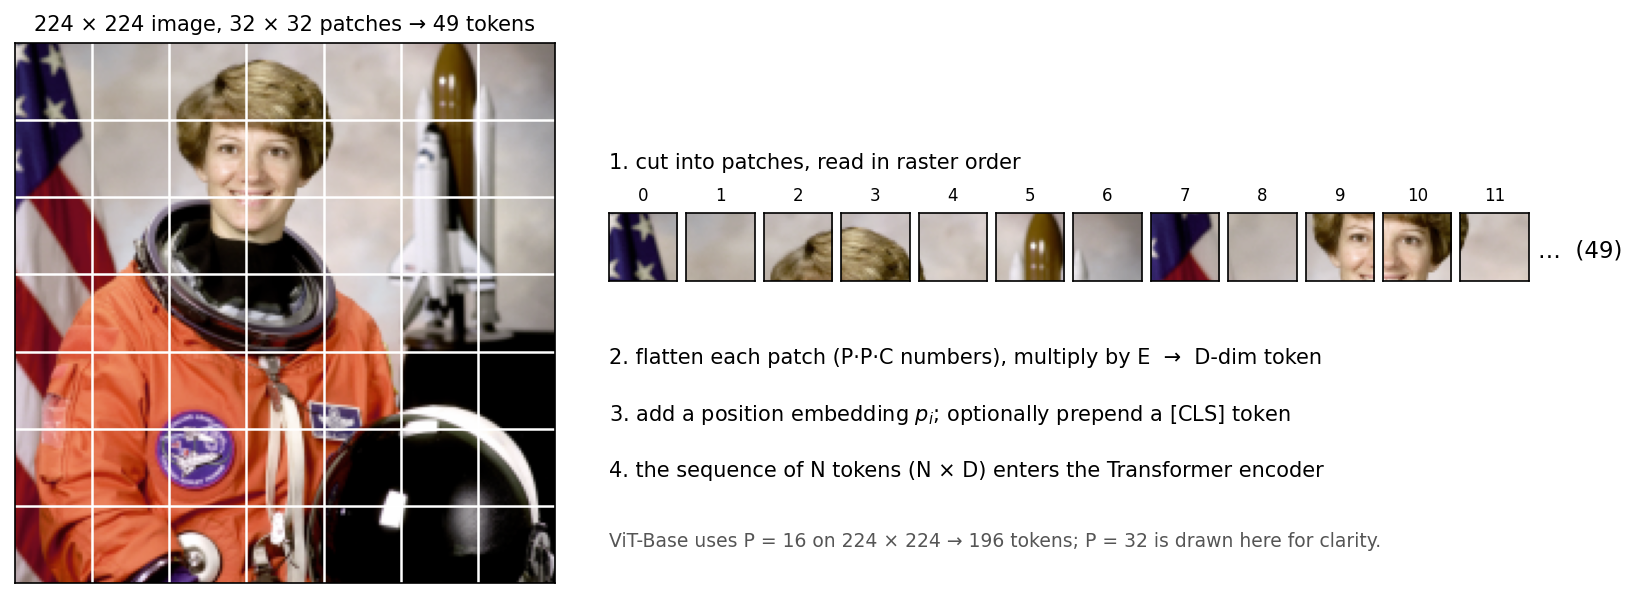
對不重疊的 patch 套用線性映射,恰好等於核大小與步幅都是 的卷積,實作上也正是這樣寫:
程式碼 · Python · 20 行
import torch
from torch import nn

torch.manual_seed(0)
B, C, H, W, P, D = 2, 3, 32, 32, 8, 48
x = torch.randn(B, C, H, W)

# 1) explicit: cut into P x P patches, flatten each, multiply by E
patches = x.unfold(2, P, P).unfold(3, P, P)                 # B, C, H/P, W/P, P, P
patches = patches.permute(0, 2, 3, 1, 4, 5).reshape(B, -1, C * P * P)   # B, N, P*P*C
E = torch.randn(C * P * P, D) * 0.02
tokens_explicit = patches @ E                                # B, N, D

# 2) the same linear map written as a convolution with kernel = stride = P
conv = nn.Conv2d(C, D, kernel_size=P, stride=P, bias=False)
conv.weight.data = E.T.reshape(D, C, P, P)
tokens_conv = conv(x).flatten(2).transpose(1, 2)             # B, N, D

print("tokens:", tuple(tokens_conv.shape), "| identical:",
      torch.allclose(tokens_explicit, tokens_conv, atol=1e-5))
輸出為 16 個寬度 48 的 token,以及 True。
模型大小。 標準設定有 ViT-Base(12 個區塊、、12 個頭、約 8,600 萬個參數)、ViT-Large(24 個區塊、、16 個頭)與 ViT-Huge(32 個區塊、、16 個頭)[2]。「ViT-B/16」代表使用 patch 的 Base 模型。patch 大小是最主要的運算量旋鈕: 減半, 變成四倍,注意力分數的數量變成十六倍。小 patch 保留細節;大 patch 便宜,但比 patch 還細的資訊都會遺失,而且後面任何一層都救不回來。
資料的教訓。 Dosovitskiy 等人 [2] 發現,只在 ImageNet-1k(約 130 萬張影像)上訓練的 ViT,表現略遜於規模相當的 ResNet;但若先在 ImageNet-21k(1,400 萬張)或 JFT-300M(3 億張)上預訓練再微調,它就能追平甚至超越 ResNet,而且預訓練成本更低。他們的解釋是歸納偏置(inductive bias):CNN 在每一層都假設局部性與平移等變性,而 ViT 只在 patch 嵌入內是局部的,空間關係必須從資料中學出來。Raghu 等人 [18] 比較了 ViT 與 ResNet 的內部表徵,發現 ViT 各層的表徵更加一致、較低層同時兼顧局部與全域的注意力,而且要在早期層學到局部注意力,需要大規模的預訓練。
程式碼:在手寫數字上訓練一個小型 ViT
這個完整範例在與 ML 03 CNN 相同的 手寫數字資料上訓練一個小型 ViT,使用 的 patch(16 個 token)、一個類別 token、可學習的位置嵌入,以及四個前置正規化區塊。在 CPU 上約半分鐘即可跑完。
程式碼 · Python · 52 行
import copy
import numpy as np
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

torch.manual_seed(0)
torch.set_num_threads(1)

class TinyViT(nn.Module):
    def __init__(self, img=8, patch=2, chans=1, D=64, depth=4, heads=4, classes=10):
        super().__init__()
        N = (img // patch) ** 2
        self.patch = nn.Conv2d(chans, D, kernel_size=patch, stride=patch)   # patchify + E
        self.cls = nn.Parameter(torch.zeros(1, 1, D))                       # [CLS] token
        self.pos = nn.Parameter(torch.randn(1, N + 1, D) * .02)             # learned positions
        layer = nn.TransformerEncoderLayer(D, heads, dim_feedforward=4 * D, dropout=0.1,
                                           activation="gelu", batch_first=True,
                                           norm_first=True)                 # pre-norm block
        self.blocks = nn.TransformerEncoder(layer, depth, enable_nested_tensor=False)
        self.norm, self.head = nn.LayerNorm(D), nn.Linear(D, classes)

    def forward(self, x):
        t = self.patch(x).flatten(2).transpose(1, 2)                         # B, N, D
        t = torch.cat([self.cls.expand(len(t), -1, -1), t], dim=1) + self.pos
        return self.head(self.norm(self.blocks(t))[:, 0])                    # read [CLS]

d = load_digits()
X = torch.tensor(d.images[:, None] / 16.0, dtype=torch.float32)
y = torch.tensor(d.target)
train, test = train_test_split(np.arange(len(y)), test_size=.2, stratify=d.target,
                               random_state=0)
train, val = train_test_split(train, test_size=.2, stratify=d.target[train], random_state=1)
model = TinyViT()
opt = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=0.05)
best = (float("inf"), None)
for epoch in range(30):
    model.train()
    for idx in torch.tensor(train)[torch.randperm(len(train))].split(64):
        loss = nn.functional.cross_entropy(model(X[idx]), y[idx])
        opt.zero_grad(); loss.backward(); opt.step()
    model.eval()
    with torch.no_grad():
        v = nn.functional.cross_entropy(model(X[val]), y[val]).item()
    if v < best[0]:
        best = (v, copy.deepcopy(model.state_dict()))
model.load_state_dict(best[1]); model.eval()
with torch.no_grad():
    acc = (model(X[test]).argmax(1) == y[test]).float().mean().item()
print("parameters:", sum(p.numel() for p in model.parameters()))
print("best validation loss:", round(best[0], 4), "| held-out accuracy:", round(acc, 4))
在我們的執行中,它約有 202,000 個參數,保留測試集準確率約 95%;而 ML 03 的 CNN 在相同的資料切分下,只用不到 10,000 個參數就達到約 96%。在小型資料集上,CNN 內建的局部性大約值二十倍的參數量。這是「資料的教訓」的縮影,而不是對大規模效能的定論。
選讀:ViT(見「論文導讀」頁)。從原圖理解證據、設計選擇與限制。
訓練配方:DeiT 及其後續
白話版。 早期 ViT 與 CNN 在 ImageNet 規模資料上的差距,很大一部分其實來自訓練方式,而不是架構。
DeiT(Touvron 等人 [4])只用 ImageNet-1k 就把 ViT 訓練到具競爭力,靠的是強力的資料擴增(RandAugment、Mixup、CutMix、隨機抹除)、大量正則化(stochastic depth、label smoothing)以及較長的訓練排程。它還引入了蒸餾 token(distillation token):一個類似類別 token 的額外可學習 token,其輸出被訓練去符合一個預訓練 CNN 教師模型的預測。CNN 的歸納偏置因此透過它的預測轉移過來。後來的 DeiT III [27] 證明,一個更簡單但仔細調校的監督式配方(輕量的「3-Augment」擴增、簡單的裁切,以及二元交叉熵損失函數)能讓純 ViT 更強。Steiner 等人 [25] 對資料、擴增與正則化做了大規模研究(「AugReg」),發現擴增、正則化與運算量的適當組合,可以追上用大約十倍資料訓練的模型。
一般性的教訓與 ML 03 討論 ConvNeXt 時相同:只有在資料、擴增、解析度、訓練排程與運算量都對齊的情況下,比較架構才有意義。
Swin 與階層式 Transformer
白話版。 對數千個 token 做全域注意力很昂貴,而且純 ViT 從頭到尾維持同一個粗解析度,不利於偵測與分割。Swin 把注意力限制在局部視窗內,在層與層之間平移視窗讓資訊仍能擴散,並合併 patch 來建立類似 CNN 的金字塔。
視窗。 Swin [5] 把 token 網格切成互不重疊、每個 個 token 的視窗(通常 ),只在每個視窗內部計算自注意力。對 的 token 網格、 個通道,論文給出的成本為
其中 是四個投影的成本,第二項則是計算分數與加權的乘法。全域成本對 token 數 是二次方;固定 時,視窗成本是線性的。
平移視窗。 若視窗固定不動,不同視窗的 token 永遠不會互動。Swin 讓一般視窗與在兩個方向各平移 個 token 的視窗交替出現。在第 層位於視窗邊界附近的 token,到第 層會與相鄰視窗的 token 同在一個視窗,資訊因此得以跨越邊界(圖 5)。高效率的實作會把特徵圖做循環平移,並用遮罩避免從對側邊緣繞過來的 token 互相注意。
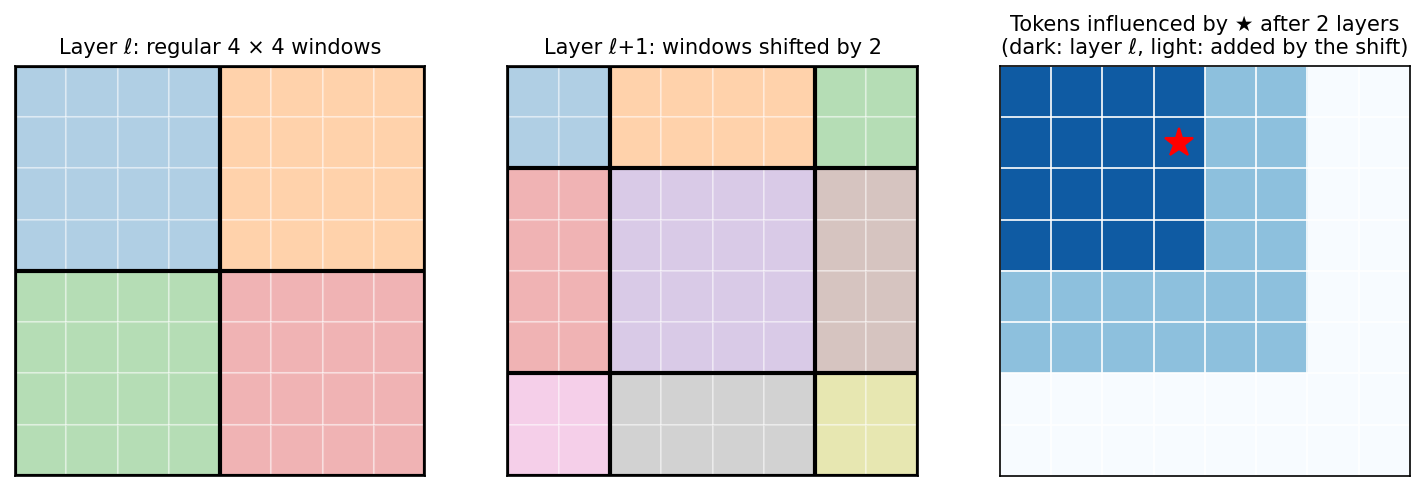
階層結構。 在各階段之間,patch 合併(patch merging)把每 組相鄰 token 串接後做線性投影,使解析度減半、通道數加倍,就像步幅卷積一樣。四個階段分別產生輸入解析度 、、、 的特徵圖,與 ResNet 的金字塔相同,因此 Swin 可以在偵測與分割框架中直接取代 CNN 骨幹。每個視窗的分數也會加上可學習的相對位置偏差。Swin V2 [32] 用殘差後置正規化、縮放餘弦注意力(scaled cosine attention),以及連續、對數間隔的位置偏差來擴大規模,後者在不同視窗大小與解析度之間的遷移效果更好。
CNN–Transformer 混合模型
白話版。 卷積擅長在資料少時處理局部細節;注意力擅長長距離互動。混合模型讓兩者各自在適合的地方發揮。
- 卷積起始層(stem)。 原始 ViT 論文就已測試過一種「混合」版本,其 patch 取自 ResNet 的特徵圖而不是原始像素 [2];在較小的運算預算下有幫助。
- 在注意力裡放卷積。 CvT [19] 在每個階段使用卷積式 token 嵌入,並用深度可分離卷積產生 query、key、value 的投影,藉此內建局部性,也因此可以省去明確的位置嵌入。
- 依階段堆疊。 CoAtNet [20] 在前期放深度卷積階段(此時解析度高、局部模式為主),後期放相對注意力階段;它在各種資料規模下都報告了強勁的結果,因為卷積階段在資料有限時提供了歸納偏置。
- 行動裝置混合模型。 MobileViT [28] 在 MobileNet 風格的網路中插入小型 Transformer 區塊,以行動裝置等級的成本加入全域脈絡。
- 反方向。 ConvNeXt(見 ML 03)把 Transformer 時代的設計選擇引進純 CNN,並追平了 Swin。
成本與高效率注意力
白話版。 全域注意力比較 token 配對,配對運算量隨 token 數呈平方成長;效率方法減少記憶體流量、互動或 token 數。
對 個寬度為 的 token,每層分數矩陣約需 次乘加,投影與 MLP 約需 次。單純的實作會為每個頭儲存一個 矩陣。固定 patch 大小時,影像高與寬各加倍, 變成四倍,成對分數變成十六倍。
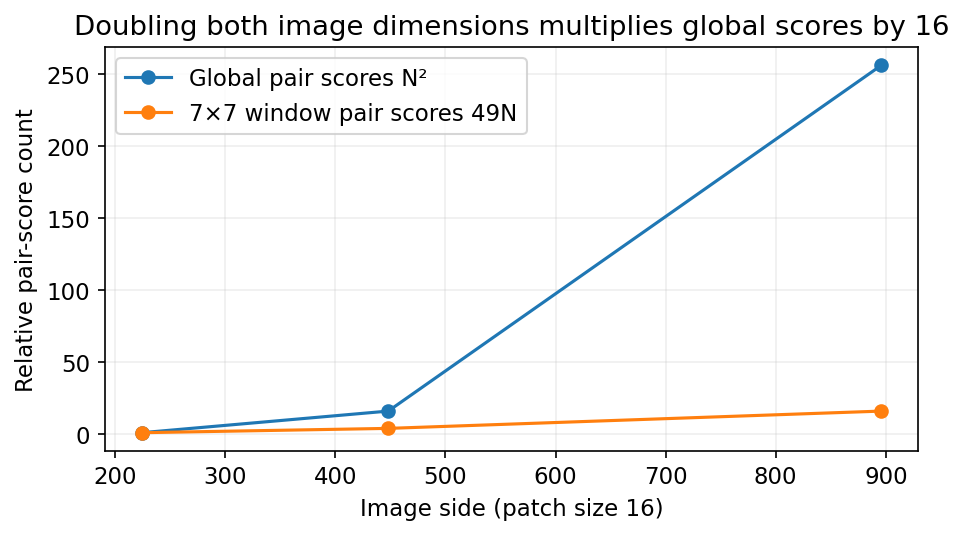
主要的方法家族:
- 精確但更快。 FlashAttention [6] 把計算切成區塊(tiling),讓 query、key、value 的區塊留在快速的晶片內記憶體中,並且從不把完整的 矩陣寫到較慢的 GPU 記憶體,藉此計算精確的注意力;FlashAttention-2 [29] 進一步改善了工作切分方式。算術量仍是二次方,但記憶體用量變成線性,實際執行時間也大幅下降。PyTorch 的
scaled_dot_product_attention在可行時會自動選用這類核心 [7]。 - 限制連接方式。 視窗(Swin)或其他稀疏模式減少了成對的數量,代價是需要好幾層才能達成全域溝通。
- 減少 token。 Token Merging(ToMe)[21] 在預訓練好的 ViT 內,以快速的配對步驟逐步合併相似的 token,不需重新訓練就能提高吞吐量。較大的 patch、token 剪枝與池化階段則以更粗略的方式達到相同效果。
- 更小的模型。 Papa 等人的綜述 [13] 把高效率 ViT 分為精簡架構、剪枝、知識蒸餾與量化四類,並提出「Efficient Error Rate」指標,用來在參數量、位元數、FLOPs 與模型大小之間比較模型。
狀態空間模型與混合模型
白話版。 不必比較每一對 token,而是像循環網路(ML 04)一樣,讓一個精簡的狀態沿著序列傳遞。成本隨 token 數線性成長。
對 token 序列,一個簡化的狀態空間遞迴為
其中 是固定大小的隱藏狀態,、、 是(離散化後的)狀態空間矩陣。在 Mamba 這類選擇性(selective)模型中,寫入/讀取係數與步長取決於輸入 ;底層連續轉移可以保持固定,離散化後的係數卻會改變。輸入選擇與仿射狀態更新使平行掃描(parallel scan)成為可能 [33]。影像沒有天然的一維順序,因此視覺版本必須選擇掃描順序:Vision Mamba(Vim)[30] 加上位置嵌入,對 patch 序列做正向與反向掃描;VMamba [31] 則沿著二維網格的四個方向掃描。Visual Mamba 綜述 [8] 回顧了 200 多篇論文,並指出掃描方式是視覺應用中最關鍵的設計決策。
MambaOut [9](CVPR 2025)是一個有用的反例。作者主張 Mamba 適合長序列與因果(自迴歸)結構的任務,並在保留閘控卷積區塊的同時拿掉狀態空間元件,建立了 MambaOut 模型。他們的模型在 ImageNet 分類上勝過視覺 Mamba 模型,顯示 Mamba 在這裡並非必要;而對於涉及長 token 序列的偵測與分割,他們認為狀態空間模型仍值得探索。更廣泛的重點在於方法論:要把某個結果歸功於某種機制(注意力、掃描、卷積)之前,必須先把它與閘控、正規化、訓練配方和參數預算分開來看。
影像掃描是一種歸納偏置
Mamba [33] 提供高效率的序列運算,但不會替我們決定影像的幾何結構。Vim [30] 使用 patch 序列、位置嵌入與正向/反向處理;VMamba [31] 則把四條路徑的選擇性掃描放進階層式視覺骨幹中。單靠模型名稱,無法判斷感受野的影響強度、解析度行為或執行時間。狀態維度、掃描路徑、局部運算與降取樣階段都會影響結果。
在固定掃描順序下,影像中相鄰的兩個像素,可能在序列中相隔許多步。反過來,一列最後的像素與下一列第一個像素,雖然在空間上相距甚遠,卻在序列中連續。局部卷積可以先提供鄰近證據,再由掃描把上下文傳得更遠。多條路徑提供額外的傳遞方式,但不會自動恢復所有幾何對稱性。位置嵌入也能編碼有用的位置,卻讓移轉到不同網格成為另一個需要處理的設計問題。
可以用數學明確呈現這個選擇:
其中 包含展平後的影像 token, 索引 條路徑中的一條, 把 token 排列成該路徑的順序, 執行該路徑的序列循環, 還原影像座標, 對產生的特徵取平均。這是概念性的路徑融合模型。可學習的視覺區塊可以使用不同投影或融合規則;這裡選擇平均,是為了讓實驗容易解讀。
CPU 實驗:量測方向偏差
下一個範例使用單一純量狀態,每條路徑的衰減係數都相同。先比較正向/反向的逐列掃描,以及加入逐欄掃描的四條路徑;接著把輸入旋轉 90 度、處理後再把輸出轉回來。全部使用合成的 脈衝,不下載權重或影像。這個實驗單獨檢查排序,並不重現訓練好的 Vim 或 VMamba。
程式碼 · Python · 28 行
import numpy as np

def scan_image(image, four=False):
    ids = np.arange(image.size).reshape(image.shape)
    row, col = ids.ravel(), ids.T.ravel()
    orders = [row, row[::-1]]
    if four:
        orders += [col, col[::-1]]
    outputs = []
    for order in orders:
        h = 0.0
        out = np.zeros(image.size)
        for i in order:
            h = 0.8 * h + 0.2 * image.ravel()[i]
            out[i] = h
        outputs.append(out.reshape(image.shape))
    return np.mean(outputs, axis=0)

image = np.zeros((6, 6))
image[1, 4] = 1.0
errors = []
for four in [False, True]:
    original = scan_image(image, four=four)
    rotated_back = np.rot90(scan_image(np.rot90(image), four=four), -1)
    error = np.max(np.abs(original - rotated_back))
    errors.append(error)
    print('four routes:', four, 'rotation discrepancy:', round(error, 6))
assert 0.0 < errors[1] < errors[0]
兩條路徑的最大差異為 0.063622,四條路徑則為 0.026738。在這個範例中,增加路徑減少方向偏差,但剩餘差異並非零。旋轉逐列路徑時,其中一個遍歷軸會反向;變換後的路徑未必屬於原本四條路徑的集合。因此,即使係數共用且以平均融合,也不保證旋轉等變性。可學習的方向投影、位置資訊與局部運算又引入更多選擇。應直接測試需要的性質,而不是從「二維掃描」推定它存在。
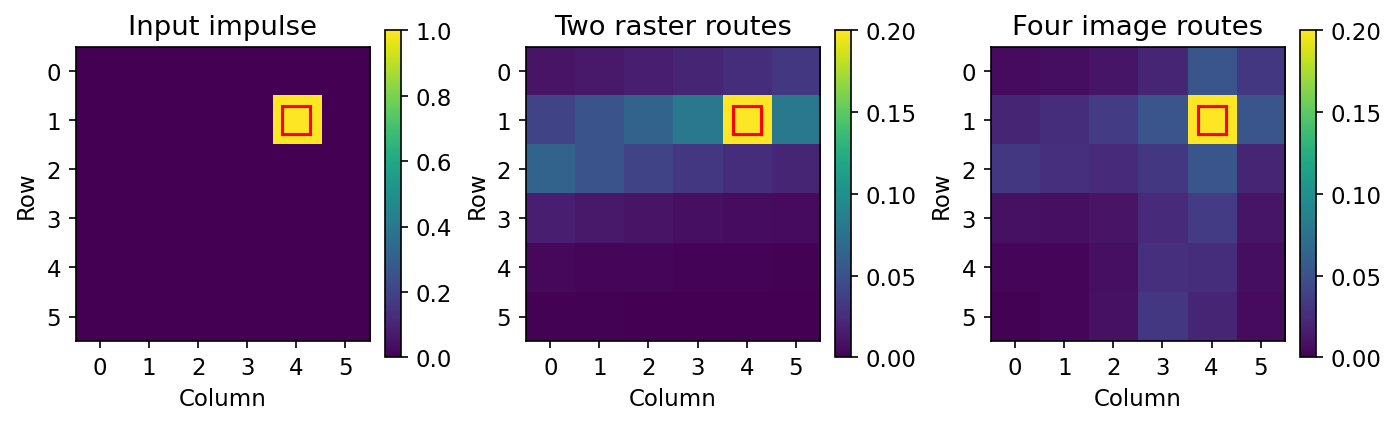
資訊能沿著完整掃描傳遞,因此循環可以具有全域感受野。這表示依賴關係可能存在,並不代表它在所有距離都保持強大影響。純量衰減為 時,攜帶的貢獻每經過一步就再乘上 。ML 04 推導的選擇性轉移可以改變這種保留方式,但訓練仍須學會哪些資訊值得保存。即使可以讀取遠處上下文,狀態壓縮或降取樣仍可能遺失細緻邊界與小物件。
Mamba-2 改變了什麼,又該如何評估
Mamba-2 [34] 以結構化狀態空間對偶性與高效率的分塊計算,重新安排選擇性序列混合器。它改變轉移結構與區塊參數投影,並沒有讓任意影像 patch 序列都等同於 Transformer。具有結構的因果係數矩陣可以用類似注意力的方式解讀,但標準 softmax 注意力仍保有不同的表達與計算性質。應用到影像時,仍須指定方向與融合方式。因此,對偶性回答的是計算問題,並未消除幾何問題。
公平的視覺比較應區分三種實驗:在共用區塊中只替換混合器;在對齊的訓練預算下比較完整骨幹;以及在目標硬體上量測部署模型。固定資料、資料增強、token 解析度與下游預測頭。除了參數量,也記錄狀態大小,並在不同影像解析度與批次大小下量測延遲及記憶體峰值。token 數的線性項可以同時伴隨昂貴的投影、路徑排列與小型運算核心的額外成本。上面的 Python 迴圈無法支持 GPU 吞吐量的宣稱。
對密集任務,檢查邊界附近、小型結構與不同長寬比下的錯誤;對影片,區分離線雙向編碼器與因果即時處理。除了分布內分類,也應納入旋轉/裁切敏感度與更長網格的評估。MambaOut [9] 提供重要的移除混合器消融實驗。結果支持依任務比較,並不是證明所有影像問題都不需要掃描的定理。Xu 等人 [8] 依骨幹、掃描機制,以及影像/影片/點雲/多模態應用整理視覺 Mamba。在已核實的紀錄中,這篇綜述仍是 2024 年預印本。其分類架構有助於選擇控制變因的實驗;提出的變體數量並不能確立普遍的贏家。
現代觀點
綜述文獻。 Khan 等人 [3](ACM Computing Surveys,2022)從基礎(自注意力、大規模預訓練、雙向編碼)談起,接著綜覽 Transformer 在辨識、生成模型、視覺問答等多模態任務、影片、低階視覺與三維分析上的應用,最後列出開放問題。Han 等人 [11](IEEE TPAMI,2023)依任務整理視覺 Transformer(骨幹、偵測與分割等中高階視覺、低階視覺、影片),也涵蓋高效率 Transformer 方法。Liu 等人 [12](IEEE TNNLS,2024)回顧了一百多個用於影像、點雲與視覺–語言資料之分類、偵測與分割的視覺 Transformer,並提出三個未來方向。在效率方面,Papa 等人 [13](IEEE TPAMI,2024)最有系統。狀態空間視覺模型請參考 Xu 等人 [8]。教科書式的推導則見 Bishop 與 Bishop [10]。
2023–2026 年的最新發展。 純 ViT 已成為預設的基礎模型(foundation model)骨幹。ViT-22B [24](ICML 2023)把 ViT 擴大到 220 億個參數,並需要一些架構修改(例如對 query 與 key 做正規化)才能在這個規模下穩定訓練。DINOv2 [23](TMLR 2024)以自監督方式在大型精選影像集合上訓練 ViT,得到的通用特徵在凍結狀態下就能用於分類、分割與深度估計(ML 06)。Darcet 等人 [22](ICLR 2024)發現大型 ViT 會把資訊量低的背景 patch 挪作內部暫存空間,在注意力圖中產生高範數的假影 token;加入少數額外的暫存器 token(register tokens)就能消除這些假影,並改善密集預測。視覺–語言基礎模型(ML 10)與擴散 Transformer(ML 08)都建立在同樣的區塊上。與此同時,階層式與混合設計在高解析度的密集任務上仍很常見;在預算對齊時,現代化的 CNN 依然具有競爭力(ML 03);而狀態空間與線性注意力模型仍持續被探索,用於影片這類非常長的 token 序列。
開放問題。 高解析度與長影片下的二次方成本;純 ViT 對資料與運算量的龐大需求;能在不同解析度與長寬比之間泛化的位置編碼;如何解讀注意力而不過度詮釋;以及在注意力、卷積與狀態空間機制之間,做出運算量對齊的公平比較。
重點整理
- query 與 key 決定權重,value 提供注意力混合的內容。
- 分數縮放在變異數假設下控制量級,不保證任意學得輸入都有單位變異數。
- 遮罩限制資訊存取,位置訊號則區分純內容注意力無法辨別的排列。
- Transformer 區塊交替進行 token 混合與逐 token 變換,並搭配殘差路徑及正規化。
- ViT、位移視窗與卷積混合模型,對局部性、解析度及訓練需求採取不同選擇。
- FlashAttention 降低精確注意力的記憶體流量;視窗、token 縮減與狀態空間掃描則改變運算或上下文存取。
練習
- Token 預算。 對一張 的影像,分別計算 patch 大小為 16 與 8 時的 token 數,以及每個頭的注意力分數個數。patch 大小減半時,分數個數增加幾倍?
提示
與 個 token; 與 個分數。patch 大小減半, 乘以 4,分數乘以 16。
- 縮放檢查。 對 ,隨機產生各分量為獨立標準常態的 query 與 key。分別量測有無除以 時 的變異數,以及在 100 個 key 上 softmax 的最大權重。不縮放時,softmax 會發生什麼事?
提示
原始點積的變異數接近 ;縮放後接近 1。不縮放時,在 下 softmax 幾乎把所有權重都放在單一個 key 上(近乎 one-hot),流經其他 key 的梯度因此消失。
- 移除位置資訊。 在 TinyViT 程式碼中,把位置嵌入設為零、拿掉類別 token 改用平均池化,然後在送進區塊之前打亂 patch token 的順序,並在評估模式下比較 logits。解釋結果,並說明這對一個沒有位置資訊的影像分類器意味著什麼。
提示
logits 在浮點誤差範圍內相同,因為每個區塊都是排列等變的,而平均池化是排列不變的。記得關掉 dropout(eval()),並打亂 token 而不是 patch 內的像素。這樣的模型無法分辨一張臉和用相同 patch 拼湊出來的亂序臉。
- 交叉注意力的形狀。 在一個文字生成影像的模型中,256 個寬度 320 的影像 token 讀取 77 個寬度 768 的文字 token,使用 8 個寬度 40 的頭。寫出 、、、單一個頭的分數矩陣以及輸出的形狀。
提示
(8 個頭 × 40),。每個頭的分數為 。輸出跟隨 query:經過輸出投影後為 。key 與 value 的長度必須彼此相同,而不必與 query 長度相同。
- Swin 的算術。 利用成本公式,比較 的 token 網格、、 時的全域注意力與視窗注意力。兩種情況各由哪一項主導?
提示
。全域: 加上 ,由二次方項主導。視窗:同樣的 加上 ,由投影主導。此例中視窗版本約便宜 14 倍。
- 公平比較。 你有 2,000 張標註影像,以及預訓練好的 CNN、ViT 與視覺 Mamba 骨幹。設計一個實驗來決定要部署哪一個骨幹,並列出必須固定的條件。 納入移除混合器的消融實驗,以及解析度/旋轉測試。
提示
先在凍結的特徵上比較線性探測(linear probe),再在驗證集上以對齊的預算、為各模型分別調校學習率來做微調。記錄預訓練資料、輸入解析度、參數量、FLOPs,以及在目標裝置上實測的延遲。拿預訓練的 ViT 去比從頭訓練的 CNN,測到的是預訓練,而不是架構。 對掃描骨幹,記錄狀態大小,並測試保留閘控與局部卷積、移除混合器後,優勢是否仍存在。解析度與旋轉測試要使用一致的前處理。
參考文獻
- A. Vaswani et al., “Attention Is All You Need,” NeurIPS, 2017. arXiv
- A. Dosovitskiy et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” ICLR, 2021. arXiv
- S. Khan, M. Naseer, M. Hayat, S. W. Zamir, F. S. Khan and M. Shah, “Transformers in Vision: A Survey,” ACM Computing Surveys, 2022. arXiv
- H. Touvron et al., “Training data-efficient image transformers & distillation through attention,” ICML, 2021. arXiv
- Z. Liu et al., “Swin Transformer: Hierarchical Vision Transformer using Shifted Windows,” ICCV, 2021. arXiv
- T. Dao, D. Y. Fu, S. Ermon, A. Rudra and C. Ré, “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” NeurIPS, 2022. arXiv
- PyTorch,
scaled_dot_product_attentionandTransformerEncoderLayerdocumentation. Attention, Encoder layer MultiheadAttention mask semantics - R. Xu et al., “Visual Mamba: A Survey and New Outlooks,” arXiv:2404.18861, 2024. arXiv
- W. Yu and X. Wang, “MambaOut: Do We Really Need Mamba for Vision?,” CVPR, 2025. Paper
- C. M. Bishop and H. Bishop, Deep Learning: Foundations and Concepts, Springer, 2024, ch. 12. Book
- K. Han et al., “A Survey on Vision Transformer,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023. DOI
- Y. Liu et al., “A Survey of Visual Transformers,” IEEE Transactions on Neural Networks and Learning Systems, 2024. DOI
- L. Papa, P. Russo, I. Amerini and L. Zhou, “A Survey on Efficient Vision Transformers: Algorithms, Techniques, and Performance Benchmarking,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2024. DOI
- J. L. Ba, J. R. Kiros and G. E. Hinton, “Layer Normalization,” arXiv:1607.06450, 2016. arXiv
- R. Xiong et al., “On Layer Normalization in the Transformer Architecture,” ICML, 2020. arXiv
- J. Su, M. Ahmed, Y. Lu, S. Pan, W. Bo and Y. Liu, “RoFormer: Enhanced Transformer with Rotary Position Embedding,” Neurocomputing, 2024. DOI
- P. Shaw, J. Uszkoreit and A. Vaswani, “Self-Attention with Relative Position Representations,” NAACL, 2018. arXiv
- M. Raghu, T. Unterthiner, S. Kornblith, C. Zhang and A. Dosovitskiy, “Do Vision Transformers See Like Convolutional Neural Networks?,” NeurIPS, 2021. arXiv
- H. Wu et al., “CvT: Introducing Convolutions to Vision Transformers,” ICCV, 2021. arXiv
- Z. Dai, H. Liu, Q. V. Le and M. Tan, “CoAtNet: Marrying Convolution and Attention for All Data Sizes,” NeurIPS, 2021. arXiv
- D. Bolya et al., “Token Merging: Your ViT But Faster,” ICLR, 2023. arXiv
- T. Darcet, M. Oquab, J. Mairal and P. Bojanowski, “Vision Transformers Need Registers,” ICLR, 2024. arXiv
- M. Oquab et al., “DINOv2: Learning Robust Visual Features without Supervision,” Transactions on Machine Learning Research, 2024. arXiv
- M. Dehghani et al., “Scaling Vision Transformers to 22 Billion Parameters,” ICML, 2023. arXiv
- A. Steiner et al., “How to train your ViT? Data, Augmentation, and Regularization in Vision Transformers,” Transactions on Machine Learning Research, 2022. arXiv
- D. Hendrycks and K. Gimpel, “Gaussian Error Linear Units (GELUs),” arXiv:1606.08415, 2016. arXiv
- H. Touvron, M. Cord and H. Jégou, “DeiT III: Revenge of the ViT,” ECCV, 2022. arXiv
- S. Mehta and M. Rastegari, “MobileViT: Light-weight, General-purpose, and Mobile-friendly Vision Transformer,” ICLR, 2022. arXiv
- T. Dao, “FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning,” ICLR, 2024. arXiv
- L. Zhu et al., “Vision Mamba: Efficient Visual Representation Learning with Bidirectional State Space Model,” ICML, 2024. arXiv
- Y. Liu et al., “VMamba: Visual State Space Model,” NeurIPS, 2024. arXiv
- Z. Liu et al., “Swin Transformer V2: Scaling Up Capacity and Resolution,” CVPR, 2022. arXiv
- A. Gu and T. Dao, “Mamba: Linear-Time Sequence Modeling with Selective State Spaces,” COLM, 2024. Author version
- T. Dao and A. Gu, “Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality,” ICML, PMLR 235, 2024. Paper
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 ML 06・表示學習與自監督 · 25 分鐘