DLCV 02・深度影像分類
先備知識:DLCV 01・深度學習的影像處理與電腦視覺、IP 13・影像圖樣分類
導覽:本頁與本系列: 導覽:本頁與本系列
用實驗理解本章 2 個互動實驗
移動固定分類分數的決策門檻。混淆矩陣隨之改變,操作點則沿著由同一組分數畫出的 ROC 與精確率–召回率曲線滑動。
你將學到
- 為單標籤與多標籤任務選擇輸出、損失及指標。
- 依設計與成本比較 CNN 和 Transformer 骨幹。
- 區分架構改進與訓練配方的效果。
- 選擇線性探測、微調或零樣本遷移。
- 評估類別不平衡、校準、分布轉移與部署效率。
先看全貌
影像分類對整張影像只問一個問題:這些標籤裡,哪一個最符合? 它是最早的深度學習基準任務,到今天仍是大多數骨幹網路誕生的地方。物體偵測、分割或影像復原網路,通常都從一個先以影像分類訓練、或至少以影像分類評估過的骨幹網路出發。
本篇假設你已經知道卷積、CNN 的層與反向傳播。分類的古典面向(貝氏分類器、感知器、用 NumPy 寫的小型 CNN、手推 softmax 與交叉熵)在IP 13。深度學習用於影像的整體歷史在 DLCV 01。這裡我們專注、深入地談分類本身。若想快速複習激活函數與最佳化器,可以參考 ML 02・類神經網路。CNN 這一側的發展,Li 等人 [1] 的綜述是很好的單篇入門。
相關篇章。 DLCV 02A 把分類變成比對:介紹開放集合問題中的臉部辨識、嵌入與以角度邊界為基礎的損失。DLCV 01B 則比較分類網路與影像復原網路如何組合同一批積木。
分類問題的定義
白話版。 分類器產生各類別分數;損失比較其機率與標籤,再更新網路以改善預測。
單標籤、多標籤與細粒度
令 為一張 RGB 影像, 為 個類別的集合。參數為 的網路 把影像映射到一個 logits 向量 ,每個類別一個未正規化的分數。
- 單標籤(多類別)分類假設恰好有一個正確類別 。以 softmax 把 logits 轉成機率向量:
其中 是模型對 的估計。訓練時最小化交叉熵,也就是正確類別機率的負對數,在一個小批次上取平均:
其中 是批次大小, 是影像 的標籤。它對 logits 的梯度(每張影像)是 , 是正確類別的 one-hot 向量;推導見 DIP 第 13 章。
-
多標籤分類允許任意個標籤同時成立(一張街景可能同時有「汽車」、「行人」、「腳踏車」)。每個類別各自接一個 sigmoid 與二元交叉熵 ,其中 表示類別 是否出現。評估指標也要換:以各類別的平均精確度(mean average precision)取代準確率。
-
細粒度分類要分開外觀非常相近的子類別,例如 200 種鳥或 1,000 種飛機型號。損失函數與單標籤相同,但訊號藏在小地方(鳥喙形狀、翅膀上的條紋),類別通常呈長尾分佈,而且非專家標註者造成的標籤雜訊很常見。iNaturalist [6] 是標準的大型細粒度基準。
評估指標:top-1、top-5 與其他
Top-1 準確率是最高分類別恰好正確的影像比例。Top- 準確率則只要正確類別落在前 高分之中就算對。ImageNet 挑戰賽回報 top-5 錯誤率,因為很多影像裡有好幾個物體,而有些類別幾乎無法區分 [2]。但 top-5 會掩蓋真正的錯誤,所以現代論文大多回報 top-1。資料不平衡時,請回報平衡準確率(各類別召回率的平均)或逐類別結果,因為分類器只要忽略稀有類別,也能拿到很高的準確率。
程式碼 · Python · 18 行
import torch
import torch.nn.functional as F

logits = torch.tensor([[2.0, 1.0, 0.1, -1.0],    # 2 images, 4 classes
                       [0.5, 2.5, 2.4, 0.0]])
y = torch.tensor([0, 2])

p = logits.softmax(dim=1)
ce = F.cross_entropy(logits, y)                       # mean of -log p[i, y_i]
ce_ls = F.cross_entropy(logits, y, label_smoothing=0.1)
top1 = (logits.argmax(1) == y).float().mean()
top2 = (logits.topk(2, dim=1).indices == y[:, None]).any(1).float().mean()
print(p.round(decimals=3))
print(f"CE {ce:.3f}  CE+LS {ce_ls:.3f}  top-1 {top1:.2f}  top-2 {top2:.2f}")

# multi-label: one independent sigmoid per class, binary cross-entropy
targets = torch.tensor([[1., 0., 1., 0.], [0., 1., 1., 0.]])
print(f"BCE {F.binary_cross_entropy_with_logits(logits, targets):.3f}")
第二張影像在類別 1 和 2 之間幾乎平手。Top-1 算它錯,top-2 算它對。支持與反對 top-5 的理由,都在這一個例子裡。
混淆矩陣與由它衍生的指標
白話版。 準確率概括正確程度,混淆矩陣指出哪些類別混淆;再用適合的指標揭露重要錯誤。
二元情況:TP、FP、FN、TN
把某一類當作陽性(positive,例如「生病」),其餘當作陰性(negative)。每一個預測都會落在四個格子之一:
| 預測為陽性 | 預測為陰性 | |
|---|---|---|
| 實際為陽性 | 真陽性(true positive, TP) | 偽陰性(false negative, FN) |
| 實際為陰性 | 偽陽性(false positive, FP) | 真陰性(true negative, TN) |
設測試樣本共 個,標準的比值為
- 精確率(precision)回答「模型說是陽性的時候,有多常是對的?」當誤報代價很高時它最重要:會把正常信件藏起來的垃圾郵件過濾器、自動觸發的產品召回。
- 召回率(recall),又稱敏感度(sensitivity)或真陽性率(true positive rate, TPR),回答「所有真正的陽性中,我們抓到了多少?」當漏抓代價很高時它最重要:癌症篩檢、產線上的瑕疵偵測。
- 特異度(specificity),即真陰性率(true negative rate, TNR),是陰性類別的召回率。偽陽性率(false positive rate, FPR)是它的補數,也就是被錯誤標記的陰性樣本比例。
精確率與召回率互相拉扯:降低決策門檻會標記更多樣本,召回率上升,精確率通常下降。把兩者合成一個數字的指標是:
其中 是精確率, 是召回率, 表示召回率比精確率重要幾倍( 偏重召回率, 偏重精確率)。 是調和平均,所以只有兩者都高時它才會高。也請注意 忽略了什麼:真陰性完全沒有出現在式子裡。
另外兩個總結指標用到了全部四格:
平衡準確率(balanced accuracy)是各類別召回率的平均,所以一個忽略某一類的分類器,不論那一類多稀有,都只能拿到 0.5。Matthews 相關係數(Matthews correlation coefficient, MCC)是真實與預測二元標籤之間的 Pearson 相關係數: 表示完美, 表示不比隨機好, 表示完全相反。Chicco 與 Jurman [57] 主張在二元評估中應優先使用 MCC,而不是準確率與 ,因為只有分類器在四個格子上都表現好時,它才會高。Sokolova 與 Lapalme [58] 系統性地比較了這些指標,以及它們各自如何隨混淆矩陣的變化而反應。
為什麼 99:1 時準確率會誤導。 假設 1,000 張掃描影像中有 10 張是生病的。一個永遠回答健康的「模型」可以拿到 99.0% 的準確率。模型 B 標記了 30 張,抓到 10 張中的 8 張;它的準確率較低(97.6%),卻是唯一有用的那一個:
程式碼 · Python · 18 行
import numpy as np
from sklearn.metrics import (accuracy_score, balanced_accuracy_score, confusion_matrix,
                             f1_score, matthews_corrcoef, precision_score, recall_score)

# 1,000 scans, 10 sick (label 1). Model A says "healthy" to everyone.
# Model B flags 30 scans and catches 8 of the 10 sick ones.
y = np.r_[np.ones(10), np.zeros(990)].astype(int)
pred_a = np.zeros(1000, dtype=int)
pred_b = np.r_[np.ones(8), np.zeros(2), np.ones(22), np.zeros(968)].astype(int)

for name, p in [("all-negative", pred_a), ("model B", pred_b)]:
    tn, fp, fn, tp = confusion_matrix(y, p).ravel()
    print(f"{name:12s} TP={tp} FP={fp} FN={fn} TN={tn}  "
          f"acc={accuracy_score(y, p):.3f} bal-acc={balanced_accuracy_score(y, p):.3f} "
          f"P={precision_score(y, p, zero_division=0):.3f} R={recall_score(y, p):.3f} "
          f"F1={f1_score(y, p, zero_division=0):.3f} MCC={matthews_corrcoef(y, p):.3f}")
# all-negative TP=0 FP=0 FN=10 TN=990  acc=0.990 bal-acc=0.500 P=0.000 R=0.000 F1=0.000 MCC=0.000
# model B      TP=8 FP=22 FN=2 TN=968  acc=0.976 bal-acc=0.889 P=0.267 R=0.800 F1=0.400 MCC=0.454
平衡準確率、 與 MCC 都把模型 B 排在第一;準確率卻把它排在最後。經驗法則:只有在類別大致平衡、所有錯誤代價相同時才用準確率;當某一種錯誤比較嚴重時,回報精確率與召回率(或依實際代價選定 的 );需要一個能反映不平衡的單一總結數字時,用平衡準確率或 MCC。
多類別混淆矩陣
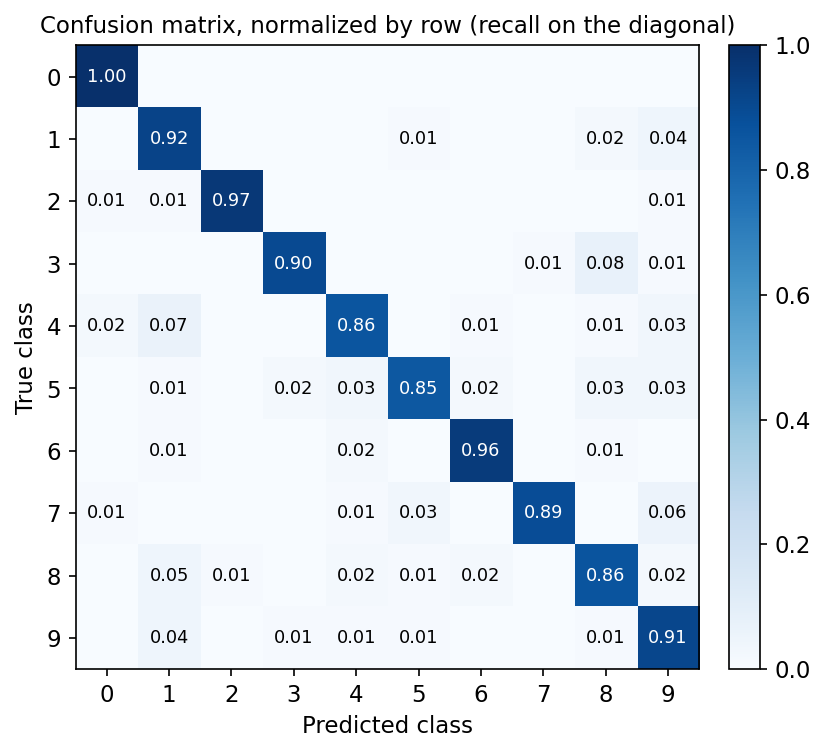
有 個類別時,混淆矩陣 的元素 是真實類別為 (列)、預測類別為 (行)的測試影像數;這是 scikit-learn [62] 的慣例。對角線是預測正確的數量。把每一列除以該列總和,得到依列正規化的矩陣:它的對角線就是各類別的召回率,非對角元素則顯示哪些類別被搞混。圖 1 是一個只用 scikit-learn 手寫數字中 200 張訓練的邏輯迴歸所得到的結果:大部分錯誤是 3 → 8、4 → 1 與 7 → 9,都是筆畫相似的組合。
輪流把每個類別 當作「陽性」、其他類別當作「陰性」,就得到逐類別的計數:,(第 行的其餘部分),(第 列的其餘部分)。因此逐類別精確率 ,召回率 。把 個逐類別數字合成一個,常見的有三種做法:
- 巨觀平均(macro average):對類別直接取平均,。每個類別權重相同,所以稀有類別和常見類別一樣重要。
- 微觀平均(micro average):先把各類別的 、、 加總,再算一次指標。在單標籤多類別問題中,每一個錯誤都同時是一個 FP(對預測的類別)和一個 FN(對真實的類別),所以微觀精確率 = 微觀召回率 = 微觀 = 準確率。
- 加權平均(weighted average):以各類別的支持數(support)(真實樣本數)為權重,對逐類別數值取平均。它很接近微觀平均,幾乎一樣會掩蓋稀有類別的失敗。
在不平衡的測試集上,幾種平均可能差很多。如果模型在常見類別上很好、在稀有類別上很差,微觀平均(被常見類別主導)會給出高分,巨觀平均則低得多;這個差距本身就是訊號。當每個類別都重要時(罕見疾病、稀有物種)回報巨觀平均;當每一張影像同等重要時,回報微觀平均/準確率。
選讀:巨觀與微觀平均的計算實例(見「補充資料」頁)。用一個小型三類別混淆矩陣一步步手算。
Cohen’s kappa [59] 是扣除巧合後的準確率:它把預測與標籤之間觀察到的一致程度,和一個只依觀察到的比例隨機猜各類別的分類器所能達到的一致程度相比。完全一致時為 1,與隨機相當時為 0;在比較模型與人類標註者時很常見。
選讀:Cohen’s kappa:扣除巧合的一致性(見「補充資料」頁)。公式,以及它在下方手寫數字分類器上的數值。
程式碼 · Python · 26 行
from sklearn.datasets import load_digits
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (average_precision_score, classification_report,
                             confusion_matrix, precision_recall_fscore_support, roc_auc_score)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import label_binarize

X, y = load_digits(return_X_y=True)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.5, stratify=y, random_state=0)
clf = LogisticRegression(max_iter=2000).fit(X_tr[:200], y_tr[:200])   # only 200 labels
pred, prob = clf.predict(X_te), clf.predict_proba(X_te)

cm = confusion_matrix(y_te, pred)                     # rows = true, columns = predicted
cm_norm = confusion_matrix(y_te, pred, normalize="true")   # each row sums to 1 (Figure 1)
print(classification_report(y_te, pred, digits=3))    # per-class P, R, F1, support + averages
for avg in ["macro", "micro", "weighted"]:
    p, r, f, _ = precision_recall_fscore_support(y_te, pred, average=avg)
    print(f"{avg:8s} P={p:.3f} R={r:.3f} F1={f:.3f}")
print(f"ROC-AUC (one-vs-rest, macro) {roc_auc_score(y_te, prob, multi_class='ovr'):.4f}")
Y = label_binarize(y_te, classes=range(10))           # one binary column per class
print(f"mean AP over classes {average_precision_score(Y, prob, average='macro'):.4f}")
# macro    P=0.914 R=0.911 F1=0.912
# micro    P=0.911 R=0.911 F1=0.911
# weighted P=0.915 R=0.911 F1=0.912
# ROC-AUC (one-vs-rest, macro) 0.9958
# mean AP over classes 0.9742
這裡巨觀與微觀平均幾乎相同,因為手寫數字的各類別是平衡的;換成不平衡的測試集就不會如此。
不依賴門檻的評估:ROC 曲線與精確率–召回率曲線
上面每一個指標都需要一條決策規則(argmax,或「分數超過 就是陽性」)。會輸出分數的分類器,可以一次在所有門檻上評估:把 從高掃到低,每個門檻記下一個點。
- ROC 曲線畫的是 TPR 對 FPR。曲線下面積 ROC-AUC 等於「隨機取一個陽性樣本,它的分數高於隨機取的一個陰性樣本」的機率;0.5 是隨機,1.0 是完美分開。Fawcett [54] 是標準的入門文獻。
- 精確率–召回率(PR)曲線畫的是精確率對召回率。它的總結指標平均精確度(average precision, AP),是在每次多找回一個陽性樣本的召回率位置上,對精確率取平均:
其中 與 是依分數由高到低排序後、第 個門檻的精確率與召回率(這是 scikit-learn [62] 的定義;PASCAL VOC [61] 等基準用過內插的變體,所以要確認論文回報的是哪一種)。
為什麼嚴重不平衡時要看 PR。 FPR 的分母是陰性樣本數。當陰性樣本是陽性的 99 倍時,即使有上千個誤報,FPR 也幾乎不動,所以 ROC 曲線看起來很漂亮,精確率卻很差。精確率的分母是被標記的樣本數,誤報會直接打擊它,而 AP 的隨機基準線等於陽性比例,而不是 0.5。Davis 與 Goadrich [55] 證明:一條曲線在 ROC 空間中占優勢,若且唯若它在 PR 空間中也占優勢;並指出最佳化 ROC-AUC 並不等於最佳化 AP。Saito 與 Rehmsmeier [56] 以模擬與文獻回顧顯示,在不平衡資料上,PR 圖比 ROC 圖更有資訊量。圖 2 把這件事具體化:在陽性只占 1% 的任務上,兩個 ROC-AUC 相同(0.95)的分類器,AP 卻明顯不同(0.45 對 0.36)。
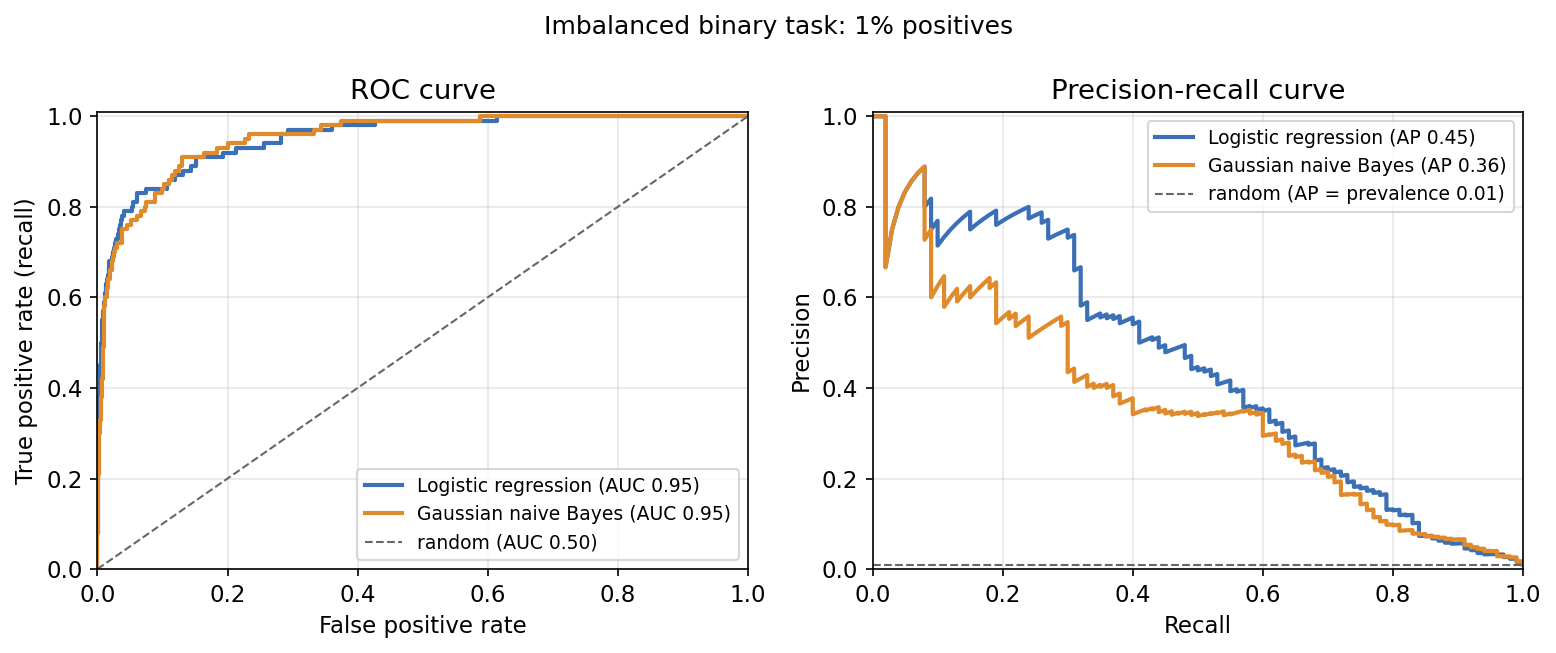
當類別數 時,兩種曲線都以一對其餘(one-vs-rest)的方式計算:類別 為陽性、其他全部為陰性,使用分數 。再把 個面積做巨觀平均(roc_auc_score(..., multi_class="ovr")),或把所有(類別, 影像)配對合併後做微觀平均。
多標籤指標
在多標籤分類中,每個標籤都是自己的一個「有/沒有」問題,所以標準的總結指標是逐類別的平均精確度,再對類別平均成 mAP,就像 PASCAL VOC 分類任務 [61] 的做法。需要門檻的指標,要嘛對每個標籤算二元指標再對標籤平均(巨觀或微觀,如上),要嘛對每張影像的預測標籤集合評分,再對影像取平均。
選讀:多標籤指標細說(見「補充資料」頁)。以樣本為基礎的 F1、Hamming loss,以及一個小型程式範例。
校準:機率說的是實話嗎?
準確率只檢查 argmax。校準(calibration)檢查信心值是否名副其實:在所有信心為 0.8 的預測中,應該大約有 80% 是對的。正式地說,若對每個信心值 都有 ,分類器就是校準良好的,其中 是預測類別, 是它的機率。常用的總結指標是期望校準誤差(expected calibration error, ECE):把預測依信心分到 個區間 ,計算
其中 是測試影像數, 是第 個區間內的準確率, 是區間內的平均信心。Guo 等人 [47] 發現,用交叉熵長時間訓練的現代深度網路傾向過度自信,而只用一個純量就能修正得相當好。我們會在穩健性一節回來談。
資料集與它們的角色
白話版。 基準讓方法在固定條件下比較。訓練與評估資料須分開,並檢查提升能否遷移到該測試集之外。
訓練用資料集
| 資料集 | 影像數 | 類別數 | 解析度 | 角色 |
|---|---|---|---|---|
| MNIST [3] | 訓練 6 萬/測試 1 萬 | 10 個數字 | 28×28 灰階 | 健全性檢查、教學 |
| CIFAR-10 / CIFAR-100 [4] | 訓練 5 萬/測試 1 萬 | 10/100(20 個超類別) | 32×32 RGB | 小規模的架構與配方研究 |
| ImageNet-1k(ILSVRC 2012)[2] | 約 128 萬訓練/5 萬驗證 | 1,000 | 不固定,通常以 224×224 訓練 | 骨幹網路的標準基準 |
| ImageNet-21k [5] | 約 1,300–1,400 萬(版本不同) | 約 2.1 萬 | 不固定 | 更大規模的監督式預訓練 |
| iNaturalist [6] | 數十萬,依年份而異 | 數千個物種 | 不固定 | 細粒度、長尾 |
MNIST 已經被解決,現在只用來抓程式錯誤。CIFAR 小到可以跑大量受控實驗,所以正則化論文特別愛用。ImageNet-1k 在 2012 年挑戰賽之後成為參考標準 [2], [10]:架構通常以「ImageNet-1k 驗證集、224×224 的 top-1」來回報,模型庫裡幾乎每個預訓練骨幹都附有一個 ImageNet 分數。ImageNet-21k 是 ImageNet-1k 所取自的更大階層;Ridnik 等人 [5] 以清理過、考慮語意階層的配方,讓在它上面預訓練變得實際可行。
評估用基準資料集
白話版。 訓練資料負責教,評估資料負責考。只考過一份考卷的模型,可能只是學會了那份考卷。所以現代論文會用一整組測試集來評估骨幹網路,每一個都設計來探測一件事:原始分佈、從同一分佈重新抽的樣本、損壞或風格化的影像、不尋常的視角、細粒度類別、很少的標註預算,或稀有類別。
最常見的評估集可以分成五組:
- 分佈內。 ImageNet-1k 驗證集 [2] 是實質上的測試集;ImageNet-ReaL [8] 為同一批影像重新標註,允許一張影像有多個標籤。
- 重新抽樣。 ImageNetV2 [7] 依原始收集流程重做一次,得到新的測試影像。
- 分佈偏移。 ImageNet-C [42] 加上合成損壞,ImageNet-R [43] 收錄藝術、卡通等各種表現形式,ImageNet-A [44] 收集會騙倒 ResNet-50 的自然照片,ImageNet-Sketch [63] 是素描,ObjectNet [64] 則呈現不尋常旋轉、背景與視角下的物體。
- 長尾與細粒度。 ImageNet-LT [73] 在長尾子集上訓練、在平衡資料上測試;iNaturalist [6]、CUB-200-2011 [65] 與 Stanford Cars [66] 測試細粒度辨識。
- 遷移。 Kornblith 等人 [33] 的 12 個資料集與 VTAB [72] 這類測試組,衡量凍結或微調後的特徵能多好地適應小型、專門的任務。
兩點實務提醒。好幾個細粒度基準回報的是各類別平均準確率,而不是一般的準確率,不要在同一個比較裡混用兩者。另外,CLIP [40] 這類影像–文字模型常以零樣本方式評估,完全不在目標資料上訓練:這時提示的寫法就成了超參數,不能在測試集上調整;而網路規模的預訓練資料也可能早已包含測試影像。
選讀:評估用基準資料集細說(見「補充資料」頁)。各基準的大小、用途與常用指標、兩個遷移測試組,以及 CLIP 回報的零樣本結果。
這些數字有多可靠?
有三條研究路線改變了我們解讀 ImageNet 準確率的方式。照原始流程重建測試集(ImageNetV2 [7])讓所有模型都掉分,但排名大致保持。重新標註的研究 [8], [9] 顯示,單一標籤與標籤錯誤都可能改變哪個模型看起來最好。而每個資料集在視角與背景上都有自己的偏差,所以只要可能,就用獨立收集的資料來測試。
選讀:ImageNet 的數字有多可靠?(見「補充資料」頁)。ImageNetV2 掉分的幅度,以及重新標註研究的發現。
評估流程
基準分數有多誠實,取決於背後的評估流程。
- 三種切分,三種任務。 在訓練集上擬合參數。在驗證集上(或在訓練資料內做交叉驗證)選擇超參數、提前停止點、溫度、門檻與提示。測試集只在最後碰一次。若基準只公開驗證集(如 ImageNet-1k),就從訓練集中切出一部分用來調整。
- 絕不在測試集上調整。 每一個看過測試結果之後才做的決定(多加一種擴增、多訓練一個 epoch、換一個檢查點),都會讓模型稍微擬合測試集。整個領域的論文累積起來,就是測試集重複使用(test-set reuse),也就是對基準的適應性過擬合。ImageNetV2 [7] 發現在新樣本上排名大致保持,這令人安心;但同一份研究也顯示絕對數字無法直接轉移,而新的測試集是唯一直接的檢驗方法。
- 回報變異。 用多個隨機種子訓練(至少三個,小資料集要更多),回報平均 ± 標準差,或信賴區間。在 10,000 張測試影像上,ImageNetV2 [7] 給出的 95% 信賴區間約為 ±1%;在這樣的測試集上進步 0.3 個百分點,算不上結果。
- 回報完整配方。 解析度、裁切數、額外資料、蒸餾、指標的哪一種變體(top-1 或各類別平均準確率、哪一種 AP 定義),以及標籤集的哪一個版本(原始或 ReaL)。
CNN 架構與其背後的理由
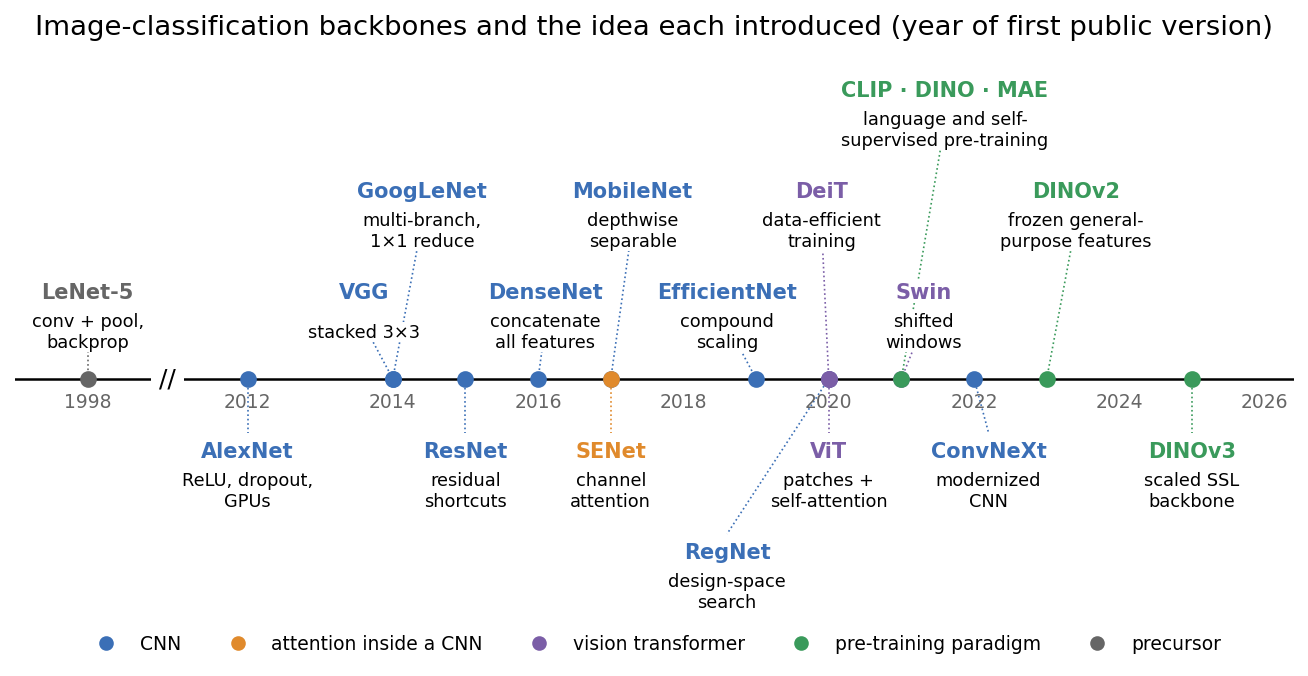
白話版。 每一個著名的 CNN 都修正了前一代的某個具體問題:訓練太慢、參數太多、太深就難以最佳化、在手機上太昂貴。知道每個架構解決了什麼問題,比背它們的層表更有用。
AlexNet:深度變得可訓練
2012 年以前,最好的 ImageNet 系統使用手工特徵(SIFT、Fisher 向量)加線性分類器。AlexNet [10] 是一個五層卷積、三層全連接的網路,在 ImageNet 上端到端訓練。讓它能在這個規模上成功的有三個要素。ReLU 激活函數 對正輸入不會飽和,梯度不會像 tanh 那樣消失,論文回報訓練速度快了好幾倍。Dropout 用在大型全連接層上對抗過擬合,那些層占了大部分參數。GPU 讓這一切可行:模型被拆在兩張 GPU 上。大量的資料擴增(隨機裁切與翻轉、顏色擾動)是第四個、常被忘記的要素。設計上的教訓是:只要資料和算力足夠,學出來的特徵勝過設計出來的特徵。
VGG:小卷積核,疊起來
VGG [11] 問了一個更乾淨的問題:如果只用 卷積,然後一直加深(16–19 個有權重的層),會怎樣?兩層 疊起來看到的是 區域,三層是 。對 個輸入與輸出通道而言,
(忽略偏差項)。所以同樣的感受野,疊層的參數更少,而且兩層之間多了一個非線性。VGG 的一致設計讓它多年來都是熱門的特徵擷取器。它的弱點是成本:全連接頭與寬大的前幾層讓它很笨重。
GoogLeNet/Inception:寬度、分支與 瓶頸
GoogLeNet [12] 則改攻成本。每個 Inception 模組平行執行 、、 卷積與池化,再把輸出串接起來,讓下一層自己挑選適合的尺度。在很多通道上跑大卷積核很昂貴,所以先用 卷積減少通道數。 卷積就是在每個像素上做一次跨通道的線性映射:它混合通道而不看鄰居,是改變寬度最便宜的方法。GoogLeNet 也用全域平均池化取代龐大的全連接頭。後續的 Inception-v3 論文 [13] 把大卷積核分解成小卷積的堆疊,或 與 的組合,並提出了標籤平滑(label smoothing),我們會在訓練一節再見到它。
ResNet:學習殘差
問題。 一直疊加普通的層,最後網路反而變差,連訓練集上都一樣。這種「退化」是最佳化問題,不是過擬合:更深的網路原則上可以複製較淺的網路,再把多出來的層設成恆等映射,但 SGD 就是找不到這個解。
想法。 He 等人 [14] 讓一個區塊學習殘差 ,再把輸入加回去:
其中 是區塊輸入, 是權重為 的兩到三層卷積, 是輸出。如果最佳映射接近恆等,區塊只需要把 推向零,這很容易。當形狀改變(通道變多、步幅為 2)時,捷徑改成 投影。
為什麼好訓練。 因為每個區塊都把輸入加回去,深層堆疊的輸出等於任何一個較早區塊的輸入,再加上一串殘差的總和。損失的梯度因此能沿著捷徑直接抵達每一個區塊,不會因為許多小因子連乘而消失。後續一篇論文 [15] 也發現,讓捷徑保持純粹的恆等(把 BN 與 ReLU 移進殘差分支,即「預激活」)能讓更深的網路更容易訓練。
選讀:殘差網路為什麼好訓練:展開後的梯度(見「補充資料」頁)。這個論證背後的兩行推導。
選讀:批次正規化(DLCV 01 的補充資料)。本頁處處用到的 BN 層在計算什麼,以及訓練與推論為何使用不同的統計量。
瓶頸結構。 對更深的 ResNet(50 層以上),每個區塊變成 (降維)→ → (升維),如圖 4(c)。在 256 通道時,兩層 的基本區塊有 萬個權重;降到 64 通道的瓶頸區塊則有 萬個。昂貴的 跑在很薄的張量上,這正是 50–152 層負擔得起的原因。
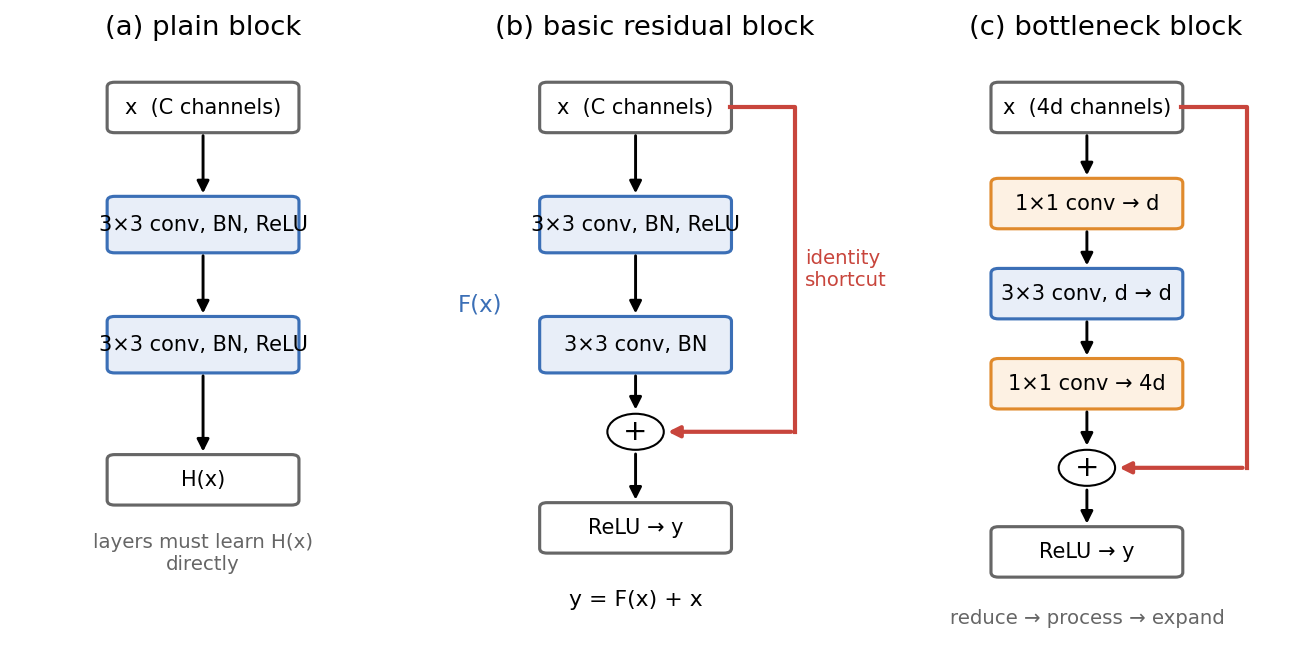
本篇實驗所用的基本區塊,以 PyTorch 寫成:
程式碼 · Python · 18 行
import torch.nn as nn
import torch.nn.functional as F

class BasicBlock(nn.Module):
    def __init__(self, cin, cout, stride=1):
        super().__init__()
        self.conv1 = nn.Conv2d(cin, cout, 3, stride, 1, bias=False)
        self.bn1 = nn.BatchNorm2d(cout)
        self.conv2 = nn.Conv2d(cout, cout, 3, 1, 1, bias=False)
        self.bn2 = nn.BatchNorm2d(cout)
        self.short = nn.Identity()
        if stride != 1 or cin != cout:   # projection shortcut when shapes change
            self.short = nn.Sequential(nn.Conv2d(cin, cout, 1, stride, bias=False), nn.BatchNorm2d(cout))

    def forward(self, x):
        out = F.relu(self.bn1(self.conv1(x)))
        out = self.bn2(self.conv2(out))
        return F.relu(out + self.short(x))   # y = F(x) + x
之後有兩種 CNN 設計進一步發展了這些想法。DenseNet [16] 讓區塊內每一層接收所有前面各層輸出的串接,以很少的參數再利用特徵,代價是記憶體。RegNet [19] 研究的是一整群類 ResNet 網路,發現好的網路在「各階段寬度如何遞增」上遵循簡單的規則。
選讀:另外兩種 CNN 設計:DenseNet 與 RegNet(見「補充資料」頁)。各自如何運作,以及帶來的教訓。
MobileNet:把卷積拆開
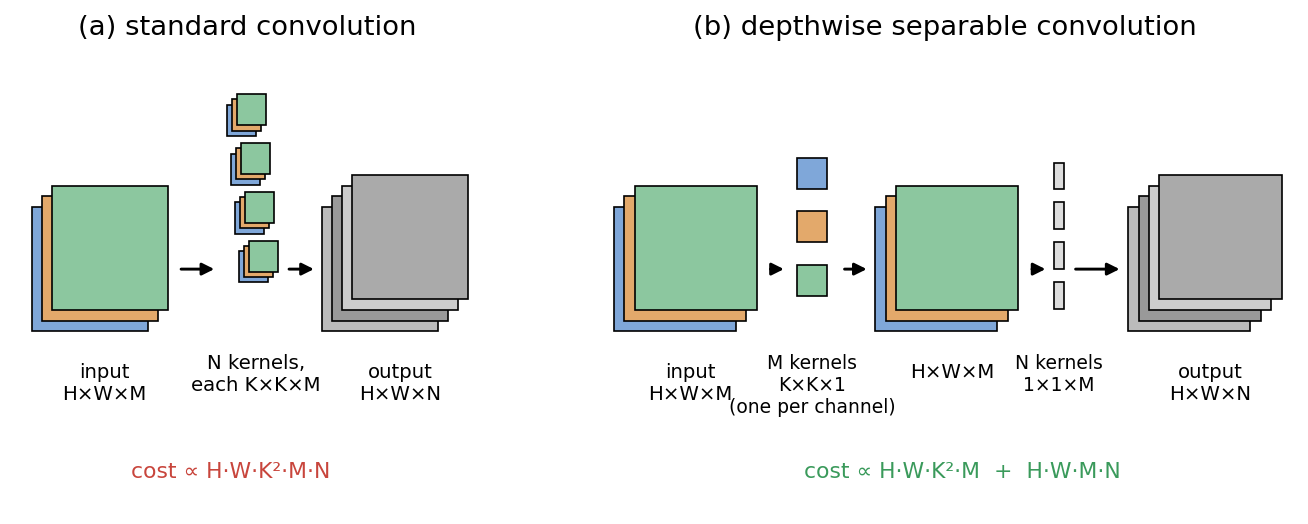
MobileNet [17] 的目標是手機。在 的特徵圖上,從 個通道到 個通道的標準 卷積需要 次乘加。深度可分離(depthwise separable)卷積把它拆成兩步:逐通道(depthwise) 卷積,每個通道各自濾波();以及逐點(pointwise) 卷積,負責混合通道()。兩者的成本比為
所以當 、輸出通道很多時,可分離版本大約便宜 8–9 倍。它押注的是:空間濾波與通道混合不需要一起學。這個賭注押得很成功,深度卷積後來在 EfficientNet 與 ConvNeXt 中再次出現。
程式碼 · Python · 12 行
import torch.nn as nn

def n_params(m):
    return sum(p.numel() for p in m.parameters())

M, N, K = 128, 128, 3
standard = nn.Conv2d(M, N, K, padding=1, bias=False)
separable = nn.Sequential(nn.Conv2d(M, M, K, padding=1, groups=M, bias=False),   # depthwise
                          nn.Conv2d(M, N, 1, bias=False))                          # pointwise
print("standard:", n_params(standard), " separable:", n_params(separable),
      f" ratio {n_params(separable) / n_params(standard):.3f} vs 1/N + 1/K^2 = {1/N + 1/K**2:.3f}")
# standard: 147456  separable: 17536  ratio 0.119 vs 1/N + 1/K^2 = 0.119
EfficientNet:深度、寬度、解析度一起放大
手上有一個好的小網路,要怎麼把它變大?加深、加寬,還是提高輸入解析度?Tan 與 Le [18] 主張這三者互相影響:解析度更高的影像需要更深(更大的感受野)與更寬(更細的圖樣)。複合縮放(compound scaling)用一個係數 同時放大三者:
其中 、、 分別是深度、寬度與解析度的倍率。FLOPs 大約與 成正比,所以 每加 1,成本大約加倍。常數是在基礎網路上做小型網格搜尋得到的(基礎網路本身由架構搜尋找出,使用帶深度卷積與 squeeze-and-excitation 的反向瓶頸區塊)。「平衡地放大」這個想法,比那些特定常數活得更久。
ConvNeXt:一步一步現代化的 CNN
在視覺 Transformer 拿下排行榜之後,Liu 等人 [20] 問:它們的優勢有多少來自注意力機制,又有多少來自其他一切?他們從一個用 Transformer 風格配方訓練的 ResNet-50 出發,一次只改一件事:仿照 Swin 的階段比例、「patchify」主幹(、步幅 4 的卷積)、用更大的 深度卷積、反向瓶頸、更少的激活與正規化層、GELU 與 LayerNorm。結果 ConvNeXt 在 ImageNet 與下游任務上,追平了相近成本的 Swin 類 Transformer。教訓是:架構家族的差異,沒有伴隨而來的許多小設計與訓練選擇那麼重要。
注意力機制與 Transformer
白話版。 卷積只用固定的權重看一個小鄰域。注意力機制讓每個位置根據內容,自己決定要聽哪些其他位置的話。視覺 Transformer 把這個機制套用到影像小塊上。
注意力最早以輕量的形式進入 CNN。Squeeze-and-excitation(SE)區塊 [21] 用全域平均把特徵圖的每個通道濃縮成一個數字,再由一個小網路把這些摘要轉成介於 0 與 1 之間的權重,重新縮放各通道。網路因此能在整張影像看起來像動物時,加強「毛皮」相關的通道。SE 區塊是 EfficientNet 與許多行動裝置網路的一部分。
選讀:Squeeze-and-excitation:CNN 裡的注意力(見「補充資料」頁)。SE 的公式與幾行 PyTorch 程式。
ViT:把影像當成一串小塊
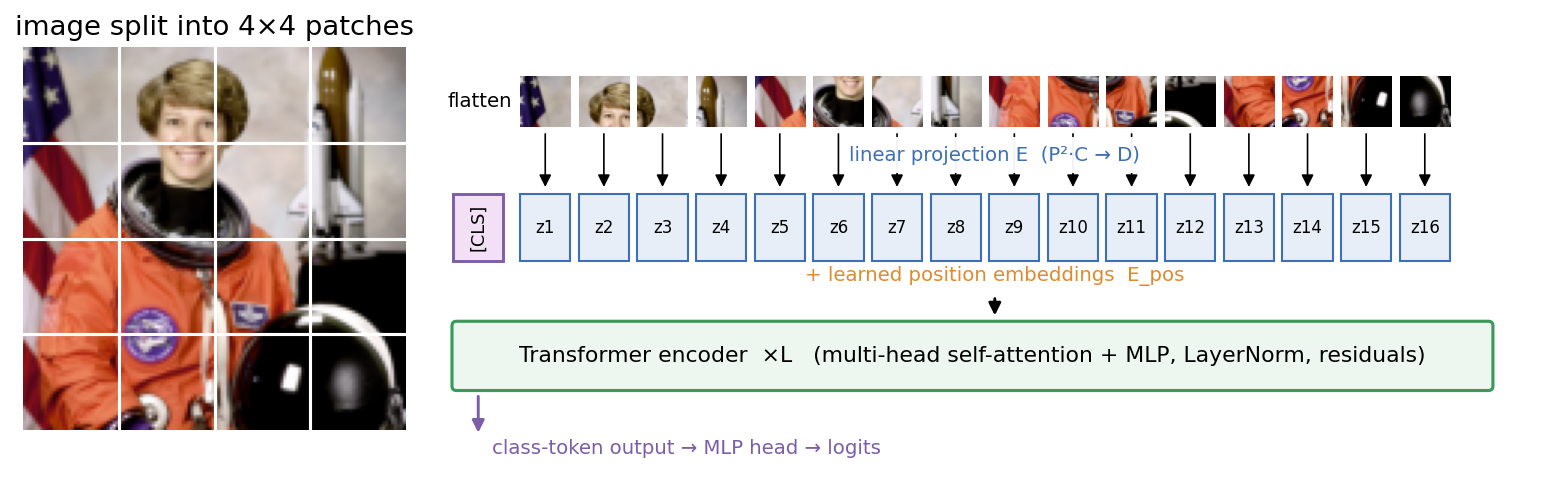
視覺 Transformer(Vision Transformer, ViT)[22] 幾乎完全拿掉卷積。影像 被切成 個不重疊的 小塊(patch)。每個小塊攤平後線性投影成 維的 token。前面再加上一個可學習的類別 token,並加上可學習的位置嵌入:
其中 是第 個攤平的小塊, 是小塊嵌入矩陣, 是位置嵌入。接著由 層標準 Transformer 編碼器(多頭自注意力與 MLP,各自帶 LayerNorm 與殘差連接)處理這個序列,最後由一個小型分類頭讀取類別 token 的最終狀態,輸出 logits。單一個注意力頭的自注意力為
其中 、、 是 token 矩陣 的線性投影, 是 key 的維度。注意力矩陣大小為 :從第一層開始,每個小塊就能注意到所有其他小塊,所以感受野一開始就是全域的。
程式碼 · Python · 23 行
import torch
import torch.nn as nn

B, C, H, W, P, D = 2, 3, 32, 32, 8, 64
img = torch.randn(B, C, H, W)

# 1) patchify: (B, C, H, W) -> (B, N, P*P*C) with N = (H/P)*(W/P)
patches = img.unfold(2, P, P).unfold(3, P, P)                 # (B, C, H/P, W/P, P, P)
patches = patches.permute(0, 2, 3, 1, 4, 5).reshape(B, -1, C * P * P)
N = patches.shape[1]

# 2) linear patch embedding + class token + learned position embedding
embed = nn.Linear(C * P * P, D)          # same as nn.Conv2d(C, D, kernel_size=P, stride=P)
cls = nn.Parameter(torch.zeros(1, 1, D))
pos = nn.Parameter(torch.randn(1, N + 1, D) * 0.02)
z = torch.cat([cls.expand(B, -1, -1), embed(patches)], dim=1) + pos   # (B, N+1, D)

# 3) one head of scaled dot-product self-attention
Wq, Wk, Wv = (nn.Linear(D, D, bias=False) for _ in range(3))
q, k, v = Wq(z), Wk(z), Wv(z)
A = (q @ k.transpose(1, 2) / D ** 0.5).softmax(dim=-1)        # (B, N+1, N+1), rows sum to 1
out = A @ v
print("tokens:", N + 1, " attention:", tuple(A.shape), " class-token output:", tuple(out[:, 0].shape))
為什麼 ViT 需要大量資料。 CNN 內建了一些假設,稱為歸納偏差(inductive bias):局部性(一個像素主要和鄰居有關)與平移等變性(同一個濾波器用在每個位置)。ViT 幾乎沒有這些;除了切小塊與位置嵌入之外,空間結構都得從資料中學。ViT 論文 [22] 回報:只在 ImageNet-1k 上訓練時,ViT 落後於規模相近的 ResNet;但在大得多的資料集上預訓練(ImageNet-21k,或 3 億張影像的 JFT)之後,就能追平甚至超越。弱先驗在小規模時要付出資料的代價,到了大規模就不再是限制。同一篇論文也嘗試了混合(hybrid)模型:把 ResNet 主幹的特徵圖、而不是原始小塊,送進 Transformer;混合模型在計算預算小時較有幫助,模型變大後差距就消失了。
DeiT:只用 ImageNet 訓練 ViT
DeiT [23] 證明「ViT 需要巨量資料」這個結論,有一部分其實是關於訓練配方。用強力的資料擴增(RandAugment、Mixup、CutMix、random erasing)、隨機深度、重複擴增與 AdamW,只在 ImageNet-1k 上訓練的 ViT-B 就達到 83.1% top-1。DeiT 還加入了蒸餾 token:第二個可學習的 token,和類別 token 一樣,但它的輸出被訓練去匹配教師網路的預測(他們發現卷積網路當教師效果最好),而類別 token 則以真實標籤訓練。這是知識蒸餾 [51] 的一種 Transformer 專屬形式。測試時把兩個頭的輸出結合起來。
選讀:知識蒸餾(DLCV 01 的補充資料)。蒸餾損失與溫度的作用。
Swin:視窗、位移與階層
全域注意力的成本隨 token 數量呈平方成長,對高解析度輸入與密集預測任務是個問題。Swin [24] 只在不重疊的 視窗內計算注意力,並在相鄰層之間把視窗網格位移半個視窗,讓資訊能跨越視窗邊界。各階段之間合併 相鄰小塊來減少 token 數,形成步幅為 4、8、16、32 的類 CNN 金字塔。對 個 token、 個通道,論文給出
所以在視窗大小 固定時,視窗注意力對 token 數 是線性的。Swin 帶回了兩個 CNN 先驗:局部性與階層性,成為偵測與分割也通用的骨幹。視覺 Transformer 的整體版圖可參考 Khan 等人的綜述 [25]。
訓練配方
白話版。 同一個網路,訓練方法不同,準確率可以差好幾個百分點。現代訓練配方是一組小技巧,每一個都讓「死背」更難,或讓最佳化更平順。
資料擴增
- 隨機縮放裁切(random resized crop)隨機取一塊占原圖面積一定比例、長寬比隨機的區域,再縮放到訓練解析度。它教會網路尺度與位置不變性,是 ImageNet 訓練的預設做法。水平翻轉只在不改變標籤時使用(大多數照片可以,文字或數字不行)。
- Mixup [26] 混合兩張影像與它們的標籤:、,其中 , 為 one-hot。它鼓勵模型在訓練樣本之間呈線性行為。
- CutMix [27] 把影像 的一個隨機矩形貼到影像 上,並依貼上的面積比例混合標籤。和 Mixup 不同,每個像素都仍是自然的,網路必須從局部視野辨認物體。
- RandAugment [28] 用兩個數字取代學出來的擴增策略:隨機套用 個操作(旋轉、剪切、色階分離、對比……),共用同一個強度 。論文回報這個極小的搜尋空間就能追平或超越先前的自動化策略,而合適的強度取決於模型與資料集大小。
程式碼 · Python · 25 行
import numpy as np
import torch
import torch.nn.functional as F

def mixup(x, y, num_classes, alpha=0.2):
    lam = float(np.random.beta(alpha, alpha))
    idx = torch.randperm(x.size(0))
    y1 = F.one_hot(y, num_classes).float()
    return lam * x + (1 - lam) * x[idx], lam * y1 + (1 - lam) * y1[idx]

def cutmix(x, y, num_classes, alpha=1.0):
    lam = float(np.random.beta(alpha, alpha))
    idx = torch.randperm(x.size(0))
    H, W = x.shape[-2:]
    h, w = int(H * np.sqrt(1 - lam)), int(W * np.sqrt(1 - lam))
    cy, cx = np.random.randint(H), np.random.randint(W)
    y0, y1_, x0, x1_ = max(cy - h // 2, 0), min(cy + h // 2, H), max(cx - w // 2, 0), min(cx + w // 2, W)
    x = x.clone()
    x[..., y0:y1_, x0:x1_] = x[idx][..., y0:y1_, x0:x1_]
    lam = 1 - (y1_ - y0) * (x1_ - x0) / (H * W)            # actual area kept
    y1 = F.one_hot(y, num_classes).float()
    return x, lam * y1 + (1 - lam) * y1[idx]

def soft_ce(logits, soft_targets):
    return -(soft_targets * logits.log_softmax(1)).sum(1).mean()
標籤平滑
以 one-hot 為目標的交叉熵會永遠把正確 logit 往上推;只有在間距無限大時,損失才會到零。標籤平滑 [13] 把目標換成
其中 (常用 0.1)是平滑強度, 是 one-hot 向量, 是全 1 向量。此時最佳解是有限的 logit 間距,對網路有正則化效果,通常也會減少過度自信。在 PyTorch 裡只是一個參數:F.cross_entropy(logits, y, label_smoothing=0.1)。
最佳化器、排程與正則化
- AdamW [29] 把權重衰減與自適應梯度步驟解耦:不是把 加到梯度上(Adam 會再對每個參數重新縮放),而是直接縮小權重,,其中 是學習率, 是 Adam 的動差估計, 是衰減係數。它是 Transformer 與現代 CNN 配方的預設選擇。偏差與正規化層的參數通常不做衰減。
- 暖身+餘弦排程。 訓練最初幾步,正規化統計量與 Adam 的動差估計都還不準,大學習率會不穩定,所以先讓學習率在幾個 epoch 內線性上升,接著沿半個餘弦曲線降到接近零,, 是暖身後的步數, 是剩餘步數;這個想法由 SGDR [30] 推廣開來。
- 隨機深度(stochastic depth)[31] 在訓練時隨機跳過整個殘差分支(區塊變成恆等映射),跳過機率隨深度增加。它縮短了訓練時的有效深度,效果類似一群較淺網路的集成。
- 權重的 EMA 維護一個指數移動平均 ( 接近 1,例如 0.999),評估時使用 。它把最後幾步 SGD 的雜訊平滑掉。
程式碼 · Python · 20 行
import math
import torch

def warmup_cosine(step, total, warmup):
    if step < warmup:
        return (step + 1) / warmup                      # linear warmup
    p = (step - warmup) / max(1, total - warmup)
    return 0.5 * (1 + math.cos(math.pi * p))            # cosine decay to 0

model = torch.nn.Linear(10, 3)
decay = [p for n, p in model.named_parameters() if p.ndim > 1]      # weights
no_decay = [p for n, p in model.named_parameters() if p.ndim <= 1]  # biases, norm scales
opt = torch.optim.AdamW([{"params": decay, "weight_decay": 0.05},
                         {"params": no_decay, "weight_decay": 0.0}], lr=1e-3)
total = 1000
sched = torch.optim.lr_scheduler.LambdaLR(opt, lambda s: warmup_cosine(s, total, warmup=50))
ema = torch.optim.swa_utils.AveragedModel(model, multi_avg_fn=torch.optim.swa_utils.get_ema_multi_avg_fn(0.999))
for step in range(total):
    loss = model(torch.randn(16, 10)).pow(2).mean()
    opt.zero_grad(); loss.backward(); opt.step(); sched.step(); ema.update_parameters(model)
一個小實驗
為了看這些元件一起運作,我們在 scikit-learn 的 手寫數字上,訓練了一個 7.8 萬參數的 ResNet(「TinyResNet」:一個主幹、三個通道數分別為 16、32、64 的基本區塊、全域平均池化)。影像先放大到 ,讓有步幅的階段有空間運作。為了讓過擬合看得見,我們只用 100 張訓練影像,另外 500 張用於校準、1,197 張用於測試;使用 AdamW(權重衰減 0.05)、批次大小 32、40 個 epoch,先暖身兩個 epoch 再做餘弦衰減。一組完全不做擴增;另一組使用隨機旋轉(±15°)、縮放與平移(類似隨機縮放裁切的仿射變換;不翻轉,因為翻轉後的數字是另一個符號),並搭配標籤平滑 0.1。所有程式碼都在 scripts/figures/dl_02_image_classification.py,在 CPU 上大約一分鐘跑完。
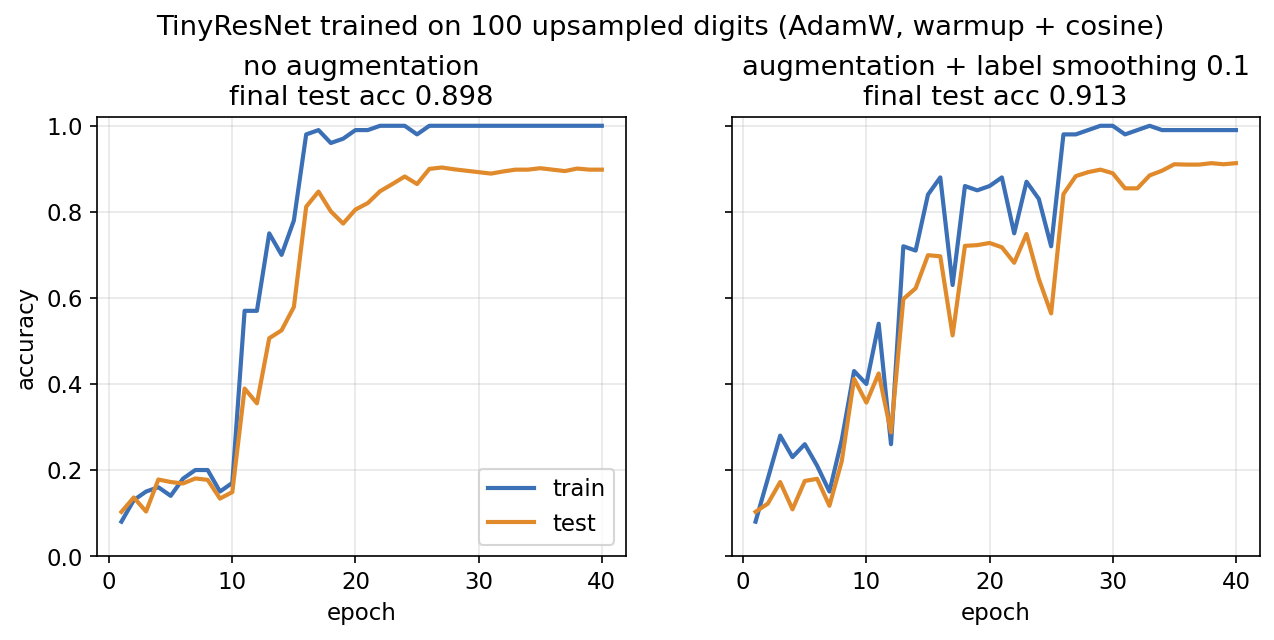
沒有擴增的模型大約二十個 epoch 後就達到 100% 訓練準確率:只有 100 張影像,背起來很容易。有擴增的模型每個 epoch 看到的都是稍微不同的數字,學得比較慢,泛化稍好(91.3% 對 89.8%)。單一隨機種子上 1.5 個百分點不必過度解讀;重點是機制。
「ResNet strikes back」
配方重要性最驚人的證據,來自 Wightman、Touvron 與 Jégou [32]。他們保持 2015 年的 ResNet-50 架構不變,用現代配方重新訓練:隨機縮放裁切與翻轉、RandAugment、Mixup 與 CutMix、LAMB 最佳化器配餘弦排程、二元交叉熵損失,以及更長的訓練。原汁原味的 ResNet-50 在 的 ImageNet 上,不用額外資料或蒸餾就達到 80.4% top-1,而他們比較的標準 torchvision 權重是 76.1%。這帶來兩個結論。第一,許多「新架構打敗 ResNet-50」的宣稱,其實是拿用新配方訓練的新模型,去比用舊配方訓練的舊模型。第二,比較架構時,要用相同且調好的配方訓練它們,就像 ConvNeXt [20] 與 RegNet [19] 的做法。
遷移學習與微調
白話版。 從頭訓練一個骨幹網路需要大量資料。比較好的做法是:從一個已經在大型資料集上訓練好的網路出發,再把它調整到你的任務上。你可以凍結它的特徵、只訓練新的最後一層,也可以溫和地重新訓練所有參數。
令 為一個預訓練骨幹,把影像映射成特徵向量 , 為新的線性分類頭。
- 線性探測(linear probe)。凍結 ,只訓練 (等於在固定特徵上做邏輯迴歸)。它便宜、需要的標籤少,也是衡量表徵好壞的標準方法。
- 完整微調(full fine-tuning)。同時更新 與 ,通常骨幹的學習率比分類頭小 10–100 倍,搭配短暫的暖身,有時還會用逐層學習率衰減(越前面的層學習率越小)。它讓特徵適應新的領域,標註資料夠多時通常勝出。
- 介於兩者之間的,有部分微調(只調最後幾個階段),以及在凍結骨幹上加入小型可訓練模組的參數高效方法。
Kornblith 等人 [33] 量測了 ImageNet 準確率能多好地預測遷移表現。對微調而言,ImageNet 上越好的模型通常遷移得越好,相關性很強。對固定特徵而言,相關性較弱,而且取決於正則化選擇:有些提升 ImageNet 準確率的設定(例如標籤平滑與 dropout),反而產生了在其他任務上更差的凍結特徵。好的分類器與好的特徵擷取器相關,但不是同一件事。
程式碼 · Python · 17 行
import torch
import torch.nn as nn

backbone = nn.Sequential(nn.Conv2d(3, 32, 3, 2, 1), nn.ReLU(), nn.Conv2d(32, 64, 3, 2, 1), nn.ReLU(),
                         nn.AdaptiveAvgPool2d(1), nn.Flatten())          # stand-in for a pre-trained model
head = nn.Linear(64, 5)

# linear probe: freeze the backbone, train only the head
for p in backbone.parameters():
    p.requires_grad = False
probe_opt = torch.optim.AdamW(head.parameters(), lr=1e-3)

# full fine-tuning: unfreeze, use a smaller learning rate for the backbone than for the head
for p in backbone.parameters():
    p.requires_grad = True
ft_opt = torch.optim.AdamW([{"params": backbone.parameters(), "lr": 1e-5},
                            {"params": head.parameters(), "lr": 1e-3}], weight_decay=0.05)
自監督學習與基礎模型分類器
白話版。 標籤很貴,影像很便宜。自監督學習自己發明一個答案就藏在影像裡的任務(這兩塊裁切是不是來自同一張照片?被遮住的地方原本是什麼?),透過解這個任務學到特徵,最後才用少量標籤。
對比式學習:SimCLR 與 MoCo
對比式方法把同一張影像的兩個擴增視圖的嵌入拉近,把不同影像的視圖推遠。在 SimCLR [34] 中,每個視圖都要在批次裡所有其他視圖中找出自己的搭檔,這是一個「錯誤答案」就是其他影像的分類任務;強力擴增(特別是裁切加上顏色扭曲)與大批次被證明不可或缺。MoCo [35] 則維護一個由緩慢更新的編碼器副本所產生的嵌入佇列,不需超大批次也能有大量負樣本。
選讀:對比式學習細說:SimCLR 與 MoCo(見「補充資料」頁)。逐一定義符號的 InfoNCE 損失,以及 MoCo 的動量編碼器如何運作。
DINO 與 DINOv2:自我蒸餾
DINO [36] 不再使用明確的負樣本。學生網路看幾個裁切(包括小的局部裁切),被訓練去匹配看全域裁切的教師網路的輸出分佈。教師是學生的 EMA;對教師輸出做中心化與銳化,可以防止崩塌成常數。用 ViT 時,DINO 特徵展現出驚人的性質:類別 token 的注意力圖不需任何分割標籤就能把物體分割出來,而在凍結特徵上用簡單的 -NN 分類器效果就很好。DINOv2 [38] 以自動篩選的資料集與一個大型 ViT(再蒸餾成較小的模型)擴大規模,產生通用的凍結特徵,不需微調就能用於分類、分割與深度估計。DINOv3 [39] 繼續擴大規模,並提出「Gram anchoring」,避免密集的小塊特徵在長時間訓練中劣化。
MAE:遮罩影像建模
MAE [37] 借用了遮罩語言模型的想法。它遮掉大比例的小塊(論文中為 75%),只把看得見的小塊送進 ViT 編碼器,再讓一個輕量解碼器重建被遮掉的像素。因為編碼器跳過被遮掉的 token,預訓練很便宜。MAE 特徵的線性可分性不如對比式特徵(線性探測較弱),但微調效果非常好。這是一再出現的模式:不同的預訓練目標,適合不同的適應方式。
CLIP:用語言做零樣本分類
CLIP [40] 用數億組影像與說明文字,以對稱的對比損失同時訓練影像編碼器 與文字編碼器 ,讓配對的影像與文字有高的餘弦相似度。之後不需要任何訓練影像就能建立分類器:為每個類別寫一句提示,例如 a photo of a dog.,將它嵌入,然後預測
其中 是類別 的提示。文字嵌入扮演線性分類器權重的角色,只是它們是從文字算出來的。論文回報零樣本 CLIP 的準確率追平了一個用 ImageNet 128 萬張標註影像訓練的 ResNet-50,而平均多個提示模板(「a photo of a …」、「a blurry photo of a …」)會有幫助。零樣本準確率高度依賴提示的用字、類別名稱在視覺上是否有意義,以及網路資料對該領域的涵蓋程度。
穩健性與評估陷阱
白話版。 一個在測試集上拿 90% 的分類器,碰到不同相機拍的照片、有人刻意加上肉眼看不見的雜訊,或它學到的「簡單線索」(背景、浮水印)不見時,可能會錯得一塌糊塗。而且就算答對了,它的信心也可能不對。
分佈偏移:ImageNet-C、-R 與 -A
Hendrycks 等人為 ImageNet 分類器建立了三個廣泛使用的偏移測試集。ImageNet-C [42] 套用 15 種演算法產生的損壞(雜訊、模糊、天氣、數位瑕疵),各有五個嚴重程度,並以相對於基準模型的錯誤率總結(mean corruption error)。ImageNet-R [43] 收集了 200 個 ImageNet 類別的各種表現形式(藝術、卡通、雕塑、素描、玩具),測試模型理解的是形狀與概念,還是照片的紋理。ImageNet-A [44] 收錄未經修改的自然照片,這些照片經過篩選、專門騙倒 ResNet-50;標準模型在上面表現非常差。這三個測試集揭露不同的弱點,改善其中一個不保證改善其他。大規模預訓練(如 CLIP 與 DINOv2)對這類自然偏移的穩健性提升,往往遠大於在相同資料下更換架構。
對抗樣本:FGSM
Goodfellow 等人 [45] 用網路在高維空間中的線性來解釋對抗樣本:對每一個輸入維度做一點點、與權重方向一致的改變,累加起來就是輸出的巨大變化。快速梯度符號法(fast gradient sign method, FGSM)一步就完成擾動:
其中 限制每個像素的改變量( 範數), 是損失函數, 把像素值限制在有效範圍內。
程式碼 · Python · 6 行
import torch.nn.functional as F

def fgsm(model, x, y, eps):
    x = x.clone().requires_grad_(True)
    F.cross_entropy(model(x), y).backward()
    return (x + eps * x.grad.sign()).clamp(-1, 1).detach()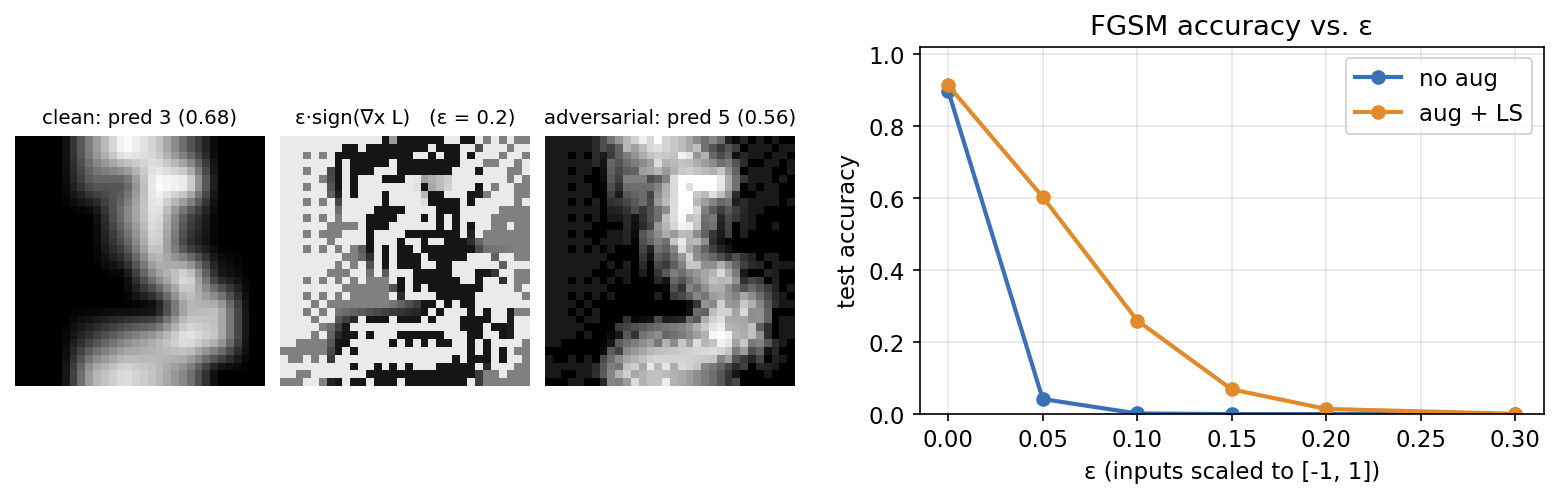
關於圖 8 有兩點要注意。第一,擴增模型在小 時看起來比較穩健,但已知標籤平滑會讓訓練點附近的損失曲面變平,可能削弱單步梯度攻擊,卻沒有帶來真正的穩健性;正確的檢驗是更強的迭代攻擊。第二,在 範圍內 對 8×8 的數字來說是看得見的;在自然影像上,肉眼無法察覺的擾動就足以騙過標準的 ImageNet 模型。
捷徑學習
Geirhos 等人 [46] 把許多失敗案例歸在同一個名字下:捷徑學習(shortcut learning)。網路會用最容易的線索來最小化訓練損失,而那常常不是我們想要的線索:看背景而不是動物、看醫院的標記而不是病灶、看紋理而不是形狀。捷徑在獨立同分佈的測試集上看起來沒問題,因為測試集裡也有同樣的捷徑;一遇到分佈偏移就會失敗。對策是:刻意在分佈外測試、設計能打破可疑捷徑的測試,並用 Grad-CAM(見下文)這類可解釋性工具檢查模型在看哪裡。
校準與溫度縮放
溫度縮放(temperature scaling)[47] 在 softmax 之前把所有 logits 除以同一個純量 :。 是在保留的校準集(絕不是測試集)上最小化負對數概似而得。 讓過度自信的預測變柔和; 讓信心不足的預測變銳利。因為除以 不改變 argmax,準確率不變。
程式碼 · Python · 32 行
import torch
import torch.nn.functional as F

def fit_temperature(logits, y, iters=300):
    """Learn one scalar T > 0 on a held-out calibration split."""
    log_t = torch.zeros(1, requires_grad=True)
    opt = torch.optim.Adam([log_t], lr=0.05)
    for _ in range(iters):
        loss = F.cross_entropy(logits / log_t.exp(), y)
        opt.zero_grad(); loss.backward(); opt.step()
    return log_t.exp().item()

def ece(probs, y, n_bins=10):
    conf, pred = probs.max(1)
    correct = (pred == y).float()
    edges = torch.linspace(0, 1, n_bins + 1)
    total = 0.0
    for lo, hi in zip(edges[:-1], edges[1:]):
        m = (conf > lo) & (conf <= hi)
        if m.any():
            total += m.float().mean() * (correct[m].mean() - conf[m].mean()).abs()
    return float(total)

# toy check: an over-confident "model" = true logits multiplied by 3
torch.manual_seed(0)
true_logits = torch.randn(4000, 10)
y = torch.distributions.Categorical(logits=true_logits).sample()
over = 3 * true_logits
T = fit_temperature(over[:2000], y[:2000])
print(f"T = {T:.2f}  ECE {ece(over[2000:].softmax(1), y[2000:]):.3f} -> "
      f"{ece((over[2000:] / T).softmax(1), y[2000:]):.3f}")
# T = 2.90  ECE 0.345 -> 0.018
在這個玩具例子裡,logits 被放大了三倍,擬合出的溫度(2.90)找回了這個倍數。而在我們真正的 TinyResNet(未擴增的那個模型)上,校準誤差的方向相反。
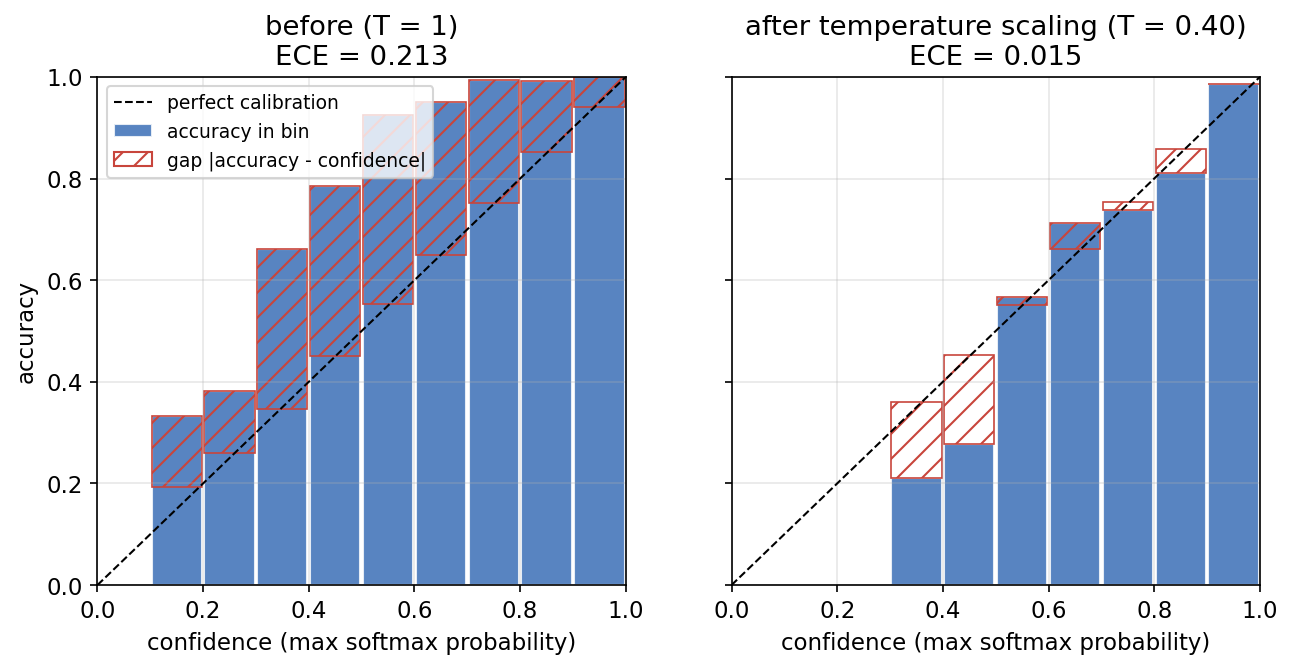
為什麼信心不足?我們的小模型訓練時間短、權重衰減又強,使 logits 保持很小。Guo 等人 [47] 觀察到的是大型、長時間訓練的現代網路過度自信,並指出深度、寬度、批次正規化與較小的權重衰減都是成因。校準誤差沒有固定的方向;要量測它。另外也要注意,校準本身在分佈偏移下很脆弱:在分佈內資料上擬合的溫度,不保證在 ImageNet-C 式的偏移上仍然校準良好。
效率
白話版。 模型必須放得進裝置、跑得進時間預算。參數量、計算量與實際速度是三種不同的量測,而使用者感受到的只有最後一種。
- 參數量決定模型在磁碟與記憶體中的大小。一個 float32 參數占 4 個位元組。
- FLOPs(或乘加運算 MACs;一次 MAC 通常算作兩個 FLOPs)衡量每張影像的運算量。對核大小 、輸入 通道、輸出 通道、輸出特徵圖為 的卷積,MACs 。計算量隨解析度的平方成長。
- 延遲與吞吐量要在目標硬體上量測。深度卷積的 FLOPs 很少,但運算密度低,所以在 GPU 上常比 FLOPs 所暗示的還慢;DenseNet 的串接則耗費記憶體頻寬。一定要實測。
- 量化(quantization)把權重與激活值存成 8 位元整數,而不是 32 位元浮點數。Jacob 等人 [50] 描述了只用整數運算的推論,搭配量化感知訓練:在訓練時模擬捨入,讓網路學會容忍它。用少量校準資料做訓練後量化,則是較便宜的替代方案。
- 蒸餾 [51] 訓練一個小的學生網路去匹配大型教師網路的軟預測,就像 DeiT 用蒸餾 token 所做的那樣。
可解釋性:CAM 與 Grad-CAM
白話版。 疊在影像上的熱圖,顯示哪些區域把某個類別的分數推高了。它是健全性檢查,不是推理過程的證明。
類別激活映射(class activation mapping, CAM)[48] 適用於以全域平均池化加一層線性層結尾的網路。若 是最後一個卷積層的第 個特徵圖, 是它連到類別 的權重,則類別分數為 ,而 這張圖顯示分數來自哪裡。Grad-CAM [49] 用空間平均的梯度取代這些權重,把方法推廣到任何可微分的架構:
其中 是類別 的 logit, 是通道 在位置 的激活值, 是位置總數。ReLU 只保留對該類別有正面影響的區域。粗糙的熱圖(我們的網路中是 )再上採樣到影像大小。
程式碼 · Python · 13 行
import torch.nn.functional as F

def grad_cam(model, x, target=None):
    model.eval()
    feats = model.features(x)                          # (1, K, h, w) last conv stage
    feats.retain_grad()
    logits = model.fc(feats.mean(dim=(2, 3)))
    c = logits.argmax(1).item() if target is None else target
    logits[0, c].backward()
    alpha = feats.grad.mean(dim=(2, 3), keepdim=True)  # channel importance weights
    cam = F.relu((alpha * feats).sum(1, keepdim=True))
    cam = F.interpolate(cam, size=x.shape[-2:], mode="bilinear", align_corners=False)
    return (cam / (cam.max() + 1e-8))[0, 0].detach(), c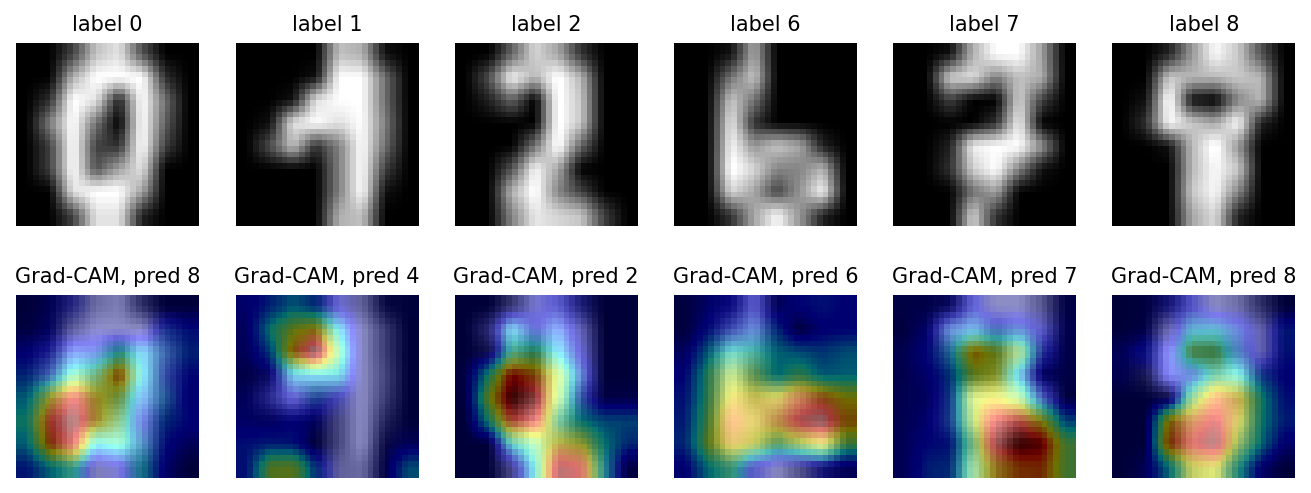
解釋方法在模型出錯時最有用,就像圖 10:它們顯示了哪些筆畫看起來像錯誤的類別。但對顯著圖要謹慎。它們很粗糙(受限於最後一層特徵圖的解析度),而且只解釋單一輸入的單一類別分數,不是模型的一般推理方式。
現代觀點
值得一讀的綜述。 Li 等人 [1] 從基本構成元件到進階模型回顧 CNN,並以實驗比較激活函數、損失函數與最佳化器。Khan 等人 [25] 綜述視覺 Transformer,強調它們對大規模預訓練的依賴,以及平方複雜度注意力的成本。Gui 等人 [41] 把自監督學習分成以脈絡為基礎、對比式、生成式與混合式方法。在基準可靠性方面,ImageNetV2 [7]、重新標註 [8] 與標籤錯誤 [9] 三項研究共同主張:使用多個測試集、多標籤評估,並回報變異。
選讀:現代觀點綜述導讀(見「論文導讀」頁)。每篇綜述涵蓋什麼,以及如何分類這個領域。
2023–2026 年的樣貌。 五個趨勢定義了當前的實務。
- 預訓練一次,便宜地適應。 大多數新的分類器都不是從頭訓練。它們從一個以自監督(DINOv2 [38]、DINOv3 [39])、影像–文字對比(CLIP [40] 及其開源重現)或遮罩建模(MAE [37])訓練的大型骨幹出發,再以線性探測、-NN 規則或短暫微調來適應。
- 零樣本與開放詞彙分類。 影像–文字模型把標籤集合變成文字。類別清單可以在測試時更換、不需重新訓練,模糊了分類與檢索之間的界線。
- 視覺的縮放定律。 Zhai 等人 [52] 把 ViT 擴大到數十億參數,刻畫了錯誤率如何隨計算量、資料量與模型大小下降,並觀察到較大的模型在少樣本遷移中更有樣本效率。Cherti 等人 [53] 在公開資料上為開源 CLIP 訓練擬合出可重現的冪律,發現縮放行為取決於訓練資料分佈與下游任務。
- 架構趨於收斂。 ConvNeXt [20] 與 Swin [24] 顯示,在相同配方與規模下,卷積與注意力會落在相近的位置。現在的選擇更多取決於硬體、解析度與下游任務(密集預測偏好階層式設計),而不是 top-1 準確率。
- 評估不再只看 ImageNet-1k top-1。 穩健性測試組(ImageNet-C/R/A [42]–[44] 與 ImageNetV2 [7])、校準,以及遷移到大量下游資料集,現在都是骨幹論文的標準內容。
開放問題。 對自然分佈偏移的穩健性仍落後於乾淨資料上的準確率,而穩健訓練方法帶來的進步往往只針對它所瞄準的那種偏移。沒有反事實測試,捷徑學習 [46] 很難被發現。分佈偏移下的校準仍未解決。長尾與細粒度辨識依然困難,因為稀有類別的樣本最少。基準飽和與標籤雜訊,讓 ImageNet-1k 上的微小準確率差異失去意義。而主流的基礎模型是用網路規模的資料訓練的,其組成、授權與偏差都很難稽核,這直接影響「零樣本」分類器能認出什麼、認不出什麼。
重點整理
- 互斥標籤使用 softmax,多標籤任務使用獨立 sigmoid 輸出。
- 在相同資料、訓練與計算條件下比較骨幹,架構名稱本身不足以解釋分數差異。
- 預訓練提供可重用特徵;線性探測評估特徵,微調則改變特徵。
- 檢查混淆矩陣與逐類別結果,並註明平均方式為 macro 或 micro。
- 用保留資料擬合校準,並同時評估信心與準確率。
- 分開測試分布轉移、捷徑與效率;報告多個隨機種子,只用驗證資料調整選擇。
練習
- 感受野與參數量。 證明三層疊加的 卷積(步幅 1)感受野為 。在輸入與輸出都是 通道、無偏差項的情況下,與單一 卷積比較參數量。
提示
每層 讓感受野增加 2 個像素:。參數量: 對 ,少了約 45%,還多了兩個非線性。
- 瓶頸區塊的算術。 一個 ResNet 瓶頸區塊輸入有 個通道,降到 。以 表示 –– 分支的權重數(無偏差),並與寬度 、兩層 的基本區塊比較。比值是多少?
提示
瓶頸:。寬度 的基本區塊:。比值為 ,權重少了約 17 倍。
- 標籤平滑的最佳解。 對一個有 個類別、平滑強度 的樣本,假設所有錯誤類別的 logit 相等。證明平滑目標下的交叉熵在「正確類別與每個錯誤類別的 logit 差」為 時最小。代入 、 計算。
提示
交叉熵對 的最小值發生在 。所以 ,其他每個 ,logit 差就是兩者比值的對數:。沒有平滑時,最佳間距是無限大。
- ViT 的 token 數。 一個使用 小塊的 ViT 收到 的影像。有多少 token 進入編碼器?若以 微調,token 數是多少?注意力矩陣大小成長幾倍?位置嵌入又該怎麼處理?
提示
個小塊加一個類別 token:197。在 384 時:。注意力矩陣成長 倍。學到的位置嵌入是 的網格,要以二維內插放大到 ;ViT 論文在較高解析度微調時正是這麼做的。
- 溫度不改變準確率。 證明對任何 ,。接著用
scripts/figures/dl_02_image_classification.py,改在測試集上而不是校準集上擬合溫度,比較回報的 ECE。為什麼那個數字過於樂觀?
提示
除以正的常數與指數函數都是嚴格遞增的,而 softmax 的分母是共用的。在測試集上擬合 等於用測試標籤調整參數,因此回報的 ECE 不再是對新資料表現的誠實估計。
- 製造一條捷徑。 修改數字實驗,讓訓練集中每個「3」的左上角都有一個亮點,但測試集沒有。訓練 TinyResNet,回報測試集上 3 的準確率,並看幾個訓練用 3 的 Grad-CAM 熱圖。你預期會看到什麼?如果你事先不知道有這條捷徑,要怎麼發現這個問題?
提示
網路光看角落的亮點就能分類訓練集中的 3,所以測試集上 3 的準確率會下降、訓練準確率卻仍完美,而 Grad-CAM 往往會亮在角落。不知道捷徑時,可以找熱區落在背景上的熱圖、在獨立收集的資料上評估,並做反事實測試(抹除或移動可疑區域,看預測是否改變)。
- 巨觀與微觀 F1。 一個三類別模型在 100 張影像上測試。列為真實類別、行為預測:類別 A(90 張)→ 88 A、1 B、1 C;類別 B(5 張)→ 3 A、2 B、0 C;類別 C(5 張)→ 4 A、0 B、1 C。計算逐類別的精確率、召回率與 ,再算巨觀 與微觀 。如果報告的重點是能否偵測稀有的 B 與 C,你會放哪一個數字?為什麼?
提示
各行總和為 95、3、2。精確率:、、。召回率:、、。用 :、、。巨觀 。微觀 等於準確率 。微觀被類別 A 主導;巨觀則揭露 B 與 C 大多被漏掉,所以對稀有類別而言,巨觀(加上逐類別召回率)才是誠實的數字。可以用 precision_recall_fscore_support(..., average="macro") 驗算。
參考文獻
- Z. Li, F. Liu, W. Yang, S. Peng, and J. Zhou, “A Survey of Convolutional Neural Networks: Analysis, Applications, and Prospects,” IEEE Transactions on Neural Networks and Learning Systems, vol. 33, no. 12, pp. 6999–7019, 2022. doi:10.1109/TNNLS.2021.3084827
- O. Russakovsky, J. Deng, H. Su, J. Krause, S. Satheesh, S. Ma, et al., “ImageNet Large Scale Visual Recognition Challenge,” International Journal of Computer Vision, vol. 115, pp. 211–252, 2015. doi:10.1007/s11263-015-0816-y
- Y. LeCun, L. Bottou, Y. Bengio, and P. Haffner, “Gradient-Based Learning Applied to Document Recognition,” Proceedings of the IEEE, vol. 86, no. 11, pp. 2278–2324, 1998. doi:10.1109/5.726791
- A. Krizhevsky, “Learning Multiple Layers of Features from Tiny Images,” technical report, University of Toronto, 2009. dataset page
- T. Ridnik, E. Ben-Baruch, A. Noy, and L. Zelnik-Manor, “ImageNet-21K Pretraining for the Masses,” NeurIPS, 2021. arXiv
- G. Van Horn, O. Mac Aodha, Y. Song, Y. Cui, C. Sun, A. Shepard, et al., “The iNaturalist Species Classification and Detection Dataset,” CVPR, 2018. arXiv
- B. Recht, R. Roelofs, L. Schmidt, and V. Shankar, “Do ImageNet Classifiers Generalize to ImageNet?,” ICML, PMLR vol. 97, 2019. paper
- L. Beyer, O. J. Hénaff, A. Kolesnikov, X. Zhai, and A. van den Oord, “Are We Done with ImageNet?,” arXiv:2006.07159, 2020. arXiv
- C. G. Northcutt, A. Athalye, and J. Mueller, “Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks,” NeurIPS, 2021. arXiv
- A. Krizhevsky, I. Sutskever, and G. E. Hinton, “ImageNet Classification with Deep Convolutional Neural Networks,” Advances in Neural Information Processing Systems 25 (NIPS), 2012. paper
- K. Simonyan and A. Zisserman, “Very Deep Convolutional Networks for Large-Scale Image Recognition,” ICLR, 2015. arXiv
- C. Szegedy, W. Liu, Y. Jia, P. Sermanet, S. Reed, D. Anguelov, D. Erhan, V. Vanhoucke, and A. Rabinovich, “Going Deeper with Convolutions,” CVPR, 2015. doi:10.1109/CVPR.2015.7298594
- C. Szegedy, V. Vanhoucke, S. Ioffe, J. Shlens, and Z. Wojna, “Rethinking the Inception Architecture for Computer Vision,” CVPR, 2016. doi:10.1109/CVPR.2016.308
- K. He, X. Zhang, S. Ren, and J. Sun, “Deep Residual Learning for Image Recognition,” CVPR, 2016. doi:10.1109/CVPR.2016.90
- K. He, X. Zhang, S. Ren, and J. Sun, “Identity Mappings in Deep Residual Networks,” ECCV, 2016. arXiv
- G. Huang, Z. Liu, L. van der Maaten, and K. Q. Weinberger, “Densely Connected Convolutional Networks,” CVPR, 2017. arXiv
- A. G. Howard, M. Zhu, B. Chen, D. Kalenichenko, W. Wang, T. Weyand, M. Andreetto, and H. Adam, “MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications,” arXiv:1704.04861, 2017. arXiv
- M. Tan and Q. V. Le, “EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks,” ICML, 2019. arXiv
- I. Radosavovic, R. P. Kosaraju, R. Girshick, K. He, and P. Dollár, “Designing Network Design Spaces,” CVPR, 2020. arXiv
- Z. Liu, H. Mao, C.-Y. Wu, C. Feichtenhofer, T. Darrell, and S. Xie, “A ConvNet for the 2020s,” CVPR, 2022. arXiv
- J. Hu, L. Shen, S. Albanie, G. Sun, and E. Wu, “Squeeze-and-Excitation Networks,” arXiv:1709.01507, 2017 (journal version in IEEE TPAMI). arXiv
- A. Dosovitskiy, L. Beyer, A. Kolesnikov, D. Weissenborn, X. Zhai, T. Unterthiner, et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” ICLR, 2021. arXiv
- H. Touvron, M. Cord, M. Douze, F. Massa, A. Sablayrolles, and H. Jégou, “Training Data-Efficient Image Transformers & Distillation through Attention,” ICML, PMLR vol. 139, 2021. paper
- Z. Liu, Y. Lin, Y. Cao, H. Hu, Y. Wei, Z. Zhang, S. Lin, and B. Guo, “Swin Transformer: Hierarchical Vision Transformer using Shifted Windows,” ICCV, 2021. doi:10.1109/ICCV48922.2021.00986
- S. Khan, M. Naseer, M. Hayat, S. W. Zamir, F. S. Khan, and M. Shah, “Transformers in Vision: A Survey,” ACM Computing Surveys, 2022. arXiv
- H. Zhang, M. Cisse, Y. N. Dauphin, and D. Lopez-Paz, “mixup: Beyond Empirical Risk Minimization,” ICLR, 2018. arXiv
- S. Yun, D. Han, S. J. Oh, S. Chun, J. Choe, and Y. Yoo, “CutMix: Regularization Strategy to Train Strong Classifiers with Localizable Features,” ICCV, 2019. arXiv
- E. D. Cubuk, B. Zoph, J. Shlens, and Q. V. Le, “RandAugment: Practical Automated Data Augmentation with a Reduced Search Space,” CVPR Workshops, 2020. doi:10.1109/CVPRW50498.2020.00359
- I. Loshchilov and F. Hutter, “Decoupled Weight Decay Regularization,” ICLR, 2019. arXiv
- I. Loshchilov and F. Hutter, “SGDR: Stochastic Gradient Descent with Warm Restarts,” ICLR, 2017. arXiv
- G. Huang, Y. Sun, Z. Liu, D. Sedra, and K. Q. Weinberger, “Deep Networks with Stochastic Depth,” ECCV, 2016. doi:10.1007/978-3-319-46493-0_39
- R. Wightman, H. Touvron, and H. Jégou, “ResNet Strikes Back: An Improved Training Procedure in timm,” arXiv:2110.00476, 2021. arXiv
- S. Kornblith, J. Shlens, and Q. V. Le, “Do Better ImageNet Models Transfer Better?,” CVPR, 2019. arXiv
- T. Chen, S. Kornblith, M. Norouzi, and G. Hinton, “A Simple Framework for Contrastive Learning of Visual Representations,” ICML, 2020. arXiv
- K. He, H. Fan, Y. Wu, S. Xie, and R. Girshick, “Momentum Contrast for Unsupervised Visual Representation Learning,” CVPR, 2020. arXiv
- M. Caron, H. Touvron, I. Misra, H. Jégou, J. Mairal, P. Bojanowski, and A. Joulin, “Emerging Properties in Self-Supervised Vision Transformers,” ICCV, 2021. doi:10.1109/ICCV48922.2021.00951
- K. He, X. Chen, S. Xie, Y. Li, P. Dollár, and R. Girshick, “Masked Autoencoders Are Scalable Vision Learners,” CVPR, 2022. doi:10.1109/CVPR52688.2022.01553
- M. Oquab, T. Darcet, T. Moutakanni, H. Vo, M. Szafraniec, V. Khalidov, et al., “DINOv2: Learning Robust Visual Features without Supervision,” Transactions on Machine Learning Research, 2024. arXiv
- O. Siméoni, H. V. Vo, M. Seitzer, F. Baldassarre, M. Oquab, C. Jose, et al., “DINOv3,” arXiv:2508.10104, 2025. arXiv
- A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, S. Agarwal, et al., “Learning Transferable Visual Models From Natural Language Supervision,” ICML, PMLR vol. 139, 2021. paper
- J. Gui, T. Chen, J. Zhang, Q. Cao, Z. Sun, H. Luo, and D. Tao, “A Survey on Self-Supervised Learning: Algorithms, Applications, and Future Trends,” IEEE Transactions on Pattern Analysis and Machine Intelligence (arXiv:2301.05712, 2023). arXiv
- D. Hendrycks and T. Dietterich, “Benchmarking Neural Network Robustness to Common Corruptions and Perturbations,” ICLR, 2019. arXiv
- D. Hendrycks, S. Basart, N. Mu, S. Kadavath, F. Wang, E. Dorundo, et al., “The Many Faces of Robustness: A Critical Analysis of Out-of-Distribution Generalization,” ICCV, 2021. arXiv
- D. Hendrycks, K. Zhao, S. Basart, J. Steinhardt, and D. Song, “Natural Adversarial Examples,” CVPR, 2021. arXiv
- I. J. Goodfellow, J. Shlens, and C. Szegedy, “Explaining and Harnessing Adversarial Examples,” in Proc. International Conference on Learning Representations (ICLR), 2015. arXiv
- R. Geirhos, J.-H. Jacobsen, C. Michaelis, R. Zemel, W. Brendel, M. Bethge, and F. A. Wichmann, “Shortcut Learning in Deep Neural Networks,” Nature Machine Intelligence, 2020. arXiv
- C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger, “On Calibration of Modern Neural Networks,” ICML, 2017. arXiv
- B. Zhou, A. Khosla, A. Lapedriza, A. Oliva, and A. Torralba, “Learning Deep Features for Discriminative Localization,” CVPR, 2016. doi:10.1109/CVPR.2016.319
- R. R. Selvaraju, M. Cogswell, A. Das, R. Vedantam, D. Parikh, and D. Batra, “Grad-CAM: Visual Explanations from Deep Networks via Gradient-Based Localization,” ICCV, 2017. doi:10.1109/ICCV.2017.74
- B. Jacob, S. Kligys, B. Chen, M. Zhu, M. Tang, A. Howard, et al., “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference,” CVPR, 2018. doi:10.1109/CVPR.2018.00286
- G. Hinton, O. Vinyals, and J. Dean, “Distilling the Knowledge in a Neural Network,” arXiv:1503.02531, 2015. arXiv
- X. Zhai, A. Kolesnikov, N. Houlsby, and L. Beyer, “Scaling Vision Transformers,” CVPR, 2022. arXiv
- M. Cherti, R. Beaumont, R. Wightman, M. Wortsman, G. Ilharco, C. Gordon, et al., “Reproducible Scaling Laws for Contrastive Language-Image Learning,” CVPR, 2023. arXiv
- T. Fawcett, “An Introduction to ROC Analysis,” Pattern Recognition Letters, vol. 27, no. 8, pp. 861–874, 2006. doi:10.1016/j.patrec.2005.10.010
- J. Davis and M. Goadrich, “The Relationship Between Precision-Recall and ROC Curves,” Proc. 23rd International Conference on Machine Learning (ICML), pp. 233–240, 2006. doi:10.1145/1143844.1143874
- T. Saito and M. Rehmsmeier, “The Precision-Recall Plot Is More Informative than the ROC Plot When Evaluating Binary Classifiers on Imbalanced Datasets,” PLOS ONE, vol. 10, no. 3, e0118432, 2015. doi:10.1371/journal.pone.0118432
- D. Chicco and G. Jurman, “The Advantages of the Matthews Correlation Coefficient (MCC) over F1 Score and Accuracy in Binary Classification Evaluation,” BMC Genomics, vol. 21, article 6, 2020. doi:10.1186/s12864-019-6413-7
- M. Sokolova and G. Lapalme, “A Systematic Analysis of Performance Measures for Classification Tasks,” Information Processing & Management, vol. 45, no. 4, pp. 427–437, 2009. doi:10.1016/j.ipm.2009.03.002
- J. Cohen, “A Coefficient of Agreement for Nominal Scales,” Educational and Psychological Measurement, vol. 20, no. 1, pp. 37–46, 1960. doi:10.1177/001316446002000104
- M.-L. Zhang and Z.-H. Zhou, “A Review on Multi-Label Learning Algorithms,” IEEE Transactions on Knowledge and Data Engineering, vol. 26, no. 8, pp. 1819–1837, 2014. doi:10.1109/TKDE.2013.39
- M. Everingham, L. Van Gool, C. K. I. Williams, J. Winn, and A. Zisserman, “The Pascal Visual Object Classes (VOC) Challenge,” International Journal of Computer Vision, vol. 88, no. 2, pp. 303–338, 2010. doi:10.1007/s11263-009-0275-4
- F. Pedregosa, G. Varoquaux, A. Gramfort, V. Michel, B. Thirion, O. Grisel, et al., “Scikit-learn: Machine Learning in Python,” Journal of Machine Learning Research, vol. 12, pp. 2825–2830, 2011. paper
- H. Wang, S. Ge, E. P. Xing, and Z. C. Lipton, “Learning Robust Global Representations by Penalizing Local Predictive Power,” NeurIPS, 2019 (introduces ImageNet-Sketch). arXiv
- A. Barbu, D. Mayo, J. Alverio, W. Luo, C. Wang, D. Gutfreund, J. Tenenbaum, and B. Katz, “ObjectNet: A Large-Scale Bias-Controlled Dataset for Pushing the Limits of Object Recognition Models,” NeurIPS, 2019. dataset page
- C. Wah, S. Branson, P. Welinder, P. Perona, and S. Belongie, “The Caltech-UCSD Birds-200-2011 Dataset,” Technical Report CNS-TR-2011-001, California Institute of Technology, 2011. dataset page
- J. Krause, M. Stark, J. Deng, and L. Fei-Fei, “3D Object Representations for Fine-Grained Categorization,” IEEE International Conference on Computer Vision Workshops (ICCVW), pp. 554–561, 2013 (introduces Stanford Cars). doi:10.1109/ICCVW.2013.77
- S. Maji, E. Rahtu, J. Kannala, M. Blaschko, and A. Vedaldi, “Fine-Grained Visual Classification of Aircraft,” arXiv:1306.5151, 2013. arXiv
- O. M. Parkhi, A. Vedaldi, A. Zisserman, and C. V. Jawahar, “Cats and Dogs,” CVPR, 2012 (introduces Oxford-IIIT Pets). dataset page
- M.-E. Nilsback and A. Zisserman, “Automated Flower Classification over a Large Number of Classes,” Indian Conference on Computer Vision, Graphics and Image Processing (ICVGIP), 2008 (introduces Oxford Flowers-102). dataset page
- L. Bossard, M. Guillaumin, and L. Van Gool, “Food-101 – Mining Discriminative Components with Random Forests,” ECCV, 2014. dataset page
- L. Fei-Fei, R. Fergus, and P. Perona, “One-Shot Learning of Object Categories,” IEEE Transactions on Pattern Analysis and Machine Intelligence, 2006 (the reference given for Caltech-101). dataset page
- X. Zhai, J. Puigcerver, A. Kolesnikov, et al., “A Large-scale Study of Representation Learning with the Visual Task Adaptation Benchmark,” arXiv:1910.04867, 2019. arXiv
- Z. Liu, Z. Miao, X. Zhan, J. Wang, B. Gong, and S. X. Yu, “Large-Scale Long-Tailed Recognition in an Open World,” CVPR, 2019 (introduces ImageNet-LT). arXiv
檢查理解
本篇有 7 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 02A・臉部辨識與度量學習 · 35 分鐘