DLCV 03・物件偵測:從 R-CNN 到 DETR
先備知識:DLCV 02・深度影像分類、IP 12・特徵擷取
導覽:本頁與本系列: 導覽:本頁與本系列
你將學到
- 定義偵測輸出,並區分方框與像素遮罩。
- 說明方框迴歸、IoU、指派、抑制與特徵金字塔。
- 比較候選區域、密集、無錨框與集合預測設計。
- 理解文字提示如何改變類別詞彙。
- 解讀 AP 協定,並量測完整部署流程。
先看全貌
分類器只回答一個關於整張影像的問題:這是什麼? 偵測器要回答更難的問題:什麼東西在哪裡? 它必須找出每一個感興趣的物件,在每個物件外面畫一個緊貼的矩形(邊界框,bounding box),寫上名稱,並說明自己有多確定。物件的數量事先不知道:可能是零個、一個,也可能是三百個。
偵測是多數「真實世界」視覺系統的入口。自駕車偵測行人與車輛;手機在對焦之前先偵測人臉;工廠偵測瑕疵;而追蹤器(見文末連結的追蹤章節)大多是在把偵測結果隨時間串起來。這個領域也產生了許多如今遍布深度學習的想法:多任務損失函數、特徵金字塔、焦點損失,以及以二元匹配做集合預測。
本篇假設你已經熟悉 CNN 與影像分類(DLCV 02),以及IP 12的傳統特徵概念。有兩篇綜述可以框住整個故事:Zou 等人的《Object Detection in 20 Years》[1],以及 Liu 等人發表於 IJCV 的深度通用物件偵測綜述 [2]。我們會在「現代觀點」回到這兩篇。
相關篇章。 DLCV 03A 深入介紹 YOLO 系列與即時 DETR;DLCV 04 則從方框走到像素遮罩(語意、實例與全景分割)。
偵測問題的定義
白話地說:輸入是一張影像,輸出是一小串(邊界框、類別、分數)三元組。訓練資料則是人工畫好、標上類別名稱的邊界框。
精確地說,給定影像 ,偵測器輸出一個集合
其中 是一個邊界框, 是 個類別之一, 是信心分數,而 隨影像不同而改變。真值(ground truth)是 個標註物件構成的集合 。常見的邊界框格式有兩種:角點 與中心–尺寸 。邊界框是與座標軸對齊的;旋轉框是另一種變體,用於空拍影像與文字偵測。
有三個性質讓偵測比分類困難:
- 輸出大小不固定。 網路必須決定要輸出幾個東西。本篇的每一種架構,本質上都是對這個問題的不同回答。
- 同時定位與辨識。 模型對物件外觀的變化要具有不變性,對物件的位置卻要很敏感;這股張力形塑了每一種偵測頭(head)的設計。
- 極度不平衡。 一張典型影像只有少數幾個物件,卻有上萬個候選位置與尺寸,幾乎全是背景。
偵測與相鄰任務的比較
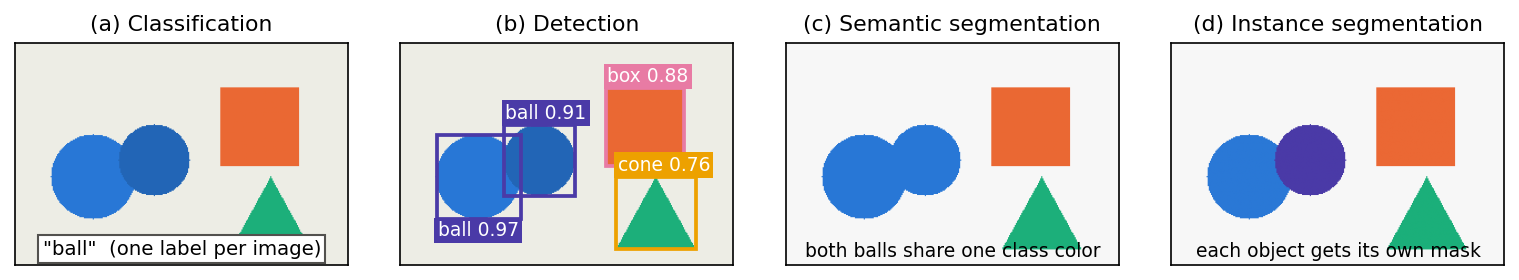
圖 1 在同一個合成場景上比較四種經典辨識任務。分類每張影像給一個標籤。偵測每個物件給一個邊界框與一個標籤。語意分割為每個像素標上類別,因此兩顆相碰的球會融成一團。實例分割為每個物件給出各自的像素遮罩,也就是「偵測+每個框一張遮罩」;稍後會看到,Mask R-CNN [16] 是取得它的標準方法。
傳統偵測:滑動視窗與手工特徵
白話地說:滑動視窗偵測在各位置與尺度套用分類器,再保留預測含有物件的視窗。
滑動視窗。 在縮放比例為 的影像金字塔上,以步幅 滑動固定大小 的視窗,視窗數量大約是
其中 是金字塔的層索引。對一張 的影像、 的視窗、、,單一長寬比就有約 個視窗,每一個都得分類。這就是IP 13的樣板比對(template matching)放大版,也有同樣的弱點:只有一種樣板形狀、要搜尋很多尺度,而且大量運算浪費在背景上。
三個傳統偵測器說明了手工特徵能走多遠。Viola–Jones(2001) [5] 讓人臉偵測達到即時:簡單的矩形特徵能在常數時間內算出,一連串越來越嚴格的分類器只用幾次便宜的測試,就丟掉大多數背景視窗。HOG+線性 SVM(2005) [6] 以梯度方向的直方圖描述每個視窗,讓行人偵測變得實用。可變形部件模型(deformable part models, DPM)[7] 在粗略的整體物件濾波器周圍加上幾個可移動的部件濾波器,一直稱霸 PASCAL VOC 基準 [3],直到 2012 年。
選讀:傳統偵測器細說:Viola–Jones、HOG 與 DPM(見「補充資料」頁)。積分影像、HOG 描述子與 DPM 的評分公式。
這個時代為何結束。 傳統偵測器慢(要在位置、尺度、長寬比上窮舉掃描,每個視窗都經過手工設計的流程評分),而且脆弱(只有一種手工特徵、少數幾個固定樣板,換到新類別、新視角或雜亂場景就表現不佳),也無法在類別之間共享特徵。深度偵測器保留了有用的想法,例如在特徵金字塔中掃描、串接、部件與困難負樣本挖掘(hard-negative mining),並把手工特徵換成學到的特徵。
核心基本元件
接下來的每一種偵測器都由同一組零件組成。我們仔細定義每一個,並附上可執行的程式碼。
邊界框參數化與迴歸目標
白話地說:以參考為基礎的方框迴歸,預測候選區域、錨框或參考點的修正量。
給定中心–尺寸形式的參考框 與其匹配的真值框 ,R-CNN [8] 提出的標準目標為
把位移除以參考框尺寸,讓目標具有尺度不變性(10 個像素的誤差,對 20 像素的框比對 400 像素的框嚴重得多)。寬高取對數,讓縮放變得對稱(放大兩倍與縮小一半分別是 與 ),並保證解碼後的尺寸為正:。實務上,目標常再除以固定的標準差,例如 ,讓四個量的大小相近。
程式碼 · Python · 33 行
import numpy as np

def to_cxcywh(b):
    return np.stack([(b[:, 0] + b[:, 2]) / 2, (b[:, 1] + b[:, 3]) / 2,
                     b[:, 2] - b[:, 0], b[:, 3] - b[:, 1]], axis=1)

def to_xyxy(c):
    return np.stack([c[:, 0] - c[:, 2] / 2, c[:, 1] - c[:, 3] / 2,
                     c[:, 0] + c[:, 2] / 2, c[:, 1] + c[:, 3] / 2], axis=1)

def encode(anchors, gt, std=(0.1, 0.1, 0.2, 0.2)):
    """Regression targets (tx, ty, tw, th) of gt relative to anchors (both xyxy)."""
    P, G = to_cxcywh(anchors), to_cxcywh(gt)
    t = np.stack([(G[:, 0] - P[:, 0]) / P[:, 2],
                  (G[:, 1] - P[:, 1]) / P[:, 3],
                  np.log(G[:, 2] / P[:, 2]),
                  np.log(G[:, 3] / P[:, 3])], axis=1)
    return t / np.array(std)          # normalize so all four have similar scale

def decode(anchors, t, std=(0.1, 0.1, 0.2, 0.2)):
    P = to_cxcywh(anchors)
    t = t * np.array(std)
    c = np.stack([P[:, 0] + t[:, 0] * P[:, 2],
                  P[:, 1] + t[:, 1] * P[:, 3],
                  P[:, 2] * np.exp(t[:, 2]),
                  P[:, 3] * np.exp(t[:, 3])], axis=1)
    return to_xyxy(c)

anchors = np.array([[0, 0, 32, 32], [100, 100, 228, 164]], float)
gt      = np.array([[4, 2, 40, 30], [90, 110, 250, 170]], float)
t = encode(anchors, gt)
print(np.round(t, 3))
print(np.allclose(decode(anchors, t), gt))   # round trip
輸出
[[ 1.875  0.     0.589 -0.668]
 [ 0.469  1.25   1.116 -0.323]]
True
這些目標通常以 Fast R-CNN [9] 的 smooth L1(Huber)損失函數訓練:
逐一套用在每個座標差 上。誤差小時它像 L2(梯度平滑),誤差大時像 L1(在訓練初期對離群值穩健)。它的弱點是把四個座標當成彼此獨立的數字,而評估指標 IoU 卻把邊界框視為一個整體。這個落差催生了以 IoU 為基礎的損失函數。
IoU 及其變體
白話地說:IoU 問的是,在兩個框各自覆蓋的總面積中,有多少比例是兩者都覆蓋到的?完全吻合時為 1,兩框不相碰時為 0。
對兩個框 與 ,
其中 代表面積。IoU(交並比,intersection over union)具有尺度不變性,是評估的標尺(若一個偵測結果與某個尚未被匹配的真值框的 IoU 超過門檻,就算正確),也用於標籤指派與 NMS。圖 2 顯示這些門檻有多嚴格:把正方形沿兩軸各平移邊長的約 18%,IoU 就掉到 0.5。
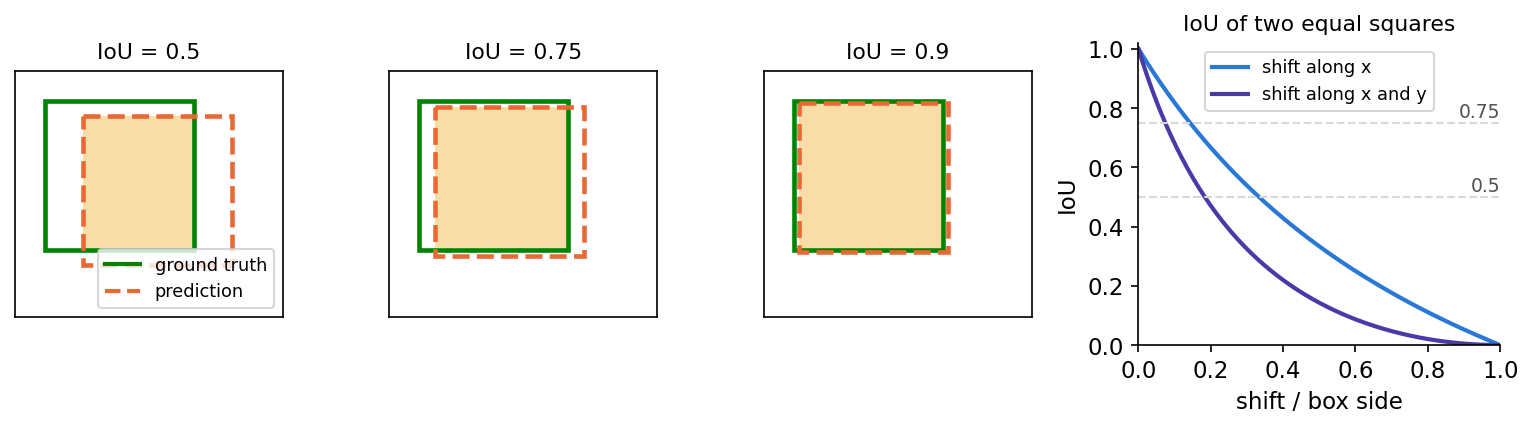
拿 當損失函數有個缺陷:兩框不重疊時,不論相距多遠 IoU 都是 0,梯度也就是 0。常用的修正有三種:
- GIoU [11] 加入一個以同時包住兩框的最小框 為基礎的懲罰項: ,值域為 ,兩個不重疊的框離得越遠,它就繼續下降。
- DIoU [12] 直接懲罰中心點距離: ,其中 是兩框中心 與 的歐氏距離, 是 的對角線長度。它比 GIoU 收斂得更快,因為即使一個框包住另一個框(此時 GIoU 的懲罰項消失),它仍會把中心點拉近。
- CIoU [12] 再加入長寬比項:,其中 衡量長寬比的差異, 是權衡權重。
對應的損失函數分別是 、 與 。
程式碼 · Python · 32 行
import numpy as np

def iou_family(a, b, eps=1e-9):
    """a, b: (N, 4) boxes as (x1, y1, x2, y2). Returns IoU, GIoU, DIoU, CIoU."""
    ix1, iy1 = np.maximum(a[:, 0], b[:, 0]), np.maximum(a[:, 1], b[:, 1])
    ix2, iy2 = np.minimum(a[:, 2], b[:, 2]), np.minimum(a[:, 3], b[:, 3])
    inter = np.clip(ix2 - ix1, 0, None) * np.clip(iy2 - iy1, 0, None)
    wa, ha = a[:, 2] - a[:, 0], a[:, 3] - a[:, 1]
    wb, hb = b[:, 2] - b[:, 0], b[:, 3] - b[:, 1]
    union = wa * ha + wb * hb - inter
    iou = inter / (union + eps)
    # smallest enclosing box C
    cx1, cy1 = np.minimum(a[:, 0], b[:, 0]), np.minimum(a[:, 1], b[:, 1])
    cx2, cy2 = np.maximum(a[:, 2], b[:, 2]), np.maximum(a[:, 3], b[:, 3])
    area_c = (cx2 - cx1) * (cy2 - cy1)
    giou = iou - (area_c - union) / (area_c + eps)
    # center distance over enclosing-box diagonal
    rho2 = ((a[:, 0] + a[:, 2]) - (b[:, 0] + b[:, 2])) ** 2 / 4 \
         + ((a[:, 1] + a[:, 3]) - (b[:, 1] + b[:, 3])) ** 2 / 4
    c2 = (cx2 - cx1) ** 2 + (cy2 - cy1) ** 2
    diou = iou - rho2 / (c2 + eps)
    v = 4 / np.pi**2 * (np.arctan(wb / hb) - np.arctan(wa / ha)) ** 2
    alpha = v / (1 - iou + v + eps)
    ciou = diou - alpha * v
    return iou, giou, diou, ciou

gt = np.array([[10, 10, 50, 50]] * 3, float)
pred = np.array([[20, 20, 60, 60],    # overlapping, shifted
                 [60, 10, 100, 50],   # disjoint, nearby
                 [200, 10, 240, 50]], float)  # disjoint, far away
for name, v in zip(["IoU", "GIoU", "DIoU", "CIoU"], iou_family(pred, gt)):
    print(f"{name:5s}", np.round(v, 3))
輸出
IoU   [0.391 0.    0.   ]
GIoU  [ 0.311 -0.111 -0.652]
DIoU  [ 0.351 -0.258 -0.662]
CIoU  [ 0.351 -0.258 -0.662]
兩個不重疊的預測框 IoU 都是 0,但 GIoU 與 DIoU 正確地指出比較遠的那個比較差。這裡 CIoU 等於 DIoU,因為所有框都是正方形,沒有長寬比差異。
錨框與標籤指派
白話地說:錨框式密集偵測器在特徵格點放置參考框,再於各位置預測物件分數與方框修正量。
在步幅為 的特徵圖上(每個格子涵蓋輸入影像的 像素),錨框的中心位於 ,並有幾種尺度 與長寬比 ,寬為 、高為 ,因此面積維持 。Faster R-CNN 在每個位置使用 3 種尺度 3 種長寬比 個錨框 [10](圖 3 左)。
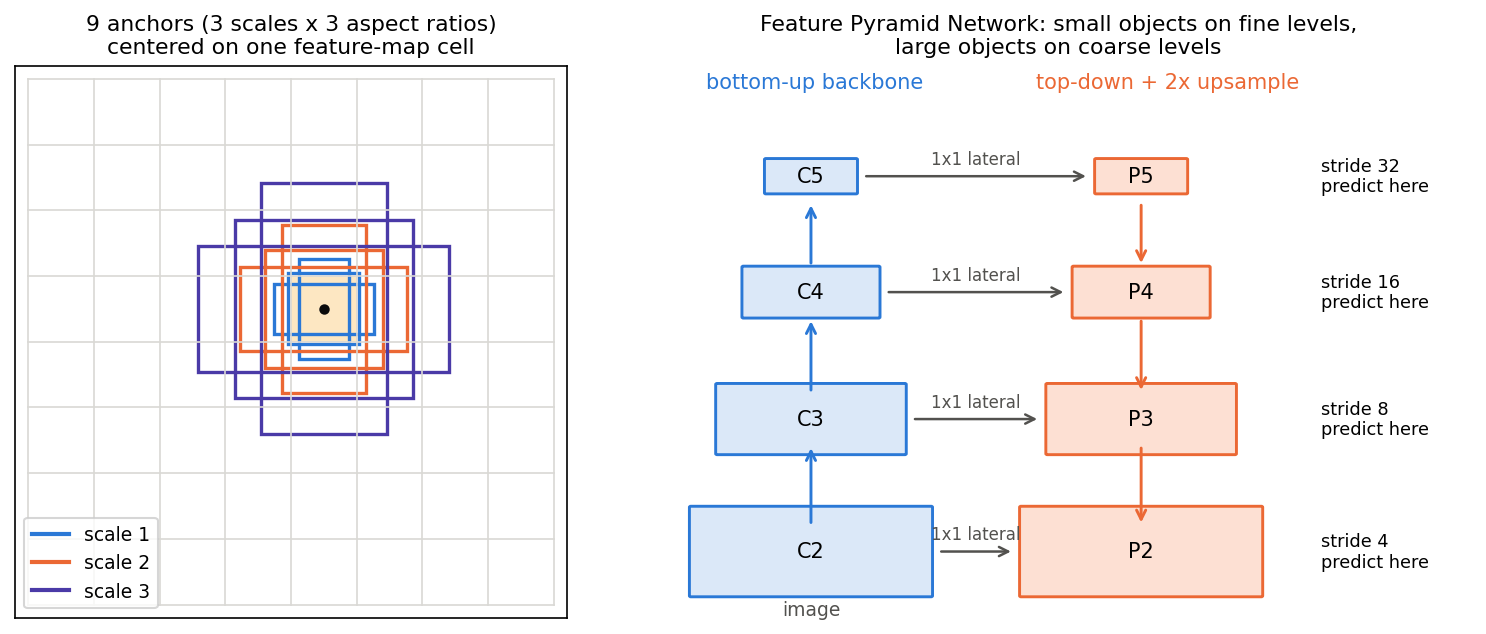
標籤指派(label assignment)決定哪個錨框要學習哪個物件。經典規則以 IoU 為準:在 Faster R-CNN 的區域提議網路中,若某錨框與某真值框的 IoU 至少 0.7(或它是該真值框最匹配的錨框),就是正樣本;若它與所有真值框的 IoU 都低於 0.3,就是負樣本;其餘忽略 [10]。RetinaNet 則使用 0.5 與 0.4 [15]。每個正樣本錨框以上述目標朝其匹配的框迴歸。後來發現,指派方式和架構一樣重要:無錨框偵測器(FCOS [29])改用位置與物件尺寸來指派,而 DETR [30] 則以學習出的一對一匹配取代所有固定規則。
錨框也有實際成本:它帶來必須針對每個資料集調整的超參數(尺度、長寬比、門檻),也讓預測數量倍增。YOLO9000 [19] 用 當距離,對訓練框做 k-means 分群來決定錨框形狀。
選讀:以 k-means 決定錨框形狀(見「補充資料」頁)。分群迴圈、為何用 取代歐氏距離,以及一個小型實驗。
非極大值抑制(NMS)與 Soft-NMS
白話地說:密集偵測器會在同一個物件上反應很多次(相鄰的錨框都看得到它)。非極大值抑制(non-maximum suppression, NMS)留下最有信心的框,刪掉與它重疊太多的其他框。
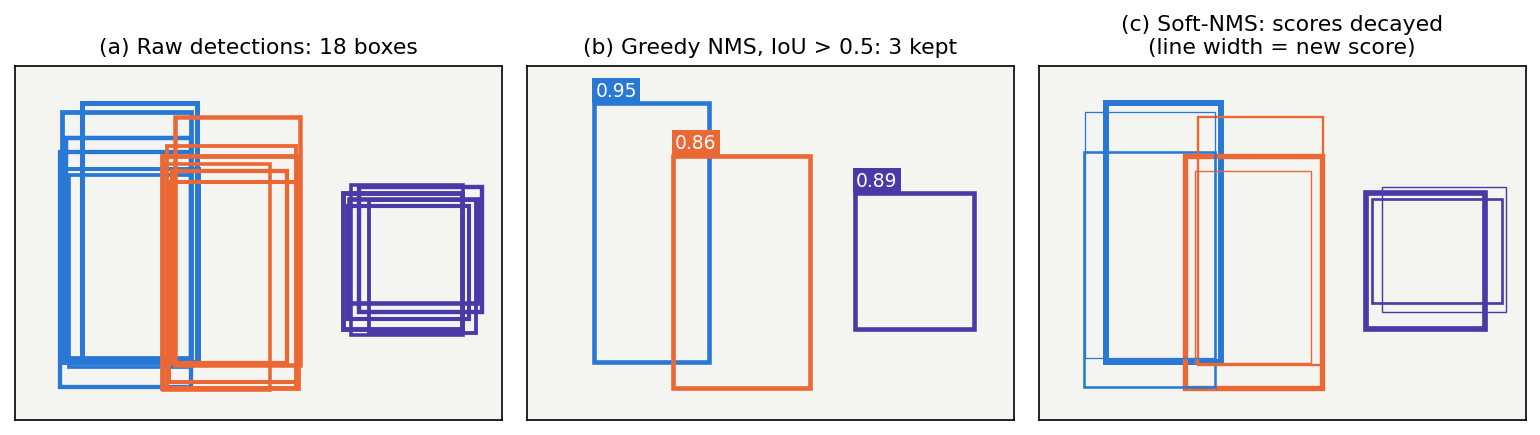
貪婪 NMS(逐類別進行):依分數排序;反覆取出剩下分數最高的框 ,保留它,並移除所有 的框 ( 通常為 0.5 到 0.7)。它的弱點在擁擠場景:兩個站得很近的真人可能重疊超過 ,分數較低的那個就被刪掉,召回率因而下降。
Soft-NMS [13] 把「刪除」改成「降低分數」。以高斯版本為例,
其中 是框 的分數, 控制重疊框被懲罰的速度。重疊很多時分數仍會大幅下降,但真正相鄰的物件會以較低的分數留下來,而不是直接消失。
程式碼 · Python · 39 行
import numpy as np

def iou_one_to_many(box, boxes):
    x1 = np.maximum(box[0], boxes[:, 0]); y1 = np.maximum(box[1], boxes[:, 1])
    x2 = np.minimum(box[2], boxes[:, 2]); y2 = np.minimum(box[3], boxes[:, 3])
    inter = np.clip(x2 - x1, 0, None) * np.clip(y2 - y1, 0, None)
    area = lambda b: (b[..., 2] - b[..., 0]) * (b[..., 3] - b[..., 1])
    return inter / (area(box) + area(boxes) - inter)

def nms(boxes, scores, thr=0.5):
    order = np.argsort(-scores)
    keep = []
    while order.size:
        i = order[0]
        keep.append(i)
        ious = iou_one_to_many(boxes[i], boxes[order[1:]])
        order = order[1:][ious <= thr]          # drop everything that overlaps too much
    return np.array(keep)

def soft_nms(boxes, scores, sigma=0.5, score_thr=0.001):
    scores = scores.copy()
    idx = np.arange(len(scores))
    keep = []
    while idx.size:
        j = np.argmax(scores[idx]); i = idx[j]
        keep.append(i)
        idx = np.delete(idx, j)
        ious = iou_one_to_many(boxes[i], boxes[idx])
        scores[idx] *= np.exp(-ious**2 / sigma)  # decay instead of delete
        idx = idx[scores[idx] > score_thr]
    return np.array(keep), scores

# two people standing close together + duplicates
boxes = np.array([[10, 10, 60, 110], [14, 12, 62, 112], [8, 6, 58, 104],
                  [40, 15, 90, 115], [43, 18, 92, 118]], float)
scores = np.array([0.95, 0.90, 0.80, 0.85, 0.70])
print("greedy NMS keeps:", nms(boxes, scores, 0.5))
keep, s = soft_nms(boxes, scores)
print("Soft-NMS order:", keep, "rescored:", np.round(s[keep], 3))
輸出
greedy NMS keeps: [0 3]
Soft-NMS order: [0 3 2 4 1] rescored: [0.95  0.761 0.183 0.145 0.058]
貪婪 NMS 為每個人留下一個框。Soft-NMS 保留所有框,但把重複的框排在兩個真實偵測結果之後很遠的位置;之後的分數門檻或 AP 計算會把它們當成低信心的猜測。圖 4 在合成場景上呈現同樣的效果。
NMS 還有三個問題:它有一個要手動調整的門檻;它是循序、依資料而定的步驟,不容易在加速器上執行;而且它不屬於訓練的一部分,所以網路從來沒被教過要避免重複。去掉 NMS 是 DETR 與 YOLOv10 [24] 的主要動機之一。
特徵金字塔(FPN)
白話地說:小物件需要高解析度的特徵圖;大物件需要看過大量上下文的特徵。特徵金字塔讓每個尺度都同時擁有兩者。
CNN 骨幹網路本來就會產生步幅為 的金字塔 ,但淺層的語意較弱。特徵金字塔網路(Feature Pyramid Network, FPN)[14] 加上一條由上而下的路徑:從最粗的一層開始,上採樣 2 倍,再加上經 投影的骨幹橫向連接,
因此每個輸出層 的通道數相同,語意也都很強。在搭配 FPN 的二階段偵測器中,大小為 的感興趣區域從第 層擷取特徵([14] 中 ),所以區域大一倍就往上移一層;密集偵測器也使用類似的「尺寸對應層級」規則。後來的頸部(neck)設計(額外的由下而上路徑、加權融合)都在精煉同一個想法;2017 年後幾乎每個偵測器都用上了它(圖 3 右)。
焦點損失與類別不平衡
白話地說:如果 99.9% 的候選都是背景,一般的損失函數會被數百萬個簡單的「這裡沒東西」樣本主導。焦點損失把模型已經答對的樣本「調小音量」。
令 為前景類別的預測機率, 為標籤。若 ,定義 ,否則 。焦點損失(focal loss)[15] 為
其中 是聚焦參數, 是類別平衡權重(前景為 ,背景為 )。 時它就是加權交叉熵。以論文預設的 、,一個 的簡單負樣本相對於交叉熵被降權 倍,而困難樣本幾乎保留全部權重。損失會再除以正樣本錨框的數量。二階段偵測器用別的方法避開這個問題(提議階段先移除大部分背景,再以固定的前景:背景比例取樣),而 SSD [26] 使用困難負樣本挖掘(只保留損失最高的負樣本,比例約 3:1)。焦點損失第一次讓密集的一階段偵測器和二階段偵測器一樣準確。
二階段偵測器:R-CNN 家族
白話地說:先提出幾千個「可能有東西」的地方,再仔細看每一個,決定它是什麼以及邊緣確切在哪裡。
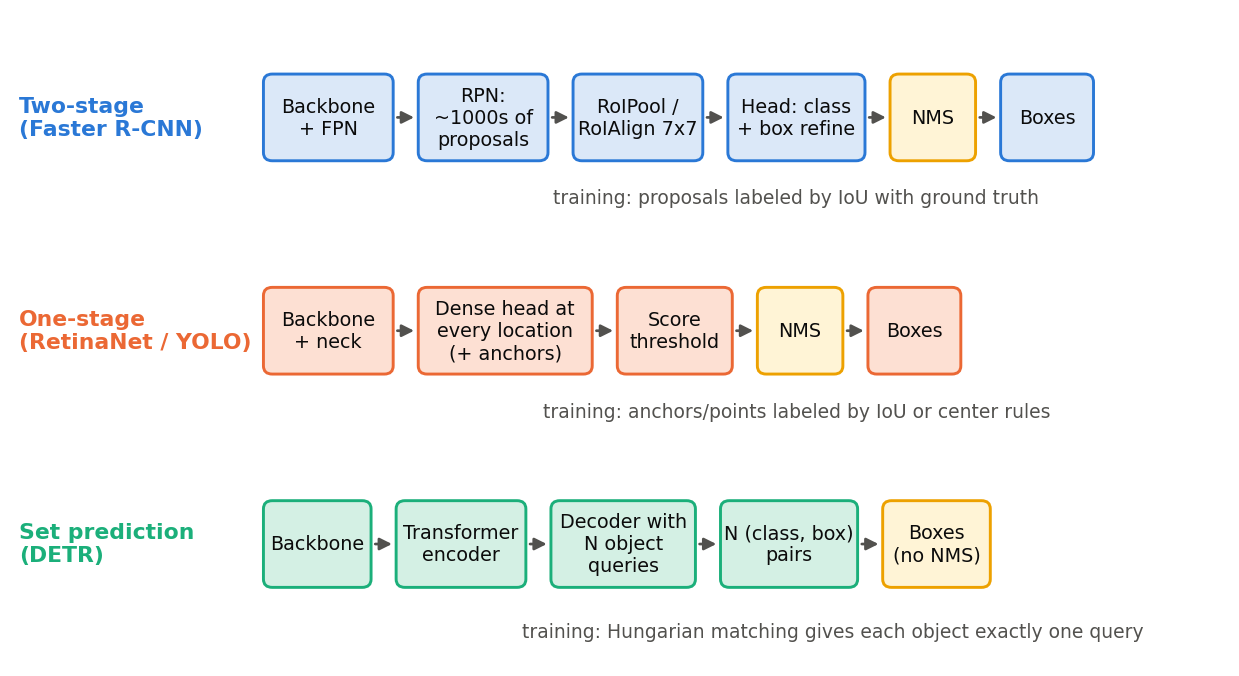
R-CNN(2014) [8] 先用一個由下而上的分組演算法,為每張影像產生約 2,000 個與類別無關的候選區域(region proposal),把每個區域變形成固定大小,送進以分類預訓練的 CNN,以每類別一個的線性 SVM 為特徵評分,再用上述目標微調邊界框。它把 PASCAL VOC 2012 的 mean AP 相對於先前最佳結果提升了 30% 以上,並確立了「先在分類上預訓練,再在偵測上微調」這個至今仍是標準的做法。它非常慢,因為 CNN 要對每個候選區域各跑一次。
Fast R-CNN(2015) [9] 對整張影像只跑一次 CNN,再用 RoI pooling 從共享的特徵圖上切出每個候選區域:把區域投影到特徵圖上,分成固定的 網格(例如 ),每格做最大池化,所以不論形狀為何,每個候選區域都得到相同大小的特徵。整個網路以多任務損失訓練:
其中 是 類的 softmax, 是真實類別(背景為 0), 只在前景候選區域為 1, 是針對類別 預測的框偏移量, 是目標偏移量, 是 smooth L1 損失。
Faster R-CNN(2015) [10] 讓候選區域本身也由學習產生。一個小型的區域提議網路(Region Proposal Network, RPN)在共享特徵圖上滑動,為每個位置的 9 個錨框預測「是否為物件」的分數與框偏移量。最好的候選區域(經 NMS 後)再送進 Fast R-CNN 的偵測頭。由於兩個階段共用骨幹,候選區域幾乎不花成本,整個偵測器也成為一個端到端訓練的網路。
Mask R-CNN(2017) [16] 加上一個小型全卷積分支,在每個 RoI 內為每個類別預測一張二值遮罩,因而得到實例分割。它的關鍵細節是 RoIAlign:RoI pooling 會把區域邊界和格子邊緣捨入到特徵網格上,使特徵最多偏移半個步幅。RoIAlign 保留實數座標,並以雙線性內插取樣每一格。這聽起來是小事,但像素級精確的遮罩需要它,高 IoU 下的框準確度也會提升。
選讀:RoI pooling 與 RoIAlign(見「補充資料」頁)。雙線性取樣公式,以及一個說明捨入誤差的手算範例。
Cascade R-CNN(2018) [17] 處理一個微妙的問題。以 IoU ≥ 0.5 為正樣本訓練的偵測頭,學到的是「在 0.5 夠好」的框,在 0.75 卻不夠好。單純提高門檻會讓正樣本太少而過擬合(overfitting)。Cascade R-CNN 串接數個以遞增 IoU 門檻(0.5、0.6、0.7)訓練的偵測頭,每一級都精煉前一級的框,所以每一級拿到的訓練分布品質都更高。它在嚴格的 COCO 指標上帶來大幅提升。
二階段偵測器準確、有彈性(RoI 偵測頭可以預測遮罩、關鍵點或屬性),至今仍是許多實例分割任務的預設選擇,但每個 RoI 一次的偵測頭與 NMS 都要花時間。
一階段偵測器:YOLO、SSD 與 RetinaNet
白話地說:跳過提議步驟。在一次前向傳遞中,對特徵圖的每個位置做一次密集預測,再用 NMS 清理。
YOLO v1(2016) [18] 把影像切成 網格()。每格預測 個框(各帶一個信心值)以及一組 個類別機率,因此輸出是單一個 張量(PASCAL VOC 的 20 類對應 )。物件中心所在的格子負責該物件。它能即時執行,而且因為看得到整張影像,背景誤判比 Fast R-CNN 少;但它定位較不精確,也難以處理小物件與成群的物件,因為每格只能預測固定數量的框與一個類別。
YOLO 家族之後演進出許多版本 [19]–[25]。核心想法始終不變——在網格上做一次密集預測,再用 NMS 清理——每一版則改進其中一個部分:錨框與多尺度預測、更強的骨幹與訓練技巧、更好的標籤指派、注意力機制,最後是不再需要 NMS 的訓練方式(YOLOv10 [24])。
選讀:YOLO 家族逐版介紹(見「補充資料」頁)。以表格列出有可查證論文的各版本及其主要想法。
SSD(2016) [26] 在多個不同解析度的特徵圖上接上小型卷積預測器,每層都有自己一組多種長寬比的預設框(default box,即錨框),處理尺度的能力遠勝 YOLO v1。它以困難負樣本挖掘與大量資料擴增訓練。
RetinaNet(2017) [15] 結合 FPN 骨幹、密集錨框(每個位置 9 個),以及分類與框迴歸兩個小型子網路,並以焦點損失訓練。論文的分析顯示,一階段偵測器先前落後二階段偵測器的主因是類別不平衡,而不是架構。
無錨框偵測器:用點取代框
白話地說:錨框是對物件長相的猜測。無錨框偵測器拿掉它們,改從點預測邊界框:角點、中心點,或物件內部的每一個像素。
CornerNet(2018) [27] 把物件偵測成一對關鍵點:一張左上角熱圖、一張右下角熱圖,以及每個角點的嵌入向量(embedding)。同一物件的兩個角點被訓練成嵌入相近,因此以嵌入距離來配對。由於角點常落在物件外面,論文提出角點池化(corner pooling),沿著列與行收集角點的證據。
CenterNet,〈Objects as Points〉(2019) [28] 以中心點代表每個物件。網路輸出一張熱圖 (輸出步幅 ,每類一個通道),以及每個位置的尺寸 與次像素偏移。真值中心以高斯函數散佈在熱圖上,熱圖以逐像素的焦點損失訓練。推論時,峰值就是局部最大值,用 最大池化比較即可找到,因此不需要以 IoU 為基礎的 NMS。同樣的設計只要在中心點迴歸更多量,就能延伸到 3D 框與人體姿態。
FCOS(2019) [29] 把偵測當成分割來做。特徵圖上每個落在真值框內的位置都是正樣本,並迴歸到框四邊的距離:
其中 是該位置的影像座標, 是框。每一層 FPN 只處理最大迴歸距離落在自己範圍內的物件,這解決了框重疊時大部分的歧義。離物件中心遠的位置預測出的框品質差,因此 FCOS 加入中心度(centerness)分支:
它在中心為 1,往邊緣遞減;測試時乘上類別分數,讓偏離中心的框在 NMS 前排得較後面。FCOS 去掉了所有錨框超參數,表現追平甚至超越以錨框為基礎的 RetinaNet。
以 Transformer 做集合預測:DETR 及其後繼者
白話地說:與其預測上千個候選再刪掉重複的,不如直接預測一小組答案,並在訓練時讓每個真實物件剛好被一個預測認領。
DETR(2020) [30] 使用 CNN 骨幹、作用在特徵圖上的 Transformer 編碼器,以及一個 Transformer 解碼器;解碼器接收 個學習得到的物件查詢(object query,論文中為 100 個),平行輸出 組(類別、框)預測。沒有錨框、沒有候選區域,也沒有 NMS。由於 大於物件數,真值會用特殊的「無物件」類別 補齊到 個。
關鍵在於以二元匹配(bipartite matching)訓練。令 為補齊後的真值, 為預測。找出使總匹配成本最低的 元素排列 :
其中 是所有排列的集合, 與 是目標 的類別與框, 是被匹配的查詢對類別 的預測機率,而 。這個指派問題可以用匈牙利演算法(Hungarian algorithm)[31] 在多項式時間內精確求解。接著,訓練損失(集合損失,set loss)使用匹配好的配對:
當 時,對數機率項的權重降為十分之一,以平衡大量的「無物件」名額。因為每個物件只會匹配到一個查詢,重複的預測會被當成錯誤的「無物件」而受到懲罰,解碼器的自注意力因此學會抑制重複,這就是不需要 NMS 的原因。
用 SciPy 寫匹配步驟只需幾行。下面的成本以 DETR 的權重結合三項;linear_sum_assignment 可直接處理 的長方形矩陣(DETR 的 L1 項是在正規化的 上計算,這裡為了簡潔使用角點格式)。
程式碼 · Python · 30 行
import numpy as np
from scipy.optimize import linear_sum_assignment

def giou_matrix(a, b):
    x1 = np.maximum(a[:, None, 0], b[None, :, 0]); y1 = np.maximum(a[:, None, 1], b[None, :, 1])
    x2 = np.minimum(a[:, None, 2], b[None, :, 2]); y2 = np.minimum(a[:, None, 3], b[None, :, 3])
    inter = np.clip(x2 - x1, 0, None) * np.clip(y2 - y1, 0, None)
    area = lambda b: (b[:, 2] - b[:, 0]) * (b[:, 3] - b[:, 1])
    union = area(a)[:, None] + area(b)[None, :] - inter
    cx1 = np.minimum(a[:, None, 0], b[None, :, 0]); cy1 = np.minimum(a[:, None, 1], b[None, :, 1])
    cx2 = np.maximum(a[:, None, 2], b[None, :, 2]); cy2 = np.maximum(a[:, None, 3], b[None, :, 3])
    c = (cx2 - cx1) * (cy2 - cy1)
    return inter / union - (c - union) / c

rng = np.random.default_rng(1)
N, C = 6, 3                                     # 6 queries, 3 real classes (+ "no object")
logits = rng.normal(size=(N, C + 1))
prob = np.exp(logits) / np.exp(logits).sum(1, keepdims=True)
pred_boxes = np.array([[.10, .10, .40, .50], [.55, .20, .90, .60], [.12, .08, .42, .48],
                       [.30, .60, .60, .95], [.00, .00, .20, .20], [.50, .50, .70, .70]])
gt_boxes  = np.array([[.10, .10, .40, .50], [.32, .62, .62, .93], [.56, .22, .88, .62]])
gt_labels = np.array([0, 2, 1])

w_cls, w_l1, w_giou = 1.0, 5.0, 2.0             # weights used by DETR
cost = (-w_cls * prob[:, gt_labels]                          # (N, M) class term
        + w_l1 * np.abs(pred_boxes[:, None] - gt_boxes[None]).sum(-1)
        - w_giou * giou_matrix(pred_boxes, gt_boxes))
rows, cols = linear_sum_assignment(cost)        # works on rectangular N x M matrices
print("query -> gt:", dict(zip(rows.tolist(), cols.tolist())))
print("unmatched queries (trained as 'no object'):", sorted(set(range(N)) - set(rows.tolist())))
輸出
query -> gt: {0: 0, 1: 2, 3: 1}
unmatched queries (trained as 'no object'): [2, 4, 5]
查詢 2 幾乎是查詢 0 的複本,卻沒有被匹配,之後會被訓練成「無物件」。這正是取代 NMS 的機制。
代價。 DETR 需要非常長的訓練(數百個 epoch,Faster R-CNN 大約只要十幾個),小物件表現也差,因為在高解析度特徵圖上做全域注意力太昂貴,只能用單一一層粗特徵。後繼者逐一解決了這些問題。
三個後繼者指出了方向。Deformable DETR [32] 讓每個查詢只看橫跨多個特徵層級的少數取樣點,讓多尺度特徵負擔得起,也大幅縮短訓練。DINO [33](不要和同名的自監督方法混淆)以去雜訊訓練與更好的查詢初始化進一步加快收斂。RT-DETR [34] 讓這個設計快到足以即時使用,而且仍不需 NMS。
選讀:DETR 後繼者細說(見「補充資料」頁)。各自如何運作,以及論文報告的結果。
如今 DETR 路線與 YOLO 路線正在匯流:YOLOv10 借用一對一指派來去掉 NMS,即時 DETR 則借用高效的卷積頸部。
開放詞彙與定位偵測器
白話地說:封閉集合的偵測器只能找出它訓練過的 80 或 365 個類別。開放詞彙偵測器在測試時以文字接收類別清單,所以你可以直接要它找「紅色消防栓」或「堆高機」,不必重新訓練。
技巧在於把最後的分類層(一個由 個類別權重向量組成的固定矩陣)換成文字嵌入。對區域特徵 與提示詞(例如 “a photo of a forklift”)的文字嵌入 ,類別分數是縮放後的餘弦相似度:
其中 是學習得到的溫度參數。任何能嵌入的片語都能變成一個類別。視覺端必須學會把區域與語言對齊,這需要遠比任何框標註資料集更大量的影像–文字資料。
- OWL-ViT(2022) [35] 從以影像–文字對比預訓練的 Transformer 影像編碼器與文字編碼器出發,移除最後的池化,在每個輸出 token 上接上輕量的框與類別偵測頭;類別偵測頭就是上面的文字嵌入。它支援零樣本(文字查詢)與單樣本(影像範例查詢)偵測,論文也顯示模型越大效果越穩定提升。
- Grounding DINO(2024) [36] 把語言深度融入 DINO 偵測器:影像與文字互相做交叉注意力的特徵增強器、語言引導的查詢選擇,以及跨模態解碼器。它在偵測、定位(片語對應區域)與圖說資料上預訓練,報告在 COCO 零樣本遷移(完全不用 COCO 訓練資料)上達 52.5 AP,在一組多樣化真實世界偵測資料集組成的基準上平均 AP 為 26.1。
- YOLO-World(2024) [37] 以視覺–語言路徑聚合網路(RepVL-PAN)與區域–文字對比預訓練,把開放詞彙帶進即時偵測器。它的先提示、後偵測(prompt-then-detect)模式會事先離線編碼使用者的詞彙,因此推論成本與封閉集合的 YOLO 相當。論文報告在 LVIS 上達 35.4 AP,在 V100 GPU 上 52.0 FPS。
可提示的基礎模型更進一步。SAM 3 [38](2025)接受一個簡短名詞片語或影像範例作為概念提示(concept prompt),為影像與影片中所有符合的實例輸出遮罩與身分;作者建立了一個資料引擎,產生含有 400 萬個不重複概念標籤的資料集,並報告在其可提示概念分割基準上的準確度是既有系統的兩倍。在這類系統中,偵測成為一個通用「找出這個概念」模型的其中一種輸出,而不是單獨訓練的網路。
小物件與密集場景
白話地說:極小的物件只有很少的像素,步幅 32 的特徵可能把它壓縮到不到一個格子。人群之所以困難,是因為物件互相遮擋,而 NMS 會把相鄰的物件誤認為重複。
小物件。 COCO 把面積小於 像素的物件定義為「小」[40]。接近該面積上限且大致呈正方形的物件,在步幅 16 的特徵圖上約橫跨 個格寬;面積小並不能同時限制細長物件的兩條邊長。降取樣可能移除定位所需的細節。IoU 也變得嚴苛:在 的框上偏差 2 個像素,IoU 就可能跌破 0.7。常見的對策有高解析度特徵層(步幅 4 的 )、特徵金字塔、推論時把影像切塊、提高輸入解析度、複製貼上與尺度擴增,以及不會讓小框缺少正樣本的指派規則。Cheng 等人的綜述與基準 [39] 整理了這些策略,並提出兩個大型小物件基準:SODA-D(24,828 張交通影像、278,433 個實例、9 個類別)與 SODA-A(2,513 張高解析度空拍影像、872,069 個實例、9 個類別)。
密集與遮擋場景。 在人群中,真實物件彼此大量重疊,固定的 NMS 門檻只能在召回率與重複之間取捨。Soft-NMS [13] 有幫助;集合預測偵測器則透過學習哪些預測是重複的,完全避開門檻。遮擋也讓框的標註變得模糊(要標完整範圍,還是只標看得見的部分?),評估結果因此取決於協定。這些問題在追蹤中會再次出現,因為物件會消失又重新出現。
偵測器的評估
白話地說:把所有偵測結果依信心排序,由上往下走:每個偵測結果要不是命中(它和一個尚未被認領的真實物件夠吻合),就是誤報。記錄精確率與召回率如何變化;這條曲線下的面積就是平均精確率(Average Precision, AP)。
精確率、召回率與 AP
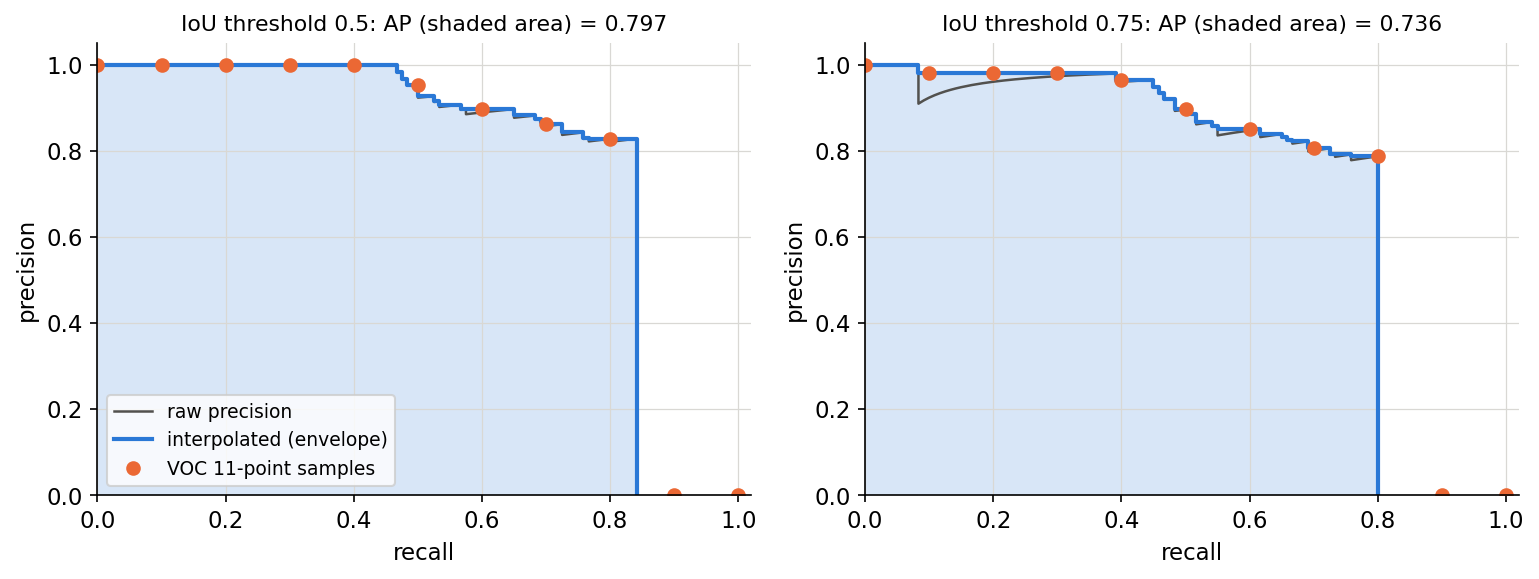
對單一類別與單一 IoU 門檻 ,把測試集中所有偵測結果依分數由高到低排序。若某偵測結果與同類別、尚未被匹配的真值框 IoU 至少為 ,就是真陽性(TP);否則是偽陽性(FP)。每個真值框只能被匹配一次,重複的偵測就是這樣被懲罰的。取前 個偵測結果時,
其中 是該類別真值物件的數量。為了讓曲線單調,精確率以其上包絡線內插:。接著:
- VOC 11 點 AP(PASCAL VOC 到 2009 年為止 [3]):。
- VOC 全點 AP(VOC 2010 起 [41]):內插曲線下的精確面積,,對所有不同的召回值加總。
- COCO AP [40]:在 共 101 個召回點上取 的平均。
圖 6 顯示一條 PR 曲線、它的包絡線,以及 AP 面積。
COCO 協定
COCO 的主要指標寫作 AP 或 mAP@[.5:.95],對 10 個 IoU 門檻 及全部 80 個類別取平均 [40]:
它獎勵的是精確定位,而不只是找到物件。配套指標有 (VOC 式指標)、(嚴格),以及針對小(面積 )、中( 到 )、大()物件的 、、。在預設依類別評估的 COCO 程式中,100 個偵測結果的上限套用於每張影像的每個類別;偵測器本身可能另設更嚴格的總輸出數上限。平均召回率(AR)也在相同的逐類別評估下,使用最大偵測數 1、10、100 的設定 [40]。注意 COCO 把類別平均後的指標稱為「AP」;論文中的「mAP」通常指同一件事。
下面的程式碼在合成預測上從頭計算所有指標(真值加上抖動、約 15% 漏偵測,再加上一些隨機的誤報)。
程式碼 · Python · 66 行
import numpy as np

def box_iou(a, b):
    """Pairwise IoU between (N,4) and (M,4) xyxy boxes -> (N, M)."""
    x1 = np.maximum(a[:, None, 0], b[None, :, 0]); y1 = np.maximum(a[:, None, 1], b[None, :, 1])
    x2 = np.minimum(a[:, None, 2], b[None, :, 2]); y2 = np.minimum(a[:, None, 3], b[None, :, 3])
    inter = np.clip(x2 - x1, 0, None) * np.clip(y2 - y1, 0, None)
    area = lambda b: (b[:, 2] - b[:, 0]) * (b[:, 3] - b[:, 1])
    return inter / (area(a)[:, None] + area(b)[None, :] - inter)

def match(dets, gts, thr):
    """dets: list over images of (boxes, scores); gts: list of gt boxes.
    Returns scores, TP flags (sorted by score), and number of GT."""
    recs = []
    for img, ((db, ds), gb) in enumerate(zip(dets, gts)):
        for k in range(len(ds)):
            recs.append((ds[k], img, k))
    recs.sort(key=lambda r: -r[0])                       # global ranking by confidence
    used = [np.zeros(len(g), bool) for g in gts]
    tp = np.zeros(len(recs))
    for n, (s, img, k) in enumerate(recs):
        gb = gts[img]
        if len(gb) == 0:
            continue
        ious = box_iou(dets[img][0][k:k + 1], gb)[0]
        ious[used[img]] = -1                             # each GT can be matched once
        j = ious.argmax()
        if ious[j] >= thr:
            tp[n] = 1; used[img][j] = True
    return tp, sum(len(g) for g in gts)

def pr_curve(tp, n_gt):
    ctp, cfp = np.cumsum(tp), np.cumsum(1 - tp)
    return ctp / n_gt, ctp / (ctp + cfp)                 # recall, precision

def ap(rec, prec, mode="all"):
    r = np.concatenate([[0], rec, [1]]); p = np.concatenate([[0], prec, [0]])
    p = np.maximum.accumulate(p[::-1])[::-1]             # monotone envelope
    if mode == "all":                                    # VOC2010+: exact area
        i = np.where(r[1:] != r[:-1])[0]
        return np.sum((r[i + 1] - r[i]) * p[i + 1])
    pts = np.linspace(0, 1, 11 if mode == "voc11" else 101)
    return np.mean([p[r >= t].max() if np.any(r >= t) else 0 for t in pts])

# synthetic data: 50 images, 1-4 objects each; detector = jittered GT + false positives
rng = np.random.default_rng(0)
gts, dets = [], []
for _ in range(50):
    n = rng.integers(1, 5)
    xy = rng.uniform(0, 200, (n, 2)); wh = rng.uniform(20, 80, (n, 2))
    g = np.hstack([xy, xy + wh]); gts.append(g)
    keep = rng.random(n) > 0.15                          # miss ~15% of objects
    jit = rng.normal(0, 0.06, (n, 4)) * np.hstack([wh, wh])
    db = (g + jit)[keep]; ds = rng.uniform(0.4, 1.0, keep.sum())
    m = rng.integers(0, 3)                               # 0-2 false positives
    fxy = rng.uniform(0, 200, (m, 2)); fwh = rng.uniform(20, 80, (m, 2))
    db = np.vstack([db, np.hstack([fxy, fxy + fwh])]); ds = np.concatenate([ds, rng.uniform(0, 0.7, m)])
    dets.append((db, ds))

for thr in (0.5, 0.75):
    tp, n_gt = match(dets, gts, thr)
    rec, prec = pr_curve(tp, n_gt)
    print(f"IoU {thr}: VOC11 {ap(rec, prec, 'voc11'):.3f}  all-point {ap(rec, prec):.3f}"
          f"  COCO-101 {ap(rec, prec, 'coco'):.3f}")
aps = [ap(*pr_curve(*match(dets, gts, t)), "coco") for t in np.arange(0.5, 0.96, 0.05)]
print("AP@[.5:.95] =", round(float(np.mean(aps)), 3))
輸出
IoU 0.5: VOC11 0.776  all-point 0.797  COCO-101 0.797
IoU 0.75: VOC11 0.749  all-point 0.736  COCO-101 0.738
AP@[.5:.95] = 0.532可以看出三個教訓。三種內插規則得到相近但不相同的數字,所以不同協定算出的 AP 絕對不能互相比較。AP@[.5:.95] 比 AP50 低得多,因為抖動的框通不過嚴格門檻。而這只是單一類別;真正的 mAP 會對類別取平均,所以稀有類別和常見類別占同樣的份量。
AP 沒告訴你的事
AP 總結的是整個測試集上的排序品質,因此它不會替你選定操作門檻,也不會區分錯誤的類型:定位錯誤、與相似類別混淆、重複偵測、背景誤報,在 AP 裡看起來都一樣。診斷模型時,要依錯誤類型與物件大小拆開分析,並且實際去看影像。
資料集與基準
白話地說:偵測的進展由少數幾個公開資料集推動;每一個都改變了「好」的定義。
| 資料集 | 類別 | 規模(依論文) | 標註 | 重要性 |
|---|---|---|---|---|
| PASCAL VOC [3] | 20 | 以今日標準來看很小 | 框(+部分遮罩) | 2005–2012 年的基準;AP50 |
| MS COCO [4] | 標註 91 種;偵測用 80 種 | 32.8 萬張影像、250 萬個標註實例 | 框+實例遮罩 | 雜亂的日常場景、大量小物件;AP@[.5:.95] |
| Objects365 [42] | 365 | 大規模、高品質的框 | 框 | 強大偵測器常用的預訓練資料集 |
| Open Images V4 [43] | 600 個有框類別 | 920 萬張影像;1,540 萬個框 | 框、影像標籤、關係 | 非常大;影像層級有 1.98 萬個概念 |
| LVIS [44] | 超過 1000 | 16.4 萬張影像中約 200 萬張遮罩 | 實例遮罩 | 長尾詞彙;稀有類別評估 |
有兩個趨勢很明顯。類別數持續增加(20、80,到數百乃至上千),隨之而來的是長尾問題:在 LVIS 中,許多類別只有少數幾個訓練樣本,忽略頻率的損失函數或取樣器在稀有類別上就會失敗。另外,最大的模型如今都先在 Objects365 或影像–文字資料上預訓練,再於 COCO 上微調,使得「只用 COCO 訓練」與「使用額外資料」成為兩個分開的排行榜。
速度、準確度與部署
白話地說:實務上你是在一條曲線上選一個點:更準通常代表更多運算。真正重要的是在你的硬體上、端到端的延遲。
- FLOPs 不等於延遲。 FLOPs 計算的是算術量,但執行時間還取決於記憶體存取、運算子支援與平行度。深度可分離卷積與注意力在 FLOPs 上可能很便宜,在某些加速器上卻很慢。
- 端到端量測。 回報延遲時要包含前處理、網路以及後處理。NMS 的成本隨候選框數量增加(最壞情況與數量的平方成正比)、依資料而定,而且常在 CPU 上執行。RT-DETR 的論文 [34] 正是分析了這一點,這也是 RT-DETR 與 YOLOv10 [24] 等免 NMS 設計對部署很有吸引力的原因之一。
- 輸入解析度是最強的調整旋鈕:邊長減半,運算量約減為四分之一,但受傷最重的是小物件。
- 量化(quantization,例如 8 位元整數的權重與活化值)與重參數化(訓練時用多分支區塊,之後折疊成單一卷積,如 YOLOv7 [22] 所用)能在小幅損失準確度下降低延遲。框迴歸輸出與分數頭通常對量化最敏感,所以要用真實資料校準,並且檢查 AP75,而不只是 AP50。
- 批次大小 1 是邊緣裝置的常見情境;以大批次量測的吞吐量數字不能直接套用。
一個你可以自己訓練的小型偵測器
為了親眼看到邊界框迴歸與 IoU 損失端到端地運作,下面的 PyTorch 程式訓練一個小 CNN,在帶雜訊的 影像中定位一個矩形或橢圓。這是單一物件偵測器:網路透過 sigmoid 直接迴歸 範圍內的 ,以 L1 加上 GIoU 損失訓練,和 DETR 對匹配到的查詢所做的一樣。
程式碼 · Python · 52 行
import time, torch, torch.nn as nn
torch.manual_seed(0)
S = 32
torch.set_num_threads(1)  # avoid CPU oversubscription in the small teaching example

def make_batch(n):
    """One white rectangle or ellipse per 32x32 noisy image; target = (cx, cy, w, h) in [0, 1]."""
    img = 0.1 * torch.randn(n, 1, S, S)
    wh = torch.rand(n, 2) * 0.4 + 0.15
    c = wh / 2 + torch.rand(n, 2) * (1 - wh)
    yy, xx = torch.meshgrid(torch.arange(S), torch.arange(S), indexing="ij")
    xx, yy = (xx[None] + 0.5) / S, (yy[None] + 0.5) / S
    dx = (xx - c[:, 0, None, None]) / (wh[:, 0, None, None] / 2)
    dy = (yy - c[:, 1, None, None]) / (wh[:, 1, None, None] / 2)
    rect = (dx.abs() <= 1) & (dy.abs() <= 1)
    ell = dx**2 + dy**2 <= 1
    shape = torch.where((torch.rand(n) < 0.5)[:, None, None], rect, ell)
    return img + shape[:, None].float(), torch.cat([c, wh], 1)

def xyxy(b):
    return torch.cat([b[:, :2] - b[:, 2:] / 2, b[:, :2] + b[:, 2:] / 2], 1)

def giou(p, g):
    p, g = xyxy(p), xyxy(g)
    lt, rb = torch.max(p[:, :2], g[:, :2]), torch.min(p[:, 2:], g[:, 2:])
    inter = (rb - lt).clamp(min=0).prod(1)
    area = lambda b: (b[:, 2:] - b[:, :2]).prod(1)
    union = area(p) + area(g) - inter
    c = (torch.max(p[:, 2:], g[:, 2:]) - torch.min(p[:, :2], g[:, :2])).prod(1)
    return inter / union, inter / union - (c - union) / c

net = nn.Sequential(
    nn.Conv2d(1, 16, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),   # 16
    nn.Conv2d(16, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),  # 8
    nn.Conv2d(32, 32, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),  # 4
    nn.Flatten(), nn.Linear(32 * 4 * 4, 128), nn.ReLU(),
    nn.Linear(128, 4), nn.Sigmoid())                               # (cx, cy, w, h) in [0, 1]
opt = torch.optim.Adam(net.parameters(), 2e-3)

t0 = time.time()
for step in range(500):
    x, y = make_batch(64)
    pred = net(x)
    iou, g = giou(pred, y)
    loss = (pred - y).abs().sum(1).mean() + (1 - g).mean()        # L1 + GIoU loss
    opt.zero_grad(); loss.backward(); opt.step()

with torch.no_grad():
    x, y = make_batch(1000)
    iou, _ = giou(net(x), y)
print(f"train time {time.time() - t0:.1f}s | test mean IoU {iou.mean():.3f}"
      f" | IoU>=0.5: {(iou >= 0.5).float().mean():.1%} | IoU>=0.75: {(iou >= 0.75).float().mean():.1%}")
輸出
train time 25.3s | test mean IoU 0.882 | IoU>=0.5: 99.9% | IoU>=0.75: 97.3%(以上為一次 CPU 執行結果;時間與最終分數可能隨硬體及數值函式庫而變。)因為恰好只有一個物件,所以沒有指派問題,也不需要 NMS。練習 6 會請你把它擴充到多個物件,而本篇所有困難的問題都會在那裡重新出現。
現代觀點
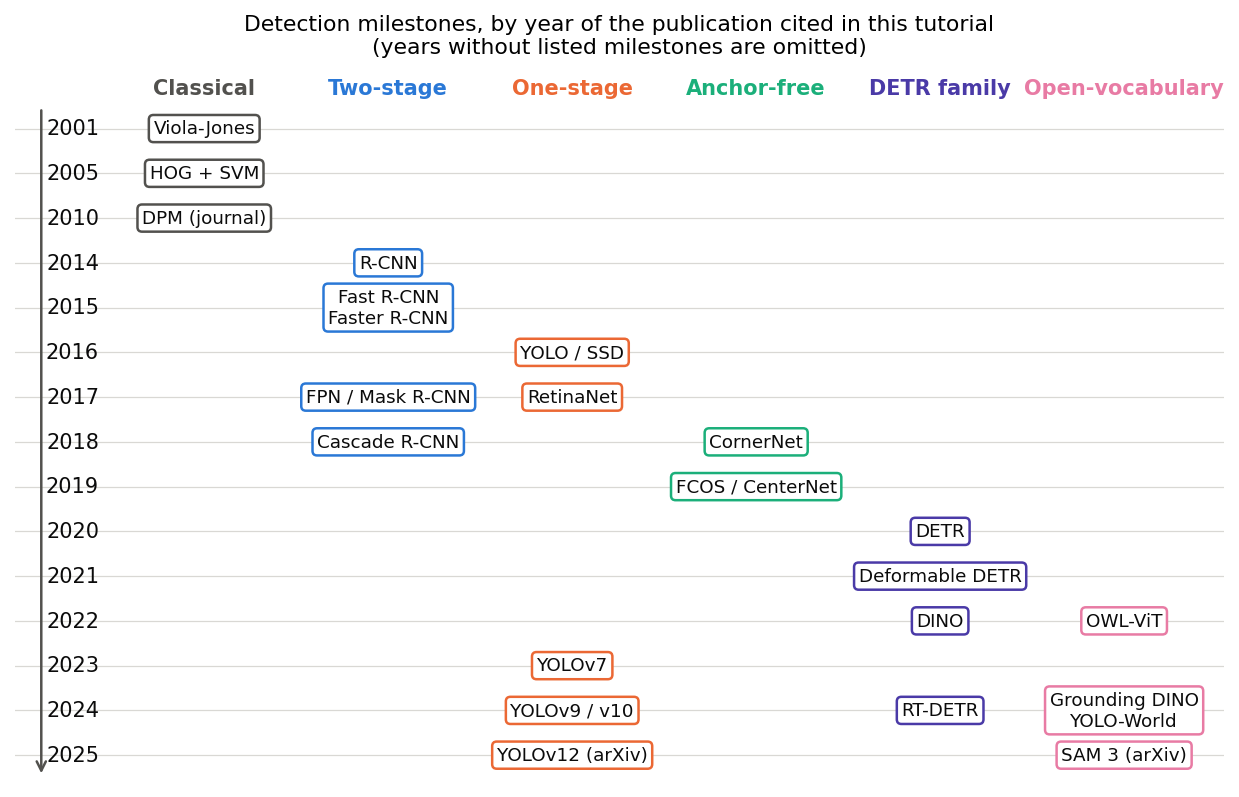
圖 7 以每篇引用文獻的發表年份,把本篇的方法放在時間軸上。
綜述怎麼說
五篇綜述框出了這個領域。Zou 等人 [1] 提供涵蓋最廣的歷史,從 Viola–Jones 到深度偵測器,並指出大多數「新」想法都有更早的根源:多尺度掃描變成特徵金字塔,困難負樣本挖掘變成焦點損失。Liu 等人 [2] 是 CNN 時代最好的單一參考,並強調訓練策略、資料與評估和架構一樣重要。Shehzadi 等人 [45] 回顧近期對 DETR 的改進;Zhu 與 Chen [46] 整理開放詞彙方法,並提醒預訓練資料與測試資料的詞彙重疊會讓評估變得複雜;Cheng 等人 [39] 則顯示小物件仍遠比大物件困難。
選讀:現代觀點綜述導讀(見「論文導讀」頁)。逐篇說明每篇綜述涵蓋什麼、如何分類這個領域,以及結論是什麼。
2023–2026 年的最先進技術
- 即時封閉集合偵測如今是 YOLO 路線(YOLOv9 [23]、YOLOv10 [24]、YOLOv12 [25])與即時 DETR(RT-DETR [34])之間的競賽。兩條路線互相借鏡:YOLO 引入一對一指派與免 NMS 偵測頭,DETR 引入卷積頸部與混合編碼器。在即時預算下使用注意力已經負擔得起。
- 高準確度的封閉集合偵測由 DETR 式模型主導,例如搭配大型骨幹與大規模預訓練(Objects365 [42] 及更多)的 DINO [33]。COCO 上的進步幅度已經很小,對最大的模型而言這個基準已接近飽和,因此注意力轉向更難的基準:LVIS [44]、開放詞彙與跨領域評估。
- 開放詞彙與定位偵測(OWL-ViT [35]、Grounding DINO [36]、YOLO-World [37])正走進實務:在許多應用中,你現在是去提示一個偵測器,而不是訓練一個,必要時再微調。
- 可提示的基礎模型(SAM 3 [38])以概念提示統一了偵測、分割與追蹤。
尚待解決的問題
- 定位品質與信心分數。 分類分數與框品質分開訓練,兩者的相關性常常不高,所以「最好」的框可能被一個更有信心、卻更差的框抑制掉。
- 小、擁擠與被遮擋的物件仍遠未解決 [39]。
- 長尾與開放世界辨識。 稀有類別與真正未見過的物件,以及知道模型何時不知道。
- 評估。 COCO AP 隱藏了錯誤類型,在頂端已經飽和;開放詞彙的評估則取決於提示詞,以及預訓練資料裡原本就包含了什麼 [46]。
- 在真實硬體上的效率,包括免 NMS 設計、利於量化的偵測頭,以及公平的延遲報告。
重點整理
- 偵測預測數量不固定的方框、類別與分數集合。
- 方框參數化定義定位目標,指派則決定各預測學習哪個物件。
- NMS 抑制重複預測,擁擠場景讓這項決策更困難。
- 特徵金字塔處理尺度差異,焦點損失調整容易與困難樣本的貢獻。
- 比較架構時,分清候選區域細化、密集預測與一對一集合匹配。
- 開放詞彙偵測改變類別介面,仍須評估定位及詞彙設定。
- 報告 AP 定義、IoU 門檻、物件尺度與完整計時協定。
練習
- 手算編碼。 一個錨框中心為 、大小為 。一個真值框中心為 、大小為 。在不做正規化的情況下計算 ,再把它們解碼回去。
提示
,,,。解碼:,, 與 同理。
- IoU 與平移。 證明兩個相同的 正方形沿單一軸平移 時,。平移多少時 IoU 為 0.5 與 0.75?再對兩軸等量平移的情況重做一次(圖 2 右)。
提示
交集為 ,聯集為 。IoU 0.5 時 ;IoU 0.75 時 。斜向平移時 ,所以 IoU 0.5 時 。
- 貪婪 NMS 何時失敗。 修改 NMS 範例,讓兩個不同的人以 IoU 0.6 重疊,然後分別以門檻 0.5 與 0.7 執行貪婪 NMS,以及 Soft-NMS。哪一種能找回兩個人?高門檻又帶來什麼新問題?
提示
門檻 0.5 時,分數較低的那個人被刪掉。門檻 0.7 時兩人都留下,但同一個人 IoU 介於 0.5 到 0.7 的重複框也會留下,增加誤報。Soft-NMS 以降低後的分數保留第二個人(原分數乘上 ),在 AP 中仍會計入召回。
- 焦點損失的數字。 在 、 下,對一個背景錨框計算 (簡單)與 (困難)時的焦點損失與一般交叉熵。兩者各自差了多少倍?
提示
背景時 ,。簡單:CE ;FL ,約小了 倍。困難:CE ;FL ,只小了約 3.7 倍。
- 協定之間的差異。 使用 AP 程式碼,(藉由改變亂數種子或抖動量)找出 VOC 11 點 AP 高於全點 AP 的情況,以及低於的情況。說明為什麼兩者沒有固定的大小關係。
提示
11 點規則在固定的召回值取樣包絡線,所以若包絡線剛好在取樣點右側很高、之後馬上下降,就會高估;反之則低估。上面的輸出已經同時呈現兩種情形:IoU 0.5 時 11 點的值較低,0.75 時較高。
- 從一個物件到多個物件。 把小型 PyTorch 偵測器擴充到最多三個形狀的影像。方案 A:像 YOLO v1 一樣預測 的(物件分數、框)網格,把每個物件指派給其中心所在的格子。方案 B:預測 5 個(類別、框)名額,並像 DETR 一樣以匈牙利匹配訓練。比較兩者的失敗模式。
提示
方案 A 在兩個中心落在同一格時會失敗,也需要 NMS 去除相鄰格子的重複框。方案 B 不需要 NMS,但訓練較慢,而且訓練初期匹配不穩定(同一個物件可能在不同步驟被指派給不同名額)。對 detach 後的成本矩陣使用 scipy.optimize.linear_sum_assignment。
偵測結果是追蹤的原料。下一步——在影片影格之間串連邊界框並維持身分——請見 DLCV 07・物件追蹤。
參考文獻
- Z. Zou, K. Chen, Z. Shi, Y. Guo and J. Ye, “Object detection in 20 years: A survey,” Proceedings of the IEEE, vol. 111, no. 3, 2023. doi
- L. Liu, W. Ouyang, X. Wang, P. Fieguth, J. Chen, X. Liu and M. Pietikäinen, “Deep learning for generic object detection: A survey,” International Journal of Computer Vision, 2020. doi
- M. Everingham, L. Van Gool, C. K. I. Williams, J. Winn and A. Zisserman, “The PASCAL Visual Object Classes (VOC) challenge,” International Journal of Computer Vision, vol. 88, 2010. doi
- T.-Y. Lin, M. Maire, S. Belongie, L. Bourdev, R. Girshick et al., “Microsoft COCO: Common objects in context,” in Proc. ECCV, 2014. doi
- P. Viola and M. Jones, “Rapid object detection using a boosted cascade of simple features,” in Proc. IEEE CVPR, 2001. doi
- N. Dalal and B. Triggs, “Histograms of oriented gradients for human detection,” in Proc. IEEE CVPR, 2005. doi
- P. F. Felzenszwalb, R. B. Girshick, D. McAllester and D. Ramanan, “Object detection with discriminatively trained part-based models,” IEEE TPAMI, 2010. doi
- R. Girshick, J. Donahue, T. Darrell and J. Malik, “Rich feature hierarchies for accurate object detection and semantic segmentation,” in Proc. IEEE CVPR, 2014. arXiv
- R. Girshick, “Fast R-CNN,” in Proc. IEEE ICCV, 2015. arXiv
- S. Ren, K. He, R. Girshick and J. Sun, “Faster R-CNN: Towards real-time object detection with region proposal networks,” IEEE TPAMI, 2017 (conference version 2015). doi
- H. Rezatofighi, N. Tsoi, J. Gwak, A. Sadeghian, I. Reid and S. Savarese, “Generalized intersection over union: A metric and a loss for bounding box regression,” in Proc. IEEE/CVF CVPR, 2019. arXiv
- Z. Zheng, P. Wang, W. Liu, J. Li, R. Ye and D. Ren, “Distance-IoU loss: Faster and better learning for bounding box regression,” in Proc. AAAI, 2020. arXiv
- N. Bodla, B. Singh, R. Chellappa and L. S. Davis, “Soft-NMS — Improving object detection with one line of code,” in Proc. IEEE ICCV, 2017. arXiv
- T.-Y. Lin, P. Dollár, R. Girshick, K. He, B. Hariharan and S. Belongie, “Feature pyramid networks for object detection,” in Proc. IEEE CVPR, 2017. doi
- T.-Y. Lin, P. Goyal, R. Girshick, K. He and P. Dollár, “Focal loss for dense object detection,” in Proc. IEEE ICCV, 2017. doi
- K. He, G. Gkioxari, P. Dollár and R. Girshick, “Mask R-CNN,” in Proc. IEEE ICCV, 2017. doi
- Z. Cai and N. Vasconcelos, “Cascade R-CNN: Delving into high quality object detection,” in Proc. IEEE/CVF CVPR, 2018. doi
- J. Redmon, S. Divvala, R. Girshick and A. Farhadi, “You only look once: Unified, real-time object detection,” in Proc. IEEE CVPR, 2016. doi
- J. Redmon and A. Farhadi, “YOLO9000: Better, faster, stronger,” IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), pp. 7263–7271, 2017. CVF · arXiv
- J. Redmon and A. Farhadi, “YOLOv3: An incremental improvement,” tech. report, arXiv:1804.02767, 2018. arXiv
- A. Bochkovskiy, C.-Y. Wang and H.-Y. M. Liao, “YOLOv4: Optimal speed and accuracy of object detection,” arXiv:2004.10934, 2020. arXiv
- C.-Y. Wang, A. Bochkovskiy and H.-Y. M. Liao, “YOLOv7: Trainable bag-of-freebies sets new state-of-the-art for real-time object detectors,” in Proc. IEEE/CVF CVPR, 2023. doi
- C.-Y. Wang, I-H. Yeh and H.-Y. M. Liao, “YOLOv9: Learning what you want to learn using programmable gradient information,” in Proc. ECCV, 2024. doi
- A. Wang, H. Chen, L. Liu, K. Chen, Z. Lin et al., “YOLOv10: Real-time end-to-end object detection,” in Proc. NeurIPS, 2024. arXiv
- Y. Tian, Q. Ye and D. Doermann, “YOLOv12: Attention-centric real-time object detectors,” arXiv:2502.12524, 2025. arXiv
- W. Liu, D. Anguelov, D. Erhan, C. Szegedy, S. Reed, C.-Y. Fu and A. C. Berg, “SSD: Single shot multibox detector,” in Proc. ECCV, 2016. arXiv
- H. Law and J. Deng, “CornerNet: Detecting objects as paired keypoints,” in Proc. ECCV, 2018. doi
- X. Zhou, D. Wang and P. Krähenbühl, “Objects as points,” arXiv:1904.07850, 2019. arXiv
- Z. Tian, C. Shen, H. Chen and T. He, “FCOS: Fully convolutional one-stage object detection,” in Proc. IEEE/CVF ICCV, 2019. arXiv
- N. Carion, F. Massa, G. Synnaeve, N. Usunier, A. Kirillov and S. Zagoruyko, “End-to-end object detection with transformers,” in Proc. ECCV, 2020. doi
- H. W. Kuhn, “The Hungarian method for the assignment problem,” Naval Research Logistics Quarterly, vol. 2, 1955. doi
- X. Zhu, W. Su, L. Lu, B. Li, X. Wang and J. Dai, “Deformable DETR: Deformable transformers for end-to-end object detection,” in Proc. ICLR, 2021. arXiv
- H. Zhang, F. Li, S. Liu, L. Zhang, H. Su, J. Zhu, L. M. Ni and H.-Y. Shum, “DINO: DETR with improved denoising anchor boxes for end-to-end object detection,” arXiv:2203.03605, 2022. arXiv
- Y. Zhao, W. Lv, S. Xu, J. Wei, G. Wang et al., “DETRs beat YOLOs on real-time object detection,” in Proc. IEEE/CVF CVPR, 2024. doi
- M. Minderer, A. Gritsenko, A. Stone, M. Neumann, D. Weissenborn et al., “Simple open-vocabulary object detection with vision transformers,” in Proc. ECCV, 2022. arXiv
- S. Liu, Z. Zeng, T. Ren, F. Li, H. Zhang et al., “Grounding DINO: Marrying DINO with grounded pre-training for open-set object detection,” in Proc. ECCV, 2024. doi
- T. Cheng, L. Song, Y. Ge, W. Liu, X. Wang et al., “YOLO-World: Real-time open-vocabulary object detection,” in Proc. IEEE/CVF CVPR, 2024. doi
- N. Carion, L. Gustafson, Y.-T. Hu, S. Debnath, R. Hu et al., “SAM 3: Segment anything with concepts,” arXiv:2511.16719, 2025. arXiv
- G. Cheng, X. Yuan, X. Yao, K. Yan, Q. Zeng et al., “Towards large-scale small object detection: Survey and benchmarks,” IEEE TPAMI, vol. 45, no. 11, 2023. arXiv
- COCO Consortium, “COCO detection evaluation,” official evaluation description (12 metrics, 101-point interpolation). link · official evaluator
- M. Everingham, S. M. A. Eslami, L. Van Gool, C. K. I. Williams, J. Winn and A. Zisserman, “The PASCAL Visual Object Classes challenge: A retrospective,” International Journal of Computer Vision, vol. 111, 2015. doi
- S. Shao, Z. Li, T. Zhang, C. Peng et al., “Objects365: A large-scale, high-quality dataset for object detection,” in Proc. IEEE/CVF ICCV, 2019. doi
- A. Kuznetsova, H. Rom, N. Alldrin, J. Uijlings, I. Krasin et al., “The Open Images Dataset V4: Unified image classification, object detection, and visual relationship detection at scale,” International Journal of Computer Vision, 2020. arXiv
- A. Gupta, P. Dollár and R. Girshick, “LVIS: A dataset for large vocabulary instance segmentation,” in Proc. IEEE/CVF CVPR, 2019. doi
- T. Shehzadi, K. A. Hashmi, M. Liwicki, D. Stricker and M. Z. Afzal, “Object detection with transformers: A review,” Sensors, vol. 25, no. 19, 2025. doi
- C. Zhu and L. Chen, “A survey on open-vocabulary detection and segmentation: Past, present, and future,” IEEE TPAMI, 2024. doi
檢查理解
本篇有 6 題練習。不看提示,你能解出來嗎?
前往練習 ↑下一篇 DLCV 03A・以 YOLOv4 讀懂單階段偵測 · 26 分鐘